

La cifra clave de Inkling 2 Mini es el coste por tarea: Artificial Analysis lo puntúa con 20, empatado con Qwen3.8-27B, a 0,59 $ por tarea frente a 3,53 $ y 9,0 minutos por tarea frente a 34,5. Es un modelo de bucle de 26,4B de parámetros bajo Apache 2.0 que cabe en unos 20 GB. La contrapartida es el conocimiento: el laboratorio lo califica como menos capaz que Inkling 2 Small en la mayoría de las evaluaciones, y afirma datos incorrectos con más confianza.
Para los equipos de soporte, eso lo convierte en un motor rápido y barato que aun así necesita fundamentación en su centro de ayuda y una prueba con tickets pasados, que es justo el trabajo que hace eesel alrededor de cualquier modelo que elija.
¿Qué es Inkling 2 Mini?
Inkling 2 Mini es el hermano menor de Inkling 2 Small en la segunda generación de Thinking Machines Lab, anunciado el 20 de noviembre de 2026. Tiene 26,4B de parámetros totales, toma texto e imágenes como entrada, escribe texto como salida y se publica con pesos abiertos. Su ficha de modelo en Hugging Face indica Apache 2.0 y un contexto de 1M de tokens.
Yo construyo funciones y agentes de IA en eesel, así que cuando llega un modelo nuevo leo cómo está construido antes de leer la tabla de benchmarks. Mini es poco habitual en ese sentido, lo cual explico más abajo. Por eso eesel también tiene una herramienta de línea de comandos: con la CLI de eesel, un agente de codificación con IA puede subir conocimiento aprobado como artículos de ayuda exportados y respuestas guardadas, cambiar las instrucciones del agente de soporte y hacer preguntas de prueba antes de que nada salga en vivo, sea cual sea el modelo que haya debajo. Conectar el helpdesk en sí todavía necesita que alguien con acceso de administrador lo apruebe.
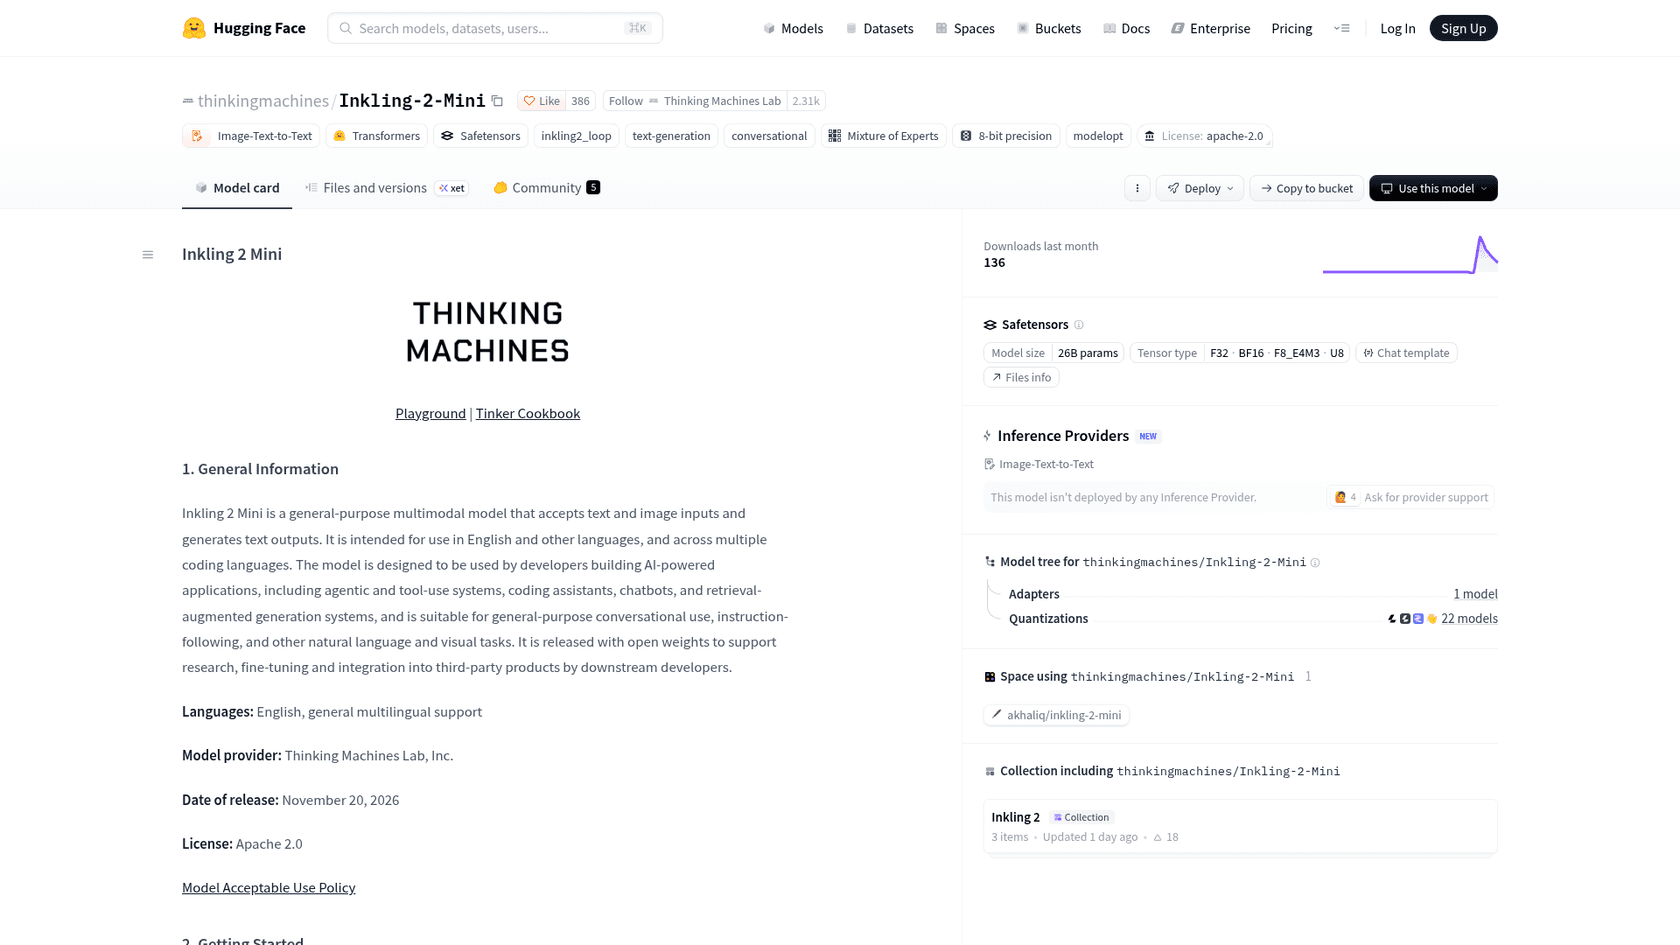
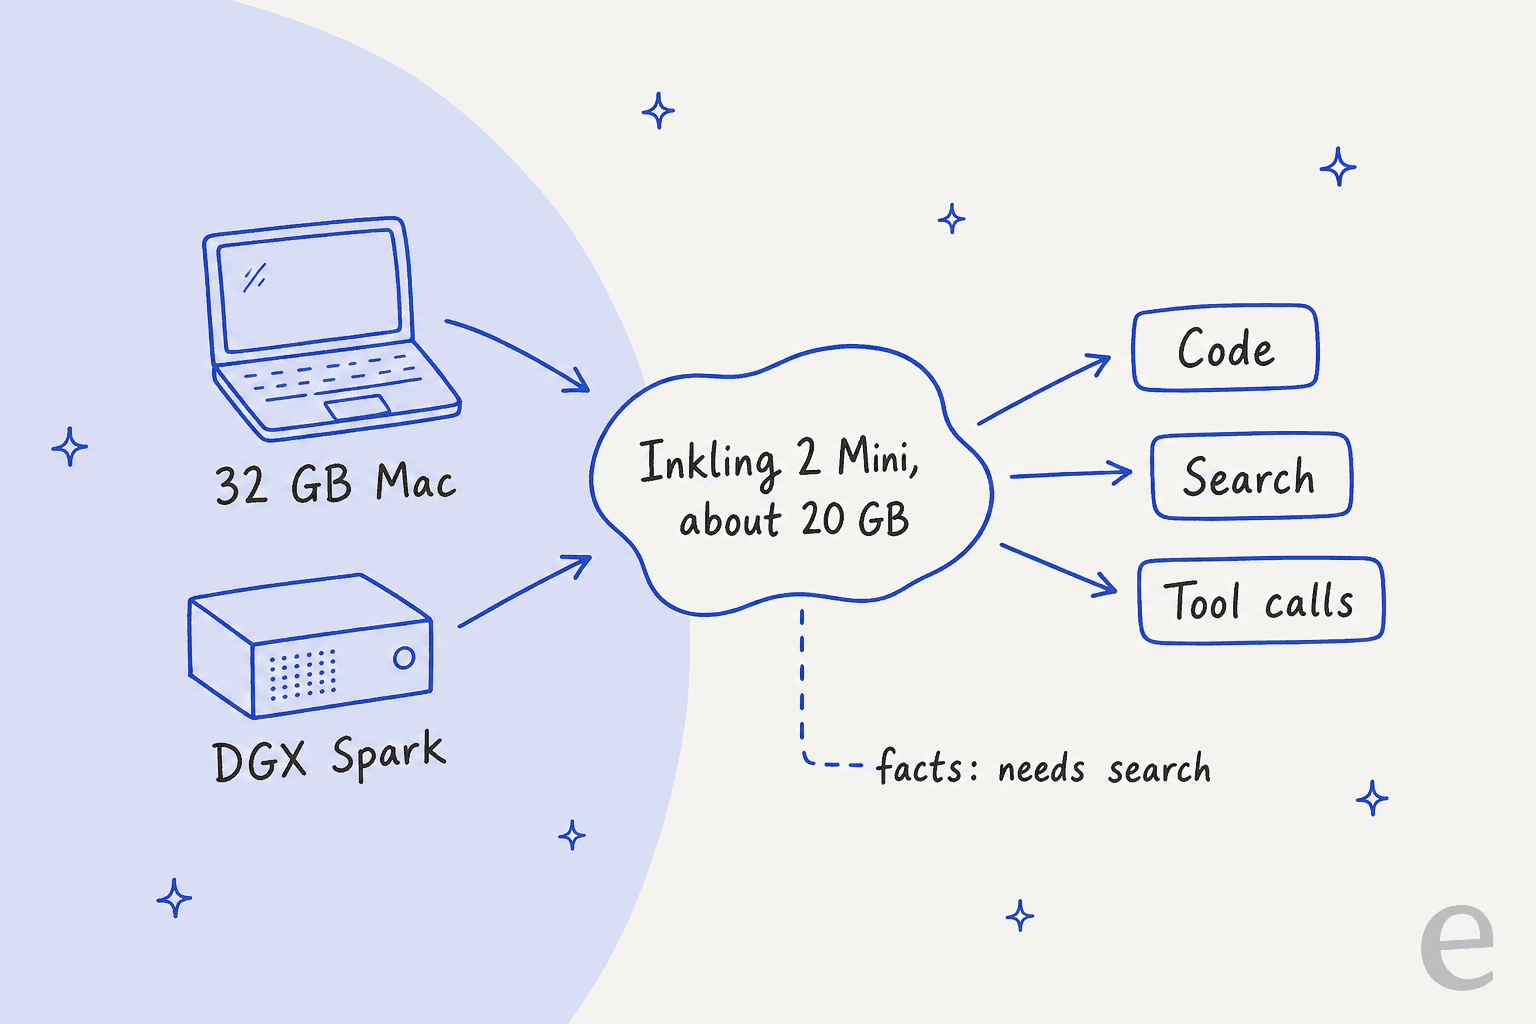
Las cifras que importan en la ficha: 3,4B de parámetros activos por token, un checkpoint de unos 20 GB, y una variante de investigación llamada TML-d24-varloop-research que le permite elegir cuántas pasadas de bucle ejecuta el modelo. La ficha indica un NVIDIA DGX Spark o silicio de Apple con 32 GB de memoria como hardware objetivo.
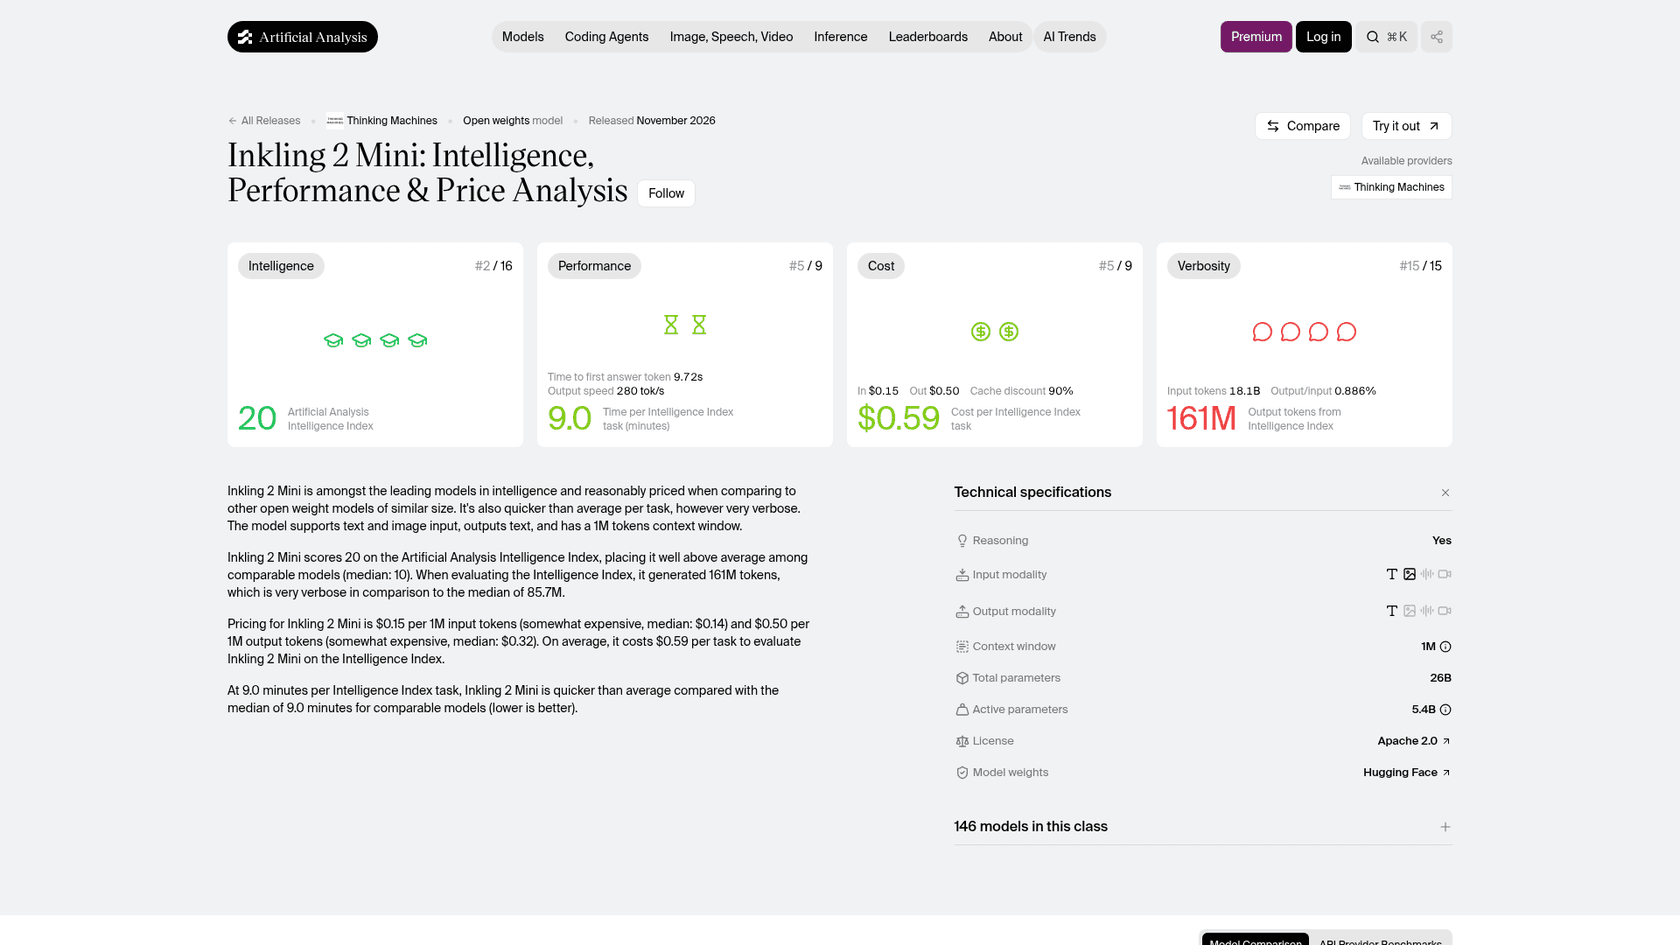
Un apunte temprano. El texto del anuncio dice 3,4B de parámetros activos, mientras que su tabla de especificaciones y Artificial Analysis dicen 5,4B. Ambos tienen razón a su manera: 3,4B son los que están almacenados y activos, y 5,4B es el conteo una vez que se suman las capas que se ejecutan tres veces.
¿Cómo se compara Inkling 2 Mini con Inkling 2 Small?
Mini es más pequeño, más barato por tarea y más rápido, y es más débil en la mayoría de las pruebas. Las especificaciones vienen de cada ficha de modelo, los precios de la página de precios de Tinker, y las puntuaciones y velocidades de las páginas de Small y Qwen3.8-27B de Artificial Analysis, además de la página de Mini que se muestra abajo.
| Inkling 2 Mini | Inkling 2 Small | Qwen3.8-27B | |
|---|---|---|---|
| Lanzamiento | 20 nov. 2026 | 5 nov. 2026 | ago. 2026 |
| Parámetros totales / activos | 26,4B / 3,4B (5,4B con bucles) | 594B / 17B | 27B |
| Entrada | Texto, imagen | Texto, imagen | n/d |
| Contexto (ficha) | 1M | 1M | n/d |
| Licencia | Apache 2.0 | Apache 2.0 | n/d |
| Entrada / en caché / salida por 1M | $0.15 / $0.015 / $0.50 | $0.30 / $0.03 / $1.00 | $0.50 / n/d / $3.00 |
| AA Intelligence Index v5.0.1 | 20 | 31 | 20 |
| Velocidad de salida (AA) | 280 tokens/s | 118 tokens/s | 53 tokens/s |
| Tiempo al primer token de respuesta (AA) | 9,7s | 39,7s | 144,1s |
| Minutos por tarea del índice AA | 9,0 | 21,2 | 34,5 |
| Coste por tarea del índice AA | $0.59 | $1.18 | $3.53 |
| Tokens de salida en la ejecución del índice | 161M | 154M | sin comparar |
La columna de Qwen es la propia lista de Artificial Analysis, y "n/d" significa que no verifiqué esa celda. Dos advertencias sobre la columna de Mini. Primero, Mini no está en la lista de inferencia serverless de Tinker, y Artificial Analysis no muestra una API pública para él, así que su coste por tarea es la tarifa de sampling de Tinker aplicada a los tokens medidos, no un precio que pueda comprar hoy. Segundo, Mini escribió 161M de tokens en la ejecución del índice, más que los 154M de Small y casi el doble de la mediana de 85,7M que Artificial Analysis cita para modelos comparables. Eso dice claramente que el modelo es muy prolijo.
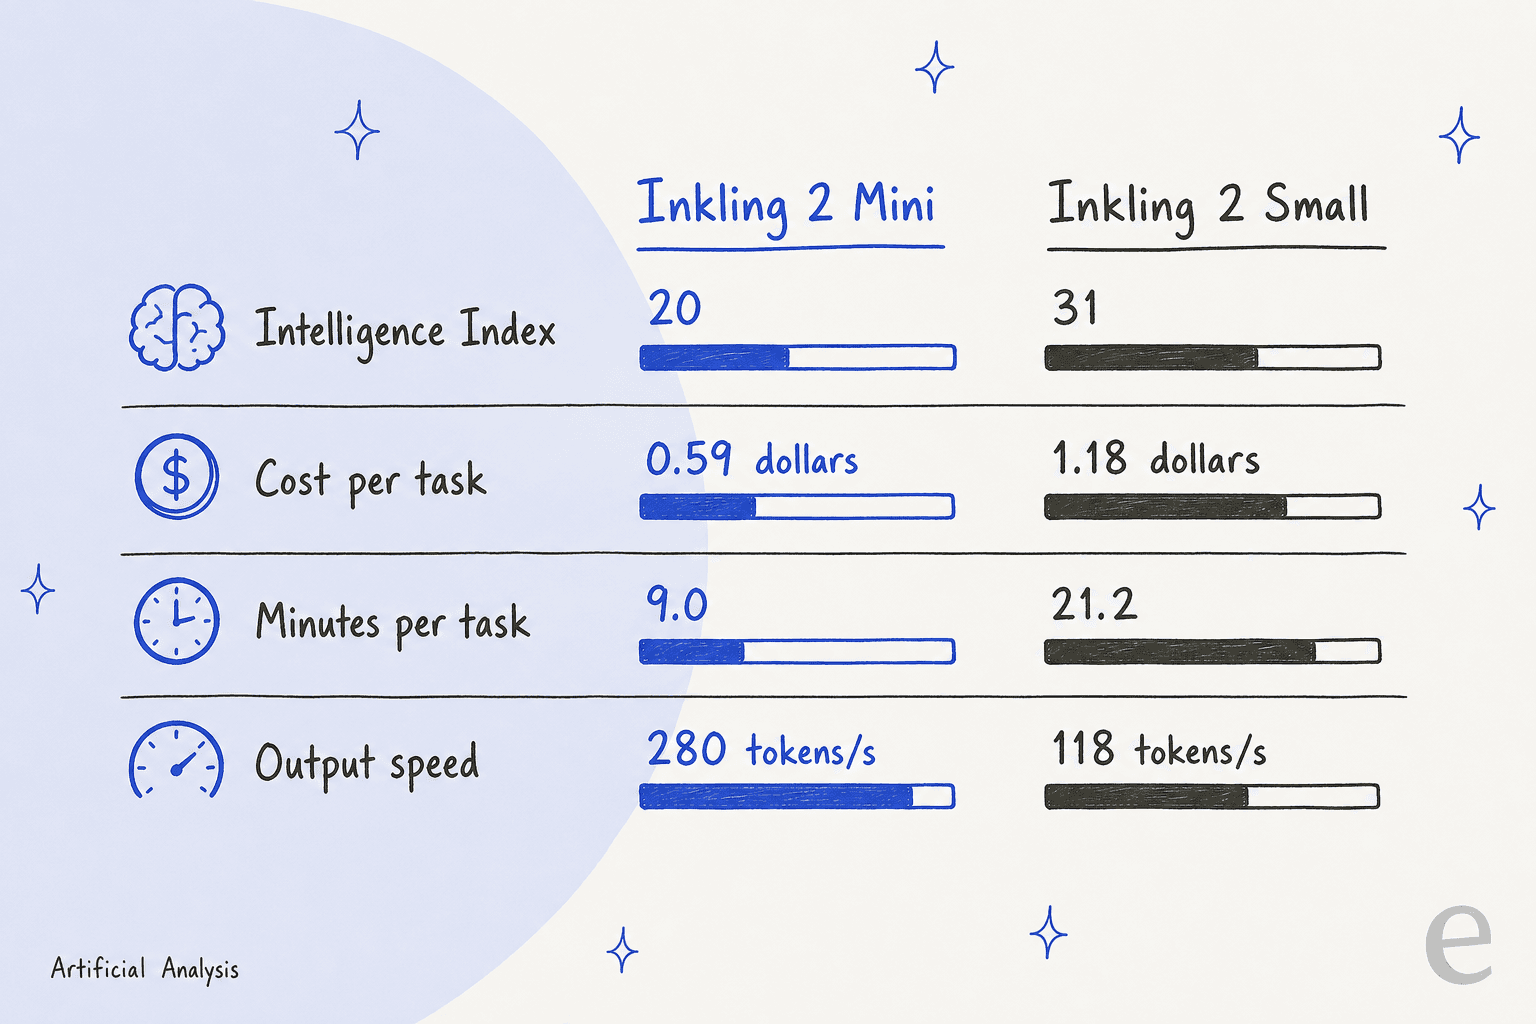
Mini puntúa 11 puntos por debajo de Small y cuesta la mitad por tarea. La propia ficha del laboratorio lo dice más claramente: el modelo es "menos capaz que Inkling 2 Small en la mayoría de nuestras evaluaciones", con las mayores brechas en el recuerdo de hechos. La excepción es el trabajo agéntico largo, donde el laboratorio dice que Mini "se acerca" a Small en su prueba PMPP-Hard. Los miembros más antiguos de la familia se cubren en las entradas de Inkling, Inkling-Small e Inkling 2 Small.
Una corrección al panorama de Small que escribí antes. En el lanzamiento, los pesos de Small eran cerrados. Desde entonces han aparecido en Hugging Face bajo Apache 2.0, y Artificial Analysis ahora lista a DeepInfra, Nebius y Together como hosts, con cifras de velocidad y coste que se movieron por ello. Arriba uso las cifras actuales.
¿Cómo funciona un modelo de bucle?
Un transformador de bucle reutiliza las mismas capas más de una vez por token. Inkling 2 Mini almacena 24 capas en cuatro bloques de seis, y los dos bloques del medio se ejecutan tres veces, así que cada token pasa por 48 aplicaciones de capa. La ficha del modelo dice que hacer bucle en las capas del medio superó a hacer bucle en las últimas capas en 27 de 28 evaluaciones.
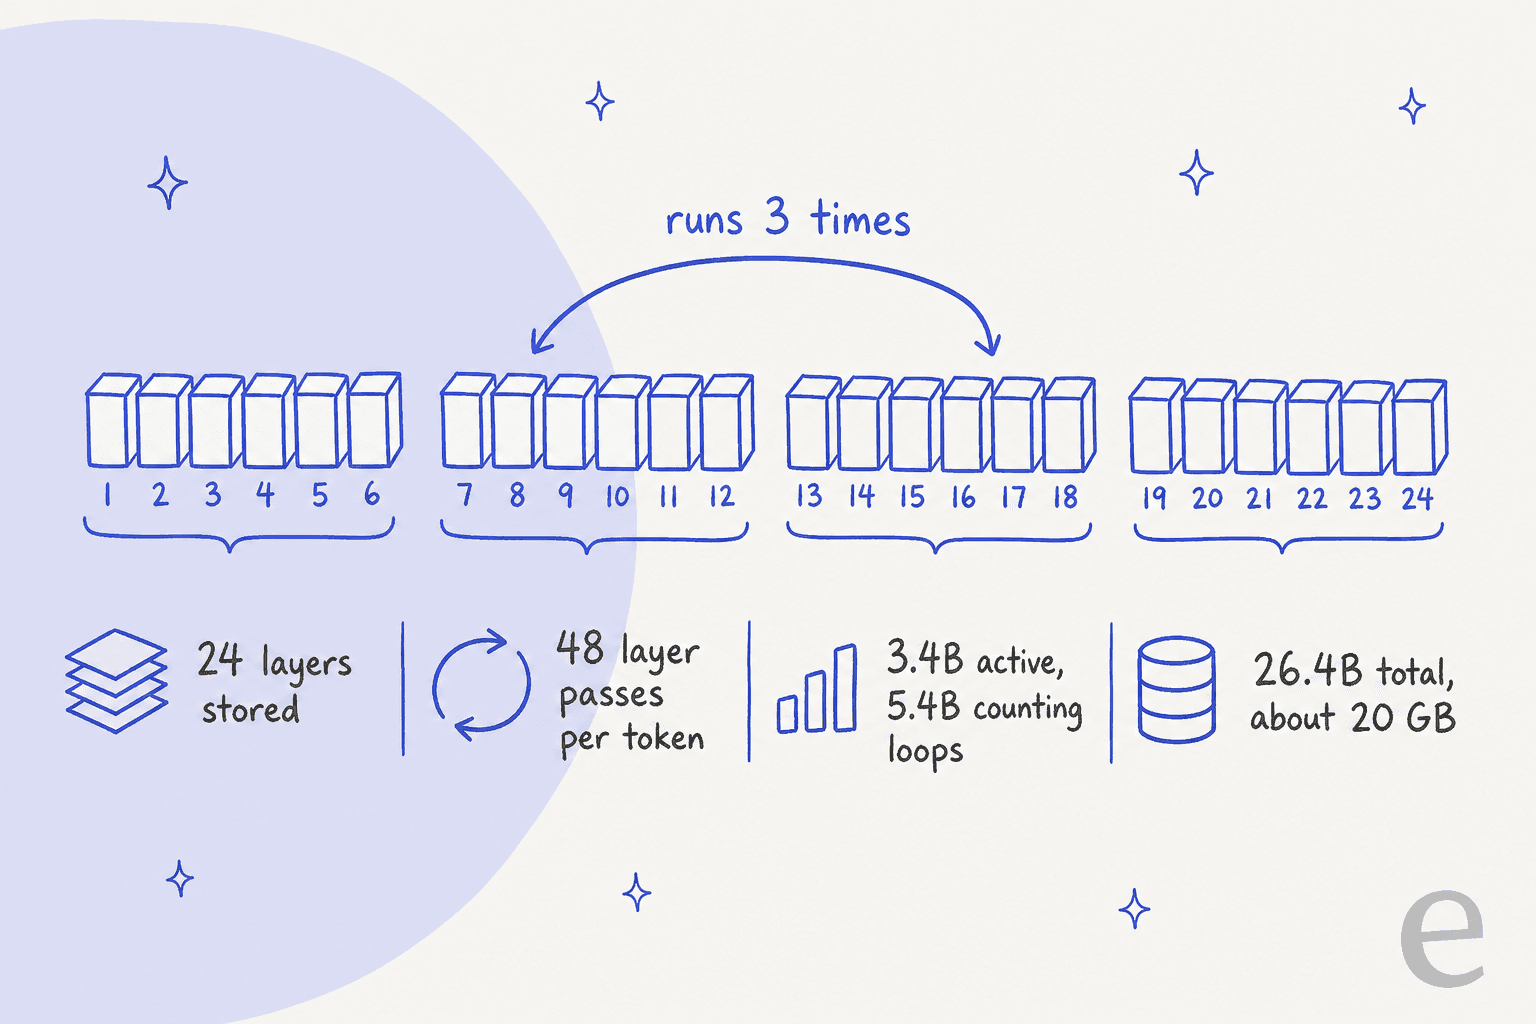
El punto es la memoria. Los teléfonos, portátiles y servidores pequeños están limitados por cuántos pesos pueden almacenar, no por cuánta aritmética pueden hacer. Reutilizar capas compra pensamiento adicional por token sin agrandar el archivo. Tres detalles más de la ficha:
- Entrenamiento. Las capas de expertos se entrenaron en NVFP4 (4 bits) desde el preentrenamiento hasta el aprendizaje por refuerzo, y las últimas cuatro capas en 8 bits, así que los pesos publicados coinciden con los entrenados sin ningún paso de conversión.
- Reducción. El laboratorio podó el modelo de 384 a 128 expertos por capa a mitad del entrenamiento, y luego lo sanó con 1T de tokens de destilación de un modelo Inkling interno mayor.
- La trampa. Hacer bucle no añade conocimiento. El laboratorio escribe que el conocimiento es sobre todo una función del número total de parámetros, así que los hechos no mejoran con más pasadas.
Esa última línea es la que hay que tener en mente para el resto de este artículo.
¿Cuánto cuesta Inkling 2 Mini?
En Tinker, Inkling 2 Mini samplea a 0,15 $ por 1M de tokens de entrada, 0,015 $ por 1M de tokens de entrada en caché y 0,50 $ por 1M de tokens de salida. El fine-tuning ("train") cuesta 0,75 $ por 1M de tokens con 64K de contexto y 1,50 $ con 256K. Inkling 2 Small es exactamente el doble en el lado del sampling. Los precios vienen de la página de precios de Tinker del proveedor; no usé ningún precio de terceros.
Tres cosas cambian la factura real:
- Serverless no está abierto para Mini. La página de precios limita la inferencia serverless a Inkling 2 Small, Inkling e Inkling-Small, y la página de OpenRouter no muestra precio. Hoy las rutas realistas son el sampling de Tinker o su propio hardware.
- La salida prolija se come el ahorro. El precio por token es la mitad del de Small, pero Mini escribe aproximadamente tantos tokens por tarea, así que la brecha por tarea con Small es de unas 2x, la misma proporción que los precios por token. Los tokens de salida son la unidad que decide la factura.
- Lo local es una factura distinta. En su propia máquina el coste es hardware y tiempo, no tokens, que es el caso para el que el laboratorio construyó Mini.
Para una visión presupuestaria de soporte, la guía de coste de la IA en atención al cliente muestra cómo se sitúa el precio del modelo junto a asientos, resoluciones y configuración.
¿Dónde flaquea Inkling 2 Mini?
Conocimiento, chats de varios turnos y sesiones de terminal. El laboratorio reporta sus propias brechas, lo cual merece reconocimiento. En su propia ficha, la tasa de no alucinación AA-Omniscience de Mini es del 63,4%, así que cuando no sabe una respuesta en esa prueba, adivina en lugar de decirlo algo más de un tercio de las veces. La ficha también coloca a Mini por detrás de Qwen3.8-27B en MultiChallenge (50,0%) y ComplexConstraints (33,4%), y empatado en un bajo 5,6% en Terminal Bench 4.0.
Los primeros usuarios notaron el mismo patrón. Un probador de Hacker News ejecutó un prompt de codificación con las herramientas desactivadas:
"The model burned through 19200 thinking tokens on this task (which was the hard limit I had set) and didn't finish."

El mismo usuario dijo que con la búsqueda permitida llegó a una solución pero aun así usó el nombre de hook equivocado. Otro comentarista fue más directo sobre los benchmarks de agentes:
"Big fan of open weights but those Terminal Bench numbers are pretty abysmal."
El hilo de lanzamiento alcanzó 473 puntos y 72 comentarios en Hacker News, y la mayor parte del elogio fue por el tamaño y la velocidad, no por la precisión. La lectura del laboratorio es que Mini "supera la brecha de conocimiento" usando búsqueda y herramientas, lo cual coincide con lo que vio ese probador: mejoró una vez que pudo consultar algo.
Donde Mini de verdad destaca es en trabajo agéntico que consiste principalmente en búsqueda y llamadas a herramientas. El laboratorio reporta 79,2% en SWE-bench Verified (solo bash), frente a 77,8% para Qwen3.8-27B, además de 79,0% en BrowseComp y 82,7% en MCP Atlas. Son las cifras del laboratorio, ejecutadas en su propio harness, así que yo esperaría a ejecuciones externas antes de tratarlas como definitivas. Gemini 3.8 Flash, DeepSeek V4 Flash y Kimi K3 son las opciones alojadas más grandes si no necesita pesos locales.
¿Se puede ejecutar Inkling 2 Mini en un portátil?
Sí, y ese es el verdadero titular para la mayoría de los desarrolladores. La ficha del modelo dice que un DGX Spark o una máquina de Apple con 32 GB o más de memoria unificada es suficiente, y existen compilaciones GGUF cuantizadas para llama.cpp, Ollama y aplicaciones similares. El laboratorio también cita un estudio de eficiencia de Stanford en un DGX Spark, donde Mini puntuó 0,703 en su medida de inteligencia por vatio frente a 0,430 de Qwen3.6-35B-A3B.
La velocidad real es menos clara. El laboratorio no publicó una cifra de tokens por segundo para su demo en portátil. Un usuario de Hacker News con una máquina más antigua reportó:
"I'm getting 20 tokens/s running the 4-bit version on my 2021 M1 Max MacBook pro with 64Gb."
Otro comentarista señaló que llama.cpp necesitó un pull request independiente para añadir soporte de bucle, así que un runtime desactualizado puede no cargar el modelo. Para otros runtimes, vea alternativas a llama.cpp. Los 280 tokens por segundo que lista Artificial Analysis son una medición alojada, no lo que hará un portátil.
¿Merece la pena usar Inkling 2 Mini para soporte?
Merece la pena probarlo como motor, no como agente. Un agente de soporte es un modelo más su documentación, sus herramientas, sus reglas de traspaso y una forma de comprobarlo antes de que los clientes lo vean. La propuesta de Mini (barato, rápido, fuerte con herramientas) se ajusta a las partes intensivas en herramientas, y su debilidad (datos incorrectos afirmados con confianza) es la parte que no puede dejar sin supervisión. Una alucinación en una respuesta de reembolso cuesta mucho más que los tokens que ahorró.
Por eso eesel trata el modelo como intercambiable. Un compañero de IA para el helpdesk se une a su cola existente, aprende de su centro de ayuda y de tickets pasados, y se simula contra tickets históricos antes de salir en vivo, así que un motor nuevo se juzga con sus propias preguntas, no con la tabla de un laboratorio. SamCart es un buen ejemplo de esta configuración. Ejecuta un agente en los tickets de Freshdesk y otro en el chat de su web, ambos respondiendo desde unos 280 artículos del centro de ayuda. En los tickets, el agente responde solo hasta que un compañero toma el relevo, y una solicitud de hablar con una persona termina su turno. Nada de eso depende de qué modelo haya debajo.
Si quiere probar Mini usted mismo, dele primero un trabajo acotado:
- Elija una tarea estrecha, como redactar respuestas a partir de un conjunto fijo de artículos.
- Limite la salida y los turnos, como recomienda la ficha del modelo, porque el ajuste mínimo de razonamiento no lo desactiva por completo.
- Reproduzca tickets pasados y compare con sus respuestas humanas, como en pruebas de simulación de agentes de soporte con IA y pruebas de agentes de soporte con IA.
- Limite lo que puede hacer, usando las ideas de permisos de agentes de soporte con IA.
- Vigílelo después del lanzamiento, con los trazos descritos en observabilidad de agentes de soporte con IA.
Para una lista más amplia, mejores modelos de IA para tickets de soporte y mejores agentes de IA de atención al cliente comparan modelos y productos en pruebas específicas de soporte, y la guía de agente de IA para Freshdesk muestra cómo es una opción nativa de helpdesk.
¿Quiere un modelo que pueda cambiar sin reconstruir su configuración de soporte? Prueba eesel: funciona como una nueva incorporación que se conecta a su helpdesk en minutos, ya conoce su centro de ayuda y se prueba con sus tickets pasados antes de hablar con un cliente.
¿Qué más deberías leer?
¿Sigues la familia Inkling? Estas son las lecturas más cercanas:
- La reseña de Inkling 2 Small, la comparación más cercana a este artículo.
- La reseña de Inkling-Small y la reseña de Inkling para la primera generación.
- Alternativas a Inkling-Small si está eligiendo entre modelos pequeños abiertos.
- Entradas del glosario sobre modelos de lenguaje grandes, fine-tuning, agentes de IA y RAG.