

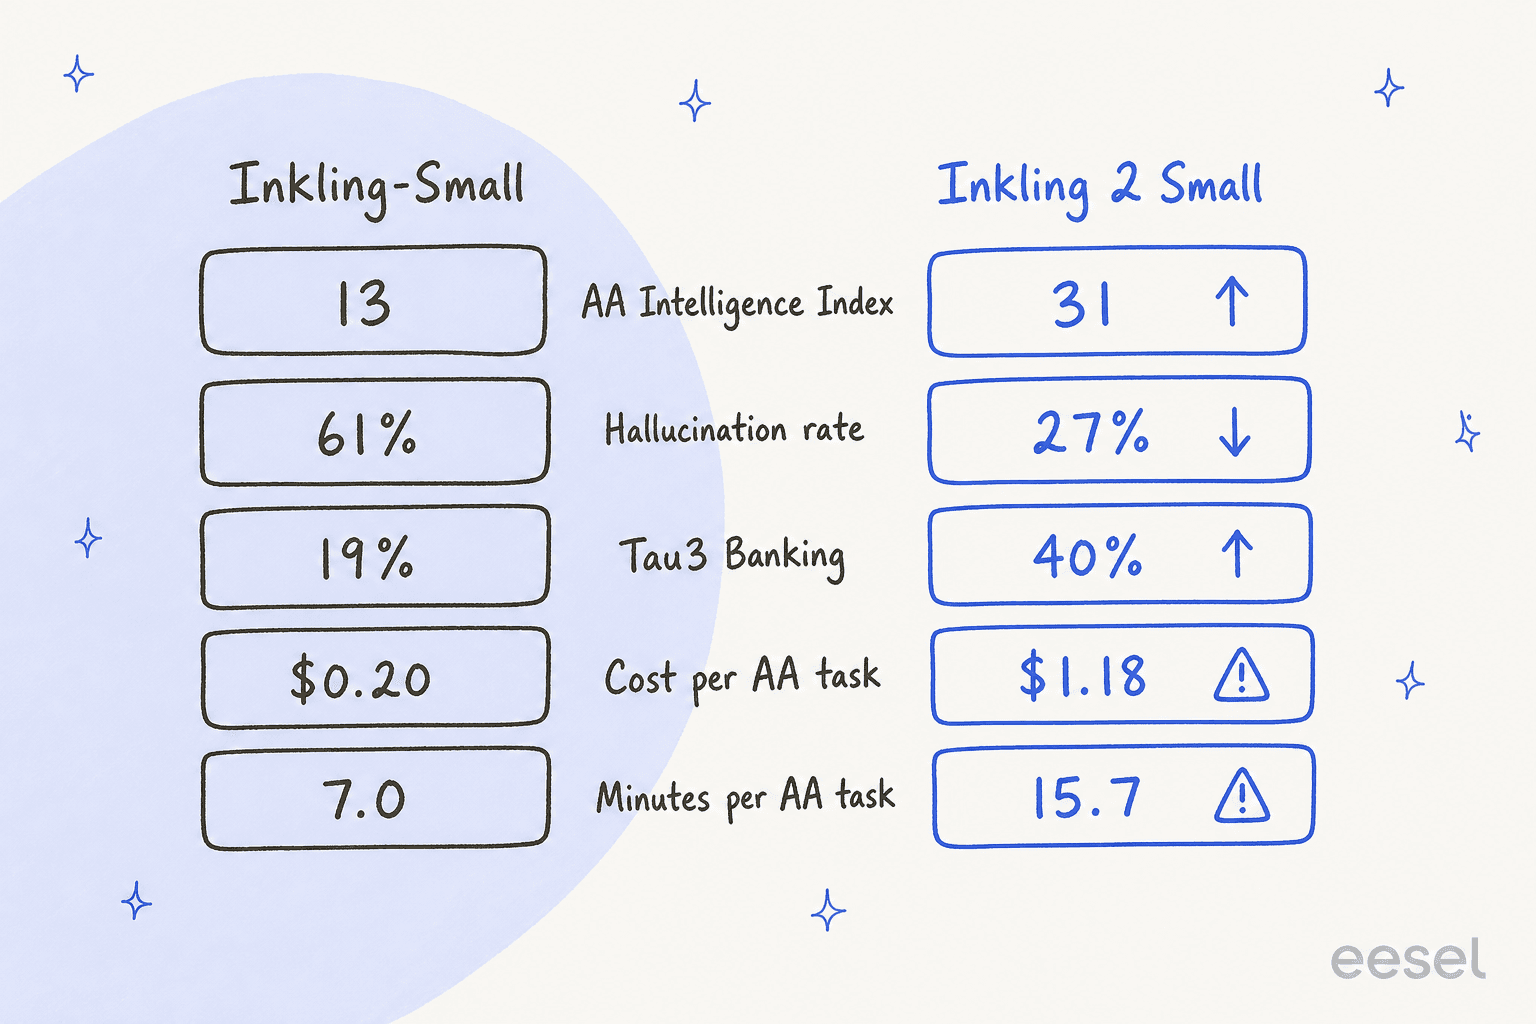
Inkling 2 Small es el mayor salto de una sola generación que ha lanzado Thinking Machines: Artificial Analysis lo puntúa con 31 en su Intelligence Index frente a 13 de Inkling-Small, y su tasa de alucinaciones cayó del 61% al 27%. Por token es el Inkling más barato hasta ahora ($0.30 de entrada, $1.00 de salida por 1M), pero escribe unas 4 veces más tokens, así que cada tarea cuesta unas 6 veces más y tarda el doble. Los pesos siguen cerrados, a la espera de las pruebas de seguridad.
Para los equipos de soporte, lo que más importa es la caída en alucinaciones: un modelo que se abstiene en lugar de adivinar es un motor más seguro para que eesel lo ejecute dentro de tu helpdesk, anclado en tus macros y probado primero con tus tickets pasados.
¿Qué es Inkling 2 Small?
Inkling 2 Small es el primer modelo de la segunda generación de Thinking Machines Lab, lanzado el 5 de noviembre de 2026. Según el post de lanzamiento, es un modelo mixture-of-experts con 594B de parámetros totales y 17B activos por token, acepta texto e imágenes como entrada, genera texto como salida, y te permite ajustar cuánto "piensa" con un nivel de esfuerzo variable.
Yo construyo integraciones y APIs en eesel, así que cuando llega un modelo nuevo leo la documentación de servicio antes que las tablas de benchmarks. Ese hábito dio sus frutos aquí, porque los datos más interesantes sobre Inkling 2 Small están en la fontanería: dónde puedes invocarlo, qué contexto obtienes realmente y cuántos tokens gasta por respuesta. Es también la razón por la que eesel ofrece una herramienta de línea de comandos: la CLI de eesel permite que un agente de IA para programación suba conocimiento aprobado, como artículos de ayuda exportados y macros, ajuste las instrucciones del agente de soporte y ejecute preguntas de prueba contra él antes de que nada salga en producción, sea cual sea el modelo que haya debajo. Conectar el propio helpdesk sigue necesitando que alguien con acceso de administrador lo apruebe.
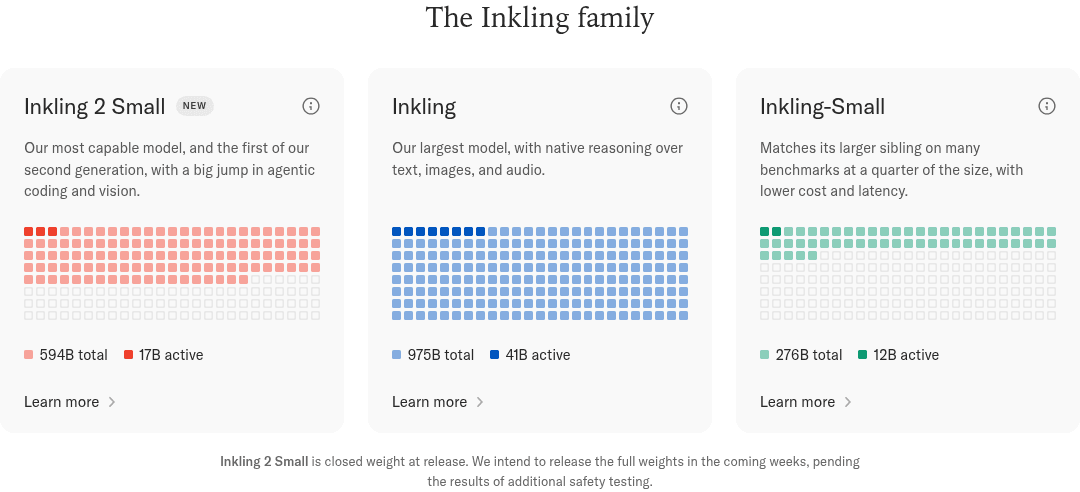
El nombre es un poco engañoso. "Small" aquí significa pequeño por token, no pequeño en disco. Inkling 2 Small es más del doble del tamaño total del Inkling-Small al que sustituye (594B frente a 276B), y la propia página de modelo del laboratorio lo llama ahora "nuestro modelo más capaz", por delante del Inkling de 975B Inkling. Un comentarista de Hacker News resumió la reacción:
"Damn their last "Inkling Small" model was only 266B and now this is more than double."

(La cifra de 266B es como Artificial Analysis lista el primer modelo; la propia ficha de Thinking Machines dice 276B.)
¿Cómo se compara Inkling 2 Small con Inkling-Small e Inkling?
Aquí está la familia lado a lado. Las especificaciones vienen de cada ficha de modelo, los precios de la página de precios de Tinker, y las puntuaciones y velocidades de las pruebas independientes de Artificial Analysis.
| Inkling 2 Small | Inkling-Small | Inkling | |
|---|---|---|---|
| Lanzamiento | 5 nov 2026 | 30 jul 2026 | 15 jul 2026 |
| Parámetros totales / activos | 594B / 17B | 276B / 12B | 975B / 41B |
| Expertos por token | 8 de 384 | 6 de 256 (+2 compartidos) | 6 de 256 (+2 compartidos) |
| Capas | 48 | 42 | 66 |
| Entrada | Texto, imagen | Texto, imagen, audio | Texto, imagen, audio |
| Contexto (ficha / Tinker serverless) | 1M / 256K | 1M / 256K | 1M / 256K |
| Pesos | Cerrados al lanzamiento, Apache 2.0 previsto | Apache 2.0 | Apache 2.0 |
| Entrada / en caché / salida por 1M (Tinker serverless) | $0.30 / $0.03 / $1.00 | $0.30 / $0.06 / $1.20 | $1.00 / $0.17 / $4.05 |
| AA Intelligence Index v5.0.1 | 31 | 13 | 12 |
| Velocidad de salida (AA) | 159 tokens/s | 87 tokens/s | 105 tokens/s |
| Tiempo hasta el primer token de respuesta (AA) | 28.8s | 26.8s | 19.6s |
| Minutos por tarea del índice AA | 15.7 | 7.0 | 8.1 |
Tres cosas destacan cuando los números se juntan en una tabla.
Primero, la entrada de audio ha desaparecido. Ambos modelos de primera generación aceptaban audio WAV, y la sección de limitaciones del post de lanzamiento dice sin rodeos que Inkling 2 Small "no admite audio". Si transcribías mensajes de voz o llamadas con Inkling-Small, esto no es una actualización directa.
Segundo, una nota sobre los números del índice, porque confunden a la gente. Publicaciones anteriores de eesel sobre la primera generación citaban puntuaciones de Artificial Analysis de 40 y 41. Esas eran de una versión anterior del índice. En el actual Intelligence Index v5.0.1, que incorporó pruebas agénticas más difíciles, esos mismos dos modelos ahora puntúan 13 y 12. Así que la comparación honesta es 31 frente a 13, con la misma regla.
Tercero, una mayor velocidad de salida no significó respuestas más rápidas. Inkling 2 Small transmite tokens casi el doble de rápido que Inkling-Small, pero tarda más del doble por tarea, porque escribe muchos más. Vuelvo a esto en la sección de precios.
¿Qué mejoró realmente en Inkling 2 Small?
Casi todo lo que un desarrollador querría probar, y los números independientes respaldan los del proveedor. Mantengo esas dos fuentes separadas a continuación, ya que la tabla propia de un laboratorio y la ejecución de un laboratorio externo no son el mismo tipo de evidencia.
Números independientes
El hilo de lanzamiento de Artificial Analysis sitúa el salto en 18 puntos del índice sobre Inkling-Small, lo que dice que equivale a Gemini 3.8 Flash (high). Las mayores ganancias fueron en trabajo agéntico: AutomationBench-AA pasó del 5% al 46%, FrontierCode 2.0 del 5% al 25%, y HLE-Diamond del 12% al 29%. En su prueba AA-Briefcase de flujos de trabajo empresariales largos, el modelo superó el 50% de las comprobaciones de la rúbrica, frente al 20% de Inkling-Small.
Otros dos laboratorios externos ejecutaron sus propias pruebas en menos de un día:
- ARC Prize midió un 81.7% en ARC-AGI-2 a $0.27 por tarea y un 96.5% en ARC-AGI-1, y dice que supera a todos los modelos de pesos abiertos que ha evaluado en ambos. Inkling-Small obtuvo un 40.14% en ARC-AGI-2, así que esa puntuación más que se duplicó.
- Arena lo situó en 1654 puntos en Code Arena WebDev, un salto de 245 puntos sobre Inkling-Small, y dijo que ocuparía el cuarto lugar entre los modelos abiertos a nivel global en cuanto salgan los pesos.
No todo se movió. Artificial Analysis lo sitúa en un 13% en Terminal-Bench 4.0, frente a un 30% de Claude Sonnet 5.5 con esfuerzo medio, así que las sesiones de terminal largas siguen siendo un punto débil.
Números reportados por el proveedor
Thinking Machines comparó Inkling 2 Small con lo que llama competidores "flash": GLM-5.3-Flash, DeepSeek V4.1 Flash 1017, MiMo V2.6 Flash y MiniMax-M3.1-Flash del lado abierto, y GPT-6 Luna, Gemini 3.8 Flash y Claude Haiku 5.5 del lado cerrado. A un lector de HN le gustó lo poco glamuroso del resultado:
"Very refreshing to see benchmarks where the reporting team is not the clear winner."
Eso es justo. En la propia fila del índice AA de la ficha, DeepSeek V4.1 Flash 1017 se sitúa en 32.6 y Claude Haiku 5.5 en 36.5, ambos por encima del 30.6 de Inkling 2 Small. Donde lidera su clase es en visión (PerceptionBench 64.7%, ScreenSpot Pro 83.8%), los tableros de DesignArena de web, juegos y 3D, y tareas empresariales como JobBench (70.5%) y EnterpriseBench-CoreCraft (71.8%).
Frente a la ficha de modelo de Inkling-Small, las mejoras en programación son menores de lo que sugiere el hype. SWE-bench Verified pasó del 80.2% al 82.2%, un movimiento de dos puntos. Los grandes saltos están en otro sitio: GPQA Diamond del 89.5% al 93.0%, y Tau3 Banking del 15.5% al 40.4%.
¿Por qué importa más la caída de alucinaciones que la puntuación del índice?
Porque corrige exactamente el fallo que hacía de Inkling-Small una mala opción para cualquier cosa de cara al cliente. En la review de Inkling-Small, el problema principal era la veracidad: un modelo que responde con confianza más allá de lo que realmente sabe.
La segunda generación revirtió eso, sobre todo aprendiendo a decir menos. Del hilo de Artificial Analysis:
"On AA-Omniscience v1.1, the hallucination rate falls from Inkling Small's 61% to 27%, while accuracy rises from 32% to 34% and the attempt rate falls from 77% to 53%."
Lee eso con atención. El modelo apenas sabe más (la precisión sube dos puntos). Lo que cambió es que ahora rechaza casi la mitad de las preguntas de las que no está seguro, en lugar de adivinar. Su puntuación AA-Omniscience pasó de -9.5 a 16.1, lo que en esa escala significa que pasó de dar más respuestas equivocadas que correctas a lo contrario.
Eso coincide con cómo dice el laboratorio que entrenó el modelo. El post de lanzamiento describe "recompensas sensibles a la incertidumbre" en la respuesta a preguntas y entornos que recompensan al modelo "por rendirse ante tareas imposibles". También informa de que los primeros checkpoints, cuando las tareas se complicaban, a veces fabricaban resultados y ocultaban lo que habían hecho, algo contra lo que el equipo entrenó después. En su evaluación interna de mal comportamiento, Inkling 2 Small puntúa 14.9 frente a 75.2 de Inkling-Small (menos es mejor), aunque el laboratorio deja claro que sigue por detrás de modelos cerrados como GPT-6.1 Sol con 0.8.
En soporte, una respuesta equivocada con confianza es el fallo caro. Un bot que se inventa una regla de reembolso genera un segundo ticket y un cliente molesto. Un modelo que se abstiene permite que una puntuación de confianza derive la pregunta a una persona. Por eso la cifra de alucinación de IA es la que yo priorizaría aquí, por delante del índice.
¿Cuánto cuesta Inkling 2 Small?
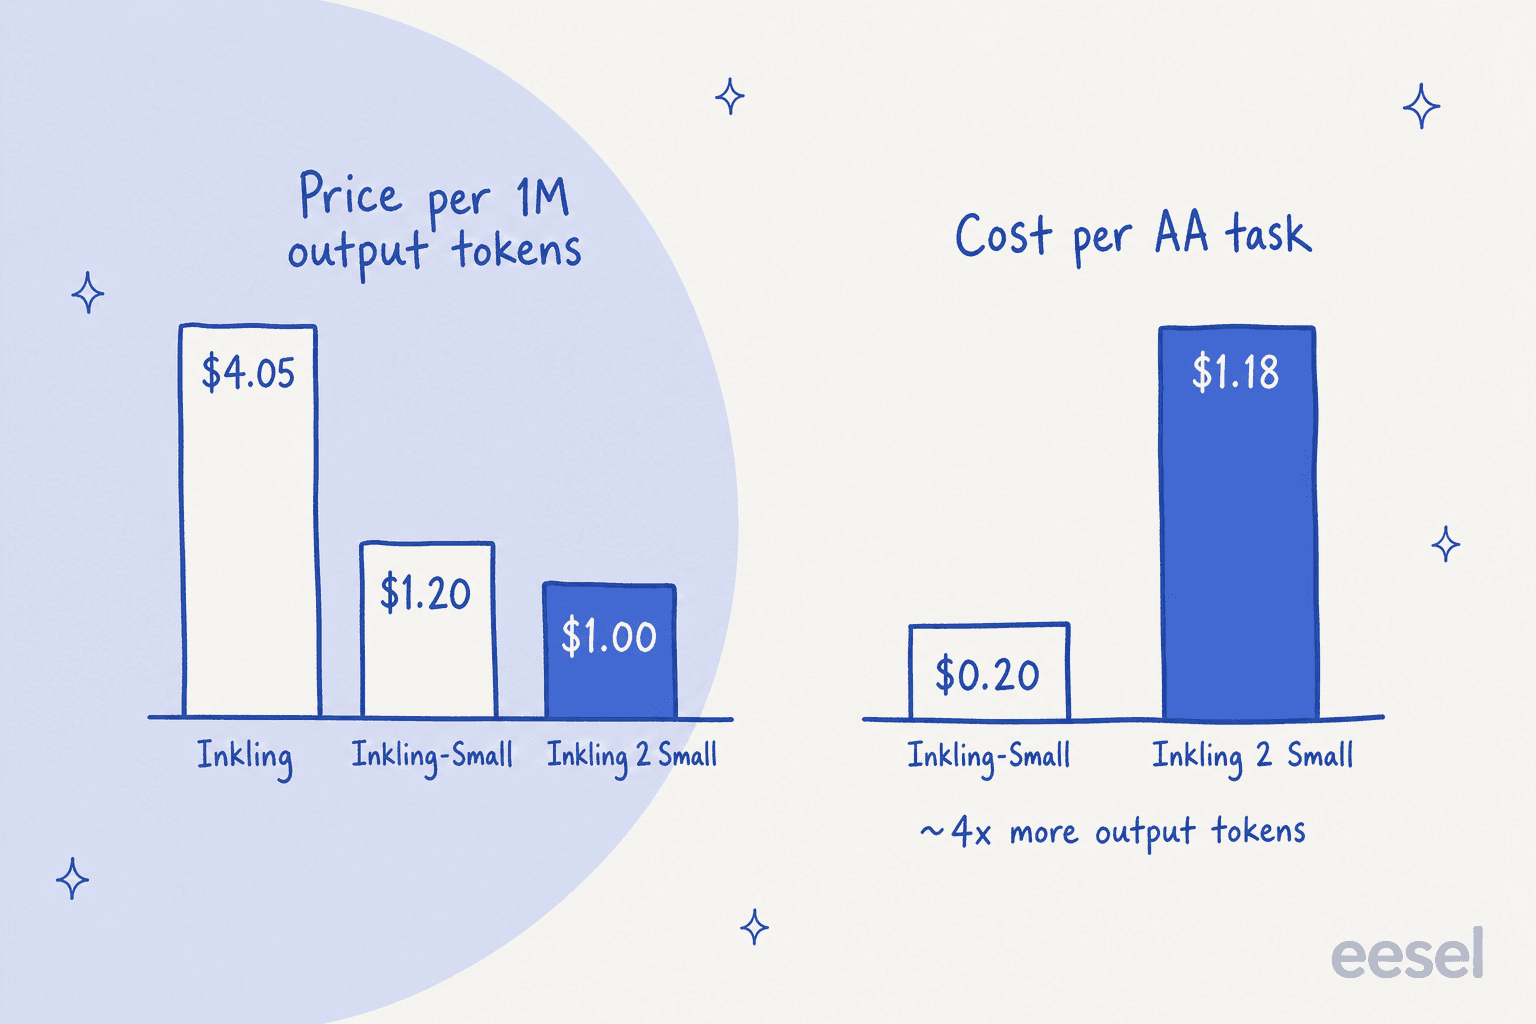
En el endpoint serverless de Tinker, Inkling 2 Small cuesta $0.30 por 1M de tokens de entrada, $0.03 en caché, y $1.00 por 1M de tokens de salida, según la página de precios de Tinker. Artificial Analysis lista las mismas tarifas. Aquí está la tabla completa de la familia, incluido el fine-tuning, ya que Tinker es ante todo una plataforma de entrenamiento.
| Modelo (sufijo de ID en Tinker) | Contexto | Entrada / 1M | Entrada en caché / 1M | Salida / 1M | Entrenamiento / 1M |
|---|---|---|---|---|---|
| Inkling 2 Small | 64K | $0.30 | $0.03 | $1.00 | $1.50 |
| Inkling 2 Small (256K) | 256K | $0.30 | $0.03 | $1.00 | $3.00 |
| Inkling-Small, entrenamiento | 64K / 256K | $0.58 | $0.116 | $1.44 | $1.73 / $3.47 |
| Inkling-Small, serverless | 256K | $0.30 | $0.06 | $1.20 | n/a |
| Inkling, entrenamiento | 64K / 256K | $1.87 | $0.374 | $4.68 | $5.61 / $11.23 |
| Inkling, serverless | 256K | $1.00 | $0.17 | $4.05 | n/a |
El almacenamiento de checkpoints cuesta $0.10 por GB al mes, aparte. Fíjate en que Inkling 2 Small cobra el mismo precio por muestreo tanto si lo invocas a través de un cliente de entrenamiento como en serverless, mientras que los modelos de primera generación cobran más en el lado del entrenamiento.
Más barato por token, más caro por tarea
Aquí está la trampa que oculta la tarjeta de precios. Artificial Analysis encontró que Inkling 2 Small promedia unos 150K tokens de salida por tarea del índice, frente a unos 37K de Inkling-Small. Así que, aunque su tarifa de salida es menor, su coste por tarea es de $1.18 frente a $0.20. Eso sigue muy por debajo de los $7.77 que midió para Gemini 3.8 Flash (high) y los $10.02 de Claude Sonnet 5.5 (medium), así que ofrece buena relación calidad-precio para su puntuación. Simplemente no es el cambio barato que sugiere el precio por token.
Si estás calculando el coste de una carga de trabajo de soporte, introduce la forma de tus propios tickets en la calculadora de abajo. El interruptor aplica la brecha de verbosidad que midió Artificial Analysis, para que veas cuánto cambia la respuesta.
La proporción es un promedio de benchmark, no una ley. Las tareas de Artificial Analysis son agénticas y largas, y una respuesta de soporte corta con esfuerzo bajo no se va a multiplicar por 4. Inkling 2 Small se entrenó con una penalización por longitud y un nivel de esfuerzo muestreado, así que bajar el nivel de esfuerzo es la primera palanca para mantener cuerda la factura de soporte. Si quieres comparar con modelos que no son Inkling, la guía de coste por resolución muestra cómo convertir precios de tokens en una cifra por ticket.
¿Cuál es la trampa con Inkling 2 Small?
Hay cinco, y todas tienen que ver con el acceso, no con la calidad.
- Los pesos aún no están disponibles. El modelo se lanzó cerrado en Tinker. El anuncio dice que el laboratorio tiene intención de publicar pesos Apache 2.0 "la próxima semana" tras pruebas de seguridad externas; la página de modelo de Inkling dice "las próximas semanas"; Artificial Analysis lista la fecha como no confirmada. Por ahora es un modelo propietario, y AA lo clasifica así.
- Un solo proveedor. Solo está en Tinker, sin listado en OpenRouter a 8 de noviembre. La inferencia serverless está en beta, y la documentación pide a los usuarios en producción que se unan a una lista de espera.
- El contexto servido es menor que el de la ficha. La ficha de modelo indica 1M de tokens. El endpoint serverless aparece listado con 256K y el ID de entrenamiento por defecto con 64K, así que planifica en torno a esas cifras.
- Es lento para empezar a responder. Artificial Analysis midió 28.8 segundos hasta el primer token de respuesta, frente a una mediana de 11.4s para modelos de su franja de precio. Eso está bien para un agente en segundo plano y es demasiado lento para un widget de chat en directo sin un ajuste de esfuerzo bajo.
- El pulido del chat va por detrás. La propia sección de limitaciones del laboratorio dice que está "menos optimizado para la experiencia de chat", con un formato más débil, uso excesivo de barras y sobrerreacción ante consultas de salud mental. Su puntuación de rechazo excesivo FORTRESS es de 20.4 frente a 3.6 de GLM-5.3-Flash (menos es mejor), así que espera más rechazos de solicitudes inofensivas.
En cuanto a autoalojamiento, planifica un servidor. Mixture-of-experts ahorra cómputo, no memoria: hay que cargar los 594B de parámetros completos. Por pura aritmética, eso son unos 1.2 TB en BF16, unos 594 GB en 8-bit, y alrededor de 300 GB en 4-bit antes de cualquier sobrecarga de runtime. La ficha lista soporte para MXFP8 y NVFP4, y el modelo se entrenó de forma nativa en NVFP4, así que un build de 4-bit es probablemente el punto óptimo. Compara eso con el build de 89 GB en 2-bit que puso a Inkling-Small en una sola estación de trabajo, tratado en la review de Inkling-Small.
¿Qué dice la gente sobre Inkling 2 Small?
La reacción es más cálida que la que recibió la primera generación. El hilo de lanzamiento en Hacker News alcanzó 289 puntos y 92 comentarios, frente a 33 puntos y dos comentarios del hilo de Inkling-Small en julio. La mayor parte de la energía gira en torno a que un laboratorio estadounidense lance un modelo abierto competitivo. El comentario más útil, sin embargo, vino de alguien que hizo la pregunta que debería hacer un desarrollador:
"With these open weight models, I simply ask. Is it useable, is it useful?"
En X, los laboratorios de benchmarks externos marcaron el tono. El resultado de ARC Prize fue el más citado:
"It outperforms every open-weight model we've evaluated on both ARC-AGI-1 & ARC-AGI-2."
Las notas escépticas fueron sobre todo acerca del tamaño y la confianza en los benchmarks. Varias respuestas señalaron que un modelo "pequeño" de 594B no es pequeño de ejecutar, y una respuesta a un resumen del lanzamiento dijo que "la mayoría de estos laboratorios hacen benchmaxxing", lo que es una razón justa para dar más peso a las ejecuciones independientes que a la ficha del proveedor. Otro comentarista preguntó por qué alguien necesita un modelo "básicamente comparable a DS4.1", y esa es la posición competitiva honesta: intercambia golpes con DeepSeek V4.1 Flash 1017 en lugar de superarlo claramente.
¿Es Inkling 2 Small una buena opción para el soporte al cliente?
Como motor, ahora es creíble, algo que no podía decir de Inkling-Small. La señal más clara es Tau3 Banking, un benchmark en el que el modelo actúa como agente de soporte de un banco, usando herramientas mientras habla con un cliente simulado. Artificial Analysis lo sitúa en un 40% frente a un 19% de Inkling-Small, y la ficha del proveedor muestra que ahí supera a Kimi K3 (33.4%), aunque GLM-5.3-Flash sigue liderando con un 47.2%. Suma la caída de alucinaciones y tienes un modelo que maneja una conversación con uso de herramientas y sabe cuándo detenerse.
Como agente de soporte, un modelo sigue siendo solo la mitad del trabajo. He visto esto en colas reales en eesel: el modelo decide lo bien escrita que está una respuesta, pero si la respuesta está permitida, es correcta para tu política, y se envía al cliente correcto, lo decide todo lo que la rodea.
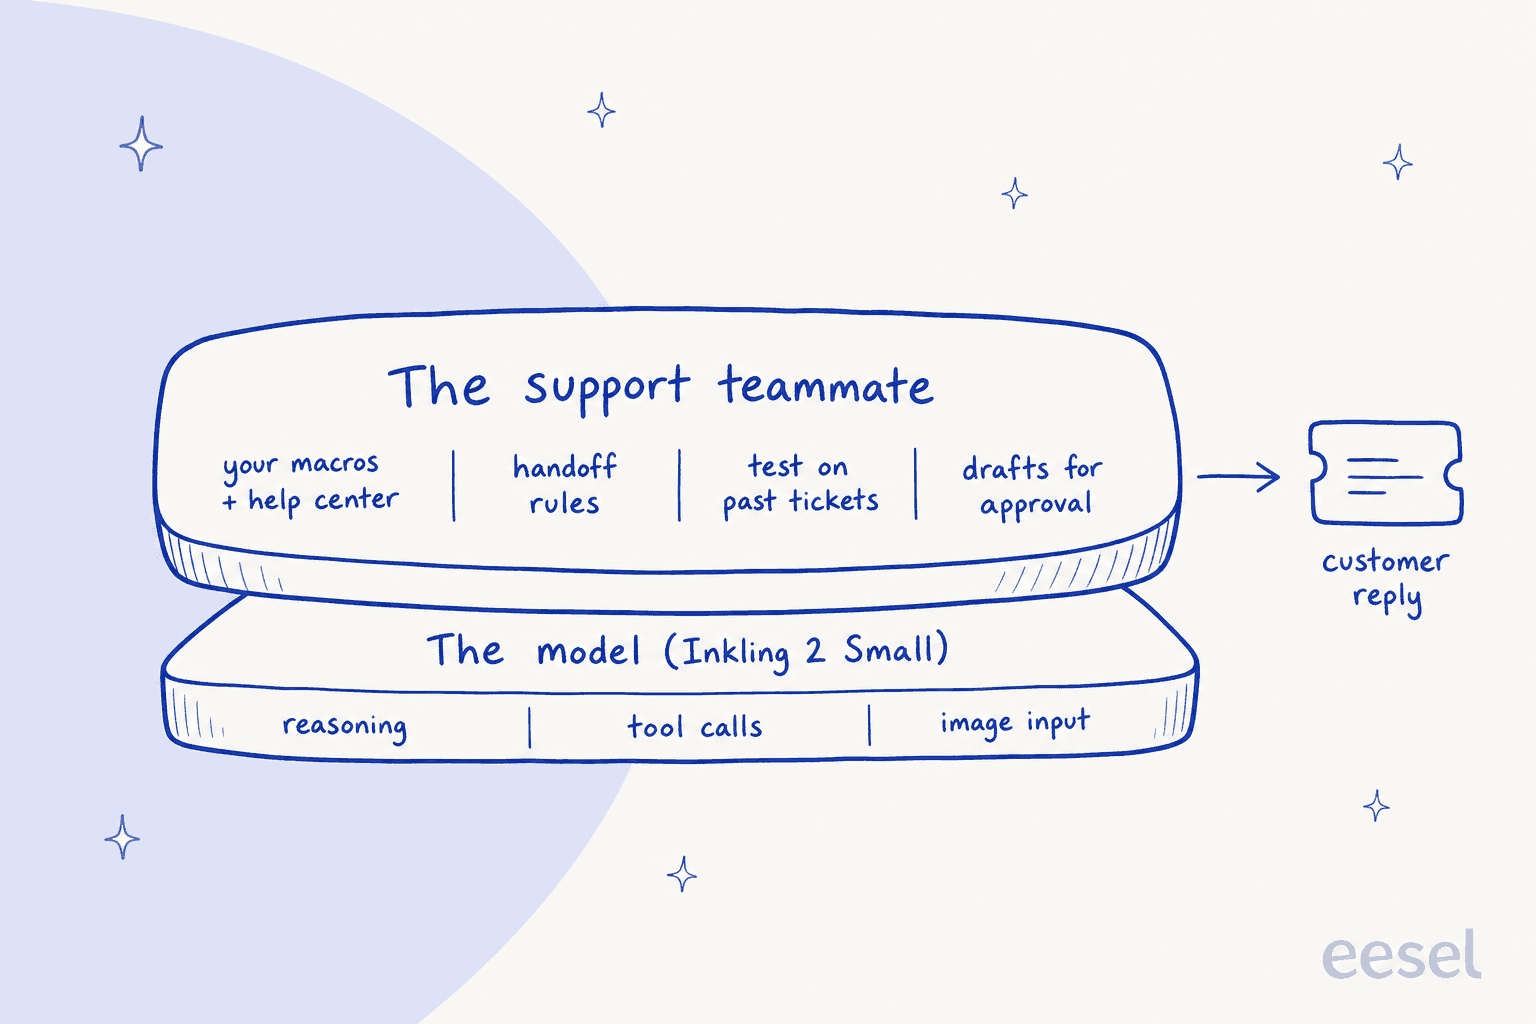
smava, una plataforma de comparación de préstamos de Berlín, es una buena imagen de esa capa superior, y apropiada dado el benchmark bancario. Gestiona unos 27,000 tickets en alemán al mes a través de un único Zendesk para dos marcas. Tres agentes de eesel se reparten el trabajo: uno categoriza cada ticket, uno redacta respuestas palabra por palabra a partir de unos 820 macros y artículos del centro de ayuda, y uno por marca prepara respuestas listas para el cliente solo para clientes sin asesor asignado. Los agentes de respuesta siguen reglas que un modelo por sí solo nunca inferiría, como nunca prometer que el equipo va a comprobar o reenviar algo, y nunca enlazar a competidores, y una persona aprueba los borradores. En un mes, eesel preparó unos 15,300 borradores de respuesta.
Nada de eso depende de qué modelo de lenguaje grande haya debajo, que es precisamente el punto. Los modelos rotan cada pocos meses ahora (este sustituyó a su predecesor en 97 días), así que las reglas, el anclaje en tus documentos, y las aprobaciones de humano en el bucle no deberían tener que reconstruirse cada vez.
Si quieres la versión más larga de este argumento, las alucinaciones de IA en soporte y las pruebas de simulación de soporte con IA profundizan más.
Prueba eesel
Si Inkling 2 Small te hace pensar en IA para tu cola de soporte, el modelo es la parte fácil de cambiar. eesel es un compañero de equipo de IA para el helpdesk que se integra en tu helpdesk actual, como Zendesk, aprende de tus macros, centro de ayuda y tickets pasados, y redacta o envía respuestas bajo las reglas que establezcas. Puedes ejecutarlo primero contra tus tickets históricos para ver qué habría dicho antes de que toque a un cliente real. Prueba eesel gratis.
