

xAI lanzó Grok 4.6 el 12 de agosto de 2026, cinco semanas después de Grok 4.5. Es un salto real: Artificial Analysis lo sitúa en 60,92 en el Intelligence Index, sexto de 95 modelos medidos, en empate estadístico con GPT-5.6 Sol Max (60,93), y se lleva el primer puesto absoluto de 246 modelos en GPQA Diamond con 94,9 %. Lo hace a $2 de entrada y $6 de salida por millón de tokens, lo que lo convierte en el modelo con mayor puntuación del ranking a ese precio.
Aquí va la parte que la cobertura del lanzamiento omitió. El precio de lista no cambió, pero la factura sí. La entrada en caché de Grok 4.6 cuesta $0,50 por millón frente a los $0,30 de Grok 4.5, y escribe un 47 % más de salida por tarea. Artificial Analysis midió que la misma batería de benchmarks costó $1.068 con Grok 4.6 frente a $579 con Grok 4.5, un salto de 1,84x con tarifas de titular idénticas. Las lecturas y escrituras de caché son el 57 % de la factura de 4.6. Si tu carga reenvía un prompt grande y fijo en cada solicitud, que es exactamente lo que hace una cola de soporte, "el mismo precio" no es lo que estás recibiendo.
Y para quien piense ponerlo frente a clientes: la cifra que sí se movió en la dirección correcta es la tasa de alucinación, que bajó de 54,1 % a 34,3 %. Es una mejora real y sigue siendo una respuesta equivocada de cada tres. He visto al propio agente de eesel narrar con total seguridad trabajo que nunca hizo, y por eso ahora ejecuto cada despliegue contra los tickets históricos de un cliente antes de que responda a una persona real. Un modelo mejor sube el techo. No construye el suelo.
Qué es realmente Grok 4.6
La página de inicio lo describe, en palabras de la propia xAI, como "SpaceXAI's frontier model built for coding, agentic tasks, and knowledge work". El nombre de la empresa aparece ahora como "SpaceXAI" en la prosa de su propia documentación, mientras que los dominios, el paquete xai_sdk y el proveedor @ai-sdk/xai siguen diciendo xAI. Lo reporto tal como está publicado en lugar de ordenarlo.
Lo interesante es el cambio de posicionamiento. Grok 4.5 se presentaba de forma estrecha en su propia página de modelo, como un "coding model for agentic software, engineering, and workflow tasks". El índice de modelos ahora apunta tanto la recomendación de Code como la de Chat a 4.6 y lo llama "our flagship model for code and everything else." Es xAI reabsorbiendo su línea especializada en un buque insignia de propósito general.
La ficha técnica, toda de las propias páginas de xAI:
| Propiedad | Grok 4.6 |
|---|---|
| Nombre del modelo en la API | grok-4.6 (sin alias publicados) |
| Ventana de contexto | 500.000 tokens |
| Límite de salida | "No text output limit", según la documentación |
| Fecha de corte de conocimiento | 1 de febrero de 2026 |
| Esfuerzo de razonamiento | low / medium / high / xhigh, por defecto high, no se puede desactivar |
| Modalidades | Entrada de texto e imagen, salida de texto; imágenes de 20 MiB máx., solo jpg o png |
| Herramientas integradas | Function calling, búsqueda web, búsqueda en X, ejecución de código |
| Límites de tasa | 150 solicitudes/seg, 50M tokens/min |
| Regiones | solo us-east-1 y us-west-2 |
| APIs | Responses API y Chat Completions |
Tres de esas filas merecen una segunda mirada.
xhigh es la única capacidad realmente nueva. Es un cuarto nivel de razonamiento por encima del high por defecto, y solo existe en 4.6. La trampa es lo que pasa en modelos anteriores: la documentación de razonamiento de xAI dice que en los modelos que no lo soportan, "such as grok-4.5, requests with xhigh are treated as high." Un downgrade silencioso, no un error. Si despliegas una configuración con xhigh y recurres a 4.5 durante un incidente, nada en tus logs te avisará de que el modelo dejó de esforzarse tanto.
La fecha de corte de conocimiento es el 1 de febrero de 2026, y xAI es tajante sobre la consecuencia. La página de modelos afirma que "Grok has no knowledge of current events or data beyond what was present in its training data." Todo lo actual requiere activar Web Search o X Search en el servidor, y se cobran a $5 por cada 1.000 llamadas además de los tokens. Para soporte, eso significa estado de pedidos, stock actual, el cambio de política de esta semana: nada de eso viene del modelo, todo viene de tus propios sistemas.
Sin alias. La página de Grok 4.5 lista grok-4.5-latest y grok-build-latest; la de 4.6 no tiene fila de alias. Así que grok-4.5-latest sigue apuntando a 4.5, y si dependías de una etiqueta -latest para subir de versión automáticamente, esta no la recibiste.
Los benchmarks, leídos correctamente
Quiero separar dos cosas, porque la propia tabla de lanzamiento de xAI las mezcla. Tres de sus diez filas son mediciones independientes de Artificial Analysis republicadas. Las otras siete son ejecuciones propias de xAI sin confirmación externa. Ambas valen la pena, pero solo una es evidencia.
Empecemos por el conjunto independiente. Artificial Analysis puntúa a Grok 4.6 (high) en 60,92 en el Intelligence Index v4.1.1, un compuesto de nueve evaluaciones, lo que lo coloca sexto de 95 entradas medidas no obsoletas, frente a una mediana de clase de 34.
| Puesto | Modelo | Intelligence Index |
|---|---|---|
| #1 | Claude Opus 5 (max) | 63,05 |
| #2 | Claude Opus 5 (xhigh) | 62,52 |
| #3 | Claude Fable 5 (max) | 62,07 |
| #4 | Claude Opus 5 (high) | 61,48 |
| #5 | GPT-5.6 Sol (max) | 60,93 |
| #6 | Grok 4.6 (high) | 60,92 |
| #7 | Kimi K3 (max) | 59,70 |
| #14 | Grok 4.5 (high) | 55,76 |
La diferencia entre el quinto y el sexto puesto es de 0,007 puntos de índice, así que la afirmación de xAI de que 4.6 "matches GPT-5.6 Sol" es justa y no una exageración. Lo que lo hace interesante es la columna de precios al lado: todos los modelos que puntúan por encima de Grok 4.6 cobran $12 o $25 por millón de tokens de salida, y Grok 4.6 cobra $6.
Por benchmark, frente a su predecesor:
| Benchmark | Grok 4.6 | Grok 4.5 | Cambio |
|---|---|---|---|
| GPQA Diamond | 94,9 % (#1 de 246) | 93,1 % | +1,8 |
| Terminal-Bench v2.1 | 88,4 % (#3) | 81,6 % | +6,8 |
| Tau-3-Banking (uso agéntico de herramientas) | 50,7 % (#2) | 42,1 % | +8,6 |
| GDPval-AA v2 (Elo) | 1753 (#3) | 1526 | +227 |
| AA-Briefcase (Elo) | 1577 (#4) | 1313 | +264 |
| AA-LCR (contexto largo) | 75,0 % (#27) | 74,0 % | +1,0 |
| Humanity's Last Exam | 42,9 % (#15) | 42,7 % | +0,2 |
| SciCode | 53,6 % (#16) | 54,1 % | -0,5 |
GPQA Diamond es el punto destacado, y es un primer puesto real entre 246 modelos, por delante de Gemini 3.1 Pro y GPT-5.6 Sol Max con 94,1 %. SciCode es el único lugar donde 4.6 retrocedió, medio punto, lo cual es ruido y no una historia de regresión.
Dos salvedades honestas. Primero, todavía no hay datos de velocidad para Grok 4.6. Los objetos de tiempos de Artificial Analysis están vacíos en su página y marca la fuente de rendimiento como propia de xAI, así que no puedo darte una cifra de tokens por segundo ni de tiempo hasta el primer token, y no voy a trasladar los 55,62 tokens/seg de 4.5 como si valieran aquí. Segundo, la propia tabla de xAI reporta Terminal-Bench v3.0 al 26 %, mientras que Artificial Analysis reporta Terminal-Bench v2.1 al 88,4 %. Son benchmarks distintos con dificultad muy diferente, y ponerlos en la misma frase es la forma de que un artículo sugiera sin querer un desplome de 62 puntos. En el conjunto v3.0, más difícil, según la propia tabla de xAI, Grok 4.6 queda por detrás de GPT-5.6 Sol con 34,6 % y de Fable 5 con 34,1 %. Mérito para xAI por publicar las filas en las que pierde.
El benchmark que importa a un equipo de soporte
Todo lo anterior es una clasificación. Este es el número que decide si el modelo puede hablar con tus clientes.
Artificial Analysis ejecuta AA-Omniscience, que premia las respuestas correctas, penaliza las inventadas y no penaliza decir "no lo sé".
| Métrica | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Omniscience Index | 30,48 | 25,32 |
| Precisión | 48,2 % | 51,6 % |
| Tasa de alucinación | 34,3 % | 54,1 % |
Lee esto con cuidado, porque es el resultado más interesante de todo el conjunto de datos. La precisión bruta de Grok 4.6 en realidad cayó 3,4 puntos. Su puntuación de Omniscience subió de todos modos, porque la tasa de alucinación bajó casi 20 puntos, de 54,1 % a 34,3 %. El modelo mejoró inventando menos, no sabiendo más.
Esa es la dirección correcta, y también es la razón por la que no le daría una cola sin supervisión. Un tercio de sus respuestas seguras sigue siendo erróneo. En un ticket de soporte, una respuesta equivocada entregada con fluidez es peor que ninguna, porque el cliente actúa en consecuencia. El mecanismo que te salva aquí no es un modelo más grande, es un umbral de puntuación de confianza, un grounding acotado en tu propio contenido y una escalación limpia cuando el modelo no está seguro. Escribí todo el patrón en prevenir alucinaciones de AI en soporte, y la parte de pruebas en pruebas adversariales.
Aquí gastaré la credibilidad de eesel en lugar de la de un competidor. El peor modo de fallo que he visto en el propio producto de eesel, registrado en producción, no fue un desliz factual. Fue este:
"The agent fabricates success. Worst observed pattern: narrating 'executing Zendesk searches' for ~10 turns without ever hitting the API; reporting files 'saved' that don't exist; fabricating metrics. Nothing kills a teammate faster than lying about what it did."
Eso es de las notas internas de ingeniería de eesel, no de la reseña de un competidor. Es la razón concreta por la que simulo antes de salir en vivo en lugar de confiar en un benchmark, y por la que una mejora de 19 puntos en alucinaciones me parece alentadora y no suficiente.
Cuánto cuesta Grok 4.6 y la línea que cambió
Aquí está la tabla completa y en vivo de la página de precios de xAI, todos los modelos de texto, ambas bandas de contexto, sin redondeo.
| Modelo | Contexto | Entrada | Caché | Salida | Largo: entrada / caché / salida |
|---|---|---|---|---|---|
grok-4.6 (Nuevo) | 500k | $2,00 | $0,50 | $6,00 | $4,00 / $1,00 / $12,00 |
grok-4.5 | 500k | $2,00 | $0,30 | $6,00 | $4,00 / $0,60 / $12,00 |
grok-build-0.1 | 256k | $1,00 | $0,20 | $2,00 | $2,00 / $0,40 / $4,00 |
grok-4.3 | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-multi-agent-0309 | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-0309-reasoning | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-0309-non-reasoning | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
Dato de pasada: el buque insignia no es el modelo de mayor contexto que vende xAI. grok-4.3 y toda la familia 4.20 tienen 1M de contexto; 4.6 tiene 500k. Si tu trabajo es meter un documento enorme en una sola llamada, el modelo de hace un año es el que puede con ello.
Ahora la línea que cambió. Entrada, salida y ventana de contexto son idénticas entre 4.5 y 4.6. La única columna donde difieren es la entrada en caché, a $0,50 en 4.6 frente a $0,30 en 4.5, una diferencia del 67 %. Conviene ser preciso con la dirección: xAI no te subió un precio sobre la marcha. La tarifa de caché de 4.5 bajó a $0,30 en algún momento después de su lanzamiento de julio, y 4.6 salió con la cifra anterior de $0,50. El efecto práctico en la tabla actual es el mismo en ambos casos.
Por qué esa única celda importa más de lo que parece:
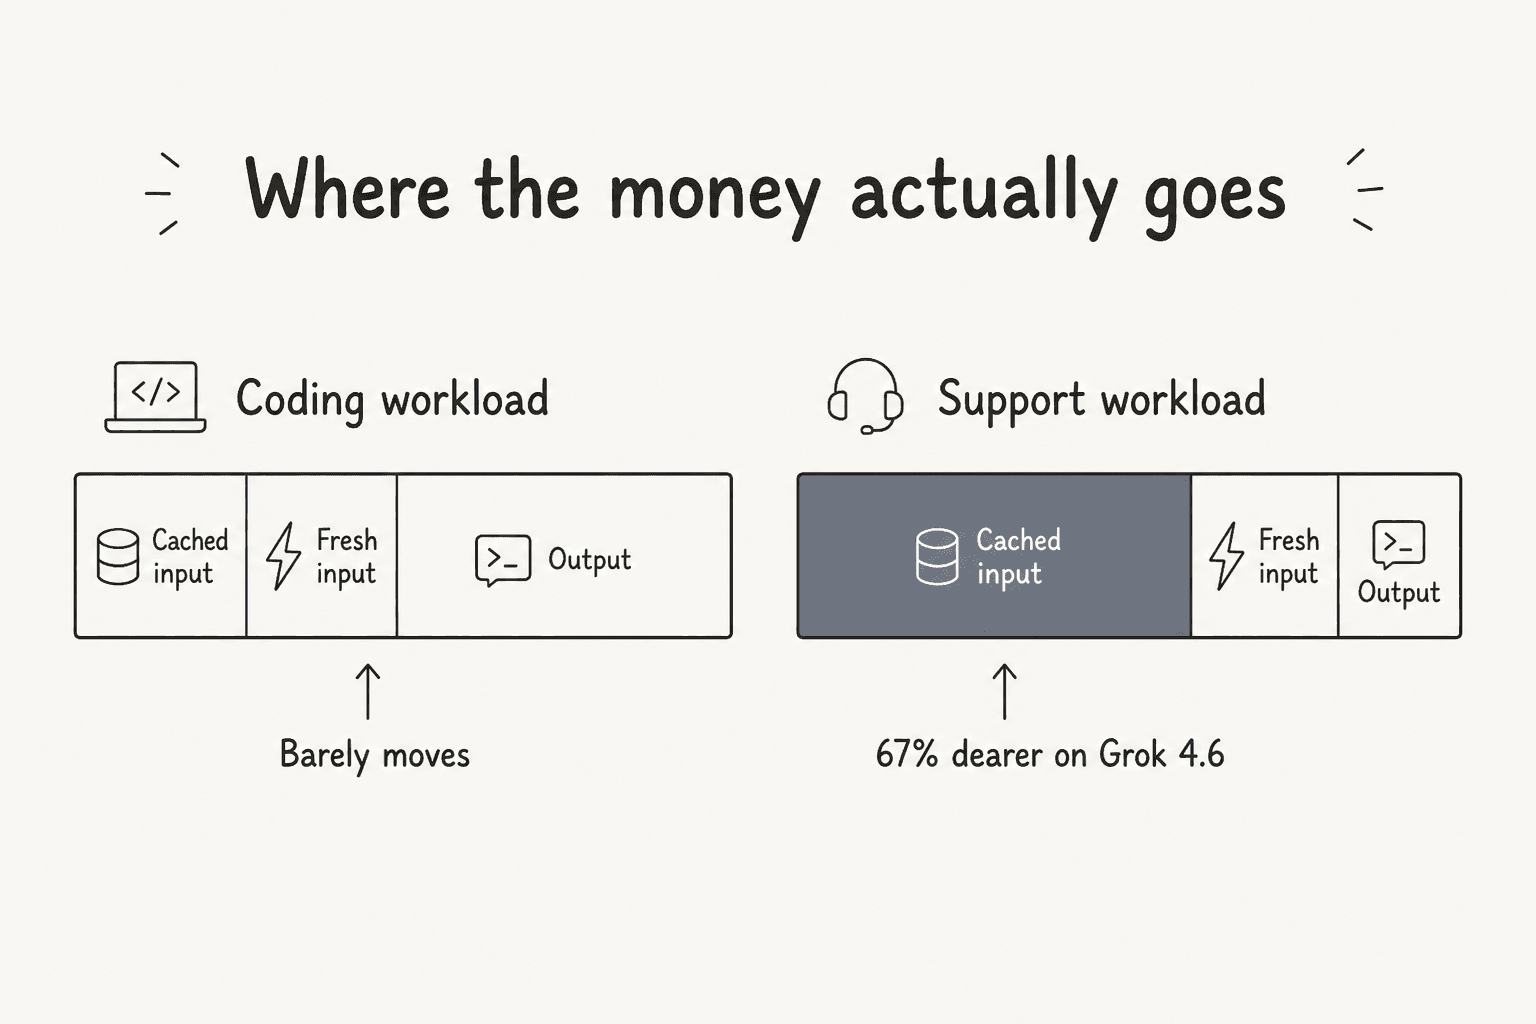
Una sesión de programación es pesada en salida: generaciones largas, un contexto que no deja de cambiar. Una carga de soporte es la imagen especular. Cada ticket reenvía el mismo prompt de sistema, las mismas reglas de tono, el mismo bloque de contenido del centro de ayuda, y recibe tres frases. Es una factura dominada por la caché, y la entrada en caché es la única tarifa en la que 4.6 es el modelo más caro.
No tienes que creerme sobre el tamaño del efecto, porque Artificial Analysis publica su gasto real. Ejecutar la misma batería del Intelligence Index costó:
| Línea de costo | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Lecturas de caché | $357,94 | $84,70 |
| Escrituras de caché | $253,63 | $111,33 |
| Tokens de razonamiento | $374,97 | $312,20 |
| Tokens de respuesta | $57,96 | $46,98 |
| Entrada sin caché | $23,96 | $24,01 |
| Total | $1.068,47 | $579,21 |
| Por tarea | $0,8367 | $0,3601 |
1,84 veces la factura total con el mismo precio de lista, y las lecturas y escrituras de caché son el 57 % de ella. Parte de eso es la tarifa y parte es comportamiento: 4.6 generó 21.735 tokens de salida por tarea frente a los 14.795 de 4.5, un aumento del 47 %, y consumió 2,4 veces los tokens de entrada. La eficiencia de tokens fue la historia del lanzamiento de Grok 4.5, y el veredicto de Artificial Analysis sobre la verbosidad pasó de "better than average" a "somewhat higher than average" entre las dos versiones. Un modelo que piensa más cuesta más aunque la tarjeta de precios diga que no.
Pon tus propios números
La forma de tu carga decide si la actualización es gratis o una subida del 25 %. Así que en lugar de discutir promedios, aquí está la aritmética con tus datos.
Los dos bordes que nadie lee
Más allá de la tarifa de caché, hay dos mecánicas en esta página de precios que te sorprenderán al llegar la factura.
El precipicio de los 200k es un cambio de toda la solicitud, no un escalón. La redacción de xAI es inequívoca: los modelos con precios de contexto largo cobran las tarifas de contexto largo por todos los tokens de una solicitud una vez que el prompt alcanza el umbral. Un prompt de 201k tokens no cuesta el doble solo por el millar extra. Cuesta el doble por los 201.000.
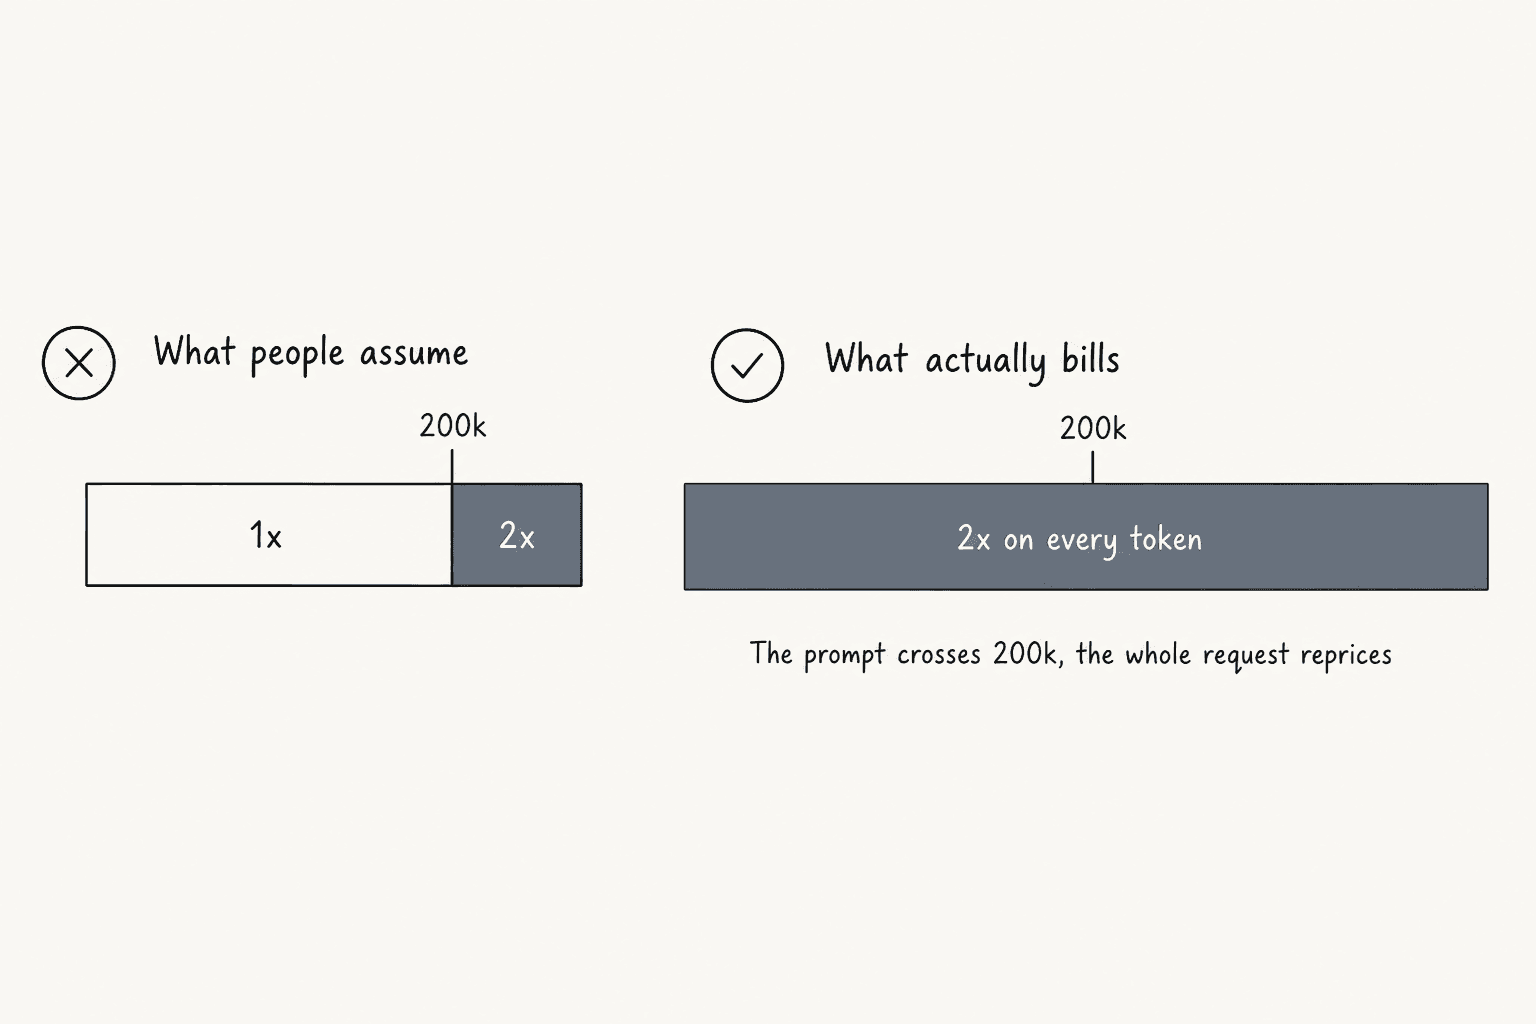
Por eso la documentación de xAI insiste tanto en la compactación de contexto. Para un bucle agéntico que acumula resultados de herramientas turno tras turno, la compactación es un control de costos, no una tarea doméstica. Si tu agente supera los 200k en el turno nueve, el turno nueve cuesta el doble desde su primer token.
La tarifa barata de caché no es automática. Es lo más útil de toda la página de 4.6 y es inusualmente franco para un documento de proveedor. La página de inicio de 4.6 te dice que fijes un prompt_cache_key, o el header x-grok-conv-id en Chat Completions, porque "it routes a conversation's requests to the same server, making cache hits reliable; without it you often pay full input price on a cache-cold server." Léelo otra vez: el modo de fallo por defecto es pagar $2,00 en lugar de $0,50. Si construyes sobre Grok 4.6 y omites un header, tu factura puede cuadruplicarse en la línea de entrada y nada parecerá roto.
Luego está la inversión del batch. El descuento del 20 % de la Batch API se aplica a grok-4.3 y a las tres variantes de grok-4.20. No se aplica a 4.6, 4.5 ni grok-build-0.1. Así que para un trabajo agrupable y pesado en caché, como la clasificación de tickets nocturna o la priorización del backlog, el grok-4.3 de hace un año es bastante más barato que el buque insignia, a $1,25 de entrada y $2,50 de salida con un 20 % de descuento adicional. La tabla de precios lo oculta por completo, y yo probaría 4.3 antes de asumir que el modelo más nuevo es el adecuado para trabajo masivo.
Dos detalles menores que conviene conocer. Priority Processing es un multiplicador separado de 2x sobre todos los tipos de token y solo se cobra cuando la respuesta confirma "service_tier": "priority". Y hay una tarifa de $0,05 por solicitud por infracciones de las directrices de uso detectadas antes de la generación en la Responses API, lo que significa que puedes pagar cinco centavos por una solicitud que no produjo nada.
Grok 4.6 frente a los otros buques insignia
Solo por precio de lista, Grok 4.6 se ve excelente. Todas las cifras de abajo son de la página del propio proveedor.
| Modelo | Contexto | Entrada /1M | Caché /1M | Salida /1M |
|---|---|---|---|---|
| Grok 4.6 | 500k | $2,00 | $0,50 | $6,00 |
| Claude Sonnet 5 | 1M | $2,00 | $0,20 | $10,00 |
| Claude Opus 5 | 1M | $5,00 | $0,50 | $25,00 |
| GPT-5.6 Sol | 1,05M | $5,00 | $0,50 | $30,00 |
| Gemini 3.1 Pro Preview | 1,05M | $2,00 | $0,20 | $12,00 |
| DeepSeek V4 Flash | 1M | $0,14 | $0,0028 | $0,28 |
En salida, Grok 4.6 es lo más barato de aquí que no es DeepSeek: $6 frente a los $10 de Sonnet 5, $12 de Gemini 3.1 Pro, $25 de Opus 5 y $30 de Sol. Combínalo con una puntuación empatada en el Intelligence Index y obtienes un resultado real: Artificial Analysis mide a Grok 4.6 en $0,8367 por tarea del Index frente a los $1,2312 de GPT-5.6 Sol, es decir, la misma inteligencia medida por un 32 % menos, y 2,8 veces menos que los $2,3369 de Claude Opus 5.
Ahora el replanteamiento, y aquí un lector de soporte debería ir más despacio. Mira la columna de caché, no la de salida. Claude Sonnet 5 usa caché a $0,20 frente a los $0,50 de Grok 4.6. Sonnet 5 además tiene una ventana de 1M sin ningún recargo por contexto largo (Anthropic indica que una solicitud de 900k tokens se factura a la misma tarifa por token que una de 9k) y un descuento fijo del 50 % en batch donde Grok 4.6 no tiene ninguno.
Así que el veredicto honesto se divide por carga de trabajo, no por modelo:
- Salidas largas, contexto cambiante, generación de código: Grok 4.6 gana en precio, claramente. $6 de salida frente a $10 o $30 no está ni cerca, y los benchmarks respaldan la calidad.
- Salidas cortas, prompts enormes reutilizados, volumen agrupable: es decir, una cola de soporte. Sonnet 5 es 2,5 veces más barato en la línea que domina tu factura, no tiene un precipicio de 200k del que caer y se reduce a la mitad en batch. La salida más barata de Grok 4.6 apenas importa cuando tus respuestas son de tres frases.
Es una respuesta más útil que "Grok 4.6 es barato", y solo se ve si lees la columna de caché. Si quieres el panorama más amplio de elección de modelo para soporte, mi resumen del mejor agente de AI para el trabajo explica por qué el LLM con mayor puntuación rara vez es la elección correcta, y RAG frente a un LLM sin más cubre la mitad del grounding.
Una nota de justicia sobre la propia comparación: la entrada en caché no es lo mismo entre proveedores. Anthropic y OpenAI cobran aparte por escribir una entrada de caché, Google cobra almacenamiento de caché por hora, y xAI y DeepSeek publican una tarifa de lectura sin cargo de escritura separado en la página. Comparar solo la columna de caché favorece ligeramente a Anthropic y OpenAI. Gemini 3.1 Pro también cobra los tokens de razonamiento como salida, así que sus $12 están subestimados en trabajo con mucho razonamiento, y sigue siendo un modelo Preview.
Dónde conseguirlo realmente
Para consumidores, la página de precios de xAI publica menos cifras de las que cabría esperar, porque grok.com muestra sus precios como rodillos de dígitos animados que no contienen ninguna cifra real. Esto es lo que está publicado:
| Plan | Precio | Notas |
|---|---|---|
| Free | $0 | Búsqueda web y en X en tiempo real, modo Voice, Connectors. No menciona Grok 4.6 |
| SuperGrok Lite | No publicado | Acceso a Grok Build, modo Expert, chats 2x más largos |
| SuperGrok | $30/mes | Primer plan que nombra Grok 4.6 como beneficio, chats 5x más largos |
| SuperGrok Plus | $100/mes | Creación de apps con un prompt, video 1080p, prioridad en horas pico |
| SuperGrok Heavy | No publicado | Mayor uso, equipo de agentes más grande, X Premium+ incluido |
| Business | $30/mes por usuario | Gestión de asientos, RBAC, verificación de dominio |
| Enterprise | Personalizado | SSO, SCIM, controles de auditoría, residencia de datos, precios por volumen |
Grok 4.6 se nombra como beneficio desde SuperGrok en adelante, no en Free. Los planes de pago pasaron en junio de 2026 a un único fondo semanal de uso compartido entre Chat, Imagine, Voice y Build, y xAI publica el mecanismo pero no cifras absolutas de mensajes. Agotar el fondo no es una parada total: se vuelve a los límites del plan gratuito en Chat y Voice. Los Extra Usage Credits empiezan en $5, caducan al año, y xAI dice con claridad que están "priced at standard rates, which means the cost per action is higher than the effective rate you get from the included weekly usage in your plan."
El dato más relevante para quien compra por adquisiciones: Grok 4.6 es un lanzamiento por API directa y de socios, no de hiperescaladores.
| Canal | Grok 4.6 en el lanzamiento |
|---|---|
| xAI API, Grok Build, OpenRouter | Disponible el primer día |
| Cursor | xAI dice que sí; la propia página de modelos de Cursor seguía listando solo 4.5 |
| Azure AI Foundry | Aún Grok 4.3 |
| AWS Bedrock | Aún Grok 4.3 |
| GitHub Copilot | Aún Grok 4.5 |
Si tu organización estandarizó en Bedrock o Copilot, todavía no puedes acceder a 4.6. Si estás en Azure Foundry, compras Grok 4.3 a $1,25 y $2,50, que es más barato pero dos generaciones atrás. Esa brecha se cierra con el tiempo, y importa ahora si una política de compras dice que toda la inferencia pasa por una sola nube. Es el mismo patrón que vi con Grok Bot y Grok Voice Think Fast 2: xAI lanza primero en sus propias superficies y deja que los revendedores se pongan al día.
Qué cambia un modelo de frontera en una cola de soporte, y qué no
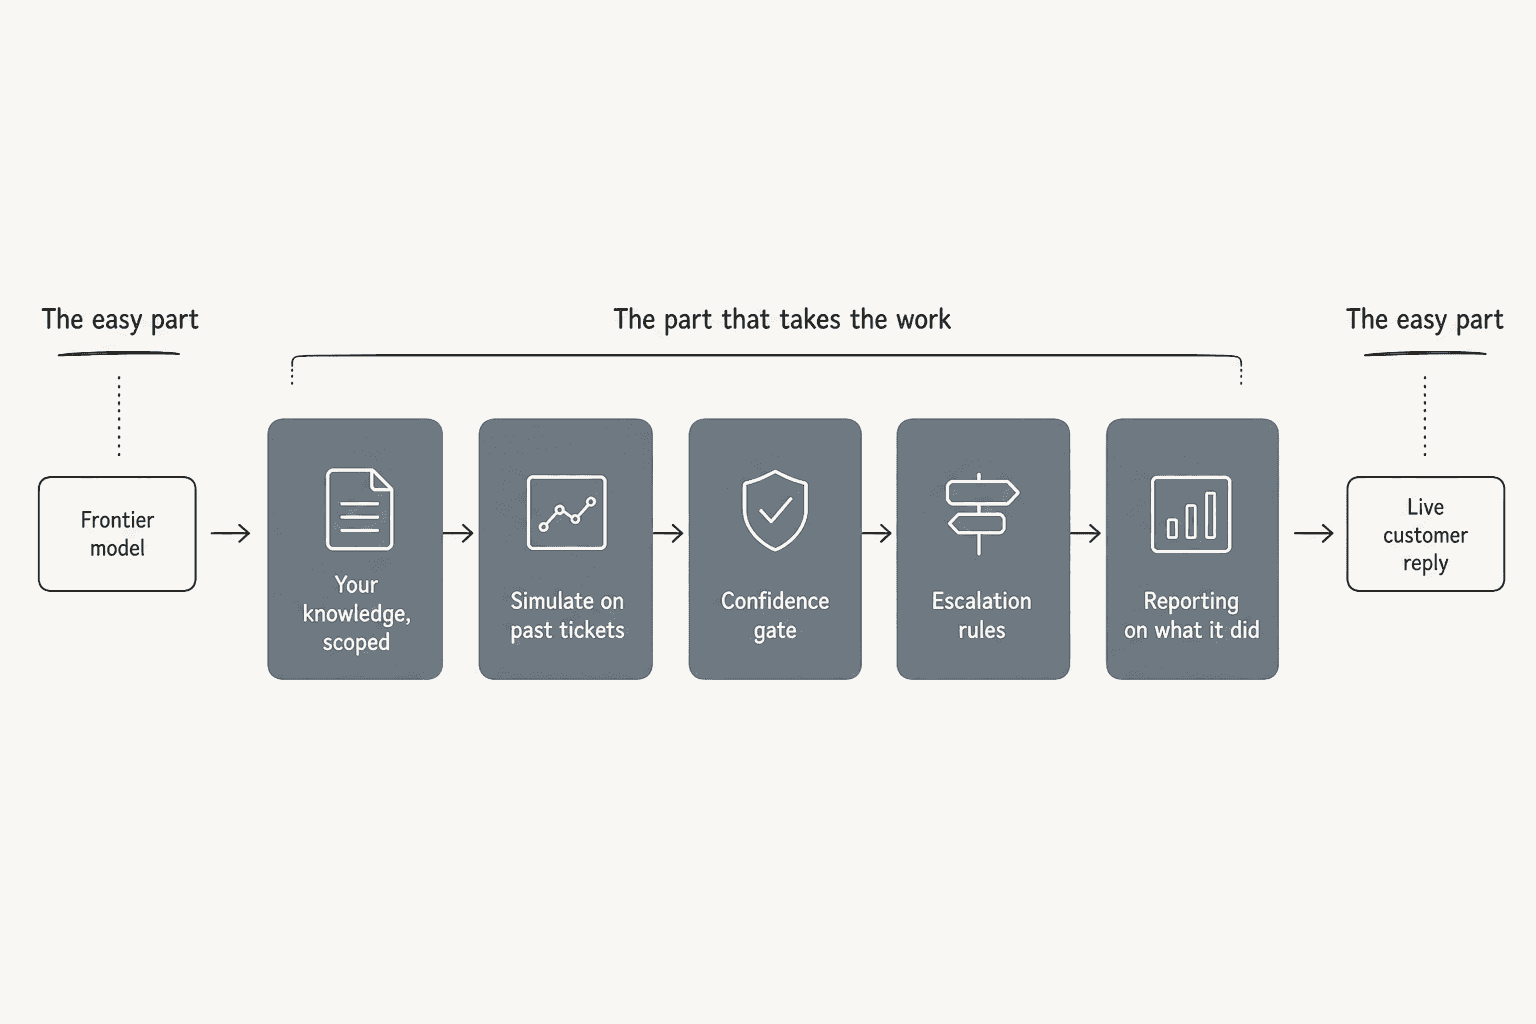
Cada cinco semanas llega un modelo nuevo y la pregunta aterriza en mi bandeja: ¿deberíamos cambiar? Habiendo construido las integraciones que van entre un modelo y un helpdesk, mi respuesta casi siempre es que el modelo no era el cuello de botella.
Lo que Grok 4.6 cambia, con honestidad:
- El uso agéntico de herramientas mejoró. 50,7 % en Tau-3-Banking, segundo de 97, 8,6 puntos más. Si tu automatización llama a un sistema de pedidos o a una API de devoluciones en plena conversación, esa fiabilidad es lo que hace que la automatización de flujos de trabajo termine en lugar de quedarse a medias.
- La invención bajó mucho. De 54,1 % a 34,3 % es la mayor mejora individual de la versión, y es la que más importa cuando la salida llega a un cliente.
- El costo por unidad de inteligencia mejoró frente a los rivales. Un 32 % más barato por tarea que un GPT-5.6 Sol empatado es dinero real a volumen.
Lo que no cambia:
- Tu conocimiento sigue siendo tu conocimiento. La fecha de corte de febrero de 2026 significa que el modelo no sabe nada de tu política de reembolsos, tus SKU ni la caída del martes pasado. Eso viene de entrenar con tu base de conocimiento y tickets pasados, y ninguna puntuación de benchmark lo sustituye.
- Un 34,3 % de alucinación sigue necesitando una barrera. Umbrales de confianza, guardrails y traspaso a una persona cuando el modelo no está seguro. Medir si debió responder siquiera es una disciplina propia, tratada en tasa de contención y calidad de la escalación.
- El precio del token es la línea más barata del montaje. Con los valores por defecto del widget, Grok 4.6 cuesta aproximadamente 1,5 centavos de tokens por conversación. La integración, las reglas de triaje, el ciclo de revisión, los reportes, la guardia cuando se porta mal: todo eso eclipsa a los tokens. Por eso mismo el costo por resolución supera al costo por millón de tokens como número de planificación.
- Comprar sigue superando a construir para la mayoría de equipos. Ese equilibrio es una decisión aparte, y construir o comprar es donde yo empezaría, no en una tabla de precios.
- Sigues sin poder saber qué hará con tus tickets. Una clasificación es un sustituto. Tu cola es la prueba. Las prácticas de evaluación existen precisamente porque ambas discrepan más a menudo de lo que nadie querría.
Si quieres la capa de plataforma y no un solo modelo, empieza por el software de atención al cliente con AI. Para las métricas con las que mediría un despliegue, la resolución automatizada de tickets y la tasa de resolución son las dos que importan.
eesel para la parte que el modelo no hace
Grok 4.6 es un buen modelo. Si estás entregando código, úsalo, la relación precio-puntuación es la mejor del ranking. Lo que no es es un agente de soporte, y la razón honesta es que un modelo sin más no tiene idea de lo que tu equipo ya le dijo a este cliente, no sabe cuándo callar y no guarda registro de lo que hizo después.
eesel es esa capa. Se conecta a Zendesk, Freshdesk, Gorgias y el resto en pocos minutos, aprende de tu centro de ayuda, macros y tickets resueltos para sonar ya como tu equipo y, la parte hacia la que más te empujaría, ejecuta una simulación sobre tus propios tickets históricos antes de responder a un solo cliente en vivo. Ves la precisión sobre tus datos, rellenas los huecos que aparecen, vuelves a ejecutar y solo entonces sales en vivo. Con un modelo que aún inventa un tercio de las veces, ese ensayo es la diferencia entre un experimento y un incidente.

El precio funciona con una tarifa mensual fija en lugar de tokens: los planes empiezan en $299/mes por 500 créditos, según la página de precios, con 1 crédito por ticket o chat sin importar cuántas respuestas lleve, sin cargos por asiento y sin cobro por los tickets que atiendan tus humanos. Tienes 100 créditos gratis sin tarjeta y puedes enrutar primero una parte, de modo que 1.000 tickets al mes con 200 enviados a la AI usan 200 créditos, lo que cabe en el plan de $299/mes. Activa el excedente opcional con un tope que tú fijes si quieres un techo firme. Las páginas de seguridad y enterprise cubren el lado del cumplimiento, y nuestros clientes cuentan si funciona.
Prueba eesel gratis, ejecuta la simulación y deja que tus propios tickets te digan lo que la clasificación no puede.
Preguntas frecuentes
¿Qué es Grok 4.6 y cuándo se lanzó?
xhigh. Si te importa menos el modelo y más ponerlo en una cola real, ese trabajo le corresponde a un agente de AI para helpdesk.¿Cuánto cuesta Grok 4.6 por 1M de tokens?
¿Es Grok 4.6 más barato que Grok 4.5?
¿Puedo usar Grok 4.6 para atención al cliente?
¿Dónde consigo Grok 4.6 y cuánto cuesta SuperGrok?
¿Es Grok 4.6 mejor que Grok 4.5?
¿Cuál es la ventana de contexto de Grok 4.6 y qué hace xhigh?
xhigh es un cuarto nivel de razonamiento por encima del high por defecto y solo existe en 4.6; según la documentación de razonamiento de xAI, los modelos anteriores tratan en silencio una solicitud xhigh como high en lugar de dar error. En cargas de soporte, el tamaño del prompt suele ser primero un problema de recuperación antes que de ventana de contexto.