

Cómo lo analicé y dónde terminan mis pruebas
En eesel construyo integraciones y APIs, las tuberías que van entre un modelo y un helpdesk en vivo. Así que este es un análisis desde el lado del desarrollador: leí cada página de la documentación speech-to-speech de xAI, las notas de versión, las tablas de límites de uso y la clasificación completa y el hilo de lanzamiento de Artificial Analysis, y lo comparé todo con lo que escribí sobre Grok Voice 2.0 hace dos meses.
Lo que no puedo afirmar son mil llamadas de producción en una línea telefónica real, porque el modelo tiene un día. Cuando hablo del comportamiento a escala, la cifra sale de un límite publicado o de las propias cifras de Starlink de xAI, y digo cuál de los dos.
Una nota sobre los nombres antes de empezar. La documentación y la publicación de lanzamiento de xAI ahora firman como SpaceXSI, y Artificial Analysis lista al proveedor como SpaceXAI. Mismo equipo, misma API en api.x.ai, misma familia Grok. Según la publicación de lanzamiento, la misma voz también funciona dentro del modo de voz de Grok Bot y en los coches Tesla. Si estás evaluando al proveedor entero, mi artículo sobre alternativas a xAI ofrece la vista más amplia.
El cuadro de mando
Pongo primero todo el veredicto y el detalle después.
| Dimensión | Grok Voice 3.0 | vs 2.0 | Mi lectura |
|---|---|---|---|
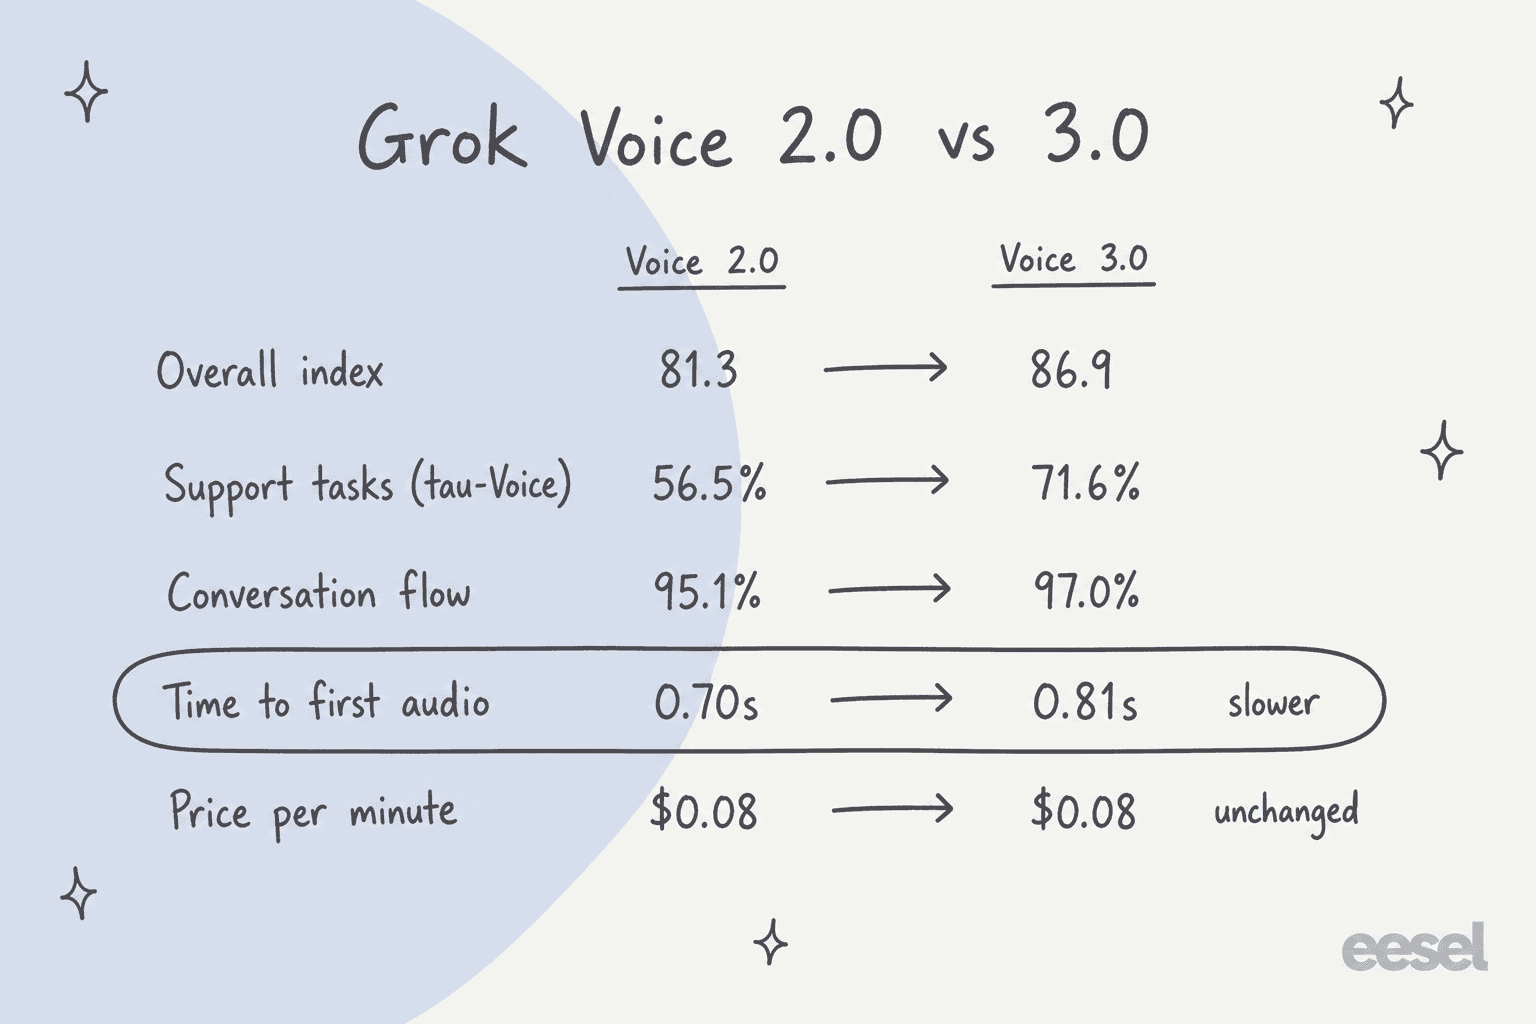
| General | 86.9 índice AA, n.º 1 | 81.3 | Mejor promedio de la tabla, 3.7 puntos por delante de GPT-Live-1 (Astra) |
| Tareas de soporte | 71.6% τ-Voice, n.º 2 | 56.5% | La mejora real. 2.9 puntos por detrás de GPT-Live-1 (Astra) |
| Éxito de tareas en llamadas reales | 94.8%, n.º 1 | 94.6% | Ya cerca del techo en la 2.0 |
| Preferencia humana | Elo 1070, n.º 3 | 1011 | Dos modelos Gemini suenan más agradables a los oyentes |
| Fluidez de la conversación | 97.0% Full Duplex Bench | 95.1% | Las interrupciones y las pausas son un problema resuelto aquí |
| Razonamiento de voz | 98.5% Big Bench Audio | 97.2% | Ganancia mínima, ya saturado |
| Latencia | 0.81s hasta el primer audio | 0.70s | Más lento que la 2.0, más rápido que cualquier modelo cercano en el índice |
| Precio | $0.08/min | $0.08/min | Sin cambios |
| Concurrencia | 10 a 200 según el nivel | 10 fijo | Resuelto, si gastas |
| Regiones | us-east-1, eu-west-1, us-saltlake-2 | us-east-1 | Los equipos de la UE por fin pueden evaluarlo |
Todas las cifras de benchmark proceden de Artificial Analysis, cuyos números de lanzamiento también se republicaron en el anuncio de Grok Voice 3.0 de xAI.
Veredicto: para un equipo que construye un agente de voz telefónico o dentro de una app que tiene que hacer cosas (buscar un pedido, emitir un crédito, reservar una cita), esta es mi elección por defecto ahora mismo. Fija la versión, presupuesta el nivel que necesites y resuelve el problema del conocimiento por separado.
Dónde gana
Me llamaron la atención tres cosas, y solo una es la cifra con la que xAI decidió abrir.
La puntuación en tareas de soporte es el titular, no el índice
τ-Voice es el benchmark en el que más confío para quien lea esto desde un equipo de soporte. Un llamante simulado llama al modelo con un problema de forma realista (cambiar un vuelo, disputar un cargo en una tienda, arreglar un problema de telecomunicaciones), el modelo actúa como agente de soporte con herramientas y un documento de políticas, y solo puntúa si el estado final de la base de datos es exactamente correcto. Artificial Analysis describe el método completo, hasta el promedio de tres intentos.
Grok Voice 2.0 puntuó 56.5%. La 3.0 puntúa 71.6%, un salto de 15.1 puntos en una versión. Esa es la diferencia entre un agente que falla cuatro de cada nueve llamadas y uno que falla aproximadamente dos de cada siete, y para una cola esa brecha es plantilla, no un error de redondeo.
No es la puntuación más alta. GPT-Live-1 (Astra, medium) está en 74.5%. Pero Astra necesita 1.34 segundos para empezar a hablar, frente a 0.81s de Grok, y xAI se apoya justo en ese intercambio en su publicación de lanzamiento. Si estás eligiendo entre los dos, mi análisis de GPT-Live-1 cubre el lado de OpenAI con más detalle.
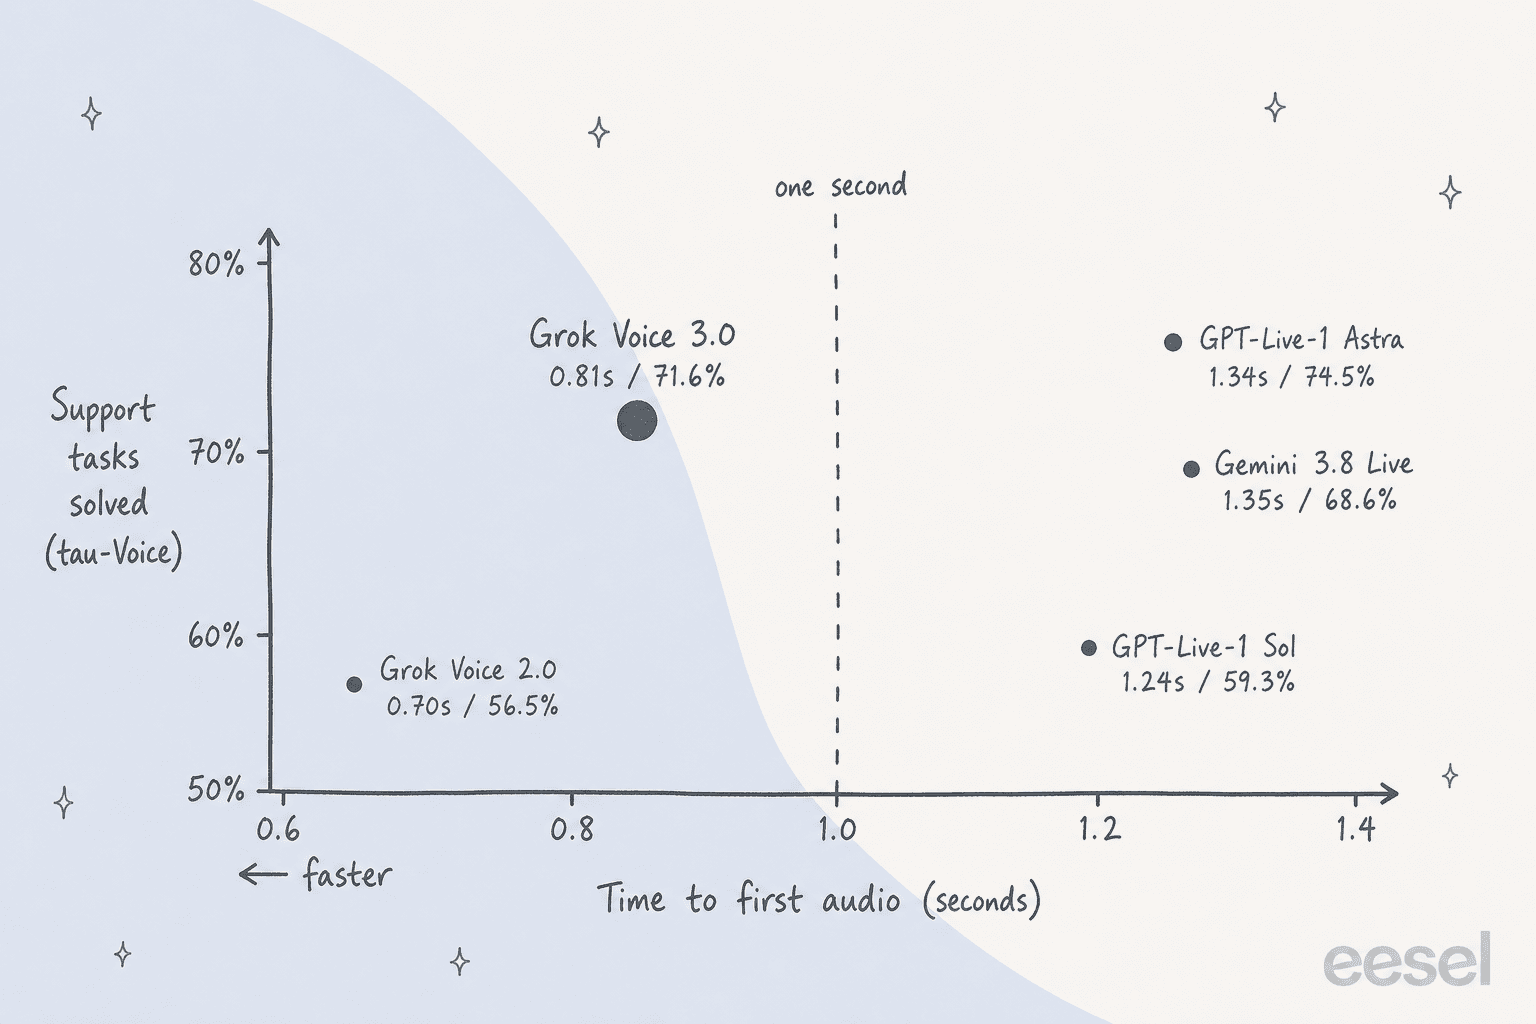
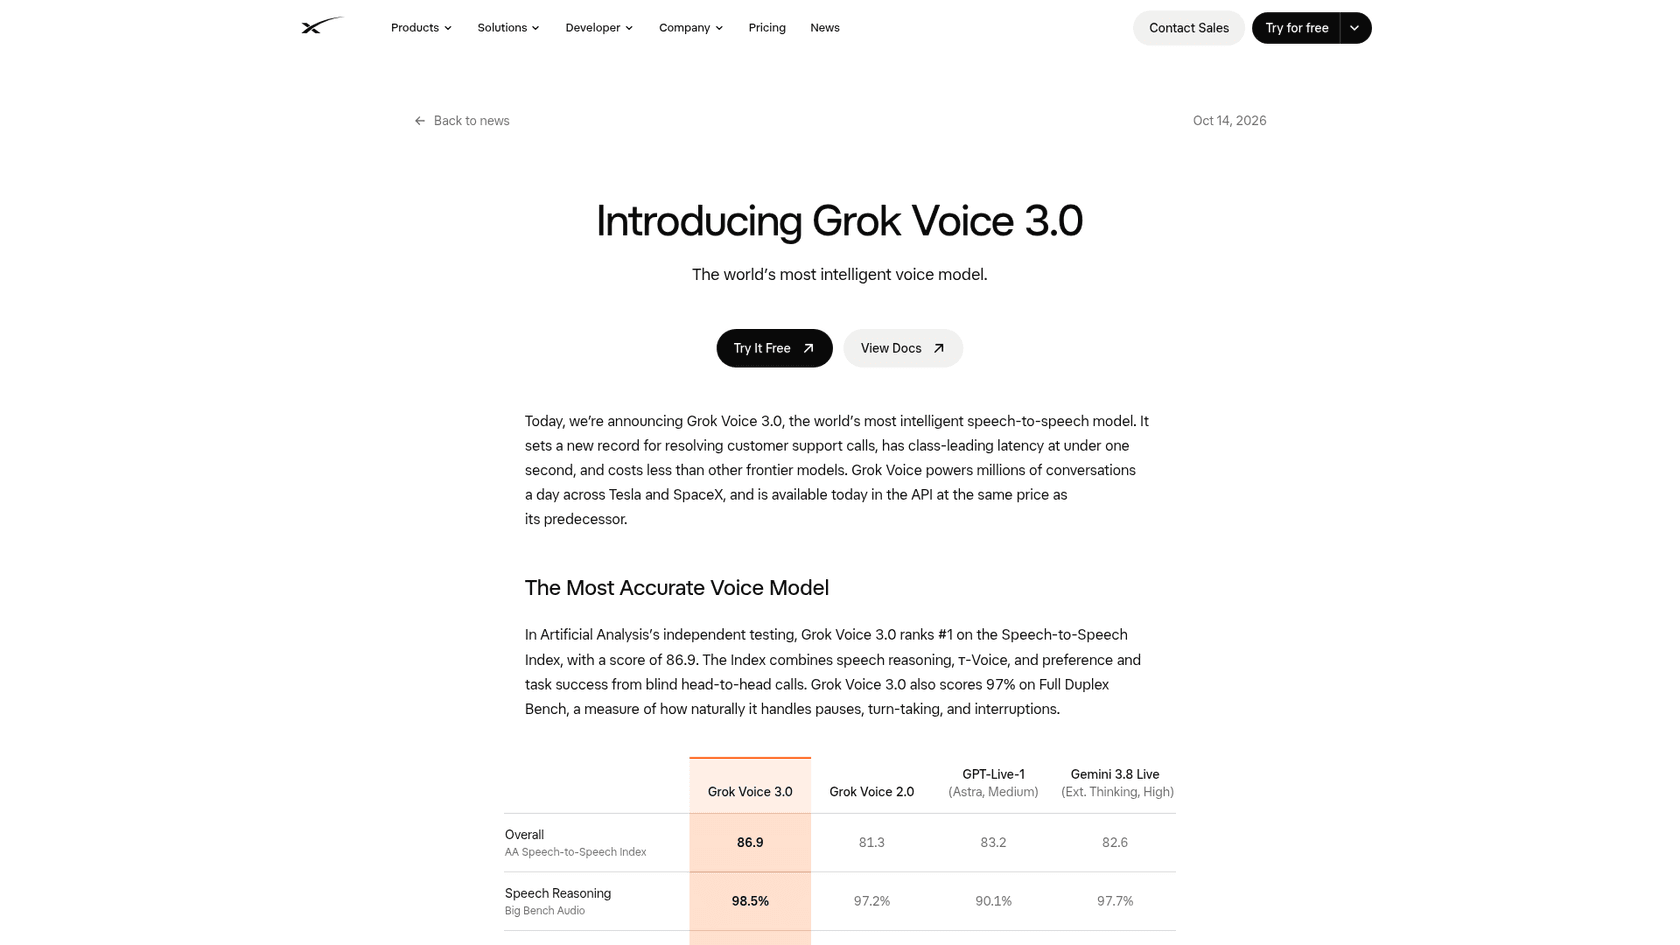
Ese gráfico es casi todo el argumento a favor de Grok Voice 3.0 en una imagen: todos los modelos que resuelven más del 65% de las tareas de soporte tardan más de 1.3 segundos en responder, excepto este. El propio hilo de Artificial Analysis lo dice claramente:
"Grok Voice 3.0 and Grok Voice 2.0 the only models in the top 5 of our Speech to Speech Index under 1 second."
Termina lo que empieza en llamadas reales
La Task Success Rate sale de la Speech Agent Arena de Artificial Analysis, donde personas reales mantienen conversaciones en vivo con dos modelos ocultos (reservar una cita con el dentista, cosas así). Grok Voice 3.0 completa el 94.8% de las tareas, el más alto de la tabla, justo por delante de Gemini 3.8 Live con 93.2%.
Una nota al pie que vale la pena añadir: Grok Voice 2.0 ya estaba en 94.6%, así que aquí no es donde mejoró la 3.0. Es un área en la que la línea Grok ya era fuerte, y la 3.0 la mantuvo mientras mejoraba en los casos más difíciles de τ-Voice.
Las cifras de Starlink, con la salvedad incluida
xAI dice que los call centers de Starlink usan Grok Voice para atender 20,000 llamadas al día en varios idiomas, resolver aproximadamente el 70% sin intervención humana y cerrar una de cada cuatro llamadas de ventas antes de que el cliente cuelgue. Un solo agente verifica clientes, resuelve problemas de hardware, emite créditos y envía equipos de reemplazo.
Es la afirmación de producción más concreta que he visto este año de cualquier proveedor de modelos de voz. También es una empresa hermana informando sobre sí misma, y no hay un método publicado detrás. Yo trataría el 70% como "lo que es posible con acceso profundo a herramientas y un producto acotado", no como una previsión para tu cola. En mi experiencia, la tasa de resolución que obtienes la fija mucho más lo que el agente puede consultar y hacer que el modelo, que es la misma lección que enseña cada despliegue de un agente de IA para call center.
Dónde el texto del lanzamiento exagera
Nada de esto es deshonesto. Es el encuadre habitual de una publicación de lanzamiento, que conviene conocer antes de citarlo a tu jefe.
- "Class-leading latency." 0.81s es excelente entre los modelos de mayor puntuación, pero Grok Voice 2.0 era más rápido con 0.70s, y las entradas más rápidas de la tabla (Deepslate Opal con 0.44s, por ejemplo) son todavía más veloces. Lectura justa: el más rápido de los listos.
- "Costs less than other frontier models." Cierto frente a GPT-Live-1 (Astra) y GPT-Realtime-2.1. No frente a todos: Artificial Analysis mide Gemini 3.8 Live Extended Thinking (High) en $3.50 por hora de audio de entrada y GPT-Live-1 (Sol) en $4.47, frente a $4.80 de Grok. Son costes de ejecución del benchmark, no precios de lista, pero la dirección es clara.
- "World's most intelligent." Lidera el índice compuesto. En preferencia humana es n.º 3 (Elo 1070, detrás de Gemini 3.1 Flash Live Minimal con 1100 y Gemini 3.8 Live con 1088), y en razonamiento de voz puro tres modelos puntúan más alto.
La reacción en X fue mayormente de aplauso, pero la respuesta más afilada bajo el hilo de Artificial Analysis fue la que todo responsable de soporte debería pegar en su monitor:
"Scores are one thing. The real test is a drive-thru order with a toddler in the back seat."
Tiene razón. Los benchmarks se ejecutan con audio limpio y escenarios ordenados, mientras que tus clientes llaman en manos libres desde un coche. Haz tus propias llamadas de prueba con ruido de fondo real antes de fiarte de cualquiera de estas cifras, incluidas las buenas.
La API: nada que migrar, mucho que gusta
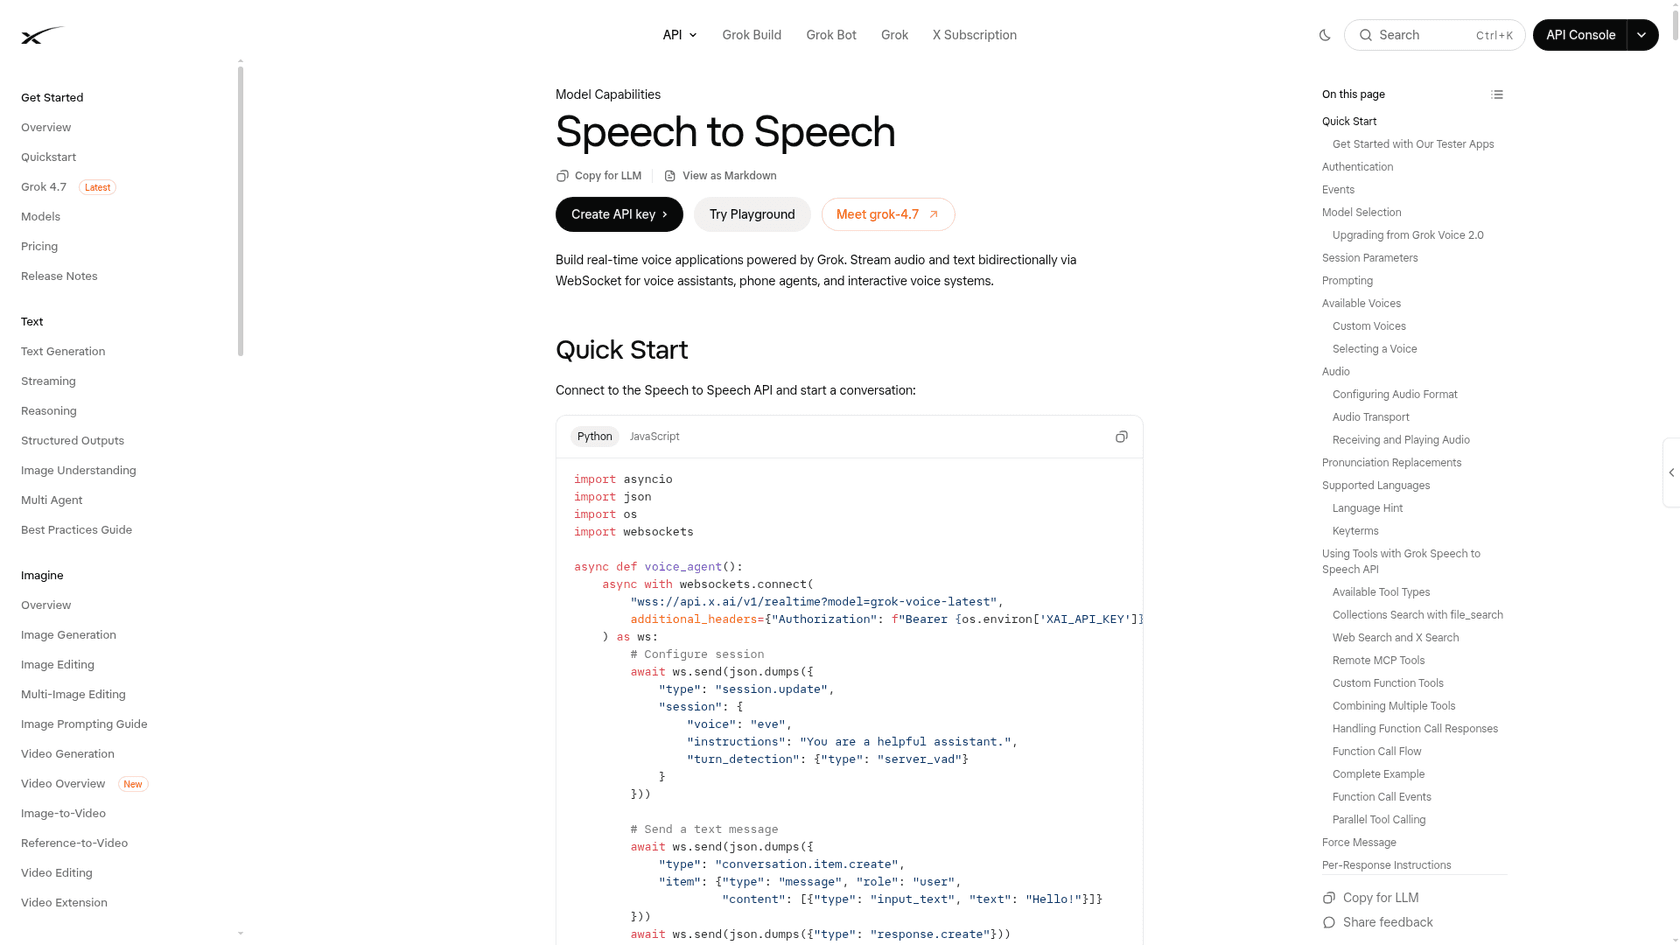
Las notas de versión de xAI lo dicen en una línea: la API no cambia. Mismo endpoint (wss://api.x.ai/v1/realtime), mismos parámetros de sesión, mismos eventos, mismo precio. Si llamas al alias grok-voice-latest, te pasaron a la 3.0 automáticamente, y grok-voice-2.0 ahora está obsoleto.
Es una buena noticia y también una pequeña advertencia. Las actualizaciones automáticas son estupendas hasta que tu prompt cuidadosamente ajustado empieza a comportarse distinto un martes cualquiera. En una línea de soporte yo fijaría grok-voice-3.0 de forma explícita y cambiaría de versión a propósito, tras una ronda de llamadas de prueba.
También sigue siendo compatible a nivel de protocolo con la OpenAI Realtime API, así que un equipo que ya trabaja con GPT Realtime puede cambiar la URL base y la clave y llegar casi hasta el final. Las partes sobre las que yo construiría, todas de la documentación speech-to-speech:
| Función | Qué hace | Por qué le importa a un equipo de soporte |
|---|---|---|
Herramientas: file_search, web_search, x_search, mcp, function | Busca en documentos subidos, llama a tus APIs, accede a un servidor MCP remoto durante la llamada | Así es como el agente emite el reembolso en lugar de prometerlo |
| Llamadas telefónicas SIP | Dirige llamadas PSTN, de contact center o PBX directamente, con DTMF | Sin un puente de telefonía aparte que vigilar |
| G.711 μ-law / A-law | Códecs telefónicos nativos | Sin retraso de transcodificación en el audio telefónico |
force_message | Dice una frase fija sin pasar por el modelo | "Esta llamada se está grabando" se dice palabra por palabra, siempre |
keyterms (hasta 100) | Sesga la transcripción hacia los nombres de tus productos | Dejan de entenderse mal tus códigos SKU |
replace | Corrige la pronunciación de nombres de marca en el audio hablado | Sin cambiar la transcripción que guardas |
| Reanudación de sesión | Reproduce de nuevo los turnos previos tras una conexión caída | Una llamada móvil cortada no vuelve a empezar desde "hola" |
idle_timeout_ms | Retoma la conversación con un cliente en silencio tras un tiempo definido | Resuelve el momento de "¿sigue ahí?" |
reasoning.effort | high (por defecto) o none | Una palanca para cambiar razonamiento por velocidad en flujos simples |
Si estás decidiendo entre WebSocket y WebRTC para un cliente de navegador, mi explicación de Realtime API vs WebRTC también se aplica aquí, ya que el formato de transmisión es el mismo.
Dos cosas más que conviene saber. Las voces se pueden clonar a partir de un clip de referencia de hasta 120 segundos, y la descripción general de voz lista 20 idiomas con acentos nativos, con el modelo detectando por sí solo el idioma del llamante. En X, una de las primeras preguntas bajo la publicación de lanzamiento de Elon Musk fue justo esa:
"Does it handle switching languages mid conversation? Genuinely curious how it does with Hungarian"
El húngaro no está en la lista, así que espera "varying degrees of accuracy", en palabras de la propia xAI. Si tus clientes hablan algo fuera de esos 20, pruébalo primero.
La llamada paralela a herramientas, junto con el consejo de la documentación sobre evitar el solapamiento de audio durante las llamadas a herramientas, me dice que este equipo ha lanzado agentes telefónicos reales. Cualquiera que haya trabajado con llamadas a herramientas en tiempo real sabe que el silencio incómodo mientras se ejecuta una función es donde los clientes cuelgan.
Los límites que cambiaron desde la 2.0
Si leíste mi análisis de la 2.0, esta es la sección que más importa, porque dos de los tres muros que señalé en agosto se han movido.
La concurrencia ahora es una escalera de gasto
En agosto cada equipo tenía 10 sesiones simultáneas, y punto. La tabla de límites de uso actual vincula la concurrencia de speech-to-speech a tu nivel de gasto, y los niveles se desbloquean automáticamente según el gasto acumulado en la API desde el 1 de enero de 2026. Nunca vuelven a bajar.
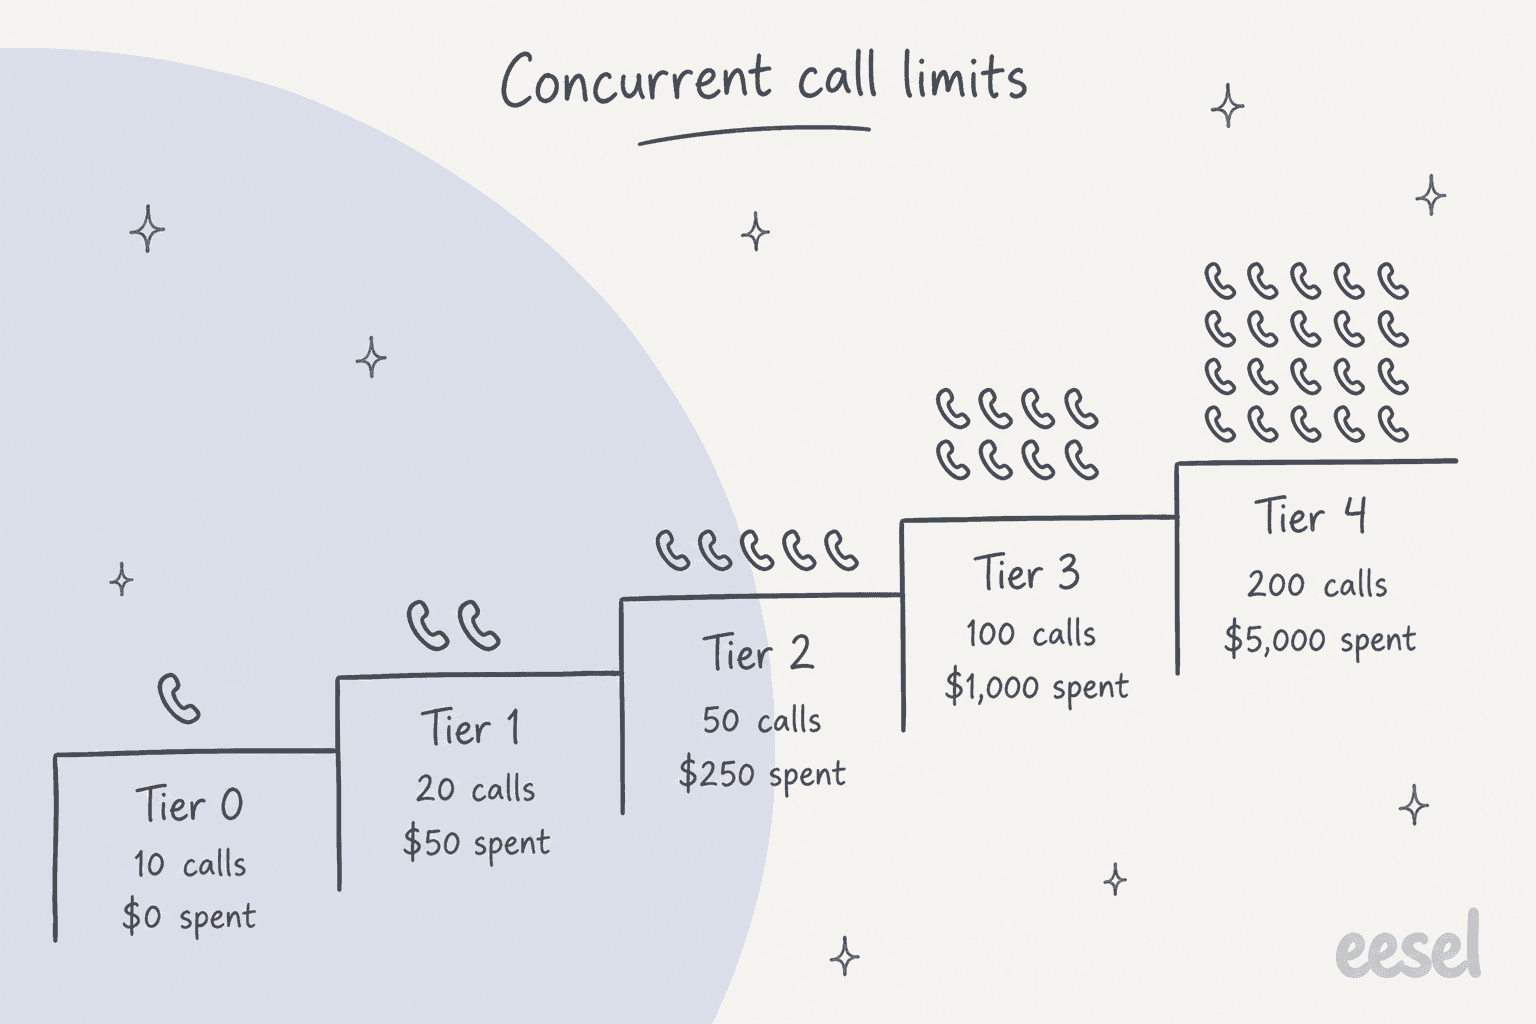
| Nivel | Gasto acumulado en la API | Sesiones de voz simultáneas |
|---|---|---|
| Tier 0 | $0 | 10 |
| Tier 1 | $50 | 20 |
| Tier 2 | $250 | 50 |
| Tier 3 | $1,000 | 100 |
| Tier 4 | $5,000 | 200 |
| Enterprise | Bajo petición | Personalizado |
A $0.08 el minuto, $5,000 son 62,500 minutos de conversación. Una cola que atiende 500 llamadas de cuatro minutos al día lo supera en aproximadamente un mes, así que el techo deja de ser un obstáculo para cualquiera en producción. Sí sigue importando para los pilotos: una cuenta nueva no puede hacer una prueba de carga de 50 llamadas simultáneas el primer día sin prepagar créditos para desbloquear el nivel.
Ahora hay una región en la UE
La página del modelo Grok Voice 3.0 lista us-east-1, eu-west-1 y us-saltlake-2. En agosto solo existía us-east-1, lo que acababa la conversación para muchos equipos europeos. La documentación de voz de xAI también menciona SOC 2 Type II, elegibilidad HIPAA con un BAA, acuerdos de tratamiento de datos del RGPD y una declaración de que el audio se procesa en tiempo real y "never stored or used for training". No he auditado nada de eso. Es lo que publica el proveedor, y basta para iniciar una revisión de seguridad.
Lo que no cambió: no sabe nada de ti
El modelo es más listo, pero no es tuyo. Todas las cifras de arriba suponen un documento de políticas y herramientas que alguien escribió para el benchmark. En tu línea, el agente sabe exactamente aquello a lo que lo conectes: una colección subida, tus funciones, un servidor MCP. La mayor parte del trabajo de un despliegue de soporte por voz real está ahí, además de decidir cuándo pasar a una persona.
Los equipos que veo hacerlo bien tratan al agente telefónico como un chatbot de base de conocimiento con voz: las respuestas viven en una única fuente mantenida, y todos los canales leen de ella. Si todavía estás decidiendo si automatizar el soporte telefónico en absoluto, empieza por ahí, no por la elección del modelo.
Cuánto cuesta, con las cuentas hechas
El precio de voz de Grok es el más simple de la categoría, directo de la página de precios de xAI:
| API de voz | Precio |
|---|---|
Speech to speech (grok-voice-3.0) | $0.08 por minuto ($4.80 por hora) + $0.004 por entrada de texto |
Speech to speech (grok-voice-2.0, obsoleto) | Misma tarifa |
| Speech to text | $0.10 por hora (REST), $0.20 por hora (streaming) |
| Text to speech | $15.00 por 1M de caracteres |
No hay licencias por usuario ni cuotas de plataforma, ni tampoco mínimo, solo una tarifa para cada minuto, tanto si el modelo pensó mucho como si no. Eso hace que la factura sea fácil de prever. Introduce tus propios números:
Para hacerte una idea de la escala: un equipo que atiende 500 llamadas al día de 4 minutos cada una gasta aproximadamente $4,800 al mes, y en su hora punta tiene unas 7 llamadas a la vez, dentro del nivel gratuito de 10. La concurrencia solo empieza a apretar a partir de unos pocos miles de llamadas al día. Las 20,000 llamadas diarias de Starlink, con la misma estimación de 4 minutos (xAI no publica la duración de las llamadas), serían 80,000 minutos y $6,400 al día. Para el ángulo de los modelos más baratos, mi artículo sobre los precios de Grok Voice 2.0 compara las tarifas por minuto de toda la categoría, y mi comparación del coste de un agente humano pone la cifra por llamada junto a un salario.
Cómo se compara con el resto
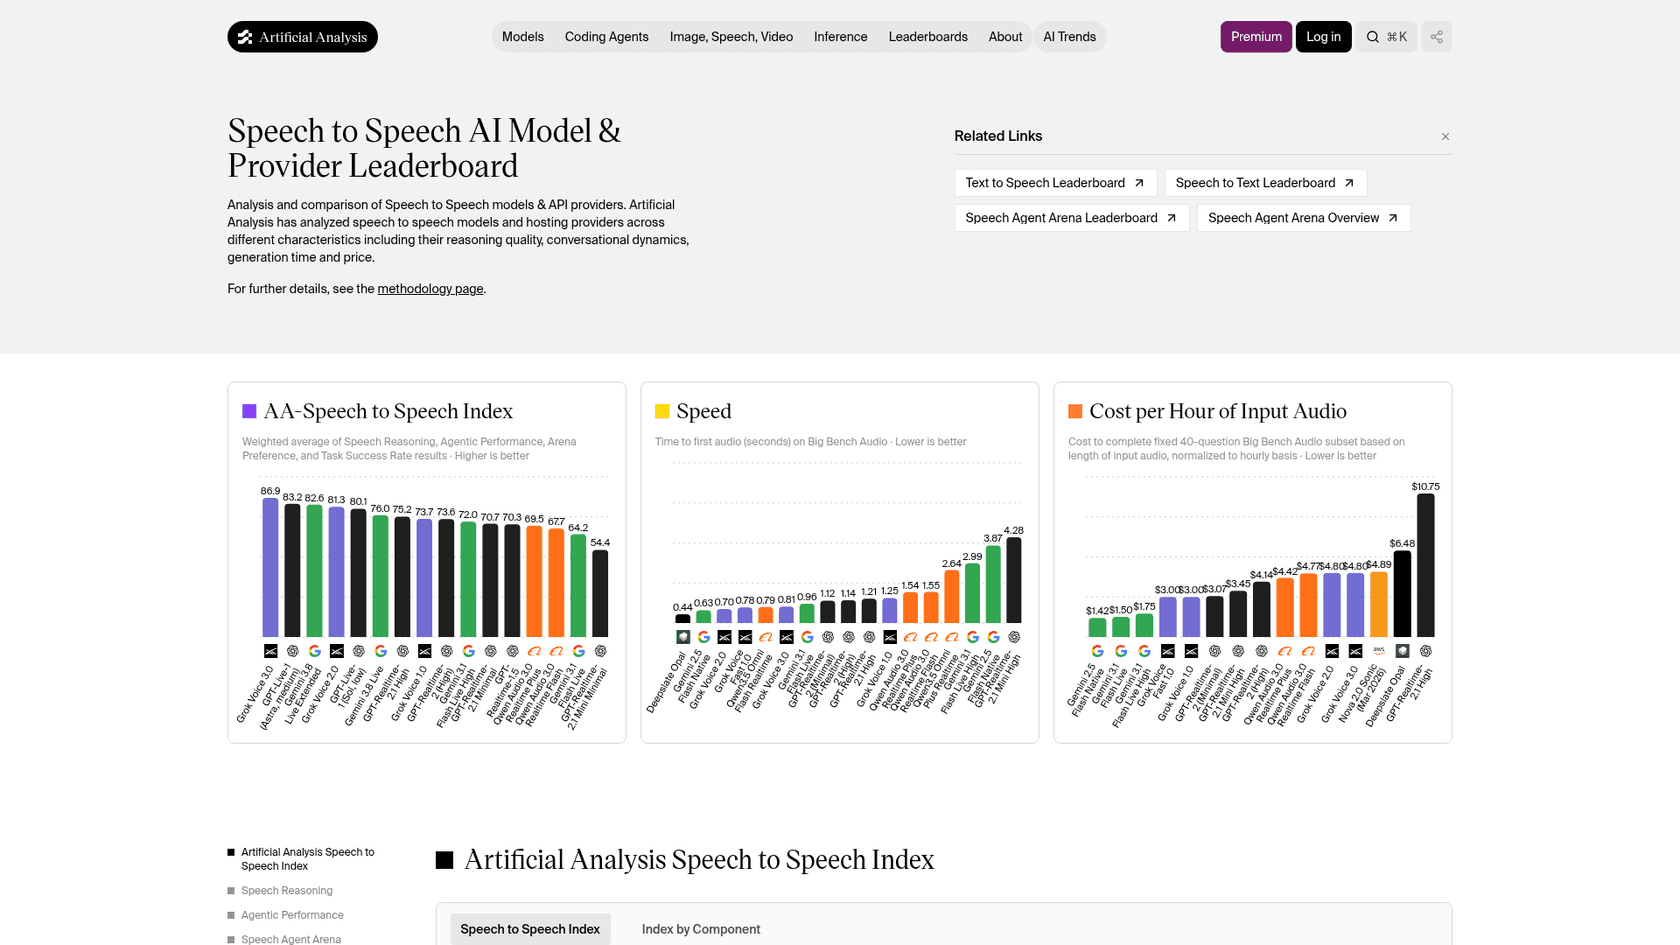
Un mapa rápido de los modelos que preseleccionarías junto a él, todo de la clasificación de Artificial Analysis (el coste es el coste de ejecución medido por AA por hora de audio de entrada, no un precio de lista):
| Modelo | Índice AA | τ-Voice | Tiempo hasta el primer audio | Coste AA por hora |
|---|---|---|---|---|
| Grok Voice 3.0 | 86.9 | 71.6% | 0.81s | $4.80 |
| GPT-Live-1 (Astra, medium) | 83.2 | 74.5% | 1.34s | $5.83 |
| Gemini 3.8 Live Extended Thinking (High) | 82.6 | 68.6% | 1.35s | $3.50 |
| Grok Voice 2.0 | 81.3 | 56.5% | 0.70s | $4.80 |
| GPT-Live-1 (Sol, low) | 80.1 | 59.3% | 1.24s | $4.47 |
| GPT-Realtime-2.1 High | 75.2 | 45.7% | 1.21s | $10.75 |
Desde fuera, xAI también señala EVA-Bench, el benchmark abierto de ServiceNow para agentes de voz empresariales con más de 200 escenarios, donde Grok Voice 3.0 logra la mayor puntuación de precisión con 74%.
Si quieres una plataforma completa en lugar de un modelo, el intercambio es distinto. Herramientas como Retell AI, Vapi y ElevenLabs envuelven los modelos en flujos de llamadas y paneles, con analítica por encima.
Si vives dentro de un helpdesk, comprueba primero lo que trae de serie: los agentes de voz con IA de Zendesk y los agentes de voz de Freshcaller merecen ambos un vistazo. Mi recopilación de los mejores agentes de voz con IA cubre el resto.
Si solo necesitas la voz y quieres traer tu propio cerebro, los motores de texto a voz como Cartesia Sonic 3 están más abajo en la pila, y el mapa más amplio de empresas de voz con IA muestra quién vende qué. Para alternativas dentro de la misma familia, mi lista de alternativas a Grok Voice 2.0 sigue vigente para los competidores.
Quién debería adoptarlo y quién debería esperar
La respuesta corta a si la IA puede atender llamadas de soporte es ahora un sí firme para la capa del modelo. Quién debería actuar:
Cambia ya si ya usas Grok Voice 2.0 (es la misma API y el mismo precio, así que el único coste es una ronda de llamadas de regresión), o estás construyendo un agente telefónico que debe completar tareas de varios pasos y cada 100ms de silencio te cuesta clientes.
Haz primero una comparativa si ya usas GPT-Live-1 (Astra). Sigue ganando en τ-Voice por 2.9 puntos. Que la ventaja de 0.5 segundos de Grok compense eso depende de cuántas herramientas usen tus llamadas.
Espera o busca otra cosa si tus clientes hablan idiomas fuera de los 20 admitidos, necesitas un constructor de flujos de llamadas sin código (empieza con el Voice Agent Builder de xAI o una plataforma de las anteriores), o tu bloqueo no es la voz sino las respuestas. Mi guía de la mejor IA para soporte por voz cubre las opciones empaquetadas. Una voz brillante leyendo la política de reembolsos equivocada sigue siendo la política de reembolsos equivocada, y encabeza toda lista de problemas de los chatbots que hacen que los clientes se rindan.
Grok atiende la llamada. eesel se encarga de lo que debe decir.
Grok Voice 3.0 es un motor de conversación. No conoce tu plazo de devolución, tus últimos 50,000 tickets ni qué clientes reciben el crédito de cortesía. Esa es la mitad que cubre eesel: un compañero de helpdesk con IA que se une a Zendesk, Freshdesk o Gorgias, aprende de tus tickets anteriores y tu centro de ayuda, y trabaja la cola de correo y chat que hay detrás de cada línea telefónica. Antes de ponerlo en marcha, puedes ejecutarlo contra tus propios tickets anteriores y ver cómo se comparan sus respuestas con lo que tu equipo envió realmente.

Para los desarrolladores, los dos encajan bien sobre el papel. La herramienta mcp de Grok acepta una URL de servidor, un token authorization y cabeceras personalizadas. Cada espacio de trabajo de eesel es un servidor MCP: ejecuta npx @eesel/cli mcp token desde la CLI de eesel y devuelve la URL, un token de 30 días y la cabecera X-Eesel-Agent-Id, que es exactamente la forma que pide Grok. La misma CLI te permite automatizar e inspeccionar el agente desde una terminal o dárselo a un agente de código como Claude Code. Todavía no he probado esa combinación en una línea telefónica real, así que trátala como una construcción prometedora, no como una integración publicada, y vigila la latencia extra de una llamada a herramienta en mitad de una frase.
El precio es un plan mensual fijo de créditos: $299 al mes por 500 créditos, donde un ticket o un chat cuenta como un crédito, con 100 créditos gratis para probar y sin tarjeta. Prueba eesel con una parte de tu cola antes de tu próximo piloto de voz, para que el agente al teléfono tenga algo que valga la pena decir.
Frequently Asked Questions
¿Es Grok Voice 3.0 lo bastante bueno para llamadas de soporte en producción?
¿Qué cambió en Grok Voice 3.0 respecto a Grok Voice 2.0?
¿Cuánto cuesta Grok Voice 3.0?
¿Es Grok Voice 3.0 mejor que GPT-Live-1?
¿Necesito cambiar mi código para actualizar a Grok Voice 3.0?
grok-voice-latest, ya estás en la 3.0. Si fijaste grok-voice-2.0, cambia el nombre del modelo a grok-voice-3.0; el endpoint, los parámetros de sesión y los eventos siguen igual. Las apps creadas sobre la OpenAI Realtime API todavía pueden migrar cambiando la URL base y la clave.