

Grok Voice Think Fast 2.0 cuesta $0.08 por minuto de audio, indicado como $4.80 por hora, más $0.004 por mensaje de texto de entrada. Think Fast 1.0 sigue publicado a $0.05. El número que importa más que ambos: hoy, 5 de agosto de 2026, el alias grok-voice-latest pasa de 1.0 a 2.0, así que si desplegaste contra el alias, tu tarifa de voz subió un 60% por minuto sin ningún despliegue de tu parte.
La comparación que cambió con esto es más silenciosa. Hasta esta mañana, Grok era un 37.5% más económico que ElevenLabs Agents en la tarifa base de voz. Cada nivel de pago de ElevenLabs resulta en casi exactamente $0.08 por minuto incluido, así que ambos están ahora a la par sobre el papel. Grok sigue costando menos de la mitad del costo medido del mejor modelo en tiempo real de OpenAI, y sigue siendo el único de los tres que publica una cifra fija por minuto que puedes poner en una hoja de cálculo.
Escribo el lado de SEO de eesel y despliego contra estas APIs, así que leo tarifas por oficio, y lo que sigo observando no es el precio de etiqueta. Es el momento en que un comprador ve la factura. Uno de los ejemplos más claros en los propios registros de eesel es una marca de trajes de baño estadounidense en Gorgias con 151 documentos conectados: doce chats de prueba exitosos, el agente funcionando bien, y luego dos solicitudes de cancelación se abrieron justo en el momento en que llegaron a la página de facturación. El producto funcionaba. La página de precios fue el evento de abandono. Por eso el resto de esta publicación es aritmética por llamada en vez de una tabla de tarifas que podrías haber leído tú mismo en la página de precios de xAI.
Interactivo
Cuánto cuestan tus minutos de voz al mes
Elige tu tiempo de conversación mensual. Las tarifas son las cifras por minuto publicadas por xAI, el plan más económico y suficiente de ElevenLabs, y el costo por hora medido por Artificial Analysis para GPT-Realtime-2.1 High.
No hacer nada te cuesta +$15/mes
No hacer nada te cuesta +$60/mes
No hacer nada te cuesta +$300/mes
No hacer nada te cuesta +$1,200/mes
Solo el medidor de audio. Las llamadas a herramientas, las entradas de texto y la telefonía de un operador externo son adicionales en cada fila.
La tarifa completa de Grok Voice, tal como está publicada hoy
Aquí está todo lo que aparece en la sección de la API de voz de la tarifa de xAI, más la línea de telefonía que en cambio vive en el anuncio del Voice Agent Builder. También incluí las tarifas independientes de transcripción y síntesis, porque muchos equipos todavía operan una canalización combinada y quieren comparar los dos enfoques.
| Concepto | Tarifa |
|---|---|
Voz a voz, grok-voice-think-fast-2.0 | $0.08 / min ($4.80 / h) |
Voz a voz, grok-voice-think-fast-1.0 | $0.05 / min ($3.00 / h) |
Entrada de texto, por conversation.item.create | $0.004 / mensaje |
| Número de teléfono provisto (telefonía) | +$0.01 / min |
| Voz a texto, REST | $0.10 / h |
| Voz a texto, streaming | $0.20 / h |
| Texto a voz | $15.00 / 1M caracteres |
web_search o x_search | $5 / 1k llamadas |
collections_search / file_search | $2.50 / 1k llamadas |
attachment_search | $10 / 1k llamadas |
code_execution | $5 / 1k llamadas |
| Almacenamiento de colecciones | $0.10 / GiB / día |
Hay dos cosas de esta tabla que merece la pena mencionar en voz alta, porque son las partes que la gente entiende mal al presupuestar.
El medidor de audio se describe en la ficha del modelo como algo que cobra por minuto de audio «enviado o recibido», lo cual suena como si pudiera contar dos veces una conversación bidireccional. No parece ser el caso. Artificial Analysis midió el costo por hora de audio de entrada en exactamente $4.80 para este modelo, que es $0.08 multiplicado por sesenta, así que en su prueba el medidor se comportó como un único conteo de duración de sesión y no como una suma de ambas direcciones. Aun así, yo vigilaría la primera factura en lugar de fiarme solo de mi palabra.
El medidor de entrada de texto también es más limitado de lo que parece. xAI cobra $0.004 por cada evento conversation.item.create que envías, pero los elementos function_call_output no se cobran, y response.create no es en absoluto un evento facturable. Así que un agente conversador que usa muchas herramientas no acumula cargos de entrada de texto por cada resultado de herramienta que devuelve, que era la suposición con la que empecé y que resultó ser incorrecta.
El cambio del 5 de agosto, en dólares
Esta es la única razón por la que esta publicación existe hoy y no la semana pasada.
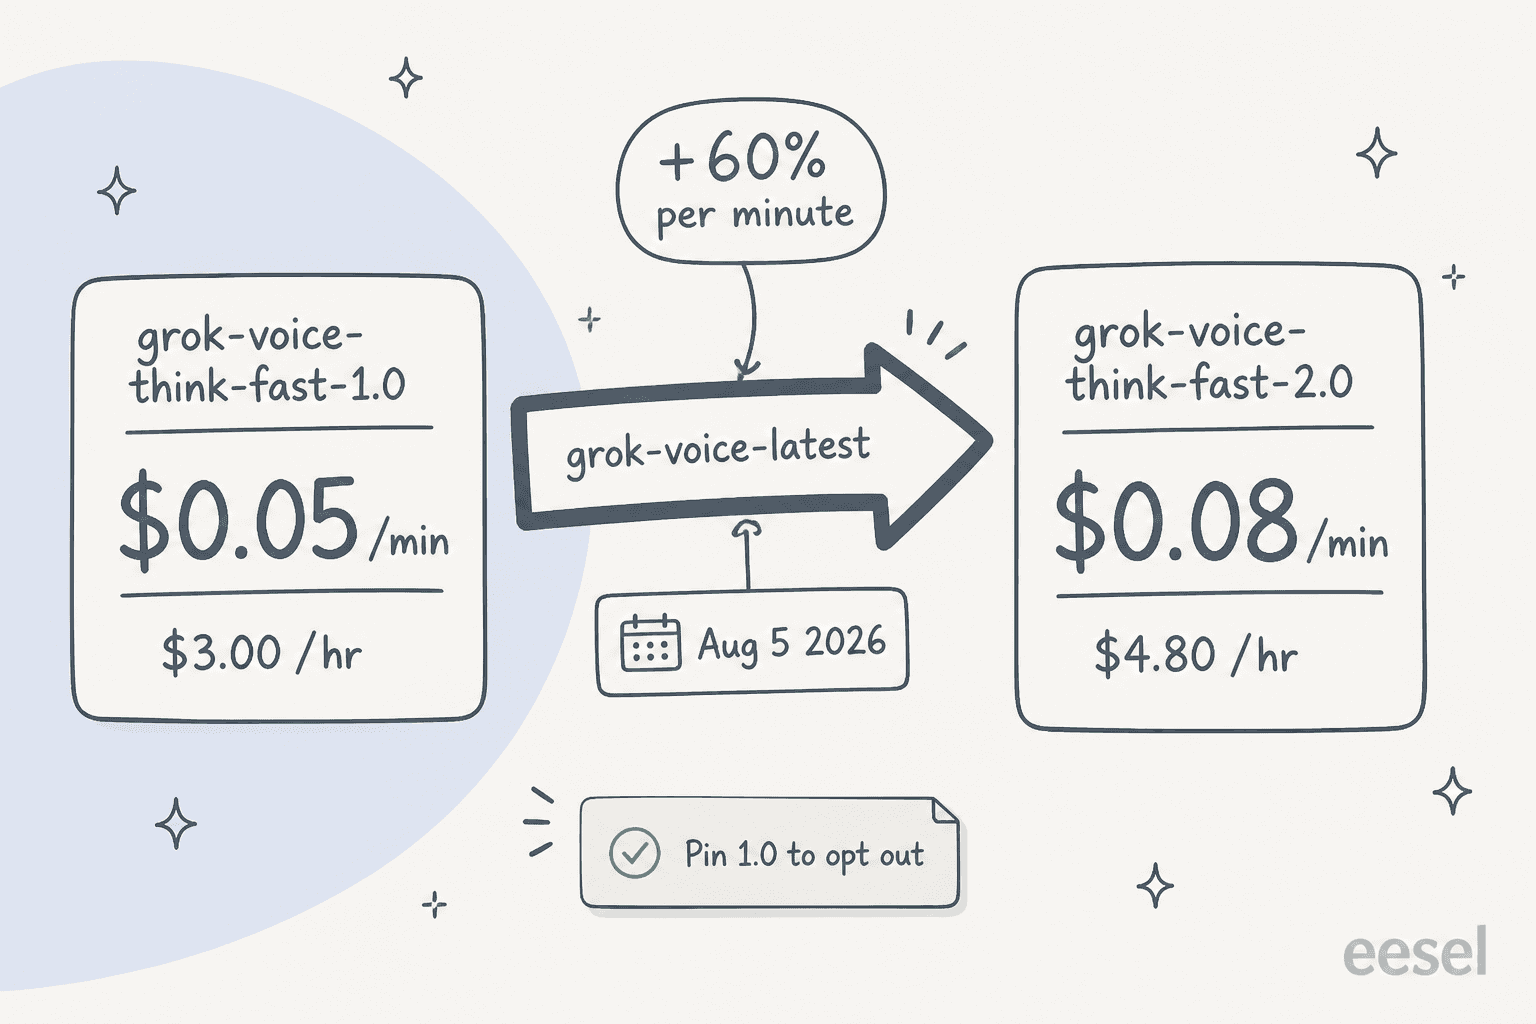
La propia nota de lanzamiento de xAI es directa al respecto: el 5 de agosto de 2026, grok-voice-latest pasa de grok-voice-think-fast-1.0 a grok-voice-think-fast-2.0, sin necesidad de ninguna acción para actualizar, y para quedarte en el modelo antiguo fijas grok-voice-think-fast-1.0 antes de esa fecha. Lo que la nota no hace es poner un porcentaje al lado, y el porcentaje es 60% por minuto.
La documentación está actualmente en medio del cambio, lo cual me pareció discretamente gracioso. La tabla de modelos en la guía de voz a voz todavía describe el alias como apuntando a 1.0 y actualizándose el 5 de agosto, mientras que un párrafo más abajo en la misma página ya dice que «siempre apunta al modelo más reciente (actualmente grok-voice-think-fast-2.0)». Ambas fueron ciertas en días distintos. Ninguna te dice qué le hace eso a tu factura.
Justo al lado de todo esto, en el mismo post de lanzamiento, está la frase con la que xAI abre su sección de precios: «Creemos que los precios deben ser predecibles y transparentes». En realidad creo que eso es defendible aquí. Dejaron 1.0 publicado a su tarifa antigua, dieron un aviso con fecha y documentaron cómo optar por no participar. Eso es más aviso del que reciben la mayoría de los cambios de precio de modelos. Simplemente no es lo mismo que tu factura sea predecible, porque la ruta predeterminada cambió, y ahí es donde vive la mayor parte del tráfico de producción.
Lo que el precio de etiqueta no muestra
Toda tarifa de voz en esta categoría tiene la misma señal: el número principal es lo único de la factura que no es una sorpresa. Aquí hay una sola llamada de soporte de seis minutos, calculada línea por línea.
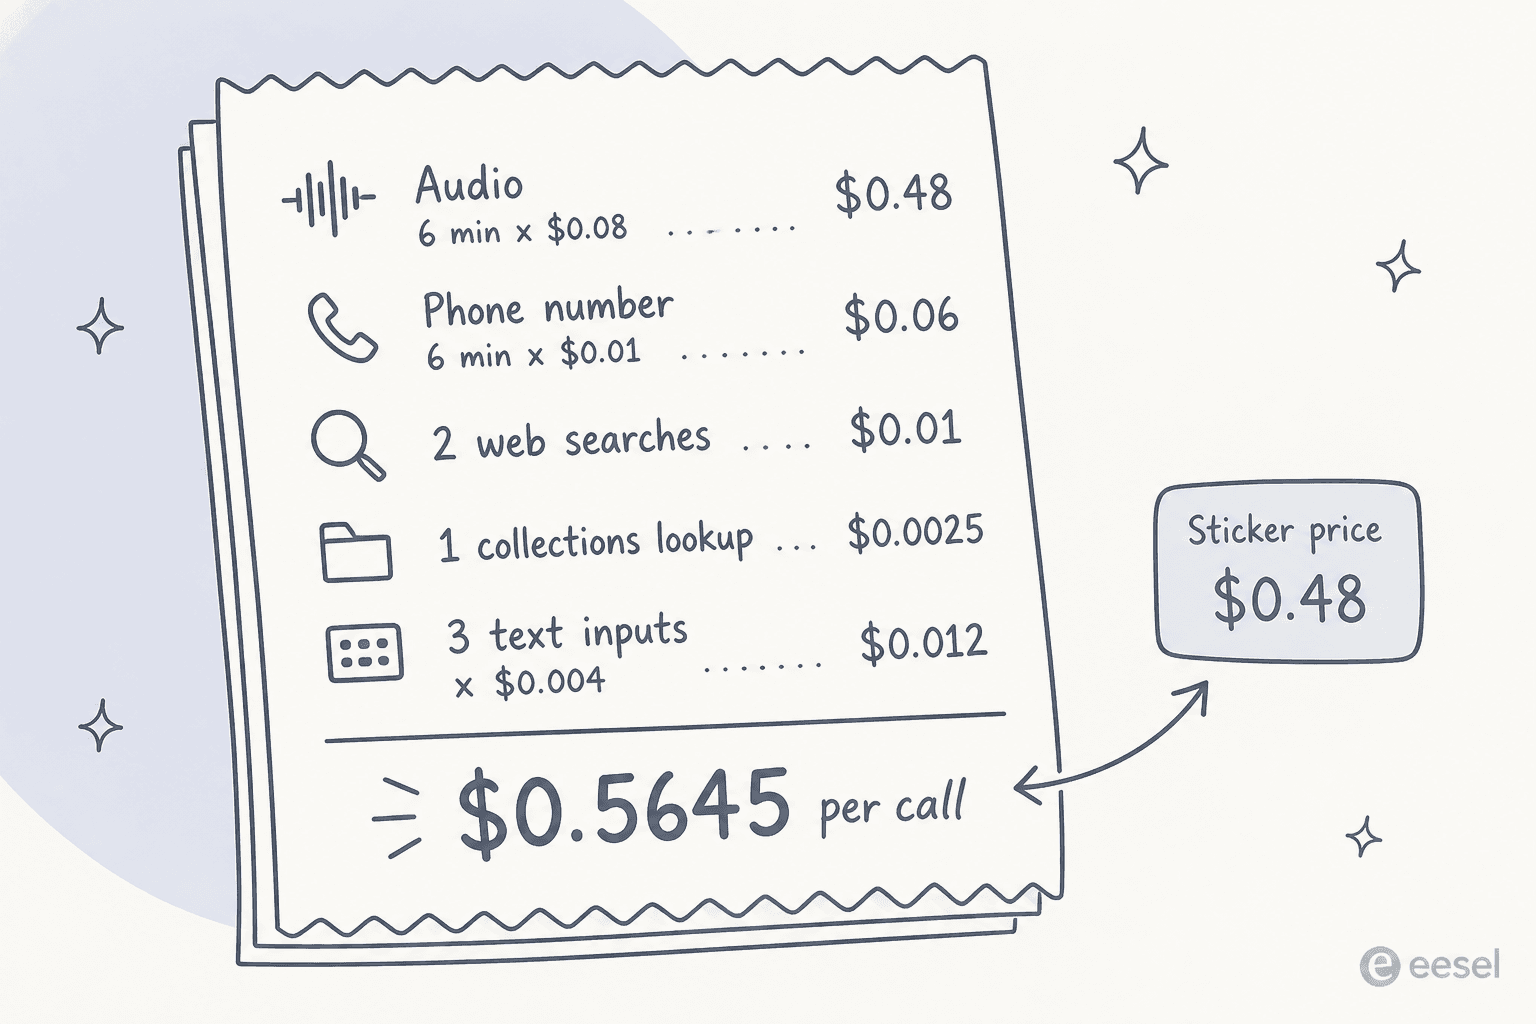
- Audio: 6 min x $0.08 = $0.48
- Número de teléfono provisto: 6 min x $0.01 = $0.06
- Dos búsquedas web: 2 x $0.005 = $0.01
- Una consulta a colecciones: 1 x $0.0025 = $0.0025
- Tres entradas de texto: 3 x $0.004 = $0.012
Eso es $0.5645 frente a un precio de etiqueta de $0.48, alrededor de un 18% más. No es catastrófico, y honestamente es una de las mejores proporciones en esta categoría, porque las tarifas de herramientas de xAI son económicas y su tarifa de voz es fija. Pero escala linealmente, y un 18% sobre una línea de voz mensual de $3,200 son $576 que nadie incluyó en el pronóstico.
La línea que modelaría con más cuidado es web_search. A $5 por cada 1,000 llamadas parece un redondeo, hasta que recuerdas que un modelo agéntico decide por sí mismo cuántas herramientas invocar. xAI lo dice claramente en la página de precios: los costos escalan con la complejidad de la consulta porque el agente elige. El nivel de razonamiento viene predeterminado en "high" en este modelo, y aunque los tokens de razonamiento no se miden por separado en el medidor de voz, un modelo que piensa más recurre también a más herramientas.
Lo que realmente compran los tres centavos extra
Yo no pagaría un 60% más por un benchmark más redondo, así que aquí está la lectura honesta de qué cambia realmente.
| Métrica | Think Fast 2.0 | Think Fast 1.0 | Cambio |
|---|---|---|---|
| Costo por hora de audio de entrada | $4.80 | $3.00 | +60% |
| Índice de voz a voz | 82.9% | 75.7% | +7.2 pts |
| Rendimiento agéntico (τ-voice) | 56.5% | 52.1% | +4.4 pts |
| Dinámica conversacional | 95.1% | 77.8% | +17.3 pts |
| Razonamiento de habla | 97.2% | 97.1% | sin cambio |
| Tiempo hasta el primer audio | 0.70s | 1.25s | 44% más rápido |
Lee esa columna de cambios como una forma, no como una puntuación. El razonamiento de habla no se movió, así que si el trabajo de tu agente es entender una frase y leer una respuesta, estás pagando un 60% más por algo que no notarás. Lo que se movió es la dinámica conversacional, +17.3 puntos, que es el manejo de interrupciones, el barge-in, saber cuándo terminó de hablar quien llama, y la latencia, que bajó a 0.70 segundos. Esas son las dos cosas que hacen que una llamada telefónica se sienta como una llamada telefónica y no como un kiosco.
El rendimiento agéntico se movió 4.4 puntos, hasta 56.5%. Es la cifra más alta publicada en la tabla de voz a voz de Artificial Analysis, y sigue siendo una tasa de fallo del 43.5% en escenarios agénticos difíciles, que es la cifra que le pondría delante a cualquiera que esté presupuestando para automatización total. También es la razón por la que la tasa de resolución con la que planificas debería venir de tu propio tráfico, no de una clasificación.
Dos desarrolladores en Hacker News llegaron a la misma lectura desde direcciones opuestas. Uno valoró el modelo por sensación:
"Grok Voice es el mejor asistente de voz con IA, y no es ni de cerca. La combinación de velocidad e inteligencia es exactamente la correcta."

Y en el propio hilo de Think Fast 2.0, el comentario más votado lo enmarcó frente al especialista establecido:
"No sé por qué esta publicación no es más popular, este es un modelo de voz de última generación (SOTA), que supera a laboratorios especializados como ElevenLabs"
Lo cual es un buen puente, porque superar a ElevenLabs en calidad es una pregunta distinta de superarlo en precio, y a día de hoy esas dos respuestas se separan.
Los precios de Grok Voice frente al resto del campo
Artificial Analysis publica el costo medido por hora de audio de entrada para toda la categoría de voz a voz, que es la única columna verdaderamente comparable cuando la mitad de los proveedores cobra por token y la otra mitad por minuto.
| Modelo | Índice S2S | $/h medido | Tiempo hasta el primer audio |
|---|---|---|---|
| Qwen Audio 3.0 Realtime Plus | 84.1% | $4.42 | 4.02s |
| Grok Voice Think Fast 2.0 | 82.9% | $4.80 | 0.70s |
| GPT-Realtime-2.1 High | 79.1% | $10.75 | 1.21s |
| GPT-Realtime-2 High | 77.2% | $4.14 | 1.14s |
| Qwen Audio 3.0 Realtime Flash | 76.3% | $4.77 | 4.16s |
| Grok Voice Think Fast 1.0 | 75.7% | $3.00 | 1.25s |
| GPT-Realtime-2.1 Minimal | 72.5% | $11.31 | 0.97s |
| Gemini 3.1 Flash High | 69.5% | $1.75 | 2.99s |
| Deepslate Opal | 62.8% | $6.48 | 0.44s |
Cuatro cosas en esa tabla importan más que la clasificación.
Grok no es el mejor modelo económico bueno, y tampoco es el mejor modelo. El Qwen Audio 3.0 Realtime Plus de Alibaba puntúa más alto con 84.1% y se mide más económico a $4.42/h. Su problema está en la última columna: 4.02 segundos hasta el primer audio, frente a 0.70. En una línea telefónica eso es silencio muerto sobre el que quien llama empezará a hablar. La verdadera propuesta de Grok es la combinación de índice y latencia, y en esa combinación no tiene rival en la tabla.
La tarifa fija es la característica subestimada. Los $4.80 medidos de Grok son idénticos a su precio de lista, porque el precio de lista es fijo por minuto. El GPT-Realtime-2 de OpenAI lista $1.15 por hora de audio de entrada y $4.61 por hora de salida, y se mide en $4.14 todo incluido, así que la tarifa de entrada que le darías a un director financiero es solo alrededor del 28% de lo que realmente pagas. Esa brecha no es un truco, es simplemente lo que hace la facturación de audio por token, y por eso los presupuestos de GPT-Realtime tienden a ser estimaciones en vez de cifras.
Bajar el razonamiento no ahorra dinero de forma confiable. GPT-Realtime-2.1 Minimal se mide en $11.31/h, más que los $10.75 de la variante High, a pesar de puntuar 6.6 puntos menos. Si asumiste que un dial de esfuerzo más bajo era una palanca de costo en voz, esa fila es el contraejemplo.
La latencia tiene su propio piso de precio. Deepslate Opal es lo más rápido medido, con 0.44s, y cuesta $6.48/h con una puntuación de 62.8%. La velocidad se puede comprar por sí sola; velocidad e inteligencia juntas es para lo que sirve la tarifa de Grok.
Vale la pena notar lo que esta tabla no contiene: la capa de plataforma. Proveedores de orquestación como Retell AI cobran una tarifa de plataforma encima de cualquier modelo al que enruten, así que su cifra por minuto y los números de arriba no son el mismo tipo de cifra.
Vapi y Hume cobran de la misma manera. He calculado el costo de ambos en el resumen de empresas de voz con IA, y el patrón se mantiene: una tarifa de modelo y una tarifa de plataforma son productos distintos que llevan las mismas unidades.
La comparación con ElevenLabs merece su propio párrafo porque es la que cambió hoy. Sus planes de agente son asignaciones de minutos prepagados: $6 por 75 minutos, $22 por 275, $99 por 1,238, $299 por 3,738, $990 por 12,375. Divide cualquiera de ellos y aterrizas en casi exactamente $0.08 por minuto incluido en cada nivel de pago, que es la nueva tarifa de Grok, al centavo. Hasta esta mañana Grok era un 37.5% más económico que eso. Lo que queda es una diferencia en la forma de facturación más que en el precio: los minutos de ElevenLabs son prepagados y caducan, los de Grok son de pago por uso, así que una línea con volumen irregular o estacional sigue saliendo mejor con Grok, y una línea que funciona a máxima capacidad todo el mes ahora es un volado. En Cartesia Sonic 3 y el resto del campo especializado, se aplica la misma pregunta sobre la forma.
Los límites que cuestan más que la tarifa
Esto me importa más que la cifra por minuto, porque es más fácil vivir con una tarifa que puedes pronosticar que con un techo que golpeas a las 4pm en el Black Friday.
Diez sesiones simultáneas por equipo. Ese es el límite predeterminado publicado en la ficha del modelo, con límites más altos disponibles a solicitud. Diez llamadas simultáneas son una cola entrante pequeña. Si estás dimensionando una línea telefónica real, la solicitud de concurrencia va antes que la tarjeta de crédito, no después.
Sesión máxima de 120 minutos. Suficiente para soporte, pero vale la pena saberlo si tenías ideas sobre asistentes de larga duración.
Sin descuento por lotes y sin nivel prioritario en voz. El descuento por lotes del 20% de xAI se aplica solo a modelos de texto específicos, y el Procesamiento Prioritario a 2x está limitado a Chat Completions y Responses. La voz no tiene ni un carril de descuento ni un carril rápido de pago, lo cual es coherente con un medidor de tiempo real fijo, pero elimina dos palancas que podrías tener en el lado de texto.
El almacenamiento se cobra por separado si tu agente hace recuperación. Las colecciones cuestan $0.10 por GiB al día, los archivos $0.025, las descargas $0.20 por GiB. Pequeño en una base de conocimiento pequeña, y vale la pena una línea en el modelo si estás sincronizando un centro de ayuda completo para soporte multilingüe.
Hay una tarifa de $0.05 por solicitudes bloqueadas. Si una solicitud a la Responses API es detectada violando las políticas de uso antes de la generación, xAI cobra $0.05. No es una línea específica de voz, pero es el tipo de cosa que aparece como un error de redondeo inexplicable en una factura grande.
Una sola región. La voz a voz corre únicamente en us-east-1, lo cual es un hecho de latencia y residencia de datos más que de precio, aunque se convierte en un precio en el momento en que una revisión de compras pregunta por ello.
Dónde realmente aterriza la cuestión de precios
Aquí está la decisión que yo tomaría con todo esto sobre la mesa.
Si operas una línea telefónica entrante donde quienes llaman interrumpen, cambian de opinión y esperan que el agente realmente haga algo, la tarifa de $0.08 es justa y el cambio de alias es un aumento que vale la pena aceptar. La dinámica conversacional con +17.3 puntos y la latencia de 0.70 segundos son las dos cosas que quienes llaman sienten, y ningún otro modelo en la tabla combina eso con un índice de 82.9%.
Si tu agente de voz solo lee estados de pedidos, fija hoy grok-voice-think-fast-1.0 y mantén la tarifa de $0.05. El razonamiento de habla ya era 97.1% en 1.0. No estás dejando calidad sobre la mesa para la carga de trabajo que realmente tienes, y a 10,000 minutos al mes, fijar la versión vale $300.
Si aún no has construido la línea, la cifra que hay que modelar no es en absoluto el precio por minuto. Es el costo por caso resuelto, y eso significa saber qué fracción de llamadas termina sin un humano. Esa es la misma aritmética detrás de cualquier caso de ROI de centro de llamadas, y vale la pena ponerla junto a la línea base de costo de IA frente a agente humano antes de firmar nada.
Una cifra más blanda también pertenece a ese modelo. Un agente más rápido y menos interrumpible mueve el CSAT, y el CSAT es lo que evita que una línea automatizada económica te cueste clientes en silencio. Es la línea más difícil de pronosticar y la más fácil de notar una vez que se resbala.
La factura de voz es la mitad pequeña del problema
Construyo el SEO de eesel y leo las notas de ventas, y las conversaciones de precios que salen mal casi nunca salen mal por una tarifa por minuto. Salen mal por la unidad.
Lo he escuchado desde ambos extremos de la curva de volumen. Un líder de operaciones en una fintech de pagos y transferencias de dinero sobre Zendesk, con 7,000 a 8,000 tickets escalados al mes, me dijo que el precio por interacción era inviable frente a la facturación por sesión, porque con aproximadamente cuatro intercambios por ticket, el medidor cuenta la conversación cuatro veces. Un operador de comercio electrónico multiempresa que escalaba hacia 150,000 tickets al mes proyectó alrededor de $30,000 al mes a 20 centavos por ticket y pasó la mayor parte de una llamada intentando averiguar si la unidad era una interacción o un ticket. Ninguno de esos dos era un argumento sobre si la tarifa era demasiado alta. Ambos eran argumentos sobre qué estaba contando la tarifa.
Esa es la lente que aplicaría a la tarifa de Grok, y sale bien con ella. Un medidor de audio fijo por minuto es la unidad más legible en esta categoría. También es, estructuralmente, una unidad que te cobra por tiempo en lugar de por resultados, que es exactamente la unidad correcta para una llamada telefónica y exactamente la incorrecta para una cola de tickets.

¿Estás calculando el costo de una línea de Grok Voice? La otra mitad de esa hoja de cálculo es el volumen de correo y chat que nunca hace sonar el teléfono, y no se cobra por minuto. eesel es un agente de mesa de ayuda con IA que cobra por ticket realmente resuelto, se conecta con Freshdesk o Gorgias en pocos minutos, y se entrena con tus tickets pasados en vez de un rastreo del sitio web.
La parte que importa para un pronóstico: ejecuta una simulación de desviación contra tu historial real de tickets antes de responder a un cliente real, así que la tasa de resolución que pones en la hoja de cálculo es una que mediste en tu propia cola, no una que tomaste prestada de una clasificación. Prueba eesel gratis, o mira los precios primero, ya que esa es aparentemente la página que decide todo.
Lo que haría antes de que llegue la factura
Tres movimientos concretos, en el orden en que los haría.
- Busca
grok-voice-latestcon grep. Si está en código de producción, estás en la nueva tarifa desde hoy. Decide si eso es lo que quieres, y luego fija una versión de todas formas, porque la propia documentación de xAI recomienda fijar versiones para producción, y esta es exactamente la razón. - Vuelve a pronosticar incluyendo las llamadas a herramientas en el modelo. Toma los minutos del mes pasado, añade 15% a 20% por invocaciones de herramientas y telefonía, y compara la cifra con la calculadora de arriba. La línea de audio nunca es toda la línea.
- Solicita el aumento de concurrencia antes de necesitarlo. Diez sesiones simultáneas es el predeterminado, no el techo. Aumentarlo es una solicitud, y las solicitudes tardan más que los picos de tráfico.
Nada de eso es una razón para evitar el modelo. Think Fast 2.0 es el modelo de voz agéntico más fuerte con cifras publicadas, y a $4.80 por hora medido cuesta menos de la mitad de lo que cuesta el mejor nivel en tiempo real de OpenAI. Es solo una razón para saber cuál de tus cadenas de modelo es un objetivo móvil, y qué le hace eso a tu factura cuando se mueve. La misma disciplina aplica al manejo de escalaciones y a prevenir respuestas incorrectas: el predeterminado raramente es la configuración que habrías elegido a propósito.
Para el resto de este clúster, el resumen de Think Fast 2.0 cubre qué cambió en el modelo mismo. La publicación sobre precios del Voice Agent Builder cubre la plataforma sin código que se apoya encima, y hay una reseña práctica del Builder si prefieres el flujo de trabajo en vez de la tarifa.
¿Todavía decidiendo si la voz es siquiera el canal correcto? Empieza con puede la IA responder llamadas de soporte, y luego con la explicación más amplia sobre llamadas telefónicas con IA.
Si quienes te llaman ya te contactan a través de un producto telefónico de mesa de ayuda como Zendesk Talk, la pregunta de construir versus comprar viene antes que la de precio por minuto. Mi resumen de automatización del soporte es el camino corto para resolverla.
Preguntas frecuentes
¿Cuánto cuesta Grok Voice Think Fast 2.0 por minuto?
¿Por qué subieron un 60% los precios de Grok Voice?
grok-voice-latest pasó de 1.0 a 2.0 el 5 de agosto de 2026, así que cualquiera que use el alias adoptó la tarifa más alta sin ningún despliegue propio. Fijar la versión es la solución, y es la misma disciplina de fijación de versiones de la que depende prevenir respuestas de IA incorrectas.¿Es Grok Voice Think Fast 2.0 más económico que la Realtime API de OpenAI?
¿Existe un nivel gratuito para Grok Voice Think Fast 2.0?
¿Cuánto cobra realmente una llamada de soporte real de Grok Voice?
web_search o x_search, $2.50 por cada 1,000 consultas a colecciones, $10 por cada 1,000 búsquedas de archivos adjuntos. Modela las llamadas a herramientas, no solo los minutos, igual que harías al calcular el costo de la automatización de centros de llamadas.