

xAI hat Grok 4.6 am 12. August 2026 veröffentlicht, fünf Wochen nach Grok 4.5. Es ist ein echter Sprung nach vorn: Artificial Analysis sieht es bei 60,92 im Intelligence Index, Platz sechs von 95 gemessenen Modellen, statistisch gleichauf mit GPT-5.6 Sol Max (60,93), und es belegt bei GPQA Diamond mit 94,9 % den ersten Platz von 246 Modellen. Das gelingt zu $2 Input und $6 Output pro Million Tokens, womit es das punktbeste Modell auf der Liste zu diesem Preis ist.
Hier der Teil, den die Launch-Berichte ausgelassen haben. Der Listenpreis hat sich nicht geändert, die Rechnung aber schon. Der gecachte Input von Grok 4.6 kostet $0,50 pro Million gegenüber $0,30 bei Grok 4.5, und es schreibt 47 % mehr Output pro Aufgabe. Artificial Analysis hat gemessen, dass dieselbe Benchmark-Suite $1.068 mit Grok 4.6 gegenüber $579 mit Grok 4.5 kostete, ein Sprung um das 1,84-Fache bei identischen Listentarifen. Cache-Lesen und -Schreiben machen 57 % der Rechnung von 4.6 aus. Wenn Ihre Workload bei jeder Anfrage einen großen festen Prompt erneut sendet, was eine Support-Warteschlange genau tut, bekommen Sie nicht „den gleichen Preis“.
Und für alle, die das Modell vor Kunden setzen wollen: Die Zahl, die sich in die richtige Richtung bewegt hat, ist die Halluzinationsquote, von 54,1 % auf 34,3 % gesunken. Das ist eine echte Verbesserung, und es ist trotzdem noch eine falsche Antwort von dreien. Ich habe erlebt, wie der Agent von eesel selbstsicher Arbeit beschrieben hat, die er nie erledigt hatte. Deshalb lasse ich jeden Rollout gegen die historischen Tickets eines Kunden laufen, bevor er einem echten Menschen antwortet. Ein besseres Modell hebt die Decke an. Den Boden baut es nicht.
Was Grok 4.6 eigentlich ist
Die Get-started-Seite nennt es mit den Worten von xAI selbst „SpaceXAI's frontier model built for coding, agentic tasks, and knowledge work“. Der Firmenname wird in den eigenen Docs im Fließtext inzwischen tatsächlich als „SpaceXAI“ geschrieben, während die Domains, das Paket xai_sdk und der Provider @ai-sdk/xai weiterhin xAI sagen. Ich gebe das so wieder, wie es veröffentlicht ist, und glätte es nicht.
Interessant ist die Verschiebung in der Positionierung. Grok 4.5 wurde auf seiner eigenen Modellseite eng gefasst, als „coding model for agentic software, engineering, and workflow tasks“. Der Modellindex verweist jetzt sowohl bei der Code- als auch bei der Chat-Empfehlung auf 4.6 und nennt es „our flagship model for code and everything else.“ xAI führt damit seine Spezialisten-Linie wieder in ein universelles Flaggschiff zurück.
Das Datenblatt, komplett von den eigenen Seiten von xAI:
| Eigenschaft | Grok 4.6 |
|---|---|
| API-Modellname | grok-4.6 (keine Aliase veröffentlicht) |
| Kontextfenster | 500.000 Tokens |
| Output-Limit | „No text output limit“, laut Docs |
| Wissensstand | 1. Februar 2026 |
| Reasoning-Aufwand | low / medium / high / xhigh, Standard high, nicht abschaltbar |
| Modalitäten | Text und Bild rein, Text raus; Bilder max. 20 MiB, nur jpg oder png |
| Integrierte Tools | Function Calling, Websuche, X-Suche, Code-Ausführung |
| Rate Limits | 150 Anfragen/Sek., 50 Mio. Tokens/Min. |
| Regionen | nur us-east-1 und us-west-2 |
| APIs | Responses API und Chat Completions |
Drei dieser Zeilen verdienen einen zweiten Blick.
xhigh ist die eine wirklich neue Fähigkeit. Es ist eine vierte Reasoning-Stufe über dem Standard high und existiert nur in 4.6. Die Falle liegt bei älteren Modellen: Die Reasoning-Docs von xAI sagen, dass bei Modellen, die es nicht unterstützen, „such as grok-4.5, requests with xhigh are treated as high.“ Ein stilles Downgrade, kein Fehler. Wenn Sie eine Konfiguration mit xhigh ausliefern und bei einem Vorfall auf 4.5 zurückfallen, verrät Ihnen nichts in Ihren Logs, dass das Modell stillschweigend aufgehört hat, sich so anzustrengen.
Der Wissensstand ist der 1. Februar 2026, und xAI ist bei den Folgen deutlich. Die Modellseite hält fest: „Grok has no knowledge of current events or data beyond what was present in its training data.“ Alles Aktuelle erfordert serverseitig aktivierte Web Search oder X Search, und die werden zusätzlich zu den Tokens mit $5 pro 1.000 Aufrufe berechnet. Für einen Support-Einsatz heißt das: Bestellstatus, aktueller Lagerbestand, die Richtlinienänderung dieser Woche kommen nicht vom Modell, sondern alle aus Ihren eigenen Systemen.
Keine Aliase. Die Seite von Grok 4.5 listet grok-4.5-latest und grok-build-latest, die Seite von 4.6 hat gar keine Alias-Zeile. grok-4.5-latest zeigt also weiterhin auf 4.5, und wenn Sie sich auf ein -latest-Tag verlassen haben, um automatisch Upgrades mitzunehmen, haben Sie dieses nicht bekommen.
Die Benchmarks, richtig gelesen
Ich möchte hier zwei Dinge trennen, weil die eigene Launch-Tabelle von xAI sie vermischt. Drei der zehn Zeilen sind unabhängige Messungen von Artificial Analysis, die erneut veröffentlicht wurden. Die anderen sieben sind eigene Läufe von xAI ohne externe Bestätigung. Beide sind lesenswert, aber nur eine Sorte ist ein Beleg.
Beginnen wir mit den unabhängigen Daten. Artificial Analysis bewertet Grok 4.6 (high) mit 60,92 im Intelligence Index v4.1.1, einem Komposit aus neun Evals, und setzt es auf Platz sechs von 95 gemessenen, nicht veralteten Einträgen bei einem Klassenmedian von 34.
| Rang | Modell | Intelligence Index |
|---|---|---|
| #1 | Claude Opus 5 (max) | 63,05 |
| #2 | Claude Opus 5 (xhigh) | 62,52 |
| #3 | Claude Fable 5 (max) | 62,07 |
| #4 | Claude Opus 5 (high) | 61,48 |
| #5 | GPT-5.6 Sol (max) | 60,93 |
| #6 | Grok 4.6 (high) | 60,92 |
| #7 | Kimi K3 (max) | 59,70 |
| #14 | Grok 4.5 (high) | 55,76 |
Der Abstand zwischen Platz fünf und sechs beträgt 0,007 Indexpunkte, die Aussage von xAI, 4.6 „matches GPT-5.6 Sol“, ist also fair und keine Schönfärberei. Interessant macht es die Preisspalte daneben: Jedes Modell, das über Grok 4.6 liegt, berechnet $12 oder $25 pro Million Output-Tokens, Grok 4.6 berechnet $6.
Pro Benchmark, im Vergleich zum Vorgänger:
| Benchmark | Grok 4.6 | Grok 4.5 | Veränderung |
|---|---|---|---|
| GPQA Diamond | 94,9 % (#1 von 246) | 93,1 % | +1,8 |
| Terminal-Bench v2.1 | 88,4 % (#3) | 81,6 % | +6,8 |
| Tau-3-Banking (agentische Tool-Nutzung) | 50,7 % (#2) | 42,1 % | +8,6 |
| GDPval-AA v2 (Elo) | 1753 (#3) | 1526 | +227 |
| AA-Briefcase (Elo) | 1577 (#4) | 1313 | +264 |
| AA-LCR (langer Kontext) | 75,0 % (#27) | 74,0 % | +1,0 |
| Humanity's Last Exam | 42,9 % (#15) | 42,7 % | +0,2 |
| SciCode | 53,6 % (#16) | 54,1 % | -0,5 |
GPQA Diamond ragt heraus, und es ist ein echter erster Platz unter 246 Modellen, vor Gemini 3.1 Pro und GPT-5.6 Sol Max mit 94,1 %. SciCode ist die einzige Stelle, an der 4.6 schlechter wurde, um einen halben Punkt, was eher Rauschen als eine Rückschritt-Geschichte ist.
Zwei ehrliche Einschränkungen. Erstens: Für Grok 4.6 gibt es noch keine Geschwindigkeitsdaten. Die Timing-Objekte von Artificial Analysis sind auf der Seite leer, und die Performance-Quelle wird als First-Party von xAI gekennzeichnet. Ich kann Ihnen also weder Tokens pro Sekunde noch Time-to-first-Token nennen, und ich übertrage die 55,62 Tokens/Sek. von 4.5 nicht und tue so, als gälten sie hier. Zweitens: Die eigene Tabelle von xAI nennt Terminal-Bench v3.0 mit 26 %, während Artificial Analysis Terminal-Bench v2.1 mit 88,4 % nennt. Das sind unterschiedliche Benchmarks mit völlig verschiedenem Schwierigkeitsgrad, und sie in einen Satz zu packen, lässt einen Beitrag versehentlich einen Einbruch um 62 Punkte andeuten. Im schwereren v3.0-Set liegt Grok 4.6 laut der Tabelle von xAI hinter GPT-5.6 Sol mit 34,6 % und Fable 5 mit 34,1 %. Anerkennung an xAI dafür, die Zeilen zu veröffentlichen, bei denen es verliert.
Der eine Benchmark, der für ein Support-Team zählt
Alles oben ist eine Rangliste. Das hier ist die Zahl, die entscheidet, ob das Modell mit Ihren Kunden sprechen kann.
Artificial Analysis führt AA-Omniscience aus, das richtige Antworten belohnt, erfundene bestraft und „Ich weiß es nicht“ nicht bestraft.
| Kennzahl | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Omniscience Index | 30,48 | 25,32 |
| Genauigkeit | 48,2 % | 51,6 % |
| Halluzinationsquote | 34,3 % | 54,1 % |
Lesen Sie das genau, denn es ist das interessanteste Ergebnis im ganzen Datensatz. Die rohe Genauigkeit von Grok 4.6 ist tatsächlich um 3,4 Punkte gesunken. Der Omniscience-Wert stieg trotzdem, weil die Halluzinationsquote um fast 20 Punkte gefallen ist, von 54,1 % auf 34,3 %. Das Modell wurde besser, indem es seltener Dinge erfindet, nicht indem es mehr weiß.
Das ist die richtige Richtung, und es ist auch der Grund, warum ich ihm keine unbeaufsichtigte Warteschlange geben würde. Ein Drittel seiner selbstsicheren Antworten ist weiterhin falsch. Bei einem Support-Ticket ist eine falsche, flüssig gelieferte Antwort schlimmer als gar keine, weil der Kunde danach handelt. Was Sie hier rettet, ist kein größeres Modell, sondern ein Schwellenwert für den Konfidenzwert, eng gefasstes Grounding in Ihren eigenen Inhalten und eine saubere Eskalation, wenn das Modell unsicher ist. Das ganze Muster habe ich in AI-Halluzinationen im Support verhindern beschrieben, die Testseite in Adversarial Testing.
Ich setze hier lieber die Glaubwürdigkeit von eesel aufs Spiel als die eines Wettbewerbers. Der schlimmste Fehlermodus, den ich im eigenen Produkt von eesel gesehen habe, protokolliert in der Produktion, war kein sachlicher Ausrutscher. Es war dieser:
"The agent fabricates success. Worst observed pattern: narrating 'executing Zendesk searches' for ~10 turns without ever hitting the API; reporting files 'saved' that don't exist; fabricating metrics. Nothing kills a teammate faster than lying about what it did."
Das stammt aus den internen Engineering-Notizen von eesel, nicht aus der Bewertung eines Wettbewerbers. Es ist der konkrete Grund, warum ich vor dem Go-live simuliere, statt einem Benchmark zu vertrauen, und warum mir eine Verbesserung der Halluzinationen um 19 Punkte ermutigend, aber nicht ausreichend erscheint.
Was Grok 4.6 kostet und die eine Zeile, die sich bewegt hat
Hier die vollständige Live-Tabelle von der Preisseite von xAI, jedes Textmodell, beide Kontextbänder, ohne Rundung.
| Modell | Kontext | Input | Gecacht | Output | Lang: in / gecacht / out |
|---|---|---|---|---|---|
grok-4.6 (Neu) | 500k | $2,00 | $0,50 | $6,00 | $4,00 / $1,00 / $12,00 |
grok-4.5 | 500k | $2,00 | $0,30 | $6,00 | $4,00 / $0,60 / $12,00 |
grok-build-0.1 | 256k | $1,00 | $0,20 | $2,00 | $2,00 / $0,40 / $4,00 |
grok-4.3 | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-multi-agent-0309 | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-0309-reasoning | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-0309-non-reasoning | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
Nebenbei: Das Flaggschiff ist nicht das Modell mit dem größten Kontext, das xAI verkauft. grok-4.3 und die ganze 4.20-Familie haben 1M Kontext, 4.6 hat 500k. Wenn Ihre Aufgabe darin besteht, ein riesiges Dokument in einen einzigen Aufruf zu stopfen, ist das ein Jahr alte Modell dasjenige, das es aufnehmen kann.
Nun die Zeile, die sich bewegt hat. Input, Output und Kontextfenster sind zwischen 4.5 und 4.6 identisch. Die einzige Spalte, in der sie sich unterscheiden, ist der gecachte Input, mit $0,50 bei 4.6 gegenüber $0,30 bei 4.5, eine Lücke von 67 %. Wichtig ist die genaue Richtung: xAI hat Ihnen nicht mitten im Flug einen Preis erhöht. Der Cache-Tarif von 4.5 wurde irgendwann nach seinem Juli-Launch auf $0,30 gesenkt, und 4.6 erschien mit dem älteren Wert von $0,50. Der praktische Effekt in der heutigen Live-Tabelle ist in beiden Fällen derselbe.
Warum diese eine Zelle wichtiger ist, als sie aussieht:
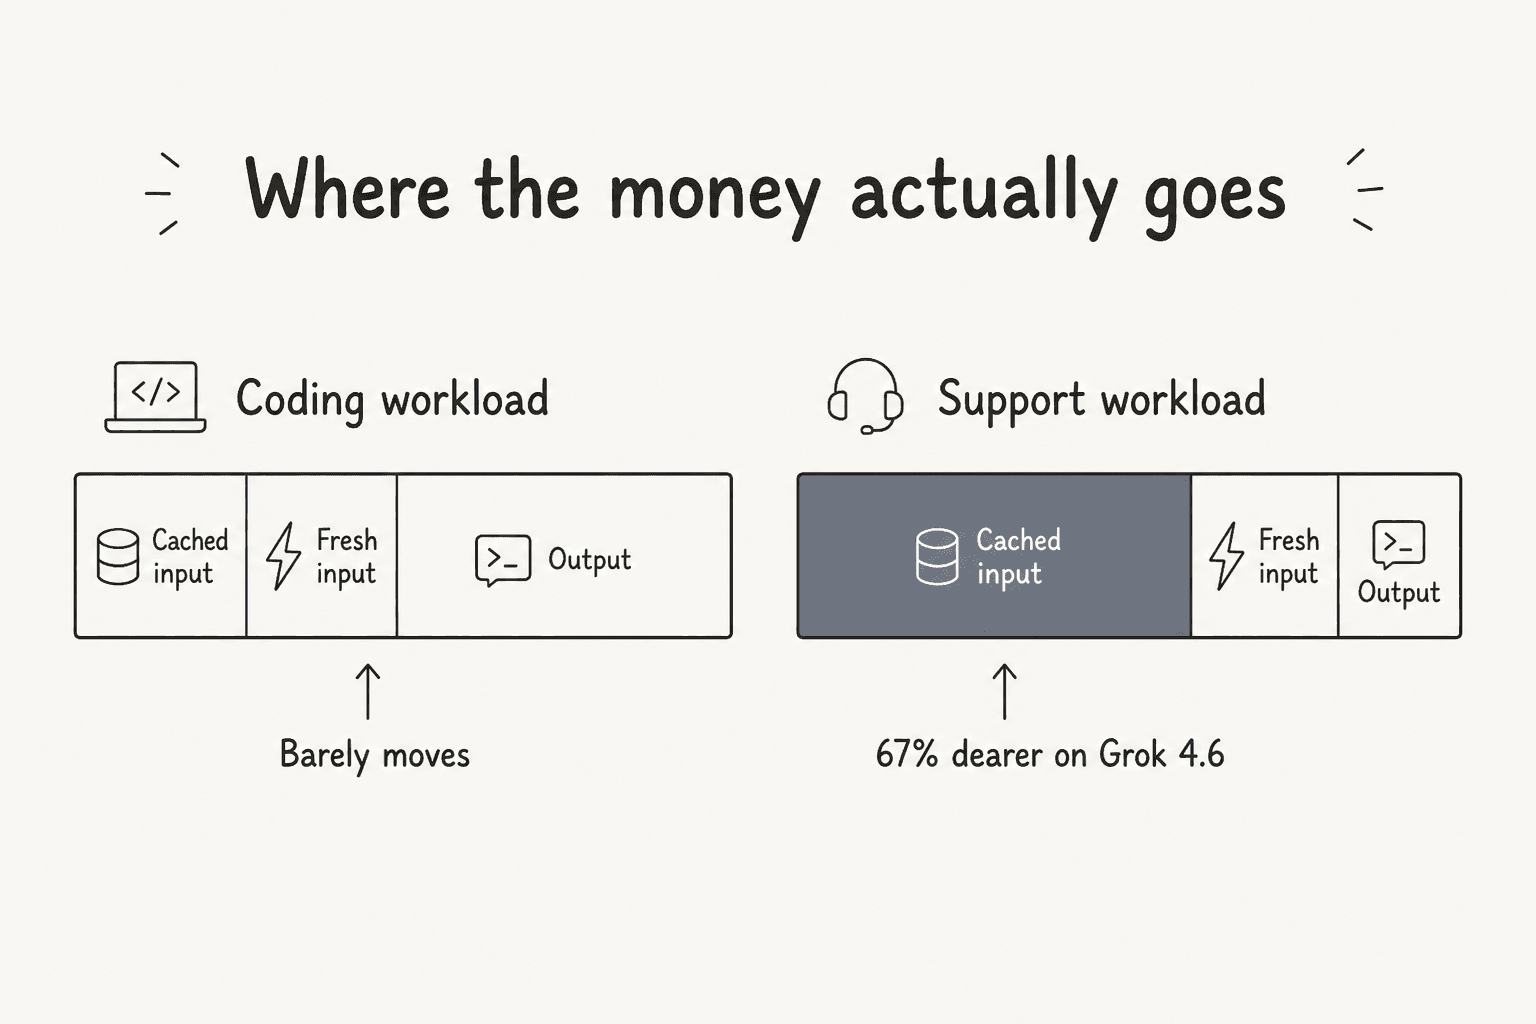
Eine Coding-Sitzung ist output-lastig: lange Generierungen, ein Kontext, der sich ständig ändert. Eine Support-Workload ist das Spiegelbild. Jedes Ticket sendet erneut denselben System-Prompt, dieselben Tonregeln, denselben Block Help-Center-Inhalt und bekommt drei Sätze zurück. Das ist eine vom Cache dominierte Rechnung, und gecachter Input ist der eine Tarif, bei dem 4.6 das teurere Modell ist.
Sie müssen mir die Größe des Effekts nicht glauben, denn Artificial Analysis veröffentlicht seine tatsächlichen Ausgaben. Die Intelligence-Index-Suite zu fahren kostete:
| Kostenposten | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Cache-Lesen | $357,94 | $84,70 |
| Cache-Schreiben | $253,63 | $111,33 |
| Reasoning-Tokens | $374,97 | $312,20 |
| Antwort-Tokens | $57,96 | $46,98 |
| Nicht gecachter Input | $23,96 | $24,01 |
| Gesamt | $1.068,47 | $579,21 |
| Pro Aufgabe | $0,8367 | $0,3601 |
Das 1,84-Fache der Gesamtrechnung bei gleichem Listenpreis, und Cache-Lesen plus -Schreiben machen 57 % davon aus. Ein Teil davon ist der Tarif, ein Teil ist Verhalten: 4.6 erzeugte 21.735 Output-Tokens pro Aufgabe gegenüber 14.795 bei 4.5, ein Anstieg um 47 %, und verbrauchte das 2,4-Fache an Input-Tokens. Token-Effizienz war die Launch-Geschichte von Grok 4.5, und das Urteil von Artificial Analysis zur Wortreichheit kippte zwischen den beiden Releases von „better than average“ auf „somewhat higher than average“. Ein Modell, das härter nachdenkt, kostet mehr, auch wenn die Preiskarte das nicht sagt.
Setzen Sie Ihre eigenen Zahlen ein
Die Form Ihrer Workload entscheidet, ob das Upgrade kostenlos ist oder eine Erhöhung um 25 %. Statt also über Durchschnitte zu streiten, hier die Rechnung mit Ihren Eingaben.
Die zwei Kanten, die keiner liest
Neben dem Cache-Tarif gibt es auf dieser Preisseite zwei Mechaniken, die Sie bei der Rechnung überraschen werden.
Die 200k-Klippe ist ein Umschalten der ganzen Anfrage, keine Stufe. Die Formulierung von xAI ist eindeutig: Modelle mit Long-Context-Preisen berechnen, sobald der Prompt die Schwelle erreicht, die Long-Context-Tarife für alle Tokens einer Anfrage. Ein Prompt mit 201k Tokens kostet nicht das Doppelte für die zusätzlichen tausend Tokens. Er kostet das Doppelte für alle 201.000.
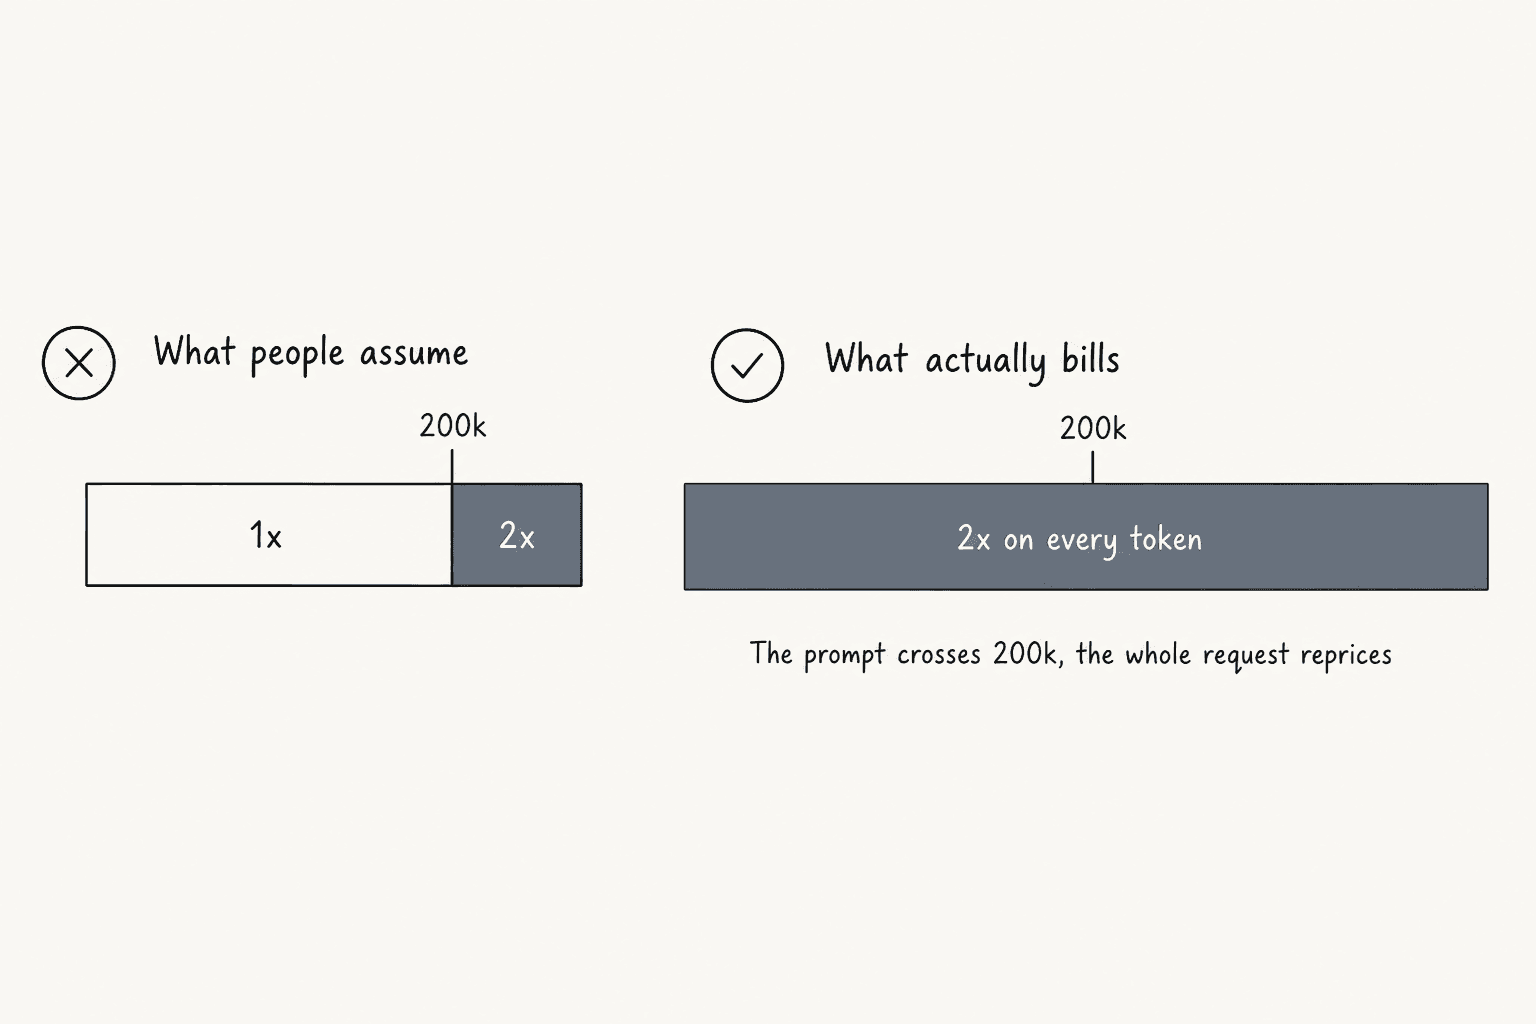
Deshalb drängen die eigenen Docs von xAI so stark auf Context Compaction. Bei einer agentischen Schleife, die Runde um Runde Tool-Ergebnisse ansammelt, ist Compaction eine Kostenkontrolle und keine Aufräumarbeit. Wenn Ihr Agent in Runde neun über 200k driftet, kostet Runde neun vom ersten Token an das Doppelte.
Der günstige Cache-Tarif ist nicht automatisch. Das ist das Nützlichste auf der gesamten 4.6-Seite und für ein Anbieter-Dokument ungewöhnlich offen. Die Get-started-Seite zu 4.6 sagt Ihnen, einen prompt_cache_key zu setzen, oder bei Chat Completions den Header x-grok-conv-id, denn „it routes a conversation's requests to the same server, making cache hits reliable; without it you often pay full input price on a cache-cold server.“ Lesen Sie das noch einmal: Der Standard-Fehlermodus ist, $2,00 statt $0,50 zu zahlen. Wenn Sie gegen Grok 4.6 bauen und einen Header weglassen, kann sich Ihre Rechnung auf der Input-Zeile vervierfachen, und nichts sieht kaputt aus.
Dann gibt es noch die Batch-Umkehrung. Der 20-%-Batch-API-Rabatt gilt für grok-4.3 und die drei grok-4.20-Varianten. Er gilt nicht für 4.6, 4.5 oder grok-build-0.1. Bei einem batchbaren, cache-lastigen Job wie nächtlicher Ticket-Klassifizierung oder Backlog-Triage ist das ein Jahr alte grok-4.3 deutlich günstiger als das Flaggschiff, mit $1,25 Input und $2,50 Output und zusätzlich 20 % Rabatt. Die Preistabelle verbirgt das völlig, und ich würde 4.3 testen, bevor ich annehme, dass das neueste Modell für Massenarbeit das richtige ist.
Zwei kleinere Punkte, die man kennen sollte. Priority Processing ist ein separater 2x-Multiplikator auf alle Token-Arten und wird nur berechnet, wenn die Antwort "service_tier": "priority" bestätigt. Und es gibt eine Gebühr von $0,05 pro Anfrage für Verstöße gegen die Nutzungsrichtlinien, die vor der Generierung in der Responses API erkannt werden, womit Sie fünf Cent für eine Anfrage zahlen können, die nichts erzeugt hat.
Grok 4.6 gegen die anderen Flaggschiffe
Allein nach Listenpreis sieht Grok 4.6 hervorragend aus. Jede Zahl unten stammt von der Seite des jeweiligen Anbieters.
| Modell | Kontext | Input /1M | Gecacht /1M | Output /1M |
|---|---|---|---|---|
| Grok 4.6 | 500k | $2,00 | $0,50 | $6,00 |
| Claude Sonnet 5 | 1M | $2,00 | $0,20 | $10,00 |
| Claude Opus 5 | 1M | $5,00 | $0,50 | $25,00 |
| GPT-5.6 Sol | 1,05M | $5,00 | $0,50 | $30,00 |
| Gemini 3.1 Pro Preview | 1,05M | $2,00 | $0,20 | $12,00 |
| DeepSeek V4 Flash | 1M | $0,14 | $0,0028 | $0,28 |
Beim Output ist Grok 4.6 hier das günstigste Modell außer DeepSeek: $6 gegenüber $10 bei Sonnet 5, $12 bei Gemini 3.1 Pro, $25 bei Opus 5 und $30 bei Sol. Kombiniert mit einem gleichauf liegenden Intelligence-Index-Wert ergibt das ein echtes Ergebnis: Artificial Analysis misst Grok 4.6 mit $0,8367 pro Index-Aufgabe gegenüber $1,2312 bei GPT-5.6 Sol, also dieselbe gemessene Intelligenz für 32 % weniger und 2,8-mal weniger als bei Claude Opus 5 mit $2,3369.
Jetzt die Neubewertung, und hier sollte ein Support-Leser langsamer werden. Schauen Sie auf die Cache-Spalte, nicht auf die Output-Spalte. Claude Sonnet 5 cached für $0,20 gegenüber $0,50 bei Grok 4.6. Sonnet 5 hat außerdem ein 1M-Fenster ganz ohne Long-Context-Aufschlag (Anthropic gibt an, dass eine Anfrage mit 900k Tokens zum gleichen Tarif pro Token abgerechnet wird wie eine mit 9k) und einen pauschalen Batch-Rabatt von 50 %, wo Grok 4.6 keinen bekommt.
Das ehrliche Urteil teilt sich also nach Workload und nicht nach Modell:
- Lange Outputs, wechselnder Kontext, Code-Generierung: Grok 4.6 gewinnt beim Preis klar. $6 Output gegenüber $10 oder $30 sind nicht annähernd gleich, und die Benchmarks stützen die Qualität.
- Kurze Outputs, riesige wiederverwendete Prompts, batchbares Volumen: also eine Support-Warteschlange. Sonnet 5 ist bei dem Posten, der Ihre Rechnung dominiert, 2,5-mal günstiger, hat keine 200k-Klippe, von der man fallen kann, und halbiert sich im Batch. Der günstigere Output von Grok 4.6 spielt kaum eine Rolle, wenn Ihre Antworten drei Sätze lang sind.
Das ist eine nützlichere Antwort als „Grok 4.6 ist günstig“, und man sieht sie nur, wenn man die Cache-Spalte liest. Für das größere Bild zur Modellwahl speziell im Support führt meine Übersicht zum besten AI-Agenten für diese Aufgabe durch, warum das punktbeste LLM selten die richtige Wahl ist, und RAG gegenüber einem rohen LLM deckt die Grounding-Hälfte ab.
Ein Fairness-Hinweis zum Vergleich selbst: Gecachter Input ist bei den Anbietern nicht dasselbe. Anthropic und OpenAI berechnen das Schreiben eines Cache-Eintrags separat, Google berechnet stündliche Cache-Speicherung, und xAI und DeepSeek veröffentlichen auf der Seite einen Lese-Tarif ohne separate Schreibgebühr. Nur die Cache-Spalte zu vergleichen schmeichelt Anthropic und OpenAI leicht. Gemini 3.1 Pro berechnet außerdem Thinking-Tokens als Output, sodass seine $12 bei reasoning-lastiger Arbeit zu niedrig angesetzt sind, und es ist weiterhin ein Preview-Modell.
Wo Sie es tatsächlich bekommen
Für Verbraucher veröffentlicht die eigene Preisseite von xAI weniger Zahlen, als man erwarten würde, weil grok.com seine Preise als animierte Ziffernwalzen darstellt, die keine tatsächliche Zahl enthalten. Veröffentlicht ist Folgendes:
| Stufe | Preis | Hinweise |
|---|---|---|
| Free | $0 | Echtzeit-Web- und X-Suche, Voice-Modus, Connectors. Nennt Grok 4.6 nicht |
| SuperGrok Lite | Nicht veröffentlicht | Zugang zu Grok Build, Expert-Modus, doppelt so lange Chats |
| SuperGrok | $30/Monat | Erste Stufe, die Grok 4.6 als Leistungsmerkmal nennt, 5x längere Chats |
| SuperGrok Plus | $100/Monat | App-Erstellung per Ein-Prompt, 1080p-Video, Vorrang zu Spitzenzeiten |
| SuperGrok Heavy | Nicht veröffentlicht | Höchste Nutzung, größeres Agenten-Team, X Premium+ inklusive |
| Business | $30/Monat pro Nutzer | Seat-Verwaltung, RBAC, Domain-Verifizierung |
| Enterprise | Individuell | SSO, SCIM, Audit-Kontrollen, Datenresidenz, Mengenpreise |
Grok 4.6 wird ab SuperGrok aufwärts als Leistungsmerkmal genannt, nicht im Free-Tarif. Bezahlte Stufen wechselten im Juni 2026 zu einem einzigen gemeinsamen wöchentlichen Nutzungspool über Chat, Imagine, Voice und Build, und xAI veröffentlicht den Mechanismus, aber keine absoluten Nachrichtenzahlen. Das Erreichen des Pools ist kein harter Stopp: Sie fallen auf die Limits der Free-Stufe für Chat und Voice zurück. Extra Usage Credits beginnen bei $5, verfallen nach einem Jahr, und xAI sagt klar, dass sie „priced at standard rates, which means the cost per action is higher than the effective rate you get from the included weekly usage in your plan.“
Die folgenreichere Tatsache für alle, die über die Beschaffung kaufen: Grok 4.6 ist ein Launch über direkte und Partner-APIs, kein Hyperscaler-Launch.
| Kanal | Grok 4.6 zum Start |
|---|---|
| xAI API, Grok Build, OpenRouter | Live am ersten Tag |
| Cursor | xAI sagt live; die eigene Modellseite von Cursor listete weiterhin nur 4.5 |
| Azure AI Foundry | Noch Grok 4.3 |
| AWS Bedrock | Noch Grok 4.3 |
| GitHub Copilot | Noch Grok 4.5 |
Wenn Ihre Organisation auf Bedrock oder Copilot standardisiert hat, erreichen Sie 4.6 noch gar nicht. Wenn Sie auf Azure Foundry sind, kaufen Sie Grok 4.3 für $1,25 und $2,50, was günstiger ist, aber zwei Generationen zurückliegt. Diese Lücke schließt sich irgendwann, und sie spielt jetzt eine Rolle, wenn eine Beschaffungsrichtlinie vorschreibt, dass alle Inferenz über eine einzige Cloud läuft. Es ist dasselbe Muster, das ich bei Grok Bot und Grok Voice Think Fast 2 gesehen habe: xAI liefert zuerst an die eigenen Oberflächen und lässt die Reseller nachziehen.
Was ein Frontier-Modell für eine Support-Warteschlange ändert und was nicht
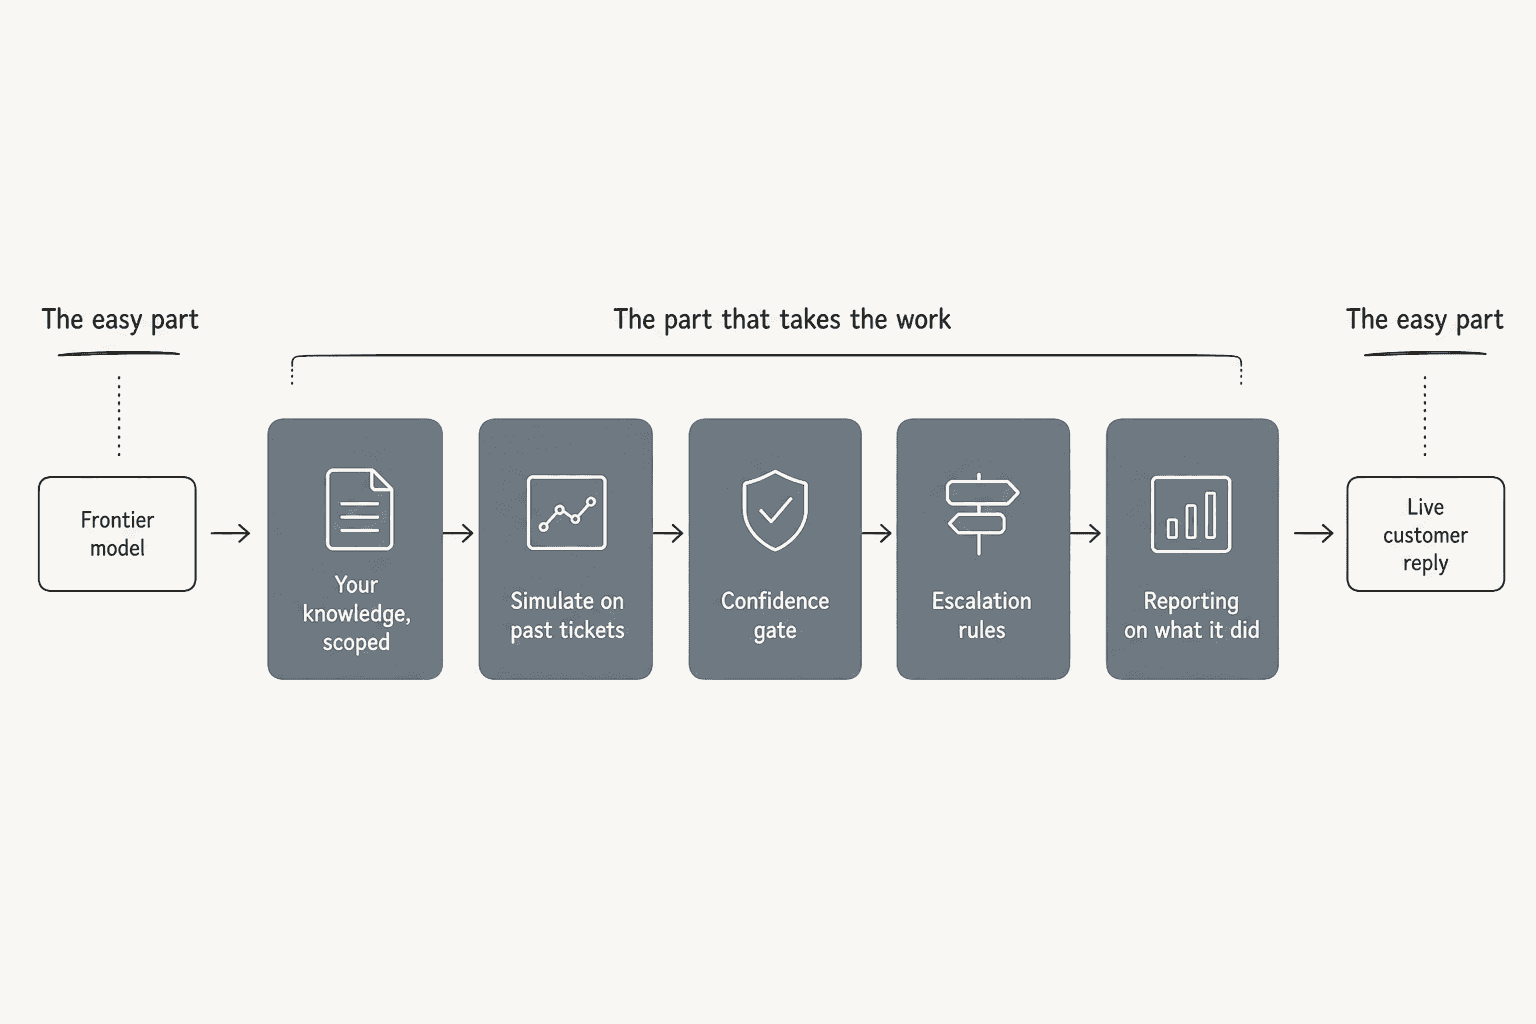
Alle fünf Wochen erscheint ein neues Modell, und die Frage landet in meinem Postfach: Sollen wir wechseln? Nachdem ich die Integrationen gebaut habe, die zwischen einem Modell und einem Helpdesk sitzen, ist meine Antwort fast immer, dass das Modell nicht der Engpass war.
Was Grok 4.6 ehrlich gesagt ändert:
- Agentische Tool-Nutzung wurde besser. 50,7 % bei Tau-3-Banking, Platz zwei von 97, plus 8,6 Punkte. Wenn Ihre Automatisierung mitten im Gespräch ein Bestellsystem oder eine Retouren-API aufruft, macht diese Zuverlässigkeit den Unterschied, ob Workflow-Automatisierung tatsächlich abschließt, statt auf halbem Weg zu stocken.
- Erfindungen gingen stark zurück. 54,1 % auf 34,3 % ist die größte einzelne Verbesserung im Release, und sie zählt am meisten, wenn der Output an einen Kunden geht.
- Kosten pro Einheit Intelligenz verbesserten sich gegenüber Rivalen. 32 % günstiger pro Aufgabe als ein gleichauf liegendes GPT-5.6 Sol ist bei Volumen echtes Geld.
Was es nicht ändert:
- Ihr Wissen bleibt Ihr Wissen. Der Wissensstand Februar 2026 bedeutet, dass das Modell nichts über Ihre Erstattungsrichtlinie, Ihre SKUs oder den Ausfall vom letzten Dienstag weiß. Das kommt vom Training auf Ihrer Wissensdatenbank und vergangenen Tickets, und kein Benchmark-Wert ersetzt das.
- 34,3 % Halluzination brauchen weiterhin eine Schranke. Konfidenz-Schwellenwerte, Guardrails und die Übergabe an einen Menschen, wenn das Modell unsicher ist. Zu messen, ob es überhaupt hätte antworten sollen, ist eine eigene Disziplin, behandelt in Containment-Rate und Eskalationsqualität.
- Der Token-Preis ist der günstigste Posten im Aufbau. Bei den Standardwerten des Widgets kostet Grok 4.6 etwa 1,5 Cent an Tokens pro Konversation. Die Integration, die Triage-Regeln, die Review-Schleife, das Reporting, die Rufbereitschaft, wenn es sich danebenbenimmt: All das überragt die Tokens bei Weitem. Genau deshalb schlagen die Kosten pro Lösung die Kosten pro Million Tokens als Planungszahl.
- Kaufen schlägt für die meisten Teams weiterhin Bauen. Diese Abwägung ist eine eigene Entscheidung, und Build versus Buy ist der Ort, an dem ich damit anfangen würde, nicht in einer Preistabelle.
- Sie können weiterhin nicht sagen, was es bei Ihren Tickets tun wird. Eine Rangliste ist ein Stellvertreter. Ihre Warteschlange ist der Test. Evaluierungspraxis gibt es genau deshalb, weil beide öfter auseinanderliegen, als irgendjemand möchte.
Wenn Sie die Plattformebene statt eines einzelnen Modells wollen, beginnen Sie mit AI-Kundenservice-Software. Für die Kennzahlen, an denen ich einen Rollout messen würde, sind automatisierte Ticket-Lösung und Lösungsrate die beiden, die zählen.
eesel für den Teil, den das Modell nicht übernimmt
Grok 4.6 ist ein gutes Modell. Wenn Sie Code ausliefern, nutzen Sie es, das Verhältnis von Preis zu Punktzahl ist das beste auf der Liste. Ein Support-Agent ist es nicht, und der ehrliche Grund ist, dass ein rohes Modell nicht weiß, was Ihr Team diesem Kunden schon gesagt hat, keine Möglichkeit hat zu erkennen, wann es schweigen sollte, und danach keine Aufzeichnung darüber hat, was es getan hat.
eesel ist diese Schicht. Es bindet sich in wenigen Minuten an Zendesk, Freshdesk, Gorgias und die übrigen an, lernt aus Ihrem Help Center, Ihren Makros und gelösten Tickets, sodass es schon wie Ihr Team klingt, und, den Teil, auf den ich Sie am stärksten hinweisen würde, führt eine Simulation über Ihre eigenen historischen Tickets aus, bevor es einem einzigen Live-Kunden antwortet. Sie sehen die Genauigkeit auf Ihren Daten, füllen die aufgedeckten Lücken, lassen es erneut laufen und gehen erst dann live. Bei einem Modell, das immer noch ein Drittel der Zeit erfindet, ist dieser Probelauf der Unterschied zwischen einem Experiment und einem Vorfall.

Die Preisgestaltung beruht auf einem festen Monatspreis statt auf Tokens: Pläne beginnen bei $299/Monat für 500 Credits, laut Preisseite, mit 1 Credit pro Ticket oder Chat, egal wie viele Antworten es braucht, ohne Seat-Gebühren und ohne Kosten für Tickets, die Ihre Menschen übernehmen. Sie erhalten 100 kostenlose Credits ohne Karte und können zunächst einen Teil routen, sodass 1.000 Tickets im Monat, von denen 200 an die AI gehen, 200 Credits verbrauchen, was in den $299/Monat-Plan passt. Aktivieren Sie optionale Überschreitung mit einem von Ihnen gesetzten Limit, wenn Sie eine harte Obergrenze wollen. Die Seiten zu Sicherheit und Enterprise behandeln die Compliance-Seite, und unsere Kunden zeigen, ob es funktioniert.
Testen Sie eesel kostenlos, führen Sie die Simulation aus und lassen Sie Ihre eigenen Tickets Ihnen sagen, was die Rangliste nicht kann.
Häufig gestellte Fragen
Was ist Grok 4.6 und wann wurde es veröffentlicht?
xhigh. Wenn es Ihnen weniger um das Modell geht und mehr darum, eines in eine Live-Warteschlange zu bringen, ist das die Aufgabe eines AI-Helpdesk-Agenten.Was kostet Grok 4.6 pro 1 Mio. Tokens?
Ist Grok 4.6 günstiger als Grok 4.5?
Kann ich Grok 4.6 für den Kundensupport nutzen?
Wo bekomme ich Grok 4.6 und was kostet SuperGrok?
Ist Grok 4.6 besser als Grok 4.5?
Wie groß ist das Kontextfenster von Grok 4.6 und was macht xhigh?
xhigh ist eine vierte Reasoning-Stufe über dem Standard high und existiert nur in 4.6. Laut den Reasoning-Docs von xAI behandeln ältere Modelle eine xhigh-Anfrage stillschweigend als high, statt einen Fehler zu melden. Bei Support-Workloads ist die Prompt-Größe meist zuerst ein Retrieval-Problem und erst danach ein Problem des Kontextfensters.