

Wie ich getestet habe und wo meine Belege enden
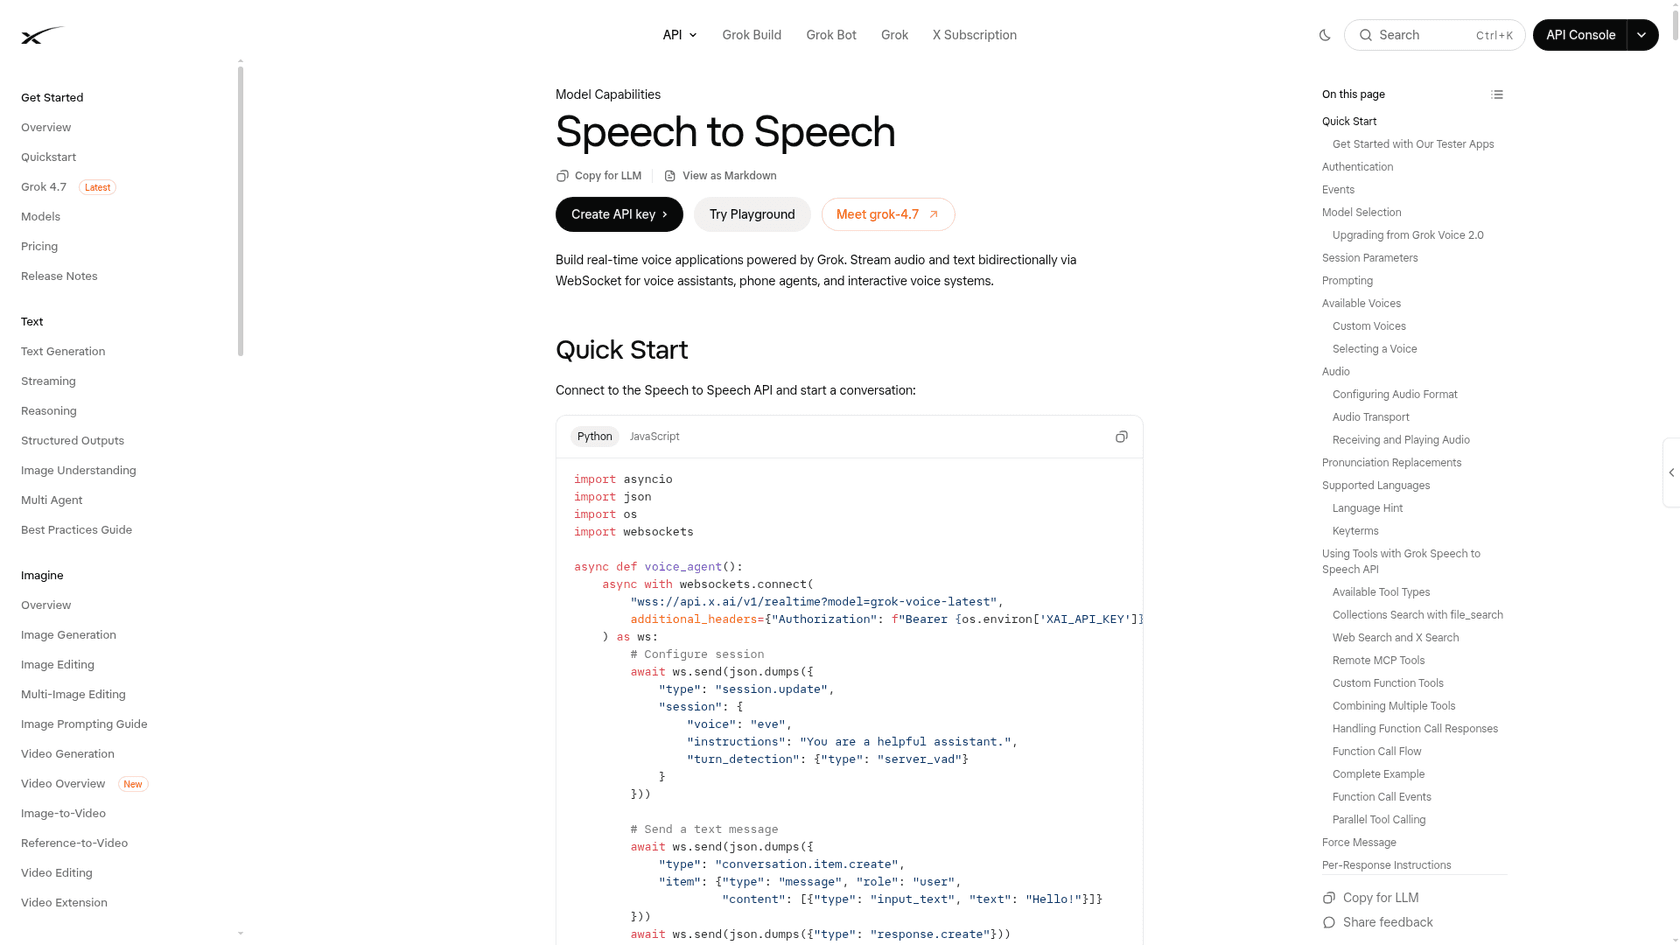
Ich baue bei eesel Integrationen und APIs, die Verbindungsschicht zwischen einem Modell und einem Live-Helpdesk. Dies ist also ein Test aus Entwicklersicht: Ich habe jede Seite der Speech-to-Speech-Dokumentation von xAI gelesen, dazu die Release Notes, die Tabellen zu den Rate Limits sowie das komplette Leaderboard und den Launch-Thread von Artificial Analysis, und alles mit dem verglichen, was ich vor zwei Monaten über Grok Voice 2.0 geschrieben habe.
Was ich nicht behaupten kann, sind tausend Produktionsanrufe auf einer Live-Telefonleitung, denn das Modell ist einen Tag alt. Wenn ich über das Verhalten im großen Maßstab spreche, stammt die Zahl entweder aus einem veröffentlichten Limit oder aus den eigenen Starlink-Zahlen von xAI, und ich sage jeweils, welches von beiden.
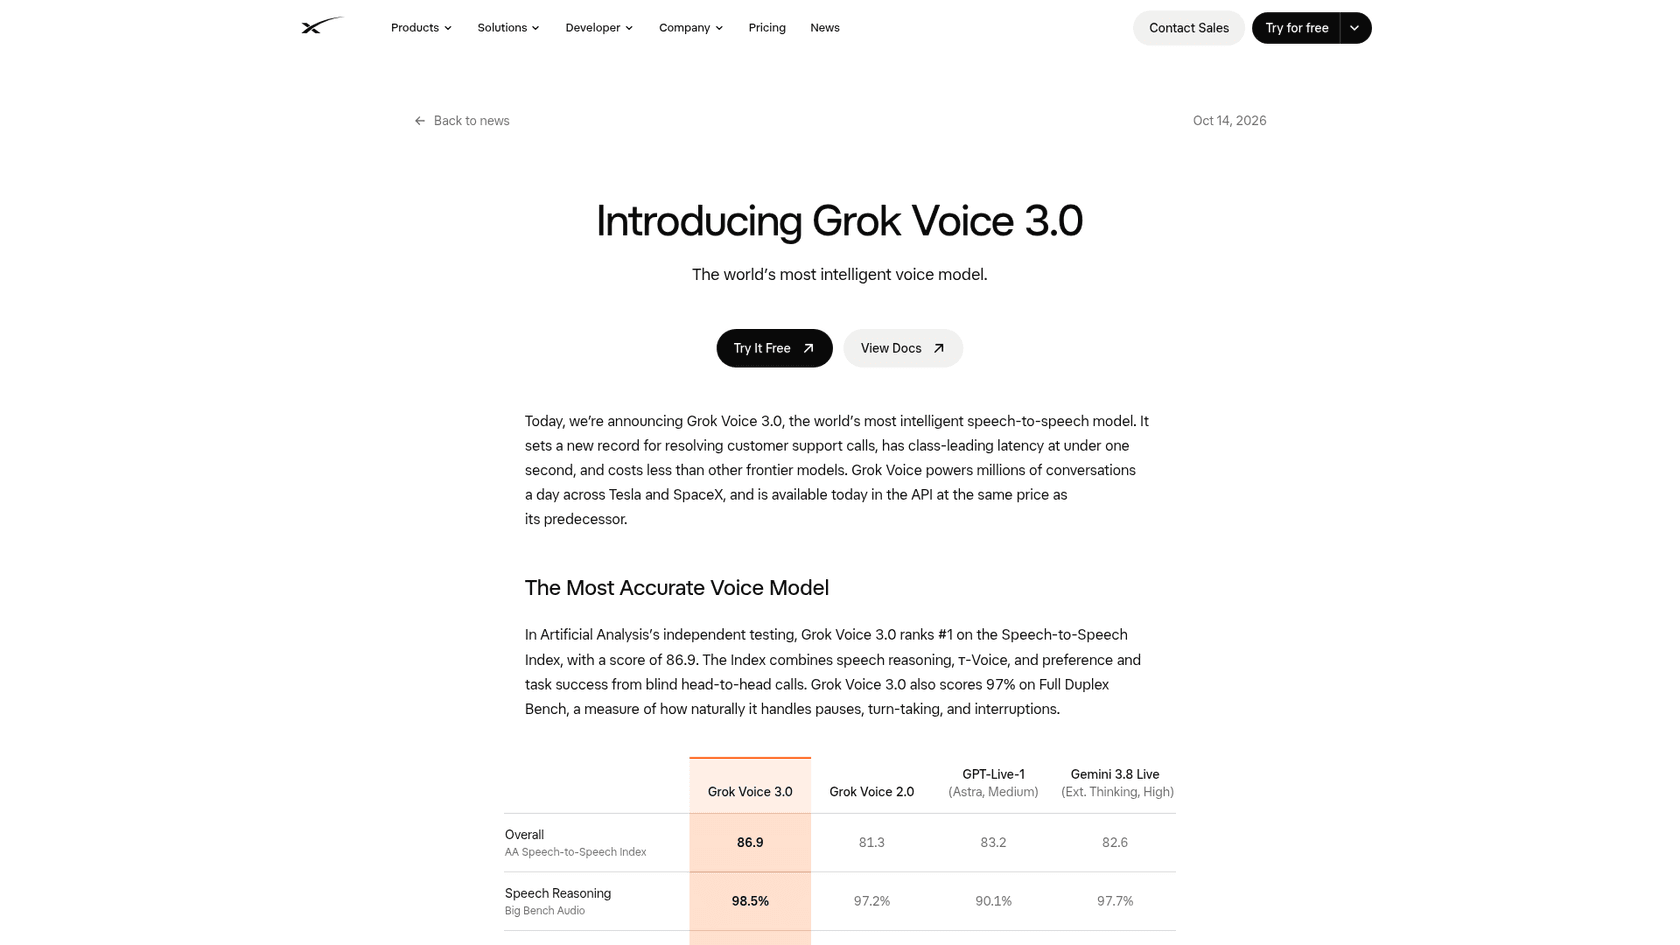
Eine Anmerkung zur Benennung vorab. Die Dokumentation und der Launch-Beitrag von xAI zeichnen jetzt als SpaceXSI, und Artificial Analysis führt den Anbieter als SpaceXAI. Dasselbe Team, dieselbe API unter api.x.ai, dieselbe Grok-Familie. Laut Launch-Beitrag läuft dieselbe Stimme auch im Sprachmodus von Grok Bot und in Tesla-Fahrzeugen. Wenn Sie den ganzen Anbieter abwägen, ist mein Beitrag zu xAI-Alternativen die breitere Sicht.
Die Bewertungstabelle
Ich stelle das ganze Urteil voran und die Details danach.
| Dimension | Grok Voice 3.0 | vs 2.0 | Meine Einschätzung |
|---|---|---|---|
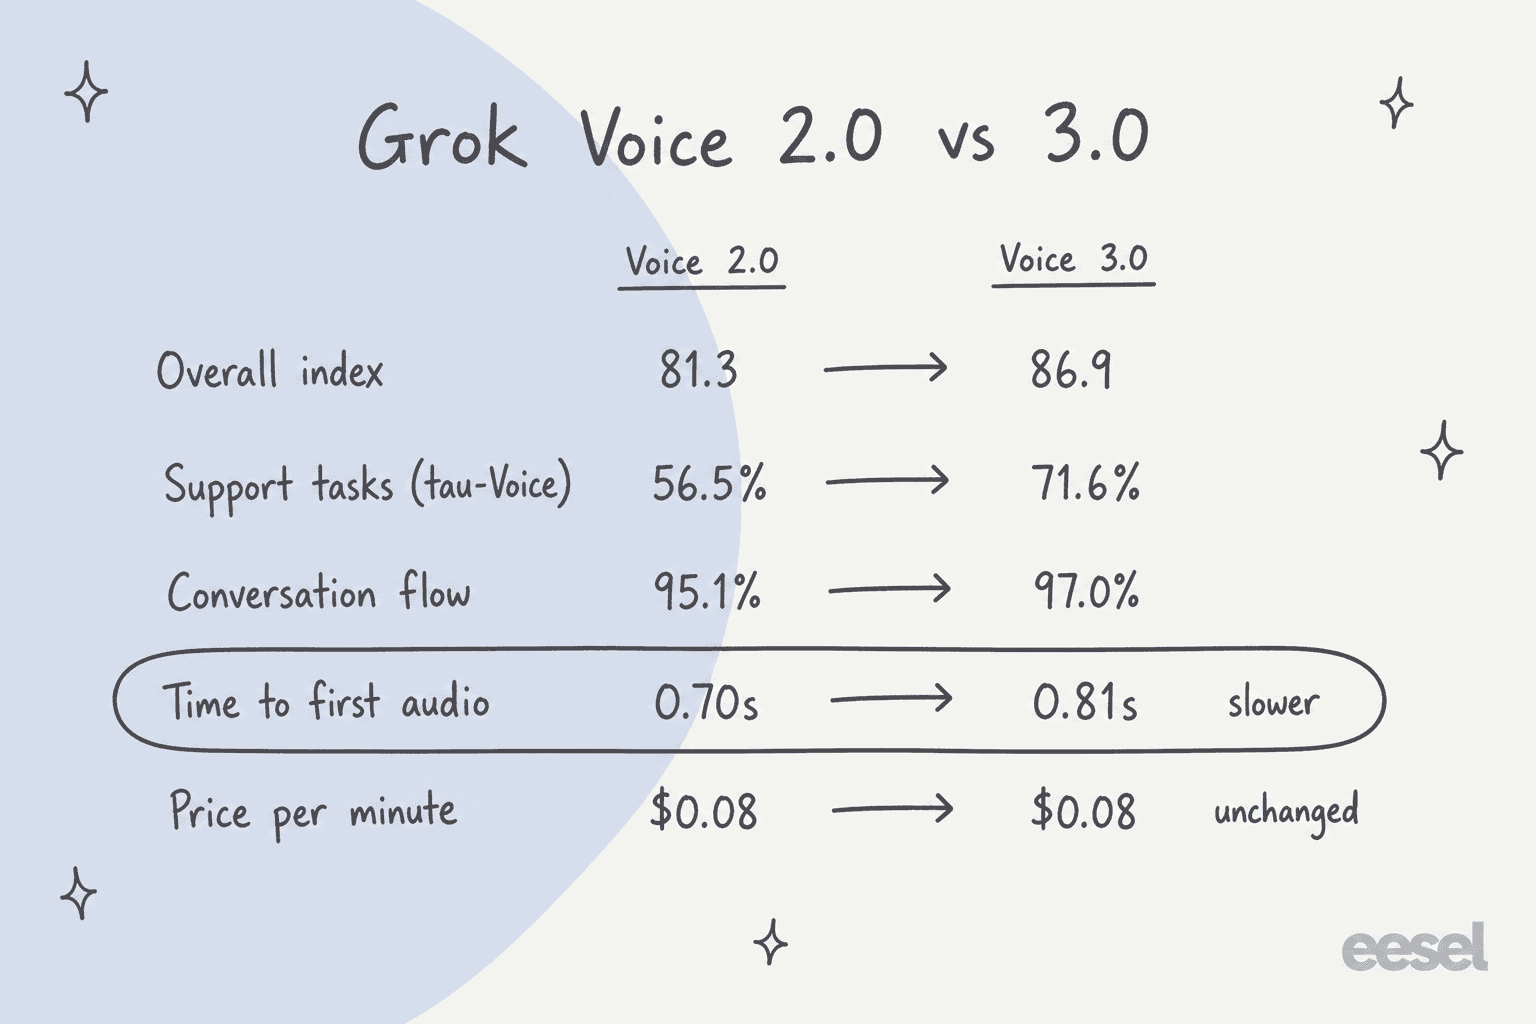
| Gesamt | 86.9 AA-Index, #1 | 81.3 | Bester Durchschnitt in der Tabelle, 3.7 Punkte vor GPT-Live-1 (Astra) |
| Support-Aufgaben | 71.6% τ-Voice, #2 | 56.5% | Das eigentliche Upgrade. 2.9 Punkte hinter GPT-Live-1 (Astra) |
| Aufgabenerfolg in Live-Anrufen | 94.8%, #1 | 94.6% | Schon mit 2.0 nahe an der Decke |
| Menschliche Präferenz | Elo 1070, #3 | 1011 | Zwei Gemini-Modelle klingen für Zuhörer sympathischer |
| Gesprächsfluss | 97.0% Full Duplex Bench | 95.1% | Unterbrechungen und Pausen sind hier ein gelöstes Problem |
| Sprach-Reasoning | 98.5% Big Bench Audio | 97.2% | Winziger Zuwachs, bereits gesättigt |
| Latenz | 0.81s bis zum ersten Audio | 0.70s | Langsamer als 2.0, schneller als jedes Modell in der Nähe im Index |
| Preis | $0.08/min | $0.08/min | Unverändert |
| Parallelität | 10 bis 200 je nach Stufe | 10 fix | Behoben, wenn Sie Geld ausgeben |
| Regionen | us-east-1, eu-west-1, us-saltlake-2 | us-east-1 | EU-Teams können es endlich evaluieren |
Alle Benchmark-Zahlen stammen von Artificial Analysis, deren Launch-Zahlen auch in der Grok-Voice-3.0-Ankündigung von xAI wiederveröffentlicht wurden.
Fazit: Für ein Team, das einen Telefon- oder In-App-Voice-Agenten baut, der Dinge tun muss (eine Bestellung nachschlagen, eine Gutschrift ausstellen, einen Termin buchen), ist das im Moment meine Standardwahl. Legen Sie die Version fest, planen Sie das Budget für die benötigte Stufe ein und lösen Sie das Wissensproblem separat.
Wo es gewinnt
Drei Dinge sind mir aufgefallen, und nur eines davon ist die Zahl, mit der xAI wirbt.
Der Support-Aufgaben-Wert ist die Schlagzeile, nicht der Index
τ-Voice ist der Benchmark, dem ich für alle, die das aus einem Support-Team heraus lesen, am meisten vertraue. Ein simulierter Anrufer ruft das Modell mit einem realitätsnahen Problem an (einen Flug ändern, eine Einzelhandelsbuchung anfechten, ein Telekom-Problem beheben), das Modell agiert als Support-Agent mit Tools und einem Richtliniendokument, und es punktet nur, wenn der endgültige Datenbankzustand exakt stimmt. Artificial Analysis beschreibt die Methode vollständig, bis hin zur Mittelung über drei Durchläufe.
Grok Voice 2.0 erreichte 56.5%. 3.0 erreicht 71.6%, ein Sprung von 15.1 Punkten in einem Release. Das ist der Unterschied zwischen einem Agenten, der vier von neun Anrufen verfehlt, und einem, der etwa zwei von sieben verfehlt, und für eine Warteschlange ist diese Lücke Personalbedarf, kein Rundungsfehler.
Es ist nicht der Spitzenwert. GPT-Live-1 (Astra, medium) liegt bei 74.5%. Aber Astra braucht 1.34 Sekunden, um zu sprechen, gegenüber 0.81s bei Grok, und xAI stützt sich in seinem Launch-Beitrag genau auf diesen Kompromiss. Wenn Sie zwischen beiden wählen, behandelt meine GPT-Live-1-Review die OpenAI-Seite ausführlicher.
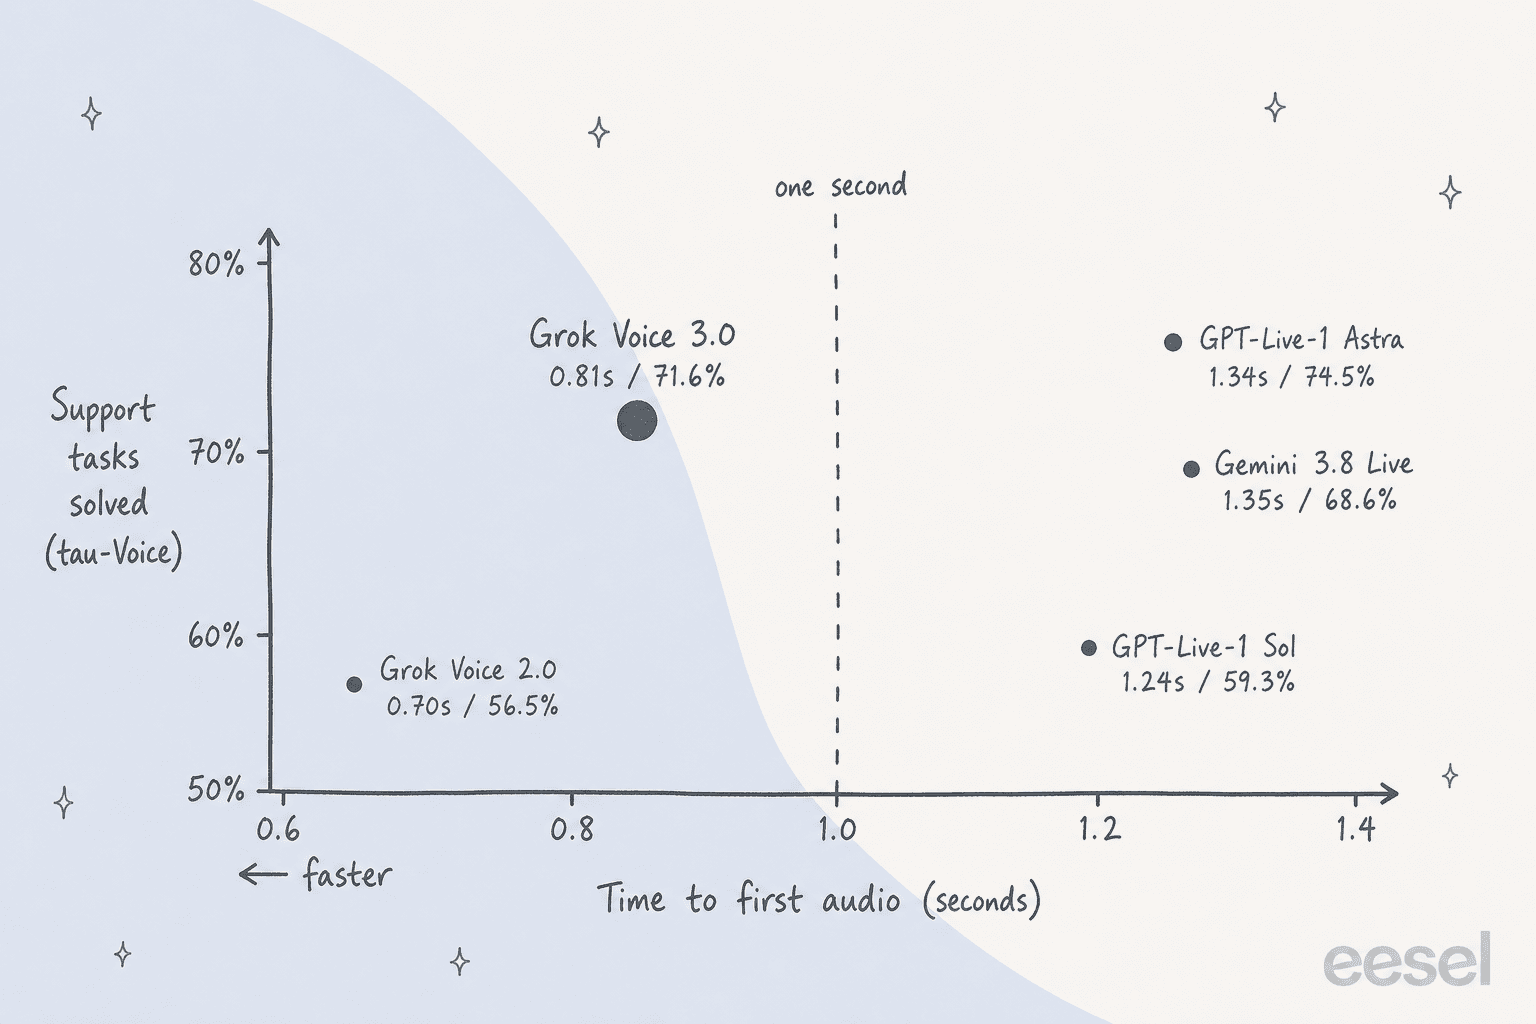
Dieses Diagramm ist ziemlich genau das ganze Argument für Grok Voice 3.0 in einem Bild: Jedes Modell, das mehr als 65% der Support-Aufgaben löst, braucht über 1.3 Sekunden zum Antworten, außer diesem. Der Thread von Artificial Analysis sagt es klar:
"Grok Voice 3.0 and Grok Voice 2.0 the only models in the top 5 of our Speech to Speech Index under 1 second."
Es bringt in Live-Anrufen zu Ende, was es beginnt
Die Task Success Rate stammt aus der Speech Agent Arena von Artificial Analysis, in der echte Menschen Live-Gespräche mit zwei verdeckten Modellen führen (einen Zahnarzttermin buchen, in dieser Art). Grok Voice 3.0 schließt 94.8% der Aufgaben ab, der höchste Wert auf der Tafel, knapp vor Gemini 3.8 Live mit 93.2%.
Eine Fußnote, die es wert ist: Grok Voice 2.0 lag schon bei 94.6%, hier hat sich 3.0 also nicht verbessert. Es ist ein Bereich, in dem die Grok-Reihe bereits stark war, und 3.0 hat ihn gehalten und ist bei den schwierigeren τ-Voice-Fällen besser geworden.
Die Starlink-Zahlen, mit angehängter Einschränkung
xAI sagt, dass die Callcenter von Starlink Grok Voice nutzen, um 20,000 Anrufe pro Tag in mehreren Sprachen zu beantworten, etwa 70% ohne Mensch zu lösen und jeden vierten Verkaufsanruf abzuschließen, bevor der Anrufer auflegt. Ein einzelner Agent verifiziert Kunden, behebt Hardwareprobleme, stellt Gutschriften aus und versendet Ersatzgeräte.
Das ist die konkreteste Produktionsbehauptung, die ich dieses Jahr von einem Anbieter von Sprachmodellen gesehen habe. Es ist auch eine Schwesterfirma, die über sich selbst berichtet, und es gibt keine veröffentlichte Methode dahinter. Ich würde die 70% als „was mit tiefem Tool-Zugriff und einem engen Produkt möglich ist“ behandeln, nicht als Prognose für Ihre Warteschlange. Meiner Erfahrung nach wird die Lösungsquote weit mehr davon bestimmt, was der Agent nachschlagen und tun kann, als vom Modell, und das ist dieselbe Lektion, die jeder Rollout eines KI-Callcenter-Agenten lehrt.
Wo der Launch-Text übertreibt
Nichts davon ist unehrlich. Es ist die übliche Rahmung eines Launch-Beitrags, die man kennen sollte, bevor man sie seinem Chef zitiert.
- „Class-leading latency.“ 0.81s ist unter den punktbesten Modellen hervorragend, aber Grok Voice 2.0 war mit 0.70s schneller, und die schnellsten Einträge auf der Tafel (Deepslate Opal mit 0.44s, um eines zu nennen) sind noch schneller. Faire Lesart: das schnellste der klugen.
- „Costs less than other frontier models.“ Stimmt im Vergleich zu GPT-Live-1 (Astra) und GPT-Realtime-2.1. Nicht gegenüber allen: Artificial Analysis misst Gemini 3.8 Live Extended Thinking (High) mit $3.50 pro Stunde Eingangsaudio und GPT-Live-1 (Sol) mit $4.47, gegenüber $4.80 bei Grok. Das sind Kosten von Benchmark-Läufen, keine Listenpreise, aber die Richtung ist klar.
- „World's most intelligent.“ Es führt den zusammengesetzten Index. Bei der menschlichen Präferenz ist es Platz 3 (Elo 1070, hinter Gemini 3.1 Flash Live Minimal mit 1100 und Gemini 3.8 Live mit 1088), und beim reinen Sprach-Reasoning erzielen drei Modelle höhere Werte.
Die Reaktion auf X war überwiegend jubelnd, aber die schärfste Antwort unter dem Thread von Artificial Analysis war die, die jede Support-Leitung an den Monitor kleben sollte:
"Scores are one thing. The real test is a drive-thru order with a toddler in the back seat."
Das ist berechtigt. Benchmarks laufen auf sauberem Audio und aufgeräumten Szenarien, während Ihre Anrufer im Auto auf Freisprechen sind. Führen Sie eigene Testanrufe mit echten Hintergrundgeräuschen durch, bevor Sie diesen Zahlen vertrauen, auch den guten.
Die API: nichts zu migrieren, viel Gutes
Die Release Notes von xAI sagen es in einer Zeile: Die API ist unverändert. Gleicher Endpunkt (wss://api.x.ai/v1/realtime), gleiche Sitzungsparameter, gleiche Events, gleicher Preis. Wenn Sie den Alias grok-voice-latest aufrufen, wurden Sie automatisch auf 3.0 umgestellt, und grok-voice-2.0 ist jetzt veraltet.
Das ist eine gute Nachricht und zugleich eine kleine Warnung. Automatische Upgrades sind wunderbar, bis Ihr sorgfältig abgestimmter Prompt an irgendeinem Dienstag anders reagiert. Auf einer Support-Leitung würde ich grok-voice-3.0 ausdrücklich festlegen und Versionen bewusst wechseln, nach einer Runde Testanrufe.
Es ist außerdem weiterhin kabelkompatibel mit der OpenAI Realtime API, sodass ein Team, das bereits auf GPT Realtime aufbaut, Basis-URL und Schlüssel austauschen und damit das meiste erreichen kann. Die Teile, auf die ich tatsächlich aufbauen würde, alle aus der Speech-to-Speech-Dokumentation:
| Funktion | Was sie tut | Warum ein Support-Team sich dafür interessiert |
|---|---|---|
Tools: file_search, web_search, x_search, mcp, function | Hochgeladene Dokumente durchsuchen, Ihre APIs aufrufen, mitten im Anruf einen entfernten MCP-Server erreichen | So stellt der Agent die Erstattung tatsächlich aus, statt sie nur zu versprechen |
| SIP-Telefonanrufe | PSTN-, Contact-Center- oder PBX-Anrufe direkt einleiten, mit DTMF | Keine separate Telefonie-Bridge, die betreut werden muss |
| G.711 μ-law / A-law | Native Telefon-Codecs | Keine Transkodierungsverzögerung bei Telefonaudio |
force_message | Spricht eine feste Zeile ohne das Modell | „Dieses Gespräch wird aufgezeichnet“ wird jedes Mal wortwörtlich gesagt |
keyterms (bis zu 100) | Richtet die Transkription auf Ihre Produktnamen aus | Ihre SKU-Codes werden nicht mehr falsch verstanden |
replace | Korrigiert die Aussprache von Markennamen im gesprochenen Audio | Ohne das gespeicherte Transkript zu ändern |
| Session resumption | Spielt frühere Gesprächsrunden nach einer unterbrochenen Verbindung erneut ab | Ein abgebrochener Mobilfunkanruf beginnt nicht wieder bei „Hallo“ |
idle_timeout_ms | Spricht einen schweigenden Anrufer nach einer festgelegten Zeit wieder an | Löst den „Sind Sie noch da?“-Moment |
reasoning.effort | high (Standard) oder none | Ein Hebel, um bei einfachen Abläufen Nachdenken gegen Tempo zu tauschen |
Wenn Sie zwischen WebSocket und WebRTC für einen Browser-Client entscheiden, gilt auch hier meine Erklärung zu Realtime API vs WebRTC, da das Wire-Format dasselbe ist.
Zwei weitere Dinge, die man wissen sollte. Stimmen können aus einem Referenzclip von bis zu 120 Sekunden geklont werden, und die Voice-Übersicht listet 20 Sprachen mit nativen Akzenten auf, wobei das Modell die Sprache des Anrufers selbst erkennt. Auf X war eine der ersten Fragen unter Elon Musks Launch-Beitrag genau diese:
"Does it handle switching languages mid conversation? Genuinely curious how it does with Hungarian"
Ungarisch steht nicht auf der Liste, rechnen Sie also mit „varying degrees of accuracy“, in den Worten von xAI selbst. Wenn Ihre Anrufer etwas außerhalb dieser 20 sprechen, testen Sie es zuerst.
Das parallele Tool-Calling sowie der Rat in der Dokumentation, Audio-Überlappungen bei Tool-Aufrufen zu vermeiden, sagen mir, dass dieses Team echte Telefon-Agenten ausgeliefert hat. Wer schon auf Realtime-Tool-Aufrufen aufgebaut hat, weiß, dass die peinliche Stille, während eine Funktion läuft, der Moment ist, in dem Anrufer auflegen.
Die Limits, die sich seit 2.0 geändert haben
Wenn Sie meine 2.0-Review gelesen haben, ist dies der wichtigste Abschnitt, denn zwei der drei Mauern, die ich im August markiert hatte, haben sich verschoben.
Parallelität ist jetzt eine Ausgabenleiter
Im August bekam jedes Team 10 gleichzeitige Sitzungen, Punkt. Die aktuelle Tabelle der Rate Limits koppelt die Speech-to-Speech-Parallelität an Ihre Ausgabenstufe, und die Stufen werden automatisch anhand der kumulierten API-Ausgaben seit dem 1. Januar 2026 freigeschaltet. Sie fallen nie wieder zurück.
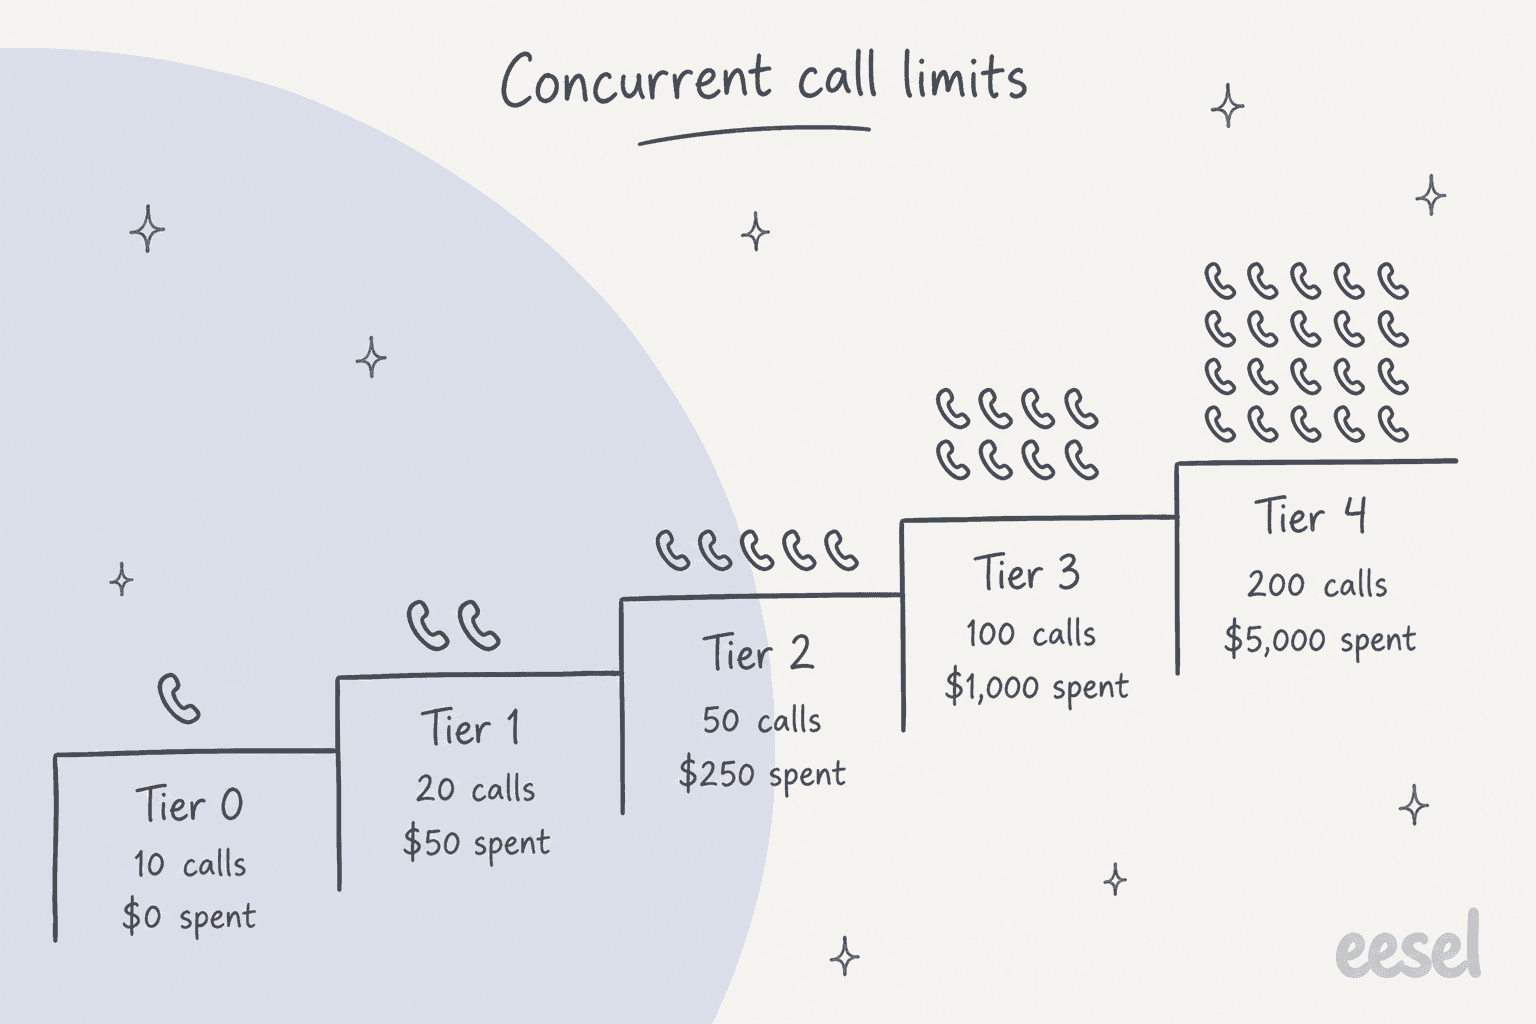
| Stufe | API-Ausgaben insgesamt | Gleichzeitige Voice-Sitzungen |
|---|---|---|
| Tier 0 | $0 | 10 |
| Tier 1 | $50 | 20 |
| Tier 2 | $250 | 50 |
| Tier 3 | $1,000 | 100 |
| Tier 4 | $5,000 | 200 |
| Enterprise | Auf Anfrage | Individuell |
Bei $0.08 pro Minute sind $5,000 gleich 62,500 Gesprächsminuten. Eine Warteschlange mit 500 Vier-Minuten-Anrufen pro Tag schafft das in etwa einem Monat, sodass die Obergrenze für niemanden in der Produktion mehr ein Hindernis ist. Für Piloten spielt sie weiterhin eine Rolle: Ein neues Konto kann am ersten Tag keinen Lasttest mit 50 gleichzeitigen Anrufen fahren, ohne Guthaben vorauszuzahlen, um die Stufe freizuschalten.
Es gibt jetzt eine EU-Region
Die Modellseite zu Grok Voice 3.0 listet us-east-1, eu-west-1 und us-saltlake-2. Im August gab es nur us-east-1, was für viele europäische Teams das Gespräch beendete. Die Voice-Dokumentation von xAI nennt außerdem SOC 2 Type II, HIPAA-Eignung mit BAA, DSGVO-Auftragsverarbeitungsverträge und die Aussage, dass Audio in Echtzeit verarbeitet und „never stored or used for training“ wird. Ich habe nichts davon geprüft. Es ist, was der Anbieter veröffentlicht, und es reicht, um eine Sicherheitsprüfung anzustoßen.
Was sich nicht geändert hat: es weiß nichts über Sie
Das Modell ist klüger, aber es gehört nicht Ihnen. Jede Zahl oben setzt ein Richtliniendokument und Tools voraus, die jemand für den Benchmark geschrieben hat. Auf Ihrer Leitung weiß der Agent genau das, womit Sie ihn verbinden: eine hochgeladene Sammlung, Ihre Funktionen, einen MCP-Server. Der größte Teil der Arbeit bei einem echten Voice-Support-Rollout liegt dort, dazu die Entscheidung, wann man an einen Menschen übergibt.
Die Teams, die ich das gut machen sehe, behandeln den Telefon-Agenten wie einen Wissensdatenbank-Chatbot mit Stimme: Die Antworten liegen in einer gepflegten Quelle, und jeder Kanal liest daraus. Wenn Sie noch entscheiden, ob Sie den Telefon-Support überhaupt automatisieren wollen, fangen Sie dort an, nicht bei der Modellwahl.
Was es kostet, mit durchgerechneten Zahlen
Die Voice-Preise von Grok sind die einfachsten der Kategorie, direkt von der xAI-Preisseite:
| Voice-API | Preis |
|---|---|
Speech to speech (grok-voice-3.0) | $0.08 pro Minute ($4.80 pro Stunde) + $0.004 pro Texteingabe |
Speech to speech (grok-voice-2.0, veraltet) | Gleicher Satz |
| Speech to text | $0.10 pro Stunde (REST), $0.20 pro Stunde (Streaming) |
| Text to speech | $15.00 pro 1M Zeichen |
Es gibt keine Nutzerlizenzen oder Plattformgebühren und auch kein Minimum, nur einen Satz für jede Minute, egal ob das Modell lange nachgedacht hat oder nicht. Das macht die Rechnung leicht prognostizierbar. Setzen Sie Ihre eigenen Zahlen ein:
Ein Gefühl für die Größenordnung: Ein Team mit 500 Anrufen pro Tag à 4 Minuten gibt etwa $4,800 im Monat aus und hat zur Spitzenstunde etwa 7 gleichzeitige Anrufe, innerhalb der kostenlosen Stufe von 10. Die Parallelität beginnt erst bei einigen tausend Anrufen pro Tag zu drücken. Die 20,000 Anrufe pro Tag von Starlink wären bei derselben Schätzung von 4 Minuten (xAI veröffentlicht die Anruflänge nicht) 80,000 Minuten und $6,400 pro Tag. Für den Aspekt günstigerer Modelle vergleicht mein Beitrag zu den Grok-Voice-2.0-Preisen die Minutenpreise der Kategorie, und mein Vergleich der Kosten menschlicher Agenten stellt die Zahl pro Anruf neben ein Gehalt.
Wie es im Vergleich zur Konkurrenz abschneidet
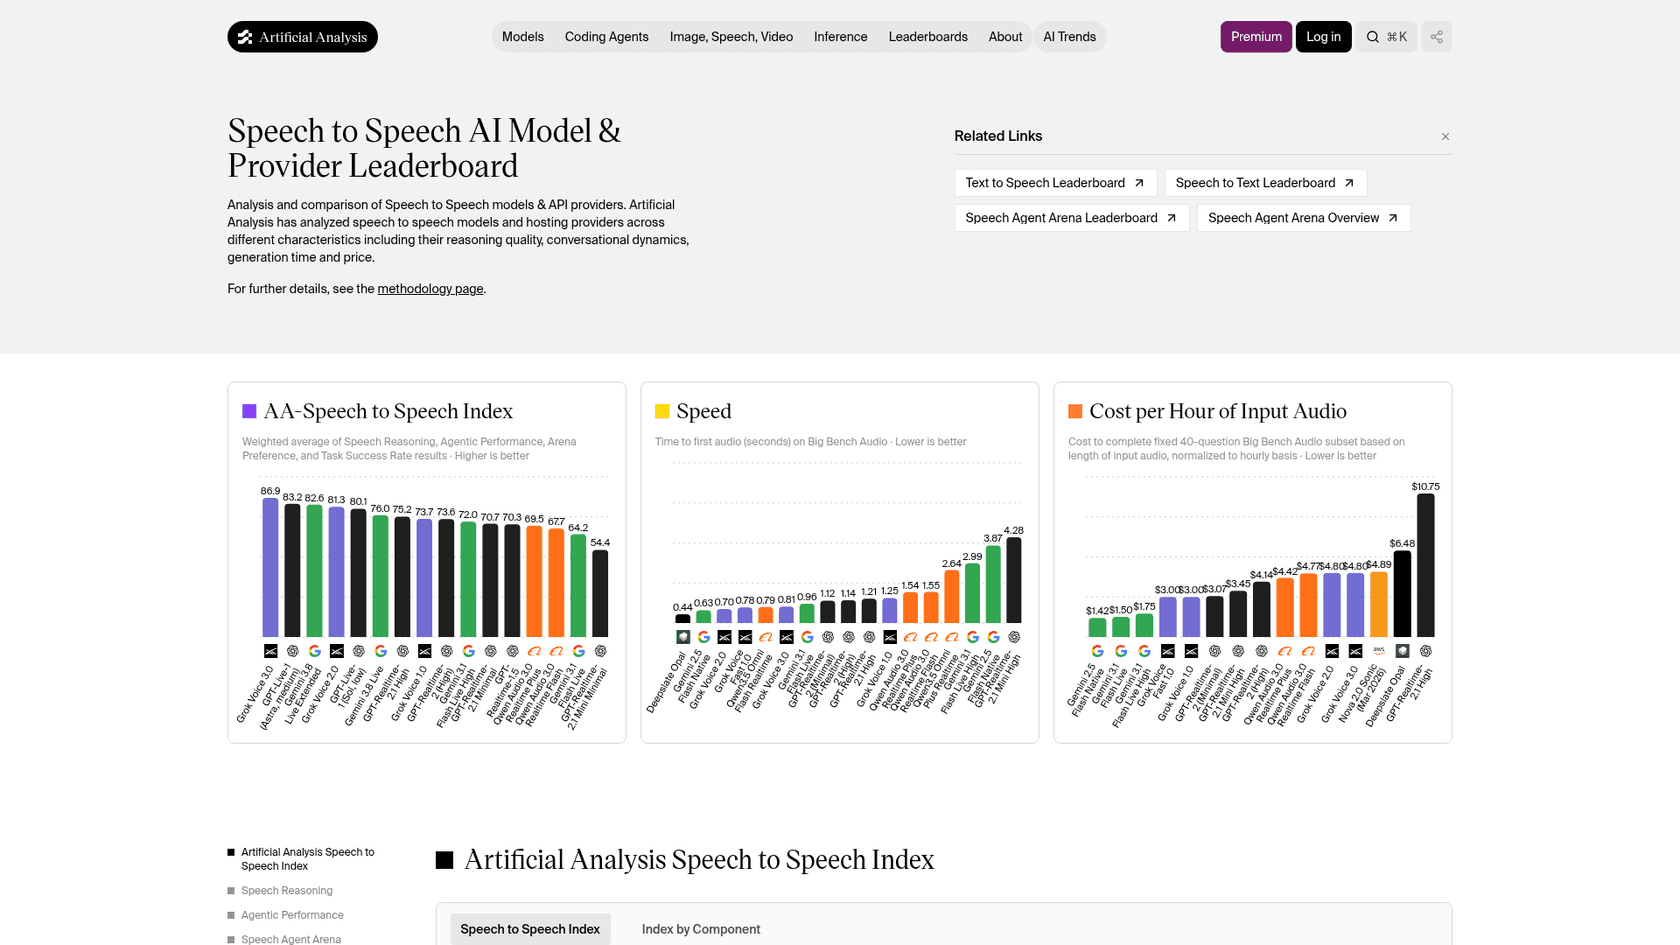
Eine kurze Übersicht der Modelle, die Sie neben ihm in die engere Wahl nehmen würden, alles aus dem Leaderboard von Artificial Analysis (die Kosten sind die von AA gemessenen Laufkosten pro Stunde Eingangsaudio, kein Listenpreis):
| Modell | AA-Index | τ-Voice | Zeit bis zum ersten Audio | AA-Kosten pro Stunde |
|---|---|---|---|---|
| Grok Voice 3.0 | 86.9 | 71.6% | 0.81s | $4.80 |
| GPT-Live-1 (Astra, medium) | 83.2 | 74.5% | 1.34s | $5.83 |
| Gemini 3.8 Live Extended Thinking (High) | 82.6 | 68.6% | 1.35s | $3.50 |
| Grok Voice 2.0 | 81.3 | 56.5% | 0.70s | $4.80 |
| GPT-Live-1 (Sol, low) | 80.1 | 59.3% | 1.24s | $4.47 |
| GPT-Realtime-2.1 High | 75.2 | 45.7% | 1.21s | $10.75 |
Von außen betrachtet verweist xAI außerdem auf EVA-Bench, den offenen Benchmark von ServiceNow für Enterprise-Voice-Agenten über 200+ Szenarien, bei dem Grok Voice 3.0 mit 74% die höchste Genauigkeit erzielt.
Wenn Sie eine ganze Plattform statt eines Modells wollen, sieht der Kompromiss anders aus. Tools wie Retell AI, Vapi und ElevenLabs verpacken Modelle in Anrufabläufe und Dashboards, dazu Analysen obendrauf.
Wenn Sie in einem Helpdesk arbeiten, prüfen Sie zuerst, was er nativ mitbringt: Zendesk Voice-KI-Agenten und die Voice-Agenten von Freshcaller sind beide einen Blick wert. Meine Übersicht der besten KI-Voice-Agenten deckt den Rest ab.
Wenn Sie nur die Stimme brauchen und Ihr eigenes Gehirn mitbringen wollen, sitzen Text-to-Speech-Engines wie Cartesia Sonic 3 tiefer im Stack, und die breitere Karte der KI-Voice-Unternehmen zeigt, wer was verkauft. Für Alternativen innerhalb derselben Familienfrage gilt meine Liste der Grok-Voice-2.0-Alternativen weiterhin für die Wettbewerber.
Wer zugreifen und wer warten sollte
Die kurze Antwort auf die Frage, ob KI Support-Anrufe beantworten kann, ist für die Modellschicht jetzt ein klares Ja. Wer darauf reagieren sollte:
Wechseln Sie jetzt, wenn Sie bereits Grok Voice 2.0 betreiben (gleiche API und gleicher Preis, die einzigen Kosten sind eine Runde Regressionsanrufe) oder einen Telefon-Agenten bauen, der mehrstufige Aufgaben abschließen muss und bei dem jede 100ms Stille Anrufer kostet.
Machen Sie zuerst einen Direktvergleich, wenn Sie bereits auf GPT-Live-1 (Astra) sind. Es gewinnt τ-Voice weiterhin um 2.9 Punkte. Ob Groks Vorsprung von 0.5 Sekunden das aufwiegt, hängt davon ab, wie tool-lastig Ihre Anrufe sind.
Warten Sie oder schauen Sie woanders, wenn Ihre Anrufer Sprachen außerhalb der unterstützten 20 sprechen, Sie einen No-Code-Builder für Anrufabläufe brauchen (beginnen Sie mit dem Voice Agent Builder von xAI oder einer Plattform oben) oder Ihr Hindernis gar nicht die Stimme ist, sondern die Antworten. Mein Leitfaden zur besten KI für Voice-Support behandelt die fertigen Optionen. Eine brillante Stimme, die die falsche Erstattungsrichtlinie vorliest, bleibt die falsche Erstattungsrichtlinie, und sie steht ganz oben auf jeder Liste der Chatbot-Probleme, die Kunden aufgeben lassen.
Grok führt den Anruf. eesel kümmert sich darum, was gesagt werden sollte.
Grok Voice 3.0 ist eine Gesprächsmaschine. Es kennt weder Ihre Rückgabefrist noch Ihre letzten 50,000 Tickets noch welche Kunden die Kulanzgutschrift bekommen. Das ist die Hälfte, die eesel übernimmt: ein KI-Helpdesk-Teammitglied, das in Zendesk, Freshdesk oder Gorgias einsteigt, aus Ihren früheren Tickets und Ihrem Help Center lernt und die E-Mail- und Chat-Warteschlange abarbeitet, die hinter jeder Telefonleitung steht. Bevor es live geht, können Sie es gegen Ihre eigenen früheren Tickets laufen lassen und sehen, wie seine Antworten im Vergleich zu dem aussehen, was Ihr Team tatsächlich gesendet hat.

Für Entwickler passen die beiden auf dem Papier sauber zusammen. Groks mcp-Tool nimmt eine Server-URL, ein authorization-Token und eigene Header entgegen. Jeder eesel-Workspace ist ein MCP-Server: Führen Sie npx @eesel/cli mcp token aus dem eesel CLI aus, und es gibt die URL, ein 30-Tage-Token und den Header X-Eesel-Agent-Id aus, genau die Form, die Grok verlangt. Mit demselben CLI können Sie den Agenten vom Terminal aus skripten und untersuchen oder ihn an einen Coding-Agenten wie Claude Code übergeben. Ich habe diese Kombination noch nicht auf einer Live-Telefonleitung betrieben, betrachten Sie sie also als vielversprechenden Entwurf, nicht als ausgelieferte Integration, und behalten Sie die zusätzliche Latenz eines Tool-Aufrufs mitten im Satz im Auge.
Die Preise sind ein fester monatlicher Credit-Plan: $299 im Monat für 500 Credits, wobei ein Ticket oder Chat als ein Credit zählt, mit 100 kostenlosen Credits zum Ausprobieren und ohne Karte. Testen Sie eesel an einem Ausschnitt Ihrer Warteschlange vor Ihrem nächsten Voice-Pilot, damit der Agent am Telefon etwas Sagenswertes hat.
Frequently Asked Questions
Ist Grok Voice 3.0 gut genug für Support-Anrufe in der Produktion?
Was hat sich in Grok Voice 3.0 gegenüber Grok Voice 2.0 geändert?
Was kostet Grok Voice 3.0?
Ist Grok Voice 3.0 besser als GPT-Live-1?
Muss ich meinen Code ändern, um auf Grok Voice 3.0 umzusteigen?
grok-voice-latest aufrufen, sind Sie bereits auf 3.0. Wenn Sie grok-voice-2.0 festgelegt haben, ändern Sie den Modellnamen auf grok-voice-3.0; Endpunkt, Sitzungsparameter und Events bleiben gleich. Apps, die auf der OpenAI Realtime API aufbauen, lassen sich weiterhin durch den Austausch von Basis-URL und Schlüssel umstellen.