

O número mais importante do Inkling 2 Mini é o custo por tarefa: a Artificial Analysis dá a ele 20 pontos, empatado com o Qwen3.8-27B, a 0,59 $ por tarefa contra 3,53 $ e 9,0 minutos por tarefa contra 34,5. É um modelo em loop de 26,4B de parâmetros sob Apache 2.0 que cabe em cerca de 20 GB. A troca é o conhecimento: o laboratório o considera menos capaz do que o Inkling 2 Small na maioria das avaliações, e ele afirma fatos errados com mais confiança.
Para equipes de suporte, isso o torna um motor rápido e barato que ainda precisa de embasamento na sua central de ajuda e de um teste em tickets passados, que é exatamente o trabalho que a eesel faz em torno de qualquer modelo que você escolher.
O que é o Inkling 2 Mini?
O Inkling 2 Mini é o modelo menor da segunda geração da Thinking Machines Lab, ao lado do Inkling 2 Small, anunciado em 20 de novembro de 2026. Ele tem 26,4B de parâmetros totais, recebe texto e imagens como entrada, escreve texto como saída e é lançado com pesos abertos. Sua ficha de modelo no Hugging Face lista Apache 2.0 e um contexto de 1M de tokens.
Eu construo funcionalidades e agentes de IA na eesel, então quando um modelo novo aparece, leio como ele foi construído antes de ler a tabela de benchmarks. O Mini é incomum nesse aspecto, o que eu explico mais abaixo. É também por isso que a eesel tem uma ferramenta de linha de comando: com a CLI da eesel, um agente de codificação com IA pode enviar conhecimento aprovado, como artigos de ajuda exportados e respostas salvas, alterar as instruções do agente de suporte e fazer perguntas de teste antes de qualquer coisa entrar no ar, qualquer que seja o modelo por trás. Conectar o helpdesk em si ainda precisa ser aprovado por alguém com acesso de administrador.
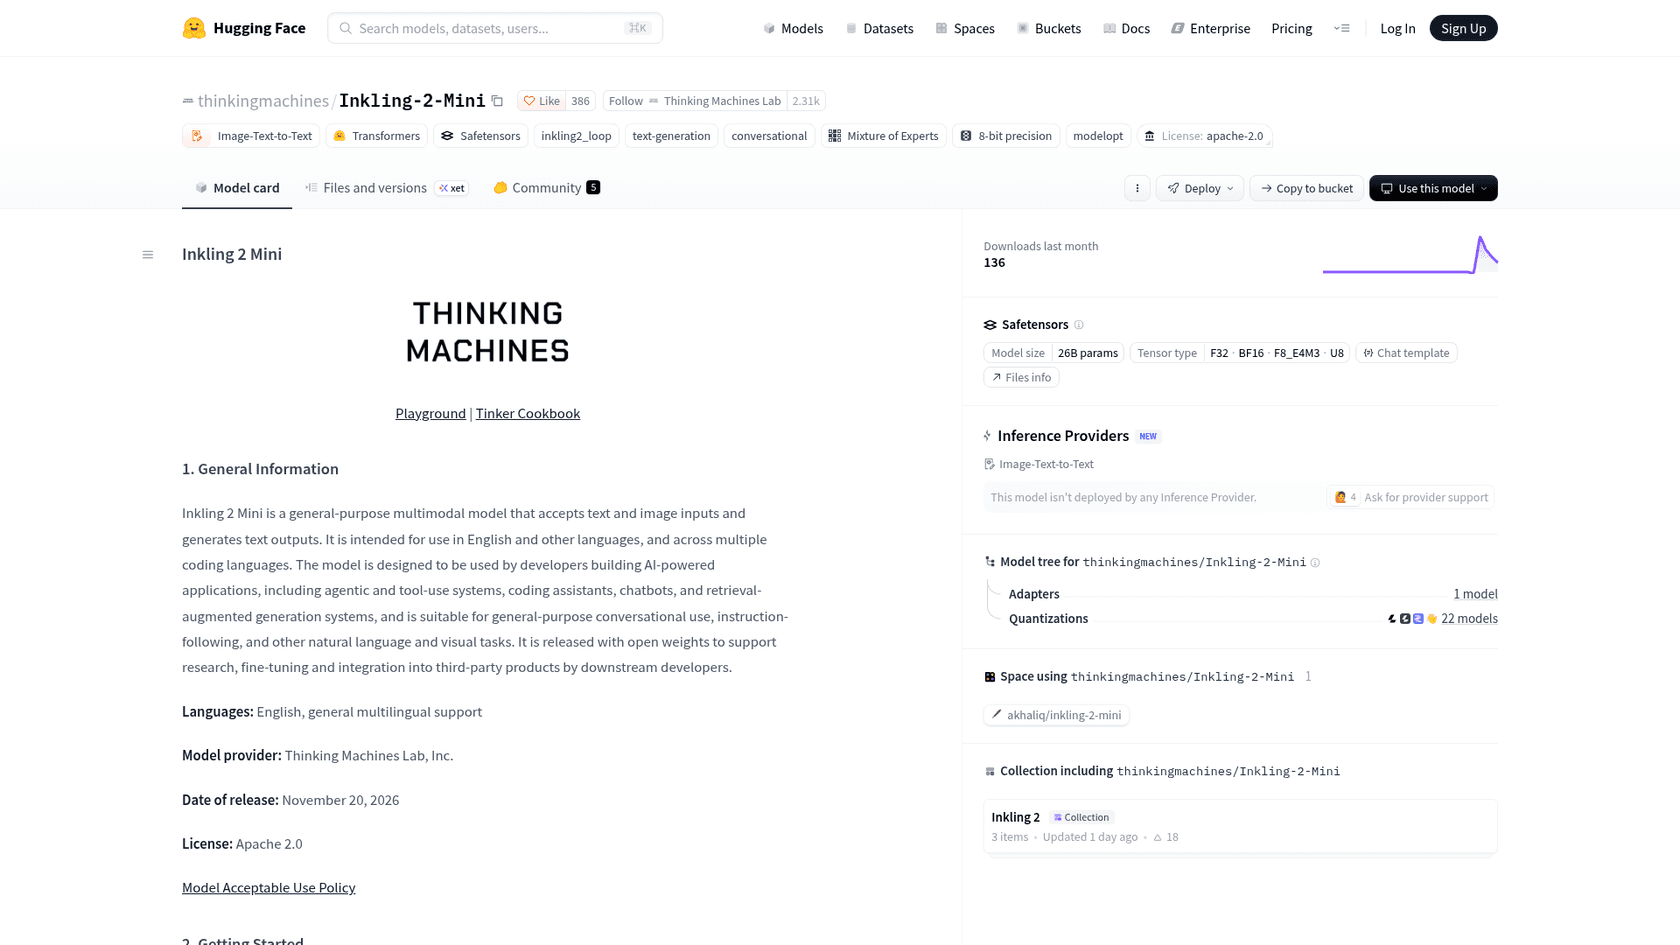
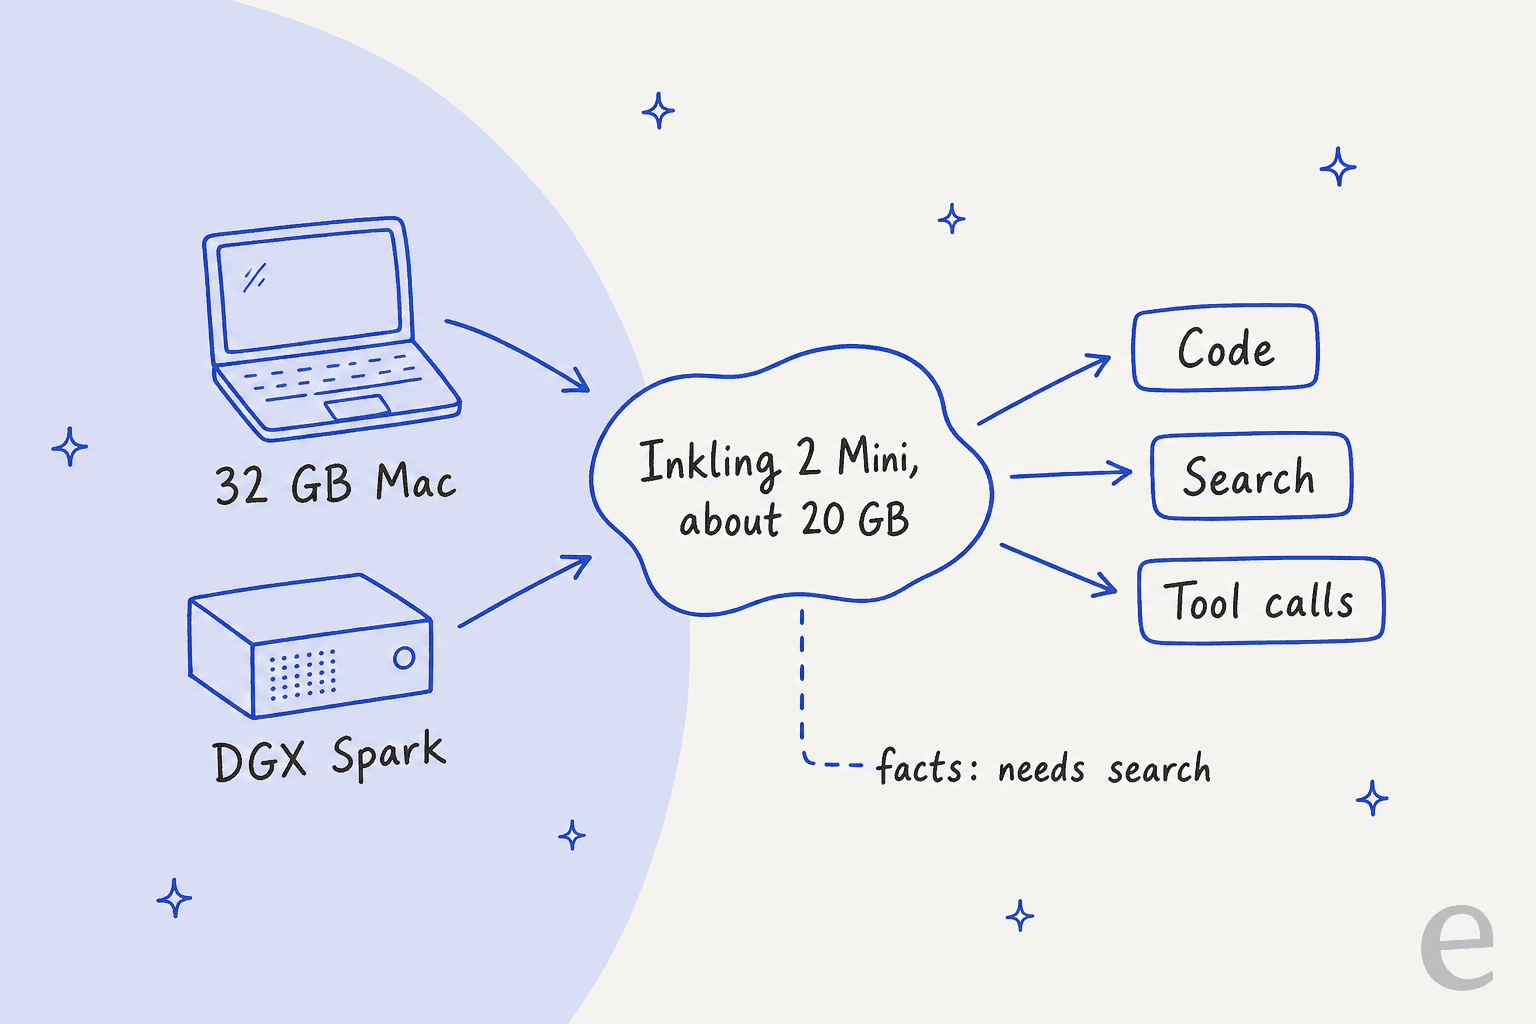
Os números que importam na ficha: 3,4B de parâmetros ativos por token, um checkpoint de cerca de 20 GB, e uma variante de pesquisa chamada TML-d24-varloop-research que permite escolher quantas passagens de loop o modelo executa. A ficha indica um NVIDIA DGX Spark ou silício da Apple com 32 GB de memória como hardware-alvo.
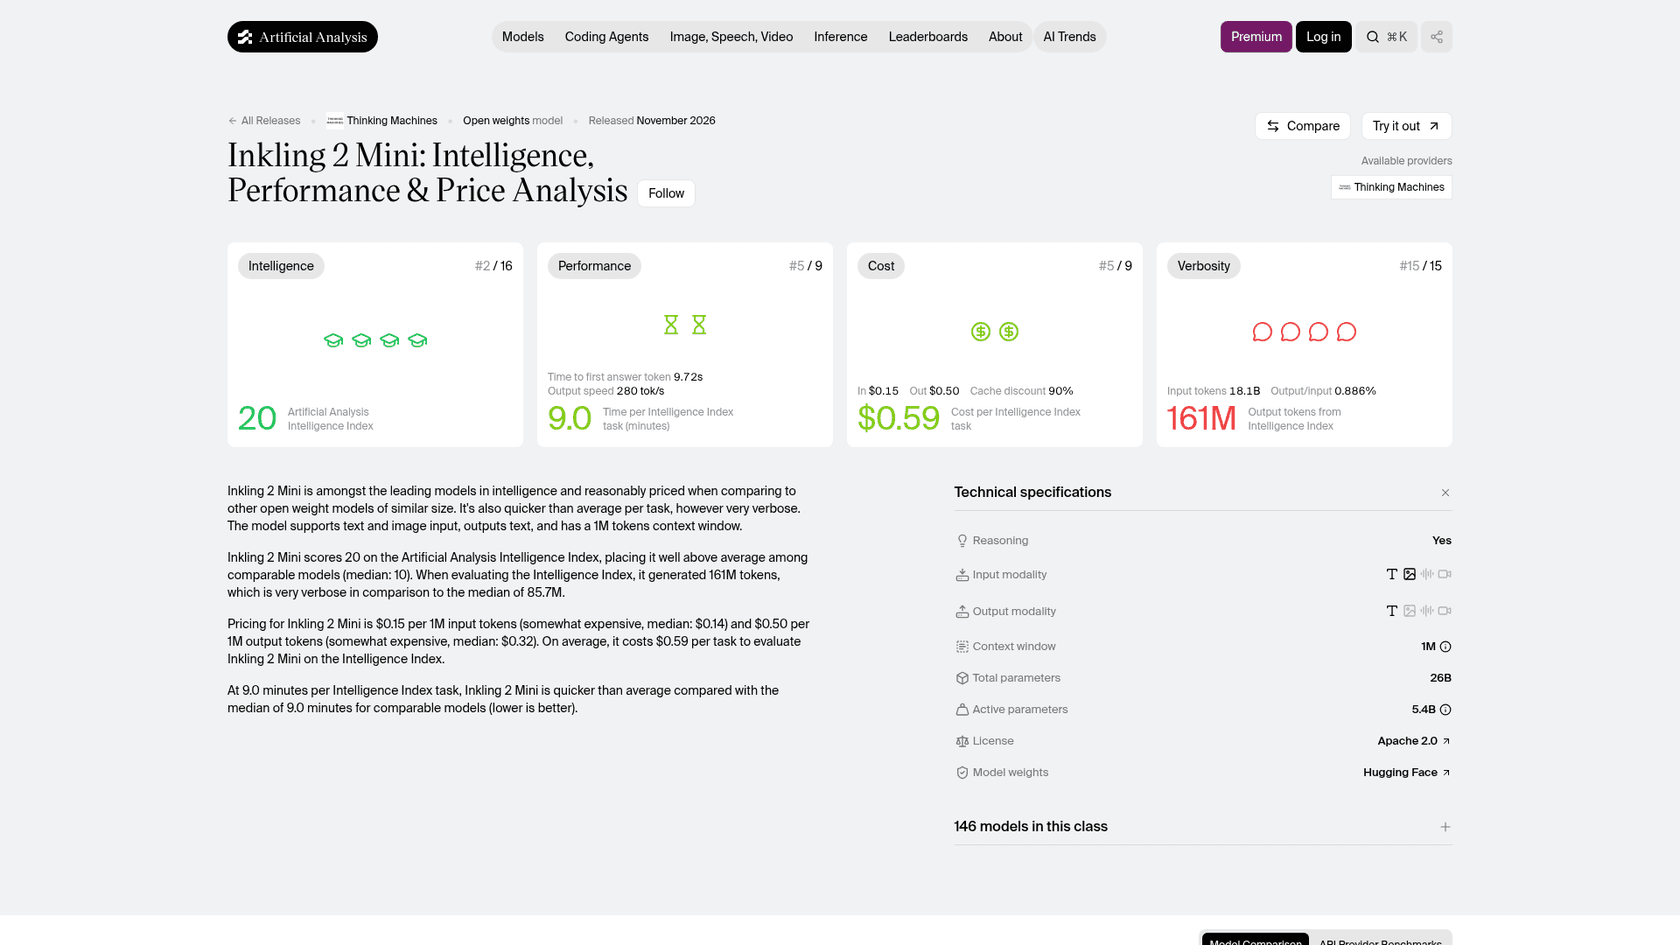
Uma coisa a destacar logo no início. O texto do anúncio diz 3,4B de parâmetros ativos, enquanto a tabela de especificações e a Artificial Analysis dizem 5,4B. Ambos estão certos à sua maneira: 3,4B são os parâmetros armazenados e ativos, e 5,4B é a contagem quando se somam as camadas que rodam três vezes.
Como o Inkling 2 Mini se compara ao Inkling 2 Small?
O Mini é menor, mais barato por tarefa e mais rápido, e é mais fraco na maioria dos testes. As especificações vêm de cada ficha de modelo, os preços da página de preços da Tinker, e as pontuações e velocidades das páginas do Small e do Qwen3.8-27B na Artificial Analysis, além da página do Mini mostrada abaixo.
| Inkling 2 Mini | Inkling 2 Small | Qwen3.8-27B | |
|---|---|---|---|
| Lançamento | 20 nov. 2026 | 5 nov. 2026 | ago. 2026 |
| Parâmetros totais / ativos | 26,4B / 3,4B (5,4B com loops) | 594B / 17B | 27B |
| Entrada | Texto, imagem | Texto, imagem | n/d |
| Contexto (ficha) | 1M | 1M | n/d |
| Licença | Apache 2.0 | Apache 2.0 | n/d |
| Entrada / cache / saída por 1M | $0.15 / $0.015 / $0.50 | $0.30 / $0.03 / $1.00 | $0.50 / n/d / $3.00 |
| AA Intelligence Index v5.0.1 | 20 | 31 | 20 |
| Velocidade de saída (AA) | 280 tokens/s | 118 tokens/s | 53 tokens/s |
| Tempo até o primeiro token de resposta (AA) | 9,7s | 39,7s | 144,1s |
| Minutos por tarefa do índice AA | 9,0 | 21,2 | 34,5 |
| Custo por tarefa do índice AA | $0.59 | $1.18 | $3.53 |
| Tokens de saída na execução do índice | 161M | 154M | não comparado |
A coluna do Qwen é a própria listagem da Artificial Analysis, e "n/d" significa que eu não verifiquei essa célula. Duas ressalvas sobre a coluna do Mini. Primeiro, o Mini não está na lista de inferência serverless da Tinker, e a Artificial Analysis não mostra uma API pública para ele, então seu custo por tarefa é a taxa de sampling da Tinker aplicada aos tokens medidos, não um preço que você pode comprar hoje. Segundo, o Mini escreveu 161M de tokens na execução do índice, mais do que os 154M do Small e quase o dobro da mediana de 85,7M que a Artificial Analysis cita para modelos comparáveis. Isso mostra claramente que o modelo é muito prolixo.
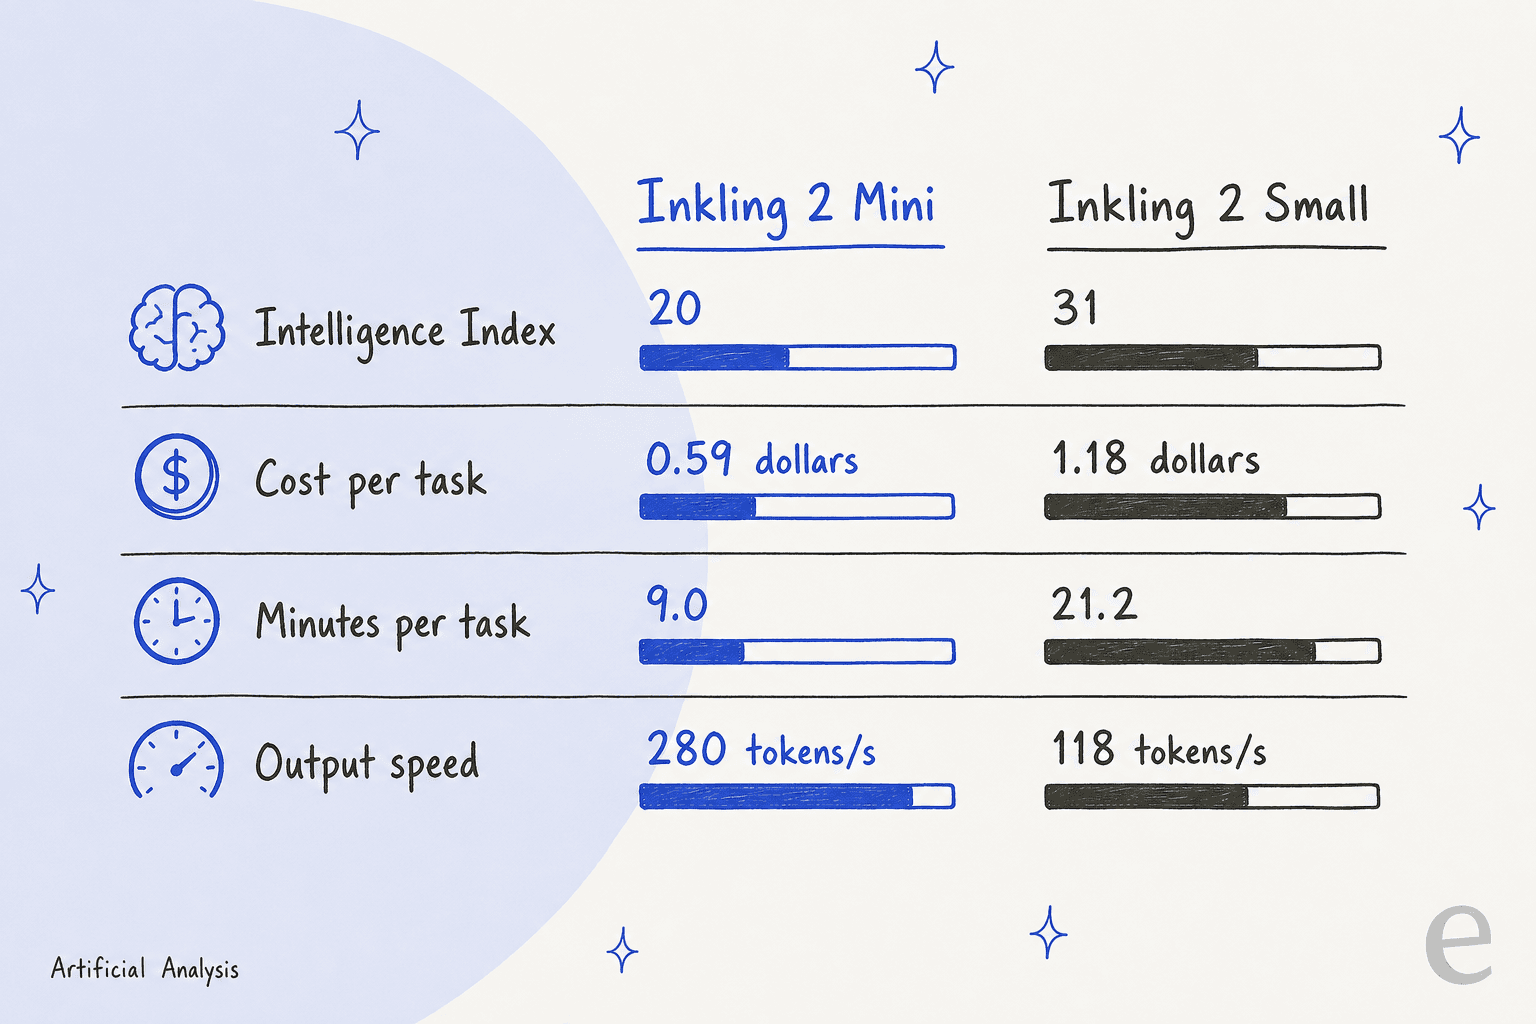
O Mini pontua 11 pontos abaixo do Small e custa metade por tarefa. A própria ficha do laboratório é mais direta: o modelo é "menos capaz do que o Inkling 2 Small na maioria das nossas avaliações", com as maiores lacunas na recordação de fatos. A exceção é o trabalho agêntico longo, onde o laboratório diz que o Mini "se aproxima" do Small no seu teste PMPP-Hard. Os membros mais antigos da família são cobertos nos artigos sobre o Inkling, o Inkling-Small e o Inkling 2 Small.
Uma correção ao retrato do Small que escrevi antes. No lançamento, os pesos do Small eram fechados. Desde então eles apareceram no Hugging Face sob Apache 2.0, e a Artificial Analysis agora lista DeepInfra, Nebius e Together como hosts, com números de velocidade e custo que mudaram por causa disso. Eu uso os números atuais acima.
Como funciona um modelo em loop?
Um transformador em loop reutiliza as mesmas camadas mais de uma vez por token. O Inkling 2 Mini armazena 24 camadas em quatro blocos de seis, e os dois blocos do meio rodam três vezes, então cada token passa por 48 aplicações de camada. A ficha do modelo diz que fazer loop nas camadas do meio superou fazer loop nas últimas camadas em 27 das 28 avaliações.
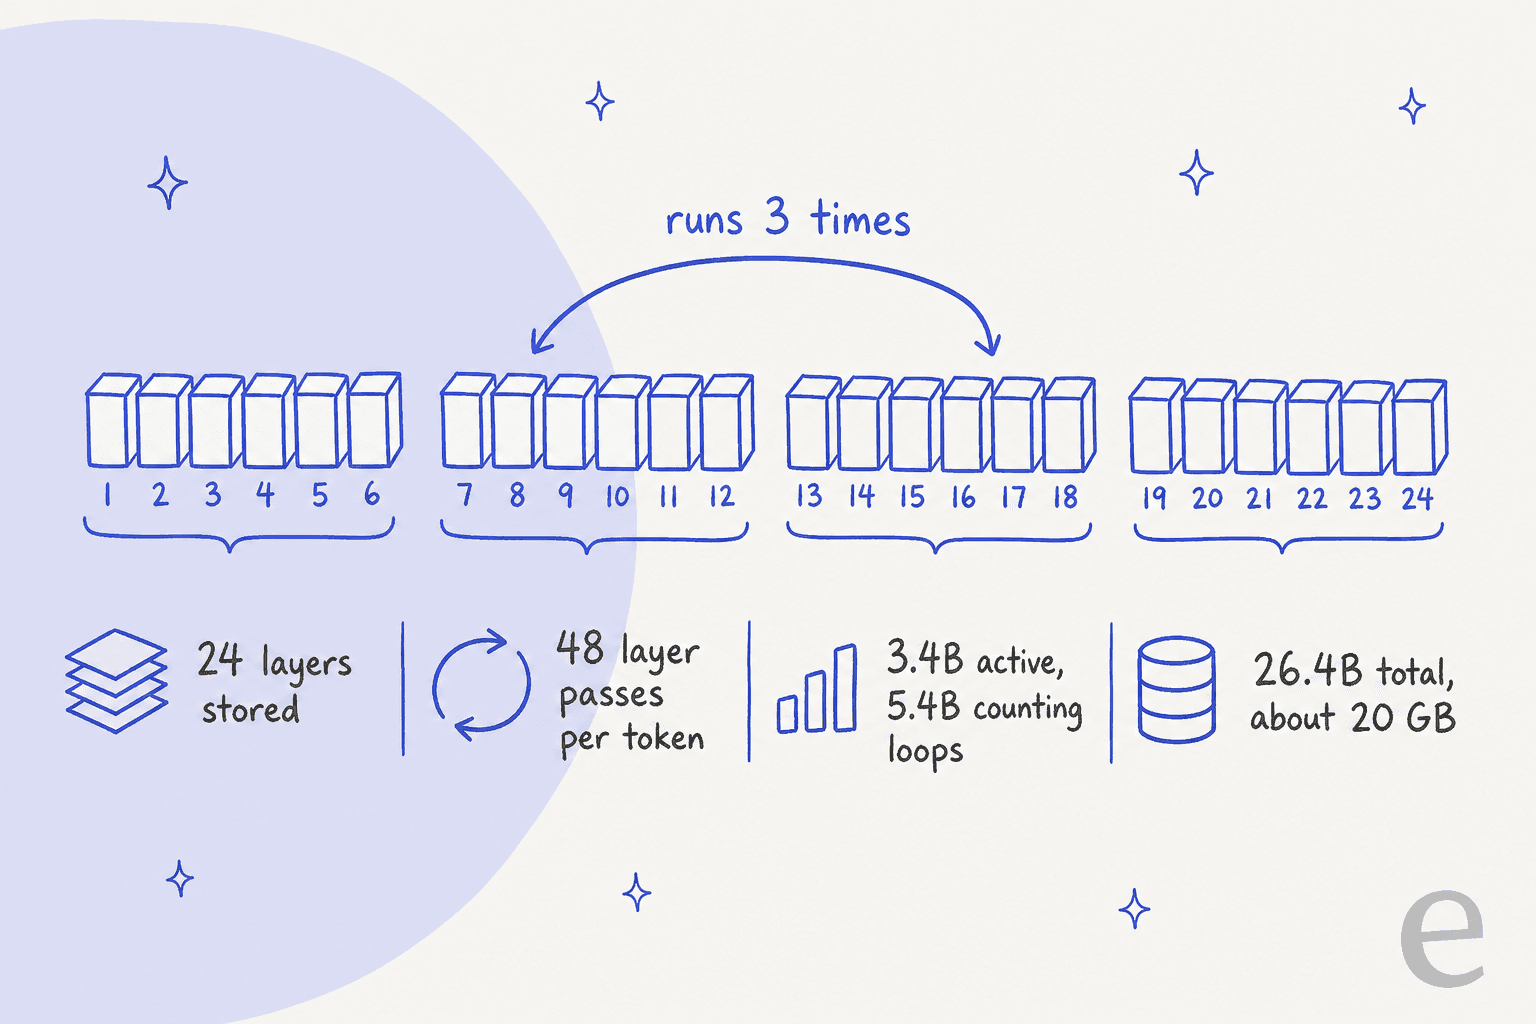
O ponto é a memória. Telefones, laptops e servidores pequenos são limitados pela quantidade de pesos que conseguem armazenar, não pela quantidade de cálculo que conseguem fazer. Reutilizar camadas compra pensamento extra por token sem aumentar o arquivo. Mais três detalhes da ficha:
- Treinamento. As camadas de especialistas foram treinadas em NVFP4 (4 bits) do pré-treinamento até o aprendizado por reforço, e as últimas quatro camadas em 8 bits, então os pesos entregues correspondem aos treinados sem nenhuma etapa de conversão.
- Redução. O laboratório reduziu o modelo de 384 para 128 especialistas por camada no meio do treinamento, e depois o curou com 1T de tokens de destilação de um modelo Inkling interno maior.
- A pegadinha. O loop não adiciona conhecimento. O laboratório escreve que o conhecimento é majoritariamente uma função do número total de parâmetros, então os fatos não melhoram com mais passagens.
Essa última linha é a que vale manter em mente para o resto deste artigo.
Quanto custa o Inkling 2 Mini?
Na Tinker, o Inkling 2 Mini faz sampling a 0,15 $ por 1M de tokens de entrada, 0,015 $ por 1M de tokens de entrada em cache e 0,50 $ por 1M de tokens de saída. O fine-tuning ("train") custa 0,75 $ por 1M de tokens com 64K de contexto e 1,50 $ com 256K. O Inkling 2 Small custa exatamente o dobro no lado do sampling. Os preços vêm da página de preços da Tinker do fornecedor; eu não usei nenhum preço de terceiros.
Três coisas mudam a conta real:
- O serverless não está aberto para o Mini. A página de preços limita a inferência serverless ao Inkling 2 Small, ao Inkling e ao Inkling-Small, e a página da OpenRouter não mostra preço. Hoje as rotas realistas são o sampling da Tinker ou o seu próprio hardware.
- A saída prolixa consome a economia. O preço por token é metade do do Small, mas o Mini escreve mais ou menos a mesma quantidade de tokens por tarefa, então a diferença por tarefa em relação ao Small é de cerca de 2x, a mesma proporção dos preços por token. Os tokens de saída são a unidade que decide a conta.
- O local é uma conta diferente. Na sua própria máquina, o custo é hardware e tempo, não tokens, que é o caso para o qual o laboratório construiu o Mini.
Para uma visão orçamentária de suporte, o guia de custo da IA no atendimento ao cliente mostra como o preço do modelo se situa ao lado de assentos, resoluções e configuração.
Onde o Inkling 2 Mini falha?
Conhecimento, chats de múltiplos turnos e sessões de terminal. O laboratório reporta suas próprias lacunas, o que merece crédito. Na sua própria ficha, a taxa de não alucinação AA-Omniscience do Mini é de 63,4%, então quando ele não sabe uma resposta nesse teste, ele chuta em vez de dizer isso em pouco mais de um terço das vezes. A ficha também coloca o Mini atrás do Qwen3.8-27B no MultiChallenge (50,0%) e no ComplexConstraints (33,4%), e empatado em um baixo 5,6% no Terminal Bench 4.0.
Os primeiros usuários notaram o mesmo padrão. Um testador do Hacker News executou um prompt de codificação com as ferramentas desligadas:
"The model burned through 19200 thinking tokens on this task (which was the hard limit I had set) and didn't finish."

O mesmo usuário disse que, com a busca permitida, ele chegou a uma solução mas ainda assim usou o nome de hook errado. Outro comentarista foi mais direto sobre os benchmarks de agentes:
"Big fan of open weights but those Terminal Bench numbers are pretty abysmal."
A thread de lançamento alcançou 473 pontos e 72 comentários no Hacker News, e a maior parte dos elogios foi sobre tamanho e velocidade, não sobre precisão. A leitura do laboratório é que o Mini "supera a lacuna de conhecimento" usando busca e ferramentas, o que combina com o que aquele testador viu: ele melhorou depois que pôde pesquisar as coisas.
Onde o Mini de fato se destaca é em trabalho agêntico que consiste principalmente em busca e chamadas de ferramentas. O laboratório reporta 79,2% no SWE-bench Verified (somente bash), contra 77,8% para o Qwen3.8-27B, mais 79,0% no BrowseComp e 82,7% no MCP Atlas. Esses são números do laboratório, executados no seu próprio harness, então eu esperaria por execuções externas antes de tratá-los como definitivos. O Gemini 3.8 Flash, o DeepSeek V4 Flash e o Kimi K3 são as opções hospedadas maiores se você não precisar de pesos locais.
É possível rodar o Inkling 2 Mini em um laptop?
Sim, e essa é a verdadeira manchete para a maioria dos desenvolvedores. A ficha do modelo diz que um DGX Spark ou uma máquina Apple com 32 GB ou mais de memória unificada já é suficiente, e existem builds GGUF quantizados para llama.cpp, Ollama e aplicativos similares. O laboratório também cita um estudo de eficiência de Stanford em um DGX Spark, no qual o Mini pontuou 0,703 na sua medida de inteligência por watt contra 0,430 do Qwen3.6-35B-A3B.
A velocidade no mundo real é menos clara. O laboratório não publicou um número de tokens por segundo para sua demonstração em laptop. Um usuário do Hacker News com uma máquina mais antiga reportou:
"I'm getting 20 tokens/s running the 4-bit version on my 2021 M1 Max MacBook pro with 64Gb."
Outro comentarista notou que o llama.cpp precisou de um pull request separado para adicionar suporte a loop, então um runtime desatualizado pode não carregar o modelo. Para outros runtimes, veja alternativas ao llama.cpp. Os 280 tokens por segundo que a Artificial Analysis lista são uma medição hospedada, não o que um laptop vai entregar.
Vale a pena usar o Inkling 2 Mini para suporte?
Vale a pena testá-lo como motor, não como agente. Um agente de suporte é um modelo mais a sua documentação, suas ferramentas, suas regras de transferência e uma forma de verificá-lo antes de os clientes o verem. A proposta do Mini (barato, rápido, forte com ferramentas) se encaixa nas partes que dependem muito de ferramentas, e a sua fraqueza (fatos errados afirmados com confiança) é a parte que você não pode deixar sem supervisão. Uma alucinação em uma resposta sobre reembolso custa muito mais do que os tokens que você economizou.
É por isso que a eesel trata o modelo como algo substituível. Um colega de equipe de IA para o helpdesk entra na sua fila existente, aprende com a sua central de ajuda e com tickets passados, e é simulado contra tickets históricos antes de entrar no ar, então um motor novo é julgado pelas suas próprias perguntas, não pela tabela de um laboratório. A SamCart é um bom exemplo dessa configuração. Ela roda um agente nos tickets do Freshdesk e outro no chat do seu site, ambos respondendo a partir de cerca de 280 artigos da central de ajuda. Nos tickets, o agente responde só até um colega de equipe assumir, e um pedido para falar com uma pessoa encerra o seu turno. Nada disso depende de qual modelo está por trás.
Se você quiser testar o Mini por conta própria, dê a ele um trabalho limitado primeiro:
- Escolha uma tarefa estreita, como redigir respostas a partir de um conjunto fixo de artigos.
- Limite a saída e os turnos, como a ficha do modelo recomenda, porque a configuração mínima de raciocínio não desliga o raciocínio por completo.
- Reproduza tickets passados e compare com suas respostas humanas, como em testes de simulação de agentes de suporte com IA e testes de agentes de suporte com IA.
- Limite o que ele pode fazer, usando as ideias de permissões de agentes de suporte com IA.
- Observe-o depois do lançamento, com os traços descritos em observabilidade de agentes de suporte com IA.
Para uma lista mais ampla, os melhores modelos de IA para tickets de suporte e os melhores agentes de IA de atendimento ao cliente comparam modelos e produtos em testes específicos de suporte, e o guia do agente de IA para o Freshdesk mostra como é uma opção nativa de helpdesk.
Quer um modelo que você possa trocar sem reconstruir sua configuração de suporte? Experimente a eesel: funciona como uma nova contratação que se conecta ao seu helpdesk em minutos, já conhece a sua central de ajuda e é testada nos seus tickets passados antes de falar com um cliente.
O que mais você deveria ler?
Está acompanhando a família Inkling? Estas são as leituras mais próximas:
- A análise do Inkling 2 Small, a comparação mais próxima deste artigo.
- A análise do Inkling-Small e a análise do Inkling para a primeira geração.
- Alternativas ao Inkling-Small se você está escolhendo entre modelos pequenos e abertos.
- Entradas do glossário sobre modelos de linguagem grandes, fine-tuning, agentes de IA e RAG.