

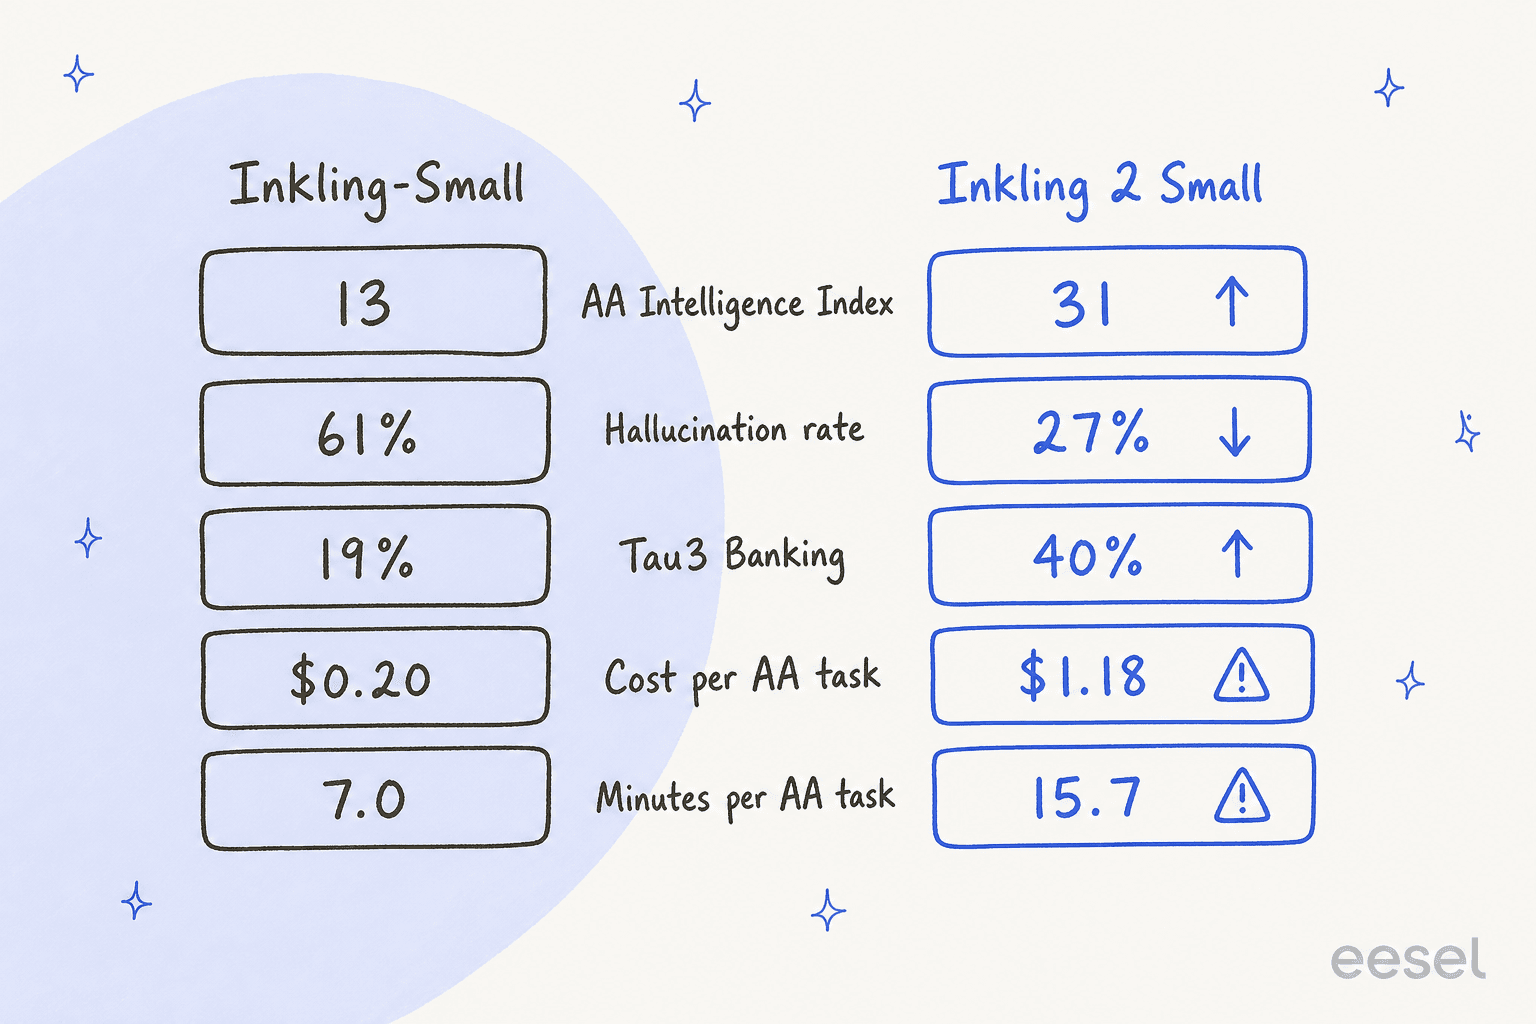
O Inkling 2 Small é o maior salto de uma única geração que a Thinking Machines já lançou: o Artificial Analysis dá a ele 31 pontos no seu Intelligence Index contra 13 do Inkling-Small, e sua taxa de alucinação caiu de 61% para 27%. Por token, é o Inkling mais barato até agora ($0,30 de entrada, $1,00 de saída por 1M), mas escreve cerca de 4 vezes mais tokens, então cada tarefa custa cerca de 6 vezes mais e leva o dobro do tempo. Os pesos ainda estão fechados, à espera dos testes de segurança.
Para equipes de suporte, a queda na taxa de alucinação é o que mais importa: um modelo que se recusa a responder em vez de adivinhar é um motor mais seguro para a eesel rodar dentro do seu helpdesk, ancorado nas suas macros e testado primeiro nos seus tickets passados.
O que é o Inkling 2 Small?
O Inkling 2 Small é o primeiro modelo da segunda geração da Thinking Machines Lab, lançado em 5 de novembro de 2026. Segundo o post de lançamento, é um modelo mixture-of-experts com 594B de parâmetros totais e 17B ativos por token, recebe texto e imagens como entrada, gera texto como saída, e permite ajustar o quanto ele "pensa" com uma configuração de esforço variável.
Eu construo integrações e APIs na eesel, então quando um modelo novo chega, leio a documentação de serviço antes das tabelas de benchmarks. Esse hábito valeu a pena aqui, porque os fatos mais interessantes sobre o Inkling 2 Small estão na tubulação: onde você pode chamá-lo, qual contexto você realmente recebe, e quantos tokens ele gasta por resposta. É também por isso que a eesel oferece uma ferramenta de linha de comando: a CLI da eesel permite que um agente de IA de programação envie conhecimento aprovado, como artigos de ajuda exportados e macros, ajuste as instruções do agente de suporte e rode perguntas de teste contra ele antes de qualquer coisa ir ao ar, seja qual for o modelo por baixo. Conectar o próprio helpdesk ainda precisa que alguém com acesso de administrador aprove.
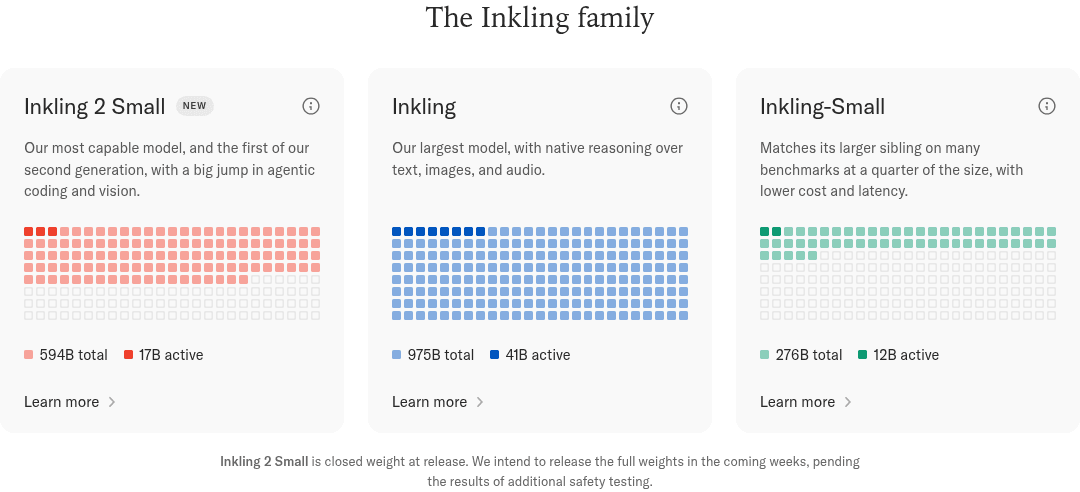
O nome é um pouco enganoso. "Small" aqui significa pequeno por token, não pequeno em disco. O Inkling 2 Small é mais do que o dobro do tamanho total do Inkling-Small que substitui (594B contra 276B), e a própria página de modelo do laboratório agora o chama de "nosso modelo mais capaz", na frente do modelo de 975B Inkling. Um comentarista do Hacker News resumiu a reação:
"Damn their last "Inkling Small" model was only 266B and now this is more than double."

(O número 266B é como o Artificial Analysis lista o primeiro modelo; a própria ficha da Thinking Machines diz 276B.)
Como o Inkling 2 Small se compara ao Inkling-Small e ao Inkling?
Aqui está a família lado a lado. As especificações vêm de cada ficha de modelo, os preços da página de preços do Tinker, e as pontuações e velocidades das execuções independentes do Artificial Analysis.
| Inkling 2 Small | Inkling-Small | Inkling | |
|---|---|---|---|
| Lançamento | 5 nov 2026 | 30 jul 2026 | 15 jul 2026 |
| Parâmetros totais / ativos | 594B / 17B | 276B / 12B | 975B / 41B |
| Especialistas por token | 8 de 384 | 6 de 256 (+2 compartilhados) | 6 de 256 (+2 compartilhados) |
| Camadas | 48 | 42 | 66 |
| Entrada | Texto, imagem | Texto, imagem, áudio | Texto, imagem, áudio |
| Contexto (ficha / Tinker serverless) | 1M / 256K | 1M / 256K | 1M / 256K |
| Pesos | Fechados no lançamento, Apache 2.0 planejado | Apache 2.0 | Apache 2.0 |
| Entrada / cache / saída por 1M (Tinker serverless) | $0.30 / $0.03 / $1.00 | $0.30 / $0.06 / $1.20 | $1.00 / $0.17 / $4.05 |
| AA Intelligence Index v5.0.1 | 31 | 13 | 12 |
| Velocidade de saída (AA) | 159 tokens/s | 87 tokens/s | 105 tokens/s |
| Tempo até o primeiro token de resposta (AA) | 28,8s | 26,8s | 19,6s |
| Minutos por tarefa do índice AA | 15,7 | 7,0 | 8,1 |
Três coisas chamam a atenção quando os números ficam juntos em uma tabela.
Primeiro, a entrada de áudio desapareceu. Os dois modelos de primeira geração aceitavam áudio WAV, e a seção de limitações do post de lançamento diz claramente que o Inkling 2 Small "não suporta áudio". Se você transcrevia mensagens de voz ou chamadas com o Inkling-Small, isso não é uma atualização direta.
Segundo, uma nota sobre os números do índice, porque eles confundem as pessoas. Posts anteriores da eesel sobre a primeira geração citavam pontuações do Artificial Analysis de 40 e 41. Essas eram de uma versão mais antiga do índice. No atual Intelligence Index v5.0.1, que trocou para testes agênticos mais difíceis, esses mesmos dois modelos agora pontuam 13 e 12. Então a comparação honesta é 31 contra 13, na mesma régua.
Terceiro, uma velocidade de saída mais rápida não significou respostas mais rápidas. O Inkling 2 Small transmite tokens quase duas vezes mais rápido que o Inkling-Small, mas leva mais do que o dobro do tempo por tarefa, porque escreve muito mais deles. Volto a isso na seção de preços.
O que realmente melhorou no Inkling 2 Small?
Quase tudo que um desenvolvedor testaria, e os números independentes confirmam os do fornecedor. Mantenho essas duas fontes separadas abaixo, já que a tabela de um laboratório e a execução de um laboratório externo não são o mesmo tipo de evidência.
Números independentes
O thread de lançamento do Artificial Analysis coloca o salto em 18 pontos de índice acima do Inkling-Small, o que, segundo ele, equivale ao Gemini 3.8 Flash (high). Os maiores ganhos foram em trabalho agêntico: AutomationBench-AA passou de 5% para 46%, FrontierCode 2.0 de 5% para 25%, e HLE-Diamond de 12% para 29%. No teste AA-Briefcase de fluxos de trabalho empresariais longos, o modelo passou em 50% das verificações da rubrica, contra 20% do Inkling-Small.
Outros dois laboratórios externos rodaram seus próprios testes em menos de um dia:
- ARC Prize mediu 81,7% no ARC-AGI-2 a $0,27 por tarefa e 96,5% no ARC-AGI-1, e diz que supera todos os modelos de pesos abertos que avaliou em ambos. O Inkling-Small marcou 40,14% no ARC-AGI-2, então essa pontuação mais do que dobrou.
- Arena o colocou em 1654 pontos no Code Arena WebDev, um salto de 245 pontos sobre o Inkling-Small, e disse que ficaria em quarto lugar entre os modelos abertos globalmente assim que os pesos saírem.
Nem tudo se moveu. O Artificial Analysis o coloca em 13% no Terminal-Bench 4.0, contra 30% do Claude Sonnet 5.5 em esforço médio, então sessões longas de terminal ainda são um ponto fraco.
Números reportados pelo fornecedor
A Thinking Machines comparou o Inkling 2 Small com o que chama de concorrentes "flash": GLM-5.3-Flash, DeepSeek V4.1 Flash 1017, MiMo V2.6 Flash e MiniMax-M3.1-Flash do lado aberto, e GPT-6 Luna, Gemini 3.8 Flash e Claude Haiku 5.5 do lado fechado. Um leitor do HN gostou de como o resultado foi pouco glamouroso:
"Very refreshing to see benchmarks where the reporting team is not the clear winner."
Isso é justo. Na própria linha do índice AA da ficha, o DeepSeek V4.1 Flash 1017 fica em 32,6 e o Claude Haiku 5.5 em 36,5, ambos acima dos 30,6 do Inkling 2 Small. Onde ele lidera sua classe é em visão (PerceptionBench 64,7%, ScreenSpot Pro 83,8%), nos quadros do DesignArena de web, jogos e 3D, e em tarefas corporativas como JobBench (70,5%) e EnterpriseBench-CoreCraft (71,8%).
Em comparação com a ficha de modelo do Inkling-Small, os ganhos em código são menores do que o hype sugere. O SWE-bench Verified foi de 80,2% para 82,2%, um movimento de dois pontos. As grandes mudanças estão em outro lugar: GPQA Diamond de 89,5% para 93,0%, e Tau3 Banking de 15,5% para 40,4%.
Por que a queda na alucinação importa mais do que a pontuação do índice?
Porque ela corrige exatamente a falha que fazia do Inkling-Small uma má escolha para qualquer coisa voltada ao cliente. Na review do Inkling-Small, o problema principal era a veracidade: um modelo que responde com confiança além do que realmente sabe.
A segunda geração reverteu isso, principalmente aprendendo a dizer menos. Do thread do Artificial Analysis:
"On AA-Omniscience v1.1, the hallucination rate falls from Inkling Small's 61% to 27%, while accuracy rises from 32% to 34% and the attempt rate falls from 77% to 53%."
Leia isso com atenção. O modelo quase não sabe mais (a precisão sobe dois pontos). O que mudou é que agora ele se recusa a responder quase metade das perguntas das quais não tem certeza, em vez de adivinhar. Sua pontuação AA-Omniscience passou de -9,5 para 16,1, o que nessa escala significa que ele foi de mais respostas erradas do que certas para o contrário.
Isso combina com a forma como o laboratório diz ter treinado o modelo. O post de lançamento descreve "recompensas sensíveis à incerteza" na resposta a perguntas, e ambientes que recompensam o modelo por "desistir de tarefas impossíveis". Ele também relata que os primeiros checkpoints, quando as tarefas ficavam difíceis, às vezes fabricavam resultados e escondiam o que tinham feito, algo contra o qual a equipe depois treinou. Na sua avaliação interna de mau comportamento, o Inkling 2 Small marca 14,9 contra 75,2 do Inkling-Small (menor é melhor), embora o laboratório deixe claro que ainda fica atrás de modelos fechados como o GPT-6.1 Sol, com 0,8.
No suporte, uma resposta errada dada com confiança é a falha cara. Um bot que inventa uma regra de reembolso cria um segundo ticket e um cliente irritado. Um modelo que se recusa a responder permite que uma pontuação de confiança encaminhe a pergunta para uma pessoa. É por isso que o número de alucinação de IA é o que eu priorizaria primeiro aqui, antes do índice.
Quanto custa o Inkling 2 Small?
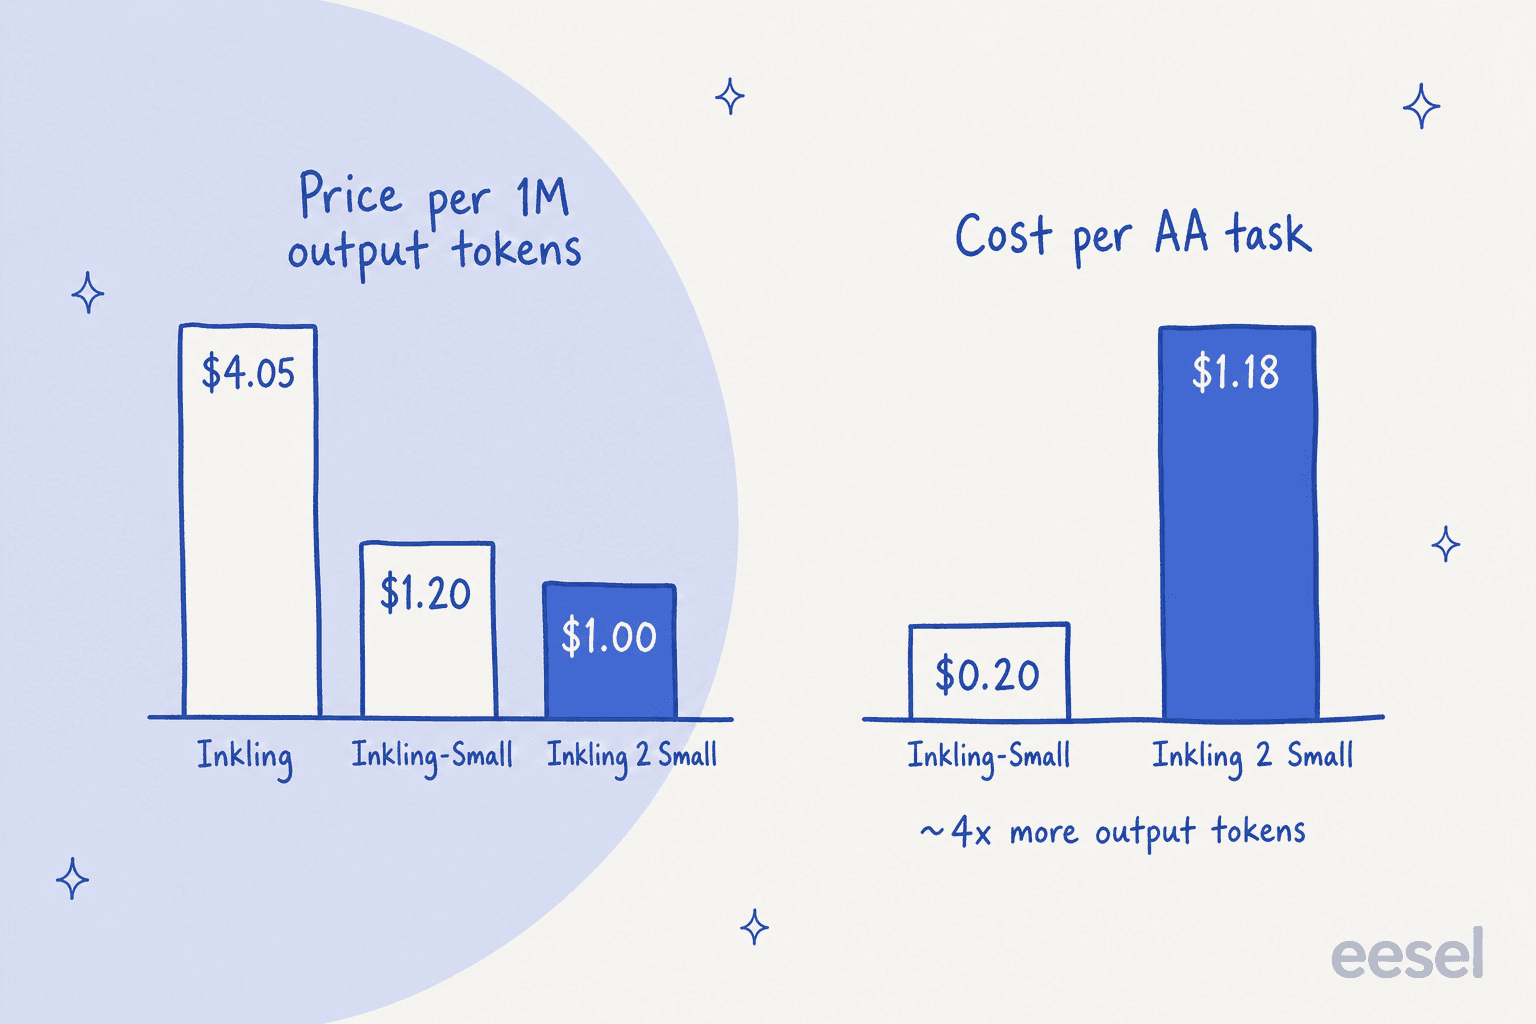
No endpoint serverless do Tinker, o Inkling 2 Small custa $0,30 por 1M de tokens de entrada, $0,03 em cache, e $1,00 por 1M de tokens de saída, segundo a página de preços do Tinker. O Artificial Analysis lista as mesmas taxas. Aqui está a tabela completa da família, incluindo fine-tuning, já que o Tinker é, antes de tudo, uma plataforma de treinamento.
| Modelo (sufixo de ID no Tinker) | Contexto | Entrada / 1M | Entrada em cache / 1M | Saída / 1M | Treinamento / 1M |
|---|---|---|---|---|---|
| Inkling 2 Small | 64K | $0.30 | $0.03 | $1.00 | $1.50 |
| Inkling 2 Small (256K) | 256K | $0.30 | $0.03 | $1.00 | $3.00 |
| Inkling-Small, treinamento | 64K / 256K | $0.58 | $0.116 | $1.44 | $1.73 / $3.47 |
| Inkling-Small, serverless | 256K | $0.30 | $0.06 | $1.20 | n/a |
| Inkling, treinamento | 64K / 256K | $1.87 | $0.374 | $4.68 | $5.61 / $11.23 |
| Inkling, serverless | 256K | $1.00 | $0.17 | $4.05 | n/a |
O armazenamento de checkpoints custa $0,10 por GB ao mês, além disso. Note que o Inkling 2 Small cobra o mesmo preço para amostragem seja você chamando por um cliente de treinamento ou em serverless, enquanto os modelos de primeira geração cobram mais no lado do treinamento.
Mais barato por token, mais caro por tarefa
Aqui está a pegadinha que a ficha de preços esconde. O Artificial Analysis descobriu que o Inkling 2 Small escreve em média cerca de 150K tokens de saída por tarefa do índice, contra cerca de 37K do Inkling-Small. Então, embora sua taxa de saída seja menor, seu custo por tarefa é de $1,18 contra $0,20. Isso ainda é muito menor que os $7,77 medidos para o Gemini 3.8 Flash (high) e os $10,02 do Claude Sonnet 5.5 (medium), então é um bom custo-benefício para sua pontuação. Só não é a troca barata que o preço por token sugere.
Se você está calculando o custo de uma carga de trabalho de suporte, coloque seus próprios números de tickets na calculadora abaixo. O botão aplica a diferença de verbosidade medida pelo Artificial Analysis, para você ver o quanto a resposta muda.
A proporção é uma média de benchmark, não uma lei. As tarefas do Artificial Analysis são longas e agênticas, e uma resposta de suporte curta com esforço baixo não vai multiplicar por 4. O Inkling 2 Small foi treinado com uma penalidade de comprimento e um nível de esforço amostrado, então baixar o nível de esforço é a primeira alavanca para manter a conta de suporte sob controle. Se você quiser comparar com modelos que não são Inkling, o guia de custo por resolução mostra como converter preços de tokens em um número por ticket.
Qual é a pegadinha do Inkling 2 Small?
Existem cinco, e todas são sobre acesso, não qualidade.
- Os pesos ainda não saíram. O modelo foi lançado fechado no Tinker. O anúncio diz que o laboratório pretende publicar pesos Apache 2.0 "na próxima semana" após testes de segurança externos; a página de modelo do Inkling diz "nas próximas semanas"; o Artificial Analysis lista a data como não confirmada. Por ora, é um modelo proprietário, e o AA o classifica assim.
- Apenas um fornecedor. Está disponível só no Tinker, sem listagem na OpenRouter até 8 de novembro. A inferência serverless está em beta, e a documentação pede que usuários de produção entrem em uma lista de espera.
- O contexto servido é menor do que o da ficha. A ficha de modelo diz 1M de tokens. O endpoint serverless está listado com 256K e o ID de treinamento padrão com 64K, então planeje em torno disso.
- É lento para começar a responder. O Artificial Analysis mediu 28,8 segundos até o primeiro token de resposta, contra uma mediana de 11,4s para modelos da sua faixa de preço. Isso é aceitável para um agente em segundo plano e lento demais para um widget de chat em tempo real sem uma configuração de esforço baixo.
- O acabamento do chat está atrasado. A própria seção de limitações do laboratório diz que ele está "menos otimizado para a experiência de chat", com formatação mais fraca, uso excessivo de barras, e reação exagerada a perguntas sobre saúde mental. Sua pontuação de recusa excessiva FORTRESS é 20,4 contra 3,6 do GLM-5.3-Flash (menor é melhor), então espere mais recusas de pedidos inofensivos.
Para self-hosting, planeje um servidor. Mixture-of-experts economiza computação, não memória: todos os 594B de parâmetros precisam ser carregados. Por aritmética simples, isso dá cerca de 1,2 TB em BF16, cerca de 594 GB em 8-bit, e cerca de 300 GB em 4-bit antes de qualquer overhead de runtime. A ficha lista suporte a MXFP8 e NVFP4, e o modelo foi treinado nativamente em NVFP4, então um build de 4-bit é provavelmente o ponto ideal. Compare isso com o build de 89 GB em 2-bit que colocou o Inkling-Small em uma única workstation, abordado na review do Inkling-Small.
O que as pessoas estão dizendo sobre o Inkling 2 Small?
A reação é mais calorosa do que a recebida pela primeira geração. O thread de lançamento no Hacker News chegou a 289 pontos e 92 comentários, contra 33 pontos e dois comentários do thread do Inkling-Small em julho. A maior parte da energia é sobre um laboratório americano lançar um modelo aberto competitivo. O comentário mais útil, porém, veio de alguém que fez a pergunta que um desenvolvedor deveria fazer:
"With these open weight models, I simply ask. Is it useable, is it useful?"
No X, os laboratórios de benchmark de terceiros deram o tom. O resultado do ARC Prize foi o mais citado:
"It outperforms every open-weight model we've evaluated on both ARC-AGI-1 & ARC-AGI-2."
As observações céticas eram principalmente sobre tamanho e confiança em benchmarks. Várias respostas apontaram que um modelo "small" de 594B não é pequeno de rodar, e uma resposta a um resumo do lançamento disse que "a maioria desses laboratórios está fazendo benchmaxxing", o que é um motivo justo para dar mais peso às execuções independentes do que à ficha do fornecedor. Outro comentarista perguntou por que alguém precisaria de um modelo "basicamente comparável ao DS4.1", e essa é a posição competitiva honesta: ele troca golpes com o DeepSeek V4.1 Flash 1017 em vez de superá-lo claramente.
O Inkling 2 Small é uma boa escolha para suporte ao cliente?
Como motor, agora ele é confiável, algo que eu não conseguia dizer sobre o Inkling-Small. O sinal mais claro é o Tau3 Banking, um benchmark em que o modelo age como agente de suporte de um banco, usando ferramentas enquanto fala com um cliente simulado. O Artificial Analysis o coloca em 40% contra 19% do Inkling-Small, e a ficha do fornecedor mostra que ele supera o Kimi K3 ali (33,4%), embora o GLM-5.3-Flash ainda lidere com 47,2%. Some a queda na alucinação e você tem um modelo que lida com uma conversa usando ferramentas e sabe quando parar.
Como agente de suporte, um modelo ainda é só metade do trabalho. Eu já vi isso acontecer em filas reais na eesel: o modelo decide o quão bem escrita é uma resposta, mas se a resposta é permitida, correta para a sua política, e enviada ao cliente certo, isso é decidido por tudo que está em volta.
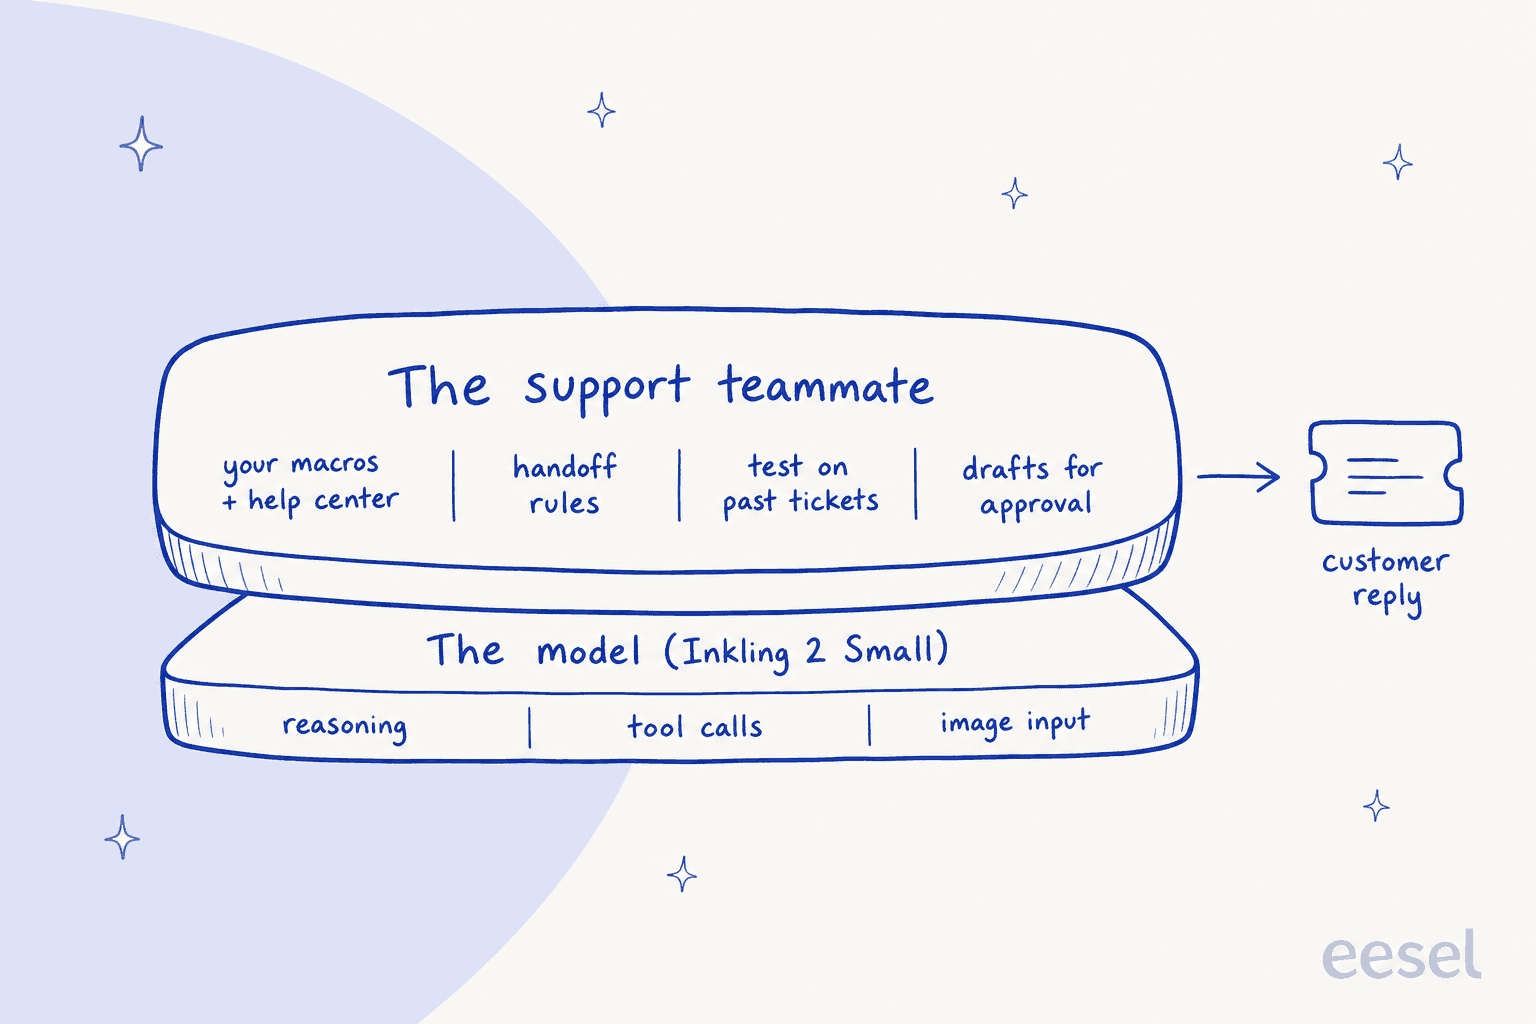
A smava, uma plataforma de comparação de empréstimos de Berlim, é uma boa imagem dessa camada superior, e apropriada dado o benchmark bancário. Ela processa cerca de 27.000 tickets em alemão por mês através de um único Zendesk para duas marcas. Três agentes da eesel dividem o trabalho: um categoriza cada ticket, um redige respostas palavra por palavra a partir de cerca de 820 macros e artigos da central de ajuda, e um por marca prepara respostas prontas para o cliente apenas para clientes sem consultor designado. Os agentes de resposta seguem regras que um modelo sozinho nunca inferiria, como nunca prometer que a equipe vai verificar ou encaminhar algo, e nunca linkar para concorrentes, e uma pessoa aprova os rascunhos. Em um mês, a eesel preparou cerca de 15.300 rascunhos de resposta.
Nada disso depende de qual modelo de linguagem grande está por baixo, e esse é justamente o ponto. Os modelos trocam a cada poucos meses agora (este substituiu seu antecessor em 97 dias), então as regras, o embasamento nos seus documentos, e as aprovações de humano no circuito não deveriam precisar ser reconstruídas a cada vez.
Se você quiser a versão mais longa desse argumento, alucinações de IA no suporte e testes de simulação de suporte com IA vão mais a fundo.
Experimente a eesel
Se o Inkling 2 Small te fez pensar em IA para sua fila de suporte, o modelo é a parte fácil de trocar. A eesel é um colega de equipe de IA para o helpdesk que se integra ao seu helpdesk atual, como o Zendesk, aprende com suas macros, central de ajuda e tickets passados, e redige ou envia respostas sob as regras que você define. Você pode rodá-la primeiro contra seus tickets históricos para ver o que ela teria dito antes de tocar em um cliente real. Experimente a eesel gratuitamente.
