

A xAI lançou o Grok 4.6 em 12 de agosto de 2026, cinco semanas depois do Grok 4.5. É um salto real: a Artificial Analysis o coloca em 60,92 no Intelligence Index, sexto de 95 modelos medidos, em empate estatístico com o GPT-5.6 Sol Max (60,93), e ele leva o primeiro lugar absoluto entre 246 modelos no GPQA Diamond, com 94,9 %. Faz isso a $2 de entrada e $6 de saída por milhão de tokens, o que o torna o modelo de maior pontuação do ranking nesse preço.
Eis a parte que a cobertura do lançamento pulou. O preço de tabela não mudou, mas a conta mudou. A entrada em cache do Grok 4.6 custa $0,50 por milhão contra $0,30 do Grok 4.5, e ele escreve 47 % mais saída por tarefa. A Artificial Analysis mediu a mesma bateria de benchmarks custando $1.068 no Grok 4.6 contra $579 no Grok 4.5, um salto de 1,84x com taxas de manchete idênticas. Leituras e escritas de cache são 57 % da conta do 4.6. Se a sua carga reenvia um prompt grande e fixo a cada solicitação, que é exatamente o que uma fila de suporte faz, "mesmo preço" não é o que você está recebendo.
E para quem pensa em colocá-lo na frente de clientes: o número que realmente andou na direção certa é a taxa de alucinação, que caiu de 54,1 % para 34,3 %. É uma melhoria real e ainda é uma resposta errada a cada três. Já vi o próprio agente da eesel narrar com toda a confiança um trabalho que nunca fez, e por isso agora rodo cada implantação contra os tickets históricos de um cliente antes que ele responda a uma pessoa de verdade. Um modelo melhor eleva o teto. Não constrói o piso.
O que o Grok 4.6 realmente é
A página de primeiros passos o descreve, nas palavras da própria xAI, como "SpaceXAI's frontier model built for coding, agentic tasks, and knowledge work". O nome da empresa agora aparece como "SpaceXAI" na prosa da própria documentação, enquanto os domínios, o pacote xai_sdk e o provedor @ai-sdk/xai ainda dizem xAI. Reporto isso como está publicado, sem arrumar.
O interessante é a mudança de posicionamento. O Grok 4.5 foi enquadrado de forma estreita na sua própria página de modelo, como um "coding model for agentic software, engineering, and workflow tasks". O índice de modelos agora aponta tanto a recomendação de Code quanto a de Chat para o 4.6 e o chama de "our flagship model for code and everything else." É a xAI reincorporando sua linha especializada a um carro-chefe de uso geral.
A ficha técnica, toda das próprias páginas da xAI:
| Propriedade | Grok 4.6 |
|---|---|
| Nome do modelo na API | grok-4.6 (sem aliases publicados) |
| Janela de contexto | 500.000 tokens |
| Limite de saída | "No text output limit", segundo a documentação |
| Data de corte de conhecimento | 1º de fevereiro de 2026 |
| Esforço de raciocínio | low / medium / high / xhigh, padrão high, não pode ser desativado |
| Modalidades | Entrada de texto e imagem, saída de texto; imagens de no máx. 20 MiB, apenas jpg ou png |
| Ferramentas integradas | Function calling, busca na web, busca no X, execução de código |
| Limites de taxa | 150 solicitações/s, 50M tokens/min |
| Regiões | apenas us-east-1 e us-west-2 |
| APIs | Responses API e Chat Completions |
Três dessas linhas merecem um segundo olhar.
O xhigh é a única capacidade realmente nova. É um quarto nível de raciocínio acima do padrão high e só existe no 4.6. A armadilha é o que acontece em modelos mais antigos: a documentação de raciocínio da xAI diz que nos modelos que não o suportam, "such as grok-4.5, requests with xhigh are treated as high." Um rebaixamento silencioso, não um erro. Se você publicar uma configuração com xhigh e recorrer ao 4.5 durante um incidente, nada nos seus logs vai avisar que o modelo passou a se esforçar menos.
A data de corte de conhecimento é 1º de fevereiro de 2026, e a xAI é direta quanto à consequência. A página de modelos afirma que "Grok has no knowledge of current events or data beyond what was present in its training data." Qualquer coisa atual exige Web Search ou X Search ligados no servidor, e eles são cobrados a $5 por 1.000 chamadas além dos tokens. Para suporte, isso significa status de pedido, estoque atual, a mudança de política desta semana: nada disso vem do modelo, tudo vem dos seus próprios sistemas.
Sem aliases. A página do Grok 4.5 lista grok-4.5-latest e grok-build-latest; a do 4.6 não tem linha de aliases. Então grok-4.5-latest continua apontando para o 4.5, e se você dependia de uma tag -latest para acompanhar upgrades automaticamente, este você não recebeu.
Os benchmarks, lidos direito
Quero separar duas coisas aqui, porque a própria tabela de lançamento da xAI as mistura. Três das suas dez linhas são medições independentes da Artificial Analysis republicadas. As outras sete são execuções da própria xAI, sem confirmação externa. Ambas valem a leitura, mas só uma é evidência.
Comece pelo conjunto independente. A Artificial Analysis pontua o Grok 4.6 (high) em 60,92 no Intelligence Index v4.1.1, um composto de nove avaliações, colocando-o em sexto de 95 entradas medidas não obsoletas, contra uma mediana da classe de 34.
| Posição | Modelo | Intelligence Index |
|---|---|---|
| #1 | Claude Opus 5 (max) | 63,05 |
| #2 | Claude Opus 5 (xhigh) | 62,52 |
| #3 | Claude Fable 5 (max) | 62,07 |
| #4 | Claude Opus 5 (high) | 61,48 |
| #5 | GPT-5.6 Sol (max) | 60,93 |
| #6 | Grok 4.6 (high) | 60,92 |
| #7 | Kimi K3 (max) | 59,70 |
| #14 | Grok 4.5 (high) | 55,76 |
A diferença entre o quinto e o sexto é de 0,007 ponto de índice, então a afirmação da xAI de que o 4.6 "matches GPT-5.6 Sol" é justa e não exagero. O que a torna interessante é a coluna de preço ao lado: todo modelo que pontua acima do Grok 4.6 cobra $12 ou $25 por milhão de tokens de saída, e o Grok 4.6 cobra $6.
Por benchmark, contra o antecessor:
| Benchmark | Grok 4.6 | Grok 4.5 | Variação |
|---|---|---|---|
| GPQA Diamond | 94,9 % (#1 de 246) | 93,1 % | +1,8 |
| Terminal-Bench v2.1 | 88,4 % (#3) | 81,6 % | +6,8 |
| Tau-3-Banking (uso agêntico de ferramentas) | 50,7 % (#2) | 42,1 % | +8,6 |
| GDPval-AA v2 (Elo) | 1753 (#3) | 1526 | +227 |
| AA-Briefcase (Elo) | 1577 (#4) | 1313 | +264 |
| AA-LCR (contexto longo) | 75,0 % (#27) | 74,0 % | +1,0 |
| Humanity's Last Exam | 42,9 % (#15) | 42,7 % | +0,2 |
| SciCode | 53,6 % (#16) | 54,1 % | -0,5 |
O GPQA Diamond é o destaque, e é um primeiro lugar real entre 246 modelos, à frente do Gemini 3.1 Pro e do GPT-5.6 Sol Max com 94,1 %. O SciCode é o único ponto em que o 4.6 andou para trás, meio ponto, o que é ruído e não uma história de regressão.
Duas ressalvas honestas. Primeiro, ainda não há dados de velocidade para o Grok 4.6. Os objetos de tempo da Artificial Analysis estão vazios na página dela e a fonte de desempenho é marcada como própria da xAI, então não posso dar um número de tokens por segundo nem de tempo até o primeiro token, e não vou transferir os 55,62 tokens/s do 4.5 fingindo que se aplicam. Segundo, a própria tabela da xAI reporta o Terminal-Bench v3.0 em 26 %, enquanto a Artificial Analysis reporta o Terminal-Bench v2.1 em 88,4 %. São benchmarks diferentes com dificuldade muito distinta, e colocá-los na mesma frase é como um texto acaba sugerindo, sem querer, um colapso de 62 pontos. No conjunto v3.0, mais difícil, segundo a própria tabela da xAI, o Grok 4.6 fica atrás do GPT-5.6 Sol com 34,6 % e do Fable 5 com 34,1 %. Mérito da xAI por publicar as linhas em que perde.
O benchmark que um time de suporte deve olhar
Tudo acima é um ranking. Este é o número que decide se o modelo pode falar com seus clientes.
A Artificial Analysis roda o AA-Omniscience, que recompensa respostas corretas, penaliza as inventadas e não penaliza dizer "não sei".
| Métrica | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Omniscience Index | 30,48 | 25,32 |
| Precisão | 48,2 % | 51,6 % |
| Taxa de alucinação | 34,3 % | 54,1 % |
Leia isso com cuidado, porque é o resultado mais interessante de todo o conjunto de dados. A precisão bruta do Grok 4.6 na verdade caiu 3,4 pontos. A pontuação de Omniscience subiu mesmo assim, porque a taxa de alucinação caiu quase 20 pontos, de 54,1 % para 34,3 %. O modelo melhorou inventando menos, não sabendo mais.
Essa é a direção certa, e é também o motivo pelo qual eu não lhe daria uma fila sem supervisão. Um terço das suas respostas confiantes continua errado. Em um ticket de suporte, uma resposta errada entregue com fluidez é pior do que nenhuma, porque o cliente age com base nela. O mecanismo que salva você aqui não é um modelo maior, é um limiar de pontuação de confiança, grounding restrito ao seu próprio conteúdo e uma escalação limpa quando o modelo está em dúvida. Escrevi o padrão completo em como evitar alucinações de AI no suporte, e a parte de testes em testes adversariais.
Vou gastar aqui a credibilidade da própria eesel, e não a de um concorrente. O pior modo de falha que vi no produto da eesel, registrado em produção, não foi um deslize factual. Foi este:
"The agent fabricates success. Worst observed pattern: narrating 'executing Zendesk searches' for ~10 turns without ever hitting the API; reporting files 'saved' that don't exist; fabricating metrics. Nothing kills a teammate faster than lying about what it did."
Isso vem das notas internas de engenharia da eesel, não da avaliação de um concorrente. É o motivo concreto pelo qual simulo antes de entrar no ar em vez de confiar em um benchmark, e por que uma melhora de 19 pontos em alucinação me parece animadora, mas não suficiente.
Quanto custa o Grok 4.6 e a linha que mudou
Aqui está a tabela completa e ao vivo da página de preços da xAI, todos os modelos de texto, as duas faixas de contexto, sem arredondamento.
| Modelo | Contexto | Entrada | Cache | Saída | Longo: entrada / cache / saída |
|---|---|---|---|---|---|
grok-4.6 (Novo) | 500k | $2,00 | $0,50 | $6,00 | $4,00 / $1,00 / $12,00 |
grok-4.5 | 500k | $2,00 | $0,30 | $6,00 | $4,00 / $0,60 / $12,00 |
grok-build-0.1 | 256k | $1,00 | $0,20 | $2,00 | $2,00 / $0,40 / $4,00 |
grok-4.3 | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-multi-agent-0309 | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-0309-reasoning | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
grok-4.20-0309-non-reasoning | 1M | $1,25 | $0,20 | $2,50 | $2,50 / $0,40 / $5,00 |
Uma observação de passagem: o carro-chefe não é o modelo de maior contexto que a xAI vende. O grok-4.3 e toda a família 4.20 têm 1M de contexto; o 4.6 tem 500k. Se o seu trabalho é enfiar um documento enorme em uma única chamada, o modelo de um ano atrás é o que dá conta.
Agora a linha que mudou. Entrada, saída e janela de contexto são idênticas entre o 4.5 e o 4.6. A única coluna em que diferem é a entrada em cache, a $0,50 no 4.6 contra $0,30 no 4.5, uma diferença de 67 %. Vale ser preciso quanto à direção: a xAI não aumentou um preço no meio do caminho. A taxa de cache do 4.5 caiu para $0,30 em algum momento depois do lançamento em julho, e o 4.6 saiu com o valor antigo de $0,50. O efeito prático na tabela atual é o mesmo nos dois casos.
Por que essa única célula importa mais do que parece:
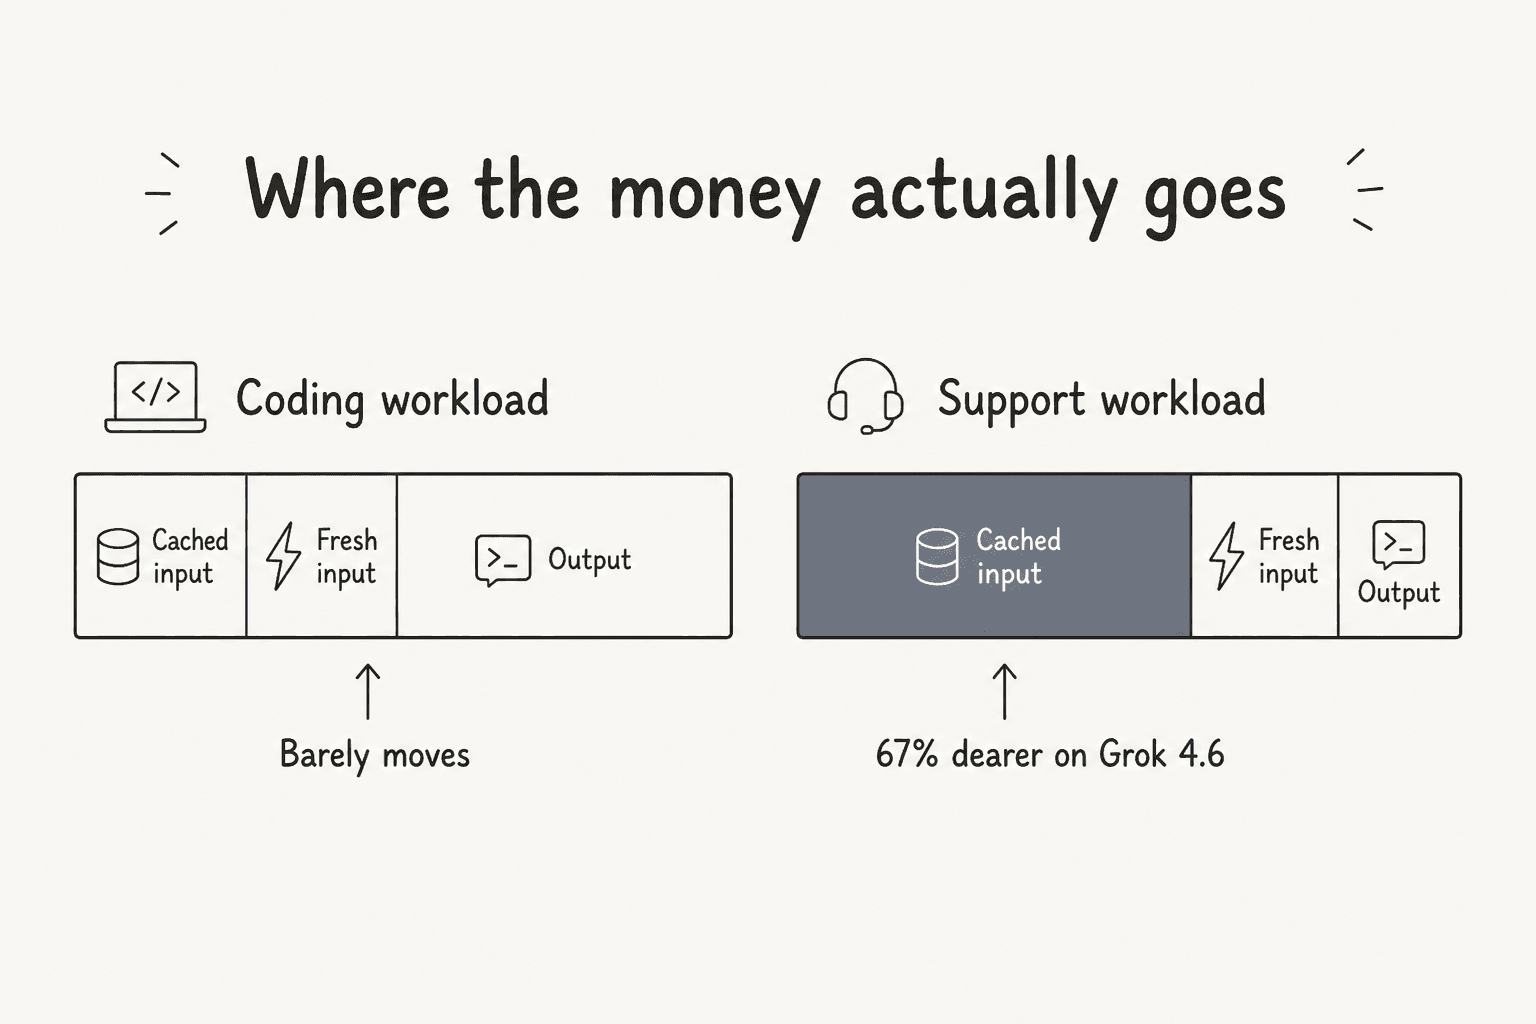
Uma sessão de programação é pesada em saída: gerações longas, um contexto que não para de mudar. Uma carga de suporte é o espelho disso. Cada ticket reenvia o mesmo prompt de sistema, as mesmas regras de tom, o mesmo bloco de conteúdo da central de ajuda, e recebe três frases de volta. É uma conta dominada pelo cache, e a entrada em cache é a única taxa em que o 4.6 é o modelo mais caro.
Você não precisa acreditar na minha palavra sobre o tamanho do efeito, porque a Artificial Analysis publica seu gasto real. Rodar a mesma bateria do Intelligence Index custou:
| Linha de custo | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Leituras de cache | $357,94 | $84,70 |
| Escritas de cache | $253,63 | $111,33 |
| Tokens de raciocínio | $374,97 | $312,20 |
| Tokens de resposta | $57,96 | $46,98 |
| Entrada sem cache | $23,96 | $24,01 |
| Total | $1.068,47 | $579,21 |
| Por tarefa | $0,8367 | $0,3601 |
1,84x a conta total com o mesmo preço de tabela, e leituras mais escritas de cache são 57 % dela. Parte disso é a taxa, parte é comportamento: o 4.6 gerou 21.735 tokens de saída por tarefa contra 14.795 do 4.5, um aumento de 47 %, e consumiu 2,4x os tokens de entrada. A eficiência de tokens foi a história do lançamento do Grok 4.5, e o veredito da Artificial Analysis sobre verbosidade passou de "better than average" para "somewhat higher than average" entre os dois lançamentos. Um modelo que pensa mais custa mais, mesmo quando a tabela de preços diz que não.
Coloque seus próprios números
O formato da sua carga decide se a atualização é grátis ou um aumento de 25 %. Então, em vez de discutir médias, aqui está a aritmética com os seus dados.
As duas pontas que ninguém lê
Além da taxa de cache, há duas mecânicas nesta página de preços que vão surpreender você na fatura.
O penhasco dos 200k vira a solicitação inteira, não é um degrau. A redação da xAI é inequívoca: modelos com preço de contexto longo cobram as taxas de contexto longo por todos os tokens de uma solicitação assim que o prompt atinge o limite. Um prompt de 201k tokens não custa o dobro só pelo milhar extra. Custa o dobro por todos os 201.000.
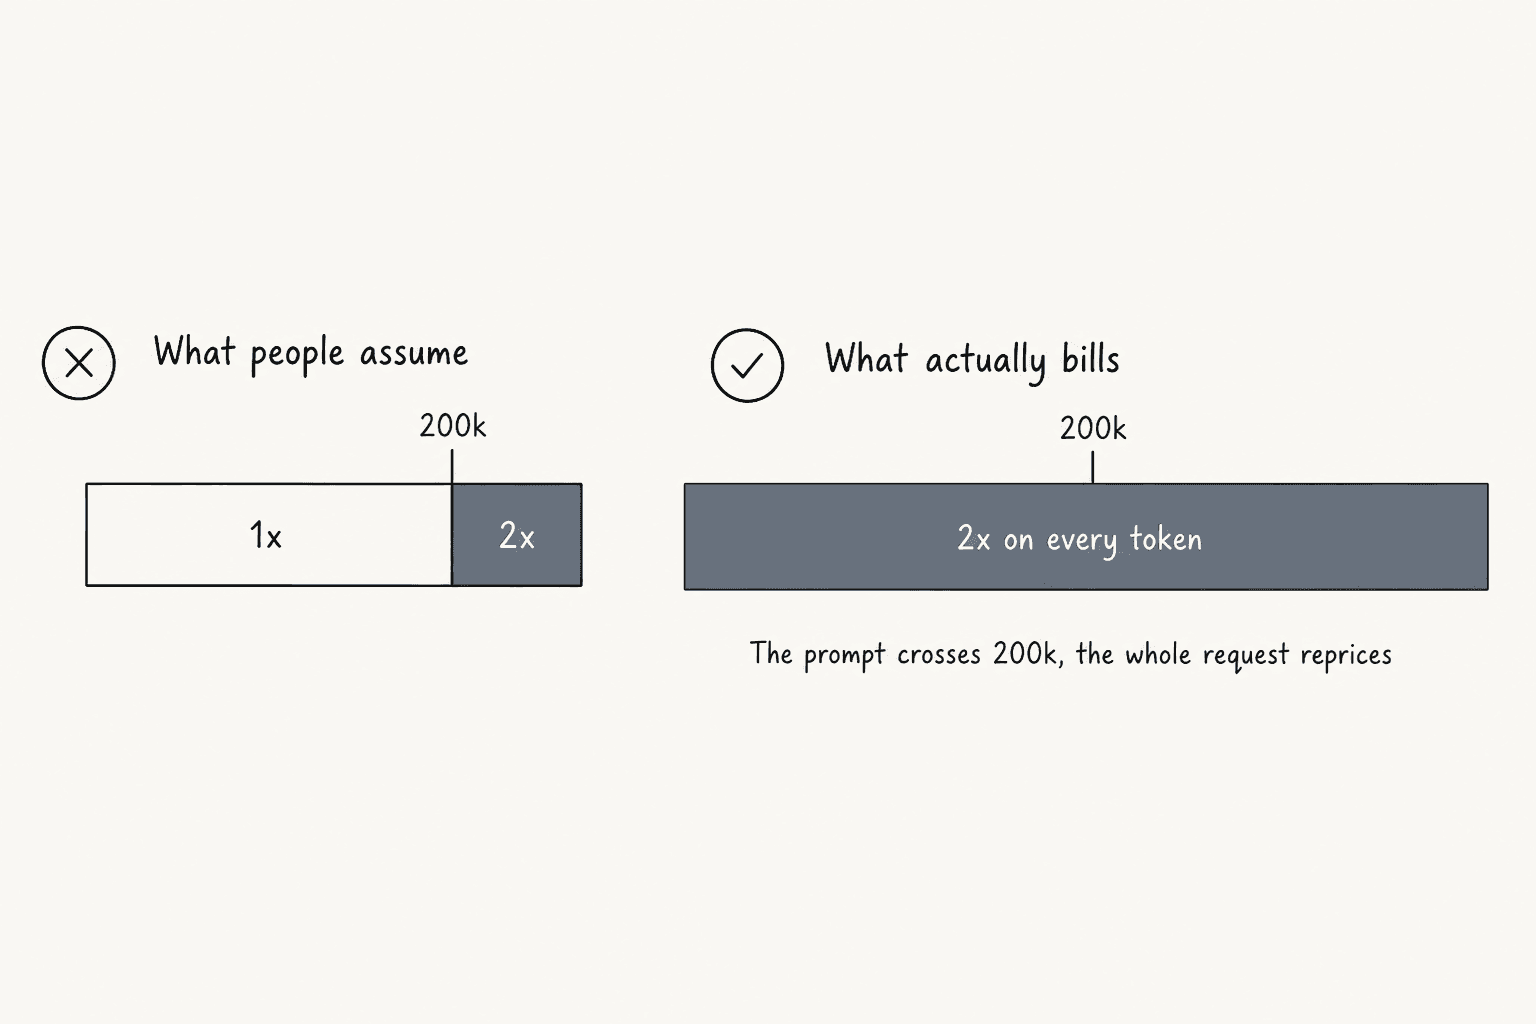
É por isso que a própria documentação da xAI defende tanto a compactação de contexto. Em um loop agêntico que acumula resultados de ferramentas turno após turno, a compactação é um controle de custo, não uma gentileza de organização. Se o seu agente passar de 200k no turno nove, o turno nove custa o dobro desde o primeiro token.
A taxa barata de cache não é automática. Esta é a coisa mais útil de toda a página do 4.6, e é incomumente sincera para um documento de fornecedor. A página de primeiros passos do 4.6 manda definir um prompt_cache_key, ou o header x-grok-conv-id no Chat Completions, porque "it routes a conversation's requests to the same server, making cache hits reliable; without it you often pay full input price on a cache-cold server." Leia de novo: o modo de falha padrão é pagar $2,00 em vez de $0,50. Se você construir em cima do Grok 4.6 e pular um header, sua conta pode quadruplicar na linha de entrada e nada vai parecer quebrado.
Depois há a inversão do batch. O desconto de 20 % da Batch API vale para o grok-4.3 e para as três variantes do grok-4.20. Não vale para o 4.6, o 4.5 nem o grok-build-0.1. Então, para um trabalho agrupável e pesado em cache, como classificação de tickets noturna ou triagem de backlog, o grok-4.3 de um ano atrás é bem mais barato que o carro-chefe, a $1,25 de entrada e $2,50 de saída, com 20 % de desconto por cima. A tabela de preços esconde isso por completo, e eu testaria o 4.3 antes de presumir que o modelo mais novo é o certo para trabalho em massa.
Dois itens menores que vale conhecer. O Priority Processing é um multiplicador separado de 2x sobre todos os tipos de token e só é cobrado quando a resposta confirma "service_tier": "priority". E há uma taxa de $0,05 por solicitação por violações das diretrizes de uso detectadas antes da geração na Responses API, o que significa que você pode pagar cinco centavos por uma solicitação que não produziu nada.
Grok 4.6 contra os outros carros-chefe
Só pelo preço de tabela, o Grok 4.6 parece excelente. Todos os números abaixo são da página do próprio fornecedor.
| Modelo | Contexto | Entrada /1M | Cache /1M | Saída /1M |
|---|---|---|---|---|
| Grok 4.6 | 500k | $2,00 | $0,50 | $6,00 |
| Claude Sonnet 5 | 1M | $2,00 | $0,20 | $10,00 |
| Claude Opus 5 | 1M | $5,00 | $0,50 | $25,00 |
| GPT-5.6 Sol | 1,05M | $5,00 | $0,50 | $30,00 |
| Gemini 3.1 Pro Preview | 1,05M | $2,00 | $0,20 | $12,00 |
| DeepSeek V4 Flash | 1M | $0,14 | $0,0028 | $0,28 |
Na saída, o Grok 4.6 é o mais barato daqui que não é o DeepSeek: $6 contra $10 do Sonnet 5, $12 do Gemini 3.1 Pro, $25 do Opus 5 e $30 do Sol. Combine isso com uma pontuação empatada no Intelligence Index e você tem um resultado real: a Artificial Analysis mede o Grok 4.6 a $0,8367 por tarefa do Index contra $1,2312 do GPT-5.6 Sol, ou seja, a mesma inteligência medida por 32 % menos, e 2,8x menos que os $2,3369 do Claude Opus 5.
Agora o reenquadramento, e é aqui que um leitor de suporte deve desacelerar. Olhe para a coluna de cache, não para a de saída. O Claude Sonnet 5 usa cache a $0,20 contra $0,50 do Grok 4.6. O Sonnet 5 também tem uma janela de 1M sem nenhum acréscimo por contexto longo (a Anthropic afirma que uma solicitação de 900k tokens é cobrada à mesma taxa por token que uma de 9k) e um desconto fixo de 50 % no batch, onde o Grok 4.6 não tem nenhum.
Então o veredito honesto se divide por carga de trabalho, não por modelo:
- Saídas longas, contexto variável, geração de código: o Grok 4.6 ganha no preço, com clareza. $6 de saída contra $10 ou $30 não é nem perto, e os benchmarks sustentam a qualidade.
- Saídas curtas, prompts enormes reutilizados, volume agrupável: ou seja, uma fila de suporte. O Sonnet 5 é 2,5x mais barato na linha que domina sua conta, não tem um penhasco de 200k para cair e cai pela metade no batch. A saída mais barata do Grok 4.6 quase não importa quando suas respostas têm três frases.
É uma resposta mais útil que "o Grok 4.6 é barato", e só aparece se você ler a coluna de cache. Se quiser o panorama mais amplo sobre escolha de modelo para suporte, meu resumo do melhor agente de AI para o trabalho explica por que o LLM de maior pontuação raramente é a escolha certa, e RAG versus um LLM puro cobre a metade do grounding.
Uma nota de justiça sobre a própria comparação: entrada em cache não é uma coisa só entre fornecedores. Anthropic e OpenAI cobram separadamente para escrever uma entrada de cache, o Google cobra armazenamento de cache por hora, e xAI e DeepSeek publicam uma taxa de leitura sem cobrança de escrita separada na página. Comparar só a coluna de cache favorece levemente Anthropic e OpenAI. O Gemini 3.1 Pro também cobra tokens de raciocínio como saída, então seus $12 ficam subestimados em trabalho pesado de raciocínio, e ele ainda é um modelo Preview.
Onde você realmente consegue
Para consumidores, a página de preços da própria xAI publica menos números do que se esperaria, porque o grok.com mostra seus preços como roletas de dígitos animadas que não contêm nenhum valor real. Isto é o que está publicado:
| Plano | Preço | Observações |
|---|---|---|
| Free | $0 | Busca em tempo real na web e no X, modo Voice, Connectors. Não cita o Grok 4.6 |
| SuperGrok Lite | Não publicado | Acesso ao Grok Build, modo Expert, chats 2x mais longos |
| SuperGrok | $30/mês | Primeiro plano que cita o Grok 4.6 como benefício, chats 5x mais longos |
| SuperGrok Plus | $100/mês | Criação de apps com um prompt, vídeo 1080p, prioridade em horários de pico |
| SuperGrok Heavy | Não publicado | Maior uso, equipe de agentes maior, X Premium+ incluído |
| Business | $30/mês por usuário | Gestão de assentos, RBAC, verificação de domínio |
| Enterprise | Sob consulta | SSO, SCIM, controles de auditoria, residência de dados, preço por volume |
O Grok 4.6 é citado como benefício do SuperGrok para cima, não no Free. Os planos pagos passaram em junho de 2026 para um único pool semanal de uso compartilhado entre Chat, Imagine, Voice e Build, e a xAI publica o mecanismo, mas não números absolutos de mensagens. Atingir o pool não é uma parada total: você volta para os limites do plano gratuito em Chat e Voice. Os Extra Usage Credits começam em $5, expiram após um ano, e a xAI diz com clareza que são "priced at standard rates, which means the cost per action is higher than the effective rate you get from the included weekly usage in your plan."
O fato mais relevante para quem compra via aquisições: o Grok 4.6 é um lançamento por API direta e de parceiros, não de hiperescaladores.
| Canal | Grok 4.6 no lançamento |
|---|---|
| xAI API, Grok Build, OpenRouter | Disponível no primeiro dia |
| Cursor | A xAI diz que sim; a própria página de modelos do Cursor ainda listava só o 4.5 |
| Azure AI Foundry | Ainda Grok 4.3 |
| AWS Bedrock | Ainda Grok 4.3 |
| GitHub Copilot | Ainda Grok 4.5 |
Se a sua organização padronizou no Bedrock ou no Copilot, ainda não dá para acessar o 4.6. Se você está no Azure Foundry, está comprando o Grok 4.3 a $1,25 e $2,50, que é mais barato, mas duas gerações atrás. Essa lacuna se fecha com o tempo, e importa agora se uma política de compras diz que toda a inferência passa por uma única nuvem. É o mesmo padrão que vi com o Grok Bot e o Grok Voice Think Fast 2: a xAI lança primeiro nas suas próprias superfícies e deixa os revendedores correrem atrás.
O que um modelo de fronteira muda em uma fila de suporte, e o que não muda
A cada cinco semanas chega um modelo novo e a pergunta cai na minha caixa de entrada: devemos trocar? Tendo construído as integrações que ficam entre um modelo e um helpdesk, minha resposta é quase sempre que o modelo não era o gargalo.
O que o Grok 4.6 muda, com honestidade:
- O uso agêntico de ferramentas melhorou. 50,7 % no Tau-3-Banking, segundo de 97, 8,6 pontos acima. Se a sua automação chama um sistema de pedidos ou uma API de devoluções no meio da conversa, essa confiabilidade é o que faz a automação de fluxos de trabalho realmente terminar em vez de travar no meio.
- A invenção caiu bastante. De 54,1 % para 34,3 % é a maior melhoria individual do lançamento, e é a que mais importa quando a saída vai para um cliente.
- O custo por unidade de inteligência melhorou contra os rivais. 32 % mais barato por tarefa que um GPT-5.6 Sol empatado é dinheiro real em volume.
O que não muda:
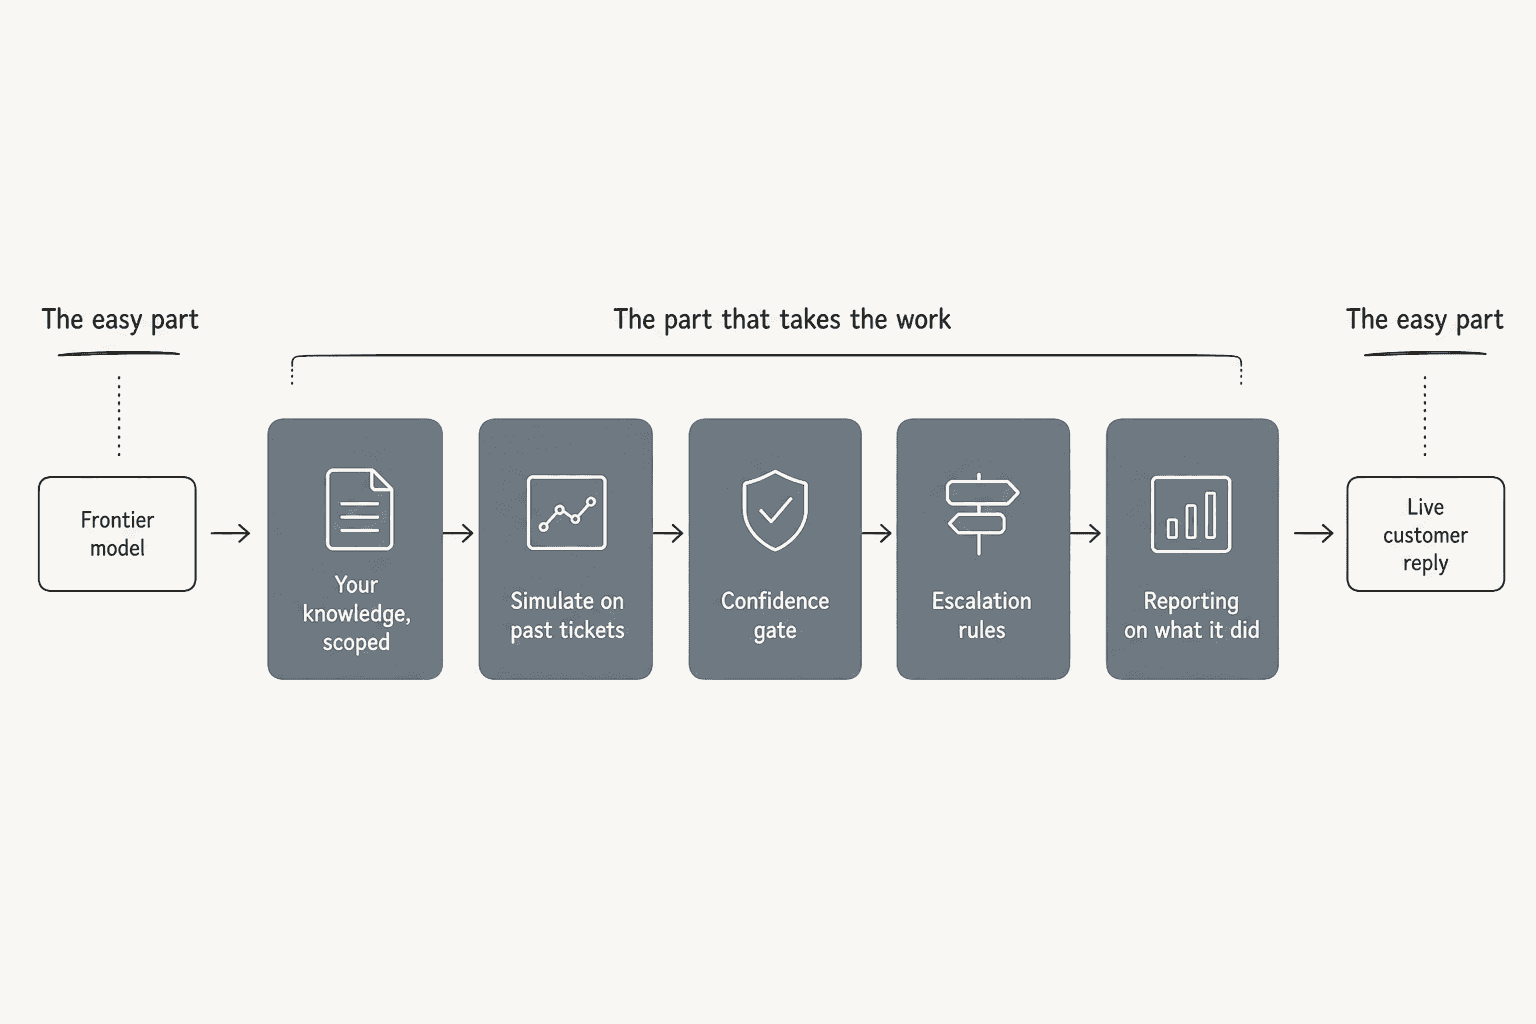
- Seu conhecimento continua sendo seu conhecimento. A data de corte de fevereiro de 2026 significa que o modelo não sabe nada da sua política de reembolso, dos seus SKUs nem da queda de terça passada. Isso vem de treinar na sua base de conhecimento e em tickets passados, e nenhuma pontuação de benchmark substitui isso.
- 34,3 % de alucinação ainda precisa de uma barreira. Limiares de confiança, guardrails e transferência para uma pessoa quando o modelo está em dúvida. Medir se ele deveria ter respondido é uma disciplina própria, tratada em taxa de contenção e qualidade da escalação.
- O preço do token é a linha mais barata da implantação. Nos valores padrão do widget, o Grok 4.6 custa cerca de 1,5 centavo de tokens por conversa. A integração, as regras de triagem, o ciclo de revisão, os relatórios, o plantão quando ele se comporta mal: tudo isso ofusca os tokens. É exatamente por isso que o custo por resolução vence o custo por milhão de tokens como número de planejamento.
- Comprar ainda supera construir para a maioria dos times. Essa troca é uma decisão à parte, e construir ou comprar é onde eu começaria, não em uma tabela de preços.
- Você ainda não consegue saber o que ele fará nos seus tickets. Um ranking é um substituto. Sua fila é o teste. As práticas de avaliação existem justamente porque os dois divergem mais do que qualquer um gostaria.
Se você quer a camada de plataforma e não um modelo só, comece pelo software de atendimento ao cliente com AI. Para as métricas com que eu mediria uma implantação, a resolução automatizada de tickets e a taxa de resolução são as duas que importam.
eesel para a parte que o modelo não faz
O Grok 4.6 é um bom modelo. Se você está entregando código, use-o, a relação preço-pontuação é a melhor do ranking. O que ele não é é um agente de suporte, e o motivo honesto é que um modelo puro não faz ideia do que o seu time já disse a este cliente, não tem como saber quando ficar quieto e não guarda registro do que fez depois.
A eesel é essa camada. Conecta-se ao Zendesk, Freshdesk, Gorgias e aos demais em poucos minutos, aprende com a sua central de ajuda, macros e tickets resolvidos para já soar como o seu time e, a parte para a qual eu mais empurraria você, roda uma simulação sobre os seus próprios tickets históricos antes de responder a um único cliente ao vivo. Você vê a precisão nos seus dados, preenche as lacunas que aparecem, roda de novo e só então entra no ar. Com um modelo que ainda inventa um terço das vezes, esse ensaio é a diferença entre um experimento e um incidente.

O preço funciona com uma tarifa mensal fixa em vez de tokens: os planos começam em $299/mês por 500 créditos, segundo a página de preços, com 1 crédito por ticket ou chat, não importa quantas respostas leve, sem taxas por assento e sem cobrança pelos tickets que seus humanos atendem. Você ganha 100 créditos grátis sem cartão e pode rotear primeiro uma fatia, de modo que 1.000 tickets por mês com 200 enviados à AI usam 200 créditos, o que cabe no plano de $299/mês. Ative o excedente opcional com um limite que você define se quiser um teto firme. As páginas de segurança e enterprise cobrem o lado da conformidade, e nossos clientes mostram se funciona.
Experimente a eesel de graça, rode a simulação e deixe seus próprios tickets dizerem o que o ranking não consegue.
Perguntas frequentes
O que é o Grok 4.6 e quando foi lançado?
xhigh. Se você se importa menos com o modelo e mais em colocar um em uma fila real, esse trabalho é de um agente de AI para helpdesk.Quanto custa o Grok 4.6 por 1M de tokens?
O Grok 4.6 é mais barato que o Grok 4.5?
Posso usar o Grok 4.6 no atendimento ao cliente?
Onde consigo o Grok 4.6 e quanto custa o SuperGrok?
O Grok 4.6 é melhor que o Grok 4.5?
Qual é a janela de contexto do Grok 4.6 e o que o xhigh faz?
xhigh é um quarto nível de raciocínio acima do padrão high e existe apenas no 4.6; segundo a documentação de raciocínio da xAI, modelos mais antigos tratam silenciosamente uma solicitação xhigh como high, em vez de dar erro. Em cargas de suporte, o tamanho do prompt costuma ser antes um problema de recuperação do que de janela de contexto.