

Como analisei e onde minhas evidências terminam
Eu construo integrações e APIs na eesel, a tubulação que fica entre um modelo e um helpdesk em operação. Então esta é uma análise de quem desenvolve: li cada página da documentação speech-to-speech da xAI, as notas de versão, as tabelas de limites de uso e o ranking completo e o thread de lançamento da Artificial Analysis, e comparei tudo com o que escrevi sobre o Grok Voice 2.0 dois meses atrás.
O que não posso afirmar são mil chamadas de produção em uma linha telefônica real, porque o modelo tem um dia. Quando falo do comportamento em escala, o número vem de um limite publicado ou dos próprios números da Starlink divulgados pela xAI, e eu digo qual dos dois.
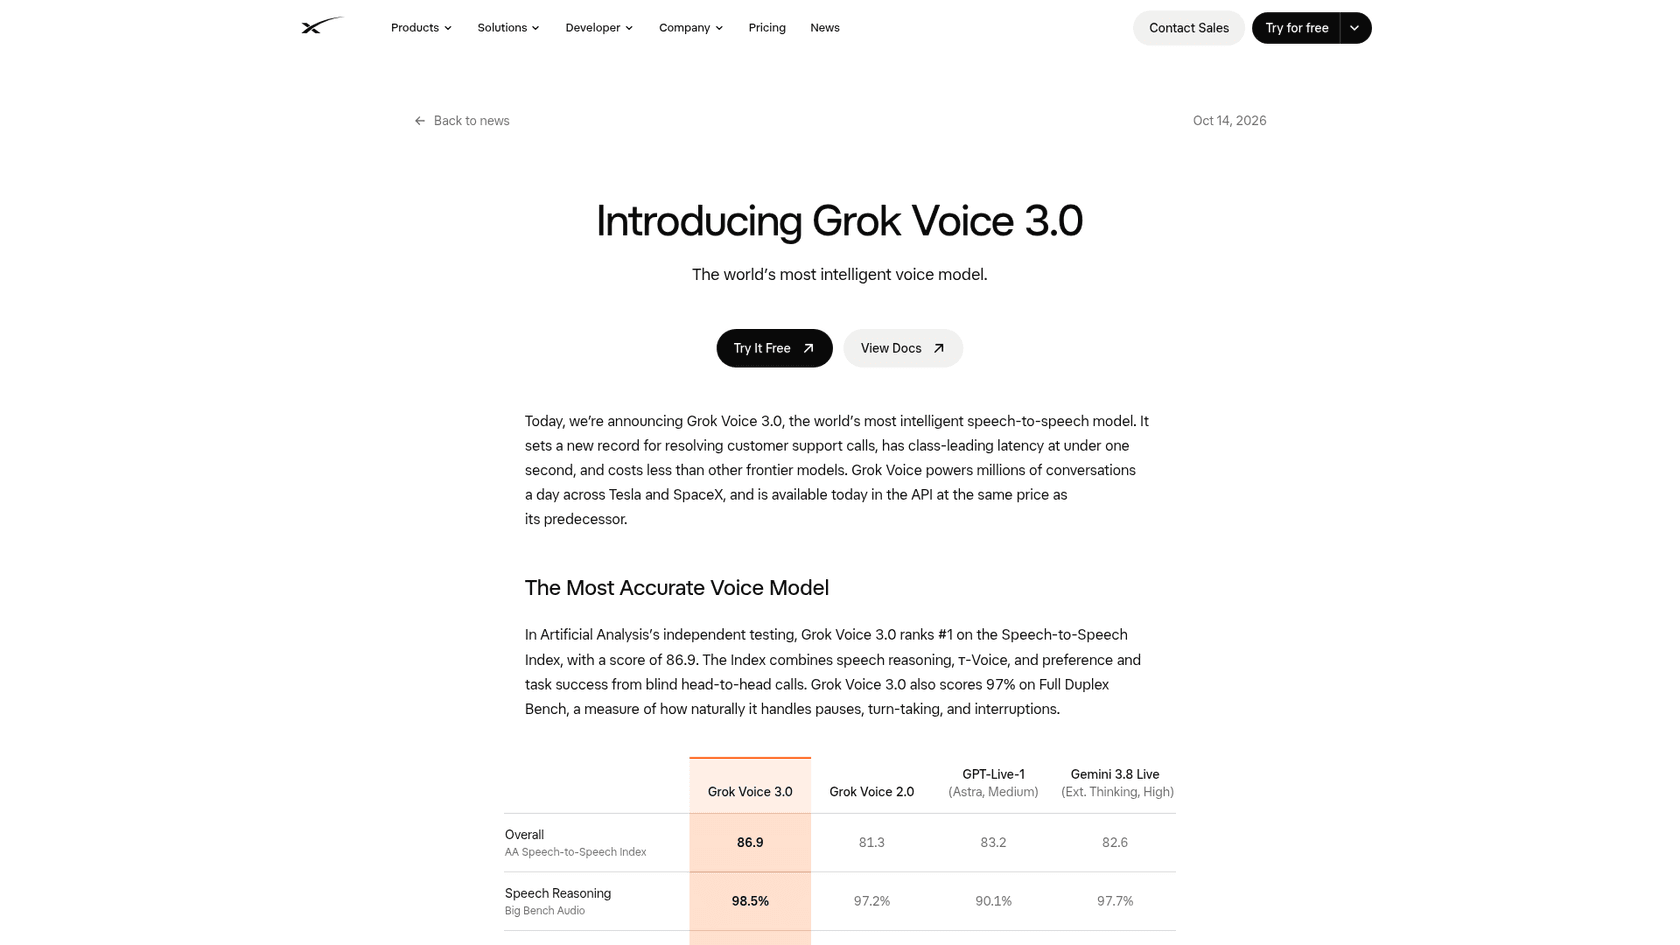
Uma observação sobre nomes antes de começar. A documentação e o post de lançamento da xAI agora assinam como SpaceXSI, e a Artificial Analysis lista o fornecedor como SpaceXAI. Mesma equipe, mesma API em api.x.ai, mesma família Grok. Segundo o post de lançamento, a mesma voz também roda dentro do modo de voz do Grok Bot e em carros Tesla. Se você está avaliando o fornecedor inteiro, meu artigo sobre alternativas à xAI é a visão mais ampla.
O placar
Coloco o veredito completo primeiro e o detalhe depois.
| Dimensão | Grok Voice 3.0 | vs 2.0 | Minha leitura |
|---|---|---|---|
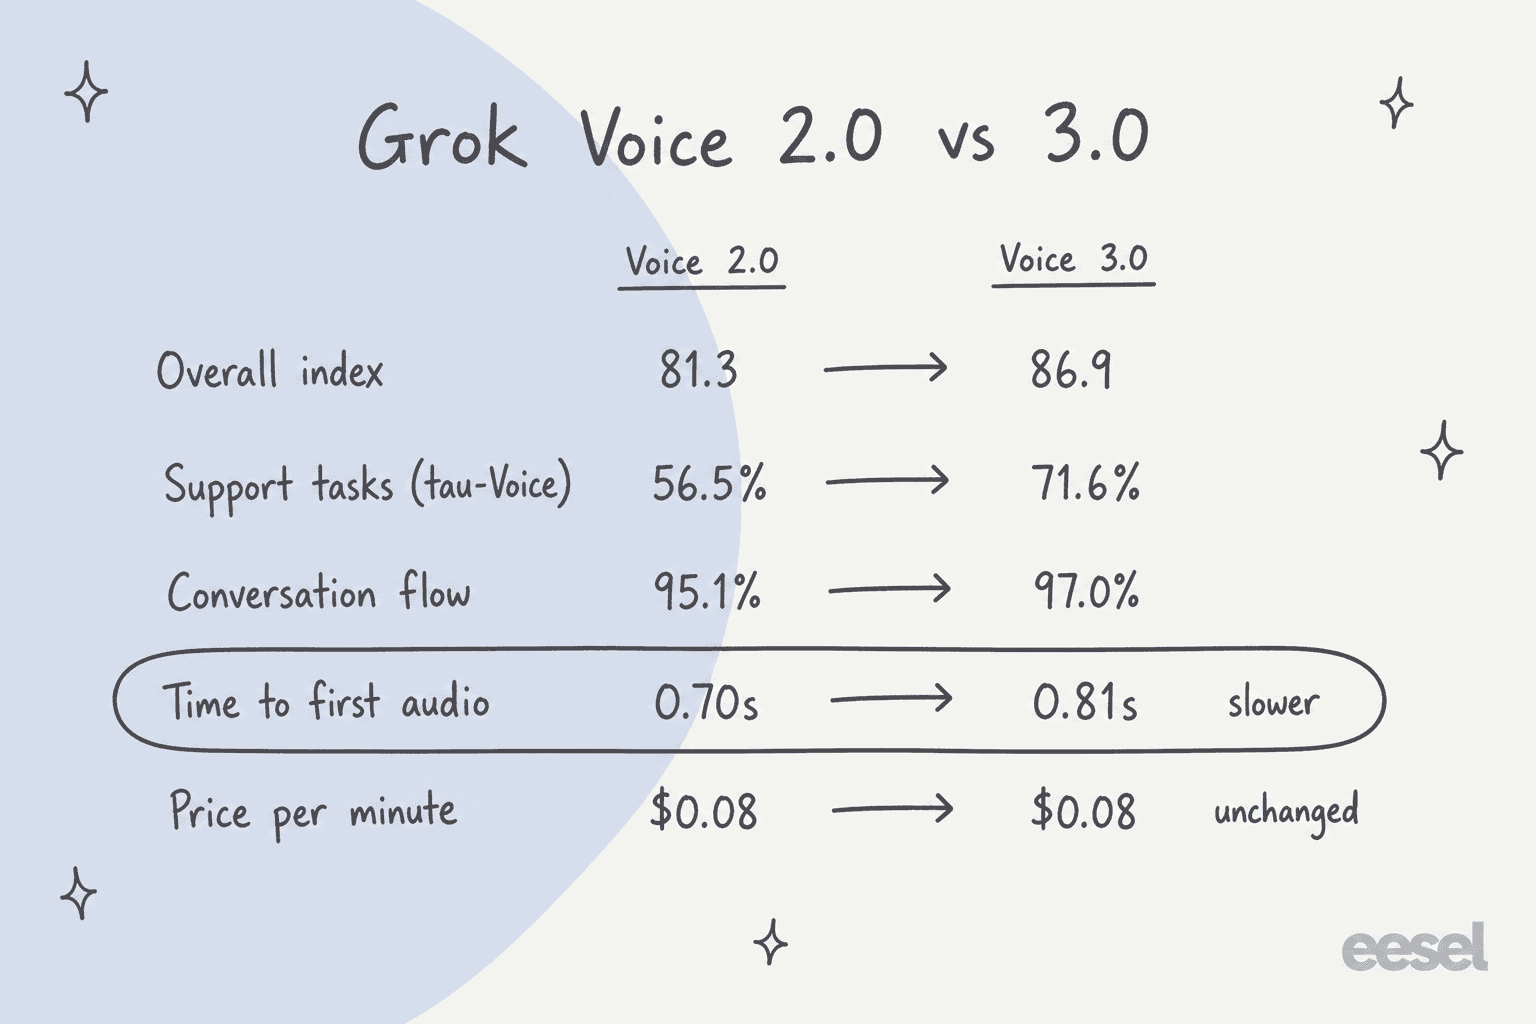
| Geral | 86.9 índice AA, n.º 1 | 81.3 | Melhor média da tabela, 3.7 pontos à frente do GPT-Live-1 (Astra) |
| Tarefas de suporte | 71.6% τ-Voice, n.º 2 | 56.5% | A melhoria real. 2.9 pontos atrás do GPT-Live-1 (Astra) |
| Sucesso de tarefas em chamadas reais | 94.8%, n.º 1 | 94.6% | Já perto do teto na 2.0 |
| Preferência humana | Elo 1070, n.º 3 | 1011 | Dois modelos Gemini soam mais agradáveis para quem ouve |
| Fluidez da conversa | 97.0% Full Duplex Bench | 95.1% | Interrupções e pausas são um problema resolvido aqui |
| Raciocínio em fala | 98.5% Big Bench Audio | 97.2% | Ganho minúsculo, já saturado |
| Latência | 0.81s até o primeiro áudio | 0.70s | Mais lento que a 2.0, mais rápido que todos os modelos próximos no índice |
| Preço | $0.08/min | $0.08/min | Inalterado |
| Simultaneidade | 10 a 200 por nível | 10 fixo | Resolvido, se você gastar |
| Regiões | us-east-1, eu-west-1, us-saltlake-2 | us-east-1 | Equipes da UE finalmente podem avaliar |
Todos os números de benchmark vêm da Artificial Analysis, cujos números de lançamento também foram republicados no anúncio do Grok Voice 3.0 da xAI.
Veredito: para uma equipe construindo um agente de voz telefônico ou dentro do app que precisa fazer coisas (consultar um pedido, emitir um crédito, reservar um horário), esta é a minha escolha padrão agora. Fixe a versão, reserve orçamento para o nível de que precisa e resolva o problema do conhecimento separadamente.
Onde ele vence
Três coisas se destacaram para mim, e só uma delas é o número que a xAI escolheu para abrir.
A pontuação em tarefas de suporte é a manchete, não o índice
O τ-Voice é o benchmark em que mais confio para quem lê isto de uma equipe de suporte. Um chamador simulado liga para o modelo com um problema de formato realista (alterar um voo, contestar uma cobrança no varejo, resolver um problema de telecom), o modelo atua como agente de suporte com ferramentas e um documento de políticas, e só pontua se o estado final do banco de dados estiver exatamente correto. A Artificial Analysis descreve o método por completo, até a média de três tentativas.
O Grok Voice 2.0 marcou 56.5%. O 3.0 marca 71.6%, um salto de 15.1 pontos em uma versão. Essa é a diferença entre um agente que falha quatro em cada nove chamadas e um que falha cerca de duas em cada sete, e para uma fila essa diferença é quadro de pessoal, não erro de arredondamento.
Não é a maior pontuação. O GPT-Live-1 (Astra, medium) está em 74.5%. Mas o Astra precisa de 1.34 segundo para começar a falar, contra 0.81s do Grok, e a xAI se apoia exatamente nessa troca no post de lançamento. Se você está escolhendo entre os dois, minha análise do GPT-Live-1 cobre o lado da OpenAI com mais profundidade.
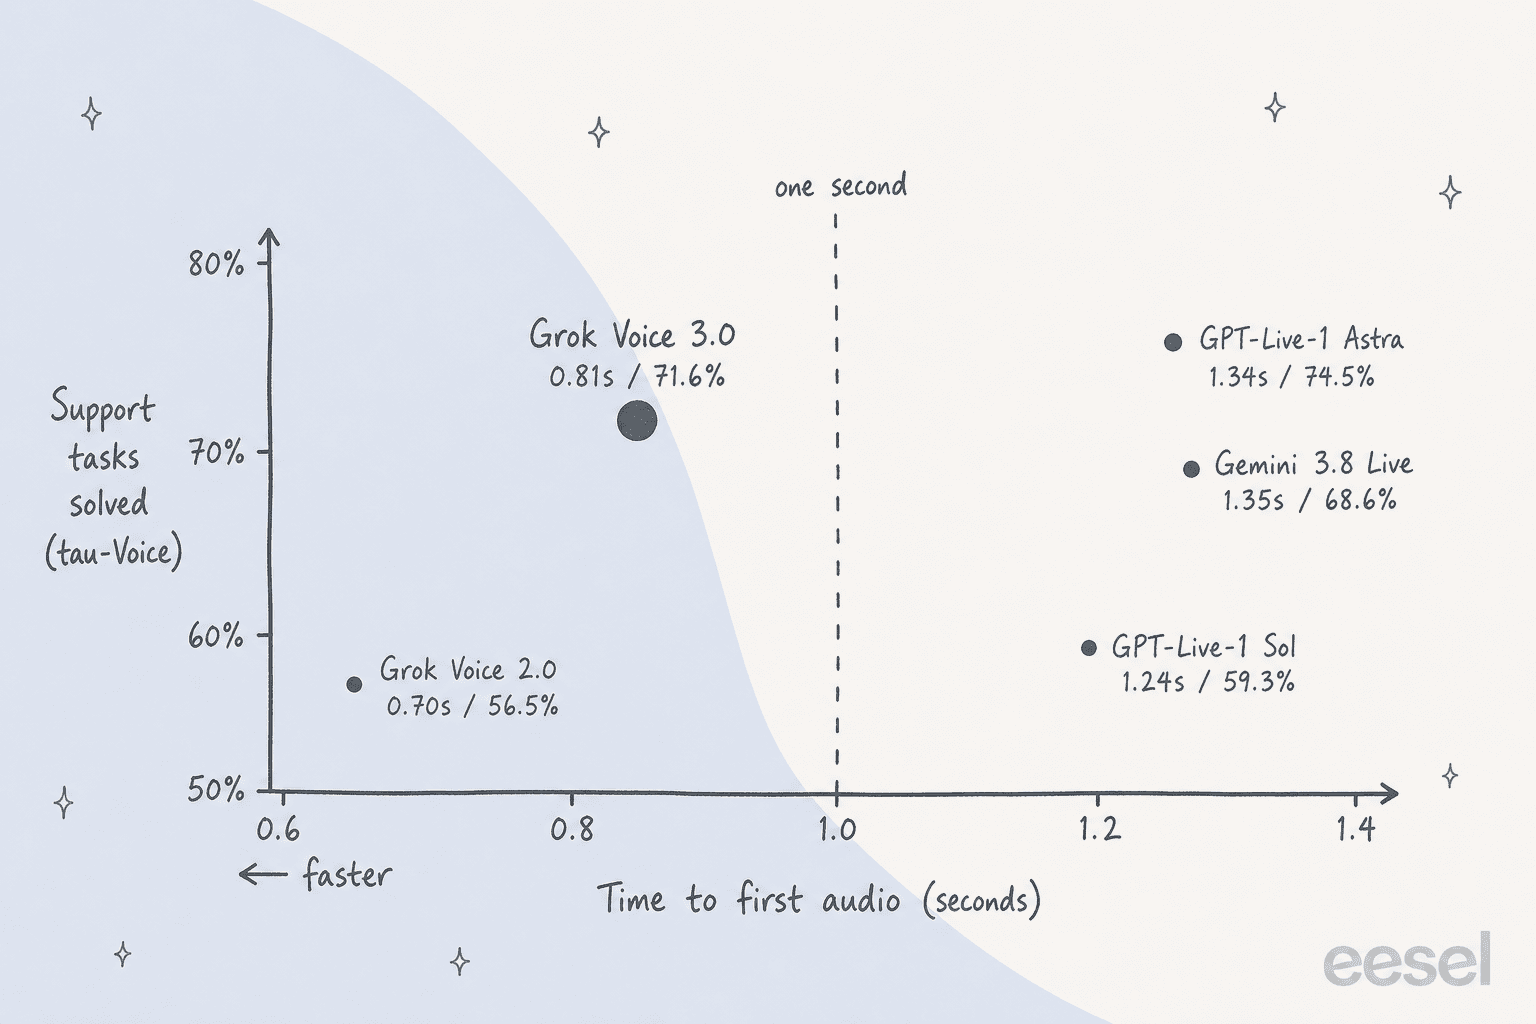
Esse gráfico é praticamente todo o argumento a favor do Grok Voice 3.0 em uma imagem: todo modelo que resolve mais de 65% das tarefas de suporte leva mais de 1.3 segundo para responder, exceto este. O próprio thread da Artificial Analysis diz isso com clareza:
"Grok Voice 3.0 and Grok Voice 2.0 the only models in the top 5 of our Speech to Speech Index under 1 second."
Ele termina o que começa em chamadas reais
A Task Success Rate vem da Speech Agent Arena da Artificial Analysis, onde pessoas reais mantêm conversas ao vivo com dois modelos ocultos (marcar uma consulta no dentista, esse tipo de coisa). O Grok Voice 3.0 conclui 94.8% das tarefas, o mais alto do quadro, logo à frente do Gemini 3.8 Live com 93.2%.
Uma nota de rodapé que vale acrescentar: o Grok Voice 2.0 já estava em 94.6%, então não é aqui que a 3.0 melhorou. É uma área em que a linha Grok já era forte, e a 3.0 a manteve enquanto melhorava nos casos mais difíceis do τ-Voice.
Os números da Starlink, com a ressalva anexada
A xAI diz que os call centers da Starlink usam o Grok Voice para atender 20,000 chamadas por dia em vários idiomas, resolver cerca de 70% sem humano e fechar uma em cada quatro chamadas de vendas antes de o cliente desligar. Um único agente verifica clientes, diagnostica hardware, emite créditos e envia equipamentos de reposição.
É a afirmação de produção mais concreta que vi este ano de qualquer fornecedor de modelos de voz. Também é uma empresa irmã falando de si mesma, sem método publicado por trás. Eu trataria os 70% como "o que é possível com acesso profundo a ferramentas e um produto estreito", não como previsão para a sua fila. Na minha experiência, a taxa de resolução que você obtém é definida muito mais pelo que o agente consegue consultar e fazer do que pelo modelo, que é a mesma lição de toda implantação de agente de IA para call center.
Onde o texto de lançamento exagera
Nada disso é desonesto. É apenas o enquadramento habitual de um post de lançamento, que vale conhecer antes de citá-lo para o seu chefe.
- "Class-leading latency." 0.81s é excelente entre os modelos de maior pontuação, mas o Grok Voice 2.0 era mais rápido com 0.70s, e as entradas mais rápidas do quadro (Deepslate Opal com 0.44s, por exemplo) são ainda mais ágeis. Leitura justa: o mais rápido dos inteligentes.
- "Costs less than other frontier models." Verdade frente ao GPT-Live-1 (Astra) e ao GPT-Realtime-2.1. Não frente a tudo: a Artificial Analysis mede o Gemini 3.8 Live Extended Thinking (High) em $3.50 por hora de áudio de entrada e o GPT-Live-1 (Sol) em $4.47, contra $4.80 do Grok. São custos de execução de benchmark, não preços de tabela, mas a direção é clara.
- "World's most intelligent." Ele lidera o índice composto. Em preferência humana é o n.º 3 (Elo 1070, atrás do Gemini 3.1 Flash Live Minimal com 1100 e do Gemini 3.8 Live com 1088), e em raciocínio de fala puro três modelos pontuam mais alto.
A reação no X foi majoritariamente de aplauso, mas a resposta mais afiada sob o thread da Artificial Analysis foi a que todo líder de suporte deveria colar no monitor:
"Scores are one thing. The real test is a drive-thru order with a toddler in the back seat."
É justo. Os benchmarks rodam em áudio limpo e cenários arrumados, enquanto seus clientes estão no viva-voz dentro de um carro. Faça suas próprias chamadas de teste com ruído de fundo real antes de confiar em qualquer um desses números, inclusive os bons.
A API: nada a migrar, muito a gostar
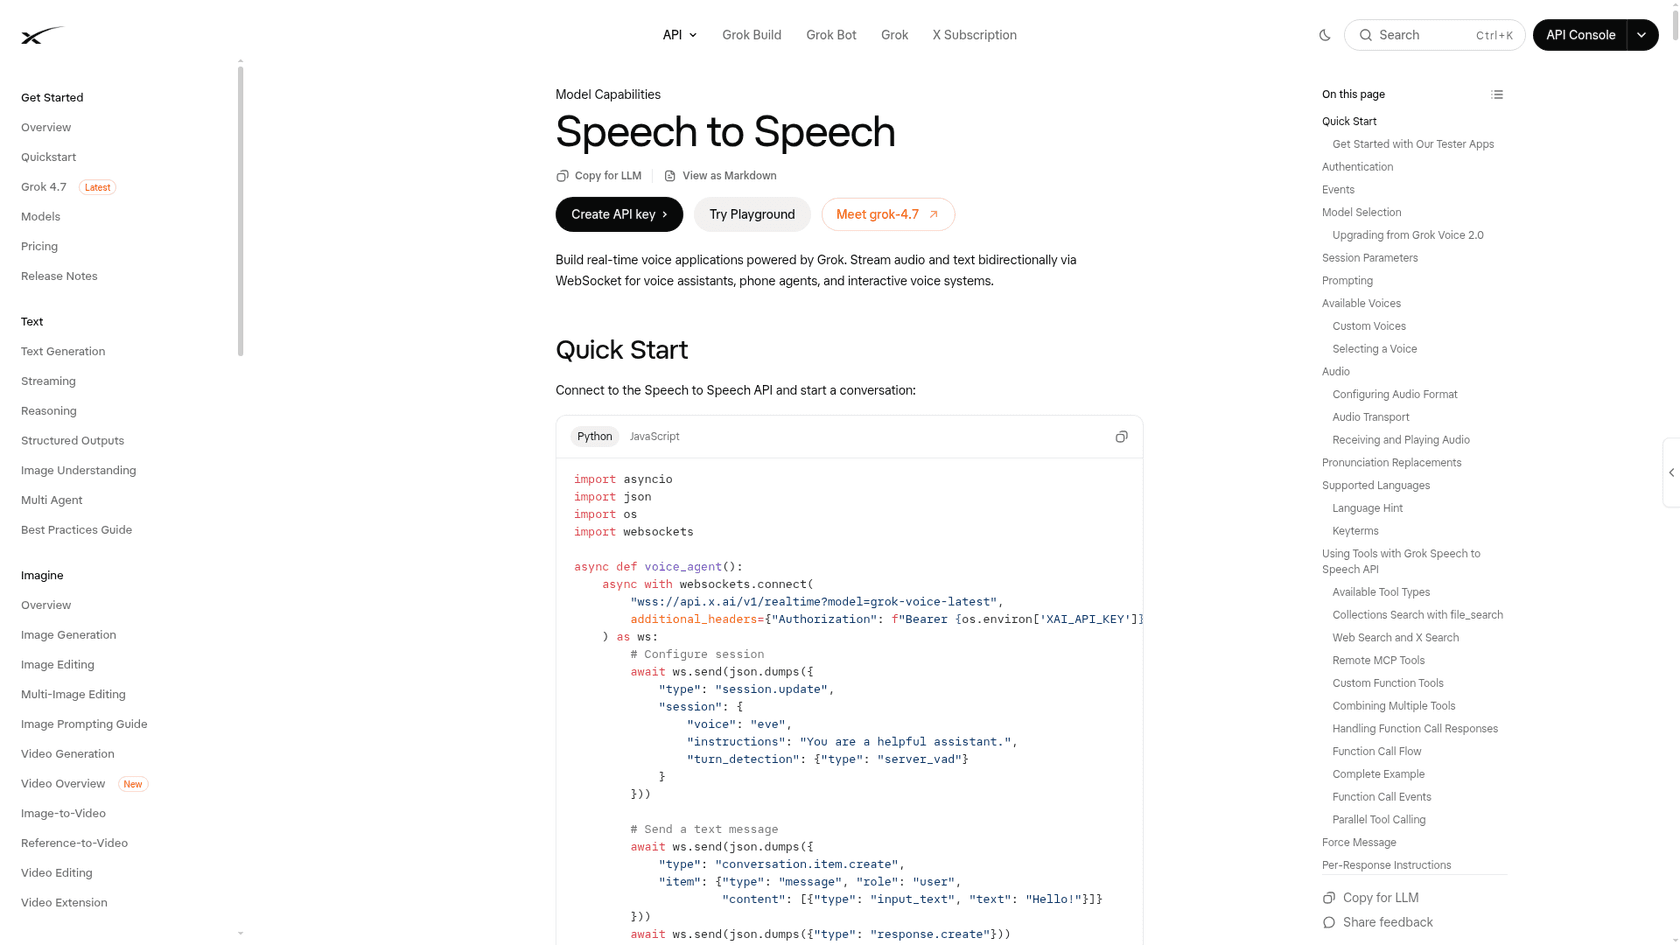
As notas de versão da xAI dizem isso em uma linha: a API não mudou. Mesmo endpoint (wss://api.x.ai/v1/realtime), mesmos parâmetros de sessão, mesmos eventos, mesmo preço. Se você chama o alias grok-voice-latest, foi movido para a 3.0 automaticamente, e grok-voice-2.0 agora está obsoleto.
Isso é uma boa notícia e também um pequeno alerta. Atualizações automáticas são ótimas até o dia em que seu prompt cuidadosamente ajustado começa a se comportar de outro jeito numa terça qualquer. Em uma linha de suporte, eu fixaria grok-voice-3.0 explicitamente e trocaria de versão de propósito, depois de uma rodada de chamadas de teste.
Ele também continua compatível no nível do protocolo com a OpenAI Realtime API, então uma equipe já construída sobre o GPT Realtime pode trocar a URL base e a chave e chegar na maior parte do caminho. As partes sobre as quais eu realmente construiria, todas da documentação speech-to-speech:
| Recurso | O que faz | Por que uma equipe de suporte se importa |
|---|---|---|
Ferramentas: file_search, web_search, x_search, mcp, function | Pesquisa documentos enviados, chama suas APIs, acessa um servidor MCP remoto durante a chamada | É assim que o agente emite o reembolso em vez de prometer um |
| Chamadas telefônicas SIP | Roteia chamadas PSTN, de contact center ou PBX direto, com DTMF | Sem uma ponte de telefonia separada para cuidar |
| G.711 μ-law / A-law | Codecs telefônicos nativos | Sem atraso de transcodificação no áudio telefônico |
force_message | Fala uma frase fixa sem passar pelo modelo | "Esta chamada está sendo gravada" é dito palavra por palavra, sempre |
keyterms (até 100) | Direciona a transcrição para os nomes dos seus produtos | Seus códigos SKU deixam de ser ouvidos errado |
replace | Corrige a pronúncia de nomes de marca no áudio falado | Sem alterar a transcrição que você armazena |
| Retomada de sessão | Reproduz as falas anteriores após uma conexão cair | Uma chamada móvel que cai não recomeça do "alô" |
idle_timeout_ms | Retoma o contato com quem fica em silêncio depois de um tempo definido | Resolve o momento do "você ainda está aí?" |
reasoning.effort | high (padrão) ou none | Uma alavanca para trocar raciocínio por velocidade em fluxos simples |
Se você está decidindo entre WebSocket e WebRTC para um cliente de navegador, minha explicação sobre Realtime API vs WebRTC também se aplica aqui, já que o formato de transmissão é o mesmo.
Mais duas coisas que vale saber. As vozes podem ser clonadas a partir de um clipe de referência de até 120 segundos, e a visão geral de voz lista 20 idiomas com sotaques nativos, com o modelo detectando sozinho o idioma de quem liga. No X, uma das primeiras perguntas sob o post de lançamento de Elon Musk foi exatamente essa:
"Does it handle switching languages mid conversation? Genuinely curious how it does with Hungarian"
O húngaro não está na lista, então espere "varying degrees of accuracy", nas palavras da própria xAI. Se seus clientes falam algo fora desses 20, teste primeiro.
A chamada paralela de ferramentas, junto com o conselho na documentação sobre evitar sobreposição de áudio durante chamadas de ferramentas, me diz que essa equipe já entregou agentes telefônicos de verdade. Quem já construiu sobre chamadas de ferramentas em tempo real sabe que o silêncio constrangedor enquanto uma função roda é onde os clientes desligam.
Os limites que mudaram desde a 2.0
Se você leu minha análise da 2.0, esta é a seção que mais importa, pois duas das três paredes que apontei em agosto se moveram.
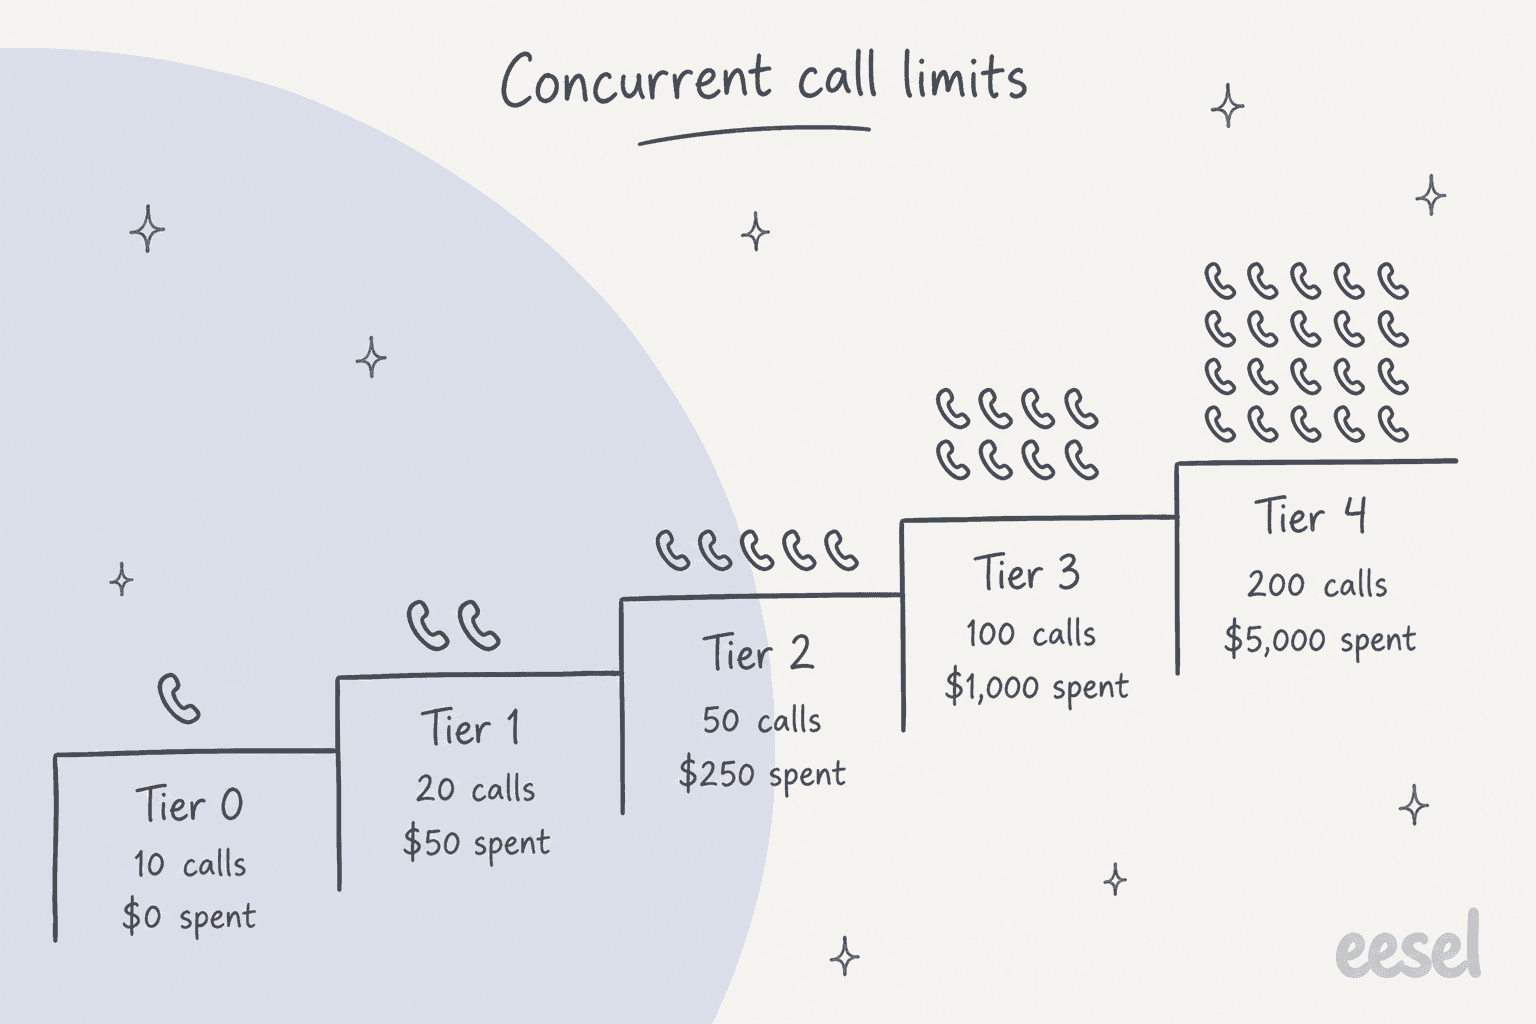
A simultaneidade agora é uma escada de gasto
Em agosto, cada equipe tinha 10 sessões simultâneas, ponto. A tabela de limites de uso atual vincula a simultaneidade do speech-to-speech ao seu nível de gasto, e os níveis são liberados automaticamente conforme o gasto acumulado na API desde 1.º de janeiro de 2026. Eles nunca voltam atrás.
| Nível | Gasto acumulado na API | Sessões de voz simultâneas |
|---|---|---|
| Tier 0 | $0 | 10 |
| Tier 1 | $50 | 20 |
| Tier 2 | $250 | 50 |
| Tier 3 | $1,000 | 100 |
| Tier 4 | $5,000 | 200 |
| Enterprise | Sob consulta | Personalizado |
A $0.08 por minuto, $5,000 são 62,500 minutos de conversa. Uma fila que atende 500 chamadas de quatro minutos por dia passa disso em cerca de um mês, então o teto deixa de ser um bloqueio para quem está em produção. Ele ainda importa para pilotos: uma conta nova não consegue fazer um teste de carga com 50 chamadas simultâneas no primeiro dia sem pré-pagar créditos para liberar o nível.
Agora existe uma região na UE
A página do modelo Grok Voice 3.0 lista us-east-1, eu-west-1 e us-saltlake-2. Em agosto era apenas us-east-1, o que encerrava a conversa para muitas equipes europeias. A documentação de voz da xAI também cita SOC 2 Type II, elegibilidade HIPAA com um BAA, acordos de processamento de dados do GDPR e uma declaração de que o áudio é processado em tempo real e "never stored or used for training". Não auditei nada disso. É o que o fornecedor publica, e é suficiente para iniciar uma revisão de segurança.
O que não mudou: ele não sabe nada sobre você
O modelo é mais esperto, mas não é seu. Todos os números acima pressupõem um documento de políticas e ferramentas que alguém escreveu para o benchmark. Na sua linha, o agente sabe exatamente aquilo a que você o conecta: uma coleção enviada, suas funções, um servidor MCP. A maior parte do trabalho de uma implantação de suporte por voz real está aí, além de decidir quando passar para um humano.
As equipes que vejo fazendo isso bem tratam o agente telefônico como um chatbot de base de conhecimento com voz: as respostas vivem em uma única fonte mantida, e todo canal lê dela. Se você ainda está decidindo se deve automatizar o suporte telefônico, comece por aí, não pela escolha do modelo.
Quanto custa, com as contas feitas
O preço de voz do Grok é o mais simples da categoria, direto da página de preços da xAI:
| API de voz | Preço |
|---|---|
Speech to speech (grok-voice-3.0) | $0.08 por minuto ($4.80 por hora) + $0.004 por entrada de texto |
Speech to speech (grok-voice-2.0, obsoleto) | Mesma tarifa |
| Speech to text | $0.10 por hora (REST), $0.20 por hora (streaming) |
| Text to speech | $15.00 por 1M de caracteres |
Não há licenças por usuário nem taxas de plataforma, nem mínimo, só uma tarifa para cada minuto, quer o modelo tenha pensado muito ou não. Isso torna a fatura fácil de prever. Coloque seus próprios números:
Para ter uma noção de escala: uma equipe que atende 500 chamadas por dia de 4 minutos cada gasta cerca de $4,800 por mês e, na hora de pico, tem cerca de 7 chamadas ao mesmo tempo, dentro do nível gratuito de 10. A simultaneidade só começa a apertar acima de alguns milhares de chamadas por dia. As 20,000 chamadas diárias da Starlink, com o mesmo palpite de 4 minutos (a xAI não publica a duração das chamadas), seriam 80,000 minutos e $6,400 por dia. Para o ângulo dos modelos mais baratos, meu post sobre os preços do Grok Voice 2.0 compara as tarifas por minuto da categoria, e minha comparação do custo de um agente humano coloca o número por chamada ao lado de um salário.
Como ele se compara ao restante
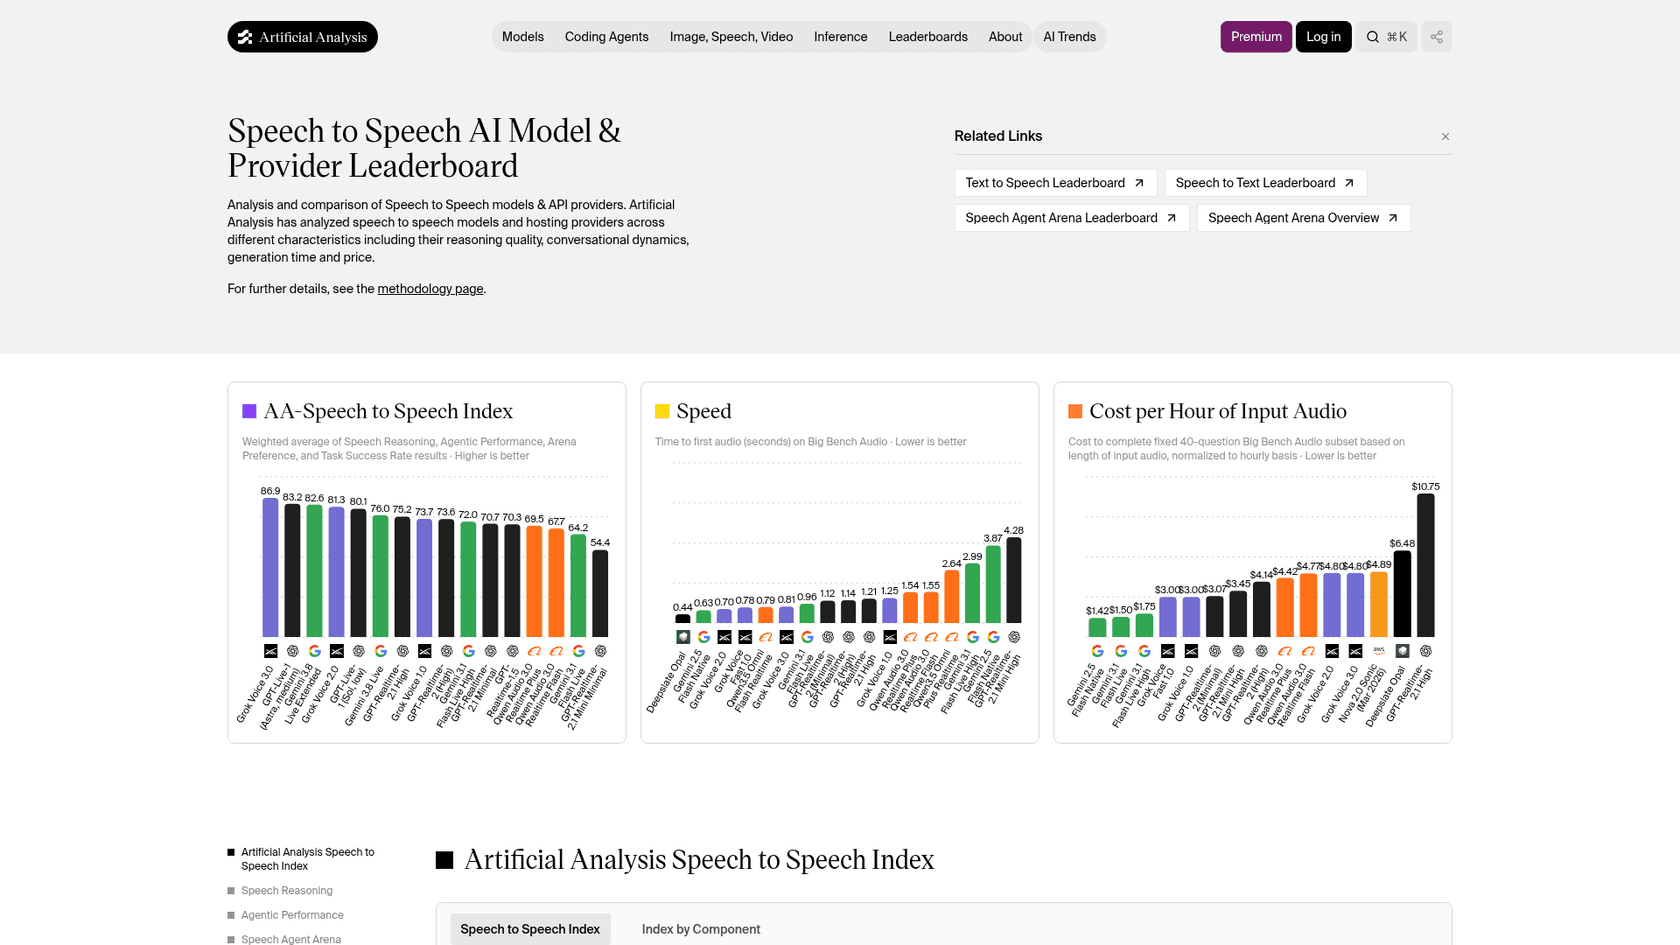
Um mapa rápido dos modelos que você colocaria na lista ao lado dele, tudo do ranking da Artificial Analysis (o custo é o custo de execução medido pela AA por hora de áudio de entrada, não um preço de tabela):
| Modelo | Índice AA | τ-Voice | Tempo até o primeiro áudio | Custo AA por hora |
|---|---|---|---|---|
| Grok Voice 3.0 | 86.9 | 71.6% | 0.81s | $4.80 |
| GPT-Live-1 (Astra, medium) | 83.2 | 74.5% | 1.34s | $5.83 |
| Gemini 3.8 Live Extended Thinking (High) | 82.6 | 68.6% | 1.35s | $3.50 |
| Grok Voice 2.0 | 81.3 | 56.5% | 0.70s | $4.80 |
| GPT-Live-1 (Sol, low) | 80.1 | 59.3% | 1.24s | $4.47 |
| GPT-Realtime-2.1 High | 75.2 | 45.7% | 1.21s | $10.75 |
Por uma visão externa, a xAI também aponta o EVA-Bench, o benchmark aberto da ServiceNow para agentes de voz corporativos em mais de 200 cenários, em que o Grok Voice 3.0 obtém a maior pontuação de precisão, 74%.
Se você quer uma plataforma completa em vez de um modelo, a troca é diferente. Ferramentas como Retell AI, Vapi e ElevenLabs envolvem os modelos em fluxos de chamada e painéis, com análises por cima.
Se você vive dentro de um helpdesk, veja primeiro o que ele oferece nativamente: os agentes de voz com IA do Zendesk e os agentes de voz do Freshcaller merecem uma olhada. Meu apanhado dos melhores agentes de voz com IA cobre o resto.
Se você só precisa da voz e quer trazer seu próprio cérebro, motores de texto para fala como o Cartesia Sonic 3 ficam mais abaixo na pilha, e o mapa mais amplo das empresas de voz com IA mostra quem vende o quê. Para alternativas dentro da mesma família, minha lista de alternativas ao Grok Voice 2.0 continua valendo para os concorrentes.
Quem deve adotar e quem deve esperar
A resposta curta para a pergunta se a IA consegue atender chamadas de suporte agora é um sim firme para a camada do modelo. Quem deve agir:
Migre agora se você já usa o Grok Voice 2.0 (é a mesma API e o mesmo preço, então o único custo é uma rodada de chamadas de regressão), ou está construindo um agente telefônico que precisa concluir tarefas de várias etapas e cada 100ms de silêncio faz você perder clientes.
Faça primeiro uma comparação direta se você já usa o GPT-Live-1 (Astra). Ele ainda vence no τ-Voice por 2.9 pontos. Se a vantagem de 0.5 segundo do Grok compensa isso depende de quão pesadas em ferramentas são suas chamadas.
Espere ou procure outra opção se seus clientes falam idiomas fora dos 20 suportados, você precisa de um construtor de fluxo de chamadas sem código (comece com o Voice Agent Builder da própria xAI ou uma plataforma acima), ou seu bloqueio não é a voz e sim as respostas. Meu guia da melhor IA para suporte por voz cobre as opções prontas. Uma voz brilhante lendo a política de reembolso errada continua sendo a política de reembolso errada, e ela está no topo de toda lista de problemas de chatbots que fazem os clientes desistir.
O Grok cuida da chamada. A eesel cuida do que ele deve dizer.
O Grok Voice 3.0 é um motor de conversa. Ele não conhece seu prazo de devolução, seus últimos 50,000 tickets nem quais clientes recebem o crédito de cortesia. Essa é a metade que a eesel faz: um colega de helpdesk com IA que entra no Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e sua central de ajuda e trabalha a fila de e-mail e chat que fica atrás de toda linha telefônica. Antes de entrar no ar, você pode rodá-lo contra seus próprios tickets anteriores e ver como suas respostas se comparam ao que sua equipe realmente enviou.

Para quem desenvolve, os dois se conectam bem no papel. A ferramenta mcp do Grok aceita uma URL de servidor, um token authorization e cabeçalhos personalizados. Todo workspace da eesel é um servidor MCP: execute npx @eesel/cli mcp token a partir da CLI da eesel e ela imprime a URL, um token de 30 dias e o cabeçalho X-Eesel-Agent-Id, exatamente o formato que o Grok pede. A mesma CLI permite automatizar e inspecionar o agente a partir de um terminal ou entregá-lo a um agente de código como o Claude Code. Ainda não rodei essa combinação em uma linha telefônica real, então trate-a como uma construção promissora, não como uma integração entregue, e fique de olho na latência extra de uma chamada de ferramenta no meio da frase.
O preço é um plano mensal fixo de créditos: $299 por mês por 500 créditos, em que um ticket ou chat conta como um crédito, com 100 créditos grátis para experimentar e sem cartão. Experimente a eesel em uma parte da sua fila antes do seu próximo piloto de voz, para que o agente ao telefone tenha algo que valha a pena dizer.
Frequently Asked Questions
O Grok Voice 3.0 é bom o bastante para chamadas de suporte em produção?
O que mudou no Grok Voice 3.0 em comparação com o Grok Voice 2.0?
Quanto custa o Grok Voice 3.0?
O Grok Voice 3.0 é melhor que o GPT-Live-1?
Preciso mudar meu código para atualizar para o Grok Voice 3.0?
grok-voice-latest, já está na 3.0. Se você fixou grok-voice-2.0, troque o nome do modelo para grok-voice-3.0; o endpoint, os parâmetros de sessão e os eventos continuam os mesmos. Apps construídos sobre a OpenAI Realtime API ainda podem migrar trocando a URL base e a chave.