

Kurzfassung
Die Verwaltung einer gemeinsamen Support-Warteschlange regelt, wie ein Support-Team einen Pool von Tickets aufteilt, damit jedes Ticket schnell einen Verantwortlichen bekommt. Gemeinsame Warteschlangen scheitern selten am Volumen. Es ist die Lücke zwischen einem Ticket, das von allen gesehen und von niemandem übernommen wird. Behebe das zuerst: Wähle bewusst ein Zuweisungsmodell (Pull, Push oder Hybrid), gib jedem neuen Ticket innerhalb einer festen Zeit einen Verantwortlichen und beobachte das Alter des ältesten Tickets ohne Besitzer, nicht nur die erste Antwortzeit.
Die meisten Helpdesks können Tickets für dich an Agenten verteilen, aber die Einstellung liegt meist hinter einer Tarifgrenze. Round Robin gibt es bei Freshdesk Pro ($55 pro Agent) und Help Scout Plus ($45), Fronts Load Balancing ist Professional ($65), und Skills-Routing gibt es bei Zendesk Suite Professional ($115) oder Freshdesk Enterprise ($89). Gorgias enthält die automatische Zuweisung in jedem Helpdesk-Tarif.
KI erledigt den Sortierschritt inzwischen gut. In einem eesel-Test mit echtem Zendesk-Traffic erreichte die Triage 93 % Genauigkeit und erkannte 100 % des Spams. eesels KI-Helpdesk-Teammitglied taggt, routet und beantwortet die einfachen Tickets in deiner bestehenden Warteschlange, damit dein Team nur übernimmt, was einen Menschen braucht.
Was ist die Verwaltung einer gemeinsamen Support-Warteschlange?
Eine gemeinsame Support-Queue ist eine einzige Liste eingehender Tickets, aus der ein ganzes Team arbeitet, statt dass jeder Agent ein eigenes Postfach hat. Die Verwaltung einer gemeinsamen Support-Warteschlange ist das Regelwerk, das entscheidet, wer welches Ticket übernimmt, wie schnell es einen Verantwortlichen bekommt, was passiert, wenn jemand abwesend ist, und wie du merkst, dass etwas durchrutscht.
Ich bearbeite die Support-Queue bei eesel jeden Tag und habe gelernt: Das Schwierige an einer gemeinsamen Warteschlange sind nicht die schwierigen Tickets. Schwierige Tickets bekommen Aufmerksamkeit, weil sie laut sind. Durchrutschen die gewöhnlichen Tickets, die vier Leute geöffnet, gelesen und wieder geschlossen haben, jeder in der Annahme, jemand anderes kümmere sich darum.
Jeder Helpdesk zeigt die gemeinsame Warteschlange etwas anders:
- Zendesk nutzt Ansichten, darunter eine Standardansicht für nicht zugewiesene Tickets (Zendesk-Doku).
- Freshdesk nutzt Ticketlisten-Ansichten, mit Routing pro Gruppe (Freshdesk-Doku).
- Help Scout gibt jedem Posteingang feste Ordner: Unassigned, Mine, Assigned, Closed und Spam (Help-Scout-Doku).
- Front arbeitet mit einem gemeinsamen Posteingang mit den Tabs Unassigned, Assigned und Waiting.
- Gorgias nutzt Ansichten, mit einer Standardansicht „Unassigned“ für offene Tickets, die niemandem gehören (Gorgias-Doku).
Die Namen der Tools ändern sich. Die Fehlermuster bleiben gleich.
Warum gemeinsame Warteschlangen scheitern: die Zuständigkeitslücke
Das Muster sehe ich am häufigsten. Ein Ticket kommt an. Drei Agenten sehen es in der Warteschlange. Jeder hat gerade etwas anderes offen, also zieht jeder weiter. Auf dem Ticket steht kein Name, also spürt niemand, wie es altert.
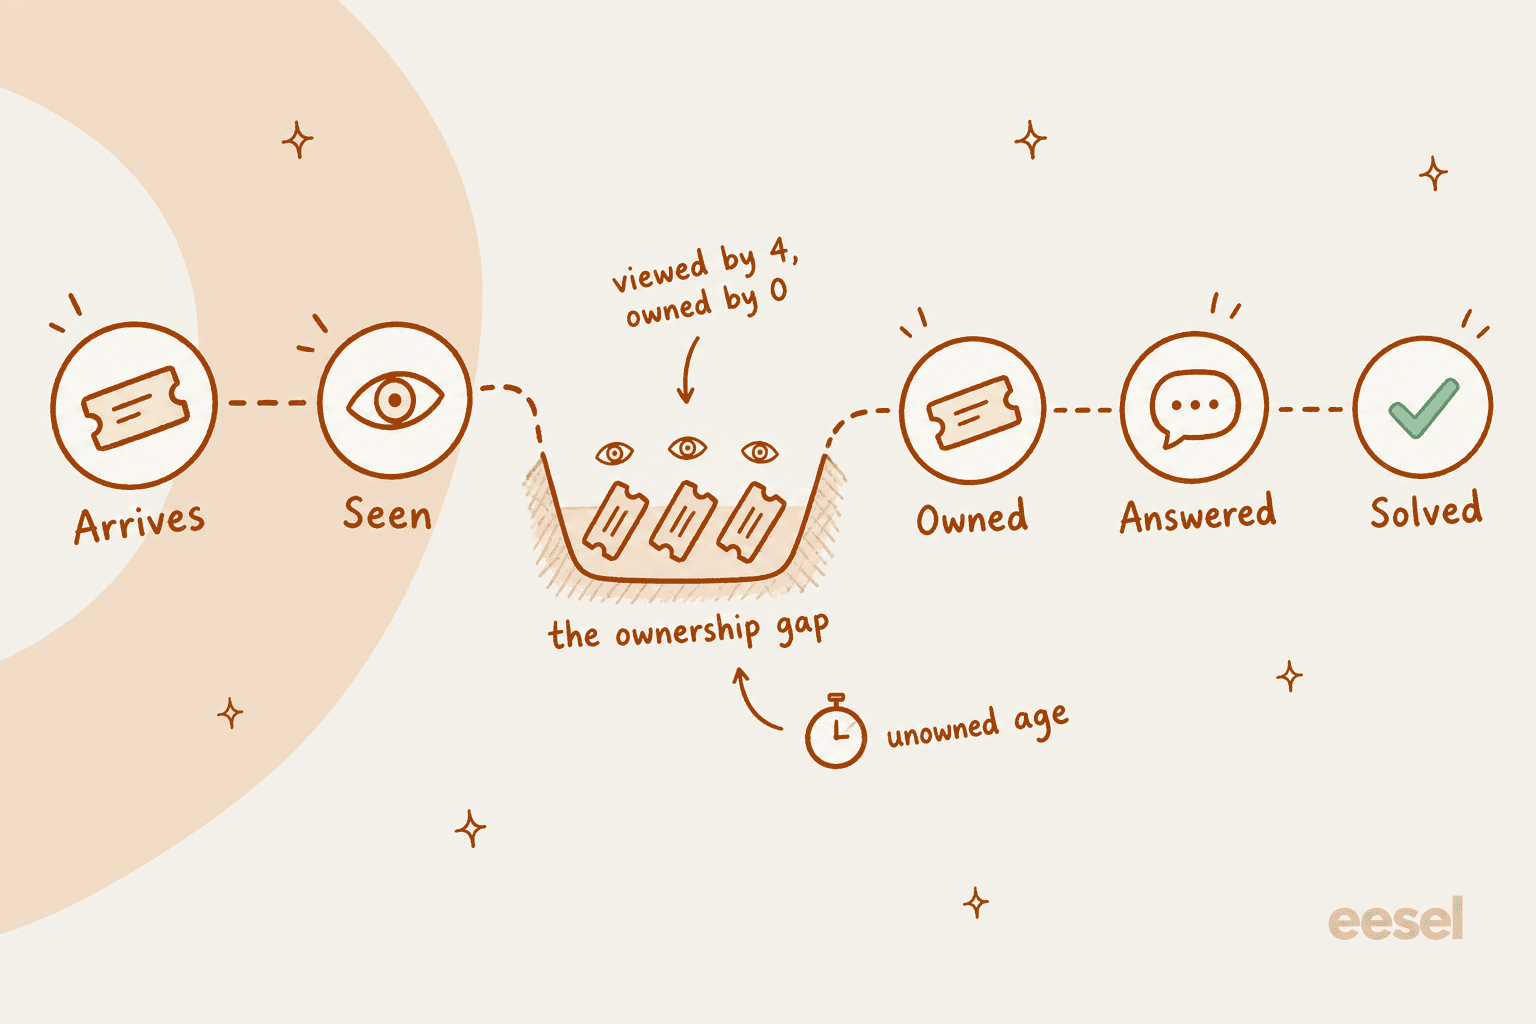
Ein IT-Leiter an einer Schule beschrieb vor Jahren die Pull-aus-dem-Stapel-Version davon, und es liest sich noch immer wie jede überlastete Support-Warteschlange, die ich kenne:
"We currently have an unending bucket of tickets, the engineers and I pluck out calls with little oversight, however this results in some calls falling to the bottom of the pile and getting ignored. There's no ownership of unassigned calls."

Teuer wird es, wenn das durchrutschende Ticket das dringende ist. Ein Zendesk-Admin berichtete im Februar 2026 von einem Enterprise-Kunden, dessen Produktivsystem um 9 Uhr ausfiel. Das Ticket lag bis 14 Uhr hinter mehr als 30 Tickets aus der Nacht, sodass der Kunde mehr als 5 Stunden ausfiel, bevor jemand bemerkte, dass es kritisch war (r/Zendesk).
Und in einem Thread über ein Ticket, das zwei Tage unzugewiesen blieb und eine 1-Sterne-Bewertung bekam, war es die klassische Geschichte: Alle nahmen an, jemand anderes habe es übernommen. Eine Antwort benannte die Ursache klar:
"That's not a system issue (crappy help desk software, bad ticketing system). It's a bad work ethic ("Meh, Bob can get that. Or Cindy. IDC, I'm busy on Reddit.")
Systems can help with setting SLAs and possibly even forcing ownership, but ultimately it's up to the team to take responsibility and do their jobs."
Ich stimme halb zu. Arbeitsmoral zählt. Aber ein Queue-Design, das davon abhängt, dass jeder daran denkt, das nächste Ticket zu nehmen, scheitert am hektischsten Tag, wenn alle schon drei in der Hand haben. Die Lösung: Zuständigkeit automatisch machen oder zu jemandes Aufgabe machen, statt zu hoffen.
Darauf baut dieser Beitrag auf: Miss die Zeit ohne Besitzer, nicht nur die Antwortzeit. Dein Durchschnitt der ersten Antwortzeit kann gut aussehen, während ein Ticket den ganzen Nachmittag altert, weil Durchschnitte das Ende der Verteilung verbergen.
Die drei Arten, Arbeit in einer gemeinsamen Warteschlange zuzuweisen
Jede gemeinsame Warteschlange läuft nach einem von drei Modellen, ob das Team es gewählt hat oder nicht.
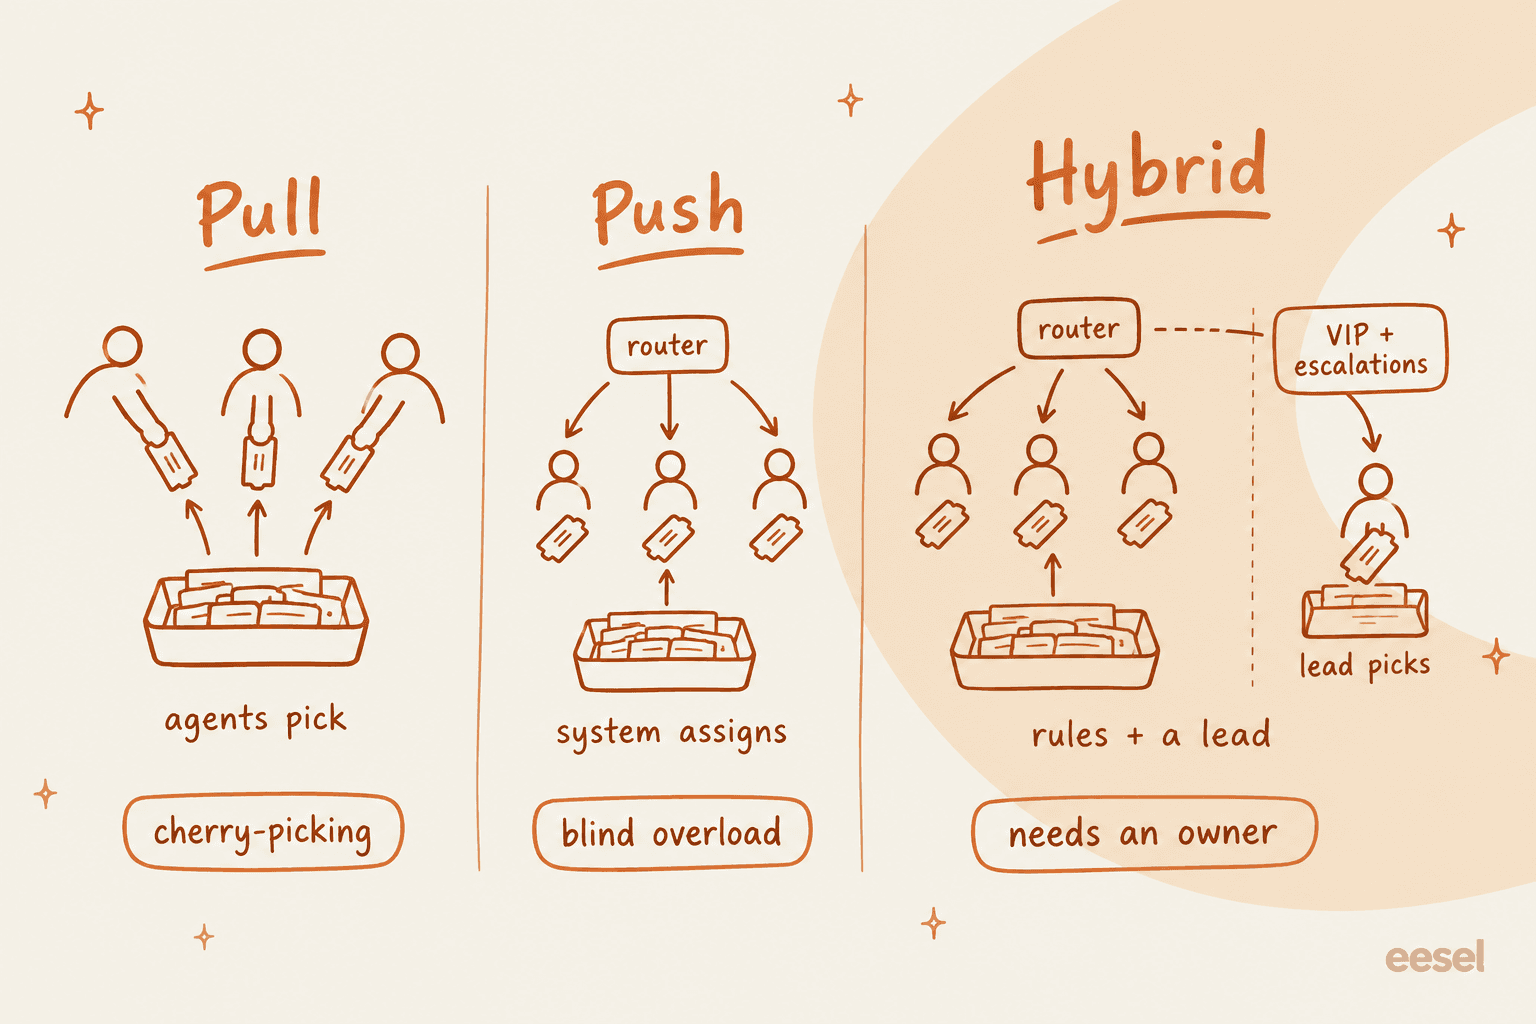
Pull heißt, Agenten wählen ihre Tickets selbst aus der gemeinsamen Ansicht. Es ist in den meisten Helpdesks der Standard und fühlt sich fair an, weil gute Agenten mehr nehmen können. Die Schwäche ist das Herauspicken der einfachen Tickets. Ein Zendesk-Team gab zu, das bei Überlastung absichtlich zu tun:
"If we're underwater we do an easy out method where we cherry-pick the simple tickets (can be handled in less than 5 minutes) and have a portion of the team hit those while the rest does fifo."
Das ist die kluge, bewusste Version. Die zufällige Version ist, dass alle still dasselbe unangenehme Ticket überspringen.
Push heißt, der Helpdesk weist Tickets für dich zu, mit Regeln für das Ticket-Routing: Round Robin (nächster Agent in der Reihe), lastbasiert (wenigste offene Tickets) oder skillbasiert (passende Sprache, Produkt oder Stufe). Das löst die Zuständigkeit, kann aber Leute überlasten, die gerade online sind, und es weiß nicht, welche Tickets schwierig sind. Ein Zendesk-Team lernte das nach dem Wechsel:
"We recently moved from Round Robin to OCR and it's been a bit of a nightmare."
Im selben Beitrag beschrieben sie, dass 2-3 Agenten 15 E-Mail-Tickets bekamen, während der Rest ein paar oder keine erhielt, und manche Tickets nie aus der Ansicht „Unsolved“ herausgeroutet wurden. Das ist meist ein Problem bei Kapazität und Status-Setup, kein Grund, zum Pull zurückzukehren, aber es zeigt, dass Push Feinabstimmung braucht.
Hybrid heißt automatische Zuweisung für den normalen Fluss plus eine kleine Spur, die ein Lead von Hand bearbeitet: VIP-Konten, Eskalationen, alles, was die Regeln nicht einordnen können. Die meisten Teams, die ich berate, landen hier.
| Modell | Wer entscheidet | Am besten für | Hauptrisiko | Was ergänzen |
|---|---|---|---|---|
| Pull | Agenten wählen | Kleine Teams, ähnliche Tickets | Herauspicken, alternde Tickets | Ansicht mit ältestem zuerst, täglicher Triage-Verantwortlicher |
| Push | Helpdesk-Regeln | Volle Warteschlangen, Chat und Messaging | Überlastung derer, die online sind | Kapazitätslimits, Abwesenheitsstatus, Neuzuweisung |
| Hybrid | Regeln plus ein Lead | Gemischte Stufen, VIPs, mehrere Sprachen | Die manuelle Spur hat keinen Verantwortlichen | Ein benannter Verantwortlicher für die Spur pro Schicht |
Wenn du bei Pull bleibst, ergänze eine Regel, auf die jeder Reddit-Thread zu diesem Thema in irgendeiner Form hinausläuft: eine Person, die die Reste verantwortet. Ein MSP-Lead beschrieb seine:
"our helpdesk team functions as one big resource pool. Inbound phone calls and tickets are automatically queued, and the techs check it every so often to take tickets. Helpdesk manager gets an alert if a ticket's been sitting in the intake queue for 30 minutes, at which point he'll assign to a resource."
Dieser 30-Minuten-Alarm ist der ganze Trick. Pull für Tempo, ein Sicherheitsnetz für die Zuständigkeit.
Welches Zuweisungsmodell passt zu deiner Warteschlange?
Wähle die Zeile, die deinem Team am ähnlichsten klingt. Jede nennt das Modell, mit dem ich anfangen würde, und die Einstellung, die es funktionieren lässt.
Welches Zuweisungsmodell passt zu deiner Warteschlange?
Tippe auf die Beschreibung, die deinem Team am nächsten kommt.
Starte mit: Pull, plus ein Triage-Verantwortlicher
Lass Agenten weiter aus einer gemeinsamen Ansicht wählen, sortiert nach ältestem zuerst. Wechsle täglich einen Triage-Verantwortlichen ab, der alles zuweist, was nach deinem Limit noch niemandem gehört (bei E-Mail sind 30 bis 60 Minuten ein vernünftiger Start).
Funktioniert in jedem Tarif. Aktiviere die Kollisionserkennung, falls dein Helpdesk sie hat.
Starte mit: Push, lastbasiert
Weise neue Tickets automatisch der Person mit den wenigsten offenen Tickets zu, mit einem Kapazitätslimit pro Agent, damit niemand begraben wird. Halte eine manuelle Spur für Eskalationen bereit.
Freshdesk Pro ($55), Help Scout Pro ($75) für Balanced, Front Professional ($65), Zendesk kapazitätsbasiertes Routing ab Team-Tarifen, Gorgias in jedem Tarif.
Starte mit: Hybrid, Skills- oder Gruppen-Routing
Route zuerst nach Sprache, Produkt oder Stufe und gleiche dann die Last innerhalb jeder Gruppe aus. Ein Lead verantwortet pro Schicht die Spur für VIPs und Sonderfälle.
Skills-Routing gibt es bei Zendesk Suite Professional ($115) und Freshdesk Enterprise ($89). Bei Help Scout, Front und Gorgias nutzt du getrennte Teams oder Posteingänge und routest per Regeln dorthin.
Starte mit: nur Push
Kunden im Live-Chat warten nicht, während Agenten stöbern. Weise Gespräche verfügbaren Agenten zu, setze einen kurzen Timer zum Annehmen oder Neuzuweisen und begrenze gleichzeitige Chats pro Agent.
Zendesk kann ein Ticket neu zuweisen, das ein Agent nicht rechtzeitig annimmt, ab Professional-Tarifen. Gorgias kann Chats entzuweisen, wenn der Agent nicht mehr verfügbar ist.
Wie jeder Helpdesk eine gemeinsame Warteschlange handhabt
Hier schlagen die Tarifgrenzen zu. Das kann jedes Tool von sich aus, laut Doku und Preisseite des jeweiligen Anbieters, Stand Oktober 2026. Preise gelten pro Agent und Monat laut jeder Preisseite, bei jährlicher Abrechnung, wo die Seite sie anbietet.
| Helpdesk | Round Robin | Last- oder kapazitätsbasiert | Skills-basiert | Kollisionserkennung | SLA-Richtlinien |
|---|---|---|---|---|---|
| Zendesk | Omnichannel-Routing, Team-Tarife und höher (Suite Team $55) | Kapazitätsbasiert ist der Standard, Team-Tarife und höher | Suite Professional $115, Support Enterprise | Alle Tarife außer Team | Suite Growth und höher |
| Freshdesk | Pro $55 | Pro $55 | Enterprise $89 | Growth $19 und höher | Eine Richtlinie ab Growth; mehrere und Eskalationen bei Pro |
| Help Scout | Plus $45 | „Balanced“, Pro $75 | Nicht in der Doku | Alle Tarife | Standard 1, Plus 2, Pro unbegrenzt |
| Front | Regelaktion, alle Tarife | Load Balancing, Professional $65 | Nicht in der Doku | Ja, keine Tarifgrenze genannt | Zeitziele, Professional $65 |
| Gorgias | Automatische Zuweisung nach wenigsten Tickets, alle Helpdesk-Tarife | Ein Kapazitätslimit, alle Tarife | Nicht in der Doku | Banner „Also viewing“ | Alle Helpdesk-Tarife |
Zendesk
Zendesks Omnichannel-Routing schickt E-Mails, Anrufe und Messaging an Agenten, abhängig von deren Status und freier Kapazität. Kapazitätsbasierte Zuweisung ist der Standard: Die Arbeit geht an den berechtigten Agenten mit dem meisten Spielraum für diesen Kanal (Zendesk-Kapazitätsregeln). Du kannst die Zuweisungsmethode auf Round Robin umstellen, das den Agenten wählt, der am längsten kein neues Ticket bekommen hat, solange er noch Kapazität hat.
Meine Anleitung zu Zendesk Round Robin führt durch die Einrichtung.
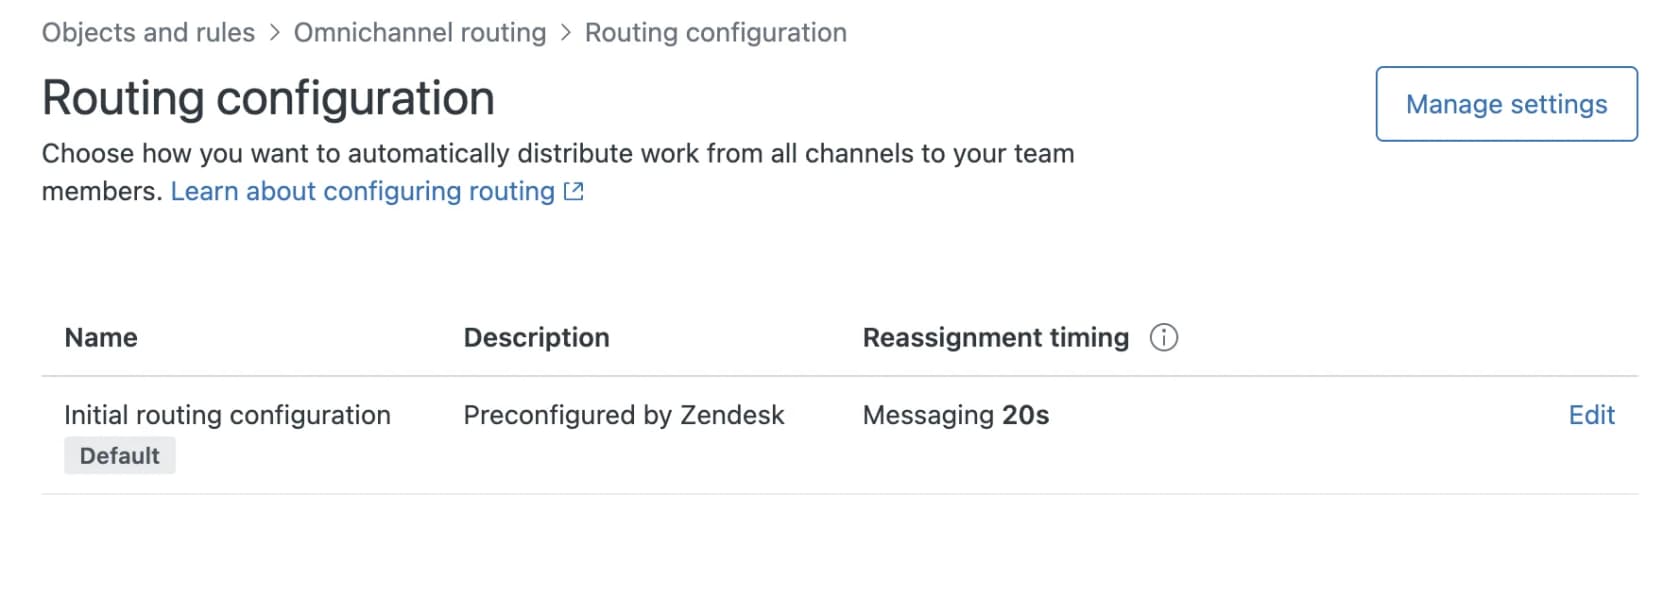
Drei Einstellungen sind für eine gemeinsame Warteschlange am wichtigsten:
- Skills. Skills-basiertes Routing gibt es ab Suite Professional. Erforderliche Skills laufen nie ab; optionale Skills entfallen nach einem von dir gesetzten Timeout (Zendesk-Skills-Doku).
- Neuzuweisung. Zendesk kann bis zu die 50 zuletzt aktualisierten offenen E-Mail- und Messaging-Tickets neu zuweisen, wenn sich der Status eines Agenten auf einen von dir gewählten ändert. Das Neuzuweisen wiedereröffneter Tickets und das Neuzuweisen, wenn ein Agent nicht rechtzeitig annimmt, gibt es ab Professional (Zendesk-Routing-Konfiguration).
- Kollision. Ein Augen-Symbol in Ansichten markiert Tickets, die jemand anderes gerade ansieht, aber Agent Collision ist in Team-Tarifen nicht verfügbar (Zendesk-Kollisions-Doku).
Zendesks Intelligent Triage klassifiziert inzwischen Absicht, Stimmung und Sprache in Professional-Tarifen und höher ohne Aufpreis, laut Zendesks Ankündigung. Diese Klassifizierungen im Routing zu nutzen, braucht weiterhin das Copilot-Add-on, auf Zendesks Preisseite mit $50 pro Agent und Monat gelistet.
Freshdesk
Freshdesk legt das Routing pro Gruppe fest. Unter Admin, Groups, Group Properties wählst du manuell oder Advanced Automatic Routing (auf Basis von Omniroute) mit Round-Robin-, lastbasierter oder skillbasierter Zuweisung.
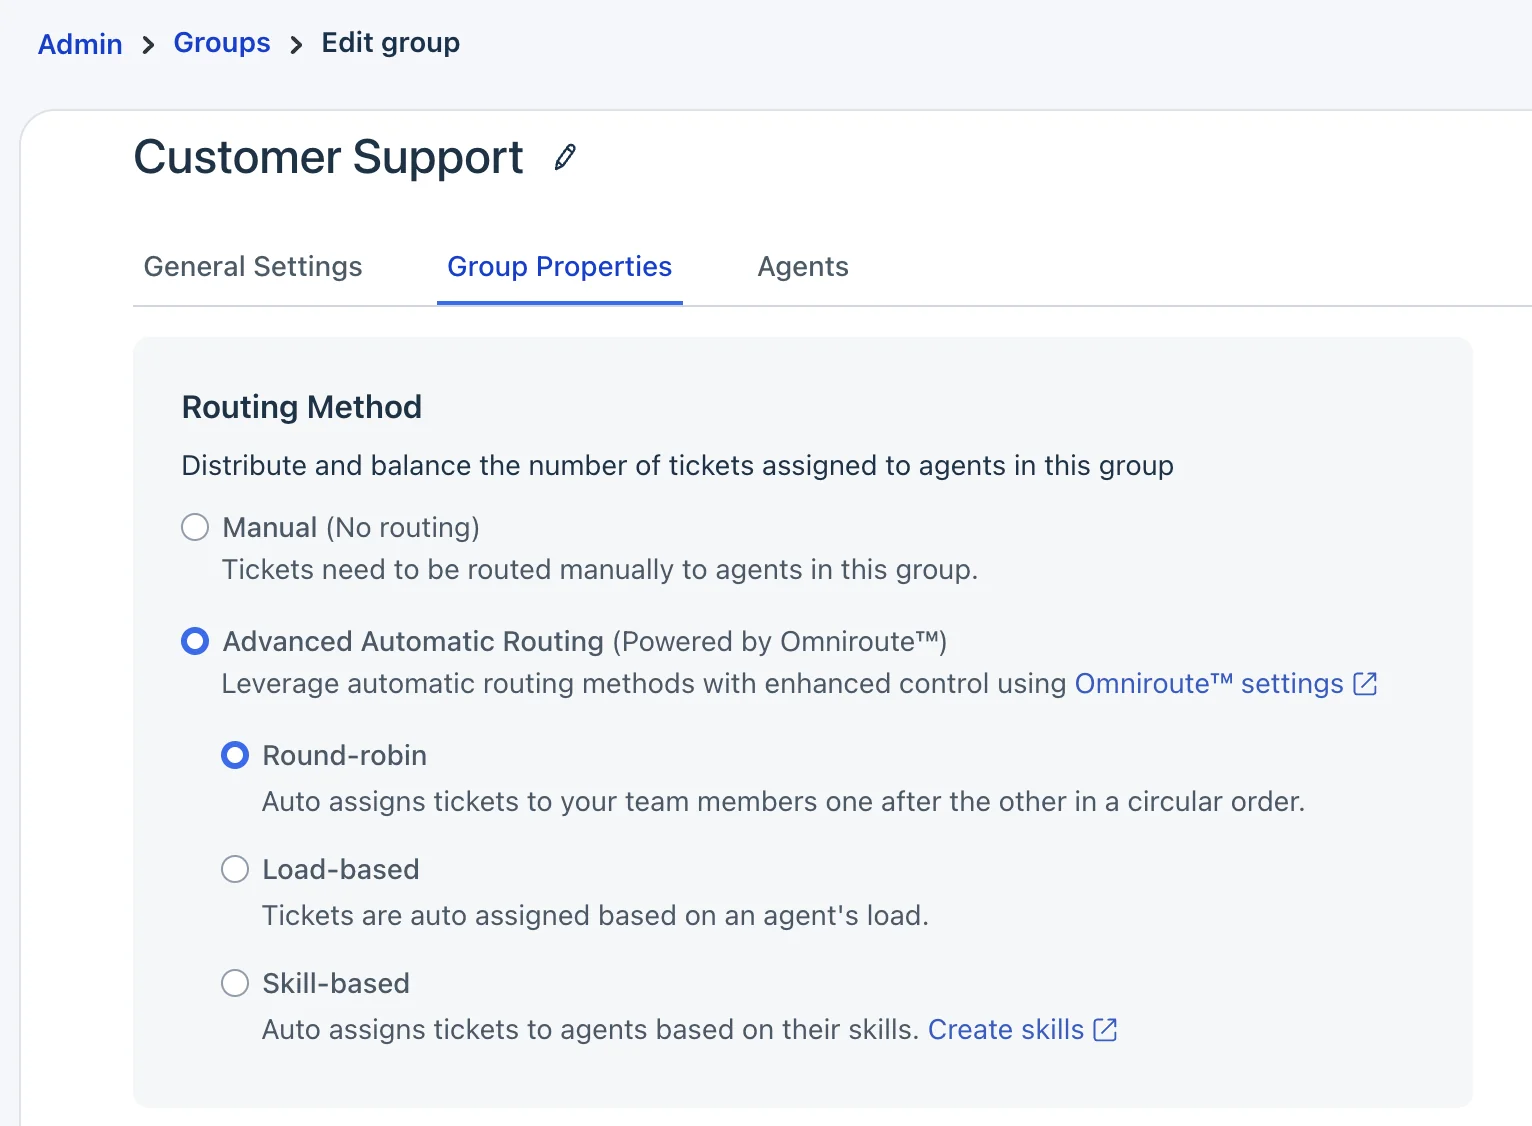
Round Robin und lastbasierte Zuweisung gibt es in Pro und Enterprise, und Round Robin überspringt Agenten, die schon ausgelastet sind (Freshdesk-Round-Robin-Doku). Lastbasiert gibt jedes Ticket dem am wenigsten belasteten verfügbaren Agenten, bis jeder sein Limit erreicht. Skillbasiertes Routing gibt es nur in Enterprise.
Auf Freshdesks Preisseite sind das Growth $19, Pro $55 und Enterprise $89 pro Agent.
Zwei Details erwischen Teams. Erstens kann ein Offline-Agent keine neuen Tickets erhalten, und wenn niemand verfügbar ist, bleibt das Ticket unzugewiesen. Zweitens kann eine manuelle Zuweisung einen Agenten über sein Limit schieben, und dieser Überschuss blockiert dann seine automatische Zuweisung (Freshdesk-Omniroute-Doku). Ich habe keine Einstellung gefunden, die die offenen E-Mail-Tickets eines Offline-Agenten in den Pool zurückgibt, also plane beim Schichtwechsel einen manuellen Durchgang ein. Kollisionserkennung gibt es ab Growth.
Help Scout
Help Scout hält es einfach. Das Routing bietet zwei Methoden: Round Robin, das „one by one in alphabetical order“ zuweist, in Plus, und Balanced, das dem Teammitglied mit den wenigsten aktiven Gesprächen zuweist, in Pro (Help-Scout-Routing-Doku).
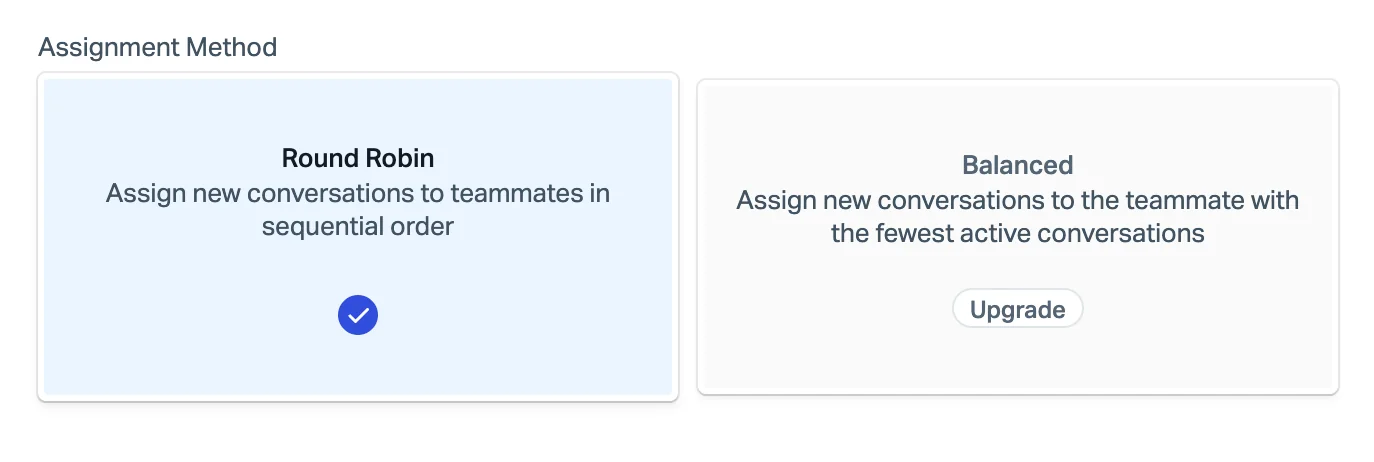
Das Routing überspringt Teammitglieder, die Away oder an ihrem Limit sind (bis zu 100), arbeitet das am längsten Wartende zuerst ab und greift alles auf, was schon in Unassigned liegt. Manuelle und Workflow-Zuweisungen ignorieren diese Regeln. Die Kollisionserkennung gibt es in jedem Tarif, und Help Scout pausiert deine Antwort, wenn ein Teammitglied geantwortet hat oder der Kunde geschrieben hat, seit du das Gespräch geöffnet hast (Help-Scout-Kollisions-Doku). Help Scouts Preise nennen Standard mit $25, Plus mit $45 und Pro mit $75 pro Nutzer und Monat. Wenn du es mit KI kombinierst, zeigt mein Leitfaden zur Help-Scout-Triage, was sich automatisieren lässt.
Front
Front routet über Regeln. Eine Round-Robin-Regel weist reihum Online-Teammitgliedern zu, aber wenn alle offline sind, wird nichts zugewiesen und es gibt keine Warteschlange, sodass ein Teammitglied, das später zurückkommt, die verpassten Gespräche nicht bekommt (Fronts Routing-Doku). Eine Load-Balancing-Regel ist für eine gemeinsame Warteschlange klüger: Sie weist dem mit den wenigsten offenen Gesprächen zu, bis zu deren Limit (max. 100), reiht ein, wenn alle voll sind, und macht beim ältesten unbeantworteten Gespräch weiter. Sie gibt es ab Professional (Front-Load-Balancing-Doku).
Fronts Umgang mit Abwesenheit ist einer der besseren für eine gemeinsame Warteschlange: Antworten auf Gespräche, die einem abwesenden Teammitglied zugewiesen sind, heben die Zuweisung auf und gehen automatisch zurück zu Unassigned, in allen Tarifen (Front-Out-of-Office-Doku). Fronts Preise nennen Starter $25, Professional $65 und Enterprise $105 pro Platz. Zur KI-Seite siehe meinen Beitrag zur Front-Triage.
Gorgias
Gorgias rechnet nicht pro Agent ab. Es rechnet nach Ticketvolumen ab, mit Helpdesk-Tarifen von Starter für $10 im Monat für 50 Tickets bis Advanced für $750 für 5.000 bei jährlicher Abrechnung (Gorgias-Preise). Die automatische Zuweisung ist in jedem Helpdesk-Tarif enthalten: Regeln schicken ein Ticket an ein Team, dann ordnet Gorgias Tickets nach Priorität und Erstellungsdatum und gibt sie verfügbaren Agenten mit den wenigsten Tickets (Gorgias-Auto-Assign-Doku).
Das Kapazitätslimit ist eine einzige Zahl für alle Agenten, sodass du einem Neuling keine leichtere Last geben kannst als einem erfahrenen Agenten. Gorgias kann die Zuweisung eines wiedereröffneten Tickets aufheben, wenn dessen Agent offline ist, und bei Chats, wenn der Agent nicht mehr verfügbar ist. Mein Leitfaden zu Gorgias-Zuweisungsregeln geht tiefer, und der Beitrag zu Gorgias-Ansichten behandelt die Queue-Seite.
Verhindere, dass zwei Personen dasselbe Ticket beantworten
Das Gegenteil eines verlorenen Tickets ist ein doppeltes: Zwei Agenten antworten demselben Kunden mit leicht unterschiedlichen Antworten. Das ist seltener als verlorene Tickets, fällt Kunden aber stärker auf. Ein CS-Lead zeigte in einem Thread über gemeinsame Postfächer auf die Lösung:
"Zendesk or hubspot would be good for tracking, and assigned ownership so multiple people don't try to take ownership and end up causing issues."
Es gibt zwei Schutzebenen. Die erste ist die Zuweisung: Ein Ticket mit genau einem Verantwortlichen ab dem Moment des Eingangs kann nicht doppelt genommen werden. Die zweite ist die Kollisionserkennung, die zeigt, wer sonst noch ansieht oder tippt. Fronts Version ist ein gutes Beispiel dafür, worauf du achten solltest:
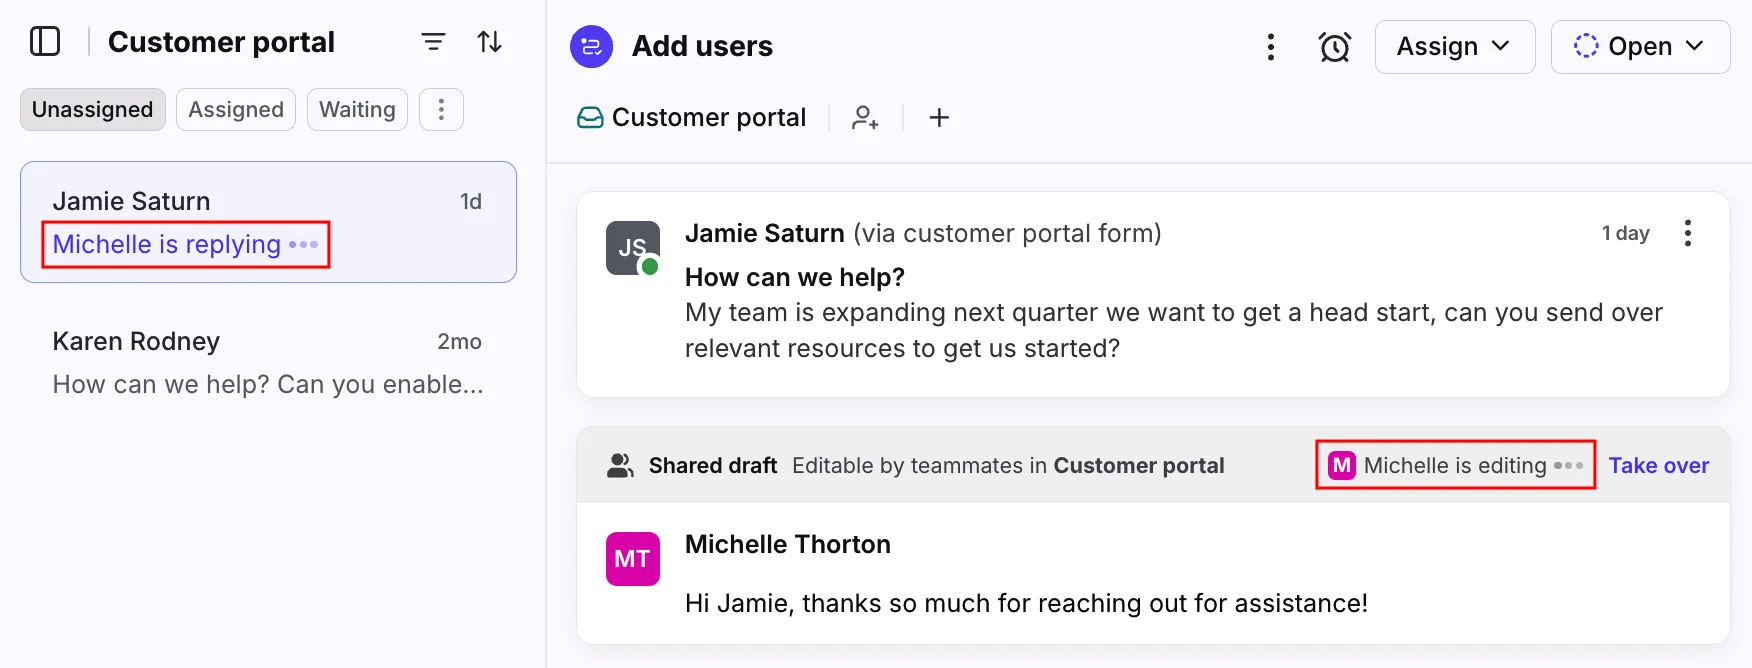
Die „replying“-Markierung erscheint in der Liste selbst, noch bevor du das Gespräch öffnest, und der gemeinsame Entwurf hat einen Take-over-Button für Übergaben (Front-Kollisions-Doku). Wenn dein aktueller Tarif keine Kollisionserkennung hat (Zendesk Team, Freshdesk Free), zählt Push-Zuweisung noch mehr, weil sie dein einziger Schutz ist.
Die Regeln, die eine gemeinsame Warteschlange ehrlich halten
Tools geben dir die Einstellungen. Diese sechs Regeln entscheiden, ob die Einstellungen wirken.
- Jedes neue Ticket bekommt innerhalb einer festen Zeit einen Verantwortlichen. Wähle pro Kanal eine Zahl, zum Beispiel 30 Minuten für E-Mail und ein paar Sekunden für Chat. Verfolge sie als eigenes Ziel, getrennt von deiner SLA für eine erste Antwort.
- Eine Person verantwortet pro Schicht die Reste. Ein Kommentator im Thread über das zwei Tage unzugewiesene Ticket schlug die einfachste Version vor: "Make one person responsible each day/week for triage; reading all calls as they come in, fixing the 5 minute ones and assigning out the remainder" (r/CustomerService).
- Sortiere gemeinsame Ansichten nach ältestem zuerst. Ansichten mit neuestem zuerst belohnen das Greifen frischer, einfacher Tickets. Mit ältestem zuerst ist das alternde Ticket das Erste, was alle sehen.
- Setze Kapazitätslimits und halte sie ein. Jeder oben genannte Helpdesk lässt Agenten sich selbst über ihr Limit hinaus zuweisen. Wenn Leads weiter dem schnellsten Agenten Tickets aufladen, gleicht Push-Routing nichts mehr aus.
- Gib dem Abwesenheitsstatus Bedeutung. Routing überspringt nur Agenten, die als abwesend oder offline markiert sind. Wenn Agenten vergessen, ihren Status in der Mittagspause zu setzen, stauen sich Tickets auf ihren Namen. Kombiniere das mit einem Durchgang zur Schichtübergabe für alles, was noch jemandem zugewiesen ist, der weg ist.
- Eskaliere Tickets ohne Besitzer automatisch. Ein Trigger oder eine Automatisierung, die einen Lead alarmiert, wenn ein Ticket länger als dein Limit unzugewiesen ist, ist eine günstige Versicherung. Mein Leitfaden zum Eskalieren nicht zugewiesener Tickets hat ein Zendesk-Rezept, und SLA-Eskalationen decken die Antwortseite ab.
Es gibt auch einen Fairness-Punkt, den Leads übersehen. Ein Sysadmin auf Reddit beschrieb, dass er dreimal so viele Anrufe bearbeitete wie der Rest des Teams und gerügt wurde, weil er zu viele offene Tickets hatte, während Kollegen, die die Queue nie anfassten, für eine „gesunde“ Zahl gelobt wurden (r/sysadmin). Wenn du im Pull-Modell offene Tickets pro Agent misst, bestrafst du die Leute, die ziehen. Miss stattdessen bearbeitete Tickets und das Alter ohne Besitzer.
Was du in einer gemeinsamen Warteschlange beobachten solltest
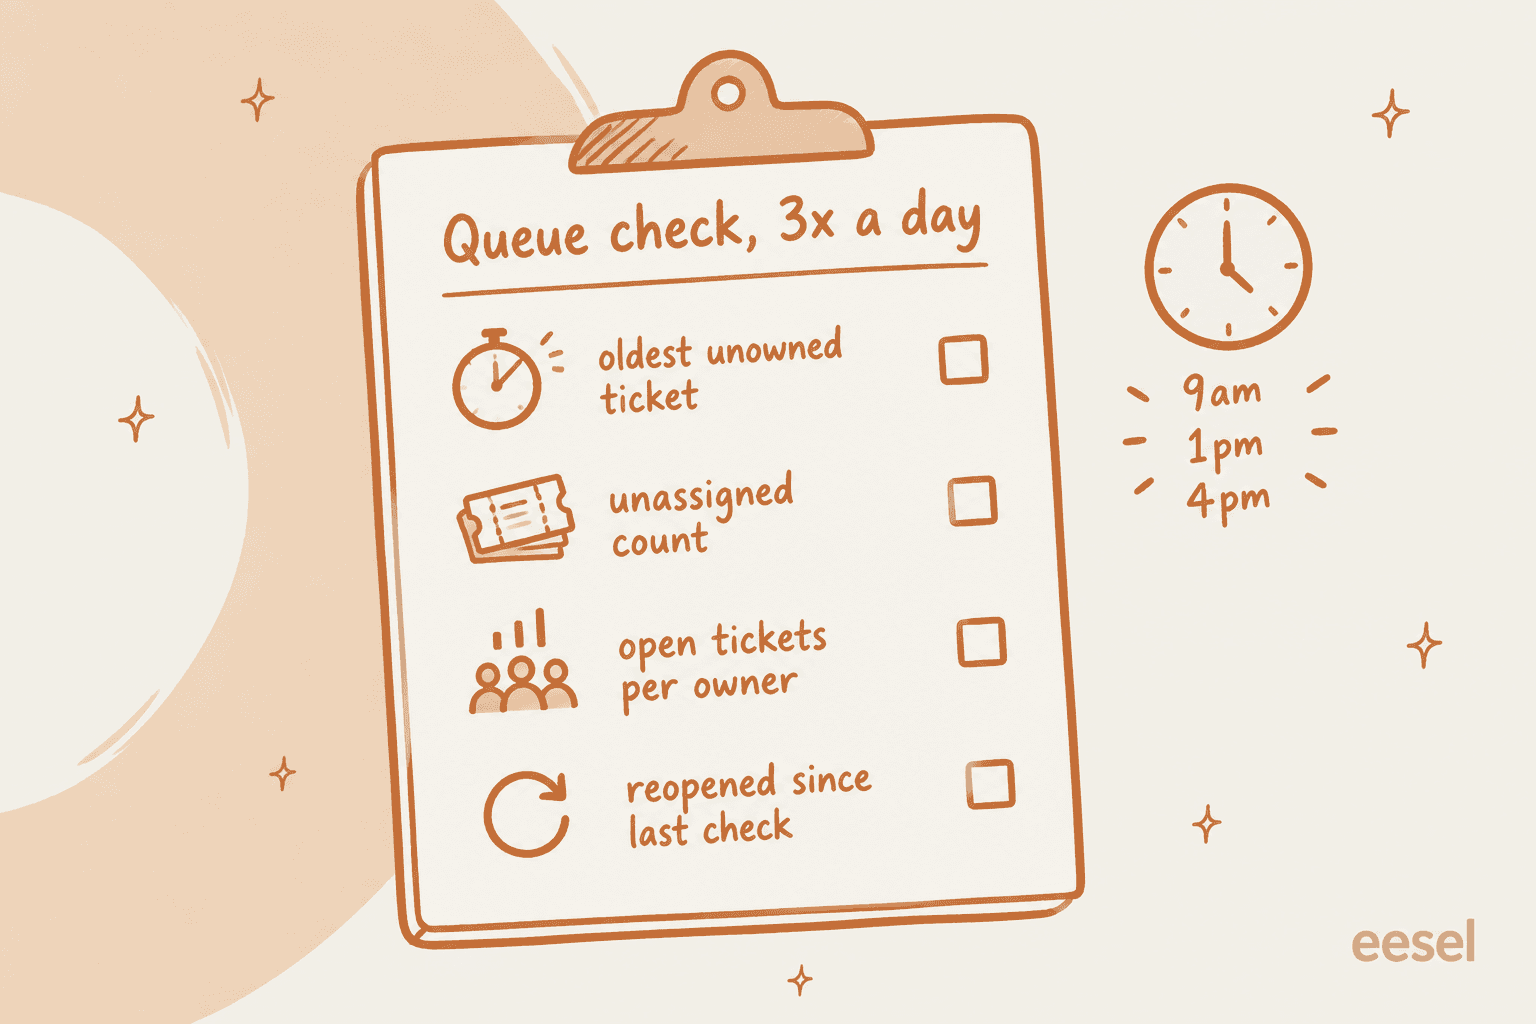
Du brauchst kein Dashboard mit 20 Kacheln. Du brauchst vier Zahlen, die du mehrmals am Tag prüfst.
| Zahl | Was sie dir sagt | Wo sie in die Irre führt |
|---|---|---|
| Ältestes Ticket ohne Besitzer | Die echte schlimmste Wartezeit | Durchschnitte verbergen sie völlig |
| Anzahl nicht zugewiesener Tickets | Ob Routing oder Leute mithalten | Ein Anstieg heißt, Status oder Kapazität sind falsch konfiguriert |
| Offene Tickets pro Verantwortlichem | Ob die Last ausgeglichen ist | Ein Agent bei dem Dreifachen der anderen heißt, Push gleicht nicht aus oder ein Lead überschreibt es |
| Seit der letzten Prüfung wiedereröffnet | Ob schnelle Antworten die Dinge wirklich lösen | Viele Wiedereröffnungen heißen, Tempo wird mit Qualität erkauft |
Diese Zahlen stehen neben deinen üblichen Kundenservice-KPIs, nicht an deren Stelle. Wenn dein Ticket-Rückstau schon groß ist, beginne mit meinem Leitfaden zum Abbau eines Support-Rückstaus, bevor du das Routing abstimmst.
Routing kann eine Warteschlange nicht reparieren, die schlicht unterbesetzt ist. Mein Beitrag zur Support-Abdeckungsplanung hat die Personalrechnung.
Wo KI in eine gemeinsame Warteschlange passt
Der Großteil der Arbeit in einer gemeinsamen Warteschlange ist nicht das Antworten. Es ist, ein Ticket zu lesen, zu entscheiden, was es ist, es zu taggen und zu entscheiden, wer es bekommen soll. Bei diesem Sortierschritt ist KI gut geworden, und dort würde ich anfangen.
eesel setzt seit Jahren KI auf Live-Support-Queues, und die Zahlen aus echten Einführungen sind nützlicher als jede Behauptung. In einem Test mit echtem Zendesk-Traffic bei einem deutschen Online-Schmuckhändler mit rund 1.000 Tickets im Monat erreichte eesels KI 93 % Triage-Genauigkeit und 100 % Spam-Erkennung, ohne Fehlalarme bei den 22 % des Posteingangs, die sich als Spam herausstellten. Die Antwortentwürfe waren zu 88 % in der Richtung richtig, und 12 % gingen unverändert raus. Die Agenten nutzten sie meist als Recherche- und Auto-Triage-Assistenten, genau die Aufgabe, die eine gemeinsame Warteschlange braucht.
Die häufigste Anforderung, die ich von Käufern höre, betrifft Kontrolle, nicht Tempo. Ein CX-Lead bei einer Supplement-Marke auf Gorgias mit etwa 7.000 Tickets im Monat sagte es in einem Gespräch so:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist der richtige Instinkt für eine gemeinsame Warteschlange. Die KI sollte die Tickets nehmen, die sie vollständig bearbeiten kann, den Rest sortieren und routen und alles Unsichere einem Menschen überlassen. Beim Helpdesk-Teammitglied von eesel folgt das Routing deinen eigenen Anweisungen (zum Beispiel „Weise alles von einem verärgerten Kunden dem Senior-Team zu“) über die Zuweisungsaktionen des Helpdesks. Du kannst in Stufen ausrollen: zuerst Entwürfe als interne Notizen, dann lässt du es die einfachen Tickets von Anfang bis Ende beantworten. Bevor etwas davon live geht, spielt Simulation deine vergangenen Tickets nach und bewertet die Antworten der KI gegen das, was dein Team tatsächlich geschickt hat, sodass du die Fehler siehst, bevor es Kunden tun.
Gridwise, eine Fahrer-Analytics-App auf Zendesk, schrieb in einer G2-Bewertung:
"In the first month, eesel is resolving 73% of our tier 1 requests... The platform even includes automations for ticket tagging, assignment, and status updates!"
Kim Simpson, Gridwise
Für eine gemeinsame Warteschlange heißt das: Die einfachen Tickets erreichen den Stapel gar nicht erst, und die, die ankommen, sind schon getaggt und geroutet. Wenn du Optionen vergleichst, deckt meine Übersicht der besten KI für Ticket-Triage das Feld ab, und der Leitfaden zum KI-Copilot die Entwurfsseite.
Häufige Fehler bei gemeinsamen Warteschlangen
- Ein gemeinsames Postfach ganz ohne Zuweisung betreiben. Bei 10 Tickets am Tag in Ordnung, bei 40 chaotisch. Ein CS-Verantwortlicher beschrieb den Wechsel auf eine eigene Plattform, "once it became unwieldy to manage the responses and mistakes were being made" (r/CustomerSuccess). Mein Beitrag zu gemeinsamem Posteingang vs. Ticketsystem behandelt, wann du wechseln solltest.
- Die Warteschlange in persönliche Postfächer aufteilen. Das wirkt aufgeräumt, aber niemand sieht den Rückstand eines Kollegen, und Tickets sterben, wenn jemand krank ist. Behalte eine Warteschlange und route innerhalb davon. Mein Leitfaden zu verteilten Support-Abläufen macht dasselbe Argument für Teams an mehreren Standorten.
- Push-Routing ohne Kapazitätslimits einschalten. Du bekommst das Muster „15 Tickets an drei Leute, keines an den Rest“ aus dem Zendesk-Thread oben.
- Eskalationen als Teil des allgemeinen Pools behandeln. Eskalierte Tickets brauchen einen benannten Verantwortlichen, keinen Platz im Round Robin. Siehe meinen Leitfaden zum Ticket-Eskalationsprozess und für Übergaben an die Entwicklung die teamübergreifende Eskalation.
- Zeitzonen ignorieren. Eine Warteschlange, die von Leuten in verschiedenen Regionen abgedeckt wird, braucht Routing nach Zeitplan, sonst landet der nächtliche Stapel bei der Person, die sich zuerst einloggt. Follow-the-Sun-Support behandelt dieses Setup.
eesel für gemeinsame Support-Warteschlangen
Wenn deine gemeinsame Warteschlange in wiederkehrenden Tickets ertrinkt, ist die günstigste Lösung ein Teammitglied, das sie vom Stapel nimmt. eesels KI-Helpdesk-Teammitglied lässt sich in Minuten in Zendesk, Freshdesk, Gorgias, Front, Help Scout und andere Helpdesks einbinden, lernt aus deinen vergangenen Tickets, Makros und deinem Help Center und taggt, routet und beantwortet dann die einfachen Tickets in der Warteschlange, die du schon betreibst. Deine Agenten behalten ihre Ansichten, ihr Routing und ihren Workflow. Sie sehen nur weniger Tickets, und die, die sie sehen, sind schon sortiert.

Du kannst es mit Simulation an deinen eigenen vergangenen Tickets testen, bevor es einen echten Kunden berührt, und es gibt einen kostenlosen Tarif zum Start. Probiere eesel an deiner gemeinsamen Warteschlange aus und sieh, welche Tickets es letzte Woche geräumt hätte.