

Kurzfassung
Support-Überlauf-Management ist vor allem eine Routing-Entscheidung, keine Personalentscheidung. In Zendesk, Freshdesk, Help Scout, Front, Gorgias und HubSpot ist der Standard, wenn alle Agenten ausgelastet sind, überall derselbe: Neue Arbeit bleibt unzugewiesen in der Warteschlange, bis jemand wieder Kapazität hat. Überlauf wird nur dann behandelt, wenn Sie vorab entscheiden, wohin das nächste Ticket geht.
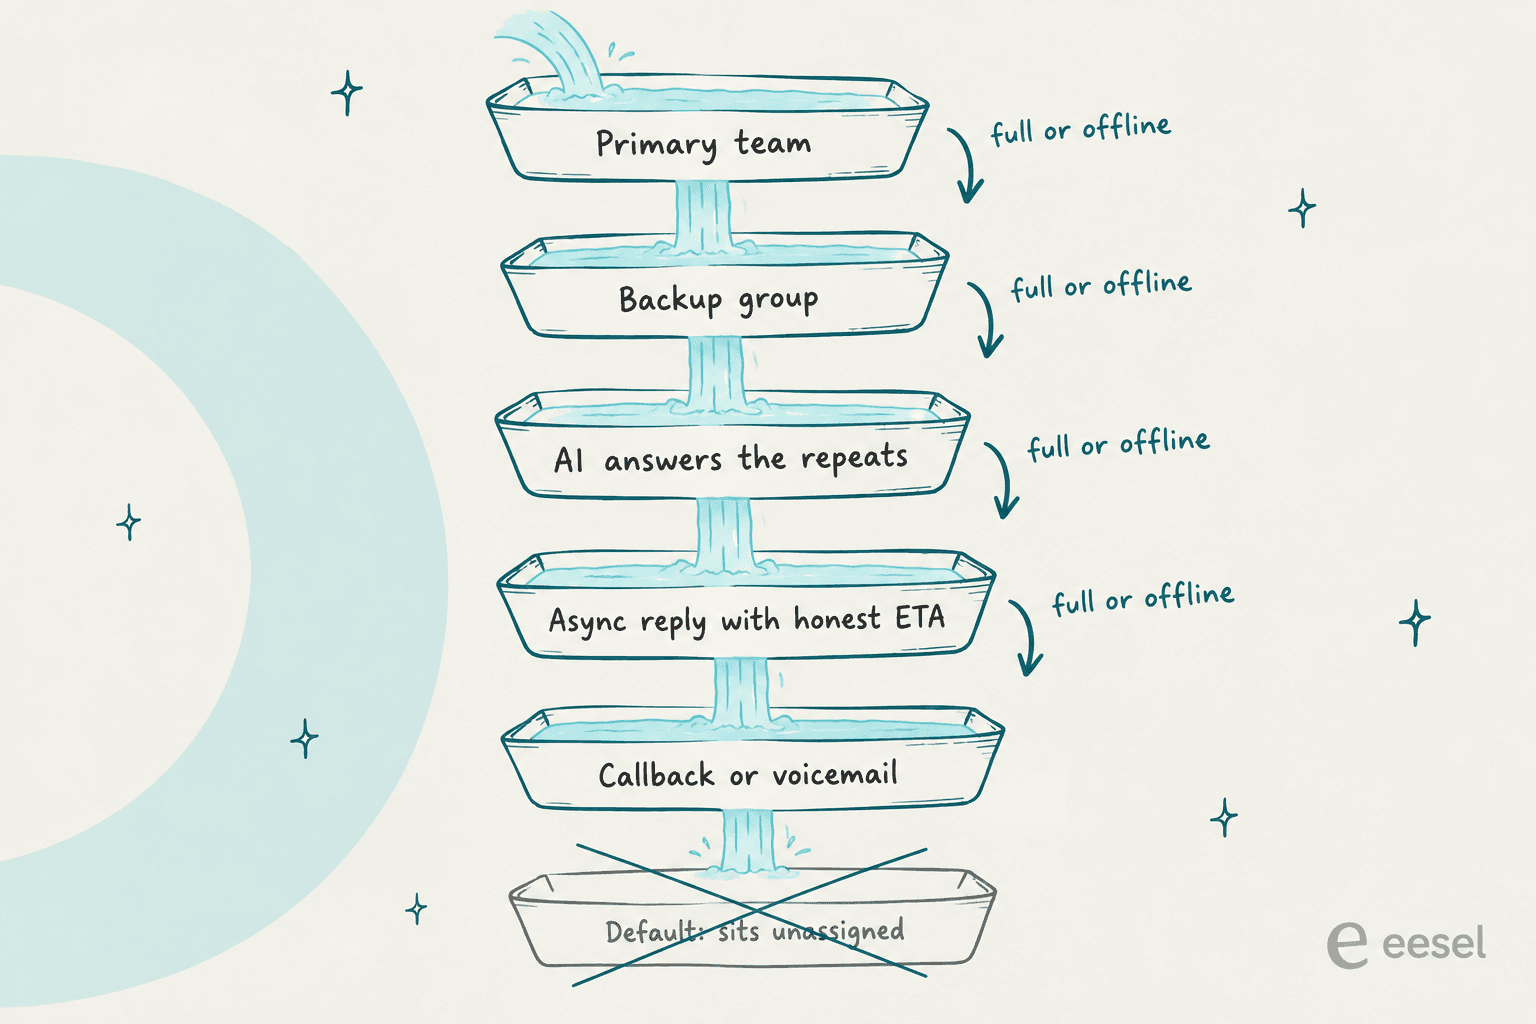
Das Setup, das für die meisten Teams funktioniert, ist eine Kaskade: primäres Team, dann eine Backup-Gruppe, dann eine KI-Schicht, die die wiederkehrenden Fragen beantwortet, dann asynchrone Antworten mit ehrlicher Wartezeit, dann Rückrufe für Telefon. Die Backup-Gruppen-Funktionen sind an Tarife gebunden (benutzerdefinierte Zendesk-Warteschlangen brauchen Suite Professional, die Fallback-Gruppen-Umleitung von Freshdesk gibt es nur in Enterprise). Prüfen Sie Ihren Tarif also vor der Spitze, nicht währenddessen.
Ich bearbeite jeden Tag die Support-Warteschlange von eesel, und der Großteil des Ansturms besteht aus denselben wenigen Fragen: Bestellstatus, Abo-Änderungen, „Ist es down?“. Ein Ops-Lead einer DTC-Marke mit etwa 7.000 Gorgias-Tickets pro Monat sagte eesel, das Team komme schlicht nicht hinterher und brauche KI, die mindestens die Hälfte des E-Mail-Volumens löst. Genau diesen wiederkehrenden Anteil nimmt das KI-Teammate von eesel innerhalb Ihres bestehenden Helpdesks aus der Warteschlange, damit Ihre Leute den Ansturm für die Tickets nutzen, die einen Menschen brauchen.
Was Support-Überlauf-Management tatsächlich umfasst
Überlauf ist jede Arbeit, die eintrifft, wenn jeder Agent, der sie übernehmen könnte, entweder am Limit oder offline ist. Dieser letzte Punkt ist wichtig: Es geht nicht nur um „zu viele Tickets“. Ein Dienstagnachmittag mit zwei kranken Kollegen ist ein Überlauf-Ereignis. Genauso ein Chat um 2 Uhr nachts, wenn Ihre Abdeckung außerhalb der Geschäftszeiten aus einer Mailbox-Ansage besteht.
Meist tritt er in einer von drei Formen auf:
| Form | Auslöser | Dauer | Was es braucht |
|---|---|---|---|
| Spitze | Ausfall, Launch, viraler Post, Lieferverzögerung | Stunden bis 2 Tage | Schnelle Eins-zu-viele-Antworten, eine Backup-Stufe, die in Minuten aufgeht |
| Saisonale Spitze | Black Friday, Feiertage, Verlängerungssaison, Steuerfristen | 2 bis 12 Wochen | Geplante Zusatzkapazität, geschulte Aushilfen oder ein Partner, vorformulierte Antworten |
| Abdeckungslücke | Krankheitstage, Zeitzonen, Mittagspause, Teammeeting | Minuten bis Stunden | Routing, das nicht davon abhängt, dass eine einzelne Person online ist |
Die meisten Leitfäden behandeln das als ein einziges Problem und springen direkt zu „mehr einstellen“ oder „auslagern“. Ich würde günstiger anfangen: Schauen Sie, was Ihr Helpdesk heute mit dem nächsten Ticket macht, wenn alle ausgelastet sind, denn dieser Standard kostet Sie wahrscheinlich mehr als Personal.
Wohin Überlauf in den einzelnen Helpdesks standardmäßig geht
Ich habe die Routing-Dokumentation der sieben Tools durchgesehen, die ich in der eesel-Support-Warteschlange am häufigsten sehe. Das Muster ist auffällig. Wenn jeder infrage kommende Agent sein Limit erreicht hat, lassen fast alle neue Arbeit ohne Namen in der Support-Warteschlange liegen:
| Helpdesk | Limit pro Agent | Alle Agenten ausgelastet oder offline | Eingebaute Überlauf-Stufe | Benötigter Tarif |
|---|---|---|---|---|
| Zendesk | E-Mail bis 500 offen, Messaging bis 20 | Ticket bleibt in der Warteschlange | Sekundäre Gruppen in einer benutzerdefinierten Warteschlange | Suite Professional (115 $/Agent/Monat) |
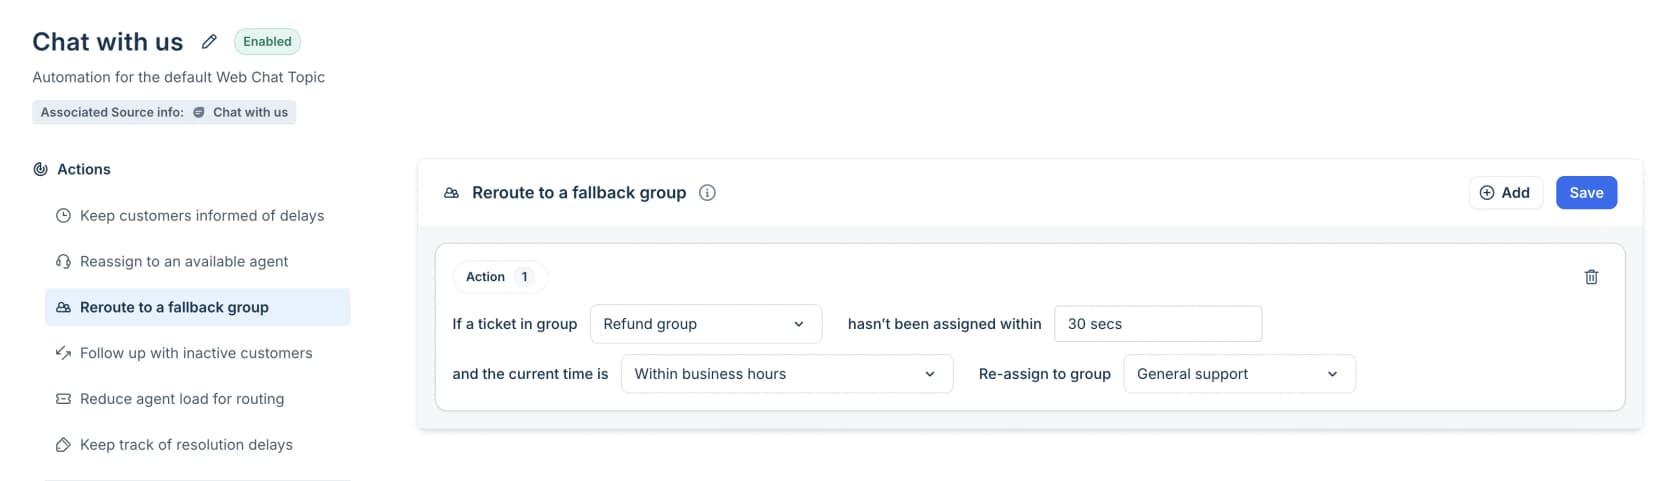
| Freshdesk | Last pro Warteschlange (z. B. E-Mail 5, Messaging 10) | Ticket bleibt unzugewiesen | „Reroute to a Fallback Group“ nach N Sekunden | Enterprise (89 $/Agent/Monat) |
| Help Scout | Zuweisungslimit bis 100, Chats standardmäßig 3 | Konversation bleibt in Unassigned | Keine dokumentiert | Round Robin im Plus (45 $), Balanced im Pro (75 $) |
| Front | Limit für Load Balancing, Standard und Maximum 100 | Load Balancing stellt Arbeit in die Warteschlange; Round Robin nicht | Keine dokumentiert | Tarif auf der Preisseite nicht angegeben |
| Gorgias | Zwei Limits: Chat und Messaging, sonstiger Text | Ticket bleibt unzugewiesen | „Skip queue when it's too busy“ bei Voice | Alle Helpdesk-Tarife (Voice-Add-on ab 25 $/Monat) |
| HubSpot Service Hub | Ticketkapazität (Pro+), Chatkapazität standardmäßig 3, max. 99 (Enterprise) | Ticket bleibt unzugewiesen, bis es manuell zugewiesen wird | Optionaler Fallback von Chats auf den Customer Agent | Professional (90 $/Seat) oder Enterprise (150 $/Seat) |
| Aircall (Voice) | Ring-basiert | Anruf wartet die Warteschlangenzeit ab, dann Mailbox oder verpasst | Einen weiteren Ring-to-Schritt nach dem ersten anhängen | Rückrufe im Professional (50 $/Lizenz) |
Zwei Dinge fallen auf. Erstens: Nur Zendesk und Freshdesk liefern eine echte „an eine andere Gruppe senden“-Überlaufregel, und beide legen sie hinter einen höheren Tarif. Zweitens funktionieren die beiden Tools unterschiedlich. Zendesk läuft nach Verfügbarkeit über: Die Arbeit geht zuerst an primäre Gruppen und fällt nur dann an sekundäre Gruppen, wenn kein primärer Agent verfügbar ist. Freshdesk läuft nach Zeit über: Die Quick-Automations-Regel greift, wenn ein Ticket in einer Gruppe nicht innerhalb einer festgelegten Zahl von Sekunden zugewiesen wurde, etwa fünf Minuten für ein Refunds-Ticket, bevor es an General Support geht.
Front ist der Fall, den man im Auge behalten sollte. Wenn Sie Round Robin nutzen, gibt es keine Warteschlange, sobald alle offline sind, und eine verpasste Zuweisung wird nicht erneut versucht, wenn jemand zurückkommt. Load Balancing stellt in die Warteschlange und gibt zuerst die älteste unbeantwortete Konversation aus. Wenn Ihr Front-Team klein und spitzenanfällig ist, entscheidet diese eine Einstellung, ob Überlauf in der Schlange wartet oder verloren geht.
So wird ein kritisches Ticket begraben. Ein Zendesk-Admin hat genau das auf Reddit beschrieben:
„Ein Enterprise-Kunde meldete um 9 Uhr, dass sein Produktivsystem down ist. Das Ticket lag bis 14 Uhr in unserer Warteschlange, weil über Nacht 30+ andere Tickets hereingekommen waren.“

Bauen Sie eine Überlauf-Kaskade statt eines größeren Teams
Ein Sysadmin fasste in einem Thread über überraschende Anrufspitzen zusammen, warum Personalplanung für die Spitze selten funktioniert:
„Man kann nicht für die seltenen 1 % Ereignisse besetzen, man besetzt für die 90 % der normalen Tage.“
Die Lösung für „Arbeit bleibt unzugewiesen“ ist also, jedem Ticket eine nächste Station zu geben. Ich stelle mir das als Stapel von Ablagekörben vor: Wenn einer voll ist, läuft er in den nächsten über, und der unterste Korb ist nie „niemand“.
So würde ich es aufbauen, in der Reihenfolge, die für das wenigste Geld die meiste Entlastung bringt.
1. Schwellenwerte am Ticketalter festmachen, nicht an der Ticketanzahl
Eine Warteschlange mit 150 Tickets, die vor zehn Minuten eingegangen sind, ist in Ordnung. Eine Warteschlange mit 40 Tickets, in der das älteste 18 Stunden wartet, ist ein Brand. Die Anzahl lügt bei einem Ansturm, weil sie schnell hochschnellt und sich wieder erholt. Das Alter des ältesten unbeantworteten Tickets zeigt, ob Kunden tatsächlich zurückgelassen werden, und es lässt sich direkt auf Ihre erste Antwortzeit und Ihre SLA-Versprechen abbilden.
Schreiben Sie drei oder vier Stufen auf und legen Sie für jede die eine Sache fest, die sich ändert. Die folgenden Zahlen sind ein Ausgangspunkt, den ich an Ihre eigene SLA anpassen würde, kein Standard:
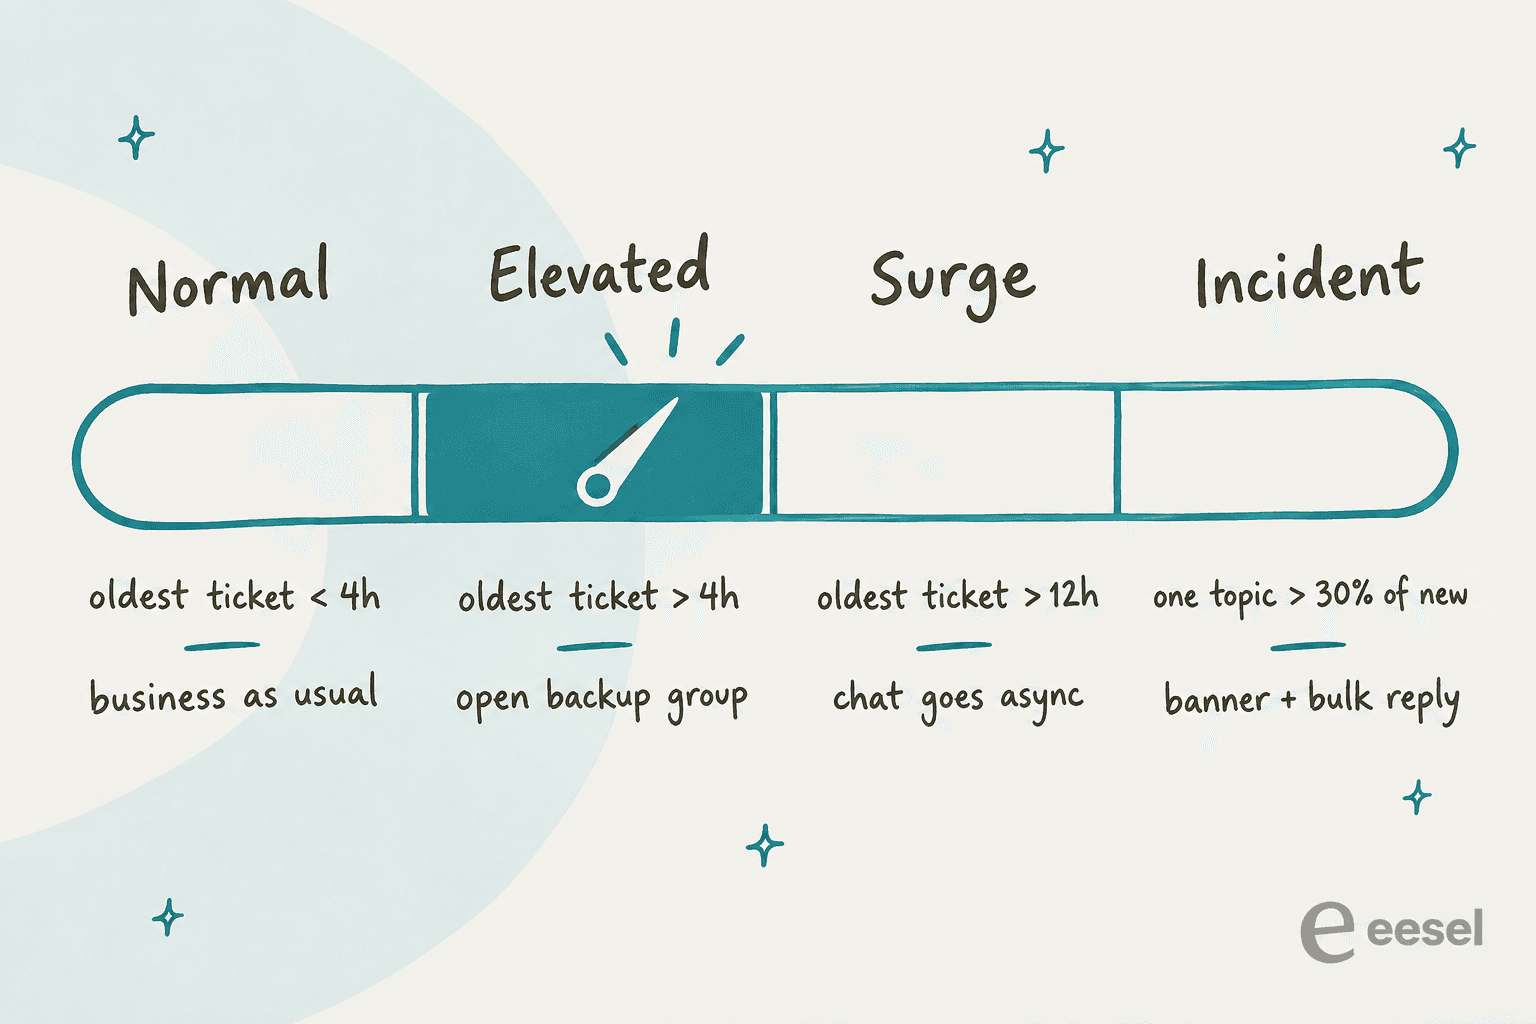
Der Sinn des Aufschreibens: Niemand muss um 16 Uhr am Launch-Tag eine Ermessensentscheidung treffen. Die Regel existiert bereits, und wer bemerkt, dass sich der Zeiger bewegt, legt einfach den Schalter um.
2. Backup-Gruppe öffnen, bevor Sie sie brauchen
Die Backup-Gruppe sind die Leute, die Tier-1-Arbeit übernehmen können, wenn das Hauptteam ausgelastet ist: ein zweites Team, Senior-Agenten aus einer anderen Region oder ein paar geschulte Freiwillige aus Success und Sales. Richten Sie sie in einer ruhigen Woche im Tool ein.
- Zendesk. Erstellen Sie eine benutzerdefinierte Warteschlange, fügen Sie Ihre Hauptgruppen als primär hinzu, wählen Sie dann „Turn on secondary groups“ und fügen Sie das Backup hinzu. Jede benutzerdefinierte Warteschlange fasst bis zu 20 primäre und 20 sekundäre Gruppen, und Sie können bis zu 199 Warteschlangen haben. Zendesks eigenes Rezept für Messaging ergänzt eine „Backup“-Gruppe als letzte Instanz, damit Tickets „nicht länger in den Warteschlangen hängen, als Sie es für vertretbar halten“.
- Freshdesk. Teilen Sie im Pro-Tarif die Kapazität jedes Agenten in Omniroute nach Warteschlange auf, damit Chat und E-Mail sich nicht gegenseitig aushungern. Im Enterprise-Tarif ergänzen Sie die Quick Automation „Reroute to a Fallback Group“ für Echtzeit-Kanäle.
- Help Scout, Front, Gorgias, HubSpot. Es gibt keine native Überlaufgruppe. Die Notlösung ist ein Workflow oder eine Regel, die nach Tag oder Wartezeit neu zuweist, plus eine gemeinsame Warteschlange, die die Backup-Leute während eines Ansturms beobachten.
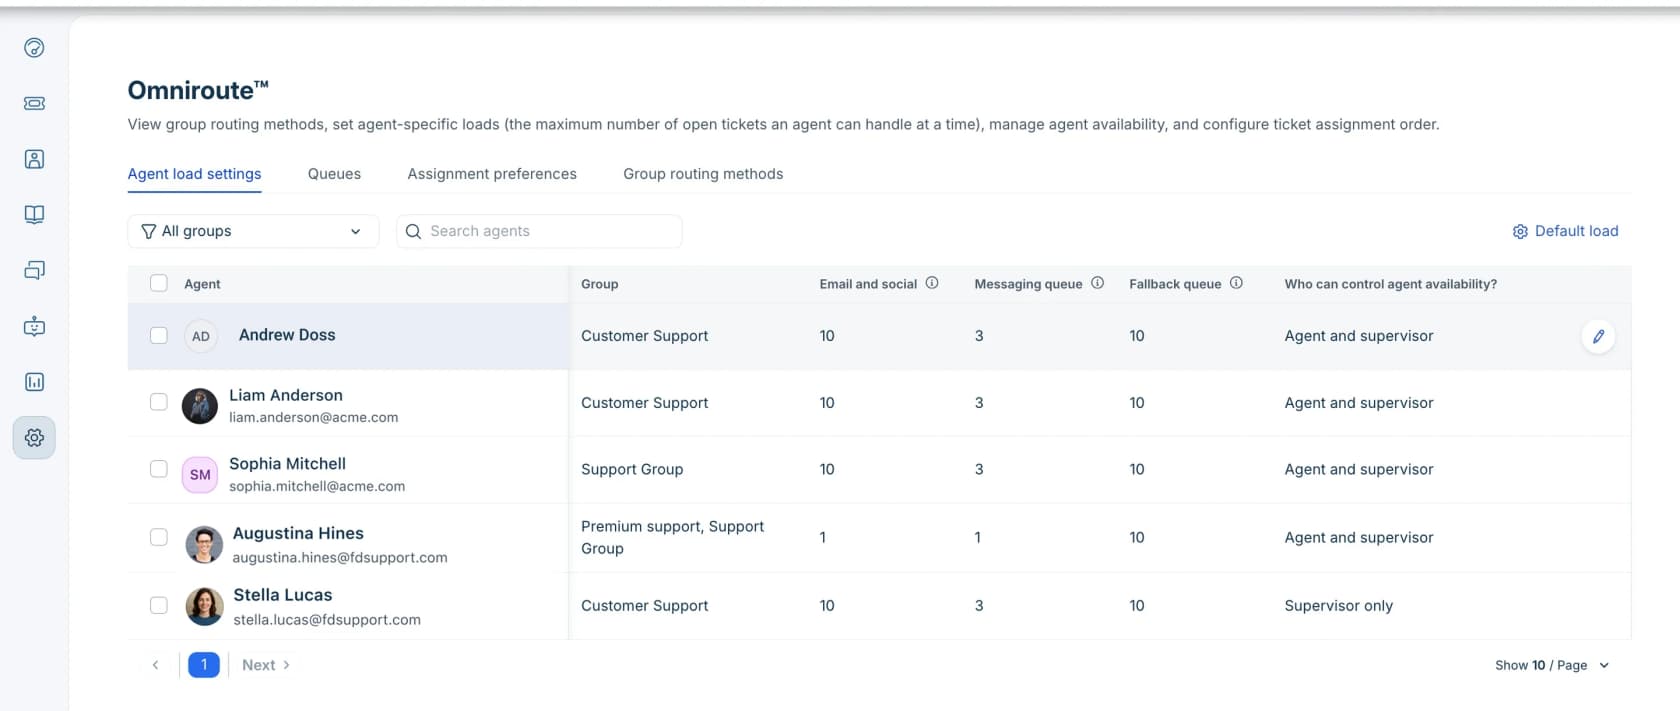
Ein Freshdesk-Detail ist hilfreich bei Spitzen, die nur eine Woche dauern: Tagespässe kosten 2 $ im Growth-, 7 $ im Pro- und 12 $ im Enterprise-Tarif. Einen Kollegen aus einer anderen Abteilung für die Launch-Woche zu leihen, heißt also nicht, einen vollen Seat zu bezahlen.
3. Spezialisten vor Tier-1-Volumen schützen
Wenn die Warteschlange überläuft, werden zuerst die Leute hineingezogen, die am meisten wissen, und sie verbringen den Ansturm damit, „Wo ist meine Bestellung?“ zu beantworten, während die schwierigen Tickets altern. Teilen Sie die Arbeit nach Typ auf. Tier-1-Fragen gehen an die Backup-Gruppe und die KI-Schicht. Rechnungsstreitigkeiten, Bugs und verärgerte VIPs bleiben bei den Spezialisten. Zendesk Suite Professional bringt dafür Skill- und Prioritäts-Routing, und Freshdesk hat im Enterprise-Tarif skill-basiertes Routing.
Wenn Sie bereits mit Stufen arbeiten, ist jetzt der Moment, in dem sich Ihr Eskalationspfad bezahlt macht. Bei einem Ansturm wird aus einem vagen „Gebt es an die Technik“ ein dreitägiges Schweigen.
4. Das Spitzenthema einmal öffentlich beantworten
Bei einem Ausfall oder einer Lieferverzögerung fragt ein großer Teil der neuen Tickets dasselbe. Jedes einzeln von Hand zu beantworten, ist die teuerste Art, „Wir wissen Bescheid, hier ist das Update“ zu sagen. Veröffentlichen Sie es einmal dort, wo Kunden nachsehen, bevor sie schreiben: in einem Status-Banner, im Help Center, in der Chat-Begrüßung und in den Antworten Ihres KI-Agenten. Bauen Sie dann ein Makro, das die Tickets beantwortet, taggt und schließt, die trotzdem eintreffen.
Derselbe Trick funktioniert am Telefon. Ein IT-Lead stellt das Update vor die Warteschlange selbst:
„Ich schalte eine Ansage vor, bevor der Anruf in die Anrufwarteschlange geroutet wird. Sie erklärt, was los ist, wann das nächste Update kommt, und dass man auflegen soll, wenn man gerade genau dieses Problem hat. Wenn nicht, bleibt man in der Leitung und wird in die Helpdesk-Warteschlange geroutet.“
Hier leistet KI auch ihre beste Überlauf-Arbeit. Sie liest die Incident-Notiz und beantwortet „Ist der Checkout down?“ einige hundert Mal mit demselben korrekten Update, während Ihr Team sich um die Kunden kümmert, deren Bestellung tatsächlich kaputtgegangen ist. Mehr dazu weiter unten.
5. Live-Kanäle mit ehrlicher Wartezeit auf asynchron umstellen
Live-Chat ist der erste Kanal, der bei einem Ansturm bricht, weil jeder Agent nur wenige Chats gleichzeitig halten kann. Der Maximum Chat von Help Scout steht standardmäßig auf 3, und auch die Chatkapazität von HubSpot ist standardmäßig 3. Wenn alle dieses Limit erreichen, ist ein Besucher, der auf ein Chatfenster starrt, das nie antwortet, schlimmer dran als mit einer E-Mail, die sagt: „Wir antworten in etwa 4 Stunden.“
Die Tools bieten den Schalter:
- HubSpot lässt Sie wählen, was passiert, wenn alle Agenten bei maximaler Kapazität sind: eine Wartenachricht anzeigen, den Launcher ausblenden oder nichts tun.
- Gorgias-Chat kann nur dann live laufen, wenn Agenten verfügbar sind, und Offline-Kunden bekommen ein Erfassungsformular, das zu einem E-Mail-Ticket wird. Es gibt außerdem die Einstellung „Share wait time with shoppers“.
- Front kann das Chat-Widget außerhalb der Online-Zeiten ausblenden, aber ein Kunde, der es bereits geöffnet hat, kann weiterhin Nachrichten senden, weshalb Front eine automatische Antwort empfiehlt.
- Zendesk-Messaging-Konversationen warten in der Warteschlange, bis ein Kapazitätsplatz frei wird, und nicht zugewiesene werden nach 10 Minuten inaktiv, wenn der Kunde nicht antwortet. Der Leitfaden zum Offline-Umgang von Zendesk Messaging behandelt die kundenseitige Seite.
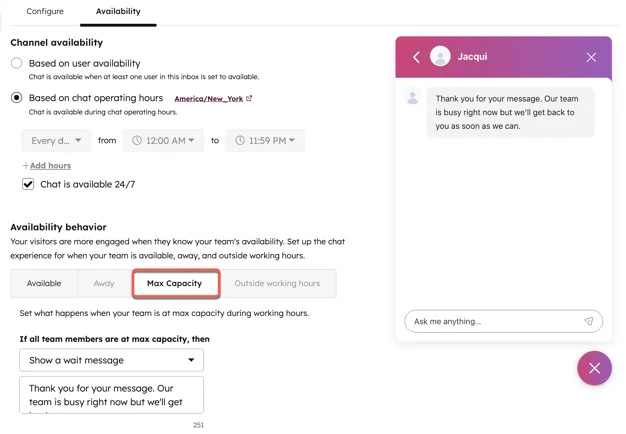
Asynchroner Support ist hier keine Verschlechterung. Ein konkretes Versprechen, das Sie halten, schlägt einen Live-Kanal, der Menschen im Stich lässt.
Voice-Überlauf: die Einstellungen, die Anrufe fallen lassen
Telefon-Überlauf verdient einen eigenen Abschnitt, denn die Standardeinstellungen können Anrufer abwürgen. Jedes Tool begrenzt, wie viele Anrufer wie lange warten, und was danach passiert, ist das, was Sie konfiguriert haben, auch wenn das nichts ist.
| Tool | Max. Warteschlangengröße | Max. Wartezeit | Wenn die Wartezeit abläuft | Rückruf |
|---|---|---|---|---|
| Zendesk Talk | 750 (Team) oder 1.500 (Pro/Enterprise) mit Omnichannel-Routing; 15 oder 50 ohne | 1 bis 20 Min., 1 bis 60 bei Enterprise | Mailbox oder Überlaufnummer, wenn die Mailbox aus ist | Professional und Enterprise |
| Freshcaller | Standard 20, mehr auf Anfrage für Pro und Enterprise | 30 Sek. bis 15 Min. | Mailbox, andere Warteschlange oder Auflegen | Taste 2, Rückruf, sobald ein Agent frei wird |
| Gorgias Voice | Warteschlangenkapazität pro Warteschlange | Max. Wartezeit in Sekunden | Nächster Schritt im Call Flow; Zweig „Skip queue when it's too busy“ | Stern-Taste, erzeugt ein Ticket „Callback requested“ |
| Aircall | Ring-basiert | 20 Sek. bis 40 Min. Team-Warteschlange | Nächstes Widget, oder der Anruf wird beendet | 0 bis 5 Wiederholungen, Professional und höher |
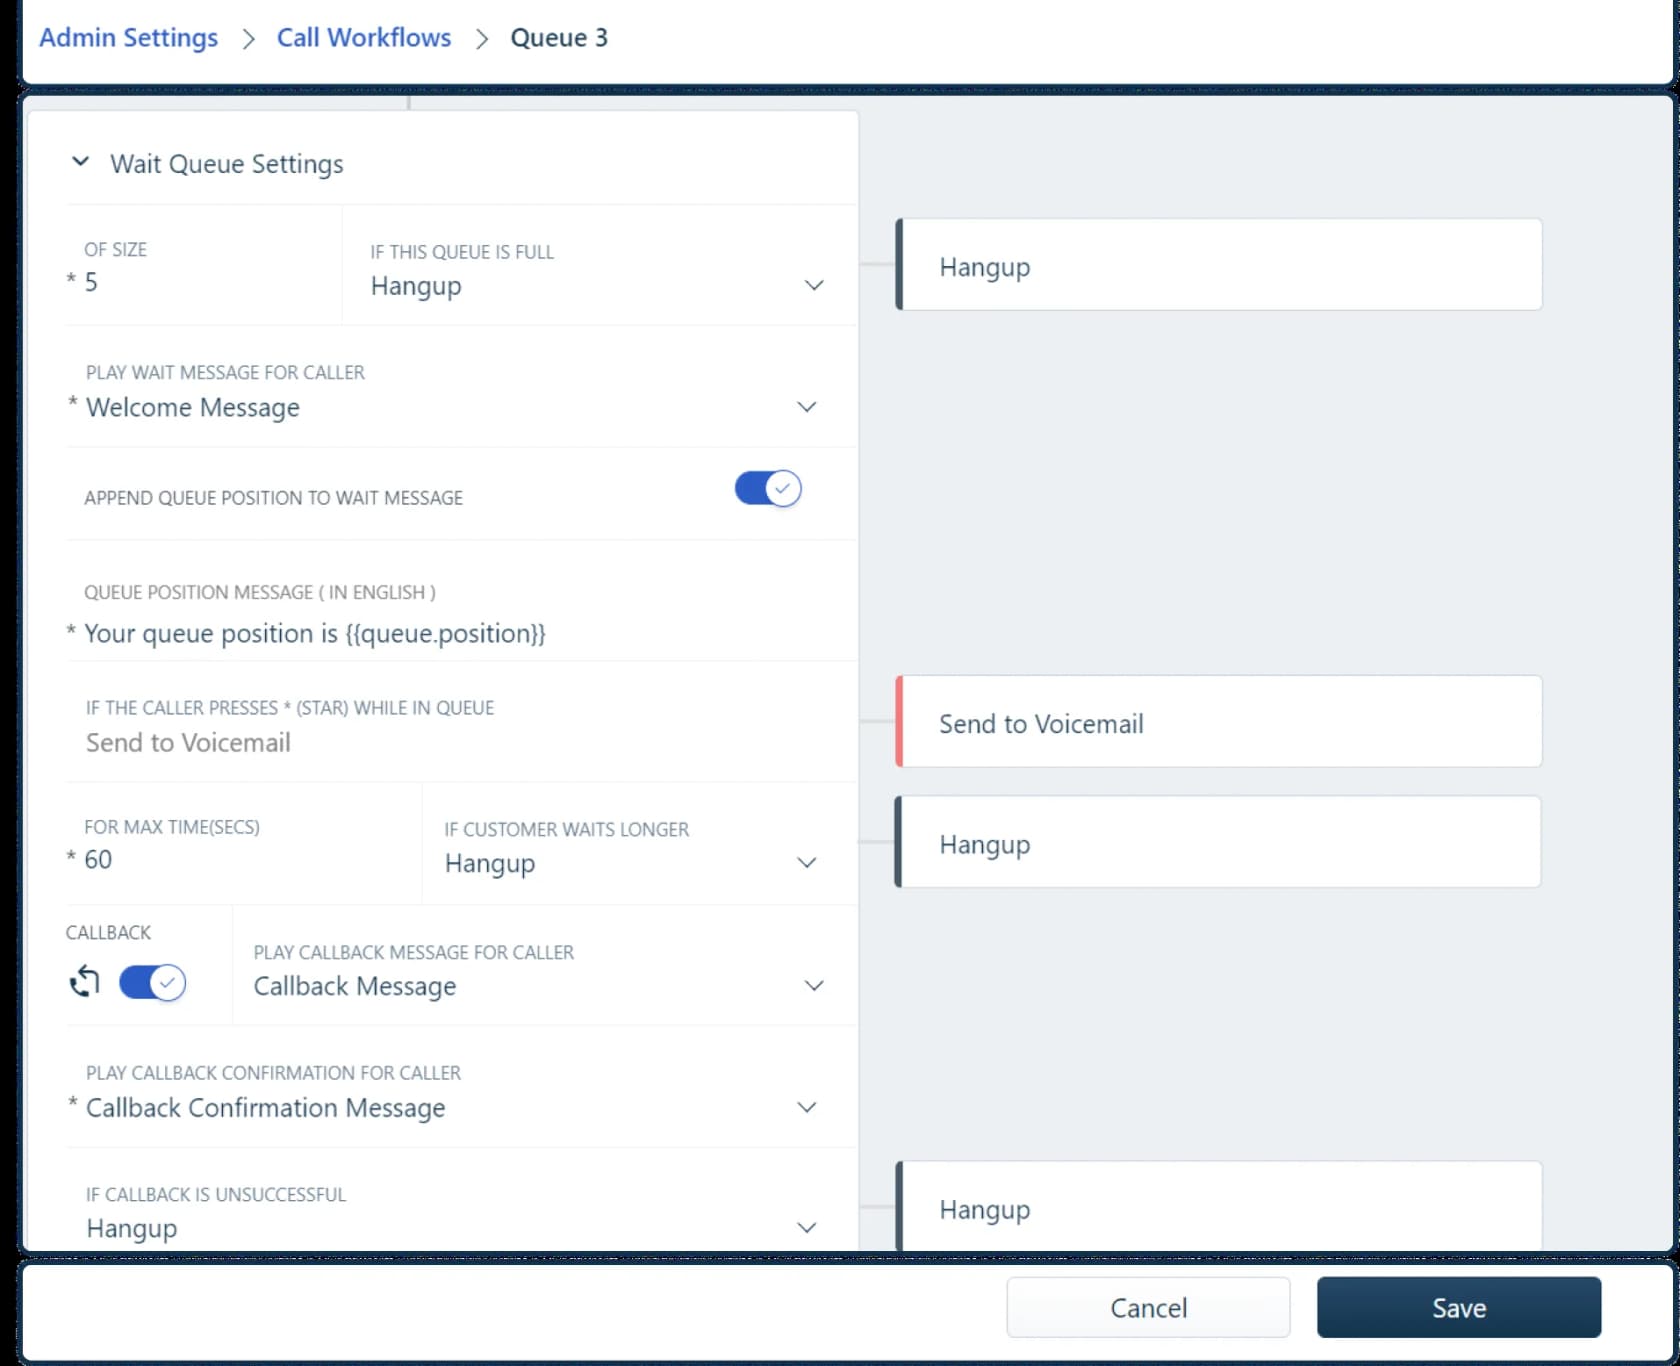
Drei Fallen, die ich heute noch prüfen würde:
- Nichts nach dem letzten Schritt. In Zendesk hört der Anrufer bei ausgeschalteter Mailbox und ohne Überlaufnummer die Ansage, und dann wird der Anruf getrennt. Wenn in Aircall nach einem Ring-to-Schritt nichts folgt, klingelt der Aircall-Anruf einmal und wird beendet. Beenden Sie den Ablauf immer in einer Mailbox oder einem Rückruf.
- Weiterleitungen ignorieren Ihre Wartegrenze. Die maximale Wartezeit von Zendesk wird nach einer Weiterleitung ignoriert, sodass ein weitergeleiteter Anrufer in der Warteschleife bleibt, bis ein Agent annimmt. Genau das passiert bei einem Ansturm, wenn Tier 1 alles an Tier 2 weiterreicht.
- Rückrufe brauchen jemanden, der online ist. Der Zendesk-Rückruf erfordert mindestens einen Agenten im Status Online oder Away, und Aircall-Rückrufe warten nicht unbegrenzt: Bei null Wiederholungen wird ein fehlgeschlagener als „Failed - No agents available“ protokolliert.
Bei aktiviertem Zendesk-Omnichannel-Routing nutzt der Anruf-Überlauf denselben Fallback von primären auf sekundäre Gruppen wie Tickets, sodass keine Überlauf-Telefonnummer nötig ist. Der Leitfaden zu Talk-Überlauf und Timeout führt durch beide Setups.
Wie groß ist Ihr Überlauf-Problem?
Überlauf summiert sich. Jedes Ticket, das Ihr Team heute nicht abarbeiten kann, rollt in den nächsten Tag, sodass eine Spitze, die nur 50 % über der Kapazität liegt, an jedem Tag, den sie dauert, einen Backlog aufbaut. Ein einfaches Beispiel: Ein Team, das normalerweise 200 Tickets pro Tag bekommt und 4 Agenten hat, die je 100 abarbeiten, wird fünf Tage lang vom Dreifachen des Volumens getroffen.
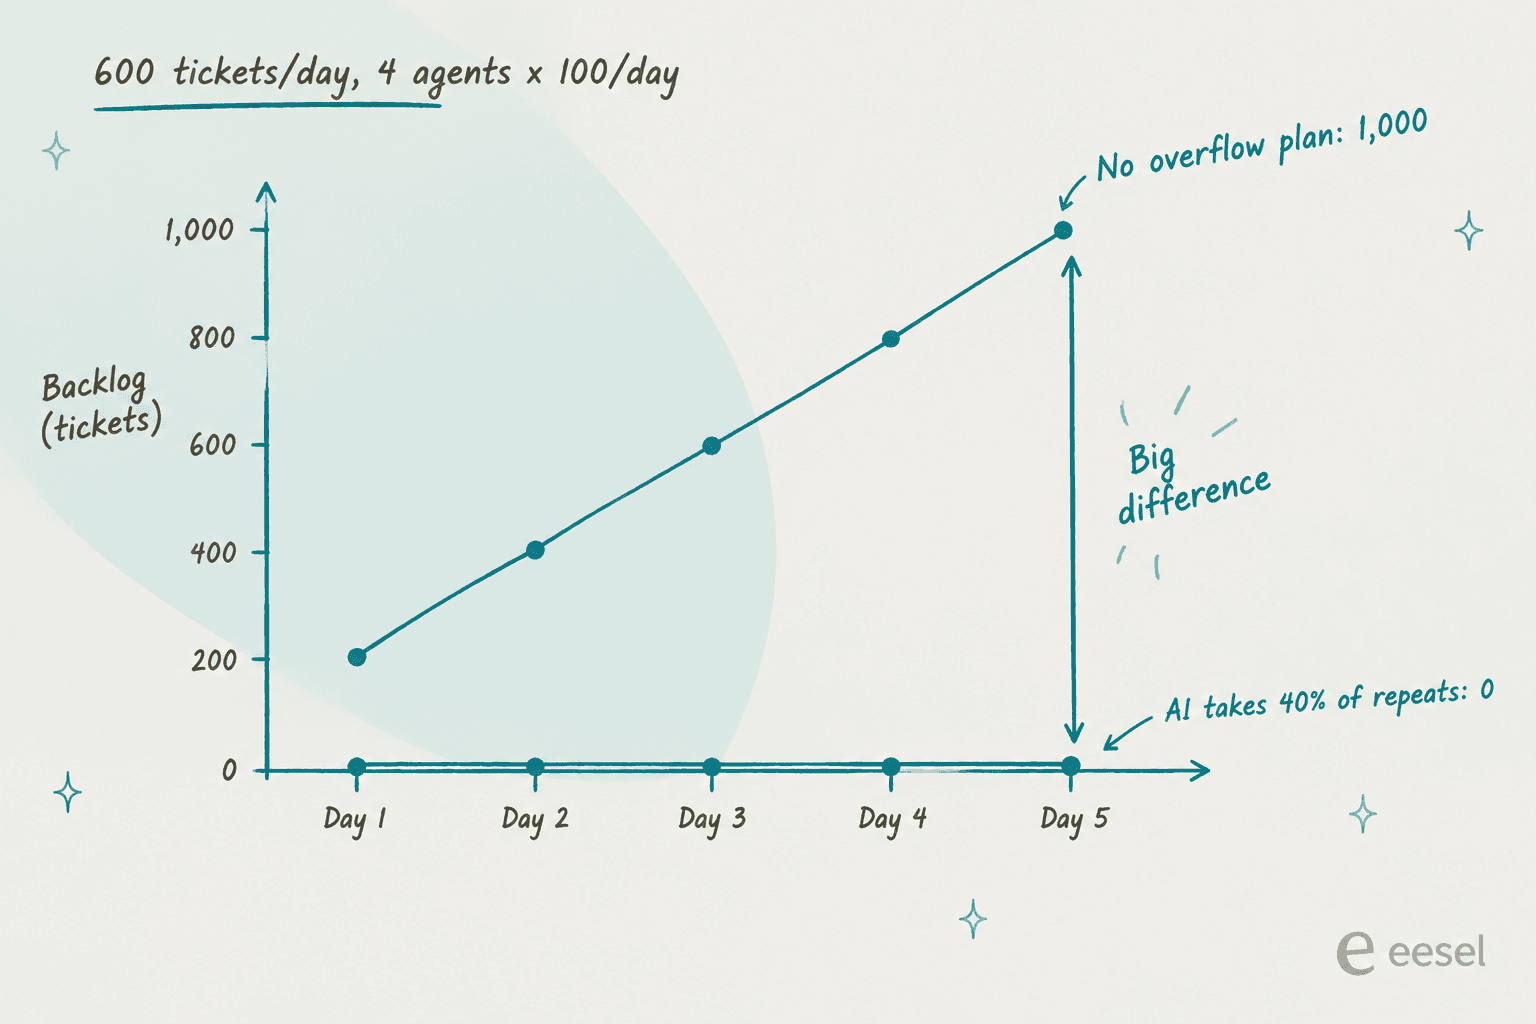
Ohne Überlauf-Stufe schafft das Team jeden Tag 400 von 600, der Backlog wächst also um 200 pro Tag und erreicht an Tag fünf 1.000 Tickets. Sobald das Volumen auf 200 zurückfällt, braucht die freie Kapazität von 200 pro Tag weitere fünf Tage, um ihn abzubauen. Kunden, die an Tag zwei geschrieben haben, warten fast eine Woche. Wenn eine Backup-Stufe 40 % der Spitze auffängt, sieht das Team nur 360 pro Tag, und die Warteschlange baut sich nie auf. Die gleiche Lücke allein mit Personal zu schließen, bedeutet 10 zusätzliche Agententage, geschult und am ersten Tag bereit.
Setzen Sie Ihre eigenen Zahlen ein:
Der Rechner lässt vieles außer Acht (Bearbeitungszeiten schwanken, manche Tickets werden wieder geöffnet, Agenten werden müde und langsamer), aber die Form stimmt. Kleine, stetige Entlastung früh schlägt heroisches Aufholen später.
Woher die zusätzliche Kapazität kommt
Sobald das Routing steht, brauchen Sie immer noch einen Ort, an dem der Überlauf landet. Es gibt vier realistische Quellen, und jede passt zu einer anderen Form von Überlauf:
| Quelle | Bereit in | Am besten für | Worauf achten |
|---|---|---|---|
| Geliehene Kollegen (Success, Sales, Ops) | Am selben Tag | Spitzen, Launch-Woche | Zieht Leute von ihrer eigenen Arbeit ab; braucht Makros und einen engen Umfang |
| Aushilfen oder Saisonkräfte | 2 bis 6 Wochen | Planbare saisonale Spitzen | Einarbeitung und Schulung; siehe den Leitfaden zum saisonalen Onboarding |
| Ausgelagerter Überlauf-Partner | 4 bis 8 Wochen Einrichtung | Lange Spitzen, 24/7-Abdeckung | Qualitätskontrolle und Kontextlücken; lesen Sie zuerst zu ausgelagertem Live-Chat |
| KI-Agent im Helpdesk | Tage | Wiederkehrende Fragen bei jeder Form von Überlauf | Muss innerhalb seines Wissens bleiben und sauber übergeben |
Die beste Version der ausgelagerten Option, die ich beschrieben gesehen habe, ist ein Partner, den Sie in einer ruhigen Woche prüfen, nicht einer, den Sie mitten im Brand hastig unter Vertrag nehmen:
„Ich habe Firmen, die ich anrufen kann, um bei großen Projekten oder Ausfällen unser Anrufvolumen abzugeben. Sie haben die Due Diligence bereits durchlaufen und stehen auf Hot Standby, falls der Bedarf entsteht.“
Für geplante Spitzen rechnen Sie früh mit einem ordentlichen Abdeckungsplan. Für den Black Friday würde ich außerdem die Kundennachrichten und die KI-Seite der Saison einen Monat vorher vorbereiten.
Wo KI beim Überlauf hilft (und wo nicht)
Ich habe viel Zeit damit verbracht, KI-Agenten in echten Warteschlangen zu beobachten, und die ehrliche Zusammenfassung lautet: KI ist die beste Überlauf-Stufe für eine Art von Ticket und eine Belastung für eine andere. Sie ist hervorragend bei den wiederkehrenden Fragen, die den Großteil einer Spitze ausmachen: Bestellstatus, Passwort-Resets, „Ist die App down?“, Rückgabefristen. Für den verärgerten Kunden, dessen dritte Bestellung verschwunden ist, ist sie das falsche Werkzeug.
Die Teams, die das richtig machen, lassen die KI ihre Gefechte auswählen. Ein CX-Lead einer DTC-Supplements-Marke auf Gorgias und Shopify mit etwa 7.000 Tickets pro Monat hat es in einem Sales-Call mit eesel besser formuliert, als ich es kann:
„Die KI wird nie 100 % der Fragen beantworten können. Aber wenn sie es versucht und einfach antwortet ‚Tut mir leid, das weiß ich nicht‘, kann ich nicht alle meine 7.000 Tickets prüfen, ob die KI tatsächlich eine gute Antwort gegeben hat. Dann ist der Sinn ein Stück weit weg. Ich brauche eine KI, die nur die Tickets bearbeitet, bei denen sie sich sicher ist, und alle anderen in Ruhe lässt.“
Das ist der richtige Auftrag für eine Überlauf-KI. Beantworten, was sie weiß, den Rest mit Kontext übergeben und nie eine selbstsichere falsche Antwort in eine Warteschlange schicken, die niemand Zeit hat zu prüfen. Ihre Hochsaison läuft von November bis Mai, genau dann, wenn ein Rückstau an „Wo ist meine Bestellung“-Tickets die Leute begraben würde, die sich um die echten Probleme kümmern müssen.
Gründer, die den Support selbst betreiben, beschreiben denselben Stau fast identischer Tickets:
„Tickets stauten sich, und es waren meist Tier-1-Beschwerden mit ähnlichen Problemen, aber ich konnte NICHT den Überblick behalten. Die Kündigungen wegen fehlender Lösung führten zu Burnout“
Die Helpdesks haben eigene KI-Schichten, und die meisten werden pro Ergebnis abgerechnet, was bedeutet, dass die Rechnung mit der Spitze wächst:
| KI-Schicht | Abrechnung | Preis |
|---|---|---|
| Zendesk AI Agents | Pro automatisierter Lösung | 1,50 $ bei Vorabzusage, 2,00 $ pay-as-you-go |
| Freddy AI Agent | Pro Sitzung | 500 inklusive, danach 49 $ pro 100 |
| Gorgias AI Agent | Pro automatisierter Interaktion | 0,85 bis 1,00 $ |
| Help Scout AI Answers | Pro Lösung | 0,75 $, mit Ausgabenlimit |
| Front Autopilot | Pro Konversation | Ab 0,05 $ |
| eesel AI-Teammate | Pro bearbeitetem Ticket oder Chat, je 1 Credit | Ab 299 $/Monat für 500 Credits, Überschreitung von Ihnen begrenzt |
Preise pro Ergebnis sind in einem normalen Monat fair. Bei einem Ansturm lohnt es sich, sie durchzurechnen. Eine Kostenanalyse, die eesel für ein E-Commerce-Postfach mit 1.000 Tickets pro Monat durchgeführt hat, zeigte bei Preisen pro Lösung etwa 792 $ in einem normalen Monat und 3.168 $ in einem Black-Friday-Monat mit 4.000 Tickets bei gleicher Lösungsquote von 80 %. Das Zendesk-Hilfecenter weist selbst darauf hin, dass Pay-as-you-go-Lösungen mehr kosten als ein zugesagtes Kontingent, und lässt Sie die monatlichen Lösungen begrenzen. Was auch immer Sie wählen: Legen Sie das Limit vor der Spitze fest, damit der Ansturm eine Obergrenze hat.
HubSpot hat eine hübsche eingebaute Version der Kaskaden-Idee: eine Live-Chat-Einstellung, die Chats dem Customer Agent zuweist, wenn keine Nutzer verfügbar oder alle ausgelastet sind. Das ist das Muster „KI als Backup-Gruppe“, innerhalb eines einzigen Tools.
eesel als Überlauf-Stufe ausprobieren
Wenn Ihr Team mit Zendesk, Freshdesk, Gorgias, Help Scout oder Front arbeitet, fügt sich das KI-Helpdesk-Teammate von eesel als der Korb zwischen Ihrer Backup-Gruppe und der asynchronen Antwort in die Kaskade ein. Es tritt der bereits vorhandenen Warteschlange bei, lernt aus Ihren früheren Tickets, dem Help Center und den Makros und beantwortet die wiederkehrenden Fragen, die eine Spitze ausmachen. Alles, bei dem es sich nicht sicher ist, geht mit einer internen Notiz an Ihr Team, und Erstattungen oder andere unumkehrbare Aktionen können auf eine menschliche Freigabe warten.

Worauf ich vor einem Ansturm setzen würde, ist die Simulation: eesel lässt den Agenten gegen Ihre echten früheren Tickets laufen und bewertet jede Antwort anhand dessen, was Ihr Team tatsächlich geschickt hat. So wissen Sie vor dem Launch-Tag, nicht währenddessen, welche Themen er übernehmen kann. Gridwise sah auf Zendesk im ersten Monat 73 % der Tier-1-Tickets gelöst. Die Abrechnung erfolgt pro bearbeitetem Ticket oder Chat, mit unbegrenzten Seats, sodass es nichts extra kostet, Ihre Backup-Gruppe zur Überwachung hinzuzufügen.
Testen Sie eesel kostenlos an Ihrer eigenen Warteschlange: Starten Sie mit 100 kostenlosen Credits, verbinden Sie Ihr Freshdesk- oder Gorgias-Konto und führen Sie vor Ihrer nächsten Spitze eine Simulation durch.