

Was ist verteilter Support-Betrieb?
Verteilter Support-Betrieb bedeutet, ein Kundensupport-Team zu führen, dessen Leute an mehr als einem Ort sitzen. Das umfasst viele Konstellationen: zwei Büros im selben Land, drei Standorte, die die Queue rund um die Uhr weiterreichen, Remote-Agenten auf einem ganzen Kontinent oder ein internes Team mit einem Offshore-Partner, der Nächte und Wochenenden abdeckt.
Ich sehe mir viele Suchdaten zu diesem Bereich an, und die Fragen zu diesem Thema lauten selten „Wie stelle ich in einem anderen Land ein“. Sie sind operativ: Wie leite ich Tickets zwischen Standorten weiter, warum geben meine Standorte unterschiedliche Antworten, warum stimmen meine Reports nicht überein. Genau darum geht es in diesem Leitfaden.
Die meisten verteilten Teams fallen in eine von vier Formen. Jede hat ihre eigene Schwachstelle, und zu den meisten gibt es schon einen ausführlicheren Leitfaden:
| Aufbau | Wie es aussieht | Wo es meist hakt | Als Nächstes lesen |
|---|---|---|---|
| Mehrere Standorte, gleiche Zeiten | Zwei oder mehr Büros decken denselben Arbeitstag ab | Doppelarbeit, unterschiedliche Gewohnheiten pro Büro | Dieser Leitfaden |
| Follow-the-Sun | Zwei oder drei Standorte reichen die Queue über Zeitzonen weiter | Die Übergabe zwischen den Standorten | Follow-the-Sun-Support |
| Intern plus ausgelagert | Ihr Team plus ein BPO oder Offshore-Partner | Lücken bei Wissen und Qualität | Offshore-Wissenstransfer |
| Komplett remote | Agenten an vielen Orten, oft asynchron arbeitend | Zuständigkeit und Antwortversprechen | Asynchroner Support |
Echte Teams mischen diese Formen. Ein häufiger Fall, den ich sehe: ein Remote-Kernteam, ein Partner für die Nächte und eine Handvoll regionaler Spezialisten für Sprachen. Die folgenden Betriebsregeln gelten für alle.
Warum verteilte Support-Teams auseinanderdriften
Jeder Standort startet mit demselben Playbook. Sechs Monate später ist es nicht mehr dasselbe. Das hat niemand beschlossen; es geschah mit einem kleinen Workaround nach dem anderen. Ein Standort findet ein schnelleres Makro und teilt es nicht. Ein anderer erfährt von einer Richtlinienänderung in einem Call, an dem der andere Standort nicht teilnahm. Ein dritter beginnt anders zu taggen, weil sein Manager einen neuen Report wollte.
Ein Entwickler in einem kleinen Multi-Region-Team hat die Ursache treffend benannt:
"The communication costs from time zones are real, and it makes everyone's context on what is going on different because they see updates from different regions."

Der Kunde spürt die Abweichung vor Ihnen. Er stellt dieselbe Frage zweimal und bekommt zwei Antworten, je nachdem, welcher Standort sie übernommen hat. Und wenn Standorte unterschiedlich gemessen werden, verhalten sie sich unterschiedlich. Ein HN-Kommentator, der erklärte, warum ausgelagerte Tier-1-Teams selten eskalieren, führte es auf ihre Bewertung zurück:
"The problem, of course, is that Tier 1 support are outsourced and a huge part of their evaluations are how many tickets they close. Escalating hurts their numbers, so it's hard to get cases escalated"
Das ist kein Personalproblem. Es ist ein System, das einen Standort fürs Schließen und einen anderen fürs Lösen belohnt und sich dann über unterschiedliche Ergebnisse wundert. Der größte Teil des Folgenden dreht sich darum, die Stellen zu beseitigen, an denen Standorte abweichen dürfen, obwohl sie es nicht sollten.
Entscheiden, was überall gleich und was lokal ist
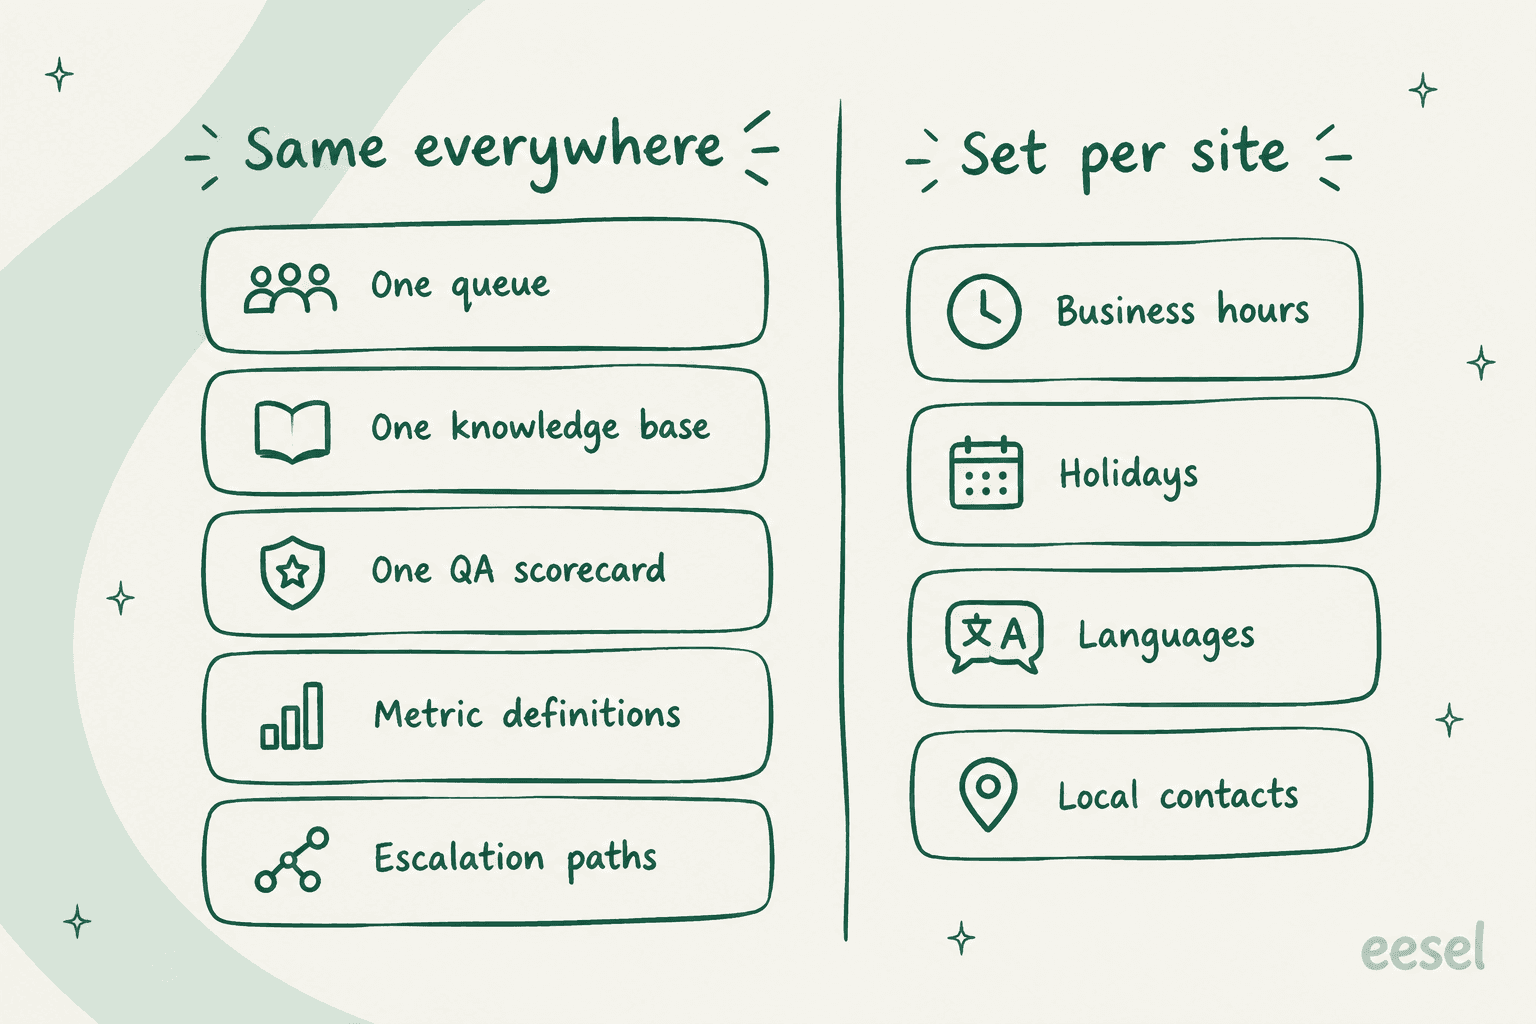
Die nützlichste Stunde, die Sie in ein verteiltes Team investieren können, ist das Aufschreiben zweier Listen. Die erste: was an jedem Standort identisch sein muss. Die zweite: was jeder Standort selbst festlegen darf. Alles andere ist eine Debatte, die Sie immer wieder führen, bis Sie sie entscheiden.
Mit dieser Aufteilung würde ich beginnen:
Überall gleich:
- Eine Queue. Alle Standorte arbeiten in derselben Helpdesk-Instanz, mit sichtbarer vollständiger Kundenhistorie.
- Eine Wissensdatenbank. Interne und externe Artikel liegen an einem Ort mit benannten Verantwortlichen, nicht in Dokumenten pro Standort. Mein Leitfaden zur internen Wissensdatenbank behandelt die Struktur.
- Eine QA-Scorecard. Dieselben Kriterien, an jedem Standort gleich bewertet.
- Kennzahlendefinitionen. Was „erste Antwort“ bedeutet, welche Stunden zählen, in welcher Zeitzone Reports laufen.
- Eskalationswege. Wer für Abrechnungsstreitigkeiten oder Bugs zuständig ist, unabhängig davon, welcher Standort sie gefunden hat. Siehe teamübergreifende Eskalation.
Pro Standort festgelegt:
- Geschäftszeiten und Feiertage. Jeder Standort hat seinen eigenen Kalender, und SLAs sollten ihn respektieren.
- Sprachen. Leiten Sie Sprach-Queues an die Standorte, die diese Sprachen sprechen.
- Lokale Ansprechpartner. Die Bereitschaftsleitung, der lokale Finanzkontakt, die Person, die in diesem Markt eine Rückerstattung genehmigen kann.
Der Datenstandort ist der Punkt, der das Muster manchmal bricht. Wenn Sie in regulierte Märkte verkaufen, prüfen Sie, wo der Helpdesk Daten speichert. Das Data-Center-Location-Add-on von Zendesk ist "free of charge for Zendesk Suite Professional or higher plans, but it is not automatically activated" und deckt die USA, den EWR, das Vereinigte Königreich, Japan und Australien ab. Freshdesk lässt Sie bei der Anmeldung den Datenstandort wählen. Mein Leitfaden zur Freshdesk-Datenresidenz geht tiefer. Beachten Sie, dass Zendesk Ihre Servicedaten an einem einzigen Standort hostet, eine Instanz also nicht in zwei Regionen gleichzeitig liegen kann.
Eine Queue statt eines Posteingangs pro Standort
Der häufigste frühe Fehler ist, jedem Standort einen eigenen Posteingang oder eine eigene E-Mail-Adresse zu geben. Das fühlt sich ordentlich an. Jedes Büro sieht seine eigene Arbeit, und niemand tritt jemandem auf die Füße. In der Praxis verbirgt es die Arbeitslast vor dem Rest des Teams und erzeugt Tickets, die niemandem gehören. Ein Kleinunternehmer beschrieb genau das auf Reddit:
"We are looking for a way to manage out digital customer interactions in three offices, for one business. Each office has its own email address with multiple employees using the same email address. We are constantly failing to respond to 100% of customer messages because one employee will open the email of another's and then it will never been seen by its intended target."

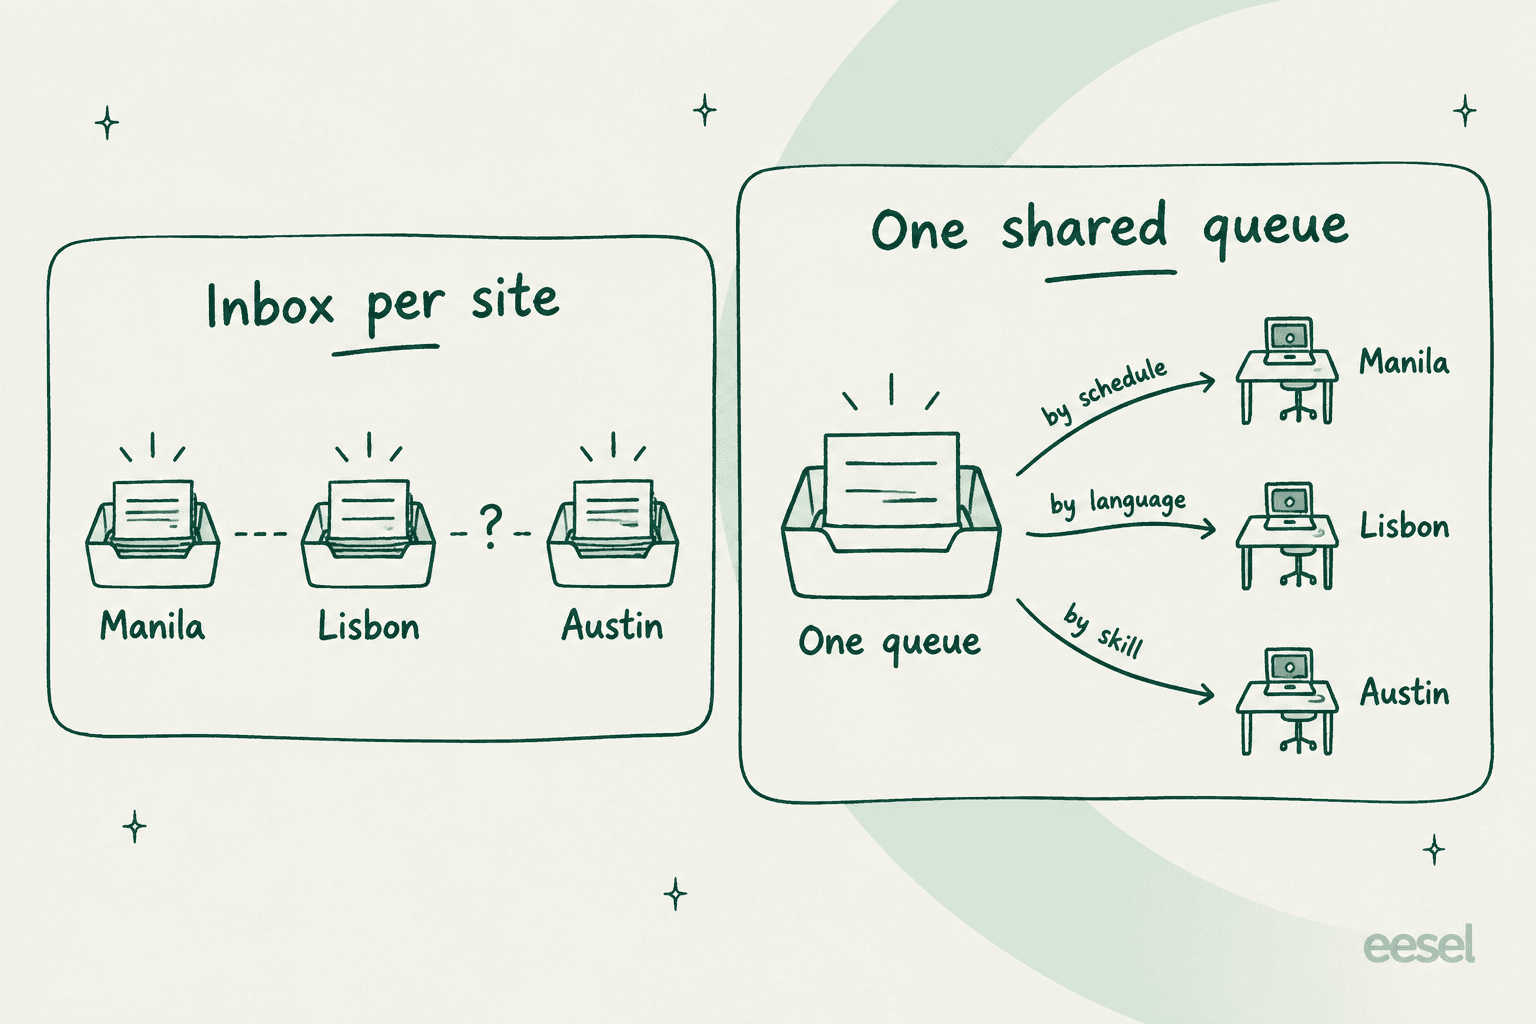
Das bessere Muster ist eine Queue, aufgeteilt per Routing. Jedes Ticket landet am selben Ort, dann schicken Regeln es anhand von drei Dingen zum richtigen Standort:
- Zeitplan. Wer gerade tatsächlich arbeitet. Kombinieren Sie das mit den Geschäftszeiten jedes Standorts, damit SLAs die Stunden nicht mitzählen, in denen ein Standort geschlossen ist.
- Sprache. Spanisch ans Madrider Team, Deutsch in die Berliner Zeiten und so weiter.
- Skill. Abrechnung, Technik, VIP oder eine bestimmte Produktlinie, unabhängig vom Standort.
Jeder Standort bekommt weiterhin eine eigene Ansicht seiner Arbeit (eine Ansicht oder ein Ordner, gefiltert auf seine Gruppe), sodass das „ordentliche“ Gefühl bleibt. Neu ist, dass ein Manager die gesamte Queue auf einmal sieht und ein Ticket, das ein Standort nicht bearbeiten kann, zu einem anderen wechseln kann, ohne die Kundenhistorie zurückzulassen. Der Leitfaden zur Ticket-Triage zeigt, wie Sie Tickets taggen, damit Routing-Regeln etwas zum Greifen haben.
Wie jeder Helpdesk Zeitpläne und Routing für mehrere Standorte handhabt
Hier kommt es auf die Tarife an. Die Funktionen, die ein verteiltes Team braucht (mehrere Geschäftszeiten-Kalender, Skill- oder Sprach-Routing), liegen oft ein bis zwei Stufen über dem Einstieg kleiner Teams. Das dokumentiert jeder Helpdesk, Stand Oktober 2026:
| Zendesk | Freshdesk | Help Scout | Gorgias | Front | |
|---|---|---|---|---|---|
| Mehrere Geschäftszeiten | Nur Enterprise | Pro ($55) und höher | Plus ($45) und höher | Basic ($60/Monat) und höher | Professional ($65) und höher |
| Wie ein Ticket seinen Zeitplan bekommt | Ein Trigger pro Zeitplan (Gruppe, Marke oder Status) | Einer Gruppe zugeordnet | Per Posteingang | Per Integration (Shop oder Kanal) | Per Posteingang |
| Skill- oder Sprach-Routing | Skills ab Suite Professional ($115) | Skills im Enterprise-Tarif ($89) | Keine Skills-Funktion; Teams und Workflows ab Plus | Spracherkennung in Regeln, alle Tarife | Regeln und Lastverteilung; keine Skills-Funktion |
| Reporting-Zeitzone | Profil-Zeitzone des jeweiligen Betrachters | Eine Helpdesk-Zeitzone | Eine Unternehmens-Zeitzone | Nicht bestätigt | Nicht bestätigt |
| Integriertes QA-Scoring | QA-Add-on oder WEM-Paket ($50) | Keines für menschliche Agenten | Keines | Auto QA, mit einem AI-Agent-Abonnement | Smart QA, $20/Seat oder in Enterprise |
Die Preise gelten pro Agent und Monat bei jährlicher Abrechnung, außer bei Gorgias, das nach Ticketvolumen abrechnet. Die Details zu jeder Spalte finden Sie unten.
Zendesk
Zendesks Einschränkung überrascht viele. Die Dokumentation zu Zeitplänen ist deutlich: "On Suite Growth and Professional or Support Professional, you can set only one schedule. On Enterprise plans you can set multiple schedules." Ein Team mit drei Standorten auf Suite Professional bekommt also einen Satz Geschäftszeiten für alle.
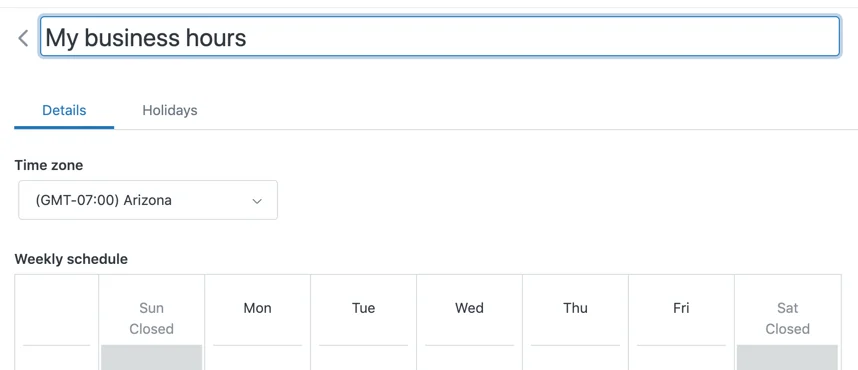
Im Enterprise-Tarif ist der erste Zeitplan der Standard, und "you need to create a trigger for each schedule", meist nach Ticketgruppe, Marke oder Status. Weiter unten im Preisgefüge ist das Routing stärker: Skill-basiertes Routing lässt Sie "define up to 10 skill types. Each skill type can contain up to 30 skills", ab Suite Professional ($115). Sprache eignet sich gut als Skill-Typ. Mein Leitfaden zu Zendesk-Routing führt durch die Omnichannel-Einrichtung, und Zendesks eigener Follow-the-Sun-Artikel empfiehlt Gruppen pro Region.
Freshdesk
Freshdesk bietet mehrere Geschäftszeiten früher, ab Pro ($55). Der Haken ist, wie sie angewendet werden. Laut Freshdesk-Dokumentation können Geschäftszeiten "cannot be applied to tickets unless they are first mapped to a group. Each group can be assigned its own business hours (for example, EU, North America, or Asia)."
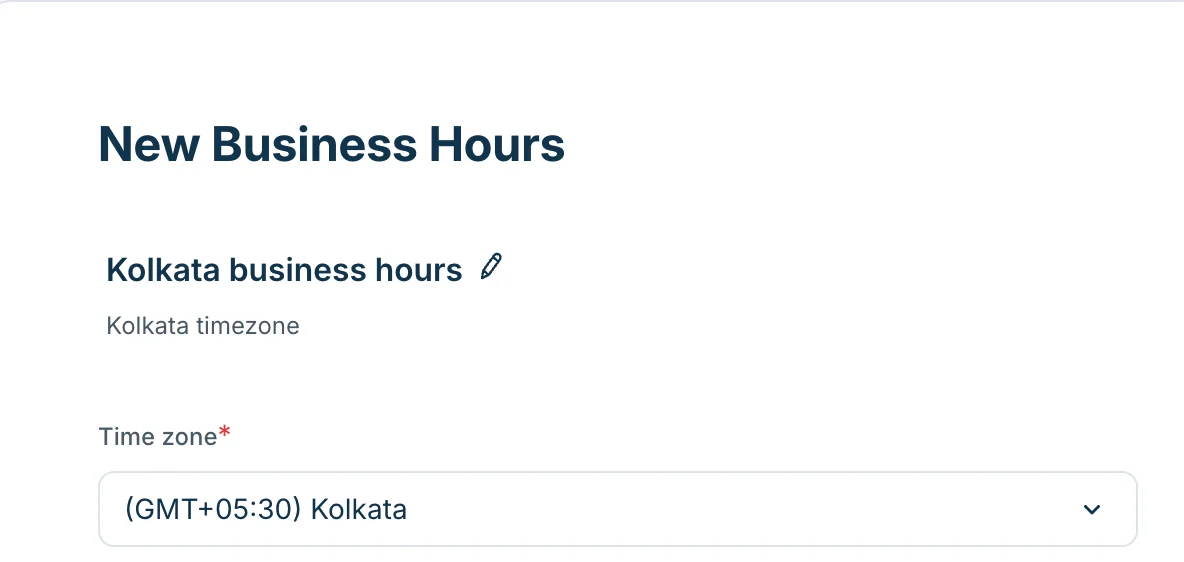
In Freshdesk ist also die Gruppe Ihr Standort. Planen Sie Gruppen nach Orten (oder Ort plus Stufe), dann folgen die SLA-Richtlinien. Skill-basiertes Routing gibt es nur im Enterprise-Tarif ($89), mit bis zu 180 Skills, und die Dokumentation nutzt Sprache als Beispiel: "every ticket from a French-speaking customer" geht an einen Skill "French".
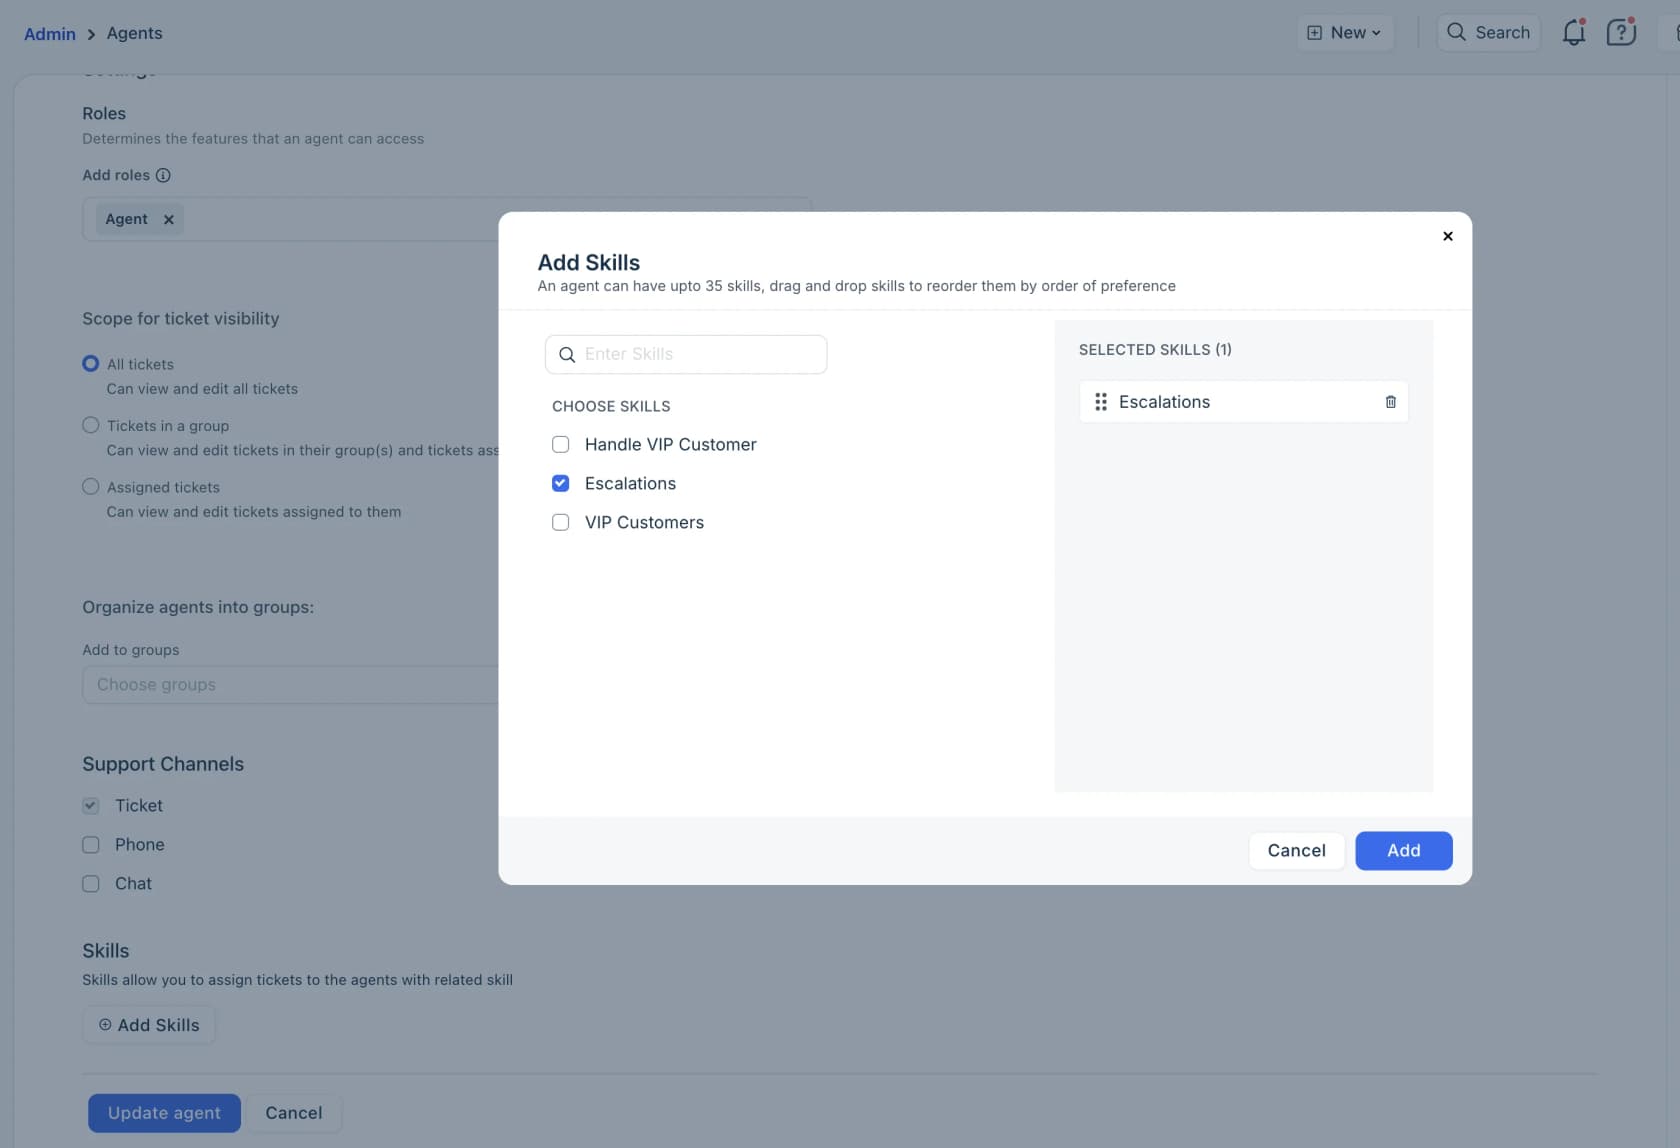
Eine Falle: Tickets, die zu keinem Skill passen, "remain unassigned until it is manually assigned", daher empfiehlt Freshdesk einen Fallback-Skill pro Gruppe. In einem verteilten Team ist dieser Fallback Ihr Sicherheitsnetz für die Stunden zwischen den Standorten. Mein Leitfaden zu Freshdesk Skill-basiertem Routing enthält die komplette Einrichtung, und Freshdesk-Agentenschichten behandelt Zeitzonen pro Schicht im Enterprise-Tarif.
Help Scout, Gorgias und Front
Diese drei verknüpfen Zeitpläne mit Posteingängen oder Kanälen statt mit Gruppen.
- Help Scout: Individuelle Inbox Hours "are available on Plus and Pro plans". Das Muster ist also ein Posteingang pro Standort oder Region. In der Dokumentation gibt es keine Skills-Funktion. Das Routing ist Round Robin im Plus-Tarif, zusätzlich Balanced im Pro-Tarif, und Teams (Plus und höher) bekommen eigene Ordner und einen Abschnitt im Company-Report.
- Gorgias: individuelle Geschäftszeiten pro Integration ab Basic, sodass jeder Shop oder Kanal seine eigene Zeitzone haben kann. Die Regeln können die erkannte Sprache ("up to 54 languages") nutzen, um "assign Spanish tickets to a team", in allen Tarifen. Siehe meinen Leitfaden zu Gorgias Auto Assign.
- Front: Geschäftszeiten funktionieren auf Workspace- und Posteingangsebene, was Front als "useful for global organizations with distinct business hours per office or time zone" beschreibt, ab Professional (
$65). Liegt eine Konversation in mehreren Posteingängen, gelten die Zeiten des alphabetisch ersten Posteingangs, was man wissen sollte, bevor man seine Posteingänge benennt.
Die Falle der Reporting-Zeitzone
Dieses Problem würde ich vor dem ersten standortübergreifenden Review-Meeting beheben. Ihre Standorte werden Zahlen vergleichen, und womöglich sehen sie nicht dieselben Zahlen.
Zendesks Dokument zur Analytics-Zeitzone sagt "Analytics uses the Timezone in the user profile", und das gilt für Dashboards, Exporte und den Report-Builder. Ein Manager in Manila und einer in Austin können dasselbe Dashboard öffnen und unterschiedliche Spitzenzeiten, unterschiedliche Tagesvolumen und unterschiedliche „Heute“-Summen sehen. Keiner liegt falsch. Sie schneiden den Tag nur an verschiedenen Stellen.
Andere Tools gehen den umgekehrten Weg. Freshdesks Ticket-Timer basieren auf "the Helpdesk time zone". Help Scouts Unternehmens-Zeitzone "is shown on reports", während die XLSX-Exporte in UTC sind und CSV-Exporte die Unternehmenszone nutzen. Ein Help-Scout-Team, das einen XLSX-Export neben einen Dashboard-Screenshot legt, kann also unbemerkt zwei verschiedene Tage vergleichen.
Drei Regeln, die ich schriftlich festhalten würde:
- Wählen Sie eine Reporting-Zeitzone (UTC ist die unpolitischste) und nutzen Sie sie für jede standortübergreifende Zahl. Bitten Sie Manager in Zendesk, ihr Profil beim Erstellen gemeinsamer Reports darauf zu setzen, oder nutzen Sie Dashboard-Zustellungen, die laut Zendesk "the recipient's time zone" verwenden.
- Messen Sie SLAs in Geschäftszeiten, mit dem eigenen Kalender jedes Standorts, damit ein Standort nicht für Stunden bestraft wird, in denen er geschlossen war. Mein Leitfaden zu Zendesk-Explore-Kennzahlen für Geschäftszeiten zeigt, wie.
- Vergleichen Sie Standorte zuerst mit sich selbst. Eine Nachtschicht sieht anderes Volumen und andere Tickettypen. Eine Reddit-Antwort zu öffentlichen Support-Kennzahlen brachte es einfach auf den Punkt:
"Someone who's working part-time or working the graveyard shift will likely have fewer messages sent than someone full time, CSAT can be skewed by one (or more) unfair review, etc."
Nutzen Sie die Kundenservice-KPIs, die Sie ohnehin erfassen, aber schneiden Sie sie nach Gruppe und Schicht, bevor Sie Personen vergleichen.
Qualität über Standorte hinweg konsistent halten
Wenn die Wissensdatenbank die Quelle der Antworten ist, zeigt QA, ob jeder Standort sie tatsächlich gibt. Die Falle in verteilten Teams: Jeder Standort betreibt eigene QA, mit eigenen Reviewern und eigener Vorstellung von „4 von 5“. Dann wirken die Werte vergleichbar, sind es aber nicht.
Die Lösung sind zwei Gewohnheiten: eine gemeinsame Scorecard und regelmäßige standortübergreifende Kalibrierung. Zendesk beschreibt Kalibrierung als "having all your reviewers rate the same batch of conversations and compare their scores". Machen Sie das wöchentlich mit mindestens einem Reviewer pro Standort, und die Abweichungen in den Werten zeigen, wo die Standorte auseinandergedriftet sind.
Integrierte QA-Tools unterscheiden sich stark:
- Zendesk QA braucht das QA-Add-on (kein öffentlicher Preis) oder das Workforce-Engagement-Paket für
$50. Mein Zendesk-QA-Leitfaden und der Beitrag zu Scorecard-Kriterien behandeln es. - Front Smart QA kostet
$20pro Seat als Add-on oder ist in Enterprise enthalten. Es bewertet Konversationen per KI anhand von Kriterien, die Sie auswählen. - Gorgias Auto QA ist "available on all Helpdesk plans with an AI Agent subscription". Es bewertet Tickets 12 Stunden nach dem Schließen nach Vollständigkeit der Lösung, Kommunikation und Sprachkompetenz.
- Freshdesk und Help Scout haben laut Dokumentation keine QA-Scorecard für menschliche Agenten, also bräuchten Sie eine Tabelle oder ein separates QA-Tool.
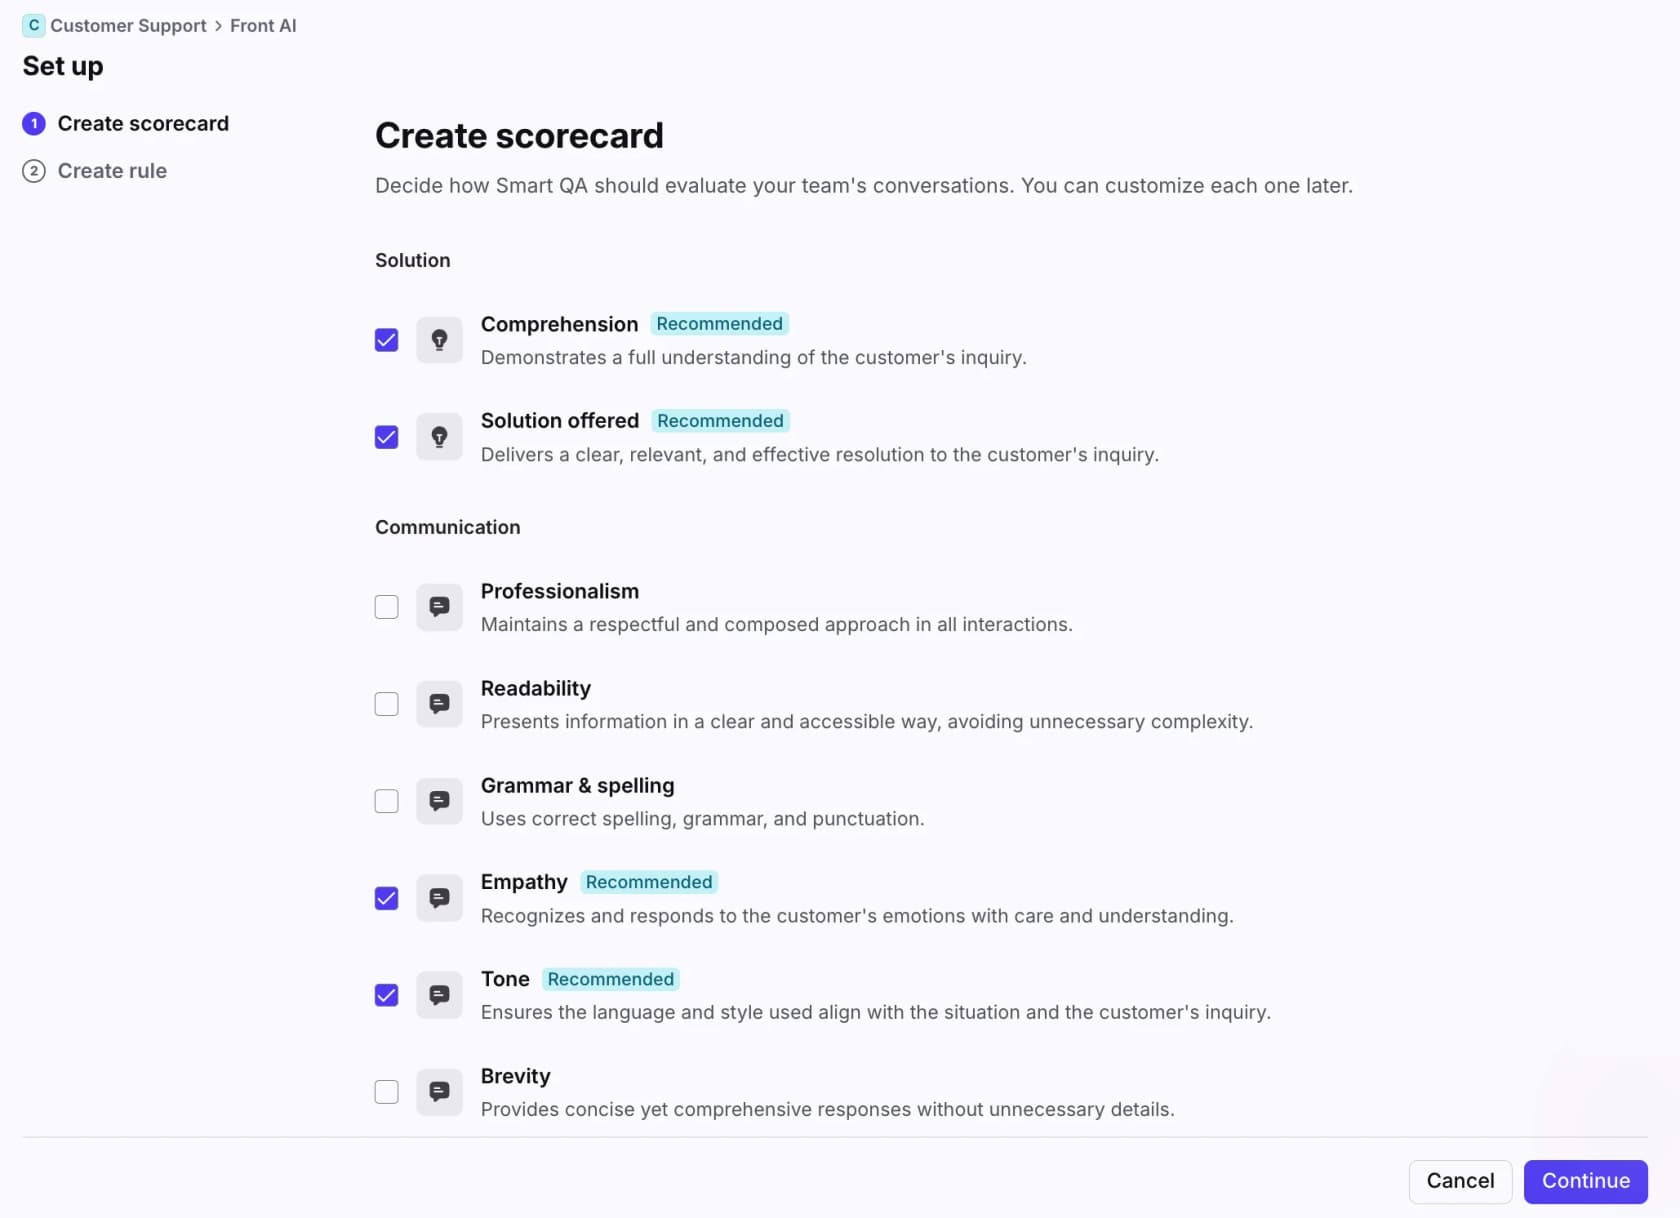
Eine Warnung von der Agentenseite. QA funktioniert nur, wenn Agenten darauf vertrauen, dass Scorecard und Wissensdatenbank übereinstimmen. Ein Support-Agent in einem internen Team, das „wie ein BPO“ geführt wird, beschrieb in einem Beitrag über QA-Streitigkeiten, was passiert, wenn sie es nicht tun:
"...even if it's clearly a system fault or not even in the knowledge base, agents still get blamed. Even when we point out that it's not in the knowledge base, they still make excuses."
Wenn ein QA-Review eine falsche Antwort markiert, fragen Sie also zuerst, ob die richtige Antwort überhaupt irgendwo festgehalten war. Wenn nicht, ist es eine Wissenslücke, kein Agentenproblem. Erfassen Sie diese getrennt. Der Leitfaden zu Zendesk-QA-Agentenfeedback zeigt, wie Sie den Kreis mit den Agenten schließen.
Eine Wissensdatenbank, die allen gehört
Der Großteil der Abweichungen in einem verteilten Team lässt sich auf Wissen zurückführen, das in den Köpfen, Chats oder privaten Dokumenten eines Standorts liegt. Der Standort, der im Richtlinien-Meeting saß, weiß Bescheid; die anderen erfahren es von einem verärgerten Kunden.
Die Regel ist leicht gesagt und schwer eingehalten: Wenn eine Antwort nicht in der gemeinsamen Wissensdatenbank steht, existiert sie nicht. Jeder Artikel hat einen benannten Verantwortlichen. Jeder Standort kann Änderungen vorschlagen. Eine Richtlinienänderung ist erst „erledigt“, wenn der Artikel aktualisiert ist. Mein Leitfaden zu KI-Wissensmanagement behandelt Zuständigkeit und Review-Zyklen, und der Beitrag zum Management der Wissensdatenbank die Audits.
Achten Sie auch auf das Gegenteil: eine Person, die das Ganze still am Leben hält. Eine Reddit-Antwort an einen Call-Center-Trainer, dessen persönliche Anleitungen sich als tragende Säule eines ausgelagerten Kontos erwiesen, fasste es zusammen:
"Love how everyone took your knowledge base and its regular updates for granted and no one at any level questioned who was maintaining that or where."
Wenn Sie einen neuen Partner oder Standort einarbeiten, gibt Ihnen der Plan zum Offshore-Wissenstransfer eine 30-Tage-Struktur. Für Sprachmärkte hält ein mehrsprachiges Help Center eine Quelle mit Übersetzungen statt einer Kopie pro Standort.
Der Betriebsrhythmus, der Standorte aufeinander abgestimmt hält
Gemeinsame Tools verhindern, dass Abweichungen entstehen. Ein regelmäßiger Rhythmus fängt die Abweichungen ab, die trotzdem durchrutschen. Mit diesem Takt würde ich beginnen:
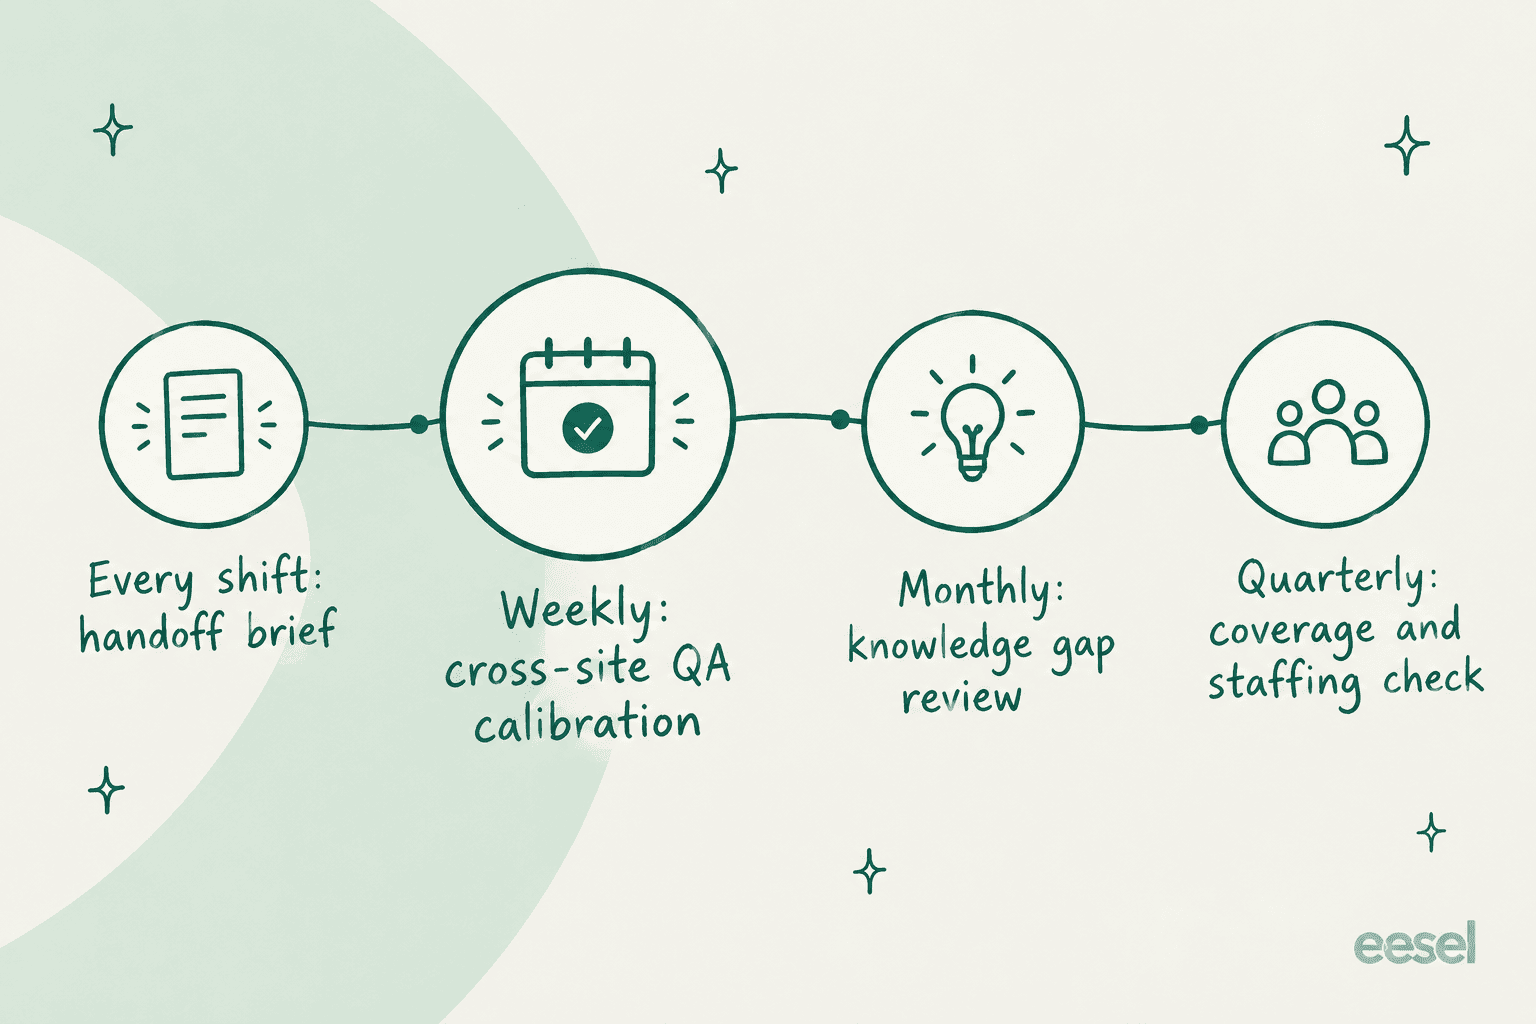
- Jede Schicht: ein Übergabe-Briefing. Eine Nachricht an den nächsten Standort zu offenen Eskalationen, fälligen Zusagen und allem Ungewöhnlichen in der Queue. Der Leitfaden zur Support-Schichtübergabe enthält eine Vorlage und eine 45-Minuten-Routine.
- Wöchentlich: standortübergreifende QA-Kalibrierung. Reviewer aller Standorte bewerten dieselben fünf bis zehn Tickets und besprechen die Unterschiede.
- Monatlich: Review der Wissenslücken. Gehen Sie die Tickets durch, die mit „no article“ oder „wrong article“ getaggt sind, und beheben Sie die Wissensdatenbank. Zählen Sie, wie viele von welchem Standort kamen.
- Vierteljährlich: Prüfung von Abdeckung und Besetzung. Sehen Sie sich das Volumen pro Stunde in Ihrer einen Reporting-Zeitzone an und gleichen Sie es damit ab, wann jeder Standort arbeitet. Hier entscheiden Sie, ob Sie einen Standort hinzufügen, die Überlappung verlängern oder KI eine ruhige Phase abdecken lassen.
Überlappungszeit sollten Sie in diesem Plan schützen. Ein Mitarbeiter eines Netzwerkbetriebsteams auf Reddit beschrieb, warum seine einstündige Überlappung funktioniert:
"It works well, there is approximately an hour overlap on each shift so if there is a fire or ongoing WebEx the new shift can be briefed on what's been done to troubleshoot the issue already and have a decent understanding."
Überlappung ist allerdings nicht billig. Ein Entwickler in einem Team mit zwei Zeitzonen merkte an, dass ihr geteilter Aufbau "works well, but it is expensive". Dieser Preis ist der Grund, warum die vierteljährliche Prüfung wichtig ist: Dort sehen Sie, welche Stunden tatsächlich einen Menschen brauchen.
Wo KI im verteilten Support-Betrieb passt
KI verdient sich ihren Platz in einem verteilten Team auf zwei Arten: Sie schließt die Stunden zwischen den Standorten, und sie beseitigt eine der größten Quellen für Abweichungen, nämlich dass verschiedene Leute dieselbe Frage unterschiedlich beantworten.
Bei eesel habe ich den KI-Helpdesk-Teamkollegen von eesel in Queues beobachtet, in denen das zählt. Anytime Fitness betreut Mitglieder in über 5.000 Studios in über 40 Ländern; vor eesel wartete ein Mitglied, das abends um 22 Uhr eine Frage stellte, bis zum Morgen. Gcore betreibt weltweiten 24/7-Support mit zwei Bots, einem für Kunden und einem für die eigenen Agenten. Und ein B2B-Hardwarehersteller auf Zendesk bearbeitet Tickets in vier Sprachen mit demselben Agenten.
So passt ein KI-Teamkollege in den oben beschriebenen Aufbau:
- Dieselbe Antwort an jedem Standort. Er lernt aus Ihren bisherigen Tickets, dem Help Center, Makros und Dokumenten und gibt eine Antwort, unabhängig davon, zu welcher Zeit der Kunde schreibt. Das Konsistenzproblem ist damit an der Quelle gelöst.
- Die Lücke zwischen Standorten abdecken. Er beantwortet Routine-Tickets zu jeder Uhrzeit und lässt den Rest, getaggt, für die Schicht des nächsten Standorts liegen.
- Sprachabdeckung. Er antwortet in der Sprache des Kunden, was eine Sprach-Queue ersetzen kann, die Sie nicht rund um die Uhr besetzen können.
- Übergabezusammenfassungen. Die geplanten Jobs von eesel können einen Prompt ausführen, etwa eine tägliche Zusammenfassung der Tickets der letzten 24 Stunden, zu einer festen Uhrzeit in einer festen Zeitzone, für das Briefing des nächsten Standorts.
- Interne Antworten für Agenten. Ein zweiter Bot, der Fragen Ihrer Agenten aus derselben Wissensdatenbank beantwortet, wie bei Gcore, hilft neueren Standorten beim Einstieg, ohne dass sie darauf warten müssen, dass eine andere Region aufwacht.
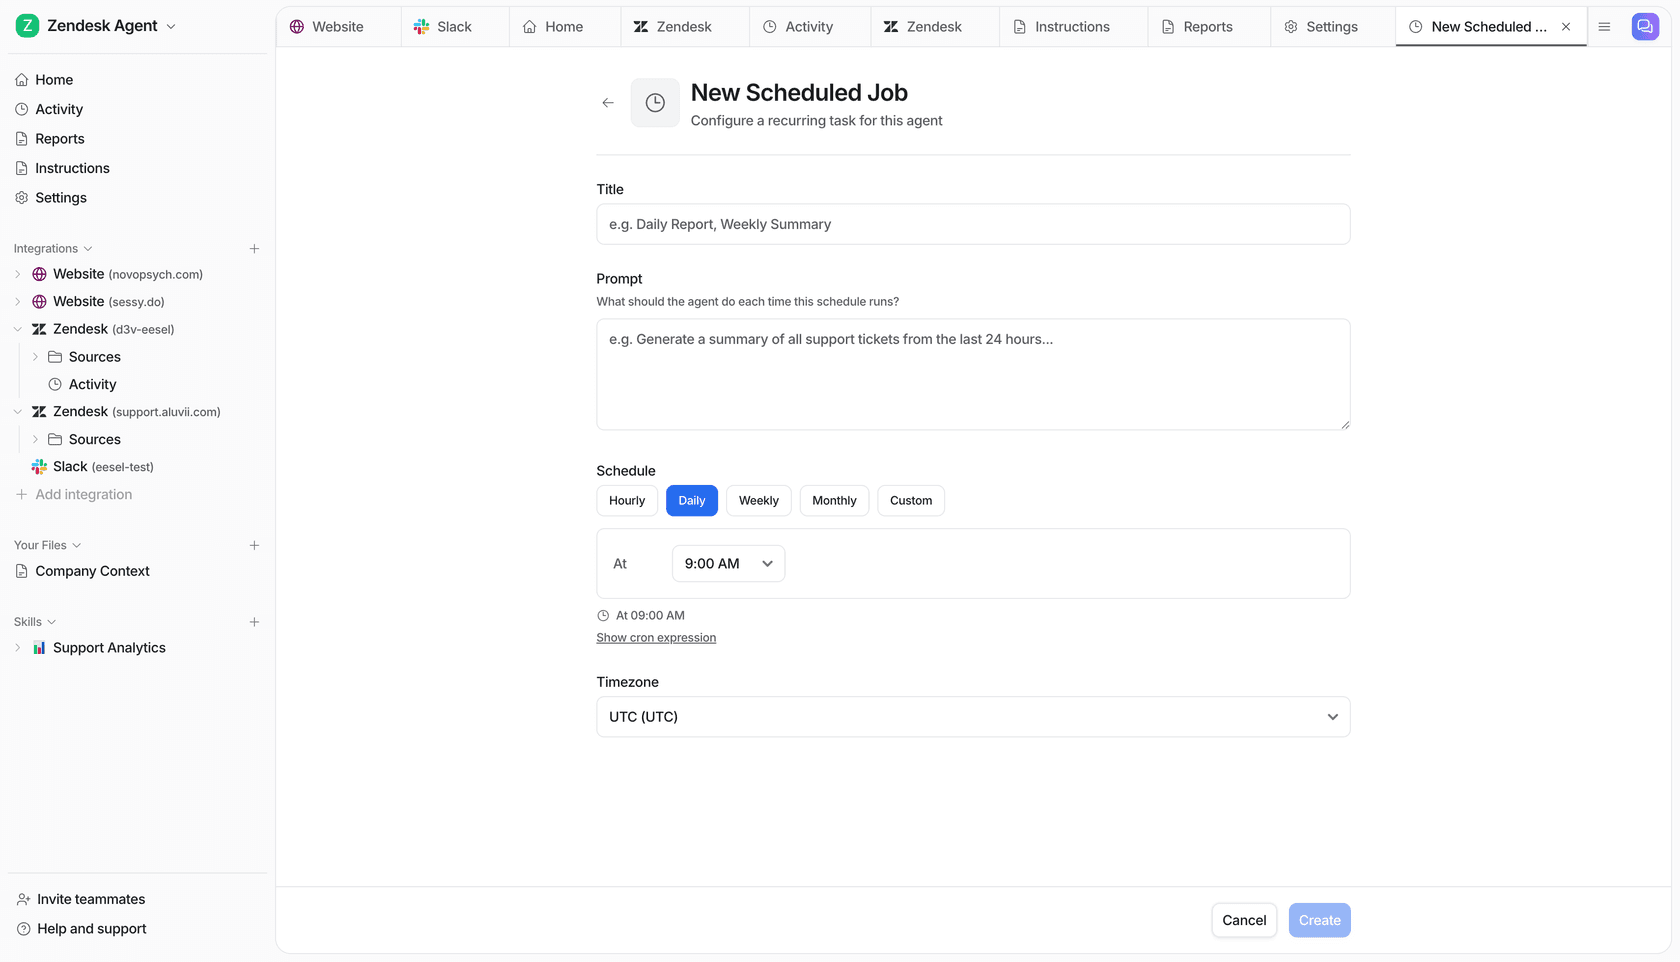
Eine Erfahrung aus echten Rollouts möchte ich weitergeben: Halten Sie Geschäftszeiten und Routing-Logik in den eigenen Einstellungen des Helpdesks. Ein langjähriger eesel-Kunde stieß auf inkonsistentes Verhalten bei Geschäftszeiten und Zeitzonen, als diese Regeln nur in den Anweisungen der KI lagen. Zeitpläne, SLAs und Routing gehören in Zendesk, Freshdesk oder den Helpdesk, den Sie nutzen. Lassen Sie die KI Antworten und Zusammenfassungen übernehmen und den Helpdesk die Uhr.
Starten Sie im Entwurfsmodus, in dem die KI Antworten als interne Notizen schreibt, die Agenten prüfen, und simulieren Sie sie gegen Ihre bisherigen Tickets, bevor sie Kunden antwortet. Mein Review zum KI-Helpdesk-Agenten und der Leitfaden zu 24/7-Support mit KI gehen beim Rollout tiefer.
Häufige Fehler im verteilten Support
- Ein Posteingang pro Standort. Er verbirgt Arbeitslast und lässt Tickets verwaisen. Nutzen Sie eine Queue und routen Sie.
- Annehmen, dass Ihr Tarif mehrere Zeitpläne unterstützt. Zendesk Professional tut das nicht. Prüfen Sie es, bevor Sie den Aufbau darauf auslegen.
- Standorte in verschiedenen Zeitzonen vergleichen. Einigen Sie sich zuerst auf eine Reporting-Zone.
- Getrennte QA pro Standort. Dieselbe Scorecard, gemeinsame Kalibrierung, sonst sind die Werte nebeneinander wertlos.
- Wissen pro Standort. Ein standortspezifisches Dokument ist der Anfang einer standortspezifischen Antwort.
- An einem Standort Schließen belohnen, am anderen Lösen. Standorte optimieren auf das, woran sie gemessen werden. Messen Sie sie gleich.
- Die Uhr in KI-Anweisungen legen. Geschäftszeiten gehören in die Helpdesk-Konfiguration.
Wenn Sie überlegen, ob Sie überhaupt einen Standort hinzufügen sollten, rechnet mein Kostenvergleich KI vs. Offshore die Zahlen durch, und Helpdesk-Software für Remote-Teams vergleicht die Tools.
eesel für verteilte Support-Teams
Wenn Ihre Standorte auf dieselben Fragen leicht unterschiedliche Antworten geben oder es eine Zeitspanne gibt, die keiner von ihnen gut abdeckt, ist der KI-Helpdesk-Teamkollege von eesel für genau diese Lücke gebaut. Er schließt sich Ihrer bestehenden Queue in Zendesk, Freshdesk, Gorgias, Front oder Help Scout an, lernt aus den Tickets, die alle Ihre Standorte bereits beantwortet haben, und antwortet zu jeder Uhrzeit und in der Sprache des Kunden auf dieselbe Weise.
Sie können ihn an Hunderten Ihrer bisherigen Tickets testen, bevor er ein Live-Ticket anfasst. Und weil die Preise pro bearbeitetem Ticket mit unbegrenzten Seats gelten, kostet es nichts extra, jeden Agenten an jedem Standort hinzuzufügen.

Testen Sie eesel kostenlos und sehen Sie, wie Ihre Queue aussieht, wenn jeder Standort von derselben Antwort ausgeht.