


KI für das Tracking von Feature-Anfragen erledigt vier Aufgaben: Sie erkennt den Wunsch in einem Support-Ticket, trennt ihn von Fehlern und Anwendungsfragen, verknüpft ihn mit einer gemeinsamen Anfrage, damit die Nachfrage gezählt wird, und antwortet allen, die danach gefragt haben, sobald das Feature live ist. Die ersten drei Aufgaben decken Tools wie Canny, Linear und Productboard gut ab. Die vierte, die Antwort, ist die, die fast keines davon im Ticket selbst erledigt, und sie ist die, die Ihre Kunden bemerken.
Richten Sie es daher von der Support-Seite aus ein, nicht von der Produktseite. Lassen Sie die KI jedes Ticket aus einer festen Liste markieren, die passende Anfrage anlegen oder finden und das Ticket verknüpft halten. Sobald die Anfrage umgesetzt ist, sind diese verknüpften Tickets Ihre Benachrichtigungsliste. Cannys Autopilot ist in jedem Tarif enthalten und liest geschlossene Tickets von selbst. Linears Zendesk-Integration öffnet das Ticket wieder, wenn das Issue erledigt ist, aber die Antwort schreibt weiterhin ein Mensch.
Wenn Ihre Queue auf Zendesk, Freshdesk oder Gorgias läuft und Ihr Produktteam auf Jira, übernimmt eesel die Support-Hälfte in einem Durchgang: Es markiert den Wunsch, durchsucht Jira nach einem bestehenden Issue, bevor es ein neues anlegt, und entwirft die „Es ist live“-Antwort, wenn das Issue geschlossen wird. smava nutzt es bereits, um 14.600 Zendesk-Tickets im Monat in Felder einzuordnen, was dieselbe Fähigkeit ist, auf der das Markieren von Feature-Anfragen beruht.
Was leistet KI für das Tracking von Feature-Anfragen eigentlich?
KI für das Tracking von Feature-Anfragen liest jede Support-Konversation, entscheidet, ob der Kunde etwas verlangt, das das Produkt noch nicht kann, und macht daraus einen gezählten, verknüpften Eintrag, mit dem Ihr Produktteam arbeiten kann. Sie entscheidet nicht, was gebaut wird.
Ich betreue die Support-Queue von eesel und sehe die Rohfassung davon täglich. Jemand schickt vier Absätze zu einer Abrechnungsfrage, und die allerletzte Zeile lautet: „Außerdem wäre es toll, wenn man das nach Sheets exportieren könnte“. Diese eine Zeile ist die Anfrage. Für einen Produktmanager ist der Rest Rauschen, und das sagte ein Hacker-News-Kommentator schon Jahre, bevor LLMs helfen konnten:
"The Customer Support teams of your customers are going to be one of the main channels for capturing feature requests. We use Zendesk and have custom fields for categorizing and sub-categorizing requests along with a brief description. We do this so that the PMs don't have to read the entire Support ticket if one sentence is about the feature request out of 10 pages of text."

Das ist im Grunde die ganze Aufgabe. Sie ziehen den einen Satz heraus und legen ihn dort ab, wo er gezählt wird, und behalten dabei den Link zurück zum Ticket. Für die KI zerfällt das in vier Schritte:
- Erkennen. Den Wunsch finden, auch wenn er in einem Ticket zu etwas ganz anderem versteckt ist.
- Einordnen. Ist es eine echte Anfrage, ein Fehler, eine Anwendungsfrage oder etwas, das das Produkt bereits kann?
- Verknüpfen und zählen. Das Ticket an eine gemeinsame Anfrage hängen, statt jedes Mal eine neue zu eröffnen.
- Antworten, wenn es live ist. Die verknüpften Tickets nutzen, um jedem Kunden Bescheid zu geben, der gefragt hat.
Die Schritte eins bis drei sind der „Tracking“-Teil und überschneiden sich stark mit KI-Ticket-Tagging und Ticket-Deduplizierung. Die meisten Setups hören vor Schritt vier auf. Wenn Sie bereits ein Voice-of-Customer-Programm betreiben, sehen Sie dies als den Support-Ticket-Ausschnitt davon.
Warum gehen Feature-Anfragen im Support verloren?
Feature-Anfragen gehen verloren, weil der Support sie in dem festhält, was gerade am nächsten liegt, während das Produktteam woanders danach sucht. Im Ticket steht „Ich habe das ans Team weitergegeben“. Danach landet der Wunsch in einem Slack-Thread oder einer Tabelle oder vielleicht in einem Ticket-Tag, über den niemand berichtet.
Hier die Tabellenversion, von einem Head of Product auf Reddit:
"So, what ends up happening is each of these customers has a google sheet of their asks/needs/requests. As the Head of Product, I am always checking these spreadsheets and trying to prioritize burning asks into our dev cycles. Its a nightmare to see it all in one place, and understand "what is the biggest need from our clients right now". I find myself prioritizing one feature only impacting a $400K client vs. a feature that would benefit 10 $20K clients."

Und hier die Kundenseite desselben Durcheinanders, von jemandem, dessen Ticket einen Monat liegen blieb:
"I'm not asking for instantaneous results. I'm asking for communication. My ticket sat untouched for something like a month before I sent a support ticket in and it was then tagged as a feature request."
Schauen Sie, was diesen Kunden wirklich geärgert hat. Nicht, dass das Feature nicht kam. Sondern dass das Ticket als Feature-Anfrage markiert wurde und danach nichts mehr zurückkam. Ein Tag ist Ablage, keine Antwort.
Ich habe gesehen, wie das beim eigenen Produkt von eesel gut lief. Die Anfragen, die in den Vertriebsnotizen von eesel am häufigsten auftauchten, waren fehlende Helpdesk-Integrationen: Front, HubSpot Service Hub, Jira Service Management und Zoho Desk kamen immer wieder vor, und deswegen gingen Abschlüsse verloren. Diese Wünsche wurden gezählt statt verstreut, also wurden sie zu Arbeit, und alle vier stehen inzwischen auf der Integrationsliste. Wenn der Wunsch eines Kunden live geht, sieht das Update im Team-Channel von eesel etwa so aus wie dieses, das mein Kollege Amogh im Mai gepostet hat: „CUS-605 prompt compressor shipped, unblocked.“ Eine Issue-ID und ein Kunde, plus eine Person, die jetzt weiß, dass sie ihm Bescheid sagen muss.
Wie unterscheidet KI eine Feature-Anfrage von einem Fehler oder einer Anwendungsfrage?
KI ordnet nach Absicht ein, aber das klappt nur gut, wenn Sie die Kategorien mit Beispielen aufschreiben. Die übliche Aufteilung hat drei Spuren: „Der Export-Button funktioniert nicht“ ist ein Fehler, „Könnt ihr wöchentliche Exporte hinzufügen“ ist eine Feature-Anfrage, „Ich finde den Export-Button nicht“ ist eine Anwendungsfrage. Ich würde eine vierte ergänzen, denn sie spart am meisten Zeit.
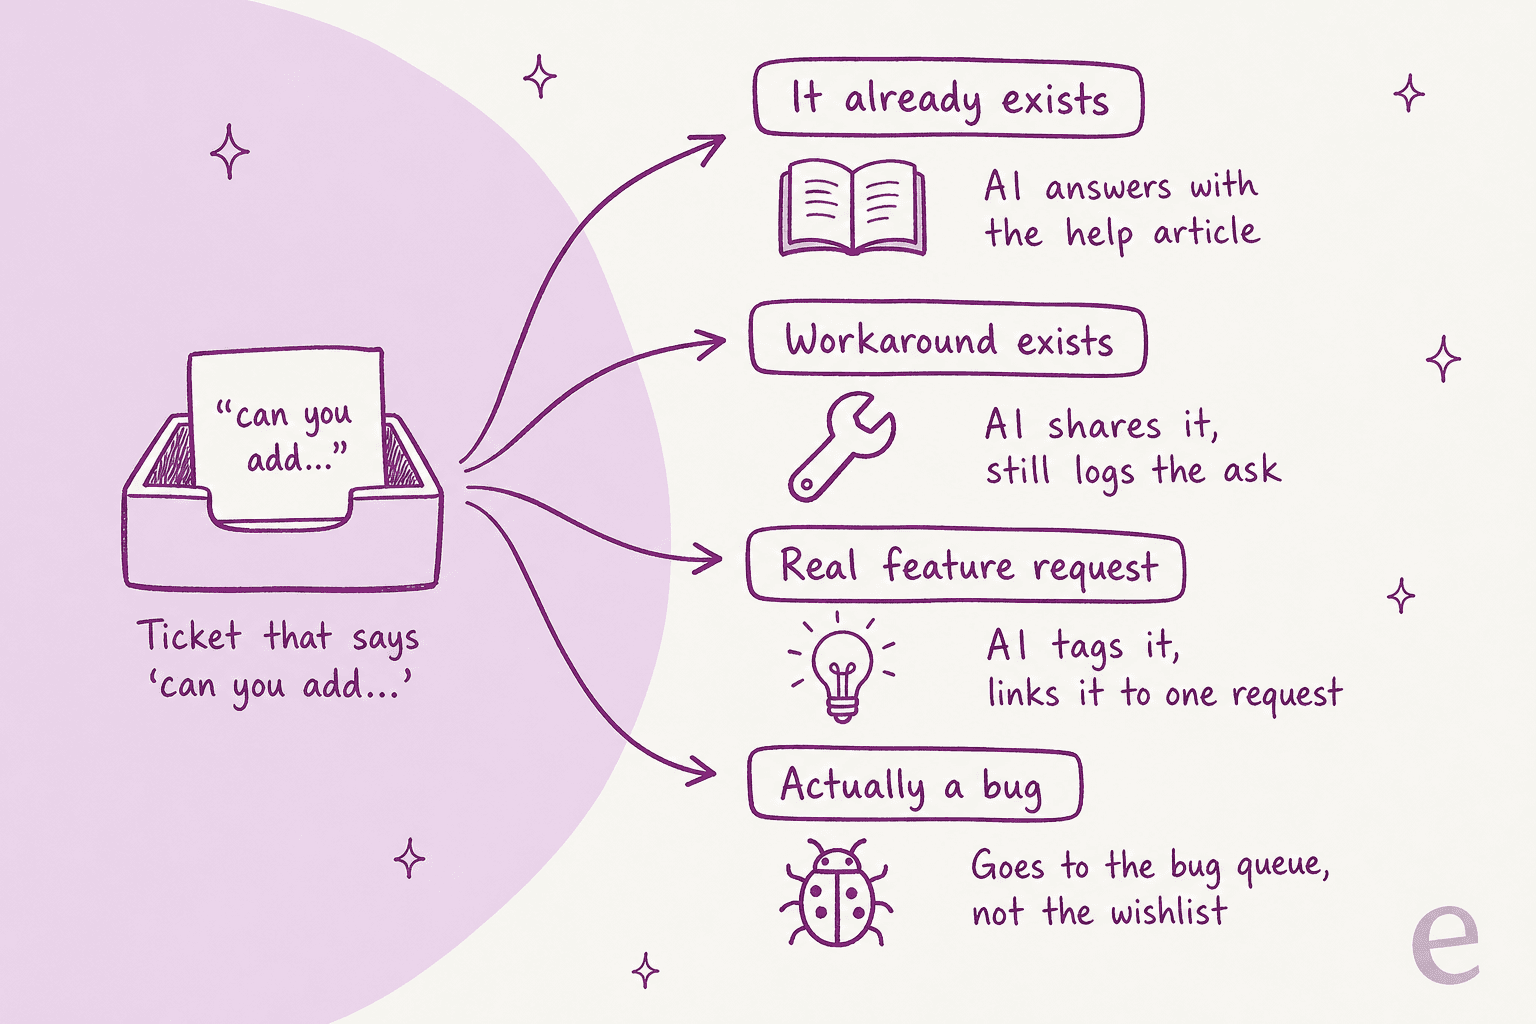
Es gibt es bereits. Erstaunlich viele „Könnt ihr X hinzufügen“-Tickets drehen sich um etwas, das das Produkt schon kann. Eine gute Support-KI sollte diese aus Ihrem Help Center beantworten, statt sie zu erfassen, denn eine Anfrage für ein vorhandenes Feature ist eigentlich ein Auffindbarkeitsproblem. Ein Customer Success Manager auf Reddit wehrte sich genau deshalb gegen vage Übergaben:
"So you don't have any detail on the request? No validation? What if its actually something they could already do or approximately do 80% of with existing features? You don't have conversations around why they want it or how it will benefit them? "Hey PM. Mr customer said they want to send emails! Figure it out!""
Es gibt einen Workaround. Teilen Sie ihn, erfassen Sie den Wunsch aber trotzdem. Wer mit einem Workaround lebt, zählt weiterhin als Stimme.
Es ist eine echte Anfrage. Markieren Sie sie und schreiben Sie den Wunsch in den eigenen Worten des Kunden auf, dann verknüpfen Sie ihn mit der passenden Anfrage.
Es ist eigentlich ein Fehler. Leiten Sie ihn an den Bug-Triage-Ablauf weiter. Ein als Wunsch erfasster Fehler kann monatelang auf einem Roadmap-Board liegen, und währenddessen denkt der Kunde, Sie ignorierten etwas Kaputtes.
Verlässlich wird das durch eine feste Liste. Rúngne, eine Kletterbekleidungsmarke auf Gorgias, lässt seinen eesel-Triage-Agenten mit einer festgelegten Tag-Liste arbeiten. Die Zahl aus der Kundengeschichte lautet 880 markierte Tickets in einem Monat, alle aus dieser Liste, „nothing invented“. Ein Tag für Feature-Anfragen funktioniert genauso. Die KI wählt aus Ihrer Liste, statt jeden Dienstag eine neue Kategorie zu erfinden. Wenn Sie bei null anfangen, führt Sie mein Leitfaden dazu, wie man Ticket-Tagging automatisiert, durch den Aufbau dieser Liste.
Was sollte jede getrackte Anfrage festhalten?
Jede getrackte Anfrage sollte den Wunsch in den eigenen Worten des Kunden enthalten, einen Link zurück zu jedem Ticket, wer gefragt hat, jeden Workaround, den Sie angeboten haben, und einen Status. Das sind fünf Felder, und Sie werden später jedes davon brauchen.
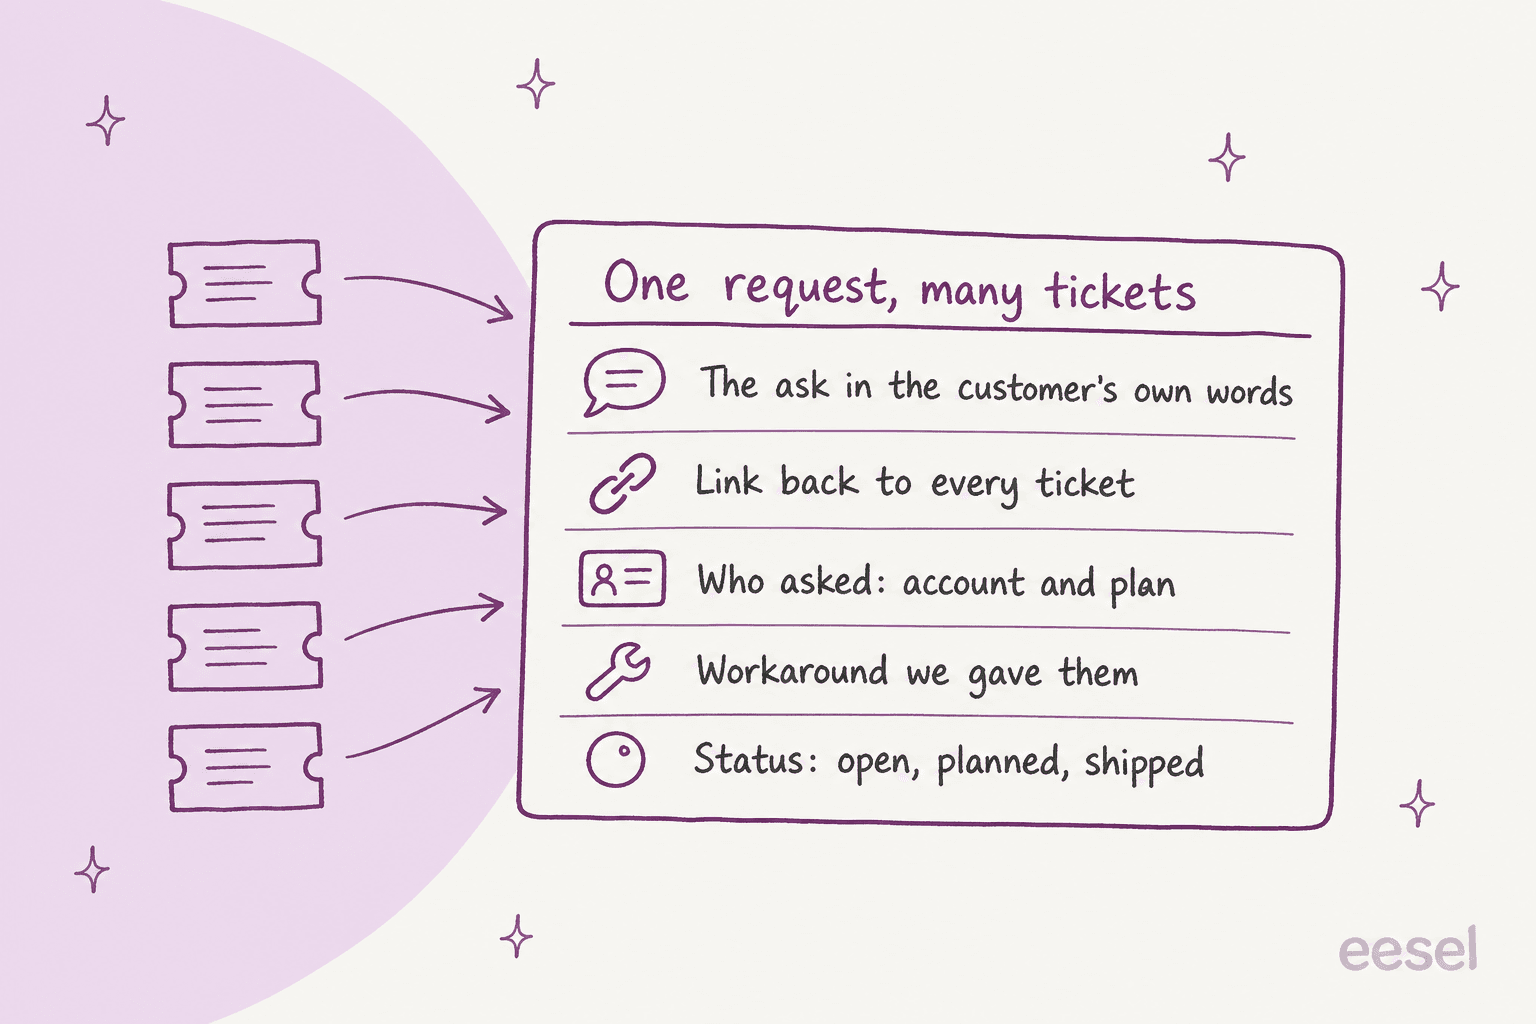
Die meisten Setups verlieren den Link zurück zu jedem Ticket. Fügen Sie eine Zusammenfassung in eine Tabelle ein, und der Ticket-Link fällt einfach weg. Sechs Monate später, wenn das Feature live geht, kann niemand mehr sagen, wer gefragt hat. Linear löst das gut: Wird ein Issue aus Zendesk erstellt oder verknüpft, „will automatically add a request pointing back to the source“, und die Anfrage zitiert die ursprüngliche Nachricht des Kunden mit Name und Zeitstempel.
„Wer gefragt hat“ ist wichtig, weil eine reine Zahl allein lügt. Der Head of Product von Reddit oben wog einen 400.000-$-Kunden gegen zehn 20.000-$-Kunden ab. In Linear können Sie eine Anfrage pro Kunde als wichtig markieren, und Cannys Wählerliste zeigt den MRR jedes Kunden neben dem verknüpften Zendesk-Ticket. Wenn Ihr Helpdesk den Tarif oder die Kontogröße bereits kennt, lassen Sie die KI diese auf die Anfrage schreiben, damit die Zahl gewichtet und nicht nur summiert werden kann.
Paul Graham brachte die andere Hälfte des Arguments schon 2009 auf den Punkt, als er über die Feature-Request-Seite von Hacker News schrieb:
"One of the main points of the feature request page is to separate feature requests from submmissions. You want to do this because most are either duplicates or bad ideas, and yet (like all meta discussion, including this post) tend to get a lot of upvotes. The feature request page serves that purpose even if no one reads it."
Duplikate sind der Normalfall, nicht die Ausnahme. Deshalb muss „mit einer bestehenden Anfrage verknüpfen“ der erste Zug der KI sein und „eine neue anlegen“ der Rückfall.
Welche Tools verfolgen Feature-Anfragen aus Support-Tickets?
Die Tools, die Feature-Anfragen aus Support-Tickets verfolgen, teilen sich in produktseitige Boards (Canny, Productboard, Featurebase, Jira Product Discovery), einen Issue-Tracker, der Anfragen aufnimmt (Linear), und KI im Helpdesk selbst (Zendesks Intelligent Triage oder ein Agent wie eesel). So schneiden sie bei den vier Aufgaben ab. Die Preise stammen von der jeweiligen Preisseite des Anbieters, geprüft am 30.10.2026.
| Tool | Wie Tickets hineinkommen | Was die KI tut | Wie der Anfragende Antwort bekommt | Einstiegspreis |
|---|---|---|---|---|
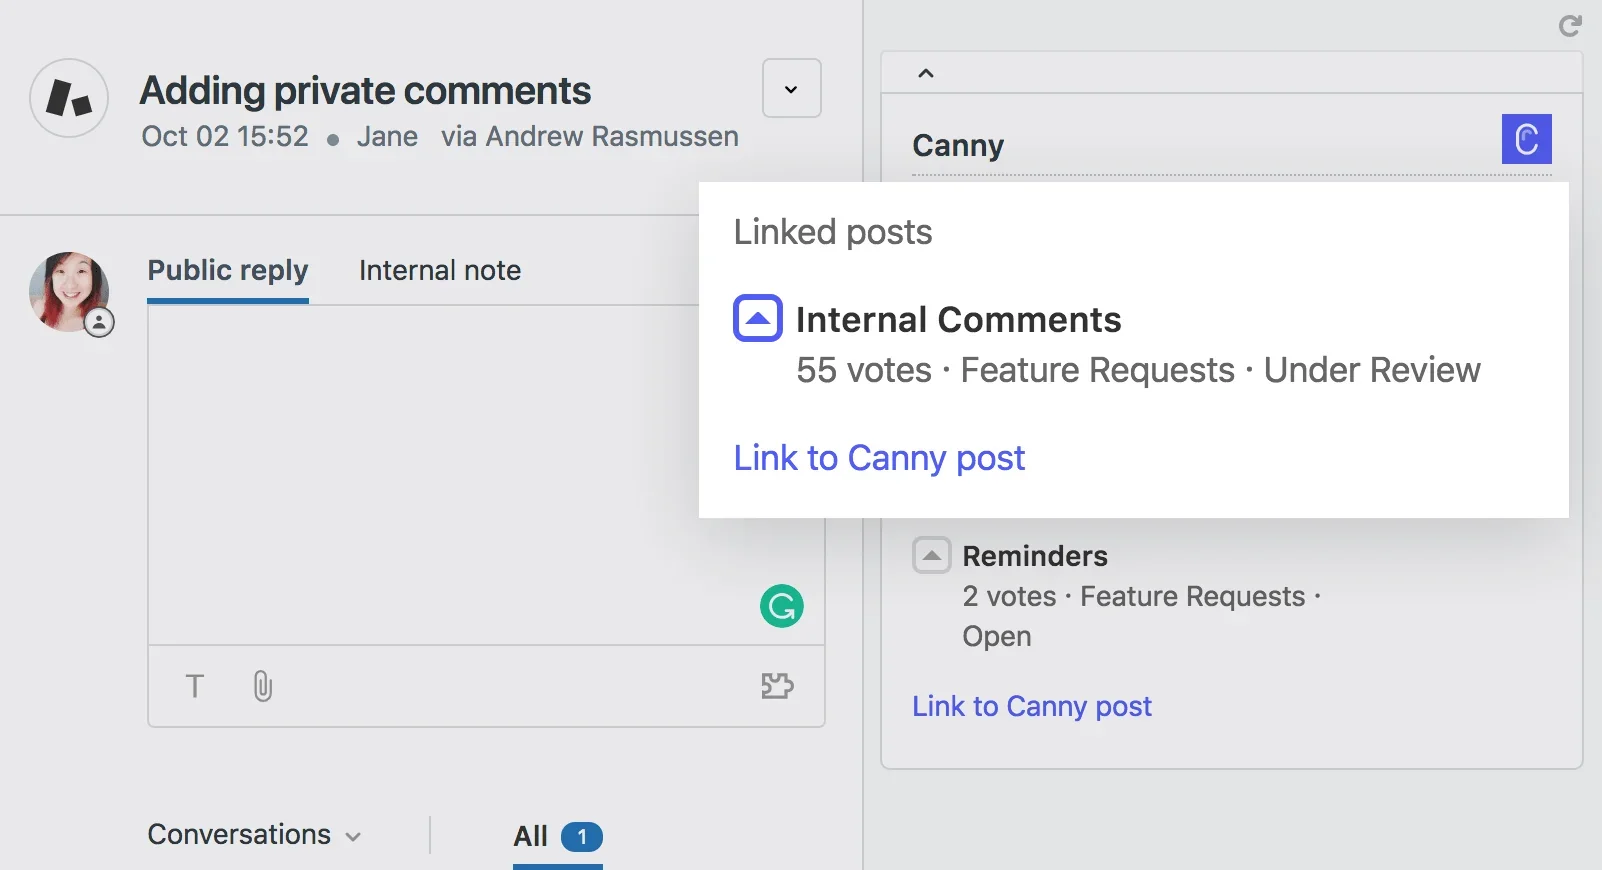
| Canny | Autopilot liest geschlossene Tickets aus Zendesk, Freshdesk, Help Scout; Zendesk-Seitenleisten-App | Findet Anfragen, führt Duplikate zusammen, manueller oder automatischer Modus | Status-E-Mails, auch an „users tracked internally“ | Kostenlos für 25 getrackte Nutzer; Pro 99 $/Monat für 100 (79 $ jährlich) |
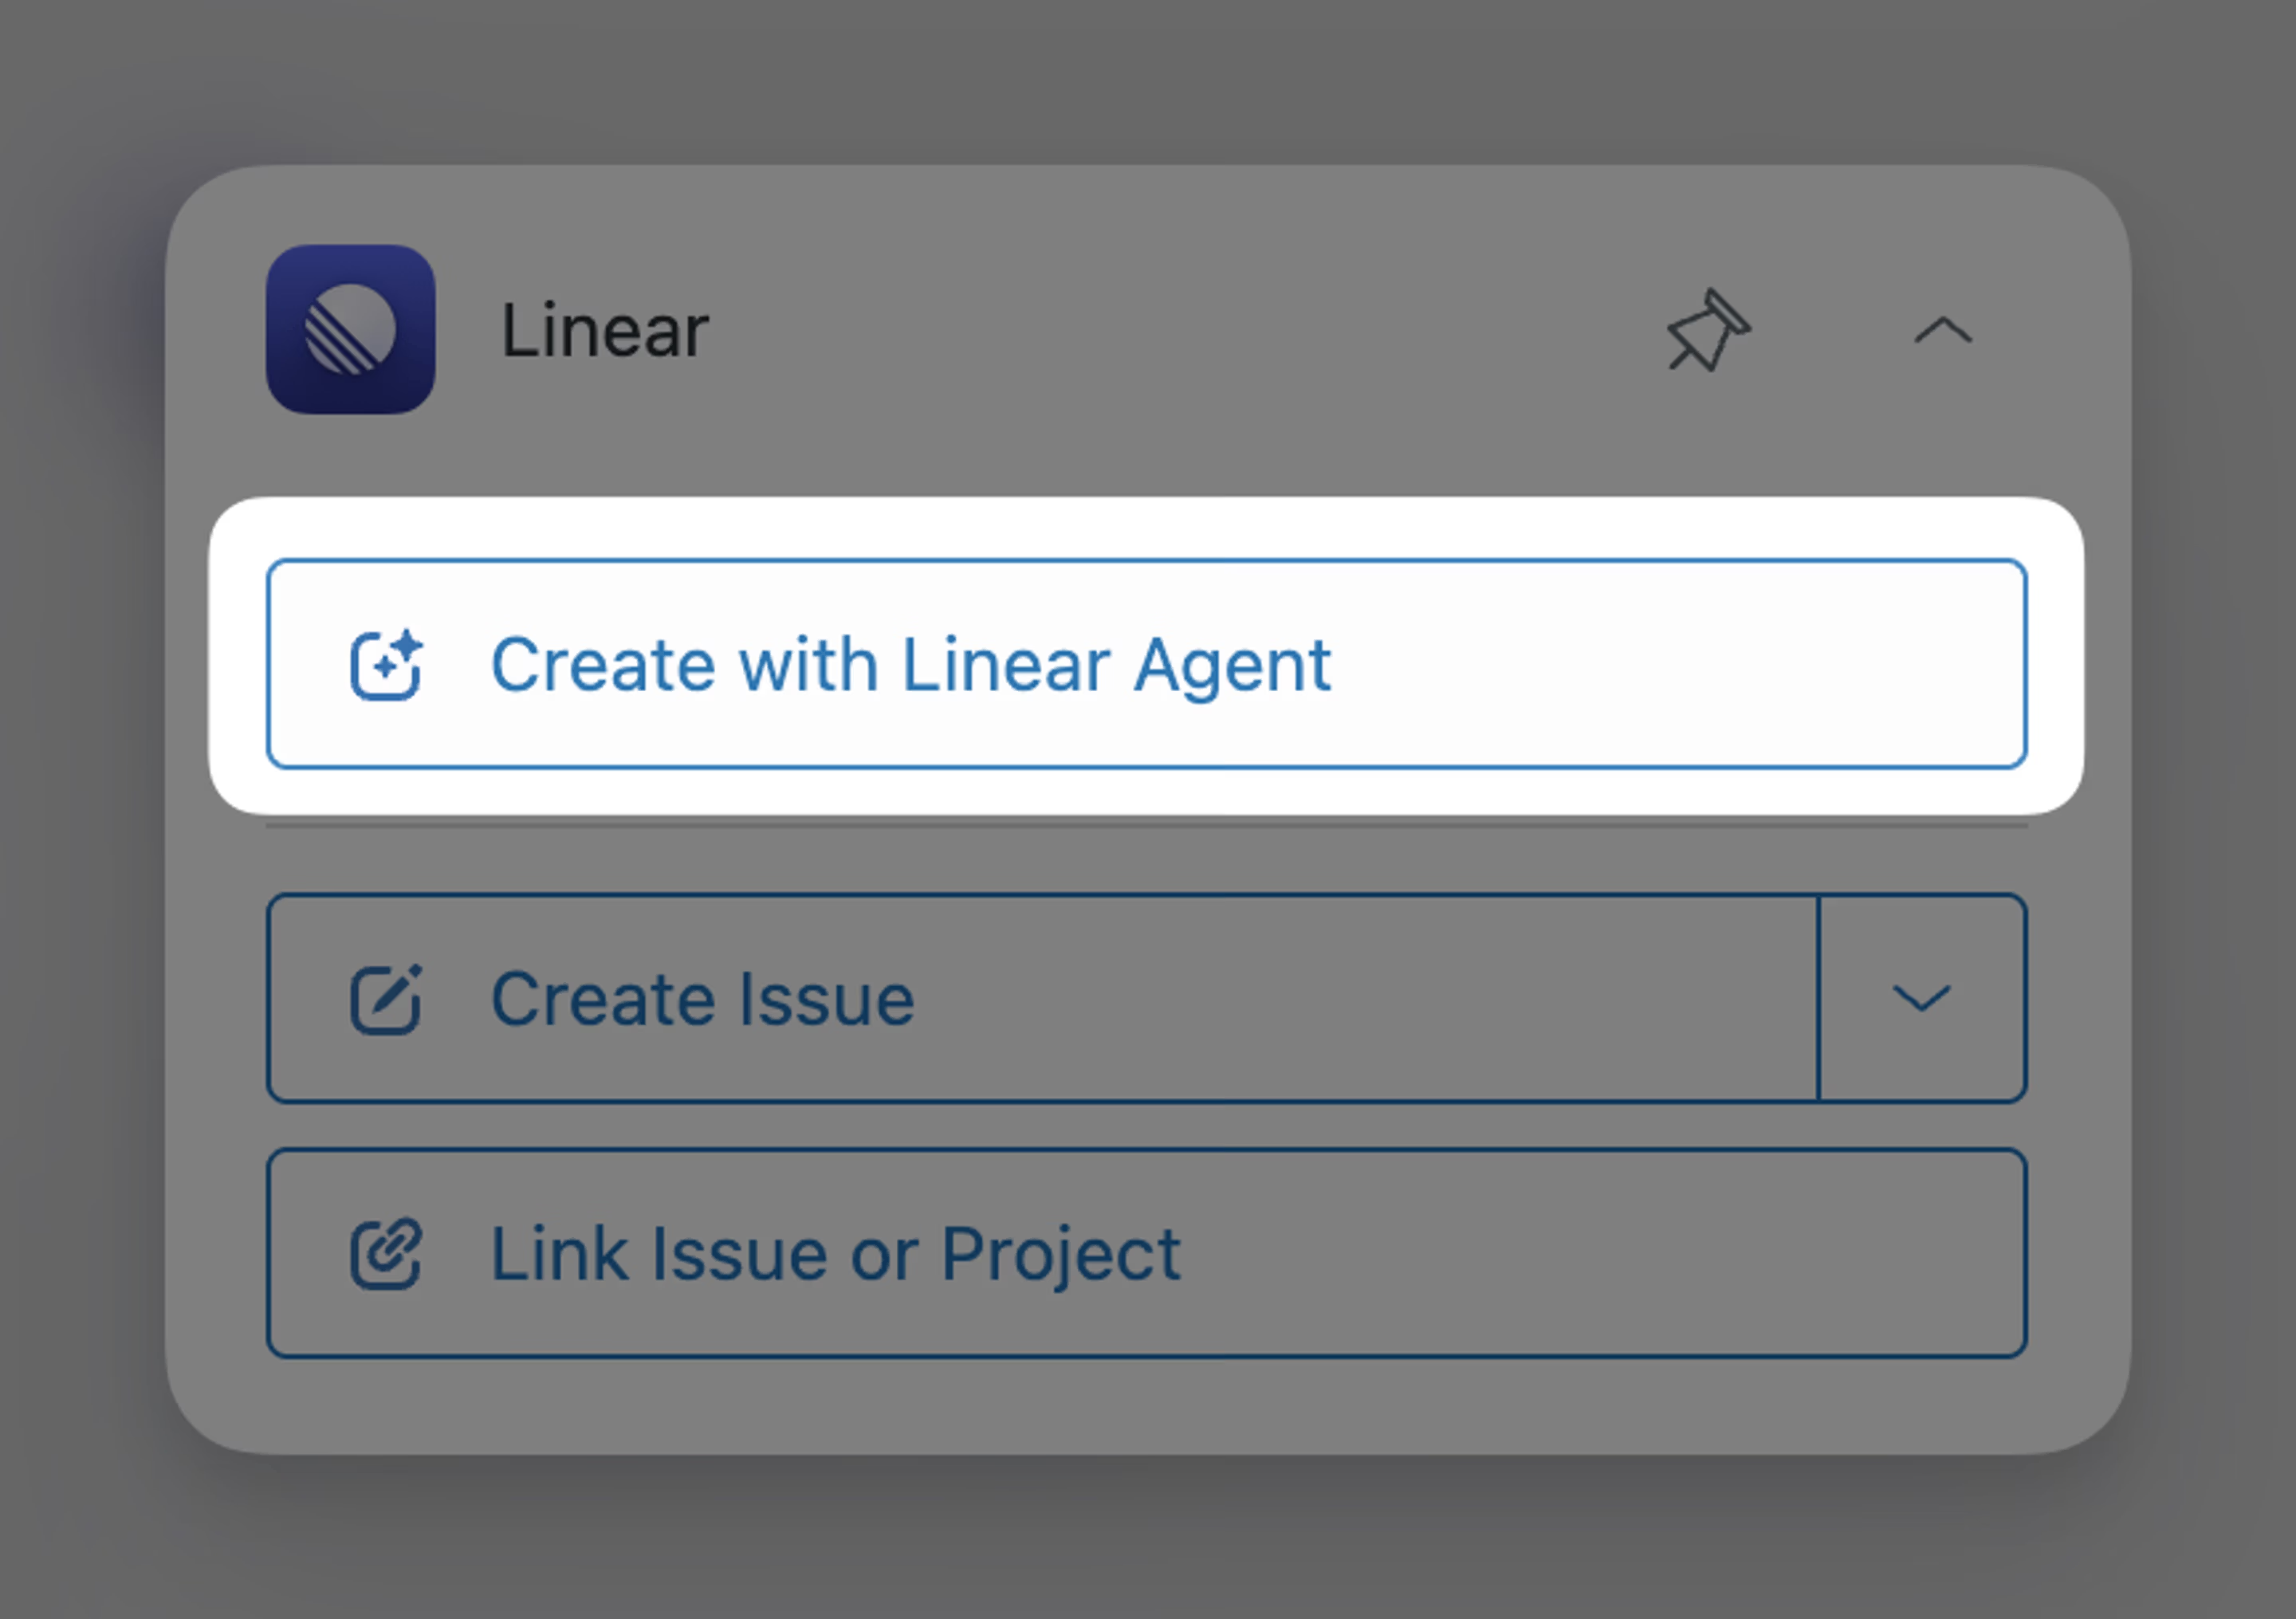
| Linear | Issue aus der Zendesk- oder Front-Seitenleiste erstellen oder verknüpfen | „Create with Linear Agent“ schreibt das Issue aus der gesamten Konversation; Triage Intelligence markiert Duplikate | Interne Notiz + Ticket wieder geöffnet; ein Mensch schreibt die Antwort | Business 16 $/Nutzer/Monat, jährlich abgerechnet (für Zendesk nötig) |
| Productboard | Zendesk-Tickets per Tag oder Trigger hereingezogen; Freshdesk einzeln | Spark ordnet Feedback in Chancen; automatisches Verknüpfen mit Features ist in Spark „Not yet“ | Ein Produktmanager schreibt ein Portal-Update | Nicht veröffentlicht; mindestens 5 Maker |
| Featurebase | Eigener Posteingang (KI), Zendesk- und HubSpot-Apps (manuell) | Verknüpft Feedback mit Anfragen, führt eindeutige Duplikate zusammen, teilt Nachrichten mit mehreren Wünschen auf | Status-E-Mail; ein benutzerdefiniertes Update kann in verknüpften Konversationen antworten | Growth 29 $/Platz/Monat jährlich (37 $ monatlich) |
| Jira Product Discovery | Zendesk- oder JSM-Link als Insight auf eine Idee einfügen | Rovo fasst zusammen und brainstormt, nur Premium | Derzeit nichts eingebaut | Kostenlos für 3 Creator; Standard 10,50 $/Creator/Monat |
| Zendesk Intelligent Triage | Klassifiziert jedes Ticket mit öffentlichem Kommentar | Markiert die Absicht; braucht ein eigenes Thema „Feature-Anfrage“ | Nichts eingebaut | Suite Professional; Copilot 50 $/Agent/Monat, um es in Workflows zu nutzen |
| eesel | Tritt Zendesk, Freshdesk, Gorgias und anderen Helpdesks als Agent bei | Markiert aus Ihrer Liste, schreibt Felder, durchsucht Jira nach Duplikaten vor dem Anlegen | Entwirft die Antwort in jedem verknüpften Ticket, per Webhook geweckt | 100 Credits kostenlos; 299 $/Monat für 500 Credits |
Ein paar Zeilen dieser Tabelle verdienen einen genaueren Blick.
Canny ist bei der Erfassung am wenigsten aufwendig. Autopilot ist „Included in all plans“ und liest Tickets erst „after they are closed out“ im Helpdesk, beginnend mit den vorherigen 30 Tagen beim ersten Verbinden. Es überspringt außerdem Felder mit personenbezogenen Daten. Worauf Sie achten sollten, ist die Zahl: Personen, deren Feedback Autopilot findet, zählen als getrackte Nutzer, und der Preis von Pro steigt mit den getrackten Nutzern (100 für 99 $ im Monat, 500 für 349 $, 1.000 für 661 $ bei monatlicher Zahlung).
Linear ist am stärksten darin, den Link zu halten. Sie können „as many Zendesk tickets to a Linear issue as you like“ verknüpfen, und wenn doppelte Issues zusammengeführt werden, wandern die Zendesk-Links zum verbleibenden Issue, sodass Automatisierungen weiterlaufen. Seine KI wird durch einen Agenten ausgelöst. Wer das Ticket bearbeitet, klickt auf „Create with Linear Agent“, dann liest Linear die gesamte Konversation samt Anhängen, um das Issue zu schreiben. Von selbst scannt es nicht jedes Ticket.
Zendesks eigene KI kann markieren, aber nicht tracken. Intelligent Triage klassifiziert Tickets nach Absicht, aber ich fand in der Dokumentation kein eingebautes Thema „Feature-Anfrage“. Sie müssten dafür selbst ein eigenes Thema anlegen. Außerdem zählt es die Nachfrage nicht pro Feature, Sie bräuchten also weiterhin ein Board oder einen Tracker am anderen Ende. Meine Intelligent-Triage-Analyse geht tiefer auf die Tarife ein.
Productboards KI liest, verknüpft aber noch nicht. Spark ist in jedem Workspace enthalten und liest Zendesk-Feedback in eine nach Rang sortierte Liste von Chancen mit Quellenangaben ein. Aber in Productboards eigener Vergleichstabelle ist das automatische Verknüpfen von Insights für Spark mit „Not yet“ markiert, und die ältere Productboard AI, die das konnte, wird nicht mehr verkauft.
Wenn Sie die produktseitigen Tools für sich vergleichen möchten, gehen meine Beiträge zu Featurebase-Alternativen, Jira Product Discovery AI und Linear vs. Jira weiter, als ich es hier kann.
Was passiert, wenn das gewünschte Feature live geht?
Wenn das Feature live geht, senden die meisten Tools entweder eine Status-E-Mail aus dem Produkt-Tool oder legen eine interne Notiz im Ticket ab. Jemand im Support muss die eigentliche Antwort trotzdem schreiben. Das „Tracking“ ist fast überall automatisiert. Das „Dem Kunden Bescheid geben“ meistens nicht.
Das tut jedes Tool im letzten Schritt, laut der eigenen Dokumentation:
- Linear legt eine interne Notiz ab und öffnet das Zendesk- oder Front-Ticket wieder, „so that your agents will be able to notify the customers“. Ein Mensch schreibt die Antwort.
- Featurebase fügt bei einer Statusänderung eine interne Notiz zu verknüpften Konversationen hinzu. „Sending a customer reply is a separate action“, laut der Statusupdate-Dokumentation, wobei ein benutzerdefiniertes Update in verknüpften Konversationen antworten kann.
- Canny schickt eine E-Mail an Nutzer, deren Anfrage über ein Ticket hereinkam, wenn Sie „Notify users tracked internally“ anhaken. Die E-Mail kommt von Canny, und „if a user replies directly to the email, the reply is not recorded“, laut der Dokumentation zu Status-Änderungs-E-Mails.
- Productboard lässt einen Produktmanager ein Portal-Update schreiben und an Wähler sowie alle mit einem verknüpften Insight senden. „It is not yet possible to reply to email updates“, laut der Anleitung zum Schließen der Feedback-Schleife.
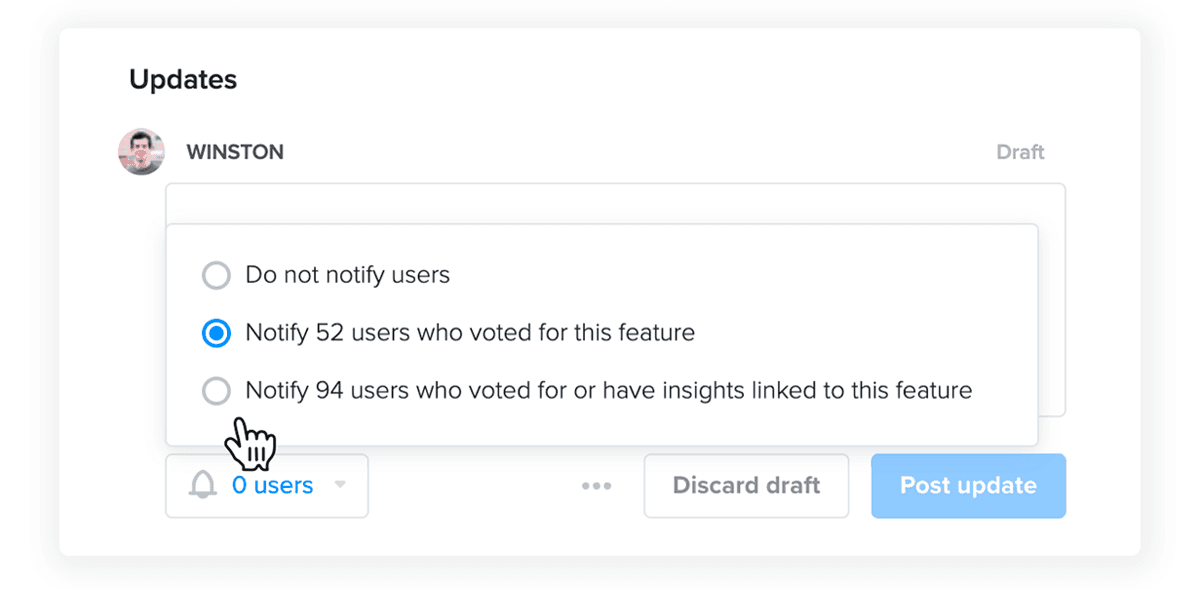
In diesem Productboard-Beispiel stimmten 52 Personen ab, aber 94 hatten entweder abgestimmt oder Feedback verknüpft. Die Leute, die über den Support gefragt haben, sind also ein großer Teil des Publikums, und sie haben das Board nie berührt. Sie haben in einem Ticket gefragt. Ein G2-Rezensent von Canny brachte die Lücke klar auf den Punkt:
"It is very basic. Unless the PM makes comments, it is difficult to understand if there has been any progress. There is no way to close the loop when a feature has been released."

Diese Rezension stammt von einem Team, in dem Canny „was a way for our support team to submit feature ideas to the Product team“, also genau das Setup, um das es in diesem Beitrag geht.
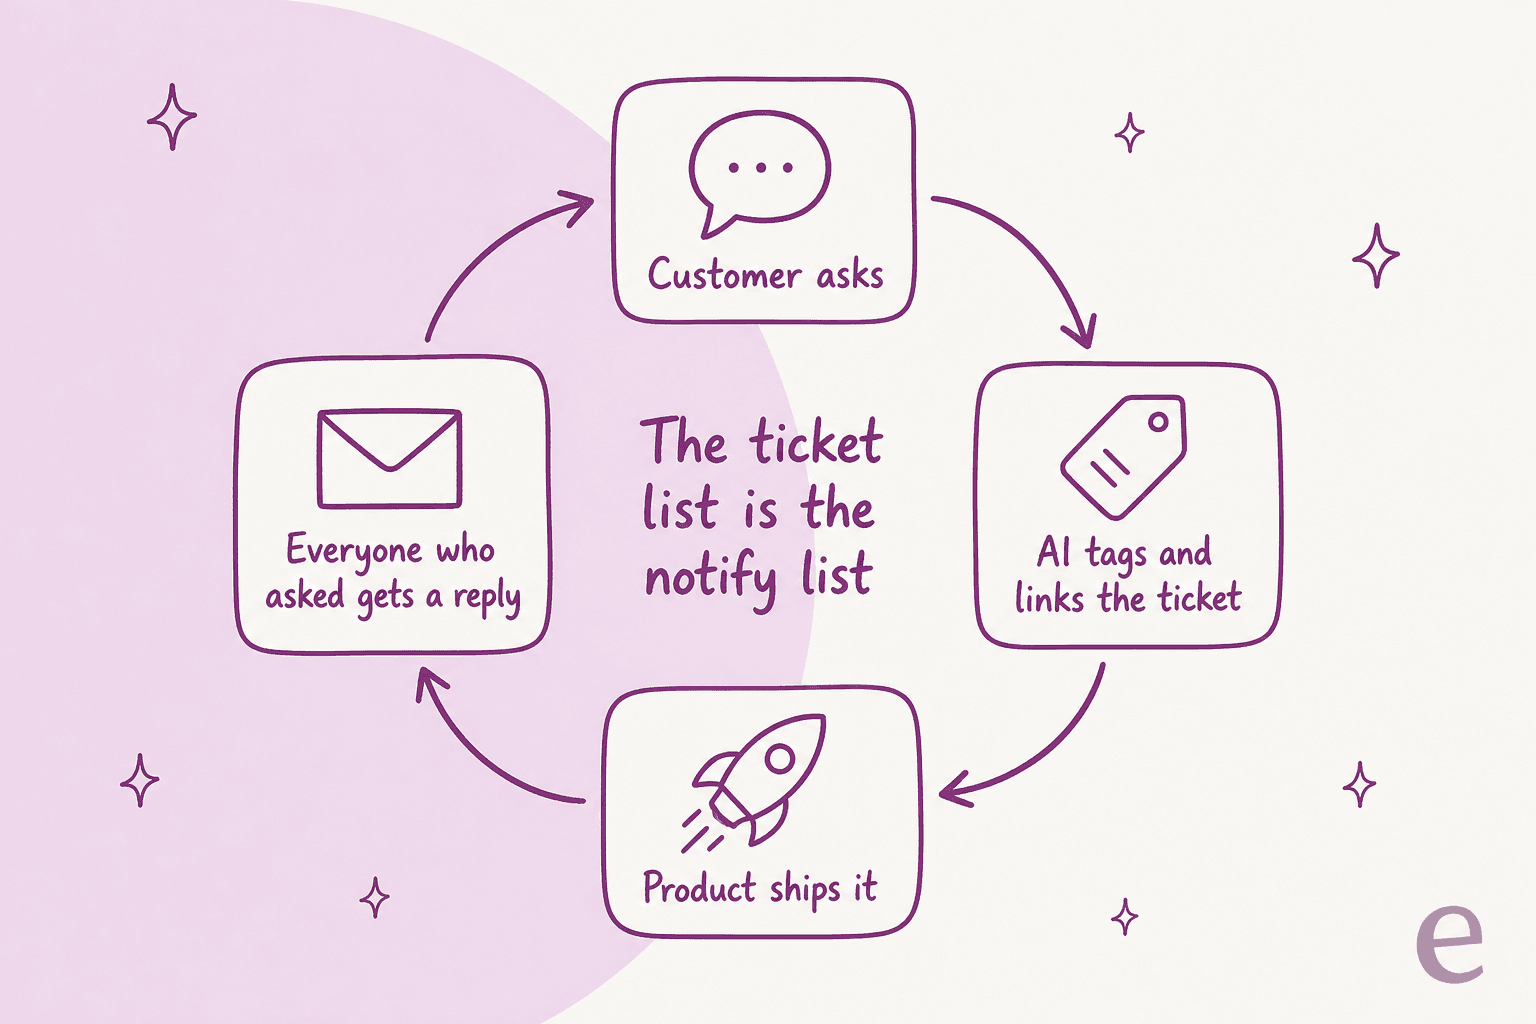
Das ist die Veränderung, die ich vornehmen würde, wenn ich das heute aufsetzen müsste. Behandeln Sie die Ticket-Liste als Benachrichtigungsliste. Wenn jede Anfrage einen Link zu jedem Ticket behält, das danach gefragt hat, dann ist „es ist live“ eine bekannte Liste von Konversationen, jede mit eigenem Kontext. Eine KI kann in jeder eine Antwort entwerfen, die erwähnt, was dieser Kunde wollte und was er in der Zwischenzeit genutzt hat, und ein Mensch gibt sie frei. Der Kunde hört im selben Thread zurück, in dem er gefragt hat, vom selben Team. Es ist dieselbe Idee wie das Eskalieren von Zendesk-Tickets nach Jira, nur in umgekehrter Richtung.
Wie richten Sie KI-Tracking für Feature-Anfragen in Ihrem Helpdesk ein?
Sie richten es in sechs Schritten ein: festlegen, was als Anfrage zählt, der KI eine feste Tag-Liste geben, wählen, wo Anfragen liegen, sie suchen lassen, bevor sie anlegt, mit Freigaben beginnen und die „Es ist live“-Antwort einrichten. Unten steht, wie ich jeden Schritt angehen würde. Ich nehme eesel als Beispiel, weil ich es kenne, aber die Schritte lassen sich auf jeden Agenten übertragen.
1. Schreiben Sie auf, was eine Feature-Anfrage ist
Legen Sie die vier Spuren von oben mit je zwei oder drei echten Beispielen aus Ihren eigenen Tickets in die Anweisungen des Agenten. Nehmen Sie die Spur „Gibt es bereits“ mit den Hilfeartikeln auf, aus denen er antworten soll. Anweisungen in eesel sind einfacher Text, das heißt, die Änderung dessen, was zählt, ist eine schnelle Bearbeitung statt eines Projekts. Das Setup von smava funktioniert genauso: Sein Kategorisierungs-Agent „picks one category from smava's mapping document, judging by intent“, und jede Regel steht in den Anweisungen.
2. Geben Sie ihm eine feste Tag-Liste und ein Feld
Wählen Sie ein Tag für Feature-Anfragen und, wenn Ihr Helpdesk benutzerdefinierte Felder hat, ein Feld für den Produktbereich. Die Zendesk-Aktionen von eesel umfassen Add tags, Update ticket und Get ticket field options, Letzteres, damit er Ihre echten Feldwerte liest, statt zu raten. SE Ranking nutzt das zur Messung. Es bat um ein ai_handled-Tag auf jedem Ticket, das eesel anfasst, damit die Zahlen in Zendesk liegen und nicht in jemandes Kopf. Wenn Sie in Zendesk Explore berichten, zeigt mein Leitfaden zum Berichten über Ticket-Tags, wie Sie die Zählwerte darstellen.
3. Entscheiden Sie, wo Anfragen liegen
Wenn Ihr Produktteam auf Jira läuft, kann der Agent dort direkt anlegen (mein Zendesk-und-Jira-Leitfaden behandelt auch den nativen Weg). Die Jira-Service-Management-Integration von eesel hat Create Issue (Projekt, Zusammenfassung, Beschreibung, Bearbeiter, Labels) und Label Issue. Wenn Ihr Team Asana nutzt, gibt es eine native Asana-Integration, die Aufgaben anlegt. Für Linear, Canny oder Productboard gibt es in der Dokumentation keine native eesel-Integration, Sie würden also deren API über Network Access anbinden, womit der Agent GET-, POST-, PATCH- und DELETE-Aufrufe an jede von Ihnen erlaubte REST-API senden kann. Die andere Möglichkeit ist, die eigene Zendesk-App des Trackers zum Verknüpfen zu behalten und den Agenten nur für Tagging und Antworten zu nutzen.
4. Lassen Sie ihn suchen, bevor er anlegt
Dieser Schritt verhindert Duplikate. Die Jira-Integration von eesel hat die Aktion Search Issues, die „finds issues with a JQL query, so your agent can find related or duplicate issues“. Die Asana-Dokumentation sagt es unverblümt: „Tell it to search before it creates. Otherwise you get a second copy of a task that already exists.“ Schreiben Sie das in die Anweisungen. Erst suchen und bei einem Treffer verknüpfen, nur anlegen, wenn es keinen gibt, und in beiden Fällen den Ticket-Link und den Kunden zum Issue hinzufügen.
5. Beginnen Sie mit Zusammenführungen und neuen Issues auf Freigabe
Jede eesel-Aktion kann pro Agent auf Auto, Needs approval oder Disabled laufen, wie die Dokumentation zu Aktionen und Freigaben beschreibt. Meine Wahl wäre Tagging von Tag eins an auf Auto, mit Create Issue auf Needs approval für die ersten Wochen. Ungeprüfte KI-Zusammenführungen können den Wunsch eines Kunden begraben, und genau das passierte diesem Canny-Nutzer:
"Their AI assistant that auto-creates features for you merges tickets in a way that's not helpful. What the AI tool was doing was: 1. Creating a feature request based on feedback 2. Merging an old ticket into the newly created feature request That was driving me mad! The trouble was being able to find my old ticket that I KNEW I created."
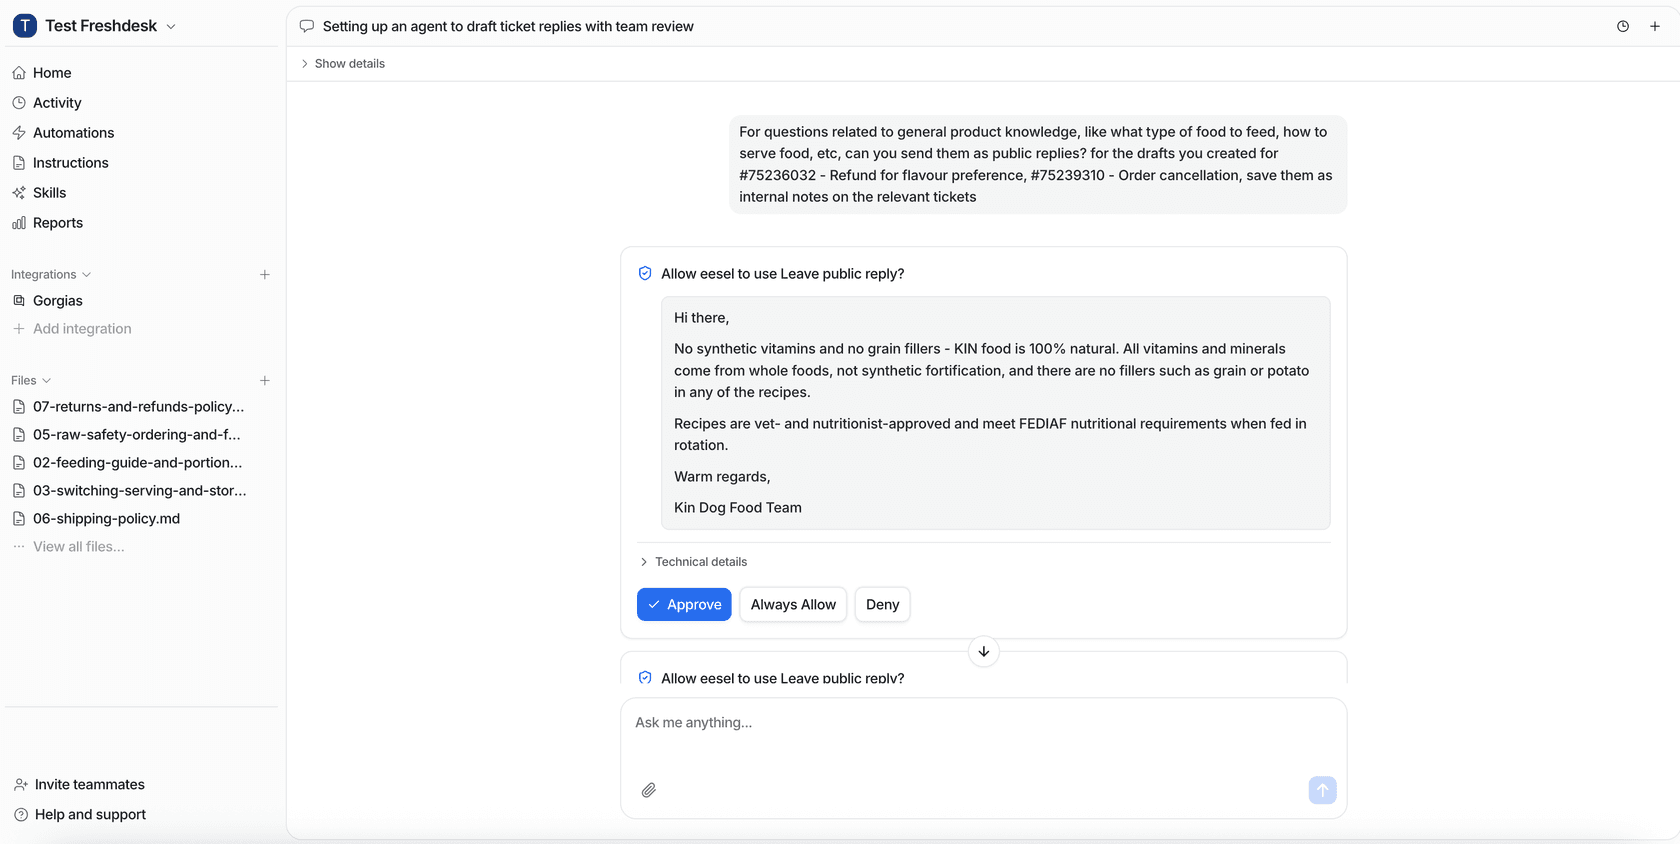
Wenn die Freigaben nach ein paar Wochen richtig aussehen, klicken Sie bei denen, denen Sie vertrauen, auf „Always allow“, und diese Aktion wechselt ab dann auf Auto.
6. Richten Sie die „Es ist live“-Antwort ein
Hier gibt es eine echte Grenze. Die Jira-Trigger von eesel feuern, wenn ein Issue angelegt oder kommentiert wird, nicht wenn sich sein Status ändert, es hört also nicht von selbst „Done“. Der Workaround ist eine Jira-Automation-Regel, die eine Web-Anfrage an einen eesel-Webhook sendet, wenn ein Issue auf Done wechselt. „Send any JSON you like, and your agent reads all of it.“ Der Agent wacht mit dem Issue-Key auf, durchsucht den Helpdesk nach Tickets, die damit markiert und verknüpft sind, und entwirft in jedem eine Antwort. Ich würde Antworten auf Needs approval lassen, zumindest bis Sie einen Stapel durchgelesen haben.
Für die Wochenansicht kann ein Zeitplan jeden Montag laufen und die wichtigsten Anfragen mit der Slack-Integration von eesel in einen Slack-Channel posten, solange er in diesen Channel eingeladen wurde. Der Reports-Skill „Analyze ticket trends“ deckt dasselbe aus der anderen Richtung ab: die Themen, die immer wieder auftauchen, mit Volumen und Stimmung. Wenn Sie es lieber aus einem Terminal steuern, listet die eesel CLI Automatisierungen mit eesel automations auf, verbindet Jira mit eesel integrations connect jira und erledigt Freigaben im Terminal, sodass ein Coding-Agent wie Claude Code denselben Agenten steuern kann, den Sie im Dashboard eingerichtet haben.
Sollten Sie Feature-Anfragen zählen oder gewichten?
Gewichten Sie sie, aber lassen Sie die rohe Zahl ebenfalls sichtbar. Allein belohnt eine rohe Zahl den, der am meisten schreibt. Ein Produktmanager auf Reddit, der Canny nutzt, beschrieb genau diese Verzerrung:
"I just feel like they just make it easier for users to throw feature requests at my team and in my experience often the vast majority of feature request don't help a ton unless a common request and they could be biased by power users."
Ein cleverer KI-Score behebt das nicht. Bessere Eingaben tun es. Wenn jedes verknüpfte Ticket Konto und Tarif trägt, kann ein Produktmanager nach „Anfragen von Kunden im höchsten Tarif“ oder „Anfragen von Konten, die eine Kündigung erwähnt haben“ sortieren. Die Dokumentation von Linear nennt als Beispiel eine Ansicht von Enterprise-Tier-Issues, „where each issue has at least 20 requests“, sortiert nach Kundenzahl. Der Beitrag des Supports ist, sicherzustellen, dass diese Daten an der Anfrage hängen, und die Entscheidung, was gebaut wird, bleibt beim Produkt.
Es gibt auch einen supportseitigen Grund, das sorgfältig zu erfassen, und ein Customer Success Manager auf Reddit hat es treffend gesagt:
"It's pretty big, especially in a CYA way. For example, if an Enterprise customer threatens to cancel for years due to a missing feature, you need to make that well known in case they churn so people know that you sounded the alarms."
Ein Tag mit dem Konto daran ist dieser Alarm, schriftlich festgehalten. Und sobald Anfragen konsistent markiert sind, fügen sie sich direkt in die Kontaktgrund-Berichte neben allem anderen ein, was Ihre Queue Ihnen sagt.
Feature-Anfragen mit eesel tracken
eesel ist ein KI-Helpdesk-Teammitglied, das Ihrer bestehenden Queue in Zendesk, Freshdesk oder Gorgias beitritt, sodass das Tracking von Feature-Anfragen dort stattfindet, wo der Wunsch ankommt, und nicht in einem separaten Tool, an dessen Öffnen der Support denken muss. Es beantwortet die „Gibt es bereits“-Tickets aus Ihrem Help Center, markiert die echten Anfragen aus Ihrer eigenen Liste, durchsucht Jira, bevor es anlegt, damit Duplikate verknüpft statt vervielfacht werden, und entwirft die „Es ist live“-Antwort in jedem verknüpften Ticket, wenn die Arbeit erledigt ist.
Der Tagging-Teil läuft bereits in großem Umfang: smava ordnet 14.600 Zendesk-Tickets im Monat in Felder ein, Dokument 24 markiert 430 Tickets im Monat nach Produkt, und die Agenten von SE Ranking haben in einem Monat etwa 400 Tickets für das Second-Line-Team mit angehängten Belegen angelegt.
Die Preise gelten pro Ticket, nicht pro Platz: 299 $ im Monat für 500 Credits, und ein Ticket kostet 1 Credit, egal wie viel der Agent darin tut. Markieren, Jira durchsuchen und ein Issue anlegen in einem Ticket kosten also trotzdem einen Credit. Es gibt einen kostenlosen Tarif mit 100 Credits, um es in Ihrer eigenen Queue zu testen. eesel testen.