

KI für Entwickler-Support funktioniert, wenn Sie die Queue in vier Ticketarten aufteilen: Doku-Fragen, die die KI mit einem Link beantwortet, Setup-Probleme, die sie anhand des Codes des Entwicklers diagnostiziert, Kontofragen, die sie über die Request-ID nachschlägt, und mögliche Bugs, die sie für einen Engineer aufbereitet. Der Doku-Bot ist der einfache Teil. Die zwei Teile, die Engineers wirklich Zeit sparen, sind die schreibgeschützte Abfrage und der Bug-Bericht.
Was die meisten Teams übersehen: Ein wachsender Teil der Entwickler-Tickets stammt inzwischen von den KI-Coding-Tools der Entwickler, die Teile Ihrer API erfinden. Jede falsche Antwort, ihre oder Ihre, zeigt auf eine Lücke in Ihrer Doku, also korrigieren Sie die Seite, nicht nur die Antwort.
Wenn Ihre Queue in Freshdesk, Zendesk oder Jira Service Management liegt, macht eesel das direkt dort. Timengo nutzt es, um dänische Antworten an IT-Admins zu Zertifikaten, Outlook-Add-ins und Mailfluss aus rund 5.300 früheren Tickets und Artikeln zu entwerfen, wobei ein Engineer jede Antwort selbst sendet.
Wie sieht Entwickler-Support 2026 aus?
Ich baue die Integrationen von eesel, das heißt, ich verbringe einen guten Teil meiner Woche auf der anderen Seite Ihrer Queue: Ich lese die API-Referenz von jemand anderem, laufe in einen 401, den ich nicht verstehe, und frage mich, ob es an mir oder an ihnen liegt. Entwickler-Tickets lesen sich anders als Verbraucher-Support. Sie kommen mit Stack Traces, einem halben curl-Befehl und einer SDK-Version, und die schreibende Person weiß meist mehr über den eigenen Code als Ihr Support-Team.
Sie fallen meist in ein paar Gruppen:
- How-to- und Referenzfragen. Welches Rate Limit gilt für diesen Endpunkt, welchen Scope brauche ich, gibt es ein Go-SDK.
- Setup- und Auth-Probleme. Test-Key in Produktion, abgelaufenes OAuth-Token, falsche Basis-URL, eine Webhook-Signatur, die sich nicht verifizieren lässt.
- "Was ist mit meiner Anfrage passiert?" Eine fehlgeschlagene Webhook-Zustellung, eine Zahlung, die nie gebucht wurde, ein 500 bei einer bestimmten Request-ID.
- Mögliche Bugs. Verhalten, das nicht zur Doku passt, eine Regression nach einem SDK-Release, ein Fehler, den nur eine Region wirft.
In der vierten Gruppe werden Engineers hineingezogen, und dort ist der Support auch am schwächsten, denn ein vages Ticket wie "Ihr Webhook ist kaputt" zwingt einen Engineer, die Untersuchung bei null zu beginnen. Das ist dasselbe Problem, über das ich in KI für Tier-2-Support geschrieben habe: Die Aufgabe auf dieser Stufe ist nicht Antworten, sondern Untersuchen.
Schreibt inzwischen die KI des Entwicklers Ihre Tickets?
Es gibt eine neue Art von Ticket, die es vor ein paar Jahren nicht gab. Ein Entwickler bittet seinen Coding-Assistenten, einen Client für Ihre API zu schreiben, der Assistent errät Felder, die er nie gesehen hat, und Ihr Support-Team bekommt das Ergebnis. Ein Entwickler auf Hacker News beschrieb genau diese Queue bei einem Kunden:
"What I'm seeing is a little eternal September of support tickets about programs that fail to interface the JSON API of a customer of mine. The API is always allucinated. In the best case there are out of place attributes. Often they don't exist at all."

Seine Lösung war, mit Zeile-für-Zeile-Kommentaren zum erfundenen JSON zu antworten. Das ist eine perfekte Aufgabe für KI auf Ihrer Seite, solange sie die Payload mit Ihrer echten Spezifikation vergleicht statt mit ihrer eigenen Vermutung. Es sagt auch etwas darüber, wo Sie Aufwand investieren sollten: Wenn die KI anderer Leute Ihre API ständig falsch versteht, gehört die Doku, die diese Tools lesen, inzwischen zu Ihrer Support-Oberfläche. Doku-Plattformen haben das bemerkt. Mintlify liefert einen MCP-Server im kostenlosen Starter-Tarif, und kapa.ai bietet einen gehosteten MCP-Server an, damit Coding-Agenten Ihre Doku direkt abfragen können.
Welche Entwicklerfragen kann KI allein beantworten?
ChatGPT teilte auf diese Frage eines Teams, das eine API und SDKs verkauft, die Queue nach Fragetyp auf und ordnete mögliche Bugs unter "menschliche Aufsicht" ein. Dieser Aufteilung stimme ich zu, und ich würde zwischen den Bahnen noch eine Linie ziehen: was die KI angebunden haben muss, um jede davon zu erledigen.
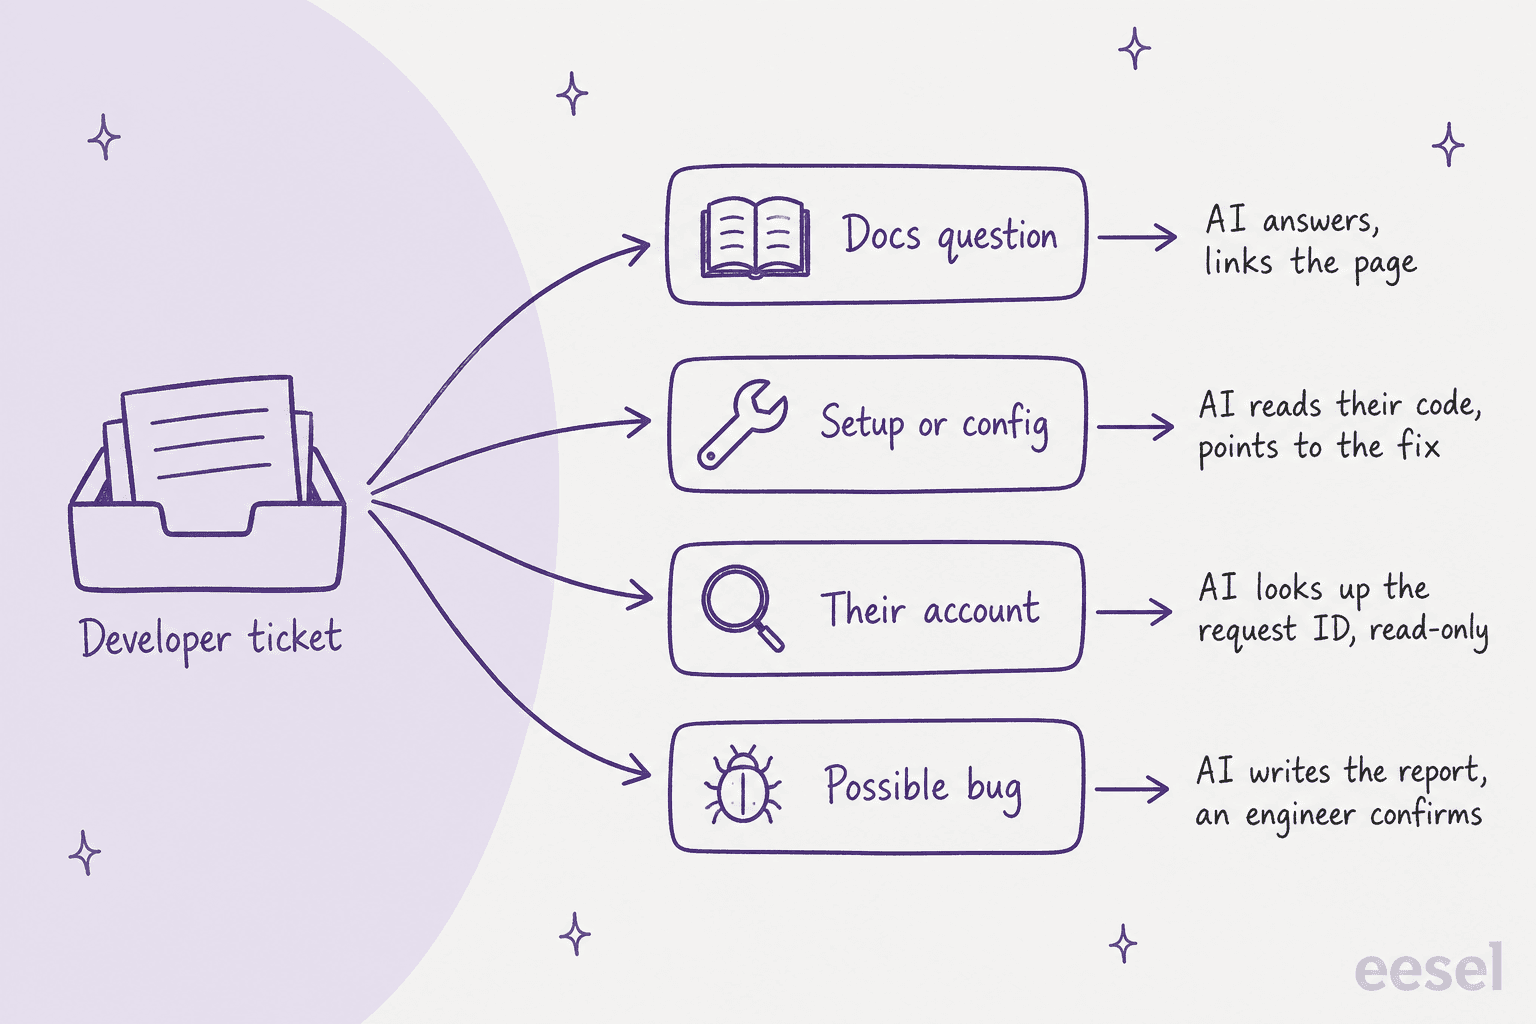
| Tickettyp | Beispiel | Was die KI tun sollte | Was angebunden sein muss |
|---|---|---|---|
| Doku-Frage | "Wie hoch ist das Rate Limit bei /search?" | Antworten und die Seite verlinken | API-Referenz, SDK-Docs, Changelog |
| Setup oder Konfiguration | "401 nach Key-Rotation mit Node SDK 2.4" | SDK-Version und Request-ID erfragen, nie den Key, dann auf die wahrscheinliche Lösung verweisen | Doku, Changelog, frühere Tickets |
| Ihr Konto | "invoice.paid-Webhook nie angekommen" | Das Zustellprotokoll schreibgeschützt abfragen und erklären, was passiert ist | Eine Abfrage in Ihre eigene API oder Admin-Tools |
| Möglicher Bug | "/search liefert seit 9 Uhr nur in der EU-Region 500" | Bekannte Probleme und Status prüfen, den Bericht schreiben, an einen Engineer übergeben | Bekannte Probleme, Statusseite, Issue-Tracker |
| Kontoänderung | "Können Sie unser Rate Limit erhöhen?" | Details sammeln, auf die Freigabe einer Person warten | Ein Freigabeschritt |
Die ersten beiden Bahnen sind dort, wo Doku-Bots schon gut sind. Die dritte ist dort, wo die meisten Setups stehen bleiben, weil sie eine Live-Verbindung in Ihre eigenen Systeme braucht. In der vierten stecken die Stunden.
Sortieren Sie selbst ein paar realistisch klingende Tickets:
Wohin gehört dieses Entwickler-Ticket?
Wählen Sie ein Ticket, um zu sehen, in welche Bahn es gehört und was die KI dafür braucht.
Noch nichts gewählt. Beginnen Sie mit einem beliebigen Ticket oben.
Die Antwort steht in Ihrer API-Referenz. Die KI antwortet mit dem Scope-Namen und verlinkt die genutzte Seite, damit der Entwickler sie prüfen kann.
Braucht: API-Referenz und SDK-Docs, regelmäßig gecrawlt.
Sie fragt nach der SDK-Version und einer Request-ID, nie nach dem Key selbst, und prüft dann den Changelog für diese Version sowie frühere Tickets mit demselben Fehler. Test-Key in Produktion ist der übliche Verdächtige.
Braucht: Doku, Changelog, frühere Tickets.
Diese Felder hat wahrscheinlich ein Coding-Assistent erfunden. Die KI vergleicht die Payload Feld für Feld mit Ihrem echten Schema und verlinkt das richtige. Halten Sie es auch als Doku-Signal fest: Hat ihr Tool falsch geraten, ist Ihre Doku für Tools womöglich schwer lesbar.
Braucht: OpenAPI-Spezifikation oder API-Referenz.
Sie ruft Ihr internes Zustellprotokoll für diesen Request auf, schreibgeschützt und auf diesen Kunden begrenzt, und erklärt, was sie gefunden hat: Wiederholungen, den Antwortcode, den ihr Endpunkt zurückgab, wann aufgegeben wurde.
Braucht: eine Abfrage in Ihre eigene API, mit Zugangsdaten, die die KI nie sieht.
Sie prüft bekannte Probleme und die Statusseite, sammelt Region, Endpunkt, Request-IDs und Zeitstempel und legt einen Bericht für das Engineering an. Sie sagt dem Entwickler, dass es geprüft wird, und nennt es nie einen bestätigten Bug.
Braucht: bekannte Probleme, Statusseite, Ihren Issue-Tracker.
Die KI sammelt Tarif, aktuelle Nutzung und den Grund und hält die Änderung dann für eine Person zurück. Alles, was ein Konto oder Geld ändert, wartet auf Freigabe.
Braucht: einen Freigabeschritt bei jeder Schreibaktion.
Warum bringt ein Doku-Bot Sie nur ein Stück weit?
Ein Doku-Bot ist der naheliegende erste Schritt, und ein guter. kapa.ai verbindet zum Beispiel Docs, GitHub-Repos, eine OpenAPI-Spezifikation, Slack-Threads und Zendesk-Tickets, und zu den Kunden zählen OpenAI, Grafana und Netlify. Ein Entwickler, dessen Team es gekauft hat, brachte den Wert schlicht auf den Punkt:
"It's not right all the time, but it is most of the time and, crucially, it shares not just an answer but a link to the docs that led it to that answer. That makes it easier to fact check the LLM."
Dieser Link ist der Kern. Ein Entwickler vertraut einer Antwort, die er prüfen kann, und einer, die er nicht prüfen kann, nicht. Aber drei Dinge verhindern, dass ein Doku-Bot die ganze Queue abdeckt.
Retrieval ist schwieriger, als es aussieht. Der Gründer von kapa.ai, Emil Sorensen, schrieb, dass Doku-Bots "deceptively hard to get right in production" seien, dass das Retrieval stark davon abhängt, wie Ihre Doku in Abschnitte zerlegt und strukturiert ist, und dass man es nur mit Evals abstimmen kann, "lots of them", laut seinem Hacker-News-Kommentar. Wenn ein Anbieter, dessen ganzes Produkt genau das ist, so etwas sagt, glauben Sie ihm, bevor Sie an einem Wochenende selbst etwas bauen.
Versionen driften. Ein Entwickler mit SDK 2.4 braucht die Antwort für 2.4, nicht die für 3.0. Ihre KI braucht den Changelog als Quelle, und Ihre Doku braucht Versionsangaben, die sie lesen kann. Ohne beides gibt sie jedem die neueste Antwort.
Die Doku kennt das Konto nicht. "Warum ist mein Webhook fehlgeschlagen?" hat auf keiner Doku-Seite eine Antwort. Die Antwort steht in Ihren Zustellprotokollen, an die ein Doku-Bot nicht herankommt. Das sind die Bahnen drei und vier, und deshalb setzen Support-Tools für Entwicklerteams (Plain, Pylon, eesel) die KI in die Ticket-Queue mit Zugriff auf Ihre Systeme, nicht nur auf die Doku-Seite.
Was sollte die KI lesen, bevor sie antwortet?
Die Quellen zählen mehr als das Modell. Das würde ich anbinden, grob nach Nutzen sortiert:
- API-Referenz und OpenAPI-Spezifikation. Die maßgebliche Quelle für Endpunkte, Parameter und Fehlercodes. Die Spezifikation ist es, die der KI erlaubt, ein erfundenes Feld zu erkennen.
- SDK-Docs pro Sprache. Installationsschritte, Konfiguration und die Eigenheiten jeder Client-Bibliothek.
- Changelog und Release Notes. So weiß die KI, dass ein Parameter in 2.4 umbenannt oder ein Standardwert in 3.0 geändert wurde.
- Gelöste Tickets. Die Sonderfälle, die niemand dokumentiert hat. Diese Quelle lässt Antworten wie Ihren erfahrensten Engineer klingen. Orosoft richtet seinen Agenten auf etwa 6.100 gelöste Freshdesk-Tickets aus und weist ihn an, gelöste zu bevorzugen, neuere stärker zu gewichten und anzugeben, auf welchem Ticket oder Artikel jeder Entwurf beruht.
- Bekannte Probleme und Status. Damit die KI "wir kennen das Problem" sagt, statt einen Entwickler durch eine Lösung für einen Ausfall zu führen.
- Interne Runbooks. Für Support-Mitarbeitende, nicht für öffentliche Antworten.
Zwei Regeln würde ich von Tag eins an setzen. Erstens: Frühere Tickets sind voller Kundendaten, also schwärzen Sie sie, bevor sie indexiert werden. Die PII-Schwärzung von eesel schickt jedes synchronisierte Ticket durch einen Detektor für fünfzehn Kategorien, darunter Kartennummern und Namen, bevor etwas gespeichert wird, sodass der Agent nie die Originale sieht. Zweitens: Halten Sie die Quellen nach Zeitplan aktuell. Timengo crawlt seine Doku-Seite jeden Montag neu, synchronisiert sein Help Center jeden Sonntagabend und zieht den vollständigen Ticketverlauf monatlich, was in einem Produkt zählt, in dem Zertifikate in einem Dreijahreszyklus ablaufen und eine Erneuerungswelle auf einmal kommt.
Wenn Sie mit einem dünnen Help Center starten, ist mein KI-Wissensdatenbank-Audit der richtige Anfang, und KI-Wissensdatenbank für SaaS behandelt die Struktur.
Wie schlägt KI eine Request-ID nach, ohne Ihre API-Keys zu sehen?
Das ist die Bahn, die aus einer KI mehr macht als eine Doku-Suche und Engineers Zeit spart. Der Entwickler nennt eine Request-ID, die KI schlägt sie in Ihrem System nach und erklärt, was passiert ist. Richtig gemacht, fragt sie dabei nie nach einem Geheimnis und sieht auch keines.
Die Regeln, an die ich mich halten würde:
- Fragen Sie den Entwickler nie nach seinem API-Key. Fragen Sie nach der Request-ID, der SDK-Version und dem Endpunkt. Das reicht zum Nachschlagen.
- Zuerst schreibgeschützt. Die KI kann Zustellprotokolle und Request-Einträge ansehen. Sie kann nichts ändern, bis Sie es erlauben.
- Auf sein Konto begrenzen. Eine Abfrage für einen Kunden sollte nur dessen Datensätze zurückgeben.
- Zugangsdaten bleiben außerhalb der KI. Der Key, der die Abfrage autorisiert, liegt in den Einstellungen, nicht im Prompt.
In eesel heißt das Network Access. Sie erlauben eine Domain, fügen den erwarteten Auth-Header hinzu und sagen dem Agenten in einfachen Worten, wofür die Verbindung da ist, etwa "wenn ein Entwickler eine Request-ID nennt, schlage sie nach und erkläre den Status". Laut Doku bleiben die Zugangsdaten "stay in your settings and are attached to each request by eesel, so the AI never sees them". Unterstützt werden GET, POST, PATCH und DELETE, sodass derselbe Mechanismus eine interne Admin-API oder eine öffentliche wie die Ihres Issue-Trackers erreichen kann, wenn Sie es erlauben.
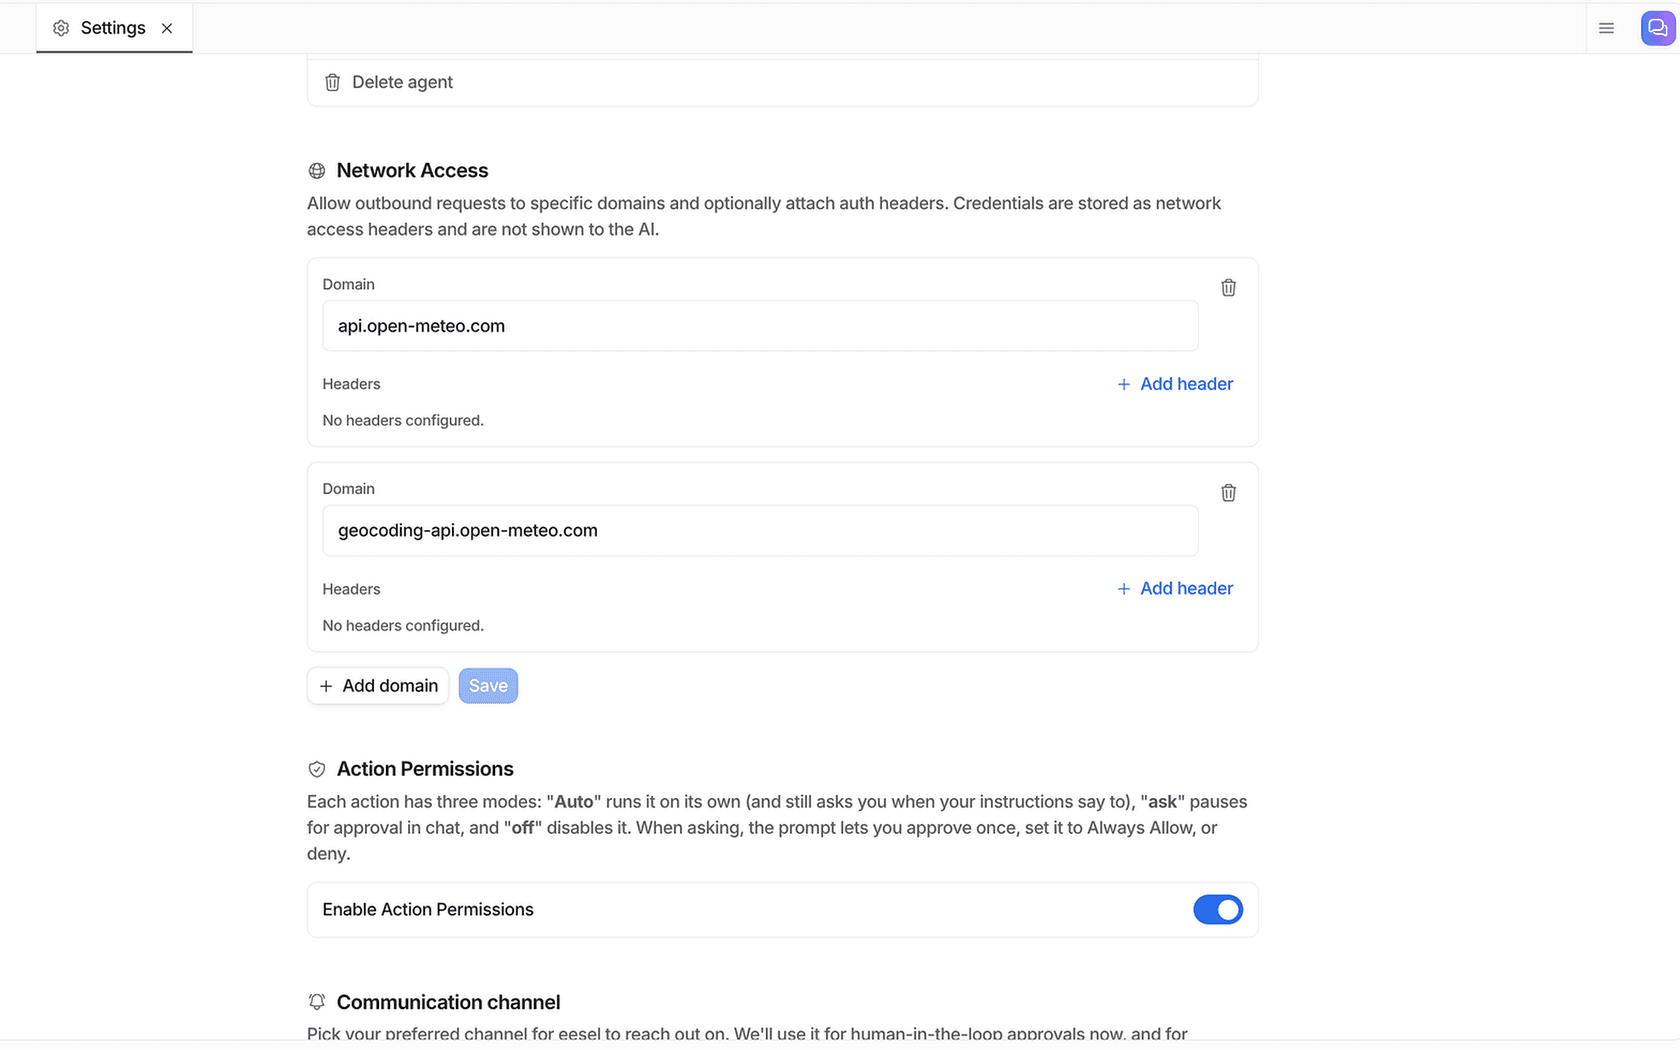
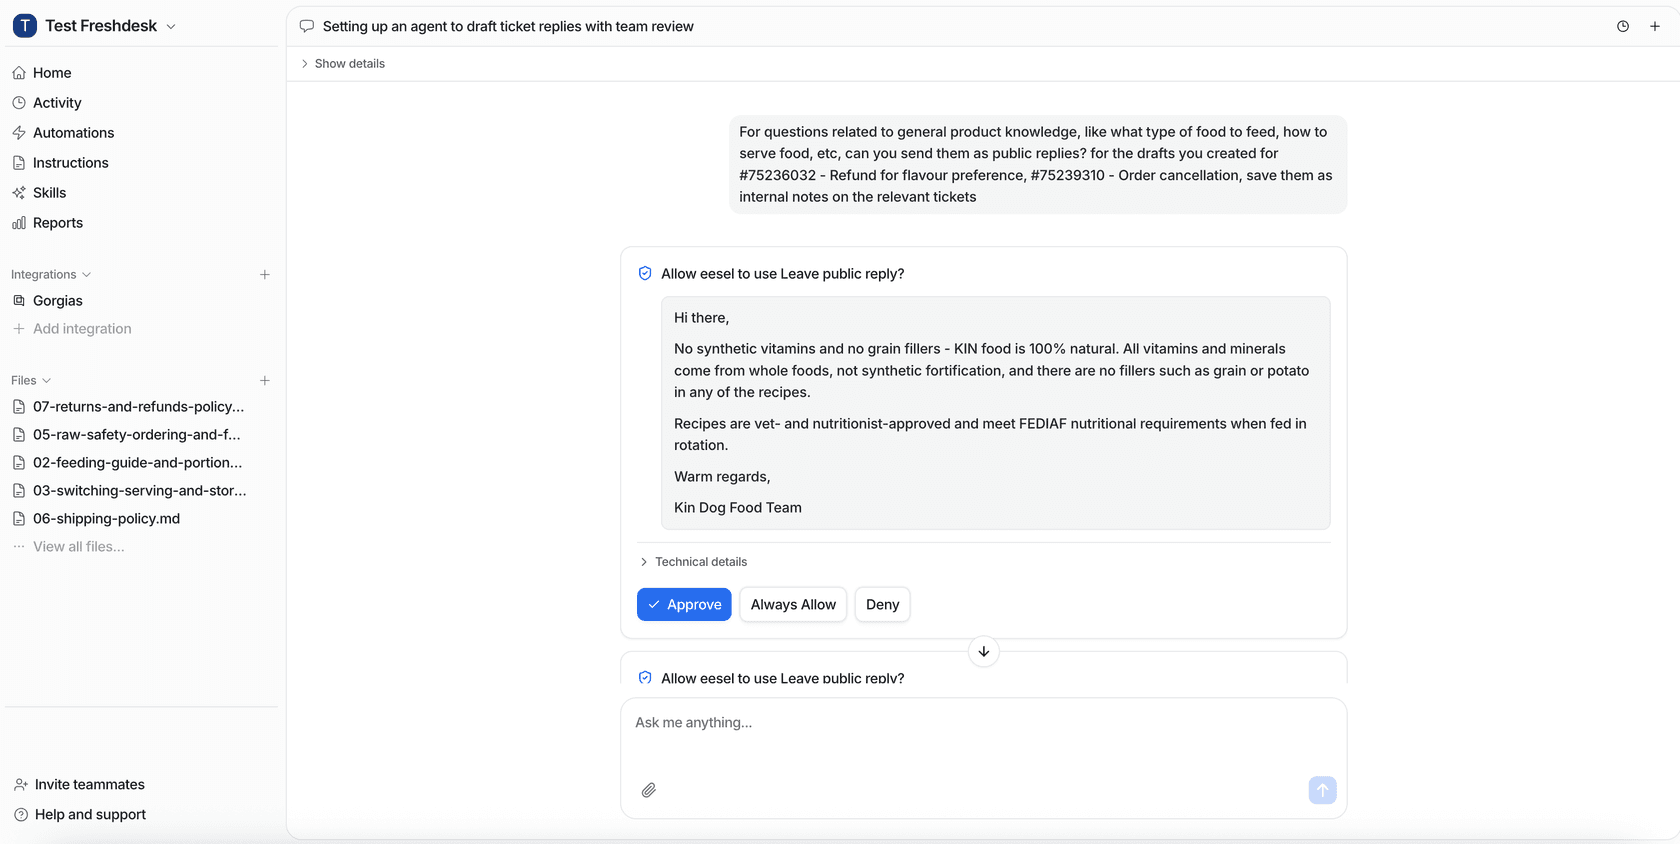
Alles, was einen Zustand ändert, kommt hinter eine Freigabe. Mit den Aktionen und Freigaben von eesel stellen Sie jede Aktion auf Auto, Needs approval oder Disabled. Der Rat der Doku selbst: neue Agenten beaufsichtigt starten und alles, was Geld kostet, hinter eine Freigabe stellen, was für eine API-Firma Änderungen am Rate Limit, Credits und Tarif-Upgrades bedeutet. Freigaben erscheinen im Dashboard, in Slack oder im Terminal.
Wie sollte ein möglicher Bug beim Engineering ankommen?
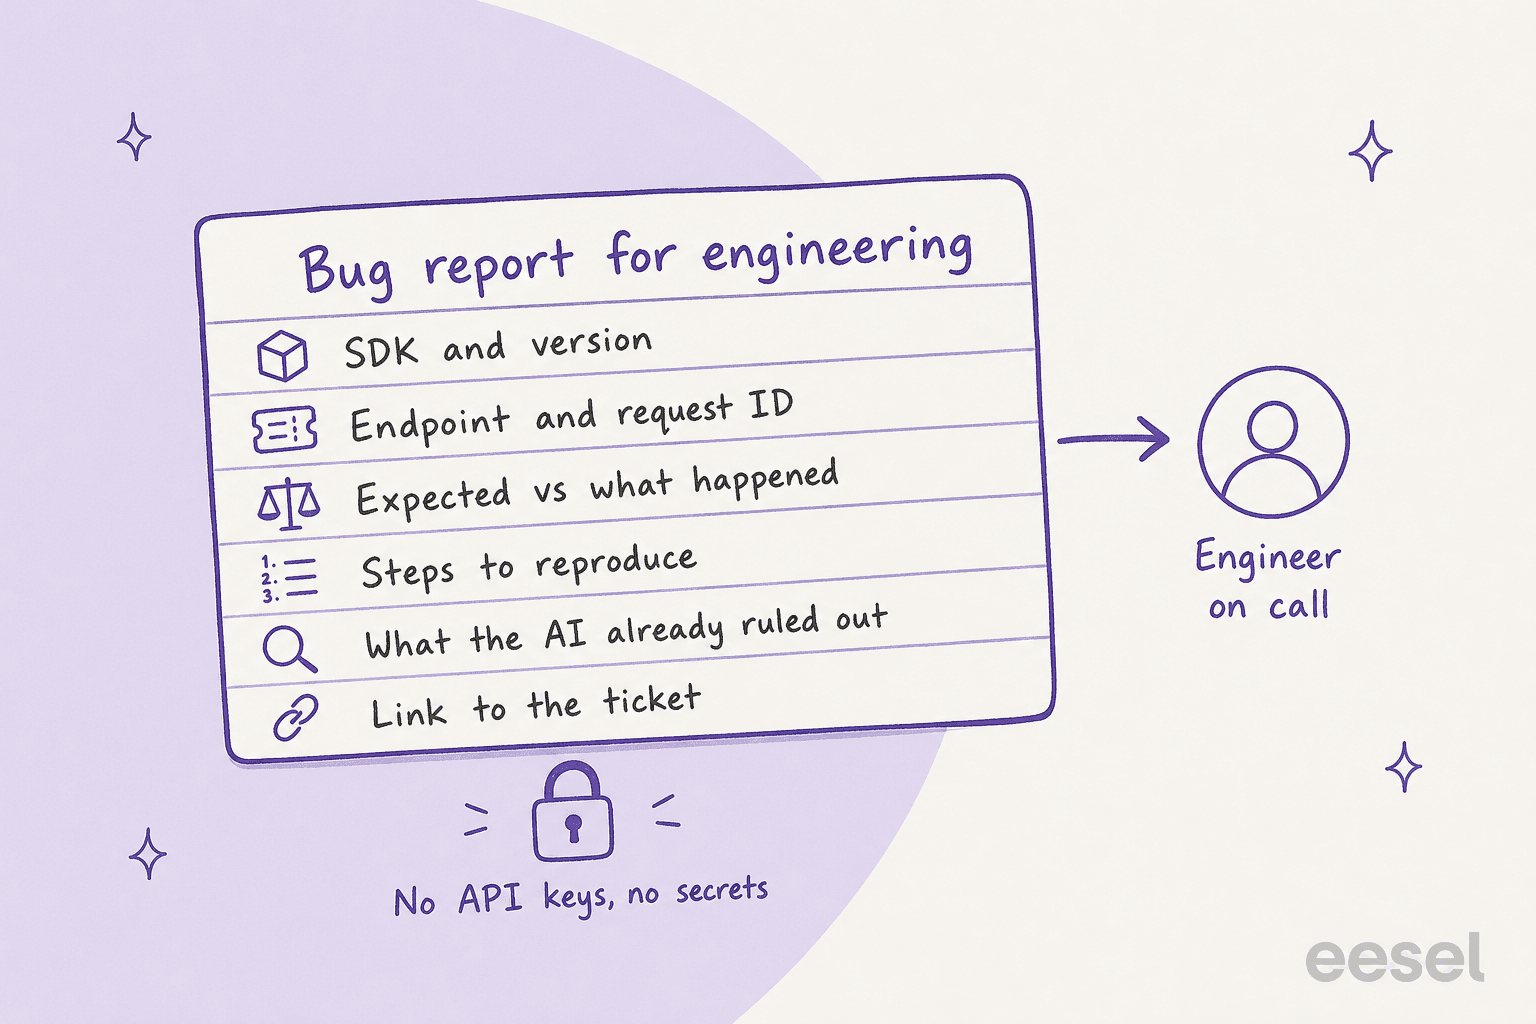
Das schlechteste Entwickler-Ticket, das ein Engineer bekommen kann, ist ein weitergeleitetes mit "Kunde sagt, Webhooks sind kaputt" obenauf. Das beste ist ein Bericht, mit dem er in fünf Minuten arbeiten kann. KI schreibt Letzteres gut, weil sie alles sammeln kann, solange der Entwickler noch im Gespräch ist.
Ein guter Bericht enthält:
- SDK, Sprache und Version, plus API-Version, falls Sie Versionen führen.
- Endpunkt, Request-IDs und Zeitstempel.
- Was der Entwickler erwartet hat und was er bekam, mit dem Fehler-Body.
- Schritte zur Reproduktion, soweit der Entwickler sie liefern kann.
- Was die KI bereits ausgeschlossen hat: bekannte Probleme geprüft, Statusseite geprüft, Konfiguration sah korrekt aus.
- Einen Link zurück zum Ticket.
Und eine Regel über allen anderen: Die KI darf sagen "das könnte ein Bug sein, ich habe es ans Engineering weitergegeben", aber sie sollte einem Entwickler nie sagen, dass etwas ein bestätigter Bug ist. Das ist eine Entscheidung für die Person, die den Code lesen kann.
Wo der Bericht landet, hängt von Ihrem Stack ab. Die Jira-Service-Management-Integration von eesel kann antworten, interne Notizen hinterlassen und Issues verschieben, zuweisen, labeln und anlegen, und Sie können vorgeben, wie ihre Notizen aufgebaut sein sollen. eesel hat keine eingebaute GitHub- oder Linear-Integration. Plain führt Linear-, Jira- und GitHub-Integrationen auf seiner Preisseite, und Pylon listet Coding-Agent-Konnektoren und eigene API-Aktionen.
Wenn Ihr Engineering schon in Jira lebt, geht mein Beitrag zur Eskalation von Zendesk zu Jira tiefer. Ticket-Deduplizierung hilft, wenn ein Ausfall als vierzig Tickets ankommt.
Warum sind falsche Antworten das nützlichste Signal?
Jedes Team, das das aufsetzt, sorgt sich um falsche KI-Antworten, und die wird es manchmal geben. Überrascht hat mich in der Recherche, wie oft eine falsche Antwort sich als Doku-Problem entpuppte. Ein Entwickler auf Hacker News beschrieb, wie sein eigener Doku-Chatbot gelegentlich ein Kommandozeilen-Flag erfand, das es nicht gab:
"So it was considered as product feedback. Maybe that exact flag wasn't needed, but something was missing and so the LLM hallucinated what it saw as an intuitive option."
Das ist der richtige Reflex. Ein erfundener Parameter zeigt Ihnen, wo Ihre Doku eine Lücke lässt, in die auch ein Entwickler fallen würde.
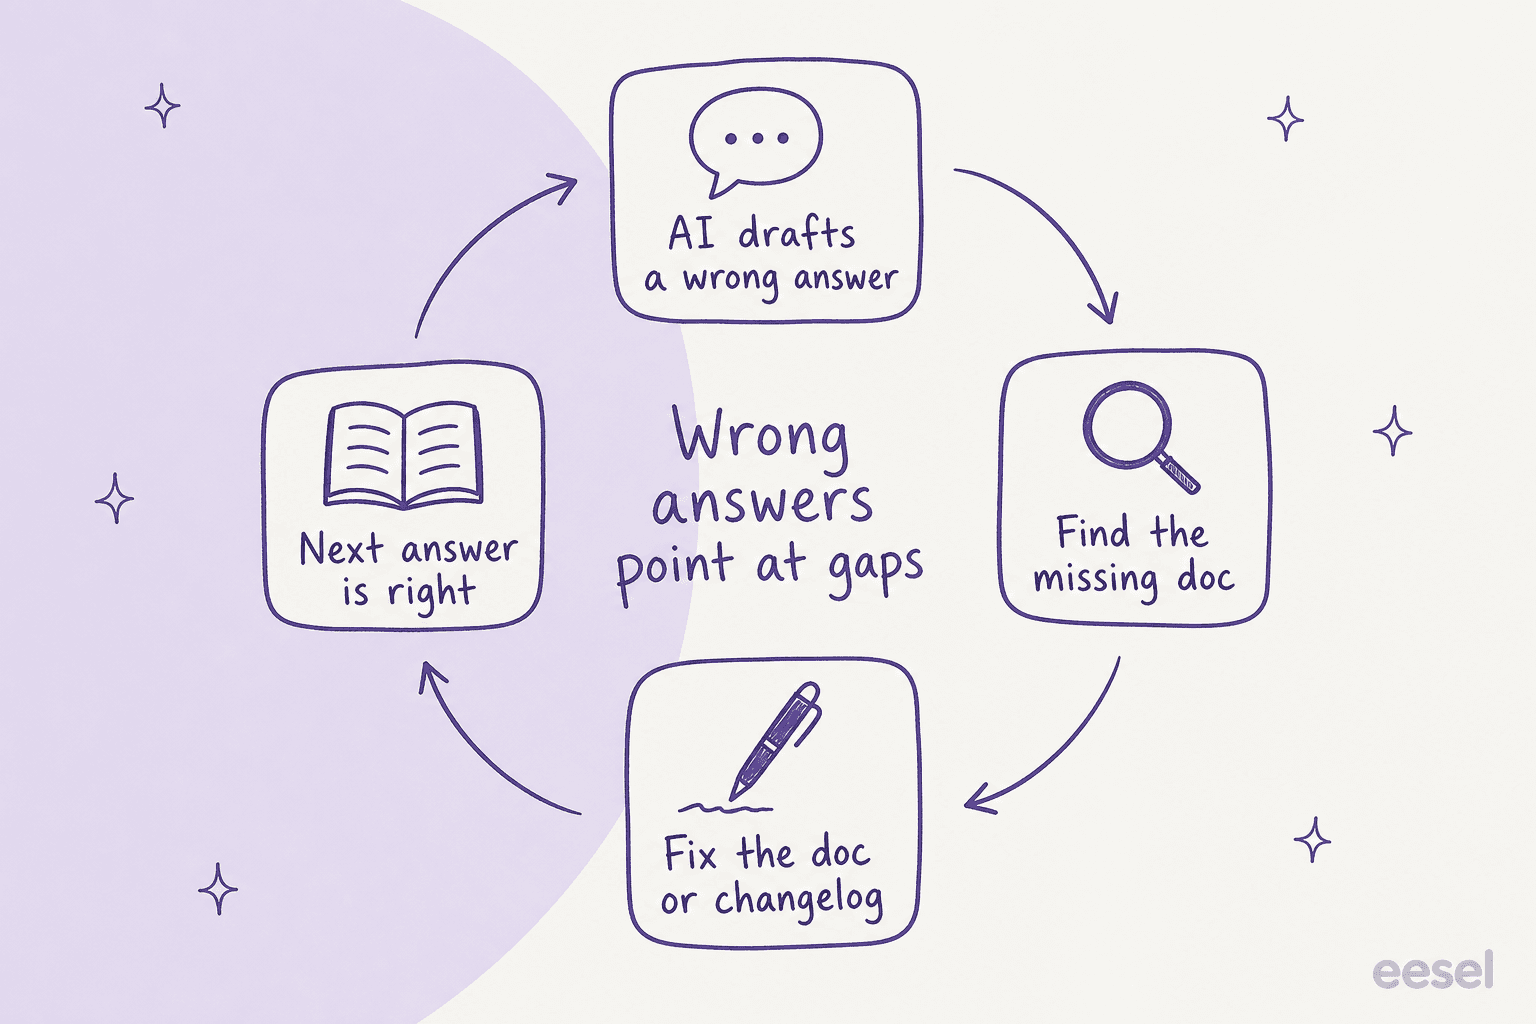
Qontro, das Cloud-ERP-Software verkauft, hat seinen Rollout genau darauf aufgebaut. Jedes Freshdesk-Ticket bekommt einen Entwurf als interne Notiz, gestützt auf das Help Center und etwa 9.800 frühere Tickets und Artikel. Das Team vergleicht jeden Entwurf mit der Antwort, die eine Person tatsächlich gesendet hat, und wo der Entwurf falsch lag, zeigt das meist auf einen fehlenden Hilfeartikel oder eine Regel, die geschärft werden muss. Laut ihrer Geschichte geht inzwischen etwa jeder zehnte Entwurf mit wenig oder gar keiner Bearbeitung raus, Tendenz steigend. Systemfehler, Datenverlust und individuelle Integrationen gehen direkt an eine Person.
Zur Mechanik, Antworten fundiert zu halten, siehe meinen Beitrag zur Vermeidung von KI-Halluzinationen im Support, den Glossareintrag zu AI Grounding und die Analyse von Wissenslücken im Support, um falsche Antworten in ein Backlog zu verwandeln.
Selbst bauen oder ein Tool kaufen?
ChatGPTs Antwort auf diese Frage verwies direkt auf die Agenten-Doku von OpenAI und ein Selbstbau-Setup: eine Retrieval-Schicht, Tool-Aufrufe für Request-Abfragen, Leitplanken und einen Eskalationsschritt. Das ist eine echte Option, wenn Sie Engineers haben, die es betreuen. Was dabei fehlt, ist das, was der Gründer von kapa.ai angemerkt hat: Retrieval-Qualität und Evals sind laufende Arbeit, keine Launch-Aufgabe. Und Sie müssen es trotzdem in Ihren Helpdesk einbinden.
So vergleichen sich die Optionen, die ich mir angesehen habe. Die Preise stammen von der jeweiligen Preisseite des Anbieters, geprüft am 30. Oktober 2026.
| Option | Was es ist | Wo die KI antwortet | Preismodell | Öffentlicher Preis |
|---|---|---|---|---|
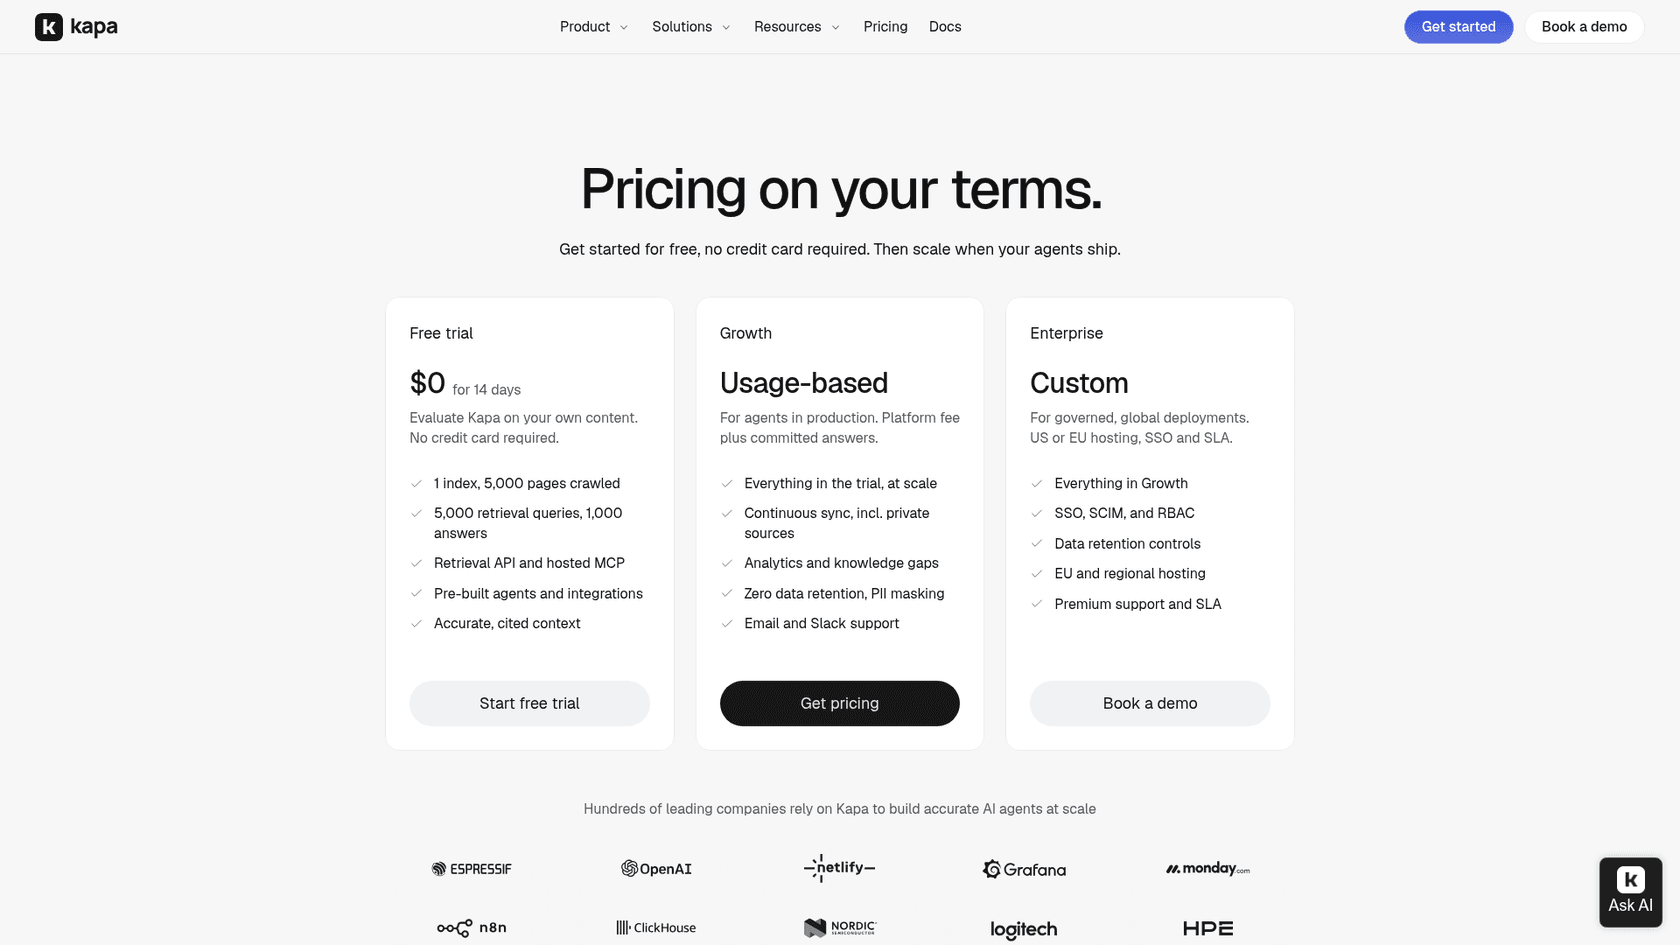
| kapa.ai | Doku-KI und Retrieval-API | Doku-Seite, im Produkt, Support-Formular, Slack, Discord, Zendesk | Plattformgebühr plus zugesagte Antworten | 14 Tage kostenlos testen, danach Growth nur auf Anfrage |
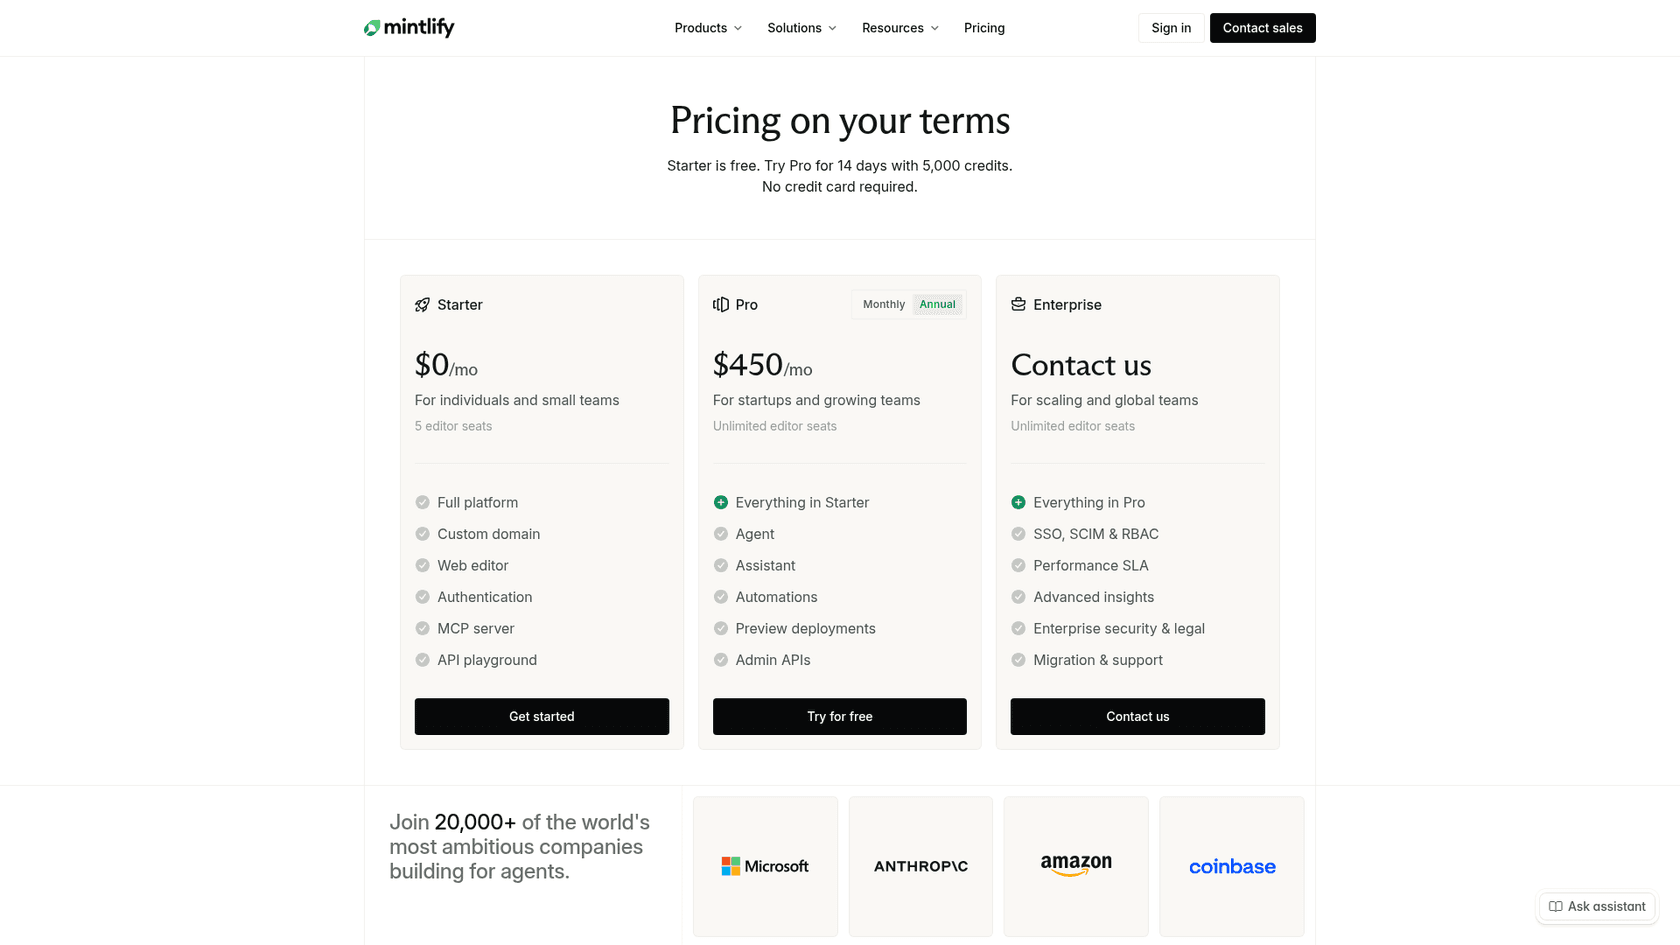
| Mintlify | Doku-Plattform mit KI-Assistent | Ihre Doku-Seite | Tarif plus Credits | Pro 450 $/Monat bei jährlicher Zahlung (540 $ monatlich), 10.000 Credits, 25 Credits pro Antwort |
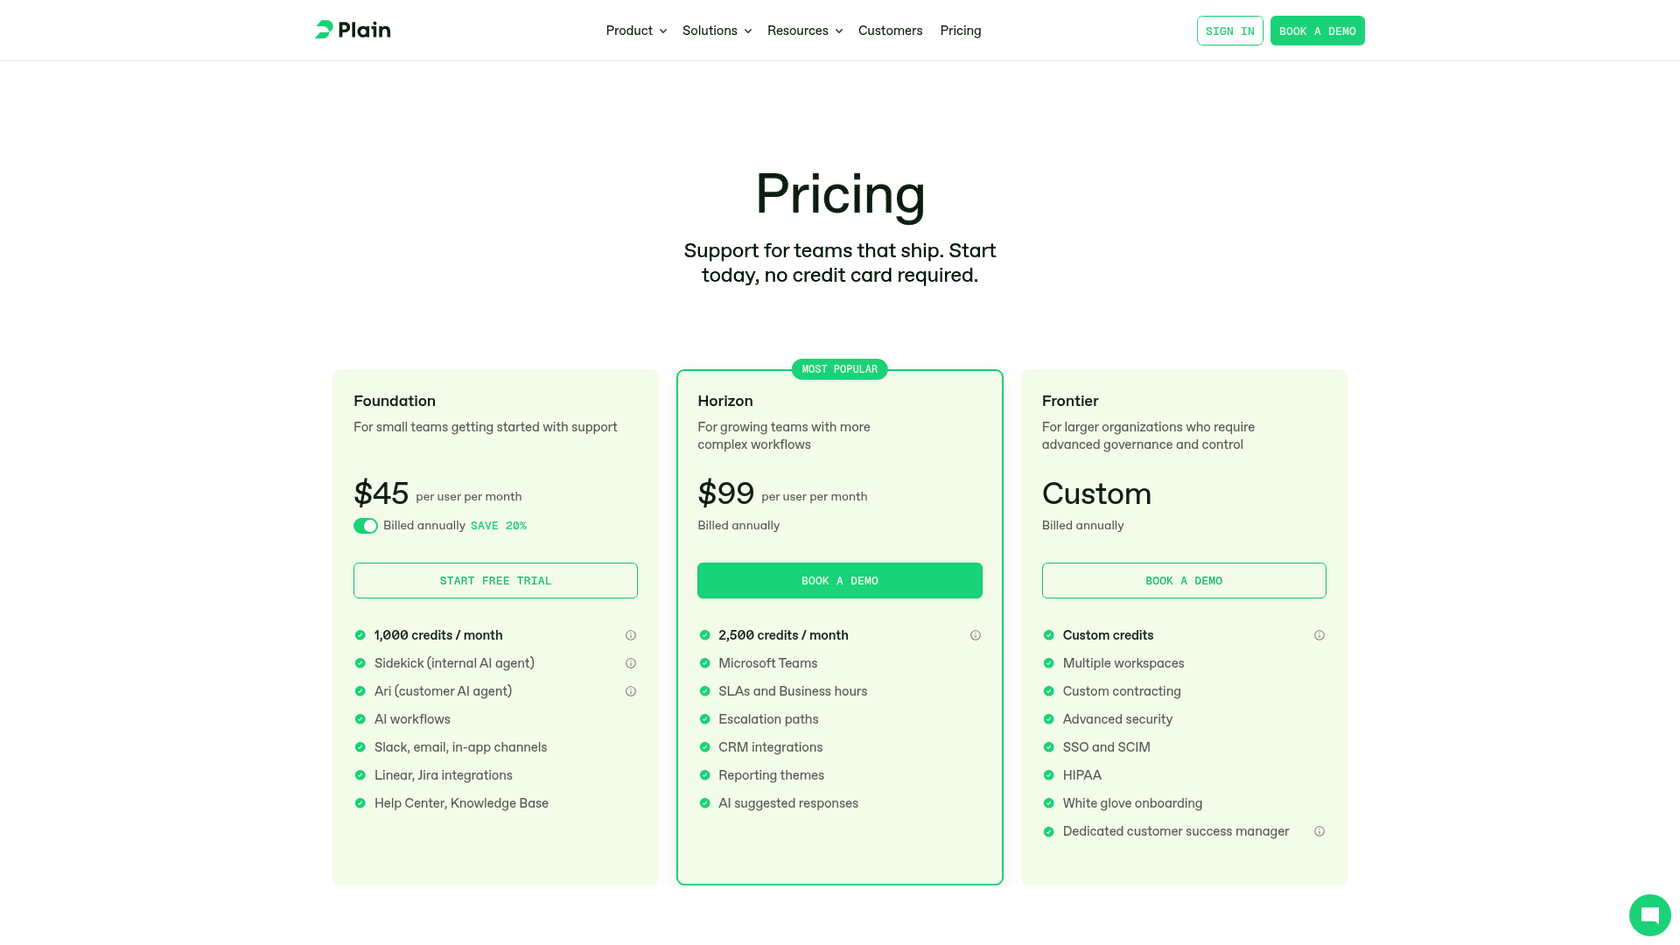
| Plain | Support-Plattform für technische B2B-Teams | Slack, E-Mail, In-App, Chat | Pro Platz plus Credits | Foundation 45 $/Nutzer/Monat jährlich (55 $ monatlich), 100 Credits pro KI-Lösung, +1.000 Credits für 10 $ |
| Pylon | B2B-Support-Plattform | Slack, Teams, E-Mail, WhatsApp | Pro Platz plus Credits | Professional 89 $/Platz/Monat jährlich, Credits je 0,30 $ Pay-as-you-go |
| eesel | KI-Teammitglied in Ihrem bestehenden Helpdesk | Freshdesk, Zendesk, Jira Service Management, Chat, Slack, E-Mail | Feste monatliche Credits | 299 $/Monat für 500 Credits, 1 Credit pro Ticket oder Chat, unbegrenzte Plätze |
| Auf einer Modell-API bauen | Ihr eigener Agent | Wo Sie ihn anbinden | Tokens plus Engineering-Zeit | Hängt von Ihrem Bau ab |
Was kostet es für ein Team?
Preise pro Platz, pro Antwort und pro Lösung lassen sich erst vergleichen, wenn sie für einen Käufer durchgerechnet sind. Nehmen wir also eine API-Firma mit 2.000 Entwickler-Tickets im Monat, drei Support-Mitarbeitenden und KI, die 30 % der Tickets vollständig löst (600), derselbe 30-%-Anteil, den Pylon in seinem eigenen Beispiel verwendet.
| Option | Die Rechnung | Monatliche Kosten |
|---|---|---|
| eesel | 2.000-Credit-Tarif, unbegrenzte Plätze, jedes bearbeitete Ticket zählt | 849 $ |
| Plain (Foundation, jährlich) | 3 Plätze x 45 $ = 135 $, plus 600 Lösungen x 100 Credits = 60.000 Credits, minus 1.000 enthalten = 59.000 x 0,01 $ = 590 $ | Etwa 725 $, vor Sidekick-Entwurfs-Credits für die anderen 1.400 |
| Pylon (Professional, jährlich) | 3 Plätze x 89 $ = 267 $, plus Pylons eigene mittlere Schätzung für 2.000 Tickets von 26.395 $ im Jahr an zugesagten Credits | Etwa 2.467 $ |
| Mintlify (Pro, jährlich) | 450 $ plus 2.000 Doku-Antworten x 25 Credits = 50.000 Credits, minus 10.000 enthalten = 40.000 x 0,01 $ = 400 $ | Etwa 850 $, nur für Doku-Antworten, nicht für Tickets |
| kapa.ai | Nicht öffentlich | Angebot |
Zwei Vorbehalte zu dieser Tabelle. Die Einheiten sind nicht dasselbe: eesel zählt jedes bearbeitete Ticket, entworfen oder beantwortet, während Plains 100 Credits nur für vollständige KI-Lösungen gelten. Und Mintlifys Assistent lebt auf Ihrer Doku-Seite, er senkt also Tickets, bevor sie entstehen, statt die eingehenden zu bearbeiten. Vielleicht wollen Sie beides.
Meine Einschätzung: Wenn Sie früh dran sind und die meisten Tickets Doku-Fragen sind, starten Sie mit dem Doku-Assistenten, den Ihre Doku-Plattform schon anbietet. Wenn Sie bereits Freshdesk, Zendesk oder Jira Service Management betreiben und der Schmerz in der Ticket-Queue liegt, setzen Sie die KI dorthin, statt den Helpdesk zu wechseln. Plain und Pylon ergeben am meisten Sinn, wenn Sie ohnehin einen neuen Helpdesk wählen, besonders wenn Ihre Entwickler in Slack leben. Überblicke über das weitere Feld finden Sie in beste KI für SaaS-Support und bester Chatbot für Entwickler.
Wie führen Sie es ein, ohne das Vertrauen der Entwickler zu verspielen?
Entwickler verzeihen "ich weiß es nicht, ich gebe das an einen Engineer weiter". Eine selbstsichere falsche Antwort zu ihrer Produktionsintegration verzeihen sie nicht. Führen Sie es also in dieser Reihenfolge ein:
- Nur Entwürfe, bei jedem Ticket. Die KI schreibt einen Entwurf oder eine interne Notiz, eine Person sendet. So läuft es bei Timengo: In einem Monat bereitete eesel etwa 300 Freshdesk-Tickets vor, schrieb etwa 180 Antwortentwürfe und etwa 260 interne Notizen und sendete nie von selbst eine Antwort.
- Fundiert oder gar nicht. Weisen Sie sie an, die genutzte Doku oder das Ticket zu nennen und eine Notiz zu hinterlassen, die eine Person anfordert, wenn nichts eine Antwort stützt. Orosofts Agent macht genau das.
- Entwürfe mit dem Gesendeten vergleichen. Korrigieren Sie die Doku dort, wo der Entwurf falsch lag, wie Qontro es tut.
- Abfragen hinzufügen. Binden Sie schreibgeschützten Zugriff auf Request- und Webhook-Logs an, sobald die Doku-Antworten zuverlässig sind.
- Enge Themen automatisch laufen lassen. Rate Limits, Scopes, SDK-Installationsschritte. Bugs, Kontoänderungen und alles mit Geld bleiben bei einer Person.
Für den Zeitplan hat meine Zeitleiste zur Einführung von KI-Support realistische Zahlen, KI-Support-Simulationstests behandelt das Testen an früheren Tickets vor dem Go-live.
Ein Sicherheits-Review lohnt sich, bevor Sie einer KI Zugriff auf Produktionssysteme geben. Wann an eine Person übergeben wird, steht in den Best Practices für die Übergabe an Menschen.
Können Engineers es vom Terminal aus einrichten?
Für eine API-Firma ist das wichtig. Die eesel CLI führt denselben Agenten, den Sie im Dashboard sehen, vom Terminal aus aus, und jeder Befehl gibt JSON aus, sodass auch ein Coding-Agent wie Claude Code, Cursor oder Codex ihn steuern kann. npx @eesel/cli init chat-bubble --site https://your-site.com richtet ohne Konto eine Chat-Bubble ein, eesel files upload fügt ein Dokument hinzu, eesel chat "how do I verify a webhook signature?" testet eine Antwort, und eesel approvals approve <id> gibt eine zurückgehaltene Aktion frei. Für CI oder einen Server liest sie EESEL_API_URL und EESEL_API_TOKEN statt eines Browser-Logins. eesel funktioniert außerdem als MCP-Server für Claude Code und andere MCP-Clients, praktisch, wenn Ihre Engineers das Wissen des Agenten lieber im selben Tool aktualisieren, in dem sie die Doku schreiben. Hintergrund zur Idee steht in meinem Beitrag zu KI-Agent-MCP-Servern.
eesel für Entwickler-Support testen
Wenn Ihre Entwickler-Tickets in Freshdesk, Zendesk oder Jira Service Management landen, stößt eesel zu dieser Queue wie ein neuer Support-Engineer, der Ihre Doku, Ihren Changelog und jedes gelöste Ticket schon gelesen hat. Es entwirft die Doku- und Setup-Antworten mit verlinkter Quelle, schlägt Request- und Webhook-Einträge über Ihre eigene API nach, ohne je den Key zu halten, und hinterlässt dem Engineering einen Bug-Bericht statt einer weitergeleiteten Beschwerde.
Timengo betreibt seinen technischen Support auf Dänisch auf diese Weise, wobei ein Engineer jede Antwort sendet.
Tarife beginnen bei 299 $ im Monat für 500 Tickets oder Chats, mit unbegrenzten Plätzen, und es gibt eine kostenlose Testphase mit 100 Credits. Testen Sie eesel an den Tickets des letzten Monats und sehen Sie, welche Entwürfe Ihr Team gesendet hätte.