

KI für die Kommunikation bei Major Incidents funktioniert, wenn Sie ein verifiziertes Incident-Protokoll führen und jeden Kanal daraus antworten lassen: die Statusseite, die Ticket-Antworten, das Makro Ihrer Agenten, die E-Mails an Großkunden und den internen Kanal. Die KI entwirft jedes Update, eine benannte Person (Ihr Incident Lead oder Comms-Verantwortlicher) gibt alles Öffentliche frei, und alle 30 Minuten geht ein Update raus, das Ziel, das incident.io vorgibt für Major Incidents.
Die KI, die Tickets selbstständig beantwortet, sollte nur Tickets anfassen, die einem erklärten Incident zugeordnet sind, und nur mit Worten aus dem letzten freigegebenen Update. Keine erfundenen ETAs, keine Ursachen-Vermutungen, kein „Ihre Daten sind sicher“. Planen Sie dann die zweite Welle nach der Behebung ein: „Ist es wirklich behoben?“-Antworten, Berichtsanfragen und SLA-Gutschriften.
Ich baue die Helpdesk-Integrationen von eesel, und der KI-Helpdesk-Teammate, an dem ich arbeite, macht das in Zendesk, Freshdesk und Gorgias: Er taggt Ausfall-Tickets, schreibt Antworten aus dem freigegebenen Update und übergibt Ausfälle und Datenverlust direkt an einen Menschen, so wie Qontro es auf Freshdesk betreibt. Die Pläne starten bei 299 $ im Monat für 500 Credits.
Warum hören Kunden bei einem Ausfall Unterschiedliches?
Weil jede Person aus dem antwortet, was sie gerade weiß, und alle Unterschiedliches wissen. Ein Agent bei Ticket #4012 hat die Statusseite vor zehn Minuten gelesen. Ein Account Manager hat etwas in einem Slack-Thread gehört. Ein Engineer hat einem Großkunden gesagt: „Sollte in einer Stunde behoben sein.“ Die Statusseite selbst hat sich seit dem ersten Post nicht bewegt. Niemand lügt. Sie antworten nur aus unterschiedlichen Momentaufnahmen.
Das Freshdesk-Hilfecenter beschreibt es gut. In seiner Anleitung zu verknüpften Tickets steht, dass bei Ausfällen verschiedene Kunden in unterschiedlichen Abständen Updates bekommen, „based on the persistence of the customer and the workload of the agent.“ Wer viermal mailt, bekommt vier Updates. Wer einmal mailt, bekommt Schweigen.
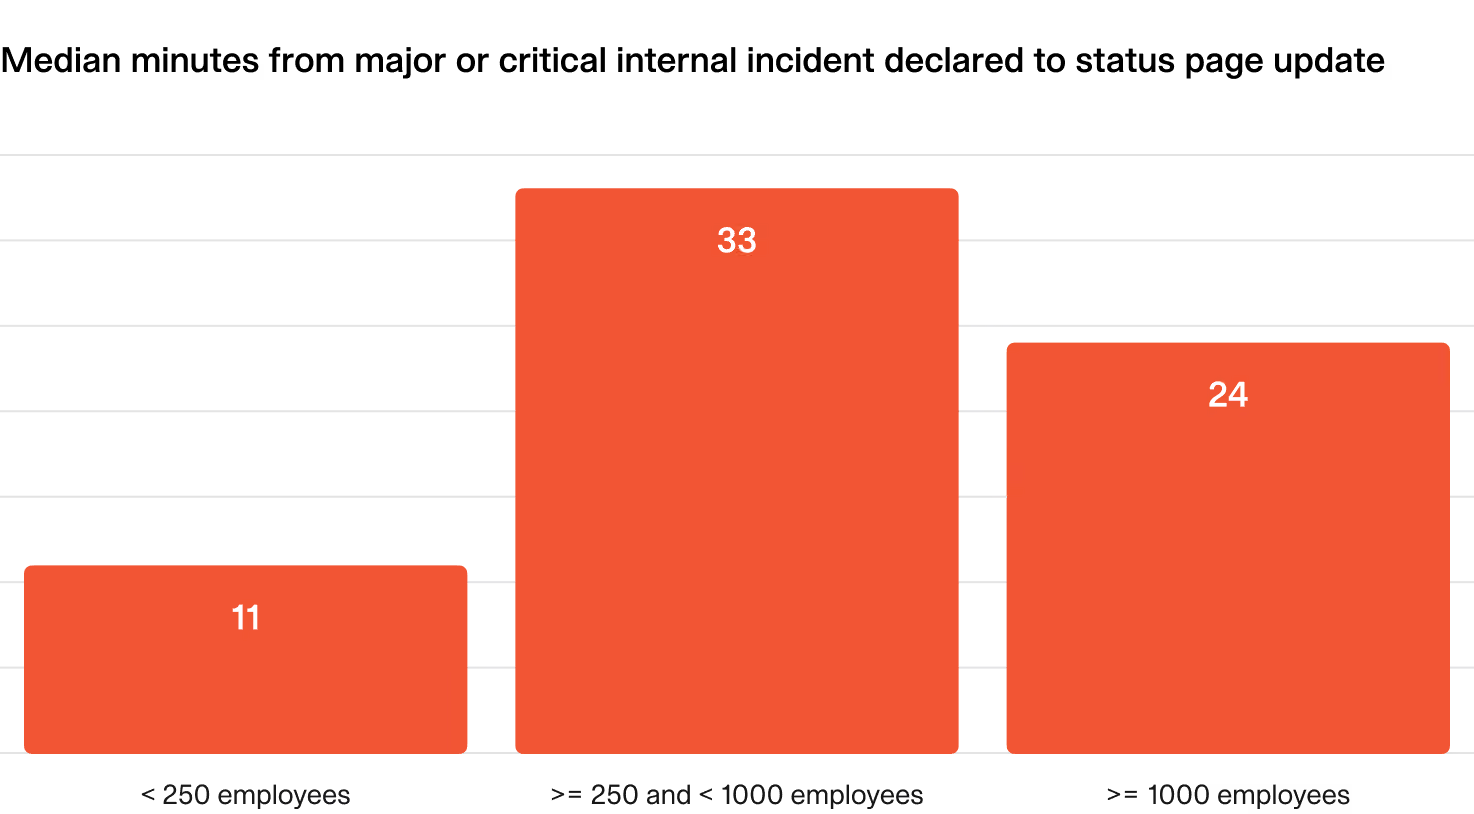
Das langsame erste Update verschärft es. Der Good-Incident-Management-Report von incident.io fand, dass Unternehmen mit 250 bis 1.000 Mitarbeitenden im Median 33 Minuten von der Erklärung eines Major Incidents bis zum ersten Statusseiten-Post brauchten, langsamer als kleinere und größere Unternehmen. In dieser halben Stunde häufen sich die Tickets, und die Geschichten laufen auseinander.
Auch die Leute, die den Incident betreuen, spüren es von innen. Ein SRE bat auf Reddit genau darum um Hilfe:
"When stuff is finally resolved, I have to parse through slack to see what happened when, ignore the "what's the status" slacks sent by 15 different random people, build a timeline with my investigation steps, etc."

Die Lösung ist also nicht „schneller schreiben“. Sie besteht darin, allen einen Ort zum Lesen zu geben und die KI die Umformulierung für jede Zielgruppe übernehmen zu lassen. Ich würde außerdem meinen Leitfaden zu KI-Support bei SaaS-Ausfällen neben diesem lesen: Dieser Beitrag behandelt die Ticketflut, mein Leitfaden zu KI für Statusseiten-Updates die Statusseite selbst, und dieser hier, was Sie auf jedem Kanal sagen und wer es sagt.
Woraus sollte jeder Kanal antworten?
Aus einem Incident-Protokoll in einfachen Worten, das eine Person besitzt und aktualisiert. Nicht aus dem Engineering-Slack-Kanal, nicht aus dem War-Room-Call, nicht aus dem Gedächtnis von jemandem. Beschränken Sie es auf vier Felder:
- Was betroffen ist: die Produktbereiche, Regionen oder Kundengruppen, in den Worten Ihrer Kunden („Checkout in der Web-App“), nicht in Dienstnamen („payments-api-v2“).
- Verifizierte Fakten: nur das, was Engineers bestätigt haben. „Einige Kartenzahlungen schlagen fehl“ ist ein Fakt. „Ein fehlerhaftes Deployment hat es verursacht“ ist eine Vermutung, bis es jemand bestätigt.
- Was wir tun: eine Zeile. „Wir rollen das Release von 14:10 zurück“ reicht.
- Nächstes Update um: eine Uhrzeit, jedes Mal.
Dieses Protokoll kann in Ihrem Incident-Tool leben (incident.io, PagerDuty, Jira Service Management) oder auf der Statusseite selbst. Wo es liegt, ist weniger wichtig als die Regel, dass jede Nachricht an irgendjemanden aus ihm neu geschrieben wird, nie aus einem Nebengespräch.
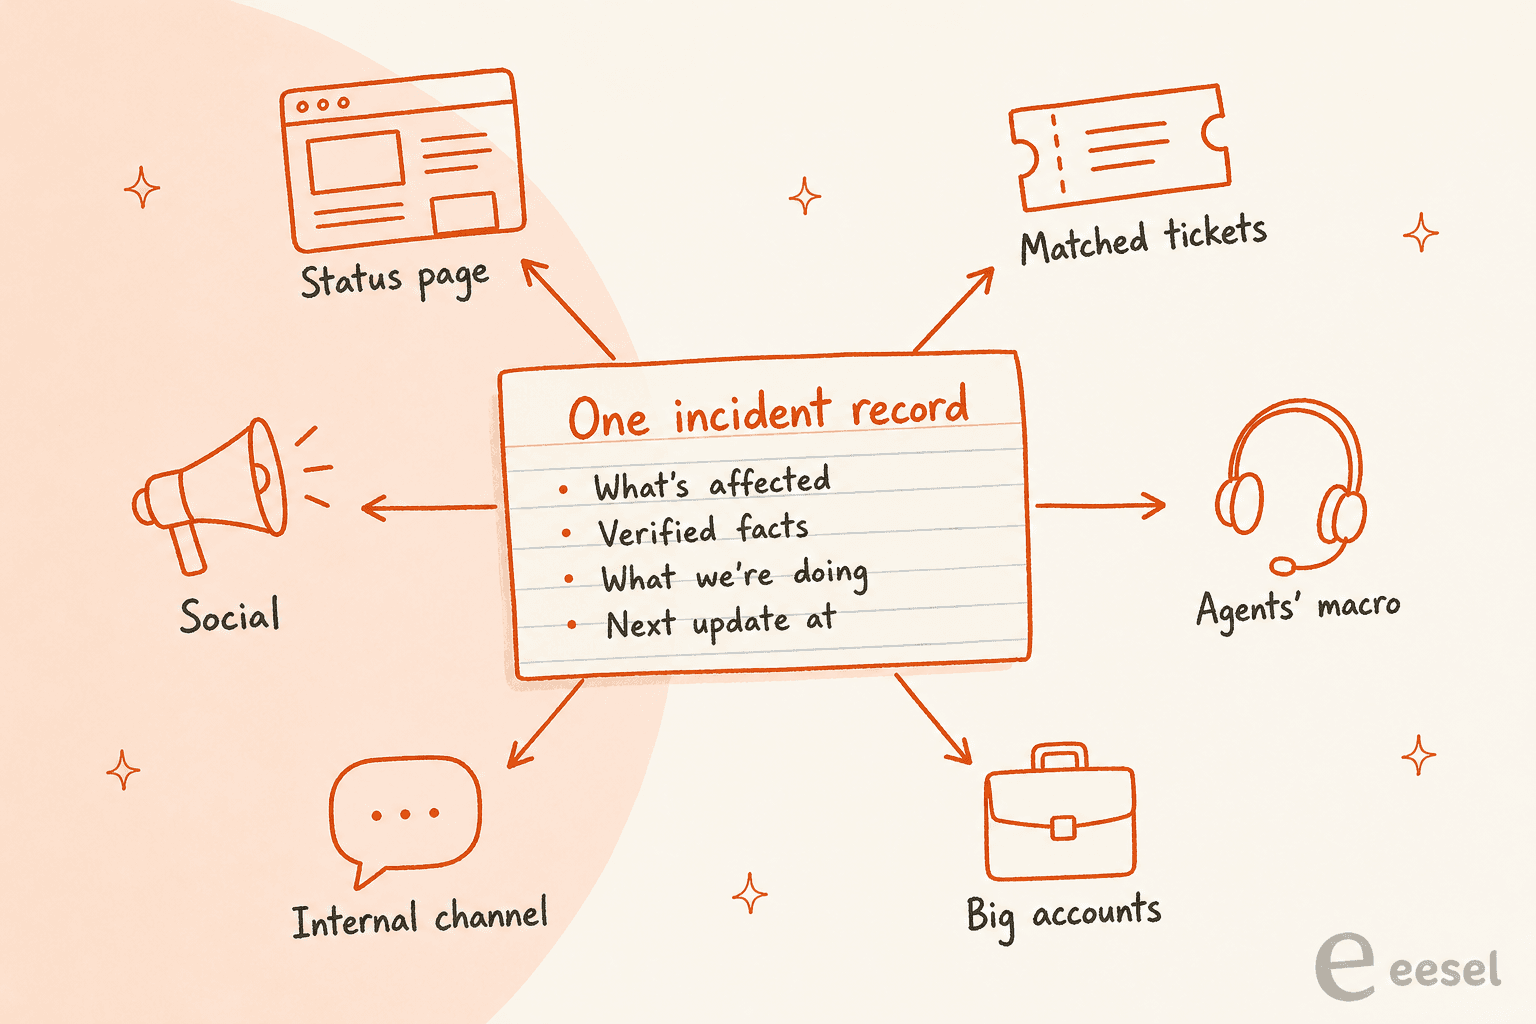
Die Pfeile zeigen absichtlich nur nach außen. Meldet ein Kunde in einem Ticket etwas Neues („es ist auch auf dem Handy kaputt“), geht das an den Comms-Verantwortlichen, der es prüft und ins Protokoll aufnimmt. Es springt nicht direkt in die Antwort an einen anderen Kunden. Diese eine Regel verhindert, dass Kanal Nummer sechs von Kanal Nummer eins abdriftet.
Wer verantwortet die Incident-Kommunikation, und wo passt die KI hin?
Eine Person, die das Problem nicht selbst behebt. Engineers, die in Produktion debuggen, sollten keine Entschuldigung formulieren. Das kam immer wieder vor, als ich nachlas, wie Betreiber damit umgehen:
"Someone not directly working the incident owns comms. gets updates from the team, tracks timelines, and updates the dedicated status page/notification channels."
Der Report von incident.io gibt denselben Rat in einfacheren Worten: „Assign communications roles“, damit klar ist, wer die Statusseiten-Updates verantwortet. Die KI sitzt unterhalb dieser Person, nicht neben ihr. Sie macht aus dem Protokoll fünf Versionen für fünf Zielgruppen, und der Comms-Verantwortliche liest und gibt frei. Das ist Human in the Loop in seiner einfachsten Form, und der eigene Kommunikationsleitfaden von incident.io zieht dieselbe Linie: KI sollte beim Entwerfen helfen, statt externe Nachrichten ohne Prüfung durch eine Person zu versenden.
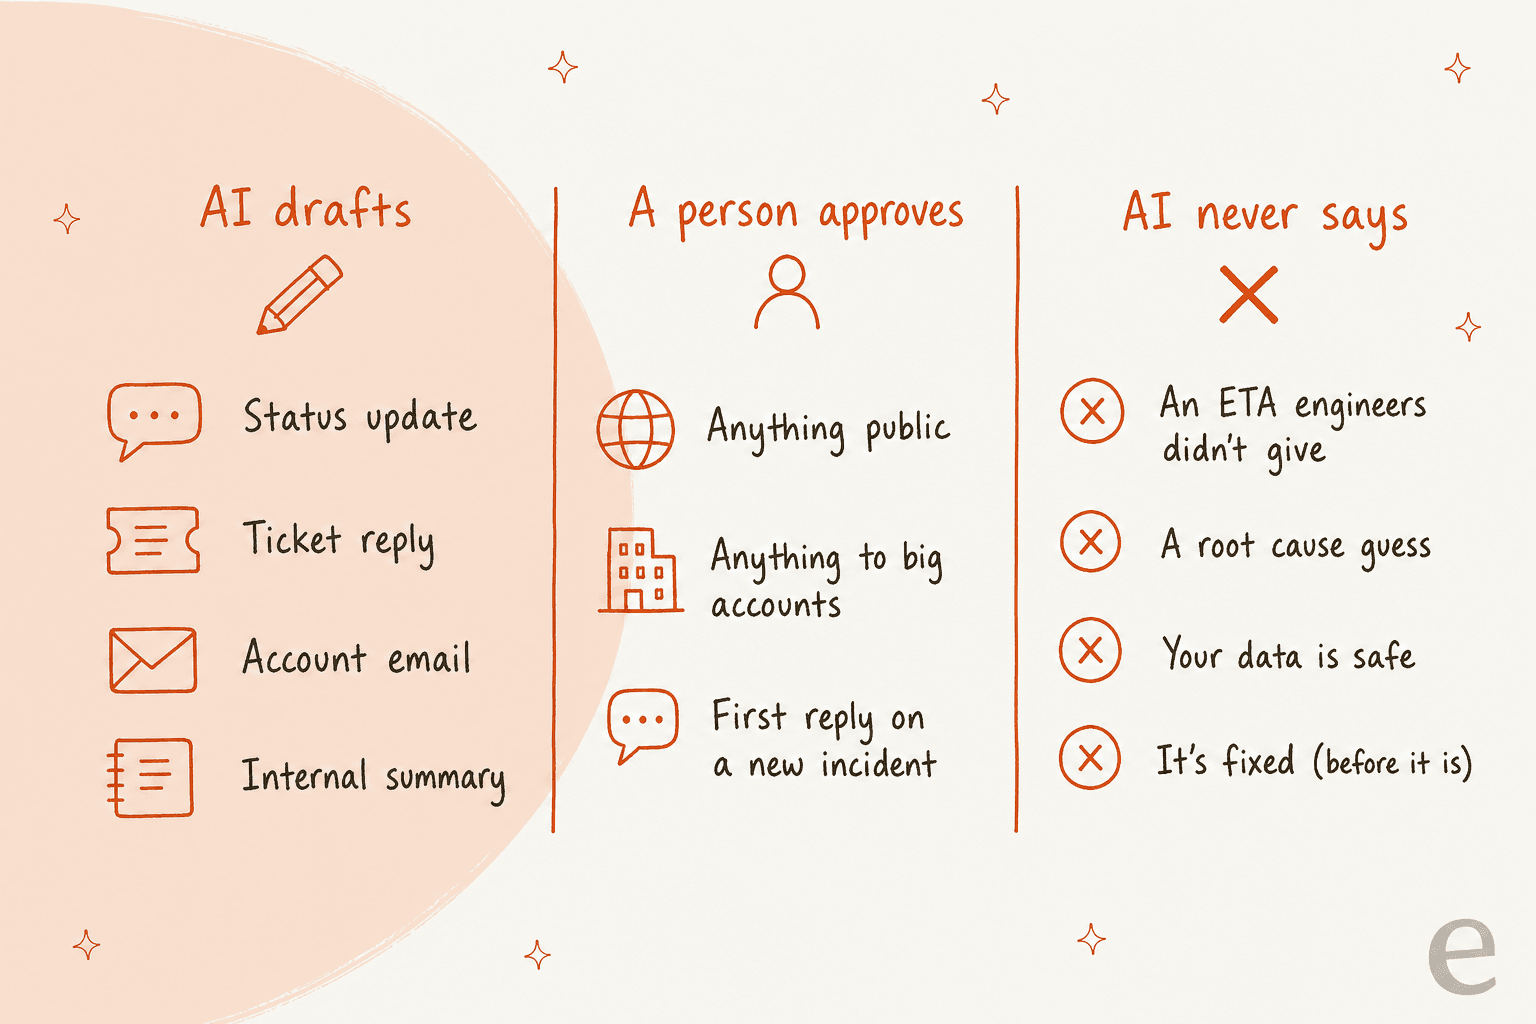
Die rechte Spalte würde ich ausdrucken. Jede dieser vier Zeilen ist ein Satz, den ein Sprachmodell gern schreibt, wenn der Prompt nur etwas nachhilft, denn es sind genau die Dinge, die ein besorgter Kunde hören will. Eine KI-Halluzination in einem normalen Ticket kostet einen Kunden. Derselbe Satz in einer Incident-Antwort geht an Hunderte gleichzeitig, und er ist die Zeile, von der sie später einen Screenshot machen.
Wie oft sollten Sie Incident-Updates senden?
Bei einem Major Incident alle 30 Minuten, auch wenn sich nichts geändert hat. Das ist das Ziel im Report von incident.io, der sagt: „aim to share status page updates every 30 minutes during major and critical incidents.“ Seine Daten zeigen, dass die meisten Teams nahe daran landen.
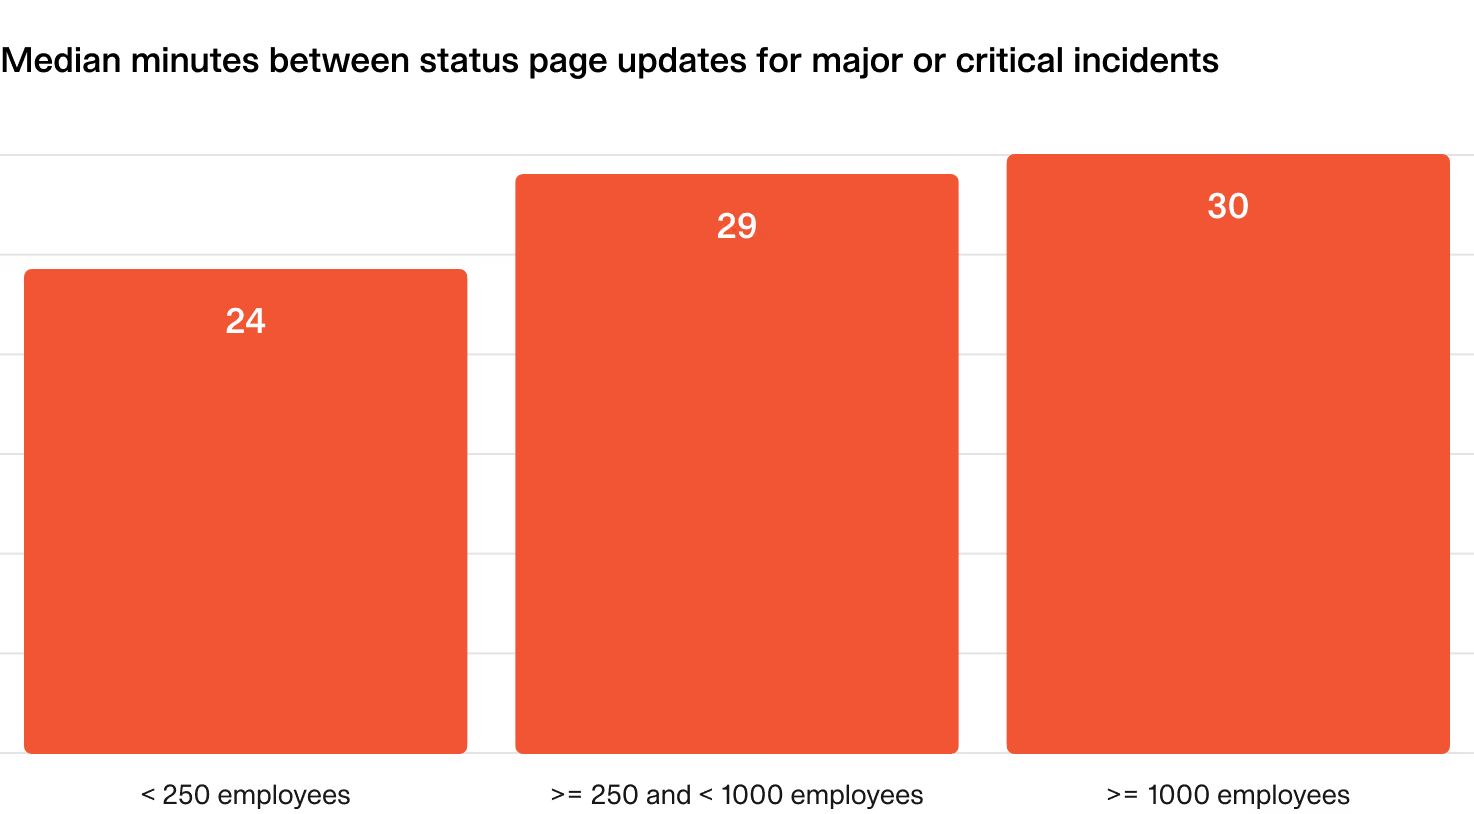
Der Leitfaden von incident.io nennt das leere Update die „Heartbeat“-Regel: „We're still investigating. No new information. Next update in 30 minutes.“ Es wirkt wie nichts, leistet aber echte Arbeit. Ein Kunde, der weiß, dass das nächste Update um 15:30 kommt, eröffnet um 15:20 kein Ticket. Der Kommunikationsleitfaden empfiehlt, den Rhythmus nach Schweregrad zu staffeln: alle 20 bis 30 Minuten bei SEV1, alle 4 Stunden bei SEV2 und Updates zu Geschäftszeiten bei SEV3.
Das ist die einfachste Aufgabe für die KI. Das Heartbeat-Update ist langweilig, es ist das, das Leute in Minute 45 eines schlimmen Incidents vergessen, und es birgt fast kein Risiko, weil es nichts Neues sagt. Lassen Sie die KI es aus dem Protokoll entwerfen und den Comms-Verantwortlichen erinnern, wenn es fällig ist. Der Plan unten zeigt, was jeder Schweregrad braucht, damit Sie sich vor dem nächsten Incident einigen können statt währenddessen.
Wie halten Sie Agenten und die KI auf demselben Skript?
Geben Sie dem Support Desk dieselben Worte wie der Statusseite und machen Sie es leicht, jedes Ticket zum Incident zu finden. Beide großen Helpdesks haben die Technik für den zweiten Teil bereits. Was sie damit jeweils tun, ist im Detail wissenswert, denn ich habe erlebt, dass Teams mehr annehmen, als die Funktion tatsächlich leistet.
Zendesk Problem- und Incident-Tickets. In der Zendesk-Dokumentation erstellen Sie ein Problem-Ticket für den Ausfall, setzen den Typ jedes zugehörigen Tickets auf Incident und verknüpfen sie. Wenn Sie das Problem-Ticket lösen, wird jedes verknüpfte Incident-Ticket gelöst, und der Kommentar, den Sie am Problem-Ticket schreiben, wird den noch offenen Incident-Tickets hinzugefügt. Zwei Haken auf derselben Seite: „Customers are not notified using the messaging channel“ und „AI agent tickets can't be linked to problem and incident tickets.“ Läuft also die Hälfte Ihres Ausfall-Traffics über den eigenen Bot von Zendesk, erreicht das Sammel-Schließen ihn nicht. Meine Anleitung zu Incident- und Problem-Tickets behandelt die Einrichtung, und Massen-Statusupdates füllen die Lücken.
Freshdesk verknüpfte Tickets. Freshdesk verknüpft zusammengehörige Tickets mit einem Master-Ticket, dem Tracker. Kommentare am Tracker gehen als Broadcast an jedes verknüpfte Ticket, aber laut Einrichtungsanleitung ist die „internal broadcast message will be visible only to agents of the helpdesk.“ Kunden sehen sie nicht. Jeder Agent sendet die eigentliche Antwort weiterhin selbst. Und das Lösen des Trackers löst die verknüpften Tickets standardmäßig nicht. Verknüpfte Tickets erfordern den Pro- oder Enterprise-Plan.
Diese Lücke füllt die KI gut. Die Helpdesk-Funktion gibt Ihnen eine Liste jedes Tickets zum Ausfall. Die KI macht aus dem neuesten freigegebenen Update eine Antwort auf jedes davon, in der Sprache des Kunden, ohne dass jemand 300 Mal kopiert und einfügt. Auch Tagging zählt hier: Ein Betreiber auf r/sre fasste den Grundgriff zusammen.
"support tools like zendesk allow you to add tags to tickets related to the same issue via a "master" ticket"
Ein Tag wie incident-2026-10-30-checkout an jedem zugeordneten Ticket ermöglicht es, alle später zu schließen, sie für den Post-Incident-Bericht zu zählen und die Kunden zu erkennen, die dreimal geschrieben haben. Wenn Sie KI-Ticket-Tagging noch nicht eingerichtet haben, ist ein Ausfall ein schmerzhafter Moment, um zu merken, dass Sie es brauchen. Dasselbe gilt für die Ticket-Deduplizierung, da Ausfall-Tickets gebündelt von denselben Leuten eintreffen.
Aktualisieren Sie das Makro Ihrer menschlichen Agenten gleichzeitig mit der Statusseite. Ein KI-Makro, das eine Stunde nach dem ausgelieferten Fix noch „wir untersuchen“ sagt, ist der Grund, warum ein Kunde an einem Nachmittag zwei verschiedene Antworten bekommt.
Wann sollte die KI bei einem Incident selbst antworten?
Nur wenn drei Dinge zutreffen: Jemand hat den Incident erklärt, das Ticket passt eindeutig dazu, und die Antwort nutzt Formulierungen, die eine Person bereits freigegeben hat. Fehlt eines davon, entwirft die KI und ein Mensch sendet. Das ist die ganze Regel, und sie deckt fast jeden Fall ab.
So würde ich eingehende Tickets bei einem Major Incident sortieren:
| Das Ticket | Was die KI tut | Warum |
|---|---|---|
| Passt zu einem erklärten Incident | Antwortet mit dem neuesten freigegebenen Update und der Uhrzeit des nächsten Updates, taggt und verknüpft es | Die Worte wurden schon einmal geprüft |
| Sieht nach Ausfall aus, nichts erklärt | Hinterlässt eine interne Notiz und meldet es dem Bereitschaftsteam, bestätigt nichts | Es könnte das erste Zeichen eines echten Incidents sein oder das WLAN eines einzelnen Kunden |
| Von einem Großkunden oder nennt einen Vertrag | Übergibt es mit Zusammenfassung an den Account-Verantwortlichen | Diese Kunden erwarten einen Menschen und einen Eskalations-Weg |
| Meldet Datenverlust, Sicherheitsbedenken oder doppelt abgebuchtes Geld | Direkt an einen Menschen, keine Antwort | Eine falsche Zeile ist hier ein rechtliches Problem |
| Hat mit dem Ausfall nichts zu tun | Normale Queue | Lassen Sie den Incident nicht alles andere verschlucken |
Zwei davon stammen direkt aus echten Setups. Qontro, ein ERP-Unternehmen auf Freshdesk, entwirft eine Antwort auf jedes neue Ticket (190 in einem Monat), schickt aber Ausfälle, Datenverlust und Abrechnungsfragen direkt an einen Menschen, und wenn ein Ticket nicht genug enthält, um sicher zu antworten, sagt der Agent das, statt zu raten. SE Ranking betreibt eesel über 4.650 Zendesk-Konversationen im Monat und taggt jedes Ticket, das es anfasst, mit ai_handled, sodass das Team genau zählen kann, was die KI getan hat. Seine Übergaberegel passt auch gut zu Incident-Tagen: Der Agent sagt Kunden, sie sollen in ein bis zwei Werktagen mit einer Antwort rechnen, und sagt nie, dass sich gleich jemand dazuschaltet.
Dieser letzte Punkt ist für mich eine Narbe. Ich habe bei einem Webhosting-Unternehmen auf Zendesk erlebt, wie ein Bot Kunden sagte, er übergebe sie an einen Menschen, obwohl die Übergabe nie stattfand. Bei einem Ausfall verdoppelt so ein leeres Versprechen den Ärger. Was Ihre KI also über nächste Schritte sagt, muss etwas sein, das Ihr System wirklich tut. Mein Beitrag zu Best Practices für die Übergabe zeigt, wie Sie das testen, bevor Sie es brauchen, und mit Simulationstests können Sie die Ausfall-Tickets des letzten Quartals vorab gegen neue Regeln abspielen.
Noch eine Falle: Incident-Antworten der KI sollten enden, sobald ein Mensch den Thread übernimmt. ClutchLoop betreibt seinen Agenten auf Gorgias genau mit dieser Regel: Antwortet bereits ein Teammitglied in einem Thread, hält sich der Agent raus. Bei Großkunden mit einem Account Manager am Ticket ist das das gewünschte Verhalten.
Was leistet die KI der Incident- und Helpdesk-Tools tatsächlich?
Der Großteil der KI in Incident-Tools richtet sich an die Engineers: Zusammenfassungen, Zeitleisten, Post-Mortems. Weniger Funktionen betreffen Kundennachrichten, und die, die es tun, sind Entwurfs-Tools mit prüfendem Menschen. Hier steht, was die Seiten der jeweiligen Anbieter sagen, mit ihren Preisen.
| Tool | KI für Incident-Kommunikation | Statusseite | Preis (Anbieterseite) |
|---|---|---|---|
| Atlassian Statuspage | Auf der Preisseite keine genannt | Ja, das Kernprodukt | Free (100 Abonnenten), Hobby 29 $, Startup 99 $, Business 399 $, Enterprise 1.499 $ im Monat |
| incident.io | KI-Funktionen wie Scribe und Suggestions, plus ein KI-nativer Post-Mortem-Editor in Pro und Enterprise | 1 öffentliche Seite bei Basic, Team und Pro, Kundenseiten bei Enterprise | Basic kostenlos, Team 19 $ pro Nutzer und Monat, Pro 25 $, plus On-Call 10 bis 20 $ pro Nutzer |
| PagerDuty | AI Status Updates entwirft interne und externe Updates, Einsatzkräfte prüfen vor dem Senden | Externe Seite ab Professional (250 Abonnenten) | Professional 21 $ pro Nutzer und Monat jährlich, KI als Add-on; Starter 2.800 $ im Jahr mit 1.000 KI-Aktionen |
| Jira Service Management | Rovo-Agenten ab Standard; KI-Incident-Erstellung und Entwürfe für Post-Incident-Reviews in Premium | Nur im Enterprise-Plan | Standard 21,50 $, Premium 55,28 $ pro Agent und Monat |
| Zendesk | Copilot (Zusammenfassungen, Zusammenführungsvorschläge, ähnliche Tickets), KI-Agenten werden pro automatisierter Lösung abgerechnet | Nein | Suite Team 55 $, Professional 115 $ pro Agent und Monat jährlich; Copilot 50 $ pro Agent und Monat |
| Freshdesk | Freddy AI Agent (500 Sessions inklusive, danach 49 $ pro 100), Copilot 29 $ pro Agent und Monat | Nein | Growth 19 $, Pro 55 $, Enterprise 89 $ pro Agent und Monat jährlich |
| eesel | Entwirft oder sendet Antworten in Ihrem Helpdesk, taggt und verknüpft Tickets, Freigaben pro Aktion | Nein, liest Ihre | 299 $ im Monat für 500 Credits, ein Ticket ist ein Credit |
Ein paar Details, die mehr zählen als die Preisspalte. Die Dokumentation von PagerDuty sagt, dass AI Status Updates externe Updates nur aus Slack entwerfen kann; in Microsoft Teams und der Web-App sind es nur interne Updates. In Jira Service Management ist „incident stakeholder communication“ (interne und externe Stakeholder einladen und per E-Mail informieren) eine Premium-Funktion, der Standard-Plan enthält sie also nicht. Mehr dazu in meiner Aufschlüsselung der JSM-Preise und im Beitrag zu KI-Post-Incident-Reviews.
Auf der Helpdesk-Seite wissen weder Zendesk Copilot noch Freddy AI von Ihrem Incident, solange es ihnen niemand sagt. Sie arbeiten mit Tickets und Hilfeartikeln, und Ihr Incident-Protokoll liegt in einem anderen Tool. Beide zu verbinden ist die eigentliche Aufgabe.
Alle Plandetails stehen in meinen Leitfäden zu Zendesk-Preisen und Freshdesk-Preisen.
Wie verbinden Sie das Incident-Protokoll mit dem Helpdesk?
Senden Sie jedes Statusupdate aus Ihrem Incident-Tool als Daten an die KI, die Tickets beantwortet. Das ist der Teil, mit dem ich meine Tage verbringe, also hier die einfache Version, wie es funktioniert.
Statuspage kann jedes Incident-Update an eine URL senden. Seine Webhook-Benachrichtigungen sind HTTP-POST-Anfragen mit dem Incident- oder Komponenten-Update, und sie sind ab dem Startup-Plan (99 $ im Monat) verfügbar. Das ist die Art von Update, die diese Payloads tragen:
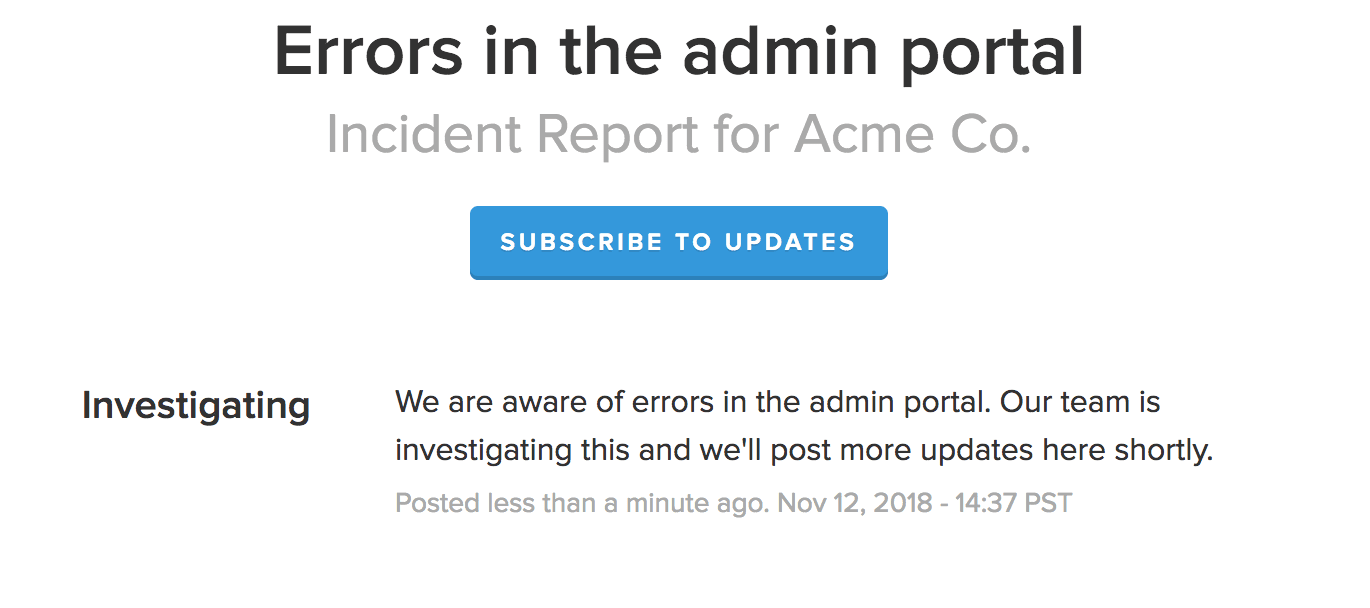
Auf der eesel-Seite gibt Ihnen eine Webhook-Automation eine private URL, an die jeder Dienst JSON per POST senden kann, und der Agent wacht mit diesen Daten auf und folgt den Anweisungen, die Sie dafür geschrieben haben. Sie richten also den Statuspage-Webhook auf diese URL und sagen dem Agenten: „When an incident update arrives, save the latest approved text as the current incident status. On new tickets that match it, reply with that text and the next update time, add the incident tag, and leave everything else for a person.“ Dasselbe funktioniert mit incident.io oder PagerDuty über deren eigene Webhooks oder Zapier. eesel hat keine native Statuspage-Integration, der Webhook ist also der Weg.
In Zendesk sind die eesel-Aktionen, die an einem Incident-Tag zählen: Ticket-Antwort entwerfen (zurückgehalten, bis eine Person freigibt), interne Notiz hinterlassen, Tags hinzufügen, Tickets suchen und Felder wie Status oder Priorität aktualisieren. Jede Aktion lässt sich auf selbstständig, Freigabe nötig oder aus stellen. Am ersten Tag würde ich „Send ticket reply“ auf Freigabe und „Add tags“ sowie „Leave internal note“ auf automatisch setzen.
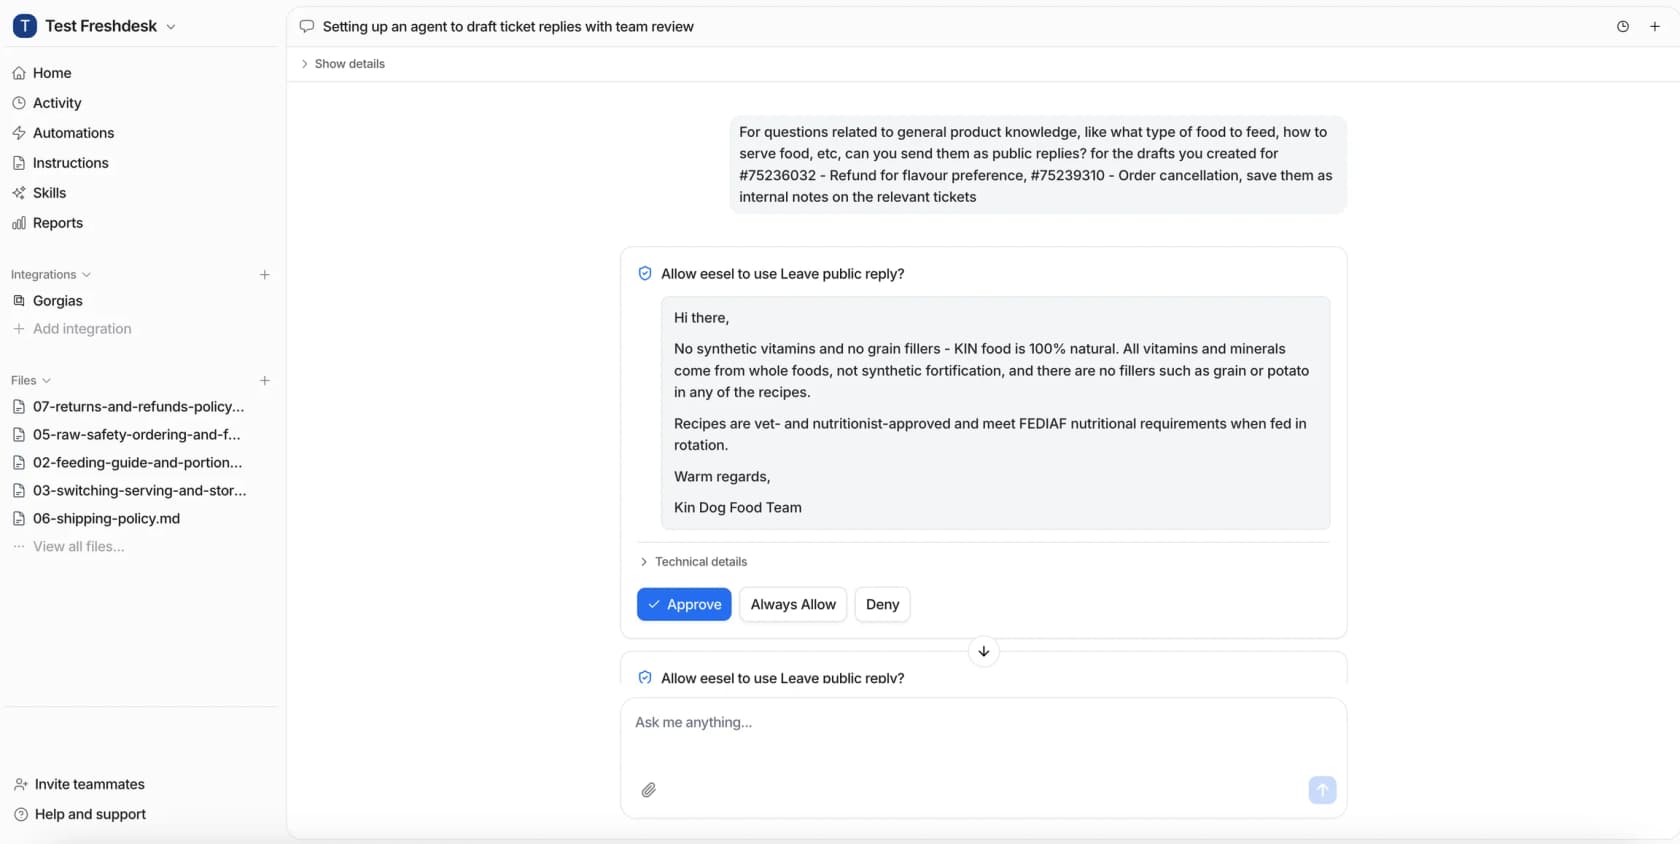
Freigaben müssen nicht im Dashboard stattfinden. Wenn der Lauf von Slack aus gestartet wurde, landet die Freigabe-Karte in diesem Thread, sodass Ihr Comms-Verantwortlicher Antworten im selben Kanal freigeben kann, den er ohnehin beobachtet. Wenn Ihr Incident Lead im Terminal lebt, erledigt die eesel CLI dasselbe: eesel approvals listet auf, was wartet, und eesel approvals approve <id> sendet es. Das heißt auch, dass ein Coding-Agent wie Claude Code oder ein Skript in Ihrem Incident-Runbook die Queue für Sie prüfen kann. Am Agenten ändert sich zwischen Dashboard, Slack und Terminal nichts. Es ist derselbe Teammate mit denselben Berechtigungen.
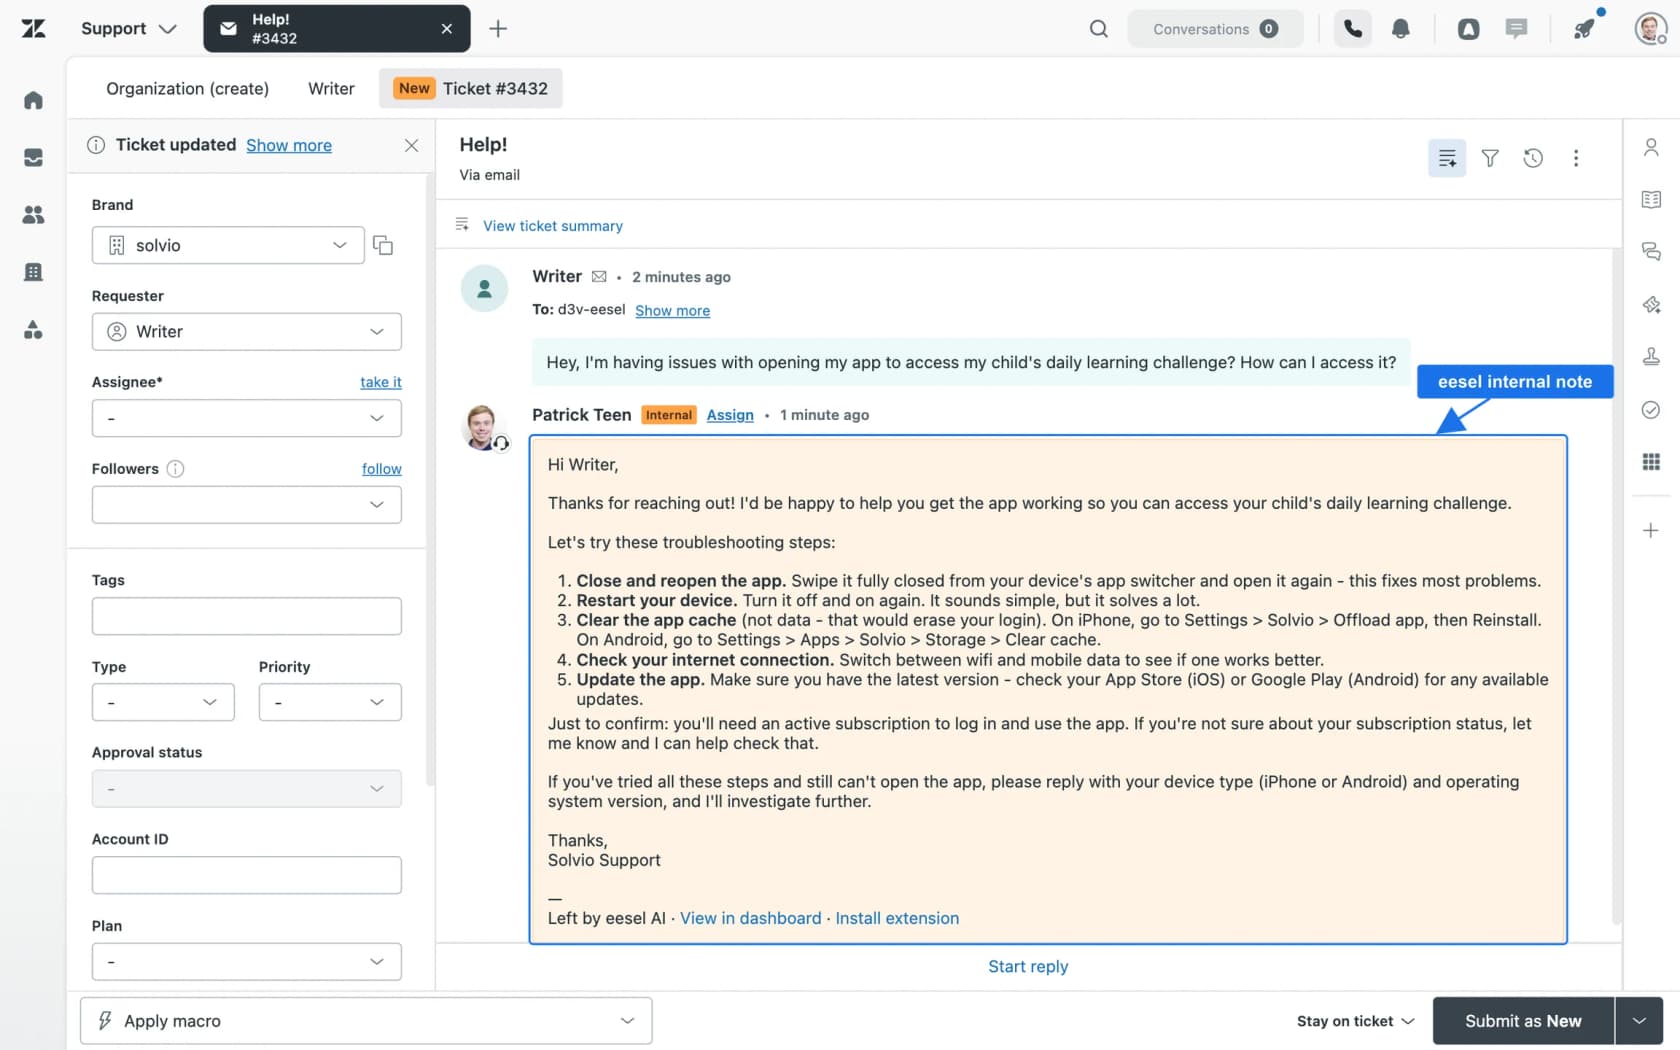
Was passiert nach der Behebung des Incidents?
Eine zweite Ticketwelle, und die meisten Teams planen sie nicht ein. Die Statusseite springt auf behoben, alle atmen aus, und dann füllt sich der Posteingang mit einer anderen Art von Nachricht.
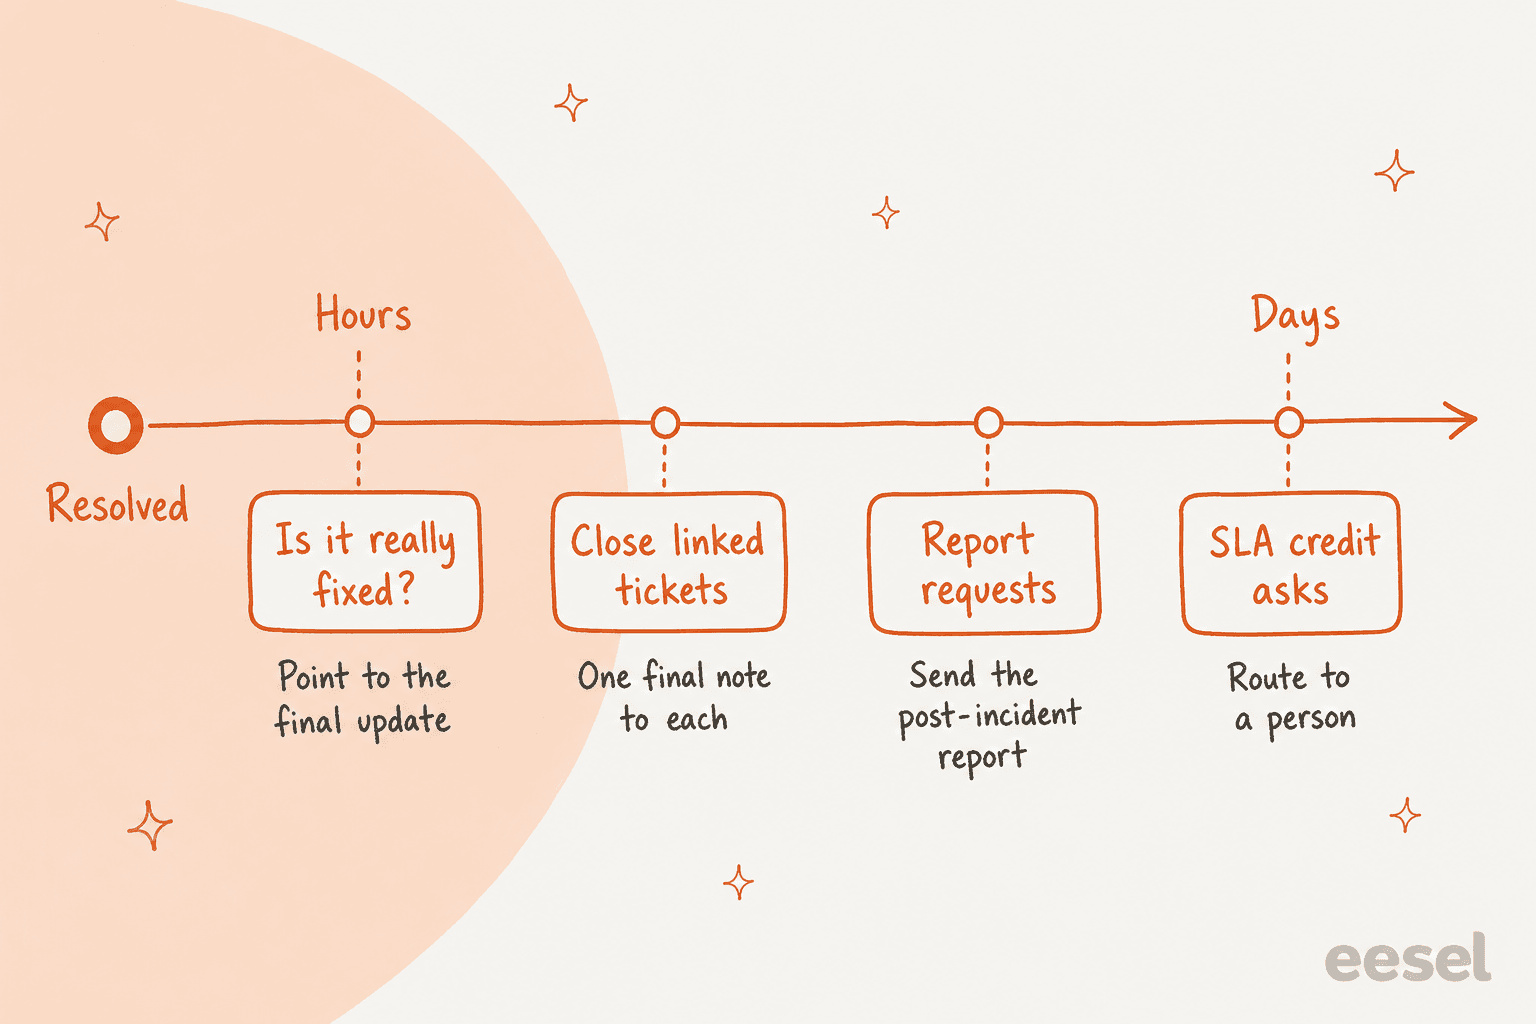
Das kommt herein, grob in dieser Reihenfolge:
- „Ist es wirklich behoben?“ Diese kommen innerhalb von Stunden, oft von Kunden, die den Resolved-Post nie gesehen haben. Die KI kann mit dem Text des letzten Updates antworten und einer Zeile, die einlädt, zu antworten, falls sie das Problem noch sehen. Ein echtes „bei mir immer noch kaputt“ geht an einen Menschen, da es bedeuten kann, dass der Fix nicht bei allen ankam.
- Alle verknüpften Tickets schließen. Senden Sie eine abschließende Notiz an jedes mit dem Incident getaggte Ticket, nicht nur an die noch offenen. In Zendesk erledigt das Lösen des Problem-Tickets das meiste. In Freshdesk lösen Sie die verknüpften Tickets selbst oder lassen die KI die abschließende Notiz an jedes posten. Beobachten Sie in den nächsten Tagen Ihre Wiedereröffnungsrate, denn sie zeigt, ob die „behoben“-Nachricht angekommen ist.
- Anfragen nach dem Post-Incident-Bericht. Größere Kunden fragen nach der Aufarbeitung, oft für ihre eigene Compliance. Führen Sie eine Liste, wer während des Incidents gefragt hat (der Tag macht das einfach), und senden Sie allen den Bericht, sobald er veröffentlicht ist. Lassen Sie die KI die Ursache nicht zusammenfassen, bevor Ihre Engineers sie veröffentlichen.
- SLA-Gutschriften. Das sind Vertragsfragen mit Geld dahinter. Leiten Sie sie mit dem Plan des Kunden und Beginn und Ende des Incidents an eine Person, so wie ich Abrechnungsstreitigkeiten handhaben würde.
In der Welle lernen Sie auch am meisten. Zählen Sie die getaggten Tickets, wie viele vor dem ersten Statusseiten-Post kamen und wie viele „Gibt es ein Update?“ fragten. Diese drei Zahlen verraten, ob Ihr erster Post langsam war, ob Ihr Rhythmus gehalten hat und wo Sie beim nächsten Mal ansetzen. KI-Support-Reporting kann sie für Sie ziehen.
Das richtig zu machen, zählt über den Tag hinaus. Wie ein Gründer auf r/SaaS es ausdrückte:
"if you wait until an outage to figure this out it’s already chaos, so even a simple status page plus a prewritten we’re investigating template and one owner for updates goes a long way because trying to debug while replying to tickets in real time is how small issues turn into trust problems fast"
Vertrauen ist auch der Grund, warum ich das mit Ihrer Churn-Arbeit verbinden würde. Die Kunden, die bei einem Ausfall geschrieben haben, wägen danach am ehesten einen Wechsel ab, und ein persönliches Nachfassen ihres Account Managers eine Woche später kostet sehr wenig.
Wie richten Sie es vor dem nächsten Ausfall ein?
Machen Sie es an einem ruhigen Dienstag, nicht um 2 Uhr nachts. In dieser Reihenfolge würde ich vorgehen:
- Den Comms-Verantwortlichen-Turnus benennen. Eine Person pro Schicht, die nicht im Engineering-Dienst ist. Schreiben Sie sie neben Ihren Bereitschaftsplan.
- Die Vorlage für das Incident-Protokoll schreiben. Die vier Felder: was betroffen ist, verifizierte Fakten, was wir tun, nächstes Update um.
- Die Formulierungen vorab freigeben. Posts für „Investigating“, „Identified“, „Monitoring“, „Resolved“, plus je eine Ticket-Antwort und eine Kunden-E-Mail. Der Report von incident.io empfiehlt genau deshalb vorab freigegebene Vorlagen für häufige Incidents.
- Ticket-Verknüpfung einschalten. Problem- und Incident-Tickets in Zendesk oder verknüpfte Tickets in Freshdesk, plus ein Tag-Format für jeden Incident.
- Die KI mit aktivierten Freigaben verbinden. Öffentliche Antworten auf Freigabe setzen, Tags und interne Notizen auf automatisch, und den Statusseiten-Webhook verbinden. Prüfen Sie eine Woche lang Entwürfe zu echten Tickets, bevor Sie eine Antwort auf automatisch stellen.
- Eine Übung durchführen. Simulieren Sie einen SEV2 in einer Test-Marke. Prüfen Sie, ob der erste Post innerhalb Ihres Ziels rausgeht, der Heartbeat feuert, das Makro aktualisiert wird und jedes getaggte Ticket die abschließende Notiz bekommt.
Wenn Ihr Team über Schichtwechsel hinweg arbeitet oder Wochenenden dünn abdeckt, ist Schritt 1 der wichtigste. Ein Ausfall um 3 Uhr nachts ohne jemanden im Comms-Turnus ist der Grund, warum die Statusseite vier Stunden auf „Investigating“ stehen bleibt.
eesel für Ihre Incident-Tage testen
Wenn Ihre Support-Queue auf Zendesk, Freshdesk oder Gorgias läuft, stößt der KI-Helpdesk-Teammate von eesel dazu wie ein neuer Agent, der Ihr Help Center und vergangene Tickets schon gelesen hat. An einem Incident-Tag taggt er jedes Ausfall-Ticket, antwortet auf zugeordnete Tickets mit dem Update, das Ihr Comms-Verantwortlicher freigegeben hat, und übergibt Großkunden, Datenverlust und Abrechnung direkt an einen Menschen, das Setup, das Qontro auf Freshdesk betreibt. Verbinden Sie Ihre Statusseite über einen Webhook, und jede Antwort bleibt bei derselben Geschichte wie die Statusseite.
Der Start ist kostenlos mit 100 Credits, danach 299 $ im Monat für 500, wobei ein Ticket als ein Credit zählt, egal wie viele Updates es bekommt. Richten Sie es auf Zendesk oder Freshdesk ein, bevor Ihr nächster Ausfall kommt, nicht währenddessen.