

Was ein Ausfall wirklich mit Ihrer Support-Warteschlange macht
Ich arbeite selbst in der Support-Warteschlange, deshalb beschreibe ich lieber ihre Form als die Theorie. An einem normalen Tag tröpfeln Tickets zu einem breiten Themenspektrum herein: hier eine Abrechnungsfrage, dort eine Bedienungsfrage, ab und zu ein Fehlerbericht. Sie können nebenbei triagieren.
Ein Ausfall presst all das auf ein einziges Thema zusammen. In dem Moment, in dem etwas Zentrales kaputtgeht, sieht die Kurve nicht mehr wie ein Tröpfeln aus, sondern wie eine Wand.
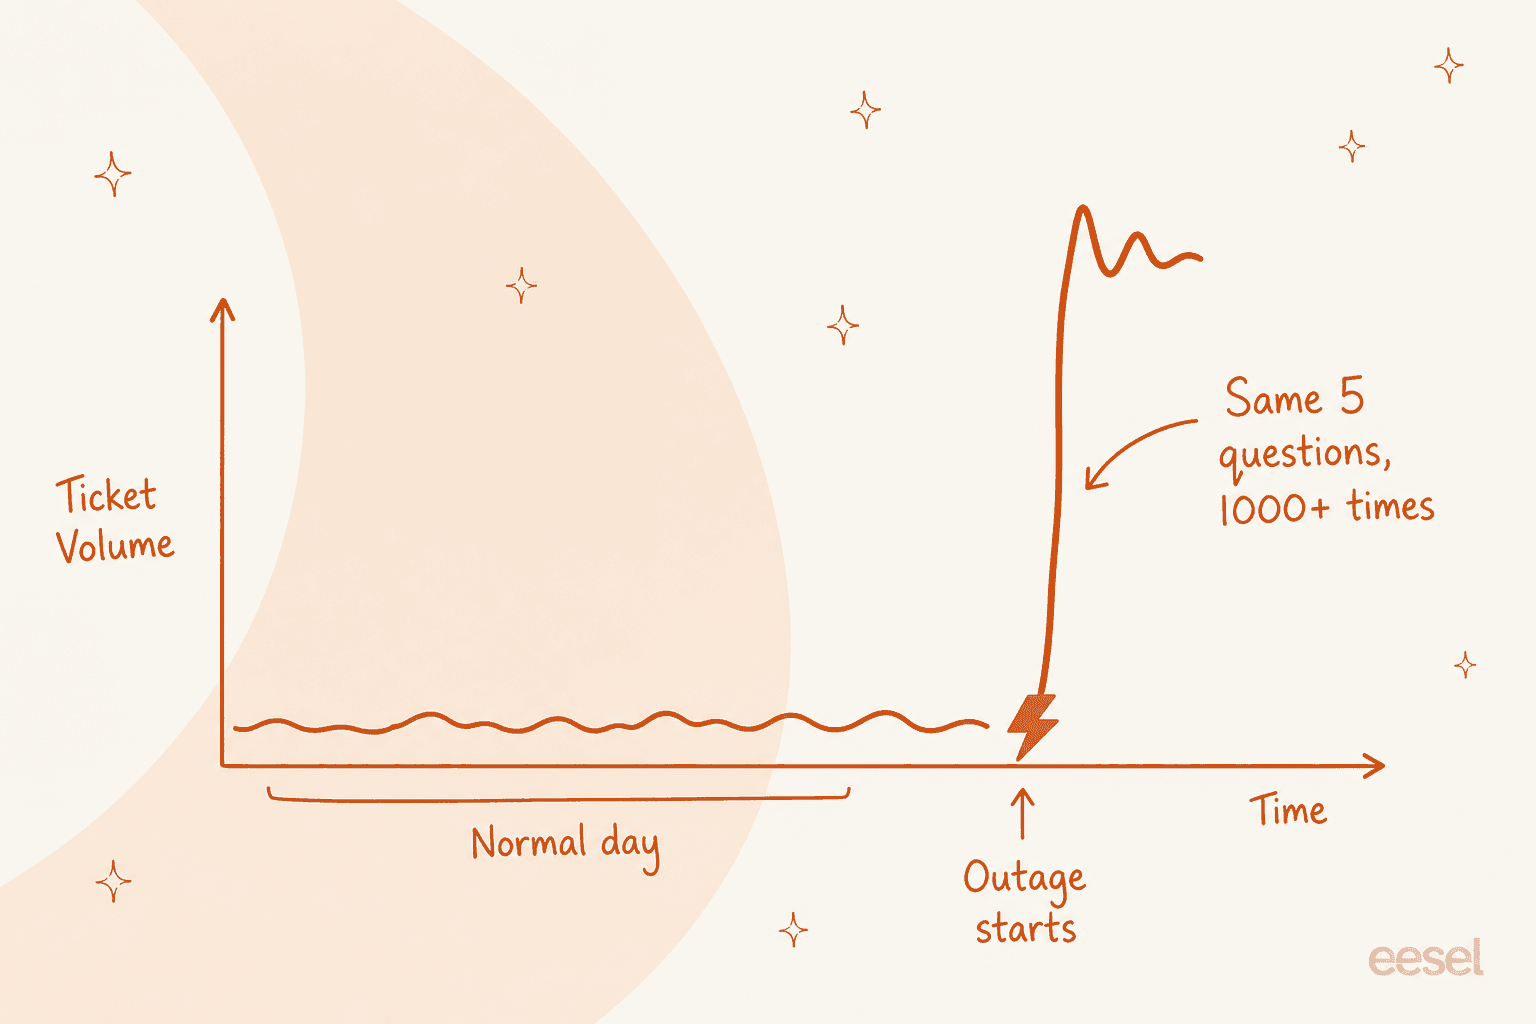
Das Gemeine daran: Es ist fast immer dasselbe Ticket. Ein Betreiber mehrerer E-Commerce-Marken, dessen Zahlen ich kenne, bearbeitet selbst an einem ruhigen Tag über 500 Tickets, größtenteils repetitive Anfragen zu Rückerstattungen, Abbestellungen und Sendungsverfolgung. Legt man einen Ausfall auf so eine Grundlast, geht die Wiederholung senkrecht nach oben: dieselben fünf Fragen, auf fünfzig Arten formuliert, tausendfach.
Ein menschliches Team ist bei genau dieser Aufgabe besonders schlecht. Dieselbe Frage zum vierhundertsten Mal zu beantworten, zermürbt, es ist langsam, weil jede Antwort weiterhin von Hand getippt wird, und während Ihre Agenten damit beschäftigt sind, steckt der eine Kunde mit einem wirklich anderen, ernsten Problem auf Platz 812 der Warteschlange fest.
Warum die Menschen zuerst an eine Grenze stoßen
Support-Teams sind meist so klein, wie es gerade noch geht, weil das Ticketvolumen an einem durchschnittlichen Tag keine Besetzung für den schlimmsten Tag rechtfertigt. Diese Rechnung geht auf, bis der schlimmste Tag kommt.
Ich höre von Support-Leitern immer wieder dasselbe: Das Team ist überlastet und kommt nicht hinterher, und was sie eigentlich brauchen, ist eine Maschine, die die Tickets übernimmt, die eine Maschine offensichtlich bewältigen kann. Ein Support-Manager eines Bus-Tracking-Dienstes mit 200 bis 250 Zendesk-Tickets pro Monat sagte uns klar, dass die KI 60 % der Tickets bearbeiten und vor allem erkennen soll, wann ein Mensch dazukommen muss. Diese Klausel „wissen, wann eskaliert wird“ ist bei einer Störung das ganze Spiel.
Denn das Problem sind nicht nur langsame Antworten. Ihre erfahrensten Leute, die eigentlich im Incident-Kanal helfen sollten herauszufinden, was kaputtgegangen ist, kopieren stattdessen zwei Stunden lang „Wir kennen das Problem“ in Tickets. Der Ausfall kostet Sie doppelt: einmal durch die Downtime und noch einmal durch jede qualifizierte Person, die Sie in den Warteschlangendienst abgezogen haben.
Wie KI-Support die Flut auffängt
Hier ist das mentale Modell, das ich verwende. Während einer Störung teilen sich Tickets in zwei Körbe: die Flut (dieselbe bekannte Störung, immer wieder) und die Ausnahmen (alles, was nicht passt). KI ist beim ersten Korb sehr gut und sollte sich aus dem zweiten heraushalten.
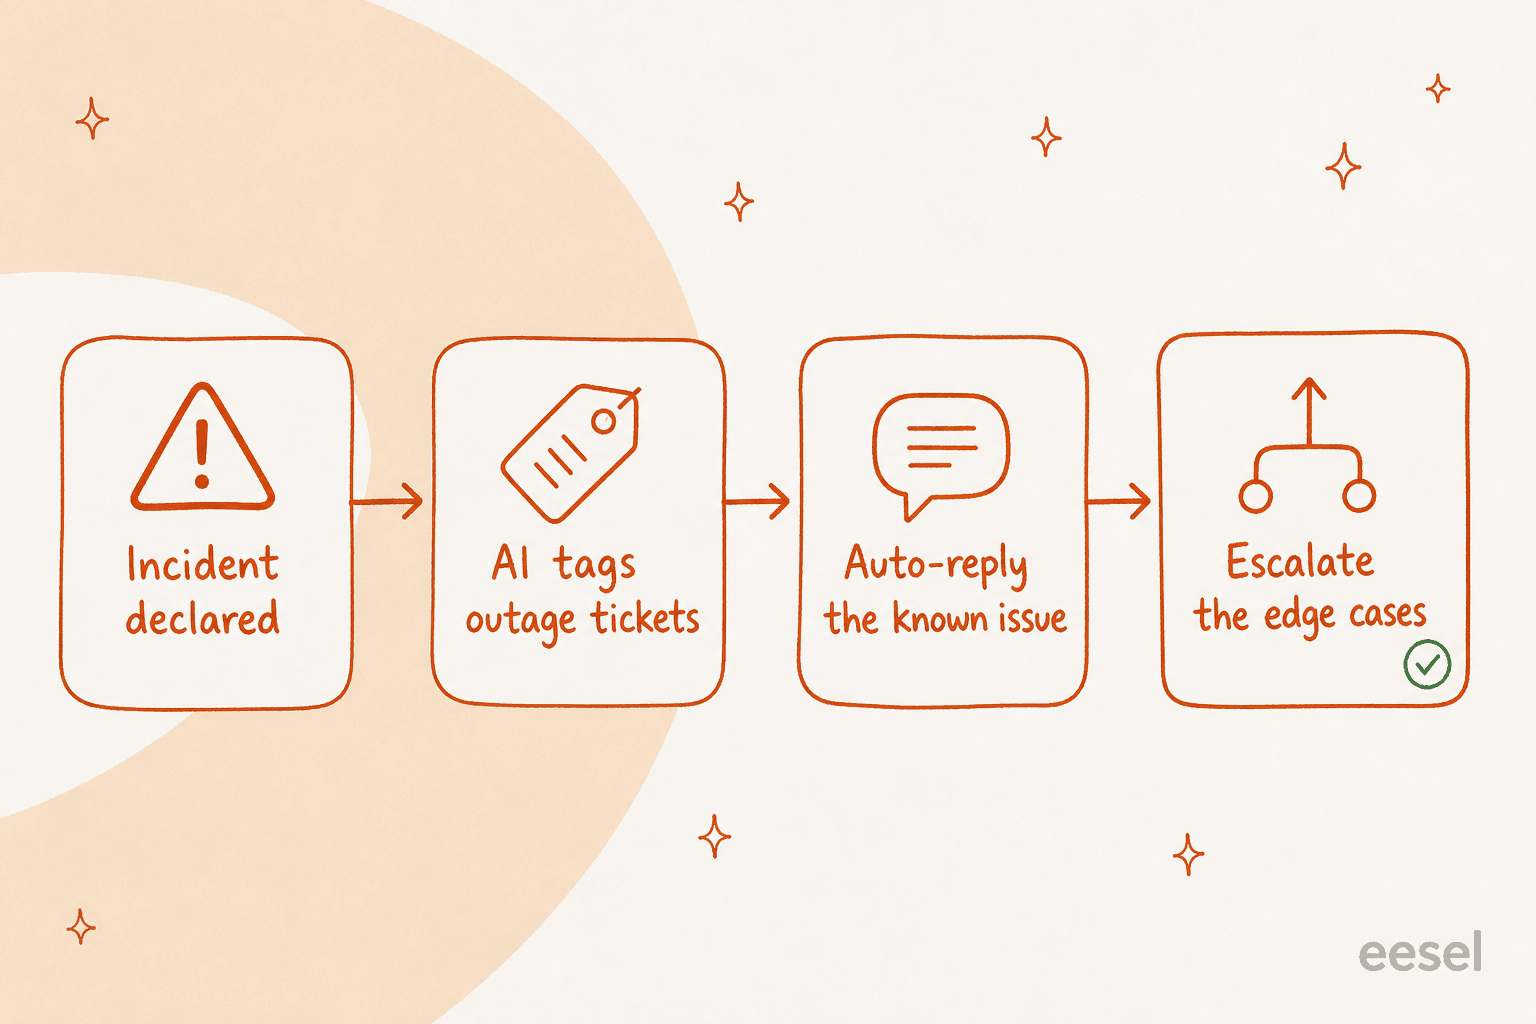
Gehen wir es durch:
- Das Muster erkennen. Sobald Sie wissen, was kaputt ist, sind die eingehenden Tickets dazu leicht zu erkennen. Die KI gleicht sie mit der von Ihnen verfassten Beschreibung der bekannten Störung ab.
- Antworten, nicht nur abwimmeln. Ein passendes Ticket bekommt eine echte Antwort: Ja, wir wissen Bescheid, das ist betroffen, hier ist die Statusseite, wir halten Sie auf dem Laufenden. Das ist für diesen Kunden eine echte Lösung, kein Ausweichmanöver.
- Alles taggen, was sie anfasst. Jedes Ausfall-Ticket erhält einen Tag, sodass Sie nach der Behebung alle gesammelt mit einer einzigen Nachricht „Das Problem ist jetzt gelöst“ schließen können, statt jeden Thread einzeln wieder zu öffnen.
- Die Ausnahmen eskalieren. Ein Ticket, das den Ausfall und einen Zahlungsstreit erwähnt, oder ein Ticket, das der bekannten Störung gar nicht ähnelt, geht unangetastet an einen Menschen.
Genau für diese Aufteilung ist ein KI-Helpdesk-Agent gebaut. Er dockt an die Zendesk- oder Freshdesk-Warteschlange an, die Sie bereits betreiben (Gorgias und Help Scout ebenfalls), tritt ihr wie ein Teammitglied bei und nimmt Ihrem Team den repetitiven Korb ab.
In den eigenen Konten von eesel sah ein Kunde, Gridwise, dass die KI im ersten Monat 73 % seiner Tier-1-Anfragen löste, und das an gewöhnlichen Tagen, nicht nur bei Störungen. Bei einem Ausfall, wo die Tickets noch einheitlicher sind, steigt dieser Anteil.
Auch der Kostenaspekt zählt und wird leicht übersehen. Wenn Ihre Tools pro Arbeitsplatz abrechnen, kostet ein Tag mit zehnfachem Ticketvolumen Sie dieselbe Summe an Software und ein Vermögen an Überstunden, denn Menschen skalieren bei einer Spitze nur über mehr Stunden. Ein fester Monatspreis dreht das um: eesel beginnt bei 299 $/Monat für 500 Credits (1 Credit pro Ticket oder Chat) ohne Gebühr pro Arbeitsplatz oder Plattform, sodass die KI eine zweistündige Flut ohne Personalaufstockung verkraftet, und Überschreitungen sind optional mit einer von Ihnen festgelegten Obergrenze.
Richten Sie einen Störungsmodus ein, bevor Sie ihn brauchen
Der schlechteste Zeitpunkt, das alles zu konfigurieren, ist mitten im Ausfall. Tun Sie es jetzt, solange es langweilig ist. Das ist die Einrichtung, die ich vor dem nächsten Vorfall haben wollte.
- Das Makro für bekannte Störungen im Voraus schreiben. Sie kennen die konkrete Ursache nicht vorab, können aber die Form vorformulieren: „Wir kennen ein Problem, das [X] betrifft. Unser Team arbeitet daran. Verfolgen Sie Live-Updates unter [Statusseite].“ Während der Störung füllen Sie die Lücken einmal aus, und die KI verwendet den Text für jedes passende Ticket.
- Helpdesk und Statusseite verbinden. Die KI muss aus Ihrem echten Help Center und vergangenen Tickets lesen, damit ihre Antworten wie Ihre klingen, und sie braucht die URL der Statusseite, um Kunden an eine verlässliche Stelle zu verweisen.
- Automatisierung nach Tickettyp und Konfidenz eingrenzen. Legen Sie im Voraus fest, welche Kategorien die KI automatisch schließen darf und welche sie in Ruhe lassen muss. Rückerstattungen, Streitfälle und alles, was rechtlich angrenzt, bleiben immer bei Menschen.
- Gegen vergangene Ausfälle simulieren. Diesen Schritt überspringen viele und bereuen es. eesel lässt den Agenten vor dem Livegang über Ihre echten historischen Tickets laufen, sodass Sie sehen, wie er Ihren letzten Vorfall bewältigt hätte, bevor Sie ihm den nächsten anvertrauen. Eine bessere Feuerübung bekommt der Support kaum.
- Den Eskalationsweg verdrahten. Stellen Sie sicher, dass ein eskaliertes Ticket dort landet, wo ein Mensch es schnell sieht, und nicht in einem Ordner, den bis Montag niemand prüft.
Wenn Sie Slack als Incident-Kanal nutzen, lohnt es sich, auch das anzubinden, damit die KI an derselben Stelle postet, an der Ihre Entwickler sich abstimmen, und Support und Technik nicht zwei verschiedene Geschichten lesen.
Was KI mitten im Ausfall nie tun sollte
Das würde ich mir an die Wand tätowieren. Ein Ausfall ist genau der Moment, in dem eine übereifrige KI den größten Schaden anrichtet, denn die Kunden sind ohnehin gestresst, und eine selbstsichere falsche Antwort kommt hart an.
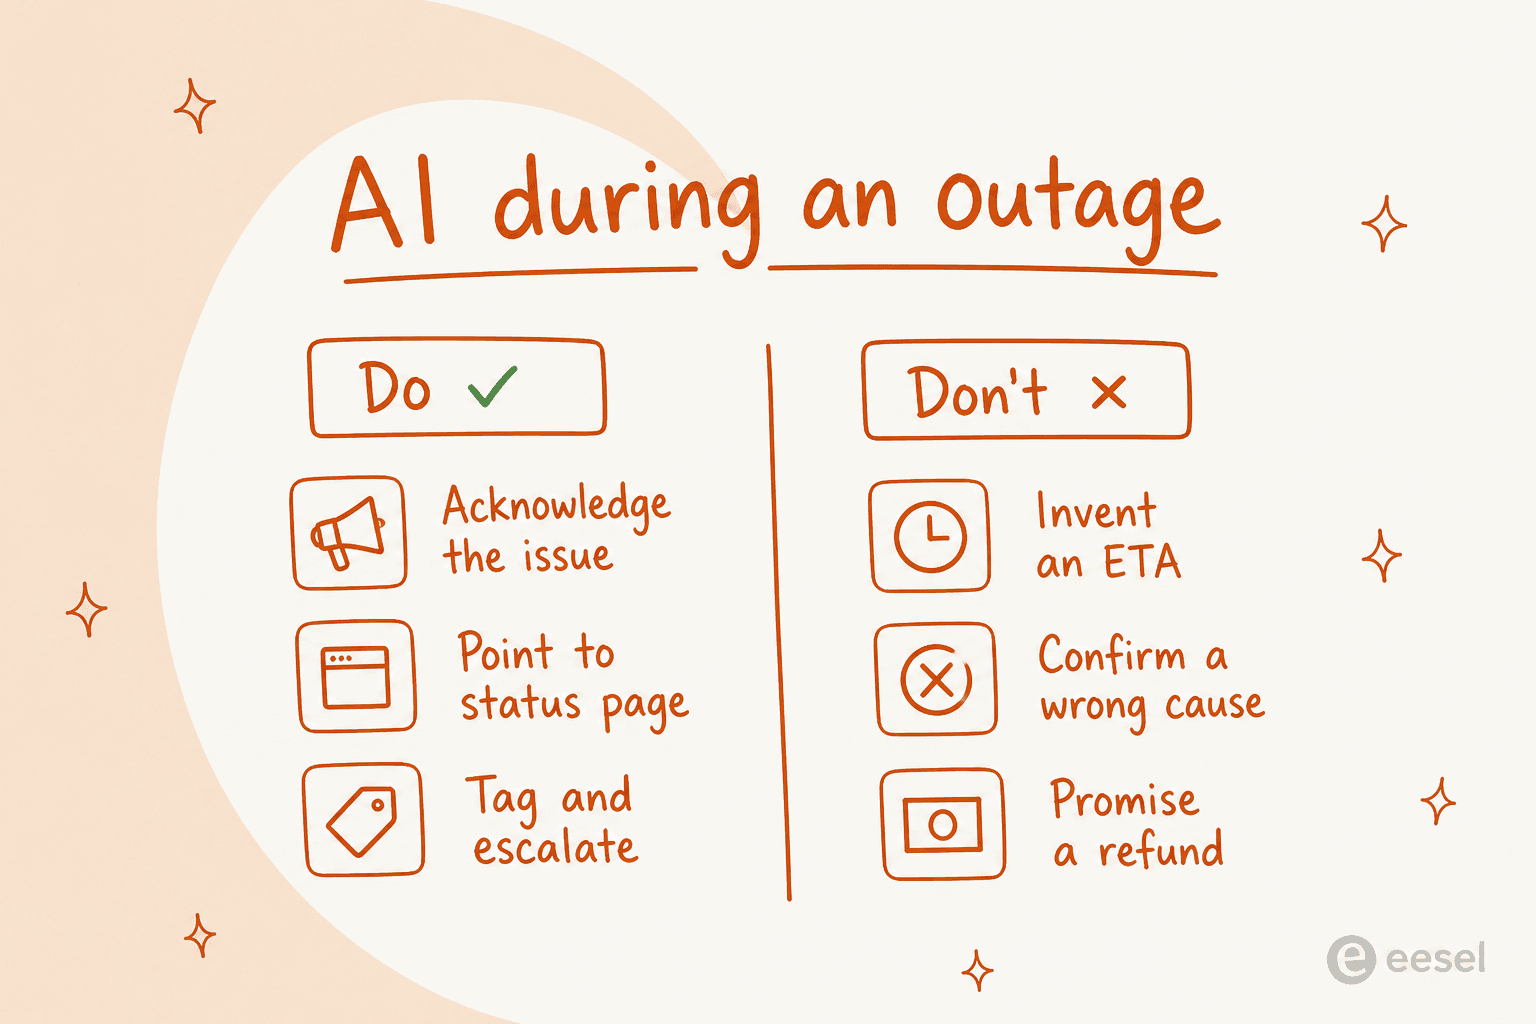
Die Don'ts sind alles Varianten derselben Sünde: Raten. Eine erfundene Dauer wird zu einem Versprechen, das Sie brechen. Eine bestätigte Ursache, die sich als falsch herausstellt, ist eine öffentliche Korrektur, die Sie nun schulden. Eine Rückerstattung durch einen Bot ist Geld und ein Präzedenzfall, den Sie nicht autorisiert haben. Nichts davon ist hypothetisch, es passiert, wenn Automatisierung zu weit gefasst ist und ohne Grenzen „hilfreich sein“ soll.
Vermeiden lässt sich das durch Kontrolle, nicht durch Hoffnung. Ein CX-Leiter, den ich anonymisiert als Betreiber einer DTC-Nahrungsergänzungsmarke beschreibe, hat das Prinzip besser formuliert, als ich es könnte:
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Diese Einstellung macht KI bei einer Störung sicher: Sie erledigt die sichere, repetitive Arbeit und hat die Disziplin, die Finger von allem anderen zu lassen. Konfidenzbasierte Eingrenzung ist hier kein Nice-to-have, sondern der Unterschied dazwischen, ob die KI den Ausfall verkürzt oder verlängert.
eesel für Ihren nächsten Vorfall testen
Wenn Sie einen KI-Helpdesk-Teammate wollen, der in Ihrer bestehenden Warteschlange arbeitet, die Flut bekannter Störungen auffängt und sauber eskaliert, sobald ein Ticket ungewöhnlich aussieht, dann ist genau das der Zweck von eesel. Er lernt aus Ihren vergangenen Tickets und Ihrem Help Center, sodass seine Ausfall-Antworten klingen, als hätte Ihr Team sie geschrieben, er grenzt die Automatisierung nach Tickettyp und Konfidenz ein, sodass er bei den wichtigen Tickets nie rät, und er simuliert anhand Ihrer echten Historie, damit Sie einen Vorfall proben können, bevor Sie ihn erleben.

Und weil er in Credits statt pro Arbeitsplatz abgerechnet wird, können Sie ihn auf eine Spitze auslegen, ohne für die schlimmste Stunde des schlimmsten Tages Personal vorzuhalten. Sie können Ihren Helpdesk verbinden, ihn auf Ihr Wissen ausrichten und kostenlos mit 100 Credits starten, ohne Kreditkarte und ohne Verkaufsgespräch. Der nächste Ausfall kommt, ob Sie bereit sind oder nicht, also ist der sinnvolle Schritt, Ihren Störungsmodus aufzubauen und zu simulieren, bevor es so weit ist.