

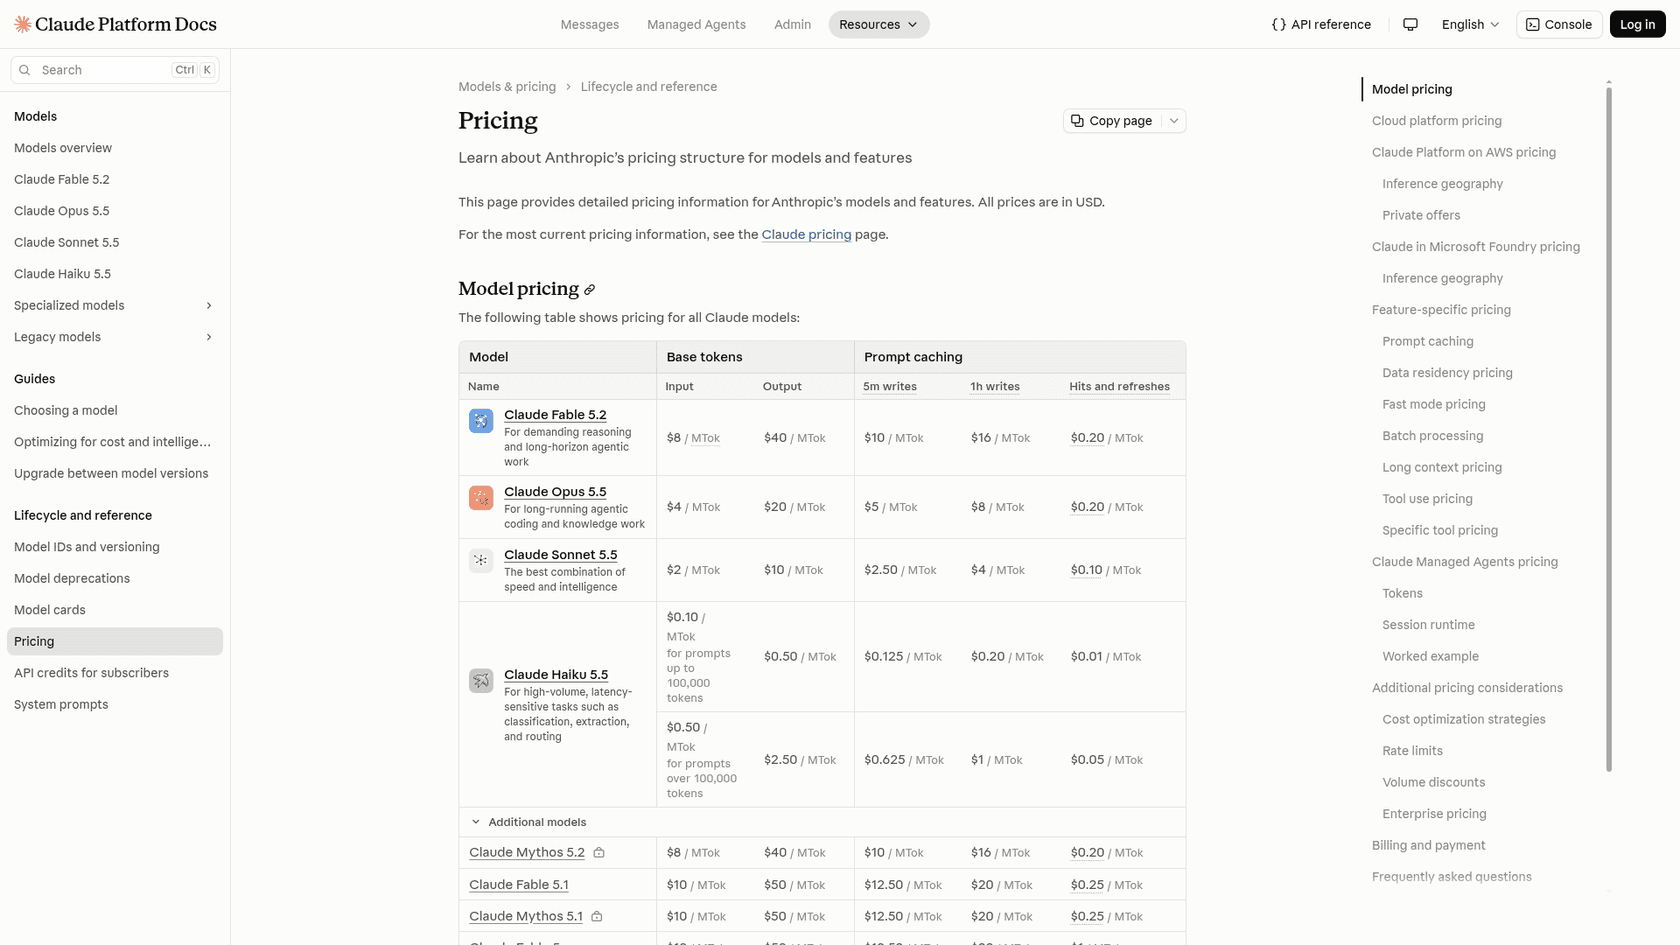
La mejor alternativa a Qwen 4 Max para la mayoría del trabajo de código y agentes es Claude Sonnet 5.5, a 2 $/10 $ por millón de tokens, con Claude Opus 5.5 para tareas difíciles y DeepSeek V4.1 Flash (0,15 $/0,60 $ fuera de hora punta) para trabajo masivo. Pero compruebe una cosa antes de cambiar: Alibaba lanzó el GA qwen4-max el 16 de noviembre, a 1,50 $/4,50 $. Si le gustaba la vista previa, cambiar un solo ID de modelo es más barato que cualquier otro cambio.
Si la vista previa alimentaba un bot de soporte, eesel hace ese trabajo sin que usted elija un modelo, y la CLI de eesel permite que un agente de código cargue su documentación de ayuda y pruebe respuestas antes de lanzarlo.
¿Qué pasa con Qwen 4 Max el 25 de noviembre?
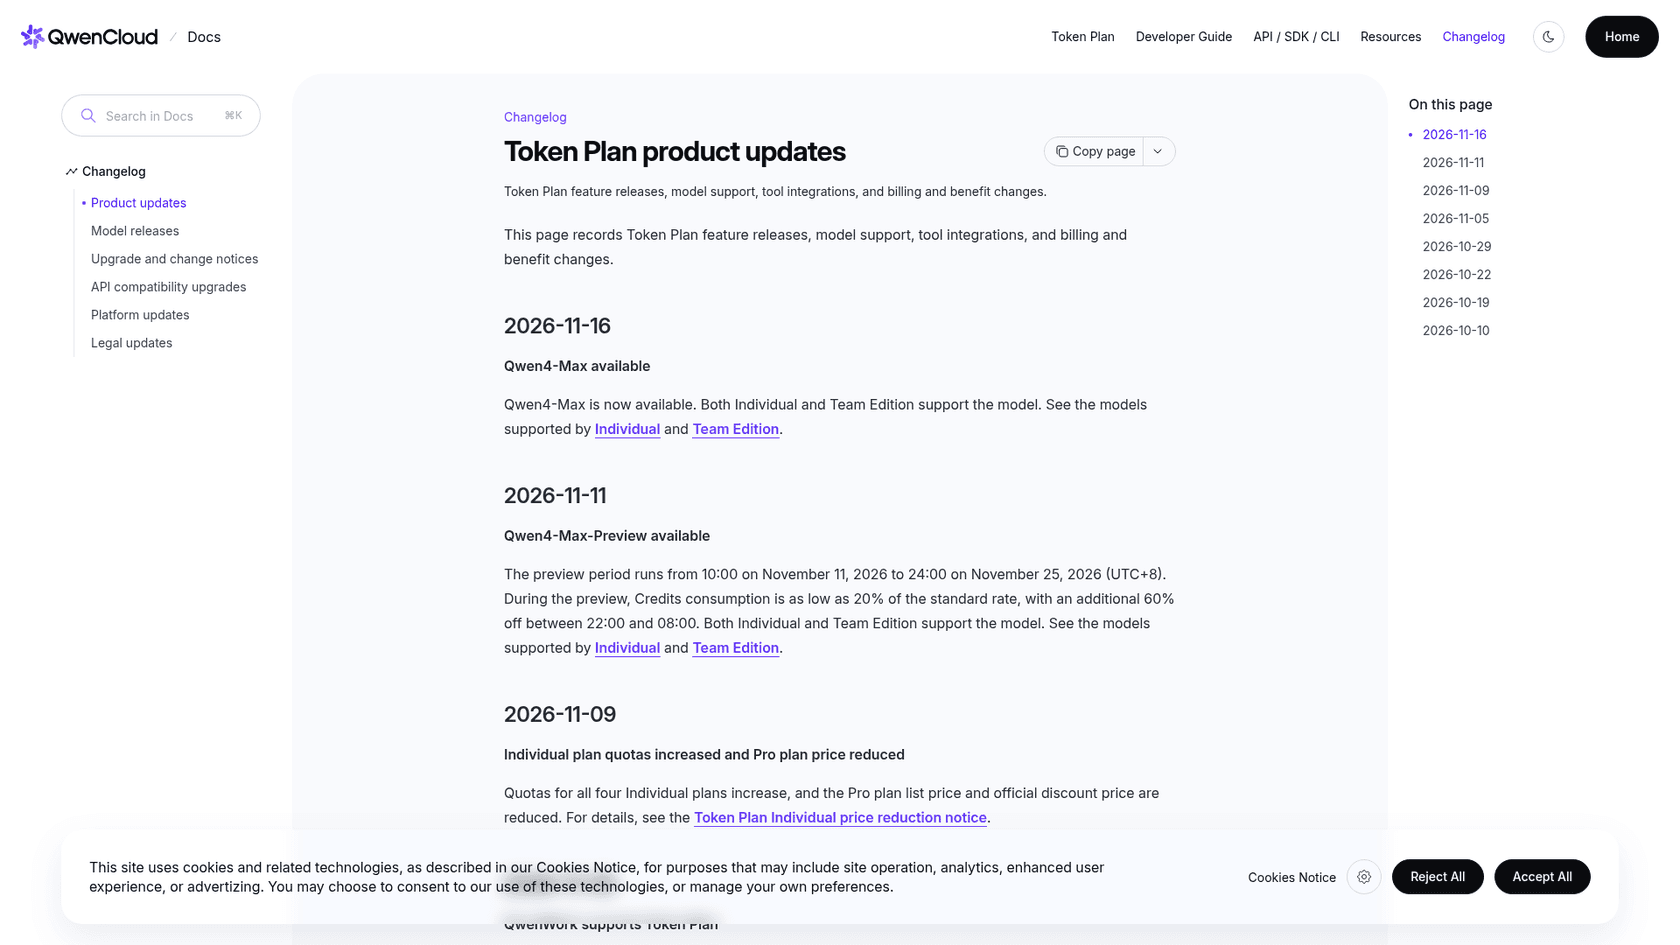
La vista previa se detiene. El registro de cambios de Token Plan de Alibaba dice que qwen4-max-preview funciona desde las 10:00 del 11 de noviembre hasta las 24:00 del 25 de noviembre de 2026 (UTC+8), y la documentación de Token Plan dice que el modelo se retirará cuando termine la vista previa. Cualquier agente, script o configuración de Claude Code que siga apuntando a ese ID deja de funcionar el día 26.
Lo que la mayoría de la cobertura pasa por alto es la siguiente entrada del mismo registro de cambios. El 16 de noviembre, Alibaba puso qwen4-max en disponibilidad general (GA) en Token Plan Personal, Token Plan Team y la API de pago por uso. Así que la pregunta ya no es "Qwen u otra cosa", sino "el Qwen GA, o algo mejor para mi carga de trabajo".
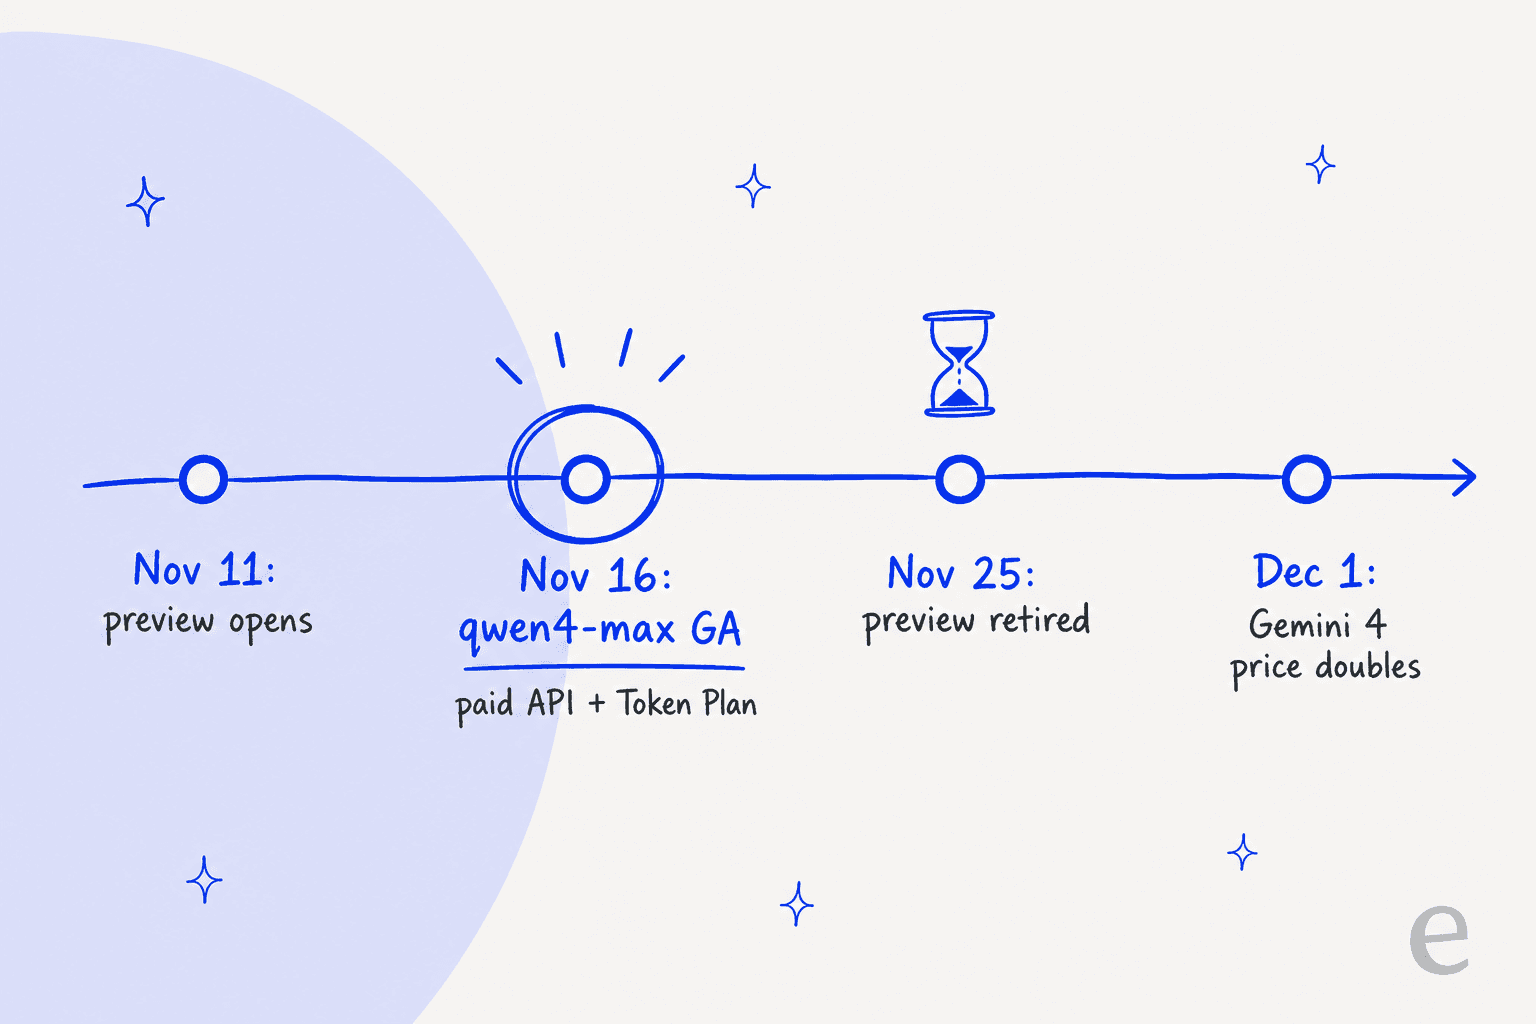
Esa última fecha también importa. Dos de las alternativas de más abajo, Gemini 4 Argon y Gemini 4 Carbon, tienen precios de lanzamiento que se duplican el 1 de diciembre, así que una decisión tomada con la tarifa de esta semana puede cambiar dos veces en dos semanas.
Soy Alicia, y construyo funciones y agentes de IA en eesel. Llevamos años poniendo modelos detrás de colas de soporte reales, y la lección de cada migración forzada es la misma: el modelo al que cambie importa menos que si lo probó primero en su propio trabajo. Cada opción de abajo viene con el precio para un comprador definido, para que pueda compararlas con un solo número antes de probar.
¿Debería simplemente pasarse al qwen4-max GA?
Para la mayoría de las personas a las que les gustaba la vista previa, sí. Esto es lo que cambia entre los dos modelos, todo de la documentación de Qwen4-Max de Alibaba:
| qwen4-max-preview | qwen4-max (GA) | |
|---|---|---|
| Estado | Retirado después del 25 de nov. | Disponibilidad general desde el 16 de nov. |
| Dónde puede usarlo | Solo Token Plan | Token Plan Personal, Token Plan Team, API de pago por uso |
| Precio | Créditos al 20 % de la tarifa estándar (8 % por la noche) | 1,50 $ entrada / 4,50 $ salida por 1 M de tokens (Singapur) |
| Ventana de contexto | 1 M de tokens | 1 M de tokens |
| Máx. razonamiento + respuesta | 393.216 tokens | 262.144 tokens |
| Esfuerzo de razonamiento | low, medium, xhigh | low, high (por defecto), xhigh |
| Herramientas de código | Claude Code vía Token Plan | Claude Code, Codex, OpenCode |
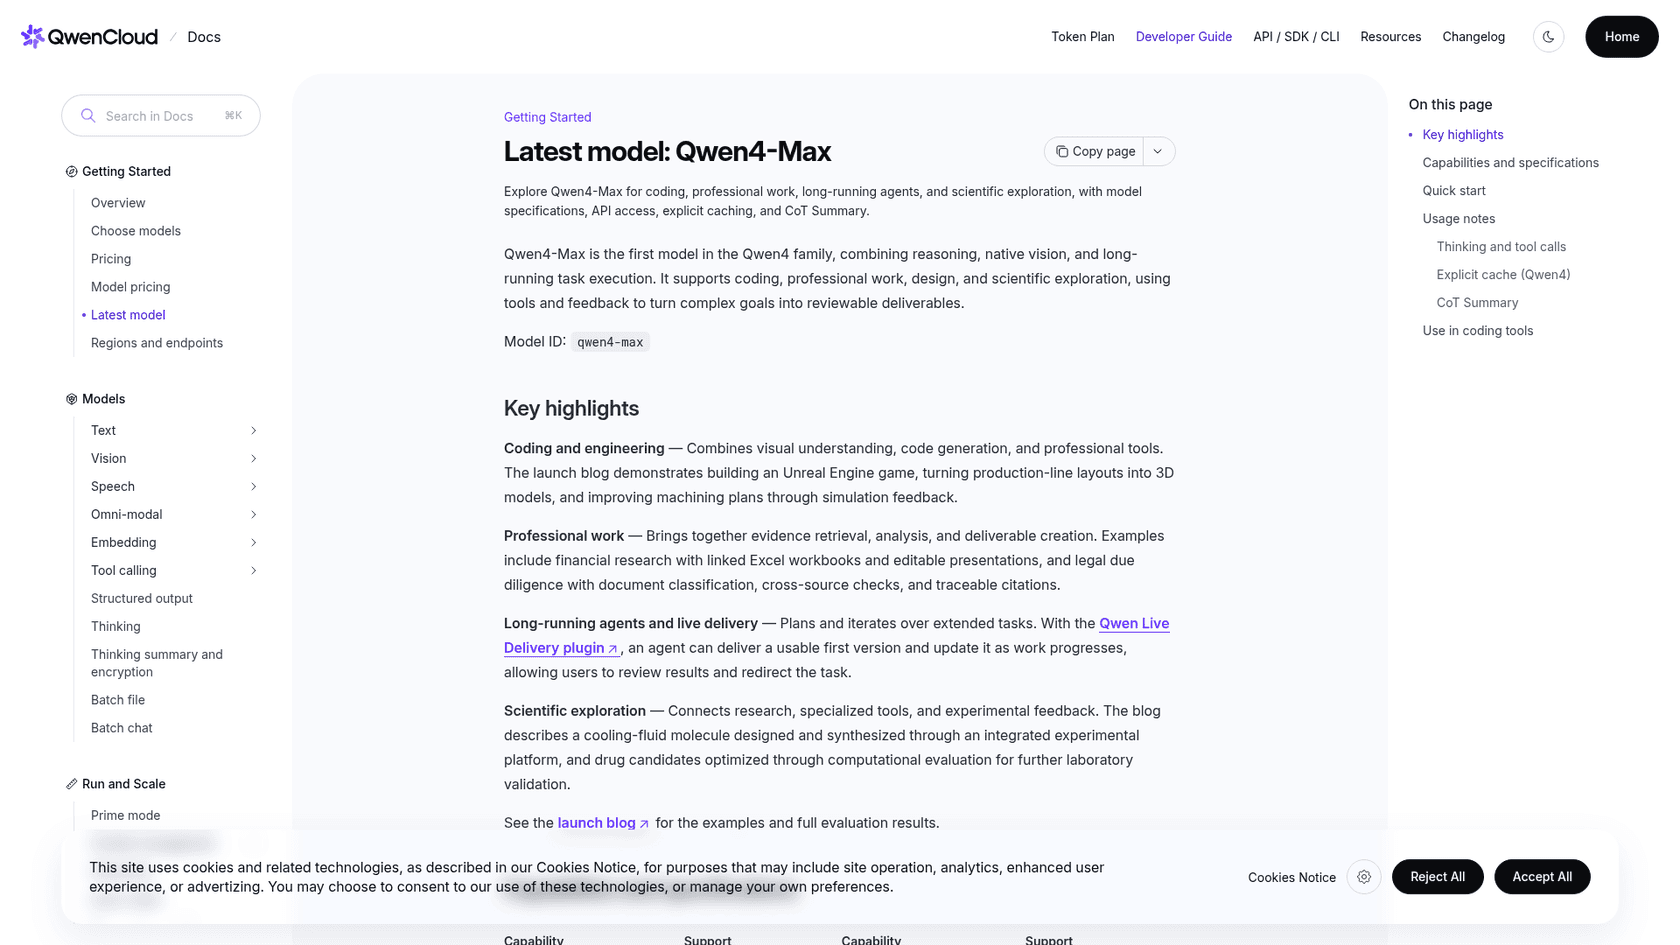
Destacan tres cosas. Primero, el modelo GA es más barato que Qwen3.8-Max: Alibaba lista qwen3.8-max a 2 $/6 $ en Singapur frente a 1,50 $/4,50 $ de qwen4-max, así que el buque insignia más nuevo es también el más barato. Segundo, el modelo GA añade caché explícita con TTL de 5 minutos o 1 hora y lecturas de caché a 0,075 $. Tercero, pierde el descuento de la vista previa. Los usuarios de Token Plan pagaban solo el 20 % de la tarifa estándar de créditos durante la vista previa, y el 8 % por la noche, según el resumen de Token Plan. Ese trato no se mantiene, así que espere que los créditos se consuman varias veces más rápido en el mismo trabajo.
La migración en sí es una línea. En la configuración de Claude Code que documentamos la semana pasada, el slot de Opus apuntaba a qwen4-max-preview; cámbielo por qwen4-max y mantenga la misma clave y endpoint de Token Plan. Si la salida le sale cortada, revise max_completion_tokens, porque el modelo GA limita razonamiento más respuesta a 262.144 tokens.
¿Cuándo debería irse en lugar de quedarse? Cuando la vista previa nunca se ganó su lugar. Alibaba todavía no ha publicado resultados de benchmarks independientes en su documentación más allá del blog de lanzamiento, y la lectura de la comunidad durante la vista previa fue mixta:
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Si estaba en la vista previa sobre todo por el descuento del 80 % o necesita un proveedor fuera de Alibaba Cloud, siga leyendo.
Cómo elegí y puse precio a estas alternativas
Elegí modelos que cubren las tres mismas tareas para las que la gente usaba la vista previa de Qwen 4 Max: código agéntico en herramientas como Claude Code, trabajo de contexto largo en una ventana de 1 M, y llamadas a herramientas en agentes de varios pasos. Cada precio viene de la propia página de precios del proveedor, comprobada el 17 de noviembre de 2026.
Para que los precios por token sean comparables, puse precio a cada modelo para un comprador: un desarrollador que usa 10 M de tokens de entrada y 1 M de salida al mes, a precio de lista estándar, sin descuentos de caché ni de lote. Eso equivale aproximadamente a un mes intenso de trabajo de agente en solitario. La caché cambia mucho el panorama en los bucles de agentes, así que la calculadora de más abajo le permite añadir su propia tasa de aciertos de caché.
Alternativas a Qwen 4 Max de un vistazo
| Modelo | Mejor para | Entrada / salida por 1 M | Lectura de caché por 1 M | Coste mensual (10 M de entrada, 1 M de salida) | Contexto | Pesos abiertos | Opción de suscripción | Cambios de precio próximos |
|---|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | Modelo diario de código | 2 $ / 10 $ | 0,10 $ | 30 $ | 1 M | No | Planes Claude | No |
| Claude Opus 5.5 | Tareas de agentes difíciles | 4 $ / 20 $ | 0,20 $ | 60 $ | 1 M | No | Planes Claude | No |
| Claude Fable 5.2 | Los trabajos más difíciles | 8 $ / 40 $ | 0,20 $ | 120 $ | 1 M | No | Créditos de uso en Pro | No |
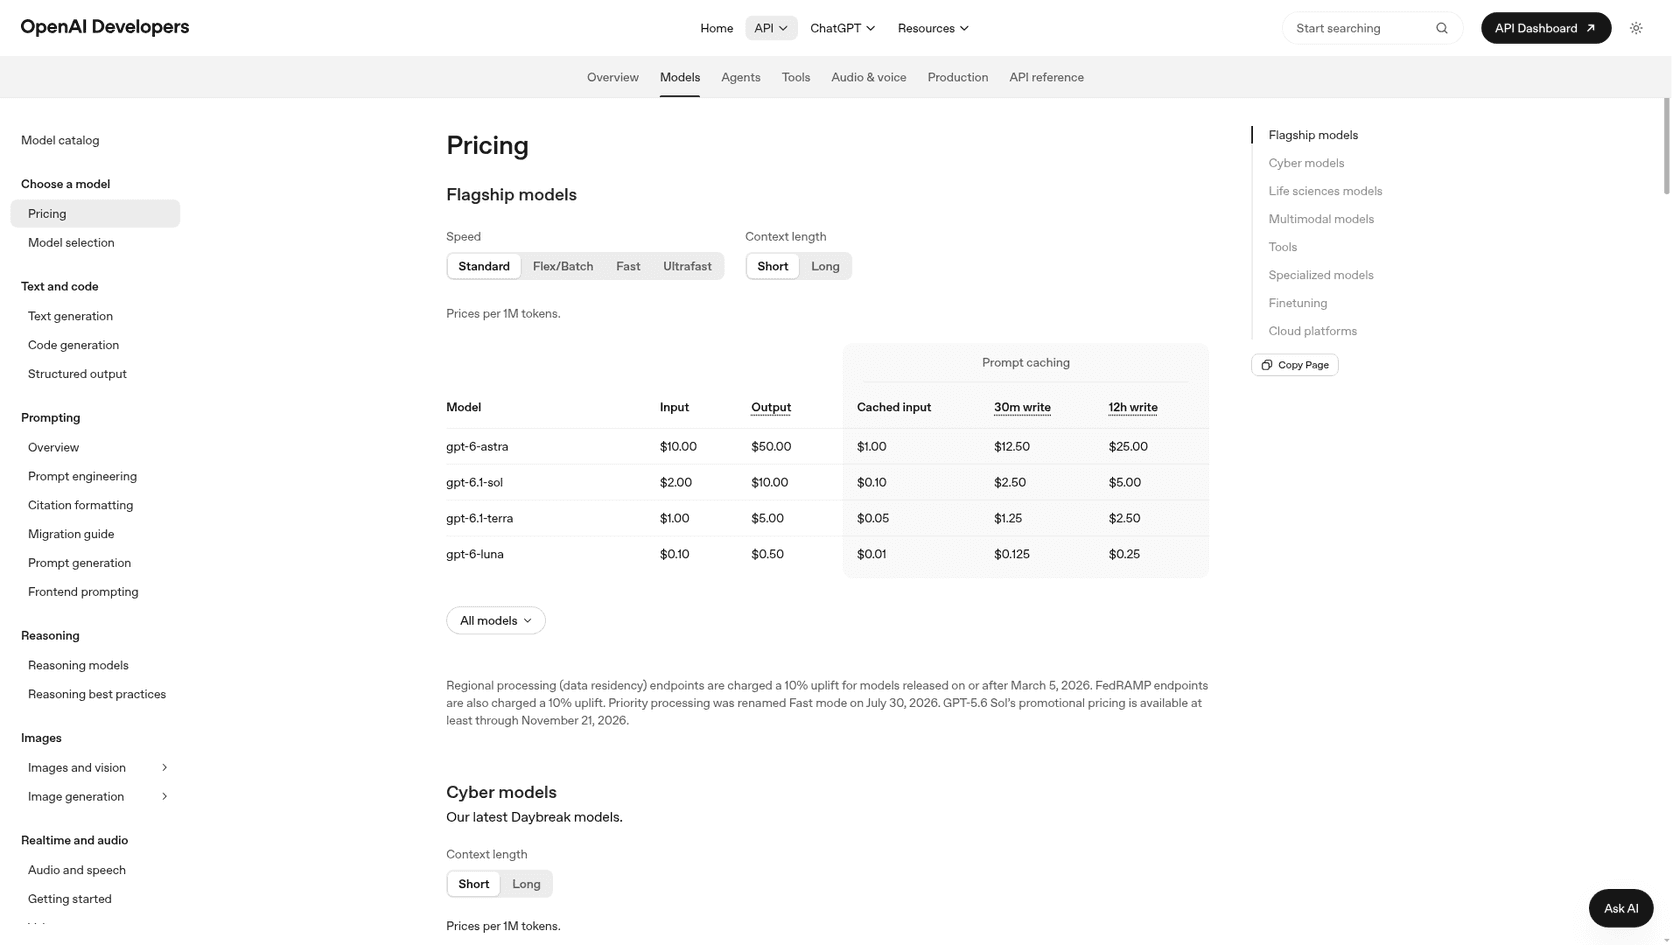
| GPT-6.1 Terra | Trabajo de frontera barato | 1 $ / 5 $ | 0,05 $ | 15 $ | Por encima de 272K cuesta 2x la entrada | No | Planes ChatGPT | No |
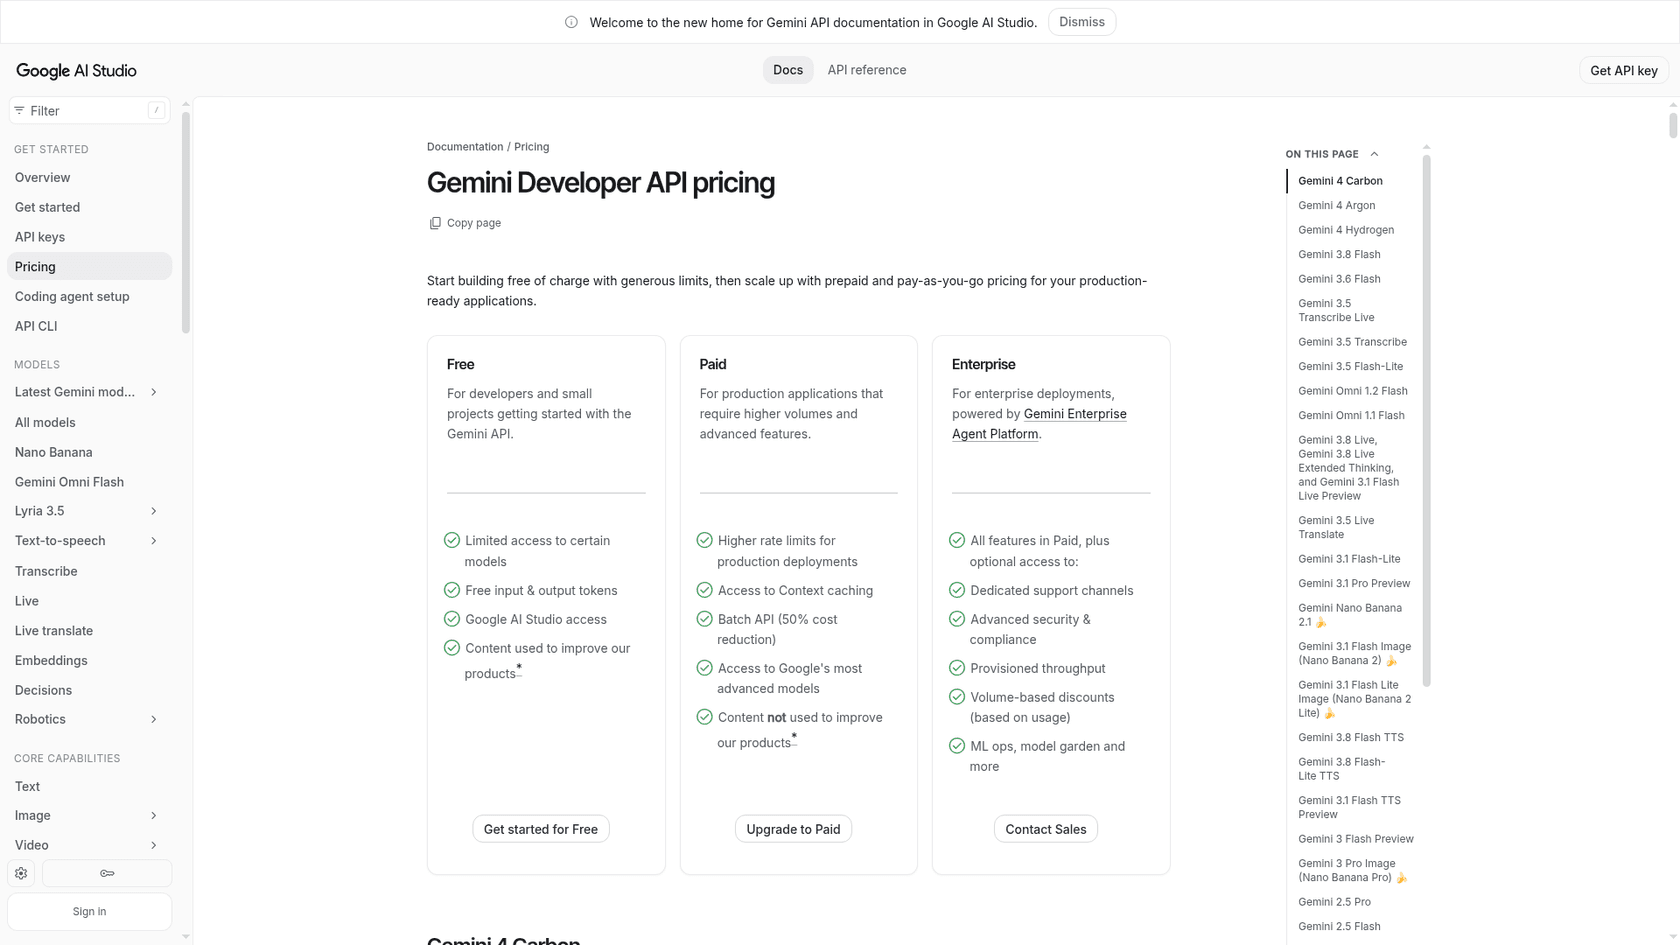
| Gemini 4 Argon | Trabajo rápido con Gemini 4 | 2 $ / 10 $ | 0,10 $ | 30 $ (60 $ desde el 1 dic.) | 1 M | No | No | Se duplica el 1 dic. |
| Gemini 4 Carbon | Agentes de largo recorrido | 2 $ / 10 $ | 0,10 $ | 30 $ (60 $ desde el 1 dic.) | 1 M | No | No | Se duplica el 1 dic. |
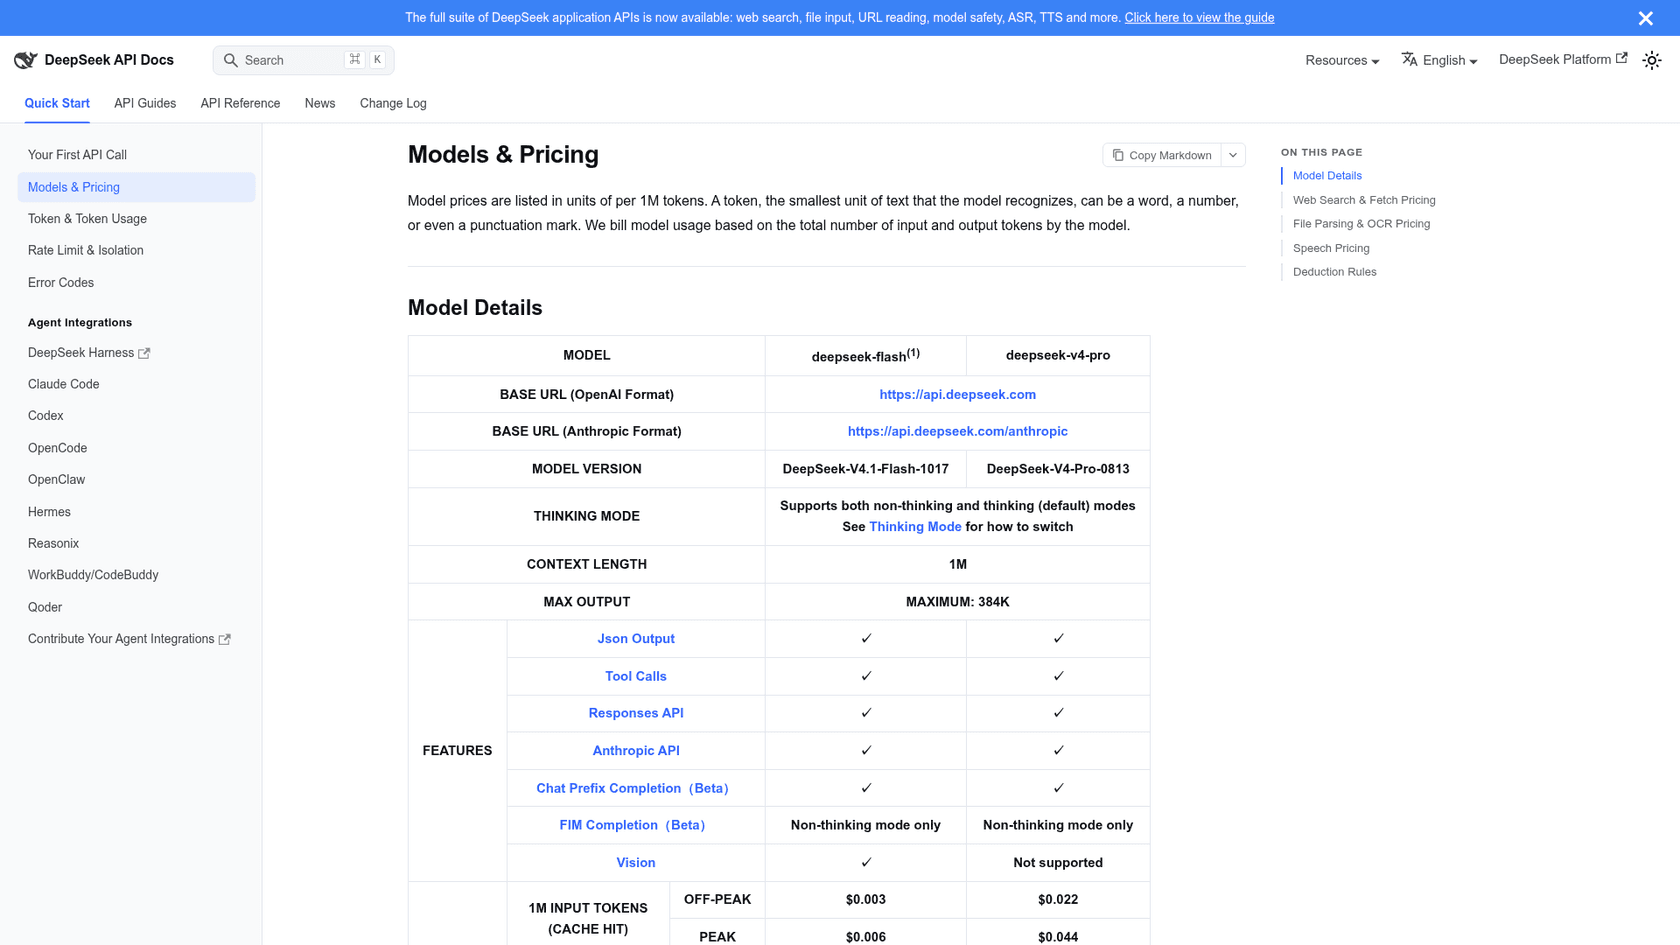
| DeepSeek V4.1 Flash | Trabajo masivo y económico | 0,15 $ / 0,60 $ fuera de hora punta | 0,003 $ | 2,10 $ (4,20 $ en hora punta) | 1 M | Sí | También en Token Plan | No |
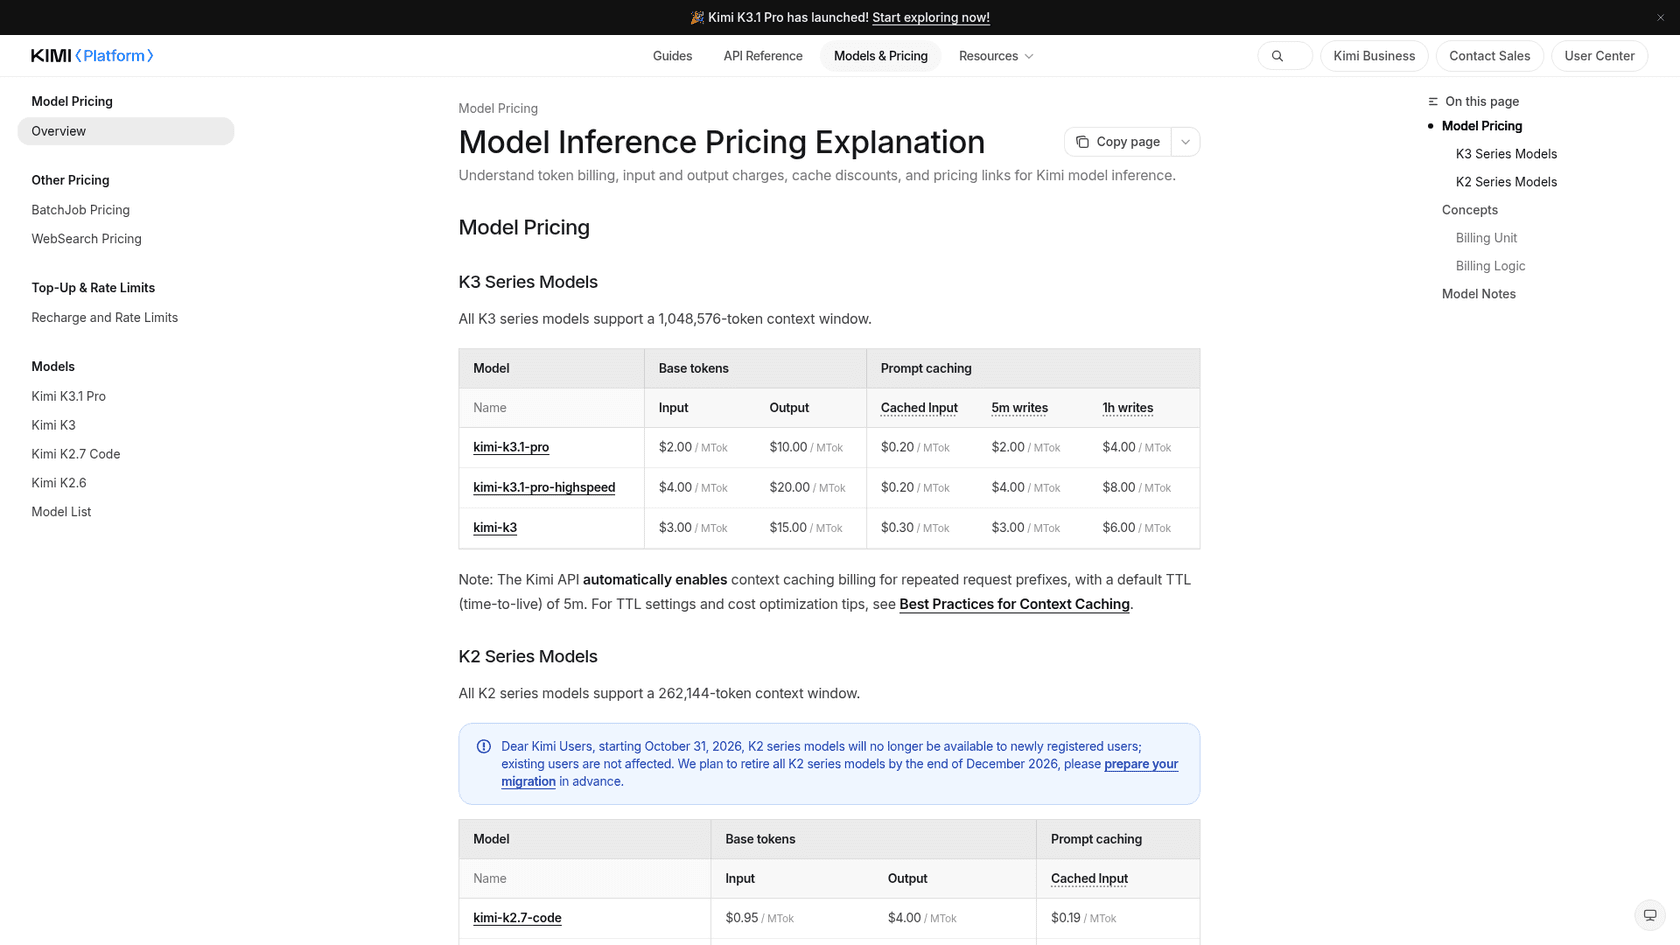
| Kimi K3.1 Pro | Opción de frontera no estadounidense | 2 $ / 10 $ | 0,20 $ | 30 $ | 1 M | No | 19 $ a 199 $/mes | No |
| Qwen3.8-Max | Quedarse en Token Plan | 2 $ / 6 $ | 0,25 $ | 26 $ | 1 M | No | Token Plan | No |
| qwen4-max (GA, de referencia) | Mismo modelo, sin cambios | 1,50 $ / 4,50 $ | 0,075 $ | 19,50 $ | 1 M | No | Token Plan | No |
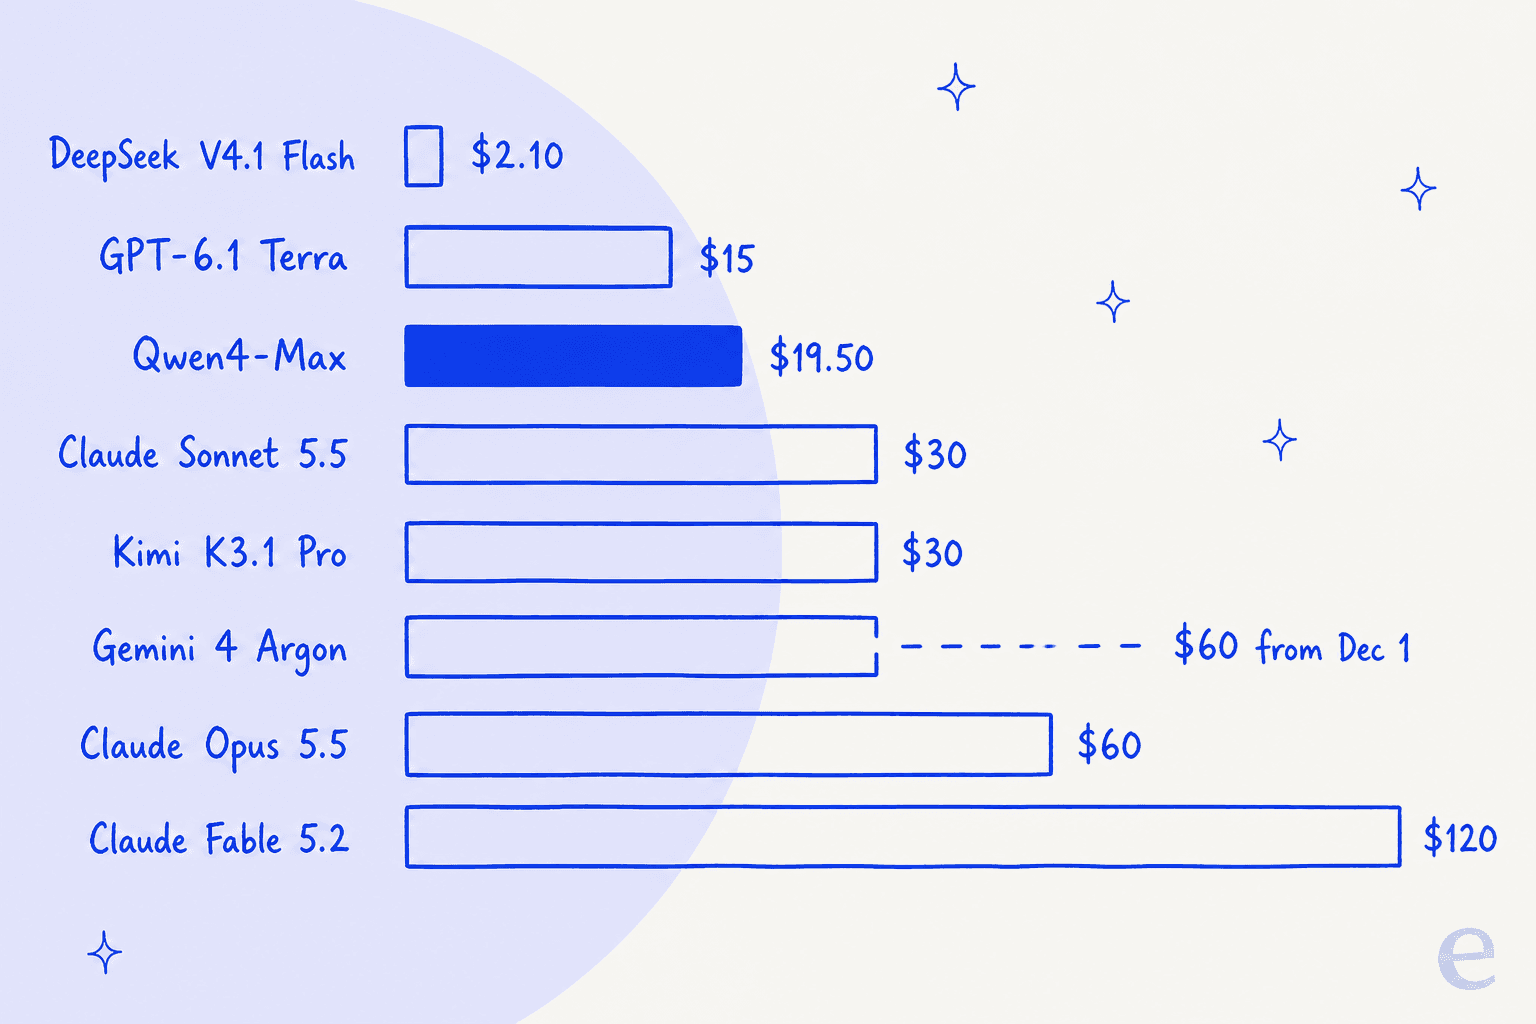
El gráfico es la sorpresa que la mayoría de quien cambia no espera: solo dos alternativas son más baratas que el GA Qwen 4 Max a precio de lista. Todo lo demás cuesta más al mes, así que un cambio tiene que justificarse por calidad, riesgo de proveedor o herramientas, no por ahorro.
Calcule su propio coste mensual
El comprador de 10 M/1 M es un sustituto. Introduzca su propio volumen y tasa de aciertos de caché a continuación. La entrada en caché se factura al precio de lectura de caché de cada proveedor; los descuentos de escritura en caché y de lote se dejan fuera para mantener la comparación simple.
Pruebe una tasa de aciertos de caché del 70 %, normal en un agente que vuelve a enviar el mismo prompt de sistema y contexto del repositorio en cada turno. Claude Sonnet 5.5 baja de 30 $ a unos 16,70 $, y qwen4-max baja a unos 9,53 $, así que la diferencia se reduce a cerca de 7 $.
¿Por qué cambiar de Qwen 4 Max?
Para ser justos con Alibaba, el modelo GA arregla la mayoría de los problemas de la vista previa: tiene un precio real por token, una API de pago por uso, y soporte en Claude Code, Codex y OpenCode. Los motivos por los que la gente aun así se va son más concretos:
- El descuento era el atractivo. Al 20 % de la tarifa estándar, la vista previa era casi gratis para usuarios intensivos. Un comentarista de HN resumió el atractivo así: "By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!" (linzhangrun, Hacker News). A tarifas GA, otros modelos vuelven a competir en precio.
- Poca evidencia pública. No había ninguna entrada independiente en tablas de clasificación para
qwen4-maxcuando lo comprobé, así que los equipos que necesitan cifras antes de producción tienen poco en lo que apoyarse. - Concentración de proveedor. Token Plan Personal se vende desde Singapur y, según nuestro artículo de precios, está pensado para uso interactivo, no para automatización de backend. Si de todos modos necesita un segundo proveedor, ahora es un buen momento para elegir uno.
- Un techo de salida más corto. El límite de razonamiento más respuesta del modelo GA, de 262.144 tokens, es menor que los 393.216 de la vista previa, lo que importa en generaciones de un solo turno muy largas.
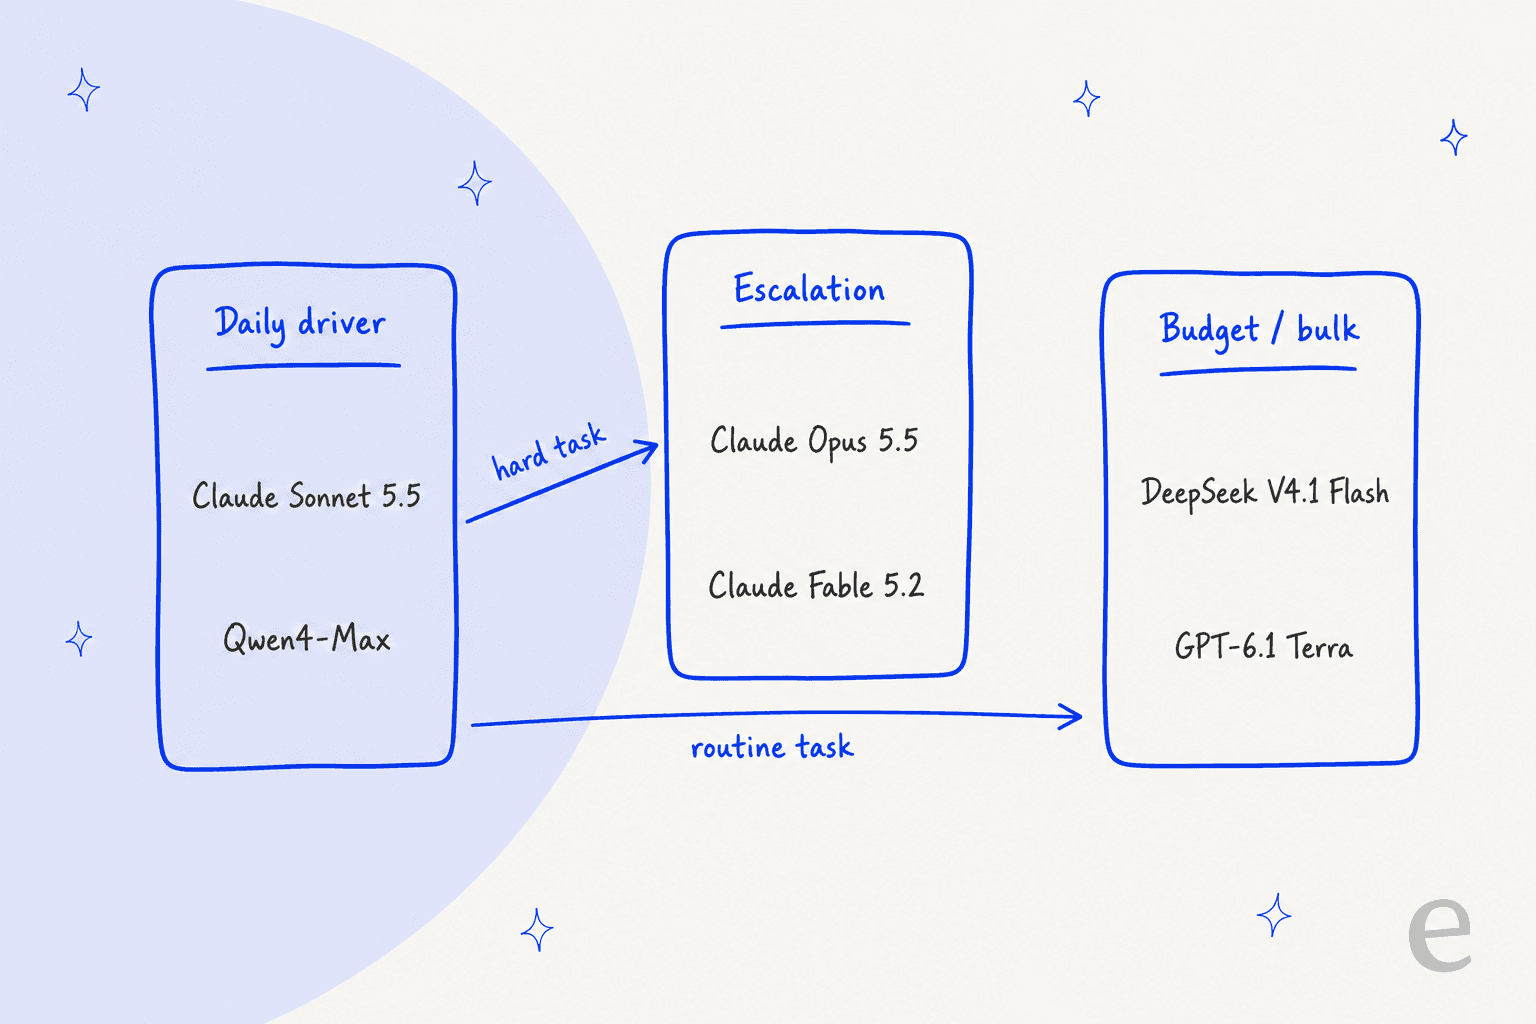
La forma en que la mayoría debería pensarlo no es un único reemplazo, sino tres puestos. ChatGPT dio el mismo consejo cuando le hice exactamente esta pregunta: un modelo diario, un modelo de escalado y un modelo económico.
1. Claude Sonnet 5.5
Mejor para: su modelo diario de código y agentes, especialmente dentro de Claude Code.
Qué hace bien
Sonnet 5.5 es el sustituto más parecido a cómo la mayoría usaba la vista previa de Qwen 4 Max: un programador agéntico fuerte con una ventana de contexto de 1 M de tokens. La página de Sonnet de Anthropic dice que funciona un 30 % más rápido y cuesta hasta un 30 % menos que Sonnet 5 para la mayoría del trabajo. Si su configuración era Claude Code apuntando al endpoint de Alibaba, este es el modelo alrededor del cual se construyó Claude Code, así que las llamadas a herramientas y las ediciones de archivos se comportan como el harness espera.
Ventajas
- Mismo precio de
2 $/10 $en toda la ventana de 1 M, sin recargo por contexto largo - Lecturas de caché a
0,10 $por millón, más baratas que Opus 5.5 y Fable 5.2 - Incluido en el plan gratuito de Claude para uso de chat
Desventajas
- Con el máximo esfuerzo, Artificial Analysis lo midió en
7,60 $por tarea, más que los5,98 $de Opus 5.5, según nuestro análisis de precios de Sonnet 5.5 30 $al mes para el comprador de 10 M/1 M, un 50 % más o menos que elqwen4-maxGA
Precio
2 $ de entrada y 10 $ de salida por millón de tokens, 0,10 $ de lecturas de caché, según la página de precios de Anthropic. Para el comprador de 10 M/1 M: 10 x 2 $ + 1 x 10 $ = 30 $ al mes.
Nuestra opinión: elija Sonnet 5.5 como predeterminado si quiere un modelo que simplemente funcione en Claude Code. Manténgalo en esfuerzo Low o Medium, y escale a Opus 5.5 en vez de llevar Sonnet a Max.
2. Claude Opus 5.5
Mejor para: el 10 % más difícil de las tareas: refactorizaciones de todo el repositorio, depuración complicada, ejecuciones autónomas largas.
Qué hace bien
Opus 5.5 es el puesto de escalado. Anthropic dice en su página de Opus que rinde al nivel de Claude Fable 5.1 en la mayoría del trabajo y cuesta un 40 % menos ejecutarlo que Opus 5, en parte porque termina con menos tokens y turnos. Esto último es lo que importa para los agentes: el precio por token es solo la mitad de la factura, y la reseña de Opus 5.5 cubre cuánto baja el número de pasos.
Ventajas
- Menos pasos por tarea, así que la factura real es menor de lo que sugiere la tarifa
- La API de lote reduce a la mitad ambas tarifas, a
2 $/10 $ - Modo rápido disponible cuando la latencia importa
Desventajas
4 $/20 $es 2,7 veces el precio de entrada del GA Qwen 4 Max y 4,4 veces el de salida60 $al mes para el comprador de 10 M/1 M si pasa todo por él
Precio
4 $ de entrada, 20 $ de salida, 0,20 $ de lecturas de caché por millón de tokens, según la página de precios de Anthropic. Para el comprador de 10 M/1 M: 40 $ + 20 $ = 60 $. Más detalles en nuestra guía de precios de Opus 5.5.
Nuestra opinión: no haga de Opus su opción por defecto. Dirija a Opus 5.5 con esfuerzo Medium las tareas en las que Sonnet o Qwen se atascan, y obtendrá la mayor parte de la calidad por una fracción de la factura de usar solo Opus.
3. Claude Fable 5.2
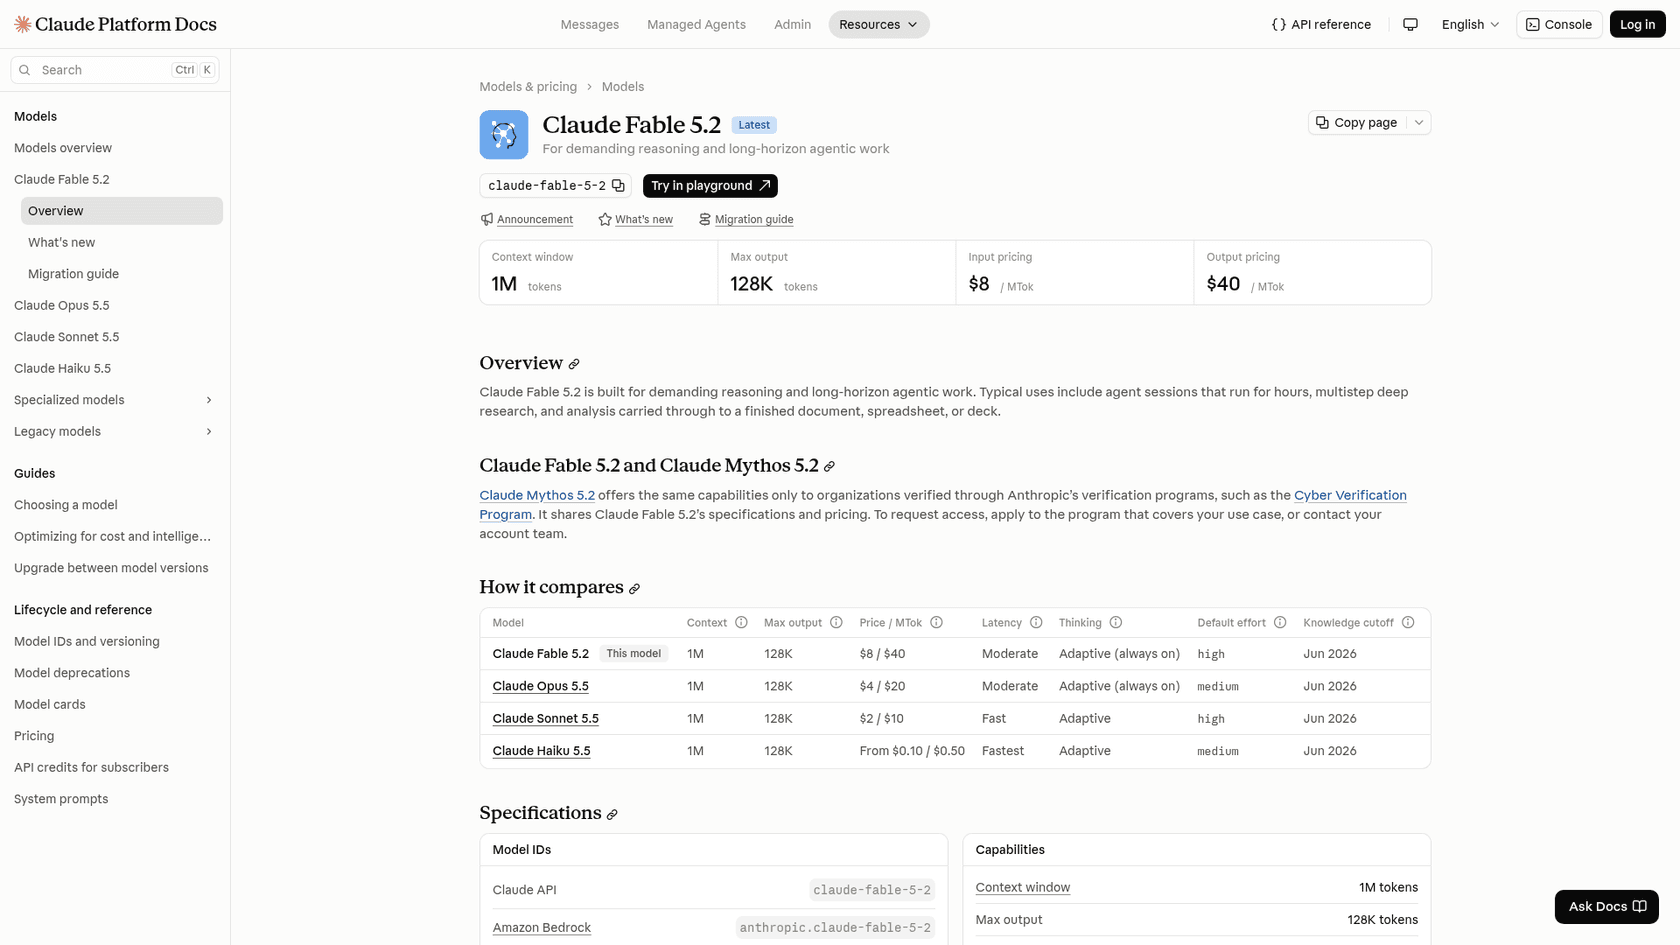
Mejor para: los trabajos de agentes más difíciles y largos, donde una ejecución fallida cuesta más que los tokens.
Qué hace bien
Fable 5.2 está por encima de Opus 5.5, y la respuesta de ChatGPT a mi pregunta señaló que lidera la tabla de clasificación de código que comprobó. El dato útil es el coste, no la posición: Anthropic midió que Fable 5.2 en High iguala a Opus 5.5 en Max por aproximadamente la mitad del coste por tarea, como se cubre en nuestro desglose de precios de Fable 5.2. Así que para trabajos en los que llevaría Opus a Max, Fable en High puede ser la opción más barata.
Ventajas
- El modelo más fuerte de esta lista para trabajo de largo recorrido
- Lecturas de caché a
0,20 $, igual que Opus 5.5 - Puede superar a Opus en coste por tarea con calidad equivalente
Desventajas
- Precio de
8 $/40 $, el más caro por token aquí - Límites de tasa separados y más bajos que Opus y Sonnet
- En el plan Pro funciona con créditos de uso, no con la asignación normal
Precio
8 $ de entrada, 40 $ de salida por millón de tokens, según la página de precios de Anthropic. Para el comprador de 10 M/1 M: 80 $ + 40 $ = 120 $.
Nuestra opinión: un especialista, no un modelo diario. Úselo donde de otro modo usaría Opus al máximo, y lea la reseña de Fable 5.2 antes de confiarle ejecuciones sin supervisión.
4. GPT-6.1 Terra
Mejor para: equipos que quieren un modelo de frontera barato de un segundo proveedor.
Qué hace bien
Terra es la única alternativa que supera en precio al GA Qwen 4 Max sin bajar a un modelo de clase Flash. A 1 $/5 $ cuesta la mitad por token que GPT-6.1 Sol, y Artificial Analysis lo situó en 0,05 $ por tarea con esfuerzo bajo y 0,40 $ con máximo, según nuestro artículo de precios de Terra. Si quiere un modelo de OpenAI en su rotación, este es el que debería probar primero.
Ventajas
15 $al mes para el comprador de 10 M/1 M, más barato queqwen4-max- Entrada en caché a
0,05 $, un descuento del 95 % - Lote y Flex reducen el precio a la mitad, a
0,50 $/2,50 $
Desventajas
- Los prompts de más de 272K tokens facturan toda la solicitud a
2 $de entrada y7,50 $de salida - No es la elección correcta si necesita toda la ventana de 1 M a tarifa fija
Precio
1 $ de entrada, 5 $ de salida, 0,05 $ de entrada en caché por millón de tokens, según la página de precios de OpenAI. Para el comprador de 10 M/1 M: 10 $ + 5 $ = 15 $.
Nuestra opinión: la mejor opción de valor si sus prompts se quedan por debajo de 272K. Para contexto de un repositorio entero, Sonnet 5.5 o qwen4-max mantienen la tarifa fija en todo 1 M.
5. Gemini 4 Argon
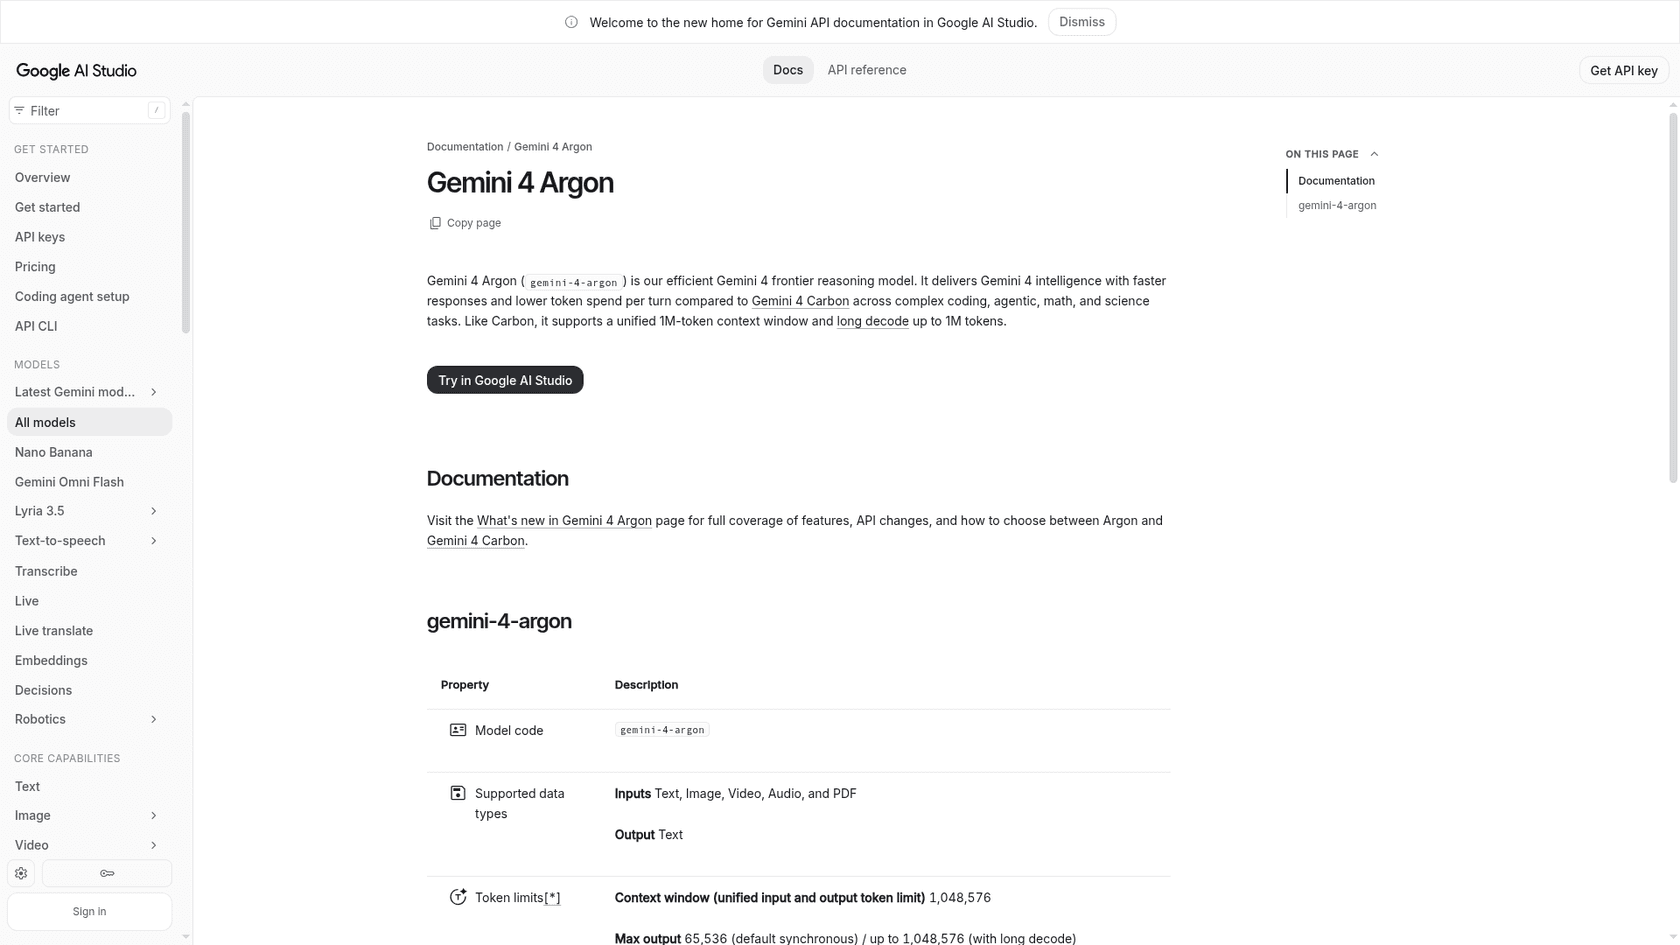
Mejor para: trabajo rápido con Gemini 4, si puede convivir con el cambio de precio de diciembre.
Qué hace bien
La página de precios de Google describe Argon como el modelo eficiente de Gemini 4, con respuestas más rápidas y menor gasto de tokens por turno que Carbon en tareas de código, agentes, matemáticas y ciencia. Su ventana de contexto es de 1.048.576 tokens, la misma clase que Qwen 4 Max. La lista reducida de ChatGPT sugirió Argon para trabajo habitual y Carbon para tareas autónomas difíciles, lo que coincide con el posicionamiento de Google.
Ventajas
2 $/10 $con0,10 $de entrada en caché hasta el 30 de noviembre- Contexto de 1 M, con decodificación larga de hasta 1 M de tokens de salida según la documentación
- Misma cuenta de Google y clave de API que otros modelos Gemini
Desventajas
- El precio se duplica a
4 $/20 $el 1 de diciembre de 2026 - Sin nivel gratuito para este modelo
- Solo caché implícita; la caché explícita no está soportada
Precio
2 $ de entrada y 10 $ de salida hasta el 30 de noviembre, luego 4 $ y 20 $ desde el 1 de diciembre, según la página de precios de Google. Para el comprador de 10 M/1 M: 30 $ ahora, 60 $ desde diciembre. Consulte nuestra guía de precios de Argon para las cuentas de coste por tarea.
Nuestra opinión: presupueste con 4 $/20 $, no con la promoción. A ese precio cuesta lo mismo que Opus 5.5, así que pruebe ambos con su carga de trabajo antes de decidirse.
6. Gemini 4 Carbon
Mejor para: agentes de largo recorrido y el razonamiento más difícil en la plataforma de Google.
Qué hace bien
Carbon es el modelo de razonamiento más capaz de Google, construido para ingeniería de software compleja, agentes autónomos de varios pasos y decodificación larga de hasta 1 M de tokens, según la página de precios. La cifra interesante: en Artificial Analysis, Carbon costó 7,76 $ por tarea a precio de lista frente a 7,68 $ de Argon, pero puntuó 59 frente a 50. Misma factura, nueve puntos más.
Ventajas
- Mismo precio que Argon, así que no paga nada extra por el modelo más fuerte
- Contexto de 1 M y hasta 1 M de tokens de salida
Desventajas
- La misma duplicación de precio del 1 de diciembre que Argon
- Escribe muchos tokens por tarea, así que el coste por tarea sale alto
Precio
2 $/10 $ hasta el 30 de noviembre, 4 $/20 $ desde el 1 de diciembre, según la página de precios de Google. Para el comprador de 10 M/1 M: 30 $, luego 60 $. Más detalles en nuestro artículo de precios de Carbon.
Nuestra opinión: si va a pasarse a Gemini, vaya a Carbon en vez de Argon para trabajo de agentes. La reseña de Carbon tiene el detalle de los benchmarks.
7. DeepSeek V4.1 Flash
Mejor para: pasos de agentes rutinarios y de alto volumen donde el precio importa más que la calidad punta.
Qué hace bien
DeepSeek V4.1 Flash es, por un amplio margen, el modelo serio más barato de esta lista. En la página de precios de DeepSeek, el modelo deepseek-flash (DeepSeek-V4.1-Flash-1017) cuesta 0,15 $ de entrada y 0,60 $ de salida fuera de hora punta, con una ventana de contexto de 1 M y hasta 384K de salida. Soporta llamadas a herramientas, salida JSON, visión y tanto el formato de API de OpenAI como el de Anthropic, así que se integra en configuraciones al estilo de Claude Code. Y si quiere quedarse en la factura de Alibaba, la documentación de Token Plan también lista deepseek-v4.1-flash, con un 50 % de descuento por la noche.
Ventajas
2,10 $al mes para el comprador de 10 M/1 M fuera de hora punta- Aciertos de caché a
0,003 $por millón - Disponible en Token Plan además de en la propia API de DeepSeek
Desventajas
- Las horas punta (01:00 a 04:00 y 06:00 a 10:00 UTC, días laborables) duplican cada tarifa
- Un modelo de clase Flash, así que mantenga un modelo más fuerte para tareas difíciles
Precio
0,15 $ de entrada (fallo de caché), 0,003 $ (acierto de caché), 0,60 $ de salida por millón de tokens fuera de hora punta; el doble en hora punta, según DeepSeek. Para el comprador de 10 M/1 M: 1,50 $ + 0,60 $ = 2,10 $ fuera de hora punta, 4,20 $ en hora punta. Vea nuestra guía de precios de V4.1 Flash.
Nuestra opinión: el puesto económico. Dirija aquí el trabajo masivo como resumir registros, escribir tests y ediciones simples, y mantenga Sonnet 5.5 o qwen4-max para todo lo que requiera criterio.
8. Kimi K3.1 Pro
Mejor para: desarrolladores que quieren un modelo de frontera no estadounidense fuerte con opción de tarifa fija.
Qué hace bien
Kimi K3.1 Pro es la elección obvia si lo que le gustaba de Qwen era tener un modelo capaz fuera de los grandes laboratorios estadounidenses. La guía rápida de Moonshot lo describe como un modelo de clase 3T con ventana de contexto de 1 M, y la API habla tanto el formato de OpenAI como el de Anthropic, así que funciona en Claude Code. Según nuestro análisis de precios de K3.1 Pro, promedió 2,11 $ por tarea en Artificial Analysis, menos de la mitad del coste por tarea de Sonnet 5.5 u Opus 5.5 con esfuerzo máximo.
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
Ventajas
2 $/10 $por token, o planes de tarifa fija de19 $a199 $al mes- Variante highspeed a aproximadamente 2-3x la velocidad
- Moonshot cita grandes mejoras en código, creación 3D e investigación financiera
Desventajas
- Escribe muchos tokens, así que el ahorro por tarea es menor de lo que sugiere el precio de lista
- Los planes de suscripción tienen un límite de 5 horas renovable que los primeros compradores alcanzan rápido
Precio
2 $ de entrada, 10 $ de salida, 0,20 $ de entrada en caché por millón de tokens; Highspeed 4 $/20 $, según la página de precios de Kimi. Para el comprador de 10 M/1 M: 30 $.
Nuestra opinión: un buen segundo proveedor si quiere evitar tanto a Alibaba como a los laboratorios estadounidenses. Lea la reseña de K3.1 Pro antes de comprar un plan de suscripción para uso intensivo de agentes.
9. Qwen3.8-Max
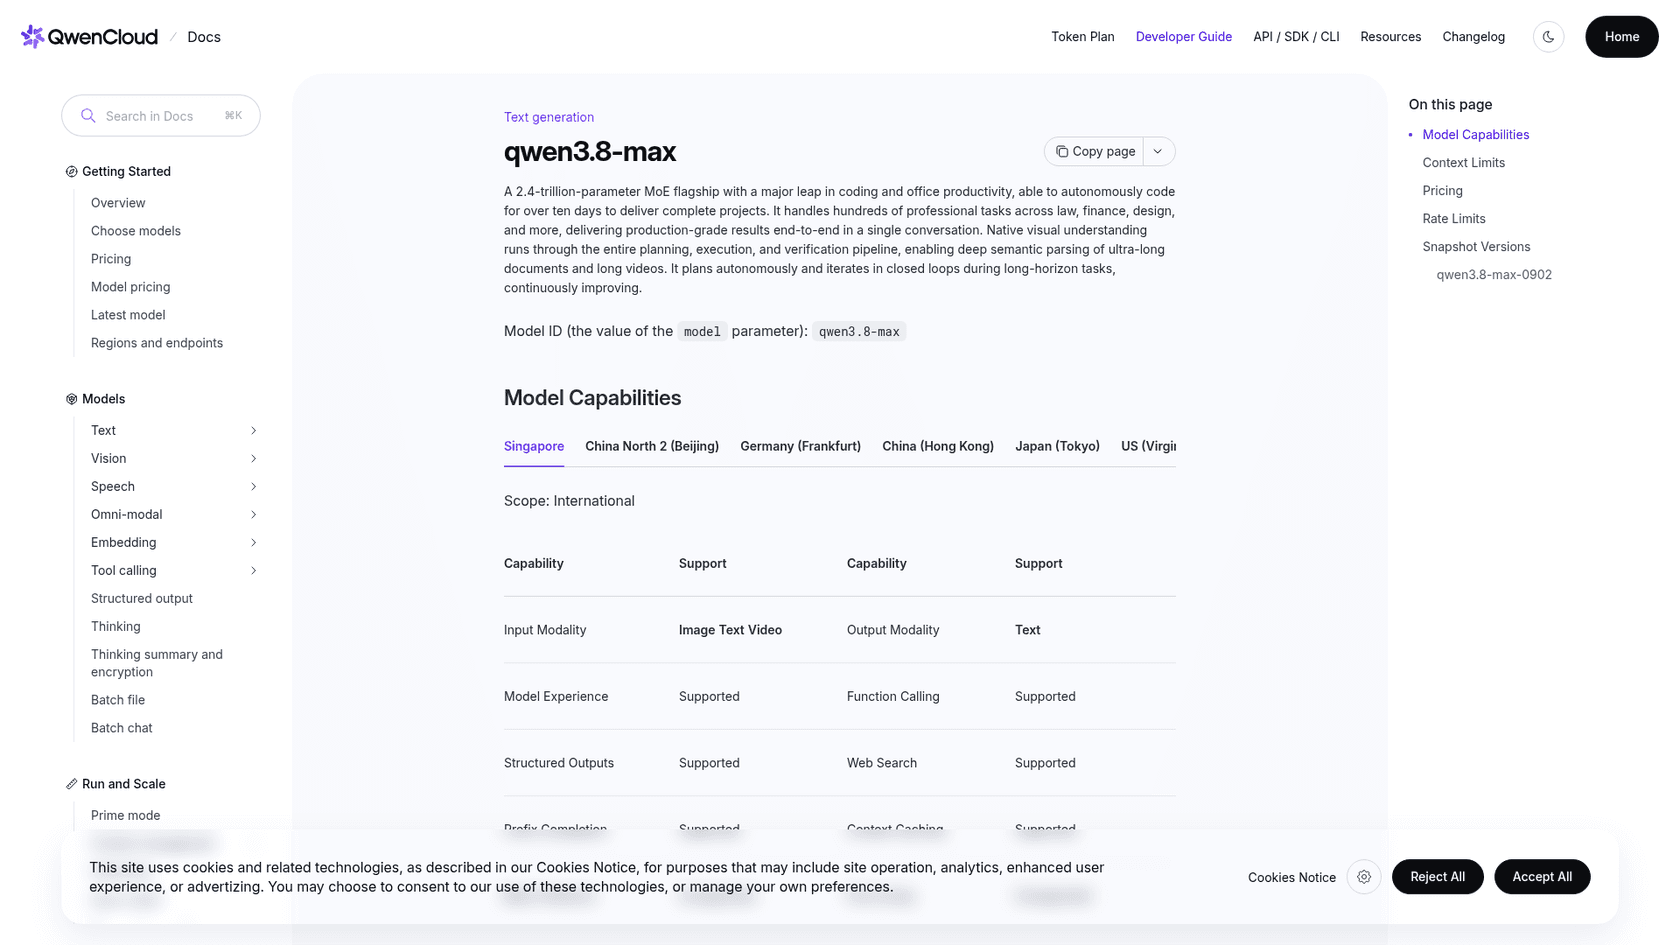
Mejor para: usuarios de Token Plan que quieren un buque insignia de Qwen más antiguo y mejor documentado, con descuento nocturno.
Qué hace bien
Qwen3.8-Max es la opción de respaldo dentro de la familia. Alibaba lo describe como un buque insignia MoE de 2,4 billones de parámetros capaz de programar de forma autónoma durante tramos largos, y funciona en el mismo Token Plan que Qwen 4 Max, así que sus claves y endpoints no cambian. En Token Plan sigue teniendo un 60 % de descuento entre las 22:00 y las 08:00 UTC+8, que coincide con el horario laboral de EE. UU. Nuestra reseña de Qwen3.8-Max cubre cómo aguantó tras el lanzamiento.
Ventajas
- Sin cambios de configuración más allá del ID del modelo si ya está en Token Plan
- El descuento nocturno sigue vigente en Token Plan
- Meses de uso por parte de la comunidad detrás
Desventajas
- Más caro que el GA
qwen4-maxen la API de pago por uso (2 $/6 $frente a1,50 $/4,50 $) - Una generación más antigua que el modelo que está sustituyendo
Precio
2 $ de entrada y 6 $ de salida por millón de tokens en Singapur, 1,65 $ y 4,951 $ en Pekín, según la página de qwen3.8-max de Alibaba. Para el comprador de 10 M/1 M: 26 $.
Nuestra opinión: solo vale la pena en Token Plan, por el descuento nocturno. En la API, el GA qwen4-max es más nuevo y más barato, así que hay poco motivo para dar un paso atrás.
¿Qué alternativa a Qwen 4 Max se ajusta a su configuración?
Su respuesta depende principalmente de dónde ejecutaba la vista previa:
- Claude Code en Token Plan: cambie primero el ID del modelo a
qwen4-max. Si los resultados decepcionan, mueva el slot de Opus a Claude Opus 5.5 y el de Sonnet a Claude Sonnet 5.5. - Su propio agente sobre una API: añada un segundo proveedor. Sonnet 5.5 o GPT-6.1 Terra como modelo diario, DeepSeek V4.1 Flash para llamadas masivas.
- Sobre todo por el descuento: DeepSeek V4.1 Flash fuera de hora punta es lo más cercano al precio de la vista previa.
- Ejecuciones autónomas de largo recorrido: Claude Fable 5.2 o Gemini 4 Carbon, probados en paralelo antes del 1 de diciembre.
- Un bot de soporte o de cara al cliente: no ponga ningún modelo de vista previa delante de clientes. Ese es el caso de un agente gestionado, de lo que hablamos a continuación.
| Si necesita | Elija | Coste mensual (10 M de entrada, 1 M de salida) |
|---|---|---|
| El menor cambio | qwen4-max (GA) | 19,50 $ |
| El mejor modelo diario de código | Claude Sonnet 5.5 | 30 $ |
| Las tareas más difíciles | Claude Opus 5.5 o Fable 5.2 | 60 $ o 120 $ |
| El precio más bajo | DeepSeek V4.1 Flash | 2,10 $ fuera de hora punta |
| Segundo proveedor con presupuesto ajustado | GPT-6.1 Terra | 15 $ |
| Modelo de frontera no estadounidense | Kimi K3.1 Pro | 30 $ |
¿Y si la vista previa estaba al frente de su cola de soporte?
Entonces el ID del modelo nunca fue el verdadero problema. Una vista previa de dos semanas que se retira en una fecha fija es el ejemplo más claro de por qué los equipos de soporte no deberían conectar un modelo en bruto directamente a su helpdesk: cada cambio del proveedor se convierte en su migración, su nueva prueba y su riesgo.
Ese es el hueco que llena eesel. Modelos como los de arriba son infraestructura; eesel es el empleado. Su compañero de IA para el helpdesk se conecta a Zendesk o Freshdesk, aprende de sus tickets pasados y su centro de ayuda, y se prueba contra conversaciones históricas antes de responder a un cliente real. Cuando sale un modelo mejor, el cambio sucede del lado de eesel.
Dos clientes muestran cómo es esto en la práctica:
- SE Ranking gestiona tres productos desde un único equipo de Zendesk, con un agente de eesel por producto que busca en unas 16.800 páginas de contenido de ayuda. Gestionó unas 4.650 conversaciones en un mes, y nada de eso dependía de qué modelo había debajo.
- OroSoft fabrica software para el comercio de lingotes y da soporte a sus clientes a través de Freshdesk. eesel redacta respuestas a partir de 6.100 tickets pasados y 20 archivos de centro de ayuda y referencia, indica qué ticket o artículo usó, y avisa a una persona cuando no encuentra base para una respuesta.
Pruebe eesel
Si estaba probando la vista previa de Qwen 4 Max para responder a clientes, eesel le da ese agente sin el cambio de modelo: se une a su helpdesk en minutos, redacta o envía respuestas a partir de su propio contenido de ayuda, y usted ve cómo habría respondido a sus tickets pasados antes de que salga en vivo. Los planes empiezan en 299 $ al mes en la página de precios de eesel, con 100 créditos gratis para probarlo. Un agente de código puede llevar la configuración a través de la CLI de eesel, subiendo artículos de ayuda aprobados y haciendo preguntas de prueba, mientras que conectar el propio helpdesk sigue necesitando que un administrador lo apruebe.
Pruebe eesel gratis, o lea primero cómo funciona la IA para Zendesk.