

Qwen 4 Max es el próximo modelo insignia de Alibaba, y hoy solo puedes acceder a él como qwen4-max-preview en la suscripción Token Plan, desde 3 $ al mes para nuevos usuarios, hasta el 25 de noviembre de 2026. Es un modelo de razonamiento multimodal con contexto de 1M y un máximo de 393.216 tokens de salida. La configuración es donde la gente tropieza: la propia configuración de Claude Code de Alibaba pone a Qwen 4 Max en el slot de Opus y al router auto en el slot principal, así que puede que no estés llamando a Qwen 4 Max a menos que elijas Opus. Para IA en tickets de soporte, eesel funciona en cambio con modelos estables, y su CLI de eesel permite que un agente de código cargue artículos de ayuda y pruebe respuestas primero.
¿Qué es Qwen 4 Max?
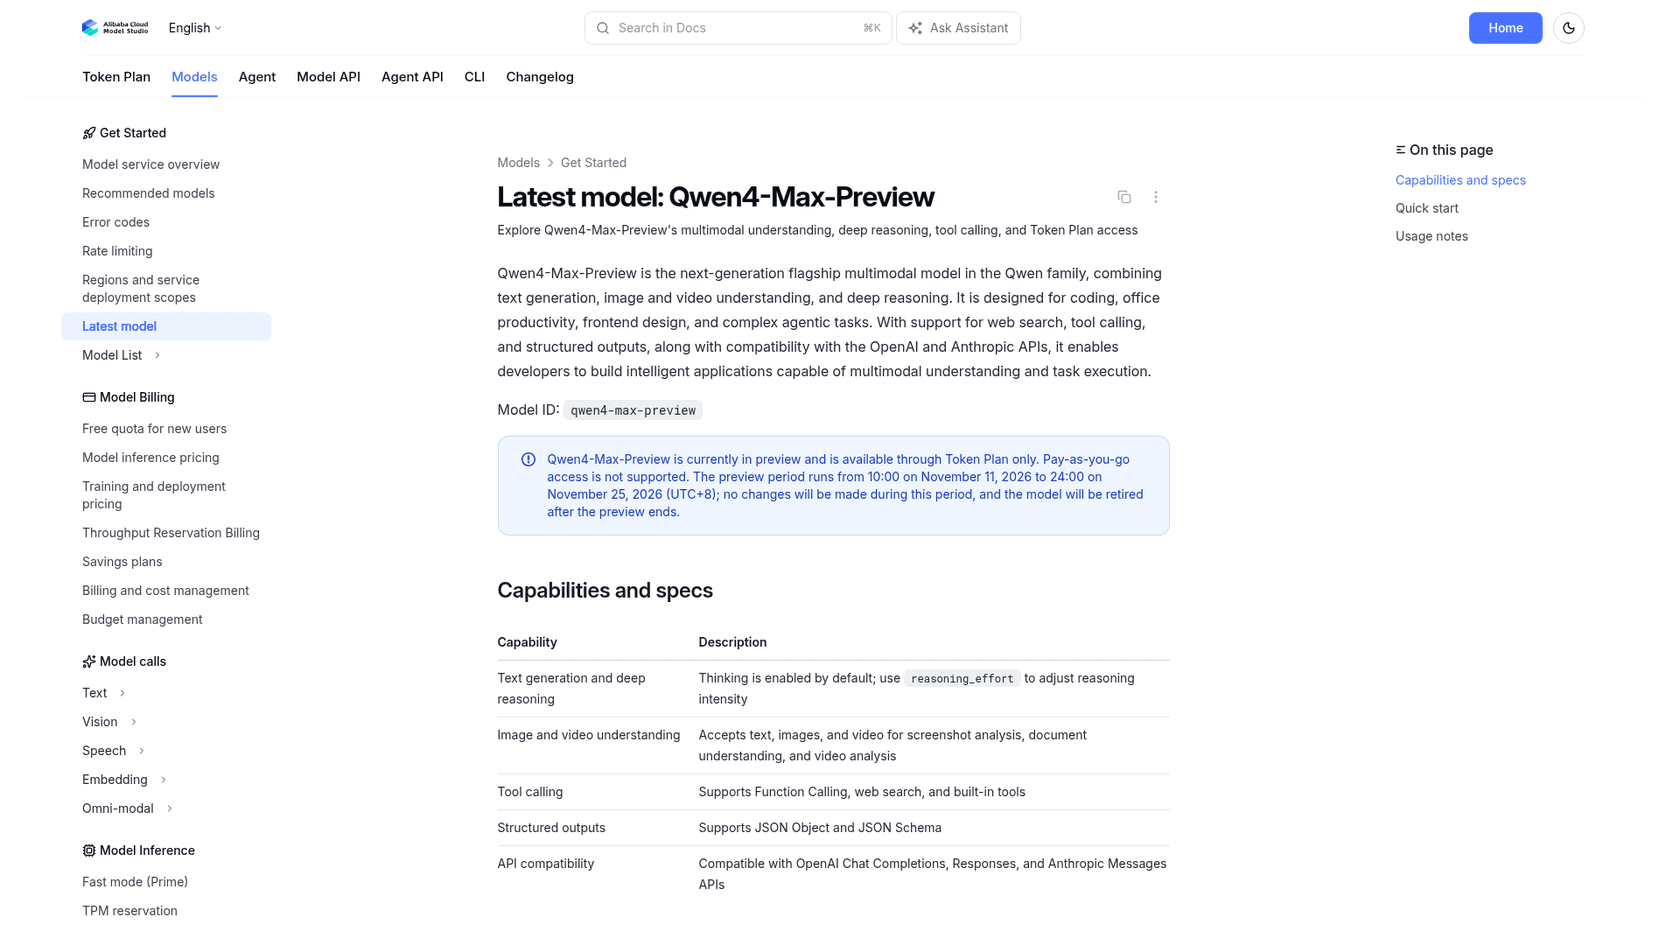
Qwen 4 Max es el primer modelo de la generación Qwen 4 de Alibaba, lanzado el 11 de noviembre de 2026 como una vista previa llamada qwen4-max-preview. La documentación del modelo de Alibaba lo describe como el modelo multimodal insignia de nueva generación de la familia Qwen, orientado a programación, trabajo de oficina, diseño frontend y tareas de agentes.
Me dedico a construir integraciones en eesel, así que cuando sale un modelo nuevo mi primera pregunta es aburrida: ¿qué pongo en la configuración, y qué se rompe al hacerlo? Este post responde eso. Si quieres mi opinión sobre si el modelo es bueno, está en la reseña de Qwen 4 Max de mi colega.
Esto es todo lo que Alibaba ha confirmado hasta ahora:
| Especificación | Qwen 4 Max preview |
|---|---|
| ID del modelo | qwen4-max-preview (alias qwen4.0-max-preview, las facturas muestran el alias) |
| Entrada | Texto, imágenes y video |
| Longitud de contexto | 1M de tokens |
| Salida máxima | 393.216 tokens, compartidos entre el razonamiento y la respuesta |
| Razonamiento | Activado por defecto; low, medium o xhigh (por defecto) |
| Herramientas | Function calling, búsqueda web, herramientas integradas |
| Salida estructurada | JSON Object y JSON Schema |
| Formatos de API | OpenAI Chat Completions, Responses, Anthropic Messages |
| Acceso | solo Token Plan, sin pago por uso |
| Disponibilidad | 11 nov., 10:00 a 25 nov., 24:00, 2026 (UTC+8), luego se retira |
No hay recuento de parámetros, ni pesos abiertos, ni ficha de modelo, ni tabla de benchmarks. Eso es normal para una vista previa de dos semanas, pero significa que es un modelo para probar, no uno sobre el que planificar.
¿Dónde se ubica Qwen 4 Max en la gama Qwen?
Qwen 4 Max se sitúa en la cima de la gama alojada de Alibaba, un escalón por encima de Qwen 3.8 Max. La lista de modelos de Token Plan los coloca uno junto al otro, lo que da la imagen más clara de lo que realmente puedes llamar hoy:
| ID del modelo en Token Plan | Para qué lo lista Alibaba | Estado |
|---|---|---|
qwen4-max-preview | Razonamiento, comprensión visual, texto | Vista previa, se retira el 25 de nov. |
qwen3.8-max | Razonamiento, comprensión visual, texto | Lanzado |
qwen3.8-flash | Razonamiento, comprensión visual, texto | Lanzado |
qwen3.7-max | Razonamiento, texto | Lanzado |
qwen3.7-plus | Razonamiento, comprensión visual, texto | Lanzado |
qwen3.6-flash | Razonamiento, comprensión visual, texto | Lanzado |
auto | Elige un modelo por solicitud | Router de la plataforma |
El mismo plan también incluye DeepSeek V4.1 Flash, DeepSeek V4 Pro, GLM 5.3 y GLM 5.2, además de modelos de imagen, video y voz. Así que una sola suscripción te da Qwen 4 Max junto a un puñado de modelos con los que compararlo en la misma tarea, que es el mejor uso de la vista previa.
Lo que falta es la parte que a mucha gente le gusta más de Qwen: los modelos más pequeños que se ejecutan en local. El nivel Max solo está alojado, y la vista previa sale sin pesos abiertos. Si ejecutas Qwen en tu propio hardware, los modelos Qwen 4 más pequeños son los que hay que vigilar, y Qwen 3.8 Flash Next es la opción actual mientras tanto.
¿Cuánto cuesta Qwen 4 Max?
No hay un precio por token para Qwen 4 Max. Pagas una suscripción a Token Plan en créditos, y Alibaba no publica la tarifa estándar de créditos para una llamada a Qwen 4 Max, solo el descuento de vista previa sobre ella. Los niveles de la Personal Edition vienen de la documentación de Token Plan:
| Plan | Precio de lista | Precio para nuevos usuarios | Créditos mensuales | Agentes simultáneos |
|---|---|---|---|---|
| Lite | 6 $/mes | 3 $/mes | 20.000 | 1-2 |
| Essential | 10 $/mes | 5 $/mes | 45.000 | 2-3 |
| Standard | 18 $/mes | - | 80.000 | 3-4 |
| Pro | 43 $/mes | - | 200.000 | 6-8 |
El precio para nuevos usuarios dura hasta las 23:59 del 30 de noviembre de 2026 (UTC+8), para cuentas que nunca han comprado una suscripción Personal. Los paquetes adicionales cuestan 15 $ por 20.000 créditos, hasta cinco a la vez. Durante la vista previa, Qwen 4 Max consume créditos al 20% de la tarifa estándar, y al 8% entre las 22:00 y las 08:00 hora de Pekín, que es la jornada laboral de EE. UU.
Hay dos cosas en los términos que vale la pena leer antes de pagar. La Personal Edition no se puede cancelar, así que elige el periodo más corto. Y los créditos no usados no se trasladan al mes siguiente. Para una prueba de dos semanas, el plan Lite de 3 $ es todo lo que necesita la mayoría. Si quieres un modelo con una tarifa fija con la que planificar un presupuesto, los precios de Qwen 3.8 Max son 2 $ de entrada y 6 $ de salida por 1M de tokens.
¿Cómo consigues acceso a Qwen 4 Max?
Consigues acceso en tres pasos, según la guía de inicio rápido de Token Plan de Alibaba: suscribirte, generar una clave y apuntar tu herramienta al endpoint correcto.
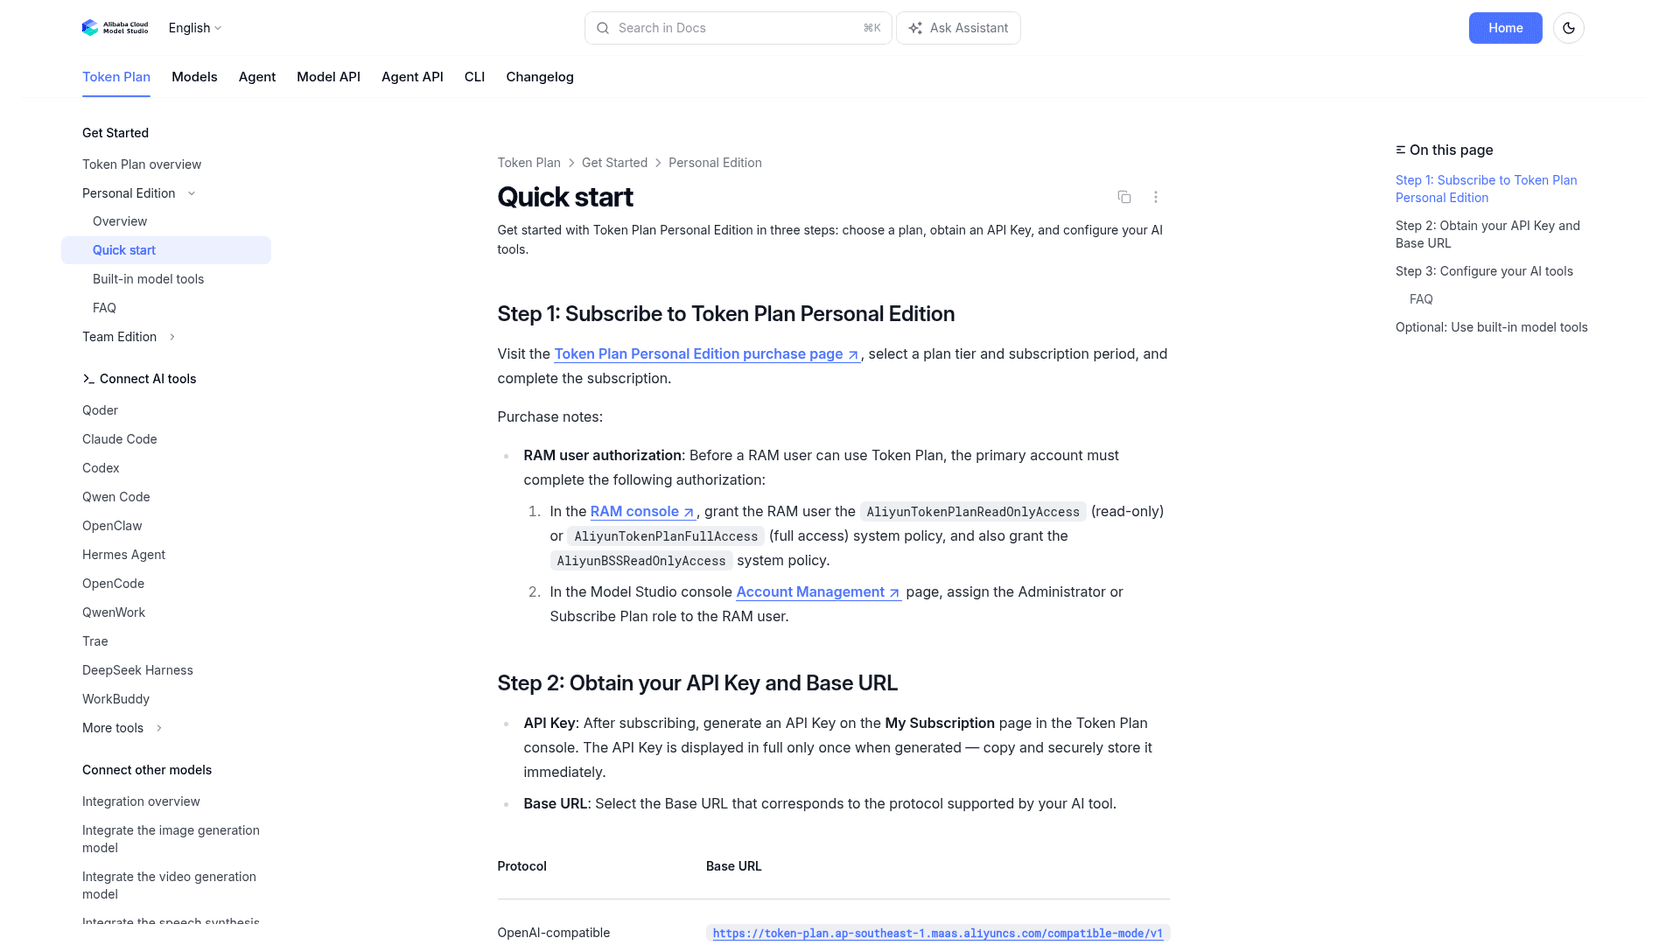
- Suscríbete a Token Plan Personal (solo región de Singapur) y elige un nivel.
- Genera una clave API en la página My Subscription. Se muestra completa solo una vez, así que cópiala de inmediato. Las claves de Token Plan empiezan por
sk-sp-. - Usa la URL base de Token Plan para el protocolo de tu herramienta:
| Protocolo | URL base |
|---|---|
| Compatible con OpenAI | https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1 |
| Compatible con Anthropic | https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic |
Luego pon el ID del modelo en qwen4-max-preview.
La clave y el endpoint tienen que coincidir
Este es el error que cuesta dinero real. Alibaba tiene tres canales de facturación separados, Token Plan, Coding Plan y pago por uso, cada uno con sus propias claves y URLs base. La FAQ de Token Plan dice que usar el endpoint general dashscope-intl.aliyuncs.com o una clave de Coding Plan enruta las llamadas por pago por uso en su lugar, y esos cargos no se pueden compensar con créditos ni reembolsar.
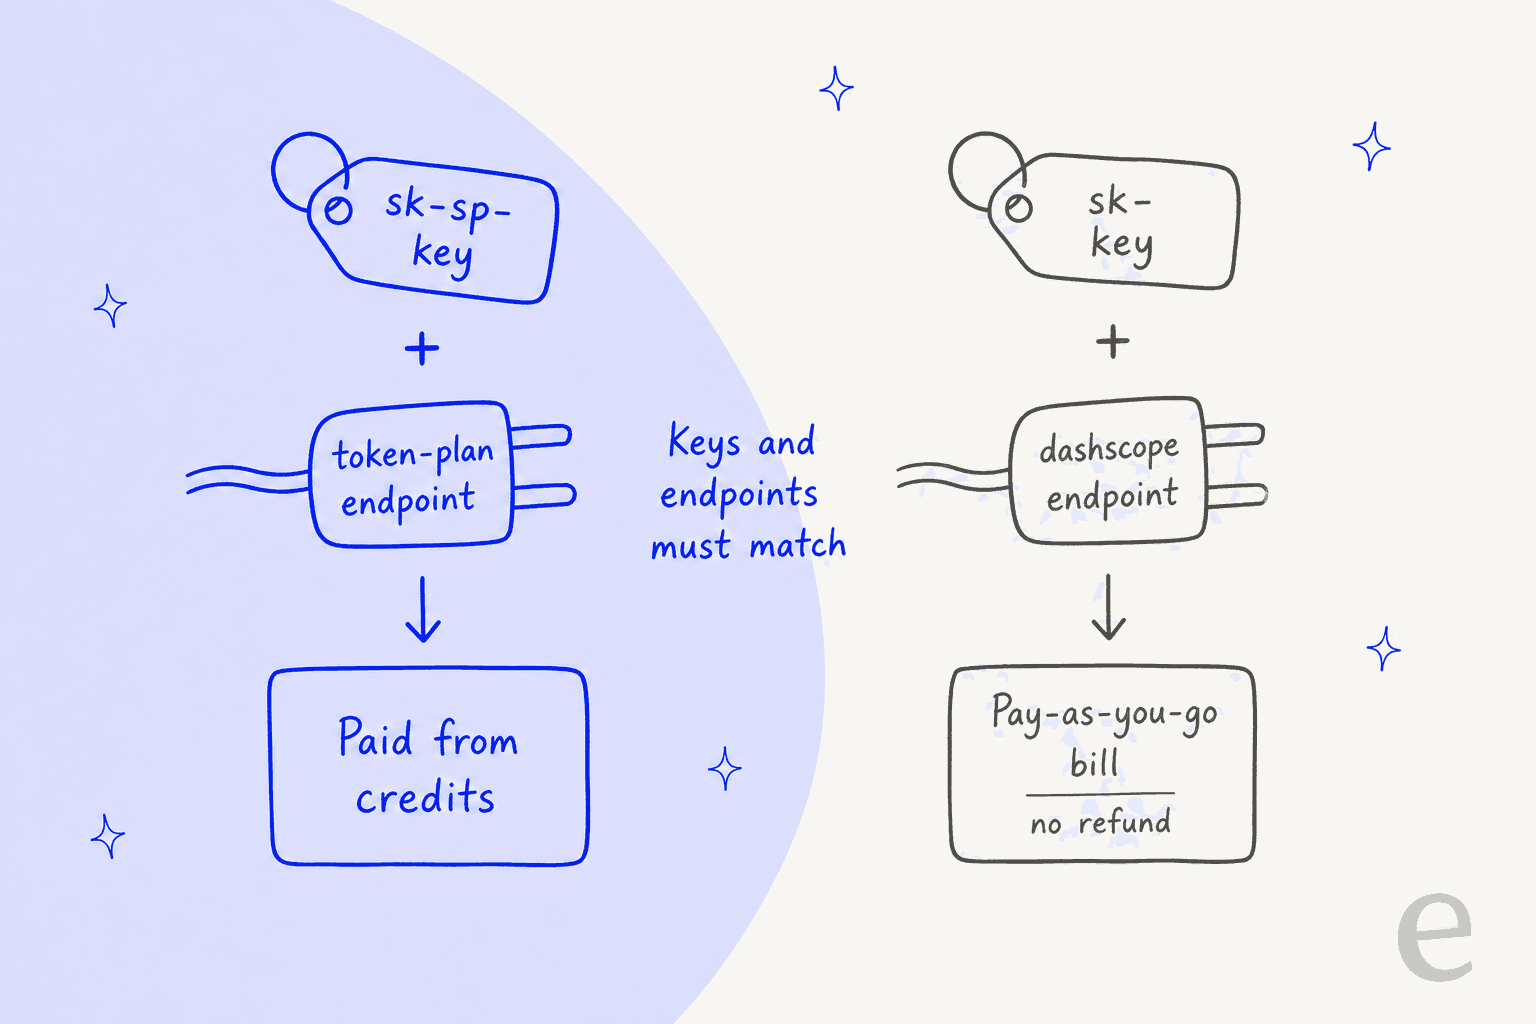
Si ya has usado Qwen a través de Alibaba antes, la configuración de tu herramienta probablemente todavía tenga una clave sk- antigua y la URL de DashScope. Cambia la clave, la URL y el nombre del modelo.
¿Cómo ejecutas Qwen 4 Max en Claude Code?
Lo ejecutas apuntando Claude Code al endpoint de Anthropic de Token Plan y asignando un slot de modelo a qwen4-max-preview. La guía de Claude Code de Alibaba da esta configuración para la CLI:
export ANTHROPIC_AUTH_TOKEN="YOUR_API_KEY"
export ANTHROPIC_BASE_URL="https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic"
export ANTHROPIC_MODEL="auto"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="qwen3.6-flash"
export ANTHROPIC_DEFAULT_SONNET_MODEL="qwen3.8-flash"
export ANTHROPIC_DEFAULT_OPUS_MODEL="qwen4-max-preview"
export CLAUDE_CODE_SUBAGENT_MODEL="auto"
export CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"
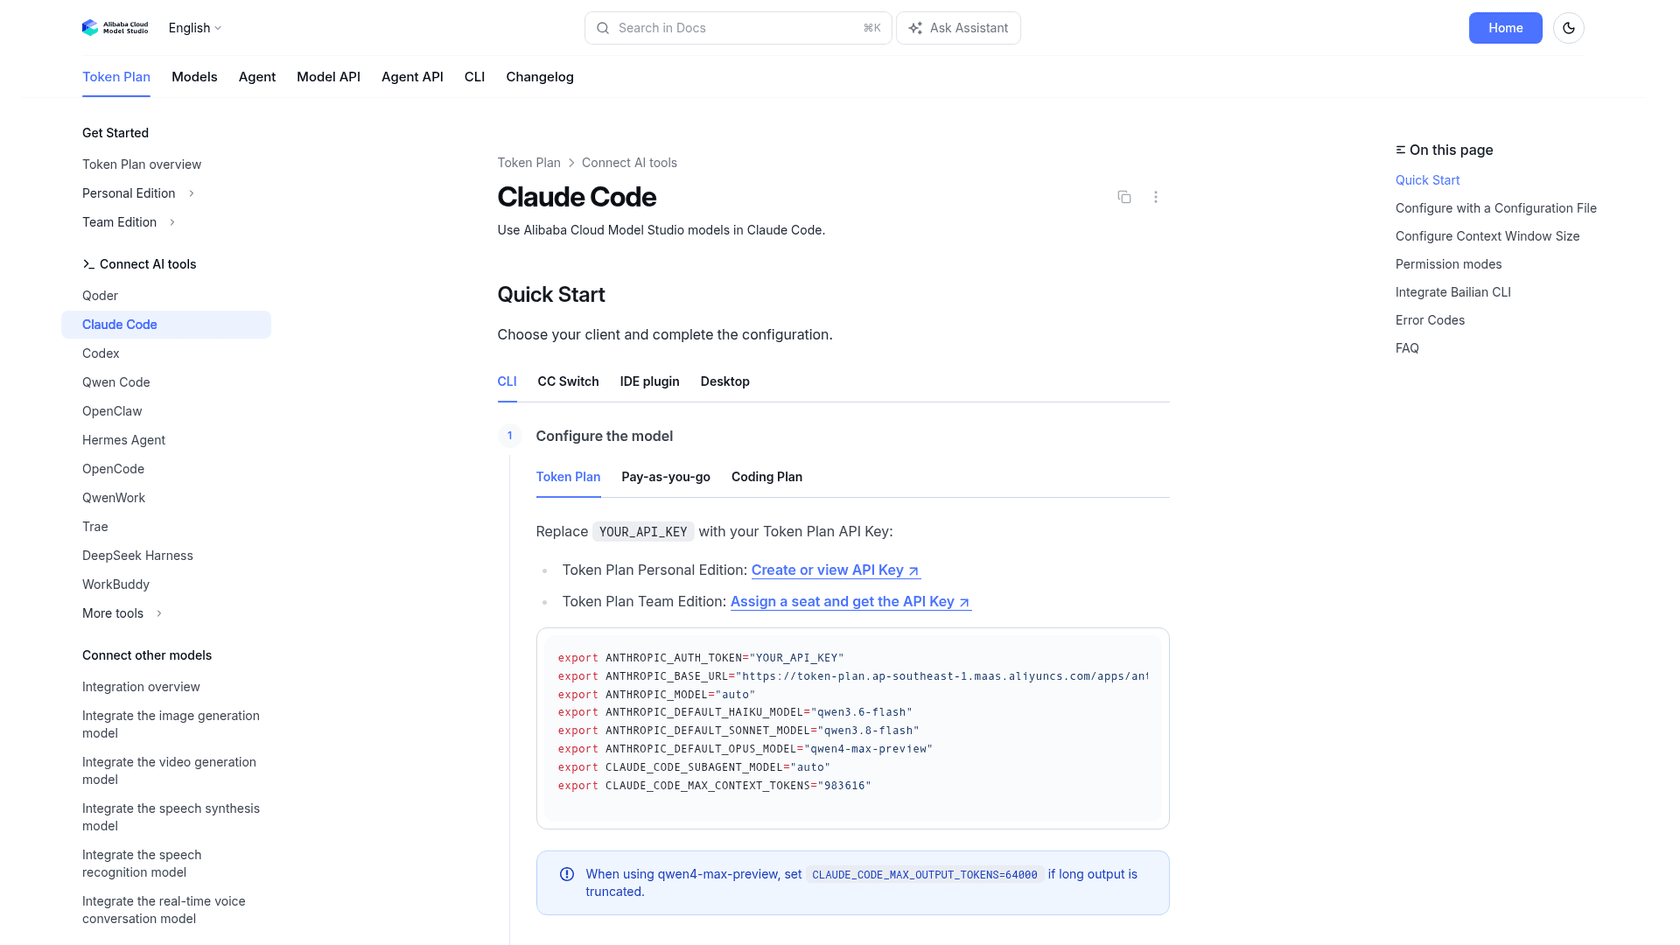
Lee ese bloque con atención, porque no hace lo que la mayoría espera. El modelo principal es auto, el router de Alibaba, y los subagentes también. Qwen 4 Max solo está en el slot de Opus.
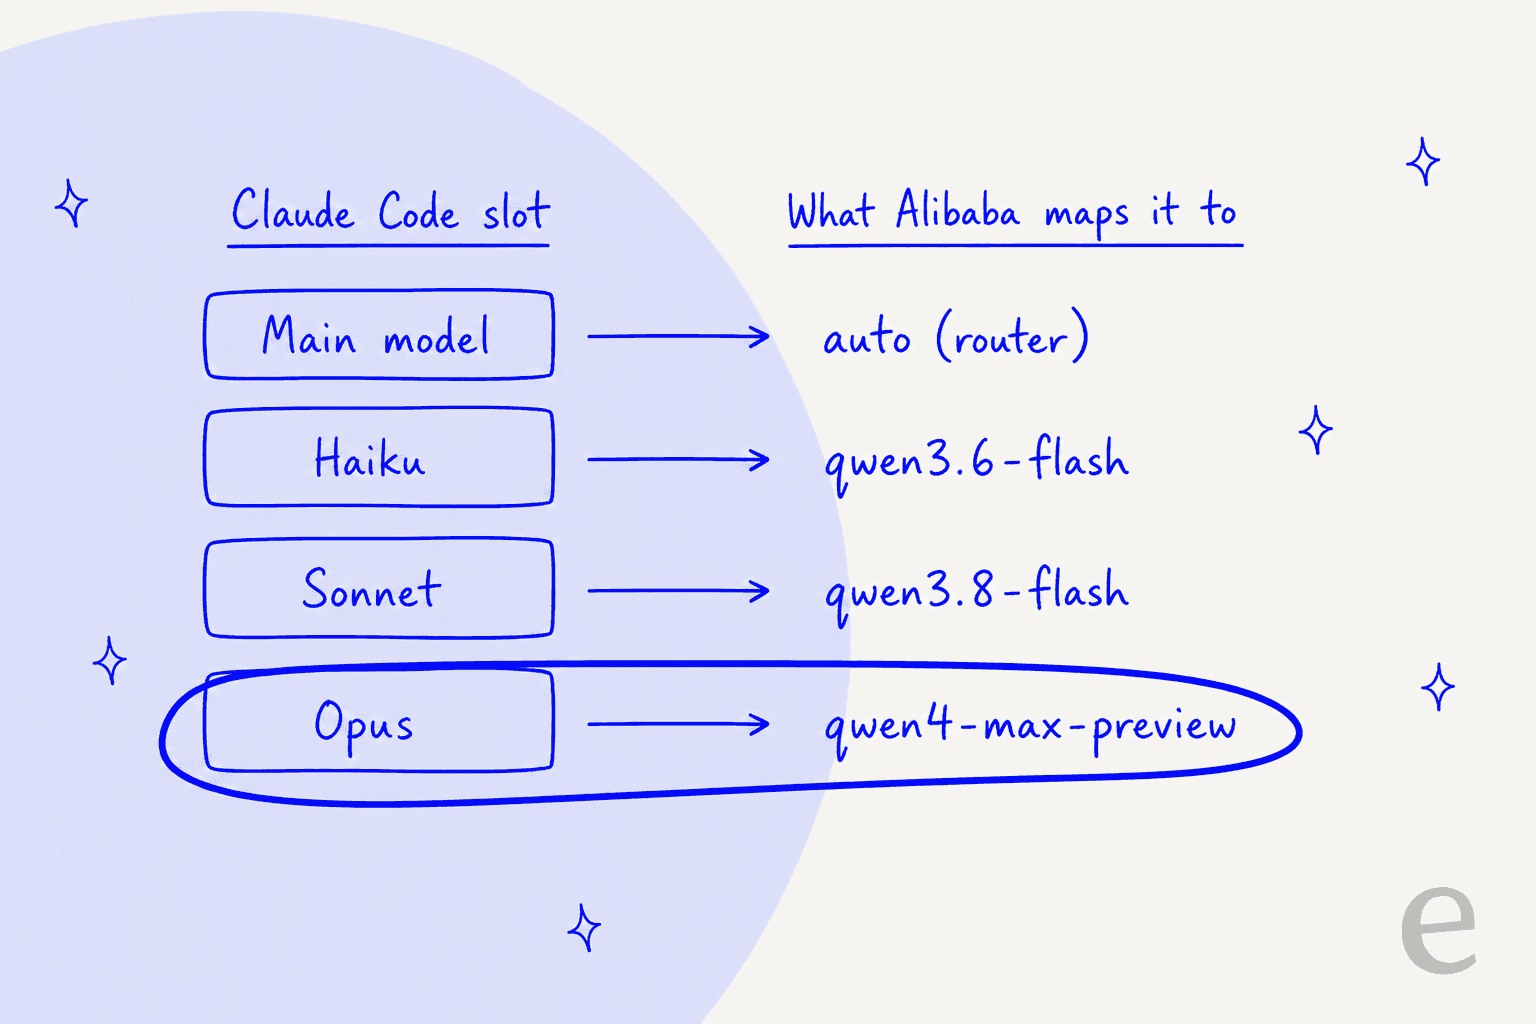
Así que si pegas esto y arrancas una sesión, tus prompts van a lo que elija auto, no a Qwen 4 Max. Para probar realmente el modelo nuevo, cambia con /model opus en la sesión, o pon ANTHROPIC_MODEL="qwen4-max-preview" tú mismo. Si estás comparando modelos, haz lo segundo, para que cada turno de tu prueba corra sobre el mismo modelo. Mi guía de selección de modelo en Claude Code explica cómo funcionan los slots.
Tres ajustes más importan:
- Longitud de salida. La documentación señala que si la salida larga se corta con
qwen4-max-preview, ponCLAUDE_CODE_MAX_OUTPUT_TOKENS=64000. - Contexto.
CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"deja que Claude Code use la mayor parte de la ventana de 1M. Consulta mi guía de la ventana de contexto de Claude Code para ver qué cambia eso. - Persistencia. Esos exports solo duran en la terminal actual. Para una configuración duradera, las mismas claves van bajo
enven~/.claude/settings.json, como se explica en mi guía de configuración de Claude Code.
Ejecuta claude -p "Hello" para comprobar que conecta. Para Claude Code Desktop, la guía de Alibaba lo enruta a través de una puerta de enlace local llamada CC Switch en vez de variables de entorno.
Qwen Code, Cursor y otras herramientas
Qwen Code usa el endpoint compatible con OpenAI. El ~/.qwen/settings.json de ejemplo de Alibaba lista qwen4-max-preview como su propia entrada de proveedor llamada "Qwen4.0 Max Preview", así que lo eliges por nombre en vez de por una asignación de slot. Cursor, OpenAI Codex, OpenCode, OpenClaw, Cline, Qoder y Hermes Agent también tienen guías de Token Plan. En cada una, comprueba dos cosas: la URL base es una de token-plan, y el ID del modelo es exactamente qwen4-max-preview.
¿Qué cambia para quienes lo llaman directamente?
Dos comportamientos son nuevos con este modelo, y ambos pueden romper una configuración que funcionaba con modelos Qwen anteriores.
max_tokens ahora también cubre el razonamiento. El aviso de compatibilidad de Alibaba dice que desde qwen4-max-preview en adelante, max_tokens equivale a max_completion_tokens en Chat Completions, así que limita el razonamiento y la respuesta final juntos. El razonamiento está activado en xhigh por defecto. Si dimensionaste max_tokens solo para la respuesta, el razonamiento consume el presupuesto y la respuesta vuelve cortada. Los modelos Qwen anteriores mantienen el comportamiento antiguo, por eso esto afecta a la gente cuando cambian de ID de modelo.
Hay que devolver el razonamiento. Chat Completions activa preserve_thinking por defecto. La documentación del modelo pide enviar de vuelta el razonamiento anterior en el campo reasoning_content de cada mensaje del asistente, no dentro de content. Además, no pongas reasoning_effort y thinking_budget a la vez.
Una cosa más: las herramientas integradas (búsqueda web, búsqueda de imágenes, scraping web, interpretador de código) solo funcionan a través de la Responses API, no de Chat Completions, según la guía de inicio rápido. Si tu herramienta habla Chat Completions, no las tendrás.
Comprobación de configuración de Qwen 4 Max
Marca lo que sea cierto en tu configuración. Lo que quede sin marcar es probablemente el motivo de que no funcione.
¿Qué no puedes hacer con Qwen 4 Max?
No puedes construir un producto sobre él, por dos razones que no tienen nada que ver con lo inteligente que sea.
Primero, es temporal. La documentación dice que no se hacen cambios durante la vista previa y que el modelo se retira cuando termina. Todo lo que llame a qwen4-max-preview deja de funcionar después del 25 de noviembre.
Segundo, Token Plan lo prohíbe. Los términos de la suscripción dicen que el plan es solo para uso interactivo dentro de herramientas de código y agentes, y que no debe usarse para "scripts de automatización, backends de aplicaciones personalizadas, o cualquier escenario de llamadas por lotes no interactivo." La FAQ añade que las tareas en segundo plano programadas también cuentan, y que compartir una clave puede hacer que se suspenda. Así que un chatbot de soporte, un clasificador de tickets o una API de atención al cliente con IA conectada a esta clave rompe las reglas desde la primera llamada.
Los primeros usuarios ya lo están leyendo como una prueba de manejo. Un comentarista de Hacker News resumió el trato en una línea:
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"

Y en cuanto a calidad, todavía no hay consenso. Una publicación muy compartida en X la llamó "decepcionante" basándose en lo que el propio autor admitió que eran rumores, y una respuesta de alguien que de verdad lo está probando no estuvo de acuerdo:
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Mi consejo: pruébalo en una tarea que ya hayas resuelto con tu modelo habitual, como Claude Fable 5.2 o GPT-6.1 Terra, y júzgalo por eso. Un modelo congelado de dos semanas es algo justo para probar y malo para construir sobre él.
¿Qué significa Qwen 4 Max para los equipos de soporte?
Para un equipo de soporte, Qwen 4 Max es un modelo para probar en tu escritorio, no uno para poner en tu cola. Los términos y la fecha de retirada lo dejan claro.
La lección más grande se repite cada semana de lanzamiento. Un modelo es el motor, no el agente. Lo que hace útil a la IA en los tickets es la capa que lo rodea: tu centro de ayuda, tus tickets anteriores, las reglas de cuándo pasar a una persona, y pruebas contra conversaciones reales antes de que algo llegue a un cliente. Para eso está hecho el compañero de IA de eesel para el helpdesk. Se une a la cola que ya gestionas en Zendesk o Freshdesk, aprende de tu historial, y se simula primero contra tickets anteriores.
OroSoft es un buen ejemplo de la parte de grounding. Fabrica software para el comercio de metales preciosos y atiende a sus clientes por Freshdesk. Cuando un agente menciona a eesel en un ticket, redacta una respuesta a partir de 6.100 tickets anteriores y 20 archivos de centro de ayuda y referencia, dice qué ticket o artículo usó, y deja una nota pidiendo una persona cuando no encuentra respaldo para una respuesta. smava, un comparador de préstamos alemán, usa eesel en dos marcas de Zendesk y gestionó 27.000 tickets en un mes.
Ninguno de los dos montajes cambia cuando sale un modelo nuevo, y ese es el punto. Si tienes curiosidad por saber cómo maneja un modelo tu propio contenido de soporte, mis guías sobre conectar Claude a tu helpdesk, traspasos de agentes de IA y evitar alucinaciones son un mejor punto de partida que una clave de vista previa.
¿Deberías configurar Qwen 4 Max esta semana?
Sí, si vives en un agente de código y quieres dos semanas baratas con un Qwen de contexto de 1M. El plan Lite de 3 $, la tarifa de créditos del 20% y la tarifa nocturna del 8% lo hacen casi gratis de probar, siempre que configures el slot del modelo correctamente y hagas coincidir tu clave con el endpoint de Token Plan.
No, si necesitas un modelo para una app, un bot o un presupuesto. Usa Qwen 3.8 Max en pago por uso para eso, y vuelve a mirar cuando Alibaba lance el Qwen 4 Max completo con precio y puntuaciones. Para una mirada más amplia a la familia, mi resumen de Qwen y alternativas a Qwen cubren el resto.
Prueba eesel para IA en tu cola de soporte
Si lo que realmente quieres es IA que responda a los clientes, eesel es un compañero de IA para el helpdesk que se conecta al helpdesk que ya usas, aprende de tus tickets anteriores y tu centro de ayuda, y se prueba contra conversaciones históricas antes de tocar una en vivo. OroSoft lo usa para redactar respuestas de Freshdesk fundamentadas que citan el ticket del que vienen. Puedes ver los precios o probar eesel gratis.
Preguntas frecuentes
¿Qué es Qwen 4 Max?
qwen4-max-preview, un modelo de razonamiento multimodal con un contexto de 1M de tokens y un máximo de 393.216 tokens de salida. Se lanzó el 11 de noviembre de 2026 y se retira después del 25 de noviembre. La reseña de Qwen 4 Max cubre lo que la vista previa puede y no puede decirte.¿Cómo uso Qwen 4 Max?
sk-sp-, apunta tu herramienta a la URL base de Token Plan y pon el ID del modelo en qwen4-max-preview. Entre las herramientas compatibles están Claude Code, Cursor, Qwen Code y OpenClaw.¿Es gratis Qwen 4 Max?
¿Está disponible la API de Qwen 4 Max?
¿Cuánto tiempo estará disponible Qwen 4 Max?
qwen4-max-preview deja de funcionar entonces. Mi resumen de herramientas para seguir modelos de IA te ayuda a vigilar el lanzamiento completo.¿Cómo configuro Qwen 4 Max en Claude Code?
ANTHROPIC_BASE_URL en el endpoint de Anthropic de Token Plan, pon tu clave sk-sp- en ANTHROPIC_AUTH_TOKEN, y asigna ANTHROPIC_DEFAULT_OPUS_MODEL a qwen4-max-preview. La configuración de Alibaba pone el modelo principal en auto, así que elige Opus con /model para asegurarte de estar usando Qwen 4 Max. Mi guía de variables de entorno de Claude Code explica cada variable.¿Cuál es la diferencia entre Qwen 4 Max y Qwen 3.8 Max?
max_tokens ahora cubre el razonamiento y la respuesta juntos. Qwen 3.8 Max ya está lanzado, tiene puntuaciones independientes y cuesta 2 $ de entrada y 6 $ de salida por 1M de tokens en pago por uso. Mira mi desglose de precios de Qwen 3.8 Max.