

Qwen 4 Max merece unos días de uso práctico en tu herramienta de código, y nada más por ahora. La preview (qwen4-max-preview) tiene 1M de tokens de contexto y 393.216 de salida máxima, pero Alibaba no publicó benchmarks ni precio por token. Solo corre con la suscripción Token Plan, que prohíbe backends de app, y se retira el 25 de noviembre de 2026. Pruébalo mientras los créditos cuestan 20 % de la tarifa estándar. Construye sobre Qwen 3.8 Max en su lugar. Para trabajo de soporte, un agente de helpdesk como eesel corre sobre modelos estables, y con el CLI de eesel un agente de código puede cargar tus artículos de ayuda y probar respuestas antes de que algo salga en vivo.
¿Qué es Qwen 4 Max?
Qwen 4 Max es el primer modelo de la generación Qwen 4 de Alibaba, y ahora mismo solo existe como preview. La documentación del modelo de Alibaba llama a qwen4-max-preview "el modelo insignia multimodal de nueva generación de la familia Qwen", construido para código, trabajo de oficina, diseño de frontend y tareas de agentes.
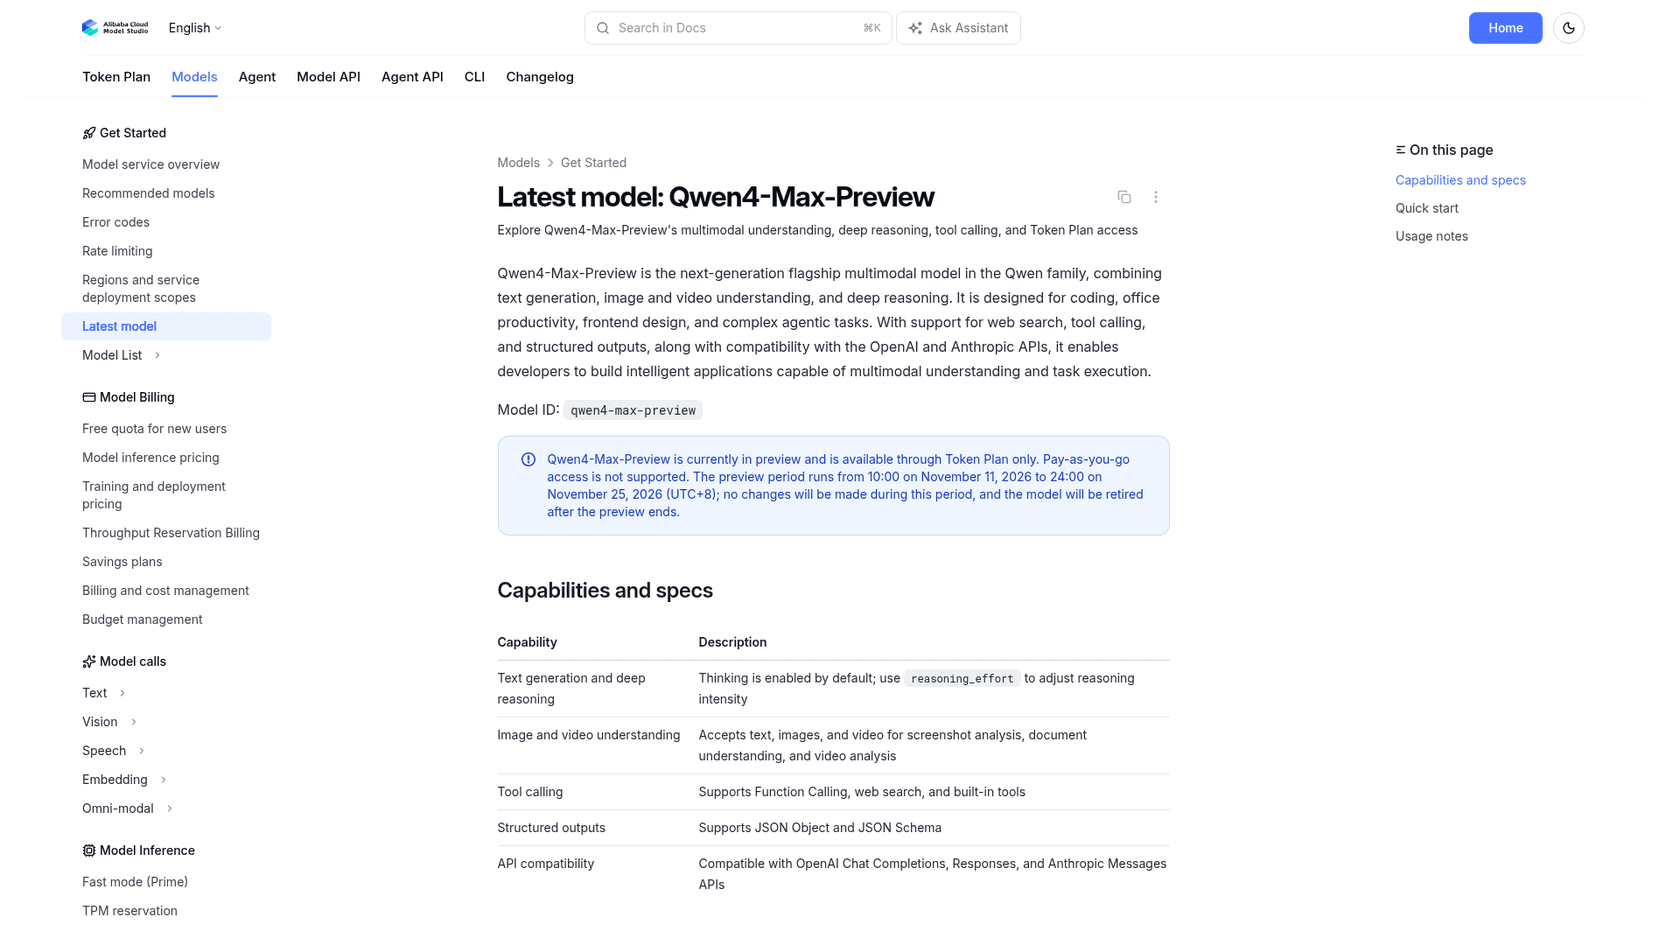
Salió en vivo el 11 de noviembre de 2026 a las 10:00 hora de Pekín. Esto es lo que confirma la documentación:
| Especificación | Qwen4-Max-Preview |
|---|---|
| ID del modelo | qwen4-max-preview (alias qwen4.0-max-preview) |
| Entrada | Texto, imágenes y video |
| Longitud de contexto | 1M de tokens |
| Salida máxima | 393.216 tokens, compartidos entre pensamiento y respuesta |
| Pensamiento | Activado por defecto, low, medium o xhigh (por defecto) |
| Herramientas | Function calling, búsqueda web, herramientas integradas |
| Salida estructurada | JSON Object y JSON Schema |
| Formatos de API | OpenAI Chat Completions, Responses, Anthropic Messages |
| Acceso | Solo Token Plan, sin pago por uso |
| Ventana de preview | Del 11 al 25 de nov. de 2026 (UTC+8), luego se retira |
Parte de mi trabajo es revisar qué promete en realidad un lanzamiento antes de que alguien construya sobre él. Así que antes de hablar de cómo se siente el modelo, esto es lo que falta. Al lado del lanzamiento de Qwen 3.8 Max, este es mucho más flaco.
¿Qué dejó fuera Alibaba?
Alibaba publicó capacidades y límites, pero no las cifras que normalmente se usan para juzgar un modelo. La página de documentación no tiene tabla de benchmarks. No hay conteo de parámetros, no hay model card, no hay pesos abiertos y no hay precio por token. Cuando revisé el 12 de noviembre, Qwen 4 Max tampoco tenía página en Artificial Analysis, mientras que Qwen 3.8 Max sí está en ese tablero.
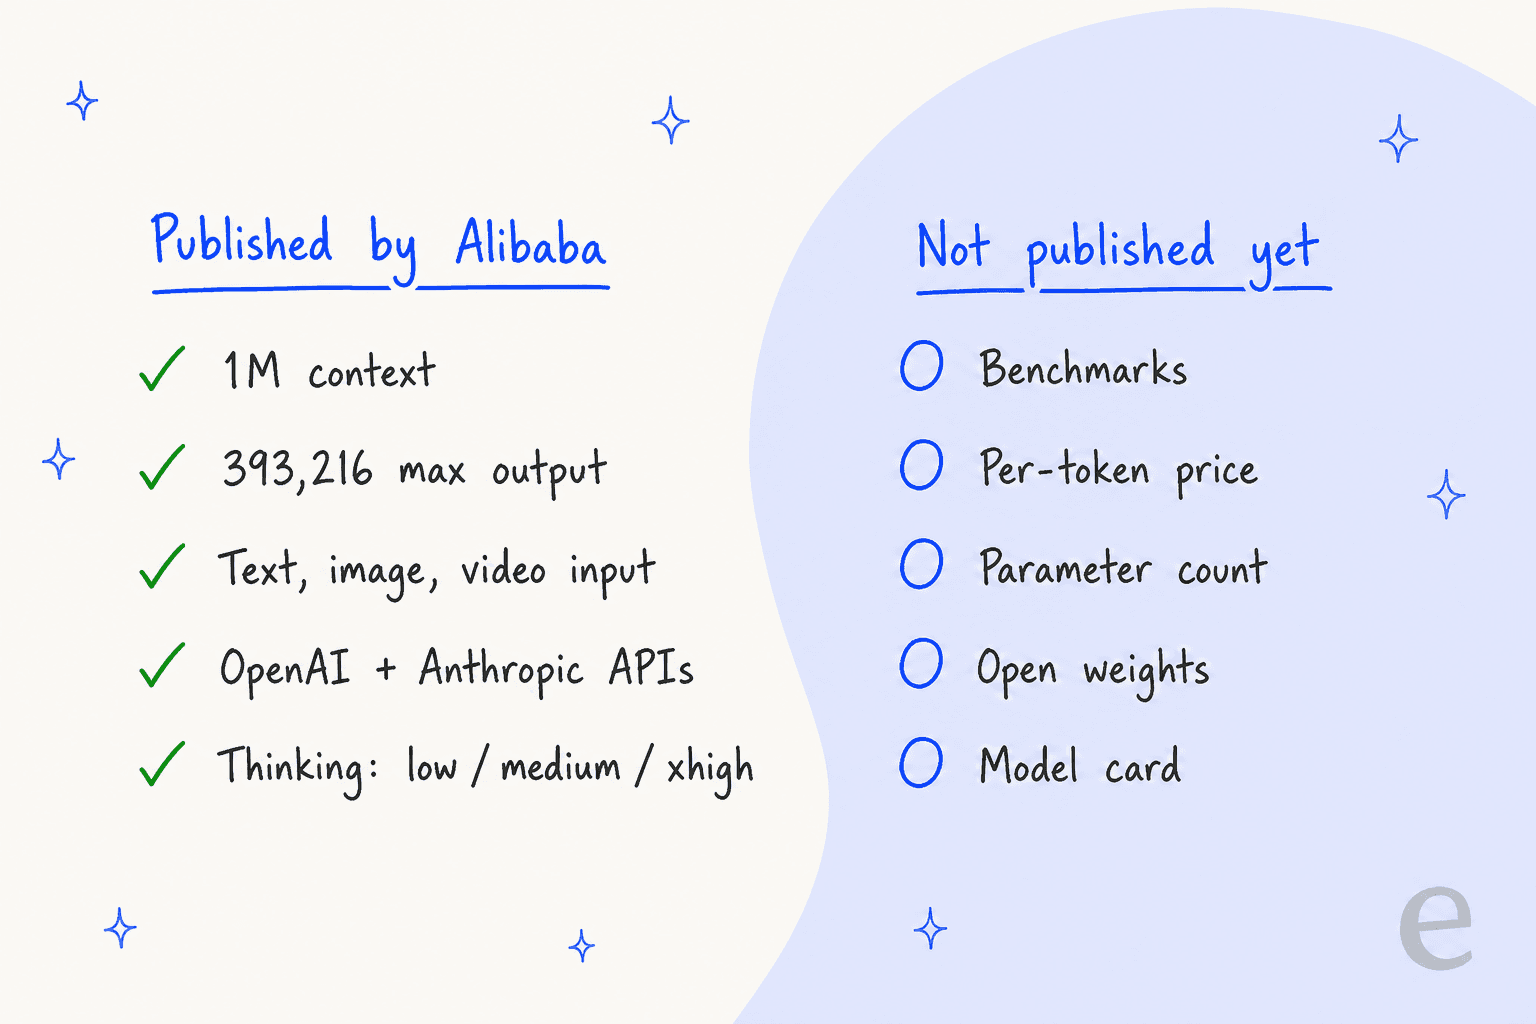
Así que cualquier gráfico de "Qwen 4 Max saca X" que veas esta semana viene de un tercero probando la preview, no de Alibaba. Eso no es condenatorio, las previews a menudo salen así. Pero significa que una reseña hoy es una reseña de los términos de acceso, no de la inteligencia. El hilo de lanzamiento en Hacker News dijo justo eso:
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

Esa segunda frase también importa. Los modelos Qwen que la gente ama son los pequeños y abiertos, como Qwen 3.8 Flash Next y el de 27B. El nivel Max solo está hospedado, y esta preview no cambia eso.
¿Cómo se consigue acceso, y qué cuesta?
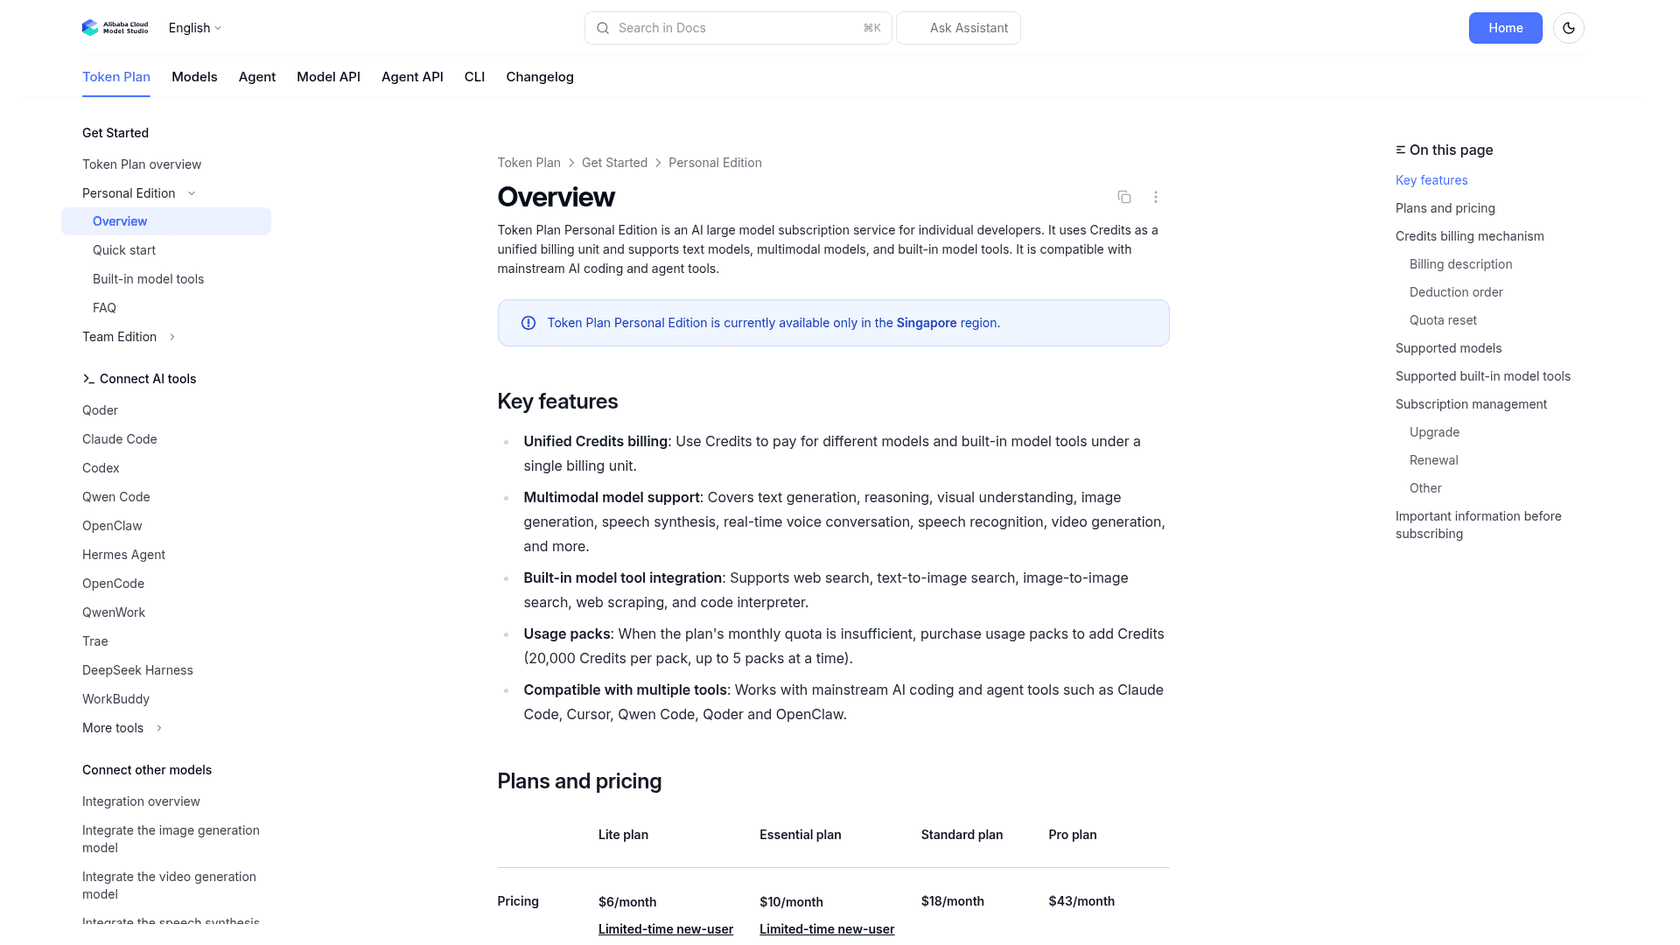
Consigues Qwen 4 Max a través del Token Plan de Alibaba, una suscripción mensual pagada en créditos. No hay opción de pago por uso para la preview. Los precios de la Personal Edition vienen de la documentación del Token Plan de Alibaba:
| Plan | Precio de lista | Precio para usuario nuevo | Créditos mensuales | Agentes concurrentes |
|---|---|---|---|---|
| Lite | 6 $/mes | 3 $/mes | 20.000 | 1-2 |
| Essential | 10 $/mes | 5 $/mes | 45.000 | 2-3 |
| Standard | 18 $/mes | - | 80.000 | 3-4 |
| Pro | 43 $/mes | - | 200.000 | 6-8 |
El precio para usuario nuevo corre hasta el 30 de noviembre de 2026 para cuentas que nunca compraron una suscripción Personal. Los paquetes extra cuestan 15 $ por 20.000 créditos, y puedes tener hasta cinco. La Personal Edition es solo para la región de Singapur, y la inferencia corre en el despliegue Global de Alibaba, así que tus prompts cruzan fronteras.
Aquí está la trampa para quien intente comparar costos. Alibaba dice que los créditos por solicitud se "determinan dinámicamente según el tipo de modelo, el uso de tokens, el modo de pensamiento y las llamadas a herramientas", y no publica una tasa de créditos por token para Qwen 4 Max. Te enteras de cuánto cuesta una llamada en la página de uso de la consola, después de hacerla. Así que no puedes calcular el precio de un trabajo por adelantado como sí puedes con Qwen 3.8 Max, que lista 2 $ de entrada y 6 $ de salida por 1M de tokens en su página de modelo de QwenCloud.
El descuento de la preview, y por qué "la noche" es tu jornada laboral
Durante la preview, Qwen 4 Max consume créditos al 20 % de la tarifa estándar. Entre las 22:00 y las 08:00 hora de Pekín, tienes otro 60 % de descuento, así que un 8 % de la tarifa estándar.
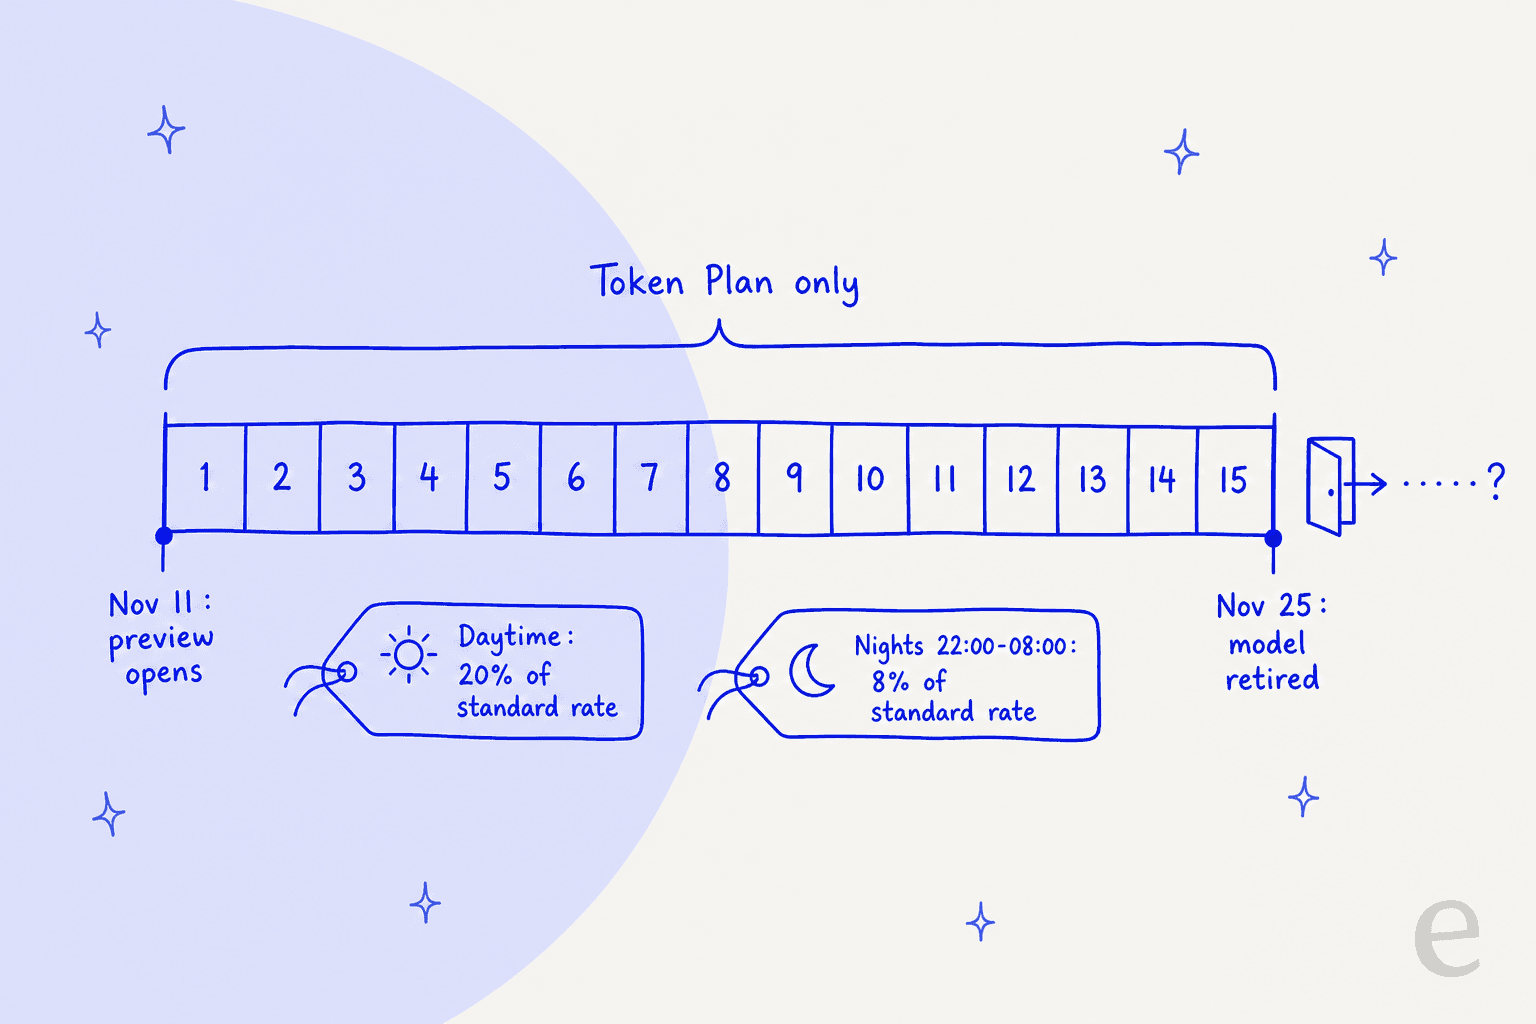
El detalle que casi todos pasan por alto: de 22:00 a 08:00 en Pekín es de 14:00 a 00:00 UTC. Eso es de 9 a.m. a 7 p.m. en la costa este de EE. UU. Si estás en América, la tarifa más barata cubre toda tu jornada laboral. Un probador temprano en Hacker News hizo el mismo comentario:
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"
¿Puedes construir sobre Qwen 4 Max?
No, y esta es la parte de la reseña que más importa si llevas un producto o un equipo de soporte. Dos cosas lo descartan.
Primero, el modelo es temporal. La documentación de Alibaba dice que "no se harán cambios durante este periodo, y el modelo se retirará cuando termine la preview". Todo lo que construyas sobre qwen4-max-preview deja de funcionar después del 25 de noviembre.
Segundo, el Token Plan prohíbe justo el uso que necesitarías. Los términos de la suscripción dicen que el plan está "pensado solo para uso interactivo dentro de herramientas de código y de agentes", y que "no debe usarse para scripts de automatización, backends de aplicaciones propias ni ningún escenario de llamadas por lotes no interactivas". Las llamadas fuera de ese alcance pueden hacer que se suspenda la suscripción o se banee la clave de API.
Así que un chatbot de soporte, un clasificador de tickets o cualquier API de atención al cliente con IA conectada a esta clave rompería las reglas desde el primer día. Lo que el plan sí permite es usar el modelo dentro de Claude Code, Cursor, Qwen Code, OpenAI Codex, Cline, OpenCode u OpenClaw, todas listadas como herramientas soportadas.
¿Deberías tocar Qwen 4 Max esta semana?
Abre la opción que se parezca más a ti.
Programo en Claude Code, Cursor o Qwen Code todos los días
Sí. Un plan Lite de 3 a 6 $ te da dos semanas con 1M de contexto al 20 % de la tarifa estándar de créditos. Pruébalo en una tarea real cuya respuesta ya conozcas, y compáralo con tu modelo habitual.
Quiero ponerlo detrás de mi app o de un bot de soporte
No. El Token Plan prohíbe los backends de app, y el modelo se retira el 25 de noviembre. Usa ahora un modelo de pago por uso como Qwen 3.8 Max, y vuelve a mirar Qwen 4 Max cuando salga una versión completa con precio.
Estoy eligiendo un modelo para la hoja de ruta de mi empresa
Espera. Sin benchmarks ni una tabla de tarifas no hay nada que poner en un modelo de costos. Anota el límite de salida de 393.216 tokens y el nuevo comportamiento de max_tokens, y vuelve cuando Alibaba publique cifras.
Tengo modelos Qwen alojados yo mismo
Omítelo. No hay pesos abiertos para la preview. Lo que hay que vigilar son los modelos Qwen 4 más pequeños, porque esos suelen ser los que llegan a Hugging Face.
¿Qué cambió para los desarrolladores?
Hay dos cambios técnicos que vale la pena conocer antes de apuntar una herramienta a este modelo.
El mayor es cómo funciona max_tokens. A partir de qwen4-max-preview, el aviso de compatibilidad de Alibaba dice que max_tokens ahora equivale a max_completion_tokens, así que limita el pensamiento y la respuesta final juntos. El pensamiento está activado por defecto en xhigh. Si tu configuración dimensionó max_tokens solo para la respuesta, un razonamiento largo puede consumir el presupuesto y cortar tu respuesta. Los modelos Qwen más antiguos mantienen el comportamiento viejo, así que esto golpea al cambiar.
El segundo es el pensamiento multi-turno. Chat Completions activa preserve_thinking por defecto, y la documentación pide devolver el pensamiento anterior en el campo reasoning_content, no pegado dentro de content. Las herramientas construidas para los formatos de Anthropic u OpenAI puede que no hagan esto de forma automática, algo que vale la pena revisar si las sesiones largas de agentes se descarrilan.
El techo de salida en sí es un salto real: 393.216 tokens, el triple de los 131.072 de Qwen 3.8 Max. Para generación de código larga o refactorizaciones grandes en una sola pasada, esa es la especificación que probaría primero.
¿Cómo se siente usarlo?
Los primeros reportes son mixtos y sobre todo hablan de velocidad, lo que calza con un modelo cuyo pensamiento está en xhigh por defecto. El probador de Hacker News citado arriba dijo que "con xhigh thinking la velocidad está bien, se siente un poco más lento que Terra", refiriéndose al GPT-6.1 Terra de OpenAI. En X, el lanzamiento tomó un giro escéptico en horas:
"Qwen-4-max is live it seems. From what I've heard so far (rumors), Qwen 4 is disappointing."
Nota la palabra "rumors" (rumores). Una respuesta bajo ese post contraatacó con uso real:
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Ambos son tempranos, y ninguno es un benchmark. Mi lectura honesta: fuera de Alibaba nadie sabe todavía qué tan bueno es Qwen 4 Max, y la ventana de 14 días más el "sin cambios durante la preview" significa que el modelo que pruebas está congelado. Si lo pruebas, pruébalo en tu propio trabajo, con una tarea que ya resolviste con Claude Fable 5.2 o GPT-6.1 Sol, para tener algo real con qué comparar.
¿Cómo se compara con otros modelos?
Así se ubica la preview junto a los modelos contra los que la gente realmente la va a sopesar. Los precios vienen de la página propia de cada proveedor, y he marcado lo que no está publicado.
| Modelo | Estado | Precio | Salida máxima | Puntajes independientes |
|---|---|---|---|---|
| Qwen 4 Max preview | Preview, se retira el 25 de nov. | Solo créditos del Token Plan | 393.216 | Ninguno todavía |
| Qwen 3.8 Max | Lanzado | 2 $ / 6 $ por 1M | 131.072 | Sí |
| Kimi K3 | Lanzado | Precios de Kimi K3 | Ver proveedor | Sí |
| DeepSeek V4.1 Flash | Lanzado, también en Token Plan | Precios de DeepSeek V4.1 Flash | Ver proveedor | Sí |
| GLM 5.3 Flash | Lanzado | Precios de GLM 5.3 Flash | Ver proveedor | Sí |
La tabla dice lo que dice el resto de esta reseña. Cada otra fila es algo que puedes calcular y verificar. Qwen 4 Max es lo único que solo puedes probar.
¿Qué significa esto para un equipo de soporte?
Para un equipo de soporte, Qwen 4 Max es un modelo para vigilar, no uno para conectar a tu helpdesk. La pregunta que surge cada semana de lanzamiento es si cambiar el bot de soporte al modelo nuevo. Con este, la respuesta es fácil, porque las reglas y la fecha de retiro la deciden por ti.
Pero el punto más grande vale para cada lanzamiento. Un modelo en bruto, sin importar cuán fuerte sea, no es un agente de soporte. El agente es todo lo que lo rodea: tu centro de ayuda, tickets pasados, macros, las reglas sobre cuándo pasarle el caso a una persona, y pruebas antes de que algo llegue a un cliente. Esa es la capa que el compañero de IA de eesel para el helpdesk está construido para ser. Se une a tu cola existente en Zendesk o Freshdesk, aprende de tus tickets pasados, y se simula contra conversaciones históricas antes de responderle a alguien.
Dos de nuestros clientes muestran cómo se ve esto en la práctica:
- smava, un comparador alemán de préstamos, corre eesel en Zendesk en dos marcas. En un mes manejó 27.000 tickets, categorizó 14.600 y preparó 15.300 borradores de respuesta en alemán, trabajando desde 820 macros y artículos de centro de ayuda sincronizados.
- SamCart corre un agente en los tickets de Freshdesk y otro en el chat de su sitio web, respondiendo desde 280 artículos del centro de ayuda.
Ninguno de esos montajes depende de si el modelo de esta semana gana una tabla de clasificación. Si quieres ver qué puede hacer un modelo con tu propio contenido de soporte, mis guías sobre conectar Claude a tu helpdesk y detener las alucinaciones de IA en soporte son un mejor uso de la tarde que una preview que se retira en dos semanas.
Mi veredicto sobre Qwen 4 Max
La preview de Qwen 4 Max es una prueba, no un producto. Las especificaciones confirmadas son fuertes, sobre todo el techo de salida de 393.216 tokens, y el descuento de la preview hace barata una prueba de dos semanas. Pero sin benchmarks, sin precio por token, con una prohibición de uso en backend y un corte duro el 25 de noviembre, todavía no hay nada aquí sobre lo que construir.
Pruébalo si vives en un agente de código y quieres probar un Qwen de contexto largo al 20 % (u 8 %) de la tarifa de créditos. Sáltatelo si necesitas un modelo para una app, un bot de soporte o un modelo de costos. Usa ahora Qwen 3.8 Max, y vuelve cuando Alibaba lance la versión completa.
Prueba eesel para un soporte que no espera a los lanzamientos de modelos
Si tu meta real es responder a los clientes más rápido, eesel es un compañero de IA para el helpdesk que se conecta al helpdesk que ya usas, aprende de tus tickets pasados y tu centro de ayuda, y se prueba contra conversaciones históricas antes de tocar una real. smava lo usa para redactar respuestas en alemán en 27.000 tickets de Zendesk al mes. Puedes ver los precios o probar eesel gratis.
Preguntas frecuentes
¿Ya está disponible Qwen 4 Max?
qwen4-max-preview (alias qwen4.0-max-preview), y abrió el 11 de noviembre de 2026 a las 10:00 hora de Pekín. Alibaba dice que la preview corre hasta el 25 de noviembre de 2026 y luego se retira el modelo. Todavía no se ha anunciado un lanzamiento completo de Qwen 4 Max. Para el modelo sobre el que se construye, mira mi reseña de Qwen 3.8 Max.¿Cuánto cuesta Qwen 4 Max?
¿Hay benchmarks de Qwen 4 Max?
¿Puedo usar la API de Qwen 4 Max en mi app?
¿Cuál es la diferencia entre Qwen 4 Max y Qwen 3.8 Max?
max_tokens ahora limita el pensamiento y la respuesta juntos. Mira mi desglose de precios de Qwen 3.8 Max.¿Funciona Qwen 4 Max con Claude Code?
qwen4-max-preview. Mi guía de selección de modelo en Claude Code explica cómo funciona el cambio de modelo.