Les 6 meilleures alternatives à GLM-5.3-Flash en 2026

Rama Adi

Katelin Teen
Dernière modification August 29, 2026
GLM-5.3-Flash est le modèle peu cher, nativement multimodal et à poids ouverts de Z.ai, et c'est un excellent choix par défaut : environ $0.075/$0.25 par 1M de tokens pendant sa promotion de lancement, une fenêtre de contexte de 1M de tokens et un Intelligence Index d'Artificial Analysis de 57 pour environ $0.045 par tâche. La plupart des équipes qui regardent ailleurs cherchent l'une de ces trois choses : des réponses plus rapides, des poids totalement ouverts à auto-héberger, ou un écosystème de fournisseur plus large.
Voici la version courte de qui choisir :
- Modèle fermé le plus rapide : Gemini 3.7 Flash, environ 340 tokens/s, mais son prix catalogue double en janvier 2027.
- Poids ouverts les moins chers : DeepSeek V4 Flash, sous licence MIT et presque gratuit à auto-héberger, mais uniquement texte.
- Plancher absolu de vitesse et de prix : Gemini 3.5 Flash-Lite à $0.30/$2.50.
- Écosystème d'une grande marque : GPT-5.6 Luna à $0.20/$1.20, avec l'outillage le plus large.
- Le moins cher sur les petits prompts : Qwen 3.7 Flash, si vos appels restent sous 32K tokens.
- Poids ouverts et vision native : Kimi K3, le plus proche de GLM en capacités, mais tarifé comme un modèle phare à $3/$15.
Une chose à dire d'emblée, après des années à faire tourner de l'IA sur des files de support en production : le modèle est la couche la moins chère et la plus facile à remplacer. Si vous en choisissez un pour résoudre de vrais tickets clients, la qualité du raisonnement compte bien moins que la récupération, les garde-fous et les tests que vous construisez autour. C'est cela qui décide si le bot est utile ou sûr de lui et dans l'erreur.
Pourquoi regarder au-delà de GLM-5.3-Flash ?
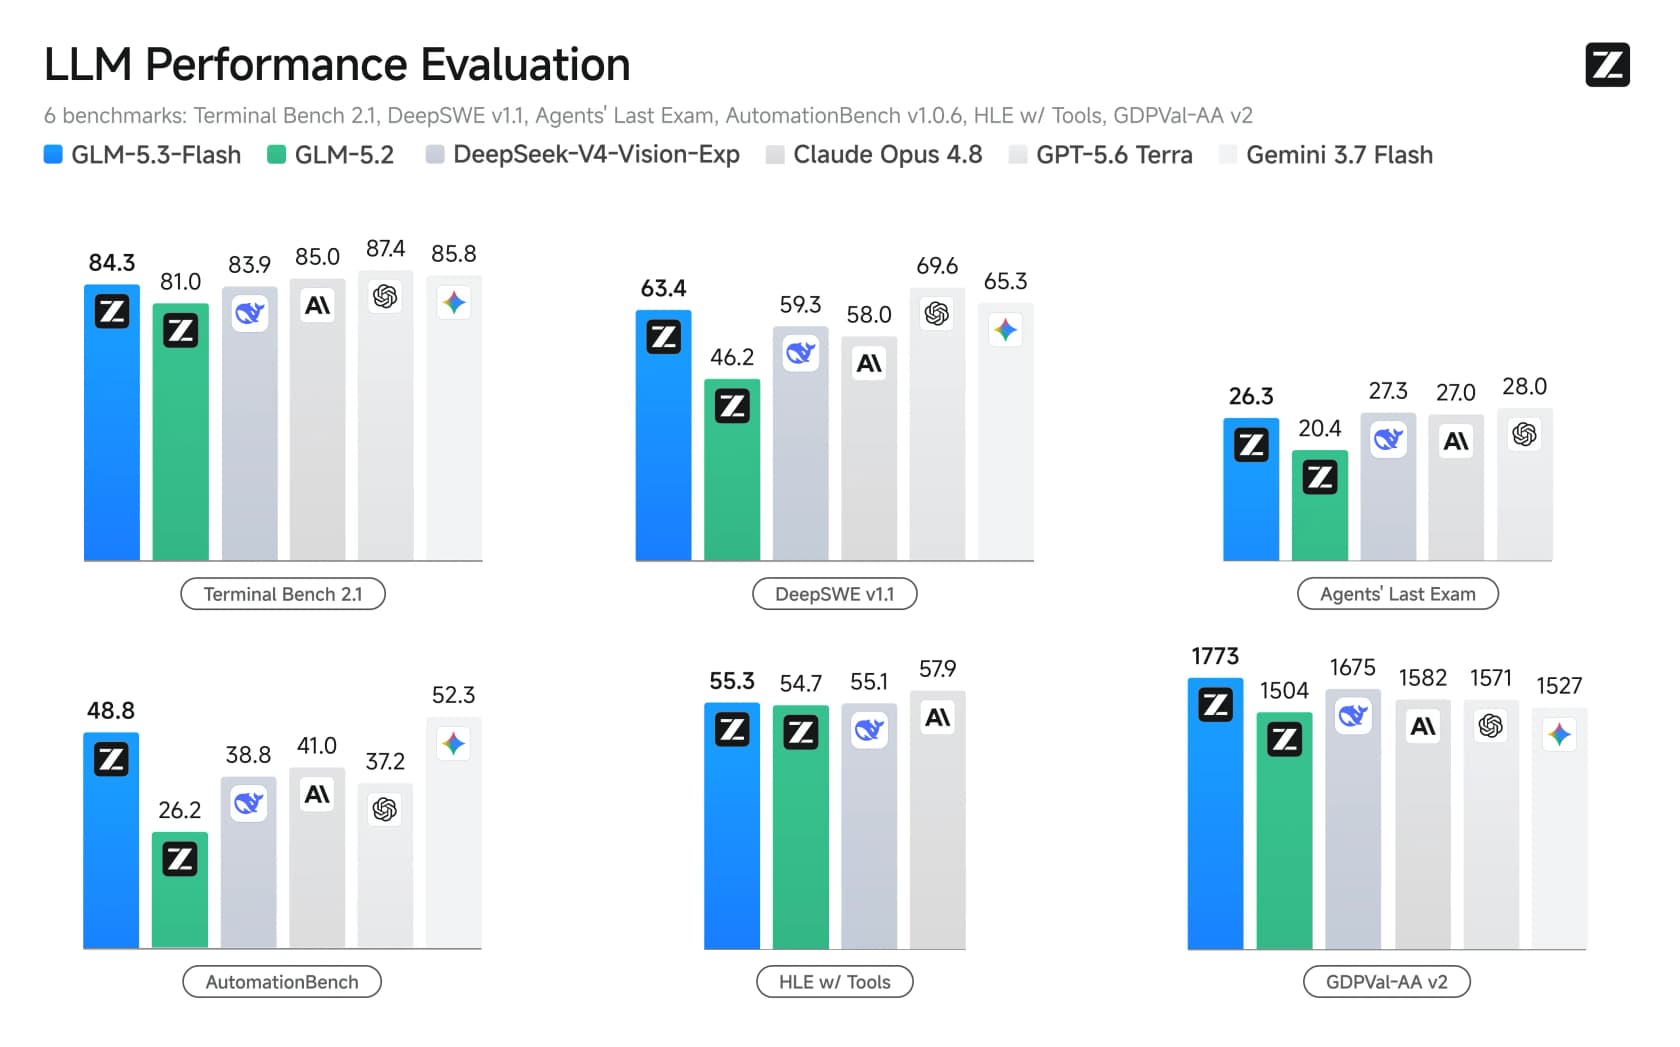
Soyons d'abord justes avec le sortant, car il a mérité son benchmark. GLM-5.3-Flash est un modèle à mélange d'experts de 320B au total / 18B actifs, le premier modèle nativement multimodal de la série GLM-5, avec une fenêtre de contexte de 1M de tokens et des poids ouverts. Selon Cloudflare, il bat GLM-5.2 sur l'ensemble des benchmarks "at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks." Sur six benchmarks de code et d'agents, il dépasse nettement son prédécesseur.
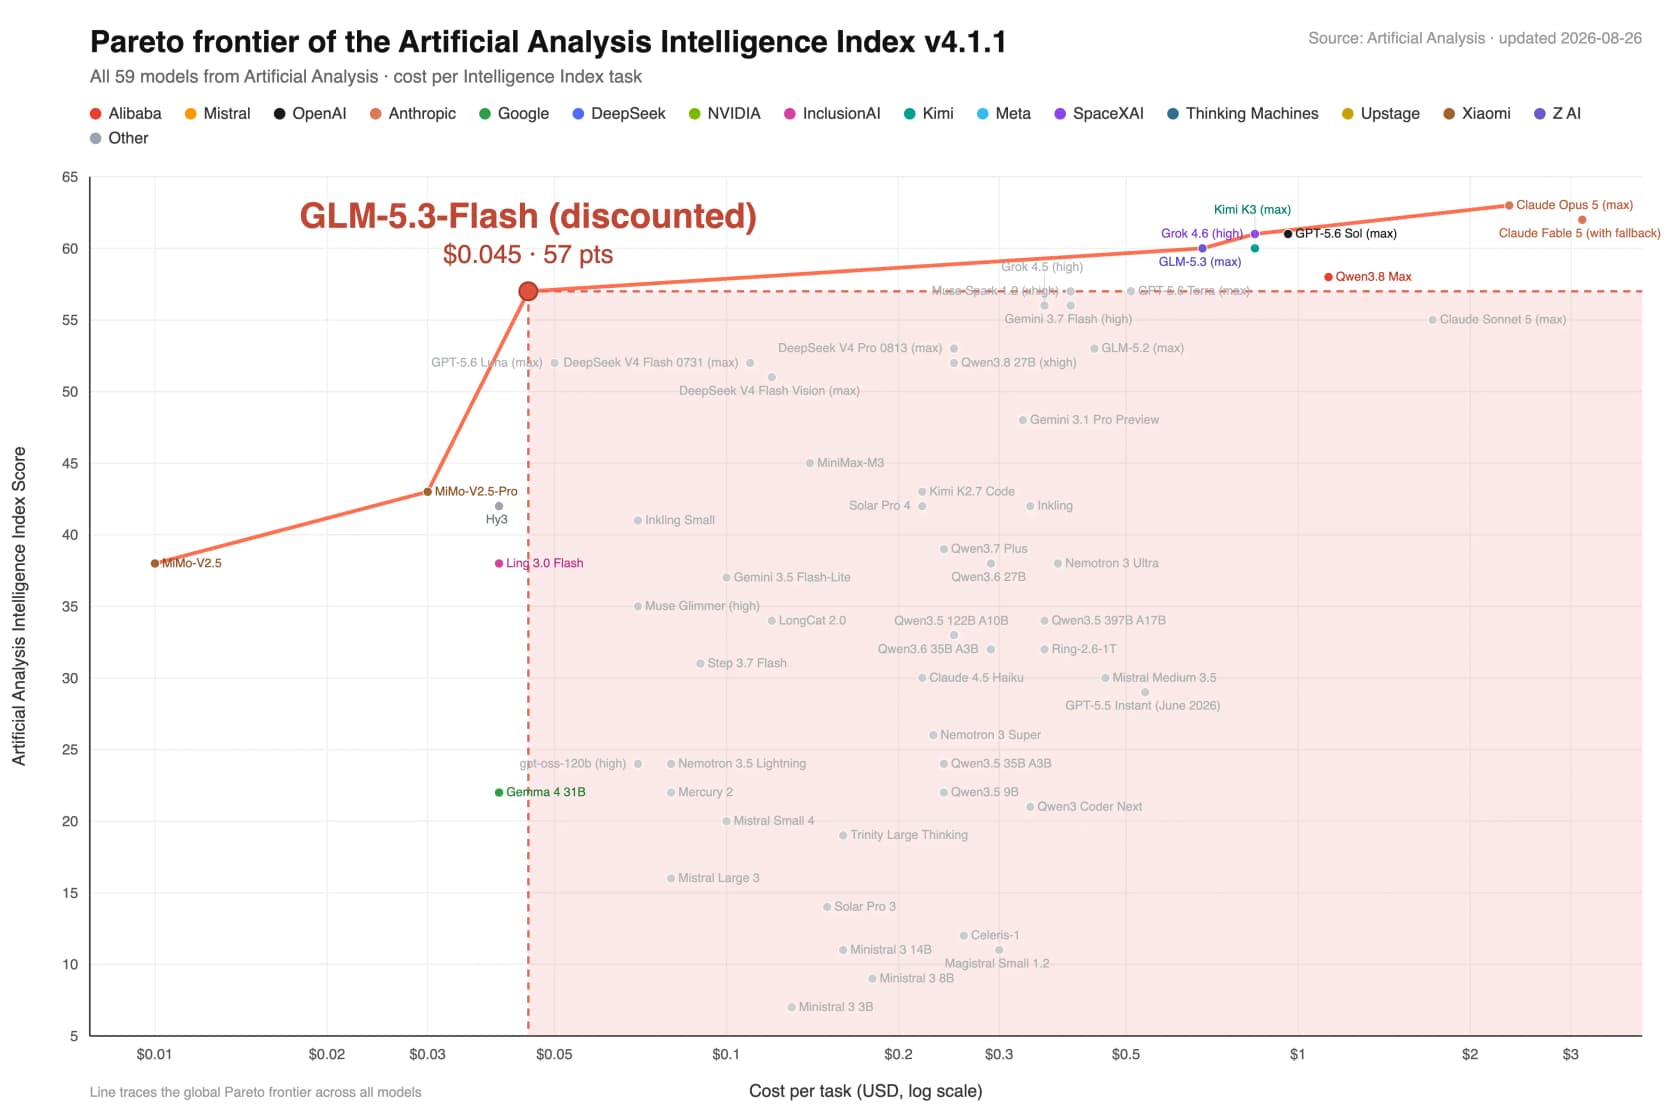
S'il a fait bouger toute la discussion sur le prix et l'intelligence, c'est à cause de ce graphique de Pareto. GLM-5.3-Flash se place sur la frontière à environ $0.045 par tâche et 57 points, une position que presque rien d'autre n'occupe.
Alors pourquoi les gens comparent-ils encore ? Quelques raisons réelles reviennent sans cesse :
- La vitesse, sur le endpoint du fournisseur. Sur l'API de Z.ai, GLM-5.3-Flash est lent, environ 49 tokens/s, et un fil r/opencode l'a qualifié de "one of the slowest models AA has ever" vu. Les hébergeurs tiers règlent le problème (Databricks mesure 272.9 t/s), mais cela implique de dépendre d'un revendeur.
- Le volet données est mince. Z.ai ne publie ni DPA ni option de rétention zéro, et les données relèvent du droit chinois. Pour des charges réglementées ou contenant des données clients, c'est un vrai blocage, sauf si vous auto-hébergez.
- L'horloge de la promo. Le tarif de $0.075/$0.25 est une remise de lancement qui se termine le 9 septembre 2026 ; le prix catalogue est le double.
- Les équipes texte seul. Si vous ne touchez jamais aux images, certains spécialistes du texte moins chers ou plus rapides ont plus de sens que de payer une architecture multimodale que vous n'utiliserez pas.
Rien de tout cela ne fait de GLM-5.3-Flash un mauvais modèle. Cela signifie seulement qu'il n'est pas automatiquement le bon pour chaque travail. Si vous voulez l'analyse approfondie du modèle lui-même, nous l'avons traitée dans le test de GLM-5.3-Flash.
Comment j'ai choisi ces alternatives
Je me suis limité aux modèles qu'un acheteur de GLM-5.3-Flash comparerait réellement : de l'économique au milieu de gamme, rapides, et idéalement multimodaux ou à poids ouverts. Chacun est noté sur les critères qui décident d'un vrai changement, pas seulement sur un benchmark vitrine :
- Le prix, et la facture réelle. Prix catalogue par 1M de tokens, plus les surcoûts qui le gonflent.
- La vitesse (tokens/s et délai avant le premier token).
- La vision / le support multimodal, car c'est la signature de GLM-5.3-Flash.
- Poids ouverts ou fermés, pour ceux qui doivent auto-héberger.
- La fenêtre de contexte et la sortie maximale.
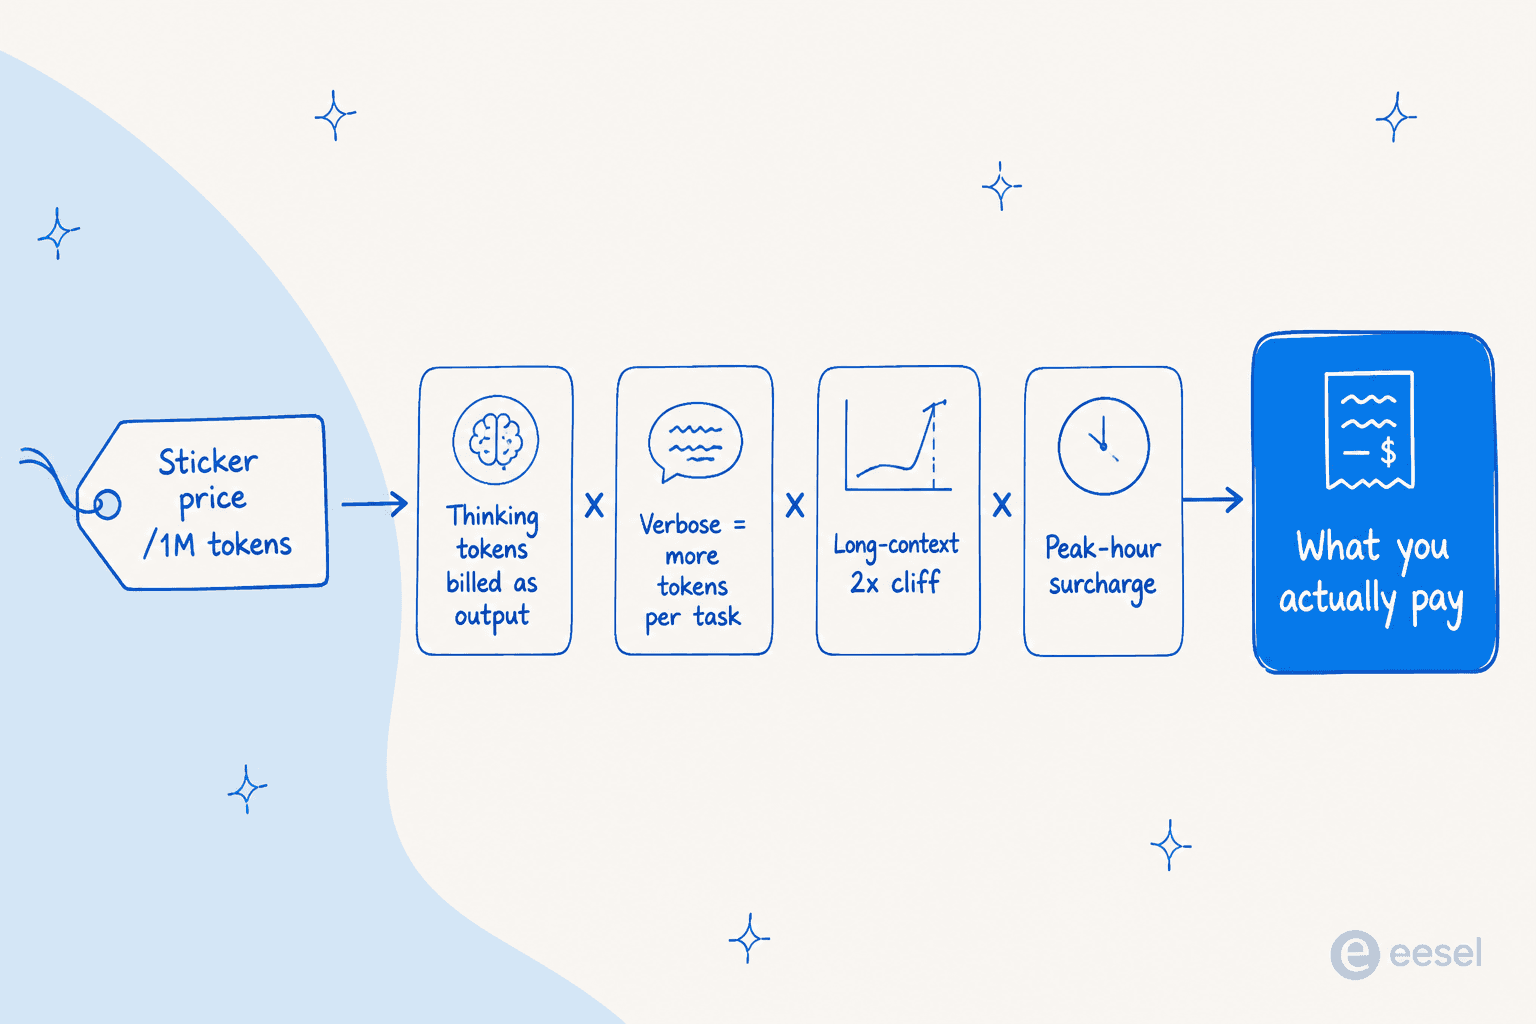
Un thème traverse tout cela : le prix catalogue n'est pas la facture. Les tokens de réflexion sont facturés au tarif de sortie, les modèles verbeux consomment plus de tokens par tâche, certains fournisseurs facturent un supplément de long contexte, et DeepSeek applique même un multiplicateur aux heures de pointe. Gardez cela en tête pour chaque ligne du tableau ci-dessous.
Voici où se situe chaque option sur les deux axes qui comptent le plus pour la plupart des gens : le prix et l'ouverture des poids.
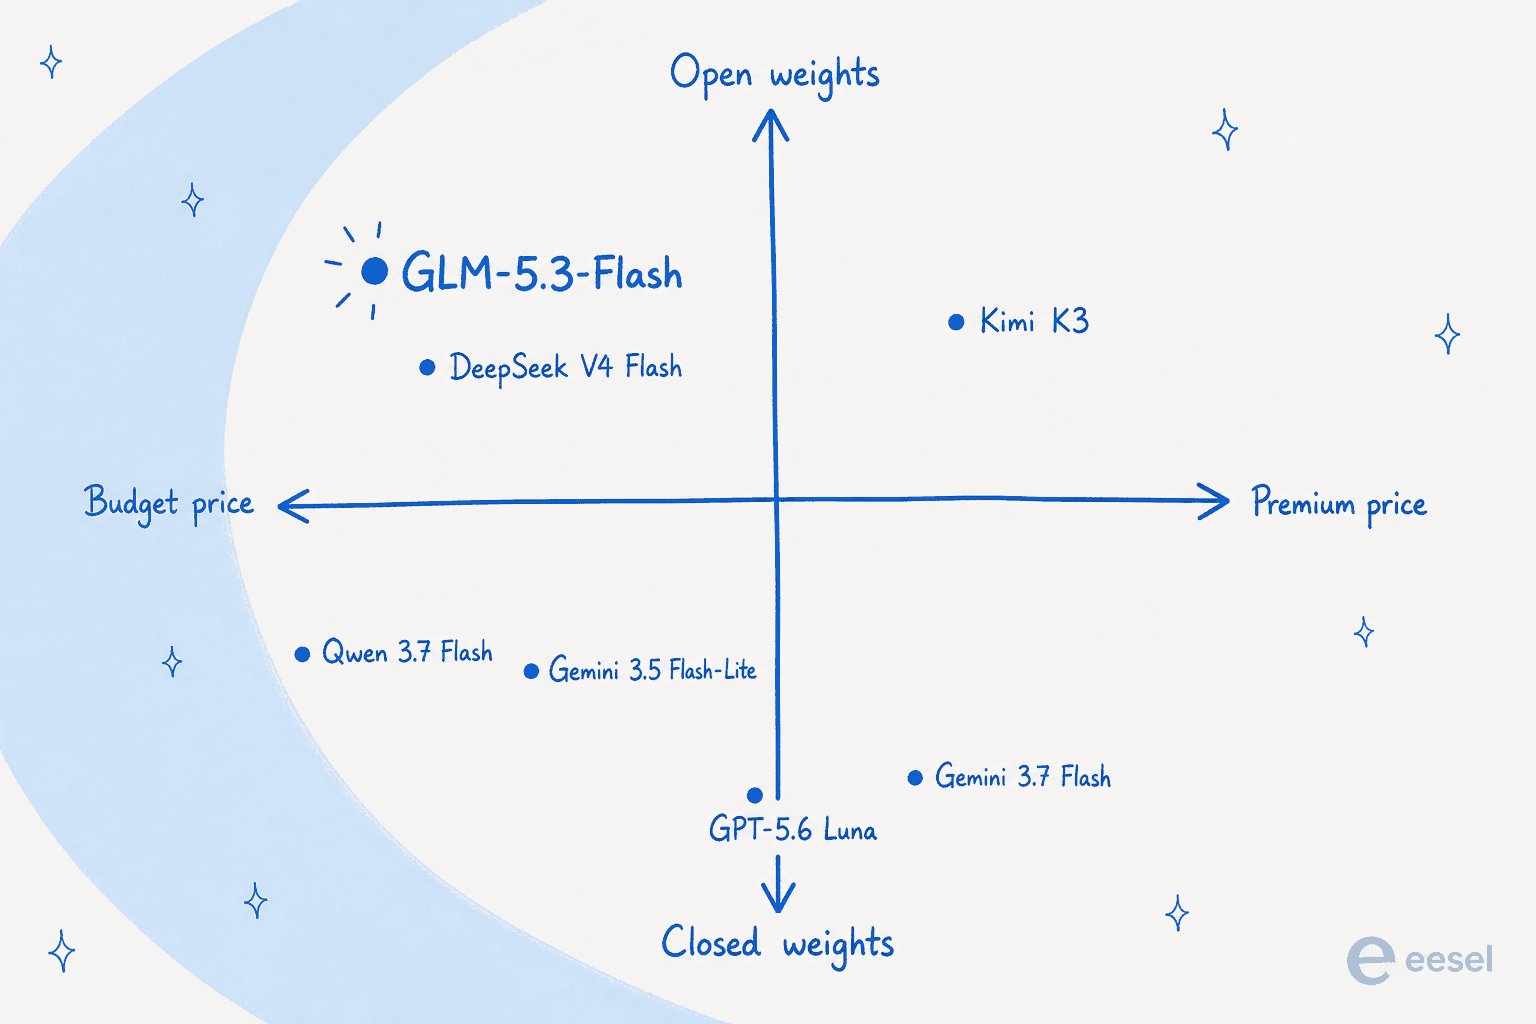
Les alternatives à GLM-5.3-Flash en un coup d'œil
| Modèle | Idéal pour | Entrée / Sortie (par 1M) | Contexte | Poids | Vision | Remarque |
|---|---|---|---|---|---|---|
| GLM-5.3-Flash (le sortant) | Multimodal ouvert et économique | $0.075 / $0.25 (promo) | 1M | Ouverts | Oui | Indice AA 57 ; promo jusqu'au 9 sept |
| DeepSeek V4 Flash | Poids ouverts les moins chers | $0.22 / $0.66 (hors pointe) | 1M | Ouverts (MIT) | Non (texte) | Tarifs x2 en pointe ; verbeux |
| Gemini 3.7 Flash | Modèle fermé le plus rapide | $0.75 / $3.75 (promo) | ~1M | Fermés | Oui | ~340 t/s ; double en janv. 2027 |
| Gemini 3.5 Flash-Lite | Plancher vitesse / prix | $0.30 / $2.50 | ~1M | Fermés | Oui | Palier Gemini le plus rapide et le moins cher |
| GPT-5.6 Luna | Écosystème d'une grande marque | $0.20 / $1.20 | 1.05M | Fermés | Oui (entrée image) | Entrée x2 au-delà de 272K tokens |
| Qwen 3.7 Flash | Le moins cher sur petits prompts | $0.03-$0.20 / $0.13-$0.80 | 1M | Fermés | Oui | Prix par paliers selon la taille du prompt |
| Kimi K3 | Poids ouverts + vision native | $3.00 / $15.00 | 1M | Ouverts | Oui (native) | Gamme phare, pas économique |
Voyons maintenant le détail de chacun, dans l'ordre où je les envisagerais.
1. DeepSeek V4 Flash
Idéal pour : les équipes qui veulent des poids ouverts qu'elles peuvent réellement auto-héberger, et la facture la plus basse possible sur des charges de texte.
Si GLM-5.3-Flash a un vrai rival sur l'axe « économique et ouvert », c'est DeepSeek V4 Flash. C'est un MoE de 284B au total / 13B actifs publié sous une véritable licence MIT, avec 1M de tokens de contexte et des poids ouverts qui tournent sur SGLang ou vLLM. Même la réaction de la communauté à GLM prend DeepSeek comme point de référence, avec une note sur r/opencode selon laquelle le "visible context grows half as fast as Deepseek Flash" de GLM.
Points forts. La licence MIT est le vrai atout : vous pouvez héberger vous-même les quelque 167GB de poids, ce qui rapproche votre coût marginal du prix de vos propres GPU et garde les données clients sur votre infrastructure. Ce dernier point est exactement là où le volet données léger de GLM pèse. À effort maximal, c'est un raisonneur capable (Artificial Analysis lui donne 50), et il est aussi vraiment peu cher sur l'API hébergée.
Points de vigilance. Deux choses. D'abord, il ne gère que le texte, sans entrée d'image documentée, donc ce n'est pas un remplacement à l'identique si vous utilisez la vision de GLM. Ensuite, la tarification hébergée comporte un surcoût aux heures de pointe : l'entrée sans cache coûte $0.22/M hors pointe mais $0.44/M pendant les heures de pointe (01:00-04:00 et 06:00-10:00 UTC), avec une sortie de $0.66 qui passe à $1.32. Une file de support américaine ou européenne est surtout facturée hors pointe, une particularité en votre faveur, mais fragile. Il est aussi verbeux et dépense plus de tokens de sortie par tâche que la médiane de sa catégorie.
Tarifs. Hors pointe $0.22 en entrée / $0.66 en sortie par 1M ; en pointe, exactement le double. Les accès au cache sont quasi gratuits à $0.007/M hors pointe. Tous les chiffres dans notre article sur les tarifs de DeepSeek V4 Flash. Il existe aussi une expérience texte plus vision, DeepSeek V4 Flash Vision, si vous voulez combler l'écart multimodal.
Verdict. Le choix quand les poids ouverts et l'auto-hébergement comptent plus que la vision. Si vous n'envoyez jamais d'images et pouvez faire tourner votre propre inférence, il bat GLM sur le contrôle des données et le coût marginal, et notre test de DeepSeek V4 Flash creuse le piège de la configuration bon marché. Si vous avez besoin de vision ou ne voulez pas exploiter de GPU, lisez la suite.
2. Gemini 3.7 Flash
Idéal pour : les équipes qui veulent le modèle fermé le plus rapide et une plateforme mûre et bien documentée, et qui acceptent un prix de grand fournisseur.
Gemini 3.7 Flash est passé en disponibilité générale le 13 août 2026 comme le "most intelligent workhorse model yet for coding and agents" de Google. C'est le choix naturel si la vitesse du endpoint propre à GLM est votre point bloquant.
Points forts. La vitesse fait la une : Artificial Analysis la mesure à 340.1 tokens/s, rang #1 sur 188 modèles. Il est multimodal, avec environ 1M de tokens de contexte, et s'accompagne de l'outillage, du grounding et de la documentation de Google. Par niveau d'effort, low obtient 50.9 à l'Intelligence Index pour $0.16/tâche et un délai avant le premier token inférieur à la seconde, à un point de l'ancien 3.6 Flash à effort complet. Si vous réduisez l'effort, il est à la fois rapide et économique.
Points de vigilance. Le prix est promotionnel. Il est de $0.75/$3.75 par 1M jusqu'au 31 décembre 2026, puis de $1.50/$7.50 à partir du 1er janvier 2027 selon la page tarifaire de Google, un doublement exact. L'API a aussi beaucoup changé : temperature, top_p et thinking_budget ont disparu, et le niveau de réflexion le moins cher, minimal, a été retiré, donc le plancher pour de l'OCR ou de la classification bon marché est plus haut que sur 3.6 Flash. Et son taux d'hallucination a régressé à 64.5 % contre 55.6 % pour 3.6 Flash, ce qui compte beaucoup si vous le mettez devant des clients sans protection.
Tarifs. $0.75 en entrée / $3.75 en sortie par 1M jusqu'à fin 2026, puis le double. Batch et Flex sont à -50 %.
Verdict. La meilleure vitesse brute ici, sur une plateforme sérieuse. Choisissez-le si la latence et la maturité du fournisseur pèsent plus que le prix, et budgétez dès maintenant la hausse de janvier 2027 plutôt que de la subir par surprise.
3. Gemini 3.5 Flash-Lite
Idéal pour : les tâches à fort débit et gros volume où vous voulez le modèle Google le moins cher et le plus rapide, et pouvez accepter un plafond plus bas.
Si Gemini 3.7 Flash est le cheval de trait, Flash-Lite est le sprinteur. Google le décrit comme "our fastest, most cost-effective 3.5 model for high-throughput execution," et c'est exactement la place que GLM-5.3-Flash peine à occuper seul avec son endpoint propre lent.
Points forts. C'est le plancher de prix et de vitesse des options fermées à $0.30/$2.50 par 1M, tournant à plus de 350 tokens/s, tout en conservant l'entrée multimodale, l'utilisation d'ordinateur et un grand contexte. Pour la classification, le routage, l'étiquetage et autres tâches « économiques et rapides » à gros volume, il est difficile à battre sans passer à l'open source.
Points de vigilance. Vous échangez de l'intelligence contre du débit. Sur le graphique de Pareto, il se situe bien en dessous de GLM-5.3-Flash sur l'Intelligence Index, ce n'est donc pas le modèle pour du raisonnement difficile ou des tâches d'agent nuancées en plusieurs étapes. C'est un spécialiste, pas un remplaçant de modèle phare.
Tarifs. $0.30 en entrée / $2.50 en sortie par 1M, avec batch à moitié prix.
Verdict. Le bon choix pour les pipelines à fort volume et faible complexité où vitesse et coût dominent. Pour tout ce qui exige un raisonnement de niveau GLM, remontez vers un modèle Flash complet.
4. GPT-5.6 Luna
Idéal pour : les équipes qui vivent déjà dans l'écosystème OpenAI et veulent un palier économique sans le quitter.
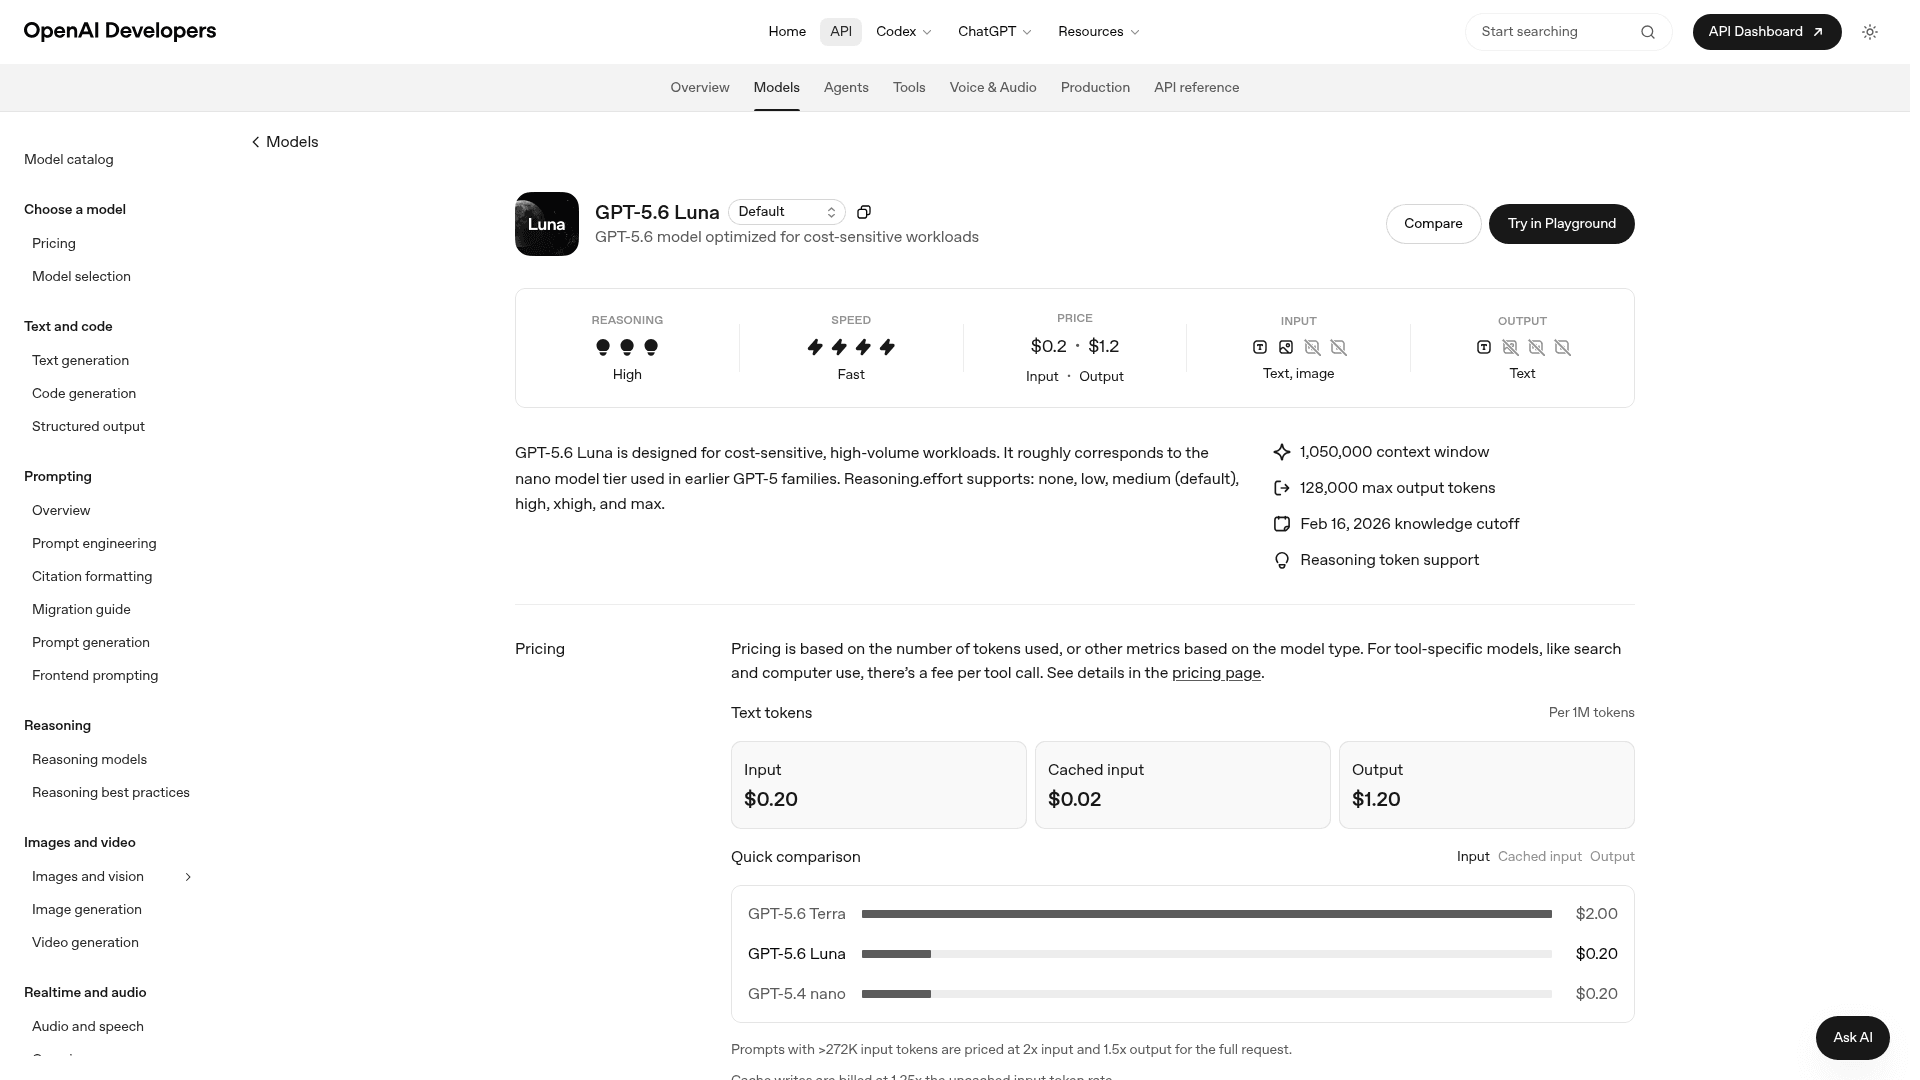
GPT-5.6 Luna est le palier d'OpenAI sensible aux coûts, "designed for cost-sensitive, high-volume workloads," à peu près l'emplacement du nano dans les familles GPT-5 précédentes. C'est l'alternative pour les équipes qui valorisent l'écosystème, l'outillage et le support du plus grand fournisseur plus que le dernier centime économisé.
Points forts. À $0.20/$1.20 par 1M, il est peu cher pour une marque de pointe, avec un contexte de 1,050,000 tokens, une entrée d'images et toute la plage reasoning.effort de none à max. Si votre équipe utilise déjà le SDK OpenAI, Agents et l'outillage, rester dedans supprime beaucoup de friction d'intégration. Cela se lit comme le choix sûr et banal, et c'est parfois le bon.
Points de vigilance. Il y a un seuil de long contexte : les prompts de plus de 272K tokens d'entrée sont facturés à 2x en entrée et 1.5x en sortie pour toute la requête. Le « contexte de 1M » et les « $0.20 » ne peuvent donc pas être vrais ensemble sur un très long prompt. Il est aussi fermé, texte et image uniquement (pas de poids ouverts, pas d'auto-hébergement), et Luna se situe sous GLM-5.3-Flash en intelligence brute, car c'est le palier économique de la famille et non le cheval de trait.
Tarifs. $0.20 en entrée / $1.20 en sortie par 1M, entrée en cache $0.02, avec le supplément de 272K indiqué ci-dessus. Plus de contexte OpenAI dans notre test de GPT-5.6.
Verdict. Idéal quand la force d'attraction de l'écosystème l'emporte sur le prix par token. Si vous êtes déjà tout-OpenAI, Luna est le moyen le moins frictionnel d'obtenir un palier économique ; si vous cherchez uniquement le coût ou des poids ouverts, GLM ou DeepSeek gagnent.
5. Qwen 3.7 Flash
Idéal pour : le travail en vision ou en texte à gros volume avec des prompts courts, où vos appels restent petits.
Qwen 3.7 Flash, d'Alibaba, est l'autre modèle chinois économique du lot, et son modèle tarifaire est vraiment différent de tous les autres ici.
Points forts. Sur les petits prompts, c'est l'option la moins chère de ce comparatif : $0.03/M en entrée et $0.13/M en sortie pour les appels sous 32K tokens. C'est un modèle de vision avec 1M de tokens de contexte, donc sur le papier il couvre le terrain multimodal de GLM avec un ticket d'entrée plus bas.
Points de vigilance. Le prix est organisé en paliers selon la taille du prompt, et les deux chiffres vitrine sont mutuellement exclusifs. Au-delà de 32K tokens, il passe à $0.10/$0.40, et dans la tranche 256K-1M il est de $0.20/$0.80, un écart de 6.7x sur l'entrée. Le mélange glissant d'OpenRouter de ce que les clients paient réellement est de $0.044/$0.149, au-dessus du tarif d'entrée, ce qui montre que le trafic réel atteint les paliers supérieurs. Il est aussi à poids fermés et peu évalué : pas de benchmarks ni d'architecture publiés, et la seule évaluation indépendante (Roboflow) le classe #22 sur 23 au global mais #1 en coût. « Flash » signifie ici économique, pas rapide, à environ 59 tokens/s.
Tarifs. Par paliers : $0.03-$0.20 en entrée / $0.13-$0.80 en sortie par 1M selon la taille du prompt. Détail complet dans notre article sur les tarifs de Qwen 3.7 Flash, et il existe un grand frère avec Qwen3.8-Max si vous avez besoin de plus de marge.
Verdict. Une vraie affaire si, et seulement si, vos prompts restent petits. Modélisez votre distribution réelle de tokens avant de changer, car une charge de support à long contexte peut vous faire glisser discrètement dans le palier cher. Notre test de Qwen 3.7 Flash en dit plus.
6. Kimi K3
Idéal pour : les équipes qui veulent des poids ouverts et la vision native comme GLM, et sont prêtes à payer des prix de modèle phare pour un plafond plus haut.
Kimi K3 est le modèle phare de Moonshot AI, et le plus proche de GLM-5.3-Flash sur la combinaison « poids ouverts plus multimodal natif ». C'est un MoE de 2.8T au total / 104B actifs avec 1M de tokens de contexte et une compréhension native de l'image et de la vidéo, et ses poids ont été publiés sur Hugging Face comme prévu.
Points forts. Les capacités, voilà l'histoire. Il obtient un Intelligence Index d'Artificial Analysis de 57, à égalité avec GLM-5.3-Flash et #4 au global, et il bat Opus 4.8 et GPT-5.5 sur la plupart des benchmarks. La vision native (image et vidéo) plus des poids ouverts signifie que vous pouvez auto-héberger et garder les fonctions multimodales, ce qui est exactement ce qu'offre GLM, mais avec un plus grand nombre de paramètres actifs derrière.
Points de vigilance. Le prix. À $3/$15 par 1M, il se situe dans la tranche de Claude Sonnet, environ 50 fois le prix de sortie de GLM-5.3-Flash. Le raisonnement ne peut être désactivé à aucun niveau, et en effort low il obtient un Index de 47 pour $0.24/tâche, ce qui est à la fois moins bon et environ 8x plus cher que DeepSeek V4 Flash. Il n'accepte pas non plus les URL d'images publiques, seulement du base64 ou des ID de fichier. Ce n'est pas un remplacement économique.
Tarifs. $3 en entrée / $15 en sortie par 1M, accès au cache $0.30. Voir nos articles sur les tarifs de Kimi K3 et les alternatives à Kimi K3 pour le tableau complet.
Verdict. La montée en capacités, pas l'économie de coût. Choisissez Kimi K3 quand vous voulez la forme ouverte plus multimodale de GLM avec plus d'intelligence brute et pouvez absorber des prix de modèle phare. Si le coût est la raison de votre présence ici, c'est la mauvaise direction.
Quelle alternative vous convient vraiment ?
Le tableau et le quadrant font l'essentiel du travail, mais la réponse honnête dépend de votre contrainte principale. Choisissez celle qui compte le plus et voyez où elle mène :
Qu'est-ce qui compte le plus pour votre charge de travail ?
Ce que le choix du modèle ne résout pas
Voici ce que je dirais à quiconque se tourmente sur ce tableau, et cela vient d'années passées à mettre de l'IA sur des files de support en production : changer de modèle, c'est les 5 % faciles. Si votre objectif est de répondre aux tickets clients, le modèle est la couche du bas de la pile, et c'est celle qui change le moins quand vous changez de fournisseur.
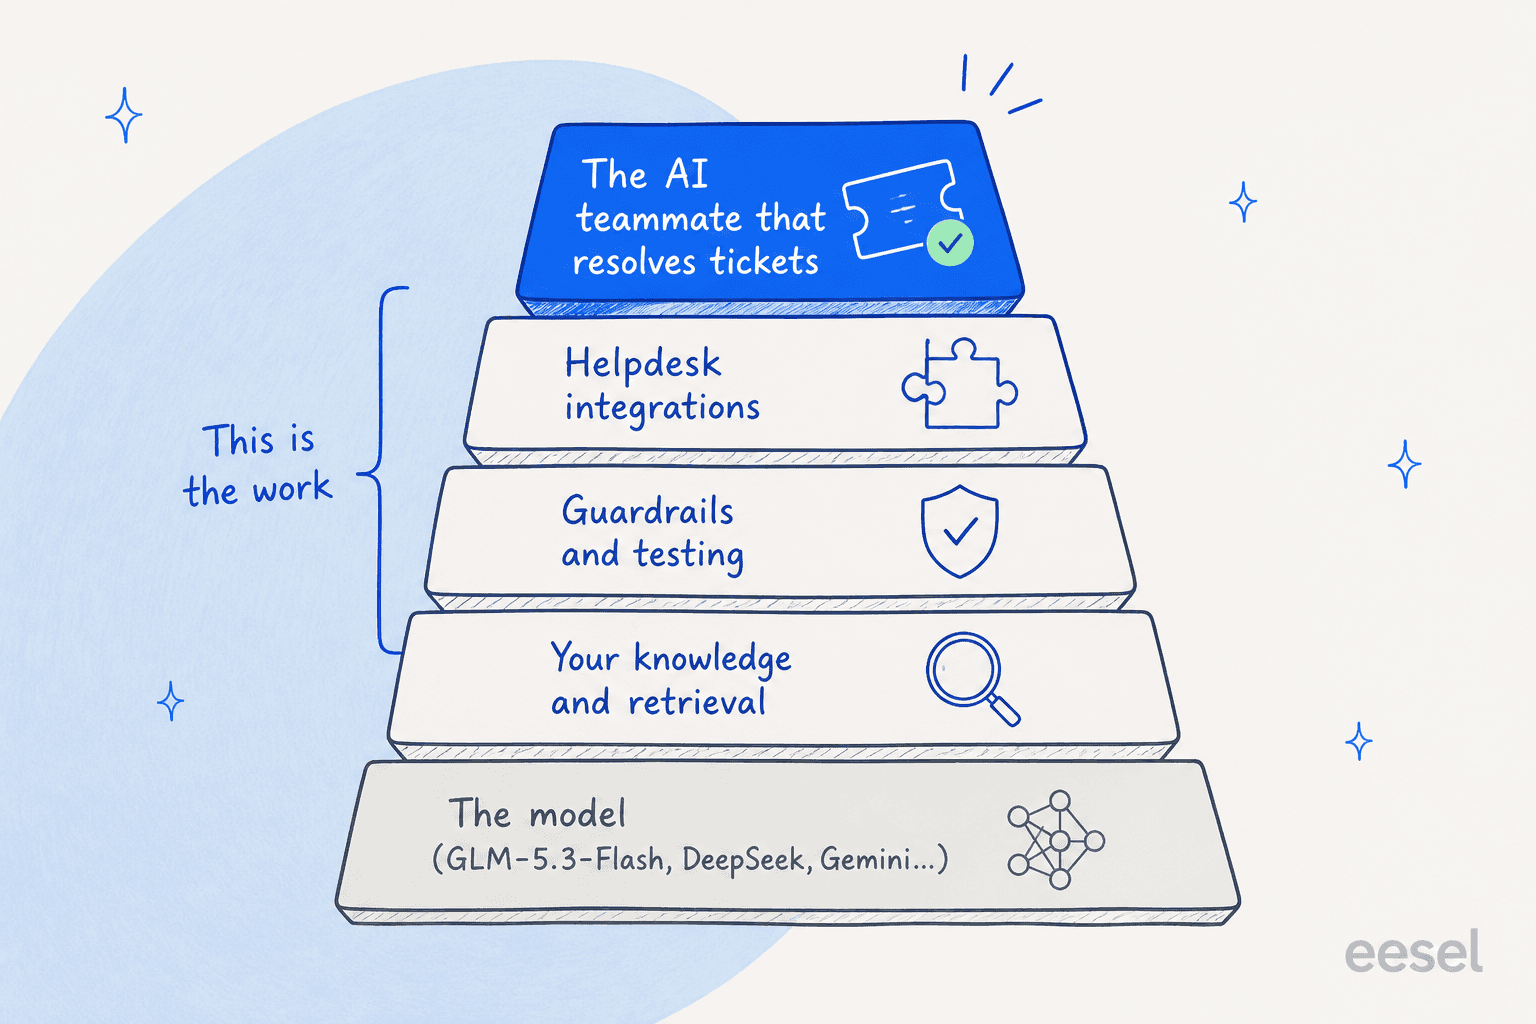
C'est la même logique que d'embaucher un employé IA plutôt que de louer une API brute, et c'est pourquoi les meilleurs coéquipiers IA sont jugés sur les résultats, pas sur les tokens par seconde. Tout ce qui se trouve au-dessus du modèle est le vrai travail : connecter votre base de connaissances pour que les réponses soient ancrées, des garde-fous pour qu'il sache ce qu'il ne doit pas dire, des tests pour savoir comment il se comporte avant vos clients, et des intégrations à votre helpdesk pour qu'il puisse réellement agir. La raison pour laquelle un modèle moins cher fait rarement bouger votre taux de résolution est que le taux de résolution se joue dans ces couches supérieures, pas dans les tokens par seconde.
C'est aussi là que les chiffres d'hallucination ci-dessus cessent d'être anecdotiques. Le taux d'hallucination de 64.5 % de Gemini 3.7 Flash, ou n'importe lequel de ces modèles répondant avec assurance quand il ne le devrait pas, n'est dangereux que s'il atteint un client sans avoir été testé. Nous avons vu des bots à l'air sûr d'eux donner discrètement de mauvaises réponses, et c'est exactement pourquoi nous simulons désormais chaque déploiement sur les vrais tickets historiques d'une entreprise avant sa mise en ligne. Aucun choix du « bon » modèle bon marché n'y supplée. Si vous voulez l'angle modèle spécifiquement pour le support, nous l'avons détaillé séparément dans l'article sur le meilleur modèle d'IA pour les tickets de support.
Essayer eesel
Si vous comparez les alternatives à GLM-5.3-Flash pour construire de l'automatisation du support client, eesel est la couche qui se place au-dessus du modèle que vous choisirez. Voyez le modèle comme le moteur et eesel comme le coéquipier IA que vous embauchez : il arrive en sachant déjà se brancher sur Zendesk, Freshdesk ou Gorgias, apprend de vos tickets passés et de votre centre d'aide, et respecte les garde-fous que vous définissez.
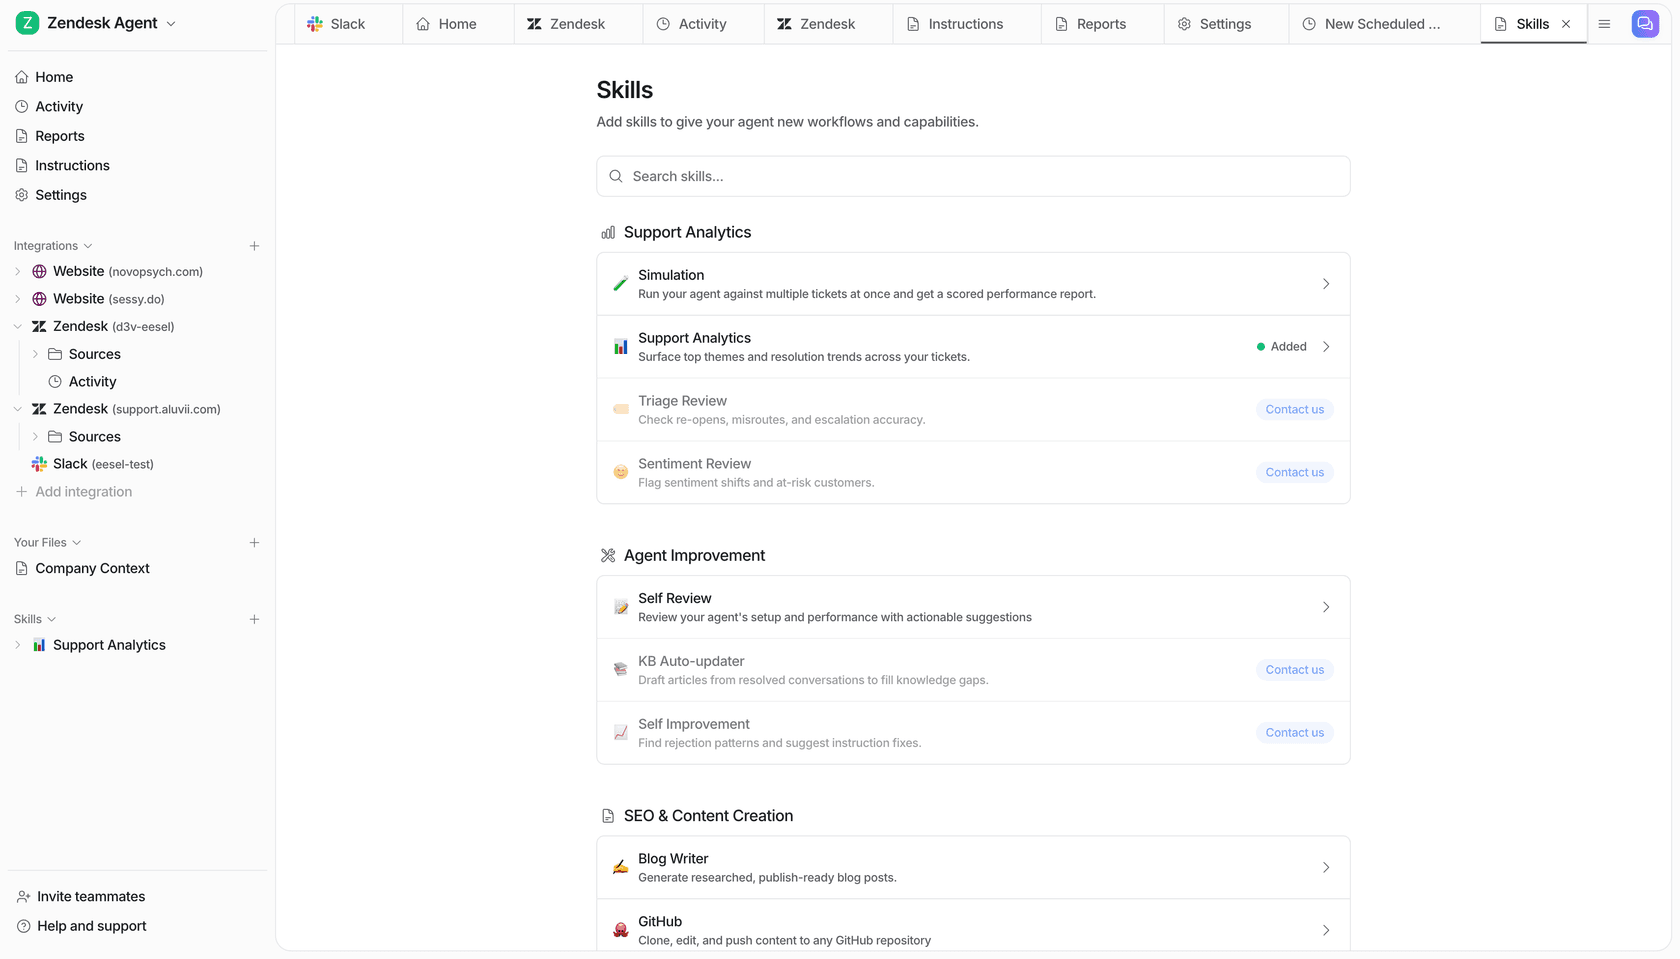
Le point différenciant, c'est la simulation : avant que votre coéquipier IA ne réponde au moindre ticket en direct, eesel le rejoue sur des milliers de vos vraies conversations passées, ce qui vous permet de voir le taux de résolution et les réponses exactes qu'il aurait envoyées, et de les corriger tant que le risque est encore nul. C'est la garantie qui transforme un modèle économique et capable en un agent de support en qui vous pouvez vraiment avoir confiance. Il est gratuit à essayer, et vous pouvez le brancher sur votre propre helpdesk en quelques minutes.