

Pour rendre votre centre d'aide lisible par les agents IA, réparez d'abord les articles, puis les fichiers : une question par article, répondue en texte brut dans les deux premières phrases, des sections qui restent sensées lues isolément, et une date sur tout ce qui change. Autorisez ensuite dans robots.txt les robots de recherche IA que vous voulez, et laissez les barrières de connexion là où vous les voulez vraiment. llms.txt et MCP viennent en dernier : le 17 novembre 2026, les centres d'aide de Zendesk et Help Scout eux-mêmes renvoyaient encore une 404 pour /llms.txt.
Le lecteur qui compte le plus est votre propre IA support. Le coéquipier IA pour helpdesk d'eesel répond à partir de votre centre d'aide et des tickets passés, et chaque brouillon que votre équipe corrige pointe vers un article à réparer. Avec le CLI eesel, un agent de code peut vérifier ce que la synchronisation du centre d'aide contient réellement et lancer des questions tests avant la mise en ligne ; un administrateur doit toujours approuver la connexion au helpdesk.
Qui lit votre centre d'aide aujourd'hui ?
Je suis ingénieur logiciel chez eesel avec deux ans de travail en SEO derrière moi, et la question que me posent les responsables support et documentation a changé. Avant, c'était : « pourquoi cet article ne se positionne-t-il pas ? » Maintenant, c'est : « pourquoi ChatGPT a-t-il dit à un client que notre délai de remboursement est de 14 jours alors qu'il est de 30 ? » La réponse courte : votre centre d'aide a trois nouveaux lecteurs, et chacun le lit différemment.
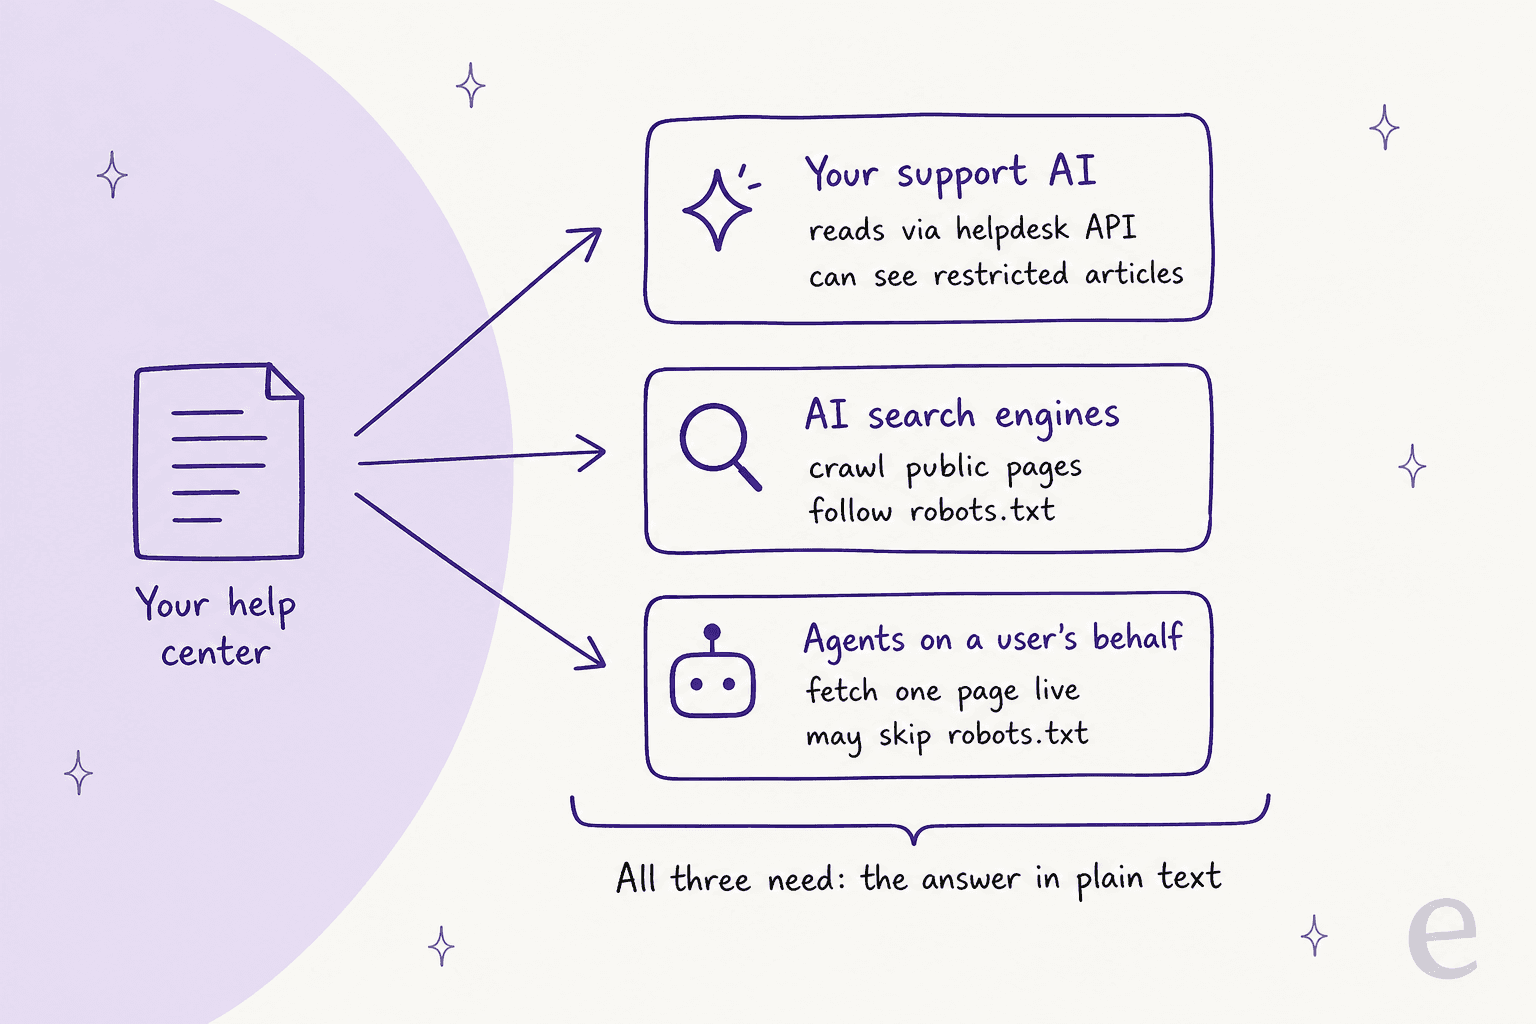
- Votre propre IA support. Le bot ou copilote que vous avez entraîné sur votre base de connaissances synchronise généralement les articles via l'API du helpdesk selon un calendrier. robots.txt lui est indifférent, et il peut lire les articles restreints si vous le permettez.
- Les moteurs de recherche IA. La recherche ChatGPT, Claude, Perplexity et les AI Overviews de Google parcourent vos pages publiques à l'avance, de la même façon que les moteurs de recherche IA construisent n'importe quel index. Ils suivent robots.txt, une règle par robot.
- Les agents agissant pour un utilisateur. Quand quelqu'un interroge ChatGPT sur votre produit, il peut récupérer votre page en direct en tant que
ChatGPT-User. Un agent de code peut récupérer votre documentation en markdown, et un client MCP peut l'interroger comme un outil.
Voici comment ils diffèrent sur ce que vous contrôlez :
| Lecteur | Comment il entre | Suit robots.txt ? | Voit les articles réservés à la connexion ? | Exécute JavaScript ? |
|---|---|---|---|---|
| Votre IA support | Synchronisation ou connecteur via l'API du helpdesk | Non, il utilise votre accès API | Oui, si la connexion a la permission | Pas nécessaire, il lit le corps de l'article |
| Robots de recherche IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot) | Parcourt les URLs publiques | Oui | Non | Les robots de ChatGPT et Claude ne l'ont pas fait dans le test de Vercel ; Gemini si |
| Récupérateurs déclenchés par l'utilisateur (ChatGPT-User, Claude-User, Perplexity-User) | Récupère une URL pendant un chat | Pas toujours, voir étape 4 | Non | Considérez que non |
| Agents de code et clients MCP | llms.txt, pages markdown, outils MCP | Dépend du client | Seulement avec des identifiants | Pas nécessaire |
La colonne qui devrait vous inquiéter est la dernière. L'analyse du trafic des robots IA de Vercel a montré que les robots de ChatGPT et Claude récupèrent les fichiers JavaScript mais ne les exécutent pas, donc tout ce qui est rendu côté client leur est invisible. Chaque lecteur du tableau peut lire le texte brut présent dans la page ou dans la réponse de l'API. C'est pourquoi les trois premières étapes ci-dessous portent sur les articles eux-mêmes, et pourquoi elles profitent aux quatre lecteurs à la fois. La façon dont l'IA support choisit ensuite un passage est une question de récupération, mais elle ne peut choisir que parmi ce qu'elle a pu lire.
Votre centre d'aide est-il lisible par l'IA aujourd'hui ?
Avant les étapes, faites l'audit. Cela prend dix minutes, avec un article ouvert dans un onglet du navigateur et votre administrateur helpdesk dans un autre.
Cochez ce qui est déjà vrai ; le score grimpe au fur et à mesure. Les points que vous ne pouvez pas cocher renvoient aux étapes ci-dessous.
Étape 1 : écrivez une question par article, répondue dans les premières lignes
Un lecteur IA utilise rarement tout votre article. Les moteurs de recherche et les robots support découpent les pages en passages, extraient les deux ou trois qui semblent les plus proches de la question, et en rédigent une réponse. L'unité pour laquelle vous écrivez est donc le passage, pas la page.
GitBook le dit clairement dans son guide de documentation prête pour les LLM : « GitBook gère la couche de livraison. Votre rédaction façonne la qualité des réponses IA. » Sa checklist est courte : donnez à chaque page un objectif clair, utilisez des titres descriptifs et des sections courtes, indiquez directement les contraintes, les valeurs par défaut et les exigences, incluez des valeurs exactes, et mettez à jour le contenu quand le produit change.
En pratique, cela signifie trois changements pour la plupart des centres d'aide :
- Les titres sont des questions que posent les clients. « Comment changer mon e-mail de facturation ? » bat « Aperçu des paramètres de facturation ». C'est le même conseil que je donne pour écrire des articles de base de connaissances, et cela correspond aussi souvent à ce que les gens tapent dans la recherche.
- La réponse vient en premier. Une ou deux phrases qui résolvent la question, puis les étapes, puis les cas particuliers. Si un passage est extrait seul, c'est la première phrase qui doit survivre.
- Chaque section se comprend seule. Répétez le nom. « Activez-le » ne veut rien dire dans un passage qui a perdu son titre.
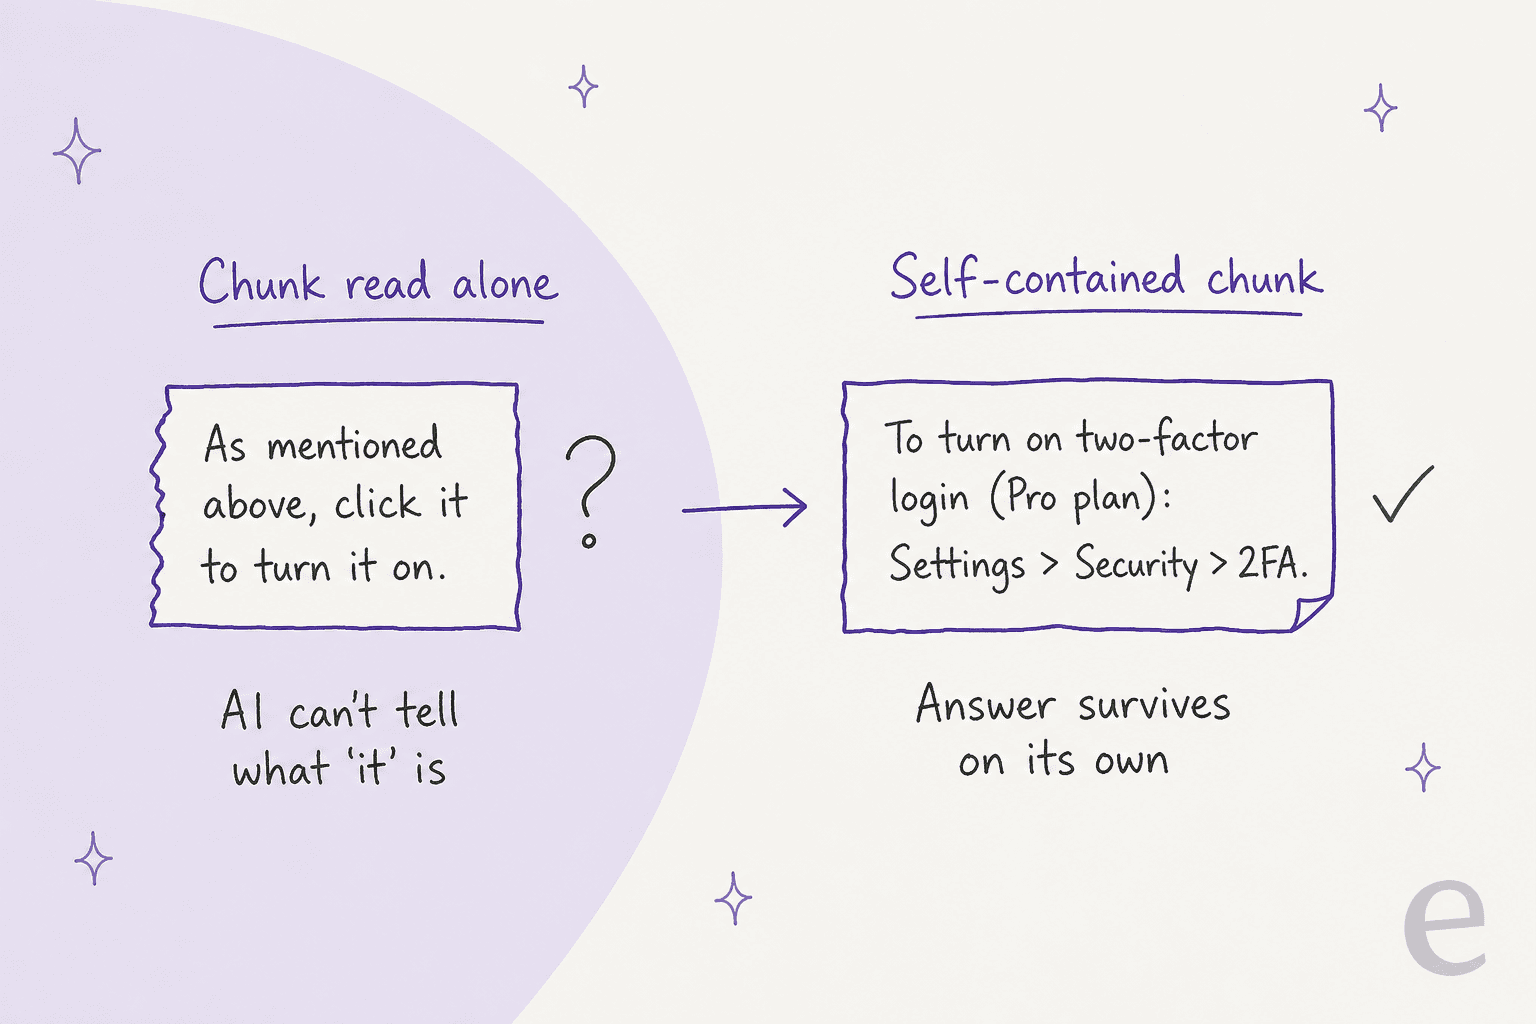
Une question par article évite aussi un échec silencieux. Une longue « FAQ du compte » avec 25 réponses sur une seule page se retrouve découpée en passages qui partagent tous le même titre, donc l'IA ne peut pas distinguer quelle réponse appartient à quelle question. Diviser d'abord les grosses pages de FAQ est le gain le plus rapide que je connaisse pour dévier les FAQ avec l'IA.
Si vous utilisez Document360, il y a une deuxième raison d'écrire de bons résumés : son llms.txt généré utilise la « description IA et recherche » de chaque article, et selon la documentation llms.txt de Document360, le contenu sans une telle description « est inclus dans llms.txt uniquement par son titre. »
Étape 2 : sortez les réponses des images, vidéos, PDF et widgets à cliquer
C'est l'étape qui casse le plus de réponses IA que je vois. Un article d'aide dit « allez dans les paramètres montrés ci-dessous », et le seul endroit où le chemin apparaît est une capture d'écran. La personne qui lit la voit. La plupart des lecteurs IA ne la voient pas.
Les propres consignes de Google sur les fonctionnalités IA listent « s'assurer que le contenu important est disponible sous forme textuelle » comme une des bases pour apparaître dans les AI Overviews et le AI Mode. La même chose s'applique à votre IA support : une synchronisation qui récupère le corps de l'article obtient le texte et l'URL de l'image, pas ce qui est dessiné dans l'image.
Où la réponse se cache généralement, et quoi faire :
| Où la réponse se cache | Ce que les lecteurs IA obtiennent | Correction |
|---|---|---|
| Capture d'écran d'une page de paramètres | Une URL d'image et peut-être un texte alternatif | Écrivez le chemin du menu en texte : Paramètres > Sécurité > 2FA. Gardez la capture comme sauvegarde (conseils de mise en forme) |
| Tutoriel vidéo intégré | Un lecteur intégré, sans étapes | Ajoutez les étapes ou une transcription sous la vidéo (vidéos intégrées) |
| PDF ou pièce jointe de diapositives | Souvent ignoré, ou lu sans structure | Déplacez le contenu dans l'article (pièces jointes) |
| Onglets ou accordéons chargés par un script | Rien, si le texte arrive après l'exécution du JavaScript | Gardez le texte dans le HTML. Un simple bloc <details> convient car le texte est déjà là |
| Prix ou limites dans un widget intégré | Rien | Indiquez le chiffre dans une phrase avec une date |
Cela compte aussi pour votre propre bot, pas seulement pour la recherche publique. Chez SE Ranking, eesel répond aux chats en direct pour trois produits à partir d'environ 14 100 pages de centre d'aide, et ses instructions précisent qu'il ne décrit jamais un menu ou un bouton qu'il n'a pas trouvé dans la connaissance. C'est la bonne règle pour un agent support. Cela signifie aussi qu'un chemin de menu qui n'existe que dans une capture d'écran est un chemin que l'agent ne donnera pas, donc le client est transféré à une personne pour quelque chose que votre centre d'aide couvre déjà.
Un test rapide pour n'importe quel article : regardez le code source de la page (ou la réponse de l'API) et cherchez l'étape clé. Si elle n'est pas dans le texte, supposez qu'aucun lecteur IA ne l'a.
Étape 3 : datez vos faits, et retirez correctement les vieux articles
Un lecteur IA est confiant par défaut. Si un vieil article dit que le délai de remboursement est de 14 jours et qu'un plus récent dit 30, le modèle peut citer l'un ou l'autre, et il n'ajoutera pas « mais vérifiez la date ». Un contenu obsolète fait plus de dégâts dans une réponse IA que sur une page, parce que le client ne voit jamais le pied de page « dernière mise à jour 2023 ».
Trois habitudes règlent la plupart des cas :
- Mettez la date juste à côté du fait. « Les remboursements sont possibles jusqu'à 30 jours après l'achat (politique en vigueur depuis octobre 2026) » survit à l'extraction dans un passage. Un pied de page ne survit pas.
- Supprimez ou fusionnez les doublons. Deux articles répondant à la même question avec des chiffres différents sont la cause la plus fréquente d'une mauvaise réponse IA que je vois. Faites d'abord une passe sur le contenu obsolète du centre d'aide.
- Redirigez, ne renvoyez pas de 404. Dans les données de crawl de Vercel, ChatGPT a passé 34,82 % de ses requêtes sur des pages 404 et encore 14,36 % à suivre des redirections. Quand vous déplacez un article, mettez en place la redirection pour que les moteurs de recherche IA atterrissent sur la version actuelle.
Votre propre IA support a aussi besoin d'une règle pour les conflits. OroSoft fait fonctionner eesel comme copilote Freshdesk, qui traite le centre d'aide comme la source de vérité pour la politique, et quand le centre d'aide et les tickets passés se contredisent, il suit le plus récent. Son centre d'aide se resynchronise chaque lundi. C'est la boucle dont toute équipe a besoin, quel que soit l'outil utilisé :
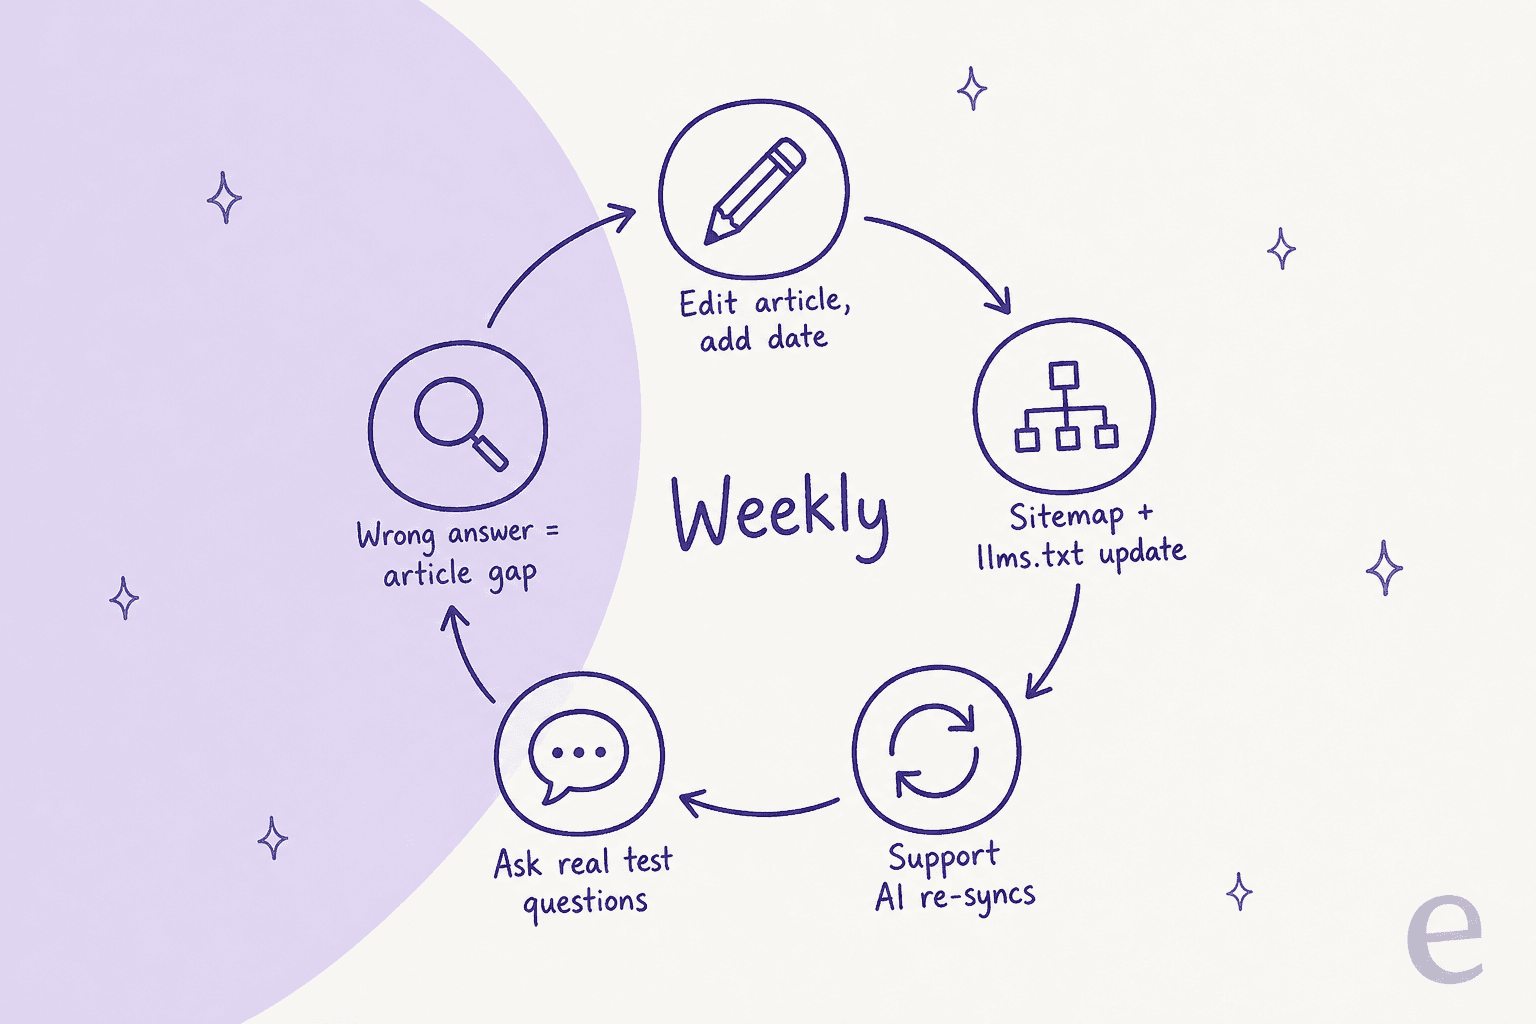
Zendesk régénère le sitemap de son centre d'aide toutes les deux heures, selon son article sur le SEO du centre d'aide, donc le côté public s'occupe surtout de lui-même. Le calendrier de synchronisation de votre bot est celui à vérifier. S'il synchronise mensuellement, un changement de politique est faux dans les réponses IA pendant jusqu'à un mois. Une base de connaissances auto-actualisée aide dans l'autre sens : elle rattrape les réponses qui n'ont jamais atteint un article.
Étape 4 : décidez quels robots IA peuvent le lire
La plupart des entreprises IA divisent désormais leurs robots par tâche : un pour l'entraînement des modèles, un pour la recherche, un pour les requêtes qu'un utilisateur demande. Vous pouvez en autoriser un et bloquer l'autre. C'est là que je vois des équipes support cacher accidentellement leur centre d'aide, généralement après que quelqu'un a collé un extrait robots.txt « bloquer tous les robots IA ».
| Entreprise | Robot d'entraînement | Robot de recherche | Récupérateur déclenché par l'utilisateur |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User (« les règles robots.txt peuvent ne pas s'appliquer ») |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User (le bloquer arrête la récupération dirigée par l'utilisateur) |
| Perplexity | aucun listé | PerplexityBot | Perplexity-User (« ignore généralement les règles robots.txt ») |
| Google-Extended (un jeton de contrôle, pas un robot séparé) | Googlebot | non couvert ici |
Chaque nom d'entreprise renvoie à sa propre documentation sur les robots.
La règle pour un centre d'aide public est simple : autorisez les robots de recherche. OpenAI indique que les sites qui se retirent d'OAI-SearchBot « ne seront pas montrés dans les réponses de recherche ChatGPT », et Anthropic indique que bloquer Claude-SearchBot « peut réduire la visibilité et la précision de votre site dans les résultats de recherche des utilisateurs ». Laisser entrer ou non les robots d'entraînement est une décision séparée pour vos équipes juridique et marketing.
Un robots.txt de centre d'aide qui conserve l'accès de recherche IA tout en se retirant de l'entraînement ressemble à ceci :
# Recherche IA : laissez ceux-ci indexer le centre d'aide
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Entraînement des modèles : un choix de politique, pas un choix de réponses
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Trois détails qui piègent les gens :
- Google-Extended fait plus que de l'entraînement. Google indique qu'il contrôle aussi le grounding dans Gemini Apps et Vertex AI, donc le bloquer peut garder vos articles hors des réponses Gemini, alors qu'il « n'affecte pas l'inclusion d'un site dans la Recherche Google ».
- Les changements ne sont pas instantanés. OpenAI indique que cela peut prendre environ 24 heures après un changement de robots.txt pour que ses systèmes de recherche s'ajustent.
- robots.txt ne couvre que le domaine où il se trouve. Les instructions d'Anthropic indiquent de répéter les règles pour chaque sous-domaine, ce qui compte si votre centre d'aide vit sur
help.ousupport.
Si vous voulez voir à quelle fréquence les moteurs IA vous citent réellement après cela, c'est une question d'optimisation pour les moteurs de réponse, et ces outils couvrent le volet suivi.
Étape 5 : placez la barrière de connexion là où vous la voulez vraiment
Tout lecteur IA public s'arrête à une page de connexion. Zendesk est direct là-dessus : si votre centre d'aide exige une connexion, « le sitemap ne sera pas généré automatiquement. Les robots web ne peuvent pas accéder aux centres d'aide fermés ou restreints. » La documentation llms.txt de Mintlify dit la même chose pour ses fichiers générés : sur des sites entièrement authentifiés, « les outils IA qui ne peuvent pas s'authentifier ne peuvent pas y accéder. »
C'est un comportement correct. L'erreur consiste à mettre des réponses publiques derrière la barrière par accident, souvent parce qu'une catégorie entière a été restreinte à un segment d'utilisateurs pour un seul article sensible. Auditez les restrictions article par article, et restreignez par segment uniquement ce qui doit vraiment être privé.
Planifiez ensuite deux voies :
- Voie publique : tout ce qu'un prospect ou un client pourrait demander avant de se connecter. C'est ce que citeront les moteurs de recherche IA et les récupérateurs de type ChatGPT.
- Voie privée : articles spécifiques à un compte, réservés aux partenaires ou internes. Seule votre propre IA support devrait les lire, via une connexion API avec permission, comme l'API Zendesk Guide ou l'API de base de connaissances Freshdesk.
Cela devient plus précis que ce qu'on attend. Lors d'un appel commercial eesel, une équipe logistique enterprise avait besoin de deux agents à partir d'un seul Zendesk : un pour les utilisateurs anonymes qui répond uniquement à partir des articles publics, et un pour les utilisateurs inscrits qui lit aussi un sous-ensemble d'articles restreints. C'est le bon instinct. Décidez quel public chaque lecteur IA sert, puis donnez-lui exactement ce contenu.
Étape 6 : ajoutez llms.txt et des versions markdown
Voici maintenant la partie par laquelle commencent la plupart des guides. llms.txt est un standard proposé : un fichier markdown à /llms.txt qui liste vos pages clés avec des descriptions d'une ligne, plus des versions markdown propres de chaque page à la même URL avec .md ajouté. L'idée est d'éviter à un agent d'analyser la navigation, les scripts et les bannières de cookies pour trouver une réponse.
Où en sont les choses en novembre 2026 :
- Les agents de code et les clients IA l'utilisent. La spécification dit que les fichiers llms.txt sont « utilisés le plus massivement pour la documentation logicielle, où les agents de code les suivent pour trouver des références d'API et des tutoriels. » Zendesk a ajouté llms.txt et des pages markdown à sa documentation développeur le 4 novembre 2026, et son annonce dit aux développeurs de donner à leur agent
developer.zendesk.com/llms.txtcomme index de recherche. - Les moteurs de recherche n'en ont pas besoin. Google indique que les AI Overviews et le AI Mode n'ont « pas d'exigences techniques supplémentaires » au-delà de l'éligibilité normale à la Recherche. L'audit llms.txt de Lighthouse de Chrome marque un fichier manquant comme non applicable, « puisque fournir le fichier est facultatif pour le moment. »
- Les centres d'aide clients n'en ont majoritairement pas encore. Le 17 novembre 2026, j'ai demandé
/llms.txtsur support.zendesk.com, docs.helpscout.com et support.freshdesk.com. Les trois ont renvoyé une 404. Les centres d'aide de ces mêmes entreprises se positionnent et sont cités sans problème, ce qui indique où llms.txt se situe dans la liste des priorités.
La communauté développeur est divisée sur l'importance de tout cela, et les deux camps ont un point valable :
"LLMs are not reading llms.txt nor AGENTS.md files from servers. We analyzed this on different websites/platforms, and except for random crawlers, no one from the big LLM companies actually requests them, so it's useless."

"llms.txt files have nothing to do with crawlers or big LLM companies. They are for individual client agents to use. I have my clients set up to always use them when they're available, and since I did that they've been way faster and more token efficient when using sites that have llms.txt files."
Le second commentaire vient du compte de Jeremy Howard, qui a écrit la proposition llms.txt, et il correspond à ce que dit la spécification : llms.txt est fait pour les agents qui viennent le chercher, pas pour les robots qui construisent un index. Si votre centre d'aide est lu par des agents de code de développeurs (produits API, outils dev, tout ce qui a un SDK), cela vaut le coup. Pour un centre d'aide grand public, c'est une assurance bon marché, pas un levier de positionnement.
Si votre plateforme le fait pour vous, activez-le et passez à la suite :
| Plateforme | llms.txt | Pages markdown | À surveiller |
|---|---|---|---|
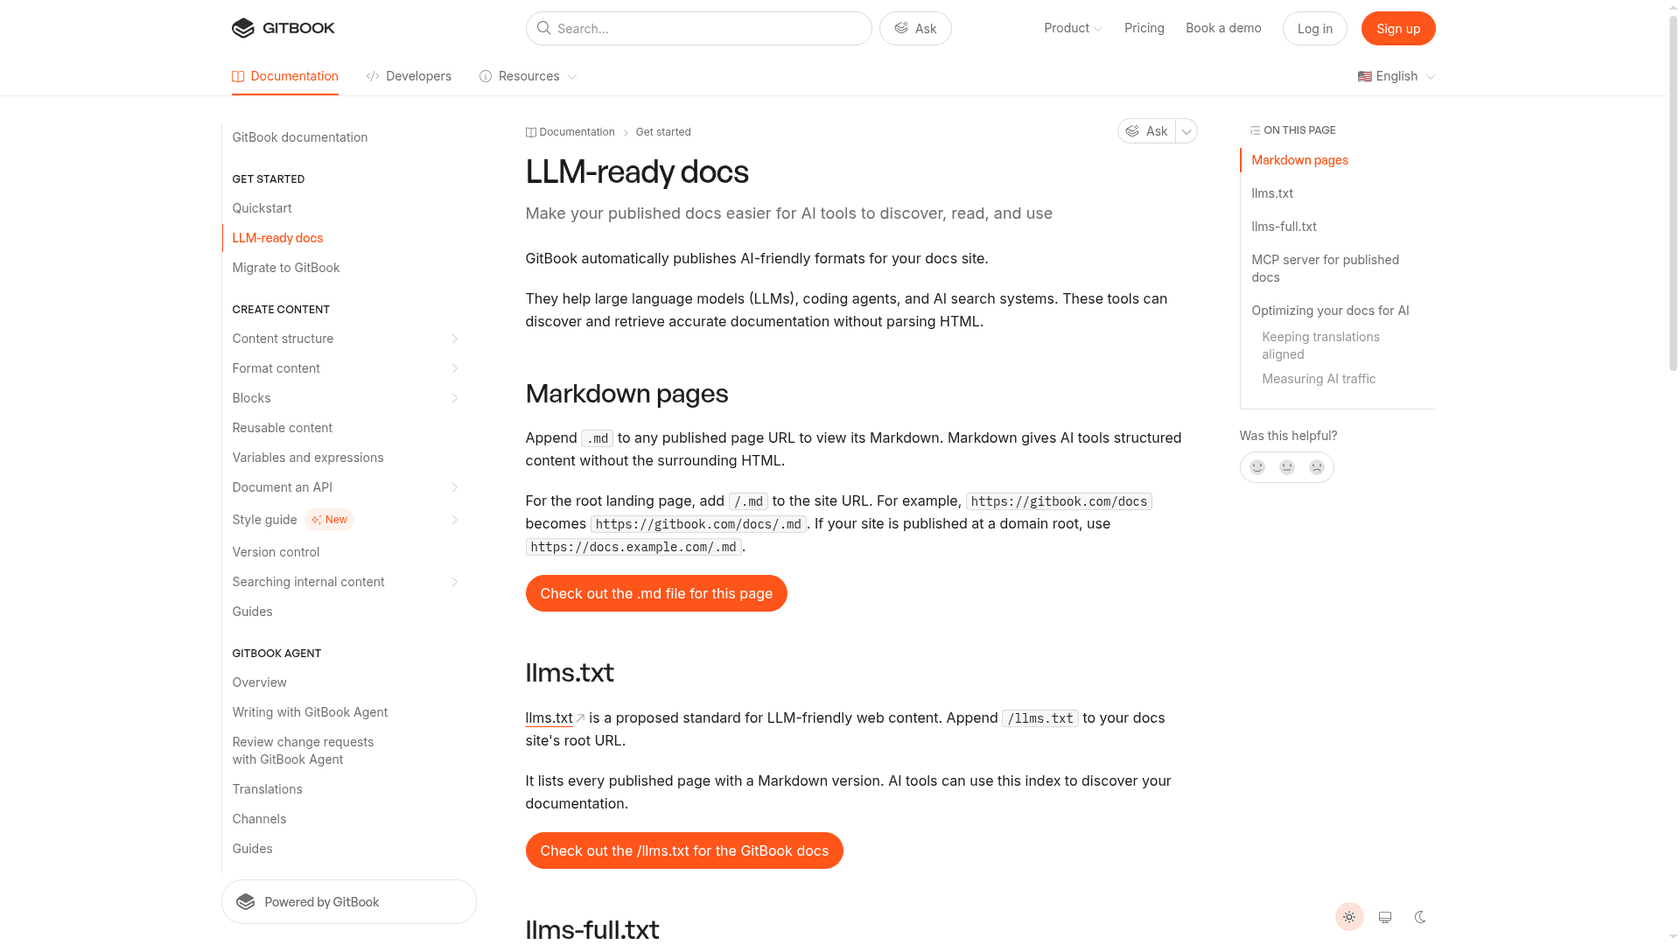
| GitBook | Automatique, plus llms-full.txt | Ajoutez .md à n'importe quelle page | Les pages masquées restent incluses dans llms-full.txt et le serveur MCP |
| Mintlify | Automatique, aussi sur /.well-known/llms.txt | Ajoutez .md ; les pages HTML renvoient vers leur version markdown | Le paramètre « Don't index project » renvoie une 404 pour llms.txt mais pas pour llms-full.txt |
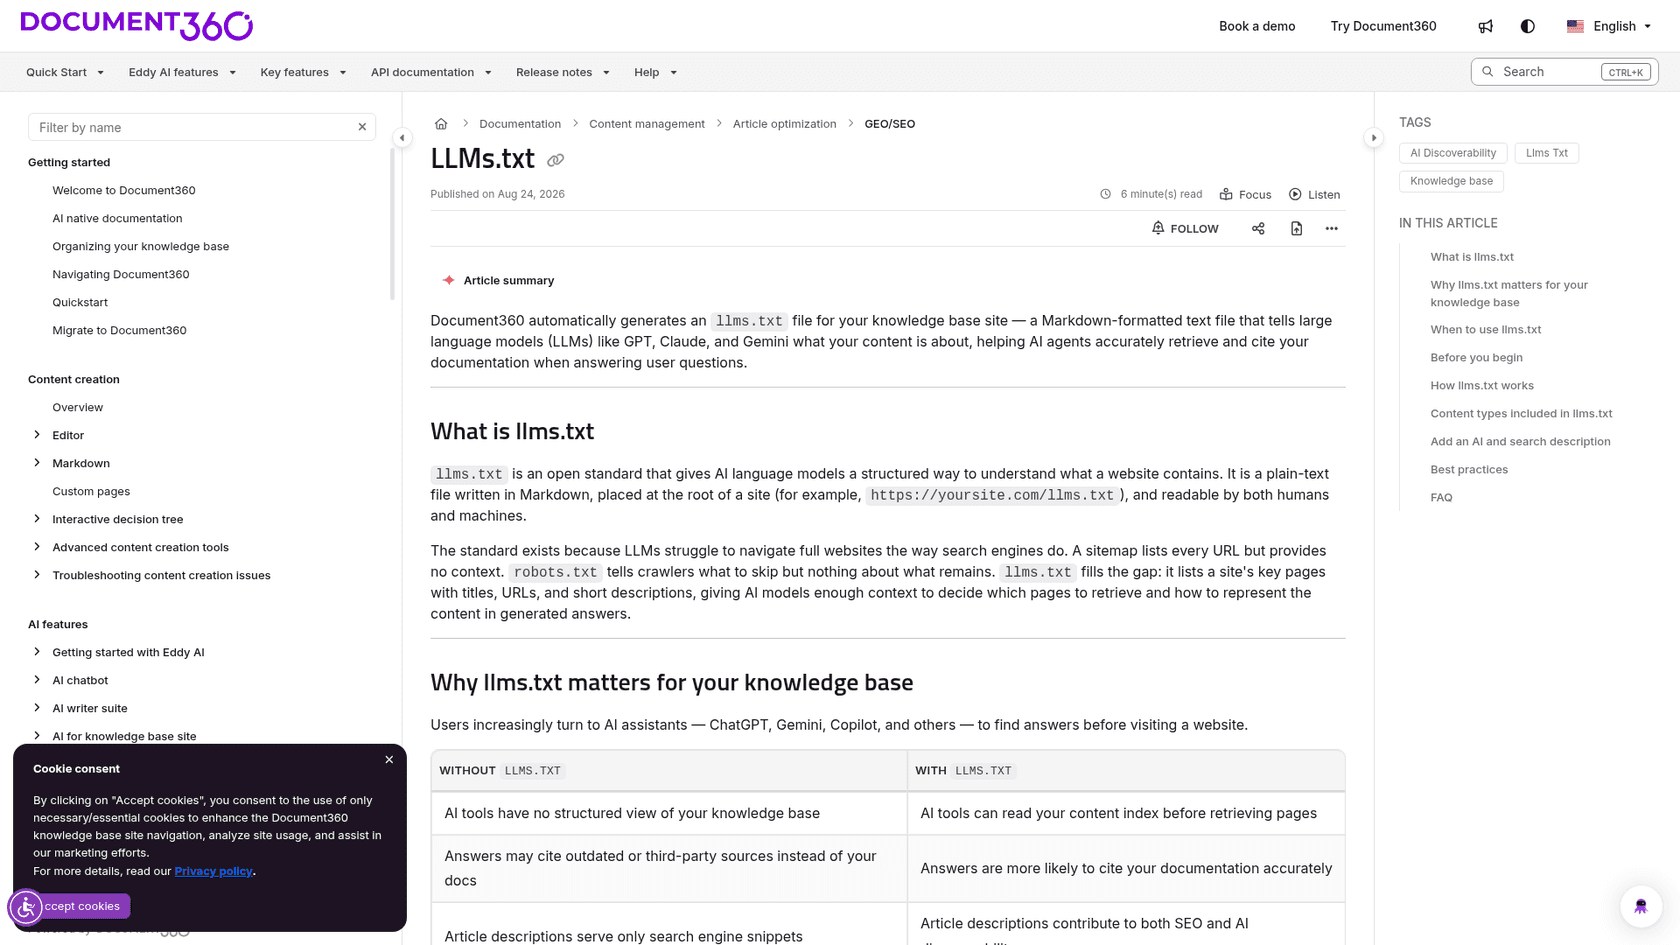
| Document360 | Automatique, mis à jour à chaque publication | Les pages proposent « View as Markdown » | Seul le contenu public est inclus ; les articles sans description apparaissent uniquement par titre |
| Centre d'aide Zendesk | Aucune option intégrée trouvée ; l'app KnowledgeBridge du Marketplace génère les deux fichiers | Via l'app, ou votre propre export de centre d'aide | Vous hébergez et actualisez le résultat vous-même |
La ligne GitBook mérite un second regard. Selon la propre documentation de GitBook, « masquer une page la retire seulement de la table des matières publiée. » Si vous avez masqué une page obsolète ou interne au lieu de la dépublier, les agents peuvent encore la lire.
Étape 7 : proposez un serveur MCP, et sachez quel type vous proposez
MCP (Model Context Protocol) permet à une application IA d'appeler votre centre d'aide comme un outil : le chercher, lire une page, récupérer du markdown, plutôt que de scraper du HTML. Il existe deux types très différents, et les équipes support les confondent.
Les serveurs MCP de documentation publique sont pour l'IA de n'importe qui. GitBook « expose un serveur Model Context Protocol (MCP) pour chaque site de documentation publié » à /~gitbook/mcp. Le serveur MCP de recherche de Mintlify donne aux agents trois outils : la recherche, un système de fichiers de documentation en lecture seule, et un outil de retour qui « signale un problème de documentation à votre équipe quand un agent trouve une page incorrecte, obsolète, confuse ou incomplète. » Ce dernier outil est l'idée que je copierais en premier : l'agent qui lit votre documentation dépose lui-même le signalement du bug.
Les serveurs MCP de compte sont pour les propres outils IA de votre équipe, avec vos permissions :
- Le MCP de Help Scout connecte Claude, ChatGPT ou Cursor aux conversations, aux clients et au contenu Docs. Il nécessite un accès API (forfaits Standard, Plus et Pro) et une clé API Docs pour les outils de base de connaissances, et les agents IA « n'accèdent qu'aux données que votre compte utilisateur spécifique est autorisé à voir. » C'est une tâche différente des outils d'autoservice de Help Scout pour les clients.
- Zendesk Bridge, en accès anticipé, permet à des agents externes comme Claude, ChatGPT, Copilot ou Gemini de chercher dans votre centre d'aide et de traiter des tickets via une connexion MCP gouvernée, selon l'article EAP de Zendesk. C'est distinct du propre client MCP de Zendesk, qui fonctionne dans l'autre sens et permet à Zendesk d'appeler d'autres outils.
- Le MCP de Document360 connecte ChatGPT et Claude à votre base de connaissances pour chercher et gérer des articles.
Aucun des deux types ne remplace les étapes 1 à 3. Un serveur MCP livre votre article plus vite et plus proprement ; il ne peut pas corriger un article obsolète. Pour le contexte sur la façon dont les agents utilisent ces serveurs, mon article sur les serveurs MCP d'agents IA le couvre, et le programme d'accès anticipé du canal ChatGPT de Zendesk montre où cela va : des « réponses génératives » dans ChatGPT « directement depuis le contenu du centre d'aide de votre compte », à côté de son centre d'aide conversationnel.
Comment tester si les agents IA le lisent correctement ?
Demandez-leur. Cela semble évident, et presque personne ne le fait selon un calendrier régulier. Prenez dix vraies questions des tickets du mois dernier, les précises avec un chiffre dans la réponse, et testez-les à trois endroits :
- ChatGPT, Claude et Perplexity avec la recherche activée. Vérifiez s'ils citent votre centre d'aide, et si le chiffre est à jour.
- Une récupération brute.
curl -A "OAI-SearchBot" https://help.yoursite.com/your-articleet cherchez la phrase clé dans la sortie. Si elle manque, un robot qui n'exécute pas JavaScript ne peut pas la voir. - Votre propre IA support, avant que les clients ne la voient. Chez eesel, chaque déploiement est d'abord testé sur des tickets historiques, parce qu'un bot qui paraît confiant et se trompe coûte plus de confiance qu'aucun bot du tout.
Pour la documentation développeur, la catégorie Lighthouse de navigation agentique de Chrome (Chrome 150 ou plus récent, encore expérimental) vérifie llms.txt, la stabilité de la mise en page et la santé de l'arbre d'accessibilité, ce qu'elle appelle la « vue à l'œil de la machine » de votre page.
La meilleure boucle de test que j'ai vue est celle qui tourne sur chaque ticket. Qontro, une entreprise d'ERP, a connecté Freshdesk à eesel et chargé son centre d'aide, ses forums support et environ 9 800 tickets passés. Chaque nouveau ticket reçoit un brouillon de réponse comme note interne avec les articles d'aide liés. L'équipe compare chaque brouillon avec la réponse qu'une personne a réellement envoyée, et là où le brouillon était faux, « cela pointe généralement vers un article d'aide manquant ou incomplet, ou une règle à resserrer. » Son centre d'aide se resynchronise chaque vendredi. Environ un brouillon sur dix part désormais avec peu ou pas de modification, et le plus grand gain jusqu'à présent est ce que les brouillons révèlent sur les manques.
C'est de l'analyse des manques de connaissances sans projet séparé. Innr utilise la même règle d'honnêteté dans l'autre sens : si le centre d'aide ne couvre pas une question, eesel le dit et transfère plutôt que de deviner. Chaque transfert est un article manquant, que vous pouvez aussi trouver en associant les requêtes de recherche aux manques du centre d'aide.
Quelles erreurs rendent un centre d'aide plus difficile à lire pour l'IA ?
Celles que je vois le plus souvent, à peu près dans l'ordre des dégâts :
- Déployer llms.txt avant de réparer les articles. Cela liste vos pages plus vite ; cela ne les rend pas correctes.
- Un robots.txt copié de « bloquer tous les robots IA ». Il bloque généralement OAI-SearchBot et Claude-SearchBot en même temps que les robots d'entraînement, ce qui sort votre centre d'aide des réponses de recherche IA.
- Masquer au lieu de dépublier. Sur GitBook, les pages masquées restent dans
llms-full.txtet le serveur MCP. - Des réponses dans des captures d'écran. La raison la plus courante pour laquelle une IA dit « je n'ai pas trouvé ça » sur quelque chose que vous avez documenté.
- Deux réponses actives à une question. L'IA citera le passage qui semble le plus proche, pas celui qui est le plus récent.
- Une synchronisation mensuelle du robot. La recherche publique rattrape en quelques heures ; une synchronisation lente laisse votre propre robot en retard sur le centre d'aide.
eesel : laissez votre centre d'aide entraîner un coéquipier support
Si l'IA principale qui lit votre centre d'aide est votre propre bot support, le moyen le plus rapide de le rendre lisible est de le regarder lire. Le coéquipier IA pour helpdesk d'eesel rejoint votre helpdesk, apprend de votre centre d'aide, de vos macros et des tickets passés, et rédige ou envoie des réponses avec l'article source lié. Chaque brouillon que votre équipe modifie vous montre un article qui a besoin d'une réponse plus claire, d'une date ou d'une fusion, comme ce fut le cas pour Qontro.
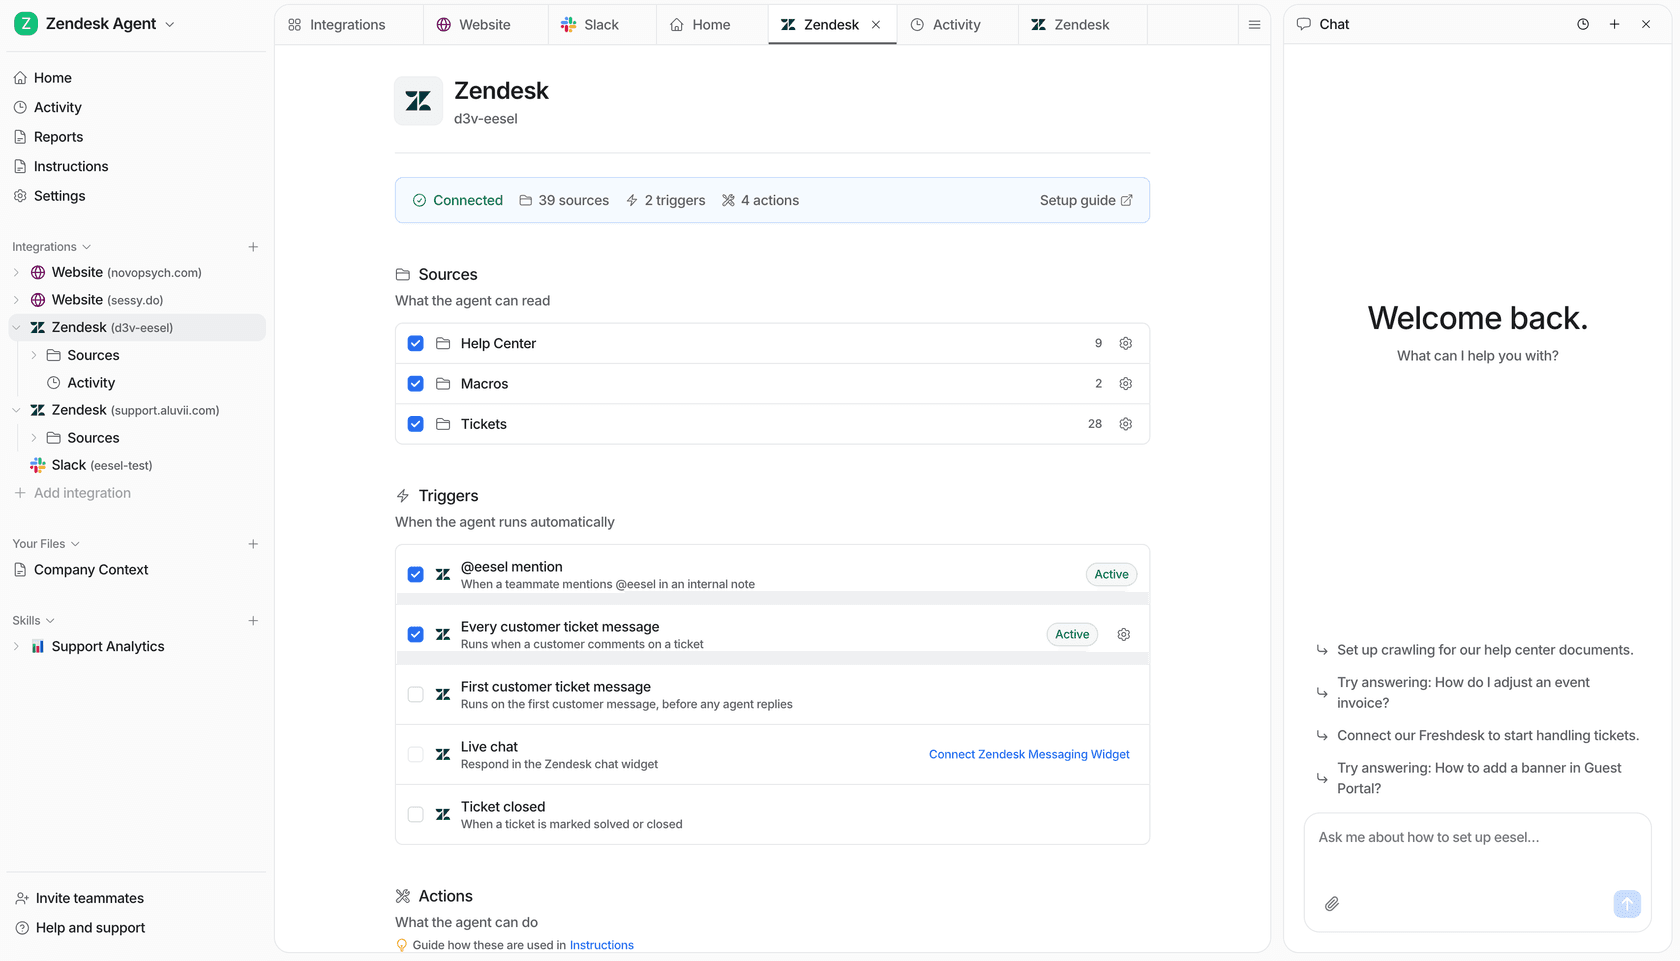
Depuis un terminal, un agent de code peut exécuter eesel integrations sources zendesk pour voir ce que la synchronisation du centre d'aide contient réellement, importer un fichier de politique approuvé, et lancer des questions tests avec eesel chat avant que quoi que ce soit n'atteigne un client. Connecter le helpdesk lui-même nécessite toujours qu'une personne avec un accès admin l'approuve. Essayez eesel gratuitement et faites passer vos dix derniers tickets.
Comment rendre mon centre d'aide lisible par les agents IA ?