

Resumen
La gestión de la cola de soporte compartida es cómo un equipo de soporte reparte un único conjunto de tickets para que cada ticket tenga un responsable, rápido. Lo que rompe las colas compartidas rara vez es el volumen. Es el hueco entre un ticket visto por todos y que no es de nadie. Arregla eso primero: elige un modelo de asignación a propósito (pull, push o híbrido), da a cada ticket nuevo un responsable en un tiempo fijo y vigila la antigüedad del ticket más viejo sin responsable, no solo el tiempo de primera respuesta.
La mayoría de los helpdesks pueden empujar tickets a los agentes por ti, pero el ajuste suele estar tras un límite de plan. El round robin está en Freshdesk Pro ($55 por agente) y Help Scout Plus ($45), el balanceo de carga de Front está en Professional ($65), y el enrutamiento por habilidades está en Zendesk Suite Professional ($115) o Freshdesk Enterprise ($89). Gorgias incluye la asignación automática en todos los planes de helpdesk.
La IA ya resuelve bien el paso de clasificación. En una prueba de eesel con tráfico real de Zendesk, la clasificación alcanzó un 93 % de precisión y detectó el 100 % del spam. El compañero de IA para helpdesk de eesel etiqueta, enruta y responde los tickets fáciles dentro de tu cola actual, para que tu equipo solo atienda lo que necesita a una persona.
¿Qué es la gestión de la cola de soporte compartida?
Una cola de soporte compartida es una sola lista de tickets entrantes de la que trabaja todo un equipo, en lugar de que cada agente tenga su propia bandeja. La gestión de la cola de soporte compartida es el conjunto de reglas que decide quién toma qué ticket, con qué rapidez recibe responsable, qué pasa cuando alguien está ausente y cómo te das cuenta de que algo se escapa.
Trabajo la cola de soporte en eesel todos los días y he aprendido que lo difícil de una cola compartida no son los tickets difíciles. Los difíciles reciben atención porque hacen ruido. Los que se escapan son los tickets corrientes que cuatro personas abrieron, leyeron y volvieron a cerrar, cada una suponiendo que otra se ocuparía.
Cada helpdesk muestra la cola compartida de forma algo distinta:
- Zendesk usa vistas, incluida una vista de sin asignar estándar (documentación de Zendesk).
- Freshdesk usa vistas de lista de tickets, con el enrutamiento definido por grupo (documentación de Freshdesk).
- Help Scout da a cada bandeja carpetas fijas: Unassigned, Mine, Assigned, Closed y Spam (documentación de Help Scout).
- Front funciona con una bandeja compartida con pestañas Unassigned, Assigned y Waiting.
- Gorgias usa vistas, con una vista estándar «Unassigned» de tickets abiertos que nadie tiene asignados (documentación de Gorgias).
Los nombres de las herramientas cambian. Los modos de fallo no.
Por qué se rompen las colas compartidas: el hueco de propiedad
Este es el patrón que más veo. Llega un ticket. Tres agentes lo ven en la cola. Cada uno tiene otra cosa abierta, así que cada uno sigue con lo suyo. Nadie tiene su nombre en él, así que nadie siente que envejece.
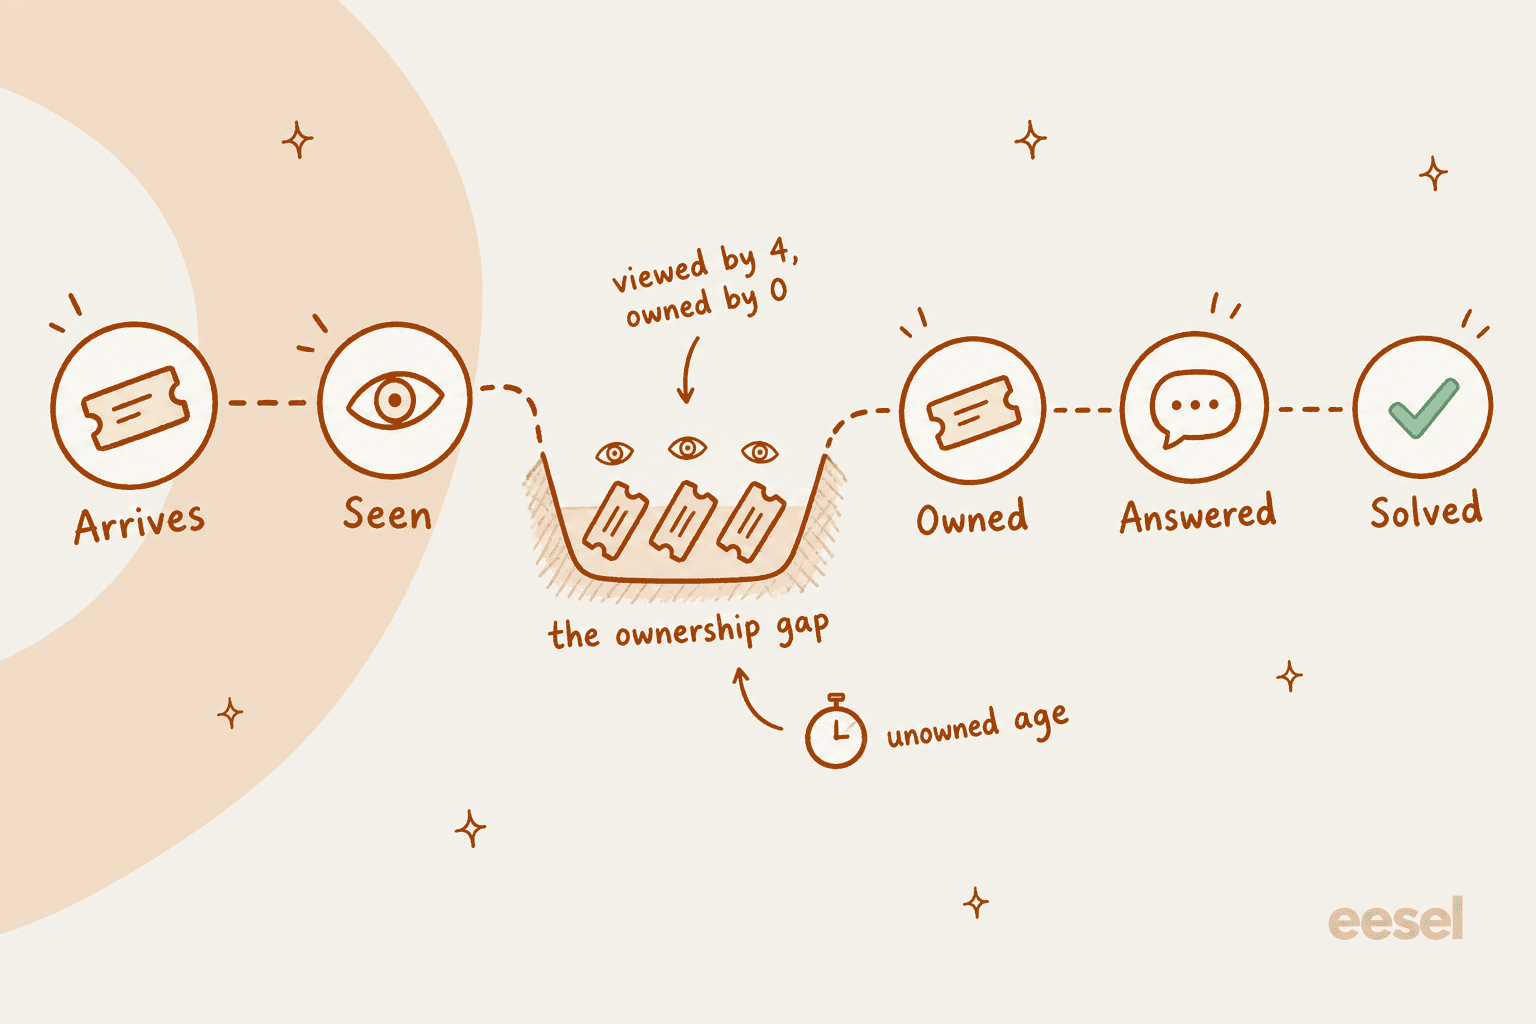
Un responsable de TI de un centro educativo describió hace años la versión de sacar tickets del montón, y sigue sonando como cualquier cola de soporte sobrecargada que he visto:
"We currently have an unending bucket of tickets, the engineers and I pluck out calls with little oversight, however this results in some calls falling to the bottom of the pile and getting ignored. There's no ownership of unassigned calls."

Se vuelve caro cuando el ticket que se escapa es el urgente. Un administrador de Zendesk publicó en febrero de 2026 sobre un cliente enterprise cuyo sistema de producción cayó a las 9 de la mañana. El ticket esperó hasta las 2 de la tarde tras más de 30 tickets de la noche, así que el cliente estuvo caído más de 5 horas antes de que alguien notara que era crítico (r/Zendesk).
Y en un hilo sobre un ticket que estuvo dos días sin asignar y recibió una reseña de 1 estrella, la historia fue la clásica: todos asumieron que otro lo había tomado. Una respuesta señaló la causa sin rodeos:
"That's not a system issue (crappy help desk software, bad ticketing system). It's a bad work ethic ("Meh, Bob can get that. Or Cindy. IDC, I'm busy on Reddit.")
Systems can help with setting SLAs and possibly even forcing ownership, but ultimately it's up to the team to take responsibility and do their jobs."
Estoy medio de acuerdo. La ética de trabajo importa. Pero un diseño de cola que depende de que todos recuerden tomar el siguiente ticket fallará el día más ocupado, cuando todos ya tienen tres. La solución es hacer que la propiedad sea automática o que sea trabajo de alguien, no confiar en la suerte.
Ese es el giro en el que se apoya este artículo: mide el tiempo sin responsable, no solo el tiempo de respuesta. Tu promedio de tiempo de primera respuesta puede verse bien mientras un ticket envejece toda la tarde, porque los promedios esconden la cola de la distribución.
Las tres formas de asignar trabajo en una cola compartida
Toda cola compartida funciona con uno de tres modelos, lo haya elegido el equipo o no.
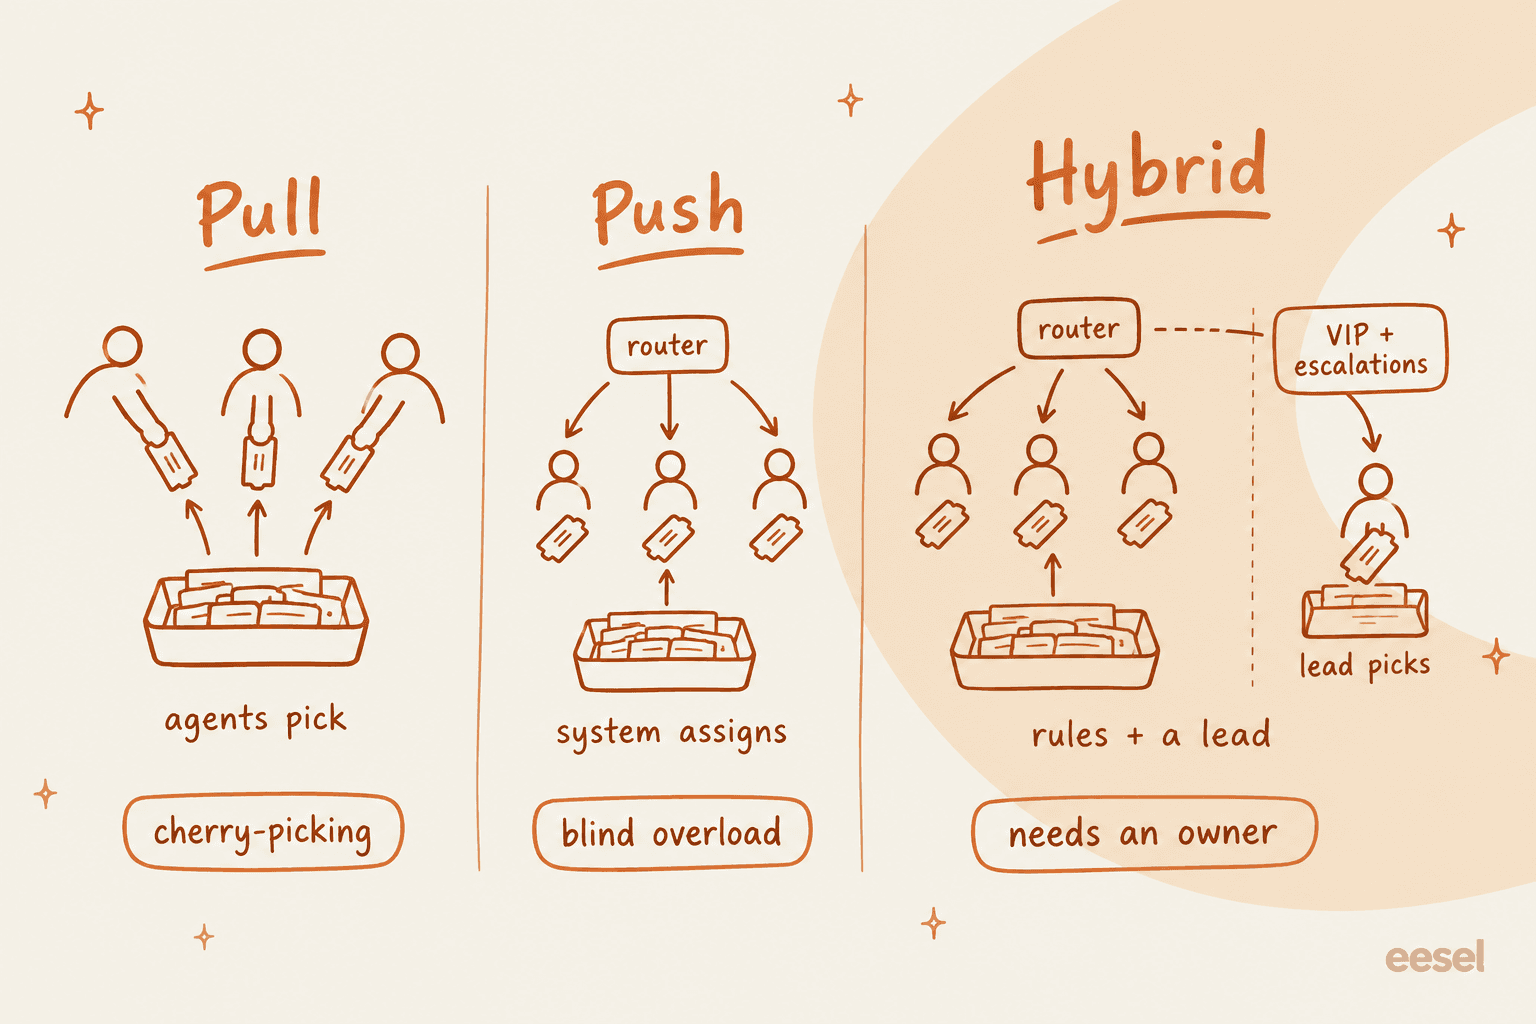
Pull significa que los agentes eligen sus propios tickets de la vista compartida. Es el modelo por defecto en la mayoría de los helpdesks y parece justo, porque los buenos agentes pueden tomar más. Su debilidad es escoger solo lo fácil. Un equipo de Zendesk admitió hacerlo a propósito cuando estaban desbordados:
"If we're underwater we do an easy out method where we cherry-pick the simple tickets (can be handled in less than 5 minutes) and have a portion of the team hit those while the rest does fifo."
Esa es la versión inteligente y deliberada. La versión accidental es que todos esquiven en silencio el mismo ticket incómodo.
Push significa que el helpdesk asigna los tickets por ti, con reglas de enrutamiento de tickets: round robin (el siguiente agente de la fila), por carga (menos tickets abiertos) o por habilidades (idioma, producto o nivel que coincidan). Resuelve la propiedad, pero puede sobrecargar a quien casualmente está conectado, y no sabe qué tickets son difíciles. Un equipo de Zendesk lo descubrió después de cambiar:
"We recently moved from Round Robin to OCR and it's been a bit of a nightmare."
En la misma publicación describieron que 2-3 agentes recibían 15 tickets de correo mientras el resto recibía un par o ninguno, y que algunos tickets nunca salían de la vista de sin resolver. Eso suele ser un problema de configuración de capacidad y estado, no un motivo para volver a pull, pero muestra que push necesita ajuste.
Híbrido significa asignación automática para el flujo normal, más un carril pequeño que un líder trabaja a mano: cuentas VIP, escalaciones, cualquier cosa que las reglas no puedan ubicar. La mayoría de los equipos a los que aconsejaría terminan aquí.
| Modelo | Quién decide | Mejor para | Riesgo principal | Qué añadir |
|---|---|---|---|---|
| Pull | Los agentes eligen | Equipos pequeños, tickets parecidos | Escoger lo fácil, tickets que envejecen | Vista con lo más antiguo primero, un responsable diario de clasificación |
| Push | Reglas del helpdesk | Colas ocupadas, chat y mensajería | Sobrecargar a quien esté conectado | Límites de capacidad, estado de ausencia, reasignación |
| Híbrido | Reglas más un líder | Niveles mixtos, VIP, varios idiomas | El carril manual no tiene responsable | Un responsable del carril con nombre por turno |
Si te quedas en pull, añade una regla a la que llega de algún modo cada hilo de Reddit sobre este tema: una persona que se encarga de lo que sobra. El líder de un MSP describió la suya:
"our helpdesk team functions as one big resource pool. Inbound phone calls and tickets are automatically queued, and the techs check it every so often to take tickets. Helpdesk manager gets an alert if a ticket's been sitting in the intake queue for 30 minutes, at which point he'll assign to a resource."
Esa alerta de 30 minutos es todo el truco. Pull para la velocidad, un respaldo para la propiedad.
¿Qué modelo de asignación encaja con tu cola?
Elige la línea que más se parezca a tu equipo. Cada una da el modelo con el que empezaría y el ajuste que lo hace funcionar.
¿Qué modelo de asignación encaja con tu cola?
Toca la descripción más parecida a tu equipo.
Empieza con: pull, más un responsable de clasificación
Deja que los agentes sigan eligiendo de una vista compartida ordenada con lo más antiguo primero. Rota un responsable diario de clasificación que asigne todo lo que siga sin dueño pasado tu límite (de 30 a 60 minutos para correo es un buen punto de partida).
Funciona en cualquier plan. Activa la detección de colisiones si tu helpdesk la tiene.
Empieza con: push, por carga
Asigna los tickets nuevos automáticamente a quien tenga menos tickets abiertos, con un límite de capacidad por agente para que nadie quede enterrado. Mantén un carril manual para escalaciones.
Freshdesk Pro ($55), Help Scout Pro ($75) para Balanced, Front Professional ($65), enrutamiento por capacidad de Zendesk en planes Team y superiores, Gorgias en todos los planes.
Empieza con: híbrido, enrutamiento por habilidades o por grupo
Enruta primero por idioma, producto o nivel y luego equilibra la carga dentro de cada grupo. Un líder se encarga cada turno del carril de VIP y casos límite.
El enrutamiento por habilidades está en Zendesk Suite Professional ($115) y Freshdesk Enterprise ($89). En Help Scout, Front y Gorgias, usa equipos o bandejas separados y enruta hacia ellos con reglas.
Empieza con: solo push
Los clientes en un chat en vivo no esperarán mientras los agentes buscan. Empuja las conversaciones a los agentes disponibles, define un temporizador corto para aceptar o reasignar y limita los chats simultáneos por agente.
Zendesk puede reasignar un ticket que un agente no acepta a tiempo en planes Professional y superiores. Gorgias puede quitar la asignación de chats cuando el agente deja de estar disponible.
Cómo maneja cada helpdesk una cola compartida
Aquí es donde pesan los límites de plan. Esto es lo que puede hacer cada herramienta por sí sola, según la documentación y la página de precios de cada proveedor a octubre de 2026. Los precios son por agente al mes según cada página de precios, con facturación anual donde la página la ofrece.
| Helpdesk | Round robin | Por carga o capacidad | Por habilidades | Detección de colisiones | Políticas de SLA |
|---|---|---|---|---|---|
| Zendesk | Enrutamiento omnicanal, planes Team y superiores (Suite Team $55) | La capacidad es el valor por defecto, planes Team y superiores | Suite Professional $115, Support Enterprise | Todos los planes excepto Team | Suite Growth y superiores |
| Freshdesk | Pro $55 | Pro $55 | Enterprise $89 | Growth $19 y superiores | Una política desde Growth; varias y escalaciones en Pro |
| Help Scout | Plus $45 | «Balanced», Pro $75 | No figura en la documentación | Todos los planes | Standard 1, Plus 2, Pro ilimitadas |
| Front | Acción de regla, todos los planes | Balanceo de carga, Professional $65 | No figura en la documentación | Sí, sin límite de plan indicado | Objetivos de tiempo, Professional $65 |
| Gorgias | Asignación automática por menos tickets, todos los planes de helpdesk | Un límite de capacidad, todos los planes | No figura en la documentación | Banner «Also viewing» | Todos los planes de helpdesk |
Zendesk
El enrutamiento omnicanal de Zendesk empuja correo, llamadas y mensajería a los agentes según su estado y su capacidad libre. La asignación por capacidad es la predeterminada: el trabajo va al agente elegible con más margen para ese canal (reglas de capacidad de Zendesk). Puedes cambiar el método de asignación a round robin, que elige al agente que lleva más tiempo sin un ticket nuevo, siempre que aún tenga capacidad.
Mi guía de round robin en Zendesk recorre la configuración.
Tres ajustes importan más para una cola compartida:
- Habilidades. El enrutamiento por habilidades está en Suite Professional y superiores. Las habilidades obligatorias nunca caducan; las opcionales caen tras un tiempo de espera que defines (documentación de habilidades de Zendesk).
- Reasignación. Zendesk puede reasignar hasta los 50 tickets abiertos de correo y mensajería actualizados más recientemente cuando el estado de un agente cambia a uno que elijas. Reasignar tickets reabiertos, y reasignar cuando un agente no acepta a tiempo, están en Professional y superiores (configuración de enrutamiento de Zendesk).
- Colisión. Un icono de ojo en las vistas marca los tickets que otra persona está viendo, pero la colisión de agentes no está disponible en los planes Team (documentación de colisión de Zendesk).
La clasificación inteligente de Zendesk ahora clasifica intención, sentimiento e idioma en planes Professional y superiores sin coste adicional, según el anuncio de Zendesk. Usar esas clasificaciones en el enrutamiento sigue requiriendo el complemento Copilot, listado a $50 por agente al mes en la página de precios de Zendesk.
Freshdesk
Freshdesk define el enrutamiento por grupo. En Admin, Groups, Group Properties, eliges manual o Advanced Automatic Routing (con tecnología de Omniroute) con asignación round-robin, por carga o por habilidades.
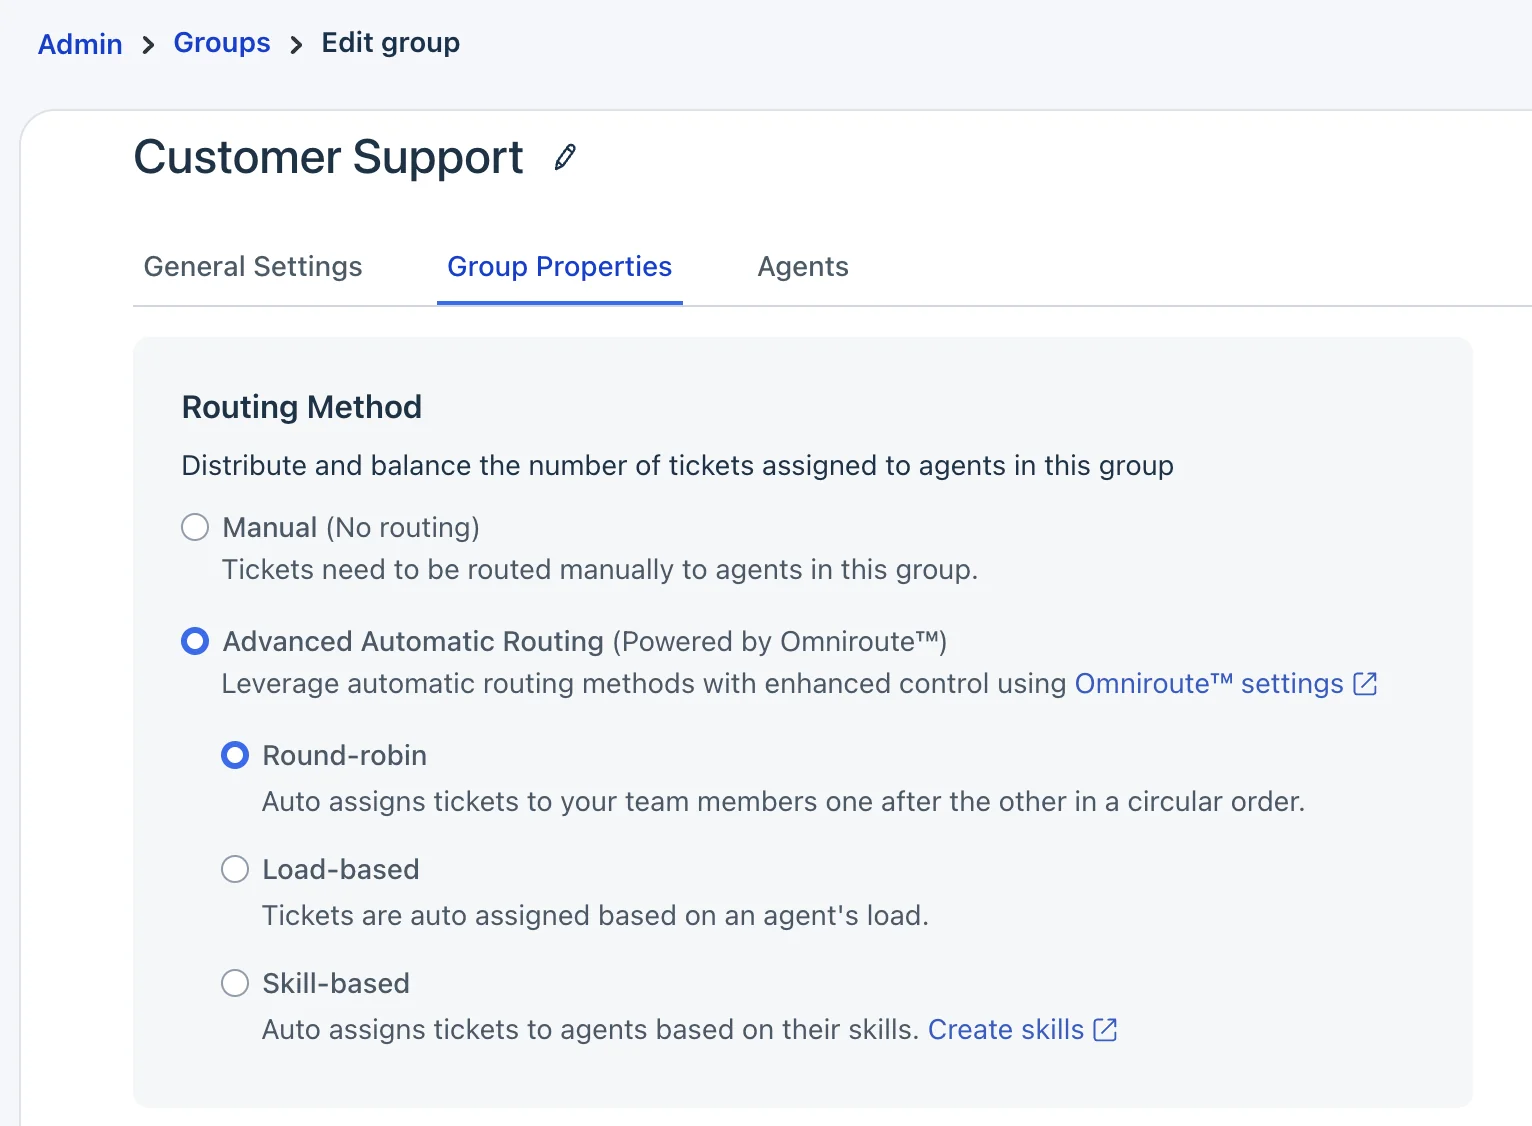
El round robin y la asignación por carga están en Pro y Enterprise, y el round robin salta a los agentes que ya están al límite (documentación de round robin de Freshdesk). La asignación por carga da cada ticket al agente disponible con menos carga hasta que cada uno alcanza su límite. El enrutamiento por habilidades es solo Enterprise.
En la página de precios de Freshdesk, eso es Growth $19, Pro $55 y Enterprise $89 por agente.
Dos detalles sorprenden a los equipos. Primero, un agente desconectado no puede recibir tickets nuevos, y si nadie está disponible el ticket queda sin asignar. Segundo, una asignación manual puede pasar a un agente de su límite, y ese exceso bloquea su asignación automática (documentación de Freshdesk Omniroute). No encontré un ajuste que devuelva al grupo los tickets de correo abiertos de un agente desconectado, así que planifica un barrido manual en el cambio de turno. La detección de colisiones está en Growth y superiores.
Help Scout
Help Scout lo mantiene simple. El enrutamiento ofrece dos métodos: Round Robin, que asigna «one by one in alphabetical order», en Plus, y Balanced, que asigna al compañero con menos conversaciones activas, en Pro (documentación de enrutamiento de Help Scout).
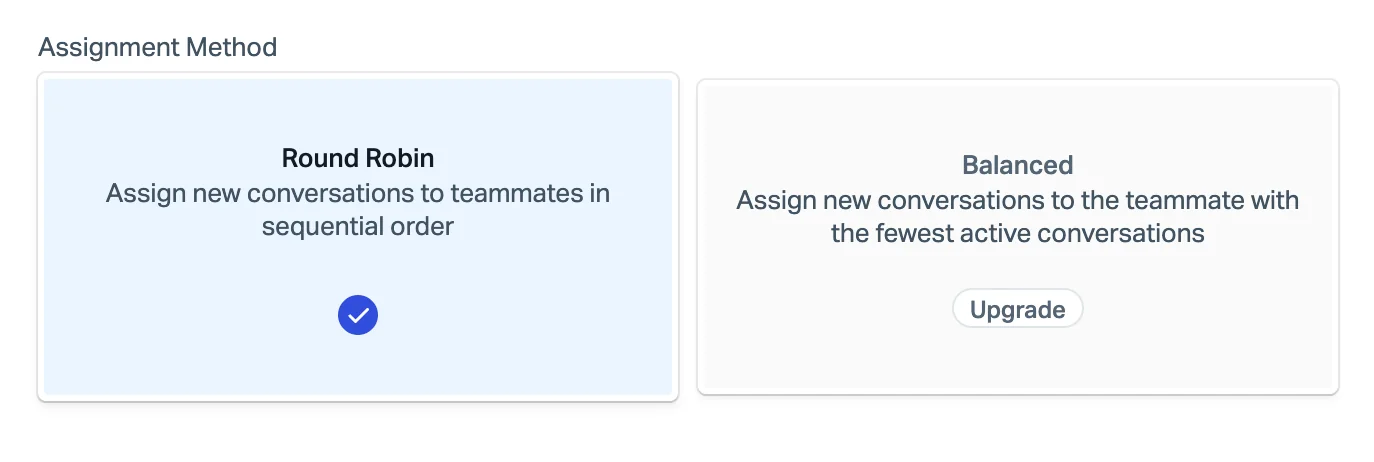
El enrutamiento salta a los compañeros que están Away o en su límite (hasta 100), trabaja primero lo que lleva más tiempo esperando y recoge lo que ya está en Unassigned. Las asignaciones manuales y de workflows ignoran esas reglas. La detección de colisiones está en todos los planes, y Help Scout pausa tu respuesta si un compañero respondió o el cliente escribió desde que abriste la conversación (documentación de colisiones de Help Scout). Los precios de Help Scout listan Standard a $25, Plus a $45 y Pro a $75 por usuario al mes. Si lo combinas con IA, mi guía de clasificación en Help Scout cubre qué se puede automatizar.
Front
Front enruta con reglas. Una regla de round robin asigna por turnos a los compañeros conectados, pero si todos están desconectados no se asigna nada y no hay cola, así que un compañero que vuelve más tarde no recibe las conversaciones que se perdió (documentación de enrutamiento de Front). Una regla de balanceo de carga es más inteligente para una cola compartida: asigna a quien tenga menos conversaciones abiertas hasta su límite (máx. 100), pone en cola cuando todos están llenos y se reanuda desde la conversación sin responder más antigua. Está en Professional y superiores (documentación de balanceo de carga de Front).
El manejo de ausencias de Front es de los mejores para una cola compartida: las respuestas a conversaciones asignadas a un compañero fuera de la oficina quitan la asignación y vuelven a Unassigned automáticamente, en todos los planes (documentación de fuera de la oficina de Front). Los precios de Front listan Starter $25, Professional $65 y Enterprise $105 por puesto. Para la parte de IA, mira mi artículo sobre la clasificación en Front.
Gorgias
Gorgias no cobra por agente. Cobra por volumen de tickets, con planes de helpdesk desde Starter a $10 al mes por 50 tickets hasta Advanced a $750 por 5.000 con facturación anual (precios de Gorgias). La asignación automática está en todos los planes de helpdesk: las reglas envían un ticket a un equipo, luego Gorgias ordena los tickets por prioridad y fecha de creación y los da a los agentes disponibles con menos tickets (documentación de auto-asignación de Gorgias).
El límite de capacidad es un único número para todos los agentes, así que no puedes dar a una persona recién llegada una carga más ligera que a un agente senior. Gorgias puede quitar la asignación de un ticket reabierto cuando su agente está desconectado, y quitarla de los chats cuando el agente deja de estar disponible. Mi guía de reglas de asignación de Gorgias profundiza más, y el artículo de vistas de Gorgias cubre el lado de la cola.
Evita que dos personas respondan al mismo ticket
El fallo opuesto al ticket perdido es el duplicado: dos agentes responden al mismo cliente con respuestas ligeramente distintas. Es más raro que los tickets perdidos, pero los clientes lo notan más. Un líder de CS en un hilo sobre bandejas compartidas apuntó a la solución:
"Zendesk or hubspot would be good for tracking, and assigned ownership so multiple people don't try to take ownership and end up causing issues."
Hay dos capas de protección. La primera es la asignación: un ticket con un solo responsable desde el momento en que llega no puede tomarse dos veces. La segunda es la detección de colisiones, que muestra quién más está viendo o escribiendo. La versión de Front es un buen ejemplo de qué buscar:
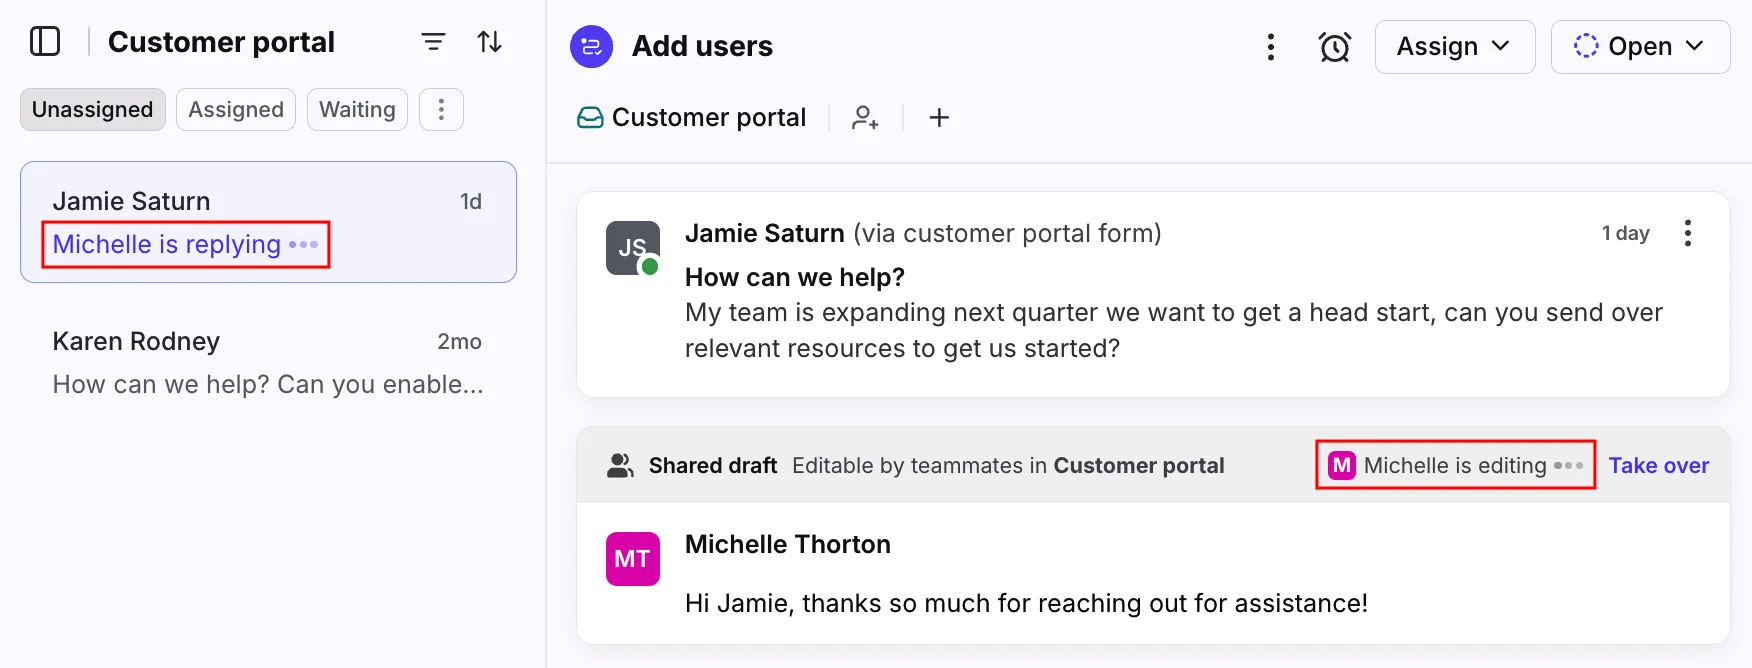
La marca de «replying» aparece en la propia lista, antes incluso de abrir la conversación, y el borrador compartido tiene un botón Take over para los traspasos (documentación de colisiones de Front). Si tu plan actual no tiene detección de colisiones (Zendesk Team, Freshdesk Free), la asignación push importa aún más, porque es tu única protección.
Las reglas que mantienen honesta una cola compartida
Las herramientas te dan los ajustes. Estas seis reglas deciden si los ajustes funcionan.
- Cada ticket nuevo recibe un responsable en un tiempo fijo. Elige un número por canal, por ejemplo 30 minutos para correo y unos segundos para chat. Síguelo como objetivo propio, separado de tu SLA de primera respuesta.
- Una persona se encarga de lo que sobra en cada turno. Un comentarista del hilo del ticket sin asignar dos días sugirió la versión más simple: "Make one person responsible each day/week for triage; reading all calls as they come in, fixing the 5 minute ones and assigning out the remainder" (r/CustomerService).
- Ordena las vistas compartidas con lo más antiguo primero. Las vistas con lo más nuevo primero premian tomar tickets frescos y fáciles. Con lo más antiguo primero, el ticket que envejece es lo primero que todos ven.
- Define límites de capacidad y respétalos. Todos los helpdesks de arriba dejan que los agentes se asignen por encima de su límite. Si los líderes siguen volcando tickets sobre el agente más rápido, el enrutamiento push deja de equilibrar nada.
- Haz que el estado de ausencia signifique algo. El enrutamiento solo salta a los agentes marcados como ausentes o desconectados. Si los agentes olvidan poner su estado a la hora de comer, los tickets se acumulan a su nombre. Combínalo con un barrido de traspaso de turno de todo lo que siga asignado a alguien que ya se fue.
- Escala automáticamente los tickets sin responsable. Un disparador o automatización que avise a un líder cuando un ticket lleva sin asignar más de tu límite es un seguro barato. Mi guía para escalar tickets sin asignar tiene una receta para Zendesk, y las escalaciones por SLA cubren el lado de la respuesta.
También hay un punto de equidad que los líderes pasan por alto. Un sysadmin en Reddit describió que gestionaba 3 veces más llamadas que el resto del equipo y lo reprendieron por tener demasiados tickets abiertos, mientras que compañeros que nunca tocaban la cola eran elogiados por un número «saludable» (r/sysadmin). Si mides tickets abiertos por agente en un modelo pull, castigas a quienes tiran de la cola. Mide en su lugar los tickets gestionados y la antigüedad sin responsable.
Qué vigilar en una cola compartida
No necesitas un panel con 20 widgets. Necesitas cuatro números, revisados varias veces al día.
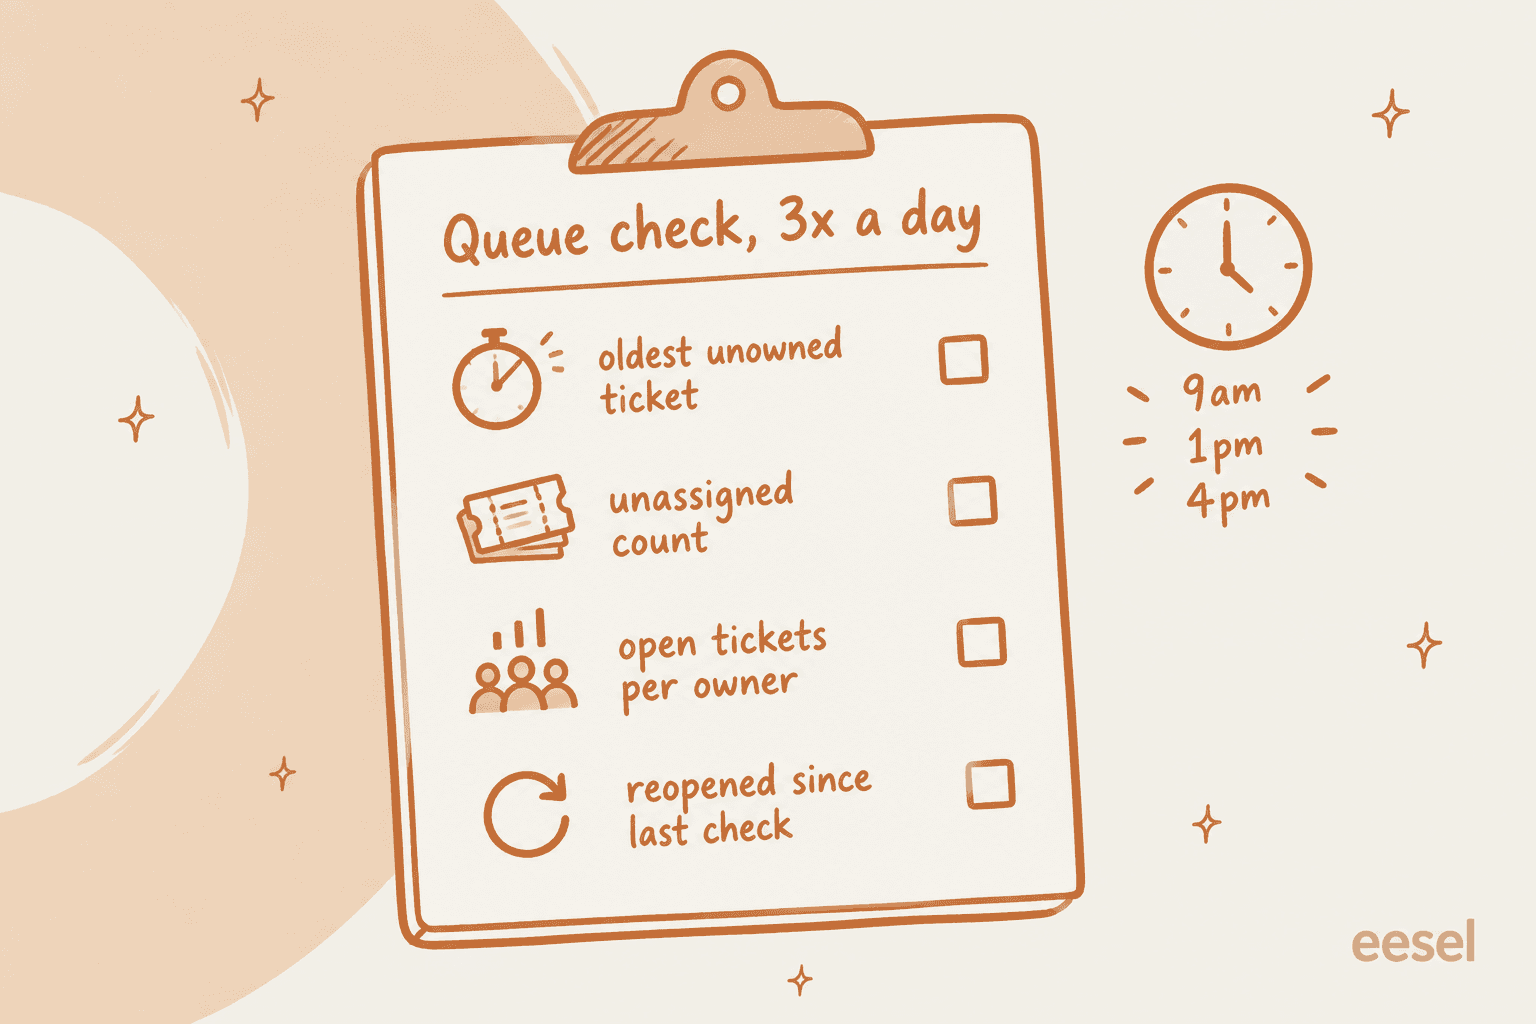
| Número | Qué te dice | Dónde falla |
|---|---|---|
| Ticket más antiguo sin responsable | La espera real en el peor caso | Los promedios lo esconden por completo |
| Número de tickets sin asignar | Si el enrutamiento o las personas van al día | Un pico significa que el estado o la capacidad están mal configurados |
| Tickets abiertos por responsable | Si la carga está equilibrada | Un agente con 3 veces los demás significa que push no equilibra o que un líder lo anula |
| Reabiertos desde la última revisión | Si las respuestas rápidas realmente resuelven | Muchas reaperturas significan que se compra velocidad a costa de calidad |
Estos números van junto a tus KPI de atención al cliente habituales, no en su lugar. Si tu atraso de tickets ya es grande, empieza con mi guía para eliminar un atraso de soporte antes de ajustar el enrutamiento.
El enrutamiento no puede arreglar una cola que simplemente tiene poco personal. Mi artículo de planificación de cobertura de soporte tiene las cuentas de dotación.
Dónde encaja la IA en una cola compartida
La mayor parte del trabajo en una cola compartida no es responder. Es leer un ticket, decidir qué es, etiquetarlo y decidir quién debería tenerlo. Ese paso de clasificación es donde la IA se ha vuelto buena, y es donde yo empezaría.
eesel lleva años poniendo IA en colas de soporte en vivo, y los números de despliegues reales son más útiles que cualquier afirmación. En una prueba con tráfico real de Zendesk en una joyería online alemana que gestiona unos 1.000 tickets al mes, la IA de eesel alcanzó un 93 % de precisión en la clasificación y un 100 % de detección de spam, sin falsos positivos en el 22 % de la bandeja que resultó ser spam. Sus borradores de respuesta acertaron en la dirección en un 88 %, y un 12 % salió tal cual estaba escrito. Los agentes la usaron sobre todo como asistente de investigación y de clasificación automática, exactamente el trabajo que necesita una cola compartida.
El requisito de compra más común que oigo trata de control, no de velocidad. Un responsable de CX de una marca de suplementos en Gorgias, con unos 7.000 tickets al mes, lo expresó así en una llamada:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Ese es el instinto correcto para una cola compartida. La IA debe tomar los tickets que puede resolver por completo, clasificar y enrutar el resto, y dejar para una persona todo lo incierto. Con el compañero para helpdesk de eesel, el enrutamiento sigue tus propias instrucciones (por ejemplo, «asigna todo lo que venga de un cliente enfadado al equipo senior») usando las acciones de asignación del helpdesk. Puedes desplegarlo por etapas: primero borradores como notas internas, y luego dejar que responda los tickets fáciles de principio a fin. Antes de que nada salga en vivo, Simulation reproduce tus tickets pasados y puntúa las respuestas de la IA frente a lo que tu equipo envió de verdad, para que veas los fallos antes que los clientes.
Gridwise, una app de analítica para conductores en Zendesk, escribió en una reseña de G2:
"In the first month, eesel is resolving 73% of our tier 1 requests... The platform even includes automations for ticket tagging, assignment, and status updates!"
Kim Simpson, Gridwise
Para una cola compartida, el efecto es que los tickets fáciles nunca llegan al montón, y los que llegan ya vienen etiquetados y enrutados. Si estás comparando opciones, mi resumen de las mejores IA para clasificación de tickets cubre el panorama, y la guía del copiloto de IA cubre el lado de los borradores.
Errores comunes en colas compartidas
- Usar una bandeja compartida sin ninguna asignación. Bien con 10 tickets al día, caótico con 40. Un responsable de CS describió el paso a una plataforma dedicada "once it became unwieldy to manage the responses and mistakes were being made" (r/CustomerSuccess). Mi artículo de bandeja compartida vs sistema de tickets cubre cuándo cambiar.
- Dividir la cola en bandejas personales. Parece ordenado, pero nadie ve el atraso de un compañero y los tickets mueren cuando alguien está enfermo. Mantén una sola cola y enruta dentro de ella. Mi guía de operaciones de soporte distribuidas defiende lo mismo para equipos en varias sedes.
- Activar el enrutamiento push sin límites de capacidad. Obtendrás el patrón de «15 tickets para tres personas, ninguno para el resto» del hilo de Zendesk de arriba.
- Tratar las escalaciones como parte del grupo general. Los tickets escalados necesitan un responsable con nombre, no un hueco en el round robin. Mira mi guía del proceso de escalación de tickets y, para traspasos a ingeniería, la escalación entre equipos.
- Ignorar las zonas horarias. Una cola cubierta por personas de distintas regiones necesita enrutamiento por horario, o el montón de la noche cae sobre quien se conecte primero. El soporte follow-the-sun cubre esa configuración.
eesel para colas de soporte compartidas
Si tu cola compartida se ahoga en tickets repetitivos, la solución más barata es un compañero que los saque del montón. El compañero de IA para helpdesk de eesel se conecta a Zendesk, Freshdesk, Gorgias, Front, Help Scout y otros helpdesks en minutos, aprende de tus tickets pasados, macros y centro de ayuda, y luego etiqueta, enruta y responde los tickets fáciles dentro de la cola que ya usas. Tus agentes conservan sus vistas, su enrutamiento y su flujo de trabajo. Solo ven menos tickets, y los que ven ya vienen ordenados.

Puedes probarlo con tus propios tickets pasados usando Simulation antes de que toque a un cliente real, y hay un plan gratuito para empezar. Prueba eesel en tu cola compartida y mira qué tickets habría despejado la semana pasada.