

Resumen
La gestión del desbordamiento en soporte es sobre todo una decisión de enrutamiento, no de contratación. En Zendesk, Freshdesk, Help Scout, Front, Gorgias y HubSpot, lo que ocurre por defecto cuando todos los agentes están al límite es lo mismo: el trabajo nuevo se queda en la cola sin asignar hasta que alguien se libera. El desbordamiento solo se gestiona cuando decides de antemano adónde va el siguiente ticket.
La configuración que funciona para la mayoría de los equipos es una cascada: equipo principal, luego un grupo de respaldo, luego una capa de IA que responde las preguntas repetidas, luego respuestas asíncronas con un tiempo de espera honesto y, por último, devolución de llamada para el teléfono. Las funciones de grupo de respaldo dependen del plan (las colas personalizadas de Zendesk requieren Suite Professional, y la redirección a un grupo de respaldo de Freshdesk es solo Enterprise), así que revisa tu plan antes del pico, no durante.
Trabajo en la cola de soporte de eesel todos los días, y la mayor parte del volumen de los picos son las mismas pocas preguntas: estado del pedido, cambios de suscripción, «¿está caído?». Un responsable de operaciones de una marca DTC con unos 7.000 tickets de Gorgias al mes le dijo a eesel que su equipo simplemente no podía con todo y necesitaba IA que resolviera al menos la mitad del volumen de correo. Esa porción repetida es la que el compañero de IA de eesel saca de la cola dentro de tu helpdesk actual, para que tu gente dedique el pico a los tickets que necesitan a una persona.
Qué abarca realmente la gestión del desbordamiento en soporte
El desbordamiento es todo trabajo que llega cuando cada agente que podría atenderlo está al límite o desconectado. Esto último importa: no se trata solo de «demasiados tickets». Un martes por la tarde con dos personas de baja es un evento de desbordamiento. También lo es un chat a las 2 de la madrugada cuando tu cobertura fuera de horario es un saludo de buzón de voz.
Suele presentarse de tres formas:
| Forma | Qué lo desencadena | Cuánto dura | Qué necesita |
|---|---|---|---|
| Pico | Caída, lanzamiento, publicación viral, retraso de envíos | De horas a 2 días | Respuestas rápidas de uno a muchos, un carril de respaldo que se abra en minutos |
| Pico estacional | Black Friday, vacaciones, temporada de renovaciones, plazos fiscales | De 2 a 12 semanas | Capacidad extra planificada, temporales formados o un socio, respuestas escritas de antemano |
| Hueco de cobertura | Bajas por enfermedad, husos horarios, almuerzo, reunión de equipo | De minutos a horas | Enrutamiento que no dependa de que una sola persona esté conectada |
La mayoría de las guías tratan esto como un único problema y saltan directamente a «contrata más» o «externaliza». Yo empezaría por algo más barato: mira qué hace hoy tu helpdesk con el siguiente ticket cuando todos están llenos, porque ese comportamiento por defecto probablemente te cuesta más que la plantilla.
Adónde va el desbordamiento por defecto en cada helpdesk
Repasé la documentación de enrutamiento de las siete herramientas que más veo en la cola de soporte de eesel. El patrón es llamativo. Cuando todos los agentes elegibles están en su límite, casi todas dejan el trabajo nuevo en la cola de soporte sin nombre de nadie:
| Helpdesk | Límite por agente | Todos los agentes llenos o desconectados | Carril de desbordamiento integrado | Plan necesario |
|---|---|---|---|---|
| Zendesk | Correo hasta 500 abiertos, mensajería hasta 20 | El ticket se queda en la cola | Grupos secundarios en una cola personalizada | Suite Professional (115 $/agente/mes) |
| Freshdesk | Carga por cola (p. ej., correo 5, mensajería 10) | El ticket queda sin asignar | «Reroute to a Fallback Group» tras N segundos | Enterprise (89 $/agente/mes) |
| Help Scout | Límite de asignación hasta 100, chats por defecto 3 | La conversación queda en Unassigned | Ninguno documentado | Round Robin en Plus (45 $), Balanced en Pro (75 $) |
| Front | Límite de balanceo de carga, por defecto y máximo 100 | El balanceo de carga pone el trabajo en cola; el round robin no | Ninguno documentado | Plan no indicado en la página de precios |
| Gorgias | Dos límites: chat y mensajería, otro texto | El ticket queda sin asignar | «Skip queue when it's too busy» en voz | Todos los planes Helpdesk (complemento Voice desde 25 $/mes) |
| HubSpot Service Hub | Capacidad de tickets (Pro+), capacidad de chat por defecto 3, máximo 99 (Enterprise) | El ticket queda sin asignar hasta que se asigna manualmente | Alternativa opcional de pasar los chats al agente de cliente | Professional (90 $/puesto) o Enterprise (150 $/puesto) |
| Aircall (voz) | Basado en timbres | La llamada espera el tiempo de cola, luego buzón de voz o perdida | Encadenar otro paso Ring to después del primero | Devolución de llamada en Professional (50 $/licencia) |
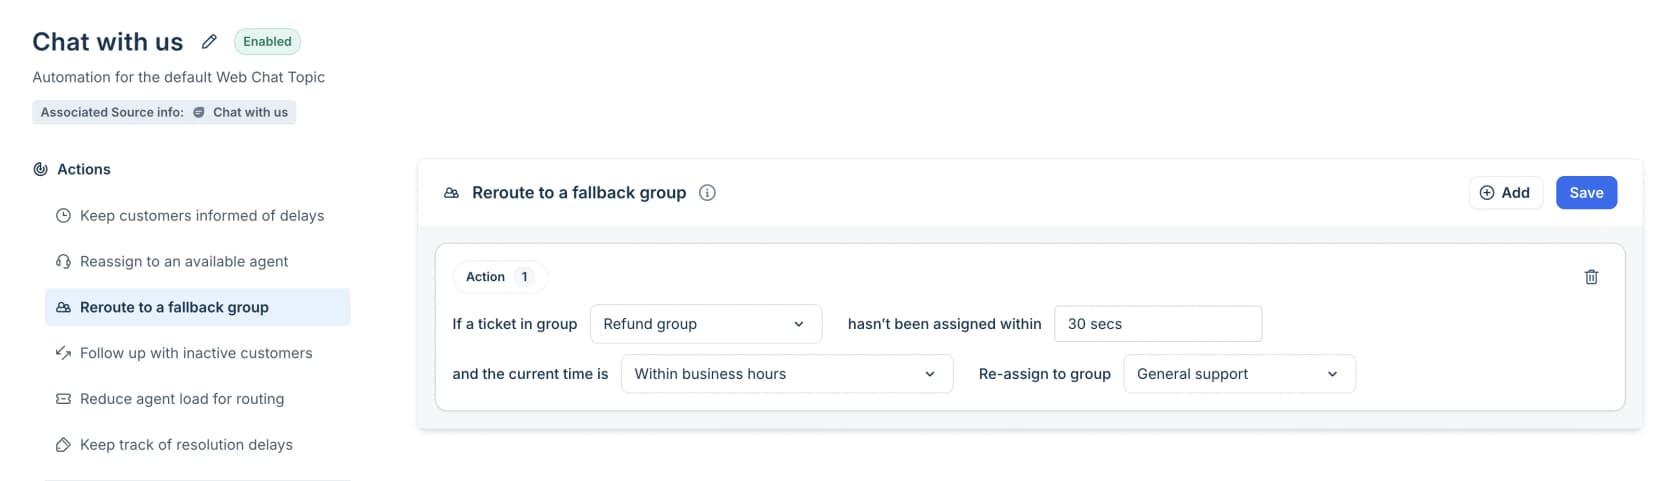
Dos cosas saltan a la vista. Primero, solo Zendesk y Freshdesk incluyen una verdadera regla de desbordamiento «envíalo a otro grupo», y ambos la ponen detrás de un plan superior. Segundo, las dos herramientas funcionan de forma distinta. Zendesk desborda por disponibilidad: el trabajo va primero a los grupos primarios y pasa a los grupos secundarios solo si no hay ningún agente primario disponible. Freshdesk desborda por tiempo: la regla de Quick Automations se activa cuando un ticket de un grupo no se ha asignado en un número de segundos determinado, por ejemplo cinco minutos para un ticket de Refunds antes de pasar a General Support.
Front es la que hay que vigilar. Si usas round robin, no hay cola alguna cuando todos están desconectados, y una asignación fallida no se reintenta cuando alguien vuelve. El balanceo de carga sí hace cola y entrega primero la conversación sin responder más antigua. Si tu equipo de Front es pequeño y con picos, ese único ajuste decide si el desbordamiento espera en fila o se pierde.
Así es como se entierra un ticket crítico. Un administrador de Zendesk lo describió exactamente así en Reddit:
«Un cliente Enterprise informó a las 9 a. m. de que su sistema de producción estaba caído. El ticket estuvo en nuestra cola hasta las 2 p. m. porque teníamos más de 30 tickets que llegaron durante la noche.»

Construye una cascada de desbordamiento, no un equipo más grande
Un sysadmin, en un hilo sobre picos inesperados de llamadas, resumió por qué contratar para el pico rara vez funciona:
«no puedes dimensionar la plantilla para el 1 % de los eventos raros, la dimensionas para el 90 % de los días normales.»
Así que la solución a «el trabajo queda sin asignar» es darle a cada ticket una siguiente parada. Lo pienso como una pila de bandejas: cuando una se llena, rebosa en la siguiente, y la bandeja de abajo nunca es «nadie».
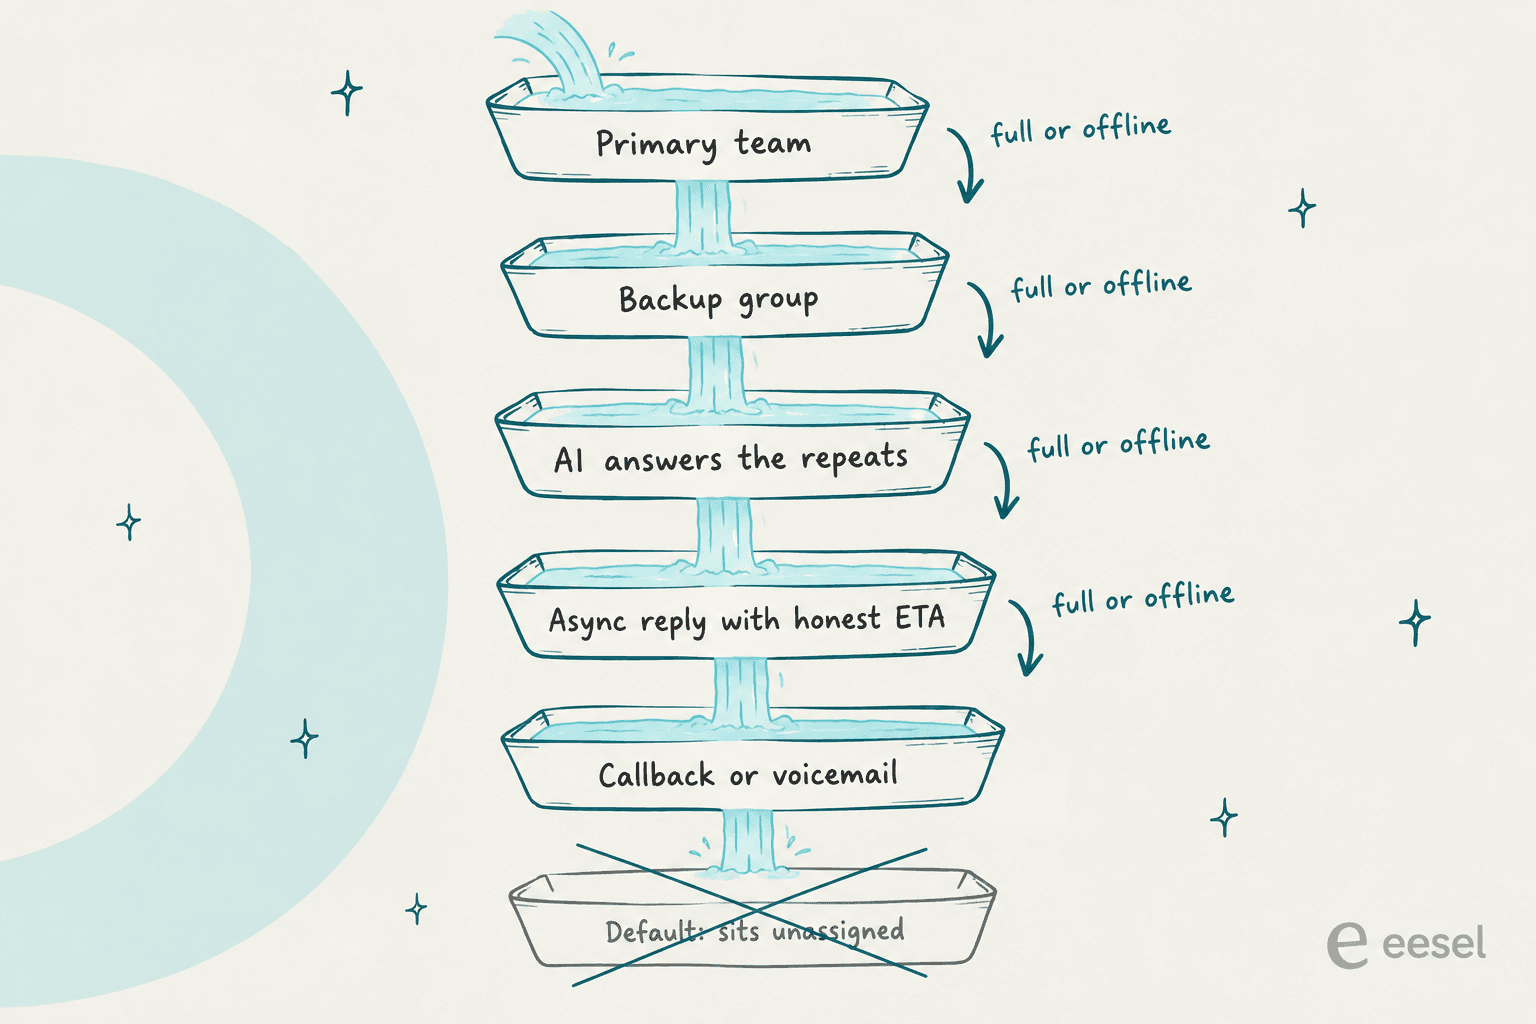
Así lo construiría yo, en el orden que da más alivio por el menor coste.
1. Fija los umbrales según la antigüedad del ticket, no según su número
Una cola de 150 tickets que llegaron hace diez minutos está bien. Una cola de 40 donde el más antiguo lleva 18 horas esperando es un incendio. El recuento miente durante un pico, porque sube y se recupera rápido. La antigüedad del ticket sin responder más antiguo te dice si los clientes realmente se están quedando atrás, y se traduce directamente en tu tiempo de primera respuesta y tus promesas de SLA.
Anota tres o cuatro niveles y, para cada uno, lo único que cambia. Los números de abajo son un punto de partida que ajustaría a tu propio SLA, no un estándar:
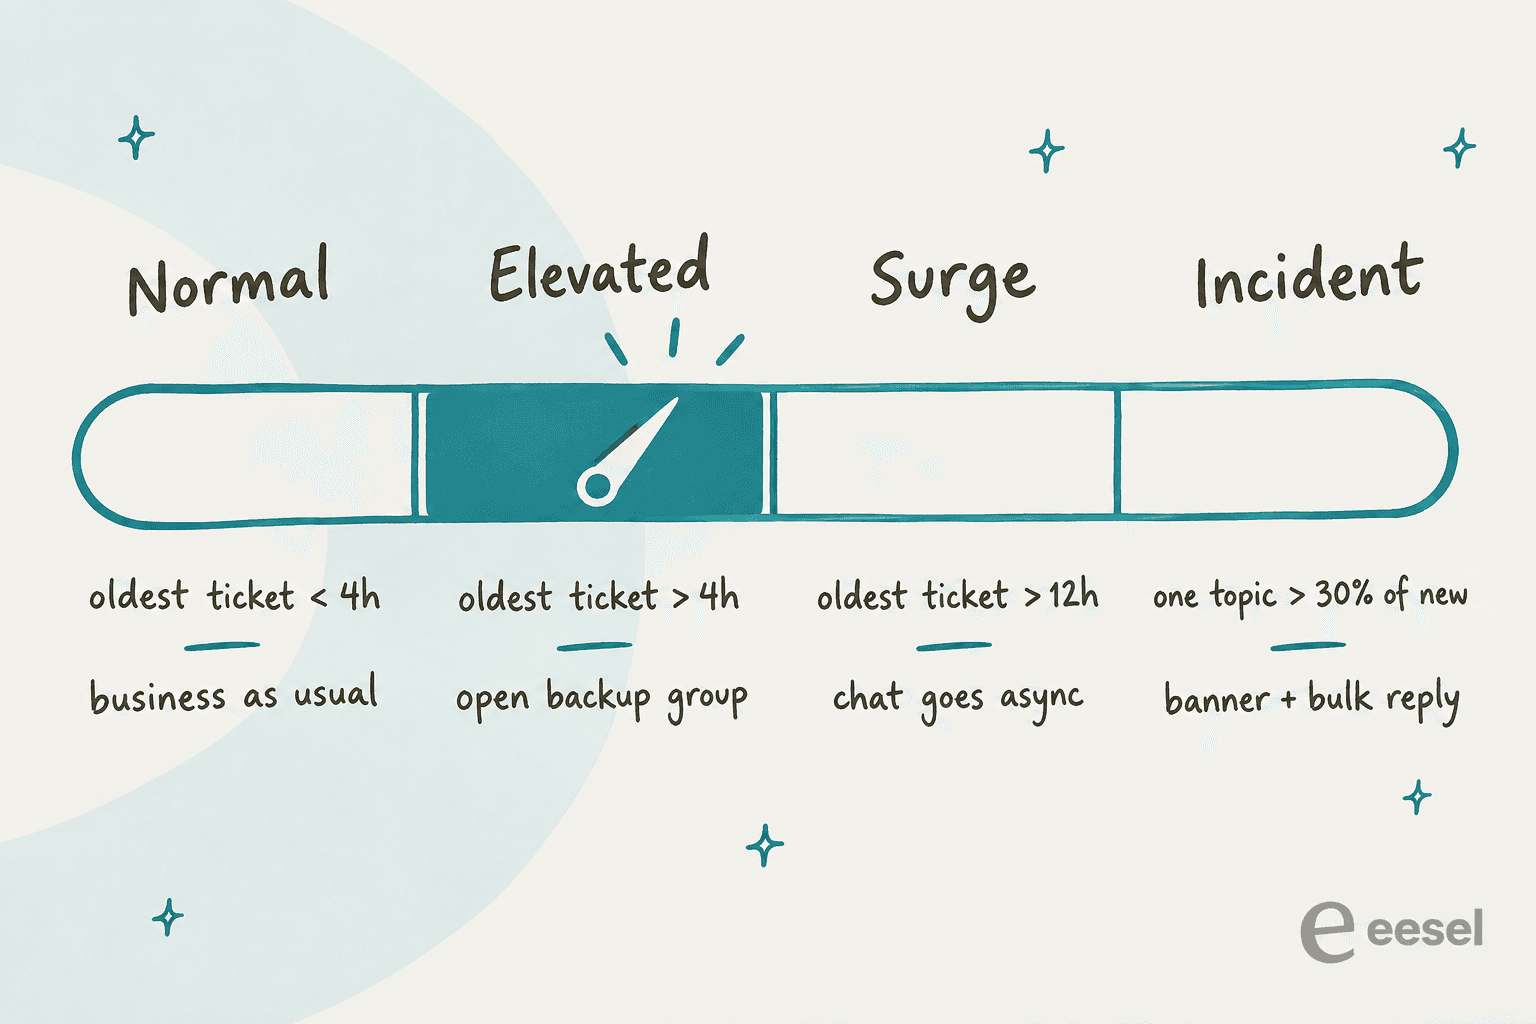
La gracia de dejarlo por escrito es que nadie tiene que tomar una decisión a juicio a las 4 p. m. del día del lanzamiento. La regla ya existe, y quien note que el indicador se mueve solo acciona el interruptor.
2. Abre un grupo de respaldo antes de necesitarlo
El grupo de respaldo son las personas que pueden asumir trabajo de nivel 1 cuando el equipo principal está lleno: un segundo equipo, agentes sénior de otra región o unos cuantos voluntarios formados de éxito del cliente y ventas. Configúralo en la herramienta en una semana tranquila.
- Zendesk. Crea una cola personalizada, añade tus grupos principales como primarios, luego «Turn on secondary groups» y añade el de respaldo. Cada cola personalizada admite hasta 20 grupos primarios y 20 secundarios, y puedes tener hasta 199 colas. La propia receta de Zendesk para mensajería añade un grupo «Backup» como último recurso para que los tickets «no se queden atascados en las colas más tiempo del que te resulte cómodo».
- Freshdesk. En Pro, divide la capacidad de cada agente por cola en Omniroute para que el chat y el correo no se dejen sin recursos entre sí. En Enterprise, añade la quick automation «Reroute to a Fallback Group» para canales en tiempo real.
- Help Scout, Front, Gorgias, HubSpot. No hay un grupo de desbordamiento nativo, así que la solución es un workflow o una regla que reasigne por etiqueta o tiempo de espera, más una cola compartida que el personal de respaldo vigile durante un pico.
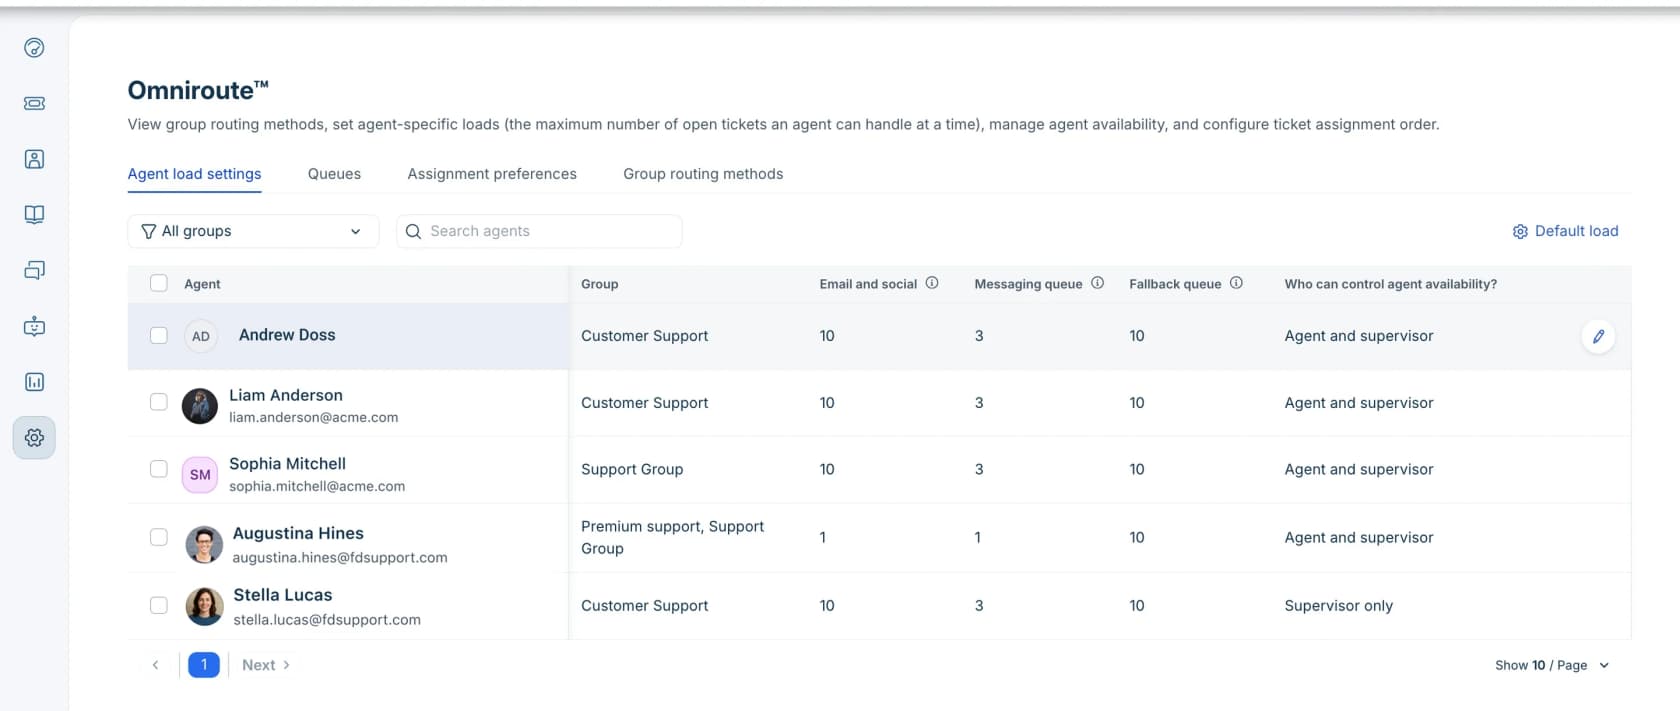
Un detalle de Freshdesk es útil para picos que solo duran una semana: los pases de día cuestan 2 $ en Growth, 7 $ en Pro y 12 $ en Enterprise, así que pedir prestado a un compañero de otro departamento para la semana del lanzamiento no implica pagar un puesto completo.
3. Protege a tus especialistas del volumen de nivel 1
Cuando la cola se desborda, a quienes se mete primero es a los que más saben, y se pasan el pico respondiendo «¿dónde está mi pedido?» mientras los tickets difíciles envejecen. Divide el trabajo por tipo. Las preguntas de nivel 1 van al grupo de respaldo y a la capa de IA. Las disputas de facturación, los errores y los VIP enfadados se quedan con los especialistas. Zendesk Suite Professional añade enrutamiento por habilidades y prioridad para esto, y Freshdesk tiene enrutamiento basado en habilidades en Enterprise.
Si ya trabajas por niveles, este es el momento en que tu ruta de escalado demuestra su valor. Un pico es cuando un vago «pásalo a ingeniería» se convierte en 3 días de silencio.
4. Responde el tema del pico una vez, en público
Durante una caída o un retraso de envíos, una gran parte de los tickets nuevos preguntan lo mismo. Responder cada uno a mano es la forma más cara de decir «lo sabemos, aquí está la actualización». Publícalo una vez en los sitios donde los clientes miran antes de escribir: un banner de estado, el centro de ayuda, el saludo del chat y las respuestas de tu agente de IA. Luego crea una macro que responda, etiquete y cierre los tickets que aun así lleguen.
El mismo truco funciona por teléfono. Un responsable de TI pone la actualización delante de la propia cola:
«Meto un mensaje antes de que la llamada se enrute a la cola de llamadas explicando qué pasa, cuándo será la próxima actualización y que cuelguen si tienen justo ese problema; si no, que sigan esperando para ser enrutados a la cola del helpdesk.»
Aquí es también donde la IA hace su mejor trabajo de desbordamiento. Lee la nota del incidente y responde «¿está caído el pago?» unos cientos de veces con la misma actualización precisa, mientras tu equipo atiende a los clientes cuyo pedido realmente falló. Más sobre esto más abajo.
5. Pasa los canales en vivo a asíncrono con un tiempo de espera honesto
El chat en vivo es el primer canal que se rompe en un pico, porque cada agente solo puede atender unos pocos a la vez. El Maximum Chat de Help Scout viene por defecto en 3, y la capacidad de chat de HubSpot también es 3 por defecto. Cuando todos llegan a ese límite, un visitante mirando una ventana de chat que nunca responde está peor que con un correo que dice «respondemos en unas 4 horas».
Las herramientas te dan el interruptor:
- HubSpot te deja elegir qué pasa cuando todos los agentes están en su capacidad máxima: mostrar un mensaje de espera, ocultar el lanzador o no hacer nada.
- El chat de Gorgias puede funcionar en directo solo cuando hay agentes disponibles, y los compradores sin conexión reciben un formulario de captura que se convierte en un ticket de correo. También hay un ajuste «Share wait time with shoppers».
- Front puede ocultar el widget de chat fuera del horario en línea, pero un cliente que ya lo tiene abierto puede seguir enviando mensajes, por lo que Front recomienda una respuesta automática.
- Las conversaciones de mensajería de Zendesk esperan en la cola hasta que se libera un hueco de capacidad, y las no asignadas pasan a inactivas a los 10 minutos sin respuesta del cliente. La guía sobre el manejo sin conexión de la mensajería de Zendesk cubre la parte de cara al cliente.
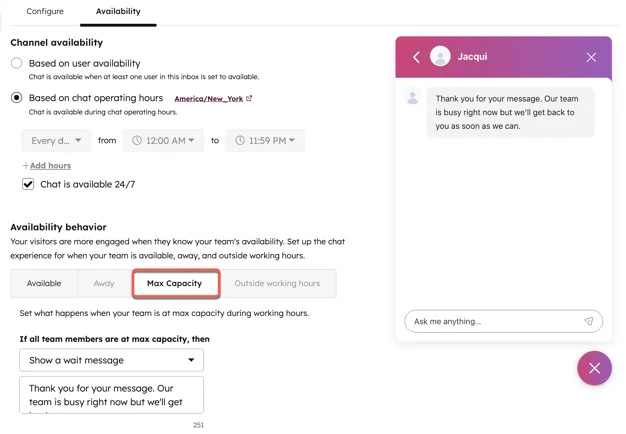
El soporte asíncrono aquí no es un retroceso. Una promesa concreta que cumples vale más que un canal en vivo que deja a la gente colgada.
Desbordamiento de voz: los ajustes que cortan llamadas
El desbordamiento telefónico merece su propia sección, porque los valores por defecto pueden colgar a la gente. Cada herramienta limita cuántos llamantes esperan y por cuánto tiempo, y lo que sucede después es lo que hayas configurado, incluso nada.
| Herramienta | Tamaño máximo de cola | Espera máxima | Cuando se agota la espera | Devolución de llamada |
|---|---|---|---|---|
| Zendesk Talk | 750 (Team) o 1.500 (Pro/Enterprise) con enrutamiento omnicanal; 15 o 50 sin él | De 1 a 20 min, de 1 a 60 en Enterprise | Buzón de voz, o número de desbordamiento si el buzón está desactivado | Professional y Enterprise |
| Freshcaller | Por defecto 20, más bajo petición en Pro y Enterprise | De 30 s a 15 min | Buzón de voz, otra cola o colgar | Pulsar 2, se devuelve la llamada cuando se libera un agente |
| Gorgias Voice | Capacidad de cola por cola | Espera máxima en segundos | Siguiente paso del flujo de llamada; rama «Skip queue when it's too busy» | Pulsar asterisco, crea un ticket «Callback requested» |
| Aircall | Basado en timbres | De 20 s a 40 min en la cola de equipo | Siguiente widget, o la llamada se corta | De 0 a 5 reintentos, Professional y superior |
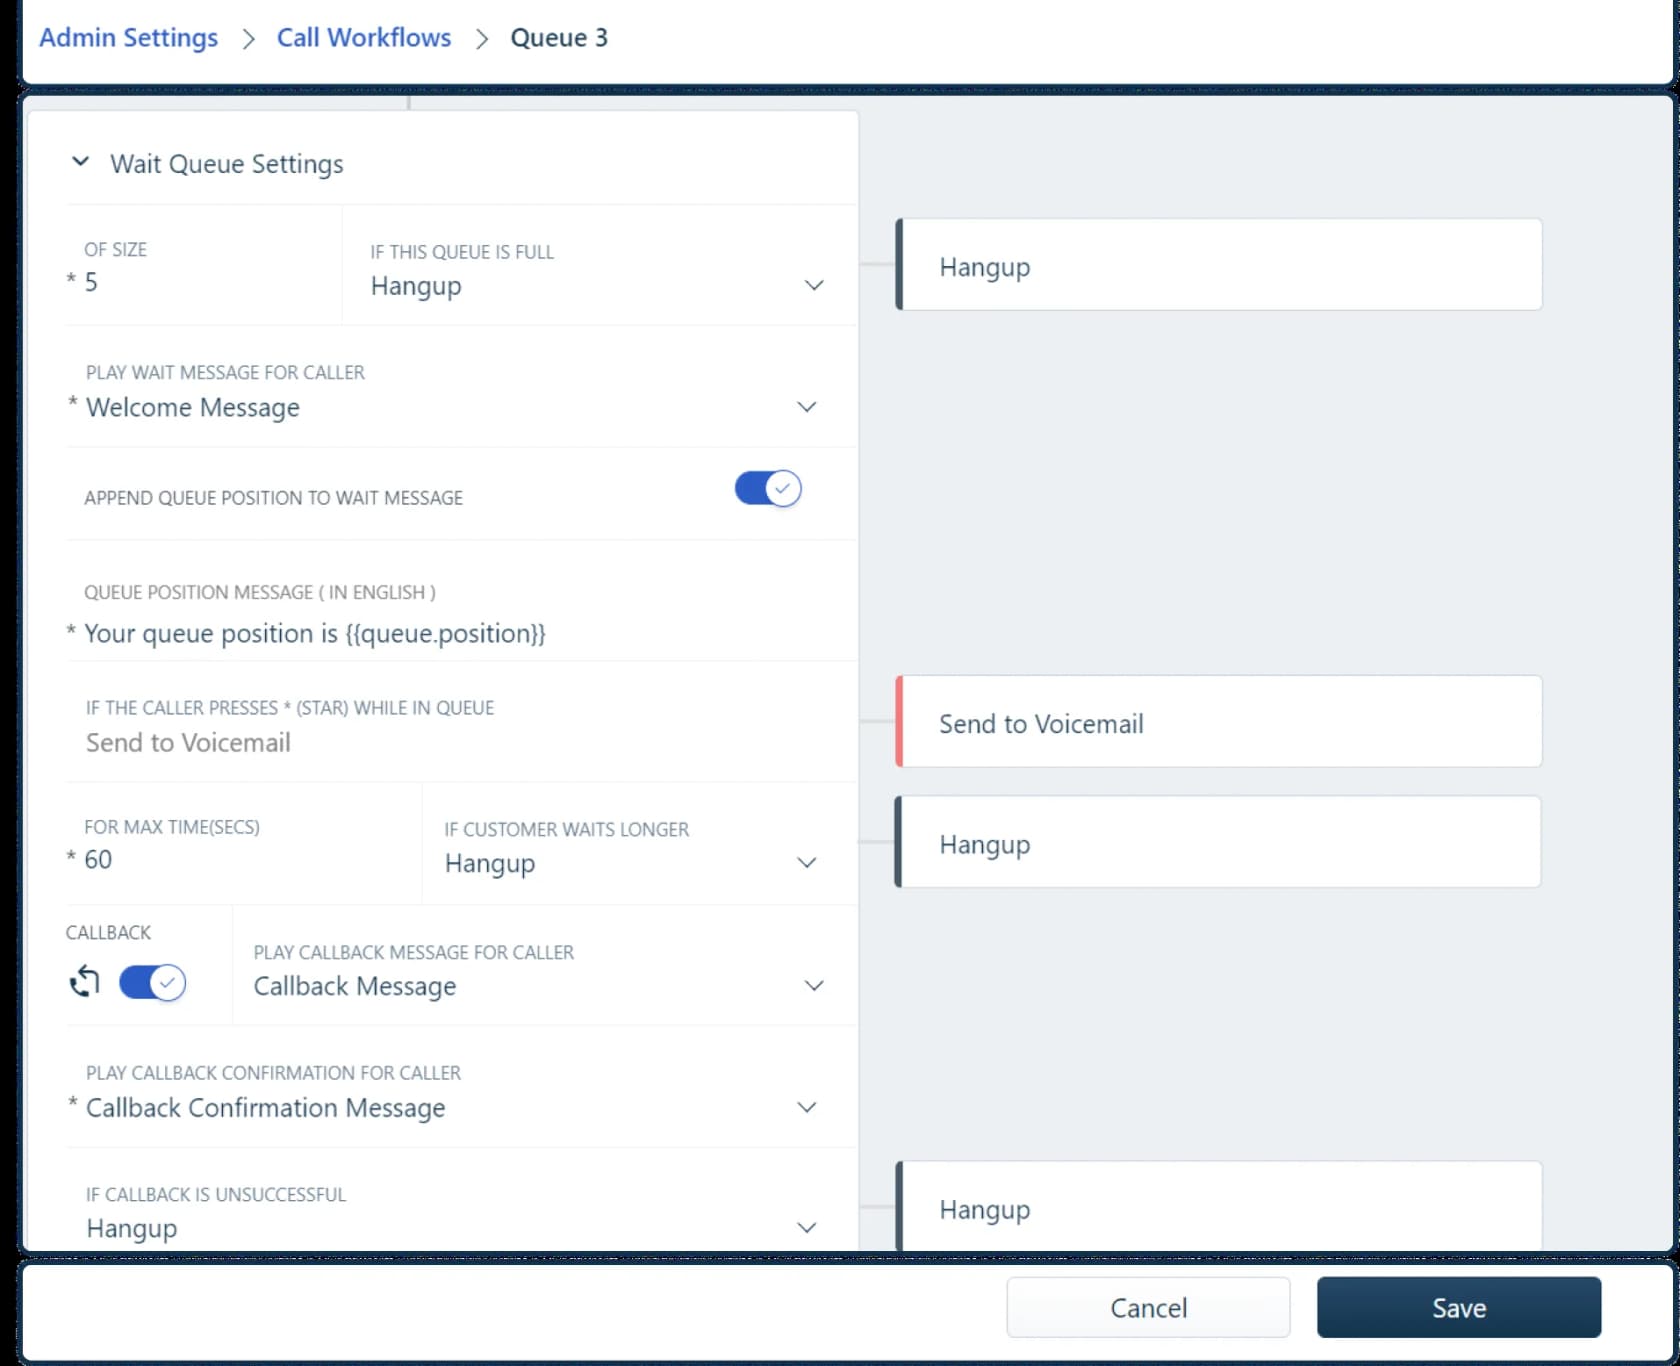
Tres trampas que revisaría hoy mismo:
- Nada después del último paso. En Zendesk, con el buzón de voz desactivado y sin número de desbordamiento, el llamante oye el saludo y la llamada se desconecta. En Aircall, si no hay nada después de un paso Ring to, la llamada de Aircall suena una vez y se corta. Termina siempre el flujo en un buzón de voz o una devolución de llamada.
- Las transferencias ignoran tu límite de espera. La espera máxima en cola de Zendesk se ignora tras una transferencia, así que un llamante transferido se queda en espera hasta que un agente acepta. Eso es justo lo que pasa en un pico cuando el nivel 1 lo reenvía todo al nivel 2.
- Las devoluciones de llamada necesitan a alguien en línea. La devolución de llamada de Zendesk requiere al menos un agente Online o Away, y las de Aircall no esperan indefinidamente: con cero reintentos, una fallida se registra como «Failed - No agents available».
Con el enrutamiento omnicanal de Zendesk activado, el desbordamiento de llamadas usa la misma alternativa de grupo primario a secundario que los tickets, así que no hace falta un número de desbordamiento. La guía de desbordamiento y tiempo de espera de Talk recorre ambas configuraciones.
¿Qué tamaño tiene tu problema de desbordamiento?
El desbordamiento se acumula. Cualquier ticket que tu equipo no pueda despachar hoy pasa a mañana, así que un pico que solo supera la capacidad en un 50 % sigue generando atraso cada día que dura. Un ejemplo sencillo: un equipo que normalmente recibe 200 tickets al día, con 4 agentes que despachan 100 cada uno, recibe el triple de volumen durante cinco días.
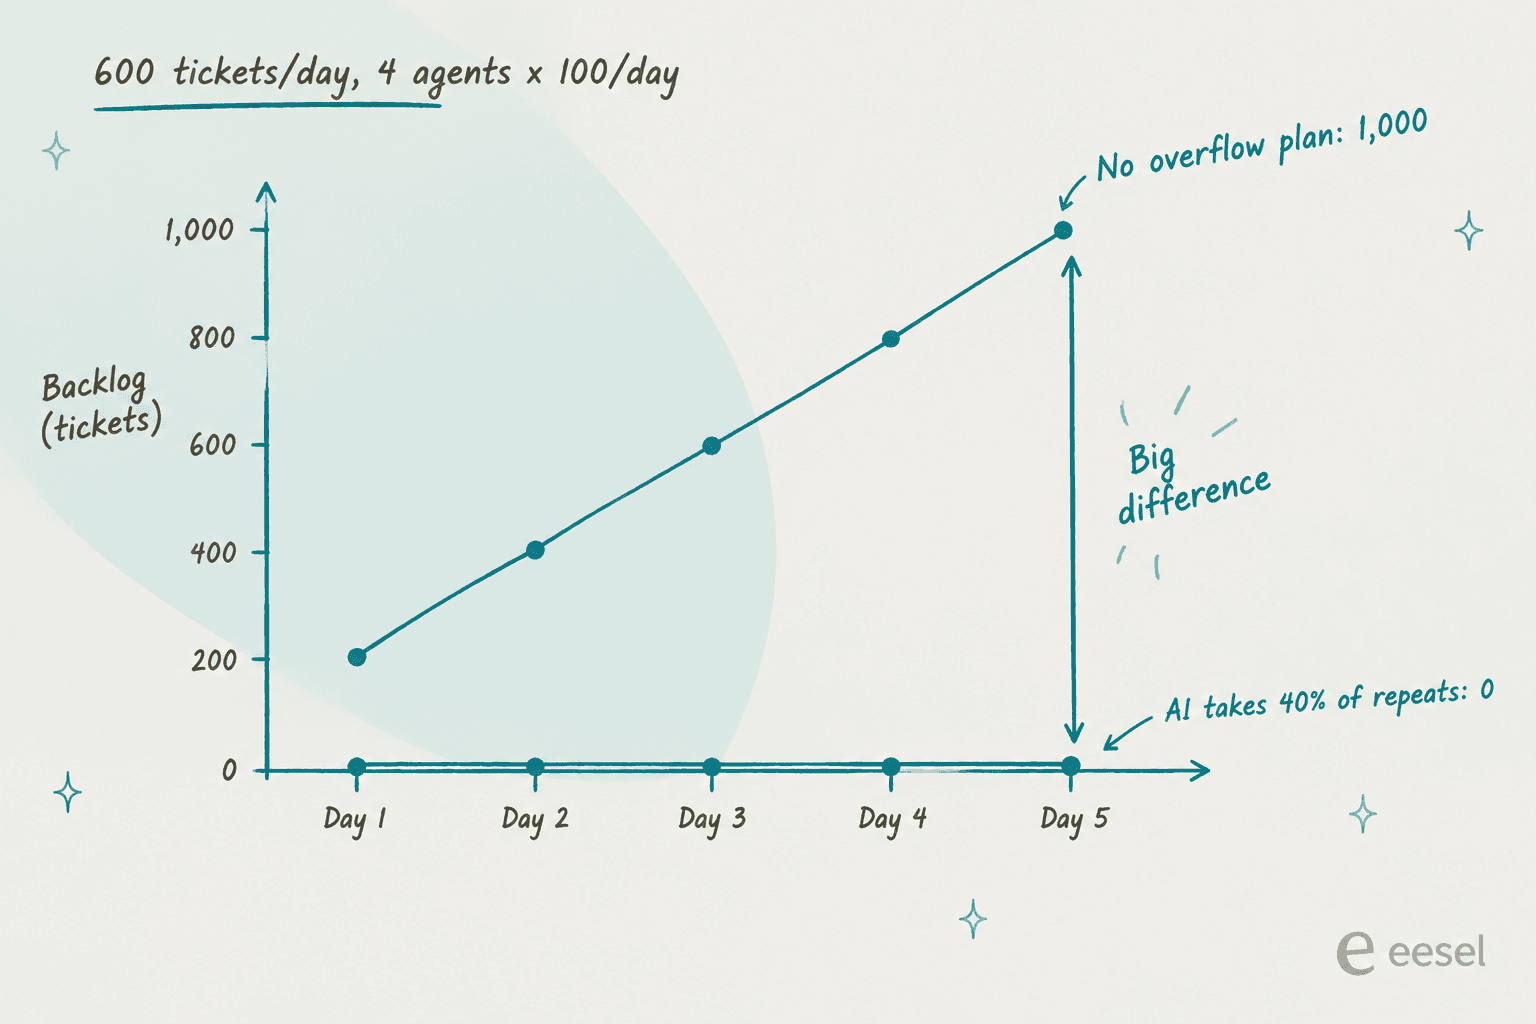
Sin carril de desbordamiento, el equipo despacha 400 de 600 cada día, así que el atraso crece 200 al día y llega a 1.000 tickets el día cinco. Cuando el volumen vuelve a 200, los 200 diarios de capacidad sobrante tardan otros cinco días en saldarlo. Los clientes que escribieron el día dos esperan casi una semana. Si un carril de respaldo absorbe el 40 % del pico, el equipo solo ve 360 al día y la cola nunca se forma. Cubrir el mismo hueco solo con personas supone 10 días-agente extra, formados y listos el primer día.
Introduce tus propios números:
La calculadora ignora muchas cosas (el tiempo de gestión varía, algunos tickets se reabren, los agentes se ralentizan con el cansancio), pero la forma es correcta. Un alivio pequeño y constante al principio supera a una recuperación heroica después.
De dónde sale la capacidad extra
Una vez que el enrutamiento está en su sitio, aún necesitas un lugar donde aterrice el desbordamiento. Hay cuatro fuentes realistas, y cada una encaja con una forma distinta de desbordamiento:
| Fuente | Lista en | Ideal para | Cuidado con |
|---|---|---|---|
| Compañeros prestados (éxito del cliente, ventas, operaciones) | El mismo día | Picos, semana de lanzamiento | Saca a la gente de su propio trabajo; necesita macros y un alcance acotado |
| Temporales o contrataciones de temporada | De 2 a 6 semanas | Picos estacionales previsibles | Tiempo de arranque y formación; consulta la guía de incorporación estacional |
| Socio externo de desbordamiento | De 4 a 8 semanas de puesta en marcha | Picos largos, cobertura 24/7 | Control de calidad y lagunas de contexto; lee antes sobre el chat en vivo externalizado |
| Agente de IA en el helpdesk | Días | Preguntas repetidas en cualquier forma de desbordamiento | Debe ceñirse a lo que sabe y derivar bien |
La mejor versión de la opción externalizada que he visto descrita es un socio al que se evalúa en una semana tranquila, no uno al que se firma a toda prisa en pleno incendio:
«Tengo empresas a las que puedo llamar para derivar nuestro volumen de llamadas durante grandes proyectos o caídas. Ya han pasado la due diligence y están en espera activa por si hace falta.»
Para los picos planificados, haz los cálculos pronto con un buen plan de cobertura. Para el Black Friday en concreto, yo también prepararía con un mes de antelación los mensajes a clientes y el lado de IA de la temporada.
Dónde encaja la IA en el desbordamiento (y dónde no)
He pasado mucho tiempo viendo a agentes de IA gestionar colas reales, y el resumen honesto es que la IA es el mejor carril de desbordamiento para un tipo de ticket y un lastre para otro. Es excelente con las preguntas repetidas que forman la mayor parte de un pico: estado del pedido, restablecimientos de contraseña, «¿está caída la app?», plazos de devolución. Es la herramienta equivocada para el cliente enfadado al que se le ha perdido el tercer pedido.
Los equipos que lo hacen bien hacen que la IA elija sus batallas. Un responsable de CX de una marca DTC de suplementos en Gorgias y Shopify, con unos 7.000 tickets al mes, lo expresó mejor de lo que puedo yo en una llamada comercial con eesel:
«La IA nunca podrá responder el 100 % de las preguntas, pero si lo intenta y solo contesta "lo siento, no sé esto", no puedo ir a revisar mis 7.000 tickets para ver si la IA dio una buena respuesta; entonces el sentido se pierde un poco. Necesito una IA que solo gestione los tickets que está segura de poder gestionar y deje en paz a todos los demás.»
Ese es el encargo correcto para una IA de desbordamiento. Responde lo que sabes, pasa el resto con contexto y nunca envíes una respuesta equivocada con seguridad a una cola que nadie tiene tiempo de revisar. Su temporada alta va de noviembre a mayo, justo cuando un atraso de tickets de «dónde está mi pedido» enterraría a las personas que tienen que ocuparse de los problemas reales.
Los fundadores que llevan el soporte ellos mismos describen la misma acumulación de tickets casi idénticos:
«Los tickets se acumulaban y eran sobre todo quejas de nivel 1 con problemas parecidos, pero NO podía llevar la cuenta. La pérdida de clientes por la falta de resolución provocó agotamiento»
Los helpdesks tienen sus propias capas de IA, y la mayoría se cobra por resultado, lo que significa que la factura crece con el pico:
| Capa de IA | Cómo se factura | Precio |
|---|---|---|
| Zendesk AI agents | Por resolución automatizada | 1,50 $ con compromiso, 2,00 $ pago por uso |
| Freddy AI Agent | Por sesión | 500 incluidas, luego 49 $ por 100 |
| Gorgias AI Agent | Por interacción automatizada | De 0,85 a 1,00 $ |
| Help Scout AI Answers | Por resolución | 0,75 $, con límite de gasto |
| Front Autopilot | Por conversación | Desde 0,05 $ |
| Compañero de IA de eesel | Por ticket o chat gestionado, 1 crédito cada uno | Desde 299 $/mes por 500 créditos, excedente limitado por ti |
El precio por resultado es justo en un mes normal. En un pico, conviene modelarlo. Un análisis de costes que eesel hizo para un buzón de e-commerce de 1.000 tickets al mes mostró un precio por resolución de unos 792 $ al mes en un mes normal y de 3.168 $ en un mes de Black Friday con 4.000 tickets, con la misma tasa de resolución del 80 %. El propio centro de ayuda de Zendesk señala que las resoluciones de pago por uso cuestan más que un bloque comprometido, y te permite limitar las resoluciones mensuales. Elijas lo que elijas, fija el límite antes del pico para que el aumento tenga un techo.
HubSpot tiene una versión integrada muy práctica de la idea de cascada: un ajuste de chat en vivo que asigna los chats al agente de cliente cuando no hay usuarios disponibles o todos están al límite. Es el patrón de «IA como grupo de respaldo», dentro de una sola herramienta.
Prueba eesel como tu carril de desbordamiento
Si tu equipo trabaja con Zendesk, Freshdesk, Gorgias, Help Scout o Front, el compañero de IA de helpdesk de eesel encaja en la cascada como la bandeja entre tu grupo de respaldo y la respuesta asíncrona. Se une a la cola que ya tienes, aprende de tus tickets pasados, tu centro de ayuda y tus macros, y responde las preguntas repetidas que forman un pico. Todo aquello de lo que no está seguro va a tu equipo con una nota interna, y los reembolsos u otras acciones irreversibles pueden esperar a una aprobación humana.

Lo que yo aprovecharía antes de un pico es la simulación: eesel ejecuta el agente contra tus tickets pasados reales y puntúa cada respuesta frente a lo que tu equipo envió de verdad, para que sepas qué temas puede asumir antes del día del lanzamiento, no durante. Gridwise, en Zendesk, vio resuelto el 73 % de los tickets de nivel 1 en el primer mes. El precio es por ticket o chat gestionado, con puestos ilimitados, así que añadir a tu grupo de respaldo para supervisarlo no cuesta nada extra.
Prueba eesel gratis con tu propia cola: empieza con 100 créditos gratis, conecta tu cuenta de Freshdesk o Gorgias y ejecuta una simulación antes de tu próximo pico.