

¿Qué son las operaciones de soporte distribuido?
Operaciones de soporte distribuido significa dirigir un equipo de atención al cliente cuya gente está en más de un lugar. Eso cubre muchas configuraciones: dos oficinas en el mismo país, tres centros que se pasan la cola las 24 horas, agentes remotos repartidos por un continente, o un equipo interno con un socio offshore que cubre noches y fines de semana.
Miro muchos datos de búsqueda de este sector, y las preguntas que la gente hace sobre este tema rara vez son "cómo contrato en otro país". Son operativas: cómo enruto tickets entre sedes, por qué mis sedes dan respuestas distintas, por qué no coinciden mis informes. De eso trata esta guía.
La mayoría de los equipos distribuidos encajan en una de cuatro formas. Cada una tiene su punto débil, y casi todas ya tienen una guía más a fondo:
| Configuración | Cómo es | Dónde suele romperse | Lee a continuación |
|---|---|---|---|
| Varias sedes, mismo horario | Dos o más oficinas cubren la misma jornada | Trabajo duplicado, hábitos distintos por oficina | Esta guía |
| Follow-the-sun | Dos o tres centros pasan la cola entre zonas horarias | El traspaso entre centros | Soporte follow-the-sun |
| Interno más externalizado | Tu equipo más un BPO o socio offshore | Brechas de conocimiento y calidad | Transferencia de conocimiento offshore |
| Totalmente remoto | Agentes en muchos lugares, a menudo en asíncrono | Responsabilidad y promesas de respuesta | Soporte asíncrono |
Los equipos reales mezclan estas formas. Una habitual que veo: un equipo central remoto, un socio que cubre las noches y un puñado de especialistas regionales para los idiomas. Las reglas operativas de abajo valen para todas.
Por qué los equipos de soporte distribuido se van separando
Todas las sedes empiezan con el mismo manual. Seis meses después, ya no es el mismo. Nadie lo decidió; ocurrió con un pequeño apaño tras otro. Una sede encuentra una macro más rápida y no la comparte. Otra se entera de un cambio de política en una llamada a la que la otra sede no asistió. Una tercera empieza a etiquetar distinto porque su responsable quería un informe nuevo.
Un ingeniero de un equipo pequeño multirregión dio con la causa de fondo:
"The communication costs from time zones are real, and it makes everyone's context on what is going on different because they see updates from different regions."

El cliente nota la deriva antes que tú. Hace la misma pregunta dos veces y recibe dos respuestas, según qué sede la atendió. Y cuando las sedes se miden de forma distinta, se comportan de forma distinta. Un comentarista de HN que explicaba por qué los equipos de nivel 1 externalizados rara vez escalan lo atribuyó a cómo se les evalúa:
"The problem, of course, is that Tier 1 support are outsourced and a huge part of their evaluations are how many tickets they close. Escalating hurts their numbers, so it's hard to get cases escalated"
Eso no es un problema de personas. Es un sistema que premia a una sede por cerrar y a otra por resolver, y luego se sorprende de que los resultados difieran. Casi todo lo que sigue trata de eliminar los puntos en los que se permite que las sedes difieran cuando no deberían.
Decide qué es igual en todas partes y qué es local
La hora más útil que puedes dedicar a un equipo distribuido es escribir dos listas. La primera, lo que debe ser idéntico en cada sede. La segunda, lo que cada sede puede definir por su cuenta. Todo lo demás es un debate que tendrás una y otra vez hasta que lo resuelvas.
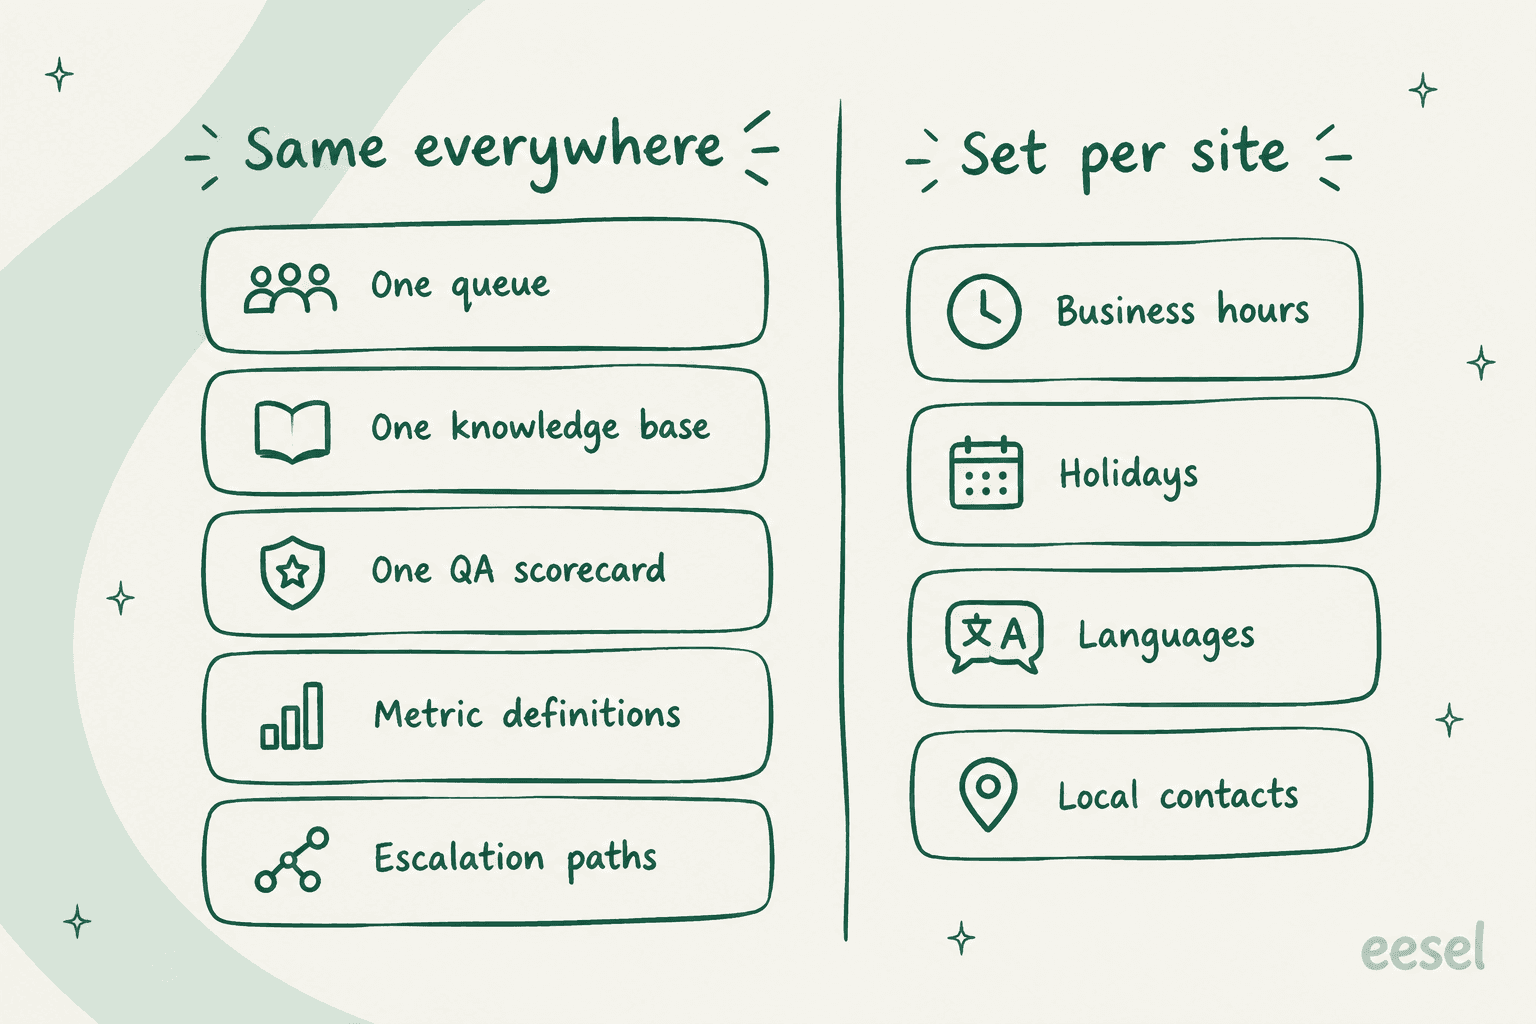
Esta es la división desde la que yo empezaría:
Igual en todas partes:
- Una cola. Todas las sedes trabajan desde la misma instancia del helpdesk, con el historial completo del cliente visible.
- Una base de conocimiento. Los artículos internos y externos viven en un solo lugar con responsables con nombre, no en documentos por sede. Mi guía de base de conocimiento interna cubre la estructura.
- Una hoja de evaluación de QA. Los mismos criterios, puntuados igual en cada sede.
- Definiciones de métricas. Qué significa "primera respuesta", qué horas cuentan, qué zona horaria usan los informes.
- Rutas de escalado. Quién se encarga de las disputas de facturación o de los errores, sin importar qué sede los encontró. Mira el escalado entre equipos.
Definido por sede:
- Horario laboral y festivos. Cada sede tiene su propio calendario, y los SLA deberían respetarlo.
- Idiomas. Enruta las colas por idioma a las sedes que los hablan.
- Contactos locales. El responsable de guardia, el contacto local de finanzas, la persona que puede aprobar un reembolso en ese mercado.
La ubicación de los datos es lo que a veces rompe el patrón. Si vendes en mercados regulados, comprueba dónde almacena datos el helpdesk. El complemento Data Center Location de Zendesk es "free of charge for Zendesk Suite Professional or higher plans, but it is not automatically activated", y cubre EE. UU., el EEE, el Reino Unido, Japón y Australia. Freshdesk te deja elegir la ubicación de tus datos al registrarte. Mi guía de residencia de datos en Freshdesk profundiza más. Ten en cuenta que Zendesk aloja tus datos de servicio en una sola ubicación, así que una instancia no puede estar en dos regiones a la vez.
Una cola, no una bandeja por sede
El error temprano más común es dar a cada sede su propia bandeja o dirección de correo. Parece ordenado. Cada oficina ve su propio trabajo y nadie estorba a nadie. En la práctica, oculta la carga de trabajo al resto del equipo y crea tickets que no son de nadie. El dueño de una pequeña empresa describió justo esto en Reddit:
"We are looking for a way to manage out digital customer interactions in three offices, for one business. Each office has its own email address with multiple employees using the same email address. We are constantly failing to respond to 100% of customer messages because one employee will open the email of another's and then it will never been seen by its intended target."

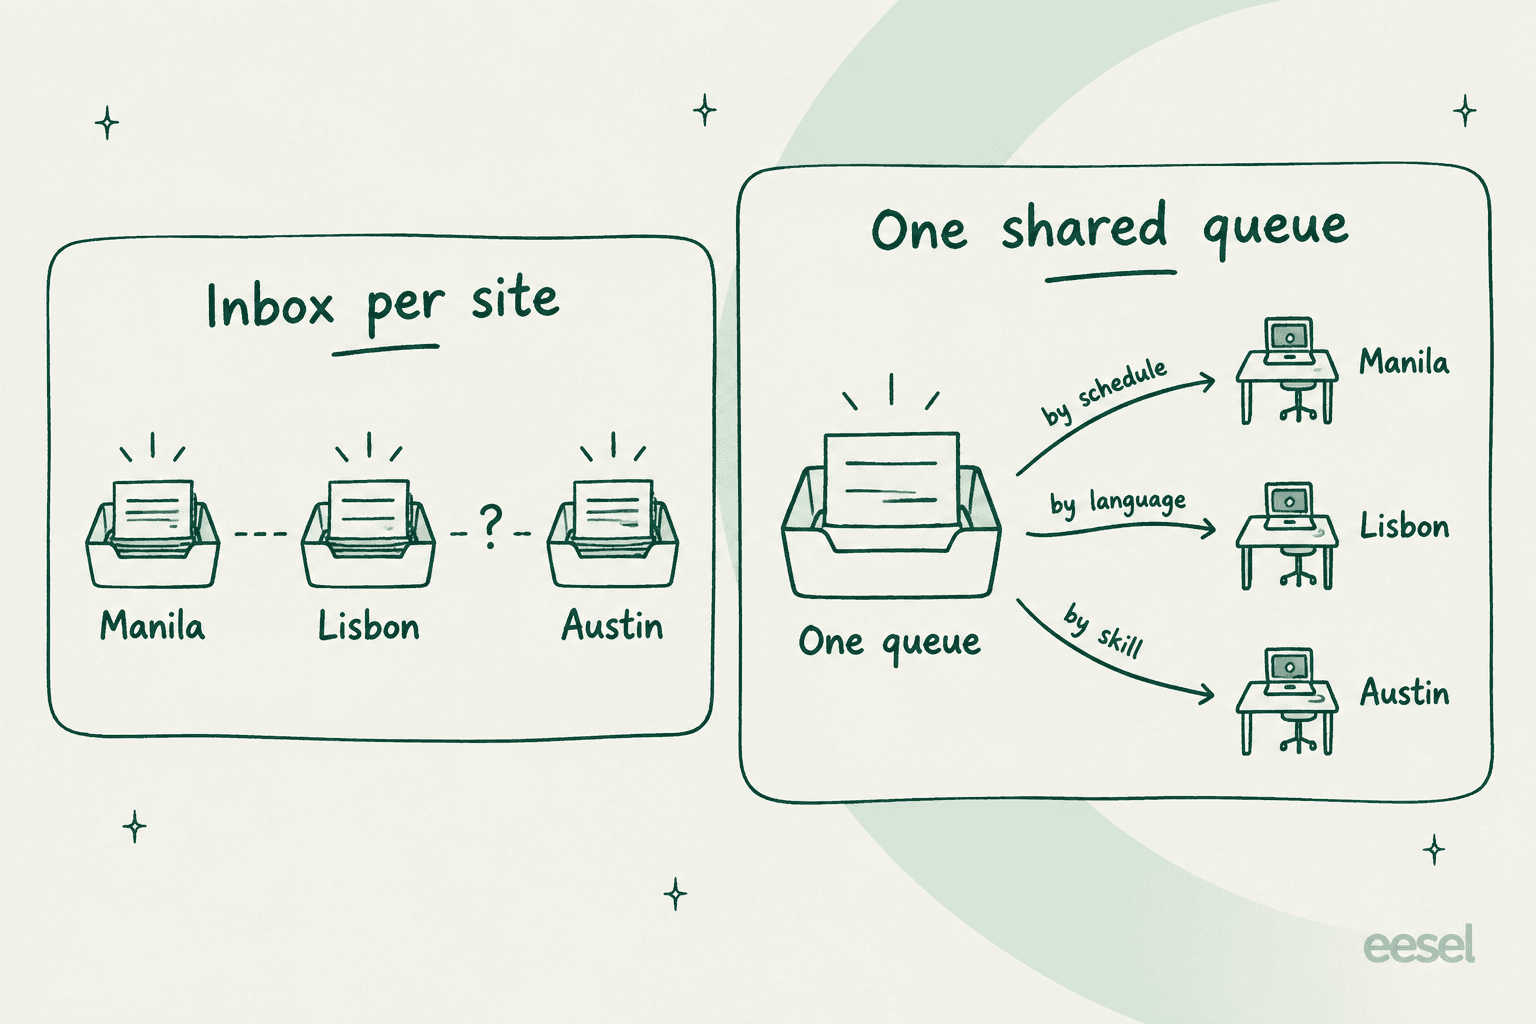
El mejor patrón es una cola, repartida con enrutamiento. Cada ticket llega al mismo sitio, y luego unas reglas lo envían a la sede adecuada según tres cosas:
- Horario. Quién está trabajando ahora mismo. Combínalo con el horario laboral de cada sede para que los SLA no cuenten las horas en que una sede está cerrada.
- Idioma. Español al equipo de Madrid, alemán al horario de Berlín, y así sucesivamente.
- Habilidad. Facturación, técnico, VIP o una línea de producto concreta, sin importar la sede.
Cada sede sigue teniendo su propia vista de su trabajo (una vista o carpeta filtrada a su grupo), así que se mantiene la sensación de "orden". Lo que cambia es que un responsable puede ver toda la cola a la vez, y un ticket que una sede no puede atender puede pasar a otra sin dejar atrás el historial del cliente. La guía de triaje de tickets explica cómo etiquetar tickets para que las reglas de enrutamiento tengan algo sobre lo que actuar.
Cómo gestiona cada helpdesk los horarios y el enrutamiento multisede
Aquí es donde importan los planes. Las funciones que necesita un equipo distribuido (varios calendarios de horario laboral, enrutamiento por habilidades o idioma) suelen estar uno o dos niveles por encima de donde empiezan los equipos pequeños. Esto es lo que documenta cada helpdesk a octubre de 2026:
| Zendesk | Freshdesk | Help Scout | Gorgias | Front | |
|---|---|---|---|---|---|
| Varios horarios laborales | Solo Enterprise | Pro ($55) y superiores | Plus ($45) y superiores | Basic ($60/mes) y superiores | Professional ($65) y superiores |
| Cómo elige un ticket su horario | Un trigger por horario (grupo, marca o estado) | Asociado a un grupo | Por bandeja | Por integración (tienda o canal) | Por bandeja |
| Enrutamiento por habilidades o idioma | Habilidades desde Suite Professional ($115) | Habilidades en Enterprise ($89) | Sin función de habilidades; Teams y workflows en Plus | Detección de idioma en reglas, todos los planes | Reglas y balanceo de carga; sin función de habilidades |
| Zona horaria de informes | La zona horaria del perfil de cada usuario | Una zona horaria del helpdesk | Una zona horaria de la empresa | Sin confirmar | Sin confirmar |
| Puntuación de QA integrada | Complemento de QA o paquete WEM ($50) | Ninguna para agentes humanos | Ninguna | Auto QA, con una suscripción a AI Agent | Smart QA, $20/puesto o incluido en Enterprise |
Los precios son por agente al mes con facturación anual, salvo Gorgias, que cobra por volumen de tickets. El detalle de cada columna está a continuación.
Zendesk
El límite de Zendesk sorprende a la gente. Su documentación sobre horarios es tajante: "On Suite Growth and Professional or Support Professional, you can set only one schedule. On Enterprise plans you can set multiple schedules." Así que un equipo de tres sedes en Suite Professional tiene un solo conjunto de horario laboral para todos.
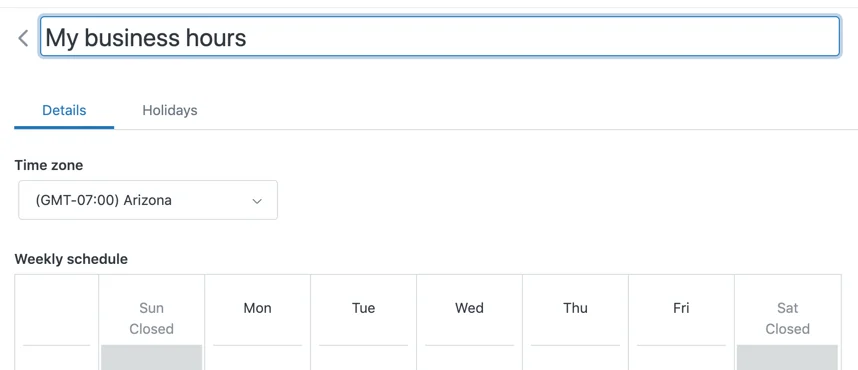
En Enterprise, el primer horario es el predeterminado y "you need to create a trigger for each schedule", normalmente por grupo de tickets, marca o estado. El enrutamiento es más potente en niveles inferiores: el enrutamiento basado en habilidades te permite "define up to 10 skill types. Each skill type can contain up to 30 skills", desde Suite Professional ($115). El idioma es un tipo de habilidad natural. Mi guía de enrutamiento en Zendesk recorre la configuración omnicanal, y el propio artículo follow-the-sun de Zendesk recomienda grupos por región.
Freshdesk
Freshdesk te da varios horarios laborales antes, desde Pro ($55). El inconveniente es cómo se aplican. La documentación de Freshdesk dice que el horario laboral "cannot be applied to tickets unless they are first mapped to a group. Each group can be assigned its own business hours (for example, EU, North America, or Asia)."
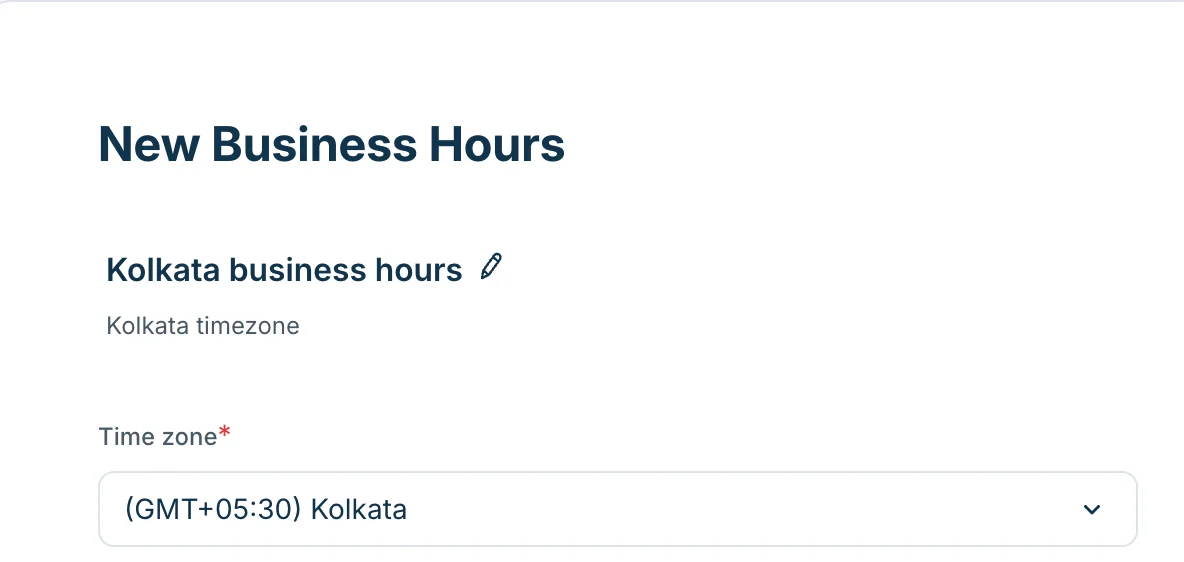
Así que en Freshdesk, el grupo es tu sede. Planifica los grupos en torno a ubicaciones (o ubicación más nivel) y las políticas de SLA las siguen. El enrutamiento basado en habilidades es solo para Enterprise ($89), con hasta 180 habilidades, y la documentación usa el idioma como ejemplo: enviar "every ticket from a French-speaking customer" a una habilidad "French".
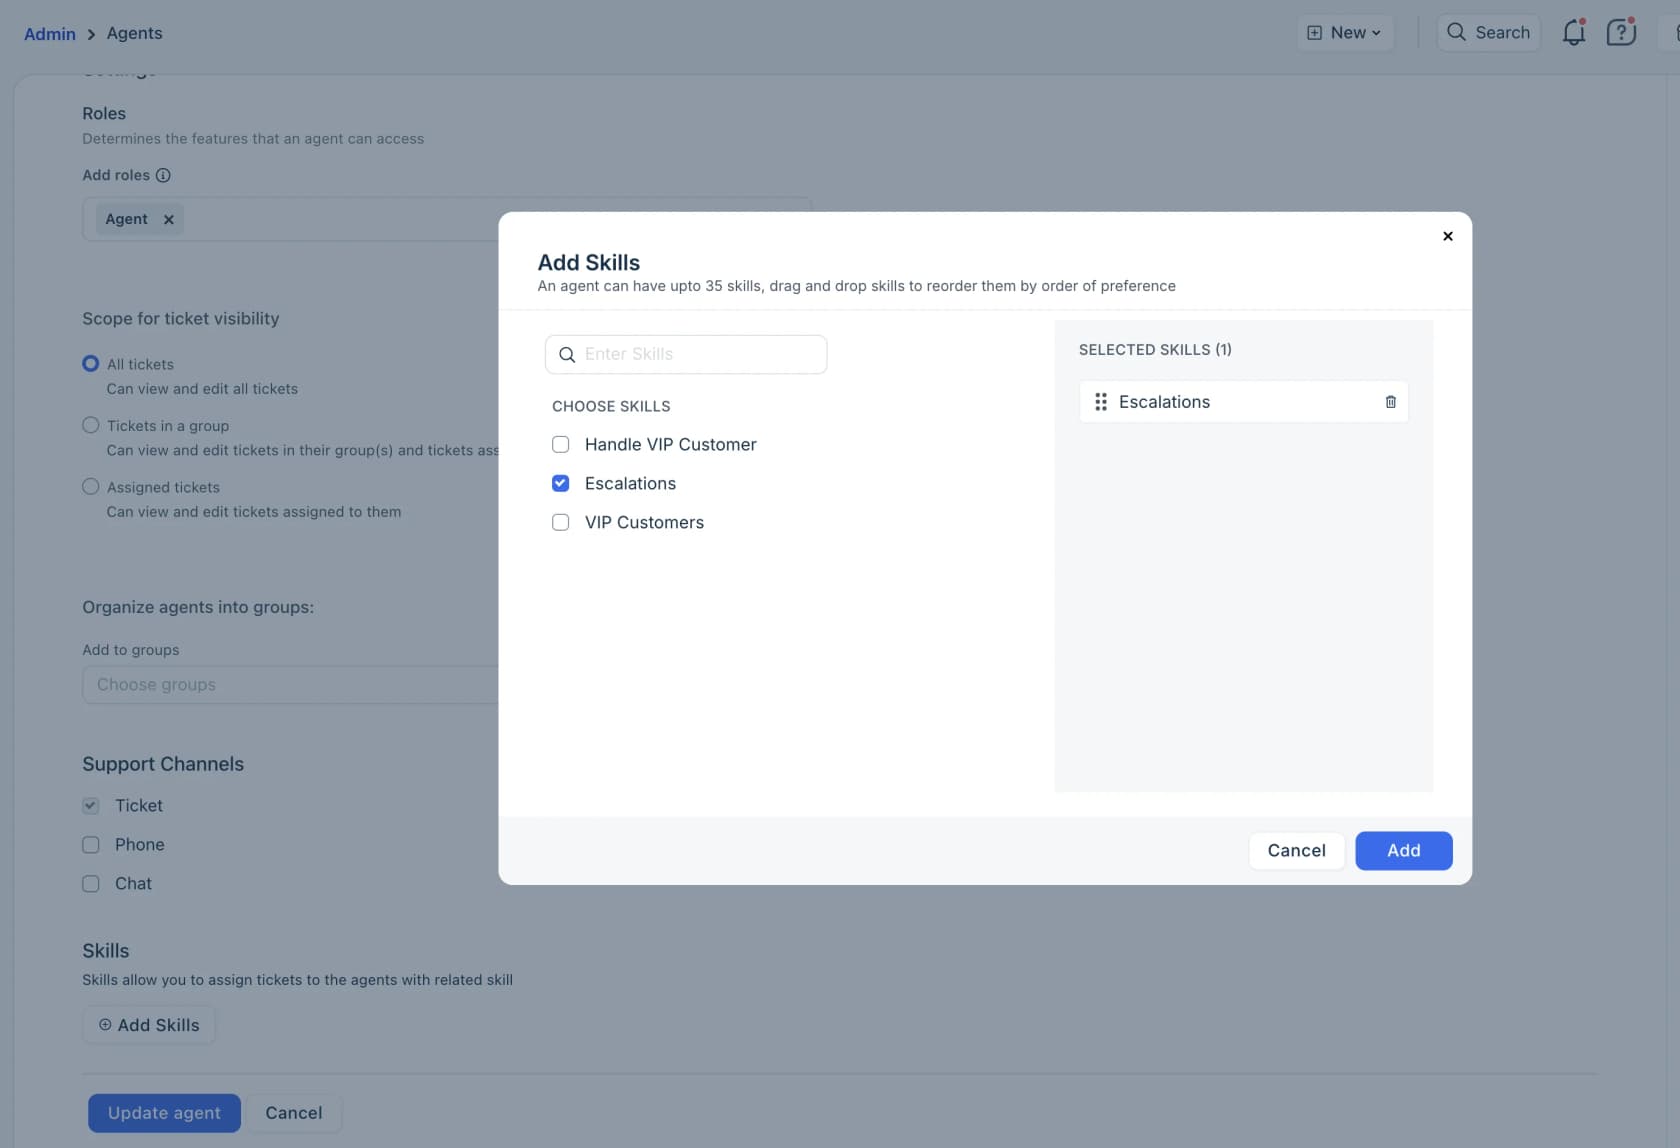
Una trampa: los tickets que no coinciden con ninguna habilidad "remain unassigned until it is manually assigned", por eso Freshdesk sugiere una habilidad de respaldo por grupo. En un equipo distribuido, ese respaldo es tu red de seguridad para las horas entre sedes. Mi guía de enrutamiento por habilidades en Freshdesk tiene la configuración completa, y turnos de agentes en Freshdesk cubre las zonas horarias por turno en Enterprise.
Help Scout, Gorgias y Front
Estos tres vinculan los horarios a bandejas o canales en lugar de a grupos.
- Help Scout: las Inbox Hours personalizadas "are available on Plus and Pro plans". Así que el patrón es una bandeja por sede o región. No hay función de habilidades en su documentación. El enrutamiento es Round Robin en Plus, más Balanced en Pro, y los Teams (Plus y superiores) tienen sus propias carpetas y una sección en el informe de la empresa.
- Gorgias: horario laboral personalizado por integración desde Basic, de modo que cada tienda o canal puede tener su propia zona horaria. Sus reglas pueden usar el idioma detectado ("up to 54 languages") para "assign Spanish tickets to a team" en todos los planes. Mira mi guía de Gorgias auto assign.
- Front: el horario laboral funciona a nivel de espacio de trabajo y de bandeja, lo que Front llama "useful for global organizations with distinct business hours per office or time zone", desde Professional (
$65). Si una conversación está en varias bandejas, se aplica el horario de la primera bandeja por orden alfabético, algo que conviene saber antes de nombrar tus bandejas.
La trampa de la zona horaria de los informes
Este es el problema que yo arreglaría antes de la primera reunión de revisión entre sedes. Tus sedes compararán cifras, y puede que no estén mirando las mismas cifras.
El documento de zona horaria de Analytics de Zendesk dice "Analytics uses the Timezone in the user profile", y eso abarca paneles, exportaciones y el generador de informes. Un responsable en Manila y otro en Austin pueden abrir el mismo panel y ver horas pico distintas, volúmenes diarios distintos y totales de "hoy" distintos. Ninguno se equivoca. Solo cortan el día en puntos diferentes.
Otras herramientas van al revés. Los temporizadores de tickets de Freshdesk se basan en "the Helpdesk time zone". La zona horaria de la empresa en Help Scout "is shown on reports", mientras que sus exportaciones XLSX están en UTC y las exportaciones CSV usan la zona de la empresa. Así que un equipo de Help Scout que pega una exportación XLSX junto a una captura del panel puede estar comparando dos días distintos sin darse cuenta.
Tres reglas que dejaría por escrito:
- Elige una zona horaria de informes (UTC es la menos política) y úsala para cada cifra entre sedes. Pide a los responsables en Zendesk que configuren su perfil con ella al crear informes compartidos, o usa las entregas de paneles, que según Zendesk usan "the recipient's time zone".
- Mide los SLA en horario laboral, con el calendario propio de cada sede, para que una sede no sea penalizada por las horas en que estuvo cerrada. Mi guía de métricas de horario laboral en Zendesk Explore muestra cómo.
- Compara primero cada sede consigo misma. Un turno de noche ve un volumen y unos tipos de ticket distintos. Una respuesta en Reddit sobre métricas de soporte públicas lo dijo con sencillez:
"Someone who's working part-time or working the graveyard shift will likely have fewer messages sent than someone full time, CSAT can be skewed by one (or more) unfair review, etc."
Usa los KPIs de atención al cliente que ya mides, pero desglósalos por grupo y turno antes de comparar personas.
Mantén la calidad consistente entre sedes
Si la base de conocimiento es de donde salen las respuestas, el QA es cómo averiguas si cada sede las está dando de verdad. La trampa en los equipos distribuidos es que cada sede hace su propio QA, con sus propios revisores y su propia idea de un "4 sobre 5". Entonces las puntuaciones parecen comparables cuando no lo son.
La solución son dos hábitos: una hoja de evaluación compartida y calibración regular entre sedes. Zendesk describe la calibración como "having all your reviewers rate the same batch of conversations and compare their scores". Hazlo cada semana con al menos un revisor de cada sede, y las diferencias de puntuación te dirán dónde se han separado las sedes.
Las herramientas de QA integradas varían mucho:
- Zendesk QA necesita el complemento de QA (sin precio público) o el paquete Workforce Engagement de
$50. Mi guía de Zendesk QA y el artículo de criterios de la hoja de evaluación lo cubren. - Front Smart QA cuesta
$20por puesto como complemento o viene con Enterprise. Puntúa las conversaciones con IA según los criterios que elijas. - Gorgias Auto QA está "available on all Helpdesk plans with an AI Agent subscription". Puntúa los tickets 12 horas después de cerrarse en cuanto a integridad de la resolución, comunicación y dominio del idioma.
- Freshdesk y Help Scout no tienen hoja de evaluación de QA para agentes humanos en su documentación, así que tendrías que usar una hoja de cálculo o una herramienta de QA aparte.
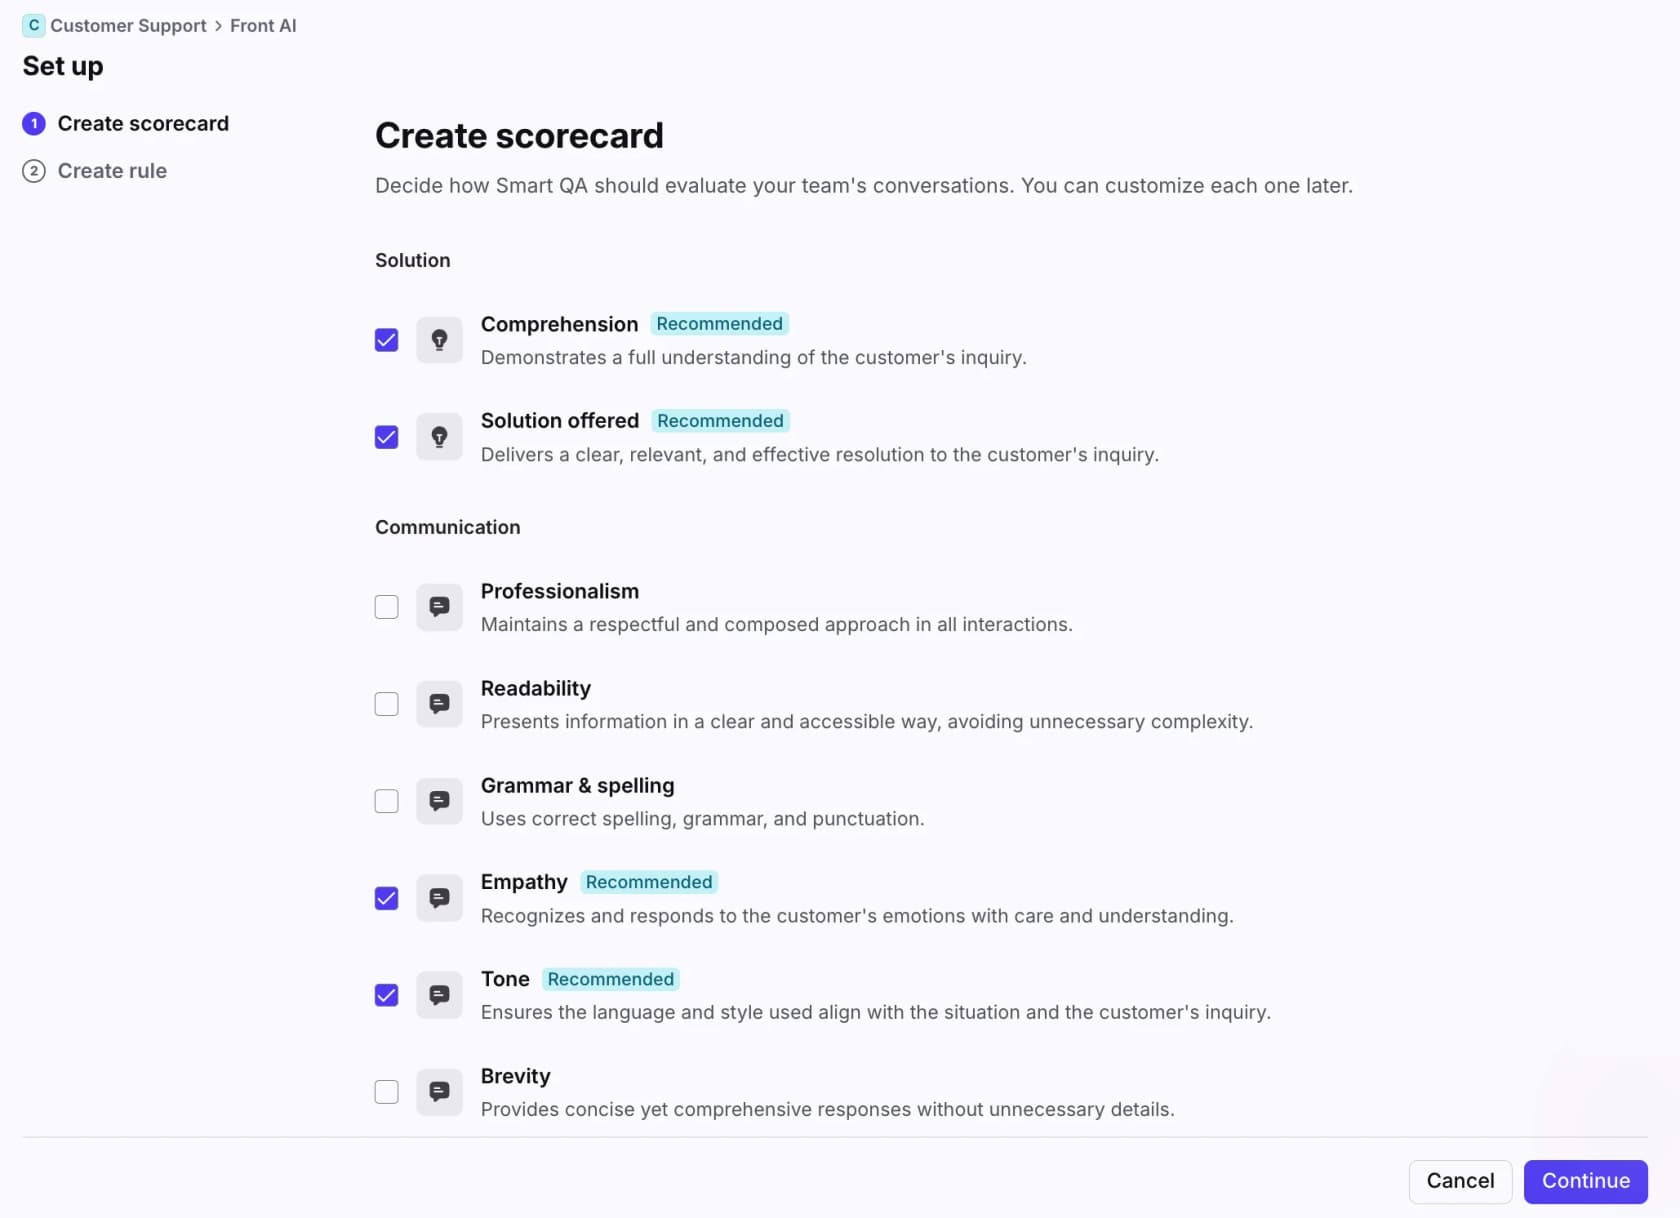
Una advertencia desde el lado del agente. El QA solo funciona si los agentes confían en que la hoja de evaluación y la base de conocimiento coinciden. Un agente de soporte de un equipo interno dirigido "como un BPO" describió lo que pasa cuando no coinciden, en una publicación sobre disputas de QA:
"...even if it's clearly a system fault or not even in the knowledge base, agents still get blamed. Even when we point out that it's not in the knowledge base, they still make excuses."
Así que cuando una revisión de QA señale una respuesta equivocada, primero pregunta si la respuesta correcta estaba escrita en algún sitio. Si no, es una brecha de conocimiento, no un problema del agente. Regístralas por separado. La guía de feedback a agentes en Zendesk QA explica cómo cerrar el ciclo con los agentes.
Una base de conocimiento, de todos
Gran parte de la deriva en un equipo distribuido se remonta a conocimiento que vive en las cabezas, chats o documentos privados de una sede. La sede que estuvo en la reunión de política lo sabe; las demás se enteran por un cliente enfadado.
La regla es fácil de decir y difícil de mantener: si una respuesta no está en la base de conocimiento compartida, no existe. Cada artículo tiene un responsable con nombre. Todas las sedes pueden proponer cambios. Un cambio de política no está "hecho" hasta que se actualiza el artículo. Mi guía de gestión del conocimiento con IA cubre la responsabilidad y los ciclos de revisión, y el artículo de gestión de la base de conocimiento cubre las auditorías.
Cuidado también con el fallo opuesto: una persona que mantiene todo vivo en silencio. Una respuesta en Reddit a un formador de centro de llamadas, cuyas guías personales resultaron estar sosteniendo una cuenta externalizada, lo resumió:
"Love how everyone took your knowledge base and its regular updates for granted and no one at any level questioned who was maintaining that or where."
Si incorporas a un nuevo socio o sede, el plan de transferencia de conocimiento de soporte offshore te da una estructura de 30 días. Para mercados con otros idiomas, un centro de ayuda multilingüe mantiene una sola fuente con traducciones en lugar de una copia por sede.
El ritmo operativo que mantiene alineadas a las sedes
Las herramientas compartidas evitan que empiece la deriva. Un ritmo regular detecta la deriva que se cuela de todos modos. Esta es la cadencia con la que empezaría:
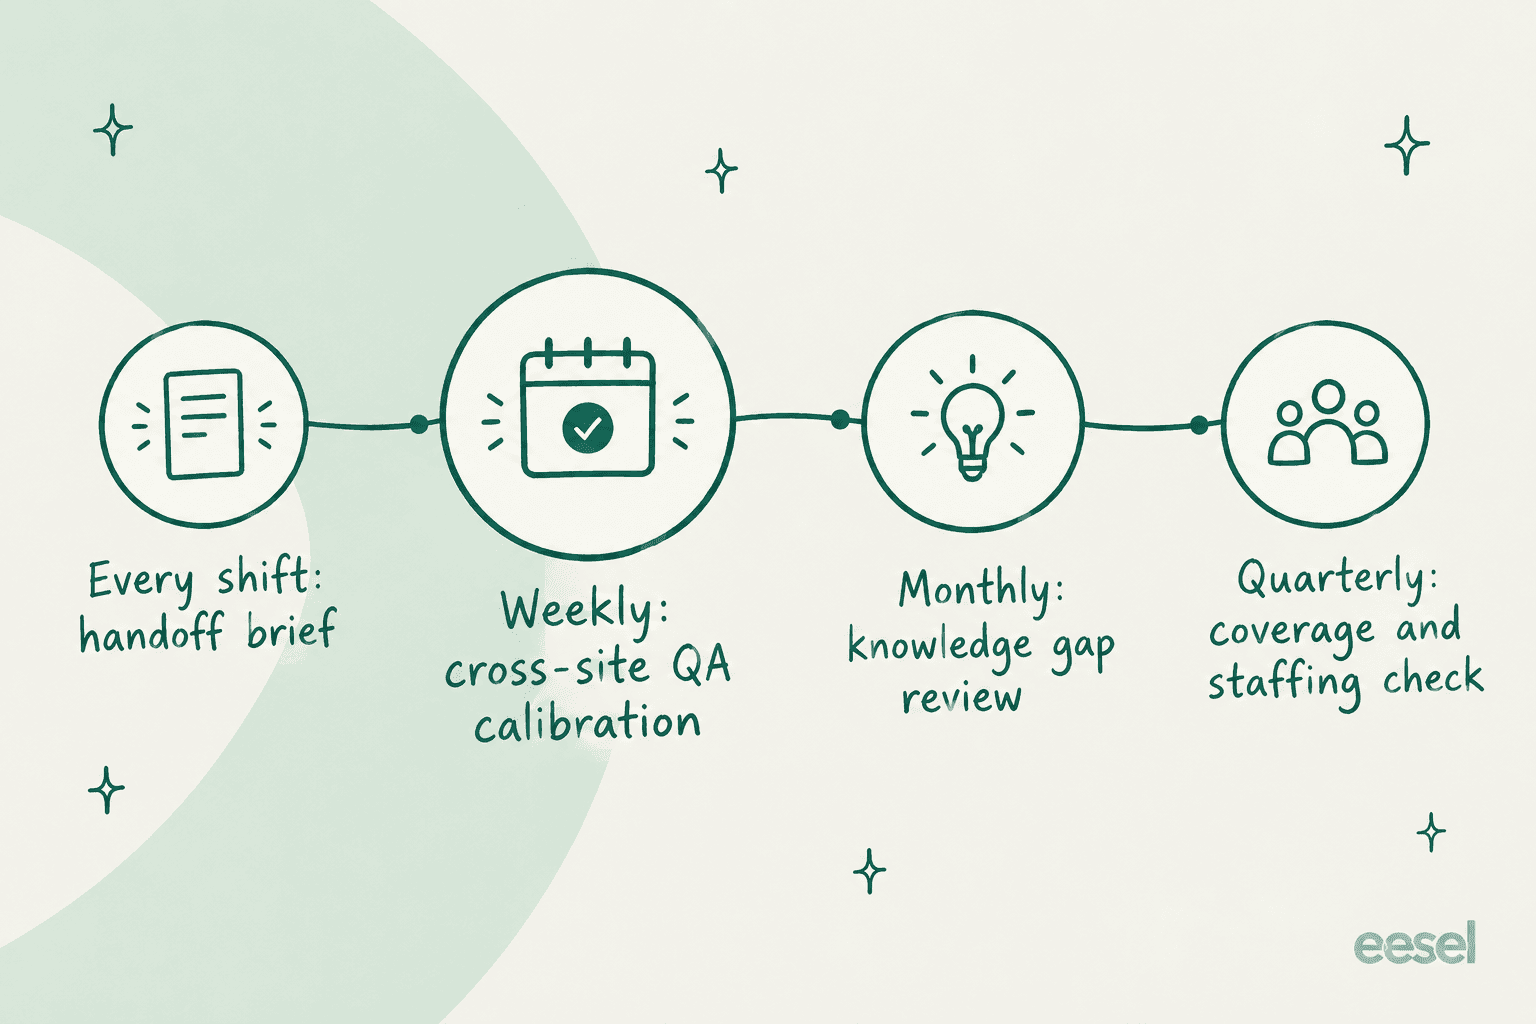
- Cada turno: un informe de traspaso. Un mensaje para la siguiente sede con las escalaciones abiertas, las promesas pendientes y cualquier cosa inusual en la cola. La guía de traspaso de turno en soporte incluye una plantilla y una rutina de 45 minutos.
- Cada semana: calibración de QA entre sedes. Revisores de todas las sedes puntúan los mismos cinco a diez tickets y comentan las diferencias.
- Cada mes: revisión de brechas de conocimiento. Repasa los tickets etiquetados "no article" o "wrong article" y arregla la base de conocimiento. Cuenta cuántos vinieron de cada sede.
- Cada trimestre: revisión de cobertura y dotación. Mira el volumen por hora en tu única zona horaria de informes y contrástalo con cuándo trabaja cada sede. Aquí decides si añadir un centro, ampliar el solapamiento o dejar que la IA cubra un tramo tranquilo.
Conviene proteger el tiempo de solapamiento en ese horario. Un miembro de un equipo de operaciones de red en Reddit describió por qué funciona su hora de solapamiento:
"It works well, there is approximately an hour overlap on each shift so if there is a fire or ongoing WebEx the new shift can be briefed on what's been done to troubleshoot the issue already and have a decent understanding."
El solapamiento no es barato, sin embargo. Un ingeniero de un equipo con dos zonas horarias señaló que su configuración dividida "works well, but it is expensive". Ese coste es la razón por la que importa la revisión trimestral: es donde ves qué horas necesitan realmente a una persona.
Dónde encaja la IA en las operaciones de soporte distribuido
La IA se gana su lugar en un equipo distribuido de dos maneras: cubre las horas entre sedes y elimina una de las mayores fuentes de deriva, que es que distintas personas respondan de forma distinta a la misma pregunta.
En eesel he visto al compañero de helpdesk con IA de eesel funcionar en colas donde esto importa. Anytime Fitness atiende a socios en más de 5.000 gimnasios en más de 40 países; antes de eesel, un socio que hacía una pregunta a las 10 p. m. esperaba hasta la mañana. Gcore ofrece soporte global 24/7 con dos bots, uno para clientes y otro para sus propios agentes. Y un fabricante de hardware B2B en Zendesk gestiona tickets en cuatro idiomas con el mismo agente.
Así encaja un compañero con IA en la configuración anterior:
- La misma respuesta en cada sede. Aprende de tus tickets anteriores, centro de ayuda, macros y documentos, así que da una sola respuesta sin importar en qué horario escriba el cliente. Eso resuelve el problema de consistencia en origen.
- Cubrir el hueco entre sedes. Responde tickets rutinarios a cualquier hora y deja el resto, etiquetado, para el turno de la siguiente sede.
- Cobertura de idiomas. Responde en el idioma del cliente, lo que puede sustituir a una cola por idioma que no puedes dotar las 24 horas.
- Resúmenes de traspaso. Los trabajos programados de eesel pueden ejecutar un prompt como un resumen diario de los tickets de las últimas 24 horas, a una hora fija en una zona horaria fija, para el informe de la siguiente sede.
- Respuestas internas para agentes. Un segundo bot que responde las preguntas de tus agentes desde la misma base de conocimiento, como hace Gcore, ayuda a que las sedes nuevas se pongan al día sin esperar a que otra región se despierte.
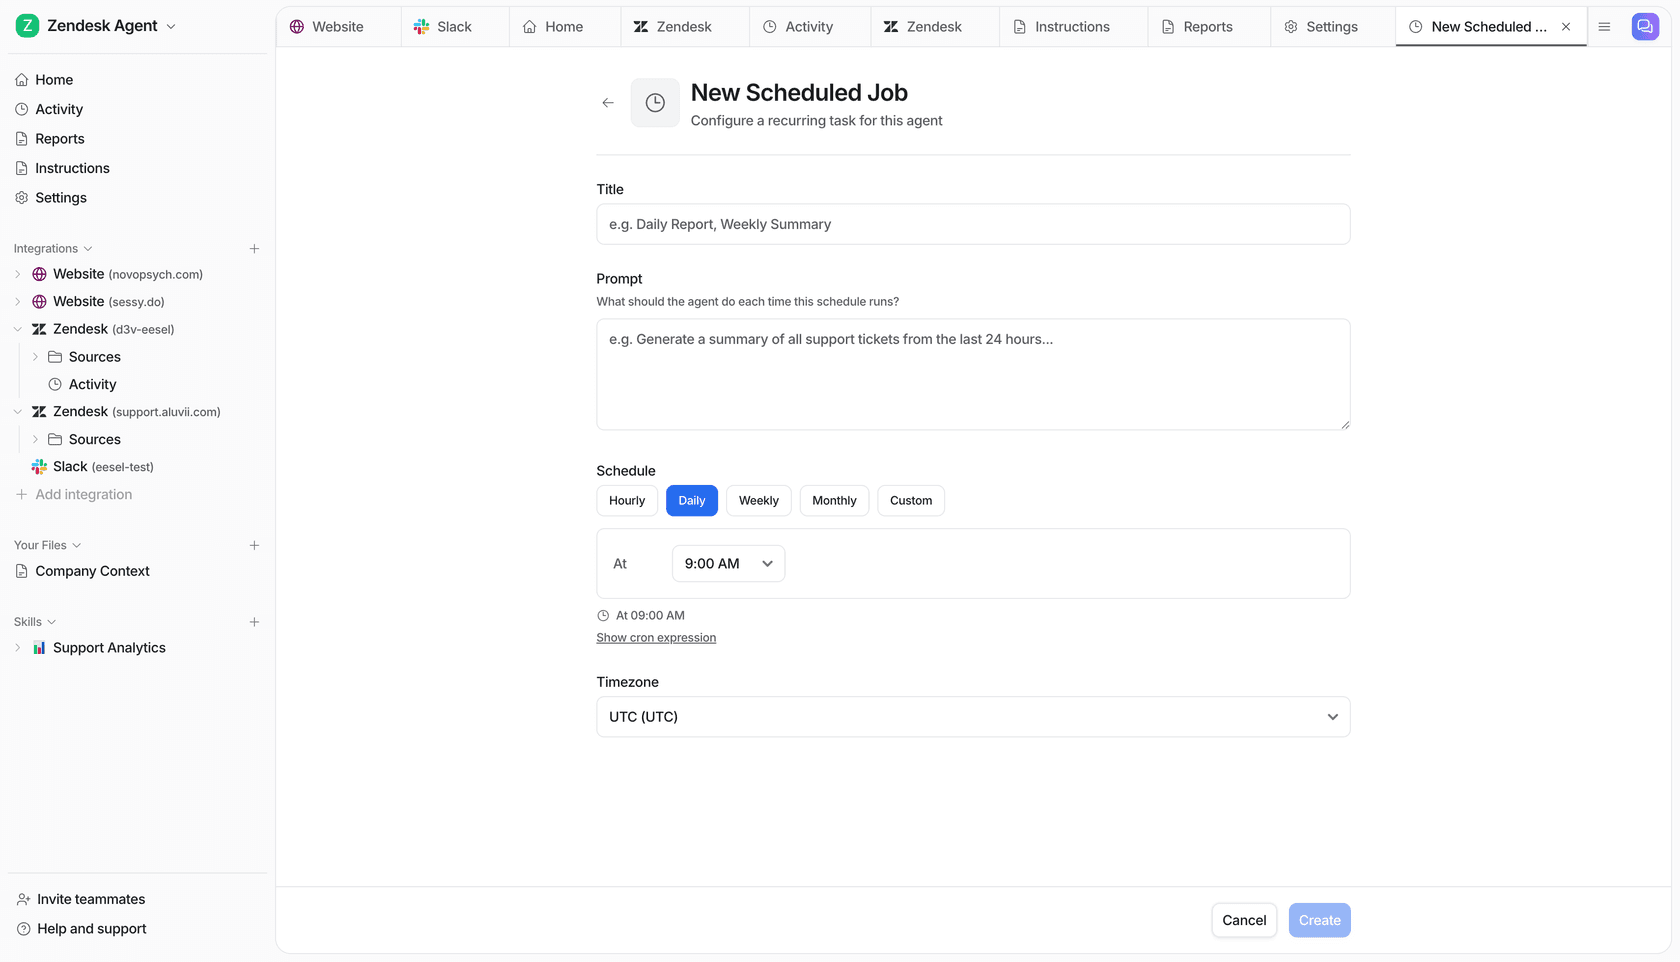
Una lección de implantaciones reales: mantén el horario laboral y la lógica de enrutamiento en los ajustes del propio helpdesk. Un cliente veterano de eesel se topó con un comportamiento inconsistente de horario laboral y zona horaria cuando esas reglas vivían solo en las instrucciones de la IA. Los horarios, los SLA y el enrutamiento pertenecen a Zendesk, Freshdesk o el helpdesk que uses. Deja que la IA se ocupe de respuestas y resúmenes, y que el helpdesk se ocupe del reloj.
Empieza en modo borrador, donde la IA escribe respuestas como notas internas para que los agentes las revisen, y simúlala con tus tickets anteriores antes de que responda a clientes. Mi reseña del agente de helpdesk con IA y la guía de soporte 24/7 con IA profundizan en la implantación.
Errores comunes en el soporte distribuido
- Una bandeja por sede. Oculta la carga de trabajo y deja tickets abandonados. Usa una cola y enruta.
- Dar por hecho que tu plan admite varios horarios. Zendesk Professional no. Compruébalo antes de diseñar la configuración sobre eso.
- Comparar sedes en distintas zonas horarias. Acuerda primero una zona horaria de informes.
- QA separado por sede. La misma hoja de evaluación, calibración compartida, o las puntuaciones no significan nada una al lado de otra.
- Conocimiento por sede. Un documento específico de una sede es el comienzo de una respuesta específica de esa sede.
- Premiar el cierre en una sede y la resolución en otra. Las sedes optimizan lo que se les mide. Mídelas igual.
- Poner el reloj en las instrucciones de la IA. El horario laboral pertenece a la configuración del helpdesk.
Si estás valorando si añadir siquiera una sede, mi comparación de costes IA frente a offshore hace los números, y software de helpdesk para equipos remotos compara las herramientas.
eesel para equipos de soporte distribuido
Si tus sedes dan respuestas ligeramente distintas a las mismas preguntas, o hay un tramo de horas que ninguna cubre bien, el compañero de helpdesk con IA de eesel está hecho para ese hueco. Se une a tu cola existente en Zendesk, Freshdesk, Gorgias, Front o Help Scout, aprende de los tickets que todas tus sedes ya han respondido y responde igual a cualquier hora y en el idioma del cliente.
Puedes probarlo con cientos de tus tickets anteriores antes de que toque uno en vivo. Y como los precios son por ticket gestionado con puestos ilimitados, añadir a cada agente de cada sede no cuesta nada extra.

Prueba eesel gratis y mira cómo es tu cola cuando todas las sedes parten de la misma respuesta.