

Die beste Qwen 4 Max Alternative für die meisten Coding- und Agentenaufgaben ist Claude Sonnet 5.5 bei 2 $/10 $ pro Million Token, mit Claude Opus 5.5 für schwere Aufgaben und DeepSeek V4.1 Flash (0,15 $/0,60 $ außerhalb der Spitzenzeit) für Massenarbeit. Aber prüfen Sie eine Sache, bevor Sie wechseln: Alibaba hat am 16. November das GA qwen4-max veröffentlicht, zu 1,50 $/4,50 $. Wenn Ihnen die Preview gefallen hat, ist der Wechsel einer einzigen Modell-ID günstiger als jeder andere Wechsel.
Wenn die Preview einen Support-Bot betrieben hat, übernimmt eesel diese Aufgabe, ohne dass Sie ein Modell auswählen müssen, und die eesel CLI lässt einen Coding-Agenten Ihre Hilfe-Dokumente laden und Antworten testen, bevor es live geht.
Was passiert mit Qwen 4 Max am 25. November?
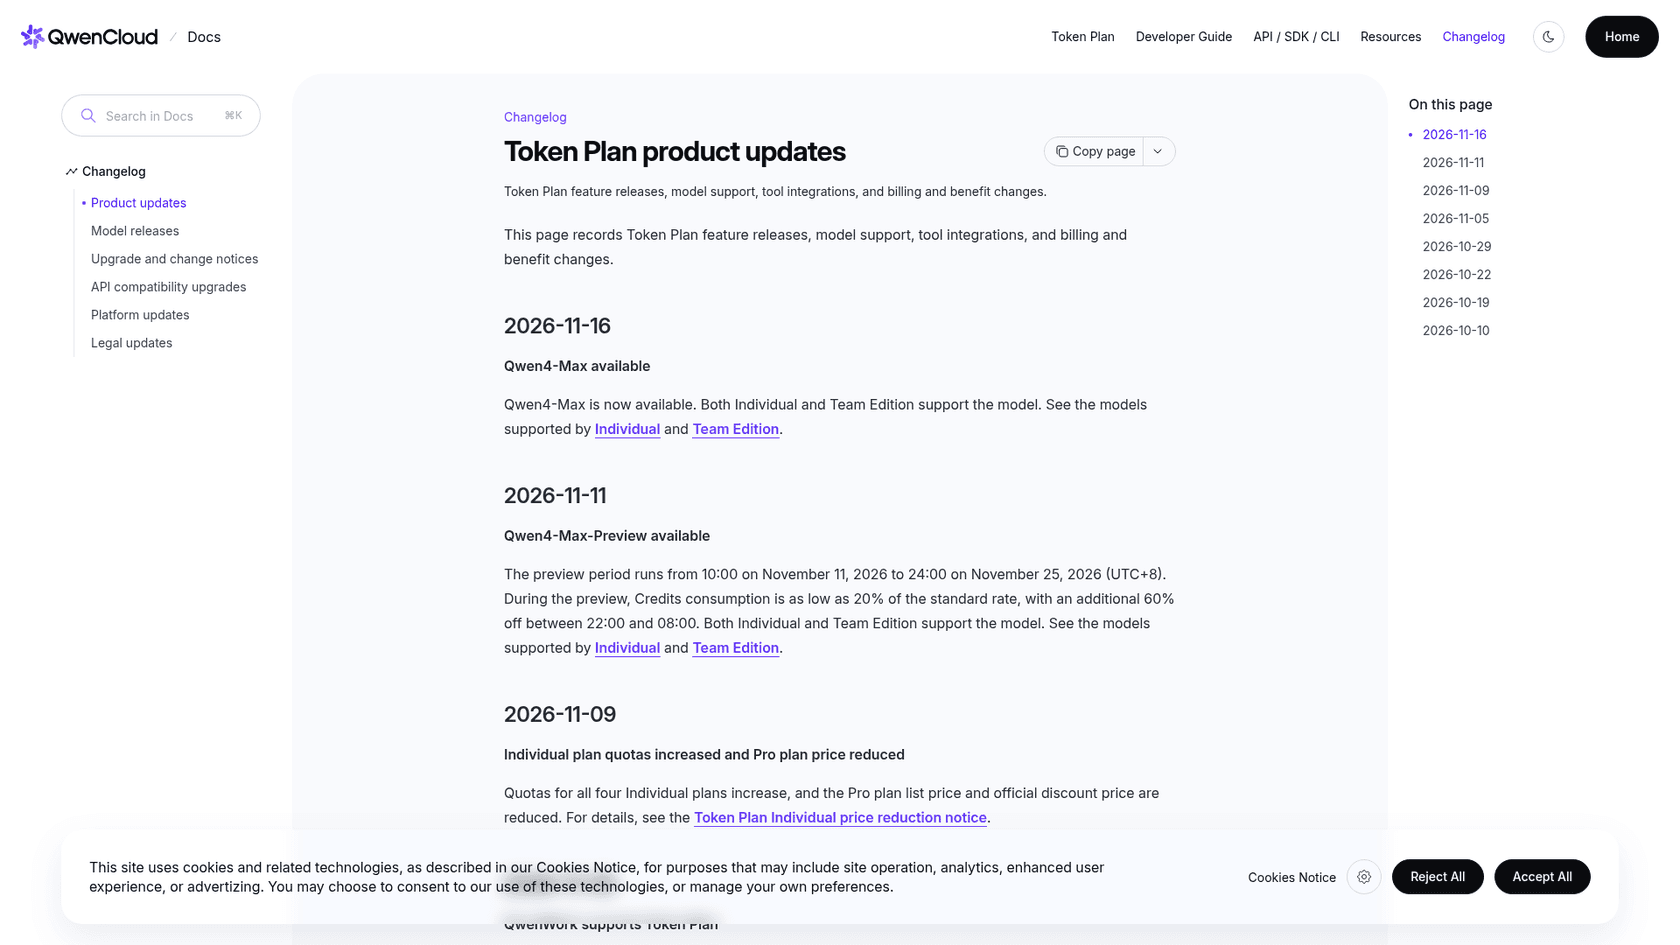
Die Preview endet. Alibabas Token-Plan-Changelog sagt, dass qwen4-max-preview vom 11. November, 10:00 Uhr, bis zum 25. November 2026, 24:00 Uhr (UTC+8), läuft, und die Token-Plan-Dokumentation sagt, das Modell wird nach Ende der Preview abgeschaltet. Jeder Agent, jedes Skript oder jede Claude Code-Konfiguration, die noch auf diese ID zeigt, bricht am 26. ab.
Was die meisten Berichte übersehen, ist der nächste Eintrag im selben Changelog. Am 16. November hat Alibaba qwen4-max allgemein verfügbar (GA) gemacht, auf Token Plan Personal, Token Plan Team und der Pay-as-you-go-API. Die Frage ist also nicht mehr „Qwen oder etwas anderes“, sondern „das GA-Qwen, oder etwas Besseres für meine Workload“.
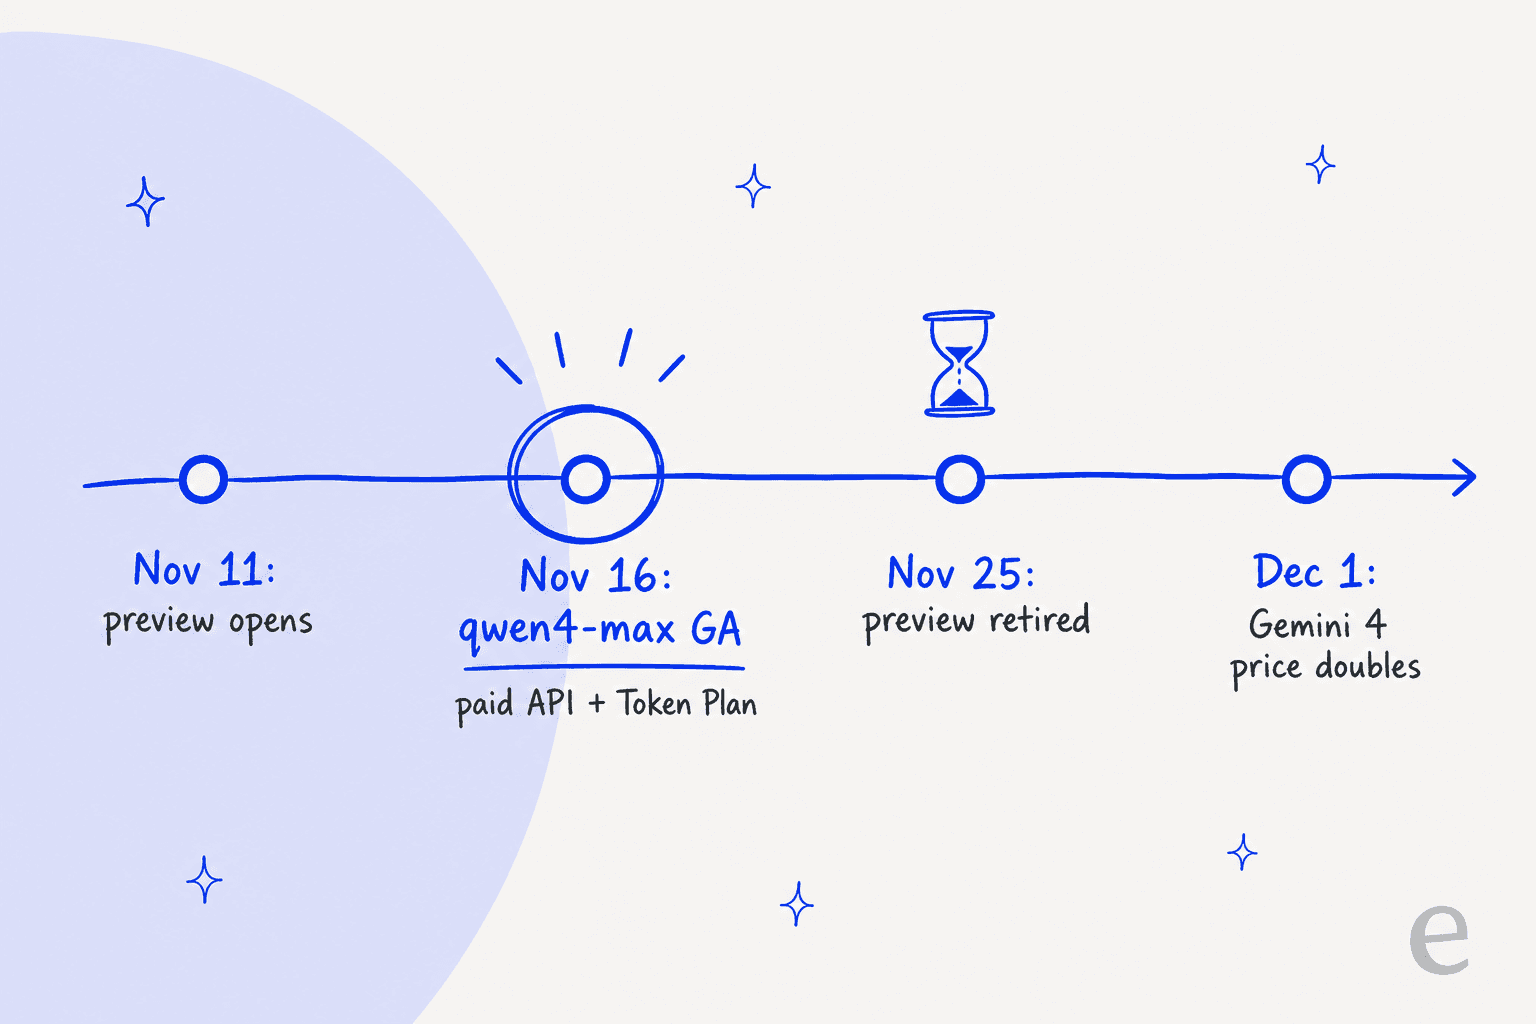
Auch dieser letzte Termin ist wichtig. Zwei der unten genannten Alternativen, Gemini 4 Argon und Gemini 4 Carbon, haben Einführungspreise, die sich am 1. Dezember verdoppeln, sodass sich eine Entscheidung, die auf der Preisliste dieser Woche basiert, innerhalb von zwei Wochen zweimal ändern kann.
Ich bin Alicia, und ich baue Funktionen und KI-Agenten bei eesel. Wir setzen seit Jahren Modelle hinter echten Support-Warteschlangen ein, und die Lehre aus jeder erzwungenen Migration ist dieselbe: Welches Modell Sie wechseln, ist weniger wichtig als ob Sie es zuerst an Ihrer eigenen Arbeit getestet haben. Jede Auswahl unten kommt mit dem Preis für einen festgelegten Käufer, damit Sie sie an einer Zahl vergleichen können, bevor Sie testen.
Sollten Sie einfach zum GA qwen4-max wechseln?
Für die meisten Menschen, denen die Preview gefallen hat: ja. Hier ist, was sich zwischen den beiden Modellen ändert, alles aus Alibabas Qwen4-Max-Dokumentation:
| qwen4-max-preview | qwen4-max (GA) | |
|---|---|---|
| Status | Nach dem 25. Nov. abgeschaltet | Allgemein verfügbar seit 16. Nov. |
| Wo Sie es nutzen können | Nur Token Plan | Token Plan Personal, Token Plan Team, Pay-as-you-go-API |
| Preis | Credits zu 20 % des Standardtarifs (8 % nachts) | 1,50 $ Input / 4,50 $ Output pro 1 Mio. Token (Singapur) |
| Kontextfenster | 1 Mio. Token | 1 Mio. Token |
| Max. Denken + Antwort | 393.216 Token | 262.144 Token |
| Reasoning-Aufwand | low, medium, xhigh | low, high (Standard), xhigh |
| Coding-Tools | Claude Code über Token Plan | Claude Code, Codex, OpenCode |
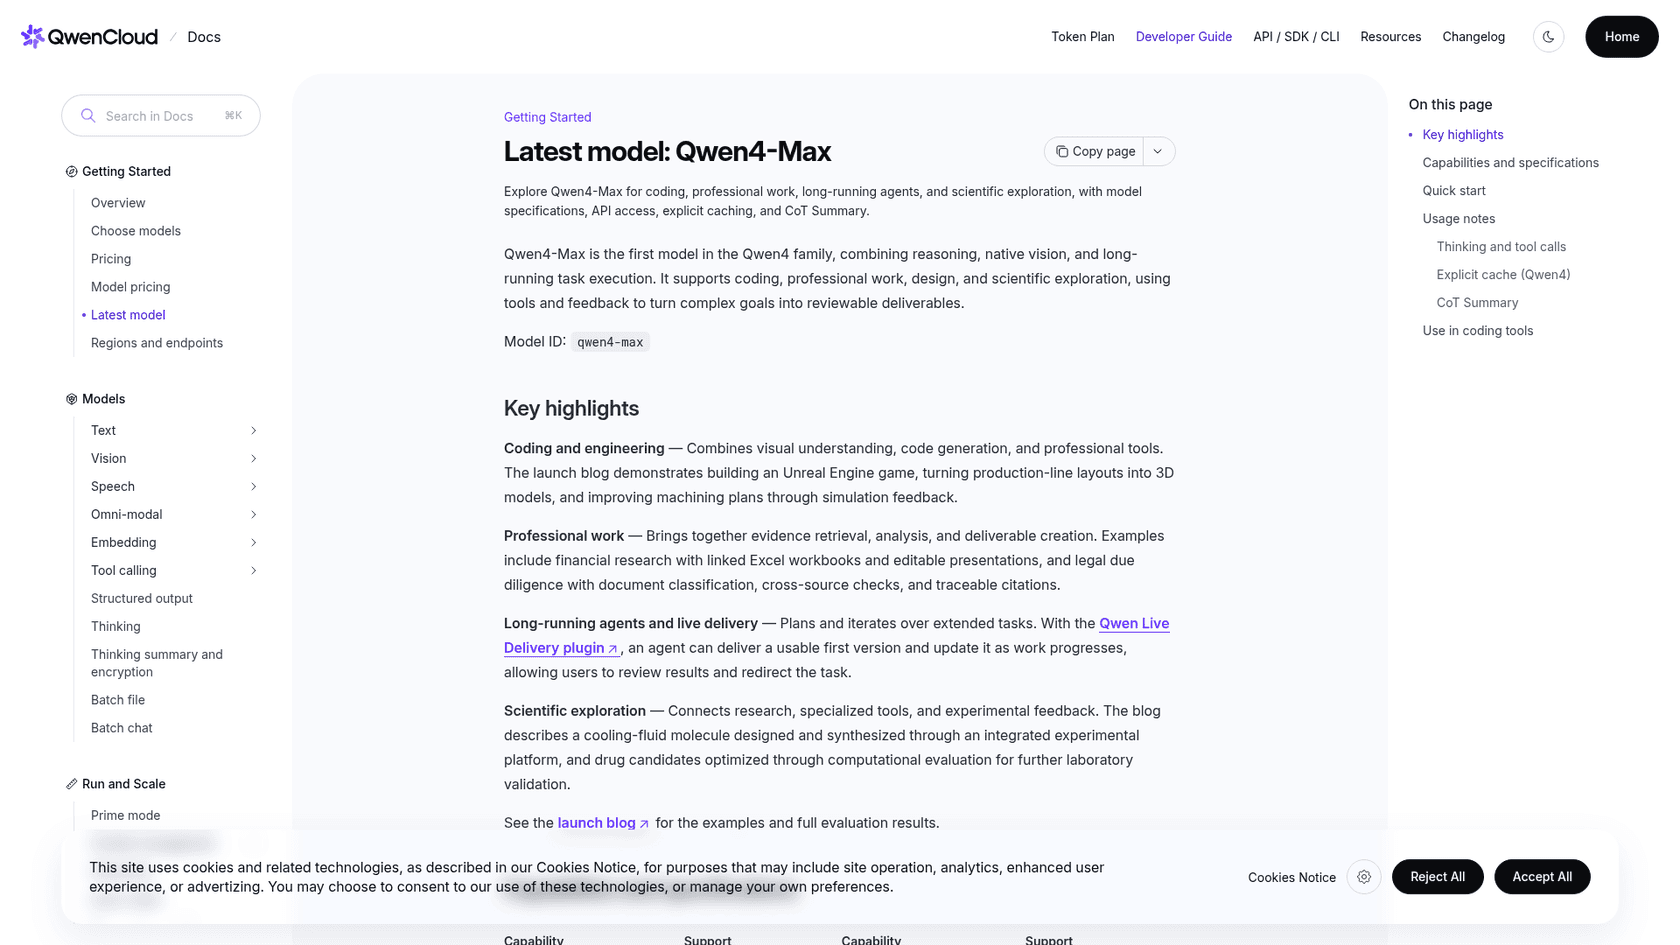
Drei Dinge fallen auf. Erstens, das GA-Modell ist günstiger als Qwen3.8-Max: Alibaba listet qwen3.8-max zu 2 $/6 $ in Singapur gegenüber 1,50 $/4,50 $ für qwen4-max, das neuere Flaggschiff ist also auch das günstigere. Zweitens fügt das GA-Modell explizites Caching mit einer TTL von 5 Minuten oder 1 Stunde und 0,075 $ Cache-Reads hinzu. Drittens verlieren Sie den Preview-Rabatt. Token-Plan-Nutzer zahlten während der Preview nur 20 % des Standard-Credit-Tarifs und nachts 8 %, laut der Token-Plan-Übersicht. Dieser Deal gilt nicht weiter, rechnen Sie also damit, dass Credits bei derselben Arbeit mehrfach schneller aufgebraucht werden.
Die Migration selbst ist eine Zeile. Im Claude Code-Setup, das wir letzte Woche dokumentiert haben, zeigte der Opus-Slot auf qwen4-max-preview; tauschen Sie ihn gegen qwen4-max aus und behalten Sie denselben Token-Plan-Schlüssel und -Endpunkt. Falls die Ausgabe abgeschnitten wird, prüfen Sie max_completion_tokens, denn das GA-Modell begrenzt Denken plus Antwort auf 262.144 Token.
Wann sollten Sie stattdessen wechseln? Wenn die Preview sich ihren Platz nie verdient hat. Alibaba hat über den Launch-Blog hinaus noch keine unabhängigen Benchmark-Ergebnisse in der Dokumentation veröffentlicht, und die Community-Stimmung während der Preview war gemischt:
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Wenn Sie vor allem wegen des 80-%-Rabatts auf der Preview waren oder einen Anbieter außerhalb von Alibaba Cloud brauchen, lesen Sie weiter.
Wie ich diese Alternativen ausgewählt und bepreist habe
Ich habe Modelle ausgewählt, die dieselben drei Aufgaben abdecken, für die Leute die Qwen 4 Max Preview genutzt haben: agentisches Coding in Tools wie Claude Code, Long-Context-Arbeit über ein 1-Mio.-Fenster und Tool-Calling in mehrstufigen Agenten. Jeder Preis stammt von der eigenen Preisseite des Anbieters, geprüft am 17. November 2026.
Um Preise pro Token vergleichbar zu machen, habe ich jedes Modell für einen Käufer bepreist: eine Entwicklerin, die 10 Mio. Input- und 1 Mio. Output-Token im Monat verbraucht, zum Standard-Listenpreis, ohne Caching- oder Batch-Rabatte. Das entspricht etwa einem arbeitsintensiven Monat Solo-Agentenarbeit. Caching verändert das Bild bei Agenten-Loops stark, daher lässt der Rechner weiter unten Sie Ihre eigene Cache-Trefferquote eingeben.
Qwen 4 Max Alternativen im Überblick
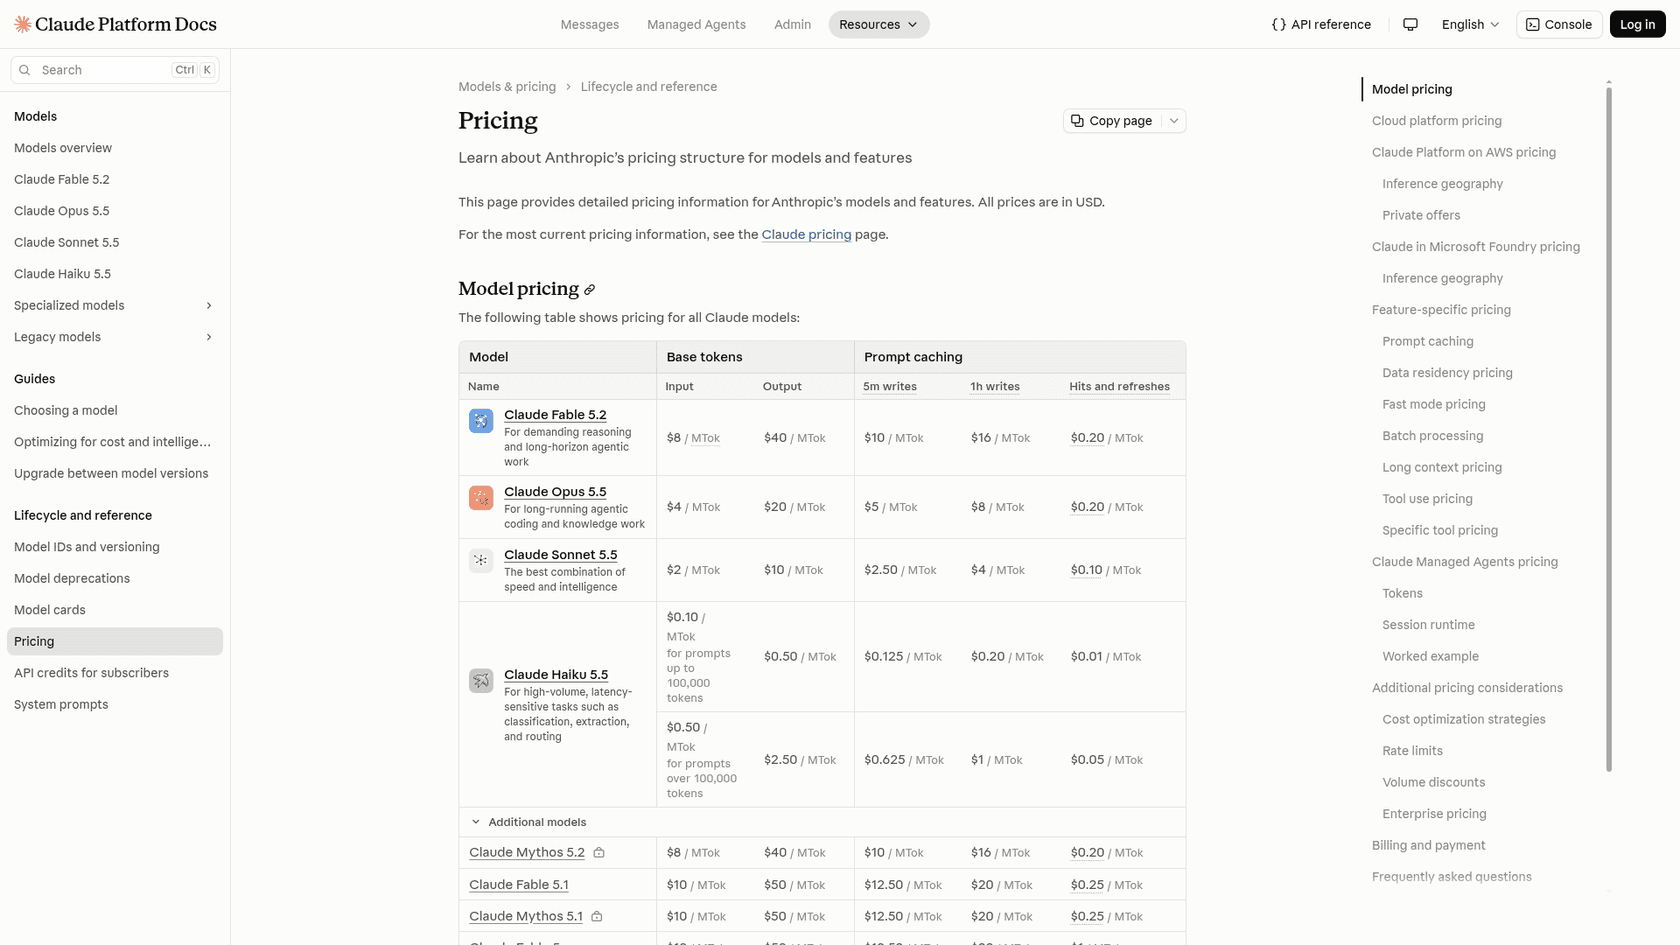
| Modell | Am besten für | Input / Output pro 1 Mio. | Cache-Read pro 1 Mio. | Monatskosten (10 Mio. In, 1 Mio. Out) | Kontext | Offene Gewichte | Abo-Option | Preis ändert sich bald |
|---|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | Täglicher Coding-Treiber | 2 $ / 10 $ | 0,10 $ | 30 $ | 1 Mio. | Nein | Claude-Pläne | Nein |
| Claude Opus 5.5 | Schwere Agentenaufgaben | 4 $ / 20 $ | 0,20 $ | 60 $ | 1 Mio. | Nein | Claude-Pläne | Nein |
| Claude Fable 5.2 | Die schwersten Aufgaben | 8 $ / 40 $ | 0,20 $ | 120 $ | 1 Mio. | Nein | Nutzungs-Credits auf Pro | Nein |
| GPT-6.1 Terra | Günstige Frontier-Klasse-Arbeit | 1 $ / 5 $ | 0,05 $ | 15 $ | Über 272K kostet 2x Input | Nein | ChatGPT-Pläne | Nein |
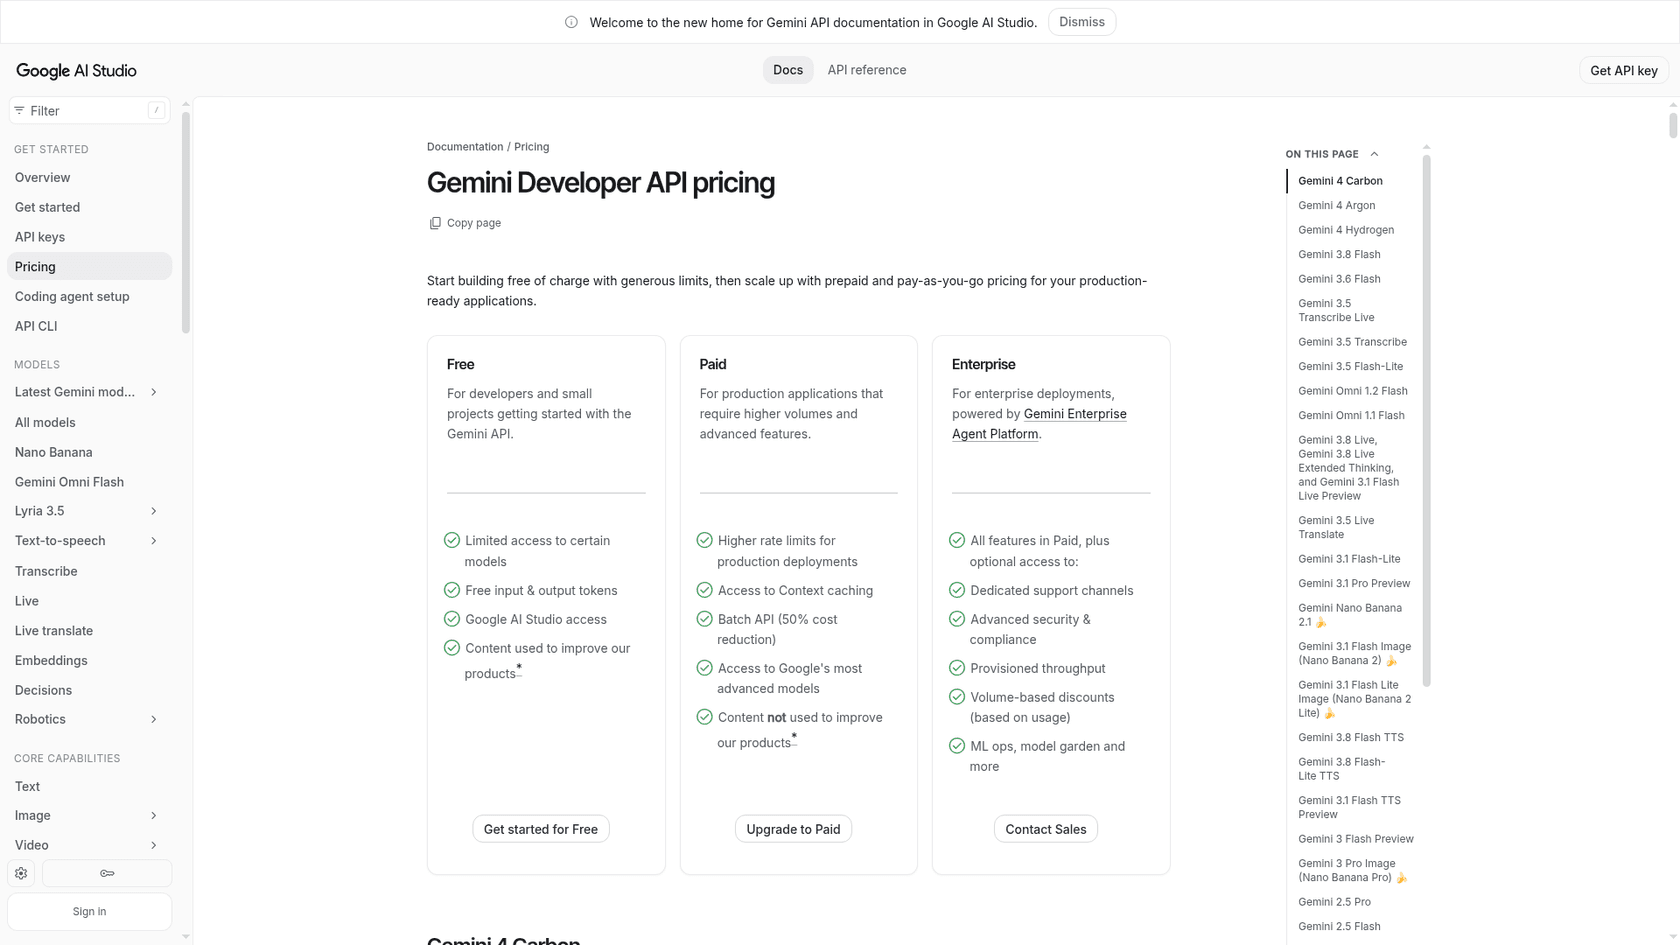
| Gemini 4 Argon | Schnelle Gemini-4-Arbeit | 2 $ / 10 $ | 0,10 $ | 30 $ (60 $ ab 1. Dez.) | 1 Mio. | Nein | Nein | Verdoppelt sich am 1. Dez. |
| Gemini 4 Carbon | Langfristige Agenten | 2 $ / 10 $ | 0,10 $ | 30 $ (60 $ ab 1. Dez.) | 1 Mio. | Nein | Nein | Verdoppelt sich am 1. Dez. |
| DeepSeek V4.1 Flash | Massen- und Budgetarbeit | 0,15 $ / 0,60 $ außerhalb der Spitzenzeit | 0,003 $ | 2,10 $ (4,20 $ zur Spitzenzeit) | 1 Mio. | Ja | Auch auf Token Plan | Nein |
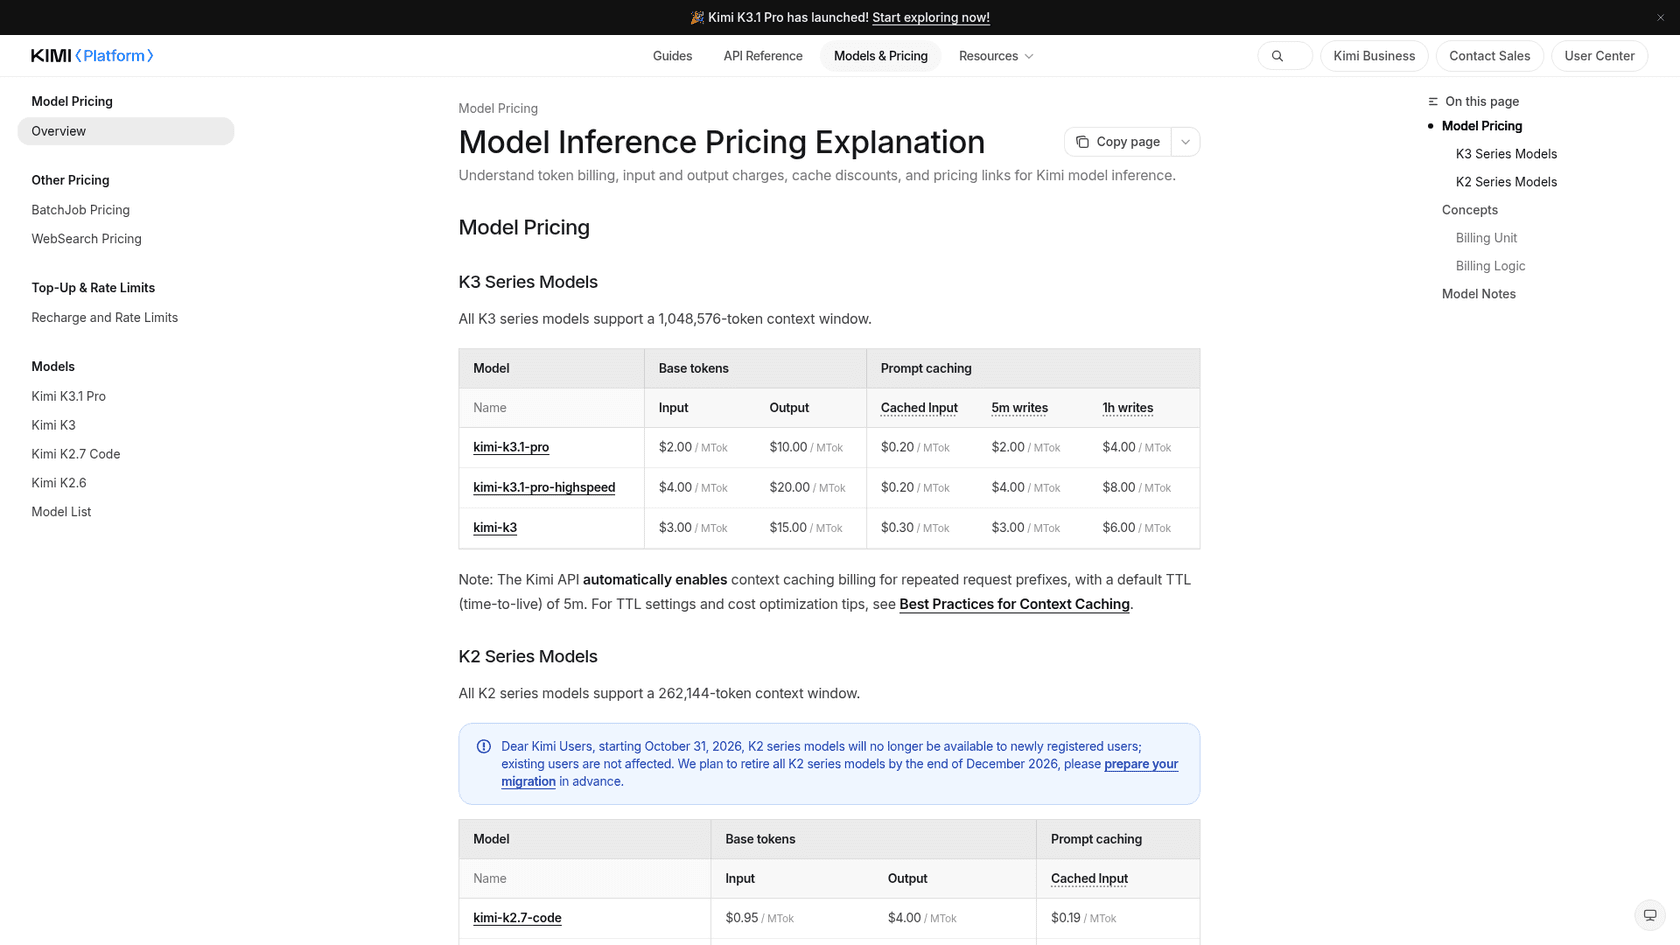
| Kimi K3.1 Pro | Nicht-US-Frontier-Option | 2 $ / 10 $ | 0,20 $ | 30 $ | 1 Mio. | Nein | 19 $ bis 199 $/Monat | Nein |
| Qwen3.8-Max | Bleiben auf Token Plan | 2 $ / 6 $ | 0,25 $ | 26 $ | 1 Mio. | Nein | Token Plan | Nein |
| qwen4-max (GA, zur Referenz) | Gleiches Modell, behalten | 1,50 $ / 4,50 $ | 0,075 $ | 19,50 $ | 1 Mio. | Nein | Token Plan | Nein |
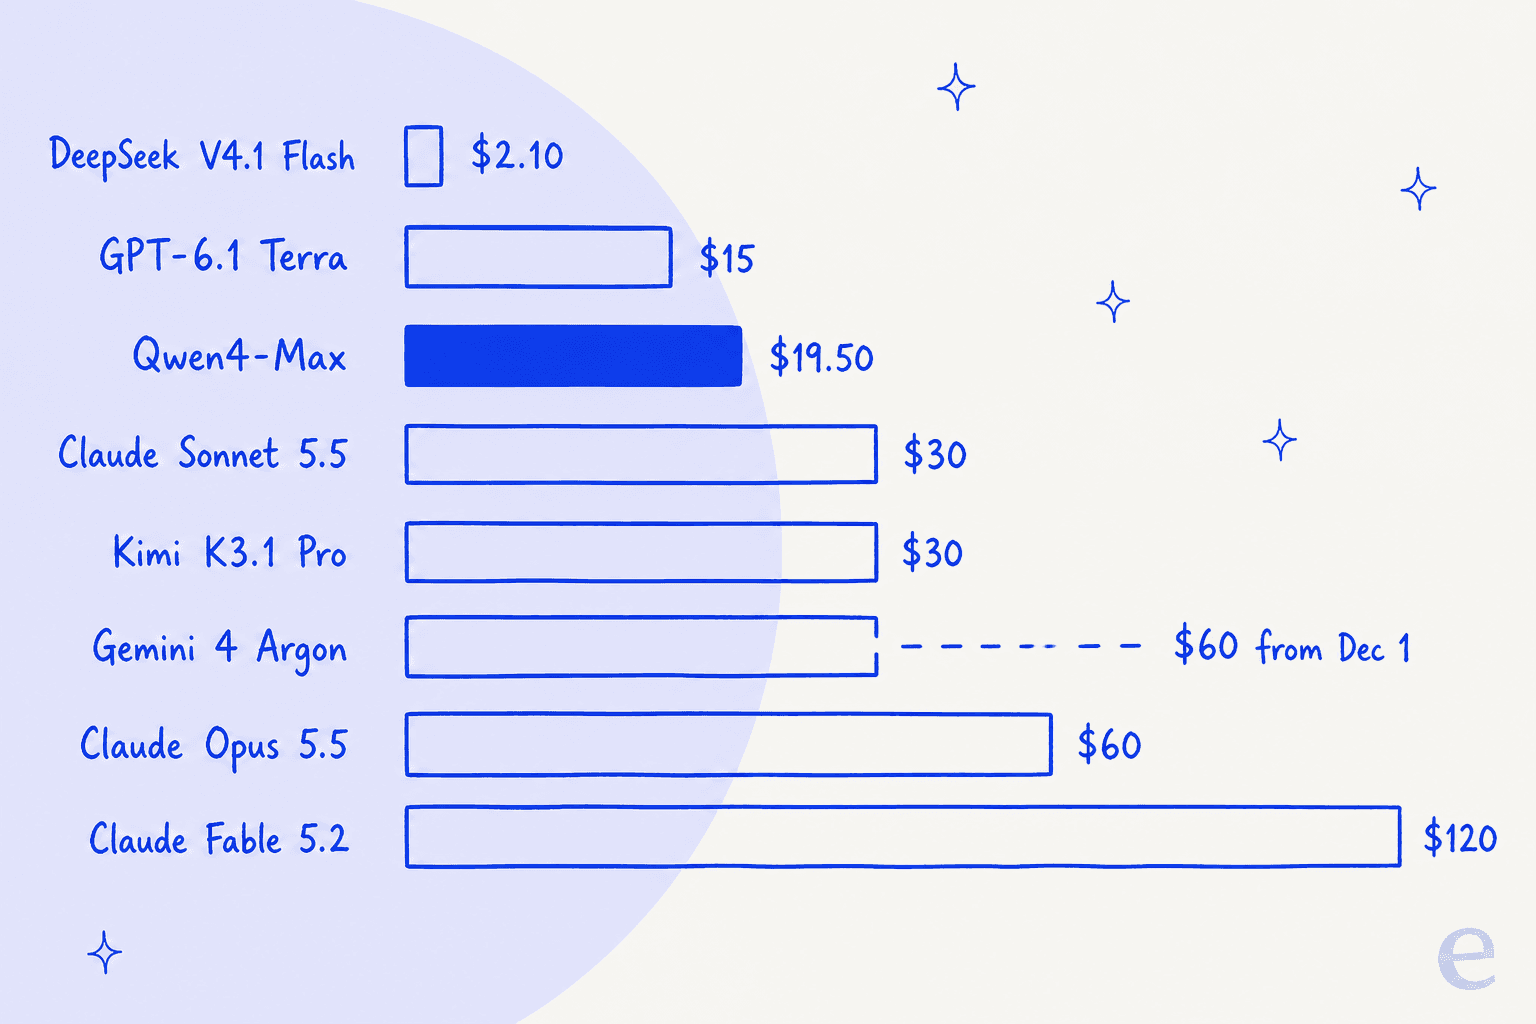
Das Diagramm ist die Überraschung, mit der die meisten Wechsler nicht rechnen: nur zwei Alternativen sind zum Listenpreis günstiger als das GA Qwen 4 Max. Alles andere kostet pro Monat mehr, ein Wechsel muss also um Qualität, Anbieterrisiko oder Tooling gehen, nicht um Einsparungen.
Rechnen Sie Ihre eigenen Monatskosten aus
Der 10-Mio./1-Mio.-Käufer ist ein Platzhalter. Geben Sie unten Ihr eigenes Volumen und Ihre Cache-Trefferquote ein. Gecachter Input wird zum Cache-Read-Preis jedes Anbieters abgerechnet; Cache-Writes und Batch-Rabatte bleiben außen vor, um den Vergleich einfach zu halten.
Probieren Sie eine Cache-Trefferquote von 70 %, normal für einen Agenten, der bei jeder Runde denselben System-Prompt und Repo-Kontext erneut sendet. Claude Sonnet 5.5 fällt von 30 $ auf etwa 16,70 $, und qwen4-max fällt auf etwa 9,53 $, sodass die Lücke auf rund 7 $ schrumpft.
Warum überhaupt von Qwen 4 Max wechseln?
Um fair zu Alibaba zu sein: Das GA-Modell löst die meisten Probleme der Preview: Es hat einen echten Preis pro Token, eine Pay-as-you-go-API und Unterstützung in Claude Code, Codex und OpenCode. Die Gründe, warum Menschen trotzdem wechseln, sind enger gefasst:
- Der Rabatt war der Anreiz. Bei 20 % des Standardtarifs war die Preview für Heavy-User fast kostenlos. Ein HN-Kommentator fasste den Reiz so zusammen: "By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!" (linzhangrun, Hacker News). Zu GA-Tarifen konkurrieren andere Modelle wieder beim Preis.
- Dünne öffentliche Beweislage. Kein unabhängiger Leaderboard-Eintrag für
qwen4-maxwar verfügbar, als ich geprüft habe, Teams, die vor der Produktion Zahlen brauchen, haben also wenig, worauf sie sich stützen können. - Anbieterkonzentration. Token Plan Personal wird aus Singapur verkauft und ist laut unserem Preis-Beitrag für interaktive Nutzung gedacht, nicht für Backend-Automatisierung. Wenn Sie ohnehin einen zweiten Anbieter brauchen, ist jetzt ein guter Zeitpunkt, einen zu wählen.
- Eine kürzere Output-Obergrenze. Die Obergrenze von Denken plus Antwort des GA-Modells liegt bei 262.144 Token, niedriger als die 393.216 der Preview, was bei sehr langen Einzelgenerierungen eine Rolle spielt.
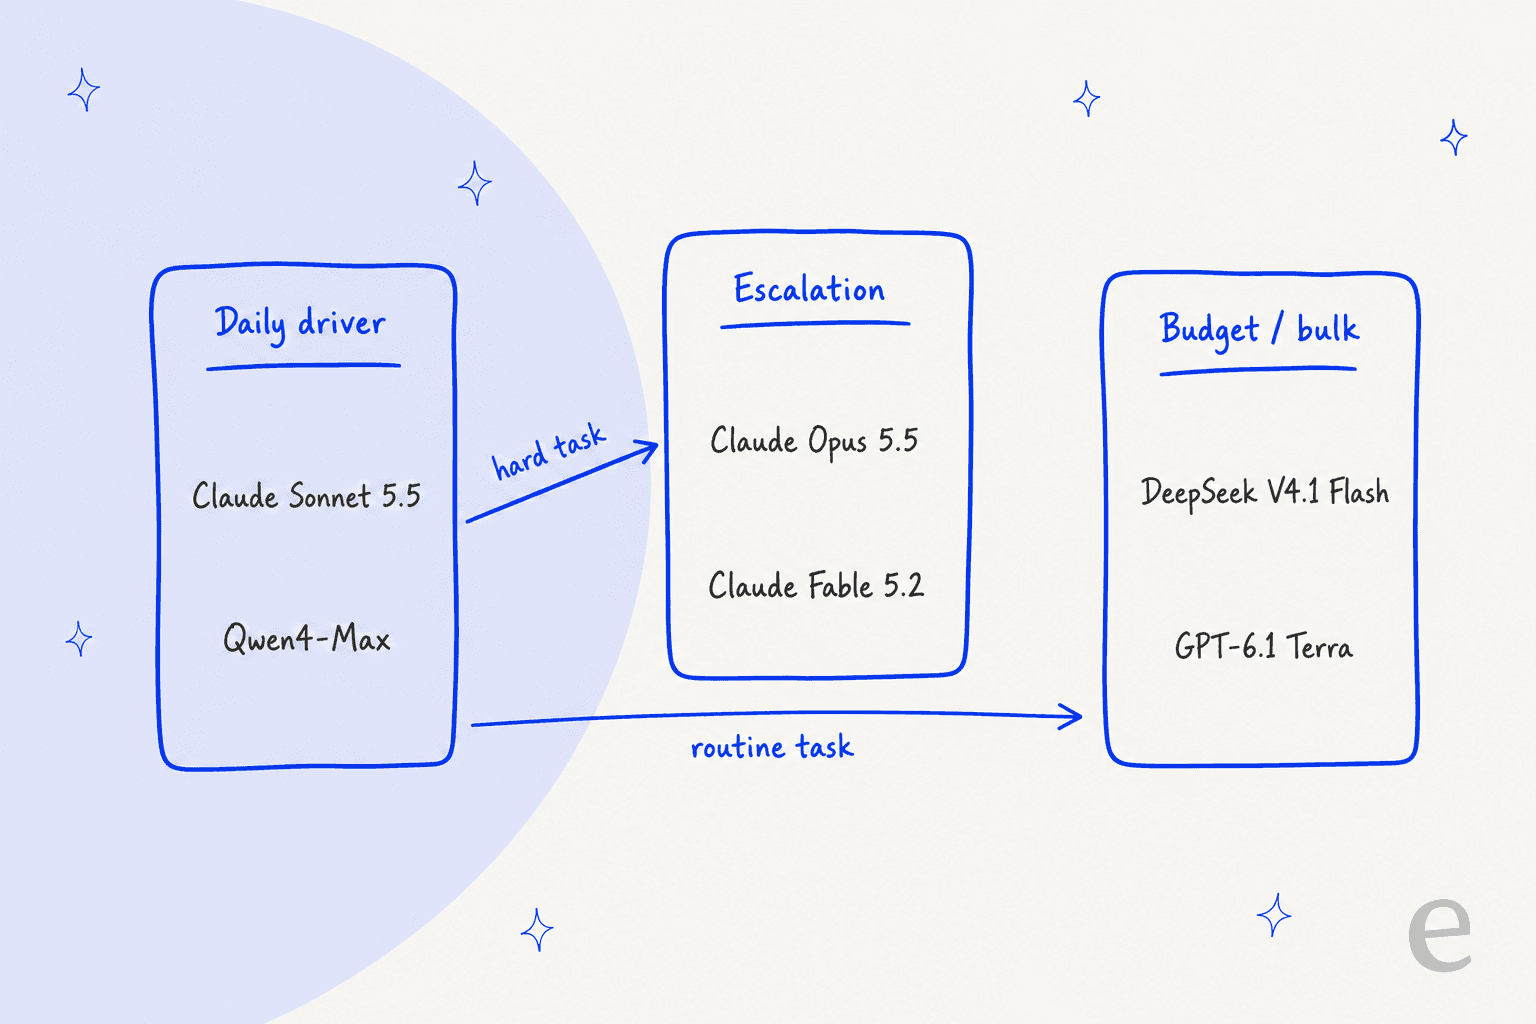
Die meisten sollten das nicht als einen Ersatz, sondern als drei Slots betrachten. ChatGPT gab denselben Ratschlag, als ich genau diese Frage gestellt habe: ein tägliches Modell, ein Eskalationsmodell und ein Budgetmodell.
1. Claude Sonnet 5.5
Am besten für: Ihr alltägliches Coding- und Agentenmodell, besonders innerhalb von Claude Code.
Was es gut macht
Sonnet 5.5 ist der nächstliegende Eins-zu-eins-Ersatz dafür, wie die meisten Leute die Qwen 4 Max Preview genutzt haben: ein starker agentischer Coder mit einem 1-Mio.-Token-Kontextfenster. Anthropics Sonnet-Seite sagt, es laufe 30 % schneller und koste bei den meisten Arbeiten bis zu 30 % weniger als Sonnet 5. Wenn Ihr Setup Claude Code war, das auf Alibabas Endpunkt zeigte, ist dies das Modell, um das Claude Code herum gebaut wurde, sodass sich Tool-Calling und Datei-Bearbeitungen so verhalten, wie das Harness es erwartet.
Pros
- Derselbe Preis von
2 $/10 $über das gesamte 1-Mio.-Fenster, ohne Long-Context-Aufschlag - Cache-Reads zu
0,10 $pro Million, günstiger als Opus 5.5 und Fable 5.2 - Im kostenlosen Claude-Plan für Chat-Nutzung enthalten
Cons
- Bei maximalem Aufwand hat Artificial Analysis es mit
7,60 $pro Aufgabe gemessen, mehr als Opus 5.5s5,98 $, laut unserer Sonnet 5.5-Preisanalyse 30 $pro Monat für den 10-Mio./1-Mio.-Käufer, etwa 50 % mehr als das GAqwen4-max
Pricing
2 $ Input und 10 $ Output pro Million Token, 0,10 $ Cache-Reads, laut Anthropics Preisseite. Für den 10-Mio./1-Mio.-Käufer: 10 x 2 $ + 1 x 10 $ = 30 $ im Monat.
Unsere Einschätzung: Wählen Sie Sonnet 5.5 als Standard, wenn Sie ein Modell wollen, das in Claude Code einfach funktioniert. Halten Sie es bei Low oder Medium Effort und eskalieren Sie zu Opus 5.5, statt Sonnet auf Max hochzudrehen.
2. Claude Opus 5.5
Am besten für: die schwersten 10 % der Aufgaben: repo-weite Refactors, kniffliges Debugging, lange autonome Durchläufe.
Was es gut macht
Opus 5.5 ist der Eskalations-Slot. Anthropic sagt auf seiner Opus-Seite, es performe bei den meisten Arbeiten auf dem Niveau von Claude Fable 5.1 und koste 40 % weniger im Betrieb als Opus 5, teilweise weil es mit weniger Token und Zügen fertig wird. Das Letztere zählt für Agenten: Der Preis pro Token ist nur die halbe Rechnung, und die Opus 5.5-Rezension behandelt, wie stark die Schrittzahl sinkt.
Pros
- Weniger Schritte pro Aufgabe, sodass die echte Rechnung niedriger ist, als die Preisliste vermuten lässt
- Die Batch-API halbiert beide Tarife auf
2 $/10 $ - Fast Mode verfügbar, wenn Latenz wichtig ist
Cons
4 $/20 $ist das 2,7-Fache des GA-Qwen-4-Max-Input-Preises und das 4,4-Fache des Output-Preises60 $im Monat für den 10-Mio./1-Mio.-Käufer, wenn Sie alles darüber laufen lassen
Pricing
4 $ Input, 20 $ Output, 0,20 $ Cache-Reads pro Million Token, laut Anthropics Preisseite. Für den 10-Mio./1-Mio.-Käufer: 40 $ + 20 $ = 60 $. Mehr Details in unserem Opus 5.5-Preisleitfaden.
Unsere Einschätzung: Machen Sie Opus nicht zu Ihrem Standard. Leiten Sie die Aufgaben, bei denen Sonnet oder Qwen hängen bleiben, an Opus 5.5 mit Medium Effort weiter, und Sie bekommen den größten Teil der Qualität für einen Bruchteil der All-Opus-Rechnung.
3. Claude Fable 5.2
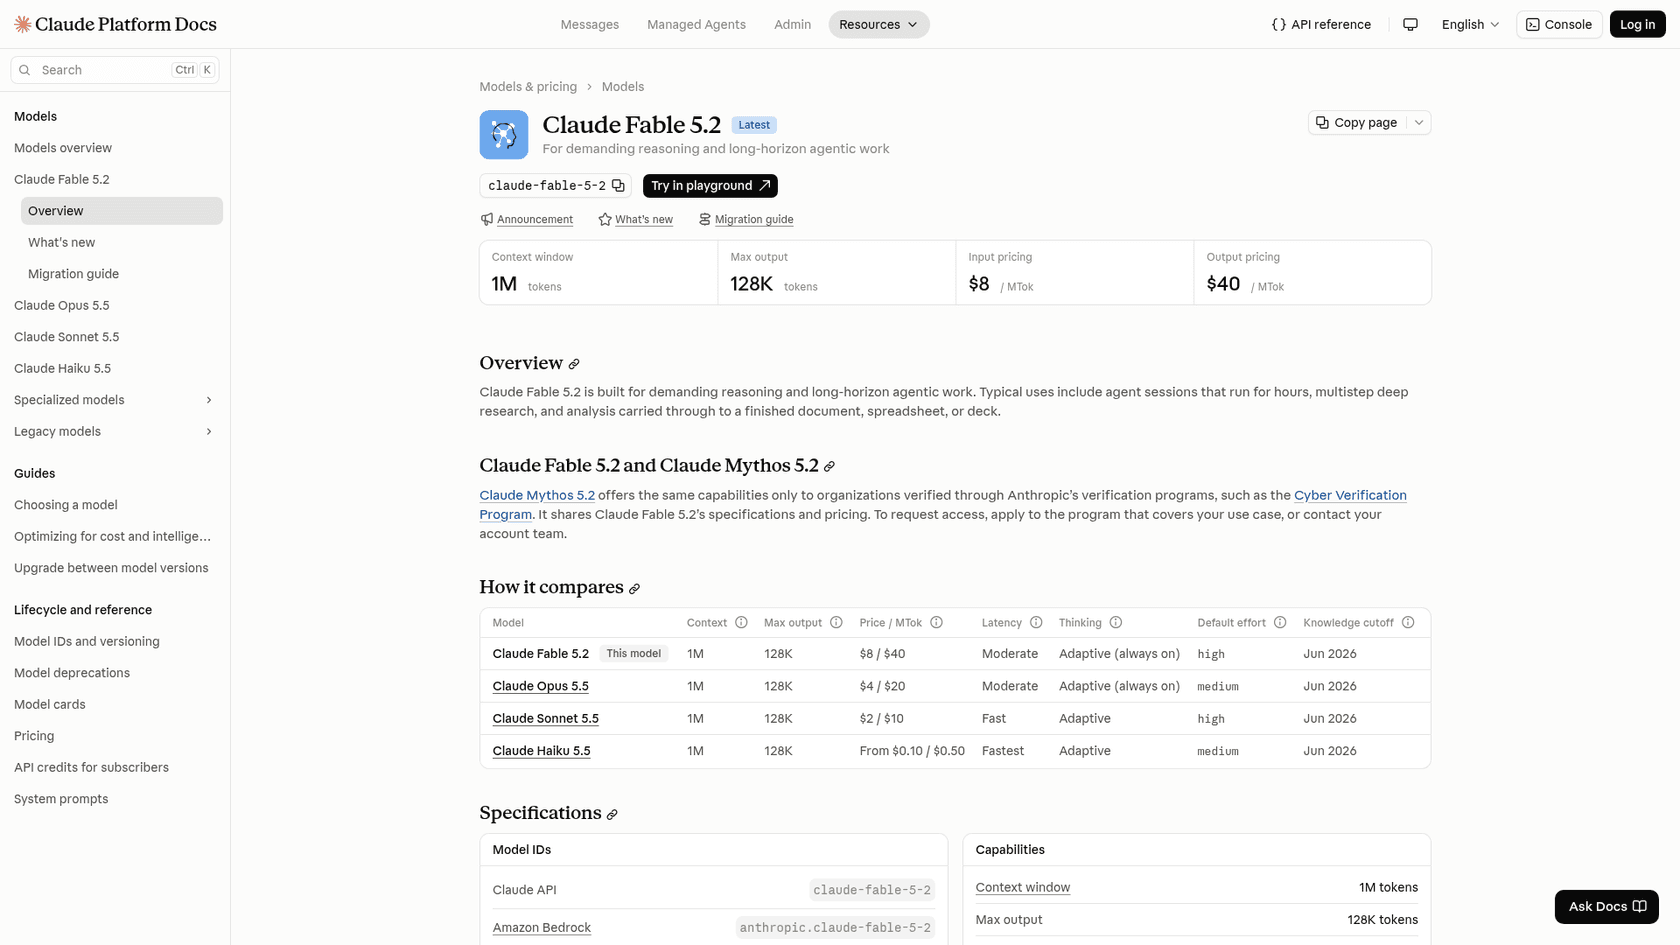
Am besten für: die schwersten, längsten Agentenaufgaben, bei denen ein fehlgeschlagener Durchlauf mehr kostet als die Token.
Was es gut macht
Fable 5.2 steht über Opus 5.5, und ChatGPTs Antwort auf meine Frage merkte an, es führe das Coding-Leaderboard an, das es geprüft hat. Die nützliche Tatsache ist der Preis, nicht der Rang: Anthropic hat gemessen, dass Fable 5.2 bei High Effort Opus 5.5 bei Max für etwa die Hälfte der Kosten pro Aufgabe entspricht, wie in unserer Fable 5.2-Preisanalyse behandelt. Für Aufgaben, bei denen Sie Opus auf Max drehen würden, kann Fable bei High also die günstigere Wahl sein.
Pros
- Stärkstes Modell in dieser Liste für langfristige Arbeit
- Cache-Reads zu
0,20 $, genauso wie Opus 5.5 - Kann Opus bei den Kosten pro Aufgabe bei gleicher Qualität übertreffen
Cons
8 $/40 $Listenpreis, der teuerste pro Token hier- Separate, niedrigere Rate-Limits als Opus und Sonnet
- Im Pro-Plan läuft es auf Nutzungs-Credits, nicht im normalen Kontingent
Pricing
8 $ Input, 40 $ Output pro Million Token, laut Anthropics Preisseite. Für den 10-Mio./1-Mio.-Käufer: 80 $ + 40 $ = 120 $.
Unsere Einschätzung: ein Spezialist, kein Alltagsmodell. Setzen Sie es dort ein, wo Sie sonst Opus auf Max laufen lassen würden, und lesen Sie die Fable 5.2-Rezension, bevor Sie ihm unbeaufsichtigte Durchläufe anvertrauen.
4. GPT-6.1 Terra
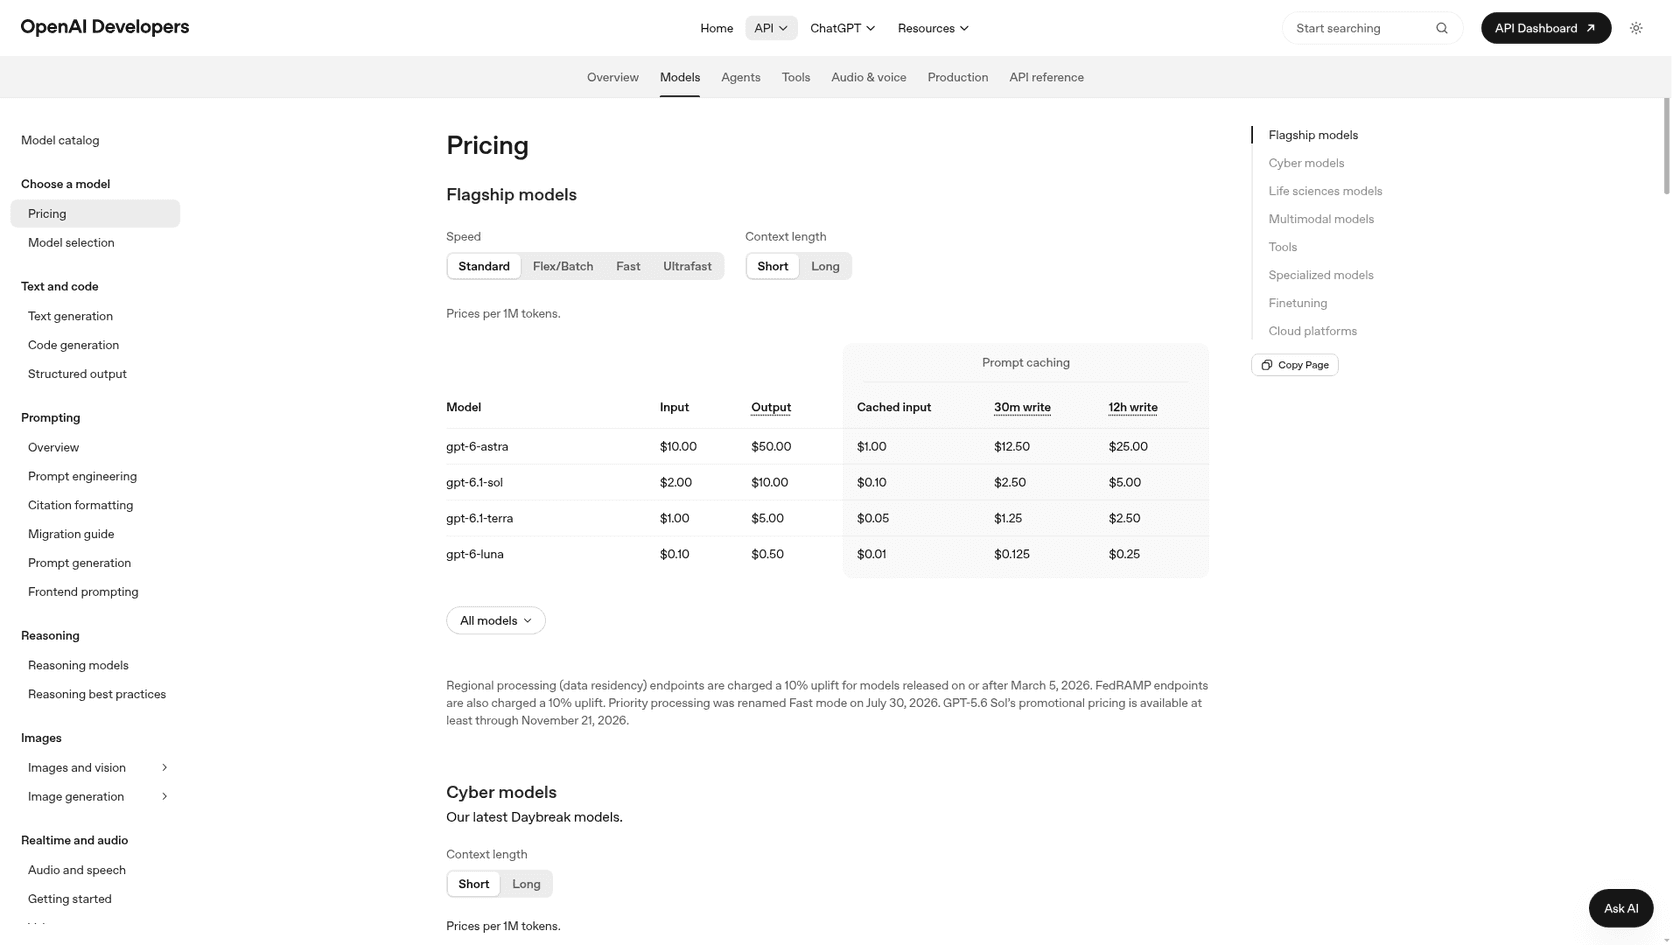
Am besten für: Teams, die ein günstiges Frontier-Klasse-Modell von einem zweiten Anbieter wollen.
Was es gut macht
Terra ist die einzige Alternative, die das GA Qwen 4 Max beim Preis schlägt, ohne auf ein Modell der Flash-Klasse herunterzugehen. Bei 1 $/5 $ ist es pro Token halb so teuer wie GPT-6.1 Sol, und Artificial Analysis hat es bei Low Effort mit 0,05 $ pro Aufgabe und bei Max mit 0,40 $ gemessen, laut unserem Terra-Preis-Beitrag. Wenn Sie ein OpenAI-Modell in Ihrer Rotation wollen, ist dies das, mit dem Sie anfangen sollten.
Pros
15 $im Monat für den 10-Mio./1-Mio.-Käufer, günstiger alsqwen4-max- Cached Input zu
0,05 $, ein Rabatt von 95 % - Batch und Flex halbieren den Preis auf
0,50 $/2,50 $
Cons
- Prompts über 272K Token rechnen die gesamte Anfrage mit
2 $Input und7,50 $Output ab - Nicht die richtige Wahl, wenn Sie das volle 1-Mio.-Fenster bei Flatrate brauchen
Pricing
1 $ Input, 5 $ Output, 0,05 $ Cached Input pro Million Token, laut OpenAIs Preisseite. Für den 10-Mio./1-Mio.-Käufer: 10 $ + 5 $ = 15 $.
Unsere Einschätzung: die beste Preis-Leistungs-Wahl, wenn Ihre Prompts unter 272K bleiben. Für Kontext über ein ganzes Repo halten Sonnet 5.5 oder qwen4-max die Flatrate über 1 Mio. bei.
5. Gemini 4 Argon
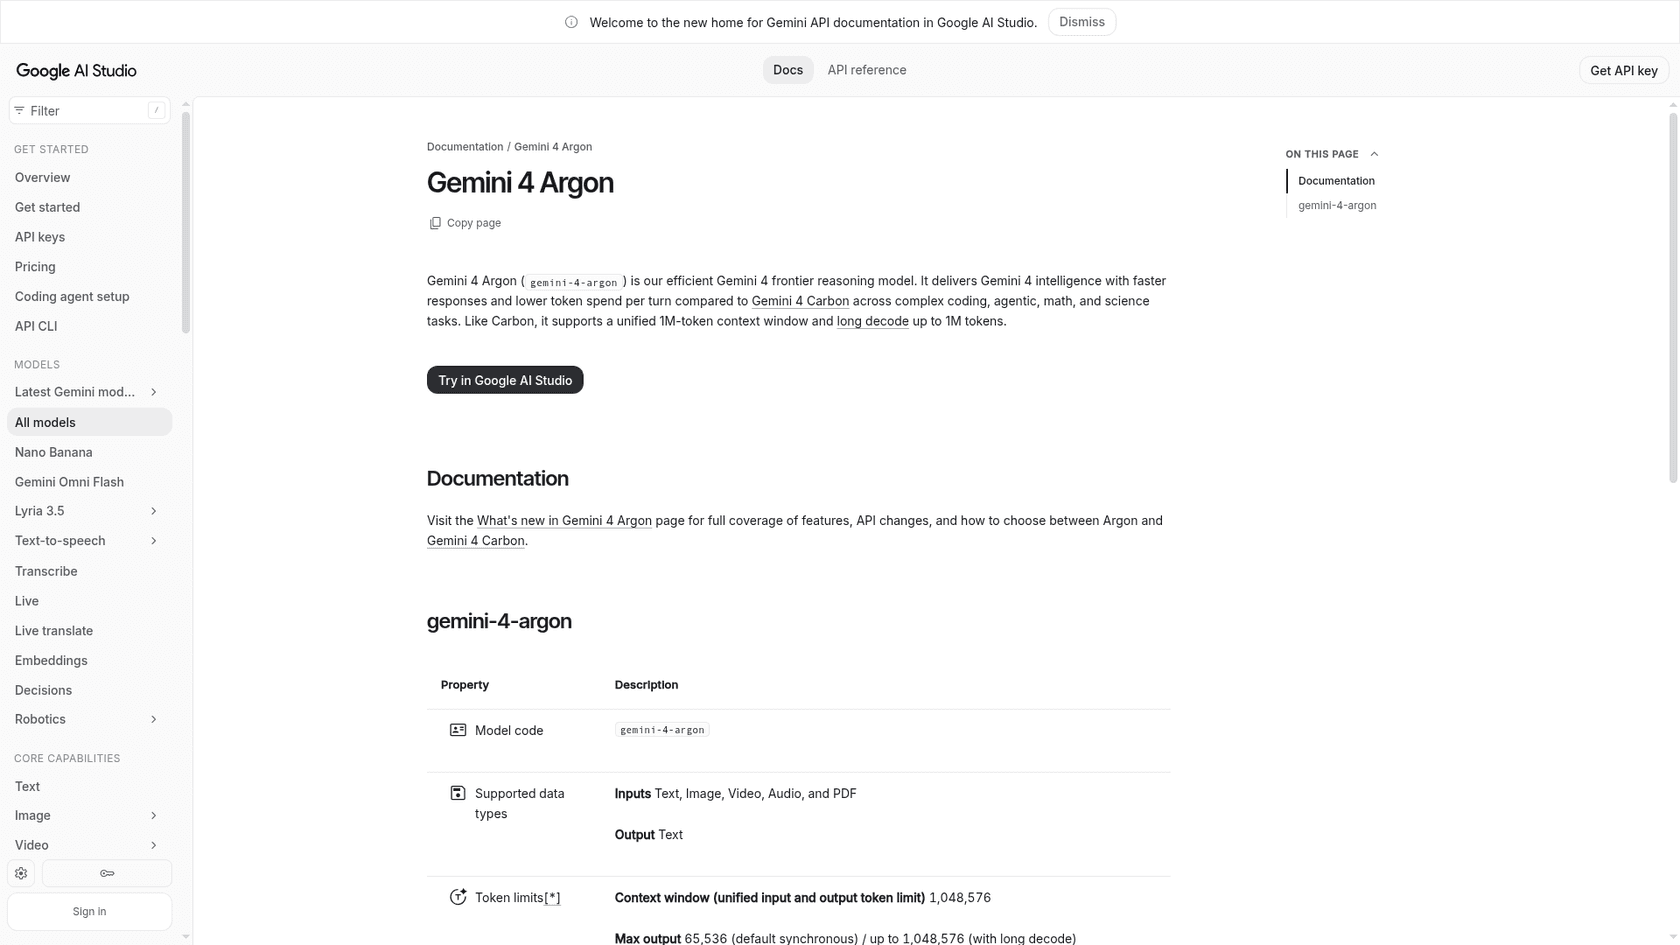
Am besten für: schnelle Gemini-4-Arbeit, wenn Sie mit der Preisänderung im Dezember leben können.
Was es gut macht
Googles Preisseite beschreibt Argon als das effiziente Gemini-4-Modell, mit schnelleren Antworten und geringerem Token-Verbrauch pro Zug als Carbon bei Coding-, Agenten-, Mathe- und Wissenschaftsaufgaben. Sein Kontextfenster beträgt 1.048.576 Token, dieselbe Klasse wie Qwen 4 Max. ChatGPTs eigene Kurzliste schlug Argon für reguläre Arbeit und Carbon für schwere autonome Aufgaben vor, was zu Googles Positionierung passt.
Pros
2 $/10 $mit0,10 $Cached Input bis zum 30. November- 1-Mio.-Kontext, mit langer Dekodierung bis zu 1 Mio. Output-Token laut Docs-Seite
- Gleicher Google-Account und API-Schlüssel wie andere Gemini-Modelle
Cons
- Preis verdoppelt sich am 1. Dezember 2026 auf
4 $/20 $ - Keine Gratisstufe für dieses Modell
- Nur implizites Caching; explizites Caching wird nicht unterstützt
Pricing
2 $ Input und 10 $ Output bis zum 30. November, danach 4 $ und 20 $ ab dem 1. Dezember, laut Googles Preisseite. Für den 10-Mio./1-Mio.-Käufer: 30 $ jetzt, 60 $ ab Dezember. Mehr dazu in unserem Argon-Preisleitfaden mit der Kosten-pro-Aufgabe-Rechnung.
Unsere Einschätzung: kalkulieren Sie mit 4 $/20 $, nicht mit der Einführungsaktion. Zu diesem Preis kostet es genauso viel wie Opus 5.5, testen Sie also beide an Ihrer Workload, bevor Sie sich festlegen.
6. Gemini 4 Carbon
Am besten für: langfristige Agenten und das schwerste Reasoning auf Googles Stack.
Was es gut macht
Carbon ist Googles leistungsfähigstes Reasoning-Modell, gebaut für komplexes Software-Engineering, autonome mehrstufige Agenten und lange Dekodierung bis zu 1 Mio. Token, laut der Preisseite. Die interessante Zahl: Auf Artificial Analysis kostete Carbon zum Listenpreis 7,76 $ pro Aufgabe gegenüber 7,68 $ für Argon, erreichte aber 59 statt 50 Punkte. Gleiche Rechnung, neun Punkte mehr.
Pros
- Gleicher Preis wie Argon, Sie zahlen also nichts extra für das stärkere Modell
- 1-Mio.-Kontext und bis zu 1 Mio. Output-Token
Cons
- Dieselbe Preisverdopplung am 1. Dezember wie bei Argon
- Schreibt viele Token pro Aufgabe, die Kosten pro Aufgabe fallen also hoch aus
Pricing
2 $/10 $ bis zum 30. November, 4 $/20 $ ab dem 1. Dezember, laut Googles Preisseite. Für den 10-Mio./1-Mio.-Käufer: 30 $, dann 60 $. Details in unserem Carbon-Preis-Beitrag.
Unsere Einschätzung: Wenn Sie zu Gemini wechseln, gehen Sie für Agentenarbeit zu Carbon statt zu Argon. Die Carbon-Rezension hat die Benchmark-Details.
7. DeepSeek V4.1 Flash
Am besten für: hochvolumige, routinemäßige Agentenschritte, bei denen der Preis mehr zählt als die Spitzenqualität.
Was es gut macht
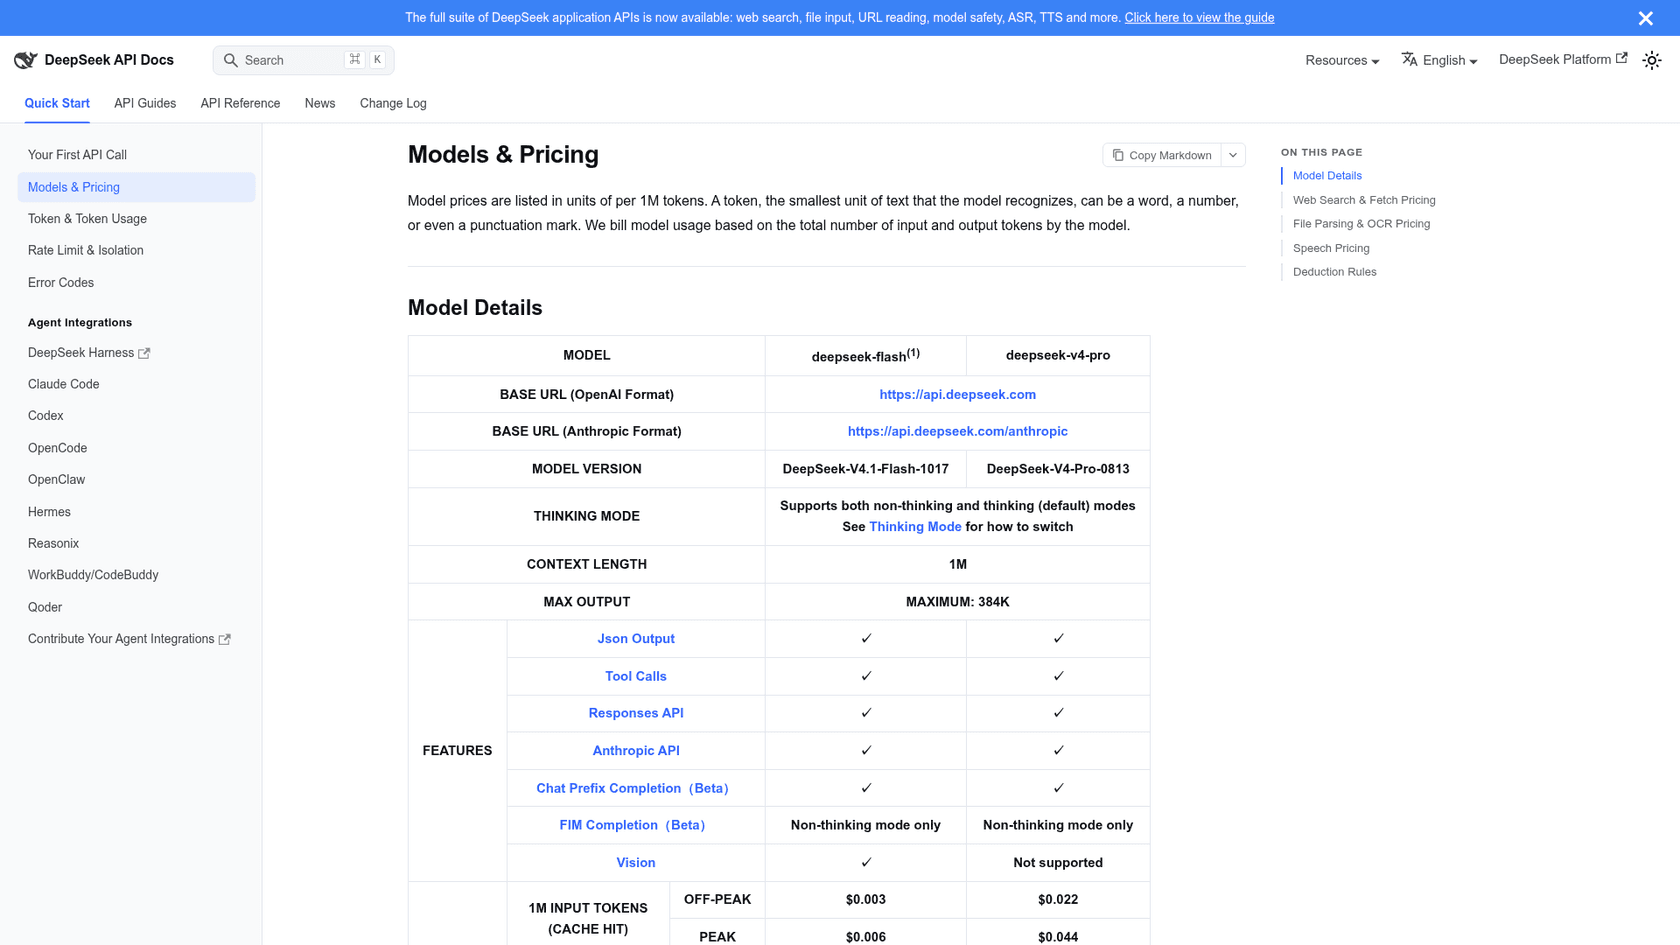
DeepSeek V4.1 Flash ist mit großem Abstand das günstigste ernstzunehmende Modell in dieser Liste. Auf DeepSeeks Preisseite kostet das Modell deepseek-flash (DeepSeek-V4.1-Flash-1017) außerhalb der Spitzenzeit 0,15 $ Input und 0,60 $ Output, mit einem 1-Mio.-Kontextfenster und bis zu 384K Output. Es unterstützt Tool-Calls, JSON-Output, Vision sowie sowohl das OpenAI- als auch das Anthropic-API-Format, passt also in Claude-Code-ähnliche Setups. Und wenn Sie auf Alibabas Rechnung bleiben wollen: Die Token-Plan-Dokumentation listet auch deepseek-v4.1-flash, mit 50 % Rabatt nachts.
Pros
2,10 $im Monat für den 10-Mio./1-Mio.-Käufer außerhalb der Spitzenzeit- Cache-Treffer zu
0,003 $pro Million - Verfügbar auf Token Plan sowie DeepSeeks eigener API
Cons
- Spitzenzeiten (01:00 bis 04:00 und 06:00 bis 10:00 UTC, werktags) verdoppeln jeden Tarif
- Ein Modell der Flash-Klasse, behalten Sie also ein stärkeres Modell für schwere Aufgaben
Pricing
0,15 $ Input (Cache Miss), 0,003 $ (Cache Hit), 0,60 $ Output pro Million Token außerhalb der Spitzenzeit; zur Spitzenzeit doppelt, laut DeepSeek. Für den 10-Mio./1-Mio.-Käufer: 1,50 $ + 0,60 $ = 2,10 $ außerhalb der Spitzenzeit, 4,20 $ zur Spitzenzeit. Siehe unseren V4.1-Flash-Preisleitfaden.
Unsere Einschätzung: der Budget-Slot. Leiten Sie Massenarbeit wie das Zusammenfassen von Logs, das Schreiben von Tests und einfache Edits hierhin, und behalten Sie Sonnet 5.5 oder qwen4-max für alles, was Urteilsvermögen braucht.
8. Kimi K3.1 Pro
Am besten für: Entwickler, die ein starkes Nicht-US-Frontier-Modell mit Flatrate-Option wollen.
Was es gut macht
Kimi K3.1 Pro ist die naheliegende Wahl, wenn Ihnen an Qwen gefallen hat, ein leistungsfähiges Modell außerhalb der großen US-Labore zu haben. Moonshots Quickstart beschreibt es als Modell der 3T-Klasse mit 1-Mio.-Kontextfenster, und die API spricht sowohl das OpenAI- als auch das Anthropic-Format, funktioniert also in Claude Code. Laut unserer K3.1-Pro-Preisanalyse lag es bei Artificial Analysis im Schnitt bei 2,11 $ pro Aufgabe, unter der Hälfte der Kosten pro Aufgabe von Sonnet 5.5 oder Opus 5.5 bei Max Effort.
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
Pros
2 $/10 $pro Token, oder Flatrate-Pläne von19 $bis199 $im Monat- Highspeed-Variante etwa 2-3x schneller
- Moonshot nennt große Fortschritte bei Coding, 3D-Erstellung und Finanzrecherche
Cons
- Schreibt viele Token, die Einsparungen pro Aufgabe sind also kleiner, als der Listenpreis vermuten lässt
- Abo-Pläne haben ein rollierendes 5-Stunden-Limit, das Early Adopters schnell erreichen
Pricing
2 $ Input, 10 $ Output, 0,20 $ Cached Input pro Million Token; Highspeed 4 $/20 $, laut der Kimi-Preisseite. Für den 10-Mio./1-Mio.-Käufer: 30 $.
Unsere Einschätzung: ein guter zweiter Anbieter, wenn Sie sowohl Alibaba als auch die US-Labore vermeiden wollen. Lesen Sie die K3.1-Pro-Rezension, bevor Sie für starke Agentennutzung einen Abo-Plan kaufen.
9. Qwen3.8-Max
Am besten für: Token-Plan-Nutzer, die ein älteres, besser dokumentiertes Qwen-Flaggschiff mit Nachtrabatt wollen.
Was es gut macht
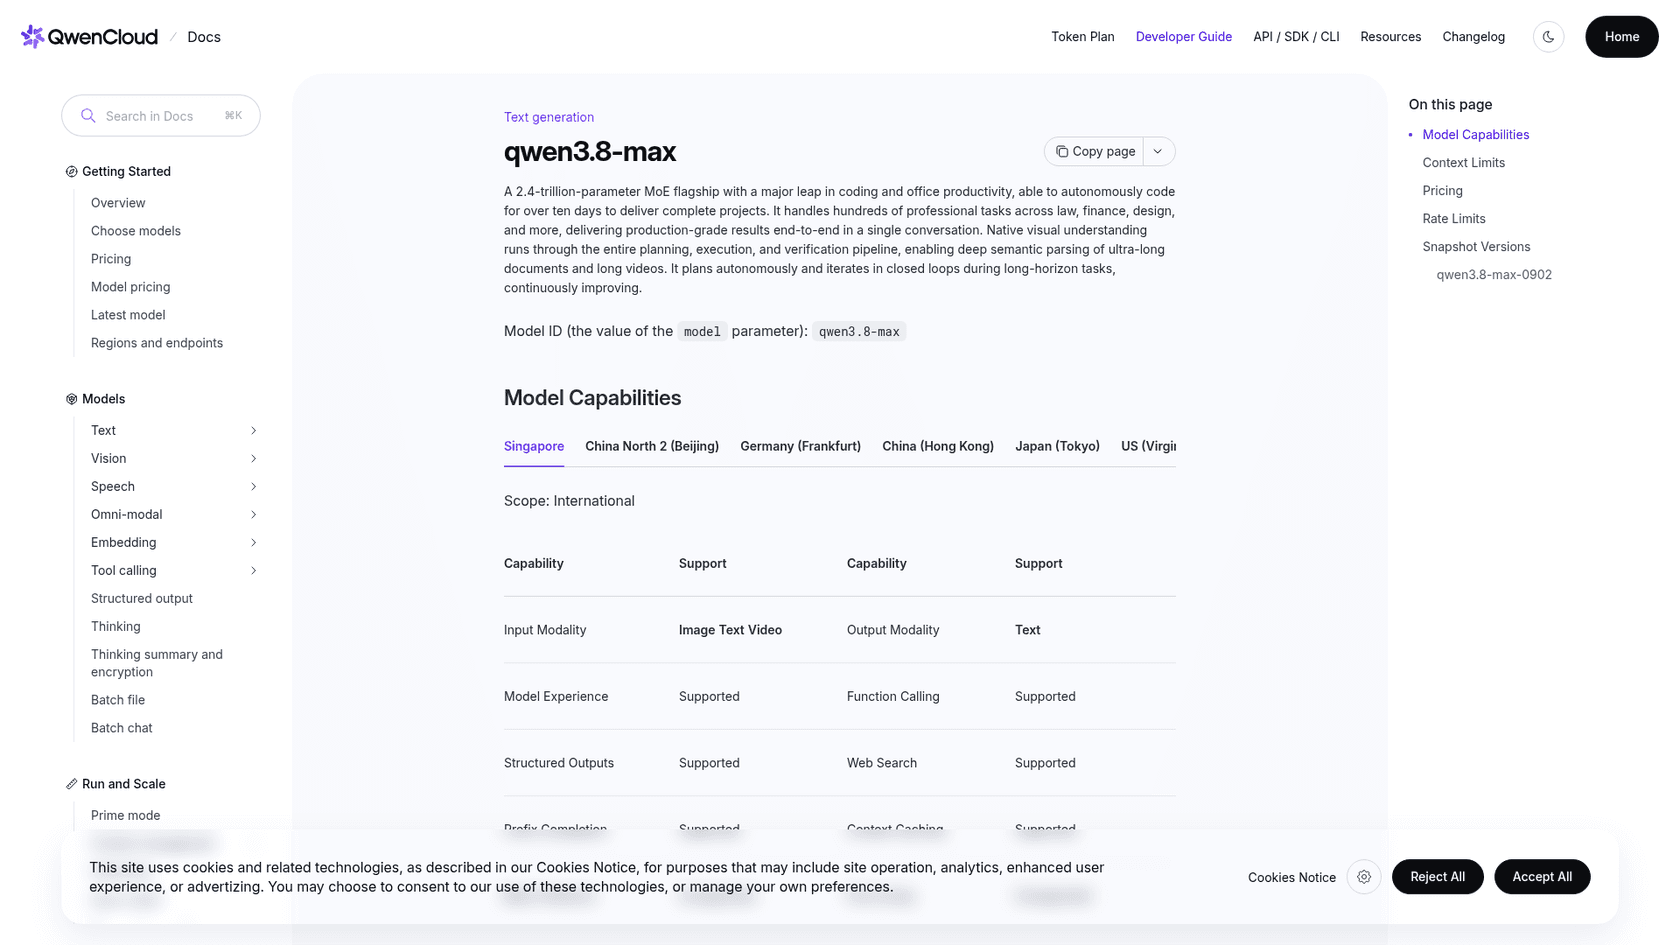
Qwen3.8-Max ist der Rückfall innerhalb der Familie. Alibaba beschreibt es als 2,4-Billionen-Parameter-MoE-Flaggschiff, das lange Zeit autonom coden kann, und es läuft auf demselben Token Plan wie Qwen 4 Max, Ihre Keys und Endpunkte ändern sich also nicht. Auf Token Plan bekommt es weiterhin 60 % Rabatt zwischen 22:00 und 08:00 Uhr UTC+8, was US-Arbeitszeiten entspricht. Unsere Qwen3.8-Max-Rezension behandelt, wie es sich nach dem Launch gehalten hat.
Pros
- Keine Konfigurationsänderungen außer der Modell-ID, wenn Sie schon auf Token Plan sind
- Nachtrabatt läuft weiter auf Token Plan
- Monate an Community-Nutzung dahinter
Cons
- Teurer als das GA
qwen4-maxauf der Pay-as-you-go-API (2 $/6 $gegenüber1,50 $/4,50 $) - Eine ältere Generation als das Modell, das Sie ersetzen
Pricing
2 $ Input und 6 $ Output pro Million Token in Singapur, 1,65 $ und 4,951 $ in Peking, laut Alibabas qwen3.8-max-Seite. Für den 10-Mio./1-Mio.-Käufer: 26 $.
Unsere Einschätzung: Nur auf Token Plan lohnt es sich, wegen des Nachtrabatts. Auf der API ist das GA qwen4-max neuer und günstiger, es gibt also wenig Grund, einen Schritt zurückzugehen.
Welche Qwen 4 Max Alternative passt zu Ihrem Setup?
Ihre Antwort hängt vor allem davon ab, wo Sie die Preview betrieben haben:
- Claude Code auf Token Plan: Ändern Sie zuerst die Modell-ID auf
qwen4-max. Wenn die Ergebnisse enttäuschen, verschieben Sie den Opus-Slot zu Claude Opus 5.5 und den Sonnet-Slot zu Claude Sonnet 5.5. - Ihr eigener Agent auf einer API: Fügen Sie einen zweiten Anbieter hinzu. Sonnet 5.5 oder GPT-6.1 Terra als tägliches Modell, DeepSeek V4.1 Flash für Massen-Calls.
- Hauptsächlich wegen des Rabatts: DeepSeek V4.1 Flash außerhalb der Spitzenzeit kommt dem Preis der Preview am nächsten.
- Langfristige autonome Durchläufe: Claude Fable 5.2 oder Gemini 4 Carbon, Seite an Seite getestet vor dem 1. Dezember.
- Ein Support- oder kundenorientierter Bot: Setzen Sie kein Preview-Modell vor Kunden ein. Das gilt für einen Managed Agent, dazu mehr als Nächstes.
| Wenn Sie brauchen | Wählen Sie | Monatskosten (10 Mio. In, 1 Mio. Out) |
|---|---|---|
| Geringste Änderung | qwen4-max (GA) | 19,50 $ |
| Bestes tägliches Coding-Modell | Claude Sonnet 5.5 | 30 $ |
| Schwerste Aufgaben | Claude Opus 5.5 oder Fable 5.2 | 60 $ oder 120 $ |
| Niedrigster Preis | DeepSeek V4.1 Flash | 2,10 $ außerhalb der Spitzenzeit |
| Zweiter Anbieter mit Budget | GPT-6.1 Terra | 15 $ |
| Nicht-US-Frontier-Modell | Kimi K3.1 Pro | 30 $ |
Was, wenn die Preview Ihre Support-Warteschlange betrieben hat?
Dann war die Modell-ID nie das eigentliche Problem. Eine zweiwöchige Preview, die zu einem festen Termin abgeschaltet wird, ist das klarste Beispiel dafür, warum Support-Teams kein rohes Modell direkt in ihr Helpdesk verdrahten sollten: Jede Anbieteränderung wird zu Ihrer Migration, Ihrem erneuten Test und Ihrem Risiko.
Genau diese Lücke füllt eesel. Modelle wie die oben sind Infrastruktur; eesel ist die Mitarbeiterin. Ihr KI-Helpdesk-Teammitglied verbindet sich mit Zendesk oder Freshdesk, lernt aus Ihren vergangenen Tickets und Ihrem Help Center und wird an historischen Gesprächen getestet, bevor sie einem echten Kunden antwortet. Wenn ein besseres Modell erscheint, passiert der Wechsel auf eesels Seite.
Zwei Kunden zeigen, wie das in der Praxis aussieht:
- SE Ranking betreibt drei Produkte aus einem Zendesk-Team, mit einem eesel-Agenten pro Produkt, der etwa 16.800 Seiten Hilfeinhalte durchsucht. Es hat in einem Monat etwa 4.650 Gespräche bearbeitet, und nichts davon hing davon ab, welches Modell darunterlag.
- OroSoft stellt Software für den Bullionhandel her und unterstützt Kunden über Freshdesk. eesel verfasst Antworten aus 6.100 vergangenen Tickets und 20 Help-Center- und Referenzdateien, nennt, welches Ticket oder welchen Artikel es verwendet hat, und meldet eine Person, wenn es keine Grundlage für eine Antwort findet.
eesel ausprobieren
Wenn Sie die Qwen 4 Max Preview getestet haben, um Kunden zu antworten, gibt Ihnen eesel diesen Agenten ohne den Modellwechsel: Er tritt in wenigen Minuten Ihrem Helpdesk bei, verfasst oder sendet Antworten aus Ihren eigenen Hilfeinhalten, und Sie sehen, wie er auf Ihre vergangenen Tickets geantwortet hätte, bevor er live geht. Pläne starten bei 299 $ im Monat auf der eesel-Preisseite, mit 100 kostenlosen Credits zum Ausprobieren. Ein Coding-Agent kann das Setup über die eesel CLI steuern, genehmigte Hilfeartikel hochladen und Testfragen stellen, während das Verbinden des Helpdesks selbst weiterhin die Zustimmung einer Administratorin braucht.
eesel ausprobieren kostenlos, oder lesen Sie zuerst, wie KI für Zendesk funktioniert.