

Qwen 4 Max ist ein paar Tage praktisches Ausprobieren in deinem Coding-Tool wert, aber noch nicht mehr. Die Preview (qwen4-max-preview) hat 1M Token Kontext und 393.216 max. Output, aber Alibaba hat keine Benchmarks und keinen Preis pro Token veröffentlicht. Sie läuft nur über das Token-Plan-Abo, das App-Backends verbietet, und sie wird am 25. November 2026 abgeschaltet. Probier sie aus, solange Credits 20 % der Standardrate kosten. Baue stattdessen auf Qwen 3.8 Max. Für Support-Arbeit läuft ein Helpdesk-Agent wie eesel auf stabilen Modellen, und mit der eesel CLI kann ein Coding-Agent deine Hilfeartikel laden und Antworten testen, bevor irgendetwas live geht.
Was ist Qwen 4 Max?
Qwen 4 Max ist das erste Modell der Qwen-4-Generation von Alibaba, und im Moment existiert es nur als Preview. Alibabas Modell-Docs nennen qwen4-max-preview „das multimodale Flaggschiff-Modell der nächsten Generation in der Qwen-Familie", gebaut für Coding, Büroarbeit, Frontend-Design und Agent-Aufgaben.
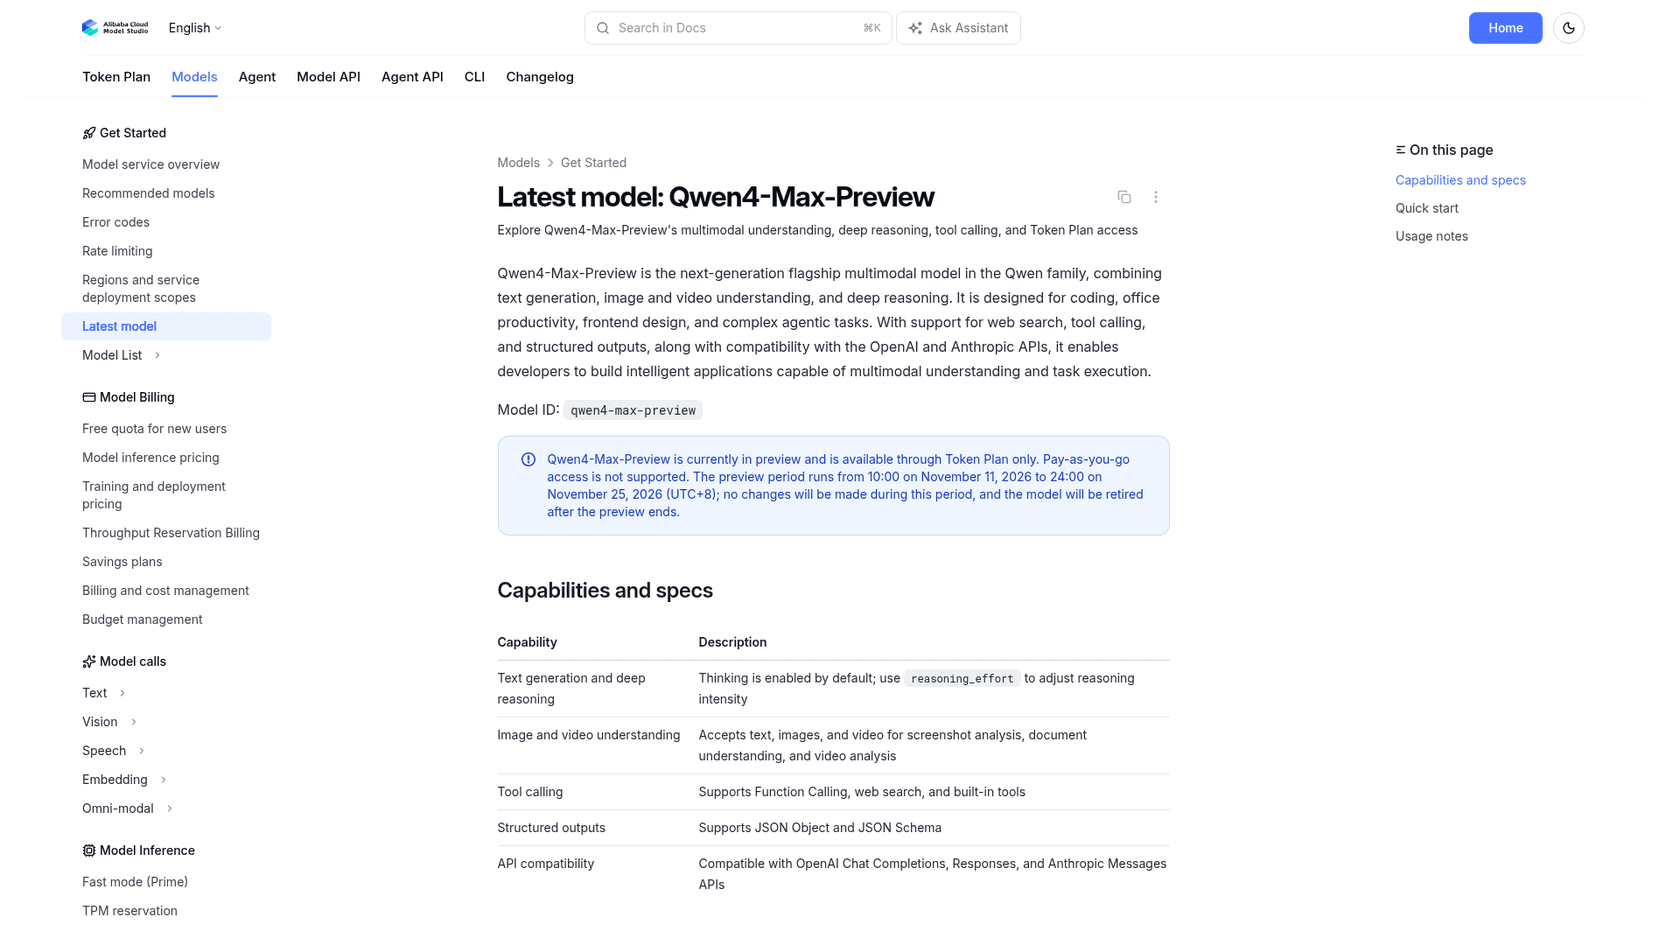
Sie ging am 11. November 2026 um 10:00 Uhr Pekinger Zeit live. Hier ist, was die Docs bestätigen:
| Spezifikation | Qwen4-Max-Preview |
|---|---|
| Modell-ID | qwen4-max-preview (Alias qwen4.0-max-preview) |
| Input | Text, Bilder und Video |
| Kontextlänge | 1M Token |
| Max. Output | 393.216 Token, gemeinsam genutzt von Denken und Antwort |
| Denken | Standardmäßig an, low, medium oder xhigh (Standard) |
| Tools | Function Calling, Websuche, integrierte Tools |
| Strukturierter Output | JSON Object und JSON Schema |
| API-Formate | OpenAI Chat Completions, Responses, Anthropic Messages |
| Zugang | Nur Token Plan, kein Pay-as-you-go |
| Preview-Zeitraum | 11. bis 25. Nov. 2026 (UTC+8), danach abgeschaltet |
Ein Teil meiner Arbeit ist zu prüfen, was ein Launch tatsächlich verspricht, bevor jemand darauf aufbaut. Bevor es also darum geht, wie sich das Modell anfühlt: Das hier fehlt. Neben dem Launch von Qwen 3.8 Max ist dieser deutlich dünner.
Was hat Alibaba weggelassen?
Alibaba hat Fähigkeiten und Grenzen veröffentlicht, aber nicht die Zahlen, mit denen man ein Modell normalerweise beurteilt. Die Docs-Seite hat keine Benchmark-Tabelle. Es gibt keine Parameterzahl, keine Model Card, keine offenen Gewichte und keinen Preis pro Token. Als ich am 12. November nachsah, hatte Qwen 4 Max auch keine Seite auf Artificial Analysis, während Qwen 3.8 Max dort gelistet ist.
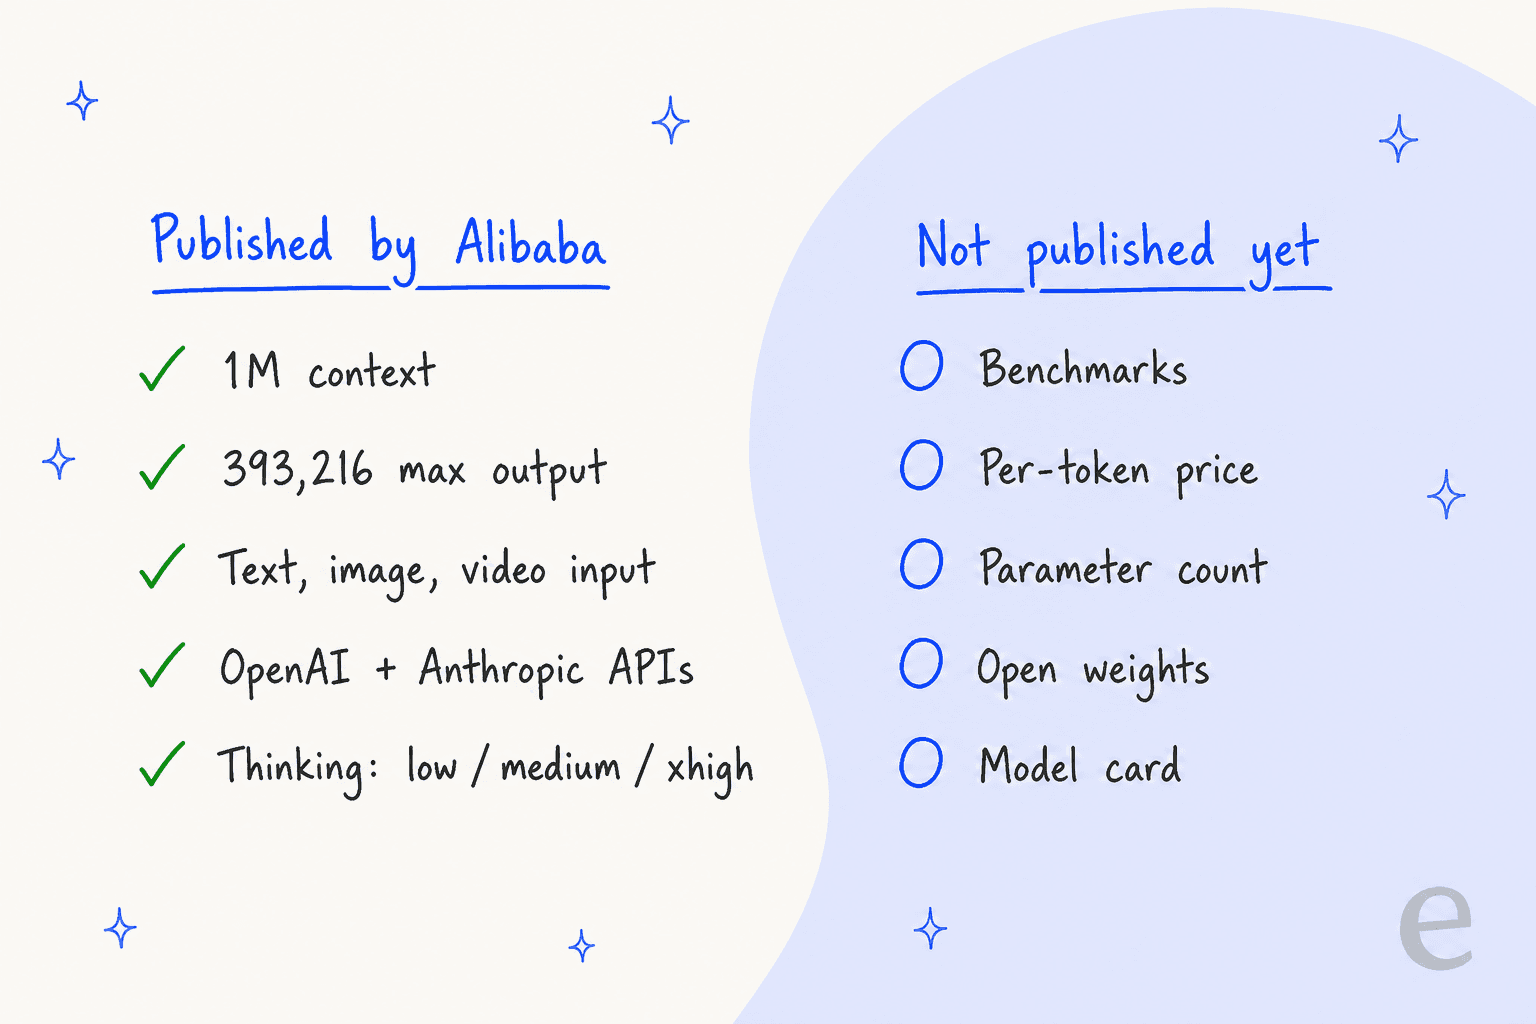
Jedes „Qwen 4 Max erreicht X Punkte"-Diagramm, das du diese Woche siehst, stammt also von einem Dritten, der die Preview testet, nicht von Alibaba. Das ist kein Makel, Previews erscheinen oft so. Aber es bedeutet, dass ein Test heute ein Test der Zugangsbedingungen ist, nicht der Intelligenz. Der Launch-Thread auf Hacker News sagte dasselbe:
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

Dieser zweite Satz ist auch wichtig. Die Qwen-Modelle, die Leute lieben, sind die kleinen offenen wie Qwen 3.8 Flash Next und das 27B. Die Max-Stufe ist nur gehostet, und diese Preview ändert daran nichts.
Wie bekommst du Zugang, und was kostet es?
Du bekommst Qwen 4 Max über Alibabas Token Plan, ein monatliches Abo, das in Credits bezahlt wird. Für die Preview gibt es keine Pay-as-you-go-Option. Die Preise der Personal Edition stammen aus Alibabas Token-Plan-Docs:
| Plan | Listenpreis | Neukundenpreis | Monatliche Credits | Gleichzeitige Agenten |
|---|---|---|---|---|
| Lite | 6 $/Monat | 3 $/Monat | 20.000 | 1-2 |
| Essential | 10 $/Monat | 5 $/Monat | 45.000 | 2-3 |
| Standard | 18 $/Monat | - | 80.000 | 3-4 |
| Pro | 43 $/Monat | - | 200.000 | 6-8 |
Der Neukundenpreis gilt bis zum 30. November 2026 für Accounts, die noch nie ein Personal-Abo gekauft haben. Zusätzliche Pakete kosten 15 $ für 20.000 Credits, und du kannst bis zu fünf davon halten. Die Personal Edition ist nur in der Region Singapur verfügbar, und die Inferenz läuft in Alibabas globalem Deployment, sodass deine Prompts Grenzen überschreiten.
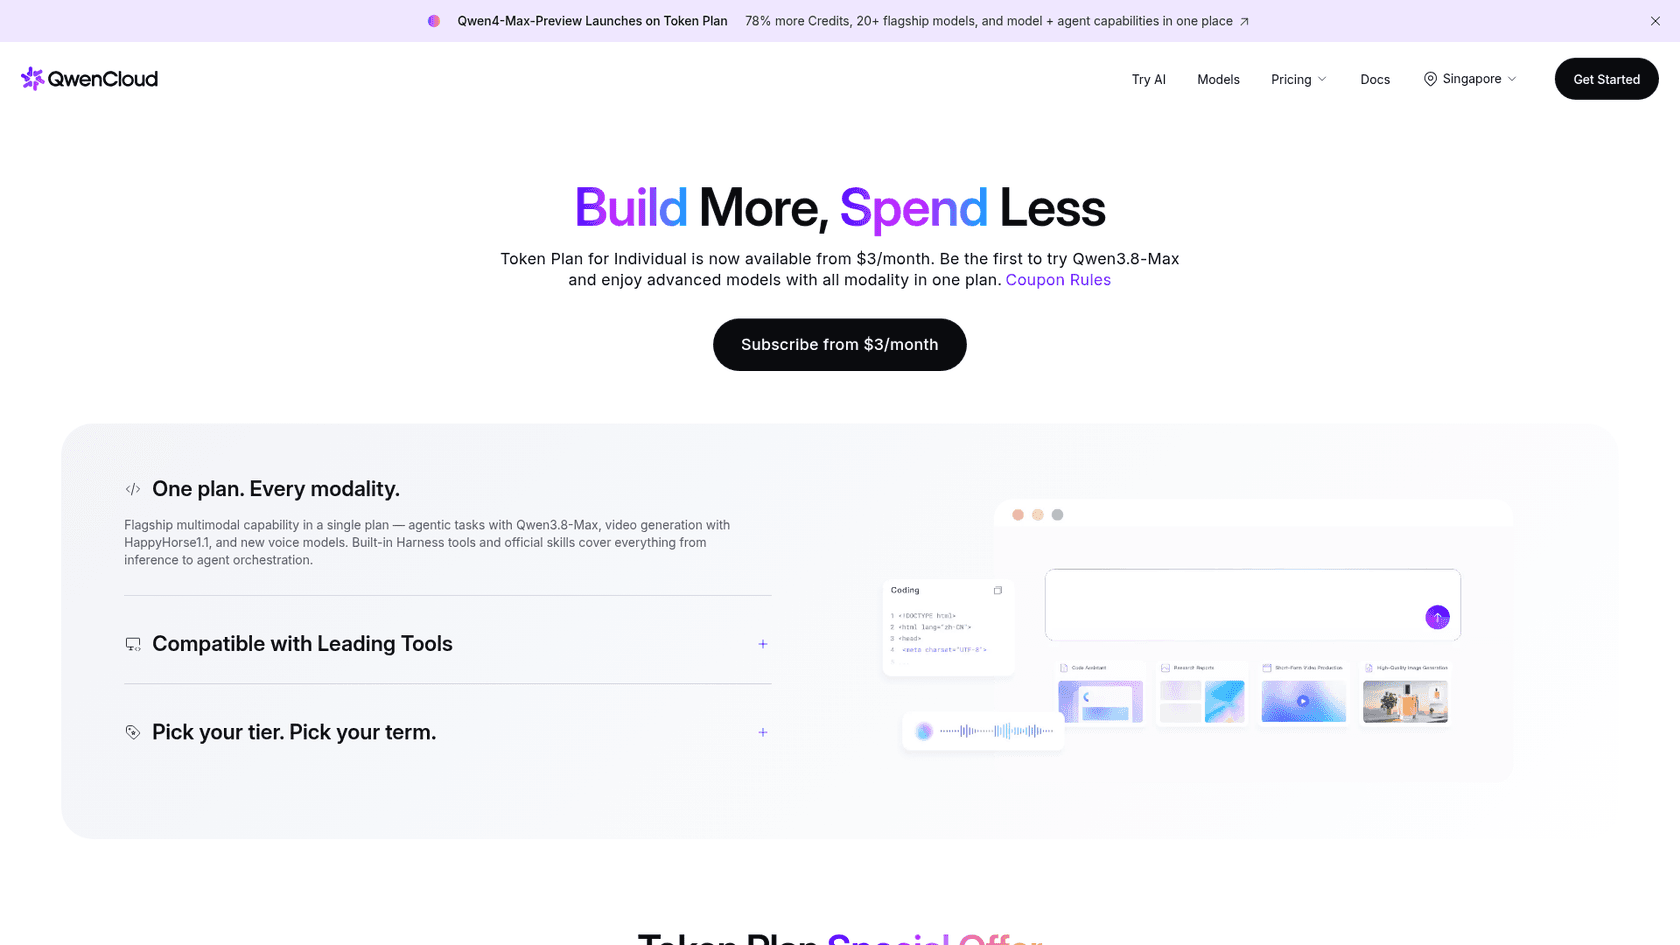
Hier ist der Haken für alle, die Kosten vergleichen wollen. Alibaba sagt, Credits pro Anfrage würden „dynamisch bestimmt durch Modelltyp, Token-Nutzung, Denkmodus und Tool-Aufrufe", und veröffentlicht keine Credits-pro-Token-Rate für Qwen 4 Max. Was ein Aufruf kostet, erfährst du erst auf der Nutzungsseite in der Konsole, nachdem du ihn gemacht hast. Du kannst einen Job also nicht im Voraus kalkulieren, wie bei Qwen 3.8 Max, das auf seiner QwenCloud-Modellseite 2 $ Input und 6 $ Output pro 1M Token angibt.
Der Preview-Rabatt, und warum „Nacht" dein Arbeitstag bedeutet
Während der Preview verbraucht Qwen 4 Max Credits mit 20 % der Standardrate. Zwischen 22:00 und 08:00 Uhr Pekinger Zeit gibt es weitere 60 % Rabatt, also 8 % der Standardrate.
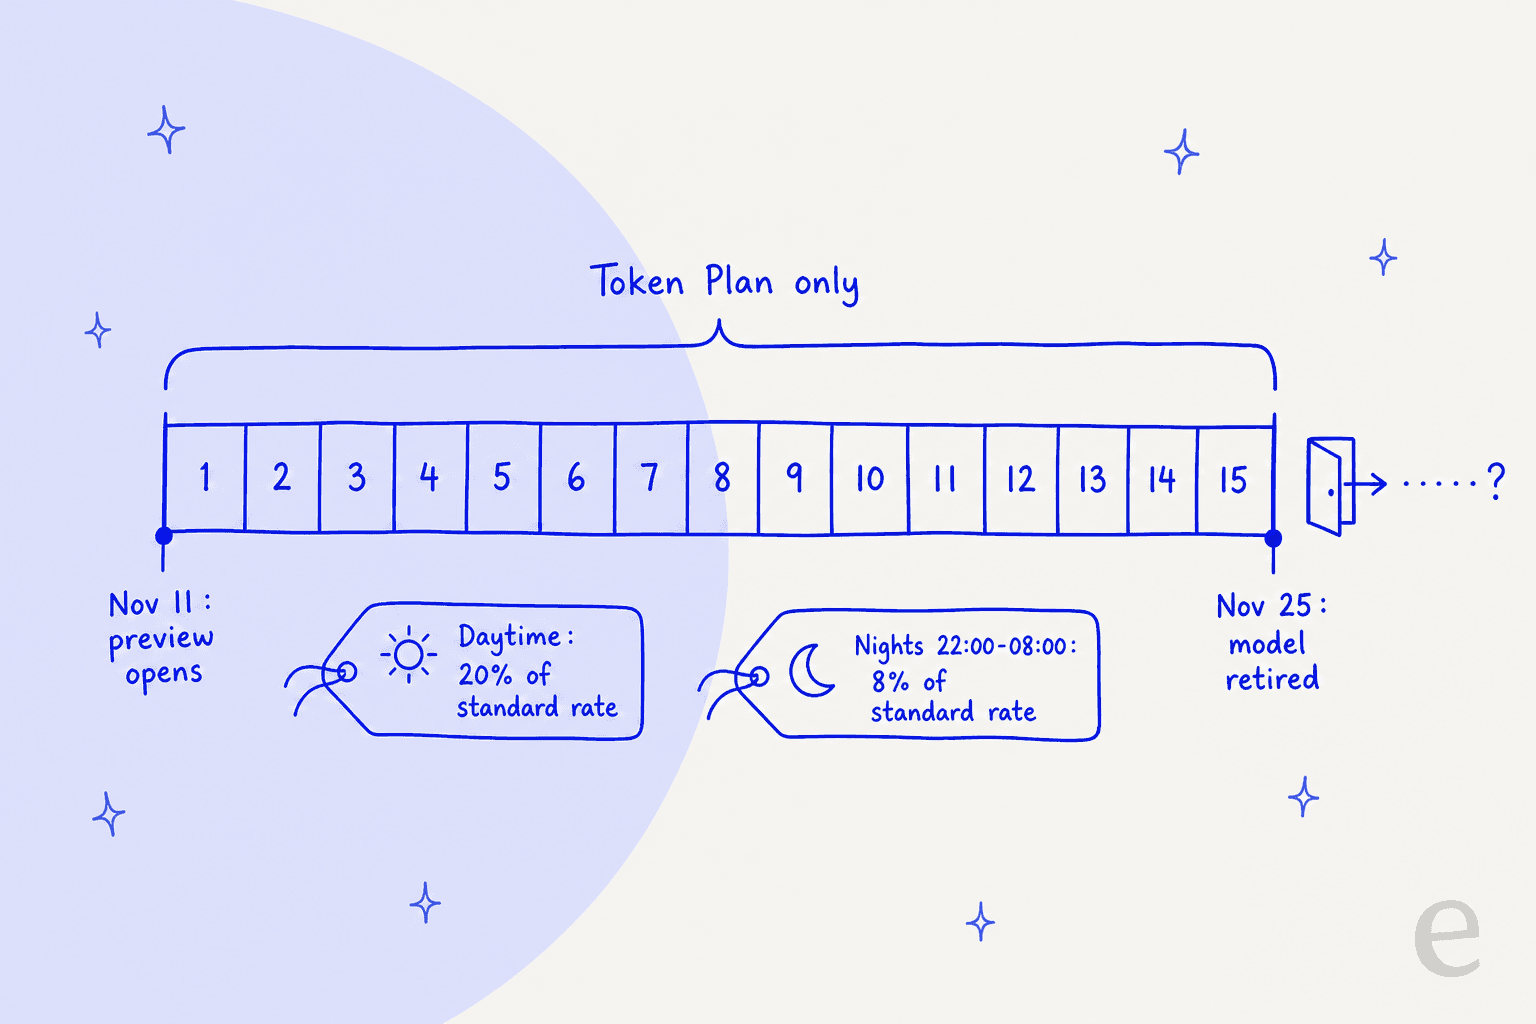
Das Detail, das die meisten übersehen: 22:00 bis 08:00 Uhr in Peking ist 14:00 bis 00:00 Uhr UTC. Das ist 9 bis 19 Uhr an der US-Ostküste. Wenn du in Amerika sitzt, deckt die günstigste Rate deinen ganzen Arbeitstag ab. Ein früher Tester auf Hacker News machte denselben Punkt:
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"
Kannst du auf Qwen 4 Max aufbauen?
Nein, und das ist der Teil des Tests, der am meisten zählt, wenn du ein Produkt oder ein Support-Team führst. Zwei Dinge schließen es aus.
Erstens ist das Modell temporär. Alibabas Docs sagen, „es werden während dieses Zeitraums keine Änderungen vorgenommen, und das Modell wird nach Ende der Preview abgeschaltet". Alles, was du auf qwen4-max-preview baust, funktioniert nach dem 25. November nicht mehr.
Zweitens verbietet der Token Plan genau die Nutzung, die du brauchen würdest. Die Abo-Bedingungen sagen, der Plan sei „nur für interaktive Nutzung innerhalb von Coding- und Agent-Tools gedacht", und dass er „nicht für Automatisierungsskripte, eigene Anwendungs-Backends oder nicht-interaktive Batch-Aufruf-Szenarien verwendet werden darf". Aufrufe außerhalb dieses Rahmens können zur Sperrung des Abos oder des API-Keys führen.
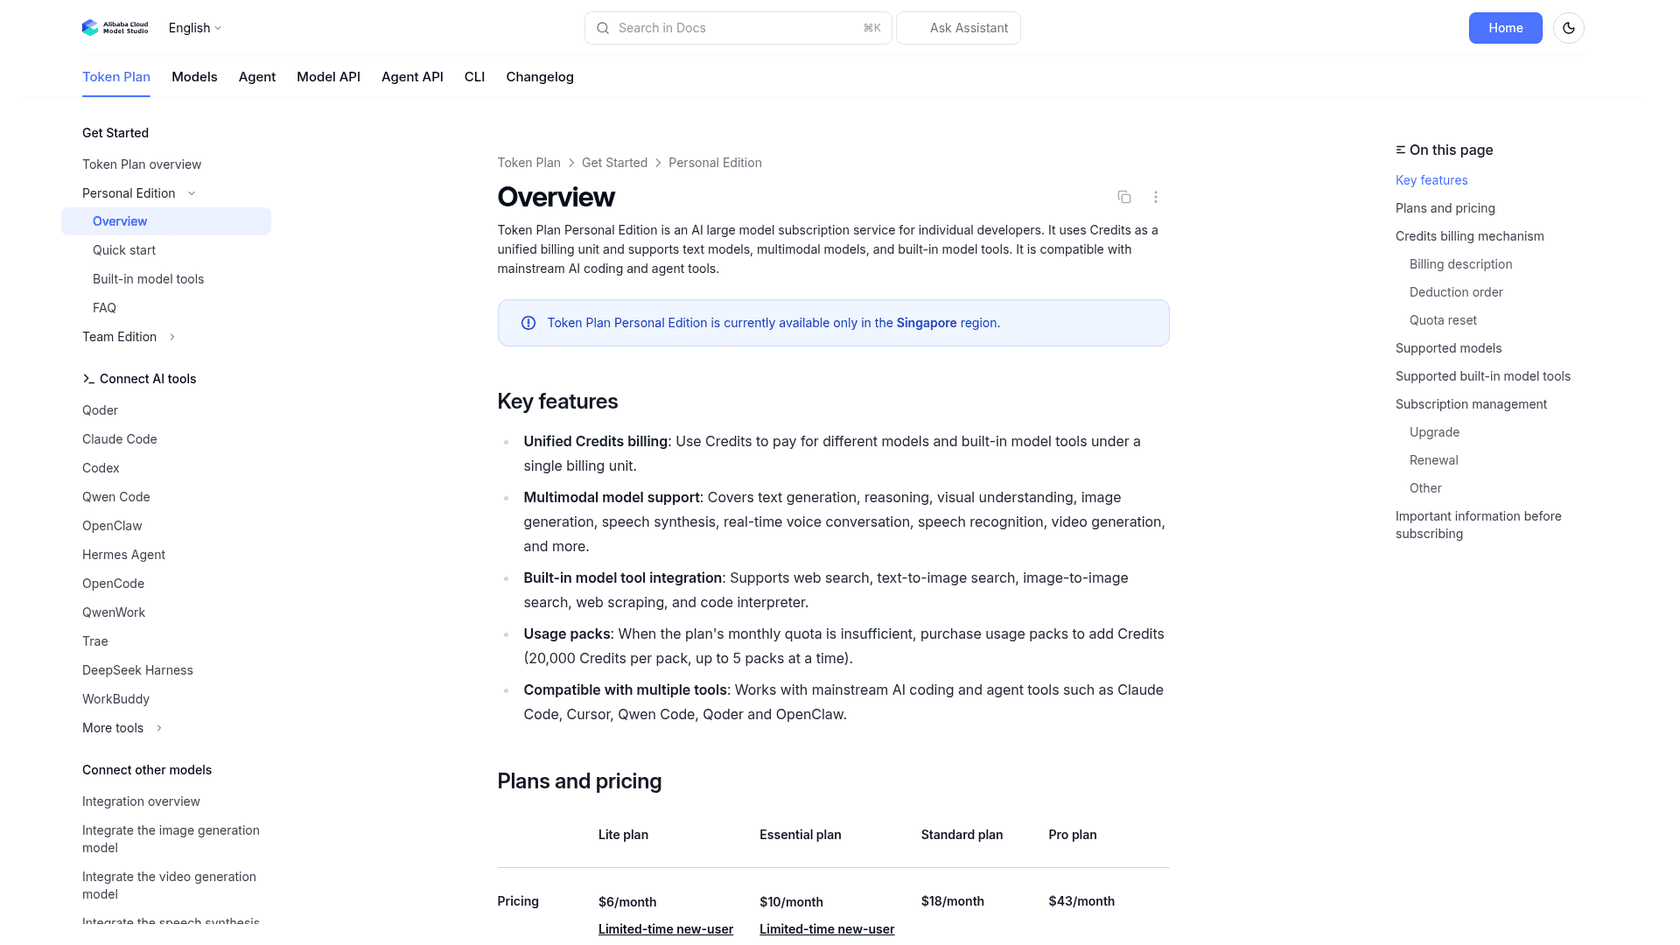
Ein Support-Chatbot, ein Ticket-Klassifizierer oder jede KI-Kundenservice-API, die an diesen Key angeschlossen ist, würde die Regeln am ersten Tag brechen. Was der Plan erlaubt, ist die Nutzung des Modells in Claude Code, Cursor, Qwen Code, OpenAI Codex, Cline, OpenCode oder OpenClaw, alle als unterstützte Tools gelistet.
Solltest du Qwen 4 Max diese Woche ausprobieren?
Öffne die Option, die am besten zu dir passt.
Ich arbeite jeden Tag in Claude Code, Cursor oder Qwen Code
Ja. Ein Lite-Plan für 3 bis 6 $ gibt dir zwei Wochen mit 1M Kontext bei 20 % der Standard-Credit-Rate. Teste es an einer echten Aufgabe, deren Antwort du schon kennst, und vergleiche es mit deinem üblichen Modell.
Ich will es hinter meine App oder einen Support-Bot setzen
Nein. Der Token Plan verbietet App-Backends, und das Modell wird am 25. November abgeschaltet. Nimm jetzt ein Pay-as-you-go-Modell wie Qwen 3.8 Max, und schau dir Qwen 4 Max wieder an, wenn eine vollständige Version mit Preis erscheint.
Ich wähle ein Modell für die Roadmap meines Unternehmens
Warte. Ohne Benchmarks oder eine Preistabelle gibt es nichts, was in ein Kostenmodell passt. Notiere dir das Output-Limit von 393.216 Token und das neue max_tokens-Verhalten, und schau noch mal vorbei, wenn Alibaba Zahlen veröffentlicht.
Ich betreibe selbst gehostete Qwen-Modelle
Lass es. Für die Preview gibt es keine offenen Gewichte. Was du im Blick behalten solltest, sind die kleineren Qwen-4-Modelle, denn das sind die, die meist auf Hugging Face landen.
Was hat sich für Entwickler geändert?
Zwei technische Änderungen solltest du kennen, bevor du ein Tool darauf ansetzt.
Die größere ist, wie max_tokens funktioniert. Ab qwen4-max-preview sagt Alibabas Kompatibilitätshinweis, dass max_tokens jetzt gleich max_completion_tokens ist, also Denken und die finale Antwort zusammen begrenzt. Denken ist standardmäßig auf xhigh an. Wenn deine Konfiguration max_tokens nur für die Antwort bemessen hat, kann langes Reasoning das Budget aufbrauchen und deine Antwort abschneiden. Ältere Qwen-Modelle behalten das alte Verhalten, das beißt also beim Wechsel.
Die zweite ist Multi-Turn-Thinking. Chat Completions schaltet preserve_thinking standardmäßig ein, und die Docs verlangen, früheres Denken im Feld reasoning_content zurückzuschicken, nicht in content eingeklebt. Tools, die für Anthropic- oder OpenAI-Formate gebaut sind, machen das nicht automatisch, ein Check lohnt sich also, wenn lange Agent-Sessions aus der Spur laufen.
Die Output-Obergrenze selbst ist ein echter Sprung: 393.216 Token, dreimal so viel wie die 131.072 bei Qwen 3.8 Max. Für lange Codegenerierung oder große Refactors in einem Durchgang ist das die Spezifikation, die ich zuerst testen würde.
Wie fühlt sich die Nutzung an?
Frühe Berichte sind gemischt und meist zur Geschwindigkeit, was zu einem Modell passt, dessen Denken standardmäßig auf xhigh steht. Der oben zitierte Hacker-News-Tester sagte, „mit xhigh thinking ist die Geschwindigkeit okay, fühlt sich etwas langsamer an als Terra", gemeint ist OpenAIs GPT-6.1 Terra. Auf X nahm der Launch innerhalb von Stunden eine skeptische Wendung:
"Qwen-4-max is live it seems. From what I've heard so far (rumors), Qwen 4 is disappointing."
Beachte das Wort „rumors" (Gerüchte). Eine Antwort unter diesem Post widersprach mit tatsächlicher Nutzung:
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Beide sind früh, und keines ist ein Benchmark. Meine ehrliche Einschätzung: Außerhalb von Alibaba weiß noch niemand, wie gut Qwen 4 Max wirklich ist, und das 14-Tage-Fenster plus „keine Änderungen während der Preview" bedeutet, dass das Modell, das du testest, eingefroren ist. Wenn du es ausprobierst, probiere es an deiner eigenen Arbeit, mit einer Aufgabe, die du schon mit Claude Fable 5.2 oder GPT-6.1 Sol gelöst hast, damit du etwas Echtes zum Vergleich hast.
Wie schneidet es im Vergleich zu anderen Modellen ab?
So steht die Preview im Vergleich zu den Modellen, gegen die Leute sie tatsächlich abwägen werden. Die Preise stammen jeweils von der eigenen Seite des Anbieters, und ich habe markiert, was nicht veröffentlicht ist.
| Modell | Status | Preis | Max. Output | Unabhängige Werte |
|---|---|---|---|---|
| Qwen 4 Max Preview | Preview, endet 25. Nov. | Nur Token-Plan-Credits | 393.216 | Noch keine |
| Qwen 3.8 Max | Veröffentlicht | 2 $ / 6 $ pro 1M | 131.072 | Ja |
| Kimi K3 | Veröffentlicht | Kimi K3 Preise | Siehe Anbieter | Ja |
| DeepSeek V4.1 Flash | Veröffentlicht, auch im Token Plan | DeepSeek V4.1 Flash Preise | Siehe Anbieter | Ja |
| GLM 5.3 Flash | Veröffentlicht | GLM 5.3 Flash Preise | Siehe Anbieter | Ja |
Die Tabelle sagt, was der Rest dieses Tests sagt. Jede andere Zeile ist etwas, das du kalkulieren und prüfen kannst. Qwen 4 Max ist das, was du nur ausprobieren kannst.
Was bedeutet das für ein Support-Team?
Für ein Support-Team ist Qwen 4 Max ein Modell, das man beobachtet, nicht eines, das man in den Helpdesk einbaut. Die Frage, die jede Launch-Woche aufkommt, ist, ob man den Support-Bot auf das neue Modell umstellt. Bei diesem hier ist die Antwort einfach, weil die Regeln und das Abschaltdatum sie für dich treffen.
Der größere Punkt gilt aber für jeden Launch. Ein rohes Modell, egal wie stark, ist kein Support-Agent. Der Agent ist alles, was darum herum liegt: dein Help Center, vergangene Tickets, Makros, die Regeln dafür, wann an einen Menschen übergeben wird, und Tests, bevor etwas einen Kunden erreicht. Genau diese Schicht soll eesels KI-Helpdesk-Teammitglied sein. Es tritt deiner bestehenden Warteschlange in Zendesk oder Freshdesk bei, lernt aus deinen vergangenen Tickets und wird gegen historische Gespräche simuliert, bevor es irgendjemandem antwortet.
Zwei unserer Kunden zeigen, wie das in der Praxis aussieht:
- smava, ein deutscher Kreditvergleichsdienst, betreibt eesel auf Zendesk über zwei Marken. In einem Monat bearbeitete es 27.000 Tickets, kategorisierte 14.600 und erstellte 15.300 Antwortentwürfe auf Deutsch, aus 820 synchronisierten Makros und Help-Center-Artikeln.
- SamCart betreibt einen Agenten auf Freshdesk-Tickets und einen weiteren im Website-Chat, der aus 280 Help-Center-Artikeln antwortet.
Keines dieser Setups hängt davon ab, ob das Modell dieser Woche ein Leaderboard gewinnt. Wenn du sehen willst, was ein Modell mit deinem eigenen Support-Content kann, sind meine Leitfäden zum Verbinden von Claude mit deinem Helpdesk und zum Verhindern von KI-Halluzinationen im Support eine bessere Nutzung des Nachmittags als eine Preview, die in zwei Wochen abgeschaltet wird.
Mein Urteil zu Qwen 4 Max
Die Qwen-4-Max-Preview ist ein Test, kein Produkt. Die bestätigten Spezifikationen sind stark, besonders die Output-Obergrenze von 393.216 Token, und der Preview-Rabatt macht einen zweiwöchigen Test günstig. Aber ohne Benchmarks, ohne Preis pro Token, mit einem Verbot für Backend-Nutzung und einem harten Stopp am 25. November gibt es hier noch nichts, worauf man aufbauen könnte.
Probier es, wenn du in einem Coding-Agenten lebst und ein Long-Context-Qwen bei 20 % (oder 8 %) der Credit-Rate testen willst. Lass es, wenn du ein Modell für eine App, einen Support-Bot oder ein Kostenmodell brauchst. Nimm jetzt Qwen 3.8 Max, und komm zurück, wenn Alibaba die vollständige Version ausliefert.
Probiere eesel für Support, der nicht auf Modell-Launches wartet
Wenn dein eigentliches Ziel ist, Kunden schneller zu antworten: eesel ist ein KI-Helpdesk-Teammitglied, das sich in den Helpdesk einbindet, den du schon nutzt, aus deinen vergangenen Tickets und deinem Help Center lernt und an historischen Gesprächen getestet wird, bevor es ein echtes berührt. smava nutzt es, um deutsche Antworten über 27.000 Zendesk-Tickets im Monat zu entwerfen. Du kannst die Preise ansehen oder eesel kostenlos testen.
Häufig gestellte Fragen
Ist Qwen 4 Max schon verfügbar?
qwen4-max-preview (Alias qwen4.0-max-preview), gestartet am 11. November 2026 um 10:00 Uhr Pekinger Zeit. Alibaba sagt, die Preview laufe bis zum 25. November 2026, danach wird das Modell abgeschaltet. Eine vollständige Qwen-4-Max-Veröffentlichung wurde noch nicht angekündigt. Zum Modell, auf dem es aufbaut, siehe meinen Qwen 3.8 Max Test.Was kostet Qwen 4 Max?
Gibt es Benchmarks für Qwen 4 Max?
Kann ich die Qwen-4-Max-API in meiner App nutzen?
Was ist der Unterschied zwischen Qwen 4 Max und Qwen 3.8 Max?
max_tokens begrenzt jetzt Denken und Antwort zusammen. Siehe meine Aufschlüsselung der Qwen 3.8 Max Preise.Funktioniert Qwen 4 Max mit Claude Code?
qwen4-max-preview. Mein Leitfaden zur Claude Code Modellauswahl erklärt, wie der Modellwechsel funktioniert.