

Qwen 4 Max ist Alibabas nächstes Flaggschiff-Modell, und aktuell erreichst du es nur als qwen4-max-preview im Token-Plan-Abo, ab 3 $ im Monat für Neukunden, bis zum 25. November 2026. Es ist ein multimodales Reasoning-Modell mit 1-Mio.-Token-Kontext und maximal 393.216 Output-Tokens. Beim Setup stolpern die meisten: Alibabas eigene Claude-Code-Konfiguration legt Qwen 4 Max in den Opus-Slot und den Router auto in den Hauptslot, sodass du Qwen 4 Max unter Umständen gar nicht aufrufst, wenn du nicht Opus wählst. Für KI auf Support-Tickets läuft eesel dagegen auf stabilen Modellen, und das eesel CLI lässt einen Coding-Agenten erst Hilfeartikel laden und Antworten testen.
Was ist Qwen 4 Max?
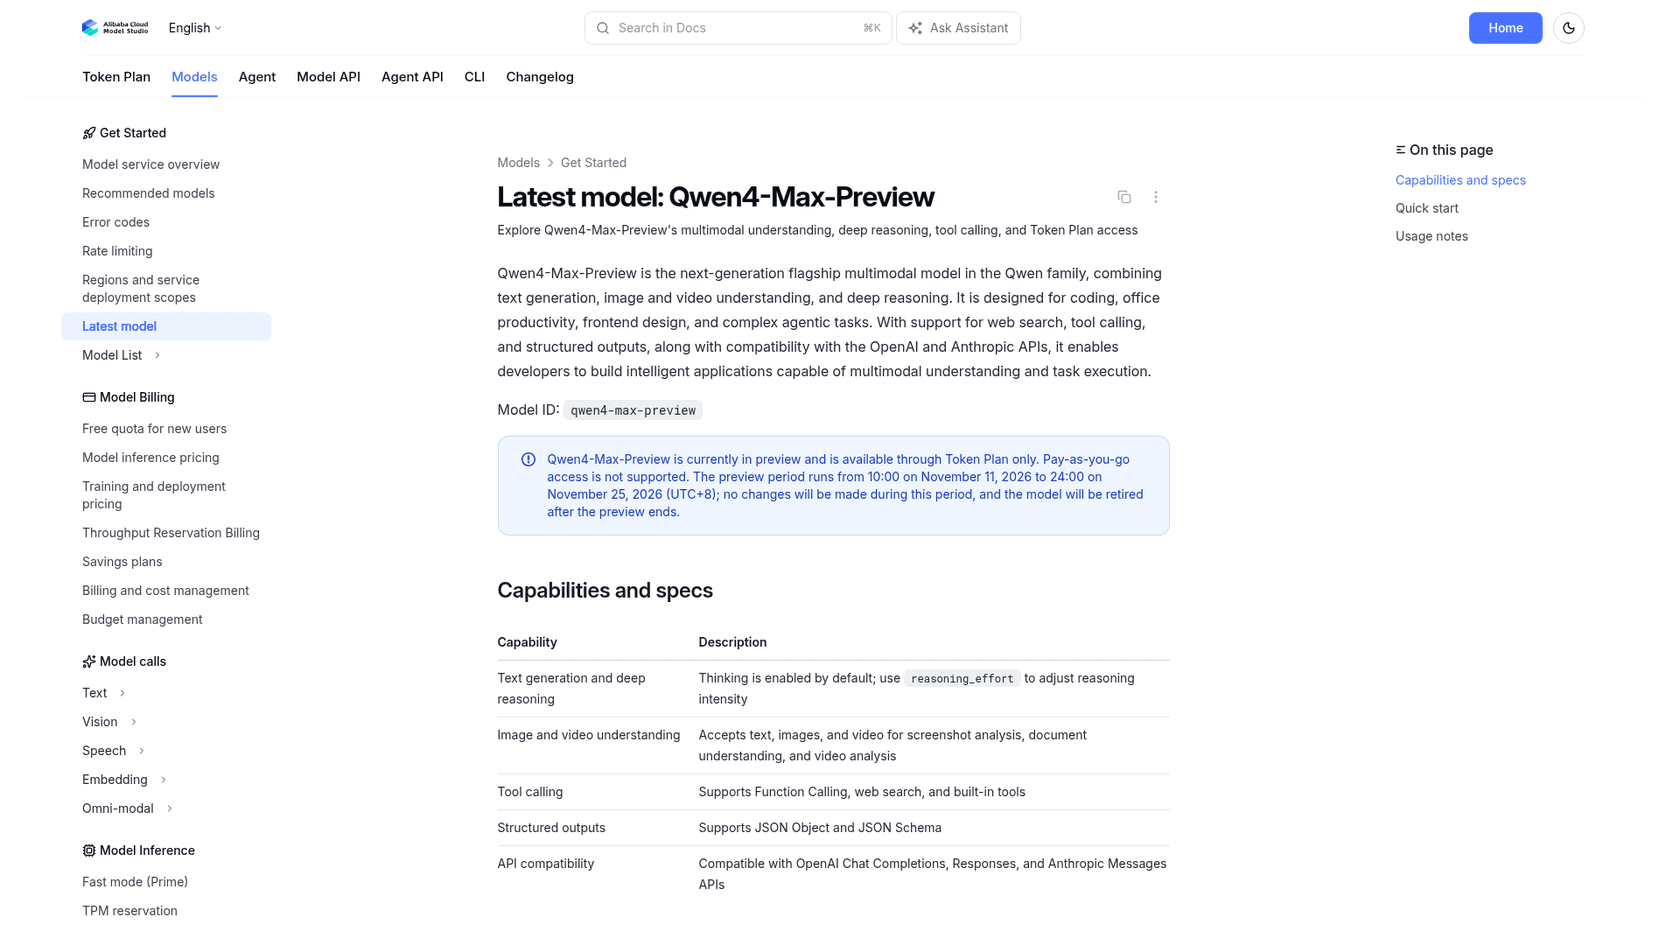
Qwen 4 Max ist das erste Modell in Alibabas Qwen-4-Generation, veröffentlicht am 11. November 2026 als Vorschau namens qwen4-max-preview. Alibabas Modell-Dokumentation beschreibt es als das multimodale Flaggschiff-Modell der nächsten Generation in der Qwen-Familie, ausgelegt auf Coding, Büroarbeit, Frontend-Design und Agenten-Aufgaben.
Ich baue bei eesel hauptberuflich Integrationen, deshalb ist meine erste Frage bei jedem neuen Modell langweilig: Was trage ich in die Konfiguration ein, und was geht dabei kaputt? Dieser Beitrag beantwortet genau das. Willst du meine Einschätzung, ob das Modell gut ist, die steht im Qwen 4 Max Review meines Kollegen.
Hier ist alles, was Alibaba bisher bestätigt hat:
| Spezifikation | Qwen 4 Max Preview |
|---|---|
| Modell-ID | qwen4-max-preview (Alias qwen4.0-max-preview, Rechnungen zeigen den Alias) |
| Input | Text, Bilder und Video |
| Kontextlänge | 1 Mio. Tokens |
| Max. Output | 393.216 Tokens, gemeinsam für Thinking und Antwort |
| Thinking | Standardmäßig an; low, medium oder xhigh (Standard) |
| Tools | Function Calling, Websuche, integrierte Tools |
| Structured Output | JSON Object und JSON Schema |
| API-Formate | OpenAI Chat Completions, Responses, Anthropic Messages |
| Zugang | nur Token Plan, kein Pay-as-you-go |
| Verfügbarkeit | 11. Nov., 10:00 Uhr bis 25. Nov., 24:00 Uhr, 2026 (UTC+8), danach abgeschaltet |
Es gibt keine Parameteranzahl, keine offenen Gewichte, keine Modellkarte und keine Benchmark-Tabelle. Das ist für eine zweiwöchige Vorschau normal, bedeutet aber: Das ist ein Modell zum Ausprobieren, nicht eins, auf das du planst.
Wo steht Qwen 4 Max in der Qwen-Reihe?
Qwen 4 Max steht an der Spitze von Alibabas gehosteter Modellreihe, eine Stufe über Qwen 3.8 Max. Die Modellliste im Token Plan stellt sie direkt nebeneinander, das gibt den klarsten Überblick, was du heute tatsächlich aufrufen kannst:
| Modell-ID im Token Plan | Wofür Alibaba es listet | Status |
|---|---|---|
qwen4-max-preview | Reasoning, visuelles Verständnis, Text | Preview, läuft am 25. Nov. aus |
qwen3.8-max | Reasoning, visuelles Verständnis, Text | Veröffentlicht |
qwen3.8-flash | Reasoning, visuelles Verständnis, Text | Veröffentlicht |
qwen3.7-max | Reasoning, Text | Veröffentlicht |
qwen3.7-plus | Reasoning, visuelles Verständnis, Text | Veröffentlicht |
qwen3.6-flash | Reasoning, visuelles Verständnis, Text | Veröffentlicht |
auto | Wählt pro Anfrage ein Modell | Plattform-Router |
Derselbe Plan führt außerdem DeepSeek V4.1 Flash, DeepSeek V4 Pro, GLM 5.3 und GLM 5.2, plus Bild-, Video- und Sprachmodelle. Mit einem Abo bekommst du also Qwen 4 Max neben einer Handvoll Modellen, mit denen du es an derselben Aufgabe vergleichen kannst, das ist der beste Nutzen der Vorschau.
Was fehlt, ist der Teil, den viele an Qwen am liebsten mögen: die kleineren Modelle, die man lokal laufen lässt. Die Max-Stufe ist nur gehostet, und die Vorschau erscheint ohne offene Gewichte. Wer Qwen auf eigener Hardware betreibt, sollte auf die kleineren Qwen-4-Modelle achten, und Qwen 3.8 Flash Next ist in der Zwischenzeit die aktuelle Wahl.
Was kostet Qwen 4 Max?
Für Qwen 4 Max gibt es keinen Preis pro Token. Du zahlst für ein Token-Plan-Abo in Credits, und Alibaba veröffentlicht nicht die Standard-Credit-Rate für einen Qwen-4-Max-Aufruf, nur den Vorschau-Rabatt darauf. Die Stufen der Personal Edition stammen aus der Token-Plan-Dokumentation:
| Plan | Listenpreis | Neukundenpreis | Monatliche Credits | Parallele Agenten |
|---|---|---|---|---|
| Lite | 6 $/Monat | 3 $/Monat | 20.000 | 1-2 |
| Essential | 10 $/Monat | 5 $/Monat | 45.000 | 2-3 |
| Standard | 18 $/Monat | - | 80.000 | 3-4 |
| Pro | 43 $/Monat | - | 200.000 | 6-8 |
Der Neukundenpreis gilt bis 23:59 Uhr am 30. November 2026 (UTC+8), für Accounts, die noch nie ein Personal-Abo gekauft haben. Zusatzpakete kosten 15 $ für 20.000 Credits, bis zu fünf auf einmal. Während der Vorschau verbraucht Qwen 4 Max Credits zu 20 % der Standardrate, und zu 8 % zwischen 22:00 und 8:00 Uhr Pekinger Zeit, was dem US-Arbeitstag entspricht.
Zwei Dinge in den Bedingungen solltest du vor dem Bezahlen lesen. Die Personal Edition lässt sich nicht kündigen, wähle also den kürzesten Zeitraum. Und ungenutzte Credits werden nicht in den nächsten Monat übernommen. Für einen zweiwöchigen Test reicht den meisten der 3-$-Lite-Plan. Willst du ein Modell mit Preisliste, mit dem du ein Budget planen kannst: Qwen 3.8 Max Preise liegen bei 2 $ Input und 6 $ Output pro 1 Mio. Tokens.
Wie bekommst du Zugang zu Qwen 4 Max?
Du bekommst Zugang in drei Schritten, laut Alibabas Token-Plan-Schnellstart: abonnieren, einen Schlüssel erzeugen und dein Tool auf den richtigen Endpunkt richten.
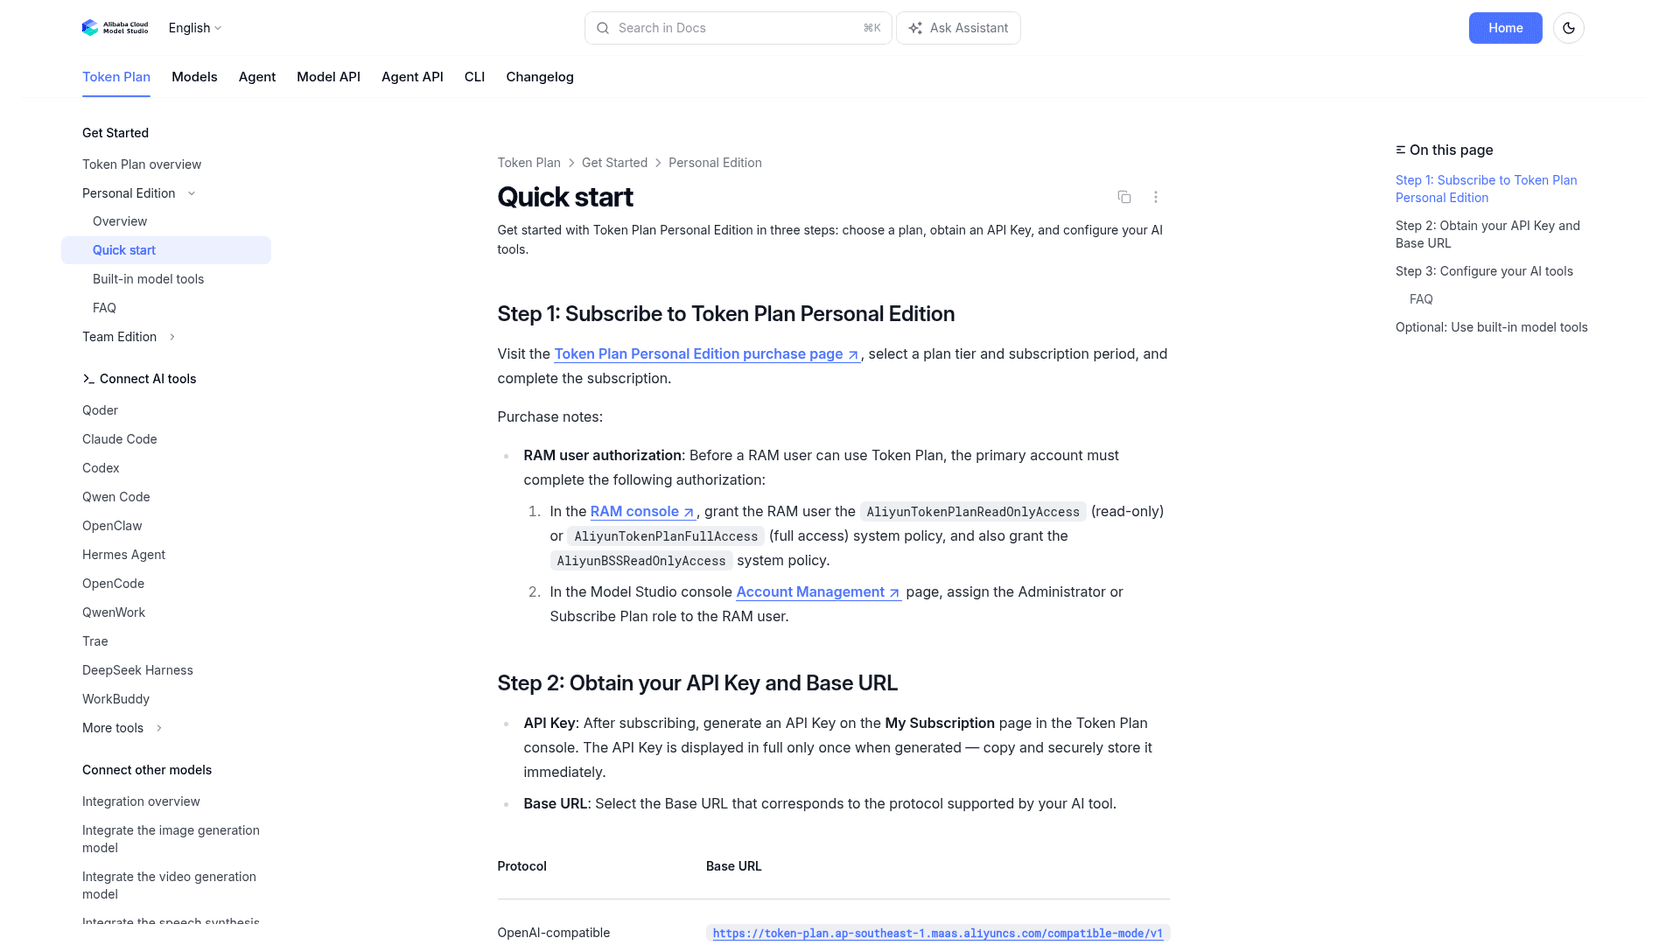
- Abonniere den Token Plan Personal (nur Region Singapur) und wähle eine Stufe.
- Erzeuge einen API-Schlüssel auf der Seite „My Subscription“. Er wird nur einmal vollständig angezeigt, kopiere ihn also sofort. Token-Plan-Schlüssel beginnen mit
sk-sp-. - Nutze die Token-Plan-Basis-URL für das Protokoll deines Tools:
| Protokoll | Basis-URL |
|---|---|
| OpenAI-kompatibel | https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1 |
| Anthropic-kompatibel | https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic |
Setze dann die Modell-ID auf qwen4-max-preview.
Schlüssel und Endpunkt müssen zusammenpassen
Das ist der Fehler, der echtes Geld kostet. Alibaba betreibt drei getrennte Abrechnungskanäle, Token Plan, Coding Plan und Pay-as-you-go, jeder mit eigenen Schlüsseln und Basis-URLs. Die Token-Plan-FAQ sagt, dass die Nutzung des allgemeinen dashscope-intl.aliyuncs.com-Endpunkts oder eines Coding-Plan-Schlüssels Aufrufe stattdessen über Pay-as-you-go leitet, und diese Kosten lassen sich nicht mit Credits verrechnen oder erstatten.
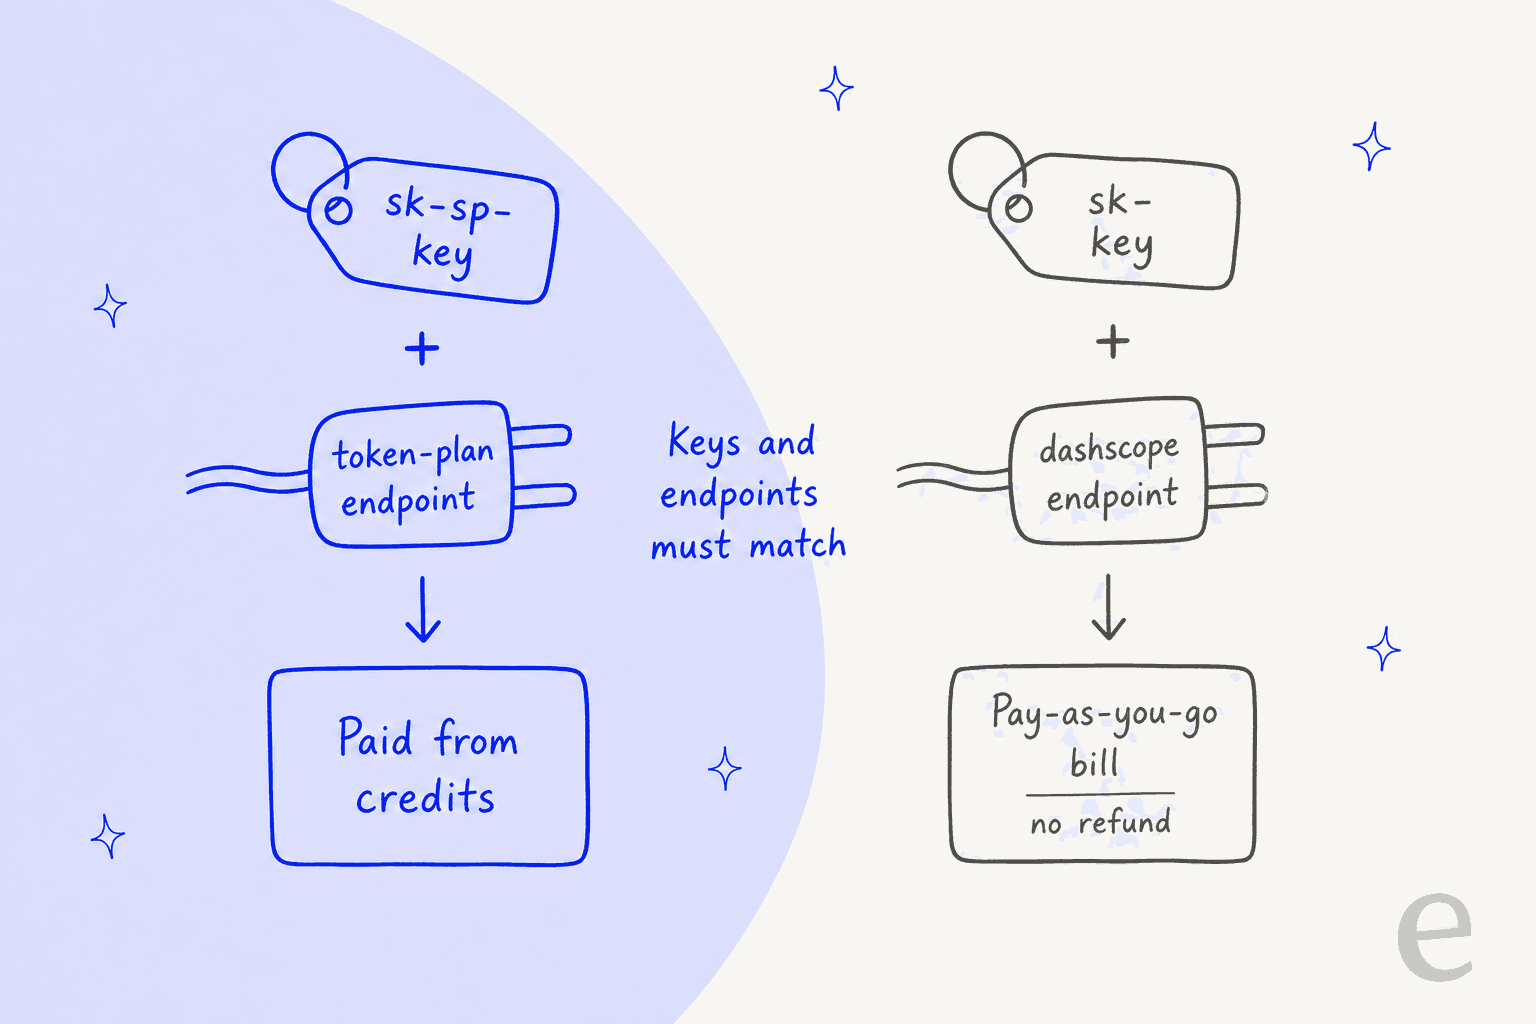
Wenn du Qwen schon einmal über Alibaba genutzt hast, steht in deiner Tool-Konfiguration wahrscheinlich noch ein alter sk--Schlüssel und die DashScope-URL. Tausche den Schlüssel, die URL und den Modellnamen aus.
Wie führst du Qwen 4 Max in Claude Code aus?
Du führst es aus, indem du Claude Code auf den Anthropic-Endpunkt des Token Plans richtest und einen Modell-Slot auf qwen4-max-preview zuordnest. Alibabas Claude-Code-Anleitung gibt diese Konfiguration für die CLI vor:
export ANTHROPIC_AUTH_TOKEN="YOUR_API_KEY"
export ANTHROPIC_BASE_URL="https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic"
export ANTHROPIC_MODEL="auto"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="qwen3.6-flash"
export ANTHROPIC_DEFAULT_SONNET_MODEL="qwen3.8-flash"
export ANTHROPIC_DEFAULT_OPUS_MODEL="qwen4-max-preview"
export CLAUDE_CODE_SUBAGENT_MODEL="auto"
export CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"
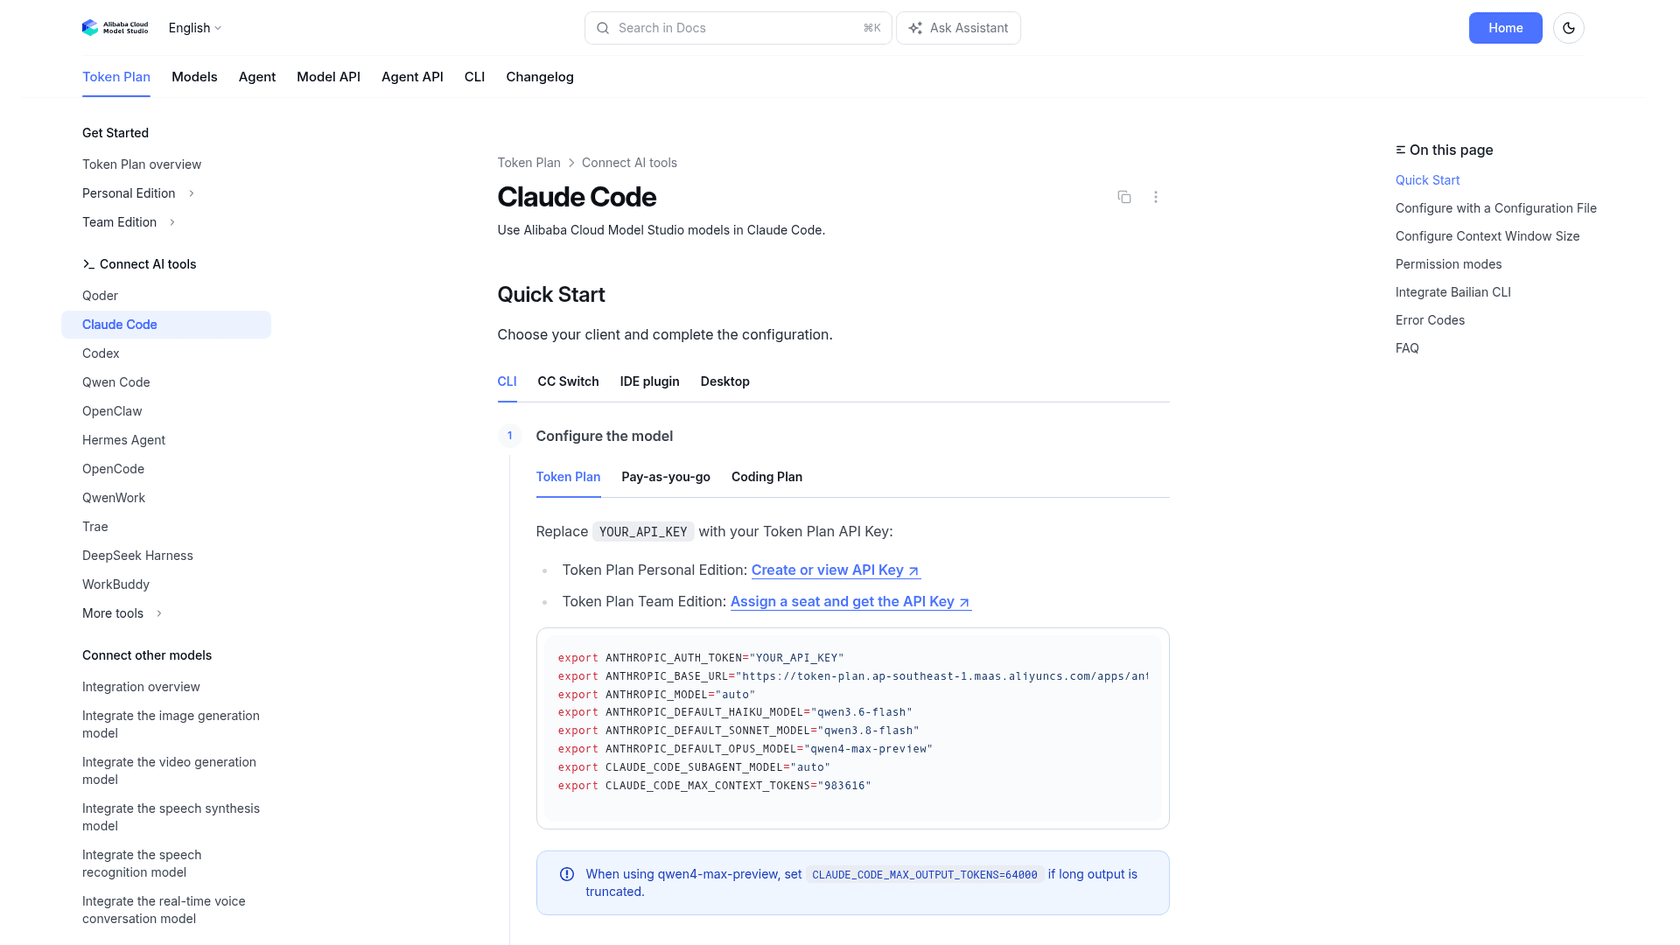
Lies diesen Block genau, denn er tut nicht das, was die meisten erwarten. Das Hauptmodell ist auto, Alibabas Router, und Subagenten laufen ebenfalls darüber. Qwen 4 Max steckt nur im Opus-Slot.
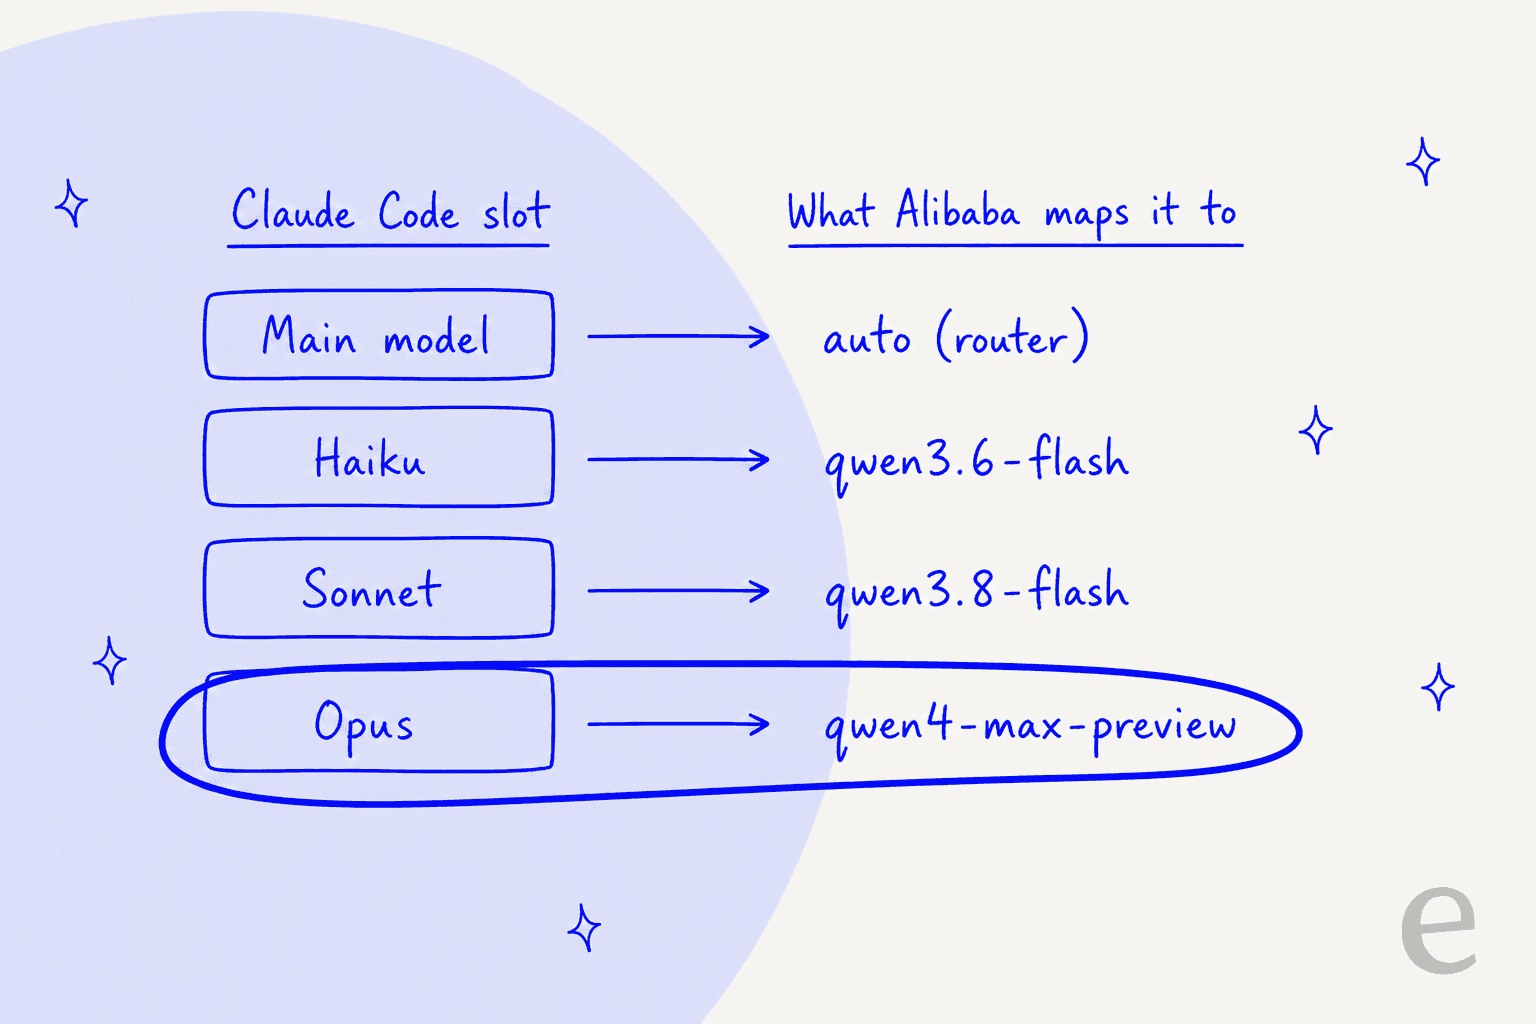
Fügst du das also ein und startest eine Session, gehen deine Prompts an das, was auto auswählt, nicht an Qwen 4 Max. Um das neue Modell wirklich zu testen, wechsle in der Session mit /model opus, oder setze ANTHROPIC_MODEL="qwen4-max-preview" selbst. Wenn du Modelle vergleichst, mach das Zweite, damit jeder Turn in deinem Test auf demselben Modell läuft. Mein Leitfaden zur Claude-Code-Modellauswahl erklärt, wie die Slots funktionieren.
Drei weitere Einstellungen sind wichtig:
- Output-Länge. Die Dokumentation merkt an, dass du bei abgeschnittenem langem Output mit
qwen4-max-previewCLAUDE_CODE_MAX_OUTPUT_TOKENS=64000setzen solltest. - Kontext.
CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"lässt Claude Code den Großteil des 1-Mio.-Fensters nutzen. Was das verändert, steht in meinem Leitfaden zum Claude-Code-Kontextfenster. - Dauerhaftigkeit. Diese Exports gelten nur für das aktuelle Terminal. Für ein dauerhaftes Setup gehören dieselben Keys unter
envin~/.claude/settings.json, wie in meinem Leitfaden zur Claude-Code-Konfiguration beschrieben.
Führe claude -p "Hello" aus, um die Verbindung zu prüfen. Für Claude Code Desktop leitet Alibabas Anleitung es über ein lokales Gateway namens CC Switch statt über Umgebungsvariablen.
Qwen Code, Cursor und andere Tools
Qwen Code nutzt den OpenAI-kompatiblen Endpunkt. Alibabas Beispiel-~/.qwen/settings.json listet qwen4-max-preview als eigenen Provider-Eintrag namens „Qwen4.0 Max Preview“, du wählst es also über den Namen statt über eine Slot-Zuordnung aus. Cursor, OpenAI Codex, OpenCode, OpenClaw, Cline, Qoder und Hermes Agent haben ebenfalls Token-Plan-Anleitungen. Prüfe bei jedem zwei Dinge: Die Basis-URL ist eine token-plan-URL, und die Modell-ID lautet exakt qwen4-max-preview.
Was ändert sich für Entwickler, die es direkt aufrufen?
Zwei Verhaltensweisen sind neu bei diesem Modell, und beide können eine Konfiguration kaputt machen, die bei älteren Qwen-Modellen funktioniert hat.
max_tokens deckt jetzt auch Thinking ab. Alibabas Kompatibilitätshinweis sagt, dass ab qwen4-max-preview max_tokens bei Chat Completions gleich max_completion_tokens ist, es begrenzt also Thinking und die endgültige Antwort gemeinsam. Thinking ist standardmäßig auf xhigh an. Hast du max_tokens nur für die Antwort bemessen, frisst das Reasoning das Budget auf, und die Antwort kommt abgeschnitten zurück. Ältere Qwen-Modelle behalten das alte Verhalten, deshalb trifft das Leute, wenn sie die Modell-ID wechseln.
Thinking muss zurückgegeben werden. Chat Completions aktiviert standardmäßig preserve_thinking. Die Modell-Dokumentation verlangt, früheres Thinking in jeder Assistant-Nachricht im Feld reasoning_content zurückzusenden, nicht innerhalb von content. Setze außerdem nicht reasoning_effort und thinking_budget gleichzeitig.
Noch etwas: Die integrierten Tools (Websuche, Bildsuche, Web-Scraping, Code-Interpreter) funktionieren laut Schnellstart nur über die Responses API, nicht über Chat Completions. Spricht dein Tool Chat Completions, bekommst du sie nicht.
Qwen-4-Max-Setup-Check
Hak ab, was auf dein Setup zutrifft. Was offen bleibt, ist wahrscheinlich der Grund, warum es nicht funktioniert.
Was kannst du mit Qwen 4 Max nicht tun?
Du kannst kein Produkt darauf aufbauen, aus zwei Gründen, die nichts damit zu tun haben, wie schlau es ist.
Erstens ist es befristet. Die Dokumentation sagt, dass während der Vorschau keine Änderungen vorgenommen werden und das Modell nach deren Ende abgeschaltet wird. Alles, was qwen4-max-preview aufruft, funktioniert nach dem 25. November nicht mehr.
Zweitens verbietet es der Token Plan. Die Abo-Bedingungen besagen, dass der Plan nur für die interaktive Nutzung in Coding- und Agenten-Tools gedacht ist und nicht für „Automatisierungsskripte, eigene Anwendungs-Backends oder nicht-interaktive Batch-Aufruf-Szenarien“ verwendet werden darf. Die FAQ fügt hinzu, dass auch geplante Hintergrundaufgaben dazu zählen und dass das Teilen eines Schlüssels zur Sperrung führen kann. Ein Support-Chatbot, ein Ticket-Klassifizierer oder eine KI-Kundenservice-API, die mit diesem Schlüssel verbunden ist, verstößt also schon beim ersten Aufruf gegen die Regeln.
Frühe Nutzer sehen es bereits als Testfahrt. Ein Hacker-News-Kommentator hat den Deal in einem Satz zusammengefasst:
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"

Und bei der Qualität gibt es noch keinen Konsens. Ein breit geteilter X-Post nannte es „enttäuschend“, basierend auf dem, was der Autor selbst als Gerüchte bezeichnete, und eine Antwort von jemandem, der es tatsächlich testet, widersprach:
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Mein Rat: Teste es an einer Aufgabe, die du mit deinem üblichen Modell schon gelöst hast, etwa Claude Fable 5.2 oder GPT-6.1 Terra, und beurteile es daran. Ein eingefrorenes zweiwöchiges Modell ist fair zum Testen, aber schlecht zum Bauen.
Was bedeutet Qwen 4 Max für Support-Teams?
Für ein Support-Team ist Qwen 4 Max ein Modell zum Ausprobieren am eigenen Schreibtisch, nicht eins für die eigene Warteschlange. Das klären die Bedingungen und das Abschaltdatum.
Die größere Lektion wiederholt sich jede Launch-Woche. Ein Modell ist der Motor, nicht der Agent. Was KI auf Tickets wirklich nützlich macht, ist die Ebene darum herum: dein Helpcenter, deine vergangenen Tickets, die Regeln, wann an einen Menschen übergeben wird, und Tests gegen echte Gespräche, bevor irgendetwas einen Kunden erreicht. Genau dafür ist eesels KI-Teammitglied für den Helpdesk gebaut. Es reiht sich in die Warteschlange ein, die du bereits in Zendesk oder Freshdesk betreibst, lernt aus deiner Historie und wird zuerst gegen vergangene Tickets simuliert.
OroSoft ist ein gutes Beispiel für den Grounding-Teil. Das Unternehmen baut Software für den Edelmetallhandel und betreut Kunden über Freshdesk. Erwähnt ein Agent eesel auf einem Ticket, entwirft es eine Antwort aus 6.100 vergangenen Tickets und 20 Helpcenter- und Referenzdateien, nennt, welches Ticket oder welchen Artikel es genutzt hat, und hinterlässt eine Notiz mit der Bitte um einen Menschen, wenn es keine Unterstützung für eine Antwort findet. smava, ein deutsches Kreditvergleichsportal, betreibt eesel über zwei Zendesk-Marken und hat in einem Monat 27.000 Tickets bearbeitet.
Keins der beiden Setups ändert sich, wenn ein neues Modell startet, und genau das ist der Punkt. Willst du wissen, wie ein Modell mit deinem eigenen Support-Content umgeht, sind meine Leitfäden zum Claude mit deinem Helpdesk verbinden, zu KI-Agenten-Übergaben und zum Vermeiden von Halluzinationen ein besserer Start als ein Vorschau-Schlüssel.
Solltest du Qwen 4 Max diese Woche einrichten?
Ja, wenn du in einem Coding-Agenten lebst und zwei günstige Wochen mit einem 1-Mio.-Kontext-Qwen willst. Der 3-$-Lite-Plan, die 20-%-Credit-Rate und die 8-%-Nachtrate machen das Ausprobieren fast kostenlos, solange du den Modell-Slot richtig setzt und deinen Schlüssel zum Token-Plan-Endpunkt passend wählst.
Nein, wenn du ein Modell für eine App, einen Bot oder ein Budget brauchst. Nutze dafür Qwen 3.8 Max im Pay-as-you-go, und schau wieder vorbei, wenn Alibaba das vollständige Qwen 4 Max mit Preis und Benchmarks ausliefert. Für einen breiteren Blick auf die Familie decken meine Qwen-Übersicht und Qwen-Alternativen den Rest ab.
Teste eesel für KI auf deiner Support-Warteschlange
Willst du eigentlich KI, die Kunden antwortet: eesel ist ein KI-Teammitglied für den Helpdesk, das sich in den Helpdesk einklinkt, den du schon nutzt, aus deinen vergangenen Tickets und deinem Helpcenter lernt und an historischen Gesprächen getestet wird, bevor es ein echtes anfasst. OroSoft nutzt es, um fundierte Freshdesk-Antworten zu entwerfen, die das Ticket zitieren, aus dem sie stammen. Du kannst dir die Preise ansehen oder eesel kostenlos testen.
Häufig gestellte Fragen
Was ist Qwen 4 Max?
qwen4-max-preview, ein multimodales Reasoning-Modell mit 1-Mio.-Token-Kontext und maximal 393.216 Output-Tokens. Es ging am 11. November 2026 live und wird nach dem 25. November abgeschaltet. Die Qwen 4 Max Review zeigt, was die Vorschau aussagt und was nicht.Wie nutze ich Qwen 4 Max?
sk-sp- beginnt, richte dein Tool auf die Token-Plan-Basis-URL und setze die Modell-ID auf qwen4-max-preview. Unterstützte Tools sind unter anderem Claude Code, Cursor, Qwen Code und OpenClaw.Ist Qwen 4 Max kostenlos?
Ist die Qwen 4 Max API verfügbar?
Wie lange ist Qwen 4 Max verfügbar?
qwen4-max-preview-ID abhängt, funktioniert dann nicht mehr. Meine Übersicht zu LLM-Tracking-Tools hilft dir, den vollständigen Release im Blick zu behalten.Wie richte ich Qwen 4 Max in Claude Code ein?
ANTHROPIC_BASE_URL auf den Anthropic-Endpunkt des Token Plans, trage deinen sk-sp--Schlüssel in ANTHROPIC_AUTH_TOKEN ein und ordne ANTHROPIC_DEFAULT_OPUS_MODEL auf qwen4-max-preview zu. Alibabas eigene Konfiguration setzt das Hauptmodell auf auto, wähle also mit /model Opus, um sicherzugehen, dass du Qwen 4 Max nutzt. Mein Leitfaden zu Claude-Code-Umgebungsvariablen erklärt jede Variable.Was ist der Unterschied zwischen Qwen 4 Max und Qwen 3.8 Max?
max_tokens deckt jetzt Thinking und Antwort gemeinsam ab. Qwen 3.8 Max ist bereits veröffentlicht, hat unabhängige Benchmark-Werte und kostet im Pay-as-you-go 2 $ Input und 6 $ Output pro 1 Mio. Tokens. Details in meiner Qwen 3.8 Max Preisübersicht.