

Resumo
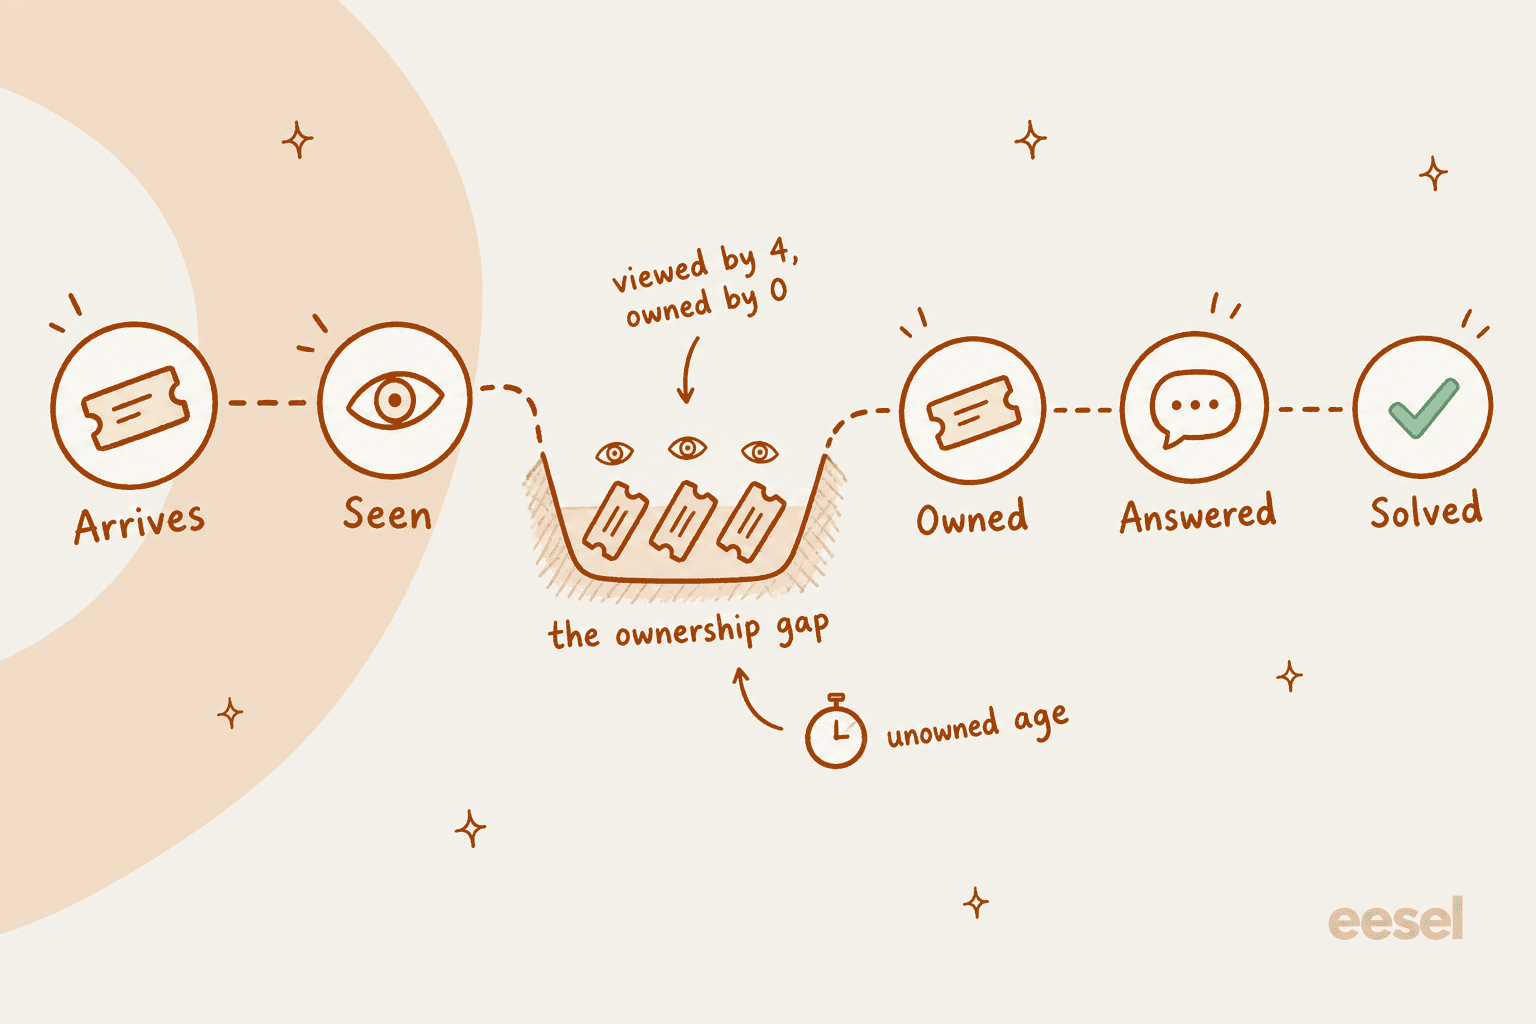
Gestão de fila de suporte compartilhada é como uma equipe de suporte divide um único conjunto de tickets para que cada ticket tenha um responsável, rapidamente. O que quebra filas compartilhadas raramente é o volume. É a lacuna entre um ticket visto por todos e que não é de ninguém. Resolva isso primeiro: escolha um modelo de atribuição de propósito (pull, push ou híbrido), dê a cada ticket novo um responsável dentro de um prazo definido e acompanhe a idade do ticket mais antigo sem responsável, não só o tempo de primeira resposta.
A maioria dos helpdesks consegue empurrar tickets para os agentes por você, mas a configuração geralmente fica atrás de um limite de plano. O round robin está no Freshdesk Pro ($55 por agente) e no Help Scout Plus ($45), o balanceamento de carga do Front está no Professional ($65), e o roteamento por habilidades está no Zendesk Suite Professional ($115) ou no Freshdesk Enterprise ($89). O Gorgias inclui a atribuição automática em todos os planos de helpdesk.
A IA agora cuida bem da etapa de triagem. Em um teste da eesel com tráfego real do Zendesk, a triagem atingiu 93% de precisão e pegou 100% do spam. O colega de IA para helpdesk da eesel etiqueta, roteia e responde os tickets fáceis dentro da sua fila atual, para que sua equipe pegue só o que precisa de uma pessoa.
O que é gestão de fila de suporte compartilhada?
Uma fila de suporte compartilhada é uma única lista de tickets recebidos da qual uma equipe inteira trabalha, em vez de cada agente ter sua própria caixa de entrada. A gestão de fila de suporte compartilhada é o conjunto de regras que decide quem pega qual ticket, com que rapidez ele ganha um responsável, o que acontece quando alguém está ausente e como você percebe que algo escapou.
Trabalho na fila de suporte da eesel todos os dias e aprendi que a parte difícil de uma fila compartilhada não são os tickets difíceis. Os difíceis recebem atenção porque fazem barulho. Os que escapam são os tickets comuns que quatro pessoas abriram, leram e fecharam de novo, cada uma achando que outra pegaria.
Cada helpdesk mostra a fila compartilhada de um jeito um pouco diferente:
- Zendesk usa visualizações, incluindo uma visualização de não atribuídos padrão (documentação do Zendesk).
- Freshdesk usa visualizações de lista de tickets, com o roteamento definido por grupo (documentação do Freshdesk).
- Help Scout dá a cada caixa de entrada pastas fixas: Unassigned, Mine, Assigned, Closed e Spam (documentação do Help Scout).
- Front trabalha a partir de uma caixa de entrada compartilhada com abas Unassigned, Assigned e Waiting.
- Gorgias usa visualizações, com uma visualização padrão "Unassigned" de tickets abertos que ninguém possui (documentação do Gorgias).
Os nomes das ferramentas mudam. Os modos de falha não.
Por que filas compartilhadas quebram: a lacuna de responsabilidade
Este é o padrão que mais vejo. Chega um ticket. Três agentes o veem na fila. Cada um tem outra coisa aberta, então cada um segue em frente. O nome de ninguém está nele, então ninguém sente que ele está envelhecendo.
Um líder de TI de uma escola descreveu anos atrás a versão de tirar do monte, e ainda soa como toda fila de suporte sobrecarregada que já vi:
"We currently have an unending bucket of tickets, the engineers and I pluck out calls with little oversight, however this results in some calls falling to the bottom of the pile and getting ignored. There's no ownership of unassigned calls."

Fica caro quando o ticket que escapa é o urgente. Um administrador do Zendesk postou em fevereiro de 2026 sobre um cliente enterprise cujo sistema de produção caiu às 9h. O ticket ficou parado até as 14h atrás de mais de 30 tickets da madrugada, então o cliente ficou fora do ar por mais de 5 horas antes de alguém perceber que era crítico (r/Zendesk).
E em um tópico sobre um ticket que ficou dois dias sem atribuição e rendeu uma avaliação de 1 estrela, a história foi a clássica: todos presumiram que outra pessoa o havia pegado. Uma resposta apontou a causa sem rodeios:
"That's not a system issue (crappy help desk software, bad ticketing system). It's a bad work ethic ("Meh, Bob can get that. Or Cindy. IDC, I'm busy on Reddit.")
Systems can help with setting SLAs and possibly even forcing ownership, but ultimately it's up to the team to take responsibility and do their jobs."
Concordo em parte. A ética de trabalho importa. Mas um desenho de fila que depende de todos lembrarem de pegar o próximo ticket vai falhar no dia mais cheio, quando todos já estão com três. A solução é tornar a responsabilidade automática ou fazer dela o trabalho de alguém, não torcer.
Essa é a mudança em que este post se apoia: meça o tempo sem responsável, não só o tempo de resposta. Sua média de tempo de primeira resposta pode parecer boa enquanto um ticket envelhece a tarde toda, porque médias escondem a cauda da distribuição.
As três formas de atribuir trabalho em uma fila compartilhada
Toda fila compartilhada funciona com um de três modelos, a equipe tendo escolhido ou não.
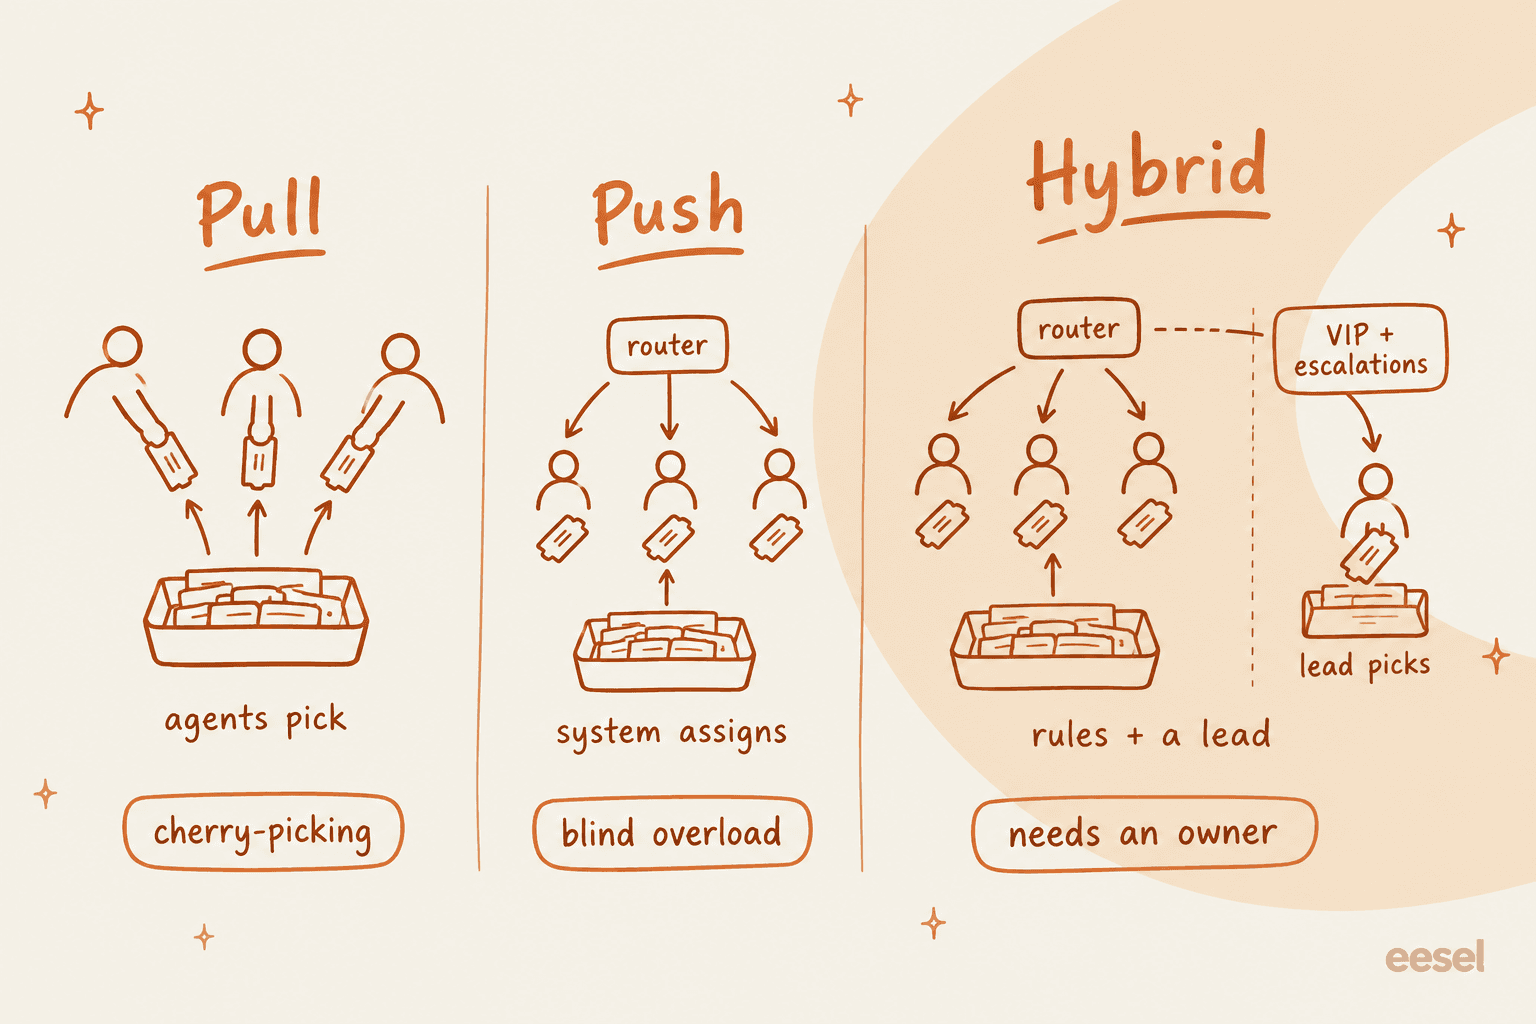
Pull significa que os agentes escolhem os próprios tickets na visualização compartilhada. É o padrão na maioria dos helpdesks e parece justo, porque bons agentes podem pegar mais. Sua fraqueza é escolher só o fácil. Uma equipe do Zendesk admitiu fazer isso de propósito quando estava sobrecarregada:
"If we're underwater we do an easy out method where we cherry-pick the simple tickets (can be handled in less than 5 minutes) and have a portion of the team hit those while the rest does fifo."
Essa é a versão inteligente e deliberada. A versão acidental é todo mundo pular em silêncio o mesmo ticket chato.
Push significa que o helpdesk atribui os tickets por você, com regras de roteamento de tickets: round robin (próximo agente da fila), por carga (menos tickets abertos) ou por habilidades (idioma, produto ou nível correspondentes). Resolve a responsabilidade, mas pode sobrecarregar quem está online por acaso, e não sabe quais tickets são difíceis. Uma equipe do Zendesk descobriu isso depois de trocar:
"We recently moved from Round Robin to OCR and it's been a bit of a nightmare."
No mesmo post, descreveram 2-3 agentes recebendo 15 tickets de e-mail enquanto o resto recebia alguns ou nenhum, e alguns tickets nunca saíam da visualização de não resolvidos. Isso geralmente é um problema de configuração de capacidade e status, não um motivo para voltar ao pull, mas mostra que o push precisa de ajuste.
Híbrido significa atribuição automática para o fluxo normal, mais uma faixa pequena que um líder trabalha à mão: contas VIP, escalonamentos, qualquer coisa que as regras não consigam encaixar. A maioria das equipes que eu aconselharia acaba aqui.
| Modelo | Quem decide | Melhor para | Risco principal | O que adicionar |
|---|---|---|---|---|
| Pull | Agentes escolhem | Equipes pequenas, tickets parecidos | Escolher só o fácil, tickets envelhecendo | Visualização com os mais antigos primeiro, um responsável diário pela triagem |
| Push | Regras do helpdesk | Filas cheias, chat e mensagens | Sobrecarregar quem está online | Limites de capacidade, status de ausência, reatribuição |
| Híbrido | Regras mais um líder | Níveis mistos, VIPs, vários idiomas | A faixa manual não tem responsável | Um responsável nomeado pela faixa em cada turno |
Se você ficar no pull, adicione uma regra a que todo tópico do Reddit sobre o assunto chega de alguma forma: uma pessoa responsável pelo que sobra. O líder de uma MSP descreveu a dele:
"our helpdesk team functions as one big resource pool. Inbound phone calls and tickets are automatically queued, and the techs check it every so often to take tickets. Helpdesk manager gets an alert if a ticket's been sitting in the intake queue for 30 minutes, at which point he'll assign to a resource."
Esse alerta de 30 minutos é o truque inteiro. Pull para a velocidade, uma rede de segurança para a responsabilidade.
Qual modelo de atribuição combina com a sua fila?
Escolha a linha que mais se parece com a sua equipe. Cada uma dá o modelo com que eu começaria e a configuração que o faz funcionar.
Qual modelo de atribuição combina com a sua fila?
Toque na descrição mais parecida com a sua equipe.
Comece com: pull, mais um responsável pela triagem
Mantenha os agentes escolhendo de uma visualização compartilhada ordenada com os mais antigos primeiro. Alterne um responsável diário pela triagem que atribui tudo que continuar sem dono depois do seu limite (de 30 a 60 minutos para e-mail é um bom começo).
Funciona em qualquer plano. Ative a detecção de colisão se o seu helpdesk tiver.
Comece com: push, por carga
Atribua os tickets novos automaticamente a quem tiver menos tickets abertos, com um limite de capacidade por agente para que ninguém fique soterrado. Mantenha uma faixa manual para escalonamentos.
Freshdesk Pro ($55), Help Scout Pro ($75) para o Balanced, Front Professional ($65), roteamento por capacidade do Zendesk nos planos Team e acima, Gorgias em todos os planos.
Comece com: híbrido, roteamento por habilidades ou por grupo
Roteie primeiro por idioma, produto ou nível e depois equilibre a carga dentro de cada grupo. Um líder cuida da faixa de VIPs e casos de borda em cada turno.
O roteamento por habilidades está no Zendesk Suite Professional ($115) e no Freshdesk Enterprise ($89). No Help Scout, Front e Gorgias, use equipes ou caixas de entrada separadas e roteie para elas com regras.
Comece com: só push
Clientes em um chat ao vivo não vão esperar enquanto os agentes navegam. Empurre as conversas para os agentes disponíveis, defina um temporizador curto para aceitar ou reatribuir e limite os chats simultâneos por agente.
O Zendesk pode reatribuir um ticket que um agente não aceita a tempo nos planos Professional e acima. O Gorgias pode remover a atribuição de chats quando o agente fica indisponível.
Como cada helpdesk lida com uma fila compartilhada
É aqui que os limites de plano pesam. Veja o que cada ferramenta faz sozinha, segundo a documentação e a página de preços de cada fornecedor em outubro de 2026. Os preços são por agente por mês conforme cada página de preços, com cobrança anual onde a página a oferece.
| Helpdesk | Round robin | Por carga ou capacidade | Por habilidades | Detecção de colisão | Políticas de SLA |
|---|---|---|---|---|---|
| Zendesk | Roteamento omnicanal, planos Team e acima (Suite Team $55) | Por capacidade é o padrão, planos Team e acima | Suite Professional $115, Support Enterprise | Todos os planos exceto Team | Suite Growth e acima |
| Freshdesk | Pro $55 | Pro $55 | Enterprise $89 | Growth $19 e acima | Uma política a partir do Growth; várias e escalonamentos no Pro |
| Help Scout | Plus $45 | "Balanced", Pro $75 | Não consta na documentação | Todos os planos | Standard 1, Plus 2, Pro ilimitadas |
| Front | Ação de regra, todos os planos | Balanceamento de carga, Professional $65 | Não consta na documentação | Sim, sem limite de plano informado | Metas de tempo, Professional $65 |
| Gorgias | Atribuição automática por menos tickets, todos os planos de helpdesk | Um limite de capacidade, todos os planos | Não consta na documentação | Banner "Also viewing" | Todos os planos de helpdesk |
Zendesk
O roteamento omnicanal do Zendesk empurra e-mail, chamadas e mensagens para os agentes com base no status e na capacidade livre deles. A atribuição por capacidade é o padrão: o trabalho vai para o agente elegível com mais folga naquele canal (regras de capacidade do Zendesk). Você pode trocar o método de atribuição para round robin, que escolhe o agente que está há mais tempo sem um ticket novo, desde que ele ainda tenha capacidade.
Meu guia de round robin no Zendesk percorre a configuração.
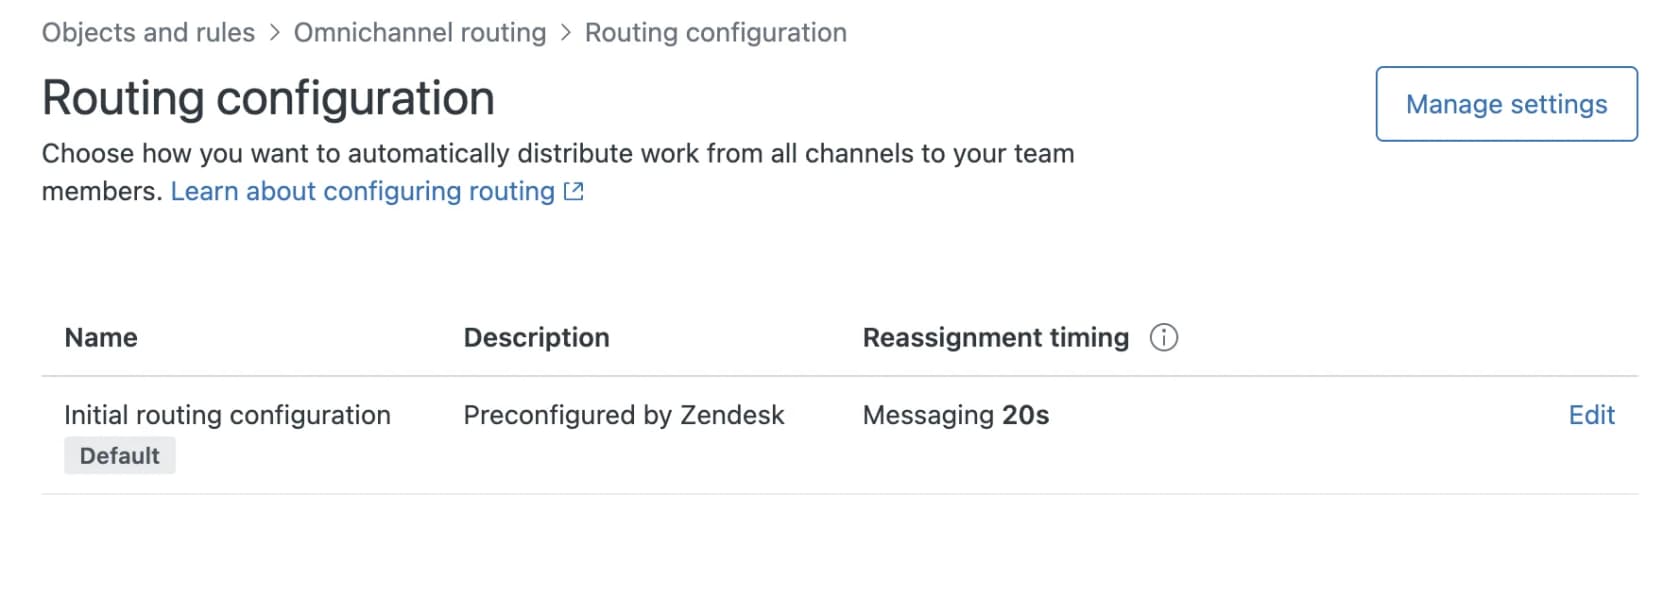
Três configurações importam mais para uma fila compartilhada:
- Habilidades. O roteamento por habilidades está no Suite Professional e acima. Habilidades obrigatórias nunca expiram; as opcionais caem após um tempo limite que você define (documentação de habilidades do Zendesk).
- Reatribuição. O Zendesk pode reatribuir até os 50 tickets abertos de e-mail e mensagens atualizados mais recentemente quando o status de um agente muda para um que você escolher. Reatribuir tickets reabertos, e reatribuir quando um agente não aceita a tempo, estão no Professional e acima (configuração de roteamento do Zendesk).
- Colisão. Um ícone de olho nas visualizações marca tickets que outra pessoa está vendo, mas a colisão de agentes não está disponível nos planos Team (documentação de colisão do Zendesk).
A triagem inteligente do Zendesk agora classifica intenção, sentimento e idioma nos planos Professional e acima sem custo extra, segundo o anúncio do Zendesk. Usar essas classificações no roteamento ainda exige o complemento Copilot, listado a $50 por agente por mês na página de preços do Zendesk.
Freshdesk
O Freshdesk define o roteamento por grupo. Em Admin, Groups, Group Properties, você escolhe manual ou Advanced Automatic Routing (com tecnologia Omniroute) com atribuição round-robin, por carga ou por habilidades.
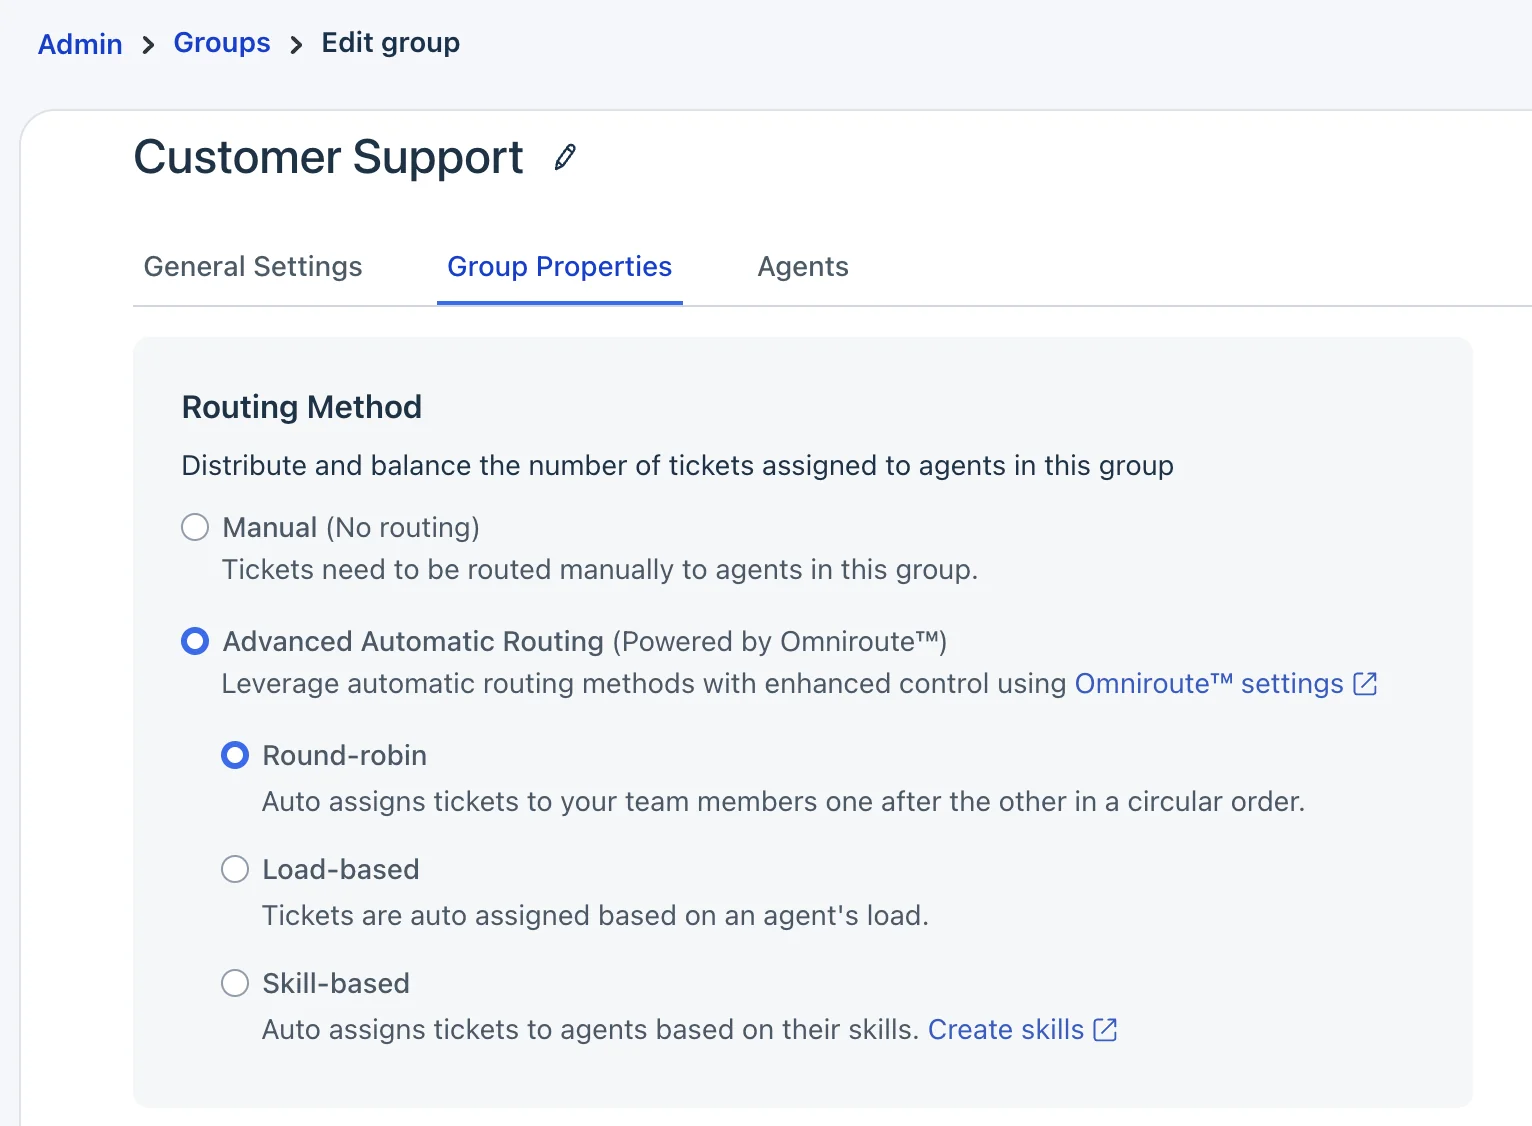
O round robin e a atribuição por carga estão no Pro e no Enterprise, e o round robin pula agentes que já estão no limite (documentação de round-robin do Freshdesk). A atribuição por carga dá cada ticket ao agente disponível menos carregado até que cada um atinja seu limite. O roteamento por habilidades é só Enterprise.
Na página de preços do Freshdesk, isso é Growth $19, Pro $55 e Enterprise $89 por agente.
Dois detalhes pegam as equipes de surpresa. Primeiro, um agente offline não pode receber tickets novos, e se ninguém estiver disponível o ticket fica sem atribuição. Segundo, uma atribuição manual pode empurrar um agente acima do limite, e esse excesso bloqueia a atribuição automática dele (documentação do Freshdesk Omniroute). Não encontrei uma configuração que devolva ao grupo os tickets de e-mail abertos de um agente offline, então planeje uma varredura manual na troca de turno. A detecção de colisão está no Growth e acima.
Help Scout
O Help Scout mantém a simplicidade. O roteamento oferece dois métodos: Round Robin, que atribui "one by one in alphabetical order", no Plus, e Balanced, que atribui ao colega com menos conversas ativas, no Pro (documentação de roteamento do Help Scout).
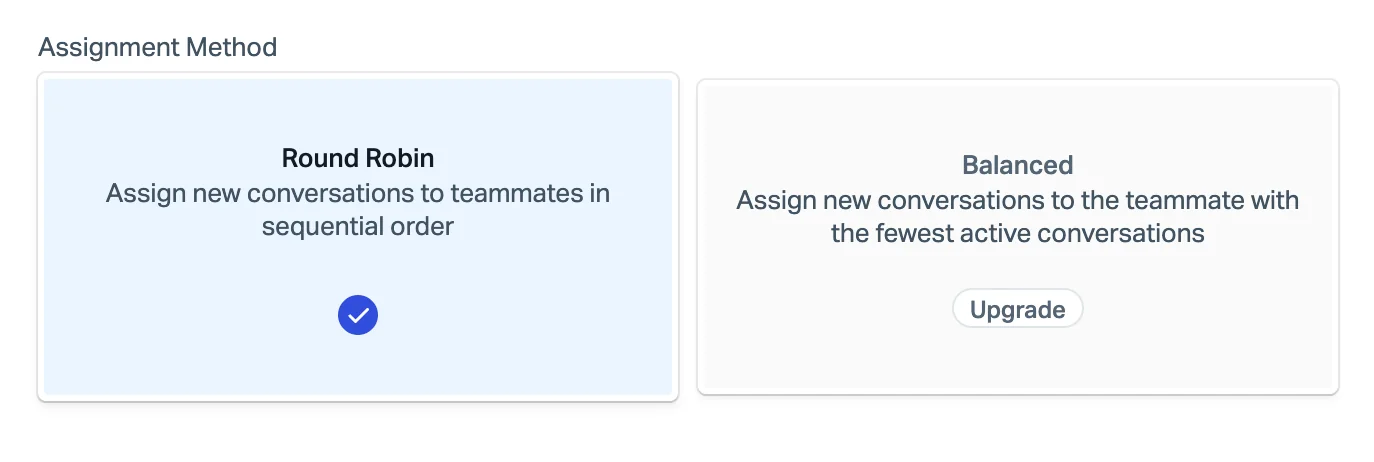
O roteamento pula colegas que estão Away ou no limite (até 100), trabalha primeiro o que espera há mais tempo e pega o que já está em Unassigned. Atribuições manuais e de workflows ignoram essas regras. A detecção de colisão está em todos os planos, e o Help Scout pausa a sua resposta se um colega respondeu ou o cliente escreveu desde que você abriu a conversa (documentação de colisão do Help Scout). Os preços do Help Scout listam Standard a $25, Plus a $45 e Pro a $75 por usuário por mês. Se você for combiná-lo com IA, meu guia de triagem no Help Scout cobre o que pode ser automatizado.
Front
O Front roteia com regras. Uma regra de round robin atribui por turnos a colegas online, mas se todos estiverem offline nada é atribuído e não há fila, então um colega que volta depois não recebe as conversas que perdeu (documentação de roteamento do Front). Uma regra de balanceamento de carga é mais inteligente para uma fila compartilhada: atribui a quem tem menos conversas abertas até o limite (máx. 100), enfileira quando todos estão cheios e retoma a partir da conversa sem resposta mais antiga. Está no Professional e acima (documentação de balanceamento de carga do Front).
O tratamento de ausência do Front é um dos melhores para uma fila compartilhada: respostas a conversas atribuídas a um colega fora do escritório removem a atribuição e voltam a Unassigned automaticamente, em todos os planos (documentação de fora do escritório do Front). Os preços do Front listam Starter $25, Professional $65 e Enterprise $105 por assento. Para o lado de IA, veja meu post sobre triagem no Front.
Gorgias
O Gorgias não cobra por agente. Cobra por volume de tickets, com planos de helpdesk do Starter a $10 por mês por 50 tickets até o Advanced a $750 por 5.000 com cobrança anual (preços do Gorgias). A atribuição automática está em todos os planos de helpdesk: regras enviam um ticket a uma equipe, depois o Gorgias ordena os tickets por prioridade e data de criação e os entrega a agentes disponíveis com menos tickets (documentação de auto-assign do Gorgias).
O limite de capacidade é um número só para todos os agentes, então você não pode dar a um novato uma carga mais leve que a de um agente sênior. O Gorgias pode remover a atribuição de um ticket reaberto quando o agente dele está offline e remover a atribuição de chats quando o agente fica indisponível. Meu guia de regras de atribuição do Gorgias aprofunda, e o post sobre visualizações do Gorgias cobre o lado da fila.
Impeça que duas pessoas respondam ao mesmo ticket
A falha oposta ao ticket perdido é o ticket duplicado: dois agentes respondem ao mesmo cliente com respostas ligeiramente diferentes. É mais raro que tickets perdidos, mas os clientes percebem mais. Um líder de CS em um tópico sobre caixas de entrada compartilhadas apontou a solução:
"Zendesk or hubspot would be good for tracking, and assigned ownership so multiple people don't try to take ownership and end up causing issues."
Há duas camadas de proteção. A primeira é a atribuição: um ticket com um único responsável desde o momento em que chega não pode ser pego duas vezes. A segunda é a detecção de colisão, que mostra quem mais está vendo ou digitando. A versão do Front é um bom exemplo do que procurar:
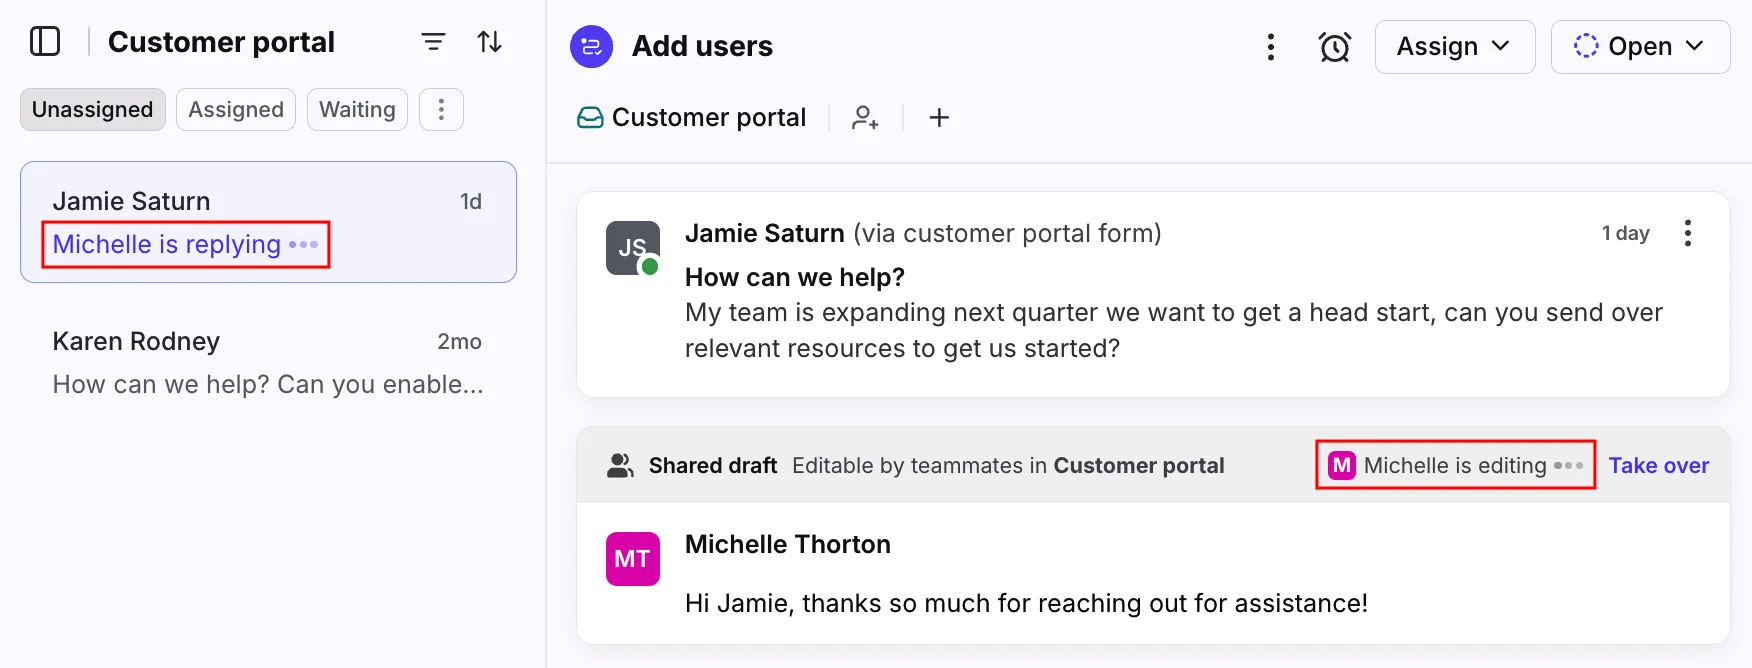
A marca "replying" aparece na própria lista, antes mesmo de você abrir a conversa, e o rascunho compartilhado tem um botão Take over para passagens de bastão (documentação de colisão do Front). Se o seu plano atual não tem detecção de colisão (Zendesk Team, Freshdesk Free), a atribuição push importa ainda mais, porque é a sua única proteção.
As regras que mantêm uma fila compartilhada honesta
As ferramentas dão as configurações. Estas seis regras decidem se as configurações funcionam.
- Todo ticket novo recebe um responsável dentro de um prazo definido. Escolha um número por canal, por exemplo 30 minutos para e-mail e alguns segundos para chat. Acompanhe-o como meta própria, separada do seu SLA de primeira resposta.
- Uma pessoa cuida do que sobra em cada turno. Um comentarista no tópico do ticket sem atribuição por dois dias sugeriu a versão mais simples: "Make one person responsible each day/week for triage; reading all calls as they come in, fixing the 5 minute ones and assigning out the remainder" (r/CustomerService).
- Ordene as visualizações compartilhadas com os mais antigos primeiro. Visualizações com os mais novos primeiro premiam pegar tickets frescos e fáceis. Com os mais antigos primeiro, o ticket que envelhece é a primeira coisa que todos veem.
- Defina limites de capacidade e respeite-os. Todo helpdesk acima permite que agentes se atribuam além do limite. Se os líderes continuarem despejando tickets no agente mais rápido, o roteamento push deixa de equilibrar qualquer coisa.
- Faça o status de ausência significar algo. O roteamento só pula agentes marcados como ausentes ou offline. Se os agentes esquecem de definir o status no almoço, os tickets se acumulam no nome deles. Combine isso com uma varredura de passagem de turno de tudo que ainda estiver atribuído a quem já saiu.
- Escale automaticamente os tickets sem responsável. Um gatilho ou automação que avise um líder quando um ticket ficou sem atribuição além do seu limite é um seguro barato. Meu guia para escalar tickets sem atribuição tem uma receita para o Zendesk, e os escalonamentos por SLA cobrem o lado da resposta.
Também há um ponto de justiça que os líderes deixam passar. Um sysadmin no Reddit descreveu que atendia 3 vezes mais chamadas que o resto da equipe e foi repreendido por ter tickets abertos demais, enquanto colegas que nunca tocavam na fila eram elogiados por um número "saudável" (r/sysadmin). Se você mede tickets abertos por agente em um modelo pull, pune quem puxa. Meça tickets atendidos e a idade sem responsável.
O que acompanhar em uma fila compartilhada
Você não precisa de um painel com 20 blocos. Precisa de quatro números, conferidos algumas vezes ao dia.
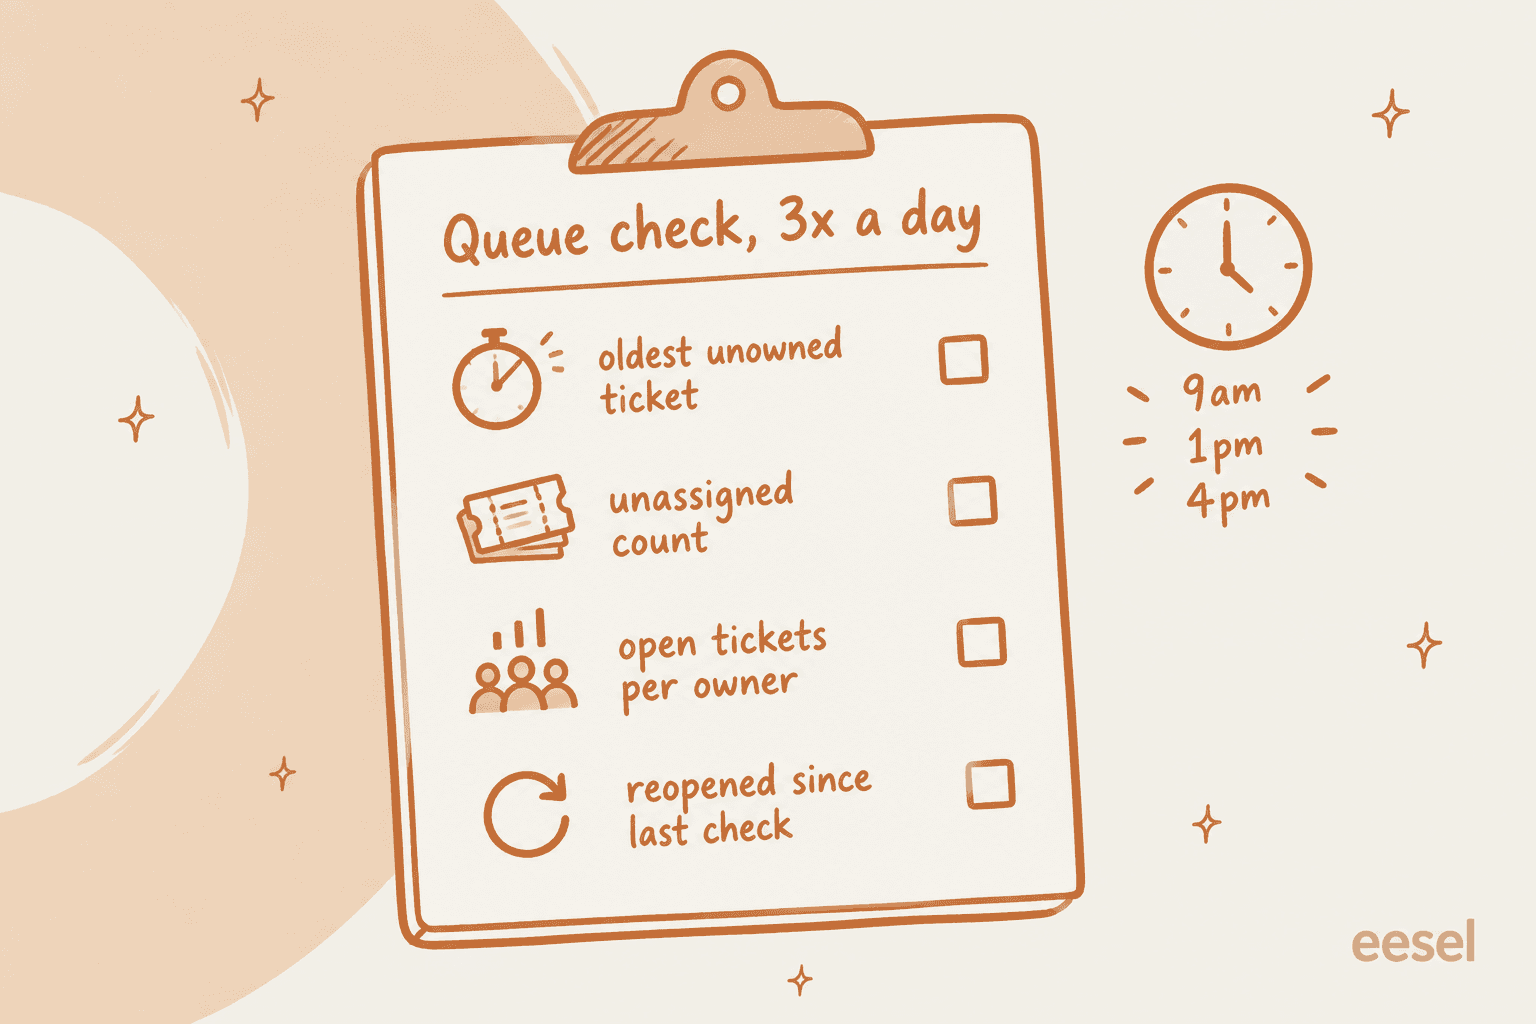
| Número | O que ele diz | Onde falha |
|---|---|---|
| Ticket mais antigo sem responsável | A pior espera real | Médias o escondem completamente |
| Contagem de tickets sem atribuição | Se o roteamento ou as pessoas estão dando conta | Um pico significa que status ou capacidade estão mal configurados |
| Tickets abertos por responsável | Se a carga está equilibrada | Um agente com 3 vezes os demais significa que o push não equilibra ou que um líder o sobrepõe |
| Reabertos desde a última verificação | Se respostas rápidas realmente resolvem | Muitas reaberturas significam que velocidade está sendo comprada com qualidade |
Esses números ficam ao lado dos seus KPIs de atendimento ao cliente habituais, não no lugar deles. Se o seu backlog de tickets já é grande, comece com meu guia para zerar um backlog de suporte antes de ajustar o roteamento.
O roteamento não conserta uma fila que simplesmente tem pouca gente. Meu post de planejamento de cobertura de suporte tem a conta de dimensionamento.
Onde a IA se encaixa em uma fila compartilhada
A maior parte do trabalho em uma fila compartilhada não é responder. É ler um ticket, decidir o que ele é, etiquetá-lo e decidir quem deve ficar com ele. Essa etapa de triagem é onde a IA ficou boa, e é onde eu começaria.
A eesel passou anos colocando IA em filas de suporte reais, e os números de implantações reais são mais úteis que qualquer promessa. Em um teste com tráfego real do Zendesk em uma joalheria online alemã que atende cerca de 1.000 tickets por mês, a IA da eesel alcançou 93% de precisão na triagem e 100% de detecção de spam, sem falsos positivos nos 22% da caixa de entrada que eram spam. Seus rascunhos de resposta estavam 88% na direção certa, e 12% foram enviados como escritos. Os agentes a usaram principalmente como assistente de pesquisa e de triagem automática, exatamente o trabalho de que uma fila compartilhada precisa.
O requisito de compra mais comum que ouço é sobre controle, não velocidade. Um líder de CX de uma marca de suplementos no Gorgias, com cerca de 7.000 tickets por mês, resumiu assim em uma ligação:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
É o instinto certo para uma fila compartilhada. A IA deve pegar os tickets que consegue resolver por completo, classificar e rotear o restante e deixar tudo que for incerto para uma pessoa. Com o colega para helpdesk da eesel, o roteamento segue as suas próprias instruções (por exemplo, "atribua tudo que vier de um cliente irritado à equipe sênior") usando as ações de atribuição do helpdesk. Você pode implantar em etapas: primeiro rascunhos como notas internas, depois deixar que ele responda os tickets fáceis de ponta a ponta. Antes de qualquer coisa entrar no ar, a Simulation reproduz seus tickets passados e pontua as respostas da IA em relação ao que sua equipe realmente enviou, para que você veja os erros antes dos clientes.
A Gridwise, um app de análise para motoristas no Zendesk, escreveu em uma avaliação no G2:
"In the first month, eesel is resolving 73% of our tier 1 requests... The platform even includes automations for ticket tagging, assignment, and status updates!"
Kim Simpson, Gridwise
Para uma fila compartilhada, o efeito é que os tickets fáceis nem chegam ao monte, e os que chegam já vêm etiquetados e roteados. Se você está comparando opções, meu panorama das melhores IAs para triagem de tickets cobre o cenário, e o guia do copiloto de IA cobre o lado dos rascunhos.
Erros comuns em filas compartilhadas
- Usar uma caixa de entrada compartilhada sem nenhuma atribuição. Tudo bem com 10 tickets por dia, caótico com 40. Um operador de CS descreveu a migração para uma plataforma dedicada "once it became unwieldy to manage the responses and mistakes were being made" (r/CustomerSuccess). Meu post sobre caixa de entrada compartilhada vs sistema de tickets cobre quando trocar.
- Dividir a fila em caixas de entrada pessoais. Parece arrumado, mas ninguém vê o backlog de um colega e os tickets morrem quando alguém adoece. Mantenha uma fila só e roteie dentro dela. Meu guia de operações de suporte distribuídas defende o mesmo para equipes em vários locais.
- Ligar o roteamento push sem limites de capacidade. Você terá o padrão "15 tickets para três pessoas, nenhum para o resto" do tópico do Zendesk acima.
- Tratar escalonamentos como parte do grupo geral. Tickets escalonados precisam de um responsável nomeado, não de uma vaga no round robin. Veja meu guia do processo de escalonamento de tickets e, para passagens à engenharia, o escalonamento entre equipes.
- Ignorar fusos horários. Uma fila coberta por pessoas em regiões diferentes precisa de roteamento por horário, ou o monte da madrugada cai em quem logar primeiro. O suporte follow-the-sun cobre essa configuração.
eesel para filas de suporte compartilhadas
Se a sua fila compartilhada está se afogando em tickets repetitivos, a correção mais barata é um colega que os tire do monte. O colega de IA para helpdesk da eesel se conecta a Zendesk, Freshdesk, Gorgias, Front, Help Scout e outros helpdesks em minutos, aprende com seus tickets passados, macros e central de ajuda e depois etiqueta, roteia e responde os tickets fáceis dentro da fila que você já opera. Seus agentes mantêm suas visualizações, seu roteamento e seu fluxo de trabalho. Só veem menos tickets, e os que veem já estão organizados.

Você pode testá-lo com seus próprios tickets passados usando a Simulation antes que ele toque em um cliente real, e há um plano gratuito para começar. Experimente a eesel na sua fila compartilhada e veja quais tickets ela teria resolvido na semana passada.