

Resumo
Gestão de transbordo no suporte é, em grande parte, uma decisão de roteamento, não de contratação. No Zendesk, Freshdesk, Help Scout, Front, Gorgias e HubSpot, o padrão quando todos os agentes estão na capacidade máxima é o mesmo: o trabalho novo fica na fila sem atribuição até alguém liberar. O transbordo só é tratado quando você decide, com antecedência, para onde vai o próximo ticket.
A configuração que funciona para a maioria das equipes é uma cascata: equipe principal, depois um grupo de reserva, depois uma camada de IA que responde as perguntas repetidas, depois respostas assíncronas com um tempo de espera honesto e, por fim, retorno de chamada para telefone. Os recursos de grupo de reserva dependem do plano (as filas personalizadas do Zendesk exigem Suite Professional, e o redirecionamento para grupo de contingência do Freshdesk é só Enterprise), então confira seu plano antes do pico, não durante.
Eu trabalho na fila de suporte da eesel todos os dias, e a maior parte do volume de pico que vejo são as mesmas poucas perguntas: status do pedido, mudanças de assinatura, "está fora do ar?". Um líder de operações de uma marca DTC com cerca de 7.000 tickets por mês no Gorgias contou à eesel que a equipe simplesmente não dava conta e precisava de IA para resolver pelo menos metade do volume de e-mail. Essa fatia repetida é o que o colega de IA da eesel tira da fila dentro do seu helpdesk atual, para que sua equipe gaste o pico nos tickets que precisam de uma pessoa.
O que a gestão de transbordo no suporte realmente cobre
Transbordo é todo trabalho que chega quando cada agente que poderia atendê-lo está no limite ou offline. Esse último ponto importa: não é só "tickets demais". Uma tarde de terça com duas pessoas doentes é um evento de transbordo. Assim como um chat às 2 da manhã quando sua cobertura fora do horário é uma mensagem de caixa postal.
Normalmente aparece em uma de três formas:
| Forma | O que provoca | Quanto dura | O que exige |
|---|---|---|---|
| Pico | Queda, lançamento, post viral, atraso de entrega | De horas a 2 dias | Respostas rápidas de um para muitos, uma faixa de reserva que abre em minutos |
| Pico sazonal | Black Friday, feriados, temporada de renovações, prazos fiscais | De 2 a 12 semanas | Capacidade extra planejada, temporários treinados ou um parceiro, respostas prontas |
| Lacuna de cobertura | Atestados, fusos horários, almoço, reunião de equipe | De minutos a horas | Roteamento que não dependa de uma única pessoa estar online |
A maioria dos guias trata tudo isso como um único problema e pula direto para "contrate mais" ou "terceirize". Eu começaria por algo mais barato: veja o que o seu helpdesk faz hoje com o próximo ticket quando todos estão lotados, porque esse padrão provavelmente custa mais do que o headcount.
Para onde o transbordo vai por padrão em cada helpdesk
Revisei a documentação de roteamento das sete ferramentas que mais vejo na fila de suporte da eesel. O padrão é marcante. Quando todos os agentes elegíveis estão no limite, quase todas deixam o trabalho novo na fila de suporte sem o nome de ninguém:
| Helpdesk | Limite por agente | Todos os agentes lotados ou offline | Faixa de transbordo nativa | Plano necessário |
|---|---|---|---|---|
| Zendesk | E-mail até 500 abertos, mensagens até 20 | O ticket fica na fila | Grupos secundários em uma fila personalizada | Suite Professional (US$ 115/agente/mês) |
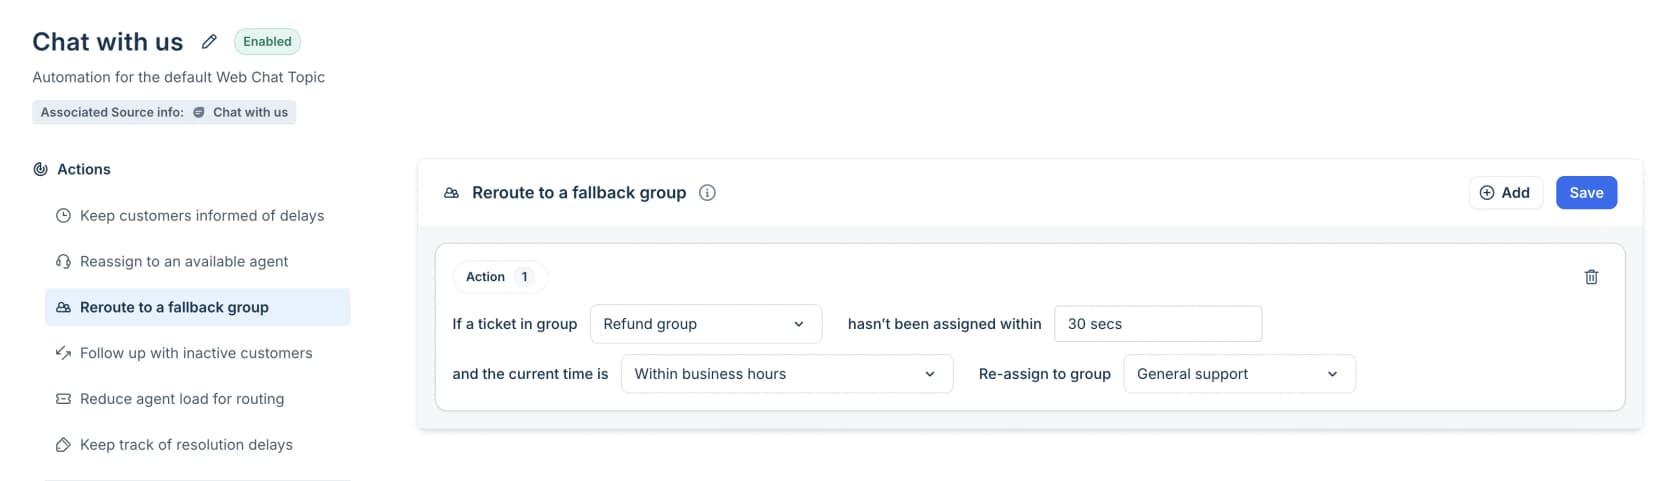
| Freshdesk | Carga por fila (ex.: e-mail 5, mensagens 10) | O ticket fica sem atribuição | "Reroute to a Fallback Group" após N segundos | Enterprise (US$ 89/agente/mês) |
| Help Scout | Limite de atribuição até 100, chats padrão 3 | A conversa fica em Unassigned | Nenhuma documentada | Round Robin no Plus (US$ 45), Balanced no Pro (US$ 75) |
| Front | Limite de balanceamento de carga, padrão e máximo 100 | O balanceamento de carga enfileira o trabalho; o round robin não | Nenhuma documentada | Plano não informado na página de preços |
| Gorgias | Dois limites: chat e mensagens, outro texto | O ticket fica sem atribuição | "Skip queue when it's too busy" em voz | Todos os planos Helpdesk (add-on Voice a partir de US$ 25/mês) |
| HubSpot Service Hub | Capacidade de tickets (Pro+), capacidade de chat padrão 3, máx. 99 (Enterprise) | O ticket fica sem atribuição até ser atribuído manualmente | Fallback opcional de chats para o agente de cliente | Professional (US$ 90/usuário) ou Enterprise (US$ 150/usuário) |
| Aircall (voz) | Baseado em toques | A ligação espera o tempo da fila, depois caixa postal ou perdida | Encadear outra etapa Ring to após a primeira | Retornos de chamada no Professional (US$ 50/licença) |
Duas coisas chamam a atenção. Primeiro, só Zendesk e Freshdesk trazem uma verdadeira regra de transbordo "envie para outro grupo", e ambos a colocam atrás de um plano superior. Segundo, as duas ferramentas funcionam de forma diferente. O Zendesk transborda por disponibilidade: o trabalho vai primeiro para os grupos primários e cai nos grupos secundários apenas se nenhum agente primário estiver disponível. O Freshdesk transborda por tempo: a regra de Quick Automations dispara quando um ticket de um grupo não foi atribuído em um número definido de segundos, digamos cinco minutos para um ticket de Refunds antes de ir para General Support.
O Front é o que merece atenção. Se você usa round robin, não existe fila quando todos estão offline, e uma atribuição perdida não é tentada de novo quando alguém volta. O balanceamento de carga enfileira e entrega primeiro a conversa sem resposta mais antiga. Se a sua equipe de Front é pequena e sujeita a picos, essa única configuração decide se o transbordo espera na fila ou se perde.
É assim que um ticket crítico fica enterrado. Um administrador do Zendesk descreveu exatamente isso no Reddit:
"Um cliente Enterprise informou às 9h que o sistema de produção dele estava fora do ar. O ticket ficou na nossa fila até as 14h porque tínhamos mais de 30 outros tickets que chegaram durante a noite."

Monte uma cascata de transbordo, não uma equipe maior
Um sysadmin, em um tópico sobre picos inesperados de ligações, resumiu por que contratar para o pico raramente funciona:
"você não dimensiona a equipe para 1% dos eventos raros, você dimensiona para os 90% dos dias comuns."
Então a solução para "o trabalho fica sem atribuição" é dar a cada ticket uma próxima parada. Penso nisso como uma pilha de bandejas: quando uma enche, transborda para a seguinte, e a bandeja de baixo nunca é "ninguém".
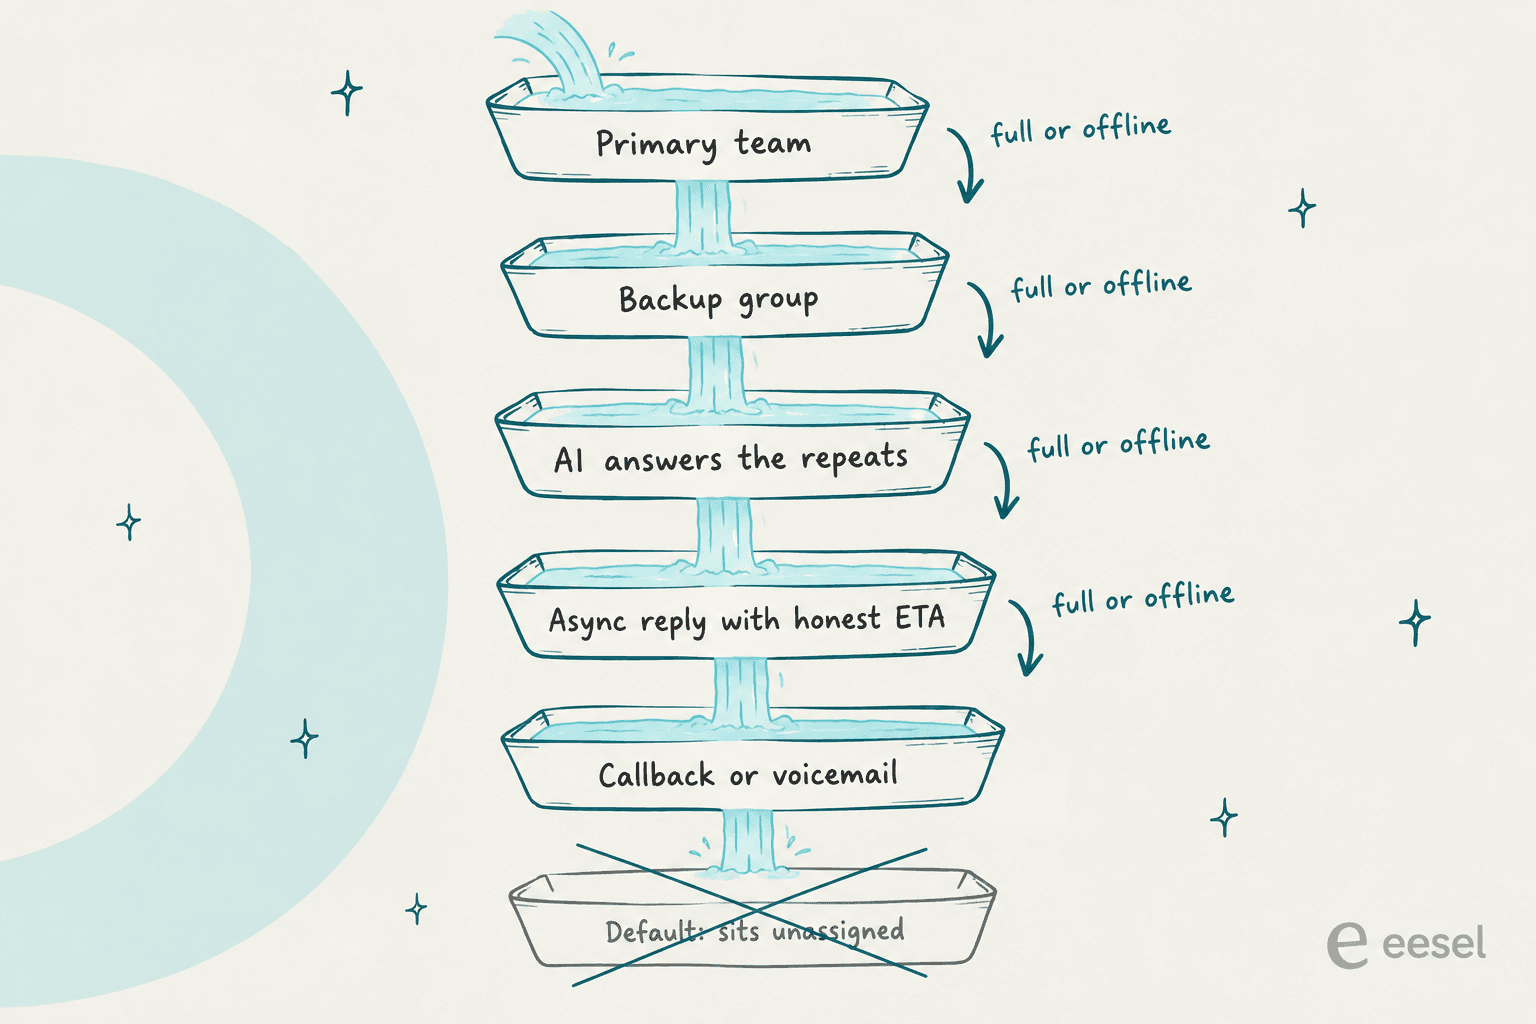
Veja como eu montaria, na ordem que dá mais alívio pelo menor custo.
1. Defina limites pela idade do ticket, não pela quantidade
Uma fila de 150 tickets que chegaram há dez minutos está bem. Uma fila de 40 em que o mais antigo espera há 18 horas é um incêndio. A contagem mente durante um pico, porque sobe e se recupera rápido. A idade do ticket sem resposta mais antigo mostra se os clientes estão de fato ficando para trás, e ela se liga diretamente ao seu tempo de primeira resposta e às suas promessas de SLA.
Anote três ou quatro níveis e, para cada um, a única coisa que muda. Os números abaixo são um ponto de partida que eu ajustaria ao seu próprio SLA, não um padrão:
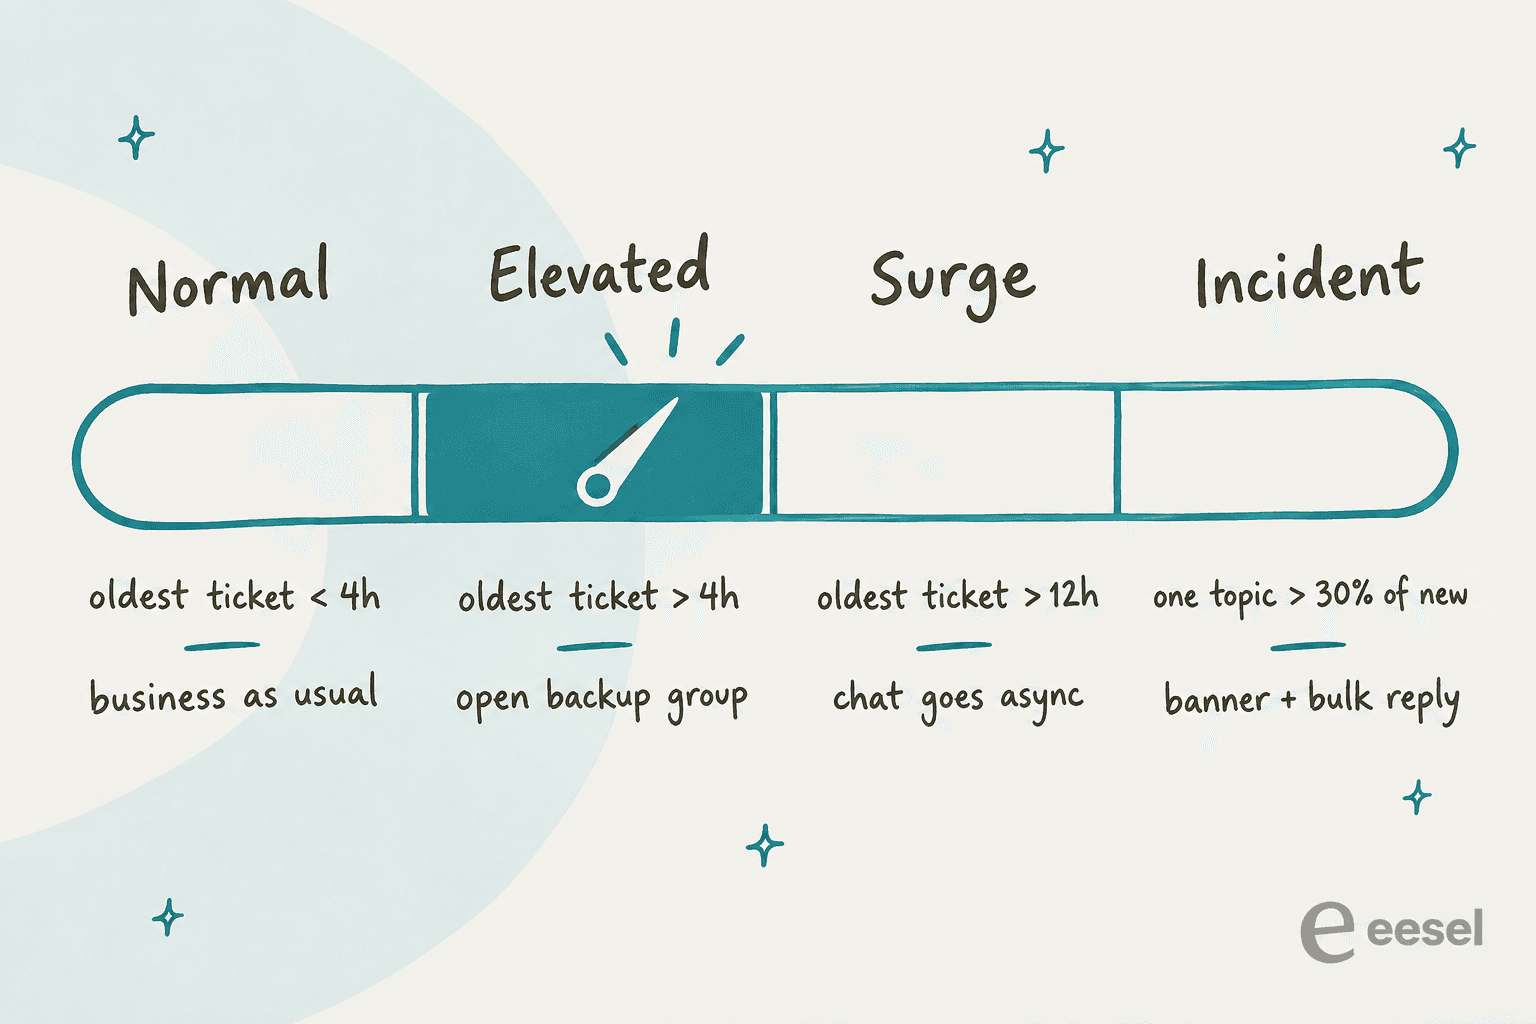
O objetivo de deixar escrito é que ninguém precise decidir por feeling às 16h do dia do lançamento. A regra já existe, e quem perceber o medidor subindo simplesmente aciona a chave.
2. Abra um grupo de reserva antes de precisar dele
O grupo de reserva são as pessoas que podem assumir trabalho de nível 1 quando a equipe principal está lotada: uma segunda equipe, agentes seniores de outra região ou alguns voluntários treinados de sucesso do cliente e vendas. Configure-o na ferramenta em uma semana tranquila.
- Zendesk. Crie uma fila personalizada, adicione seus grupos principais como primários, depois "Turn on secondary groups" e adicione o de reserva. Cada fila personalizada aceita até 20 grupos primários e 20 secundários, e você pode ter até 199 filas. A receita do próprio Zendesk para mensagens acrescenta um grupo "Backup" como último recurso para que os tickets "não fiquem presos nas filas por mais tempo do que você considera confortável".
- Freshdesk. No Pro, divida a capacidade de cada agente por fila no Omniroute para que chat e e-mail não se esgotem mutuamente. No Enterprise, adicione a quick automation "Reroute to a Fallback Group" para canais em tempo real.
- Help Scout, Front, Gorgias, HubSpot. Não há grupo de transbordo nativo, então o jeito é um workflow ou regra que reatribua por tag ou tempo de espera, mais uma fila compartilhada que o pessoal de reserva acompanha durante um pico.
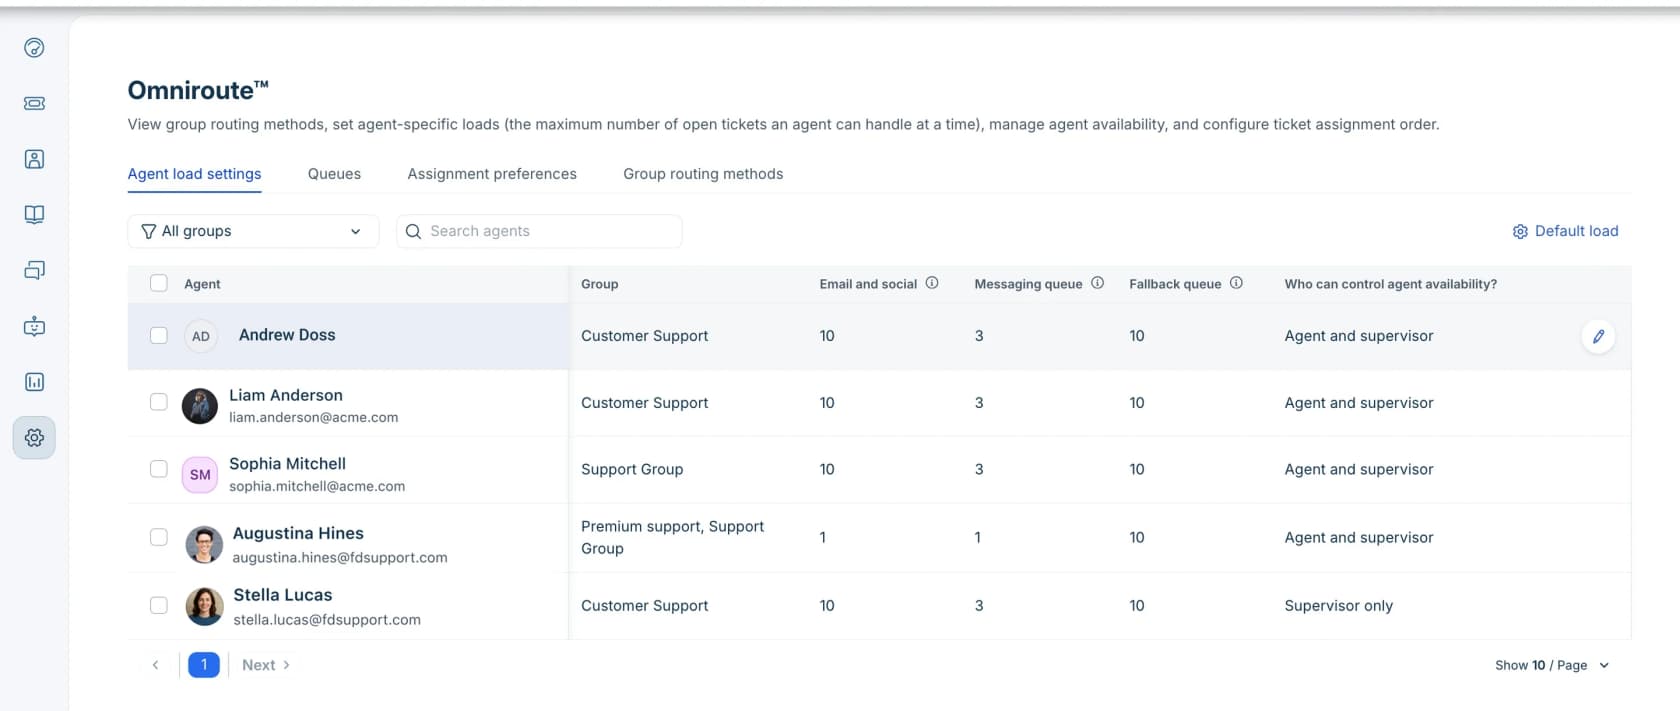
Um detalhe do Freshdesk é útil para picos que duram só uma semana: os day passes custam US$ 2 no Growth, US$ 7 no Pro e US$ 12 no Enterprise, então pegar emprestado um colega de outro departamento na semana do lançamento não significa pagar uma licença completa.
3. Proteja seus especialistas do volume de nível 1
Quando a fila inunda, as primeiras pessoas puxadas são as que mais sabem, e elas passam o pico respondendo "cadê meu pedido?" enquanto os tickets difíceis envelhecem. Divida o trabalho por tipo. Perguntas de nível 1 vão para o grupo de reserva e a camada de IA. Disputas de cobrança, bugs e VIPs irritados ficam com os especialistas. O Zendesk Suite Professional acrescenta roteamento por habilidade e prioridade para isso, e o Freshdesk tem roteamento baseado em habilidades no Enterprise.
Se você já trabalha com níveis, este é o momento em que seu caminho de escalonamento se paga. Um pico é quando um vago "mande para a engenharia" vira 3 dias de silêncio.
4. Responda o tema do pico uma vez, em público
Durante uma queda ou um atraso de entrega, grande parte dos novos tickets pergunta a mesma coisa. Responder cada um à mão é a forma mais cara de dizer "sabemos, aqui está a atualização". Publique uma vez nos lugares que os clientes consultam antes de escrever: um banner de status, a central de ajuda, a saudação do chat e as respostas do seu agente de IA. Depois crie uma macro que responda, etiquete e feche os tickets que ainda chegarem.
O mesmo truque funciona ao telefone. Um líder de TI coloca a atualização antes da própria fila:
"Coloco uma mensagem antes de a ligação ser roteada para a fila de chamadas explicando o que está errado, quando será a próxima atualização e pedindo para desligar se a pessoa estiver com esse problema; se não, que continue na linha para ser roteada para a fila do helpdesk."
Aqui também a IA faz seu melhor trabalho de transbordo. Ela lê a nota do incidente e responde "o checkout está fora do ar?" algumas centenas de vezes com a mesma atualização correta, enquanto sua equipe cuida dos clientes cujo pedido realmente deu problema. Mais sobre isso abaixo.
5. Passe os canais ao vivo para assíncrono com um tempo de espera honesto
O chat ao vivo é o primeiro canal a quebrar em um pico, porque cada agente só consegue segurar poucos ao mesmo tempo. O Maximum Chat do Help Scout vem em 3 por padrão, e a capacidade de chat do HubSpot também é 3 por padrão. Quando todos atingem esse limite, um visitante olhando para uma janela de chat que nunca responde está pior do que com um e-mail que diz "respondemos em cerca de 4 horas".
As ferramentas oferecem a chave:
- O HubSpot deixa você escolher o que acontece quando todos os agentes estão na capacidade máxima: mostrar uma mensagem de espera, ocultar o launcher ou não fazer nada.
- O chat da Gorgias pode ficar ao vivo apenas quando há agentes disponíveis, e os compradores offline recebem um formulário de captura que vira um ticket de e-mail. Também há a configuração "Share wait time with shoppers".
- O Front pode ocultar o widget de chat fora do horário online, mas um cliente que já o abriu ainda pode enviar mensagens, por isso o Front recomenda uma resposta automática.
- As conversas de mensagens do Zendesk esperam na fila até abrir uma vaga de capacidade, e as não atribuídas ficam inativas após 10 minutos sem resposta do cliente. O guia sobre o tratamento offline das mensagens do Zendesk cobre o lado voltado ao cliente.
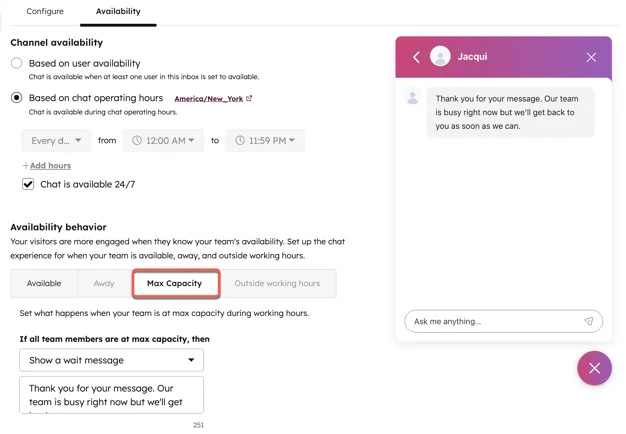
O suporte assíncrono não é um rebaixamento aqui. Uma promessa específica que você cumpre vale mais do que um canal ao vivo que deixa as pessoas penduradas.
Transbordo de voz: as configurações que derrubam ligações
O transbordo telefônico merece uma seção própria, porque os padrões podem desligar na cara das pessoas. Cada ferramenta limita quantas pessoas esperam e por quanto tempo, e o que acontece depois é o que você configurou, inclusive nada.
| Ferramenta | Tamanho máx. da fila | Espera máx. | Quando a espera acaba | Retorno de chamada |
|---|---|---|---|---|
| Zendesk Talk | 750 (Team) ou 1.500 (Pro/Enterprise) com roteamento omnichannel; 15 ou 50 sem | 1 a 20 min, 1 a 60 no Enterprise | Caixa postal, ou número de transbordo se a caixa postal estiver desligada | Professional e Enterprise |
| Freshcaller | Padrão 20, mais sob solicitação para Pro e Enterprise | 30 s a 15 min | Caixa postal, outra fila ou desligar | Tecla 2, a ligação é retornada quando um agente libera |
| Gorgias Voice | Capacidade da fila por fila | Espera máx. em segundos | Próxima etapa do fluxo de chamada; ramo "Skip queue when it's too busy" | Tecla asterisco, cria um ticket "Callback requested" |
| Aircall | Baseado em toques | 20 s a 40 min na fila da equipe | Próximo widget, ou a ligação cai | 0 a 5 novas tentativas, Professional e acima |
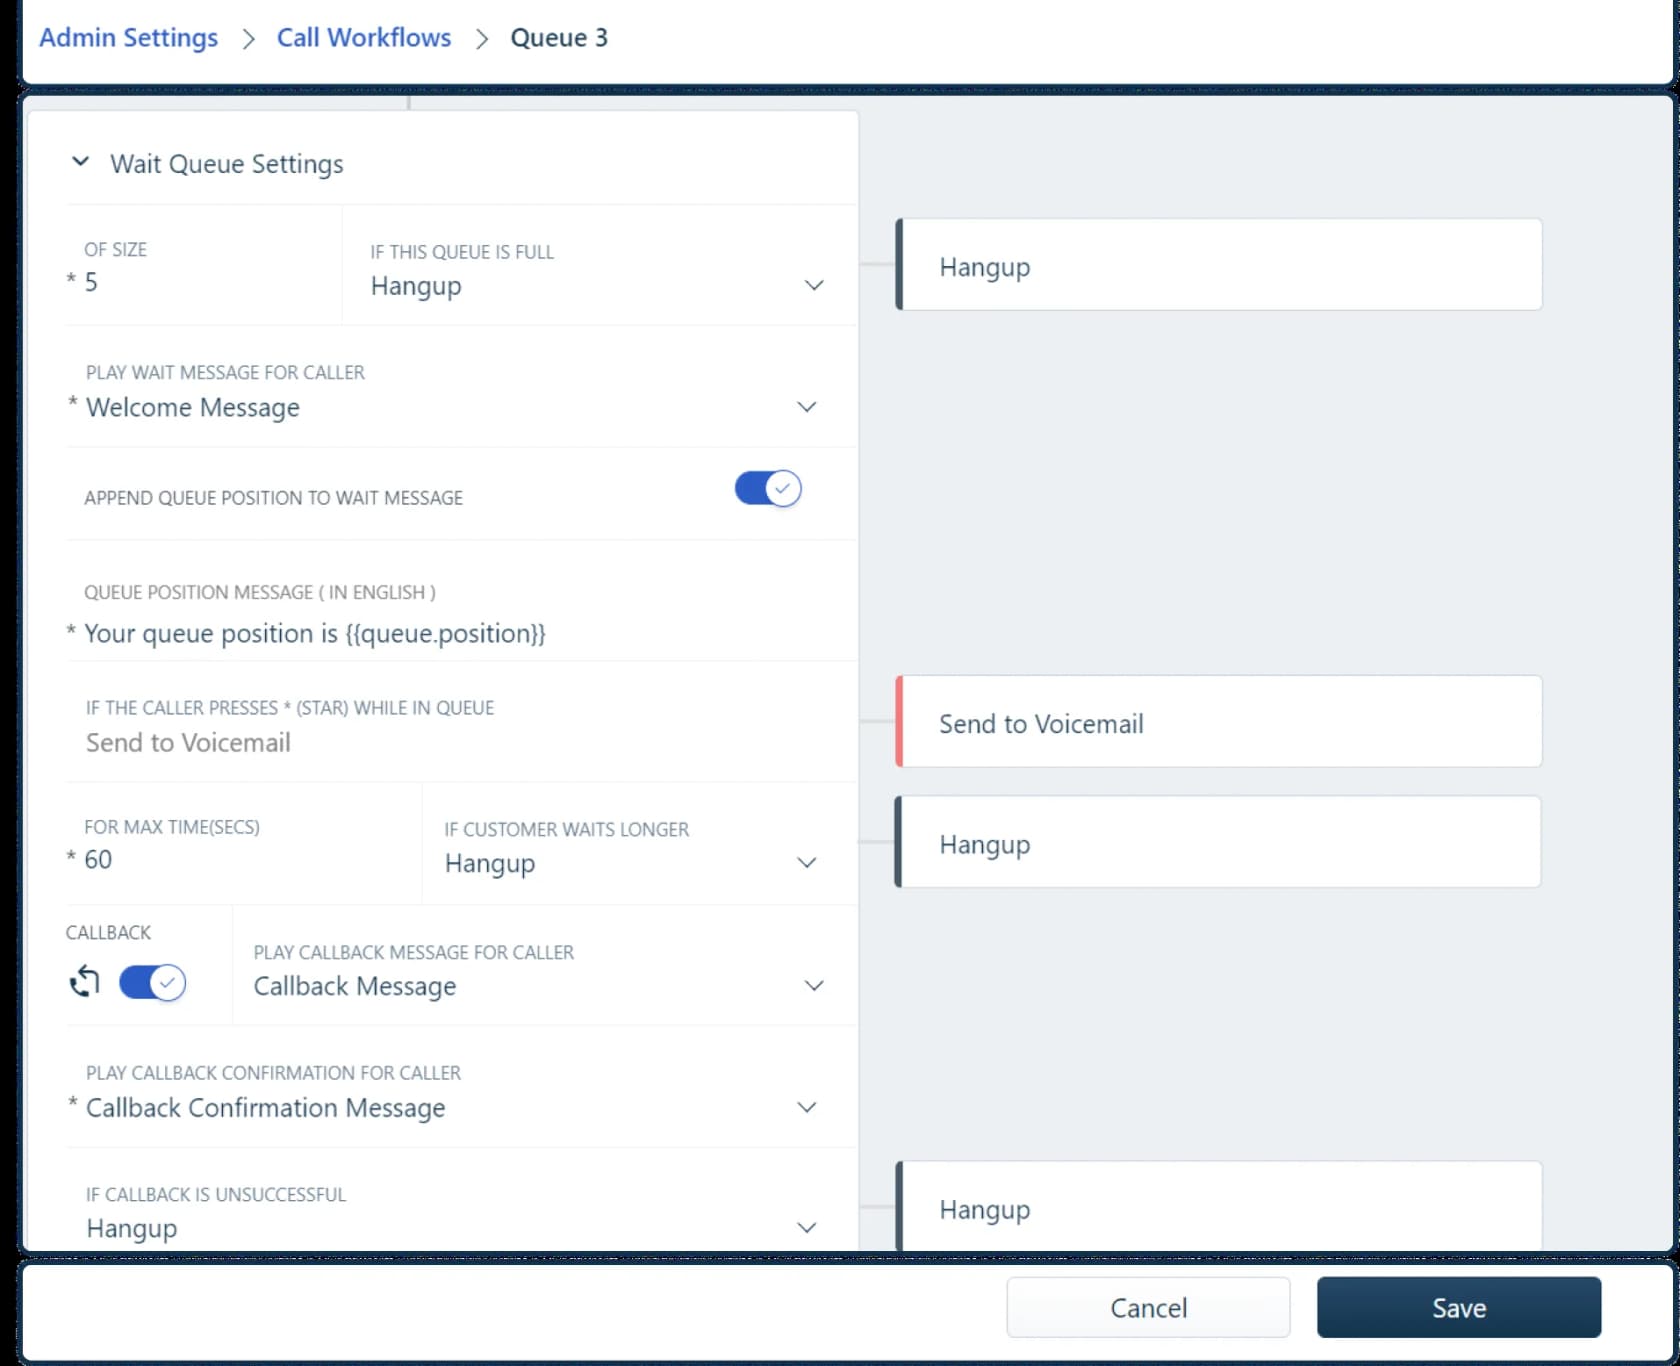
Três armadilhas que eu conferiria hoje:
- Nada depois da última etapa. No Zendesk, com a caixa postal desligada e sem número de transbordo, quem ligou ouve a saudação e a ligação é desconectada. No Aircall, se nada vem depois de uma etapa Ring to, a ligação do Aircall toca uma vez e cai. Sempre termine o fluxo em caixa postal ou retorno de chamada.
- Transferências ignoram seu limite de espera. A espera máxima na fila do Zendesk é ignorada após uma transferência, então quem foi transferido fica em espera até um agente aceitar. É exatamente o que acontece em um pico quando o nível 1 encaminha tudo para o nível 2.
- Retornos de chamada precisam de alguém online. O retorno de chamada do Zendesk exige pelo menos um agente Online ou Away, e os retornos do Aircall não esperam indefinidamente: com zero novas tentativas, um que falha é registrado como "Failed - No agents available".
Com o roteamento omnichannel do Zendesk ativado, o transbordo de ligações usa o mesmo fallback de grupo primário para secundário dos tickets, então um número de transbordo não é necessário. O guia de transbordo e timeout do Talk percorre as duas configurações.
Qual o tamanho do seu problema de transbordo?
O transbordo se acumula. Qualquer ticket que sua equipe não consegue concluir hoje rola para amanhã, então um pico de apenas 50% acima da capacidade ainda forma backlog em cada dia que dura. Um exemplo simples: uma equipe que normalmente recebe 200 tickets por dia, com 4 agentes que concluem 100 cada, é atingida por 3x o volume durante cinco dias.
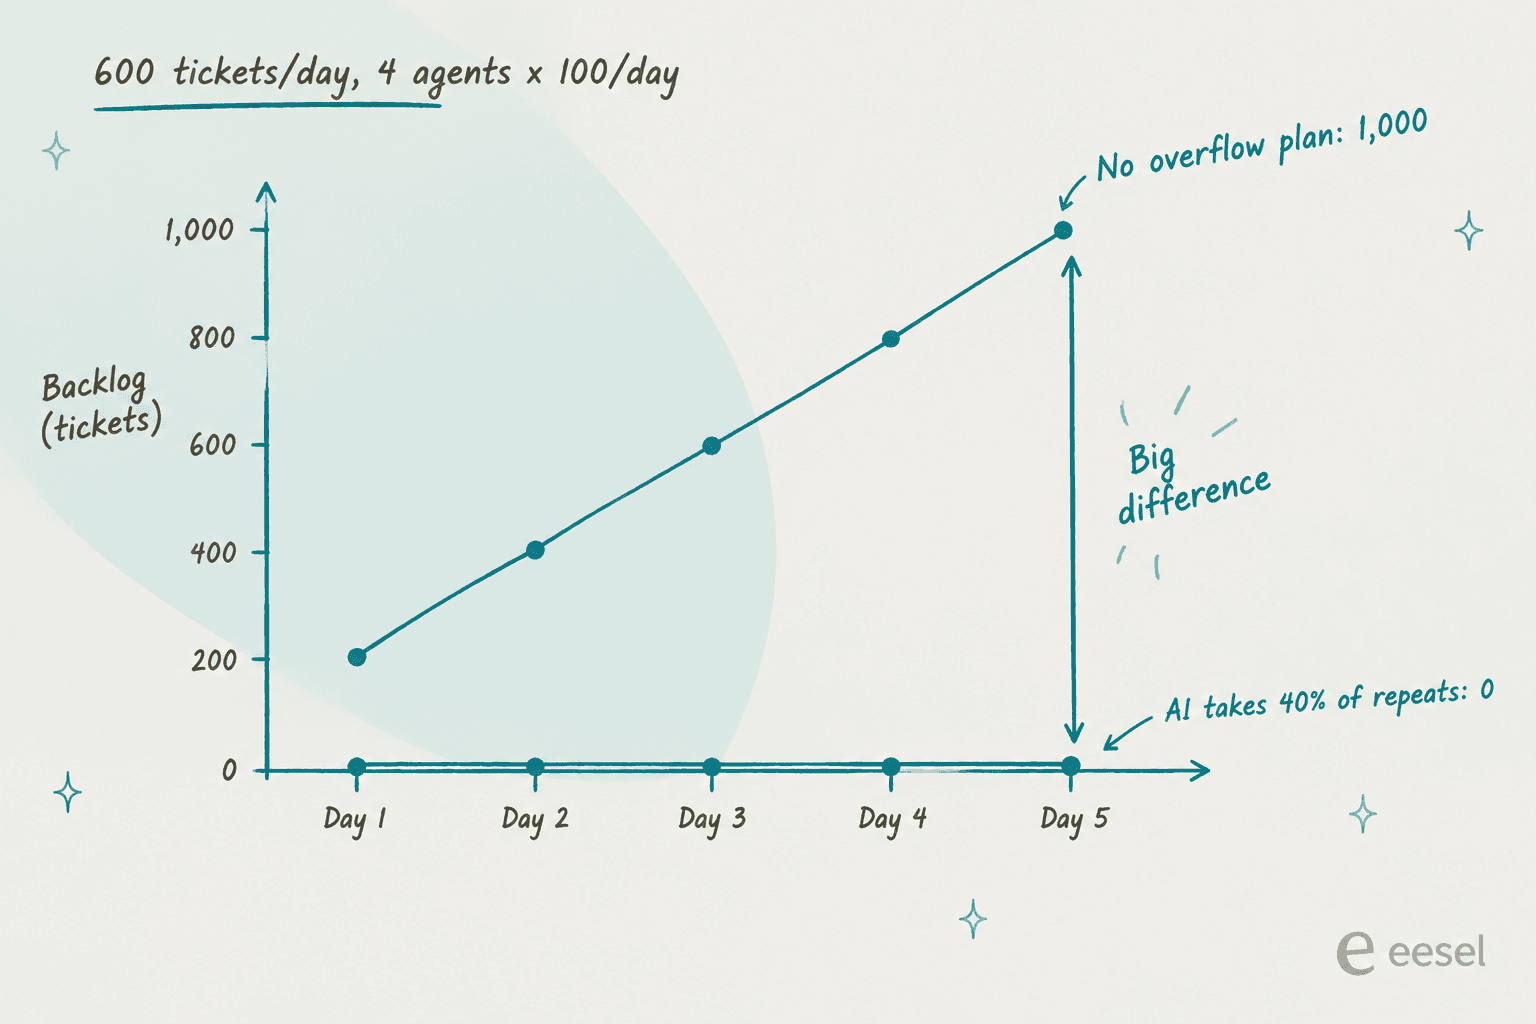
Sem faixa de transbordo, a equipe conclui 400 de 600 por dia, então o backlog cresce 200 por dia e chega a 1.000 tickets no quinto dia. Quando o volume volta a 200, os 200 diários de capacidade sobressalente levam mais cinco dias para quitá-lo. Clientes que escreveram no dia dois esperam quase uma semana. Se uma faixa de reserva absorve 40% do pico, a equipe vê apenas 360 por dia e a fila nunca se forma. Cobrir a mesma lacuna só com pessoas significa 10 agente-dias extras, treinados e prontos no primeiro dia.
Coloque os seus próprios números:
A calculadora ignora muita coisa (o tempo de atendimento varia, alguns tickets são reabertos, os agentes ficam mais lentos quando cansados), mas o formato está certo. Um alívio pequeno e constante no começo vale mais do que uma recuperação heroica depois.
De onde vem a capacidade extra
Com o roteamento no lugar, você ainda precisa de um lugar onde o transbordo aterrisse. Há quatro fontes realistas, e cada uma serve a uma forma diferente de transbordo:
| Fonte | Pronta em | Melhor para | Cuidado com |
|---|---|---|---|
| Colegas emprestados (sucesso do cliente, vendas, operações) | No mesmo dia | Picos, semana de lançamento | Tira as pessoas do próprio trabalho; precisa de macros e escopo restrito |
| Temporários ou contratações sazonais | 2 a 6 semanas | Picos sazonais previsíveis | Tempo de ramp-up e treinamento; veja o guia de onboarding sazonal |
| Parceiro terceirizado de transbordo | 4 a 8 semanas para configurar | Picos longos, cobertura 24/7 | Controle de qualidade e lacunas de contexto; leia antes sobre chat ao vivo terceirizado |
| Agente de IA no helpdesk | Dias | Perguntas repetidas em qualquer forma de transbordo | Precisa ficar dentro do que sabe e passar a bola direito |
A melhor versão da opção terceirizada que vi descrita é um parceiro que você avalia em uma semana calma, não um que você assina às pressas no meio do incêndio:
"Tenho empresas para as quais posso ligar para transferir nosso volume de ligações durante grandes projetos ou quedas. Elas já passaram pela due diligence e estão em hot standby, caso a necessidade surja."
Para picos planejados, faça as contas cedo com um bom plano de cobertura. Para a Black Friday em especial, eu também prepararia com um mês de antecedência as mensagens aos clientes e o lado de IA da temporada.
Onde a IA entra no transbordo (e onde não entra)
Passei muito tempo observando agentes de IA em filas reais, e o resumo honesto é que a IA é a melhor faixa de transbordo para um tipo de ticket e um risco para outro. Ela é ótima nas perguntas repetidas que compõem a maior parte de um pico: status do pedido, redefinição de senha, "o app está fora do ar?", prazos de devolução. É a ferramenta errada para o cliente irritado cujo terceiro pedido sumiu.
As equipes que acertam fazem a IA escolher suas batalhas. Um líder de CX de uma marca DTC de suplementos na Gorgias e Shopify, com cerca de 7.000 tickets por mês, disse isso melhor do que eu numa call de vendas com a eesel:
"A IA nunca vai conseguir responder 100% das perguntas, mas se ela tenta e só responde 'desculpe, não sei isso', eu não consigo checar todos os meus 7.000 tickets para ver se a IA realmente deu uma boa resposta, aí o objetivo meio que se perde. Preciso de uma IA que só trate os tickets que ela tem confiança para tratar e deixe todos os outros em paz."
Esse é o briefing certo para uma IA de transbordo. Responda o que sabe, passe o resto com contexto e nunca envie uma resposta errada com confiança para uma fila que ninguém tem tempo de revisar. A alta temporada deles vai de novembro a maio, exatamente quando um backlog de tickets de "cadê meu pedido" enterraria as pessoas que precisam cuidar dos problemas reais.
Fundadores que tocam o suporte por conta própria descrevem o mesmo acúmulo de tickets quase idênticos:
"Os tickets se acumularam e eram principalmente reclamações de nível 1 com problemas parecidos, mas eu NÃO conseguia acompanhar. A perda de clientes por falta de resolução causou burnout"
Os helpdesks têm suas próprias camadas de IA, e a maioria é cobrada por resultado, o que significa que a conta cresce com o pico:
| Camada de IA | Como é cobrada | Preço |
|---|---|---|
| Zendesk AI agents | Por resolução automatizada | US$ 1,50 com compromisso, US$ 2,00 pay-as-you-go |
| Freddy AI Agent | Por sessão | 500 incluídas, depois US$ 49 por 100 |
| Gorgias AI Agent | Por interação automatizada | US$ 0,85 a US$ 1,00 |
| Help Scout AI Answers | Por resolução | US$ 0,75, com limite de gasto |
| Front Autopilot | Por conversa | A partir de US$ 0,05 |
| Colega de IA da eesel | Por ticket ou chat tratado, 1 crédito cada | A partir de US$ 299/mês por 500 créditos, excedente limitado por você |
O preço por resultado é justo em um mês normal. Em um pico, vale modelar. Uma análise de custos que a eesel fez para uma caixa de e-commerce de 1.000 tickets por mês mostrou o preço por resolução em cerca de US$ 792 por mês em um mês normal e US$ 3.168 em um mês de Black Friday com 4.000 tickets, com a mesma taxa de resolução de 80%. A própria central de ajuda do Zendesk observa que resoluções pay-as-you-go custam mais do que um bloco comprometido, e permite limitar as resoluções mensais. Seja qual for a sua escolha, defina o limite antes do pico para que o aumento tenha um teto.
O HubSpot tem uma versão embutida bem prática da ideia de cascata: uma configuração de chat ao vivo que atribui chats ao agente de cliente quando não há usuários disponíveis ou todos estão na capacidade máxima. É o padrão "IA como grupo de reserva", dentro de uma única ferramenta.
Experimente a eesel como sua faixa de transbordo
Se sua equipe usa Zendesk, Freshdesk, Gorgias, Help Scout ou Front, o colega de IA de helpdesk da eesel se encaixa na cascata como a bandeja entre o seu grupo de reserva e a resposta assíncrona. Ele entra na fila que você já tem, aprende com seus tickets antigos, central de ajuda e macros, e responde as perguntas repetidas que formam um pico. Tudo de que ele não tiver certeza vai para sua equipe com uma nota interna, e reembolsos ou outras ações irreversíveis podem esperar por uma aprovação humana.

A parte em que eu apostaria antes de um pico é a simulação: a eesel roda o agente contra seus tickets antigos reais e pontua cada resposta em relação ao que sua equipe de fato enviou, para você saber quais temas ele consegue assumir antes do dia do lançamento, não durante. A Gridwise, no Zendesk, viu 73% dos tickets de nível 1 resolvidos no primeiro mês. A cobrança é por ticket ou chat tratado, com licenças ilimitadas, então incluir seu grupo de reserva para supervisionar não custa nada a mais.
Experimente a eesel grátis na sua própria fila: comece com 100 créditos grátis, conecte sua conta do Freshdesk ou da Gorgias e rode uma simulação antes do seu próximo pico.