2026年版 GLM-5.3-Flashのおすすめ代替モデル6選

Rama Adi

Katelin Teen
最終更新 August 29, 2026
GLM-5.3-Flashは、Z.aiが提供する安価でネイティブにマルチモーダルなオープンウェイトモデルで、非常に強力な標準の選択肢です。ローンチ記念のプロモーション価格は100万トークンあたり約$0.075/$0.25、コンテキストウィンドウは100万トークン、Artificial AnalysisのIntelligence Indexは57で、1タスクあたり約$0.045です。これ以外を探しているチームの多くは、次の3つのどれかを求めています。より速い応答、自前でホストできる完全オープンのウェイト、またはより大きなベンダーのエコシステムです。
誰を選ぶべきかの短いまとめです。
- 最速のクローズドモデル: Gemini 3.7 Flash、約340トークン/秒ですが、定価は2027年1月に倍になります。
- 最安のオープンウェイト: DeepSeek V4 Flash、MITライセンスで自前ホストならほぼ無料ですが、テキスト専用です。
- 速度と価格の絶対的な下限: Gemini 3.5 Flash-Lite、$0.30/$2.50。
- 大手ブランドのエコシステム: GPT-5.6 Luna、$0.20/$1.20、最も幅広いツール群。
- 小さなプロンプトで最安: Qwen 3.7 Flash、呼び出しが32Kトークン未満に収まる場合。
- オープンウェイトとネイティブの画像対応: Kimi K3、機能面でGLMに最も近いものの、価格は$3/$15とフラッグシップ級です。
最初に言っておきたいことがあります。実際のサポートキューでAIを何年も運用してきた経験から言うと、モデルは最も安く、最も簡単に入れ替えられる層です。実際にお客様のチケットを解決するためにモデルを選ぶなら、推論の質よりも、その周りに構築する検索、ガードレール、テストのほうがはるかに重要です。ボットが役に立つのか、自信満々に間違えるのかは、そこで決まります。
そもそもなぜGLM-5.3-Flash以外を探すのか?
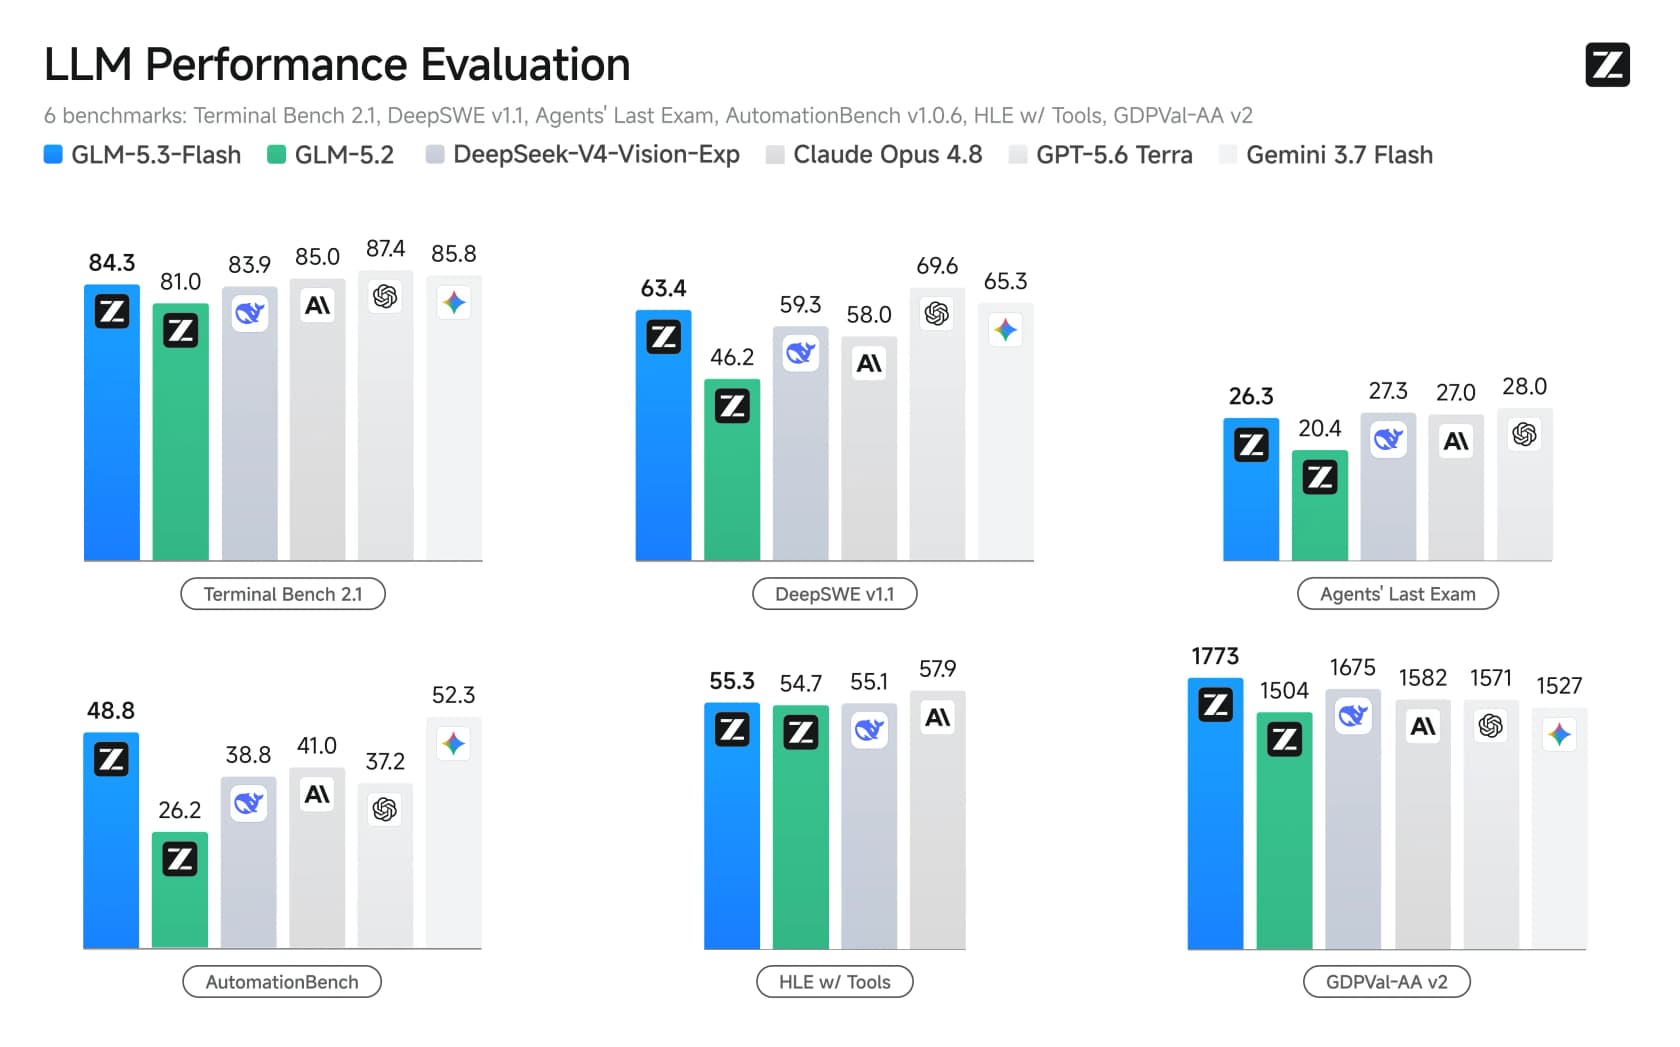
まず現行の本命に公平であるべきです。ベンチマークの結果は本物です。GLM-5.3-Flashは、総計320B/アクティブ18BのMixture-of-Expertsモデルで、GLM-5シリーズで最初のネイティブなマルチモーダルモデルであり、コンテキストウィンドウは100万トークン、ウェイトはオープンです。Cloudflareの説明では、全ベンチマークでGLM-5.2を上回り、"at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks." とされています。コーディングとエージェント系の6つのベンチマークで、前世代を明確に上回ります。
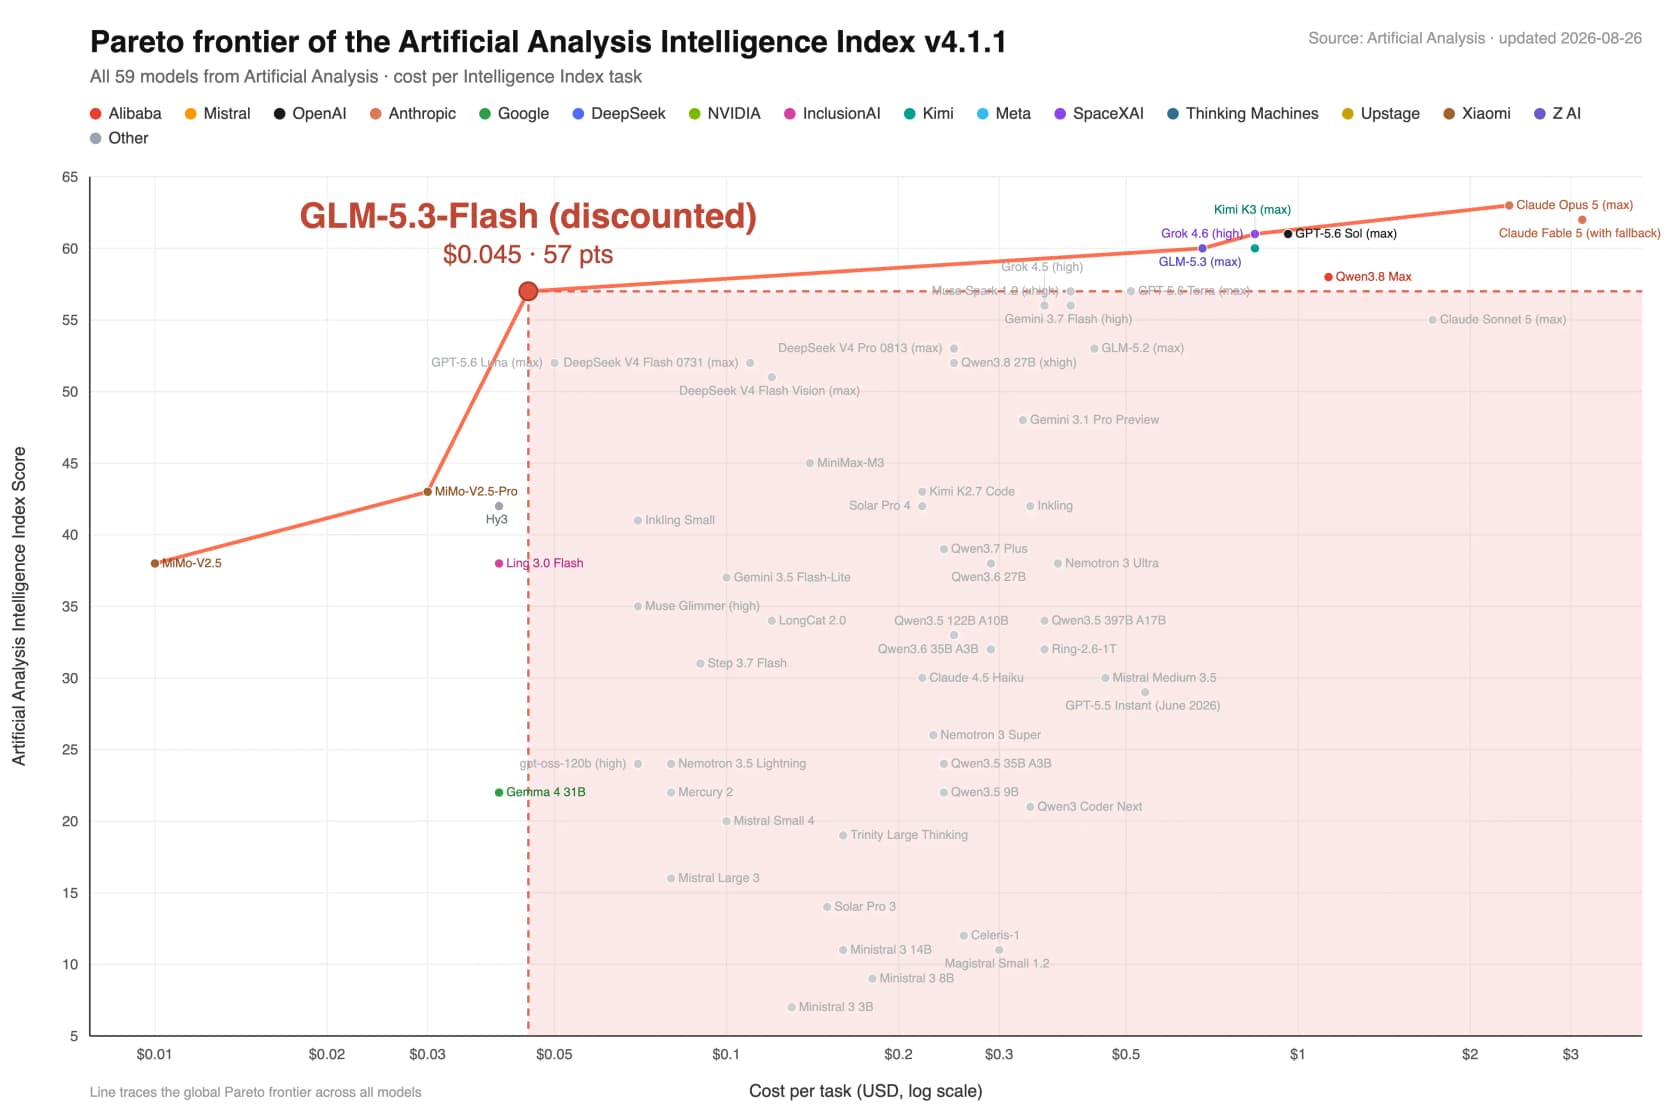
価格と知能をめぐる議論全体を動かしたのは、このパレート図です。GLM-5.3-Flashは1タスクあたり約$0.045、57ポイントでフロンティア上に位置し、ほかにほとんど誰もいない場所を占めています。
それでも人が他を探す理由は何でしょうか。実際の理由がいくつも繰り返し挙がります。
- 公式エンドポイントでの速度。 Z.ai自身のAPIでは、GLM-5.3-Flashは約49トークン/秒と遅く、あるr/opencodeのスレッドでは "one of the slowest models AA has ever" 見たと評されました。サードパーティのホストなら解決します(Databricksでは272.9 t/s)が、その分リセラーに依存することになります。
- データの扱いが手薄。 Z.aiはDPAもゼロリテンションのオプションも公開しておらず、データは中国の法律の下にあります。規制対象やお客様データを扱うワークロードでは、自前でホストしない限り、実際の障害になります。
- プロモーションの期限。 $0.075/$0.25という料金はローンチ割引で、2026年9月9日に終了します。定価は倍です。
- テキスト専用のチーム。 画像を一切扱わないなら、使わないマルチモーダルの構造にお金を払うより、安いまたは速いテキスト特化モデルのほうが理にかなう場合があります。
これらのどれも、GLM-5.3-Flashが悪いモデルだという意味ではありません。あらゆる仕事に自動的に最適とは限らないというだけです。モデル自体の詳細は、GLM-5.3-Flashレビューでご覧いただけます。
代替モデルの選び方
GLM-5.3-Flashを検討している人が実際に比較しそうなモデルに絞りました。低価格から中価格帯で、速く、できればマルチモーダルかオープンウェイトのものです。見出しのベンチマークだけでなく、実際の乗り換えを左右する観点で、それぞれを評価しています。
- 価格と実際の請求額。 100万トークンあたりの定価と、それを押し上げる割増。
- 速度(トークン/秒と最初のトークンまでの時間)。
- 画像/マルチモーダル対応。 GLM-5.3-Flashの看板機能だからです。
- オープンウェイトかクローズドか。 自前でホストしたい人向け。
- コンテキストウィンドウと最大出力。
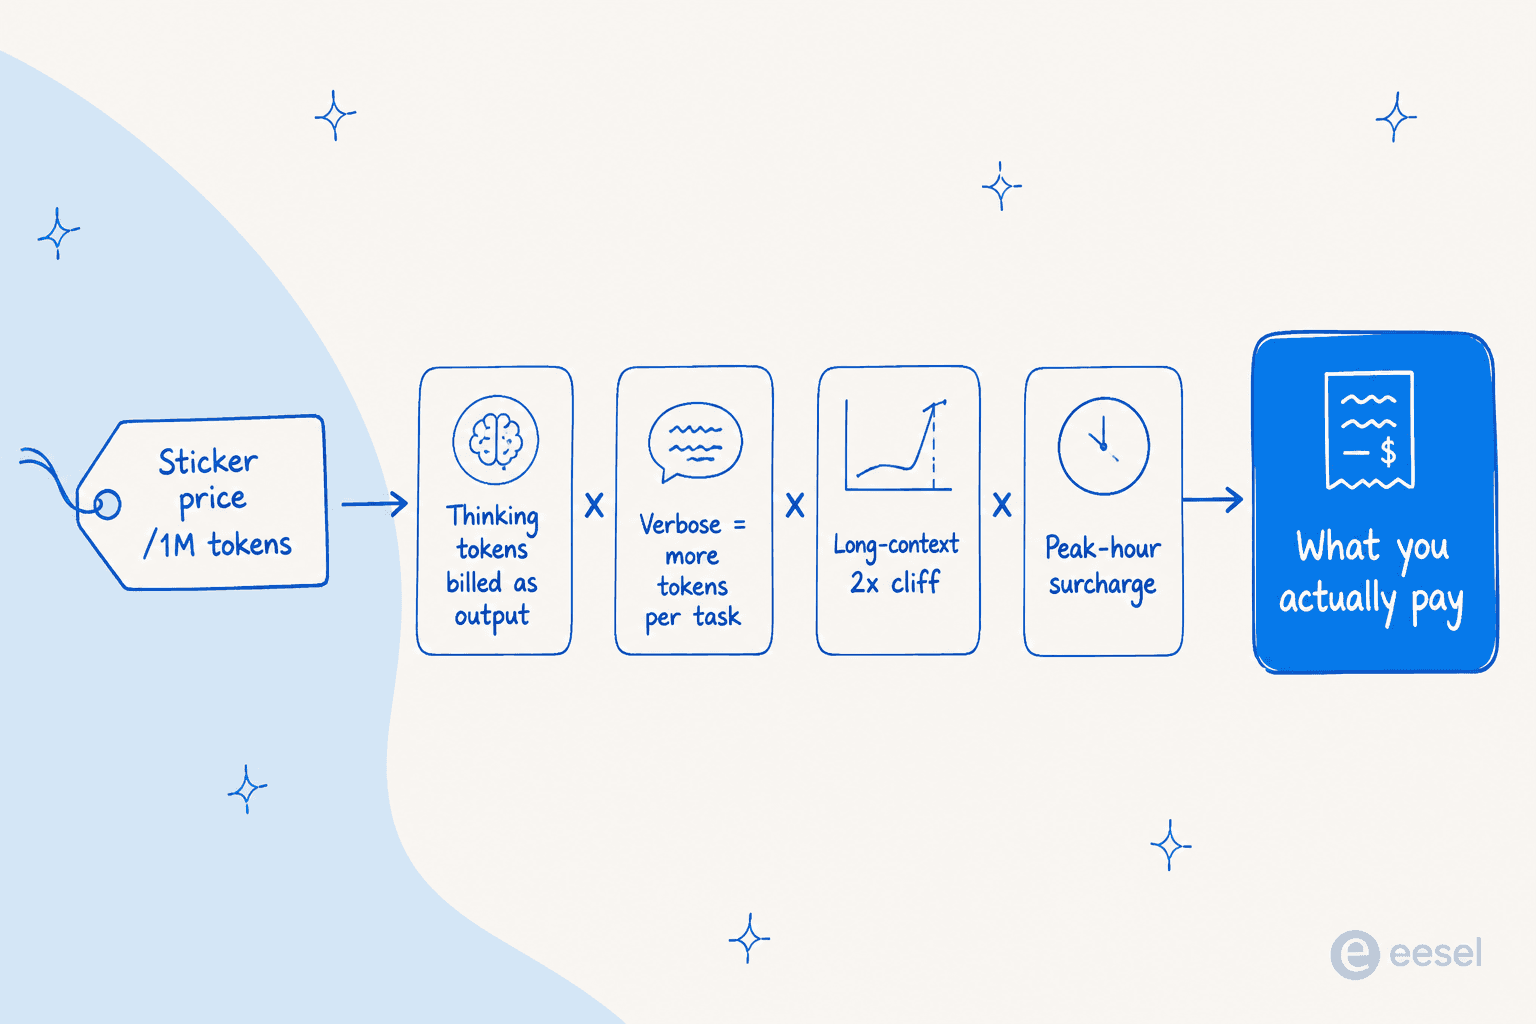
全体を貫くテーマが一つあります。定価は請求額ではないということです。思考トークンは出力料金で課金され、冗長なモデルはタスクあたりのトークンを多く消費し、長いコンテキストに割増を課すベンダーもあり、DeepSeekにはピーク時間帯の倍率さえあります。下の表の各行について、これを念頭に置いてください。
多くの人が重視する2つの軸、価格とウェイトが公開されているかどうかで、各選択肢の位置を示します。
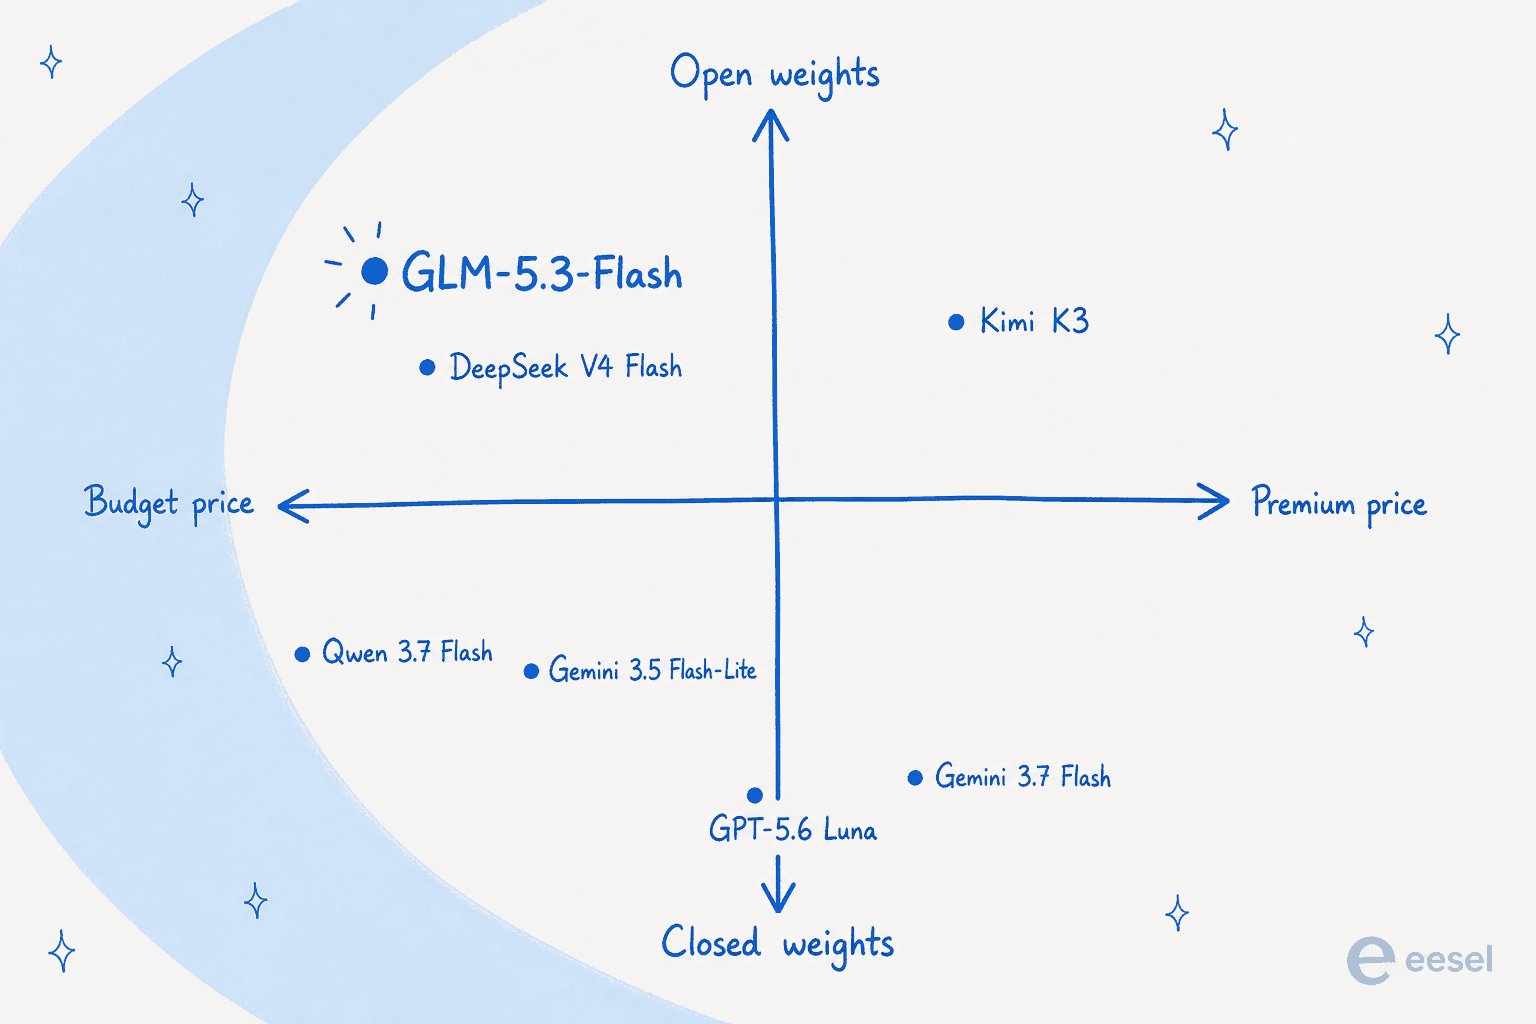
GLM-5.3-Flashの代替モデル一覧
| モデル | 向いている用途 | 入力 / 出力(100万あたり) | コンテキスト | ウェイト | 画像 | 備考 |
|---|---|---|---|---|---|---|
| GLM-5.3-Flash(現行の本命) | 安価でオープンなマルチモーダル | $0.075 / $0.25(プロモ) | 1M | オープン | 対応 | AA指数57;プロモは9月9日まで |
| DeepSeek V4 Flash | 最安のオープンウェイト | $0.22 / $0.66(ピーク外) | 1M | オープン(MIT) | 非対応(テキスト) | ピーク時は2倍;冗長 |
| Gemini 3.7 Flash | 最速のクローズドモデル | $0.75 / $3.75(プロモ) | 約1M | クローズド | 対応 | 約340 t/s;2027年1月に倍額 |
| Gemini 3.5 Flash-Lite | 速度/価格の下限 | $0.30 / $2.50 | 約1M | クローズド | 対応 | Geminiで最速かつ最安の階層 |
| GPT-5.6 Luna | 大手ブランドのエコシステム | $0.20 / $1.20 | 1.05M | クローズド | 対応(画像入力) | 272Kトークン超で入力2倍 |
| Qwen 3.7 Flash | 小さなプロンプトで最安 | $0.03-$0.20 / $0.13-$0.80 | 1M | クローズド | 対応 | プロンプトサイズで価格が段階的 |
| Kimi K3 | オープンウェイト+ネイティブ画像対応 | $3.00 / $15.00 | 1M | オープン | 対応(ネイティブ) | フラッグシップ級、低価格ではない |
では、検討する順に、それぞれの詳細を見ていきます。
1. DeepSeek V4 Flash
向いている用途: 実際に自前でホストできるオープンウェイトを求め、テキスト処理で可能な限り低い請求額にしたいチーム。
「安くてオープン」という軸でGLM-5.3-Flashに真のライバルがいるとすれば、それはDeepSeek V4 Flashです。総計284B/アクティブ13BのMoEで、正真正銘のMITライセンスで公開され、コンテキストは100万トークン、ウェイトはSGLangやvLLMで動かせます。GLMに対するコミュニティの反応でも、DeepSeekが基準として使われており、r/opencodeには、GLMの"visible context grows half as fast as Deepseek Flash" というコメントがありました。
強み。 MITライセンスが真の魅力です。約167GBのウェイトを自前でホストでき、限界コストは自社GPUの費用に近づき、お客様データも自社インフラに置けます。この最後の点こそ、GLMのデータ面の弱さが響くところです。最大努力では有能な推論モデルで(Artificial Analysisのスコアは50)、ホスト型APIでも本当に安価です。
注意点。 2つあります。第一に、テキスト専用で、画像入力の記載がなく、GLMの画像対応を使っているなら同等の置き換えにはなりません。第二に、ホスト型の価格にはピーク時間帯の割増があります。キャッシュミスの入力は、ピーク外では$0.22/Mですが、ピーク時間帯(UTC 01:00-04:00と06:00-10:00)は$0.44/Mで、出力は$0.66から$1.32に上がります。米国やEUのサポートキューはほとんどがピーク外の課金になり、これはこちらに有利な特性ですが、頼りない前提です。また冗長で、同クラスの中央値よりタスクあたりの出力トークンが多くなります。
料金。 ピーク外は100万あたり入力$0.22/出力$0.66、ピーク時はちょうど倍です。キャッシュヒットはピーク外で$0.007/Mとほぼ無料です。詳細な数字はDeepSeek V4 Flashの料金の記事にあります。マルチモーダルの差を埋めたいなら、テキスト+画像の実験版DeepSeek V4 Flash Visionもあります。
結論。 オープンウェイトと自前ホストが画像対応より重要なときの選択肢です。画像を送らず、自前で推論を運用できるなら、データ管理と限界コストでGLMに勝ります。安い設定の落とし穴についてはDeepSeek V4 Flashレビューで掘り下げています。画像対応が必要、またはGPUを運用したくないなら、読み進めてください。
2. Gemini 3.7 Flash
向いている用途: 最速のクローズドモデルと、成熟して文書が整ったプラットフォームを求め、大手ベンダーの価格を気にしないチーム。
Gemini 3.7 Flashは2026年8月13日に一般提供が始まり、Googleの "most intelligent workhorse model yet for coding and agents" とされています。公式エンドポイントのGLMの速度が決め手にならない場合の、当然の選択肢です。
強み。 速度が最大の見どころです。Artificial Analysisの計測で340.1トークン/秒、188モデル中1位です。マルチモーダルで、コンテキストは約100万トークン、Googleのツール、グラウンディング、ドキュメントが付いてきます。努力レベル別では、lowでIntelligence Indexが50.9、1タスク$0.16、最初のトークンまで1秒未満で、旧3.6 Flashのフル努力時と1ポイント以内です。努力を下げれば、速くて安くなります。
注意点。 価格は導入価格です。Googleの料金ページによれば、2026年12月31日までは100万あたり$0.75/$3.75、2027年1月1日からは$1.50/$7.50と、ちょうど倍になります。APIも大きく変わりました。temperature、top_p、thinking_budgetはなくなり、最安のminimal思考レベルも削除されたため、安価なOCRや分類の下限は3.6 Flashより高くなります。さらに、ハルシネーション率は3.6 Flashの55.6%から64.5%に悪化しており、保護なしでお客様に向けるなら大きな問題です。
料金。 2026年末まで100万あたり入力$0.75/出力$3.75、その後は倍。BatchとFlexは50%割引です。
結論。 ここで最高の生の速度を、しっかりしたプラットフォームで得られます。遅延とベンダーの成熟度が価格より重要なら選び、2027年1月の値上げは、驚かされる前に今から予算に入れておきましょう。
3. Gemini 3.5 Flash-Lite
向いている用途: 高スループット・大量処理で、最安かつ最速のGoogleモデルを求め、上限が低くても許容できる場合。
Gemini 3.7 Flashが働き者なら、Flash-Liteはスプリンターです。Googleはこれを "our fastest, most cost-effective 3.5 model for high-throughput execution," と説明しており、まさにGLM-5.3-Flashが、遅い公式エンドポイントのままでは埋めにくい枠です。
強み。 クローズド系の価格と速度の下限で、100万あたり$0.30/$2.50、約350+トークン/秒で動き、マルチモーダル入力、コンピュータ操作、大きなコンテキストも備えています。分類、ルーティング、タグ付けなど、大量の「安くて速い」処理では、オープンソースに行かない限り、これに勝るのは難しいでしょう。
注意点。 知能とスループットを交換することになります。パレート図ではIntelligence IndexでGLM-5.3-Flashをかなり下回るため、難しい推論や、ニュアンスのある複数ステップのエージェント作業には向きません。専門特化のモデルで、フラッグシップの代役ではありません。
料金。 100万あたり入力$0.30/出力$2.50、バッチは半額。
結論。 速度とコストが支配的な、大量・低複雑度のパイプラインに適した選択です。GLM水準の推論が必要なら、フルサイズのFlashモデルに戻りましょう。
4. GPT-5.6 Luna
向いている用途: すでにOpenAIのエコシステムにいて、そこから出ずに安価な階層を使いたいチーム。
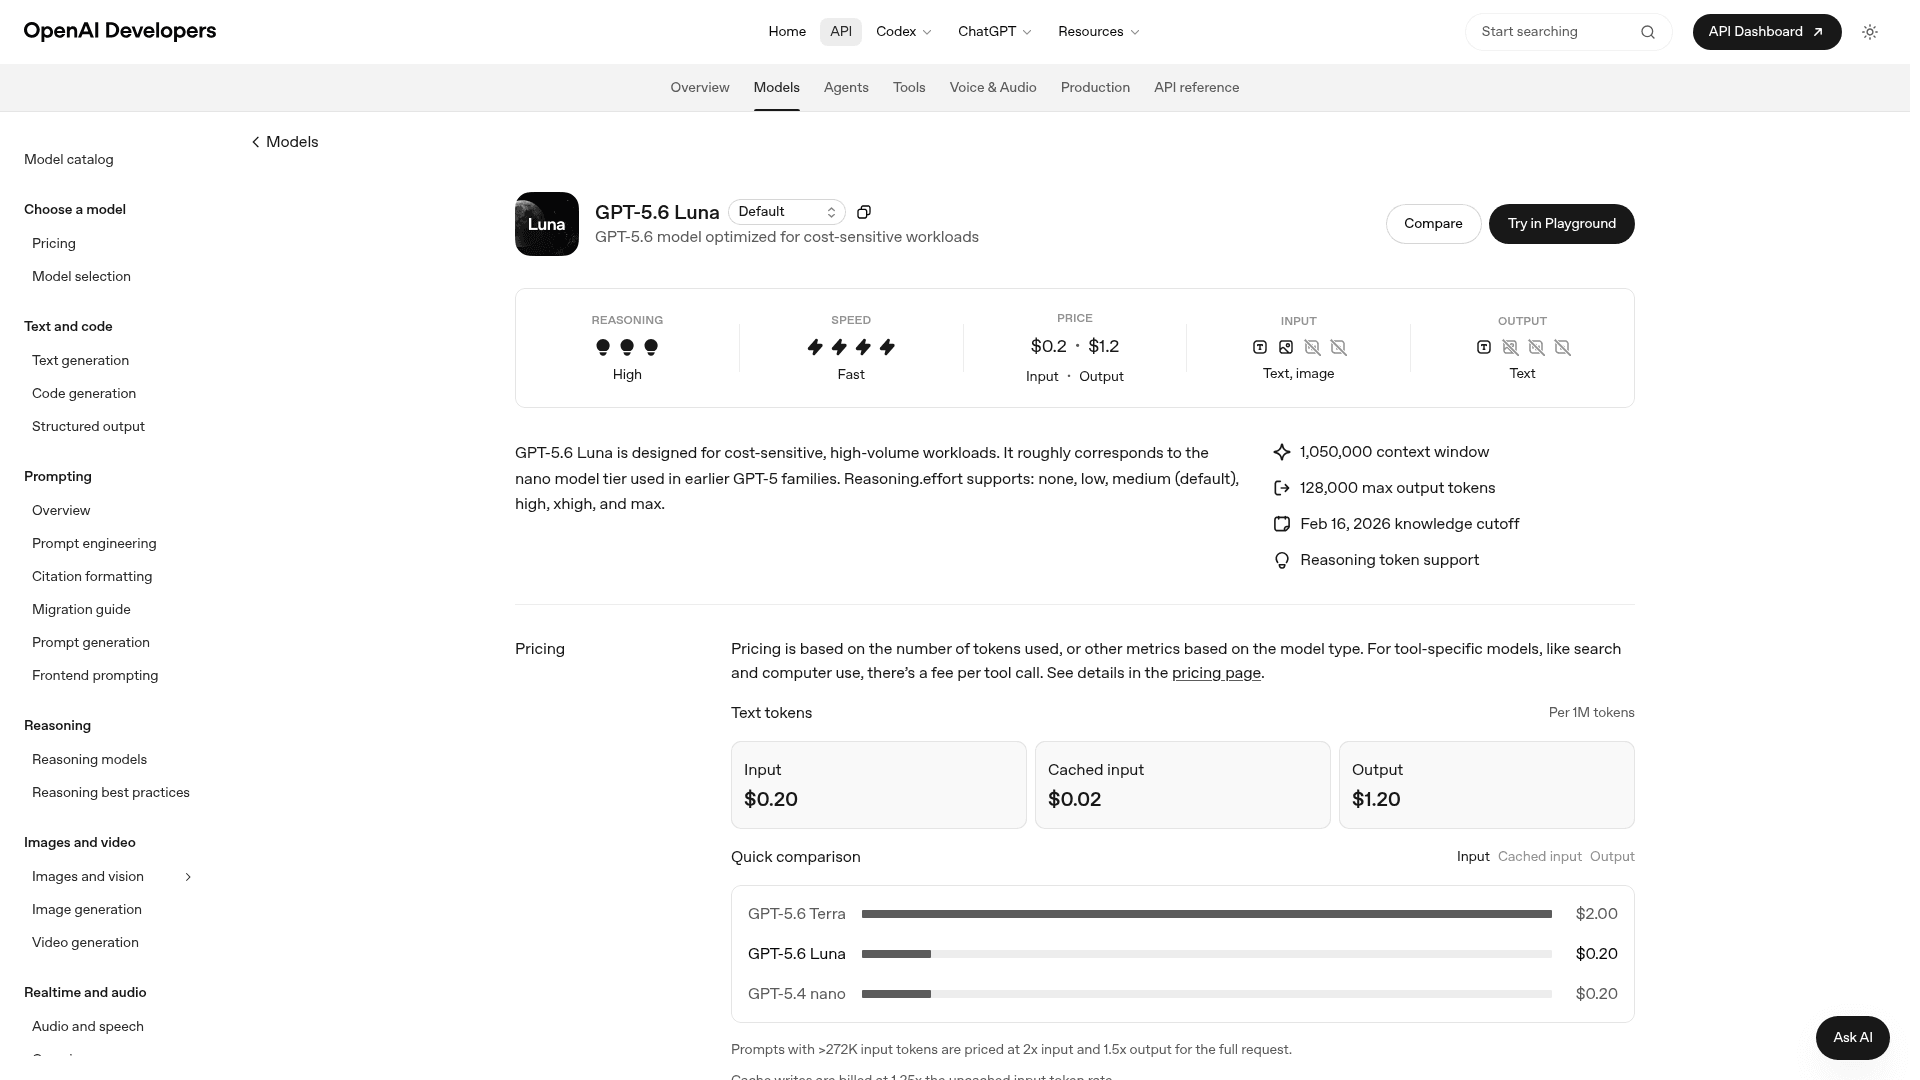
GPT-5.6 Lunaは、OpenAIのコスト重視の階層で、"designed for cost-sensitive, high-volume workloads," とされ、以前のGPT-5ファミリーのnanoに相当します。最後の1セントを削るより、最大手ベンダーのエコシステム、ツール、サポートを重視するチームにとっての代替です。
強み。 100万あたり$0.20/$1.20で、フロンティアブランドのモデルとしては安く、コンテキストは1,050,000トークン、画像入力に対応し、reasoning.effortはnoneからmaxまで揃っています。チームがすでにOpenAIのSDK、Agents、ツールを使っているなら、その中にとどまることで連携の手間がかなり省けます。無難で退屈な選択に見えますが、それが正解のこともあります。
注意点。 長いコンテキストの崖があります。入力が272Kトークンを超えるプロンプトは、リクエスト全体が入力2倍、出力1.5倍で課金されます。つまり、非常に長いプロンプトでは「100万コンテキスト」と「$0.20」は両立しません。また、クローズドでテキストと画像のみ(オープンウェイトも自前ホストもなし)、生の知能ではGLM-5.3-Flashを下回ります。ファミリーの主力ではなく、低価格の階層だからです。
料金。 100万あたり入力$0.20/出力$1.20、キャッシュ入力$0.02、上記の272K割増あり。OpenAIの詳しい背景はGPT-5.6レビューにあります。
結論。 エコシステムの引力がトークン単価に勝つときに最適です。すでにOpenAI一色なら、Lunaは安価な階層を得る最も摩擦の少ない方法です。純粋にコスト重視、またはオープンウェイトが欲しいなら、GLMかDeepSeekが勝ちます。
5. Qwen 3.7 Flash
向いている用途: 呼び出しが小さく収まる、短いプロンプトの大量の画像またはテキスト処理。
AlibabaのQwen 3.7 Flashは、この中でもう一つの低価格な中国製モデルで、料金モデルはここにある他のどれとも本当に異なります。
強み。 小さなプロンプトでは、この比較で最安です。32Kトークン未満の呼び出しで入力$0.03/M、出力$0.13/M。コンテキスト100万トークンのビジョンモデルなので、紙の上ではGLMのマルチモーダルの領域を、より低い入口価格でカバーします。
注意点。 価格はプロンプトサイズで段階的に決まり、見出しの2つの数字は同時には成り立ちません。32Kトークンを超えると$0.10/$0.40に跳ね上がり、256K-1Mの帯では$0.20/$0.80で、入力は6.7倍の開きです。OpenRouterが集計する、顧客が実際に支払う加重平均は$0.044/$0.149で、入口の料金を上回り、実際のトラフィックが上の段階に当たることを示しています。またクローズドウェイトで評価も乏しく、ベンチマークもアーキテクチャも未公開で、唯一の独立評価(Roboflow)では総合23中22位、コストでは1位です。ここでの「Flash」は安いという意味で、速いという意味ではなく、約59トークン/秒です。
料金。 段階式:プロンプトサイズに応じて100万あたり入力$0.03-$0.20/出力$0.13-$0.80。詳しい内訳はQwen 3.7 Flashの料金の記事にあり、もっと余裕が必要なら上位のQwen3.8-Maxがあります。
結論。 プロンプトが小さく収まる場合に限り、本当にお買い得です。切り替える前に実際のトークン分布をモデル化してください。長いコンテキストのサポート用途だと、知らないうちに高い帯に入ってしまうことがあります。詳しくはQwen 3.7 Flashレビューをご覧ください。
6. Kimi K3
向いている用途: GLMのようなオープンウェイトとネイティブの画像対応を求め、より高い上限のためにフラッグシップ価格を払う用意があるチーム。
Kimi K3はMoonshot AIのフラッグシップで、「オープンウェイトとネイティブのマルチモーダル」という組み合わせではGLM-5.3-Flashに最も近いモデルです。総計2.8T/アクティブ104BのMoEで、コンテキストは100万トークン、画像と動画をネイティブに理解し、ウェイトは予定どおりHugging Faceで公開されました。
強み。 注目点は能力です。Artificial AnalysisのIntelligence Indexは57で、GLM-5.3-Flashと並び、総合4位。ほとんどのベンチマークでOpus 4.8とGPT-5.5を上回ります。ネイティブの画像対応(画像と動画)とオープンウェイトにより、自前でホストしながらマルチモーダル機能を保てます。これはまさにGLMが提供するものですが、背後により大きなアクティブパラメータ数があります。
注意点。 価格です。100万あたり$3/$15は、Claude Sonnetの帯で、GLM-5.3-Flashの出力価格の約50倍です。推論はどのレベルでもオフにできず、lowの努力ではIndex 47で1タスク$0.24となり、DeepSeek V4 Flashより性能が低く、しかも約8倍高くなります。公開の画像URLも受け付けず、base64かファイルIDのみです。低価格への乗り換えではありません。
料金。 100万あたり入力$3/出力$15、キャッシュヒット$0.30。全体像はKimi K3の料金とKimi K3の代替の記事をご覧ください。
結論。 コスト削減ではなく、能力の向上のための選択です。GLMのオープン+マルチモーダルという形のまま、より高い生の知能が欲しく、フラッグシップ価格を吸収できるときにKimi K3を選んでください。コストが理由でここに来たのなら、方向が違います。
結局どの代替があなたに合うのか?
表と四象限の図でほとんどは分かりますが、正直な答えは、最も大きな制約によって変わります。いちばん重要なものを選び、どこを指すか見てみましょう。
ワークロードで最も重要なことは何ですか?
モデル選びでは解決しない部分
この表で悩んでいる人に私が伝えたいことで、実際のサポートキューでAIを何年も運用してきた経験から言えるのは、モデルの入れ替えは簡単な5%にすぎないということです。目的がお客様のチケットに答えることなら、モデルはスタックの最下層で、ベンダーを変えても最も変化しない層です。
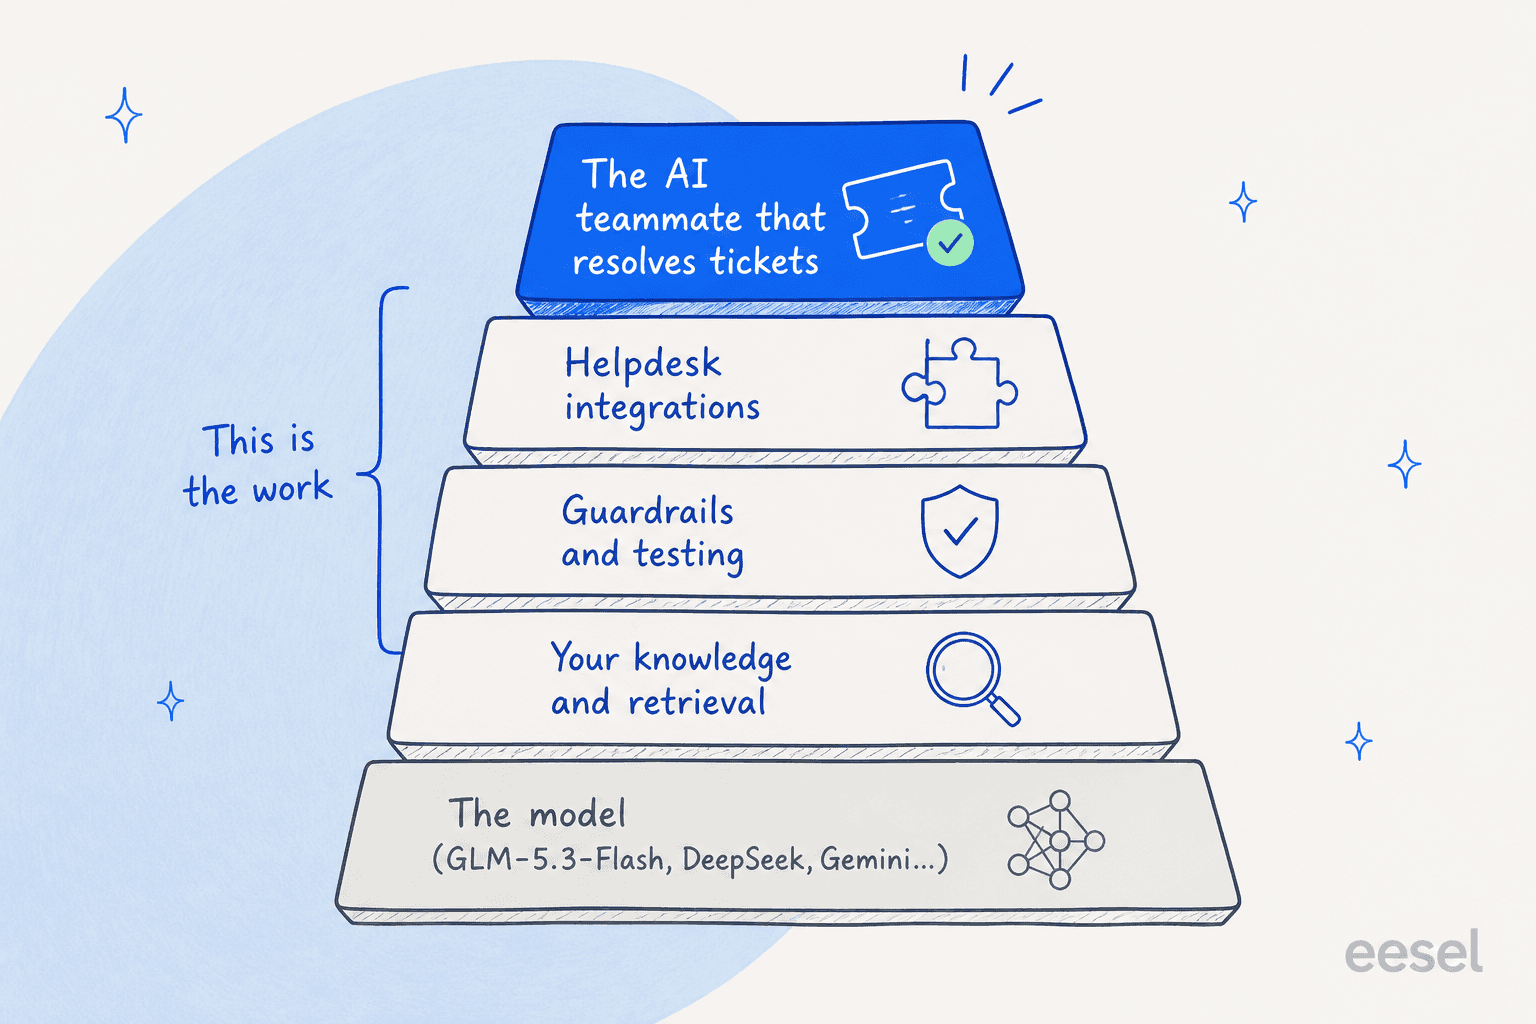
これは、素のAPIを借りるのではなくAI従業員を採用する、というのと同じ理屈であり、最高のAIチームメイトが毎秒のトークン数ではなく成果で評価される理由でもあります。モデルより上の層すべてが本当の仕事です。回答に根拠を持たせるためのナレッジベースの接続、言ってはいけないことを知るためのガードレール、お客様より先に挙動を知るためのテスト、実際に動けるようにするためのヘルプデスクとの連携です。安いモデルに替えても解決率がほとんど動かないのは、解決率が、毎秒のトークン数ではなく、これらの上位の層にあるからです。
ここでは、先ほどのハルシネーションの数字も単なる豆知識ではなくなります。Gemini 3.7 Flashの64.5%というハルシネーション率や、これらのモデルが答えるべきでない場面で自信満々に答えることは、テストされないままお客様に届いて初めて危険になります。自信ありげなボットが静かに誤った回答を出すのを、私たちは見てきました。だからこそ今では、公開前にすべてのロールアウトを、その企業の実際の過去のチケットでシミュレーションしています。「正しい」安価なモデルを選ぶだけでは、これは代わりになりません。サポートに特化したモデルレベルの見方は、サポートチケットに最適なAIモデルとして別にまとめています。
eeselを試す
カスタマーサポートの自動化を構築するためにGLM-5.3-Flashの代替を比較しているなら、eeselは、選んだどのモデルの上にも載る層です。モデルをエンジン、eeselをあなたが採用するAIチームメイトと考えてください。Zendesk、Freshdesk、Gorgiasへの接続方法を最初から把握した状態で加わり、過去のチケットとヘルプセンターから学び、あなたが設定したガードレールに従います。
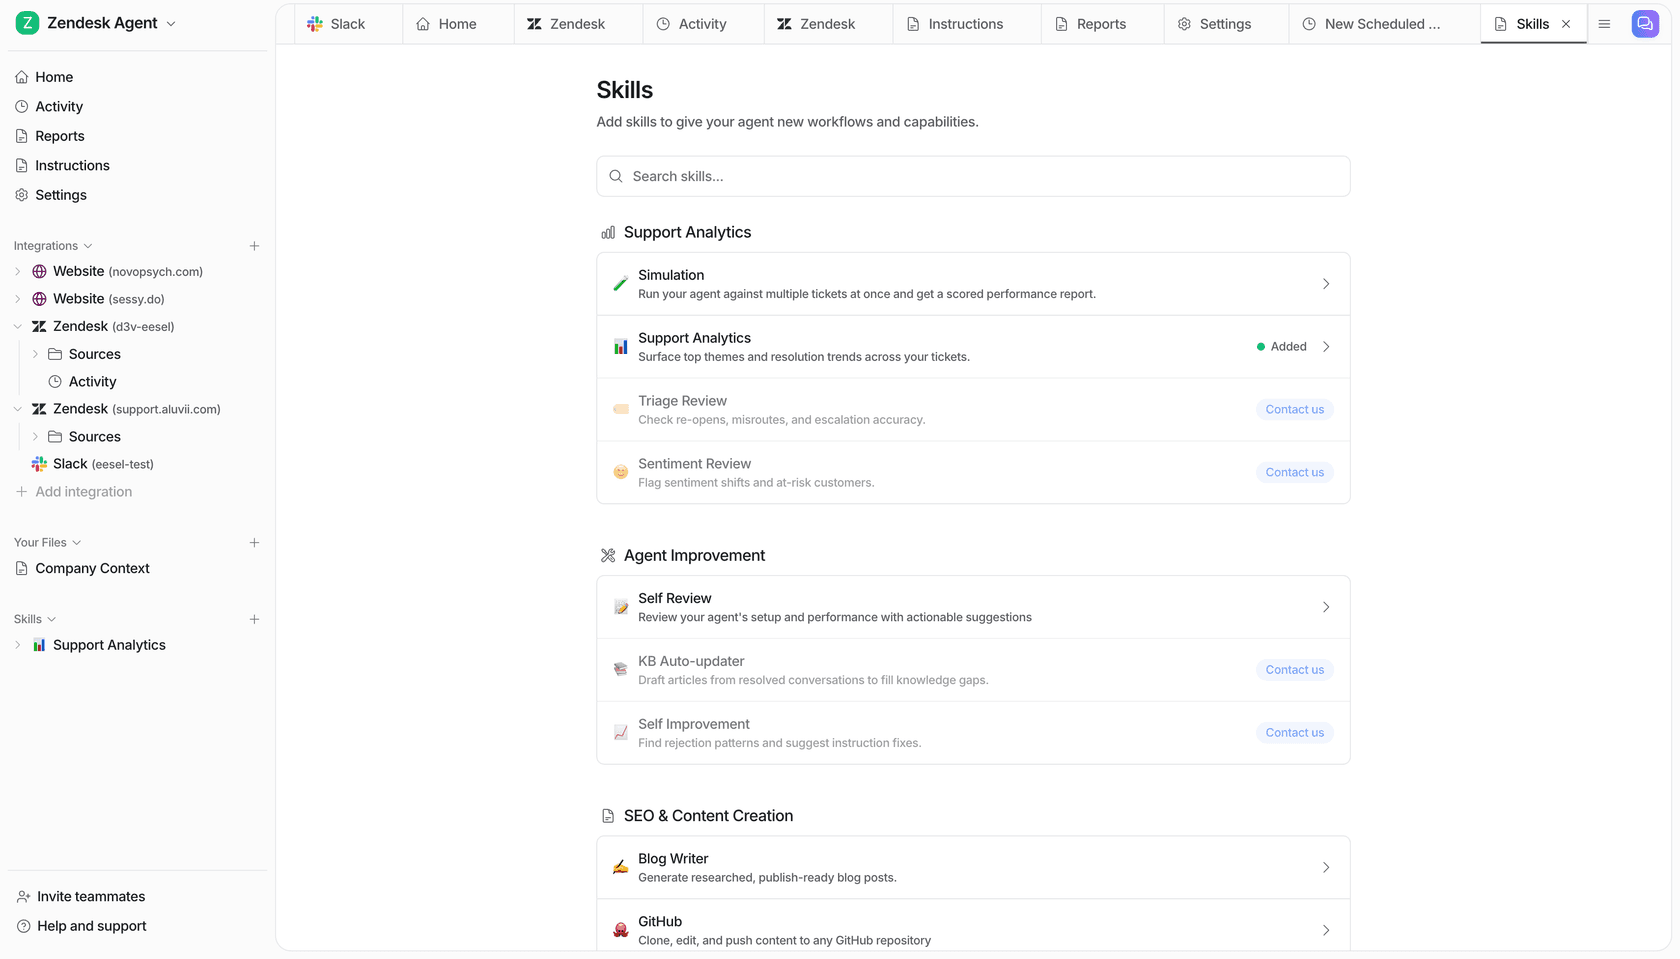
決め手はシミュレーションです。AIチームメイトが実際のチケットに1件でも回答する前に、eeselは過去の実際の会話数千件でそれを再現し、解決率と実際に送ったであろう返信そのものを確認でき、リスクがまだゼロのうちに修正できます。これが、安くて有能なモデルを、本当に信頼できるサポートエージェントに変える安全策です。無料で試せますし、数分で自社のヘルプデスクにつなげられます。