

Il n'existe pas de chiffre de précision unique pour un chatbot IA dans les services financiers ; un chiffre moyenne des questions très différentes. Expliquer ce que signifie le TAEG est facile. Les réponses qui dépendent de la grille de frais du jour, d'un taux en direct, du niveau de compte du client ou d'une exception sont celles où les bots se trompent avec assurance, généralement à cause d'une source obsolète ou fausse, pas d'un modèle faible. La précision se décide donc par l'aiguillage : documents approuvés pour les concepts, systèmes en direct pour les faits de compte, une personne pour les remises et litiges, et une relecture de vos anciens tickets avant le lancement. Le coéquipier helpdesk d'eesel fonctionne ainsi, testé d'abord sur vos propres tickets.
Les chatbots IA sont-ils précis dans les services financiers ?
La réponse honnête est « ça dépend de la question », et ce n'est pas une esquive. Je construis les agents IA chez eesel, et la chose la plus utile que j'ai apprise en observant leurs réponses sur de vrais tickets, c'est que la précision n'est pas un chiffre, elle en fait quatre, un pour chaque type de question posée par un client.
Les banques utilisent des chatbots depuis des années. Le rapport de la CFPB sur les chatbots dans la finance grand public a constaté que les dix plus grandes banques commerciales américaines les utilisent toutes, et que plus de 98 millions de personnes, environ 37% de la population américaine, ont utilisé le chatbot d'une banque en 2022. Sa conclusion principale est celle qui compte ici : les chatbots « may be useful for resolving basic inquiries, but their effectiveness wanes as problems become more complex ».
Cela correspond à ce que j'observe. Voici comment les questions se répartissent :
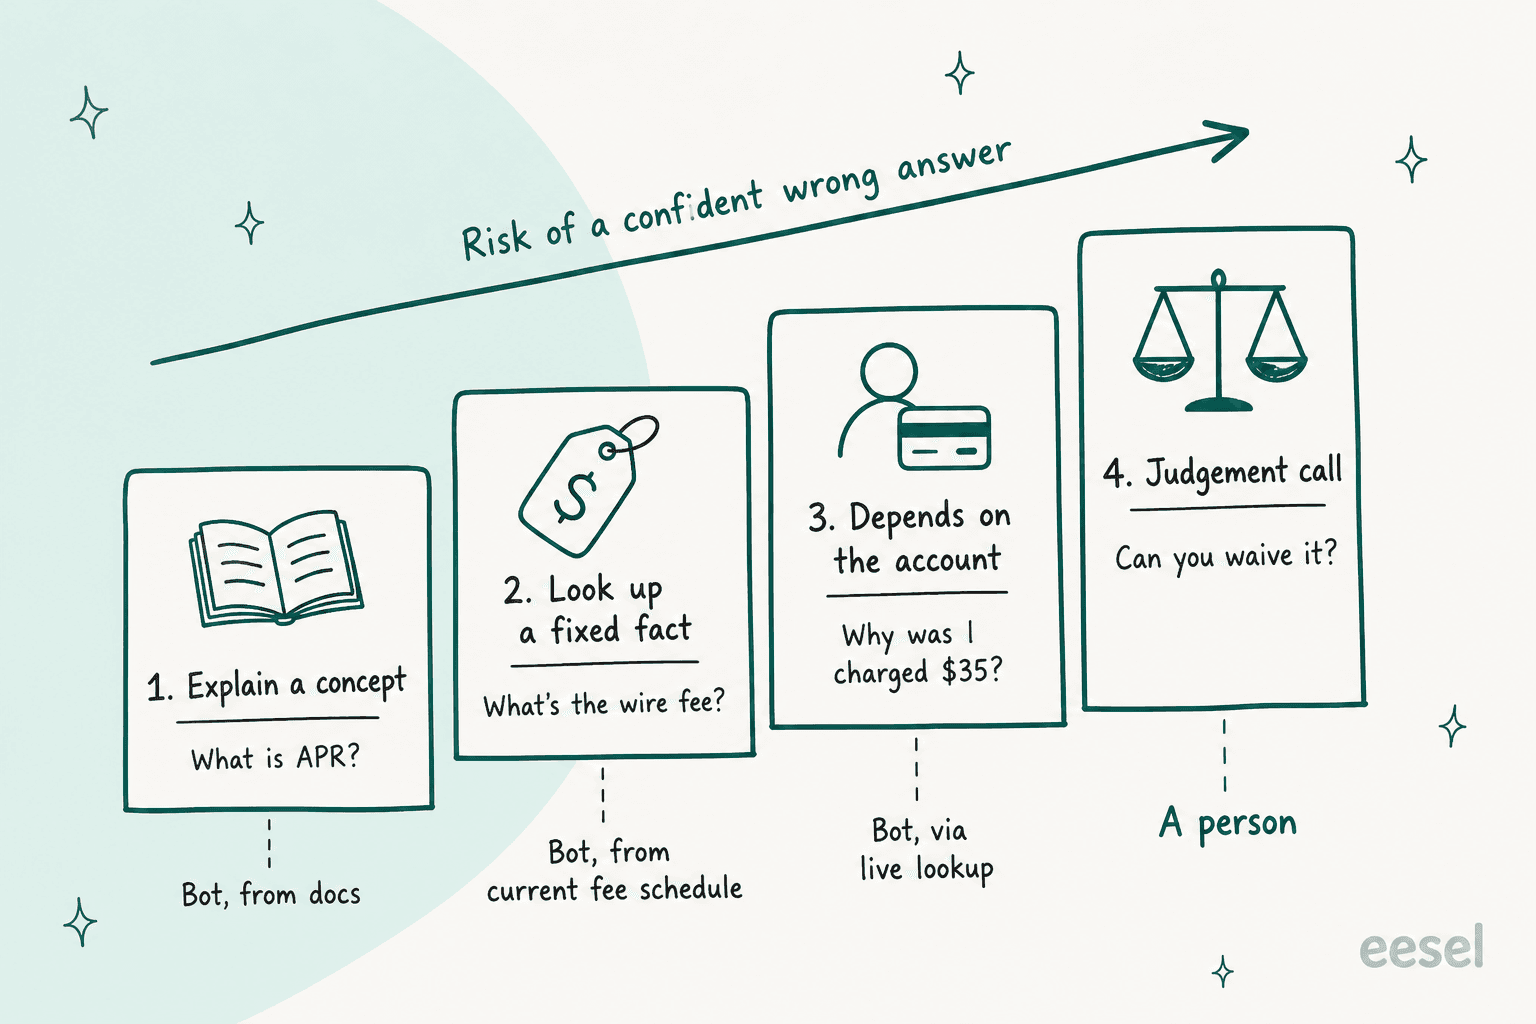
| Type de question | Exemple | Risque de mauvaise réponse | Bonne source | Ce que le bot devrait faire |
|---|---|---|---|---|
| Expliquer un concept | « Qu'est-ce que le TAEG ? » | Faible | Articles d'aide approuvés | Répondre et renvoyer vers l'article |
| Consulter un fait fixe | « Quels sont les frais de virement international ? » | Moyen : documents obsolètes ou en double | La grille de frais actuelle, avec un responsable et une date | Répondre uniquement à partir de la version actuelle |
| Dépend du compte | « Pourquoi ai-je été débité de 35 $ hier ? » | Élevé : la page de frais ne peut pas le savoir | Consultation en direct des transactions ou du compte | Consulter, citer le relevé, ou transférer |
| Décision de jugement | « Pouvez-vous l'annuler ? » | Le plus élevé : c'est une décision, pas un fait | Une personne habilitée | Recueillir les détails et transférer |
Un bot peut obtenir un score quasi parfait sur la première ligne et rester dangereux sur la troisième. Si un fournisseur vous donne un seul pourcentage global, demandez quelle part de l'ensemble de test était des questions type « qu'est-ce que le TAEG ».
eesel déploie depuis des années des agents IA sur de vraies files de support, et ce schéma se vérifie aussi hors finance. Lors d'un essai en trafic réel sur une boîte de réception e-commerce, l'équipe d'eesel a passé en revue chaque brouillon réécrit par les agents support. La plupart des réécritures portaient sur la longueur et le ton. Environ 20% nécessitaient des données que le bot ne pouvait pas voir, comme les données de commande et de logistique, et seulement environ 5% étaient des cas où le bot s'était trompé factuellement de lui-même. En d'autres termes, la plupart des problèmes de « précision » étaient des problèmes de données manquantes. En finance, les données manquantes sont la grille de frais, le compte et l'historique des transactions.
Si votre équipe utilise des agents de codage, la CLI d'eesel permet à l'un d'eux de faire le travail de configuration : importer vos grilles de frais et documents de politique approuvés, puis poser à l'agent des questions tests sur chaque frais et vérifier les réponses avant toute mise en ligne. Connecter votre helpdesk nécessite toujours qu'une personne avec un accès admin approuve la connexion.
Pourquoi les chatbots financiers se trompent-ils sur les frais et les taux ?
Parce qu'un modèle de langage répond avec aisance à ce qu'on lui donne, que la source soit juste ou non. Le profil IA générative du NIST appelle cela la confabulation : « confidently stated but erroneous or false content », plus connu sous le nom d'hallucinations. Dans un bot de support, j'en vois venir de cinq sources.
- Un document obsolète gagne la recherche. Dans un pipeline de récupération classique, la grille de frais de l'année dernière est toujours dans le centre d'aide, et elle correspond mieux aux mots du client que la nouvelle. Le bot la cite avec pleine confiance.
- Deux niveaux se mélangent. Le compte premium exonère les frais de retrait, le compte de base non. Les deux pages mentionnent les frais de retrait, et le bot les fusionne en une réponse qui n'est vraie pour personne.
- Le bot fait le calcul. Les montants de remboursement, les intérêts proratisés et les conversions de devises relèvent de l'arithmétique, et les modèles de langage ne sont pas des calculatrices.
- La question nécessite des données de compte que le bot n'a pas. « Pourquoi ai-je été débité » ne peut pas trouver de réponse sur une page de frais. Un bot sans consultation des transactions devinera le frais le plus probable au lieu du frais réel.
- La récupération ne renvoie rien et le bot comble le vide. eesel a vu cela sur de vrais déploiements : quand la base de connaissances n'avait rien de pertinent, un agent de la première heure répondait avec des connaissances générales au lieu de le dire. C'est pourquoi un filet de sécurité strict du type « je n'ai pas cette information » fait désormais partie de la façon dont on configure les agents.
Le point sur le calcul est sous-estimé. Voici la tentative d'un utilisateur de Hacker News pour obtenir un montant de paiement de ChatGPT :
"I asked it to calculate my total mortgage payments over 10 years for $100,000 at 2% interest. The result ($102,945.60) looked a bit suspicious to me. But it gets really interesting with 4.5% interest."

À 4,5%, le modèle a ensuite produit une mensualité négative puis expliqué pourquoi cela avait du sens. Personne ne devrait citer à un client un montant de remboursement issu de l'arithmétique propre d'un modèle de langage. Le chiffre doit venir du système de prêt, et le travail du bot est de le répéter.
Le risque le plus grand est que les clients croient ces réponses, qu'elles viennent du bot d'une banque ou de ChatGPT en finance. Un autre commentateur sur un forum de finances personnelles l'a formulé ainsi :
"Our robot overlords are terrible at anything financial. I'm on a financial forum where, lately, people are constantly posting stuff that they got from The Oracle and asking what they're doing wrong because they don't understand the result, and the answer is inevitably that ChatGPT or whatever fed them plausible-looking rubbish"
« À l'apparence plausible » résume le problème en une expression. Un frais erroné dans une réponse assurée et bien formatée se lit exactement comme un frais correct. Le guide sur la prévention des hallucinations et l'article sur garder un agent les pieds sur terre approfondissent la mécanique générale. En finance, les cinq causes ci-dessus se résument à une seule question : d'où vient cette réponse ?
Qui est responsable quand un chatbot donne une mauvaise réponse ?
L'entreprise qui l'a déployé. L'affaire que tout le monde cite n'est pas celle d'une banque, mais c'est le jugement le plus clair qui existe.
Dans l'affaire Moffatt c. Air Canada (2024 BCCRT 149, décidée le 14 février 2024), le tribunal de résolution civile de Colombie-Britannique a examiné un chatbot qui a dit à un client en deuil qu'il pouvait demander rétroactivement un tarif de compassion, dans les 90 jours suivant l'achat du billet. La propre page de tarif de compassion de la compagnie, vers laquelle le chatbot renvoyait, disait le contraire. Air Canada a plaidé qu'elle ne pouvait pas être tenue responsable de ce que disait son chatbot. Le tribunal a qualifié cela de « a remarkable submission », a jugé que la compagnie n'avait pas pris de précaution raisonnable pour garantir l'exactitude du chatbot, et l'a condamnée à payer 812,02 $, dont 650,88 $ de dommages. La phrase que les équipes finance devraient retenir : « It makes no difference whether the information comes from a static page or a chatbot. »
Remarquez le mécanisme. Le bot ne manquait pas de la bonne politique. Il avait la bonne page juste sous les yeux et a tout de même produit une réponse contradictoire. C'est l'échec numéro deux de la liste ci-dessus, deux sources en désaccord, et c'est la façon la plus courante dont une réponse sur les frais part en vrille.
Les régulateurs financiers disent la même chose, dans leurs propres mots :
- CFPB (États-Unis). Les chatbots « must comply with all applicable federal consumer financial laws, and entities may be liable for violating those laws when they fail to do so ». Le rapport signale aussi les bots qui ne reconnaissent pas les litiges, piègent les gens dans des « doom loops » et donnent des informations inexactes, et note que les systèmes automatisés « may be less likely to waive fees ».
- FCA (Royaume-Uni). Sa page AI good and poor practice, mise à jour le 20 octobre 2026, cite comme bonne pratique le fait que des entreprises aient « limited chatbots and generative AI assistants to approved source material, with checks and escalation routes ». Comme mauvaise pratique, elle cite des entreprises qui « overstated the accuracy, reliability or role of AI systems ».
- UE. Selon les règles de transparence de l'AI Act, en vigueur depuis août 2026, les personnes utilisant un chatbot doivent savoir qu'elles parlent à une machine.
Rien de tout cela n'interdit les chatbots. Cela signifie que vous êtes responsable de chaque réponse, donc vous devez savoir quelles réponses votre bot a le droit de donner. Le guide sur l'AI Act européen, l'article sur le support réglementé et la checklist SOC 2 et RGPD couvrent la conformité plus en détail.
D'où devrait venir chaque réponse ?
C'est la partie où je passerais le plus de temps, car c'est elle qui décide de la précision. Chaque question à laquelle votre bot pourrait répondre devrait correspondre à exactement une source de vérité avant la mise en ligne.
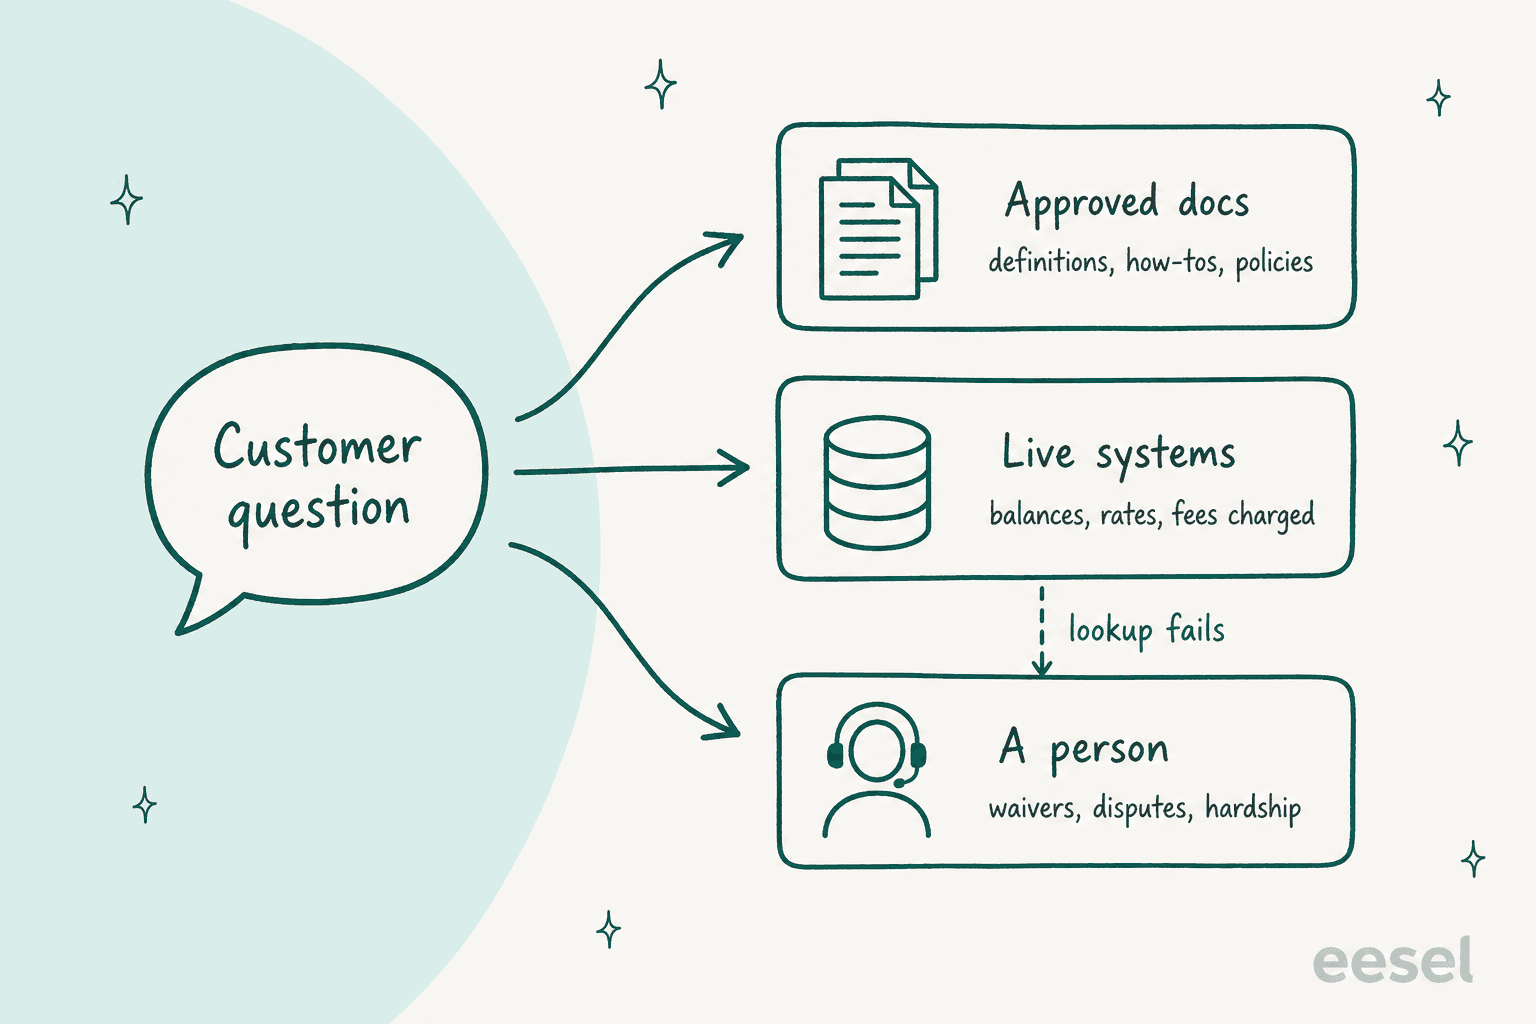
Les documents approuvés portent les concepts, les guides pratiques et les politiques publiées. Chaque document a besoin d'un responsable, d'une version et d'une date d'effet, et l'ancienne version doit quitter les connaissances du bot le jour où la nouvelle entre en vigueur. Quand deux versions d'une page de frais sont toutes deux consultables, le bot n'a aucun moyen de savoir laquelle est actuelle. Un audit régulier de la base de connaissances et des outils pour détecter le contenu obsolète font plus pour la précision que n'importe quelle mise à niveau de modèle. Le guide sur une base de connaissances IA pour la fintech explique comment la structurer.
Les systèmes en direct portent tout ce qui est spécifique à un client ou change tous les jours : soldes, frais réellement facturés, taux actuel, montant de remboursement, statut d'un paiement. Le bot y accède via des actions, c'est-à-dire des consultations d'API qu'il est autorisé à effectuer. L'intégration Stripe d'eesel, par exemple, permet à l'agent de lire les factures, paiements et abonnements pour répondre à une question de facturation directement à partir du relevé. L'article sur l'IA pour le support de facturation Stripe montre à quoi cela ressemble. Si la consultation échoue, le bot le dit et transfère. Il ne se replie jamais sur la page générale de frais.
Une personne porte les décisions : remises, remboursements hors politique, arrangements pour difficultés financières, litiges et réclamations. Plus de détails dans la section suivante.
C'est ainsi que smava, une plateforme berlinoise de comparaison de prêts, utilise eesel sur Zendesk. Environ 27 000 tickets par mois arrivent entre smava et Finanzcheck, presque tous en allemand. La position de smava est sans détour : c'est de la finance réglementée, donc chaque mot compte. eesel rédige des brouillons à partir d'environ 820 macros et articles du centre d'aide, séparés par marque, et l'agent de rédaction reprend mot pour mot le corps de la macro correspondante. Les réponses prêtes pour le client ne partent que vers les tickets sans conseiller crédit assigné, environ 1 100 des 27 000 par mois. Les instructions des agents interdisent de promettre que l'équipe vérifiera, transmettra ou organisera quoi que ce soit, et l'agent de rédaction ne peut pas prétendre avoir cherché s'il ne l'a pas fait. La liberté du bot est volontairement étroite, et cette étroitesse est la stratégie de précision.
À quoi un chatbot financier ne devrait-il jamais répondre seul ?
Tout ce qui est une décision plutôt qu'un fait, et tout ce pour quoi le bot ne peut pas désigner une seule source actuelle. Ma liste par défaut pour une file financière :
- Remises de frais et remboursements hors politique écrite. Le bot peut expliquer la politique. Il ne devrait pas décider de l'exception.
- Litiges et transactions non reconnues. La CFPB signale spécifiquement les bots qui ne reconnaissent pas un litige ou se contentent de répéter les informations que le client conteste. Reconnaître un litige et ouvrir correctement le dossier relève du bot. Le résoudre, non.
- Difficultés financières, recouvrement et vulnérabilité. Les lignes directrices de la FCA mettent en garde contre l'idée qu'un LLM pourrait détecter de façon fiable la vulnérabilité sans tests.
- Décisions d'éligibilité et de crédit. « Serai-je approuvé ? » n'est pas une question qu'un bot de support devrait trancher.
- Toute réponse où deux sources se contredisent. Si le bot trouve deux montants de frais différents, il devrait transférer, pas en choisir un.
- Les calculs. Remboursements, intérêts et conversions viennent du système de référence, ou de nulle part.
Choisissez une question ci-dessous pour voir où elle se situe et ce que le bot devrait en faire.
Mon bot peut-il répondre seul à cette question ?
Source : un article d'aide approuvé.
Le bot fait : répond directement et renvoie vers l'article. C'est la ligne facile, et celle qui alimente le plus souvent la précision mise en avant d'un bot.
Source : la grille de frais actuelle, avec un responsable et une date d'effet.
Le bot fait : répond uniquement à partir de la version actuelle. S'il trouve deux chiffres différents, il transfère plutôt que d'en choisir un. Les pages de frais obsolètes causent la plupart des erreurs ici.
Source : une consultation en direct des transactions.
Le bot fait : consulte le débit réel et cite le relevé. Il ne devine jamais à partir de la page de frais. Si la consultation échoue, il le dit et transfère.
Source : une personne habilitée à décider.
Le bot fait : explique la politique écrite, recueille le compte et le motif, et transfère. Il ne promet jamais une remise.
Source : un montant de remboursement du système de prêt.
Le bot fait : demande le montant et le répète. Il ne fait jamais lui-même le calcul des intérêts.
Source : votre processus de litige et une personne.
Le bot fait : reconnaît qu'il s'agit d'un litige, ouvre le dossier ou l'achemine avec les détails, et dit au client ce qui va se passer. Ouvrir un dossier devrait d'abord être une action nécessitant une approbation.
Écrire ces limites est la partie facile. Le bot doit les respecter, ce qui suppose deux réglages : ce qu'il peut dire et ce qu'il peut faire.
Ce qu'il peut dire vit dans ses instructions. Chez eesel, ce sont des règles en langage simple, et la plus importante pour la finance est la règle de refus : répondre uniquement à partir de la documentation récupérée, et si rien de pertinent ne revient, dire qu'on n'a pas cette information.

Ce qu'il peut faire vit dans les permissions d'action. Chez eesel, chaque action est réglée sur Activée, Demander d'abord ou Désactivée, par agent, selon la documentation sur les actions et approbations. Pour une file financière, je commencerais avec les consultations activées, tout ce qui déplace de l'argent ou ouvre un dossier en demander d'abord, et les remboursements désactivés jusqu'à avoir vu assez d'exécutions. L'article sur les garde-fous de remboursement explique pourquoi ces limites relèvent des réglages plutôt que du prompt.
Le transfert lui-même doit aussi fonctionner. Des acheteurs de support entreprise, dont un du secteur du financement médical, ont dit la même chose à l'équipe commerciale d'eesel : ils n'acceptent pas une IA qui répond à tout, même avec « je ne sais pas », et veulent qu'elle ne réponde automatiquement que si elle peut traiter le ticket, en transférant le reste. Côté client, un transfert raté ressemble à ceci :
"I told it to go get me a human and it said it would find a human... then put me through a questionnaire before telling me to call the main support line. sigh"
C'est le « doom loop » de la CFPB à petite échelle. Un transfert devrait faire passer la conversation et les détails recueillis à une personne sur le même canal. Les guides sur l'escalade de chatbot, le transfert vers un humain et les seuils de confiance couvrent la mécanique.
Pour les files à fort taux de litiges, voir l'IA pour les litiges de facturation et les demandes de contestation. Les litiges de paiement suivent le même schéma : le bot rassemble les faits, une personne décide.
Comment tester la précision avant le lancement ?
Rejouez vos propres anciens tickets dans le bot et comparez ses réponses à ce que votre équipe a réellement envoyé. Un benchmark générique vous dit comment un modèle se comporte sur les questions de quelqu'un d'autre. Vos tickets résolus vous disent comment ce bot se comporte sur vos frais, vos niveaux de compte et le vocabulaire de vos clients.
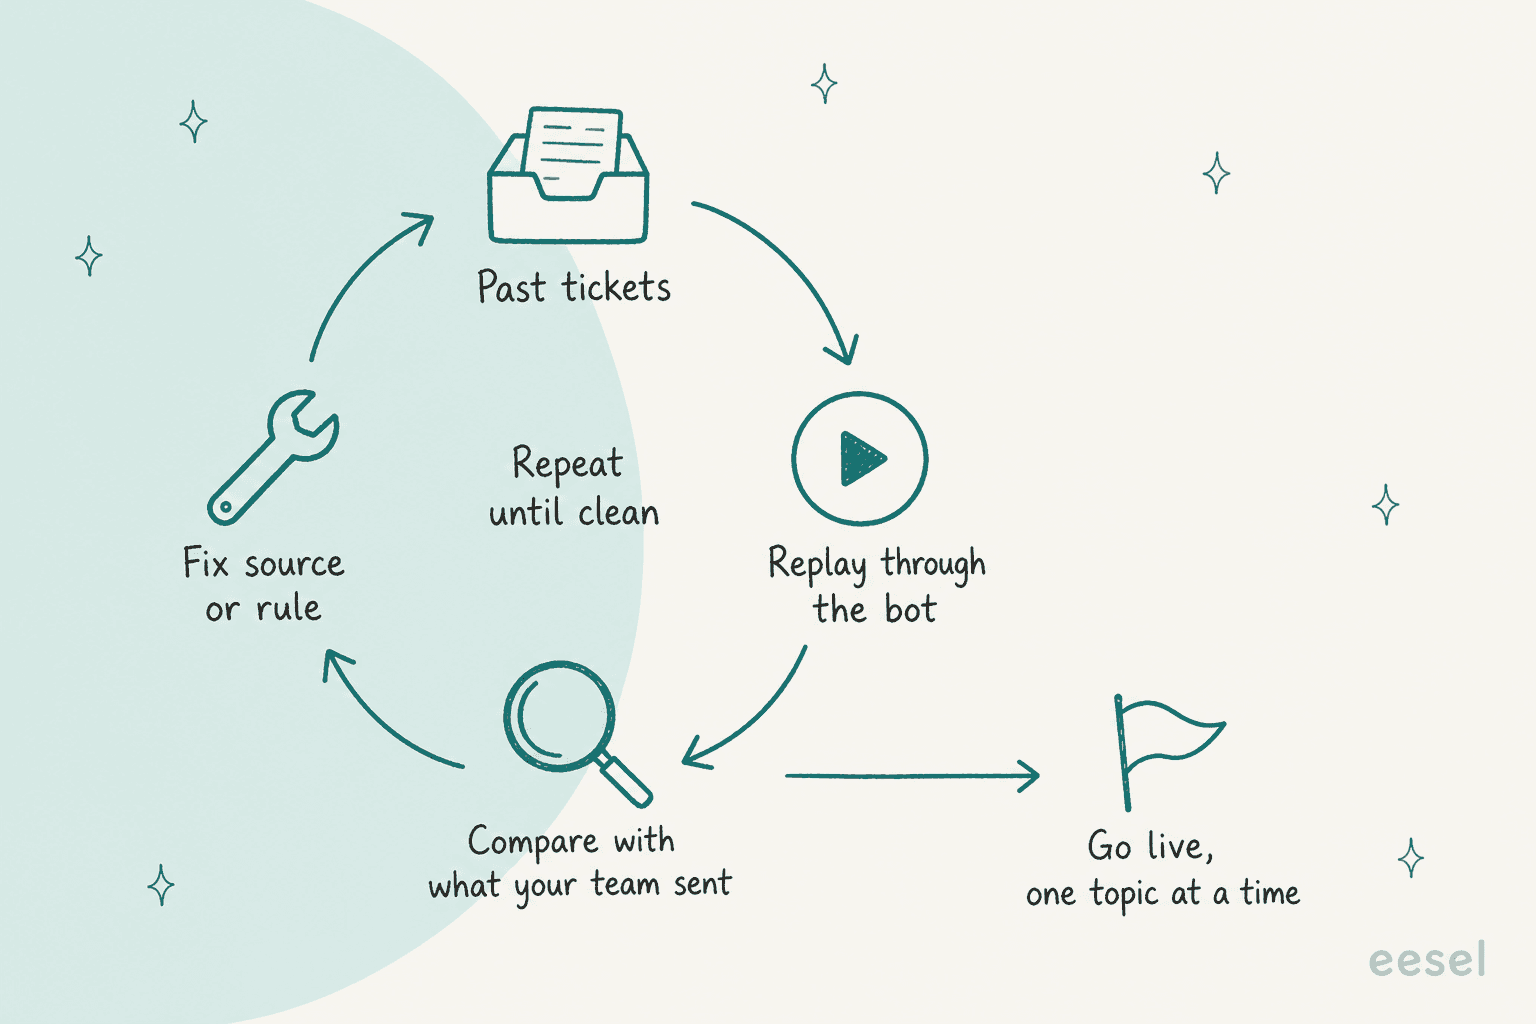
Voici la routine que je suivrais :
- Prélevez quelques centaines de tickets résolus, en surpondérant les lignes risquées : questions de frais, débits, questions de taux, litiges. Ne laissez pas les réinitialisations de mot de passe dominer l'échantillon.
- Rejouez-les sans rien envoyer. La simulation d'eesel fait tourner l'agent complet sur des tickets réels ou générés dans un bac à sable et note chaque réponse par rapport à ce que votre équipe a envoyé.
- Notez par thème, pas avec une seule moyenne. Un score global de
90%peut masquer un score de60%sur les questions de frais. La répartition par thème est le chiffre qui compte. - Étiquetez chaque échec par sa cause. Document obsolète, sources mélangées, consultation manquante, règle de refus manquante. Chaque cause a sa propre solution, et aucune n'est « essayer un autre modèle ».
- Corrigez et rejouez les mêmes tickets. Retestez sur les tickets qui ont échoué, pour savoir que la correction a fonctionné sur la formulation exacte qui posait problème.
- Mettez en ligne thème par thème, en commençant par la ligne d'explication de concept, et gardez les lignes plus risquées en brouillons pour qu'une personne les approuve.
La FCA décrit la même idée du côté du régulateur. Sa liste de bonnes pratiques inclut de tester les résultats pour les consommateurs sur différents groupes et scénarios, de conserver des traces des prompts, des sorties et des décisions d'escalade, et de comparer la performance d'un modèle au processus mené par des humains. Les plus petites entreprises, note-t-elle, peuvent utiliser des sorties échantillons et des données de test soigneusement filtrées plutôt que de tester à pleine échelle.
Les tests ne s'arrêtent pas au lancement non plus. Qontro, une entreprise d'ERP cloud en Nouvelle-Zélande, utilise eesel comme copilote sur Freshdesk : chaque ticket reçoit un brouillon, les questions de facturation vont directement à une personne, et quand un ticket ne contient pas assez d'éléments pour répondre avec confiance, eesel le dit au lieu de deviner. L'équipe compare chaque brouillon à la réponse réellement envoyée par une personne, et quand un brouillon était faux, cela pointe généralement vers un article d'aide manquant ou une règle à resserrer. Environ un brouillon sur dix sort désormais avec peu ou pas de modification. C'est un chiffre lent et honnête, et l'écart indique à l'équipe exactement où travailler.
Pour la partie continue, les guides sur la revue des conversations IA, le contrôle qualité du support IA et les tests contradictoires couvrent ce qu'il faut examiner chaque semaine.
Surveillez aussi votre taux de résolution avec un peu de méfiance : l'article sur déflection contre résolution explique pourquoi une conversation close n'est pas la preuve d'une bonne réponse.
Essayez eesel pour le support financier
Si vous mettez de l'IA face à des clients qui posent des questions sur les frais, taux et débits, eesel est un coéquipier helpdesk IA qui rejoint votre file existante dans Zendesk, Freshdesk et d'autres helpdesks. Il apprend de votre centre d'aide, de vos macros et de vos anciens tickets, ne répond qu'à partir de ce qu'il a récupéré, consulte des données en direct via des intégrations, et confie à votre équipe les remises et litiges avec les détails déjà recueillis.
La différence pour une équipe finance, c'est le test. Avant qu'un seul client ne le voie, eesel rejoue vos tickets résolus et montre, thème par thème, où il aurait cité un mauvais frais ou raté un transfert. smava l'utilise sur 27 000 tickets de prêt par mois, avec chaque règle écrite dans les instructions des agents, si bien que changer ce qu'eesel peut dire relève d'une modification de texte et non d'un projet. Les forfaits démarrent à 299 $ par mois pour 500 crédits après un essai gratuit de 7 jours, selon les tarifs d'eesel.
Pour aller plus loin sur le cas d'usage finance, voir les guides sur l'IA pour le support fintech, les chatbots bancaires et l'IA conversationnelle pour la banque.
Essayez eesel sur vos propres anciens tickets et voyez quelles questions de frais il traite correctement avant que vos clients ne le découvrent.
Comment tester la précision d'un chatbot IA avant son lancement ?