En bref
« Meta Muse pour Document360 » revient en réalité à alimenter Meta Business Agent avec votre base de connaissances Document360, l'IA qui répond aux clients sur WhatsApp et Messenger. Muse lui-même est un agent grand public. Business Agent n'a aucun importateur Document360 et n'apprend que de quatre sources : infos sur l'entreprise, entrées de FAQ, fichiers téléversés et sites web publics explorés.
Document360 facilite la chose plus que la plupart des outils, car un site Document360 public est fait pour être exploré. Les cas difficiles sont les projets privés et la fraîcheur. Meta ne peut pas explorer derrière une connexion lecteur, les fichiers téléversés ne se mettent jamais à jour d'eux-mêmes, et le serveur MCP de Document360 se connecte via un flux OAuth utilisateur que les connecteurs de Meta ne prennent pas en charge. Une clé d'API v3 en lecture seule est l'authentification qui convient.
eesel fait tourner de l'IA sur de vraies files de support depuis des années, et l'échec que je vois le plus est un bot qui répond avec aplomb alors que la base de connaissances n'a rien sur le sujet. Si vos articles Document360 changent chaque semaine, eesel explore votre site Document360, cite l'article source dans chaque réponse et est testée sur vos anciens tickets avant de répondre à qui que ce soit.
Ce que « Meta Muse pour Document360 » signifie vraiment
Je passe beaucoup de temps sur ce que les gens tapent dans Google avant d'acheter, et « Meta Muse pour Document360 » est un bon exemple de recherche qui pointe vers le mauvais produit. Trois produits Meta portent le nom Muse ou en sont proches, et un seul parle à vos clients (mon hub Meta Muse pour le support client détaille les trois) :
- Muse, l'agent IA personnel lancé par Meta pour les courses du quotidien des particuliers. Il n'est pas conçu pour répondre aux clients d'une entreprise.
- Muse Spark 1.3, le modèle, vendu via la Meta Model API. Vous pourriez construire vous-même un bot Document360 dessus, et mon aperçu de Muse Spark 1.3 donne les détails du modèle.
- Meta Business Agent, que Meta a lancé en juin comme l'IA qui répond aux clients sur WhatsApp, Messenger et Instagram. Meta affirme que plus d'un million d'entreprises l'utilisent déjà.
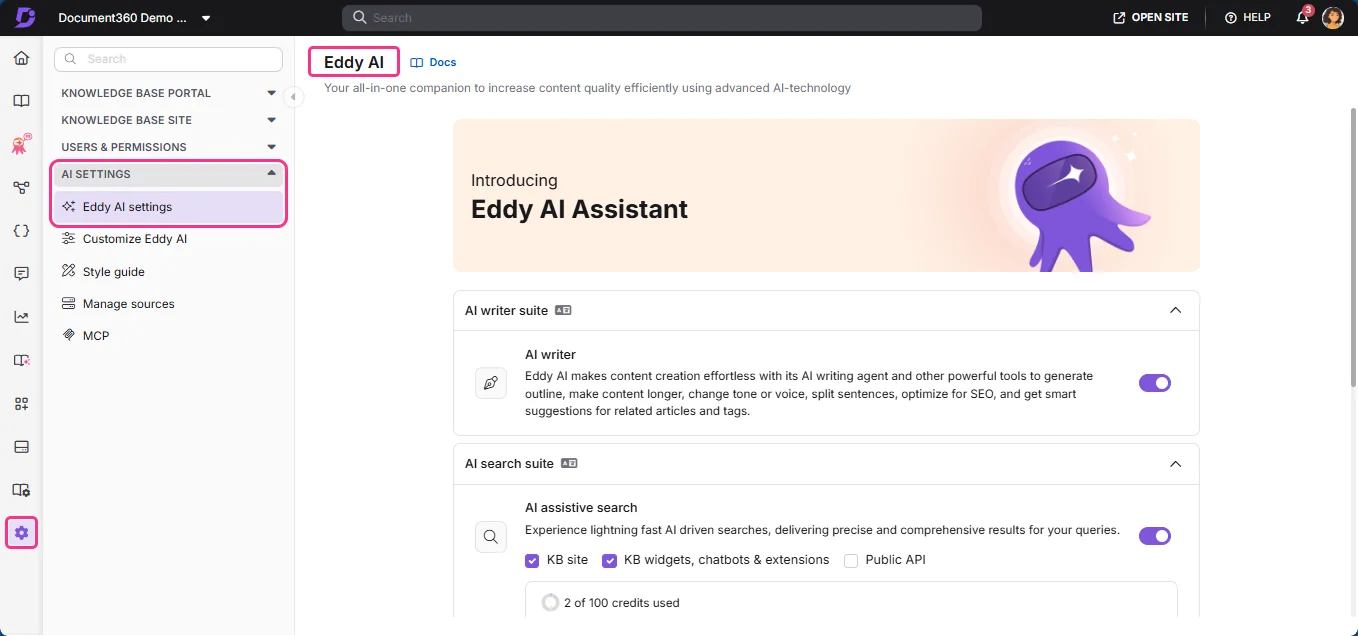
La vraie question d'achat derrière la recherche est donc : comment mon contenu Document360 arrive-t-il dans un bot WhatsApp ? C'est un autre travail que celui des articles sur les helpdesks de cette série, comme Zendesk ou Freshdesk, où atterrissent les conversations. Document360 est l'endroit où vivent les réponses, et il a déjà sa propre IA, Eddy, sur laquelle je reviendrai.
Document360 ressemble aussi davantage à la version Confluence de cet article qu'à n'importe quel helpdesk. La différence est que la plupart des sites Document360 sont tournés vers le client par conception, ce qui change la voie la plus simple.
Quatre façons d'amener le contenu Document360 à l'agent de Meta
La page des capacités de Meta liste quatre sources de connaissances sur la Platform API : Business Info, FAQs, Files et Websites. Les actions et consultations passent par des connecteurs, des intégrations HTTP ou MCP que vous définissez. Document360 n'est nommé nulle part dans la documentation de Meta.
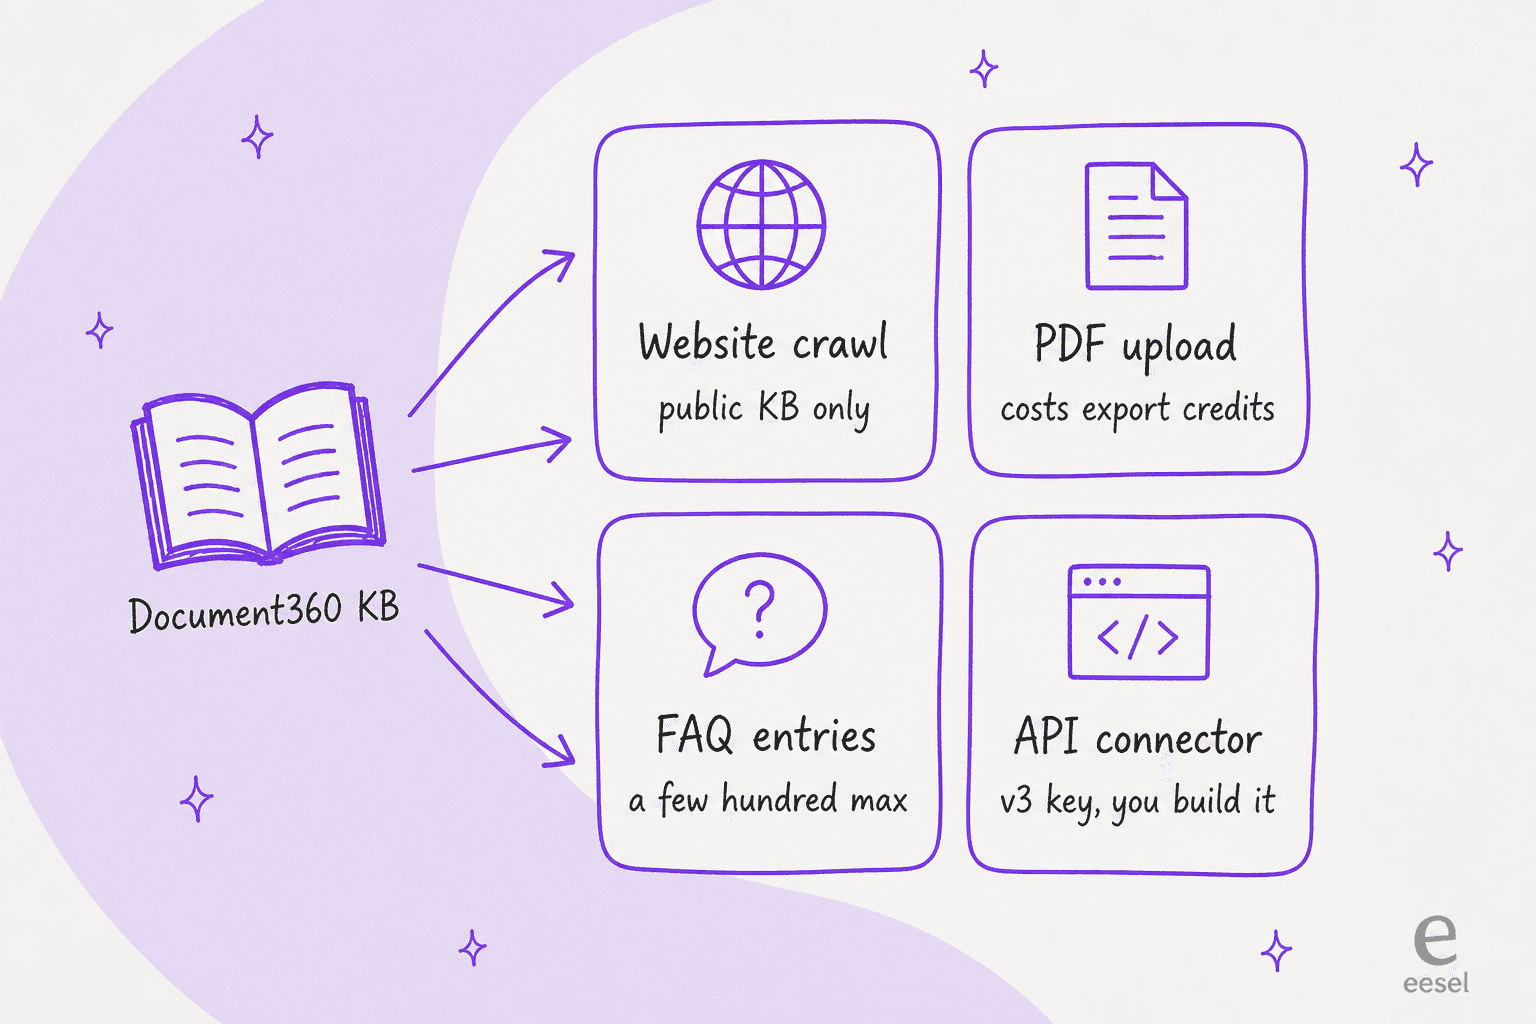
Voici comment les quatre se comparent avant de détailler chacune :
| Voie | Entrée Meta | Configuration Document360 | Projets privés ? | Fraîcheur | Principal piège |
|---|---|---|---|---|---|
| Exploration publique | API Websites | Un projet public ou mixte, sitemap activé | Non | Prochaine exploration, intervalle non publié | Ne fonctionne que pour les articles publics |
| Téléversement PDF | API Files | Exporter les articles en PDF | Oui, si vous les exportez | Jamais, jusqu'au re-téléversement | Consomme des crédits d'export PDF, les anciens fichiers restent actifs |
| Réécriture en FAQ | API FAQs | Aucune, réécrire à la main ou avec le générateur de FAQ IA | Oui | Quand vous mettez à jour l'entrée | La qualité baisse au-delà de quelques centaines d'entrées |
| Connecteur d'API | Connecteur HTTP | Clé d'API v3, en lecture seule et restreinte | Oui, selon le périmètre de contenu de la clé | En direct | Vous le construisez et le maintenez |
Voie 1 : laisser Meta explorer votre site Document360 public
C'est la voie que la plupart des équipes Document360 peuvent utiliser aujourd'hui, car un projet Document360 public est déjà un site web.
L'API Websites de Meta explore une URL et en récupère le contenu. Par défaut, elle prend « tout le domaine », et vous pouvez restreindre avec des champs de sous-domaine, de motif d'URL et d'URL unique. La requête n'a aucun champ pour une connexion ou un cookie, et le guide de l'agent de support de Meta la décrit comme l'exploration de « votre site web public ». Seul le contenu que n'importe qui peut ouvrir sans se connecter est donc concerné.
Document360 offre quelques contrôles qui rendent l'exploration plus propre :
- Sitemap. Document360 en génère un pour votre site, la carte qu'un robot suit. La documentation du sitemap détaille son contenu.
- Robots.txt. Vous pouvez le modifier dans les paramètres du site de base de connaissances pour bloquer des chemins pour tous les robots ou un user agent, selon la page robots.txt de Document360. Meta ne publie pas le user agent de son robot dans la documentation de Business Agent, donc je restreindrais avec les champs de motif d'URL de Meta sans me fier aux règles robots.
- Visibilité dans la recherche. Des bascules par article excluent une page de Google, de la recherche de la base de connaissances ou d'Eddy AI. Le piège figure dans la documentation de visibilité dans la recherche de Document360 : ces paramètres « ne restreignent pas l'accès ». Un article exclu reste lisible à son URL, donc un robot qui trouve le lien peut quand même le lire.
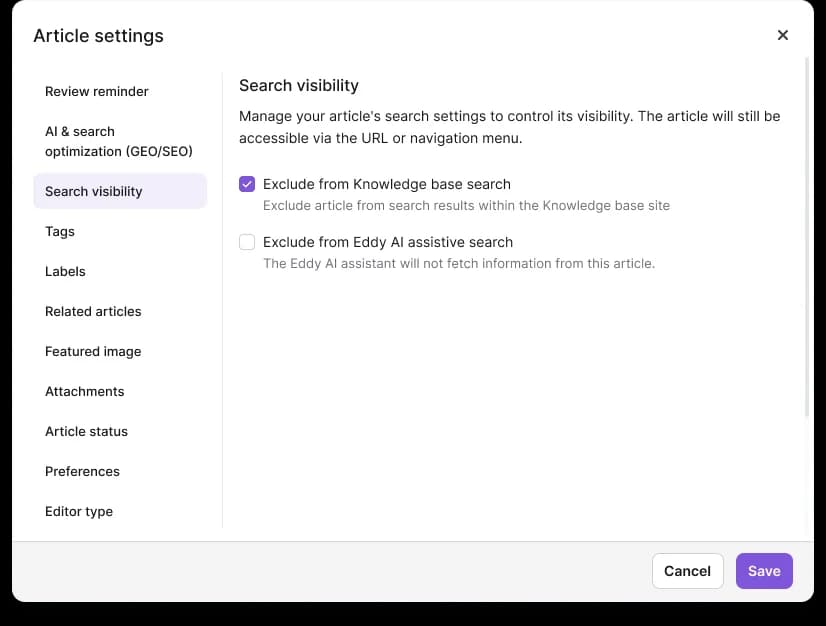
Ce dernier point compte si vous avez un projet mixte, où certaines catégories sont publiques et d'autres réservées aux lecteurs connectés. La FAQ tarifaire de Document360 décrit les projets comme publics, privés ou mixtes, et dit que les comptes lecteur « ne s'appliquent qu'aux bases de connaissances privées » (tarifs Document360). Meta verra la partie publique et rien d'autre, vérifiez donc que les réponses les plus demandées par les clients ne se trouvent pas dans la moitié réservée aux lecteurs.
Restreignez quand même l'exploration. Le guide de Meta avertit qu'explorer un site entier « dilue le contenu d'aide dont l'agent devrait tirer ses réponses ». Si votre site Document360 comporte aussi une référence d'API ou des notes de version, pointez Meta uniquement vers les catégories d'aide.
Voie 2 : exporter les articles en PDF et les téléverser
Pour un projet privé, vous pouvez exporter le contenu et remettre les fichiers à Meta. L'export PDF de Document360 permet de choisir des catégories et des articles, d'appliquer un modèle et de télécharger un PDF.
L'API Files de Meta accepte .pdf, .doc, .docx et les images, avec CSV et XLSX quand l'extraction est activée, jusqu'à 100 000 000 d'octets par fichier. Markdown et HTML ne figurent pas dans la liste, donc le PDF est le format raisonnable ici. Deux détails de Document360 valent d'être connus d'abord :
- Les exports coûtent des crédits. « Chaque page du PDF généré consomme un crédit » d'un quota mensuel, et ce quota est partagé avec les PDF que vos lecteurs téléchargent depuis le site. Un export de 200 pages chaque semaine finit par peser.
- Seul le contenu publié entre. Les articles et catégories masqués ne sont pas sélectionnables, ce qui est utile, car cela garde les brouillons hors du bot.
Vient ensuite la partie que Meta signale dans son propre guide de support :
« Il n'y a pas d'appel de mise à jour. Pour remplacer un document, supprimez l'ancienne entrée et téléversez la nouvelle, sinon l'agent puise dans les deux versions et peut citer un terme que vous avez déjà retiré. »
Supposons que votre délai de retour passe de 30 à 14 jours et que quelqu'un téléverse le nouveau PDF sans supprimer l'ancien. L'agent peut citer l'un ou l'autre chiffre sur WhatsApp. La documentation d'export de Document360 dit la même chose sous l'autre angle : un PDF exporté « est statique », et les modifications ultérieures « n'apparaîtront pas dans le PDF ». Cette voie implique donc un script qui supprime le fichier précédent par son ID et téléverse le nouveau à chaque changement de contenu.
Meta déconseille aussi de tout téléverser : « un grand jeu de documents ralentit l'agent pour trouver le bon passage ». Des PDF plus petits par catégorie valent mieux qu'un export géant.
Voie 3 : réécrire vos principaux articles en entrées de FAQ
L'API FAQs de Meta stocke des paires question-réponse que vous pouvez mettre à jour sur place. L'agent traite une entrée correspondante comme la réponse et « répond à partir d'elle, plutôt que de déduire une réponse de vos autres sources de connaissances ». Cela fait des FAQ l'entrée la plus prévisible pour des réponses qui doivent être exactes, comme les conditions de remboursement ou les prix.
Le plafond est bas : Meta dit que la qualité peut se dégrader « en général au-delà de quelques centaines » d'entrées. Pour une équipe Document360, cette voie est moins coûteuse qu'il n'y paraît, car le générateur de FAQ IA d'Eddy rédige déjà des paires Q/R à partir d'un article. Je prendrais les principaux motifs de tickets du dernier trimestre (la même liste que pour la déflexion de tickets WhatsApp), je générerais des FAQ pour ces articles, je les retoucherais à la main et je les pousserais chez Meta. La longue traîne va à l'exploration ou à un connecteur.
Voie 4 : construire un connecteur d'API avec une clé v3 restreinte
C'est la seule voie qui garde le contenu privé à la fois privé et à jour, et c'est celle que vous devez construire.
La référence des connecteurs de Meta permet de pointer l'agent vers une API HTTP ou un serveur MCP distant. L'authentification est limitée : « Actuellement, seuls OAUTH2_CLIENT_CREDENTIALS, API_KEY et NONE sont pris en charge. » Cette seule ligne décide de l'interface Document360 utilisable.
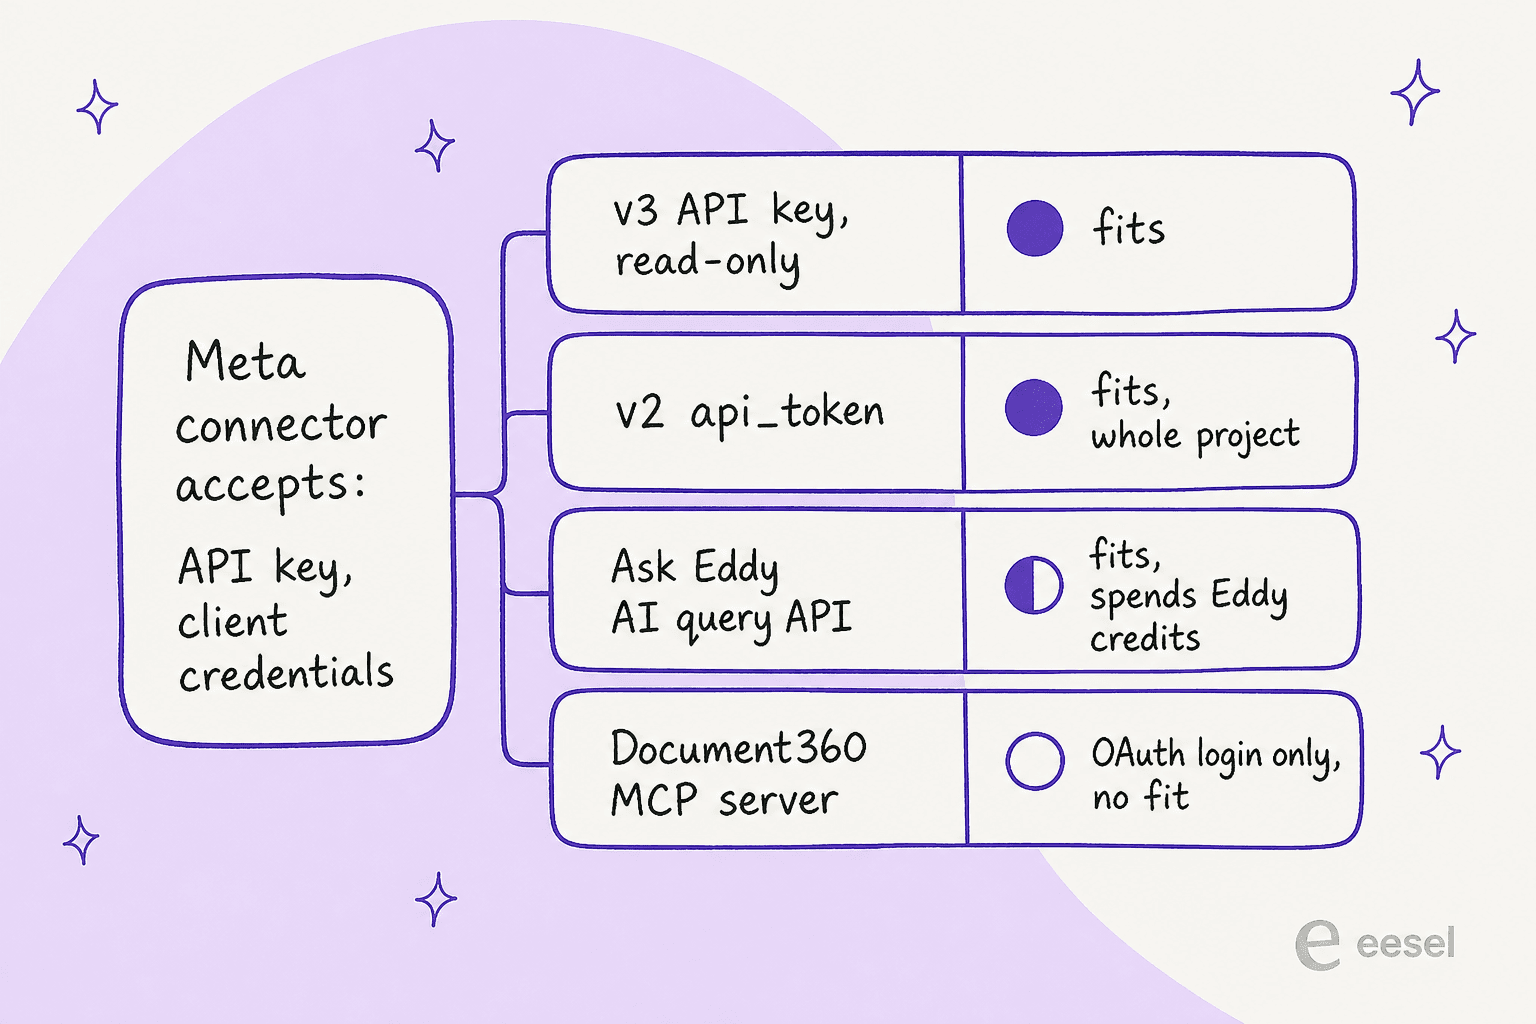
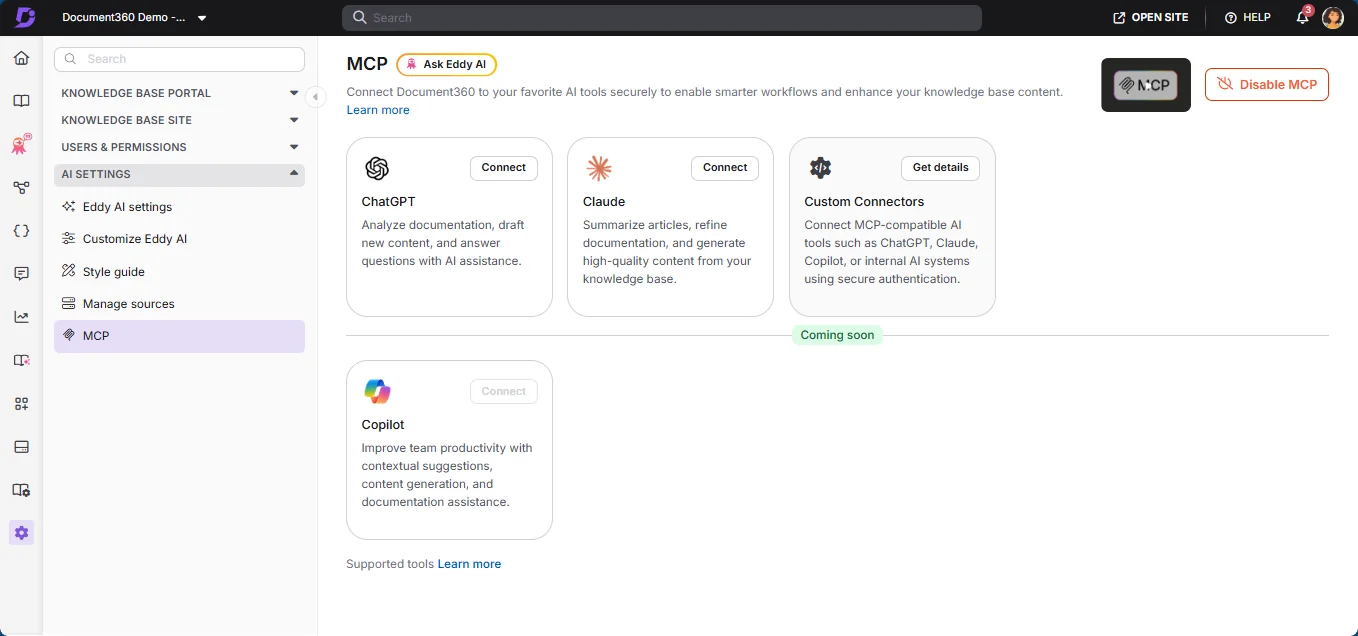
Le serveur MCP de Document360 ne convient pas, tel que documenté. C'est la première idée qui vient, puisqu'il a déjà un outil document360-mcp-search. Mais l'aperçu MCP dit qu'il « utilise OAuth pour l'authentification » et lie chaque connexion au « compte utilisateur qui termine le flux OAuth ». C'est un écran de consentement dans un navigateur, et les connecteurs de Meta ne peuvent pas cliquer dessus.
L'API REST v3 convient. Si MCP est nouveau pour vous, mon explication MCP pour le support client montre pourquoi le modèle d'authentification compte tant. La page des clés d'API de Document360 dit qu'une clé se place dans un en-tête X-API-Key et est « également acceptée en Authorization: Bearer », ce qui correspond au type d'authentification API_KEY de Meta. Le point utile est le périmètre : une clé v3 porte un rôle de portail, un rôle de contenu et un périmètre d'accès au contenu, vous pouvez donc émettre une clé GET seulement qui lit un espace de travail ou quelques catégories et rien d'autre. Les projets créés avant la v3 peuvent encore avoir l'ancien api_token v2, qui fonctionne aussi mais n'a pas de périmètre de contenu.
Un connecteur de base a besoin de deux outils :
- Recherche, avec le point d'accès v3 search workspace articles. C'est une recherche par mots-clés sur les articles publiés et visibles, et
page_sizeplafonne à 100. - Obtenir l'article, pour récupérer le corps complet du meilleur résultat.
Il existe une troisième option plus intéressante : le point d'accès v3 AI search query envoie une question en langage naturel à Eddy et renvoie une réponse générée à partir de vos docs. Branchez-le comme outil et l'agent de Meta demande la réponse à Eddy. Cela fonctionne avec la même clé d'API, mais chaque appel est une requête Eddy, et les requêtes Eddy sont comptées en crédits.
Prévoyez trois pièges dès le départ :
- Limites de débit. La v3 autorise 120 ou 200 lectures par minute selon l'offre, par clé, d'après la page sur les limites de débit. C'est suffisant pour une petite équipe et à vérifier avant une période chargée.
- Taille des réponses. La référence des outils de connecteur de Meta avertit que des réponses trop volumineuses « dégradent la qualité de réponse de l'agent ». Utilisez sa
transformation_specpour réduire les corps d'article au texte. - C'est une consultation, pas une source de connaissances. Meta documente les connecteurs pour des actions et des consultations client comme l'état d'une commande. Elle n'en décrit jamais un comme base de connaissances, donc un outil « rechercher dans Document360 » est à tester rudement, pas une promesse de Meta.
Prévoyez un budget pour les limites sur les deux voies qui touchent à la plomberie de Document360. Un administrateur Document360 sur G2 a signalé exactement les deux sur lesquelles repose cet article :
« Enfin, il y a des contraintes sur l'utilisation des jetons d'API, les limites quotidiennes de taille d'export et d'autres plafonds d'usage. Ces limites peuvent créer des coûts supplémentaires ou des frictions opérationnelles pour les équipes qui gèrent la documentation à grande échelle. »

Le problème de fraîcheur que personne ne montre en démo
La plupart des guides d'installation s'arrêtent dès que le bot répond à sa première question de test. Pour une équipe Document360, le vrai test est ce qui se passe le mardi suivant, quand quelqu'un publie une modification.
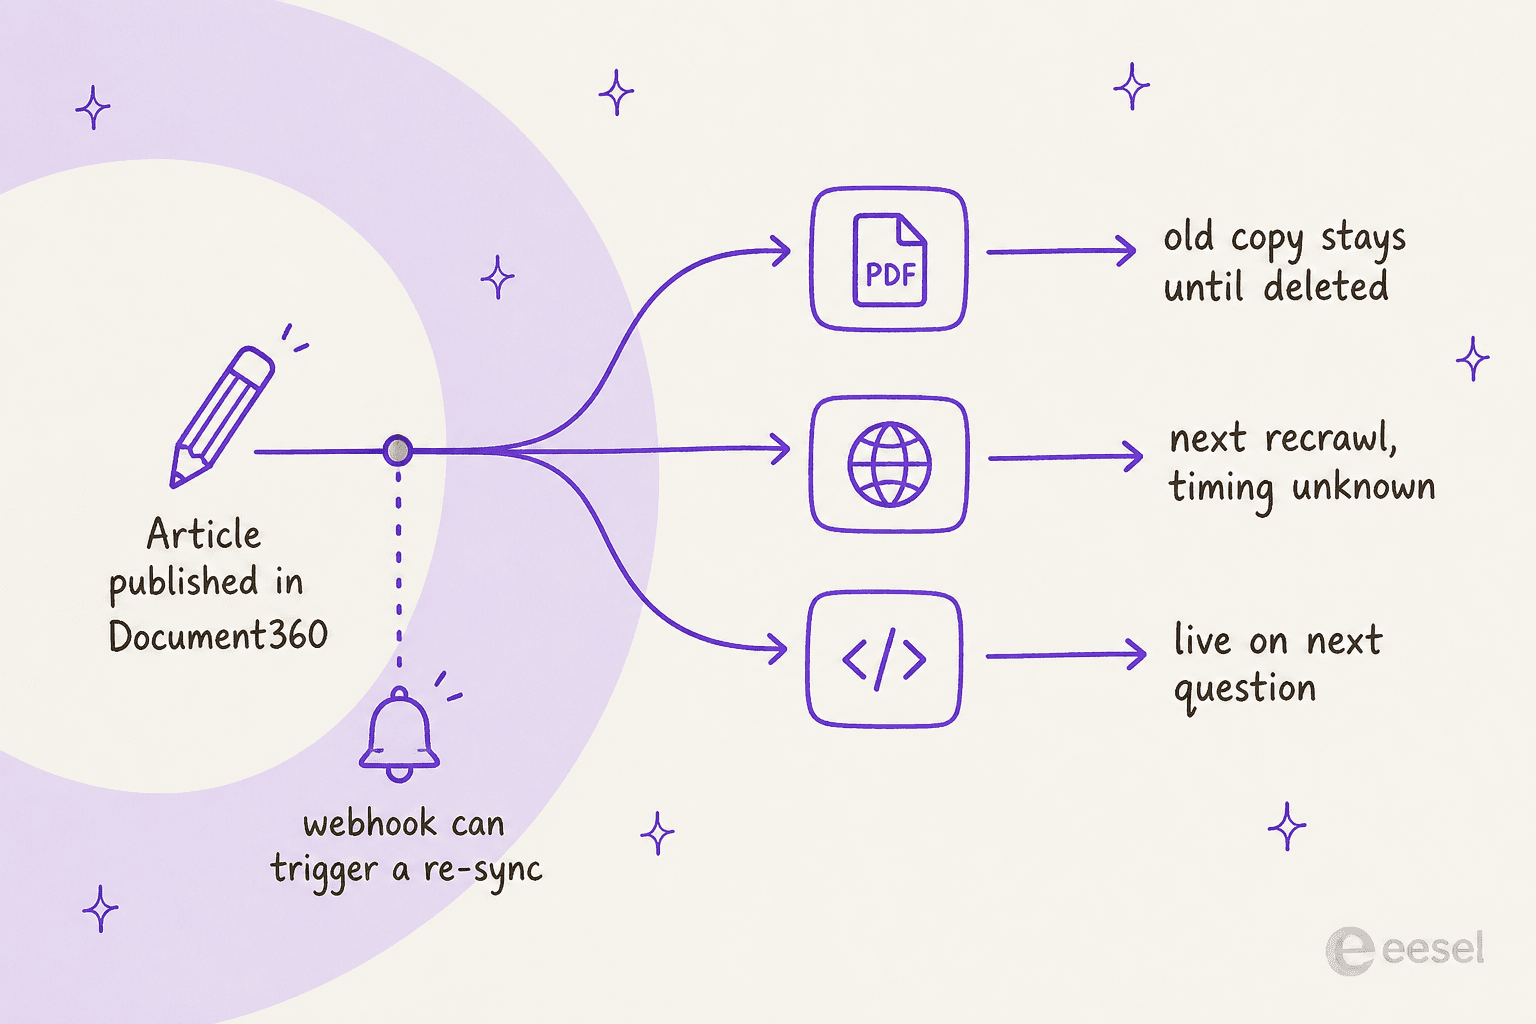
Meta dit que les sites explorés sont « ré-explorés périodiquement » mais ne donne pas d'intervalle, et son guide ajoute que les connaissances du site web sont « un instantané pris au moment de l'exploration ». Les fichiers ne se rafraîchissent jamais. Les FAQ changent quand vous appelez l'API. Seul un connecteur en direct voit une modification tout de suite.
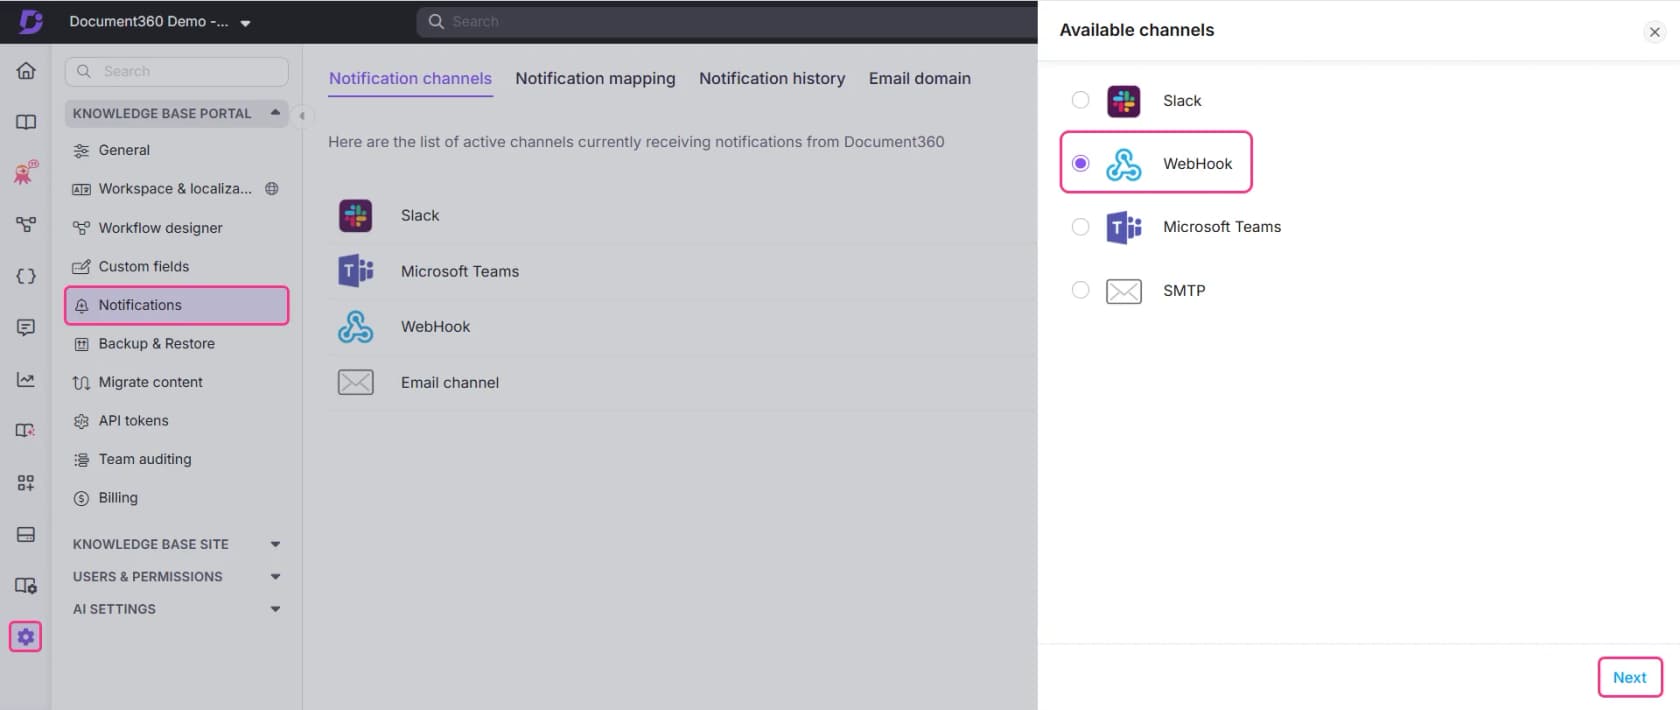
Document360 a une fonction utile ici : les notifications par webhook. Vous pouvez associer des événements comme la publication, la mise à jour et la suppression d'article à une URL de webhook, d'après la documentation du canal webhook, et Document360 cite l'invalidation de cache comme cas d'usage. C'est le déclencheur dont a besoin un script de re-téléversement, et c'est le même schéma que toute automatisation du support WhatsApp : à la publication, exporter l'article, supprimer l'ancien fichier chez Meta, téléverser le nouveau. C'est toujours un script à vous, mais au moins il s'exécute sur un vrai événement et non parce que quelqu'un y a pensé.
L'autre moitié de la fraîcheur, c'est ce que fait le bot quand votre base de connaissances n'a rien sur la question. Meta n'a pas d'interrupteur « répondre uniquement à partir des connaissances ». L'ancrage est une ligne dans vos instructions, et l'exemple de Meta dit : « Réponds aux questions de politique uniquement à partir des politiques documentées, et dis que tu vas vérifier avec un collègue plutôt que de deviner quand la réponse n'y est pas. » Un des premiers testeurs de Business Agent sur Reddit a décrit ce qui se passe sans cela :
« La cohérence est un problème. J'ai vu le même produit revenir à deux prix différents dans deux réponses. Si vous ne l'ancrez pas correctement, il invente simplement. »

J'ai vu la même chose lors de vrais déploiements eesel. Nous avons eu des clients payants dont le bot inventait des réponses à de vrais clients quand la recherche revenait vide, c'est pourquoi une réponse de repli en cas de connaissance manquante et un test sur des tickets historiques sont désormais la norme avant la mise en service de tout bot. Le guide de prévention des hallucinations détaille cette configuration.
Il aide aussi d'écrire des articles que le bot peut exploiter. Des pages courtes sur un seul sujet avec la réponse dans le premier paragraphe sont mieux retrouvées que les longues, et le tutoriel sur l'entraînement sur la base de connaissances montre comment les structurer.
Où se place Eddy AI
Avant de construire tout cela, il est légitime de se demander si l'IA propre à Document360 fait déjà le travail. Eddy répond sur le site de votre base de connaissances, dans le widget KB et via un chatbot autonome que vous intégrez avec une Chatbot Key. Il peut aussi s'entraîner sur des tickets Freshdesk ou Zendesk, comme le détaille le guide Freshdesk et Document360. Il cite les articles utilisés et respecte les permissions d'article pour les lecteurs connectés.
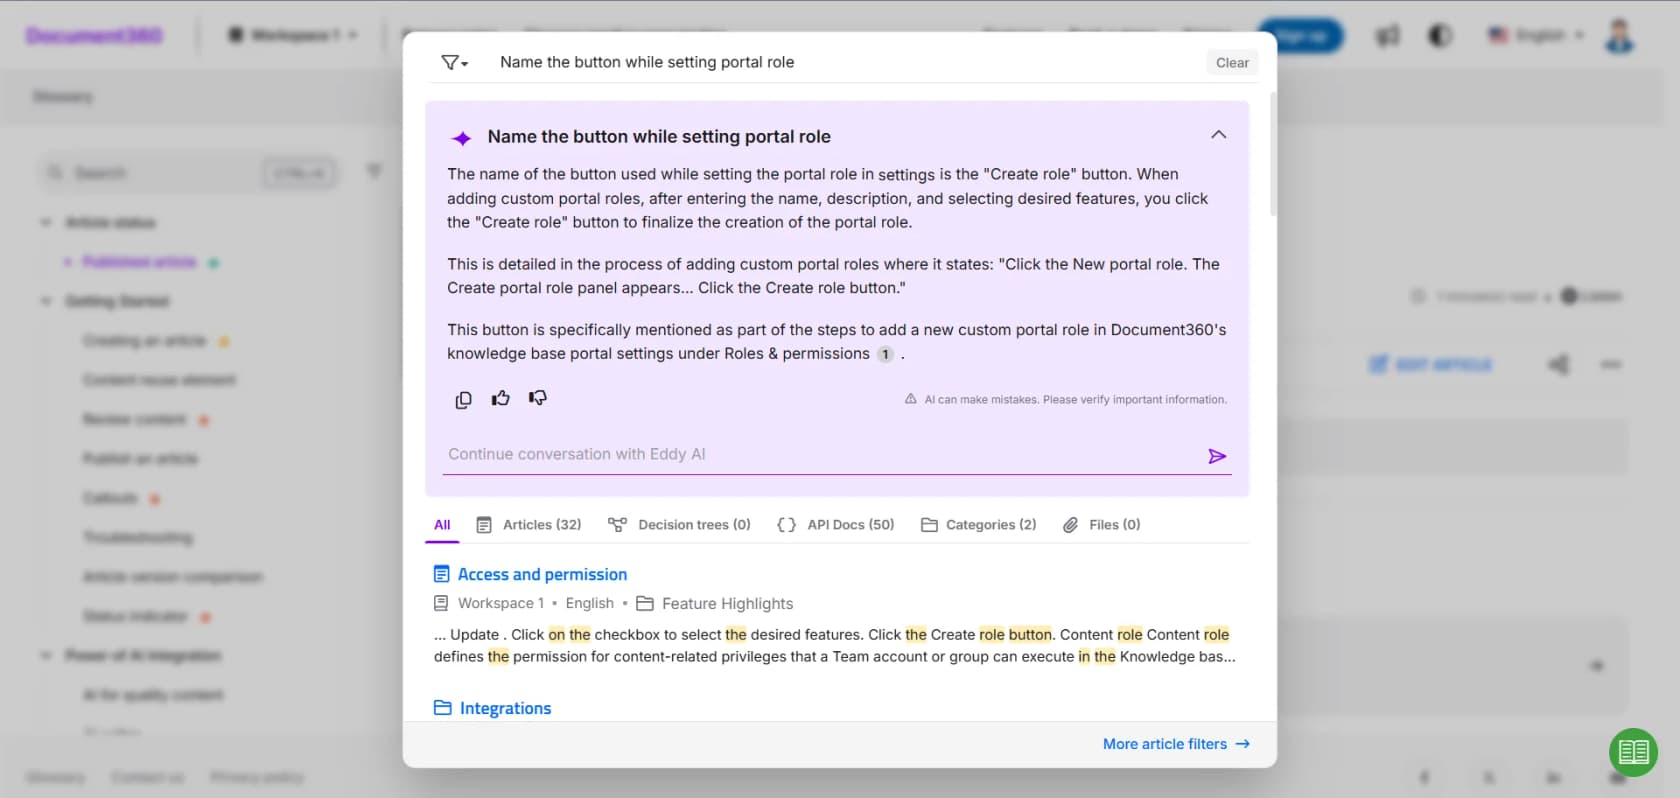
Ce que Document360 ne documente pas, c'est un canal WhatsApp pour Eddy. Le chatbot se déploie sur un site web, un par domaine, et sa seule action de helpdesk est de créer un ticket dans Zendesk ou Freshdesk. Le partage est donc simple :
- Les clients posent leurs questions sur votre site ou centre d'aide : Eddy y est déjà. Mon test de Document360 AI le couvre en détail, et la liste des alternatives à Eddy AI couvre ce qui d'autre répond depuis une KB Document360.
- Les clients posent leurs questions sur WhatsApp : l'agent de Meta possède ce numéro, et Eddy n'aide que si vous branchez son API de recherche IA dans un connecteur.
Si vous voulez plutôt un assistant généraliste sur Document360, les guides ChatGPT pour Document360 et Grok Bot pour Document360 couvrent ces voies, et IA pour Document360 compare l'écriture de docs et la réponse à partir de ceux-ci.
Ce que ça coûte
Il y a deux factures : celle de Meta et celle de Document360.
| Poste de coût | Prix | Source |
|---|---|---|
| Meta Business Agent, WhatsApp Platform | 2,00 $ par million de tokens, environ 16 à 20 centimes pour une conversation simple et 40 à 50 centimes pour une complexe | Tarifs Meta |
| Réponses WhatsApp de votre équipe, à partir du 1er oct. 2026 | Au message aux tarifs utilitaires, après 1 000 gratuits par numéro et par mois | Tarifs Meta |
| Offre Document360 | Sur devis uniquement, tarifée selon les comptes d'équipe, espaces de travail, langues, SSO, modèle de confidentialité et usage de l'AI Premium Suite | Tarifs Document360 |
| Comptes lecteur Document360 | Facturables, projets privés uniquement | Tarifs Document360 |
| Exports PDF (Voie 2) | Un crédit d'export par page PDF, quota mensuel | Documentation Document360 |
| Recherche Eddy AI via API (option de la Voie 4) | Un crédit Eddy par requête, quota fixé dans votre devis | Documentation Document360 |
Le côté Document360 est difficile à chiffrer, chaque offre étant un devis sur mesure. Mon décryptage des tarifs Document360 explique ce qui le fait bouger. Sur les six facteurs, le modèle de confidentialité est celui qui se rattache à cet article : un projet privé nécessite des comptes lecteur payants, et c'est aussi la configuration que Meta ne peut pas explorer.
Côté Meta, surveillez le changement du 1er octobre. La page tarifaire de Meta dit que chaque message est facturé « soit comme message Meta Business Agent soit comme message de service, jamais les deux », donc les réponses de l'IA sont facturées en tokens et tout ce que votre équipe envoie après un transfert l'est en messages de service. Mon explication des tarifs de l'API WhatsApp donne tout l'historique.
Où l'agent de Meta s'arrête pour une équipe Document360
L'agent de Meta est un choix raisonnable pour certaines équipes. Voici où il s'arrête :
- Une IA par numéro. L'aperçu de la plateforme de Meta dit qu'« une intégration active d'agent autorisé bloque Meta Business Agent ». Vous choisissez un bot par numéro WhatsApp.
- Surfaces Meta uniquement. Il répond sur WhatsApp, Messenger, Instagram et un plugin de site lié pour l'instant à Shopify. Ma liste de chatbots WhatsApp compare des outils qui répondent au-delà des apps de Meta. L'e-mail et les files de helpdesk sont hors périmètre, et c'est là que finissent la plupart des lecteurs Document360 quand le libre-service échoue.
- Pas de réglage de citations. Rien dans la documentation de Meta ne fait citer par l'agent l'article utilisé. Eddy le fait, comme la plupart des chatbots de base de connaissances.
- Le transfert déplace la boîte de réception. Une fois que Business Agent prend le numéro, votre boîte WhatsApp existante passe en veille. La version Zendesk de cet article couvre le Conversation Routing de Meta, et le guide sur le transfert d'agent IA explique à quoi ressemble un bon transfert.
- La doc d'API n'est pas une réponse de support. Beaucoup de sites Document360 mêlent articles d'aide et référence d'API. Gardez la référence hors de l'exploration, sinon le bot répondra à une question de facturation par la description d'un point d'accès.
Quelle configuration convient à votre équipe Document360
Voici comment je choisirais :
| Votre situation | Voie que j'utiliserais |
|---|---|
| Centre d'aide Document360 public, WhatsApp uniquement | Exploration ciblée des catégories d'aide |
| Moins de 100 réponses clés qui doivent être exactes | Entrées de FAQ du générateur de FAQ IA, plus une exploration pour le reste |
| Projet privé, contenu qui change chaque mois | Téléversement PDF par catégorie, avec un script déclenché par webhook qui supprime d'abord l'ancien fichier |
| Projet privé, changements hebdomadaires, un ingénieur disponible | Connecteur HTTP avec une clé d'API v3 en lecture seule et limitée par catégorie |
| Vous payez déjà des crédits Eddy | Connecteur qui appelle l'API de recherche IA d'Eddy, en surveillant la consommation de crédits |
| Vous répondez aussi dans un helpdesk ou un chat de site | Une IA sur tous les canaux, et décider quel bot possède WhatsApp |
Vous comparez encore des outils plutôt que des voies ? Mon comparatif meilleure IA pour le support WhatsApp et la liste des meilleurs outils d'IA pour base de connaissances l'abordent par chaque bout, et les alternatives à Document360 couvrent le changement de la KB elle-même.
Si vous êtes tenté de construire le connecteur vous-même, l'article construire ou acheter mérite dix minutes avant.
Essayer eesel avec Document360
Chaque voie ci-dessus se termine par quelqu'un de votre équipe qui maintient à jour la copie de Meta de votre base de connaissances. eesel saute cette étape. C'est un coéquipier helpdesk IA qui lit votre site Document360 comme une source de connaissances web : vous lui donnez l'URL du centre d'aide, il explore jusqu'à 2 000 pages via votre sitemap et vos liens, et chaque réponse cite l'article dont elle vient. Des chemins d'inclusion et d'exclusion gardent votre référence d'API dehors, et des en-têtes personnalisés (Cookie, Basic ou Bearer) existent pour les sites derrière une connexion, ce qui vaut d'être testé sur un projet privé.
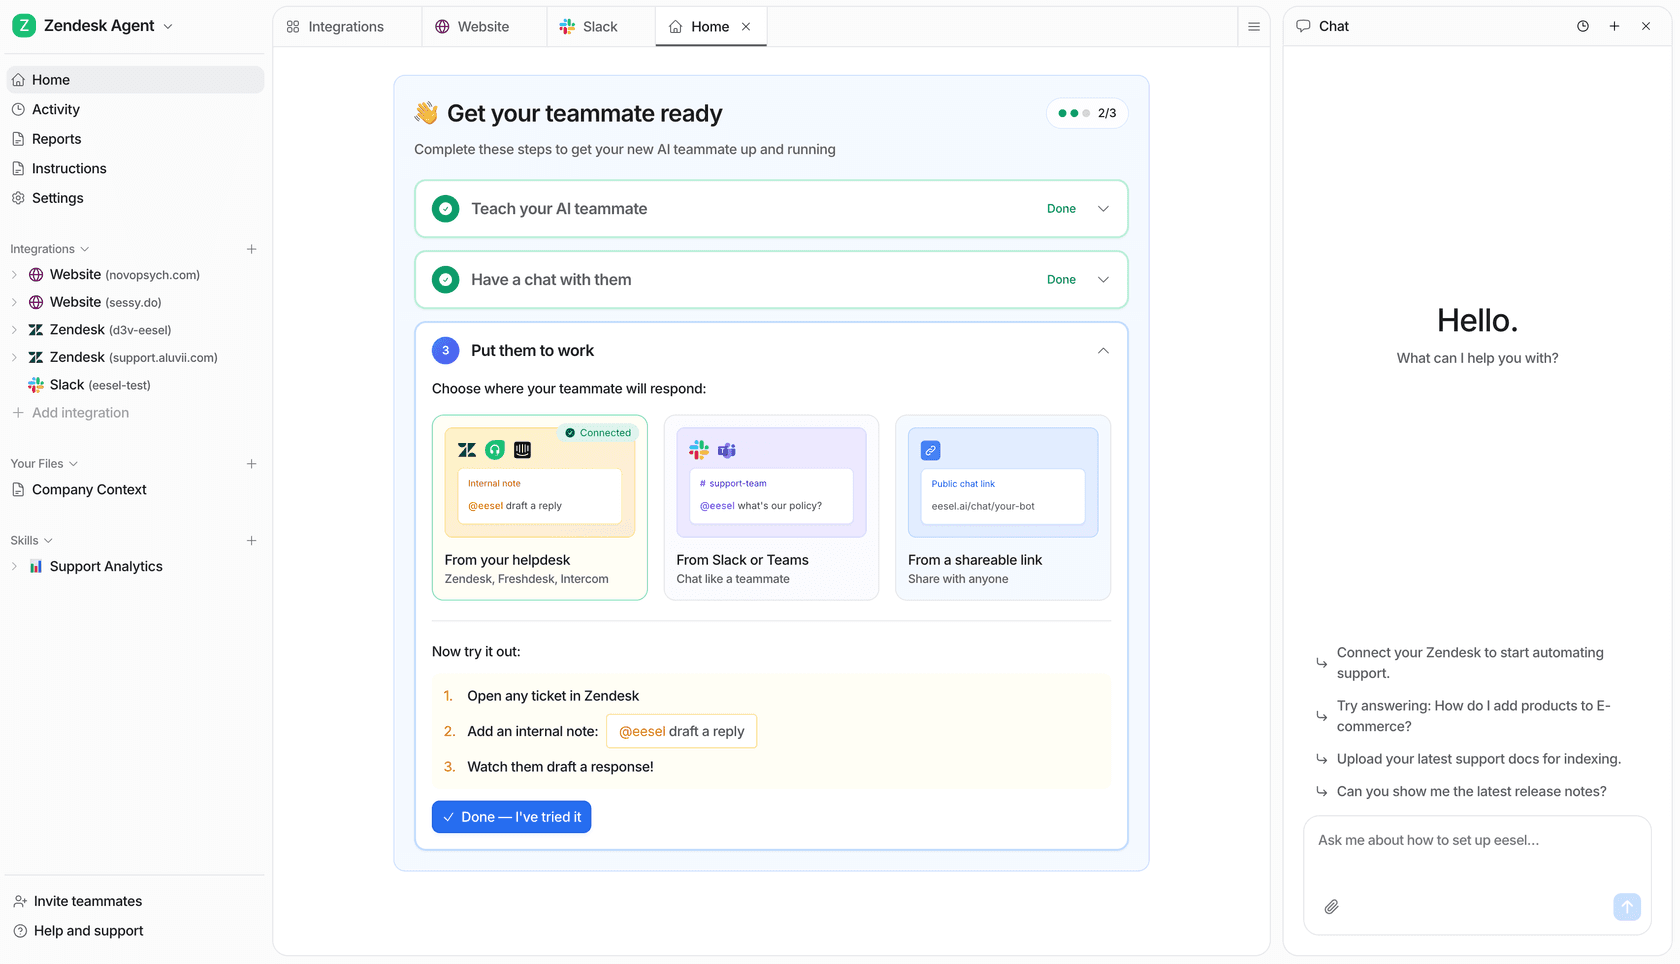
Il n'y a pas de connecteur Document360 natif, je ne ferai donc pas semblant du contraire. Ce qu'eesel ajoute à l'exploration, c'est tout le reste dont une réponse de support a besoin : vos anciens tickets, macros et helpdesk, mis en commun avec les articles Document360, et une simulation sur vos tickets historiques avant que le bot ne réponde à un vrai client. Si vous travaillez depuis un terminal, la CLI eesel exécute la même configuration en commandes : eesel integrations connect website ajoute le site Document360 et eesel status affiche le nombre de pages, si bien que Claude Code ou Cursor peuvent le faire pour vous.
Si WhatsApp est le canal qu'il vous faut, regardez l'intégration WhatsApp d'eesel et gardez à l'esprit la règle d'une IA par numéro de Meta dans votre choix. L'offre gratuite inclut 100 crédits sans carte, et les offres payantes démarrent à 299 $ pour 500 tickets ou chats par mois. Essayez eesel sur votre centre d'aide Document360 et voyez comment il répond.
Questions fréquentes
Qu'est-ce que Meta Muse pour Document360 ?
Meta Business Agent peut-il lire une base de connaissances Document360 privée ?
Le serveur MCP de Document360 fonctionne-t-il avec l'agent WhatsApp de Meta ?
Que se passe-t-il quand je mets à jour un article Document360 que l'agent de Meta utilise déjà ?
Combien coûte Meta Muse pour Document360 ?
Dois-je utiliser Eddy AI ou Meta Business Agent pour le support WhatsApp ?
Existe-t-il une meilleure IA pour répondre aux clients WhatsApp depuis Document360 ?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.