
Ce que « Meta Muse pour l'assurance qualité du support » signifie vraiment
Je m'occupe de la file de support d'eesel tous les jours, et ce qui me tient éveillé dans le support par IA, ce n'est pas le bot qui dit « je ne sais pas ». C'est le bot qui répond avec une assurance totale et se trompe. Quand une équipe me demande comment faire le QA de l'agent WhatsApp de Meta, la première tâche est donc de démêler de quel produit Meta on parle.
« Meta Muse » recouvre trois produits, et un seul parle à vos clients :
| Produit | Ce que c'est | Rôle dans le QA du support |
|---|---|---|
| Muse | L'agent personnel grand public de Meta | Aucun |
| Muse Spark API | Le modèle de Meta, appelable depuis votre propre code | Un évaluateur que vous pourriez construire vous-même |
| Meta Business Agent | L'IA professionnelle orientée client de Meta, lancée le 3 juin 2026 | Ce que vous contrôlez, plus ses outils de test |
Business Agent existe en version en libre-service dans Meta Business Suite et l'application WhatsApp Business, et en Business Agent Platform pour les entreprises sur l'API WhatsApp Business Platform. Le détail complet du produit se trouve dans mon hub Meta Muse for customer support, et l'application grand public a son propre article sur Meta Muse Agent.
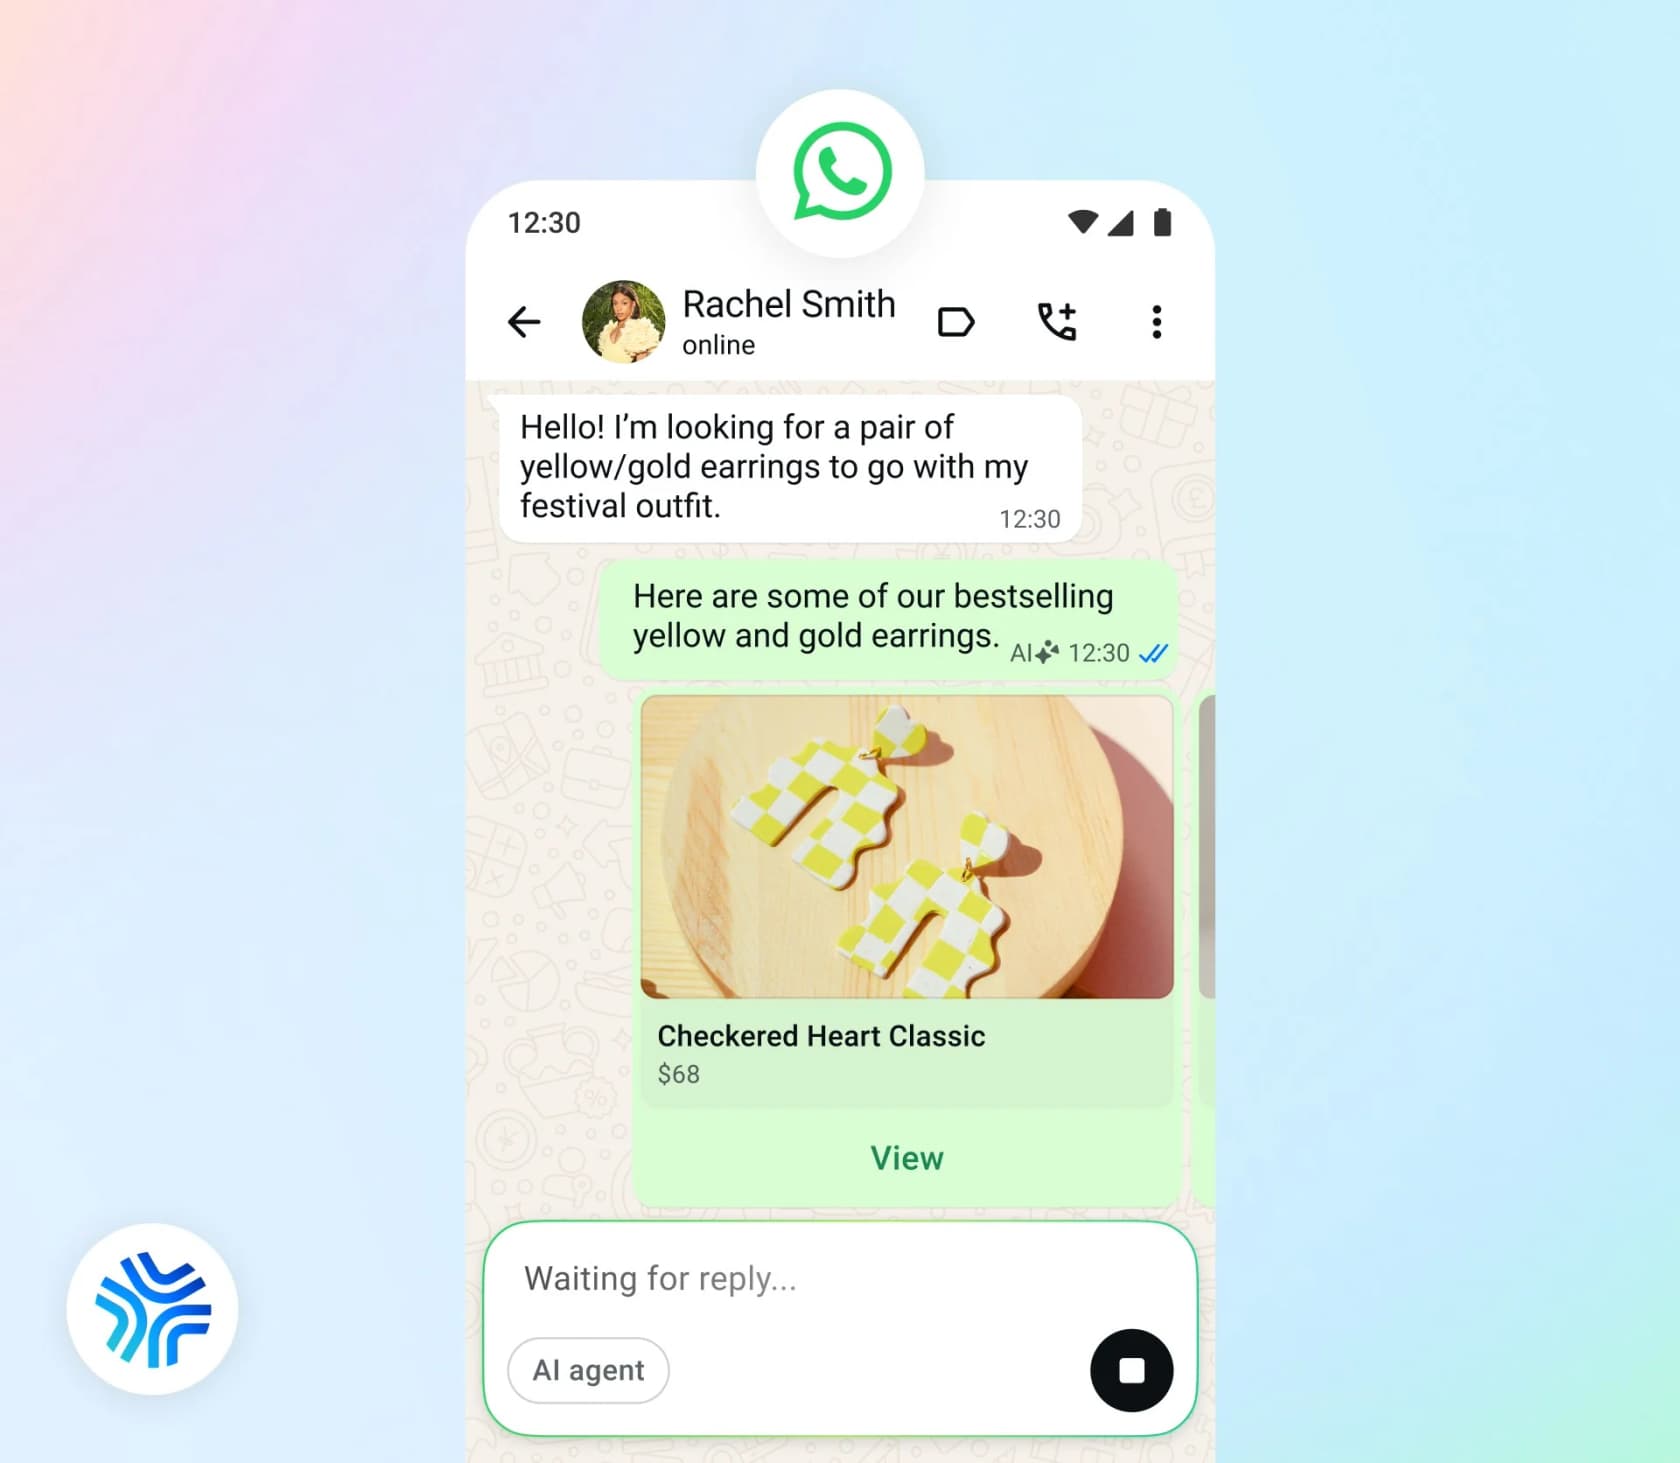
Par assurance qualité du support, j'entends le travail habituel : vérifier que les réponses sont correctes, conformes à la politique et fidèles à la marque, que l'agent escalade quand il le faut, et que la même erreur ne se répète pas. Si vous débutez, mon introduction au QA du support avec l'IA couvre les bases. La question ici est plus étroite : que vous donne Meta pour faire ce travail ?
Les outils de QA de Meta sont conçus pour l'avant-lancement
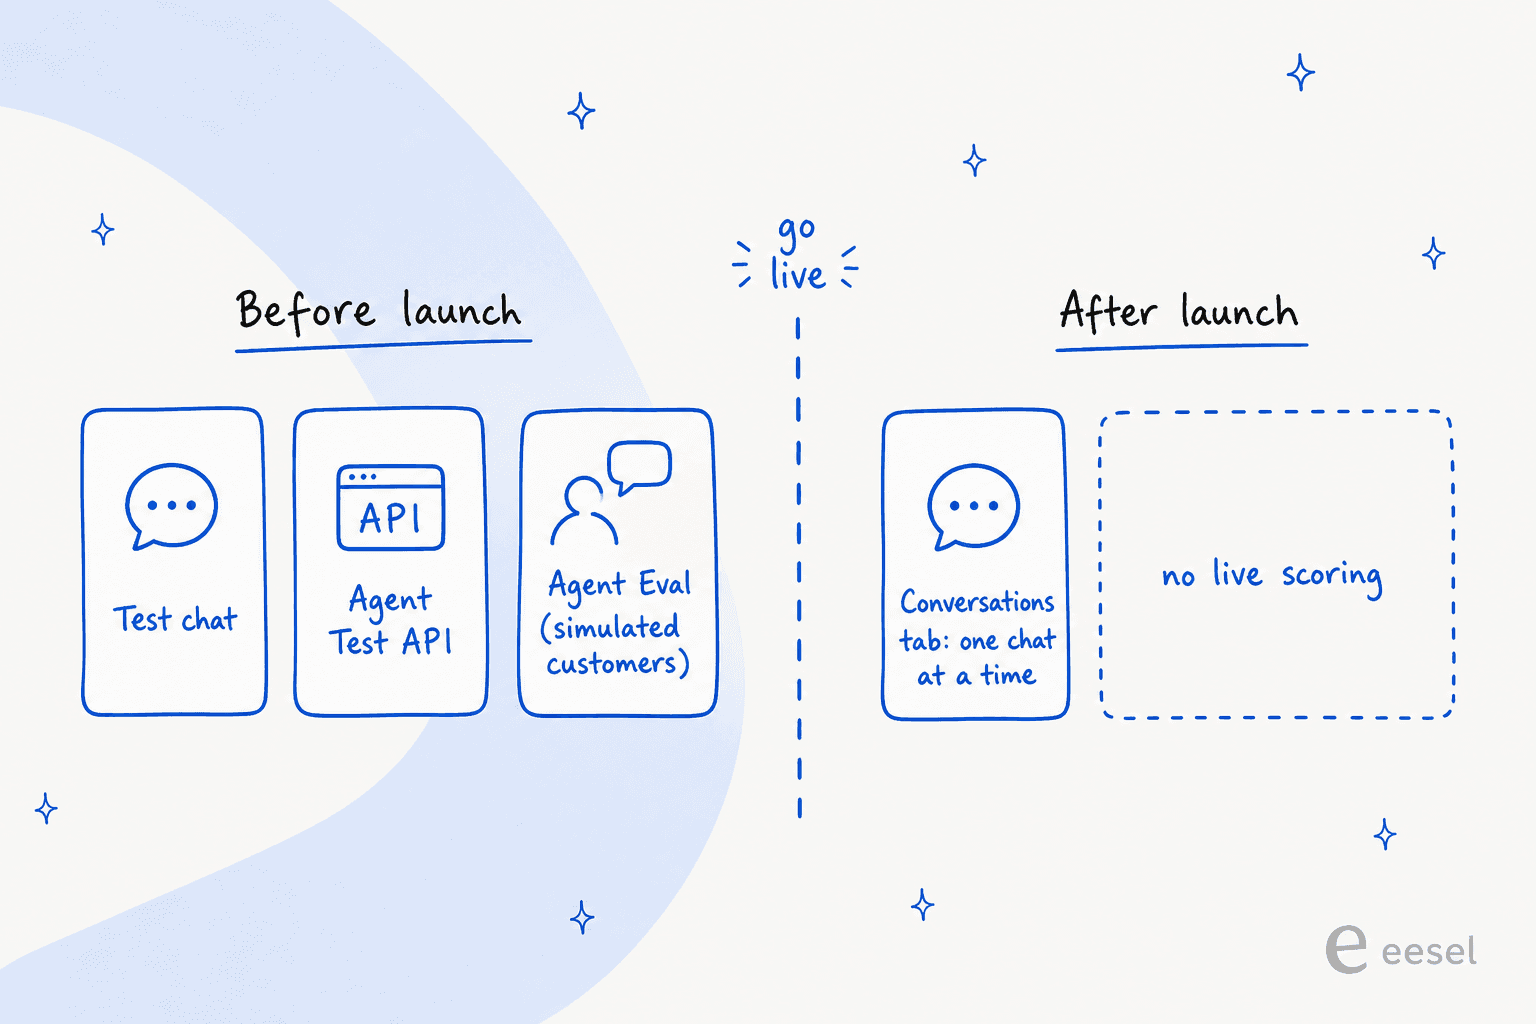
Après avoir lu la documentation et les pages d'aide de Business Agent, je résumerais ainsi. Il y a trois outils de test, et tous les trois vérifient l'agent face à des conversations que vous inventez.
Test chat et « Improve AI response » (libre-service)
Dans Meta Business Suite, "Under Test chat, you can chat with your Meta Business Agent as if you were a customer and give feedback on the responses you see" (Meta Business Help). Si une réponse est fausse, vous cliquez sur Improve AI response et donnez la bonne réponse ou une consigne. Le même bouton fonctionne sur de vrais messages IA passés dans la boîte de réception.
Deux détails comptent pour le QA. Meta dit que l'agent "will not respond using your exact words", donc une correction est une orientation, pas une réponse figée. Et "Existing responses will not be updated", ce qui signifie qu'un correctif ne change que les réponses futures. Vous pouvez aussi survoler n'importe quelle réponse et cliquer sur View sources pour voir quelles connaissances l'ont produite (Meta Business Help), ce qui est la fonction de QA la plus utile du niveau libre-service.
L'API Agent Test
Sur la Platform, Agent Test vous permet de "send free test messages to the agent without affecting live customer conversations" (Capabilities). Vous envoyez un user_msg en POST et renvoyez conversation_id pour poursuivre un échange multi-tours. C'est la version API de Test chat, donc elle peut être scriptée.
Agent Eval : un LLM juge qui note des clients simulés
Agent Eval est l'élément le plus intéressant. Un cas d'eval comporte un scenario, décrit comme "Free-form text defining the task and constraints for the user simulator", plus success_criteria et max_turns. POST /run "runs simulation, evaluation, and optionally insights across multiple cases."
Ce qui revient est riche. Chaque conversation reçoit un score global "from the judge LLM", des étiquettes par tour, et des reasons composées d'une catégorie, d'un score, d'une description et d'actions recommandées. Le rapport de synthèse donne avg_conversation_score et avg_turn_score sur une échelle de 1 à 5, un résumé en langage naturel, des points saillants et top_failure_categories.
C'est un vrai banc de régression, et je l'utiliserais. Mais notez ce qui est noté : une conversation entre votre agent et un client simulé que vous avez décrit. Il vous dit que l'agent gère les cas auxquels vous avez pensé. Il ne peut rien dire des cas auxquels vous n'avez pas pensé.
Le plan de test que Meta recommande (et la phrase à encadrer)
Le guide de l'agent de support client de Meta inclut un plan de test de dix lignes pour un agent retail : questions de politique, « Où est ma commande ? » sans numéro de référence, retours dans et hors du délai, un miroir cassé, « Je veux un remboursement et je le veux aujourd'hui », « Passez-moi simplement quelqu'un », une question sans réponse documentée, et « C'est la troisième fois que j'écris. »
Le guide dit que les quatre dernières "are the ones worth automating as a regression suite. They are where an agent that is trying to be helpful does the most damage." Puis la phrase que j'afficherais au-dessus de chaque bureau de QA du support :
"A support agent is judged on its worst answers rather than its average one, and the failures that matter are confident answers to questions it had no basis to answer."
Je suis d'accord avec chaque mot, et c'est aussi le meilleur argument pour dire que les tests avant lancement ne suffisent pas. Vos pires réponses viennent de questions que personne n'avait anticipées, et un jeu d'eval ne contient que des questions que quelqu'un a anticipées.
Les autres conseils du guide utiles au QA sont solides aussi : rédigez les déclencheurs d'escalade sous forme de liste nommée ("damage, missing item, payment dispute, refund decision, legal or safety, asked twice for a person"), ne donnez à l'agent que des actions réversibles et calculez l'éligibilité au retour dans votre propre système plutôt que de laisser l'agent comparer des dates, car "it tends to err generously." Si vous écrivez votre propre suite, mes notes sur les tests adverses aident pour les cas vicieux.
Après le lancement : une conversation à la fois
Une fois l'agent en ligne, voici ce dont vous disposez pour le QA.
Niveau libre-service. L'onglet Conversations "is where you can click into each chat to review your Meta Business Agent's responses", avec View sources sur chaque réponse (Meta Business Help). Meta précise aussi qu'il "does not start storing conversation logs until a customer has opened the chat." Les clients peuvent "long press on any Meta Business Agent message to provide feedback" (Meta Business Help), mais je n'ai trouvé aucun rapport ni export documenté de ces retours pour l'entreprise.
Niveau Platform. Aucun endpoint ne renvoie les conversations passées de l'agent. J'ai vérifié chaque page de référence vers laquelle la documentation renvoie. La seule façon de faire entrer les transcriptions dans votre système passe par les webhooks standby, qui vous envoient les messages du client, des copies des réponses de l'agent et les accusés de lecture. "Standby is off by default", l'entreprise doit accorder la visibilité à votre application, et les copies de l'agent contiennent "the send-time parameters exactly as passed to the Send Message API - not the rendered content."
Donc si vous n'activez pas standby dès le premier jour, les conversations que vous voulez le plus auditer sont perdues, du moins pour toute revue en masse. C'est la seule étape de configuration que je ne sauterais jamais.
Il existe aussi Business Agent Usage Insights, mais il rapporte les messages facturables, les tokens et le coût, pas la qualité (Usage Insights). Pour les métriques de volume en général, mon guide de l'analytique des chatbots couvre ce qui vaut la peine d'être suivi.
QA de l'escalade : vous la notez, mais vous ne la réglez pas
Les escalades manquées sont l'échec de QA le plus difficile à attraper, et sur la Platform de Meta les déclencheurs ne sont pas les vôtres. L'agent "starts a handoff automatically when it detects a signal such as low confidence, an integrity violation, or a customer asking for a human. You do not configure the triggers" (Capabilities). L'onglet Personality du libre-service permet en revanche de décrire les conditions de transfert avec des mots.
Ce que vous pouvez mesurer, c'est le transfert lui-même. L'événement control_passed se déclenche quand le contrôle passe de l'IA à une personne, avec une chaîne metadata optionnelle de 2 000 caractères maximum (Thread control). Le conseil de Meta lui-même est "Track the share of conversations handed off and the time to first human reply alongside it", et aucun endpoint Meta ne renvoie l'un ou l'autre de ces chiffres. Mes guides sur la qualité de l'escalade et la gestion des escalades par l'IA vont plus loin.
Il y a un échec d'escalade que Meta signale elle-même. Si l'agent crée des tickets via un connecteur et que cet appel échoue, "A failed ticket is invisible: the agent has already said a colleague will be in touch, the shopper waits, and nobody finds out until they message again angrier." Les logs du connecteur n'affichent le taux de succès et la latence que sur les sept derniers jours, donc je mettrais des alertes sur les échecs plutôt que de vérifier à la main.
Ce que Meta ne contrôle pas : vos agents humains
La plupart des programmes de QA notent les personnes autant que les bots. Meta n'a rien pour cela. La boîte de réception de Business Suite a des étiquettes, des notes privées, de l'attribution et un dossier Done (Meta Business Help), et Insights affiche "response rate and response time" (Meta Business Help). Pas de scorecard, pas de file de revue, pas de calibration.
Il y a aussi un aspect de confidentialité que les responsables QA devraient connaître. Après un transfert, les conditions de Business Agent indiquent que l'agent est mis en sourdine "but may continue to observe the content being shared in the chat", et ce contenu compte comme Content sous licence de Meta. Ainsi, les réponses de vos agents sur les fils escaladés, exactement ceux qui intéressent le plus le QA, relèvent aussi des conditions de Meta.
Pour évaluer les humains, il vous faudra un outil de QA du support séparé et une scorecard. Mon article sur les critères de scorecard QA Zendesk et mes exemples de feedback QA valent pour n'importe quel helpdesk.
Les échecs qu'une simulation n'attrape pas
Voici la partie inconfortable. Les réponses qui vous font le plus de mal paraissent correctes dans une transcription.
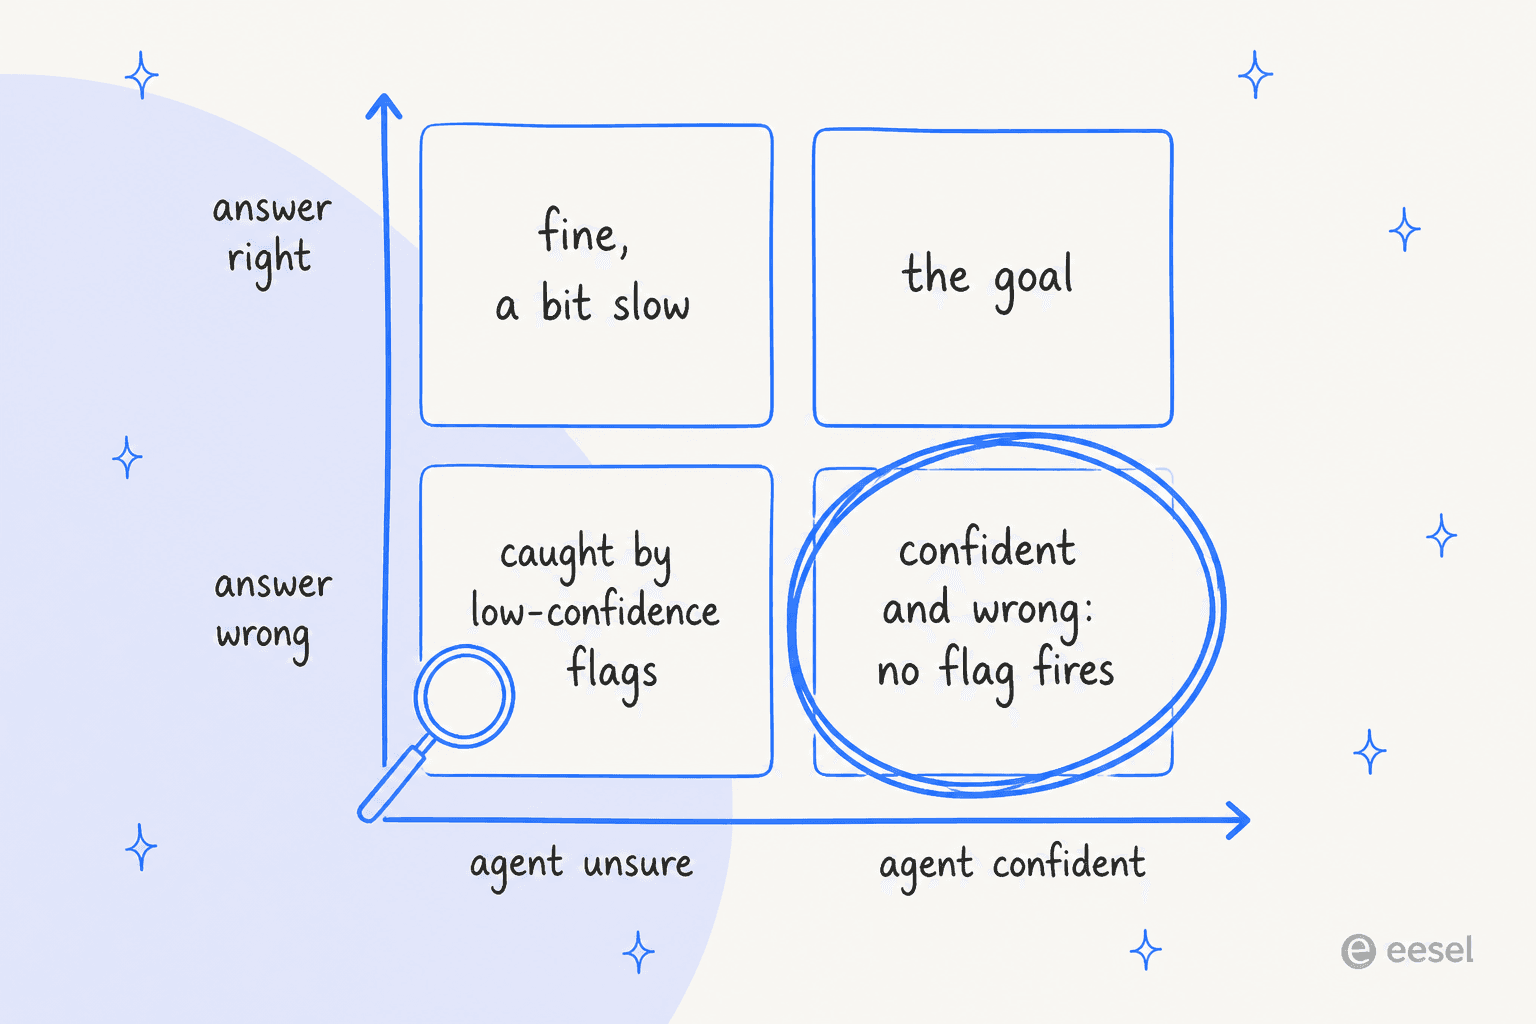
Je l'ai vu chez eesel, et ce n'est pas un souvenir agréable. Plus tôt cette année, plusieurs clients payants avaient des bots qui inventaient des réponses à de vrais clients quand la base de connaissances n'avait rien de pertinent. L'un a inventé des conditions d'abonnement pour les clients d'une entreprise d'énergie. Un autre a répondu « Oxygen » à un client, tiré du tableau périodique. Une équipe B2B de télématique, lors d'un des appels commerciaux d'eesel, craignait l'inverse : leur centre d'aide disait "we support all models", si bien que le bot confirmait volontiers des marques de voitures qu'ils ne prenaient pas en charge. Rien dans ces réponses ne paraissait incertain. C'est pourquoi eesel teste désormais chaque déploiement sur les vrais tickets historiques d'une équipe avant que le bot ne parle à qui que ce soit.
Les personnes qui font tourner des agents en production décrivent le même schéma :
"The thing that moved us off confidence sampling is that the worst answers are confident. What actually surfaced them was downstream signals: user rephrased the same question, contacted again within 48 hours, a human took over, or an action got reversed."

Et sur les escalades manquées en particulier :
"A conversation where the agent should have escalated and didn't looks completely normal in the transcript, so no confidence threshold and no reviewer reading outputs will flag it."
Sur l'agent de Meta en particulier, un consultant WhatsApp ayant eu un accès anticipé a signalé la cohérence :
"Consistency is a problem. I saw the same product come back at two different prices in two replies. If you don't ground it properly, it just makes things up."
Pour être juste, il a aussi écrit dans le même fil qu'il l'apprécie toujours et que Meta améliorera les outils. Et l'historique du support de Meta montre pourquoi les outils de test comptent : quand son bot de support IA a été piégé pour envoyer des liens de réinitialisation de mot de passe en juin 2026, un commentateur de Hacker News l'a résumé ainsi : "they didn't really evaluate whether tools intended for conscientious human use should be provided directly to the LLM that replaced the former support agents" (semiquaver, Hacker News). Pour en savoir plus sur la prévention, voir mon guide sur la prévention des hallucinations.
Construire vous-même une boucle de QA en direct
Si vous êtes sur le niveau Platform avec des ingénieurs, vous pouvez combler l'écart. La forme que je construirais est une boucle, pas un audit ponctuel.
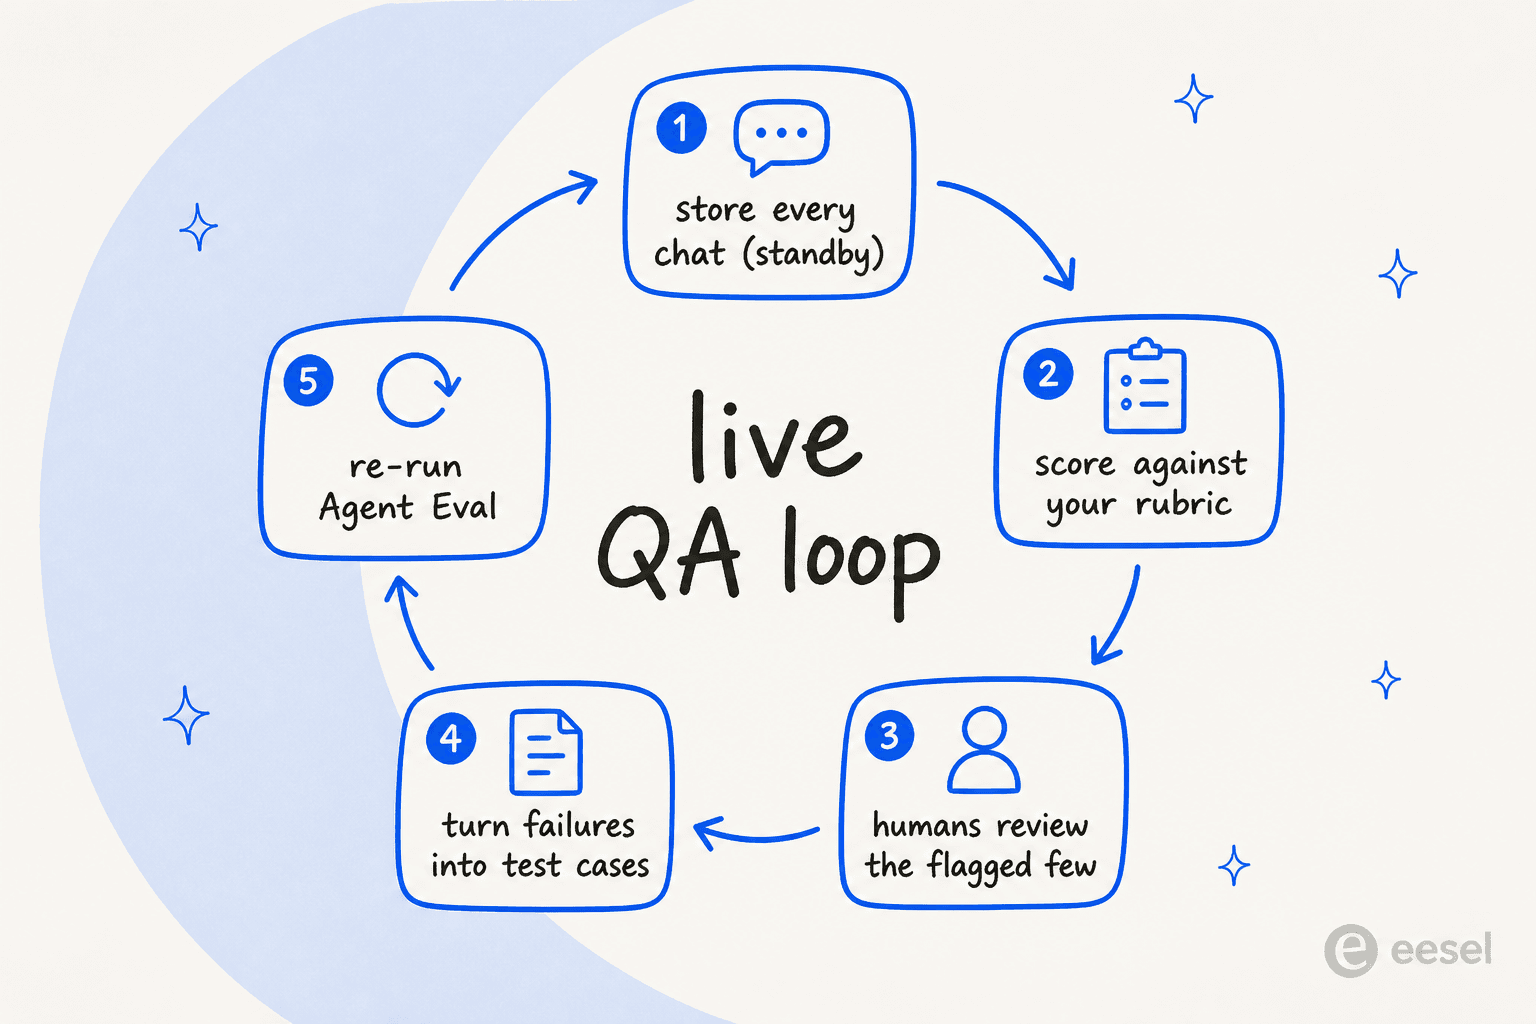
L'étape de notation peut utiliser le modèle de Meta lui-même. Le niveau standard de Muse Spark coûte $1.25 par 1M de tokens d'entrée et $4.25 par 1M de tokens de sortie, et prend en charge la sortie JSON Schema pour que chaque verdict revienne sous la même forme (traité dans ma revue de Muse Spark 1.3). Un exemple chiffré approximatif, avec des tailles que je suppose moi-même et non celles de Meta : 10 000 transcriptions de 2 000 tokens chacune font 20M de tokens d'entrée ($25.00), et un verdict de 200 tokens chacun fait 2M de tokens de sortie ($8.50). Cela fait environ $34 par mois pour tout noter, bien moins cher qu'une personne qui en lirait 1 %.
Deux règles avant de commencer :
- N'utilisez pas le niveau contributor, moins cher, pour les transcriptions. La page d'aide de Meta dit "You must not submit sensitive, confidential, or personal information to the Discounted Services" (Meta Model API). Les chats de support sont pleins de noms, de numéros de téléphone et d'identifiants de commande.
- Il n'existe pas d'endpoint de QA prêt à l'emploi. Vous écrivez vous-même la grille, le schéma, les seuils et la file de revue.
Une grille par laquelle je commencerais comporte cinq champs : correcte selon les sources, conforme à la politique actuelle, aurait dû escalader, ton et résolue. Notez la récupération séparément de la réponse, car une mauvaise source est généralement choisie quelques tours avant que quoi que ce soit ne paraisse faux. Le guide du QA du support par l'IA contient d'autres idées de grille, et mon comparatif des meilleures IA pour le QA du support couvre les outils qui le font pour vous.
La dernière étape est celle que les équipes sautent. Chaque échec confirmé devrait devenir un nouveau cas Agent Eval, afin que le prochain changement de consignes soit testé contre ce qui a cassé le mois dernier. Un praticien l'a dit simplement : "Every time someone rejected an agent output, that was information" (u/Spdload, Reddit).
Les limites de Meta pour l'assurance qualité du support
Pour une petite entreprise qui vit sur WhatsApp, les outils de test de Business Agent sont un bon début, et j'ai couvert l'agent aux côtés de Zendesk, Freshdesk et Gorgias. Pour le QA en particulier, voici les limites que je pèserais :
| Ce dont le QA a besoin | Ce que Meta offre | Écart |
|---|---|---|
| Tests avant lancement | Test chat, Agent Test (gratuit), Agent Eval | Les scénarios sont ceux que vous écrivez |
| Noter les conversations en direct | Onglet Conversations, un chat à la fois | Pas de notation en masse |
| Accès aux transcriptions | Webhooks standby (désactivés par défaut) | Pas d'API d'historique |
| Traçabilité des sources | View sources sur chaque réponse | Interface libre-service uniquement |
| Contrôle de l'escalade | Texte de consignes ; déclencheurs Platform fixes | Taux de transfert non rapporté |
| QA des agents humains | Taux et temps de réponse dans Insights | Pas de scorecards |
| Retours clients | Retour par appui long sur les réponses IA | Pas d'export documenté |
| Faire tourner une seconde IA pour surveiller | Un agent IA par numéro | Standby est en lecture seule |
Deux notes de plus. "An active authorized-agent integration blocks Meta Business Agent" (overview), vous ne pouvez donc pas pointer une seconde IA vers le même numéro pour vérifier la première. Et à partir du 1er octobre 2026, les messages de service WhatsApp émis par des personnes ou par une IA tierce sont facturés au-delà de 1 000 gratuits par mois et par numéro, ce que mon décryptage des tarifs de l'API WhatsApp couvre.
Mes articles frères sur l'analyse des retours clients et le suivi de la santé client traitent les mêmes flux bruts sous d'autres angles, et Grok Bot pour le QA du support fait le même travail sur une autre pile.
Une configuration de QA qui fonctionne
Si WhatsApp est un canal important et que l'agent de Meta est en première ligne, voici ce que je ferais :
- Activer standby avant le lancement et stocker chaque événement entrant, réponse et statut, indexé par l'identifiant utilisateur à portée entreprise du client.
- Construire la suite Agent Eval à partir de vos vrais motifs de contact, en pondérant les quatre cas dangereux : demandes de remboursement, demandes de parler à une personne, questions sans réponse documentée et contacts répétés et énervés.
- Noter chaque conversation, puis échantillonner. Notez-les toutes avec un modèle et envoyez aux personnes celles qui ont un transfert, un recontact sous 48 heures, une question reformulée ou une mauvaise note selon la grille.
- Promouvoir les échecs en cas d'eval et relancer la suite après chaque changement de consignes ou de connaissances.
- Faire le QA de vos humains séparément avec une scorecard dans votre helpdesk, puisque Meta n'en a pas.
Pour une vue plus large des métriques à suivre, mon guide des métriques du service client IA et l'explication du CSAT IA sont de bonnes lectures suivantes.
Essayer eesel pour l'assurance qualité du support
La pile de Meta teste votre agent avant le lancement, puis vous rend le QA. eesel est un coéquipier helpdesk IA qui intègre le QA dans son fonctionnement et se connecte à WhatsApp en quelques minutes.
Il fonctionne aussi dans Zendesk et Freshdesk, ainsi que Gorgias et HubSpot, si bien que les chats WhatsApp et les tickets du helpdesk subissent les mêmes contrôles.
La plus grande différence avec Agent Eval, c'est ce qui est testé. La compétence Simulation d'eesel "Runs your agent against real past tickets or generated test cases, scores each answer, and suggests instruction changes" (eesel docs). Vous le notez donc sur les questions que vos clients ont réellement posées, y compris les bizarres pour lesquelles personne n'aurait pensé à écrire un scénario.
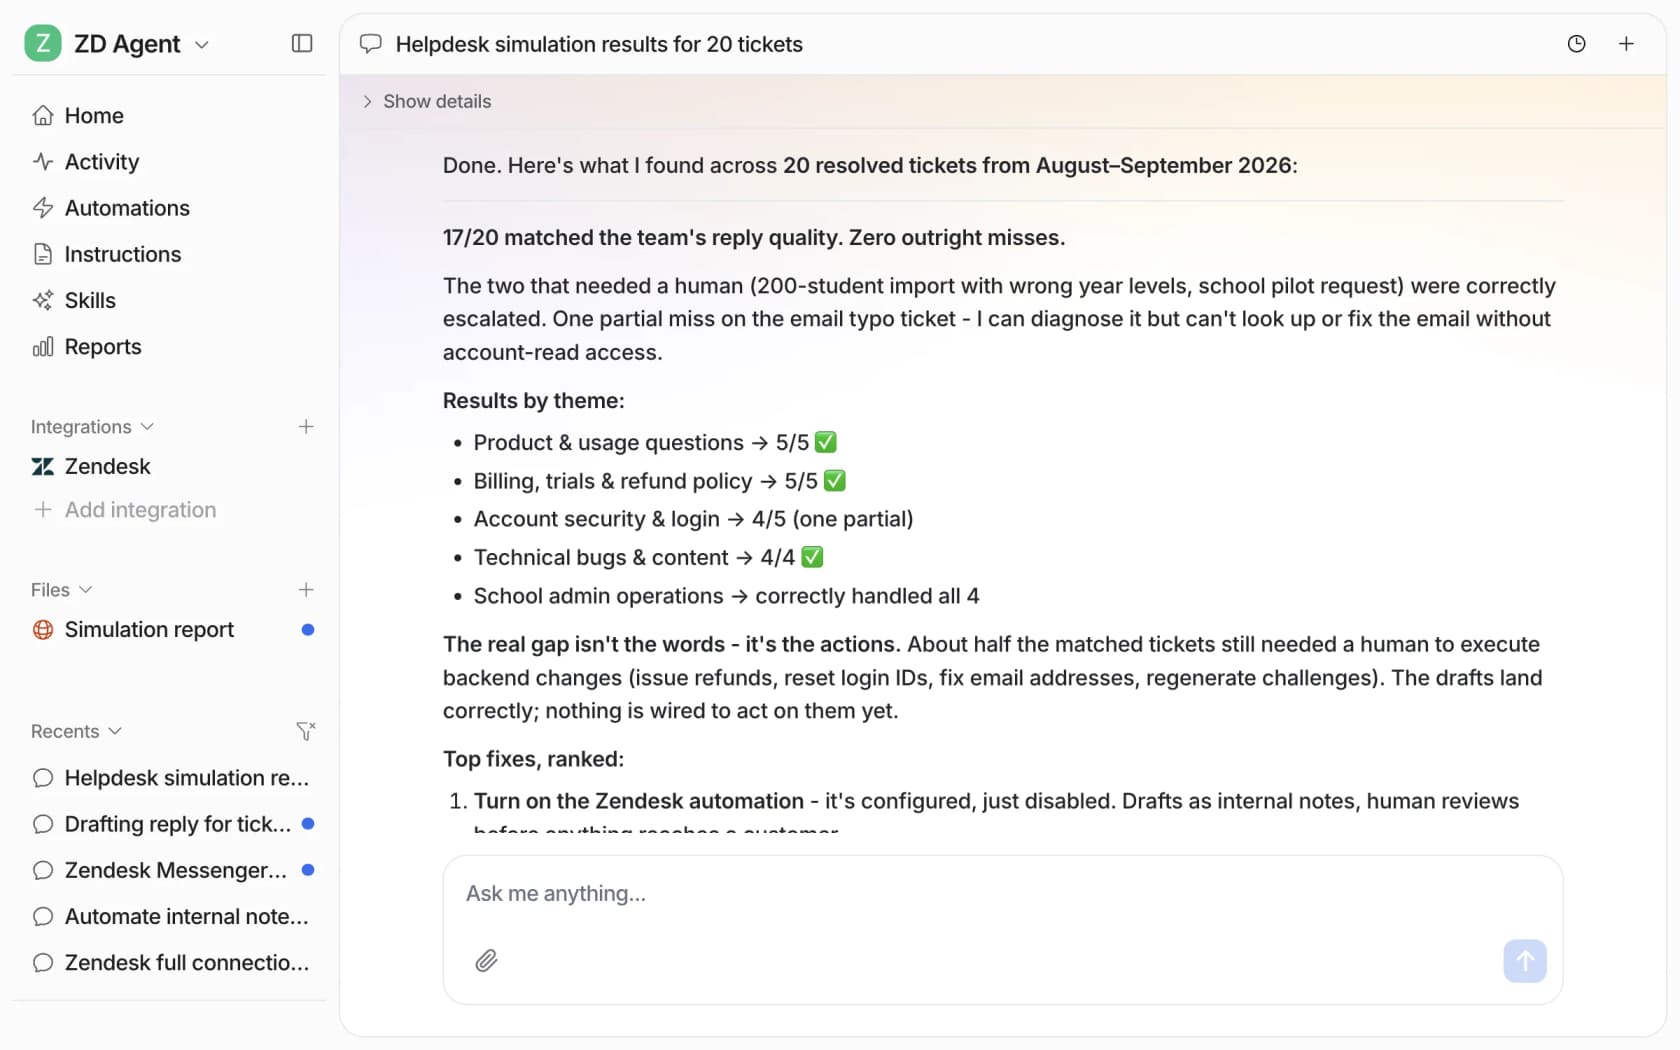
Après le lancement, chaque exécution apparaît dans Activity avec l'endroit où elle a eu lieu, "What it read", chaque action et l'endroit où une personne l'a approuvée, et "Why, its reasoning step by step" (Reports docs). Quand une réponse est à côté, vous ouvrez l'exécution et la corrigez dans le chat à côté, et la correction devient une règle pour toute réponse similaire. La compétence "Analyze and improve replies" fait la même chose à l'échelle : elle regarde ce que votre équipe a rejeté ou modifié et suggère le correctif, ce qui correspond au signal de sortie rejetée décrit par le commentateur Reddit.
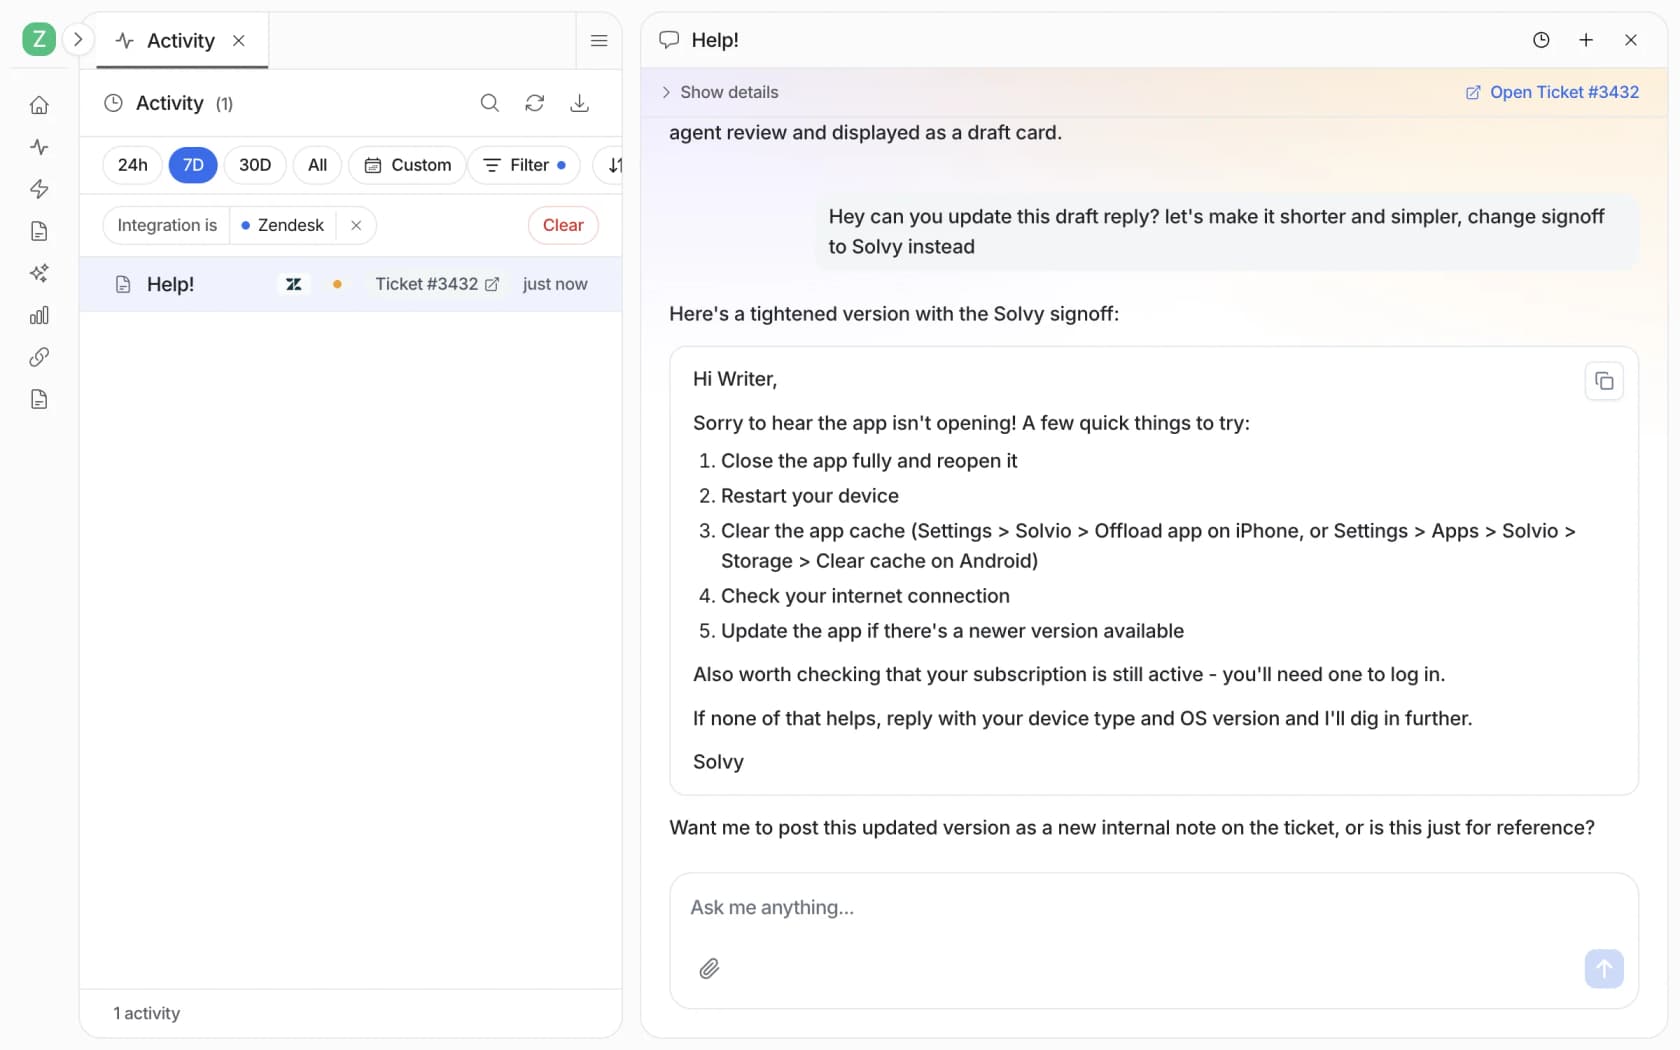
La page Reports suit un score CSAT IA, les lacunes de connaissances et les taux d'approbation, et je répète la mise en garde des docs eux-mêmes : "AI CSAT is not customer feedback." C'est un signal de qualité interne. Vous pouvez aussi planifier une auto-revue hebdomadaire, et si votre QA vit dans des scripts, la CLI eesel affiche du JSON pour chaque commande, de sorte qu'un agent de code comme Claude Code peut faire remonter l'activité et les approbations dans votre propre tableau de bord QA.
Une remarque honnête : à cause de la règle de Meta d'une IA par numéro, vous feriez tourner eesel ou Meta Business Agent sur un numéro WhatsApp donné, pas les deux. Si WhatsApp est votre seul canal et que vous avez des ingénieurs pour la boucle de QA ci-dessus, l'agent de Meta est un choix correct. Si vous voulez le QA intégré et les conversations de tous les canaux au même endroit, les tarifs d'eesel sont un forfait mensuel fixe de crédits avec un niveau gratuit de 100 crédits et des forfaits à partir de $299 pour 500, et vous pouvez lancer la simulation sur vos propres tickets passés avant qu'il ne réponde à un seul client.
Questions fréquentes
Puis-je utiliser Meta Muse pour l'assurance qualité du support ?
Que note réellement Meta Agent Eval ?
Meta Business Suite propose-t-il des scorecards QA pour les agents humains ?
Combien coûte l'assurance qualité du support avec Meta Muse ?
Pourquoi mon agent IA WhatsApp donne-t-il des réponses fausses avec assurance ?
Puis-je faire tourner une seconde IA sur mon numéro WhatsApp pour contrôler Meta Business Agent ?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.





Comment faire le QA des conversations en direct de Meta Business Agent sur WhatsApp ?