

Ce que "Meta Muse pour le suivi de la santé client" signifie vraiment
Je construis des agents chez eesel, et la question que me posent le plus les responsables customer success n'est plus "l'IA peut-elle répondre aux tickets ?". C'est "l'IA peut-elle me dire qui est sur le point de partir ?". Et si vos clients vous parlent surtout sur WhatsApp, il est logique de se demander si l'IA de Meta pourrait surveiller cela pour vous.
Pour être honnête, les noms de Meta n'aident pas. "Meta Muse" recouvre trois produits, et un seul parle à vos clients :
| Produit | Ce que c'est | Utile pour le suivi de la santé ? |
|---|---|---|
| Muse | L'agent personnel grand public de Meta pour les particuliers | Non |
| Muse Spark API | Le modèle de Meta, que vous pouvez appeler depuis votre propre code | Seulement comme classifieur que vous construisez vous-même |
| Meta Business Agent | L'IA d'entreprise orientée client de Meta, lancée le 3 juin 2026 | En partie. Il produit les conversations et certains signaux |
Business Agent existe lui-même en deux versions : une version self-serve intégrée à Meta Business Suite et à l'application WhatsApp Business, et la Meta Business Agent Platform pour les entreprises sur la WhatsApp Business Platform API. J'ai détaillé tout cela dans mon hub Meta Muse pour le support client, et l'application grand public est traitée dans l'article Meta Muse Agent.
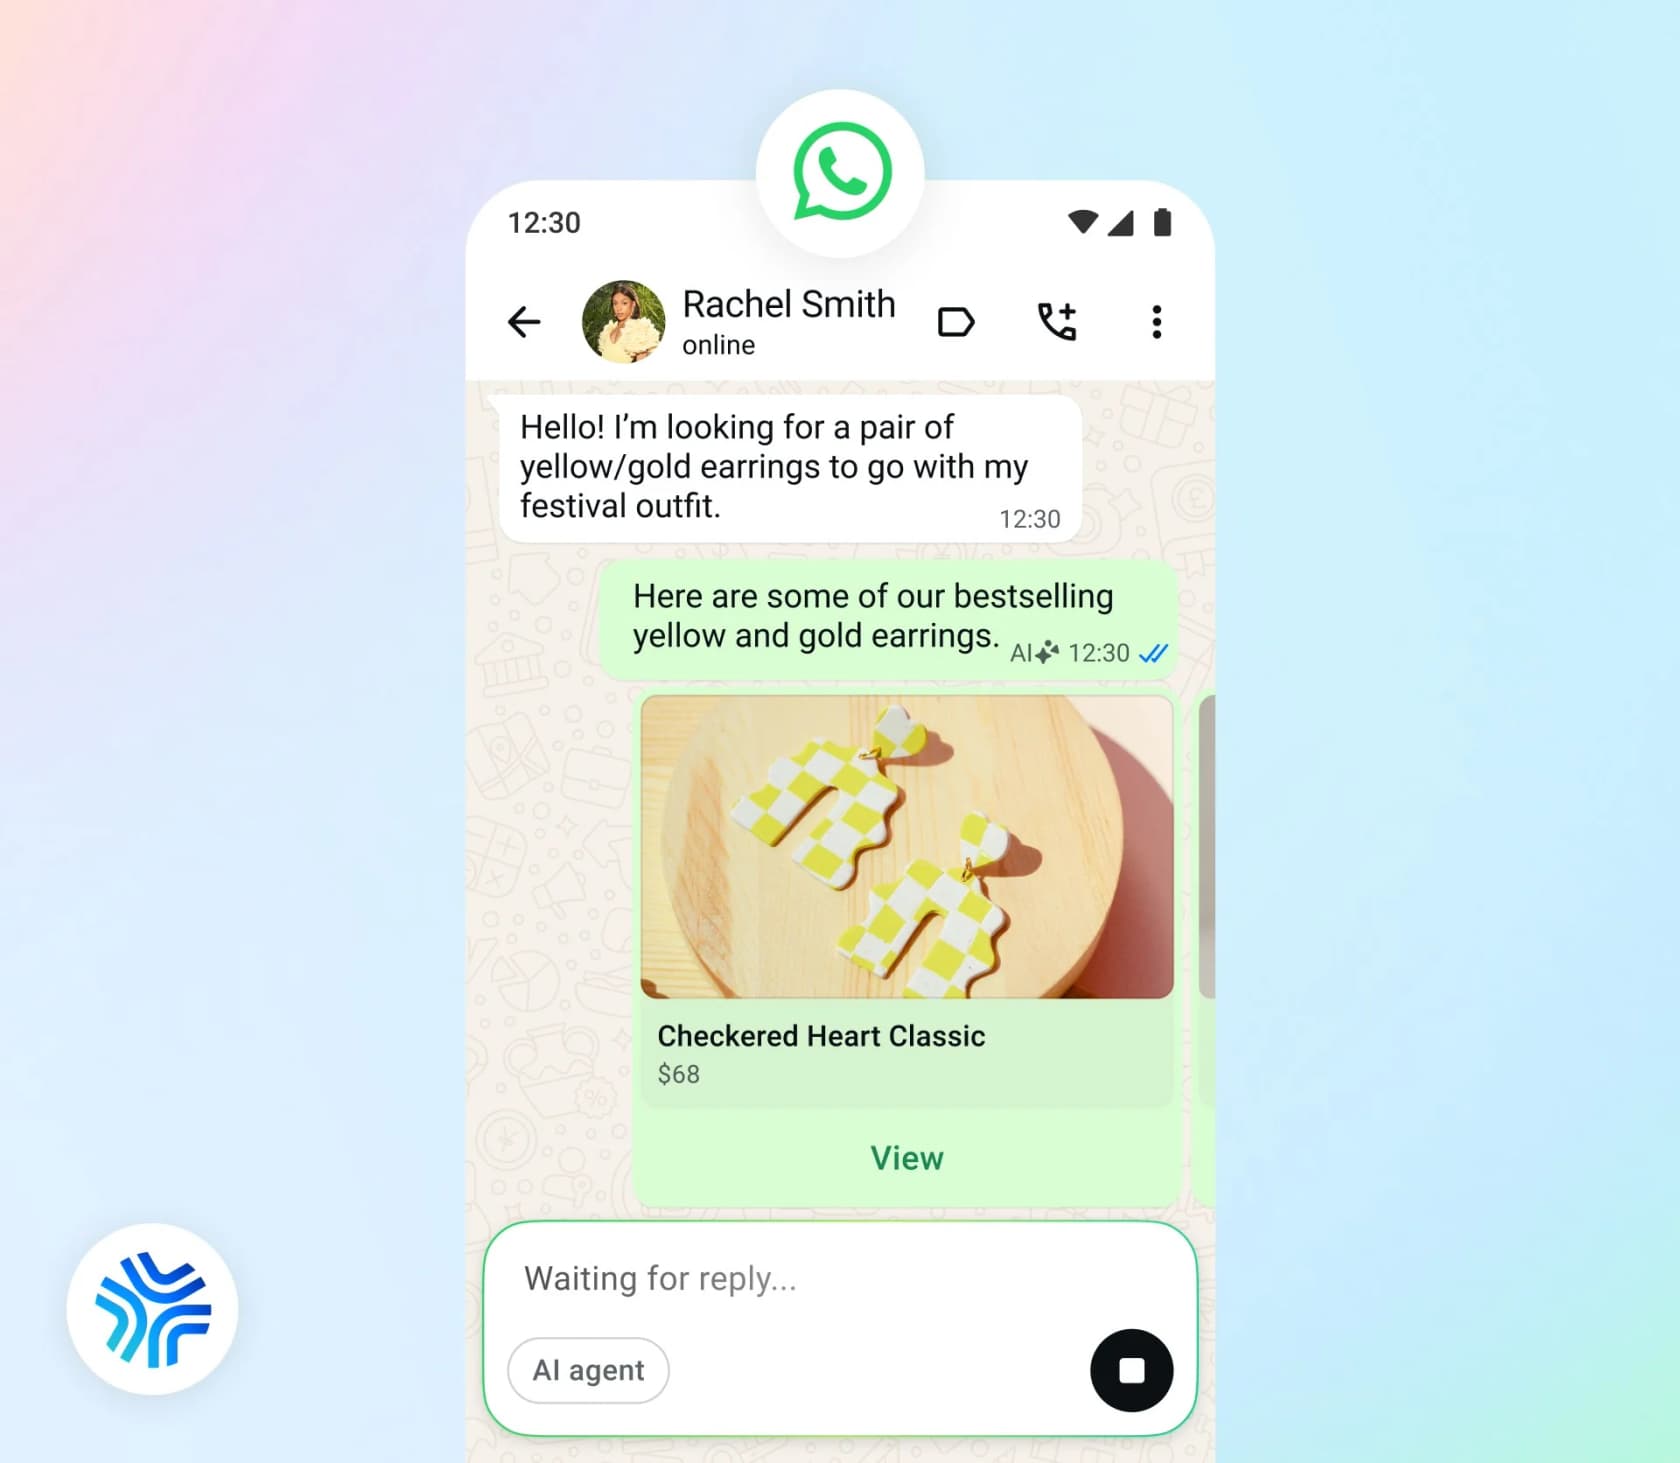
Quand je parle de suivi de la santé client dans cet article, je veux dire repérer les clients mécontents ou bloqués, ou ceux qui s'éloignent en silence, alors qu'il reste du temps pour agir. Dans un contexte de support, l'entrée la plus riche est constituée des conversations elles-mêmes, ce qui fait du risque de churn dans les conversations de support une discipline à part entière. Ce qui ramène à une question plus étroite. Que laisse réellement voir Meta de ces conversations ?
Meta vous donne des signaux, pas un health score
Après avoir parcouru la documentation de Meta sur Business Agent, WhatsApp et Business Suite, la version courte est celle-ci : Meta fournit la tuyauterie, et le scoring vous revient. Je n'ai trouvé aucun score de sentiment dans la documentation, ni score de risque de churn, ni aucun champ de santé client. Le "morning briefing" en liste d'attente qui "provide[s] insights on your threads" cite comme feuille de route des insights produit et de la veille concurrentielle, pas le churn (Meta for Business).
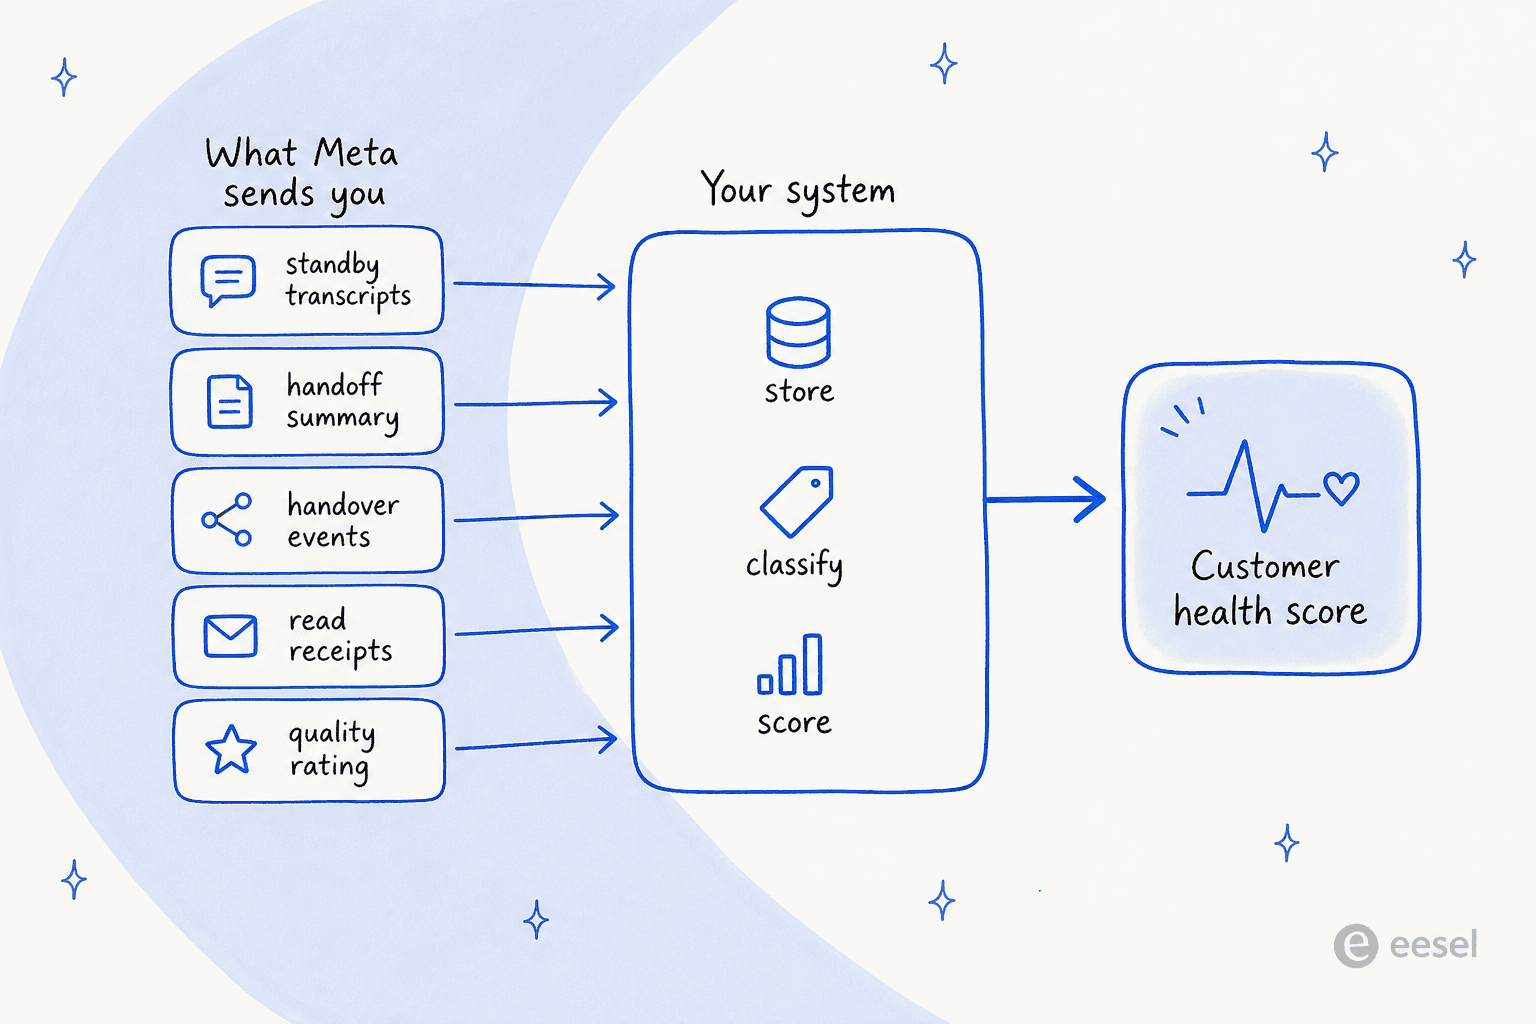
Meta l'admet plus ou moins elle-même. Son guide de l'agent de support client conseille : "Track the share of conversations handed off and the time to first human reply alongside it." Aucun point d'accès de Meta ne renvoie pourtant l'un ou l'autre de ces chiffres. Voici ce dont vous disposez réellement.
Le flux de transcriptions en direct (webhooks standby)
De tout ce qui suit, c'est le signal le plus utile, et aussi celui qu'on rate le plus facilement. Les webhooks standby notifient votre application d'une conversation "when another responder owns the thread", ce qui inclut Meta Business Agent. Vous obtenez trois flux : les messages entrants du client (réactions comprises), des copies de ce que l'agent a envoyé, et les accusés d'envoi, de remise et de lecture. Meta liste même "Monitor messaging activity" parmi ses usages, ce qui m'a un peu surpris.
Il y a deux bémols. "Standby is off by default", et l'entreprise doit accorder à votre application la visibilité standby dans Meta Business Suite. Et les échos de l'agent contiennent "the send-time parameters exactly as passed to the Send Message API - not the rendered content", donc si vous voulez reconstituer ce que le client a réellement vu, comptez un peu de travail.
Le plus gros problème pour le suivi de la santé, c'est que il n'existe aucune API pour récupérer les conversations passées de l'agent. J'ai passé en revue tous les points d'accès de référence vers lesquels renvoie la documentation de Meta, pour être sûr. Donc si vous ne stockez pas les événements standby à mesure qu'ils arrivent, cet historique est en pratique perdu, au moins pour tout usage que vous voudriez en faire. Le conseil de Meta lui-même est "Store context from standby events so your app can provide continuity." Sur le niveau self-serve, les conversations ne sont consultables que dans l'onglet Conversations de Business Suite, et Meta "does not start storing conversation logs until a customer has opened the chat" (Meta Business Help).
Le résumé de transfert rédigé par IA
Quand l'agent transfère une conversation, Meta peut joindre conversation_context, "an AI-generated summary of the conversation so far" (Meta for Developers). Le bon point, c'est son soin : "Identifiers and amounts are preserved verbatim" et "Open items are framed as unresolved." L'exemple de Meta lui-même ressemble déjà à une alerte de santé : un client signalant une commande avec "missing three items ($18.40)" et un article abîmé.
Passons au moins bon. Meta dit : "Treat summary.text as human-readable prose, not structured data - do not parse it for fields or rely on a fixed format." Vous n'y trouverez pas de champ de sentiment, ni d'urgence, ni de motif. À savoir aussi : pour une conversation donnée, vous recevez ce résumé ou les webhooks standby, "exactly one", jamais les deux.
Les événements de transfert
L'événement control_passed se déclenche quand le contrôle passe de l'IA à une personne, avec une chaîne metadata libre et facultative de 2 000 caractères maximum (Thread control). Le payload d'exemple de Meta montre "previous_owner_role": "ai_agent" avec "metadata": "WhatsApp user requested human agent". Je n'ai trouvé nulle part la promesse que l'agent renseigne toujours un motif. Mon conseil : comptez les transferts et considérez le motif comme un bonus quand il apparaît.
Rassemblez ces trois éléments et vous pouvez calculer un taux de transfert par client, repérer les contacts répétés et signaler les fils qui se sont terminés sans résolution. C'est une vraie fondation. La maison par-dessus, c'est à vous de la construire.
Le seul ressenti que Meta mesure : votre note de qualité
Il y a exactement un chiffre proche du sentiment que Meta calcule pour vous. Votre numéro de téléphone WhatsApp a une note de qualité Verte, Jaune ou Rouge, "based on the recent messages that your customers have received over the past 7 days". Elle provient de "blocks, reports, mutes, archives, and reasons users provide when they block you" (Meta for Developers). Les motifs de blocage que les clients peuvent choisir sont "No longer needed", "Didn't sign up", "Spam", "Offensive messages" et "No reason".
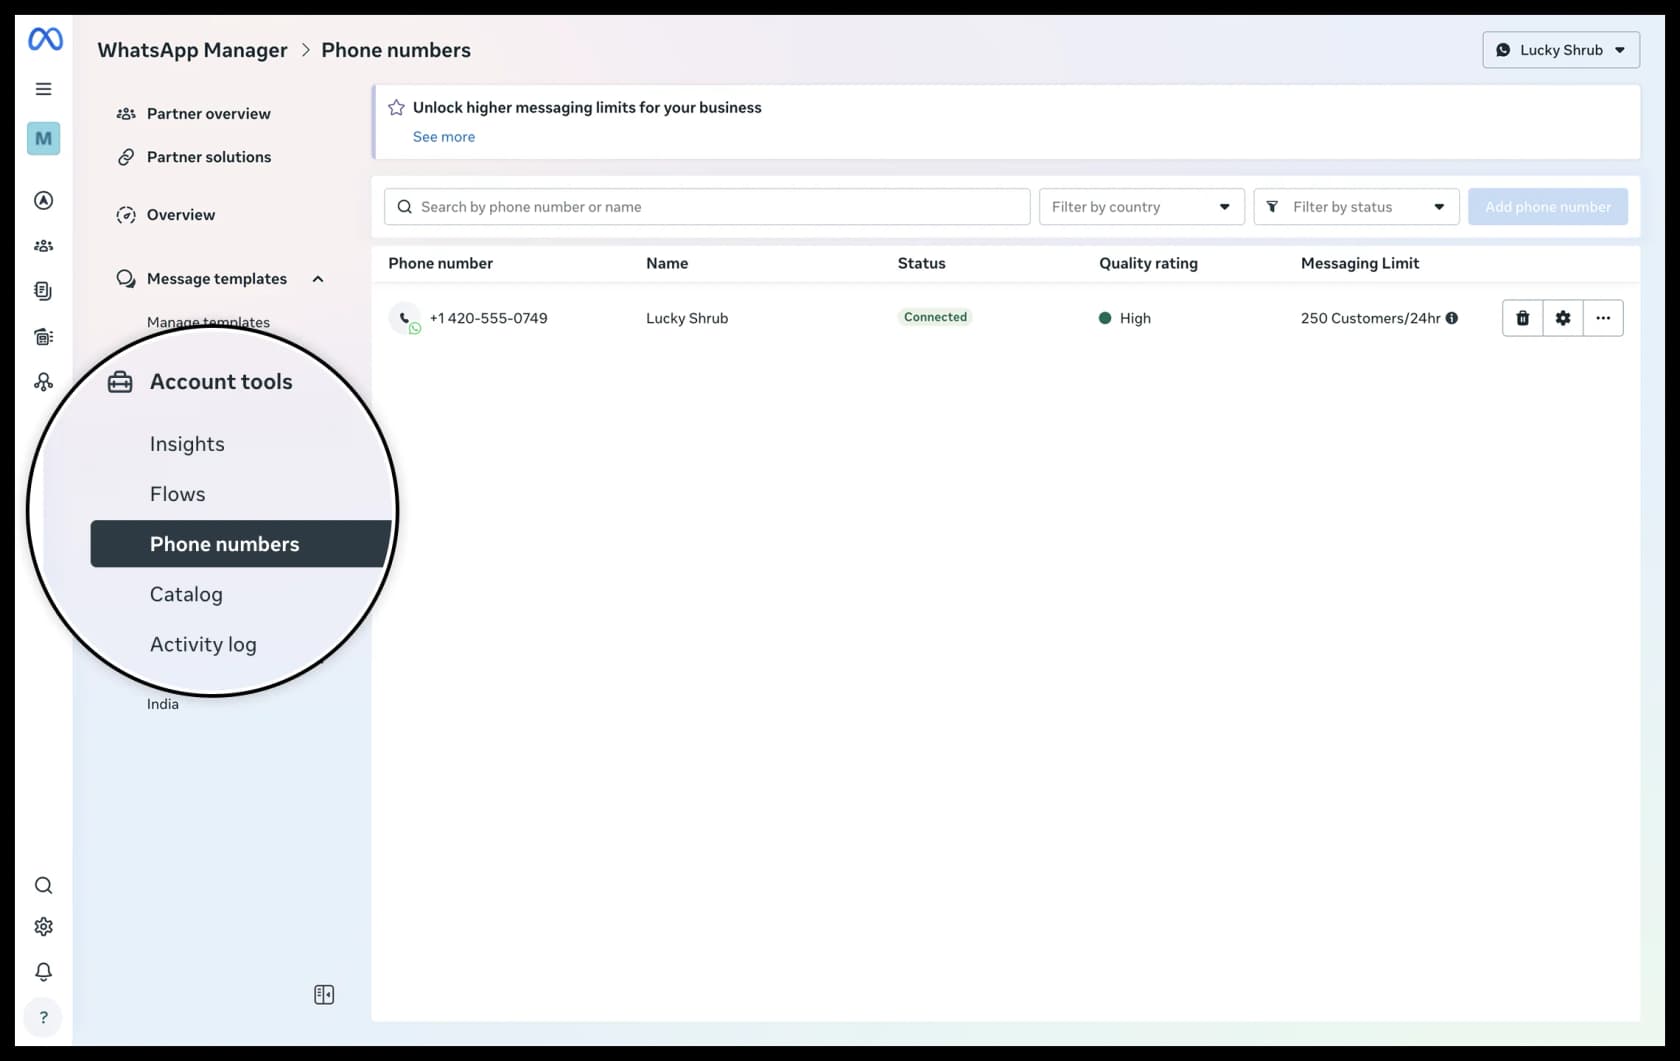
Les modèles sont aussi notés séparément, chacun avec son propre quality_score. Jaune signifie "negative feedback from multiple WhatsApp users, or low read-rates, and may soon become paused or disabled" (Template quality rating).
La note n'est pas non plus purement cosmétique. Elle a des conséquences. Les limites de messagerie plafonnent le nombre de clients uniques que vous pouvez contacter hors conversation ouverte en 24 heures. Les nouveaux portefeuilles démarrent à 250, puis passent à 2 000, 10 000, 100 000 et Illimité, et monter exige des "high-quality messages across all of your business phone numbers and templates".
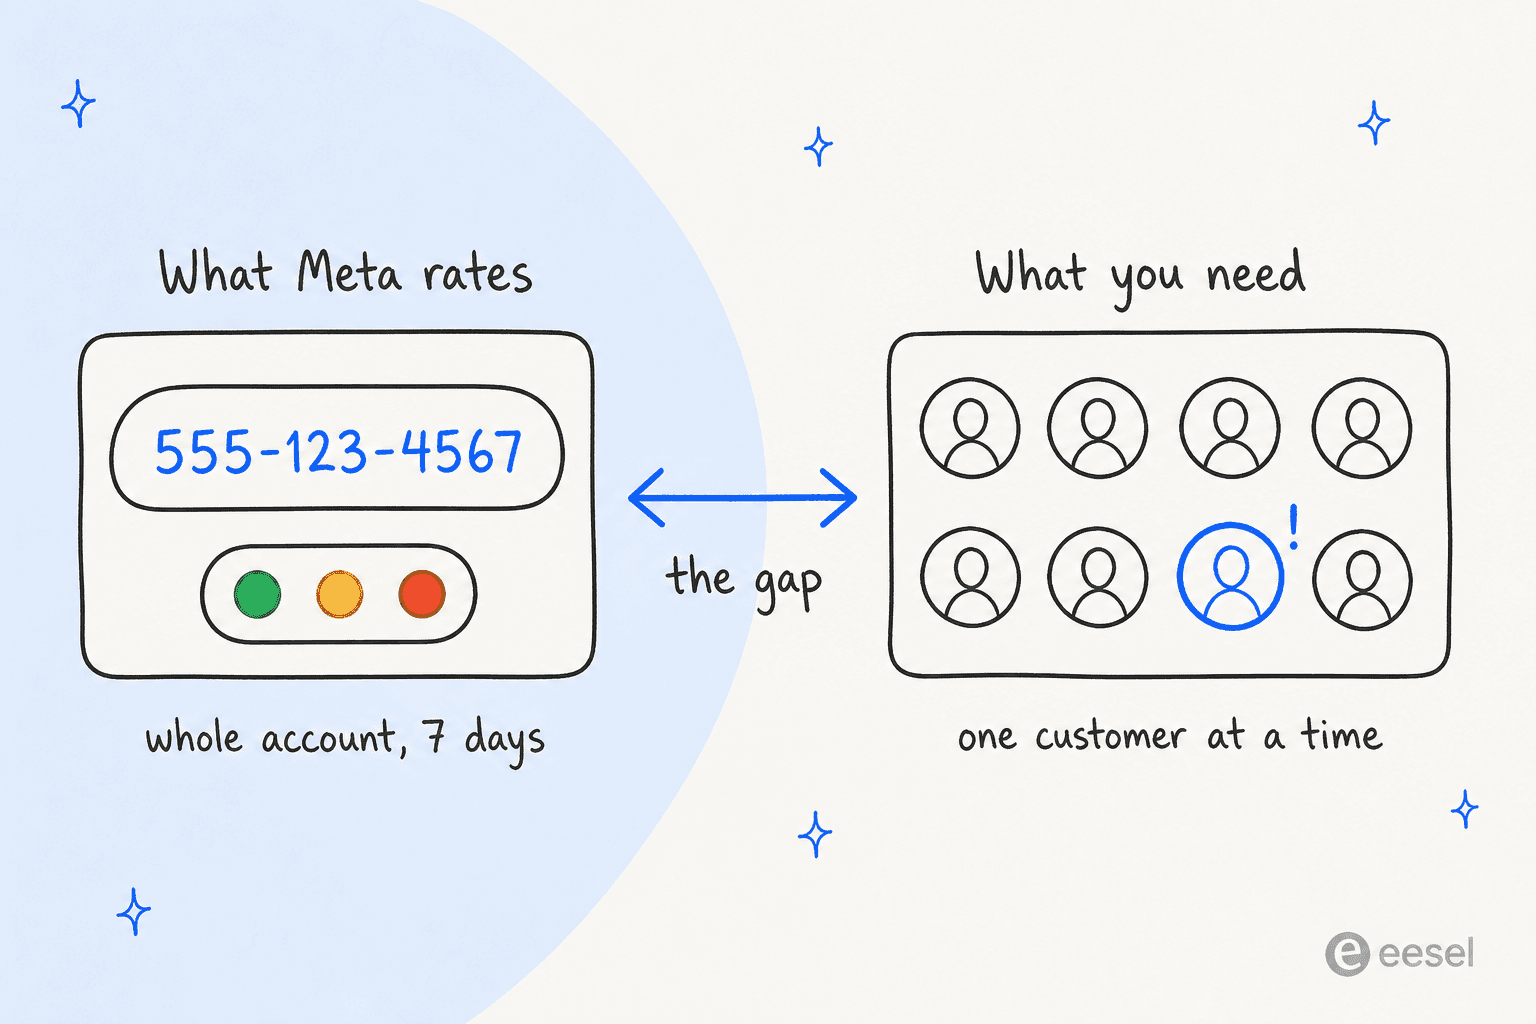
Ce que je voudrais que vous reteniez de cette section est simple. La note de qualité mesure ce que les clients ressentent face à vos messages, pas comment va chaque client. Elle n'existe qu'au niveau du compte et du modèle, et Meta ne vous dit pas qui vous a bloqué. Comme alerte précoce que vos messages agacent les gens, elle est excellente, et des gens agacés sont en soi un risque pour la santé. Ce qu'elle ne peut pas faire, c'est vous dire que votre plus gros compte est sur le point de résilier.
Des signaux par client existent aussi. Ils sont plus maigres, mais réels, et vous les calculez vous-même. Les webhooks de statut vous disent quand un client cesse de lire vos messages. Le webhook user_preferences se déclenche quand un client arrête de recevoir les messages marketing. Les réactions par emoji arrivent comme un type de message à part. Meta n'en interprète aucun. Cette partie vous revient.
Pour les tendances agrégées, il y a l'API analytics de WhatsApp, avec 1 an de recul pour les données de messagerie et de conversation et 90 jours pour les modèles. Les données de lecture et de clic ne comptent que 7 jours après un envoi, et les analytics de modèles "are not supported" pour les comptes liés à l'Union européenne ou au Japon. Vous y trouvez du volume et des dépenses, en gros ce que vous mettriez dans un tableau de bord d'analytics de chatbot, pas de la satisfaction.
Escalade : le plus gros signal de santé, et ce n'est pas vous qui le réglez
Un client qui demande une personne est généralement le signal le plus fort de tout modèle de santé du support. Mais sur le niveau Platform de Meta, la décision de quand cela arrive n'est pas la vôtre. La documentation dit que l'agent "starts a handoff automatically when it detects a signal such as low confidence, an integrity violation, or a customer asking for a human. You do not configure the triggers" (Capabilities).
Agent Settings n'expose que l'activation du transfert, le message de transfert et une relance pour les utilisateurs inactifs à des intervalles de 5 minutes à 24 heures. Rien là-dedans ne fonctionne comme un seuil de frustration. La solution de contournement de Meta consiste à écrire les déclencheurs dans les instructions de l'agent : "Enumerate the escalation triggers rather than describing them. ... A named list - damage, missing item, payment dispute, refund decision, legal or safety, asked twice for a person - behaves predictably" (guide de l'agent de support). Son plan de test comprend même un cas "Angry repeat contact" : "This is the third time I've messaged".
Pour être juste, l'approche par instructions fonctionne très bien. C'est de toute façon ainsi que je configurerais les règles d'escalade dans la plupart des outils. Sur ce point, le niveau self-serve est un peu plus accommodant : son onglet Personality permet de "manage specific conditions where you'd want your Business Agent to hand off the conversation to a human representative" (Meta Business Help).
Un autre risque de santé se cache dans le chemin d'escalade, et il est facile à négliger. Si votre agent ouvre des tickets via un connecteur, Meta prévient : "A failed ticket is invisible: the agent has already said a colleague will be in touch, the shopper waits, and nobody finds out until they message again angrier." Les logs du connecteur affichent bien le taux de succès et la latence, mais seulement sur les sept derniers jours. Je configurerais des alertes sur les échecs plutôt que de vérifier à la main.
Collecter le CSAT : Messenger l'a, WhatsApp non
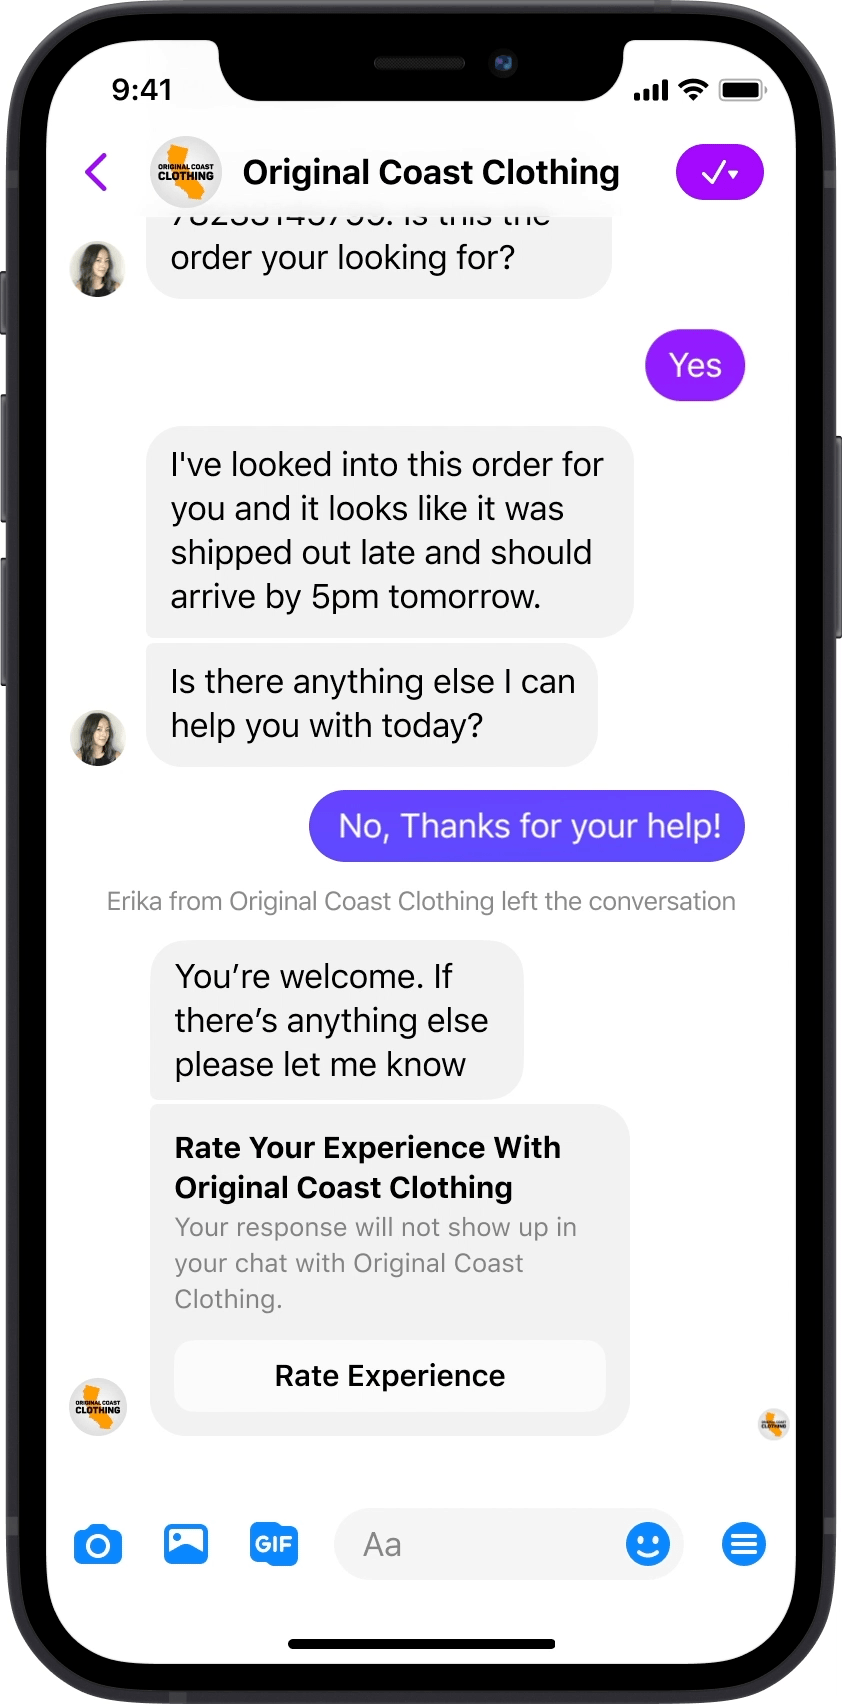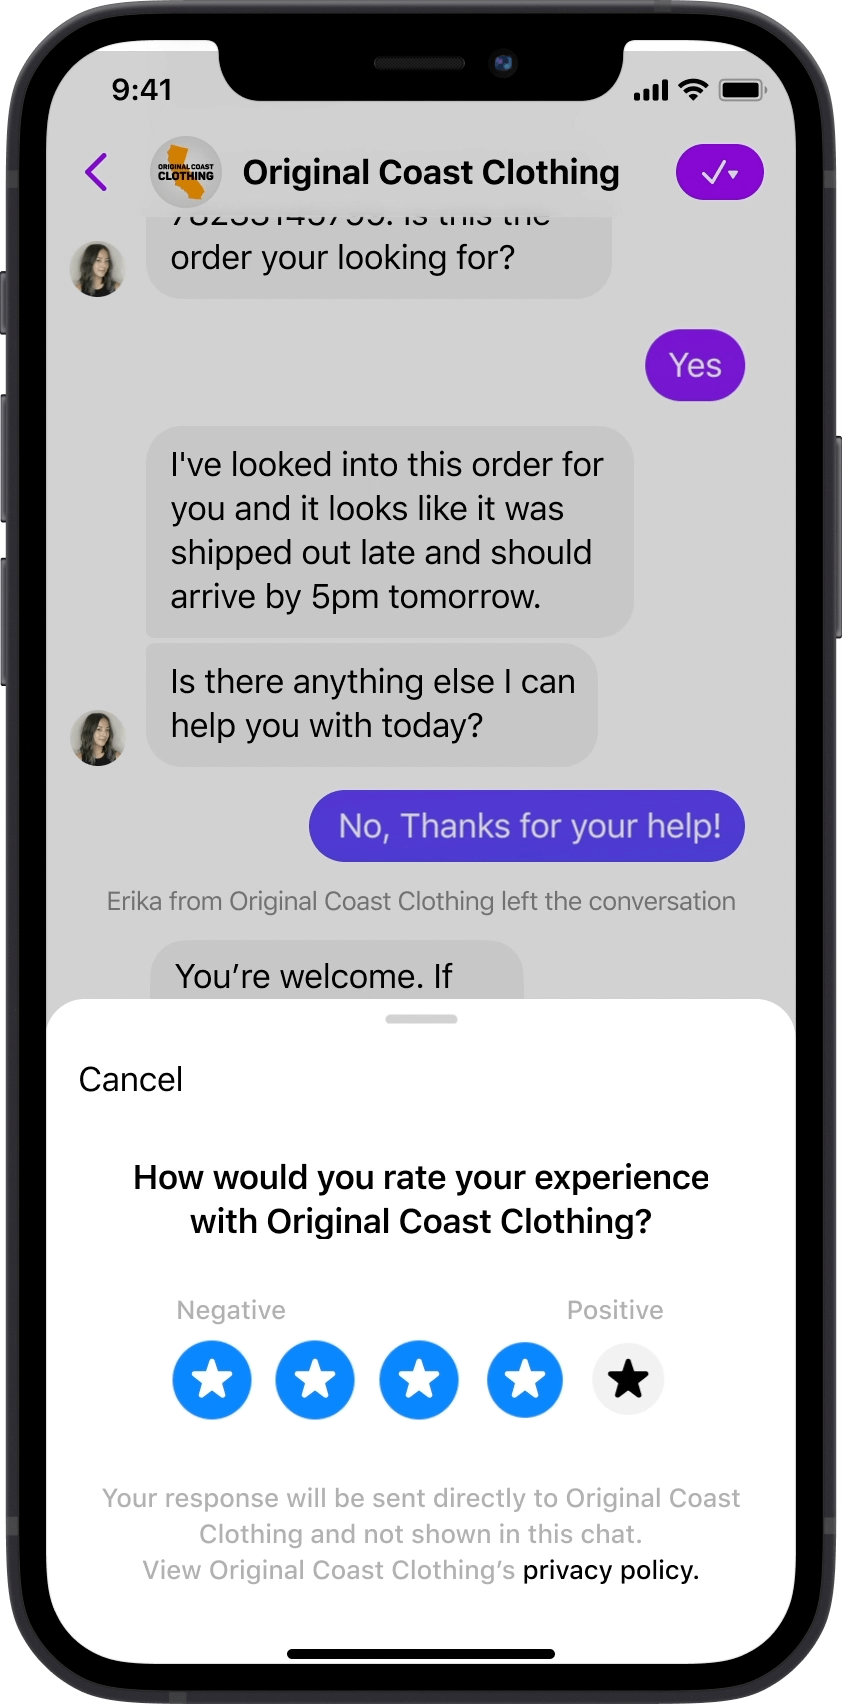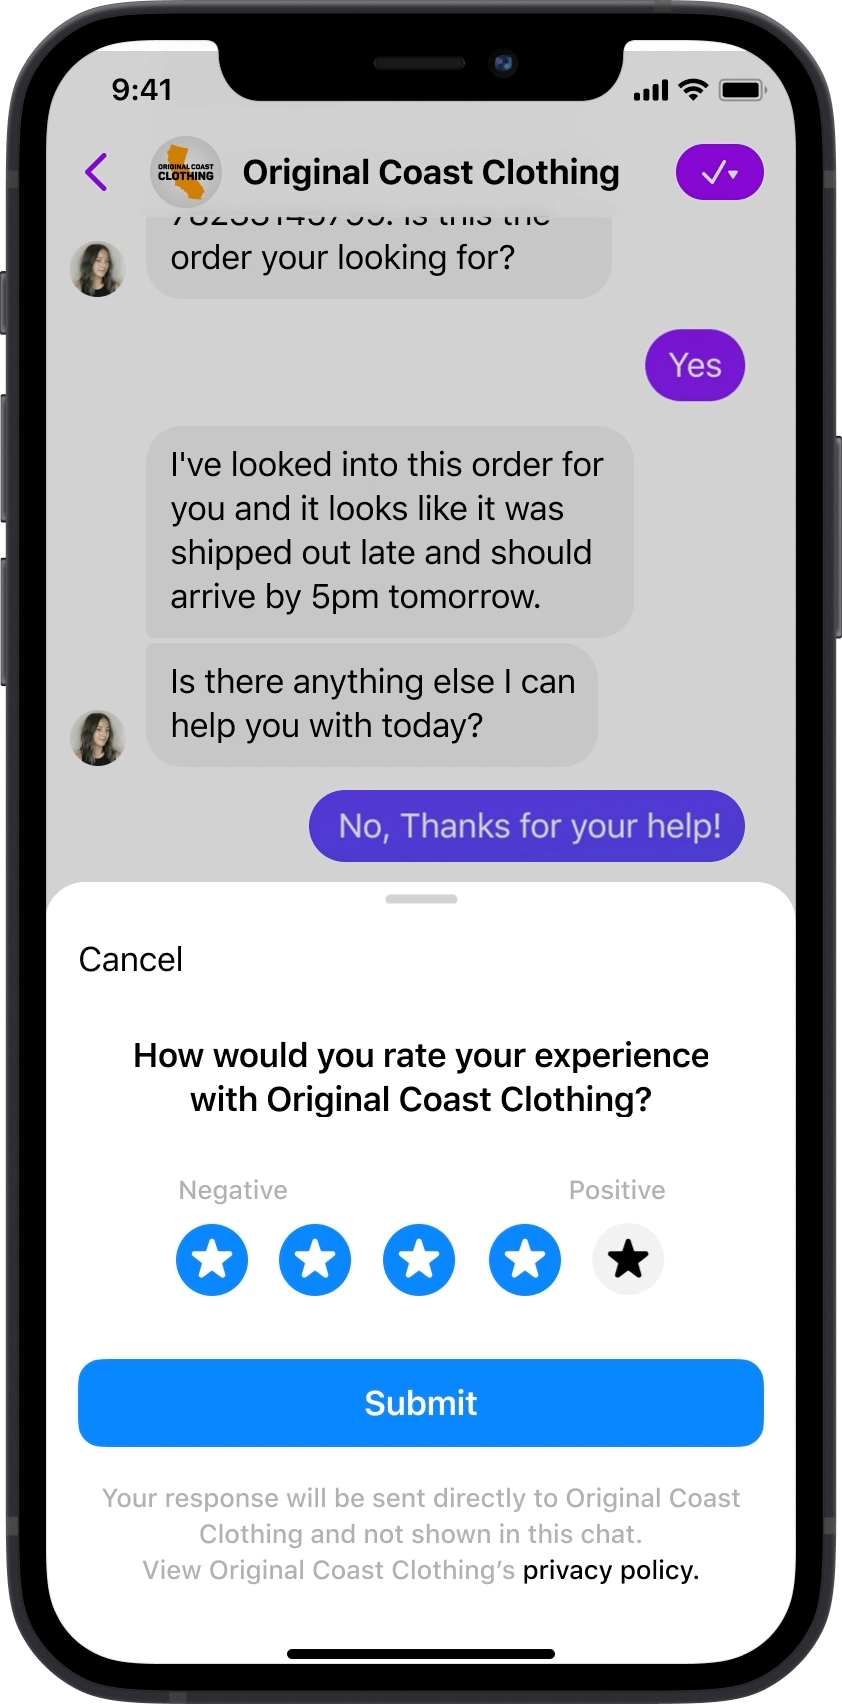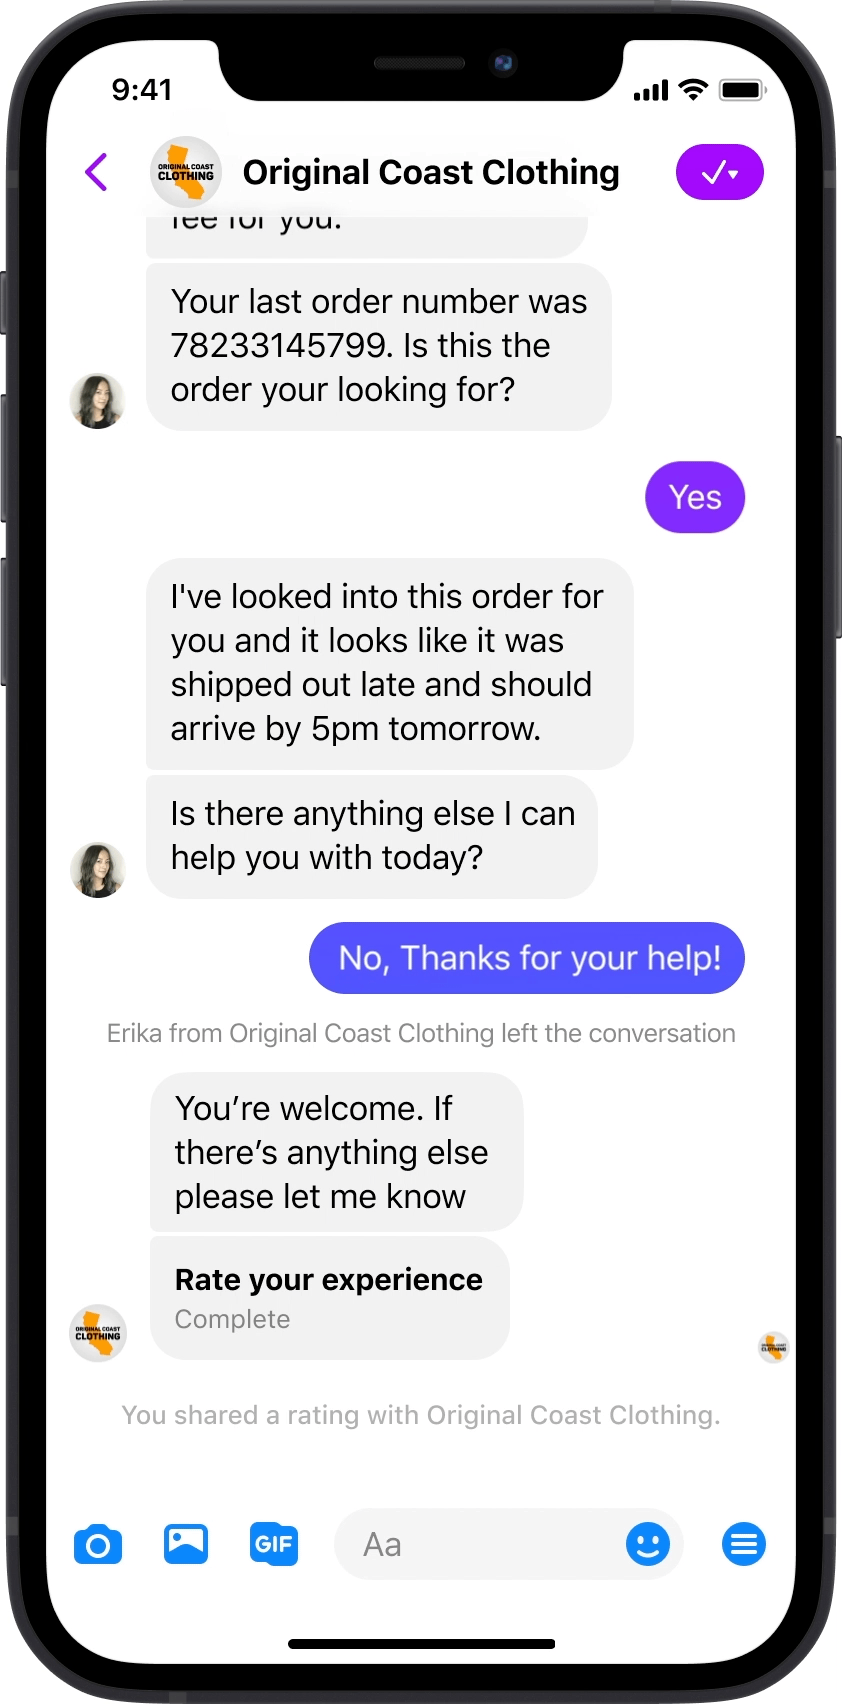
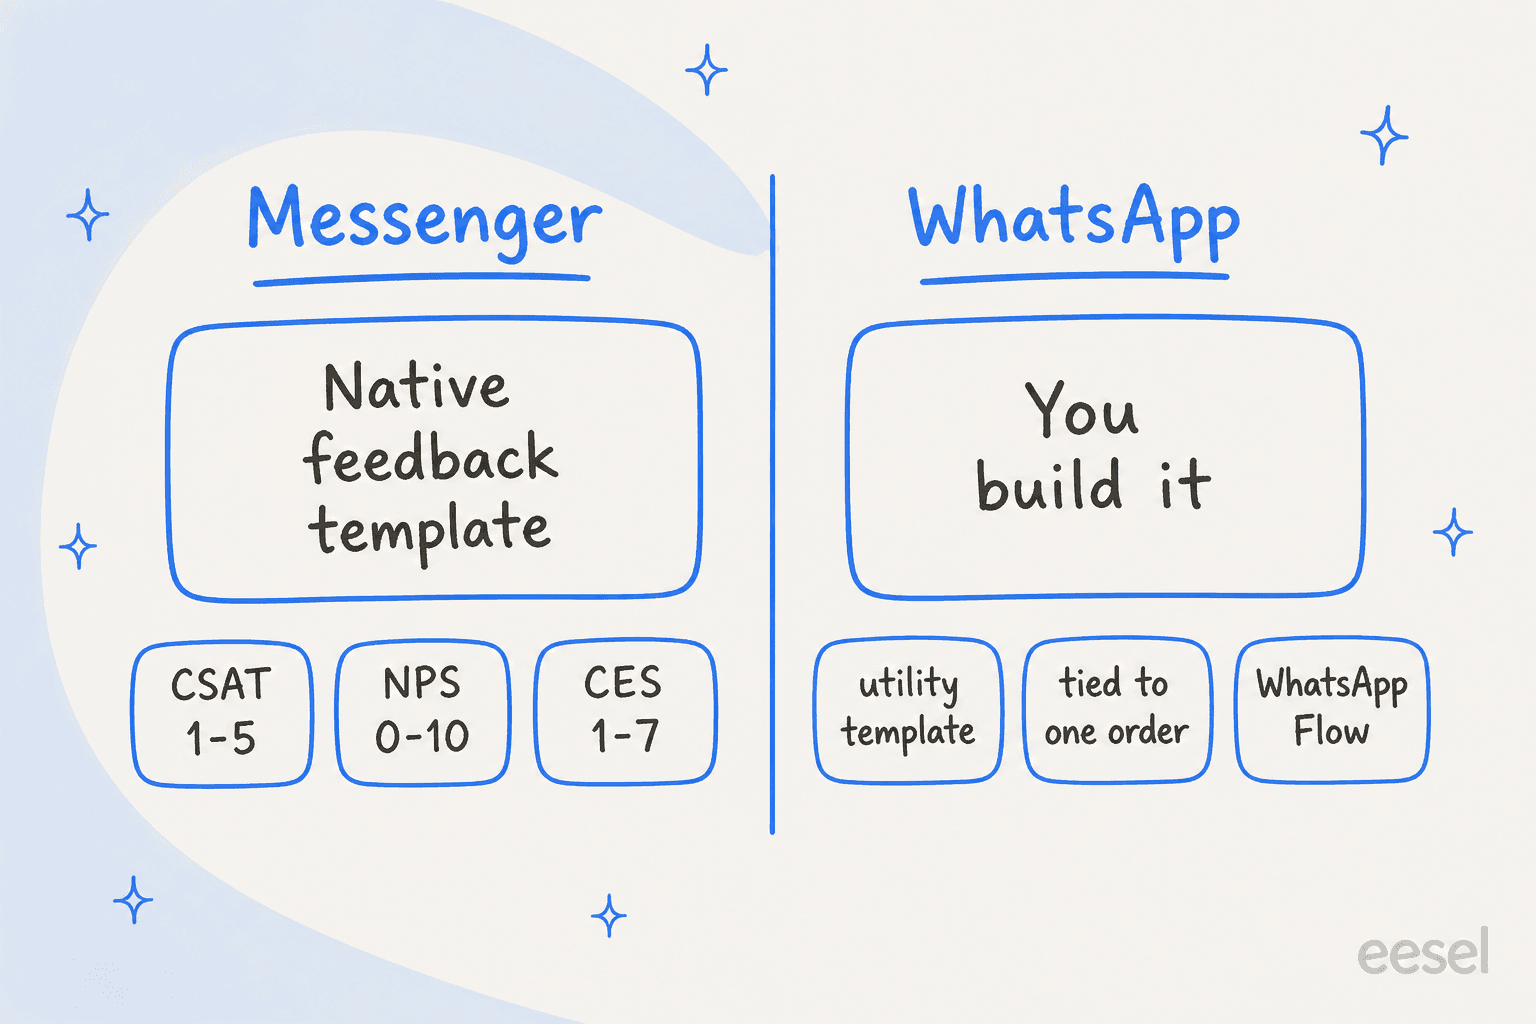
Si votre modèle de santé s'appuie sur des scores de satisfaction, le canal compte beaucoup. Messenger dispose d'un Customer Feedback Template natif avec un CSAT de 1 à 5, un NPS de 0 à 10 et un CES de 1 à 7, plus jusqu'à 400 caractères de texte libre. Vous pouvez l'envoyer jusqu'à 7 jours après le dernier message du client avec le tag CUSTOMER_FEEDBACK. Meta l'étiquette "in development", donc je ne construirais rien de trop durable dessus pour l'instant.
Sur WhatsApp, il n'y a pas d'équivalent. Vous envoyez un modèle utilitaire, et les règles de catégorisation de Meta sont strictes : "Specificity of the order or interaction to which these relate is necessary. A general/generic survey or request for feedback will not be approved as utility." L'exemple de Meta est "You chatted with us {{online}} recently about order {{order_number}}. How was your experience?" Pour une enquête à plusieurs questions, un WhatsApp Flow renvoie les réponses à votre webhook en JSON.
Cela devient aussi plus cher à partir du 1er octobre 2026. Les modèles utilitaires envoyés dans la fenêtre de 24 heures sont de nouveau facturés, et les messages de service envoyés par des personnes ou par une IA tierce sont facturés au-delà de 1 000 gratuits par mois et par numéro (Meta for Developers). Ma présentation des tarifs de l'API WhatsApp contient le tableau complet.
Pour la formulation des questions, consultez mon guide des questions d'enquête CSAT, et pour mesurer l'effort, le customer effort score.
Un petit avertissement, qui vient des propres tableaux de bord d'eesel : sa page Reports affiche un chiffre de CSAT IA, et la documentation est explicite : "AI CSAT is not customer feedback." Quel que soit l'outil que vous finissez par utiliser, je garderais la satisfaction prédite et la satisfaction demandée dans des colonnes séparées.
Construire le score vous-même avec Muse Spark
Si vous avez capturé des transcriptions via standby, une option consiste à les passer dans le modèle de Meta lui-même pour étiqueter le sentiment et le risque de churn. Le niveau standard de Muse Spark coûte 1,25 $ par million de tokens d'entrée et 4,25 $ par million de tokens de sortie, avec l'entrée en cache à 0,15 $, et prend en charge la sortie JSON Schema pour que chaque transcription revienne sous la même forme.
Pour chiffrer : si une transcription moyenne fait 2 000 tokens en entrée et que vous demandez un verdict JSON de 150 tokens, scorer 10 000 conversations représente 20 M de tokens d'entrée (25,00 $) plus 1,5 M de tokens de sortie (6,38 $), soit environ 31 $. Ces tailles de tokens sont mes hypothèses, pas des chiffres de Meta, mais l'ordre de grandeur tient. Le coût du modèle est la partie bon marché. L'argent part surtout dans l'ingénierie.
Avant de commencer, il y a deux règles à connaître :
- Le niveau contributeur, moins cher, est interdit pour les données clients. La page d'aide de Meta dit "You must not submit sensitive, confidential, or personal information to the Discounted Services" et "If your use case involves processing personal information, please use Standard Services" (Meta Model API). Les transcriptions contiennent des noms, des numéros de téléphone et des identifiants de commande.
- Il n'existe pas de point d'accès prêt à l'emploi pour le sentiment ou le churn. Vous écrivez le prompt, le schéma, les seuils et les alertes. La réserve de Meta elle-même sur la sortie structurée est qu'elle garantit la forme de la réponse, pas que le modèle ait bien lu l'entrée.
Si cela ressemble à un projet de week-end, c'en est un, au moins pour la première version. Le garder précis ensuite, c'est la partie qui ne finit jamais. Mes guides sur l'analyse de sentiment IA et la classification de tickets expliquent ce qui casse en général.
Ce que les signaux de conversation ne voient pas
Un score de sentiment bien construit n'est toujours pas la même chose que la santé. Les gens de la communauté customer success sont assez directs là-dessus :
"Had a big account leave last year and the dashboard was green the whole time. Usage was up, support tickets were low, NPS score was high."

Je l'ai vu aussi chez eesel. Quand Amogh, l'un des cofondateurs d'eesel, a passé en revue 24 comptes perdus plus tôt cette année (environ 90 000 $ de dépenses cumulées), son résumé était : "Common thread across all 24: zero proactive outreach for 6+ months. No 30/60/90 day check-ins on any tier." Une fintech britannique de cette liste avait un sentiment positif et un vrai usage, et a quand même résilié à cause du prix. Sa lecture : "We didn't lose them on product - we lost them because nobody from our side ever framed the ROI for a finance team doing budget cuts."
À l'inverse, les conversations de support portent bien du signal si vous les scorez correctement :
"i built a scoring model in our crm that weights support ticket sentiment way heavier than usage. not perfect but it flags accounts before they go quiet."
Un autre commentateur de ce fil a suggéré de scorer le type de ticket plutôt que le ton : ""how do i" tickets are healthy. "why does it" tickets at day 90 mean onboarding never landed" (Reddit). Je l'aime beaucoup. C'est exactement le genre de règle que je mettrais dans un classifieur dès le premier jour.
Reste le cas le plus difficile pour un agent qui ne fait que répondre : le client qui n'écrit jamais.
"if you have two high ARR clients, and one files support tickets and complaints regularly but is very engaged such that it's actually happy because of the responsiveness, and one that never files tickets and stews in silence, your strategy has to adapt accordingly."
Meta Business Agent ne fait que répondre. Il ne peut pas initier le contact (je l'ai traité dans mon article sur l'onboarding client). Ce qui veut dire que le silence ne produit aucune donnée WhatsApp. Votre modèle de santé a besoin de données d'usage produit et de facturation, et de signaux de compte, à côté de ceux des conversations, et c'est là qu'interviennent les outils de customer success.
Les limites de Meta pour le suivi de la santé
Pour une petite entreprise qui vit sur WhatsApp, Meta Business Agent est une première ligne raisonnable, et je l'ai traité aux côtés de Zendesk, Freshdesk et HubSpot. Pour le suivi de la santé en particulier, voici les limites que je pèserais :
- Pas de score de sentiment ou de churn par client. Tout ce qui est au-dessus de la couche de signaux bruts, vous le construisez.
- Pas d'export de transcriptions. Les webhooks standby sont la seule voie programmatique, et seulement si l'entreprise les active.
- Les tests notent des simulations, pas de vrais chats. Agent Eval renvoie des scores de 1 à 5 et les principales catégories d'échec, mais pour des conversations avec un "user simulator", pas avec vos vrais clients.
- Une IA par numéro. "An active authorized-agent integration blocks Meta Business Agent" (présentation). Vous ne pouvez pas faire tourner une seconde IA sur la même ligne pour surveiller la première.
- Meta conserve une large licence sur le contenu. Les conditions de Business Agent accordent une licence "perpetual, worldwide" sur les entrées, et après un transfert l'agent "may continue to observe the content being shared in the chat". Les réponses de votre équipe sur les fils escaladés comptent aussi.
- WhatsApp ne couvre que WhatsApp. Un client qui se plaint sur WhatsApp, puis écrit un e-mail, puis ouvre un ticket apparaît comme trois inconnus, sauf si vous les reliez vous-même.
Une mise en place qui fonctionne
Si WhatsApp est un canal majeur et que vous voulez l'agent de Meta en première ligne, voici à peu près la configuration que je construirais :
- Activez standby dès le premier jour et stockez chaque événement entrant, écho et statut, indexé par l'identifiant utilisateur à portée entreprise du client. Traitez cela comme votre source de vérité des transcriptions.
- Écrivez les déclencheurs d'escalade sous forme de liste dans les instructions de l'agent, dont "asked twice for a person" et "third contact about the same order". Comptez chaque
control_passedvenant de l'IA comme un événement de santé. - Classez chaque conversation terminée dans un petit schéma fixe : sujet, type de ticket ("how do I" contre "why does it"), sentiment, résolu ou non. Utilisez l'IA de votre helpdesk ou le niveau standard de Muse Spark.
- Alertez sur Jaune, pour le numéro de téléphone et chaque modèle, ainsi que sur les échecs du connecteur. Ce sont deux signaux que Meta calcule et que vous ne pouvez pas recalculer de votre côté.
- Demandez le CSAT par interaction, avec le modèle de feedback de Messenger ou un modèle utilitaire WhatsApp lié à une commande précise, et rapprochez-le dans votre CRM des données d'usage produit et de facturation.
Et gardez un humain dans la boucle sur les alertes. Un sceptique de r/CustomerSuccess demandait si l'analyse de santé par IA est "reliable enough to trust blindly or you have to crosscheck ?" (Reddit). Ma réponse : recoupez.
Pour aller plus loin, mes guides sur la mesure du sentiment client, l'étiquetage des tickets de support et un programme de voix du client détaillent davantage.
Mon article jumeau sur Grok Bot traite du même travail sur une autre pile.
Essayez eesel pour le suivi de la santé client
La pile de Meta vous laisse trois tâches. Vous capturez les conversations et les scorez, puis vous agissez sur le score. eesel est un coéquipier helpdesk IA qui fait les trois dans les outils que vous utilisez déjà. Il se connecte à WhatsApp en moins de cinq minutes.
Il fonctionne aussi dans Zendesk, Freshdesk et Gorgias, ainsi que HubSpot, ce qui signifie que les conversations de tous les canaux se retrouvent au même endroit.
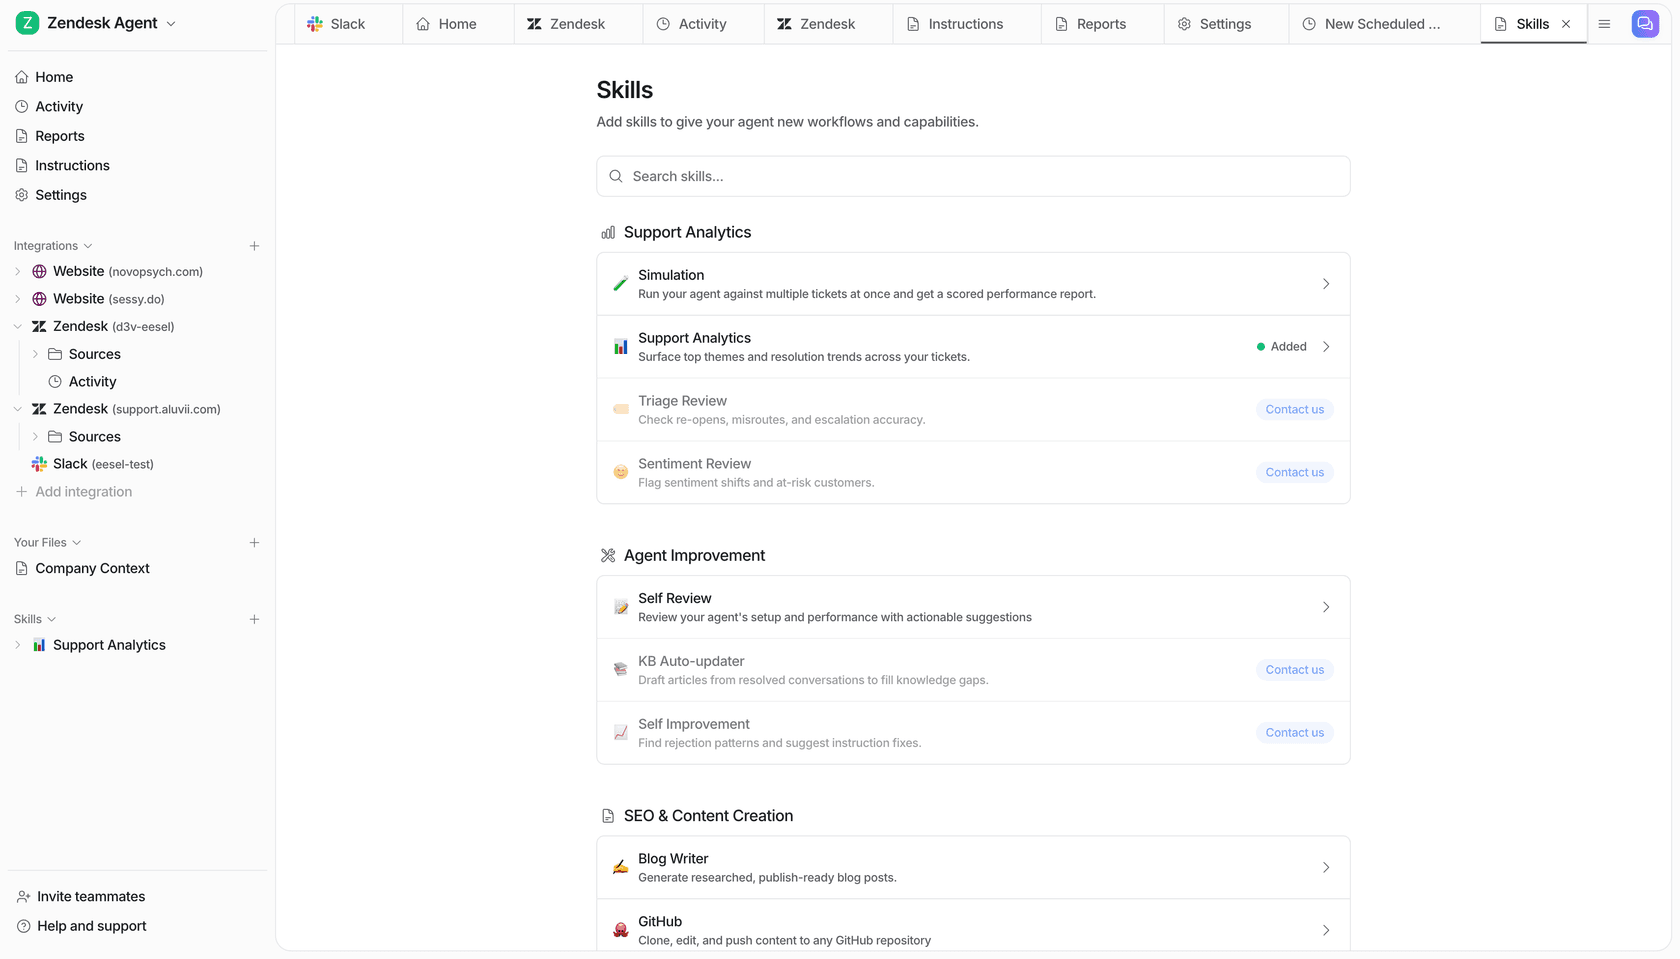
Sur chaque ticket, il peut étiqueter la conversation, définir des champs comme la priorité, laisser une note interne et router vers une personne selon vos propres instructions, "for example low confidence or an angry customer" (documentation eesel). Le tri démarre dès le premier message du client, avant que personne n'ait répondu. À l'échelle des tickets, le skill de tendances de tickets rapporte "Recurring topics, sentiment, volume and resolution patterns", à la fréquence de votre choix, par exemple chaque lundi matin (Skills). Un skill Sentiment Review dédié aux clients à risque est disponible sur demande.

Chaque action peut être réglée sur automatique ou sur approbation requise, et le journal d'activité montre ce que l'agent a lu et pourquoi il a signalé quelque chose, ce qui répond à la question "puis-je lui faire confiance aveuglément ?" par "vous n'avez pas à le faire". Si vous préférez envoyer les alertes vers votre propre modèle de santé, la CLI eesel affiche du JSON pour chaque commande, donc un script ou un agent de code comme Claude Code peut récupérer activité et approbations directement dans votre CRM.
Une remarque honnête avant de vous lancer : à cause de la règle de Meta d'une IA par numéro, vous feriez tourner eesel ou Meta Business Agent sur un numéro WhatsApp donné, pas les deux. Si WhatsApp est votre seul canal et que vous avez des ingénieurs pour construire la couche de scoring, l'agent de Meta plus les webhooks standby est un choix correct. Si les conversations viennent de partout, les tarifs d'eesel sont un forfait mensuel fixe de crédits, avec un niveau gratuit de 100 crédits et des forfaits à partir de 299 $ pour 500, et vous pouvez le tester sur vos anciens tickets avant qu'il ne parle à qui que ce soit.
Questions fréquentes
Puis-je utiliser Meta Muse pour le suivi de la santé client ?
Meta Business Agent fait-il de l'analyse de sentiment ?
Puis-je envoyer une enquête CSAT sur WhatsApp ?
Que m'apprend la note de qualité WhatsApp sur la santé client ?
Puis-je faire en sorte que Meta Business Agent escalade les clients en colère ?
Combien coûte Meta Muse pour le suivi de la santé client ?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.





Comment récupérer les transcriptions de Meta Business Agent dans mon CRM ?