

L'IA pour la communication d'incident majeur fonctionne quand vous tenez un seul registre d'incident vérifié et que chaque canal y puise ses réponses : la page de statut, les réponses aux tickets, la macro de vos agents, les e-mails aux grands comptes et le canal interne. L'IA rédige chaque mise à jour, une personne nommée (votre responsable d'incident ou de la communication) valide tout ce qui est public, et une mise à jour part toutes les 30 minutes, l'objectif fixé par incident.io pour les incidents majeurs.
L'IA qui répond seule aux tickets ne doit toucher que les tickets rattachés à un incident déclaré, et uniquement avec des mots repris de la dernière mise à jour validée. Pas d'heures de rétablissement inventées, pas de suppositions sur la cause racine, pas de « vos données sont en sécurité ». Prévoyez ensuite la seconde vague après la résolution : réponses « c'est vraiment réparé ? », demandes de rapport et demandes de crédit SLA.
Je construis les intégrations helpdesk d'eesel, et le coéquipier IA pour helpdesk sur lequel je travaille fait cela dans Zendesk, Freshdesk et Gorgias : il étiquette les tickets de panne, rédige les réponses à partir de la mise à jour validée et transmet directement les pannes et les pertes de données à une personne, comme le fait Qontro sur Freshdesk. Les plans démarrent à 299 $ par mois pour 500 crédits.
Pourquoi les clients entendent-ils des choses différentes pendant une panne ?
Parce que chaque personne répond avec ce qu'elle sait à cet instant, et que toutes savent des choses différentes. Un agent sur le ticket #4012 a lu la page de statut il y a dix minutes. Un responsable de compte a entendu quelque chose dans un fil Slack. Un ingénieur a dit à un grand client « ce sera réparé dans une heure ». La page de statut elle-même n'a pas bougé depuis la première publication. Personne ne ment. Ils répondent simplement à partir d'instantanés différents.
Le centre d'aide de Freshdesk le décrit bien. Dans son guide des tickets liés, il note que pendant une indisponibilité, différents clients reçoivent des mises à jour à des intervalles différents, "based on the persistence of the customer and the workload of the agent." Le client qui écrit quatre fois reçoit quatre mises à jour. Celui qui écrit une fois reçoit le silence.
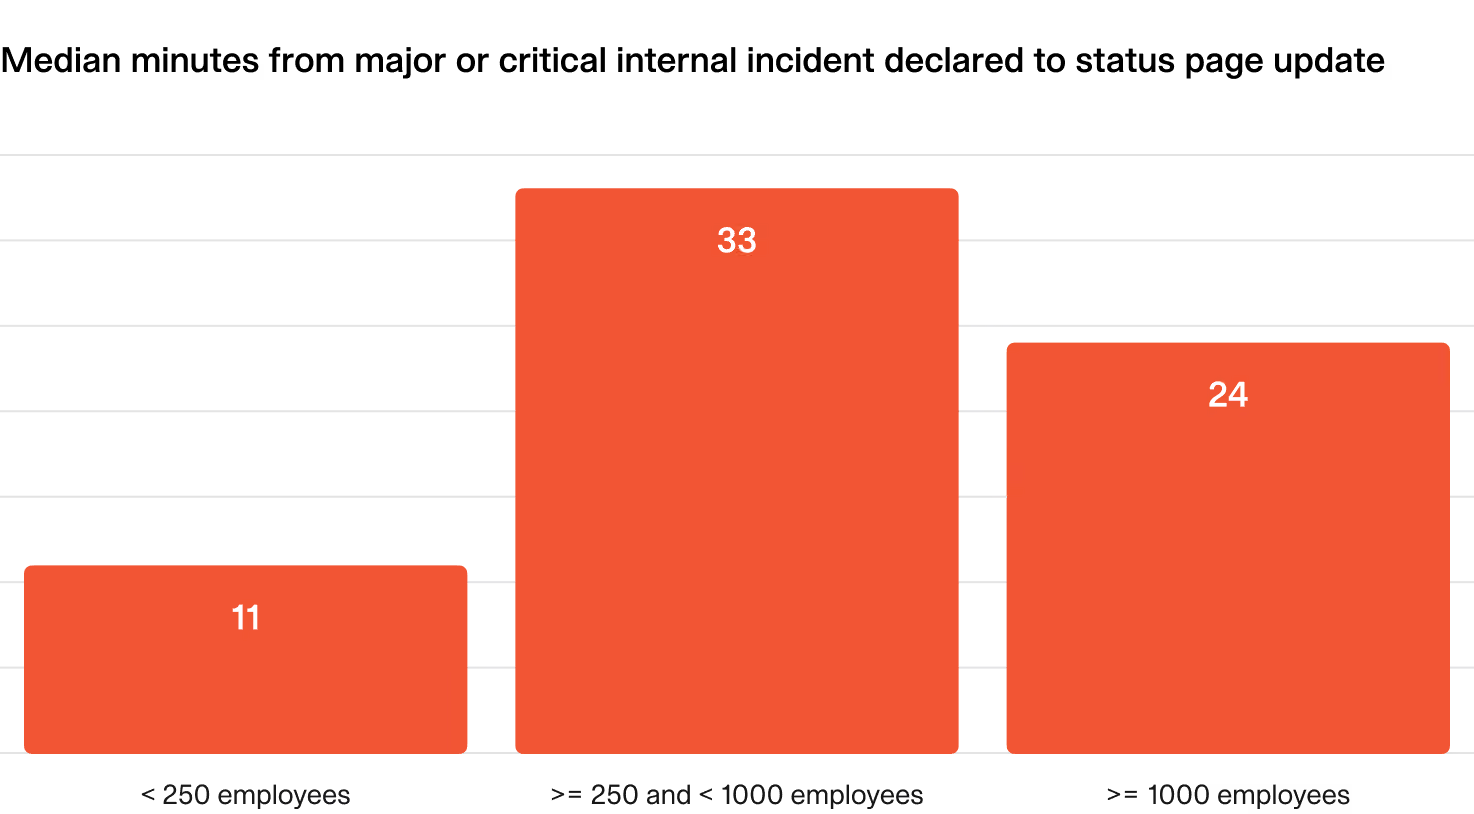
La lenteur de la première mise à jour aggrave les choses. Le rapport sur la bonne gestion des incidents d'incident.io a constaté que les entreprises de 250 à 1 000 employés mettaient une médiane de 33 minutes entre la déclaration d'un incident majeur et leur première publication sur la page de statut, soit plus lentement que les plus petites comme les plus grandes. C'est pendant cette demi-heure que les tickets s'accumulent et que les versions des faits divergent.
Ceux qui pilotent l'incident le ressentent aussi de l'intérieur. Un SRE a demandé de l'aide sur Reddit pour exactement cela :
"When stuff is finally resolved, I have to parse through slack to see what happened when, ignore the "what's the status" slacks sent by 15 different random people, build a timeline with my investigation steps, etc."

La solution n'est donc pas « écrire plus vite ». C'est de donner à tout le monde un seul endroit où lire, et de laisser l'IA faire la réécriture pour chaque public. Je lirais aussi mon guide sur l'IA de support pendant les pannes SaaS en parallèle de celui-ci : cet article traite de l'afflux de tickets, mon guide sur l'IA pour les mises à jour de la page de statut traite de la page de statut elle-même, et celui-ci traite de ce que vous dites sur chaque canal et de qui le dit.
Sur quoi chaque canal doit-il s'appuyer pour répondre ?
Sur un seul registre d'incident, écrit en mots simples, dont une personne est responsable et qu'elle met à jour. Pas le canal Slack de l'ingénierie, pas l'appel de la cellule de crise, pas la mémoire de quelqu'un. Limitez-le à quatre champs :
- Ce qui est touché : les zones de produit, régions ou groupes de clients, dans les mots de vos clients (« le paiement sur l'application web »), pas en noms de services (« payments-api-v2 »).
- Faits vérifiés : uniquement ce que les ingénieurs ont confirmé. « Certains paiements par carte échouent » est un fait. « Un mauvais déploiement en est la cause » est une supposition tant que personne ne l'a confirmé.
- Ce que nous faisons : une ligne. « Retour arrière sur la version de 14 h 10 » suffit.
- Prochaine mise à jour à : une heure précise, à chaque fois.
Ce registre peut vivre dans votre outil d'incident (incident.io, PagerDuty, Jira Service Management) ou sur la page de statut elle-même. Où il se trouve compte moins que la règle selon laquelle chaque message à quiconque est réécrit à partir de lui, jamais à partir d'une conversation annexe.
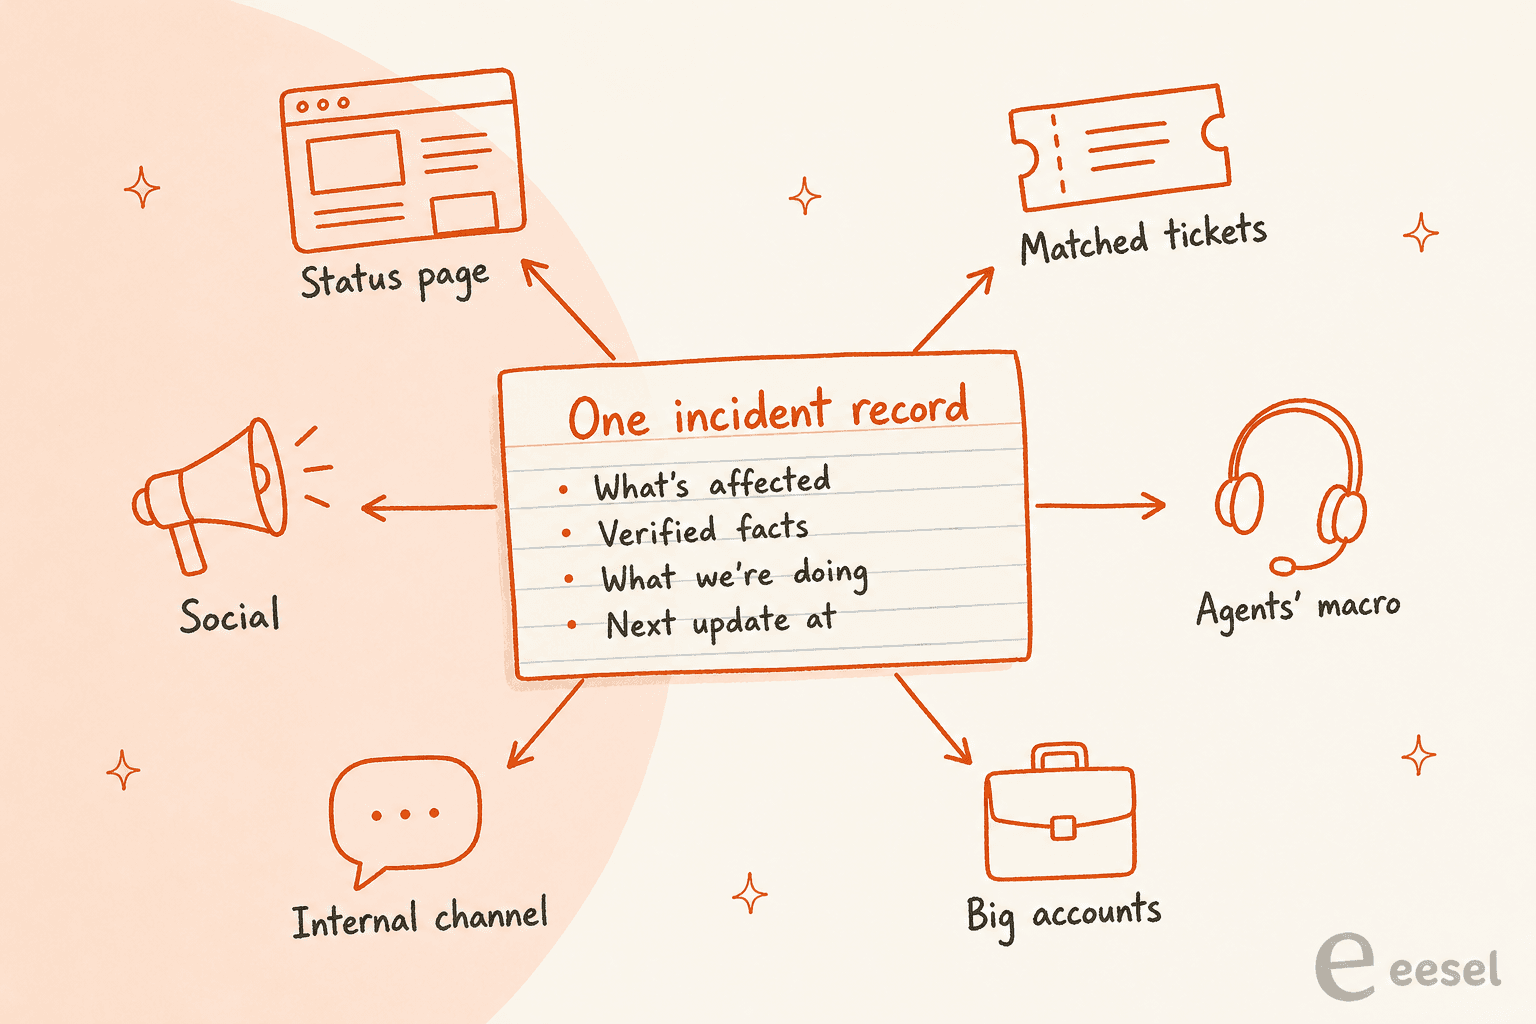
Les flèches ne vont volontairement que vers l'extérieur. Si un client signale quelque chose de nouveau dans un ticket (« c'est aussi cassé sur mobile »), cela remonte au responsable de la communication, qui le vérifie et l'ajoute au registre. Cela ne saute pas directement dans la réponse à un autre client. Cette seule règle est ce qui empêche le canal numéro six de s'éloigner du canal numéro un.
Qui est responsable de la communication d'incident, et où l'IA s'intègre-t-elle ?
Une personne qui n'est pas en train de réparer le problème. Les ingénieurs qui déboguent la production ne devraient pas peaufiner des excuses. Cela revenait sans cesse quand j'ai lu comment les exploitants s'y prennent :
"Someone not directly working the incident owns comms. gets updates from the team, tracks timelines, and updates the dedicated status page/notification channels."
Le rapport d'incident.io donne le même conseil en termes plus simples : "Assign communications roles", pour que l'on sache clairement qui est responsable des mises à jour de la page de statut. L'IA se place sous cette personne, pas à côté d'elle. Elle transforme le registre en cinq versions pour cinq publics, et le responsable de la communication relit et valide. C'est le human in the loop dans sa forme la plus simple, et le guide de communication d'incident.io trace la même ligne : l'IA doit aider à rédiger plutôt qu'envoyer des messages externes sans qu'une personne les relise.
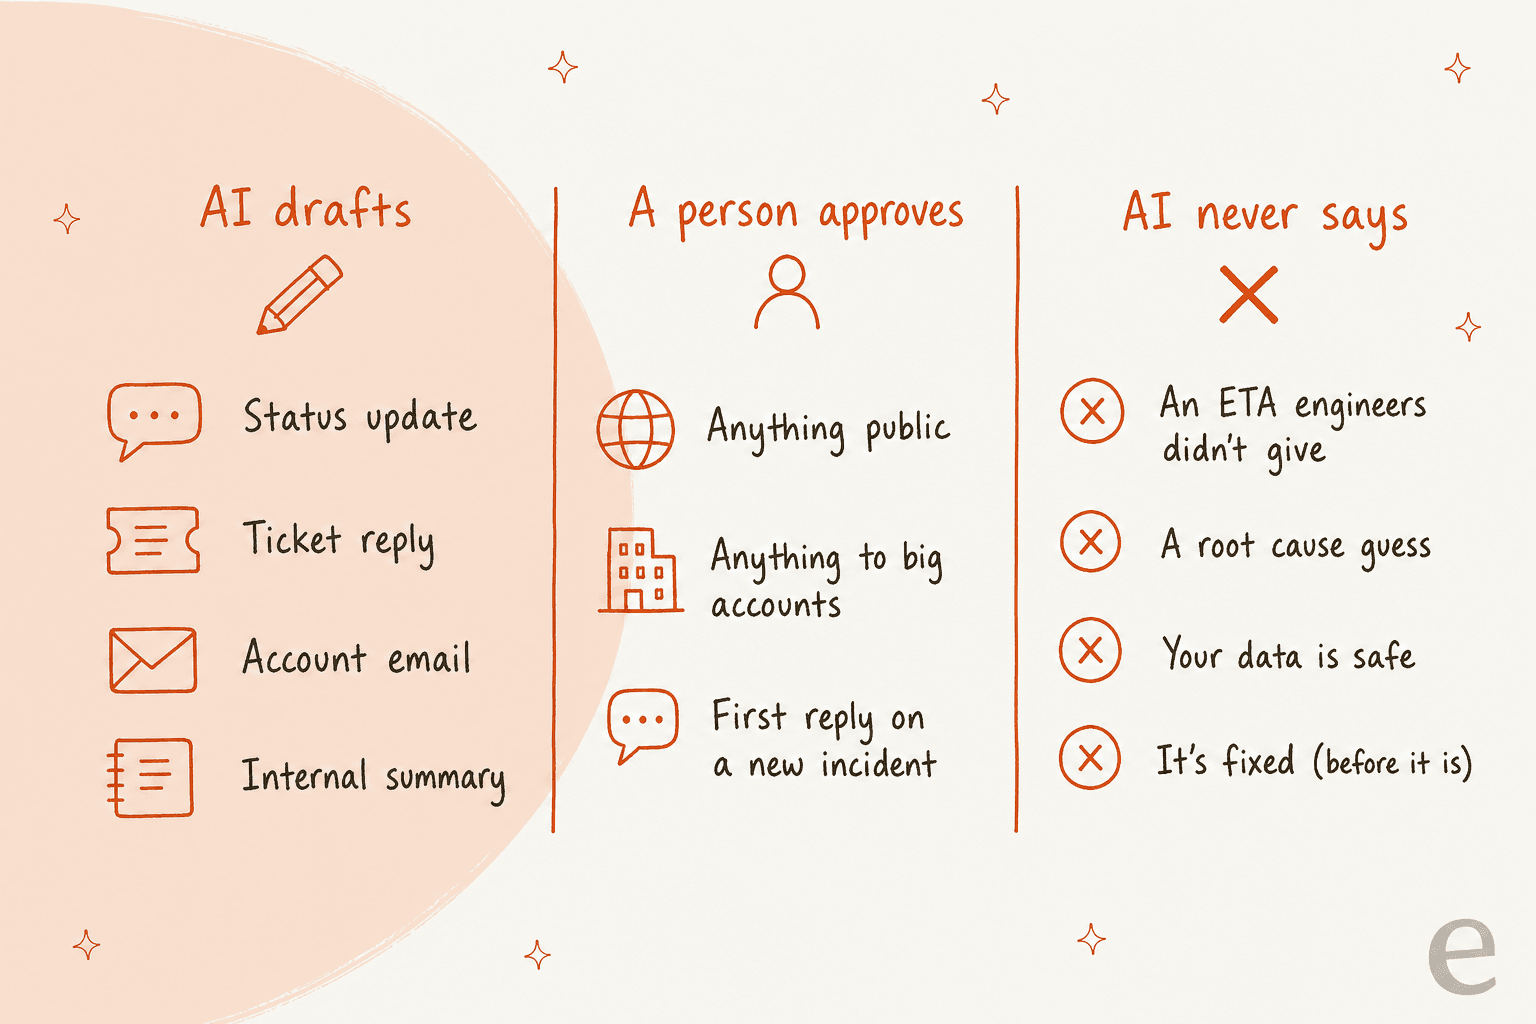
La colonne de droite est celle que j'imprimerais. Chacune de ces quatre lignes est une phrase qu'un modèle de langage écrira volontiers si le prompt le pousse un peu, car ce sont exactement les choses qu'un client inquiet veut entendre. Une hallucination de l'IA dans un ticket ordinaire coûte un client. La même phrase dans une réponse d'incident part vers des centaines de personnes à la fois, et c'est la ligne dont elles feront une capture d'écran.
À quelle fréquence envoyer les mises à jour d'incident ?
Toutes les 30 minutes pour un incident majeur, même quand rien n'a changé. C'est l'objectif du rapport d'incident.io, qui dit de "aim to share status page updates every 30 minutes during major and critical incidents." Ses données montrent que la plupart des équipes s'en approchent.
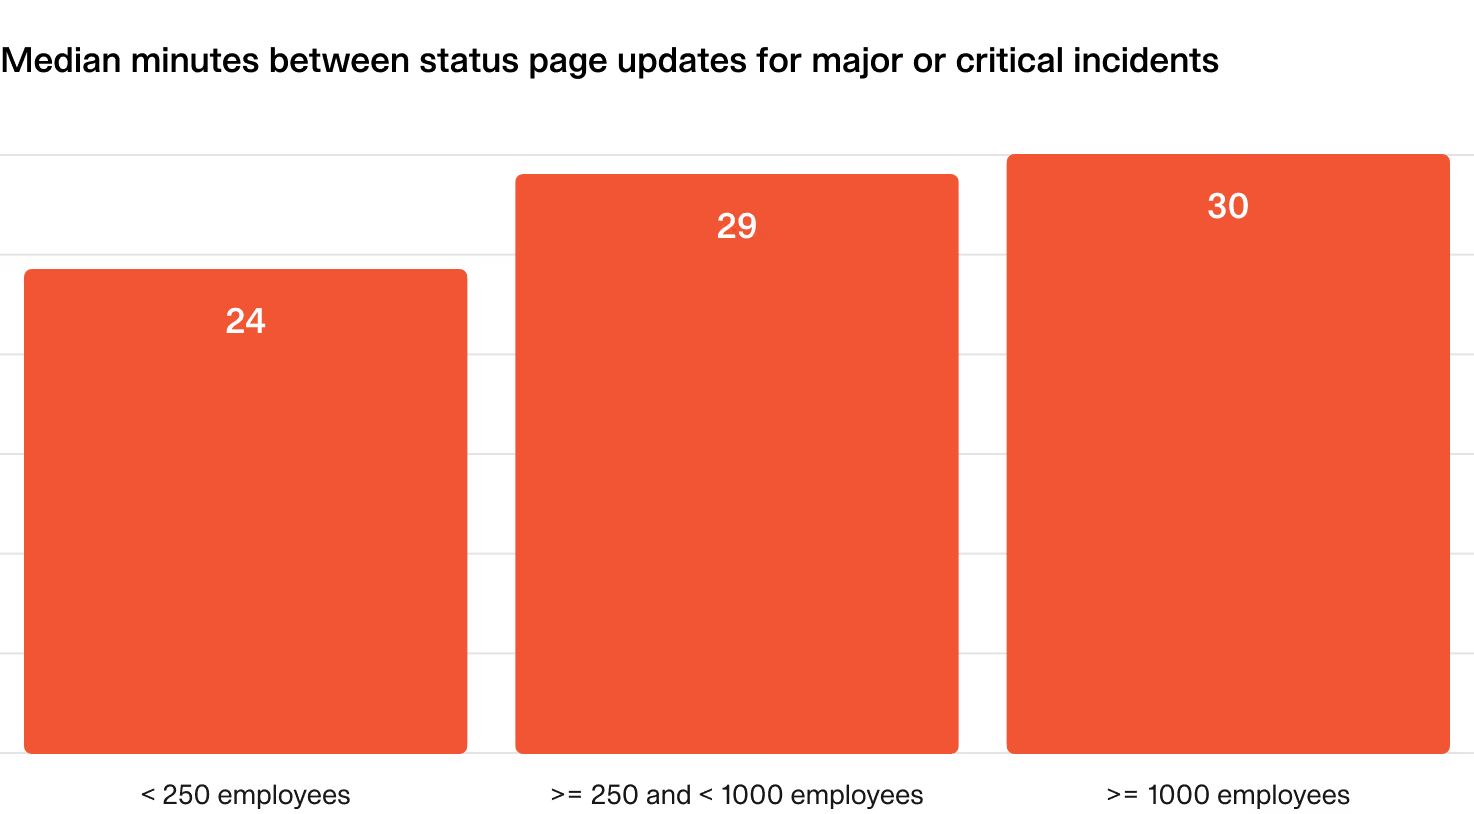
Le guide d'incident.io appelle la mise à jour vide la règle du « battement de cœur » : "We're still investigating. No new information. Next update in 30 minutes." Cela ne semble rien, mais ça fait un vrai travail. Un client qui sait que la prochaine mise à jour tombe à 15 h 30 n'ouvre pas de ticket à 15 h 20. Son guide de communication suggère de moduler le rythme selon la gravité : toutes les 20 à 30 minutes pour un SEV1, toutes les 4 heures pour un SEV2, et des mises à jour en heures ouvrées pour un SEV3.
C'est la tâche la plus facile à confier à l'IA. La mise à jour de battement de cœur est ennuyeuse, c'est celle que l'on oublie à la 45e minute d'un mauvais incident, et elle ne présente presque aucun risque puisqu'elle ne dit rien de nouveau. Laissez l'IA la rédiger à partir du registre et relancer le responsable de la communication quand elle est due. Le plan ci-dessous montre ce dont chaque niveau de gravité a besoin, pour que vous vous accordiez avant le prochain incident plutôt que pendant.
Comment garder les agents et l'IA sur le même discours ?
Donnez au support les mêmes mots que ceux de la page de statut, et facilitez la recherche de tous les tickets liés à l'incident. Les deux grands helpdesks ont déjà la plomberie pour la seconde partie. Ce que chacun en fait mérite d'être connu en détail, car j'ai vu des équipes supposer plus que ce que la fonctionnalité fait réellement.
Tickets de problème et d'incident Zendesk. Dans la documentation de Zendesk, vous créez un ticket de problème pour la panne, réglez le type de chaque ticket associé sur incident et vous les liez. Quand vous résolvez le ticket de problème, chaque ticket d'incident lié est résolu, et le commentaire que vous écrivez sur le ticket de problème est ajouté aux tickets d'incident encore ouverts. Deux réserves sur la même page : "Customers are not notified using the messaging channel" et "AI agent tickets can't be linked to problem and incident tickets." Si la moitié de votre trafic de panne passe par le bot de Zendesk lui-même, la clôture en masse ne l'atteindra donc pas. Mon guide sur les tickets d'incident et de problème détaille la configuration, et les mises à jour de statut en masse comblent les trous.
Tickets liés Freshdesk. Freshdesk lie les tickets associés à un ticket maître appelé tracker. Les commentaires sur le tracker sont diffusés à chaque ticket lié, mais le guide de configuration indique que le "internal broadcast message will be visible only to agents of the helpdesk." Les clients ne le voient pas. Chaque agent envoie toujours lui-même la vraie réponse. Et résoudre le tracker ne résout pas les tickets liés par défaut. Les tickets liés nécessitent le plan Pro ou Enterprise.
C'est le vide que l'IA comble bien. La fonctionnalité du helpdesk vous donne la liste de tous les tickets sur la panne. L'IA transforme la dernière mise à jour validée en réponse sur chacun, dans la langue du client, sans que personne ne copie-colle 300 fois. L'étiquetage compte aussi ici : un exploitant sur r/sre a résumé le geste de base.
"support tools like zendesk allow you to add tags to tickets related to the same issue via a "master" ticket"
Une étiquette comme incident-2026-10-30-checkout sur chaque ticket rattaché permet de tous les clôturer plus tard, de les compter pour le rapport post-incident et de repérer les clients qui ont écrit trois fois. Si vous n'avez pas encore mis en place l'étiquetage de tickets par IA, une panne est un moment pénible pour découvrir que vous en avez besoin. Il en va de même pour la déduplication de tickets, puisque les tickets de panne arrivent par paquets des mêmes personnes.
Mettez à jour la macro que vos agents humains utilisent en même temps que la page de statut. Une macro IA qui dit encore « nous enquêtons » une heure après la livraison du correctif, c'est ainsi qu'un client reçoit deux réponses différentes dans le même après-midi.
Quand l'IA doit-elle répondre seule pendant un incident ?
Seulement quand trois conditions sont réunies : quelqu'un a déclaré l'incident, le ticket y correspond clairement et la réponse utilise une formulation qu'une personne a déjà validée. S'il en manque une, l'IA rédige et une personne envoie. C'est toute la règle, et elle couvre presque tous les cas.
Voici comment je trierais les tickets entrants pendant un incident majeur :
| Le ticket | Ce que fait l'IA | Pourquoi |
|---|---|---|
| Correspond à un incident déclaré | Répond avec la dernière mise à jour validée et l'heure de la prochaine, l'étiquette et le lie | Les mots ont déjà été vérifiés une fois |
| Ressemble à une panne, rien de déclaré | Laisse une note interne et prévient l'équipe d'astreinte, ne confirme rien | Ce peut être le premier signe d'un vrai incident, ou le wifi d'un client |
| D'un grand compte ou cite un contrat | Le transmet au responsable du compte avec un résumé | Ces clients attendent une personne et une voie d'escalade |
| Signale une perte de données, une inquiétude de sécurité ou un double prélèvement | Directement à une personne, pas de réponse | Une seule mauvaise phrase ici est un problème juridique |
| Sans rapport avec la panne | File normale | Ne laissez pas l'incident avaler tout le reste |
Deux de ces cas viennent directement de configurations réelles. Qontro, une entreprise d'ERP sur Freshdesk, rédige une réponse sur chaque nouveau ticket (190 en un mois) mais envoie les pannes, les pertes de données et les questions de facturation directement à une personne, et quand un ticket ne contient pas assez d'éléments pour répondre avec confiance, l'agent le dit plutôt que de deviner. SE Ranking fait tourner eesel sur 4 650 conversations Zendesk par mois et étiquette chaque ticket qu'il touche avec ai_handled, pour que l'équipe puisse compter exactement ce que l'IA a fait. Sa règle de transfert convient aussi bien aux jours d'incident : l'agent dit aux clients d'attendre une réponse sous un à deux jours ouvrés et ne dit jamais que quelqu'un les rejoint tout de suite.
Ce dernier point est une cicatrice pour moi. J'ai vu un bot dire à des clients qu'il les passait à une personne alors que le transfert n'avait jamais lieu, dans une société d'hébergement web sur Zendesk. Pendant une panne, ce genre de fausse promesse double la colère. Donc tout ce que votre IA dit sur les prochaines étapes doit correspondre à ce que votre système fait réellement. Mon article sur les bonnes pratiques de transfert explique comment le tester avant d'en avoir besoin, et les tests de simulation permettent de rejouer les tickets de panne du trimestre dernier avec les nouvelles règles au préalable.
Un dernier piège : les réponses d'incident de l'IA doivent s'arrêter dès qu'une personne reprend le fil. ClutchLoop fait tourner son agent sur Gorgias avec exactement cette règle : si un membre de l'équipe répond déjà dans un fil, l'agent reste à l'écart. Pour les grands comptes avec un responsable de compte sur le ticket, c'est le comportement voulu.
Que fait vraiment l'IA des outils d'incident et de helpdesk ?
L'essentiel de l'IA dans les outils d'incident vise les ingénieurs : résumés, chronologies, post-mortems. Peu de fonctionnalités touchent aux messages clients, et celles qui le font sont des outils de rédaction avec une personne qui relit. Voici ce que disent les pages de chaque éditeur, avec leurs prix.
| Outil | IA pour la communication d'incident | Page de statut | Prix (page de l'éditeur) |
|---|---|---|---|
| Atlassian Statuspage | Aucune indiquée sur la page des tarifs | Oui, c'est le produit principal | Free (100 abonnés), Hobby 29 $, Startup 99 $, Business 399 $, Enterprise 1 499 $ par mois |
| incident.io | Fonctions IA dont Scribe et Suggestions, plus un éditeur de post-mortem natif IA dans Pro et Enterprise | 1 page publique dans Basic, Team et Pro, pages clients dans Enterprise | Basic gratuit, Team 19 $ par utilisateur et par mois, Pro 25 $, plus astreinte de 10 à 20 $ par utilisateur |
| PagerDuty | AI Status Updates rédige des mises à jour internes et externes, les intervenants relisent avant envoi | Page externe à partir de Professional (250 abonnés) | Professional 21 $ par utilisateur et par mois en annuel, IA en option ; Starter 2 800 $ par an avec 1 000 actions IA |
| Jira Service Management | Agents Rovo à partir de Standard ; création d'incident par IA et brouillons de revue post-incident dans Premium | Plan Enterprise uniquement | Standard 21,50 $, Premium 55,28 $ par agent et par mois |
| Zendesk | Copilot (résumés, suggestions de fusion, tickets similaires), agents IA facturés à la résolution automatisée | Non | Suite Team 55 $, Professional 115 $ par agent et par mois en annuel ; Copilot 50 $ par agent et par mois |
| Freshdesk | Freddy AI Agent (500 sessions incluses, puis 49 $ les 100), Copilot 29 $ par agent et par mois | Non | Growth 19 $, Pro 55 $, Enterprise 89 $ par agent et par mois en annuel |
| eesel | Rédige ou envoie des réponses dans votre helpdesk, étiquette et lie les tickets, validations par action | Non, lit la vôtre | 299 $ par mois pour 500 crédits, un ticket égale un crédit |
Quelques détails qui comptent plus que la colonne des prix. La documentation de PagerDuty indique qu'AI Status Updates ne peut rédiger des mises à jour externes que depuis Slack ; dans Microsoft Teams et l'application web, ce ne sont que des mises à jour internes. Dans Jira Service Management, la "incident stakeholder communication" (inviter et envoyer des e-mails aux parties prenantes internes et externes) est une fonction Premium, donc le plan Standard ne l'inclut pas. Plus de détails dans mon analyse des tarifs de JSM et dans l'article sur les revues post-incident par IA.
Côté helpdesk, ni Zendesk Copilot ni Freddy AI ne connaissent votre incident si personne ne le leur dit. Ils travaillent à partir des tickets et des articles d'aide, et votre registre d'incident vit dans un autre outil. Relier les deux est le vrai travail.
Tous les détails des plans figurent dans mes guides des tarifs de Zendesk et des tarifs de Freshdesk.
Comment relier le registre d'incident au helpdesk ?
Envoyez chaque mise à jour de statut de votre outil d'incident à l'IA qui répond aux tickets, sous forme de données. C'est la partie sur laquelle je passe mes journées, voici donc la version simple de son fonctionnement.
Statuspage peut envoyer chaque mise à jour d'incident vers une URL. Ses notifications par webhook sont des requêtes HTTP POST portant la mise à jour de l'incident ou du composant, et elles sont disponibles à partir du plan Startup (99 $ par mois). Voici le genre de mise à jour que ces charges utiles transportent :
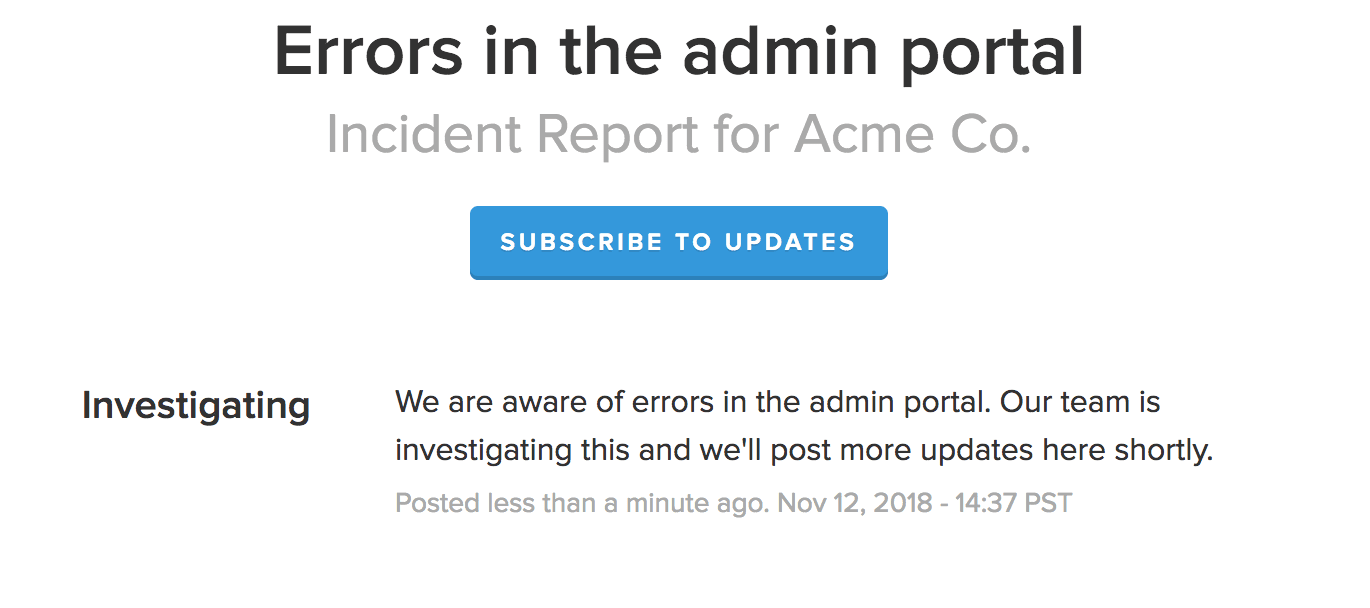
Côté eesel, une automatisation par webhook vous donne une URL privée vers laquelle n'importe quel service peut envoyer du JSON en POST, et l'agent se réveille avec ces données et suit les instructions que vous lui avez écrites. Vous pointez donc le webhook Statuspage vers cette URL et vous dites à l'agent : "When an incident update arrives, save the latest approved text as the current incident status. On new tickets that match it, reply with that text and the next update time, add the incident tag, and leave everything else for a person." Cela fonctionne de la même façon depuis incident.io ou PagerDuty via leurs propres webhooks ou Zapier. eesel n'a pas d'intégration native avec Statuspage, le webhook est donc la voie à suivre.
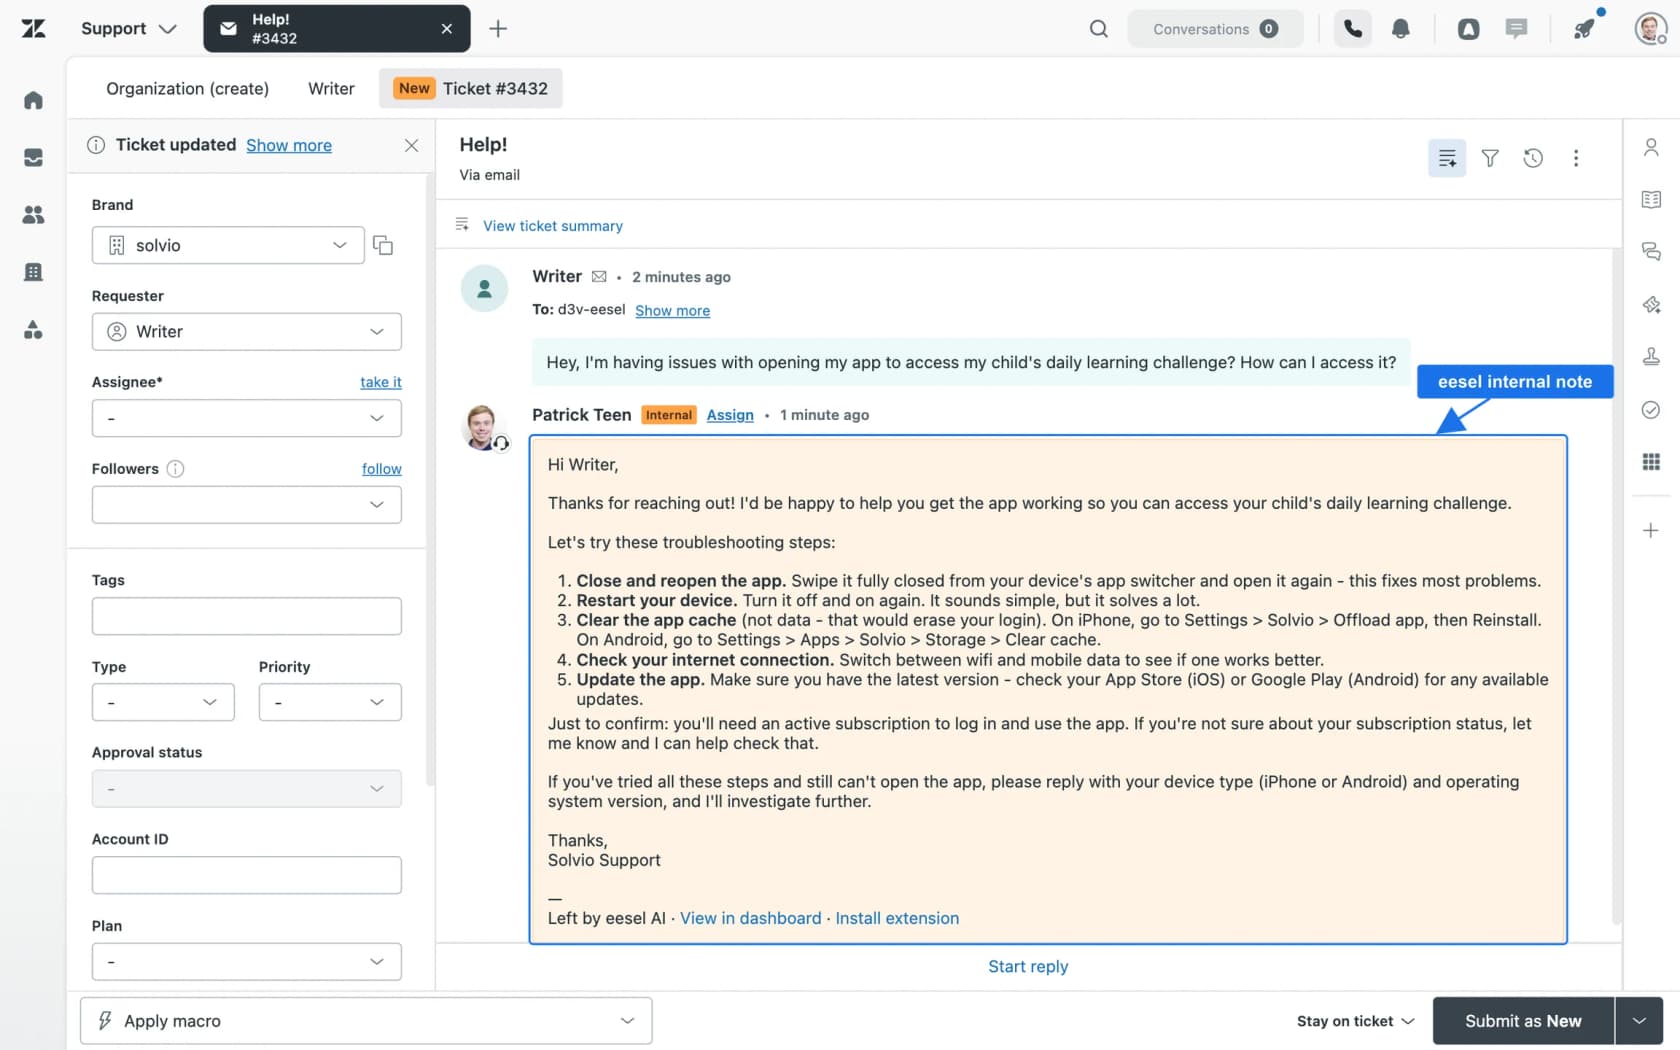
Dans Zendesk, les actions eesel qui comptent un jour d'incident sont : rédiger une réponse de ticket (retenue jusqu'à validation par une personne), laisser une note interne, ajouter des étiquettes, rechercher des tickets et mettre à jour des champs comme le statut ou la priorité. Chaque action peut être réglée pour s'exécuter seule, nécessiter une validation ou être désactivée. Le premier jour, je mettrais "Send ticket reply" en validation, et "Add tags" et "Leave internal note" en automatique.
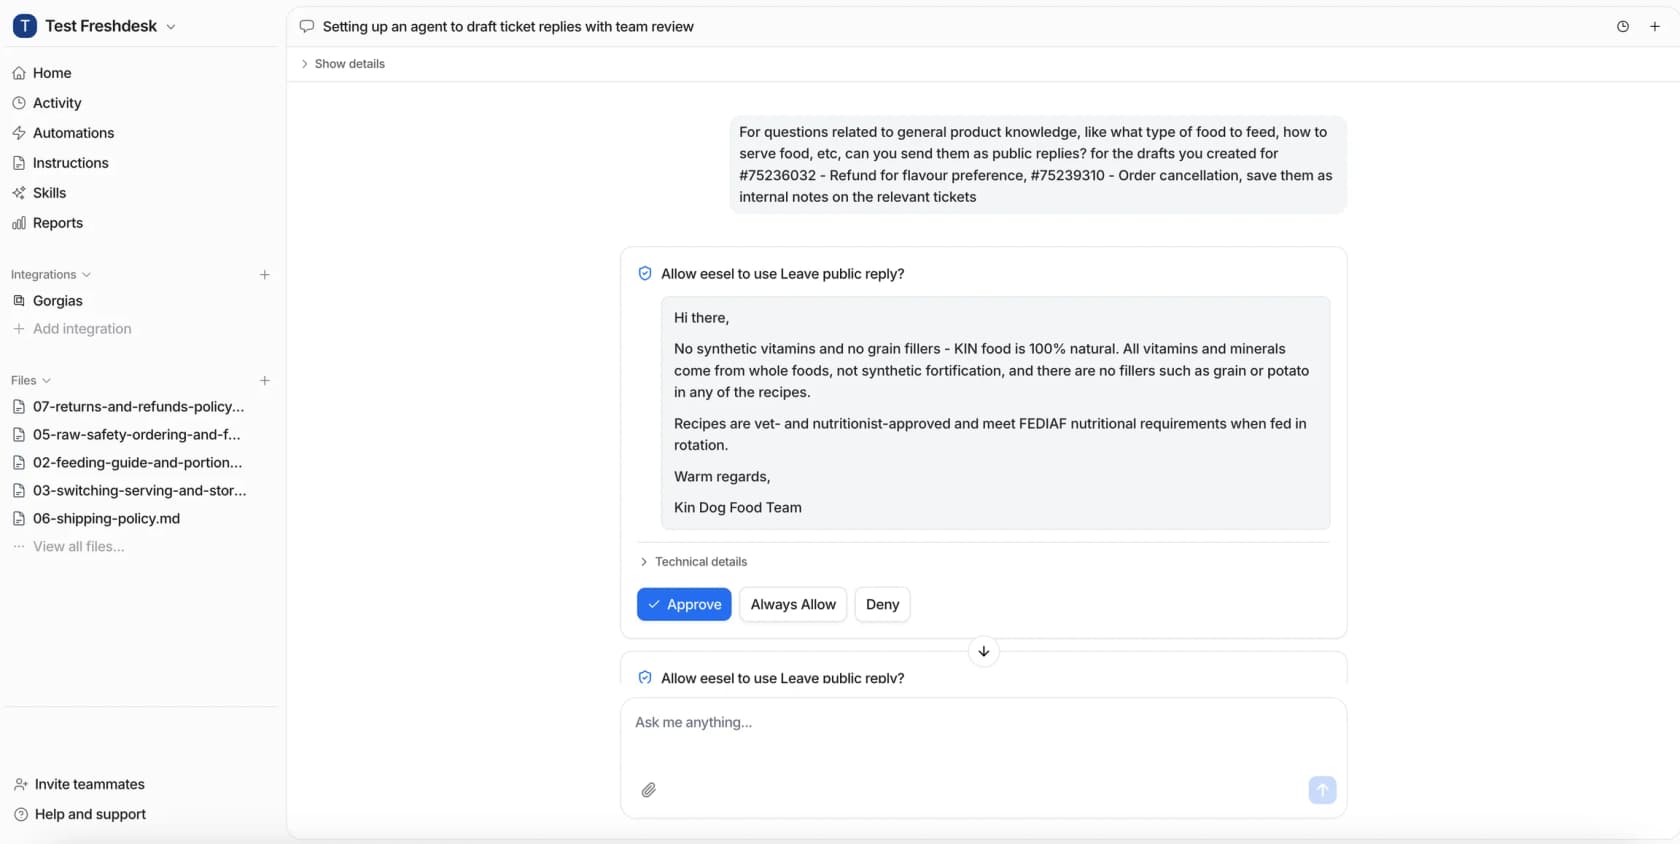
Les validations n'ont pas à se faire dans le tableau de bord. Si l'exécution a démarré depuis Slack, la carte de validation arrive dans ce fil, et votre responsable de la communication peut donc valider les réponses depuis le canal qu'il surveille déjà. Si votre responsable d'incident vit dans un terminal, la CLI d'eesel fait le même travail : eesel approvals liste ce qui attend et eesel approvals approve <id> l'envoie. Cela signifie aussi qu'un agent de code comme Claude Code ou un script de votre runbook d'incident peut consulter la file à votre place. Rien ne change dans l'agent entre le tableau de bord, Slack et le terminal. C'est le même coéquipier avec les mêmes permissions.
Que se passe-t-il après la résolution de l'incident ?
Une seconde vague de tickets, que la plupart des équipes ne prévoient pas. La page de statut passe à résolu, tout le monde souffle, puis la boîte de réception se remplit d'un autre type de message.
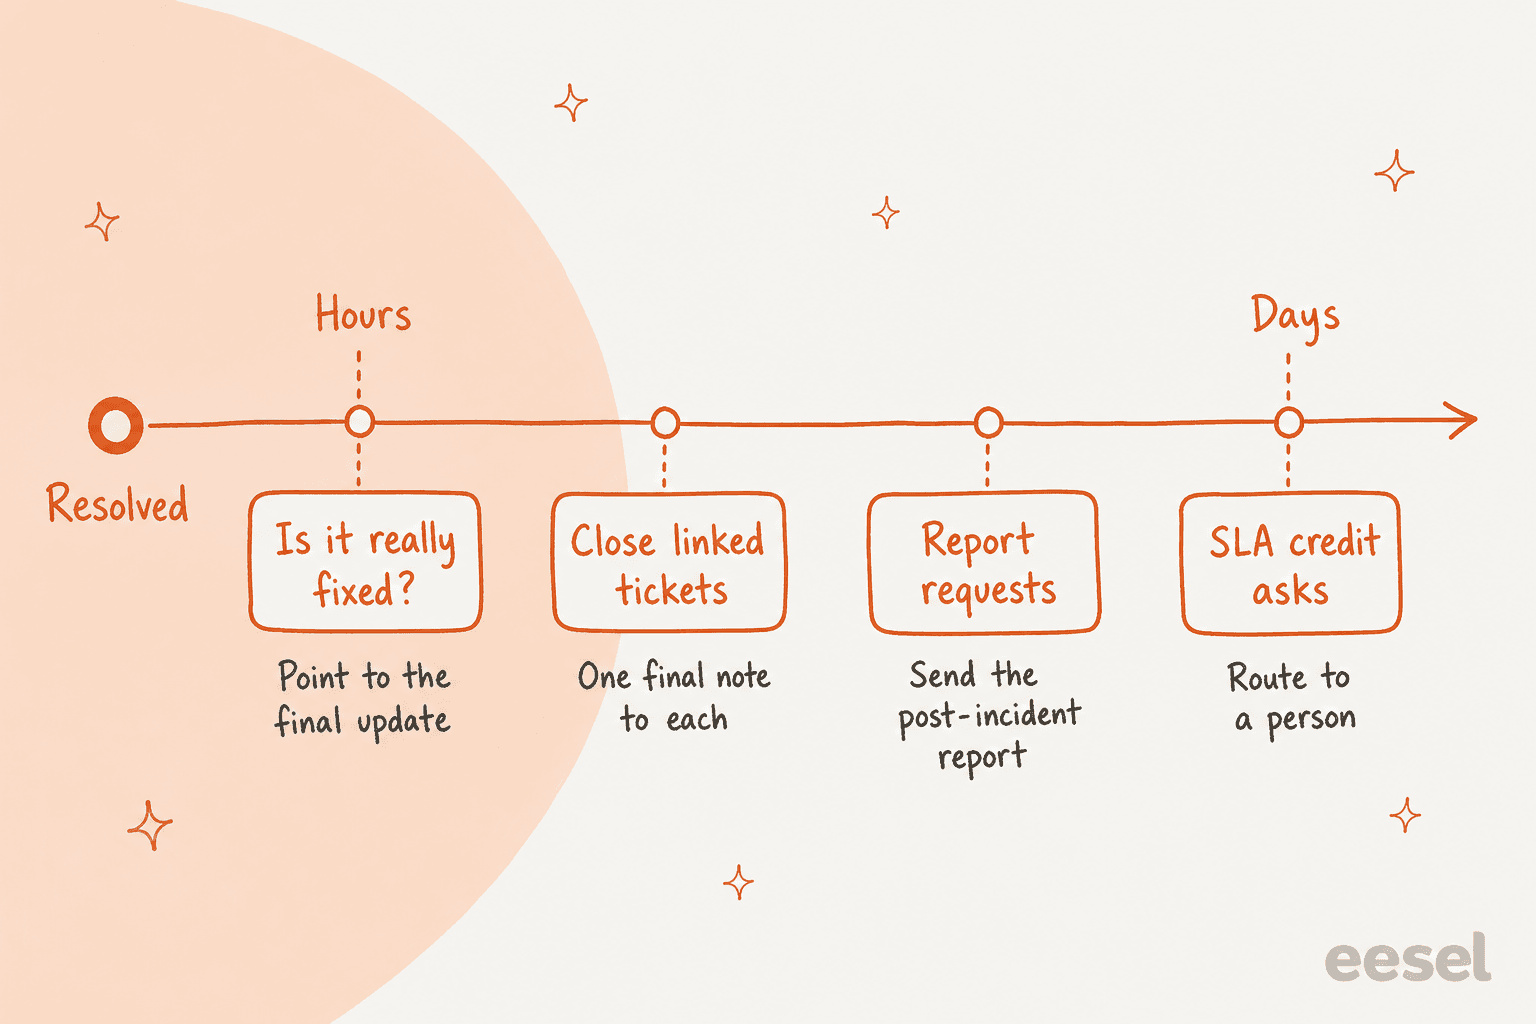
Voici ce qui arrive, à peu près dans l'ordre :
- « C'est vraiment réparé ? » Ces messages arrivent en quelques heures, souvent de clients qui n'ont jamais vu la publication de résolution. L'IA peut y répondre avec le texte de la mise à jour finale et une phrase les invitant à répondre s'ils voient encore le problème. Un vrai « c'est toujours cassé pour moi » va à une personne, car cela peut signifier que le correctif n'a pas atteint tout le monde.
- Clôturer chaque ticket lié. Envoyez une dernière note à chaque ticket étiqueté avec l'incident, pas seulement à ceux qui sont encore ouverts. Dans Zendesk, résoudre le ticket de problème fait l'essentiel. Dans Freshdesk, vous résolvez les tickets liés vous-même ou vous faites publier la dernière note par l'IA sur chacun. Surveillez votre taux de réouverture les jours suivants, car il vous dit si le message « réparé » est bien passé.
- Demandes de rapport post-incident. Les gros clients demandent le compte rendu, souvent pour leur propre conformité. Gardez la liste de ceux qui l'ont demandé pendant l'incident (l'étiquette le facilite) et envoyez-leur tous le rapport à sa publication. Ne laissez pas l'IA résumer la cause racine avant que vos ingénieurs ne la publient.
- Demandes de crédit SLA. Ce sont des questions contractuelles où de l'argent est en jeu. Orientez-les vers une personne avec le plan du client et les heures de début et de fin de l'incident jointes, comme je traiterais des litiges de facturation.
Cette vague est aussi l'endroit où l'on apprend le plus. Comptez les tickets étiquetés, combien sont arrivés avant la première publication de statut et combien demandaient « une mise à jour ? ». Ces trois chiffres vous disent si votre première publication était lente, si votre rythme a tenu et par où commencer la prochaine fois. Le reporting support par IA peut les extraire pour vous.
Bien faire cela compte au-delà de la journée elle-même. Comme l'a dit un fondateur sur r/SaaS :
"if you wait until an outage to figure this out it’s already chaos, so even a simple status page plus a prewritten we’re investigating template and one owner for updates goes a long way because trying to debug while replying to tickets in real time is how small issues turn into trust problems fast"
La confiance est aussi la raison pour laquelle je relierais cela à votre travail sur la perte de clients. Les clients qui ont écrit pendant une panne sont les plus susceptibles de peser un changement ensuite, et un suivi personnel de leur responsable de compte une semaine plus tard coûte très peu.
Comment tout mettre en place avant la prochaine panne ?
Faites-le un mardi calme, pas à 2 h du matin. Voici l'ordre que je suivrais :
- Nommez la rotation des responsables de la communication. Une personne par équipe qui n'est pas d'astreinte côté ingénierie. Inscrivez-la à côté de votre planning d'astreinte.
- Rédigez le modèle de registre d'incident. Les quatre champs : ce qui est touché, faits vérifiés, ce que nous faisons, prochaine mise à jour à.
- Faites pré-valider les formulations. Publications « Investigation en cours », « Cause identifiée », « Surveillance », « Résolu », plus une réponse de ticket et un e-mail aux comptes pour chacune. Le rapport d'incident.io recommande des modèles pré-validés pour les incidents courants précisément pour cette raison.
- Activez la liaison de tickets. Tickets de problème et d'incident dans Zendesk, ou tickets liés dans Freshdesk, plus un format d'étiquette pour chaque incident.
- Connectez l'IA avec les validations activées. Réglez les réponses publiques sur validation, les étiquettes et notes internes sur automatique, et connectez le webhook de la page de statut. Relisez une semaine de brouillons sur de vrais tickets avant de passer une réponse en automatique.
- Faites un exercice. Simulez un SEV2 dans une marque de test. Vérifiez que la première publication part dans votre objectif, que le battement de cœur se déclenche, que la macro se met à jour et que chaque ticket étiqueté reçoit la note finale.
Si votre équipe travaille avec des changements d'équipe ou couvre peu les week-ends, l'étape 1 est la plus importante. Une panne à 3 h du matin sans personne dans la rotation de communication, c'est ainsi que la page de statut reste sur « investigation en cours » pendant quatre heures.
Essayez eesel pour vos jours d'incident
Si votre file de support tourne sur Zendesk, Freshdesk ou Gorgias, le coéquipier IA pour helpdesk d'eesel s'y joint comme un nouvel agent qui a déjà lu votre centre d'aide et vos anciens tickets. Un jour d'incident, il étiquette chaque ticket de panne, répond sur les tickets rattachés avec la mise à jour validée par votre responsable de la communication, et transmet directement les grands comptes, les pertes de données et la facturation à une personne, la configuration que Qontro fait tourner sur Freshdesk. Connectez votre page de statut via un webhook et chaque réponse reste alignée sur la même version que la page de statut.
C'est gratuit pour commencer avec 100 crédits, puis 299 $ par mois pour 500, un ticket comptant pour un crédit quel que soit le nombre de mises à jour qu'il reçoit. Mettez-le en place sur Zendesk ou Freshdesk avant votre prochaine panne, pas pendant.
Comment lier tous les tickets de panne dans Zendesk ?