

Jira Service Management hat eine native Statusseite, aber Atlassian liefert sie nur im Enterprise-Plan, für öffentliche und private Seiten. Bei Premium oder darunter nutzt du das separate Statuspage-Produkt und verbindest es über eine App oder eine Alert-Integration mit JSM. Was du vor dem Kauf wissen solltest: Die native Seite holt ihre Komponenten aus deiner Service-Registry und ihre Updates aus dem Incident, es gibt also kein zweites Tool, das synchron gehalten werden muss. Ein KI-Teammitglied wie eesel deckt ab, was die Seite nicht kann: Es beantwortet die "Ist es down?"-Tickets in deiner Queue anhand des Updates, das du gepostet hast.
Ich baue eesels Agenten, deshalb lese ich dieses Feature danach, woher jedes Datenstück kommt und wer es ändern kann. Für diesen Leitfaden bin ich Atlassians Statusseiten-Dokus und Preisseiten durchgegangen, und die Dokus widersprechen sich an ein paar Stellen, was ich weiter unten markiere. Mit der eesel CLI kann ein KI-Coding-Agent freigegebene Ausfall-Makros und die Incident-Richtlinie hochladen, ihm dann Testfragen stellen und die Antworten prüfen, bevor etwas live geht. Die Jira-Site selbst anzubinden braucht weiterhin einen Jira-Admin, der das freigibt.
Was sind Jira Service Management-Statusseiten?
Das sind gebrandete Seiten, die Kund:innen oder dem eigenen Team zeigen, welche deiner Services laufen und was du tust, wenn einer nicht läuft. Atlassian beschreibt sie als in JSM integriert, sodass sie "deine Service-Registry und Incidents" nutzen statt einer zweiten App, die du erneut einrichten musst. Du legst eine unter Operations und dann Status pages an, und Agents posten Updates aus der Incident-Ansicht.
Es gibt eigentlich drei Wege, wie Jira Service Management und eine Statusseite zusammenhängen, und Atlassians Dokus decken alle drei ab. Sie zu verwechseln ist die häufigste Quelle für Verwirrung, die ich sehe.
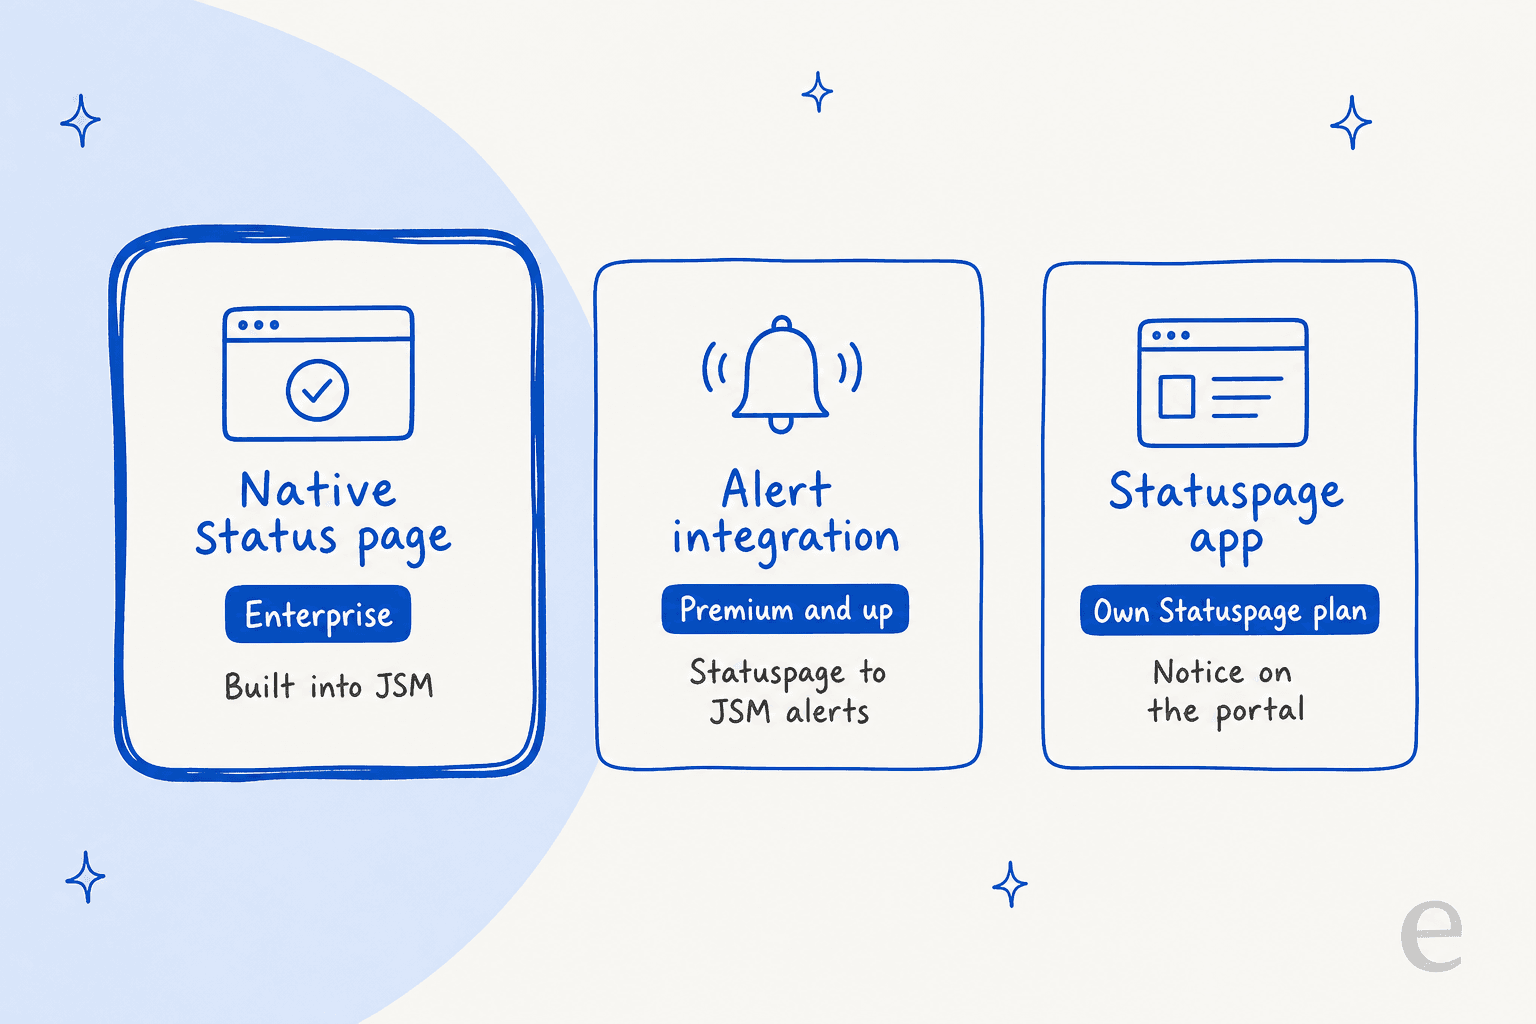
Die native Seite ist die neue. Atlassians Community-Ankündigung vom 17. Februar 2026, gepostet von einem Atlassian-Teammitglied, sagte, der Rollout habe am 16. Februar 2026 begonnen. Die anderen beiden Wege verbinden JSM mit dem älteren Statuspage-Produkt, und das gab es schon vorher.
Welcher Plan enthält Jira Service Management-Statusseiten?
Enterprise, für das native Feature. Atlassians Preisseite listet "Status pages" mit einem Haken nur unter Enterprise, und die Doku zur Statusseiten-Ansicht wiederholt, dass die Funktion "exclusive to Enterprise plans" ist. So verteilen sich die Teile nach Plan, laut denselben Seiten:
| Funktion | Free | Standard | Premium | Enterprise |
|---|---|---|---|---|
| Native Statusseiten (öffentlich und privat) | Nein | Nein | Nein | Ja |
| Statuspage-Alert-Integration (bidirektional) | Nein | Nein | Ja | Ja |
| Incident-Stakeholder-Kommunikation | Nein | Nein | Ja | Ja |
| Eskalation bei Major Incidents | Nein | Nein | Ja | Ja |
| Aufbewahrung von Alert-Daten | 1 Monat | 1 Jahr | 3 Jahre | 5 Jahre |
Bei den Kosten zeigte Premium 55,28 $ pro Agent und Monat auf der Preisseite, als ich am 12. November 2026 nachgesehen habe. Enterprise hat keinen öffentlichen Preis, wird jährlich abgerechnet und läuft über den Vertrieb. Atlassian sagt, die monatliche Preisgestaltung sei progressiv, die Zahl ist also ein Mischwert für eine vorgegebene Teamgröße, kein Listenpreis. Mein Preis-Überblick geht die Stufen im Detail durch.
Bist du unter Enterprise, hat das eigenständige Produkt seine eigenen öffentlichen Preise:
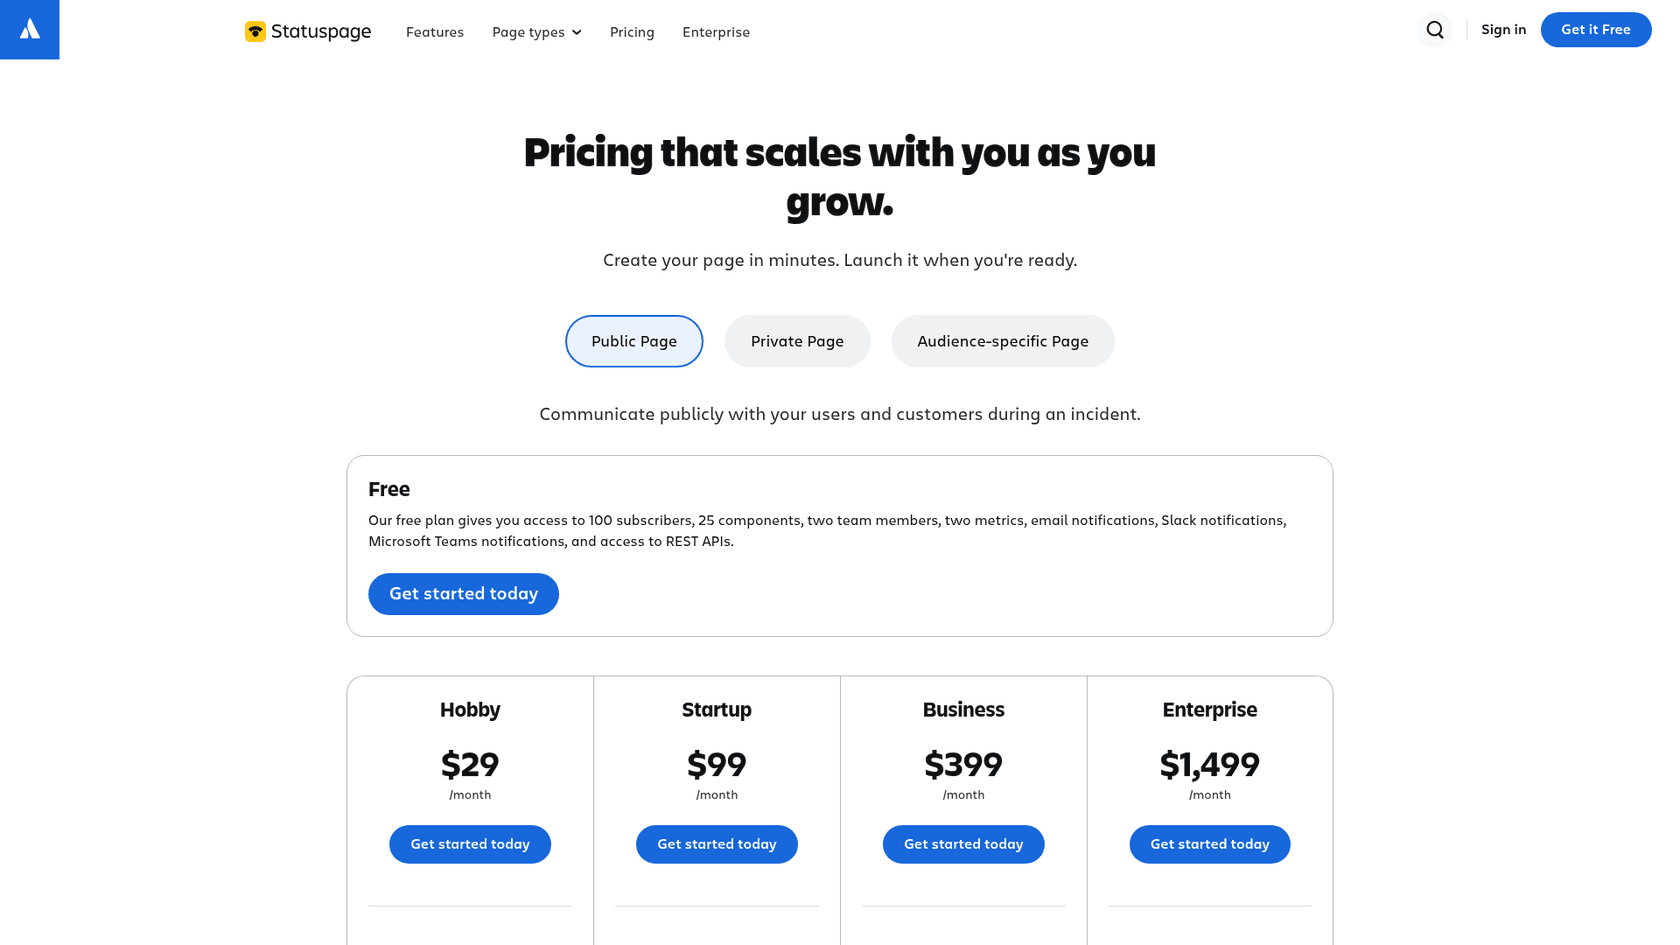
| Statuspage-Public-Plan | Preis pro Monat | Abonnent:innen | Teammitglieder | Komponenten-Abos |
|---|---|---|---|---|
| Free | $0 | 100 | 2 | Nein |
| Hobby | $29 | 250 | 5 | Nein |
| Startup | $99 | 1.000 | 10 | Nein |
| Business | $399 | 5.000 | 25 | Ja |
| Enterprise | $1.499 | 25.000 | 50 | Ja |
Private Seiten starten bei 79 $ pro Monat auf derselben Preisseite. Der eigenständige Weg kostet mehr in separaten Rechnungen, funktioniert aber auf einem niedrigeren JSM-Plan.
Wie richtest du eine Statusseite in Jira Service Management ein?
Du musst Product-Admin sein, und die erste Entscheidung lässt sich nicht zurücknehmen. Atlassians Seite zum Erstellen und Anpassen sagt, du wählst bei der Erstellung Public oder Private und "can't change it afterwards". Zum Wechseln legst du eine neue Seite an.
- Geh zu Operations und dann Status pages und wähle den Seitentyp.
- Setze unter Details den Seitennamen, die interne Beschreibung, die URL und die Zeitzone. Die Standardadresse ist
<name>.status.atlassian.com. - Füge unter Components Services aus deiner Service-Registry hinzu und gruppiere sie.
- Füge unter Appearance Farben, ein Titelbild und ein Favicon hinzu. CSS und HTML sind für tieferes Styling erlaubt.
- Füge unter Advanced settings Incident-Vorlagen und eine eigene Domain hinzu.
- Sieh dir die Desktop- und Mobile-Ansicht in der Vorschau an und wähle dann Publish page, laut der Doku zum Veröffentlichen.
Die Komponenten-Limits sind großzügig, aber real: bis zu 1.000 Komponenten insgesamt, 50 pro Gruppe und 20 Gruppen pro Seite. Die eigene Domain braucht zwei CNAME-Einträge, und SSL wird automatisch ausgestellt, wie die Seite zur eigenen Domain erklärt.
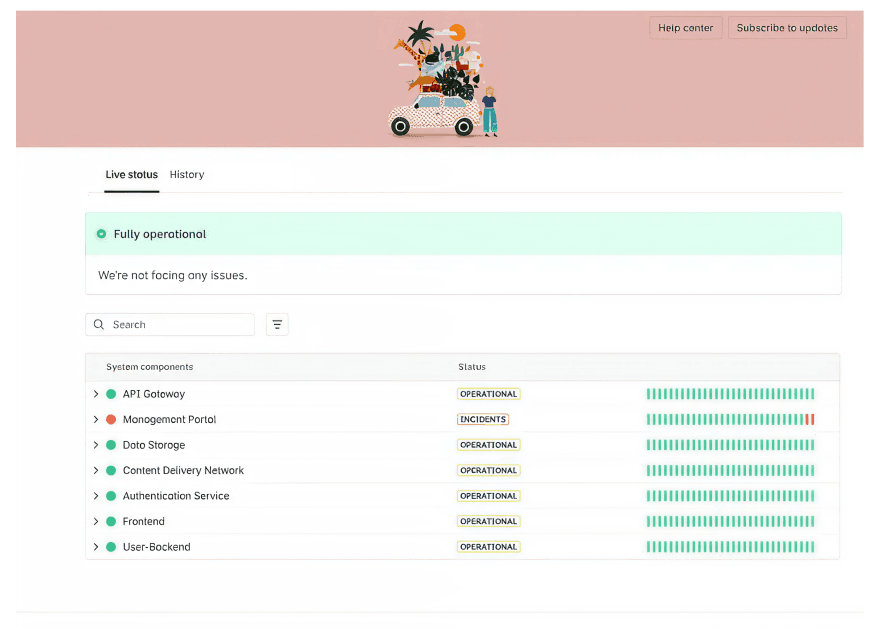
Besucher:innen sehen ein Banner, eine Komponentenliste mit Suchfeld sowie die Tabs Live status und History. Falls deine Admins neu bei der Service-Registry sind, die die Komponentenliste füttert, deckt mein Leitfaden zum ITSM-Ticketsystem die Grundlagen ab.
Wie erreichen Incident-Updates die Statusseite?
Direkt aus dem Incident. Atlassians Doku zu Stakeholder-Updates lässt Agents eine veröffentlichte Seite im Bereich Status pages des Incidents verlinken und dann Send update wählen. Du kannst pro Incident nur eine Statusseite verlinken.
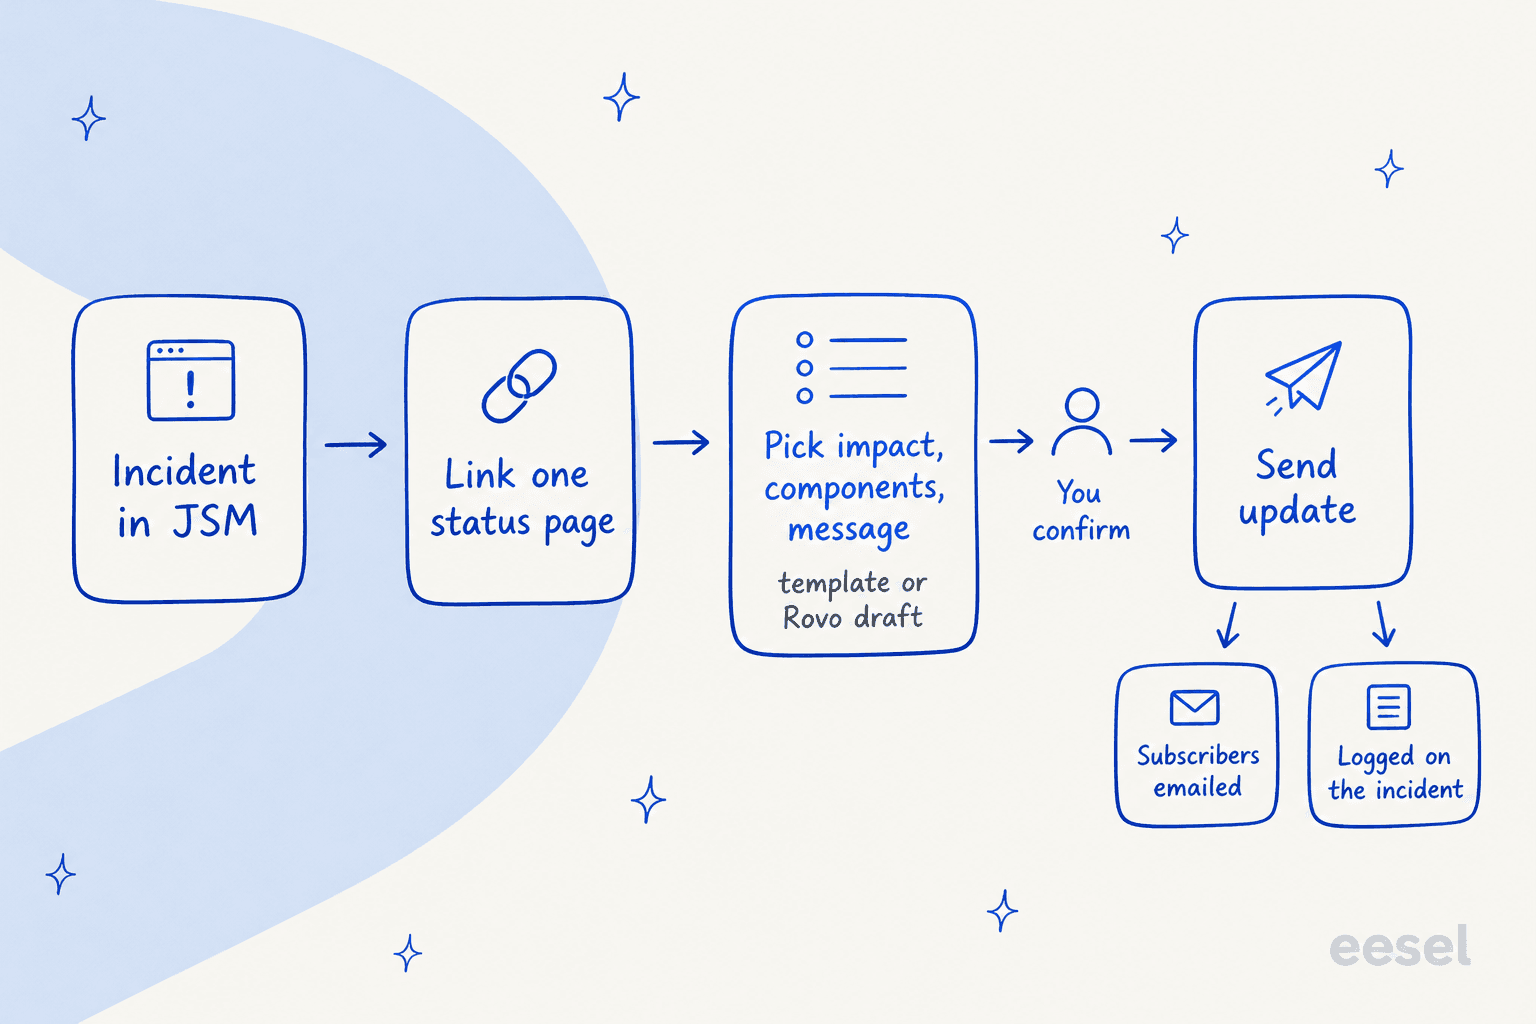
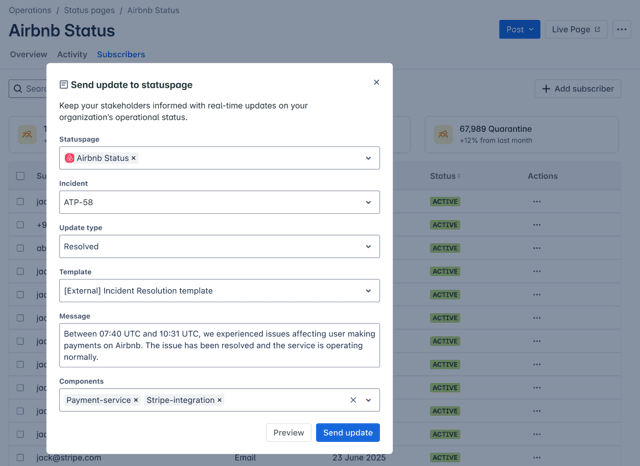
Der Update-Dialog fragt nach Impact, Status, Titel und Nachricht des Incidents. Du kannst das von Hand schreiben, von einer Standard-Incident-Vorlage starten oder einen von Rovo vorgeschlagenen Titel und eine Nachricht bei geeigneten Incidents prüfen. Atlassian macht deutlich, dass Vorschläge "are applied only after you confirm them". Updates werden außerdem am Incident protokolliert, sodass die Timeline zeigt, was Kund:innen mitgeteilt wurde. Stakeholder-Gruppen laufen parallel dazu: Rovo schlägt Personen anhand ähnlicher vergangener Incidents vor, aber Stakeholder werden nur nach Bestätigung hinzugefügt.
Das Rovo-Drafting ist ein eigenes Thema. Meine Notizen zu Atlassian Intelligence: Incidents aus Alerts und Post-Incident-Reviews decken die benachbarten KI-Features ab, und Rovo-Agents erklärt das größere Agentenmodell.
Wie bekommt eine Komponente ihren Status?
Durch den schwersten offenen Incident, was mich überrascht hat. Atlassians Doku zur Statusseiten-Ansicht sagt, dass die Seite bei mehreren Incidents auf einer Komponente den schlechtesten Status zeigt, und der ändert sich erst, wenn ein Update aus JSM gesendet wird.
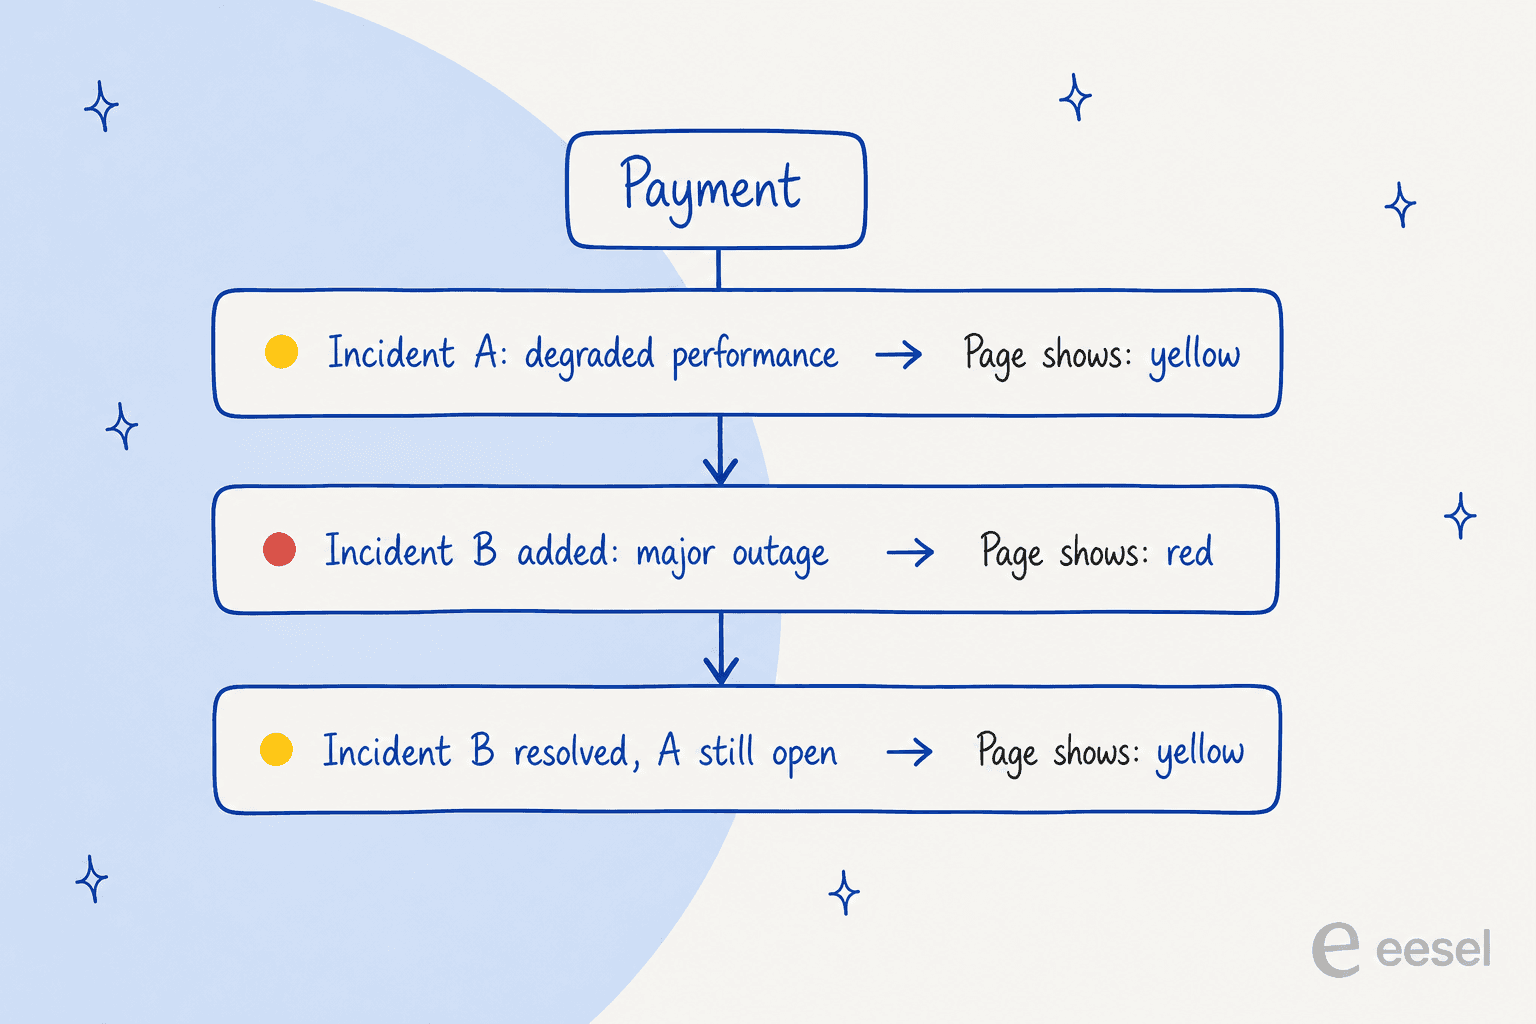
Daraus folgen zwei Dinge. Erstens: Die Seite ist nur so aktuell wie dein letztes Send update, ein stiller Incident-Kanal bedeutet also eine veraltete Seite. Zweitens: Eine Komponente innerhalb eines einzelnen Incidents herunterzustufen, senkt sie nicht, weil die Doku sagt, der Uptime-Status "will still reflect the most significant impact". Uptime ist (Total Time - Downtime) / Total Time, also ergibt Atlassians Beispiel von 90 Minuten Downtime in einem 30-Tage-Fenster 99,791 %.
Wer kann abonnieren, und wo liegen die Grenzen?
Jede:r, bei einer öffentlichen Seite, und die Limits gelten pro Site statt pro Seite. Hier die Zahlen aus Atlassians Abonnent:innen-Doku und Bearbeiten-Doku:
| Limit | Wert |
|---|---|
| Abonnent:innen pro Site (alle Seiten zusammen) | 10.000, zählt aktive, ausstehende und inaktive |
| Komponenten pro Seite | 1.000 |
| Komponenten pro Gruppe | 50 |
| Gruppen pro Seite | 20 |
| Manuelle Abo-Zugänge auf einmal | 10 E-Mail-Adressen, keine Verteilerlisten |
| Abo-Kanäle | E-Mail, und Webhooks |
Nur Active-Abonnent:innen erhalten Updates, und wer die E-Mail nicht bestätigt hat, erscheint als Pending. Bei privaten Seiten entfernt das Löschen einer Person aus der verlinkten Atlassian-Gruppe ihren Zugang, kündigt aber nicht ihr E-Mail-Abo, das musst du selbst löschen.
Solltest du die native Seite oder Statuspage nutzen?
Das hängt vor allem von deinem Plan ab, dann davon, wie viel du an einem Ort haben willst. Atlassian selbst sagt, die eigenständige App "works as a separate product, so its scope for integration and customization is limited". Probier den Picker unten aus, der sich an der Doku orientiert.
Welcher Statusseiten-Weg passt?
Wähle deinen JSM-Plan und für wen die Seite ist.
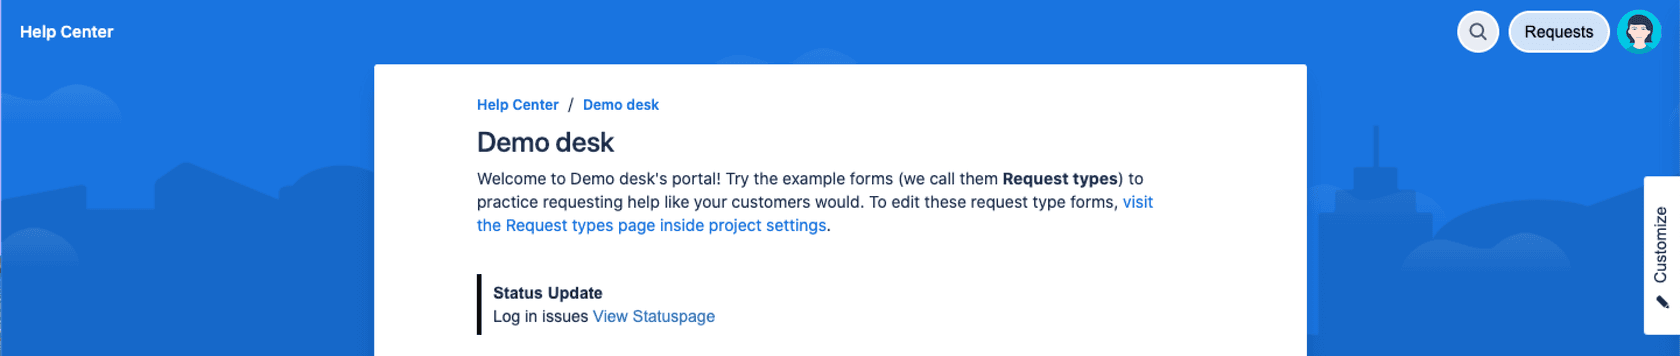
Nutzt du Statuspage schon, sagt Atlassian, du kannst dort weitermachen, nach der Statuspage-Setup-Seite. Diese Seite fügt außerdem den unten gezeigten Portal-Hinweis hinzu, sodass Kund:innen den Incident sehen, bevor sie ein Ticket erstellen.
Statusseiten stehen neben Change Management, das sein eigenes Plan-Gate hat, und die breiteren JSM-KI-Features sind auch einen Blick wert. Wägst du erst andere Tools ab, decken mein Freshservice-Vergleich, Zendesk-Vergleich und meine Liste von Alternativen die größere Entscheidung ab.
Wie hängt das mit der Opsgenie-Nachfolge beim Alerting zusammen?
Über den Incident. Opsgenie wird abgeschafft: Atlassian stoppte den Neuverkauf am 4. Juni 2025 und beendet den Support am 5. April 2027, und seine Alerting- und On-Call-Features sind in Jira Service Management und Compass eingebaut. In JSM routen Alerts nach On-Call-Plan und können einen Incident öffnen, und im Incident postest du das Status-Update.
Die Statuspage-Integration läuft auch andersherum. Die Doku zur Statuspage-Integration sagt, ein neuer Statuspage-Incident erzeugt einen Alert in JSM, und jedes Update wird als Notiz an diesem Alert ergänzt. JSM kann dann über zugeordnete Alert-Aktionen Incidents in Statuspage erstellen, aktualisieren und auflösen. Atlassian listet bidirektionale Integrationen als Premium- und Enterprise-Funktion.
Für die Alert-Seite der Geschichte lies meine Notizen zu Alert-Gruppierung, KI-Monitoring und Alerting und ITIL mit KI. Für KI-Add-ons siehe die Übersichten zur besten KI für JSM und KI für ITSM. Bildest du den ganzen Prozess ab, ist Help Desk vs. Service Desk ein nützlicher Einstieg.
Wo widersprechen sich Atlassians Dokus?
Fünf Stellen, und ich würde jede auf deiner eigenen Site prüfen, bevor du einen Rollout planst:
- Private Seiten. Der Community-Post vom Februar 2026 sagte, private Seiten seien "coming soon", und eröffnete ein Early-Access-Programm. Die aktuelle Doku beschreibt ein vollständiges Setup mit Atlassian-Gruppen, und die Preisseite sagt "public & private". Ich würde private Seiten als verfügbar behandeln, aber in deinem Tenant gegenprüfen.
- Updates senden. Die Seite zum Senden von Updates sagt, das Post-Feature "will be released soon", während die Incident-Doku und ihr eigener Screenshot es als funktionierend beschreiben.
- Stakeholder bei Standard. Die Preistabelle listet Incident-Stakeholder-Kommunikation als nicht enthalten bei Standard. Die Stakeholder-Doku sagt, Nutzer:innen mit Agent-Lizenz bei Standard können als Stakeholder hinzugefügt werden.
- Webhook-Abonnent:innen. Der Launch-Post listet E-Mail und Webhooks, und die Ansicht-Doku nennt nur E-Mail. Webhooks haben ihre eigene Doku.
- KI-Drafting. Der Launch-Post nennt Auto-Drafting eine Open Beta für Enterprise, während die Doku sagt, Rovo-Vorschläge erscheinen bei "eligible incidents", ohne einen Plan zu nennen.
Was sollte deine Support-Queue während eines Incidents tun?
Antworte aus dem geposteten Update, und schick nichts, das nicht darin steht. Eine Statusseite sagt Menschen, was nicht funktioniert, aber die meisten schreiben trotzdem. Meine Leitfäden zu Statusseiten-Updates, Kommunikation bei Major Incidents und Support während SaaS-Ausfällen decken diese Schleife im Detail ab, und Software für Kundenkommunikation deckt das Tooling ab.
Eine harte Grenze würde ich ziehen: Eine KI kann das Update zitieren, aber ein Mensch entscheidet, was als Ausfall zählt. Qontro, ein ERP-Anbieter, der eesel auf Freshdesk betreibt, hat es so eingerichtet: Ausfälle, Datenverlust und Abrechnung gehen direkt an einen Menschen, und eesel versucht nicht, diese zu lösen. Im Monat vom 8. August bis 8. September 2026 hat es Antworten auf 190 Tickets entworfen, und das Team schickt oder überarbeitet jede davon.
Der virtuelle Agent und eine gute Wissensdatenbank übernehmen nativ einen Teil davon. Deflection ist die Zahl, die du beobachten solltest. Ticket Deflection, Tier-1-Deflection und Deflection-Rate erklären, wie man sie misst, und SLA-Management deckt die weiterlaufenden Uhren ab. Zum Routen des Rests siehe KI-Eskalationsmanagement.
eesel für Jira Service Management testen
Ist deine Statusseite in Ordnung, aber deine Queue läuft jedes Mal voll, wenn sie rot wird, klinkt sich eesel wie ein neuer Mitarbeiter in deinen Jira Service Management-Desk ein. Es liest jede "Ist es down?"-Anfrage, antwortet aus deinem geposteten Update und deiner Wissensdatenbank und hinterlässt eine interne Notiz für einen Menschen bei allem, was nach einem neuen Ausfall aussieht. Kostenlos zum Testen. Für das größere Bild siehe meine Leitfäden KI für Jira Service Management und KI zu JSM hinzufügen, plus die JSM-KI-Bewertung.
