

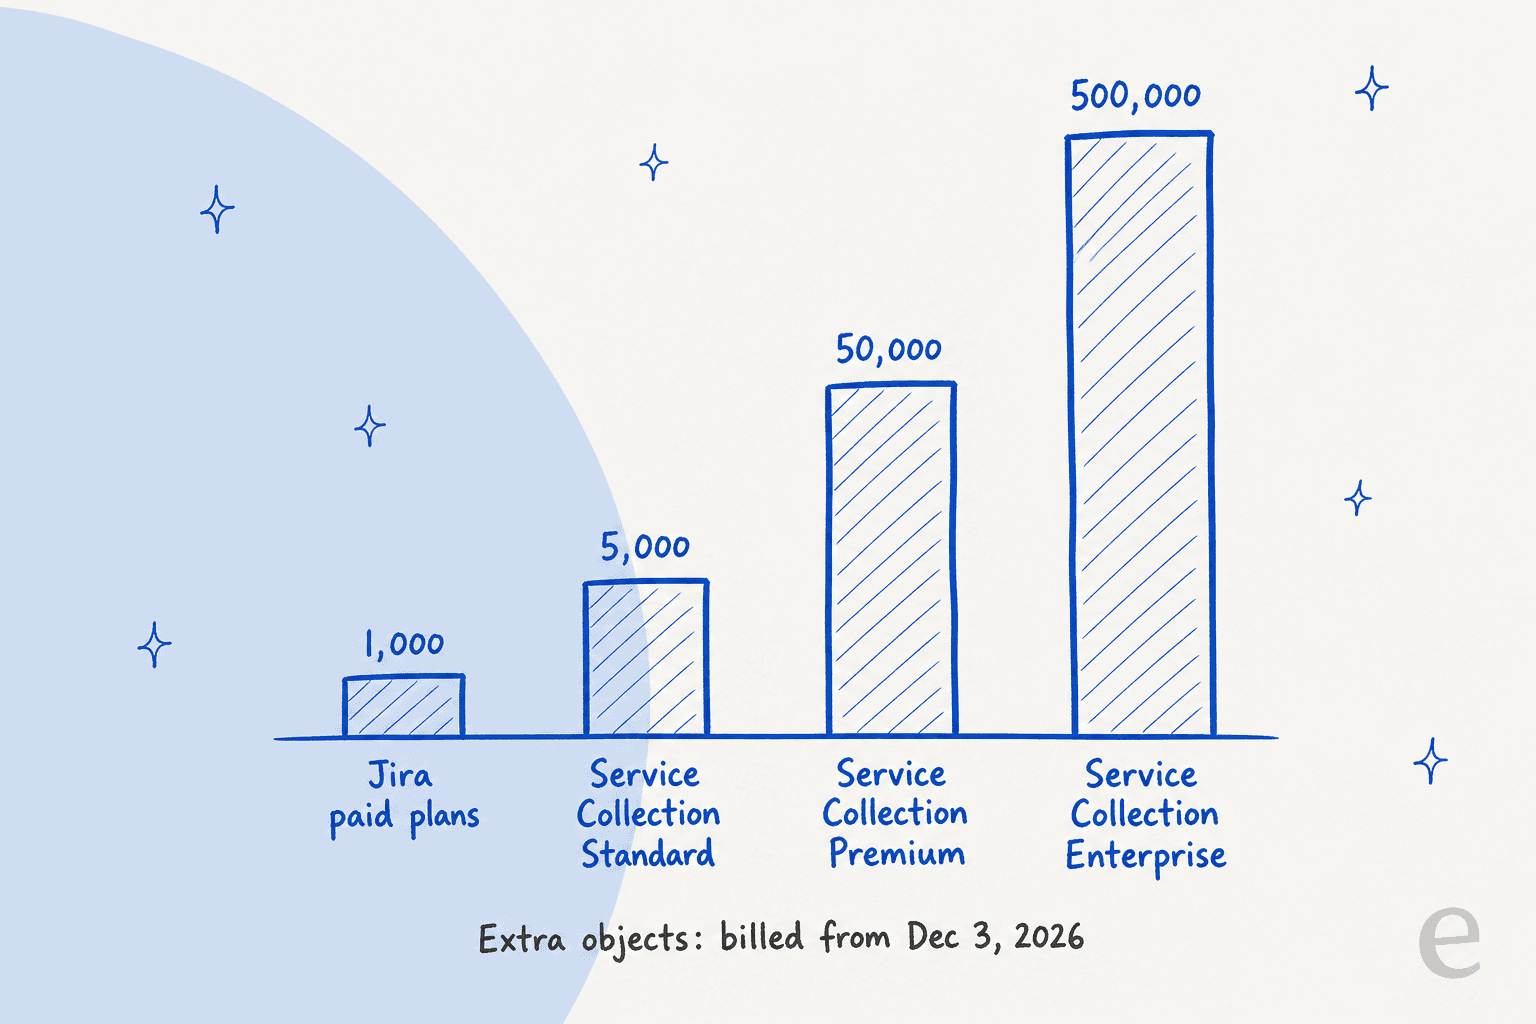
Jira Service Management Assets ist Atlassians CMDB: Du beschreibst, was du erfasst, als Objekte mit Attributen, verknüpfst sie mit Referenzen und hängst sie dann an Requests, Incidents und Changes an. Pläne haben ein Objektkontingent, 5.000 bei Standard, 50.000 bei Premium und 500.000 bei Enterprise, und Atlassian sagt, die Abrechnung für Objekte darüber beginnt am 3. Dezember 2026, also plane dein Schema vorher. Die wichtigste Fähigkeit ist die Modellierung: ein Objekt für alles, was einen eigenen Owner, Lebenszyklus oder Referenzen braucht, und ein Attribut für den Rest. eesel kann auf der Queue-Seite sitzen und "Welchen Laptop habe ich?" aus freigegebenen Asset-Notizen beantworten, während IT jede Datensatzänderung behält.
Ich baue eesels Integrationen und APIs, also lese ich Assets so, wie es ein Integrator tut: Wie sieht das Datenmodell aus, was sieht ein verbundenes Tool, und wo liegen die harten Grenzen? Ich habe für diesen Leitfaden Atlassians Assets-Dokumentation und Preisseite durchgearbeitet, und einige davon widersprechen sich, was ich unten markiere. Mit der eesel CLI kann ein KI-Coding-Agent freigegebenes Referenzmaterial hochladen, etwa eine exportierte Geräteliste und deine Laptop-Ersatzrichtlinie, dann Testfragen stellen und die Antworten prüfen, bevor etwas live geht. Die Verbindung der Jira-Site selbst braucht weiterhin die Freigabe eines Jira-Admins.
Was ist Jira Service Management Assets?
Es ist ein Ort, um alles zu erfassen, was deinem Team wichtig ist, und es mit der Arbeit zu verbinden, die du schon machst. Atlassians Übersicht listet Services, Mitarbeitende, Lieferanten, Verträge, Standorte und Ausrüstung als typische Dinge zum Erfassen, und sagt, dass alles, was du erfasst, als Objekt gespeichert wird, mit Attributen, die es beschreiben, und Referenzen, die es mit anderen Objekten verknüpfen.
Zwei Änderungen machen das lesenswert, selbst wenn du Assets schon benutzt hast:
- Assets ist jetzt eine Plattform-App. Atlassian sagt, es ist aus jeder Jira-App erreichbar über den App-Switcher. Die Rollen-Seite ergänzt, dass eine Person mit der Rolle Assets User oder App Admin keine Jira- oder JSM-Lizenz braucht, um die App zu öffnen.
- Objekte werden jetzt gemessen. Dasselbe Banner kündigt nutzungsbasierte Abrechnung ab 3. Dezember 2026 an, die unten im Plan-Abschnitt behandelt wird.
Eine vollwertige CMDB muss eine Frage beantworten: Was wird berührt, wenn etwas kaputt geht oder sich ändert? In Jira Service Management erreicht diese Antwort den Agenten über Requests, die ich unten behandle, und über Change Management. Wenn dir die ITSM-Seite neu ist, geben meine Leitfäden zu KI für ITSM und dem ITIL-Framework das Vokabular.
Wie hängen Schemas, Objekttypen, Attribute und Referenzen zusammen?
Ein Objektschema enthält Objekttypen, und Objekttypen enthalten Objekte. Atlassians Schema-Seite sagt, jedes Schema hat seine eigenen Objekttypen, Objekte, Attribute, Icons, Referenzen und Status, und eigene Berechtigungen, sodass du ein Vertragsschema vor Leuten verstecken kannst, die nur Hardware brauchen.
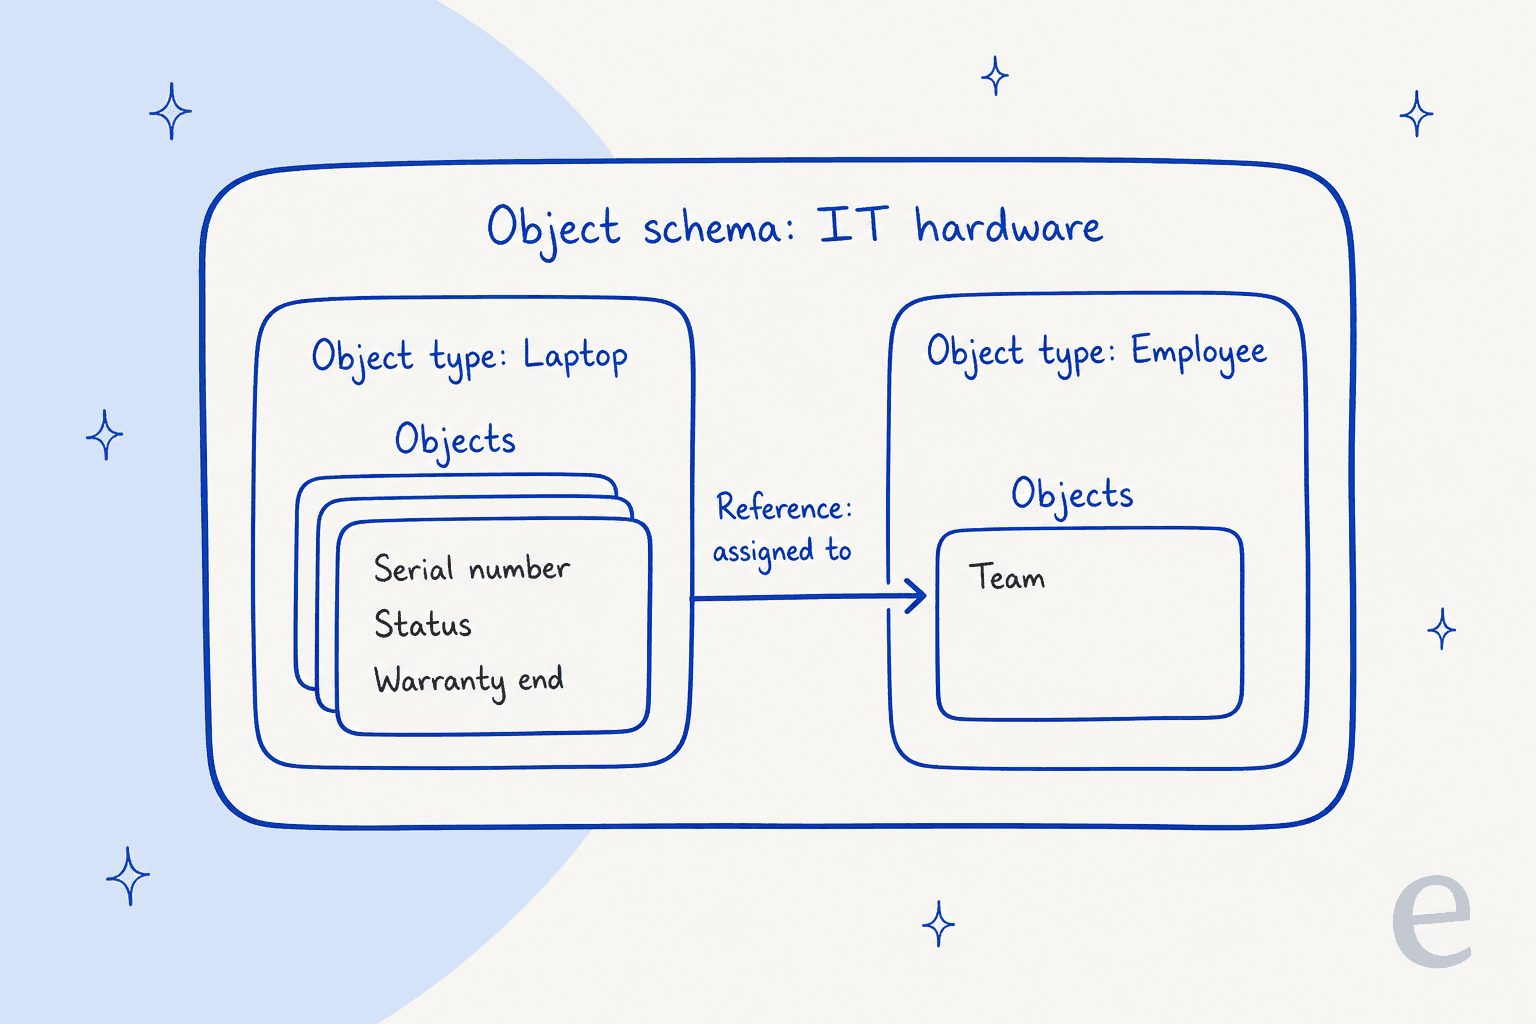
Das Glossar definiert einen Objekttyp als eine Gruppe ähnlicher Objekte mit denselben Attributen, und eine Referenz als ein besonderes Attribut, das auf ein anderes Objekt verweist. Objekttypen können auch Attribute von einem übergeordneten Typ erben, und ein abstrakter Objekttyp kann selbst keine Objekte halten, funktioniert aber als übergeordneter Typ.
Bei den Attributtypen wird ein Design praktisch. Laut Atlassians Attributtypen-Seite sind die sieben Gruppen:
| Gruppe | Was sie enthält | Wissenswertes Detail |
|---|---|---|
| Standard | Text, Boolean, Integer, Float, Date, DateTime, URL, Email, Textarea, Select, IP-Adresse | Text ist auf 255 Zeichen begrenzt, Textarea auf 10.000 |
| Objekt | Referenzen zu anderen Objekten | Minimale und maximale Kardinalität lassen sich festlegen |
| User | Ein Link zu einem Jira-User | Eine Liste nach User zu sortieren, sortiert nach User-ID, nicht nach Name |
| Group | Ein Link zu einer Jira-Gruppe | Jira-Gruppen, die du sehen kannst, werden automatisch erkannt |
| Project | Ein Jira-Projekt | Wird aus deinen Berechtigungen erkannt |
| Status | Ein Status aus globalen oder Schema-Optionen | Beschreibt den Zustand eines Objekts |
| Bitbucket-Repository | Ein Link zu einem Repository | Wird aus deinen Berechtigungen erkannt |
Die Design-Regel, die ich anwenden würde, kommt aus Atlassians eigener Optimierungsanleitung: Lege ein separates Objekt an, wenn ein Element einen eigenen Owner, Lebenszyklus, Referenzen, Reporting oder aufbewahrte Historie braucht, und nutze sonst ein Attribut an einem bestehenden Objekt. Ein Lieferant, der von jedem Vertrag referenziert wird, ist besser als ein Lieferant, der auf jedem Vertrag neu eingetippt wird. Dieser Rat betrifft genauso Kosten wie Ordnung, denn jedes Objekt zählt auf dein Kontingent.
"The knowledge base and asset information also contribute to faster resolution of recurring tickets and better storage of critical information for future reference."

Welcher Plan enthält Assets, und wie viele Objekte bekommst du?
Atlassians Preisseite listet Assets als nicht enthalten bei Free und enthalten bei Standard, Premium und Enterprise, jeweils mit einem Objektkontingent.
| Plan | Enthaltene Assets-Objekte | Weitere Assets-Funktionen auf derselben Seite |
|---|---|---|
| Free | Nicht enthalten | Keine |
| Standard | 5.000 | Common Data Model, Asset Discovery, Dependency Mapping |
| Premium | 50.000 | Fügt Data Manager und Hardware Asset Management hinzu |
| Enterprise | 500.000 | Wie Premium |
Drei Dinge in Atlassians eigener Dokumentation stimmen nicht zusammen, und ich würde sie mit deinem Atlassian-Ansprechpartner klären, bevor du budgetierst.
- Bundle versus Produkt. Die Spalten der Preisseite sind das Service-Collection-Bundle, das Assets enthält. Die Assets-for-Cloud-Seite listet 1.000 Objekte für Jira Standard, Premium und Enterprise, und 5.000, 50.000 und 500.000 für Service Collection Standard, Premium und Enterprise. Ein Abrechnungsbeispiel auf der Seite zu zusätzlichen Objekten paart Jira Service Management Premium mit 50.000 Objekten, und Kontingente aus mehreren Subscriptions addieren sich, sodass 50.000 plus 1.000 insgesamt 51.000 ergeben.
- Die Site-Obergrenze. Die Nutzungsseiten sagen, jede Site kann bis zu 3 Millionen Objekte halten, während die technische Limit-Tabelle 10 Millionen Schema-Objekte pro Site nennt. Ich würde mit der niedrigeren Zahl planen.
- Das Common Data Model. Die Preisseite markiert es bei Standard und höher, aber Atlassians Common-Data-Model-Seite sagt, es ist derzeit nur für Kunden im Beta-Programm verfügbar. Seine vier System-Schemas sind People, Geography, External organizations und Hardware.
Was ändert sich am 3. Dezember 2026?
Atlassians Support-Seiten tragen ein Banner, das besagt, dass die nutzungsbasierte Abrechnung an diesem Tag beginnt. Du wirst nur für Objekte oberhalb deines enthaltenen Kontingents abgerechnet, entweder als vorausbezahlte Objekt-Pakete mit Mengenrabatten oder nachträglich nach tatsächlicher Nutzung darüber. Atlassian veröffentlicht den Preis pro Objekt nicht auf diesen Seiten und sagt, du sollst in der Atlassian Administration für deinen Fall nachsehen, daher kann ich keinen Preis nennen. Die Nutzungsseite sagt, du wirst bei 80 % und erneut bei 100 % deines Kontingents benachrichtigt.
Nicht alles zählt. Objekte in den Schemas Software Registry und Business Portfolio, im auslaufenden Services-Schema, in Sandboxes und in Data Manager zählen nicht zur Nutzung, aber Objekte in anderen System-Schemas wie dem Hardware-Assets-Schema zählen, laut Atlassians Nutzungs-Erklärung. Eine weitere Feinheit: Die Limit-Seite sagt, die Abrechnung wird schrittweise eingeführt und berechtigte Kunden werden vor jeder Berechnung benachrichtigt, also kann das Datum dich zu einem anderen Zeitpunkt erreichen, als das Banner vermuten lässt.
Hier ist ein kleines Widget, um zu prüfen, wo deine Objektanzahl im Vergleich zu diesen Kontingenten liegt.
Wähle deine geschätzte Objektanzahl, um zu sehen, welcher Jira-Service-Management-Plan sie abdeckt.
Wie verbindest du Assets-Objekte mit Requests?
Du fügst deinen Request-Typen ein Assets-Objekte-Custom-Field hinzu. Atlassians Setup-Seite führt dich durch: Erstelle das Feld im Jira-Admin, wähle den Feldtyp Assets-Objekte, wähle das Objektschema, das das Feld erreichen kann, und füge optional AQL hinzu, um zu filtern, welche Objekte erscheinen.
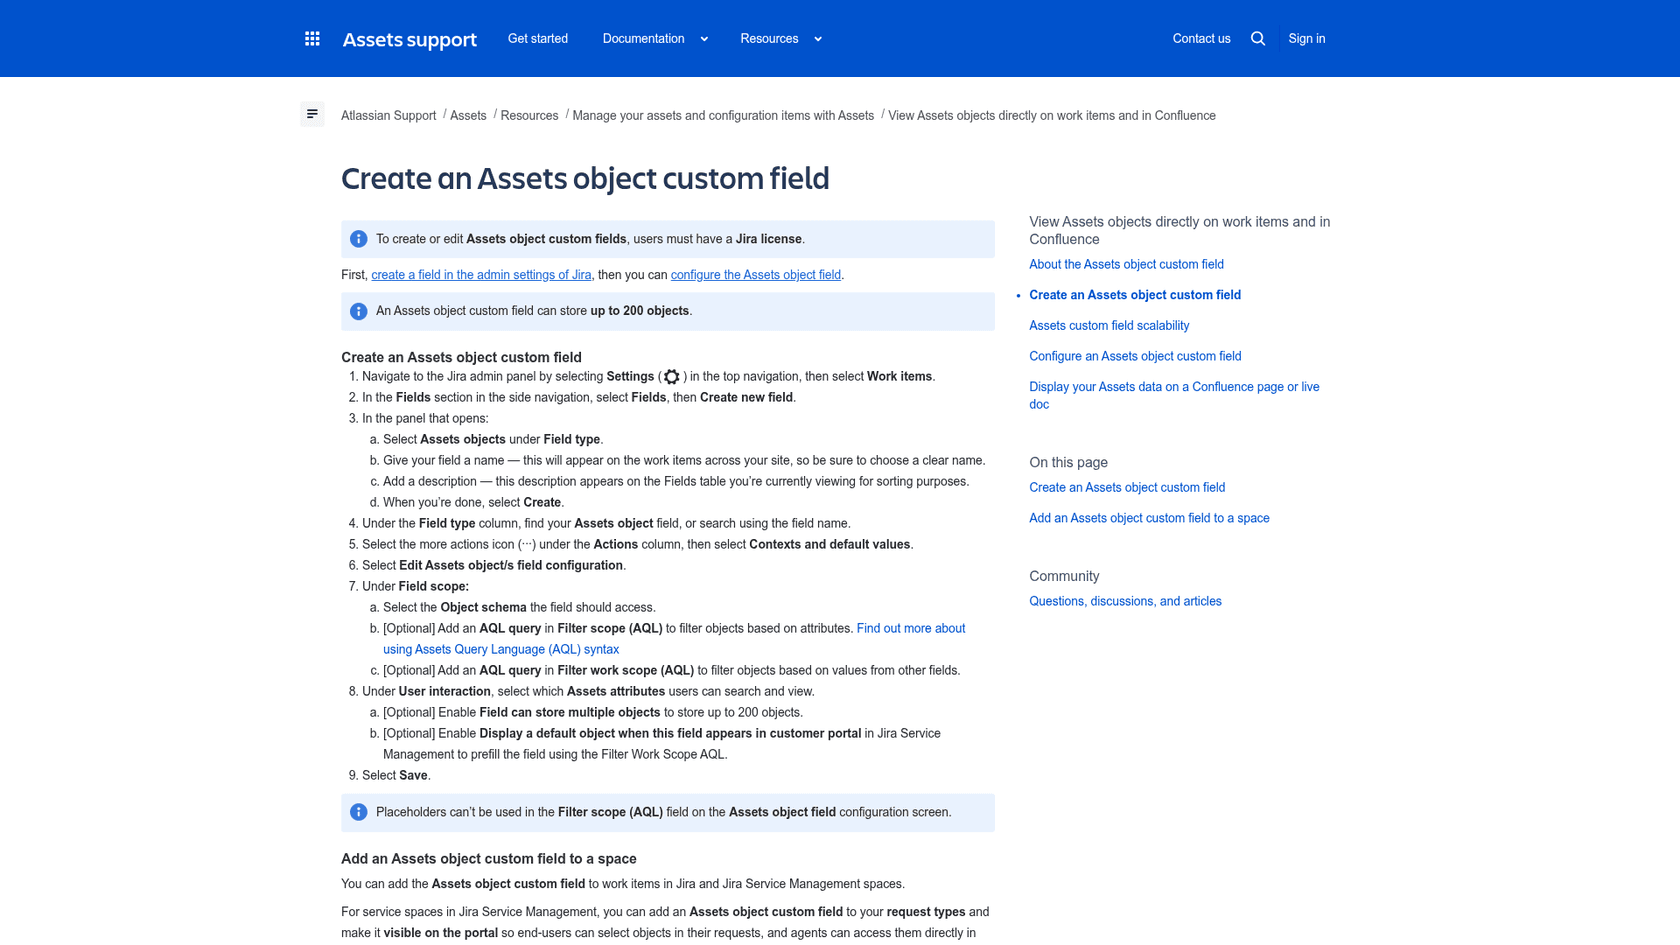
Die Einstellungen, die entscheiden, ob das Feld nützlich ist:
- Filter scope (AQL) begrenzt die Objekte, die eine Person auswählen kann, und Platzhalter können darin nicht verwendet werden.
- Filter work scope (AQL) filtert nach Werten aus anderen Feldern, und kann ein Standardobjekt im Kundenportal vorausfüllen.
- Multiple objects ist optional, und ein Feld kann bis zu 200 Objekte speichern.
- Portal visibility lässt Kunden Objekte in ihren eigenen Requests auswählen. Atlassian weist darauf hin, dass das Hinzufügen eines Felds zu einem Request-Typ allen Portal-Kunden die nur-lesende User-Rolle in Assets gewährt, was es wert ist zu wissen, bevor du ein Schema mit sensiblen Attributen freigibst.
Atlassian sagt auch, dass manche Ansichten wie Boards und das Backlog eine gekürzte Liste von 50 Objekten zeigen, während Arbeitselement- und Portalansichten bis zu 200 zeigen. Sobald ein Objekt ausgewählt ist, erscheint der Request unter Connected Jira work items am Objekt. Diese zweiseitige Verknüpfung ist das, was die Datenbank für Agenten wertvoll macht: Sie sehen den Status und die Garantie des Laptops am Ticket, und die Historie des Laptops zeigt jedes Ticket, das über ihn eröffnet wurde.
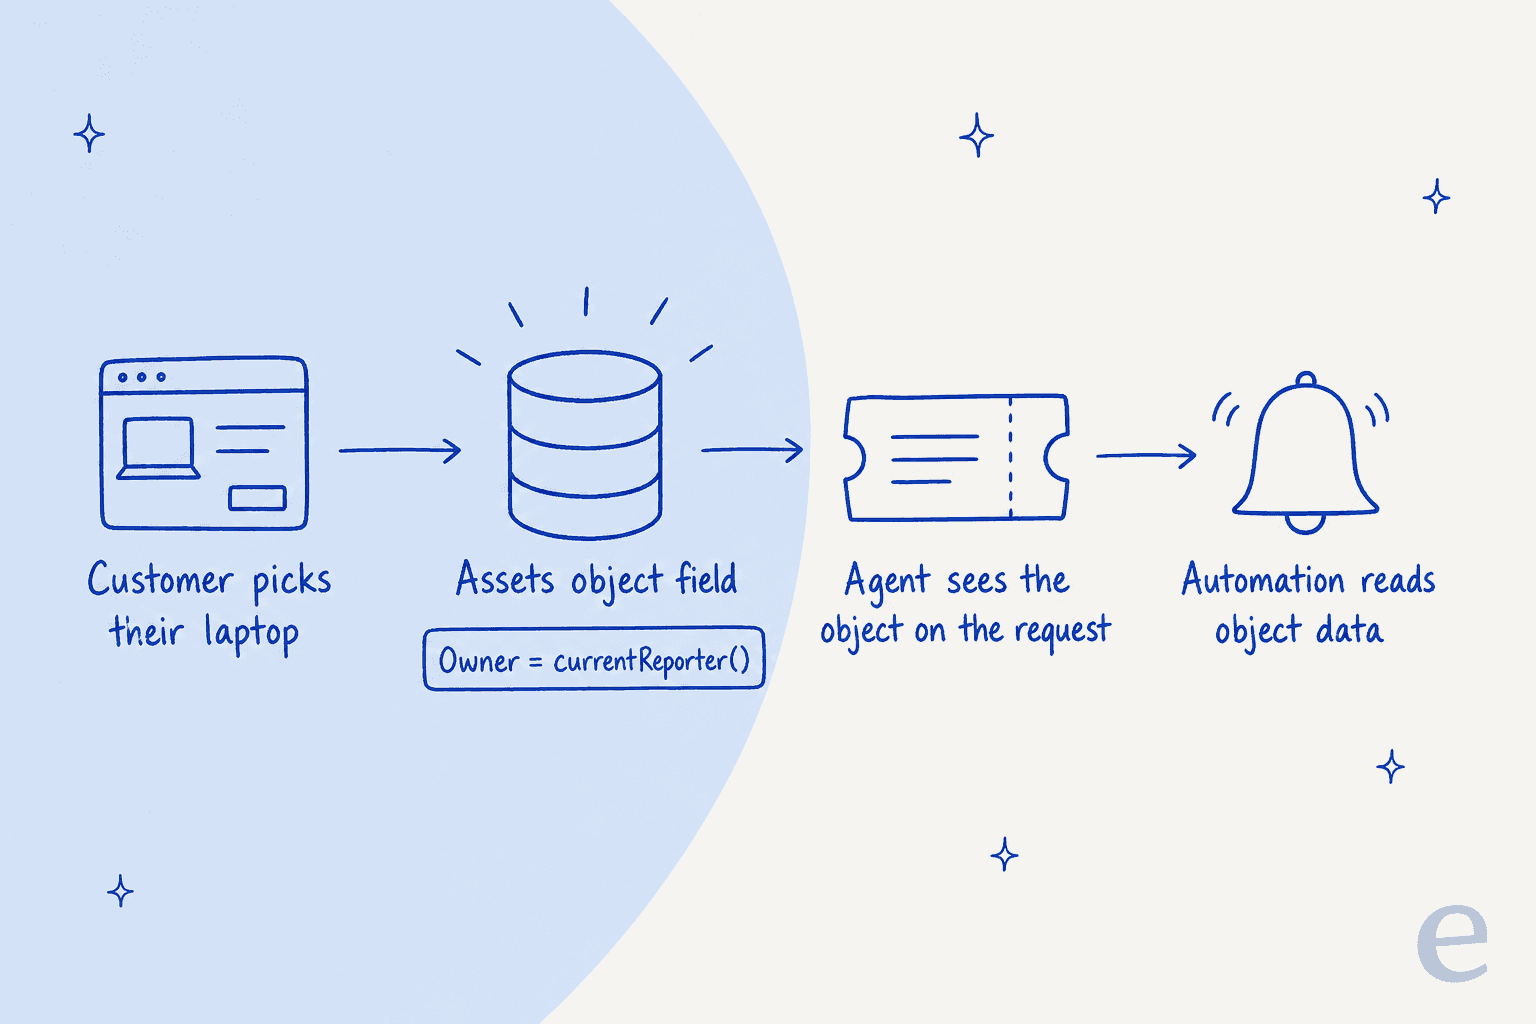
Atlassians Seite verweist auch auf Automatisierung: Smart Values für Assets lassen Regeln auf Objektdaten reagieren, und Atlassian Automation ist als Cloud-only-Funktion gelistet. Wenn du überlegst, was du sonst noch automatisieren kannst, behandeln meine Leitfäden zu Service-Desk-Automatisierung und Jira-Automatisierung das.
Wie funktioniert AQL?
AQL ist eine kleine Abfragesprache: <attribute> <operator> <value>. Atlassians AQL-Seite sagt, sie kann in der erweiterten AQL-Suche oder in einem benutzerdefinierten Objektfeld verwendet werden, und sie ist nicht case-sensitiv, auch wenn == der case-sensitive Gleichheitsoperator ist.
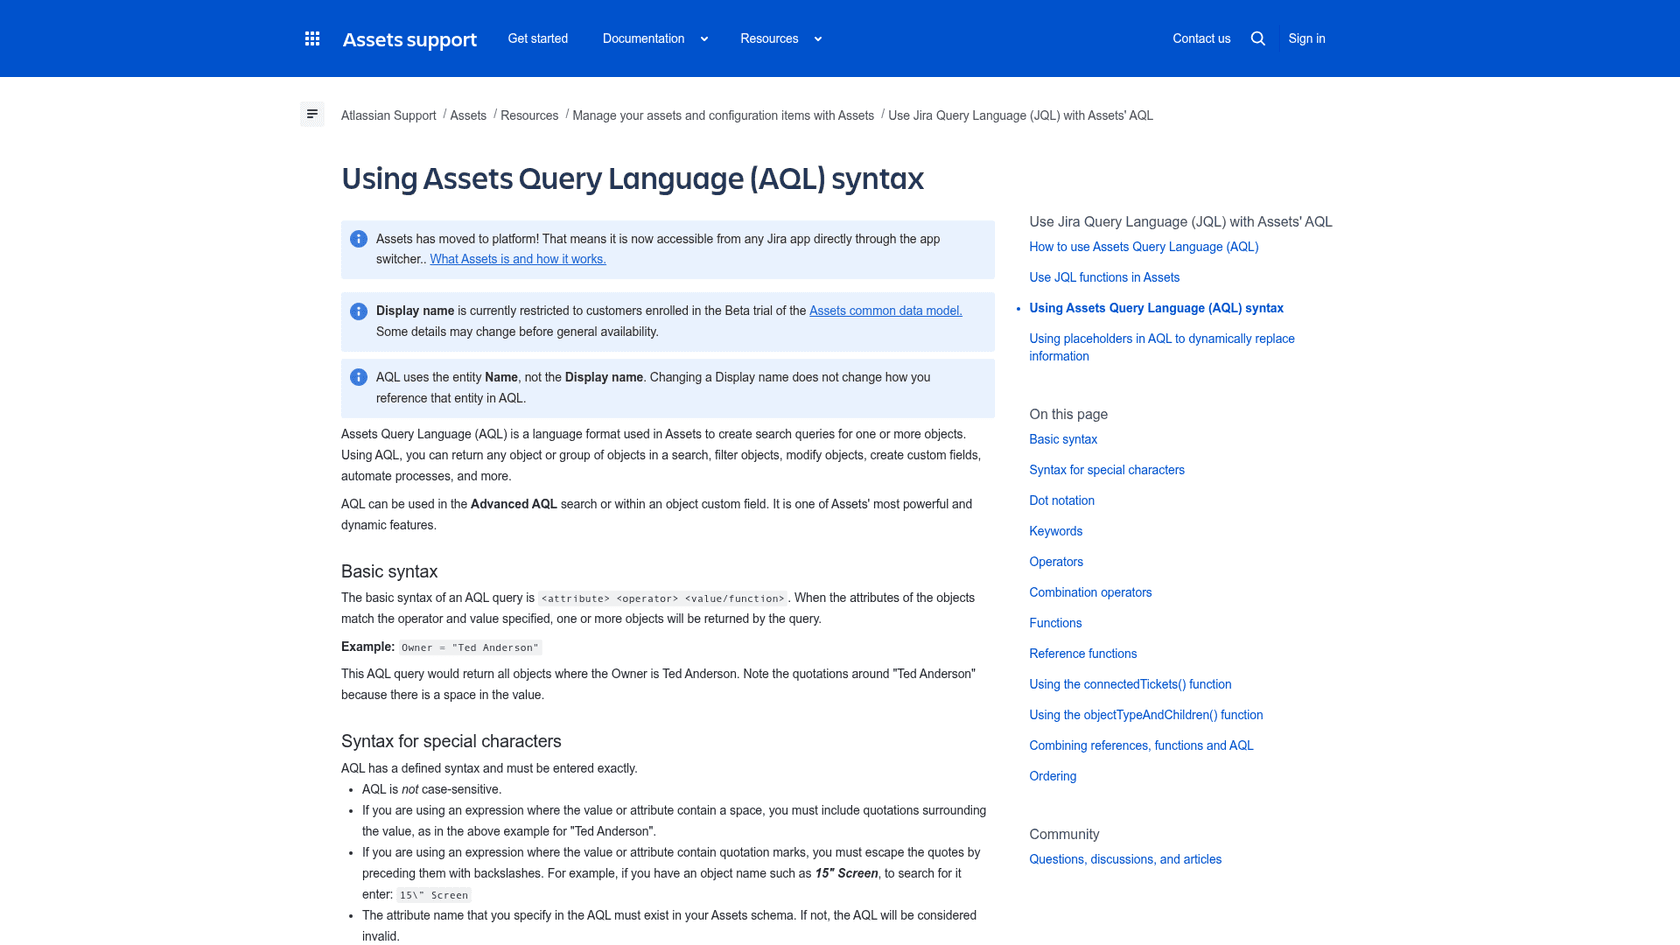
Die Teile, die ich am meisten nutze, von dieser Seite:
| Bedarf | AQL | Was es macht |
|---|---|---|
| Alle Objekte eines Typs | objectType = "Host" | Stichwortsuche nach Objekttyp |
| Einer Referenz folgen | "Belongs to Department".Name = HR | Punktnotation folgt einer Referenzkette |
| Objekte ohne Owner | Owner is EMPTY | Der is-Operator prüft auf leere Werte |
| Nur meine Geräte | objecttype = Computer and User = currentUser() | Braucht ein User-Typ-Attribut |
| Die Geräte des Reporters | User = currentReporter() | Funktioniert nur, wenn ein Arbeitselement ausgewählt ist |
| Objekte mit offener Arbeit | object HAVING connectedTickets(Project = VK) | Führt erst die JQL aus, dann die AQL |
| Ein Typ und seine Kinder | objectType in objectTypeAndChildren("Asset Details") | Schließt untergeordnete Objekttypen ein |
Zwei Warnungen. AQL nutzt den Name einer Entität, nicht ihren Display name, sodass das Umbenennen eines Anzeigenamens deine Abfragen nicht bricht, und das Attribut muss im Schema existieren, sonst ist die Abfrage ungültig. Die anyAttribute-Abfrage und connectedTickets() funktionieren nicht mit dem Confluence-Makro, das eine Objekttabelle auf einer Seite einbettet, also braucht ein so aufgebauter Confluence-Report andere Filter. Wenn dein Team in Confluence dokumentiert, kann die eesel-Confluence-Integration diese Seiten in dasselbe Wissen ziehen, aus dem ein KI-Teammitglied antwortet.
Wie funktionieren Importe, Data Manager und Discovery?
Cloud unterstützt mehrere Wege hinein. Die Assets-for-Cloud-Seite listet Import aus CSV, JSON und Assets Discovery, plus Import von einer Webadresse und eine External Imports API. Die Limit-Seite setzt die maximale Importdatei auf 250 MB pro Schema.
Premium und Enterprise fügen Data Manager hinzu, das laut Atlassian Daten aus mehreren Quellen verbindet, bereinigt und abgleicht, mit mehr als 30 Adaptern, einschließlich CSV und ODBC für SQL-Datenbanken.
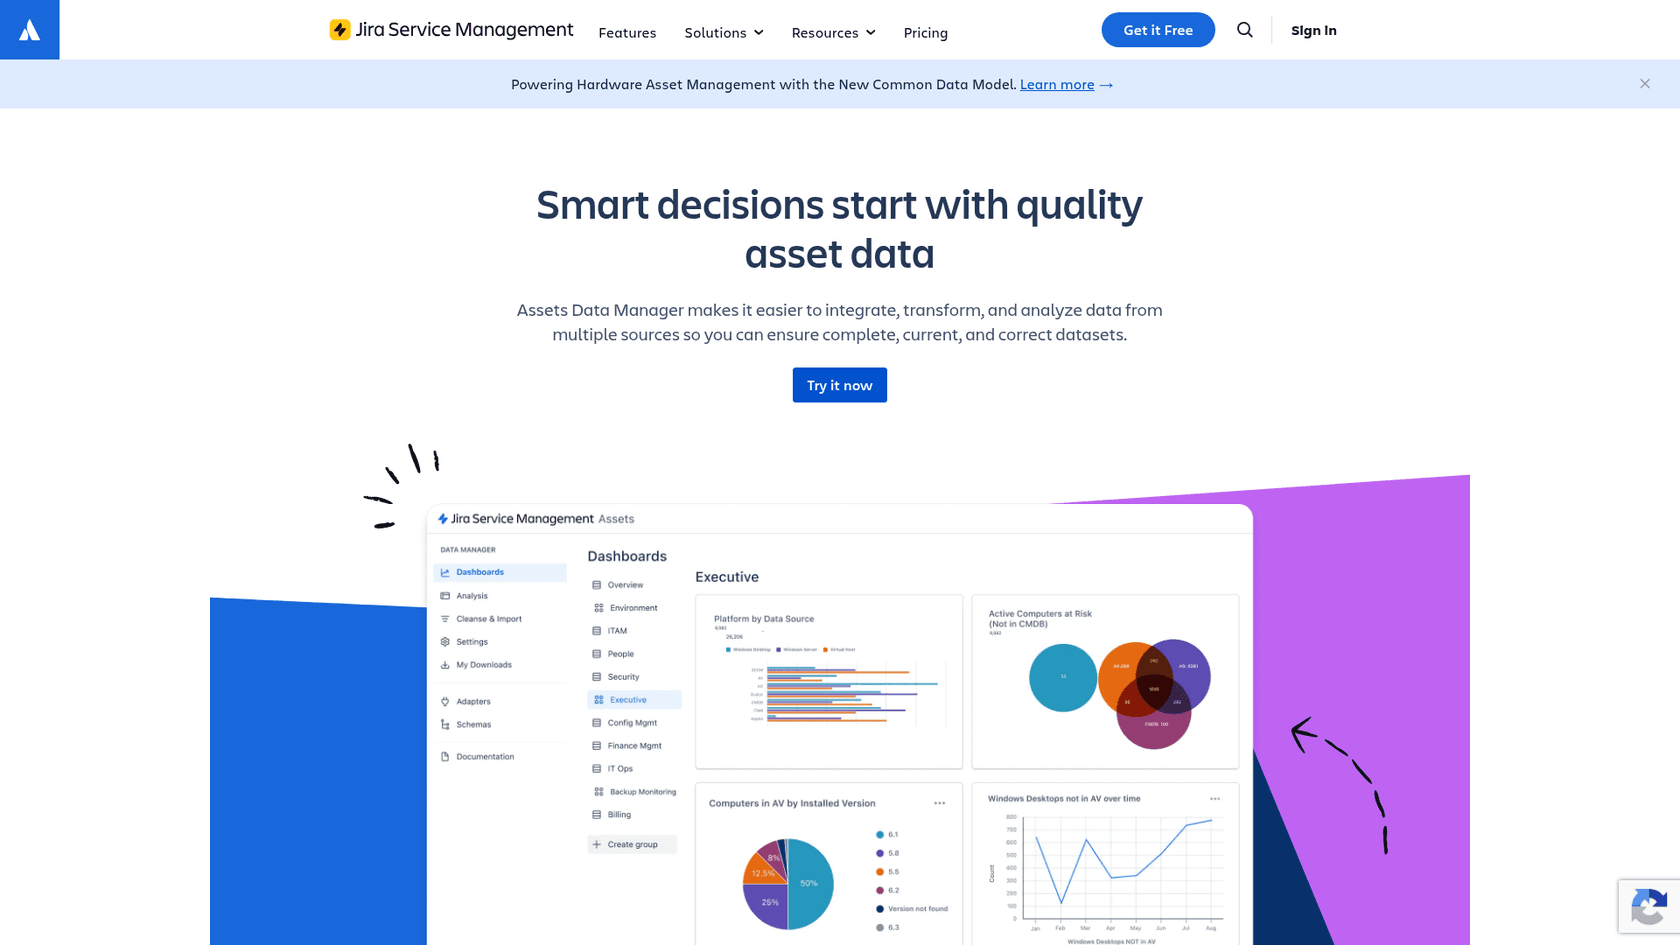
Atlassians eigene Seiten unterscheiden sich darin, wie Data Manager ein Schema erreicht. Die Preisseite sagt, natives Importieren von Daten in Schemas sei "coming soon", während die Data-Manager-FAQ sagt, Daten können über CSV oder einen neuen Import-Adapter in ein Schema importiert werden. Ich würde den CSV-Weg als heute verfügbar behandeln und den Adapter bestätigen lassen. Die für die Kosten nützliche Tatsache: Objekte, die in Data Manager gehalten werden, zählen nicht zu deiner Objektnutzung, sodass es Rohdaten aus der Quelle halten kann, während nur abgeglichene Datensätze in einem Schema leben.
Atlassians Rat zur Duplikatvermeidung gilt für jeden Import: Nutze eine stabile Kennung, etwa eine Mitarbeiter-ID oder einen Standortcode, um eingehende Datensätze mit bestehenden Objekten abzugleichen, sodass ein Import den richtigen aktualisiert, statt ein Duplikat anzulegen. Assets Discovery, der Netzwerkscanner, ist auf eine konsolidierte Dokumentationsseite umgezogen, und die Preisseite listet es bei Standard und höher.
Wie verbindet sich Assets mit Change- und Incident-Management?
Über dasselbe Custom Field. Atlassians Change-Management-Seite sagt, du erstellst ein Assets-Objekte-Feld, bildest es auf ein Schema ab und fügst es den Change- und Incident-Screens hinzu. Verbundene Objekte erscheinen dann in Change-Risk-Insights, wo du mögliche Konflikte bei bestimmten Objekten siehst, und im Change-Kalender, wo du siehst, welche Objekte kommende Changes betreffen.
Das ist der praktische Nutzen einer CMDB: Bevor ein Change an einem Datenbankserver genehmigt wird, sieht der Genehmigende die anderen bereits geplanten Changes an demselben Objekt. Mein Change-Management-Leitfaden behandelt die Genehmigungs-, Risiko- und Kalenderteile, und KI für Change Management behandelt, wo KI hilft. Für die Incident-Seite siehe automatisiertes IT-Incident-Management und meine SLA-Best-Practices.
Was sind die harten Limits und Fallstricke?
Über das Kontingent hinaus veröffentlicht Atlassian technische Limits, die die Abrechnung nicht ändert. Von der Limit-Seite:
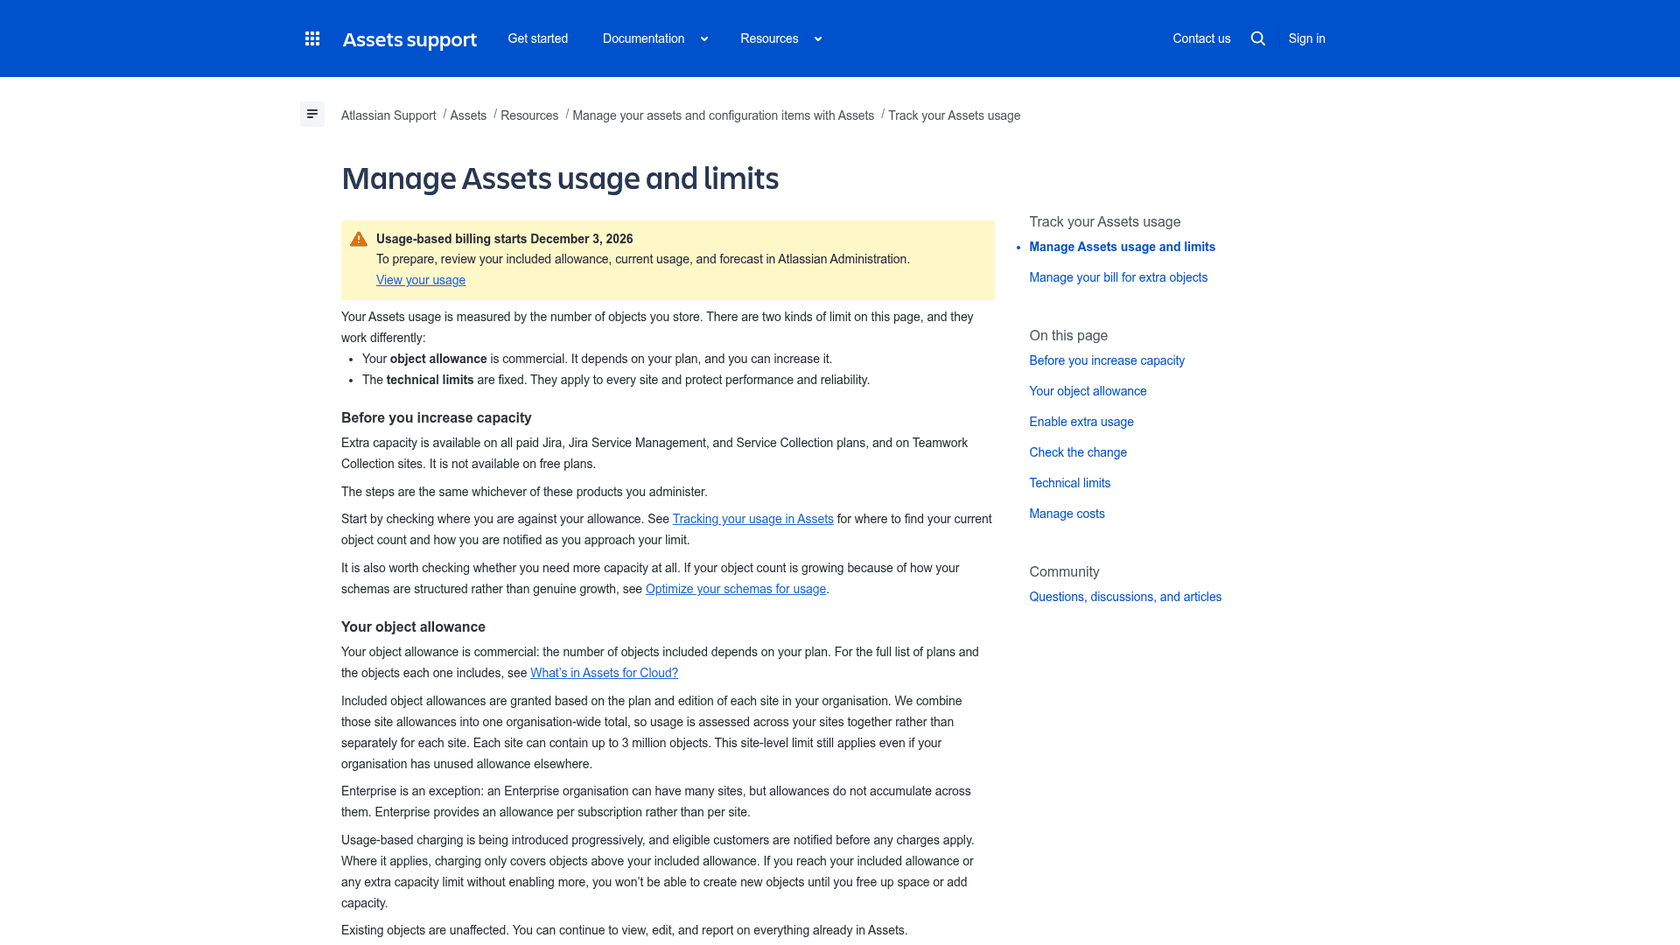
| Limit | Wert |
|---|---|
| Schema-Objekte pro Site | 10 Millionen |
| Schemas insgesamt | 100 |
| Objekte pro Objekttyp | 2 Millionen |
| Attribute pro Objekttyp | 120 |
| Eindeutige Constraints pro Objekttyp | 2 |
| Zeichen im Text-Attribut | 255 |
| Zeichen im Textarea-Attribut | 10.000 |
| Importdateigröße pro Schema | 250 MB |
Was Leute überrascht: Assets hat keinen Archivzustand. Atlassians Optimierungsanleitung sagt, Archivieren kann die Nutzung nicht senken, weil es keinen archivierten Zustand gibt: Gelöschte Objekte zählen nicht mehr, aber Löschen ist unumkehrbar, also entscheide die Lebensdauer eines Objekts, bevor du es anlegst. Aktualisiere das bestehende Objekt, wenn ein Mitarbeiter das Team wechselt, statt ein zweites anzulegen.
Eine kurze Checkliste vor dem Aufbau, die ich durchgehen würde:
- Liste die Objekttypen auf, die du brauchst, und markiere, welche einen eigenen Owner oder Lebenszyklus haben.
- Mach den Rest zu Attributen an einem bestehenden Typ.
- Wähle für jeden Typ eine stabile Kennung, bevor der erste Import läuft.
- Entscheide, welche Schemas Portal-Kunden sehen dürfen, da das Feld ihnen die User-Rolle gewährt.
- Zähle deine Objekte gegen das Plankontingent, und prüfe die App-Nutzung monatlich.
Wo setzt ein KI-Teammitglied auf Assets auf?
KI sitzt auf der Ticket-Seite dieser Daten, nicht im Datensatz. Wenn jemand fragt "Welchen Laptop habe ich?" oder "Wann läuft meine Garantie aus?", liegt die Antwort in einem Objekt, und die fragende Person ist meist in der Queue. Mein Leitfaden zu KI für IT-Asset-Management geht durch, welche dieser Aufgaben KI übernehmen kann und welche bei IT bleiben sollten, und KI für Asset-Management und die besten KI-Asset-Tools runden es ab.
Eine Warnung zu dem, was ich bestätigen kann: Ich habe keinen nativen eesel-Reader für Assets-Objekte bestätigt. Was eesel heute tut, ist, sich mit deinem Jira-Service-Management-Desk zu verbinden, aus vergangenen Requests und deiner Knowledge Base zu lernen, und innerhalb der Queue zu antworten oder zu entwerfen, wie es seine Integrationsseite beschreibt. Für Asset-Fragen ist der praktische Weg ein freigegebener Export der Daten, etwa eine Geräteliste, die nach Plan aktualisiert wird, was eine Person dafür verantwortlich hält, was die KI zitieren darf, und bedeutet, dass ein veralteter Export das ist, worauf man achten muss.
Das Muster hält auch auf einem technischen Desk. Ein Industrieautomatisierungsunternehmen betreibt eesel über seine technische Bibliothek, und ein Support-Agent entwirft eine Antwort auf jedes Ticket, mit einem Konfidenzlevel und den genutzten Quellen, bevor ein Ingenieur es öffnet. Das wöchentliche Volumen verdoppelte sich in den ersten Monaten etwa, und deutlich mehr als doppelt so viele Fragen kommen im Chat an wie den Support-Desk erreichen. Ein Ingenieur bearbeitet und sendet, und eesel schreibt nie von selbst an einen Kunden.
Für einen JSM-Desk würde ich diese Form kopieren: Erst gegen vergangene Requests testen mit KI-Support-Simulation, Genehmigungen bei Menschen halten wie in meinem Leitfaden zu Genehmigungsworkflows, und eine saubere Knowledge Base als Quelle nutzen. Wenn du zwischen Wegen wählst, sind die besten KI-Optionen für JSM, Atlassians eigene KI und Rovo die Startpunkte, und der Leitfaden zu agentischer KI behandelt, wohin Atlassian geht.
Teste eesel auf deinem Jira-Service-Management-Desk
Assets sagt deinen Agenten, was ein Gerät ist; die Queue braucht trotzdem jemanden, der die Frage schnell beantwortet. eesel ist ein KI-Helpdesk-Teammitglied, das sich deiner bestehenden Jira-Service-Management-Queue anschließt, aus deinen vergangenen Requests und deiner Knowledge Base lernt, Antworten entwirft und Request-Felder aktualisiert, und Genehmigungen bei deinem Team lässt. Verwandte Lektüre: KI für den Service Desk und KI für Onboarding-Fragen.
Teste eesel zuerst an einer Stichprobe deiner eigenen Requests, und siehe den JSM-Preisleitfaden für das, was der Desk selbst kostet.
Häufig gestellte Fragen
Was ist Jira Service Management Assets?
Welcher Jira-Service-Management-Plan enthält Assets?
Wie viele Objekte umfasst Jira Service Management Assets?
Was ist AQL in Jira Service Management?
objectType = "Laptop" AND Status = "In stock". Sie funktioniert in der erweiterten Suche und in benutzerdefinierten Objektfeldern, laut Atlassians AQL-Syntaxseite. Sie ist nicht case-sensitiv und verwendet Attributnamen, nicht Anzeigenamen.