

Was ist ein Glossar für Support-Übersetzungen?
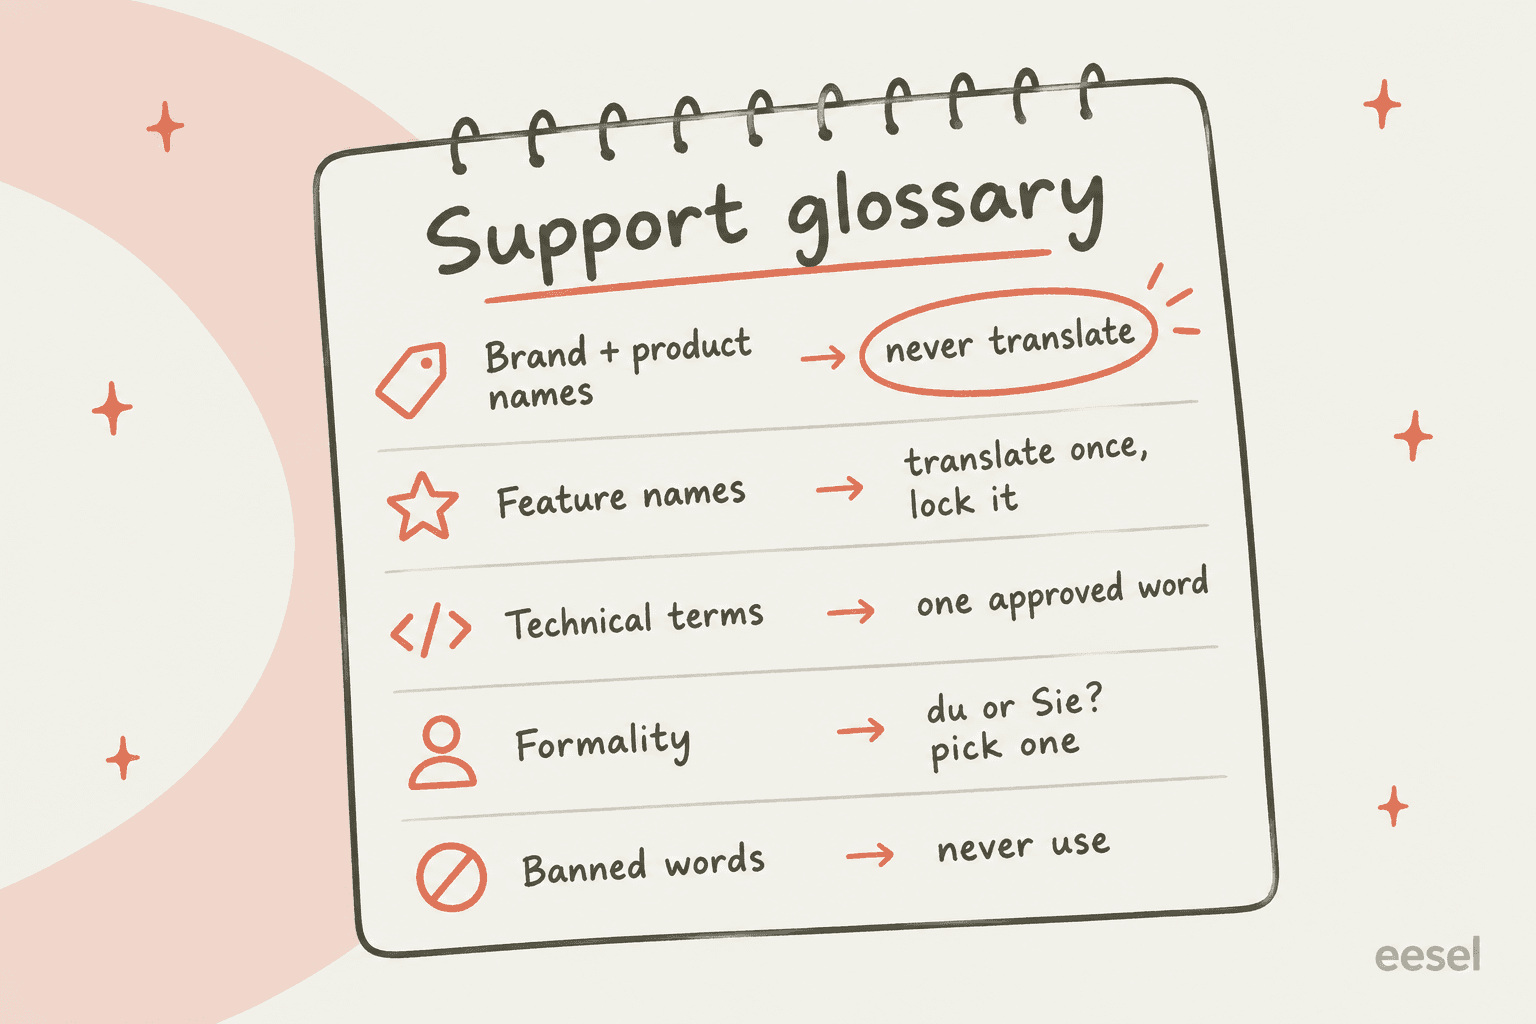
Ein Glossar für Support-Übersetzungen (Übersetzer nennen es Termbasis) ist eine Tabelle mit Wörtern und kurzen Wendungen, jeweils mit einer Regel: unverändert lassen, genau so übersetzen oder nie verwenden. Es ist kein Wörterbuch für alles. Es enthält nur die Begriffe, bei denen „ungefähr richtig“ falsch ist.
Ein Hacker-News-Kommentator hat sowohl die Idee als auch ihre geringe Bekanntheit zusammengefasst:
"To address the problem of inconsistent terminology, Localization Management Systems (LMS) leverage a term base (glossary), which clearly explains each term and provides a preferred translation. ... Sadly, the know-how across engineering teams around localization is rather low, meaning that the existence of term bases, translation memories is not well known."

Es hilft, das Glossar von seinen zwei Nachbarn abzugrenzen, weil Tools die Namen durcheinanderbringen:
| Was | Was es steuert | Beispielregel |
|---|---|---|
| Glossar | Einzelne Begriffe | „eesel“ bleibt in jeder Sprache „eesel“ |
| Styleguide | Ton, Formalität, Formatierung | Auf Deutsch „Sie“ verwenden, nie „du“ |
| Translation Memory | Ganze Sätze, die du schon übersetzt hast | Den freigegebenen französischen Erstattungsabsatz wiederverwenden |
Im Support verschwimmen die ersten beiden, deshalb würde ich die Formalität ebenfalls in der Glossardatei festhalten. Das ist eine Zeile pro Sprache, und es fällt Kunden als Erstes auf. Wenn du bereits einen Leitfaden zur Markenstimme oder eine Support-SOP hast, ist das Glossar die fehlende Seite, die sagt, wie diese Wörter die Übersetzung überstehen.
Warum Support ein Glossar nötiger hat als Marketing
Marketing übersetzt eine Seite einmal, ein Prüfer liest sie, und sie geht live. Support übersetzt jeden Monat Tausende kurzer Nachrichten, live und ohne Korrekturleser. Jedes Ticket ist eine neue Chance für die Engine, für dieselbe Sache ein anderes Wort zu wählen. Deshalb halte ich das Glossar in der Warteschlange für wichtiger als auf der Website.
Ohne eines gehen vier Dinge schief.
Marken- und Produktnamen werden als normale Wörter übersetzt. Der Klassiker:
"Back in Windows 2000 days, I found instances where "Windows" the product name was translated to "vinduer", the danish word for an actual window."
Amazon dokumentiert dieselbe Falle im eigenen Produkt. Ohne Terminologieeintrag macht Amazon Translate aus „Amazon Photos“ auf Französisch „Photos d'Amazon“. Die Lösung: den Namen auf sich selbst abbilden.
Fachbegriffe kommen zu wörtlich heraus. Ich baue bei eesel die KI-Agenten, und die Sorge, die ich von technischen Teams beim Schritt zur Mehrsprachigkeit am häufigsten höre, betrifft ein einzelnes Wort. Ein B2B-Team für Fahrzeug-Telematik auf Zendesk, das in deutsche, spanische und italienische Märkte expandiert, sagte eesel in einem Verkaufsgespräch, es mache sich Sorgen, dass Automotive-Begriffe wie „wiring harness“ nicht in jeder Sprache ein direktes Äquivalent haben. Die Sorge war berechtigt. Ein falscher Teilename in einer Support-Antwort schickt einen Techniker auf die Suche nach dem falschen Teil.
Die Formalität wechselt mitten im Gespräch. In vielen Sprachen gibt es für „you“ eine formelle und eine informelle Form, und Engines halten die Wahl nicht stabil:
"It had difficulties getting choosing a consistent translation of "you" (informal "du" or formal "Sie") and translated the "it's" variant incorrectly."
Ein deutscher Kunde, der in einer Antwort mit „Sie“ und in der nächsten mit „du“ angesprochen wird, hält das für zwei verschiedene Unternehmen. Wähle eine Form pro Sprache und schreibe sie auf.
Maschinell übersetzter Support wirkt lieblos. Kunden merken das und ziehen Schlüsse über die ganze Firma:
"if poking around reveals machine translation into dozens of languages, it's a signal that they're probably not prepared to provide reliable services/support."
Eine Narbe aus eesels eigener Warteschlange gebe ich zu: Ich habe deutsche und niederländische KI-Entwürfe in Kunden-Helpdesks gesehen, die einen nicht ausgefüllten Vornamen-Platzhalter und ein eckig geklammertes „[Employee Name]“ zeigten. Nicht direkt ein Glossarproblem, aber dieselbe Lehre: In einer Sprache, die deine Prüfer nicht lesen, rutschen kleine Fehler durch. Seitdem wird jeder mehrsprachige Rollout, den ich begleite, in jeder Sprache an echten früheren Tickets getestet, bevor etwas rausgeht. Mehr zum großen Ganzen findest du in meinem Leitfaden zu mehrsprachigem KI-Support und zur Frage, ob KI mehrsprachigen Support bewältigen kann.
Unterstützt dein Helpdesk ein Übersetzungsglossar?
Hier hatte ich in jedem Tool eine aufgeräumte Einstellungsseite erwartet. Fehlanzeige. Ich habe das Help Center jedes Anbieters nach Ticket-Übersetzung, Hilfecenter-Übersetzung und jeder Form von Begriffskontrolle durchsucht. Das ist dokumentiert, Stand Oktober 2026:
| Helpdesk | Integrierte Übersetzung | Tarif oder Add-on | Glossar oder Begriffskontrolle |
|---|---|---|---|
| Zendesk | Tickets in allen Kanälen außer Voice; KI-Übersetzung von Hilfecenter-Artikeln | Tickets ab Team; ausgeschlossene Begriffe über das Copilot-Add-on (50 $/Agent/Monat, jährlich) | Teilweise. Bis zu 300 Nicht-übersetzen-Begriffe, nur für Hilfecenter-Artikel. Tickets: noch nicht |
| Freshdesk | Live Translate bei Tickets, ein Klick pro Ticket | Pro und Enterprise; begrenzt auf Copilot-Lizenzen x 100 Tickets/Monat | Nicht dokumentiert |
| Gorgias | Eingehende und ausgehende Ticket-Übersetzung | Alle Helpdesk-Tarife | Nicht dokumentiert (nur ganze Sprachen überspringen) |
| Front | Translate für E-Mail und chatähnliche Kanäle | Starter, Professional, Enterprise | Nicht dokumentiert („Never translate“ ist eine Sprache, kein Begriff) |
| Help Scout | AI Assist, Markieren und Übersetzen | Plus und Pro (nutzerbasierte Tarife) | Nicht dokumentiert |
| HubSpot | Übersetzung der KI-Wissensdatenbank | Service Hub Pro und Enterprise | Nicht dokumentiert |
Zendesk ist die interessanteste Zeile. Die Einstellung für ausgeschlossene Begriffe erlaubt es, bis zu 300 Wörter (Groß- und Kleinschreibung beachtet) aufzulisten, die die KI nicht übersetzen soll, zum Beispiel Markennamen. Diese Liste gilt aber für die KI-Übersetzung von Hilfecenter-Artikeln. Für Ticket-Konversationen sagt Zendesks eigene Ankündigung: „Translation glossaries and excluded terms for translations are scheduled for a future release.“ In den Release Notes vom September 2026 ist es noch nicht enthalten. Zendesks automatische Übersetzung eingehender Nachrichten ist zum Lesen von Tickets solide; sie kann nur deine Begriffe nicht schützen. Wenn du den nativen Weg gegen Add-ons abwägst, habe ich sie in den Zendesk-Übersetzungsoptionen verglichen.
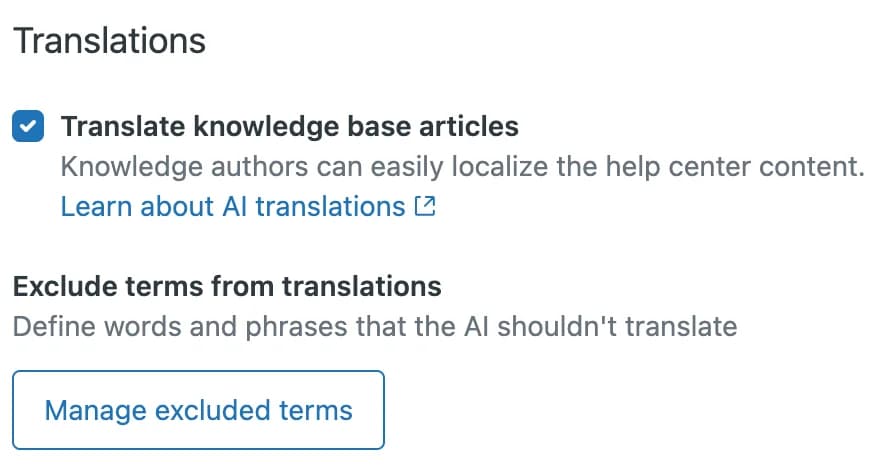
Die Einstellungen von Front zeigen die Lücke deutlich. Du wählst eine Sprache für „Always translate to“ und eine für „Never translate“, praktisch zum Überspringen englischer E-Mails, aber es gibt kein Feld für Begriffe. Fronts KI-Übersetzung ist schnell und gut im Posteingang platziert; sie behandelt nur jedes Wort als Freiwild. Bei Gorgias ist es ähnlich: Einstellungen pro Nutzer legen fest, welche Sprachen übersprungen werden, während der AI Agent ein eigenes Feld für verbotene Wörter hat, was er schreibt.
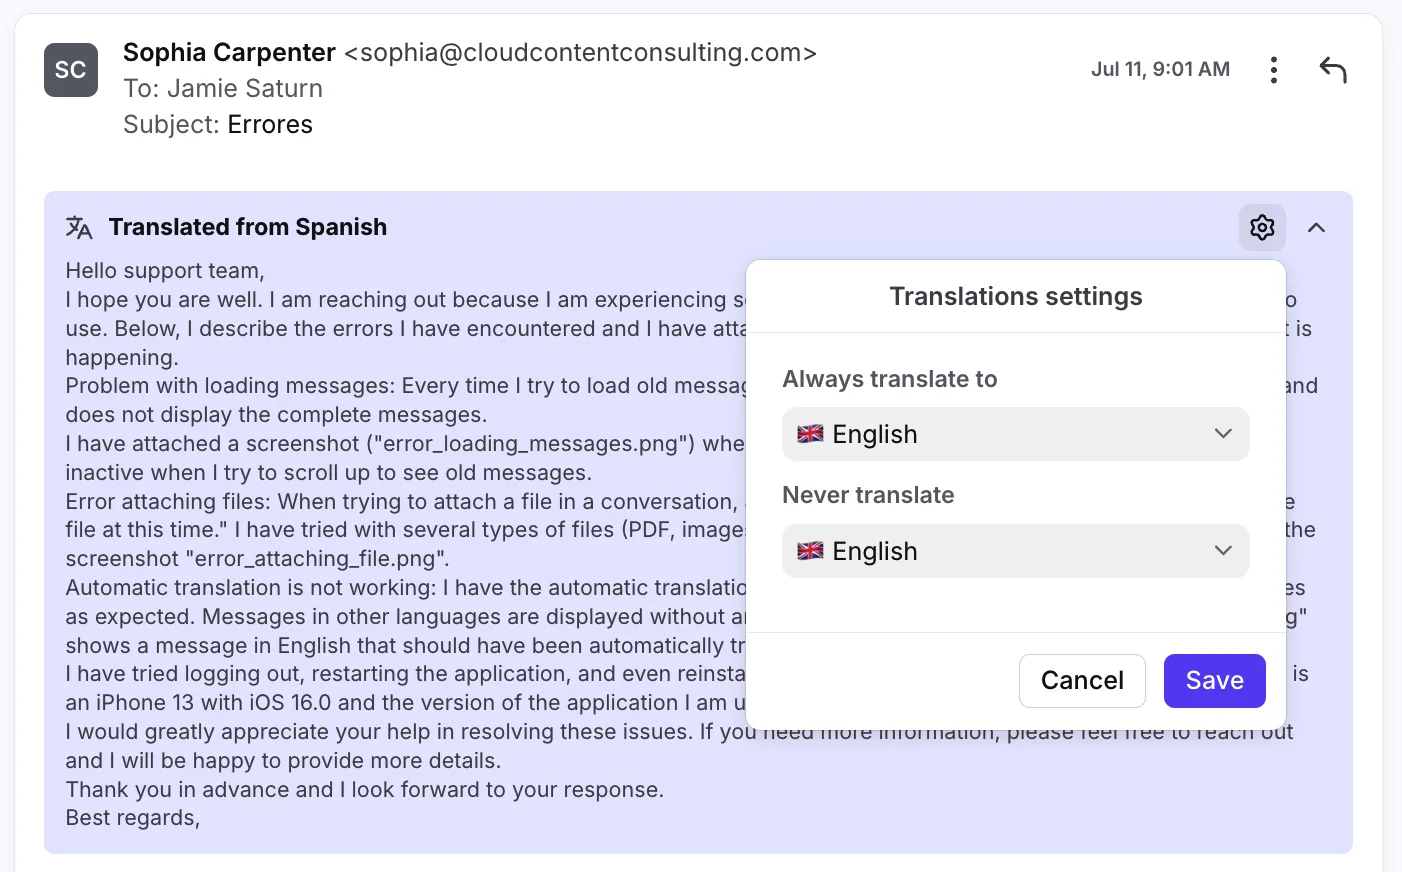
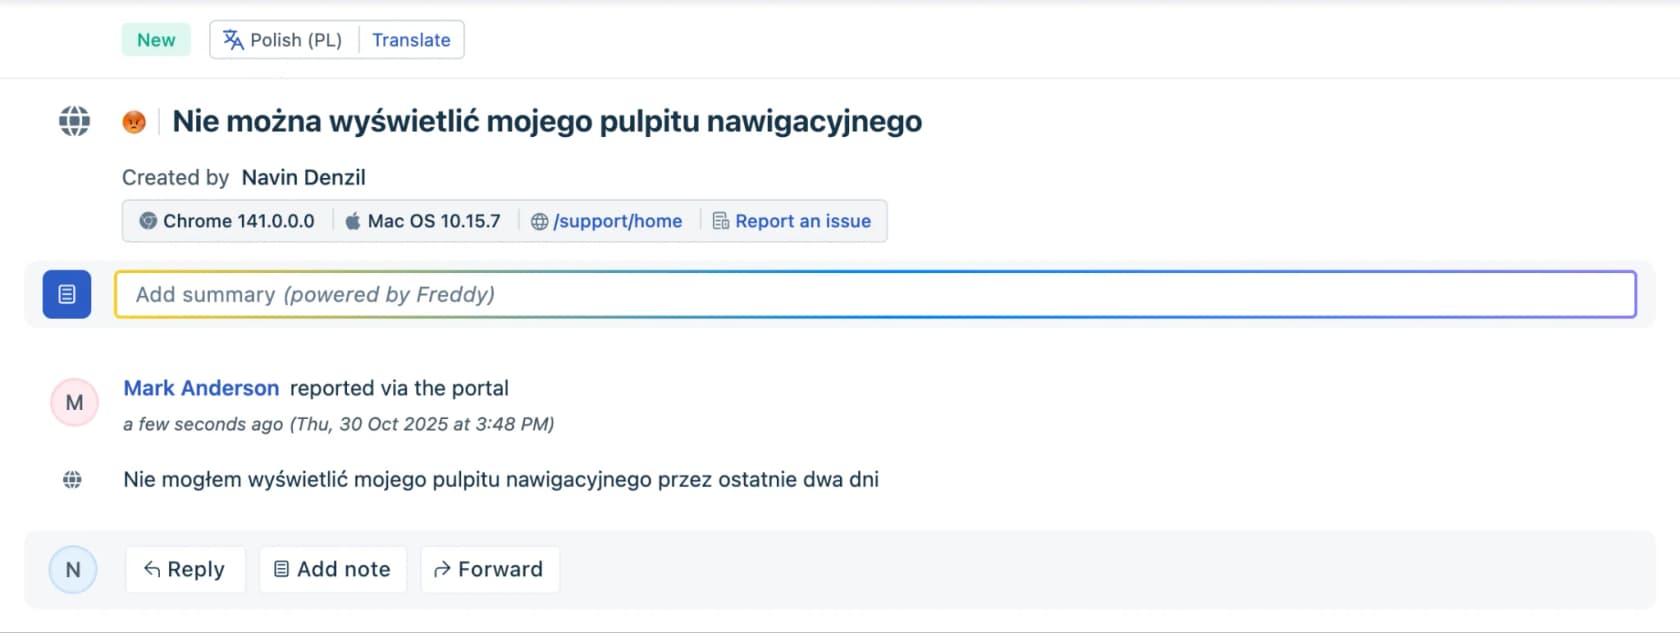
Freshdesk funktioniert auf Ticket-Ebene genauso: ein Sprach-Chip und eine Translate-Schaltfläche, angetrieben von Freddy AI. Es erfüllt seinen Zweck, wenn du ein polnisches Ticket schnell lesen willst. Deine Produktnamen sind auf sich allein gestellt.
Bei den beiden spezialisierten Add-ons sind Glossare ein zentrales Feature. Unbabel nimmt ein vom Kunden geliefertes Glossar als Excel-Liste oder .tbx-Termdatenbank entgegen und weist darauf hin, dass das Glossar „is not automatically created and updated during the translation process.“ Language I/O wendet vor dem Übersetzen ein eigenes Glossar an (ihr Beispiel verhindert, dass aus „apple pencil“ „pomme crayon“ wird) und ergänzt ein selbstverbesserndes Glossar, das neue Begriffe aus deinen Konversationen vorschlägt. Keines von beiden veröffentlicht einen Preis.
Wo Glossare tatsächlich leben: in den Übersetzungs-Engines
Wenn dein Helpdesk das Glossar nicht hält, kann es oft die Engine darunter. Alle vier großen Engines für maschinelle Übersetzung unterstützen eines, mit sehr unterschiedlichen Limits:
| Engine | Glossar-Feature | Wichtige Limits | Nicht übersetzen und Formalität |
|---|---|---|---|
| DeepL | Glossare, dazu Stilregeln und benutzerdefinierte Anweisungen | Web Free und Individual: 1 Glossar, 5 Einträge pro Sprachpaar. Team: 5 Glossare, 1.000 Einträge. API Free: 1 Glossar, 1.000 Einträge | ignore_tags für unübersetzten Text; formality bei unterstützten Sprachen |
| Google Cloud Translation | Unidirektionale Glossare und äquivalente Begriffssätze | 10.485.760 Byte pro Glossardatei, 10.000 Glossare pro Projekt; das Erstellen von Glossaren ist kostenlos | Standardmäßig Groß- und Kleinschreibung beachtet; kontextbezogenes Glossar nur beim Modell Translation LLM |
| Amazon Translate | Benutzerdefinierte Terminologie | 20 MB pro Datei, 100 Dateien pro Region, 1 Datei pro Anfrage | translate="no" in HTML; Formalität für 11 Zielsprachen |
| Azure Translator | Dynamisches Wörterbuch und Custom-Translator-Wörterbücher | Das dynamische Wörterbuch braucht Englisch auf einer Seite und eine festgelegte Quellsprache | notranslate in HTML; formeller, informeller oder neutraler Ton in der API vom 2026-06-06 |
Zwei Details sind wichtiger als die Höchstwerte.
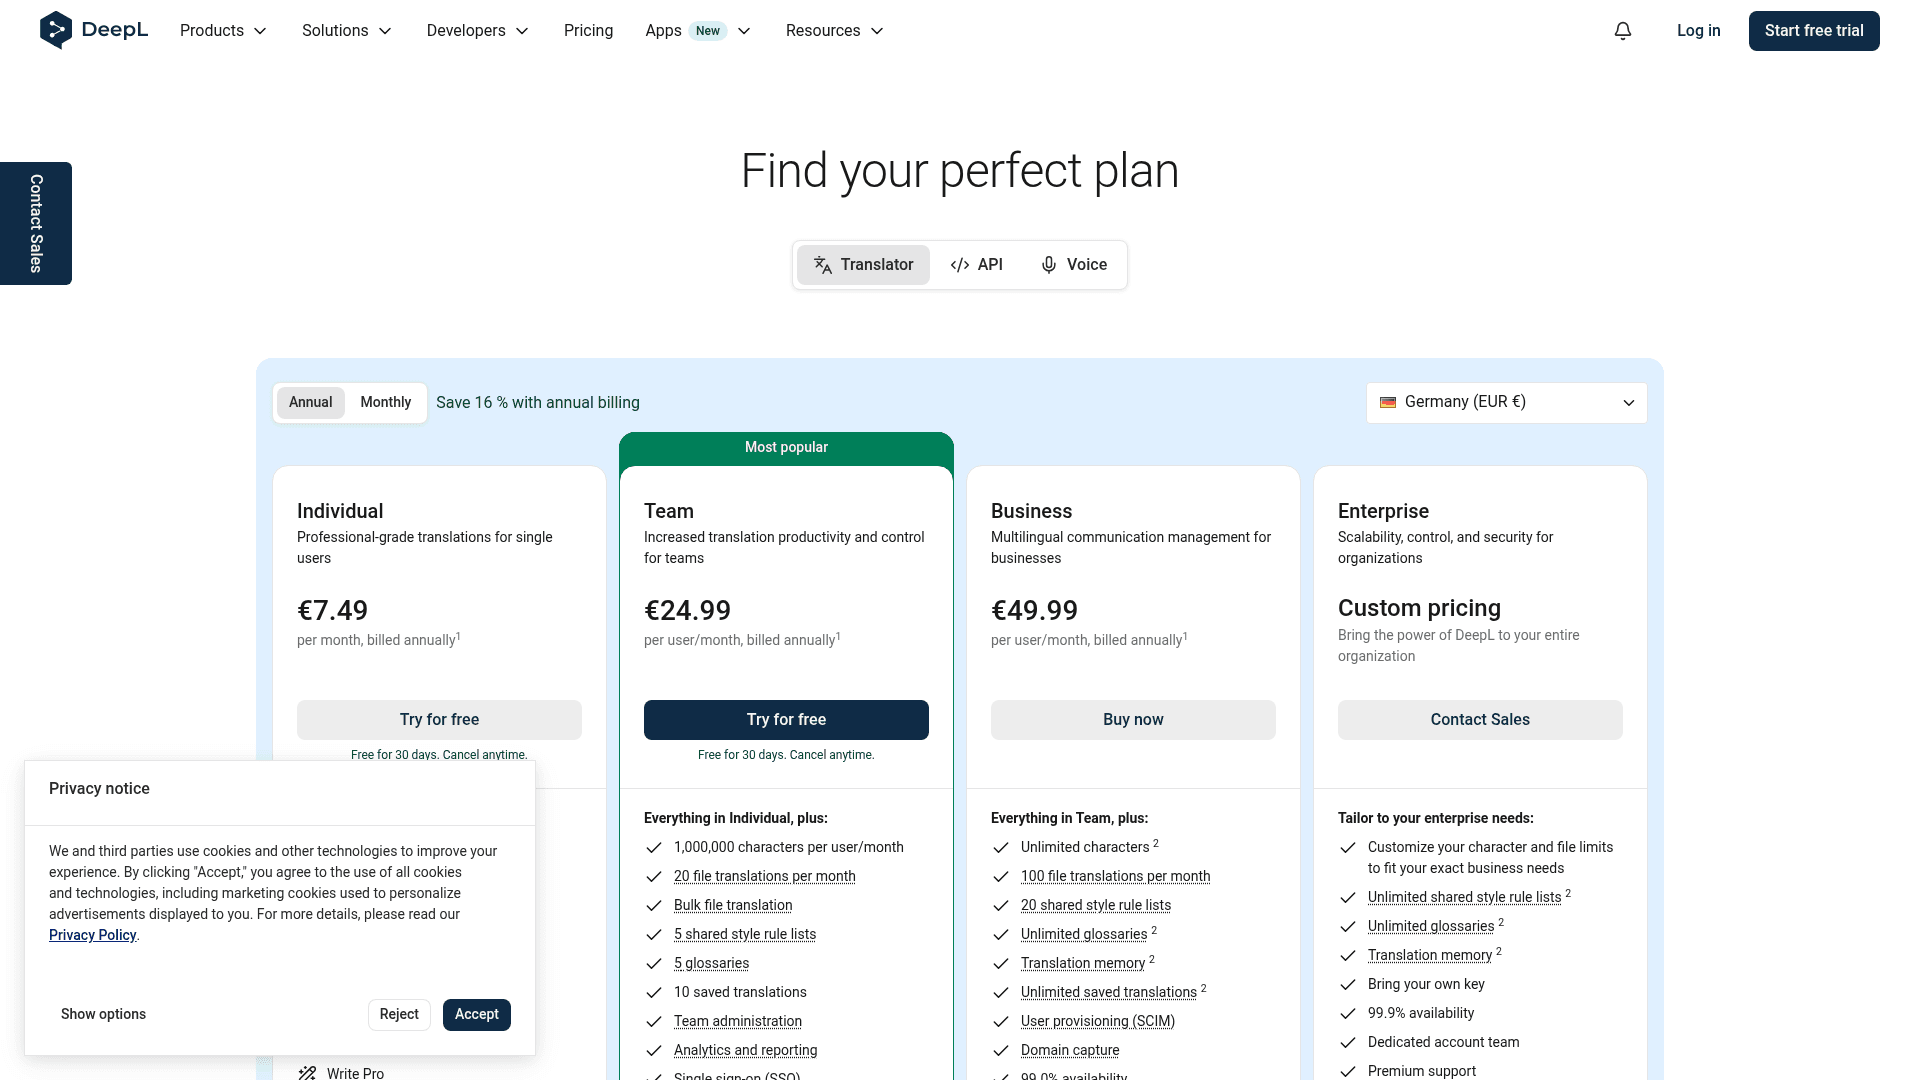
Erstens: Die günstigen Web-Tarife von DeepL fassen jetzt 5 Glossareinträge pro Sprachpaar. Das steht auf DeepLs eigener Tarifseite, und zahlende Nutzer haben es bemerkt:
"Among these changes, reducing the glossary limit to a mere 5 entries is absolutely ridiculous for paying customers who rely on this tool for professional work."

Fünf Einträge reichen für deinen Firmennamen und vier Produkte. Ein echtes Support-Glossar hat meist 50 bis 200 Zeilen, du brauchst also Team oder die API. Meine Aufschlüsselung der DeepL-Preise enthält die komplette Tarifrechnung.
Zweitens: Ein Glossar ist ein starker Hinweis, keine Garantie. Amazon sagt klar, dass es „doesn't guarantee that it will use the target term for every translation“, weil es den Begriff gegen den Kontext abwägt. Microsoft sagt, sein neuronales Wörterbuch verfehle den gewünschten Begriff in „less than 0.1%“ der Fälle. Beides ist ehrlich, und beides heißt, dass du trotzdem Stichproben machen musst. Wenn du Engines vergleichst, deckt meine Liste der DeepL-Alternativen die Support-tauglichen Optionen ab, und mein DeepL-Test behandelt die Genauigkeit.
So baust du ein Glossar für Support-Übersetzungen in 7 Schritten
So würde ich es mit einer Support-Leitung und einem zweisprachigen Prüfer pro Sprache angehen. Plane etwa eine Woche für die erste Version ein und danach 30 Minuten im Monat.
1. Sammle Kandidatenbegriffe dort, wo Kunden sie tatsächlich sehen
Brainstorme nicht von einem leeren Blatt. Durchsuche vier Orte:
- Die UI-Bezeichnungen deiner App (Schaltflächen- und Menünamen, die Kunden dir zurücktippen)
- Deine 30 wichtigsten Makros und gespeicherten Antworten, einschließlich mehrsprachiger Vorlagen
- Die Artikeltitel deines Hilfecenters
- Frühere Tickets, in denen ein Agent eine Übersetzung korrigiert hat oder ein Kunde gefragt hat „Was meinen Sie mit X?“ (eine Analyse von Wissenslücken findet sie schnell)
Ziel sind 50 bis 150 Begriffe. Alles über 200 bedeutet meist, dass du normale Wörter aufgenommen hast, mit denen die Engine ohnehin gut klarkommt.
2. Gib jedem Begriff eine Regel
Jede Zeile braucht genau eine Regel. Wenn du unsicher bist, welche, gehe den Begriff hierdurch:
Welche Glossarregel braucht dieser Begriff?
Öffne die erste Frage, die für deinen Begriff zutrifft.
Ist es der Name deines Unternehmens, Produkts oder Tarifs?
eesel,eesel. So verhindert Amazon, dass aus „Amazon Photos“ „Photos d'Amazon“ wird.Ist es der Name einer Schaltfläche, eines Menüs oder einer Funktion in deiner App?
Ist es ein Fachbegriff mit mehreren möglichen Übersetzungen?
Ändert sich das richtige Wort je nach Land?
fr-FR und fr-CA oder es-ES und es-MX hinzu. Deine Engine muss regionale Varianten unterstützen, damit das greift.Ist es ein Wort, das du nie in einer Antwort haben willst?
Nichts davon?
3. Lege die Formalität für jede Sprache einmal fest
Schreibe eine Zeile pro Sprache: Deutsch nutzt „Sie“, Französisch „vous“, Spanisch „usted“ oder „tú“, Japanisch die höfliche Form. Ein HN-Kommentator, der Ratgeber für Menschen schreibt, die nach Deutschland ziehen, hat die Regel einfach formuliert:
"You must choose formal or informal pronouns (tu/vous, du/Sie) and use them consistently."
Stelle sie dann in der Engine ein, wo es geht (DeepL und Amazon haben beide eine Formalitätseinstellung), und in den Anweisungen deines KI-Agenten. Zendesk-Nutzer haben genau das für die Hilfecenter-Übersetzung gefordert, nachdem sie festgestellt hatten, dass es „always translates to formal German“, und es ist noch keine Einstellung dokumentiert. Eine gute Konfiguration von Ton und Markenstimme deckt den Rest ab.
4. Schreibe es als eine CSV mit einer Zeile pro Begriff
Jede Engine akzeptiert CSV, also fang damit an. Halte es schlicht:
term,rule,de,fr,es,notes
eesel,keep,eesel,eesel,eesel,always lowercase
wiring harness,approved,Kabelbaum,faisceau de câbles,mazo de cables,used by field techs
refund,approved,Rückerstattung,remboursement,reembolso,never "credit"
formality,setting,Sie,vous,usted,applies to every reply
Die Spalte notes ist für Menschen. Dort erklärst du das Warum, damit die nächste Person eine bewusste Entscheidung nicht „korrigiert“.
5. Lade sie in jedes Tool, das an Kunden schreibt
Diesen Schritt überspringen die meisten Teams. Sie laden das Glossar in eine Engine und glauben, fertig zu sein, doch ein im letzten Jahr auf Französisch geschriebenes Makro, ein Hilfecenter-Artikel und ein KI-Agent verwenden weiter die alten Wörter.
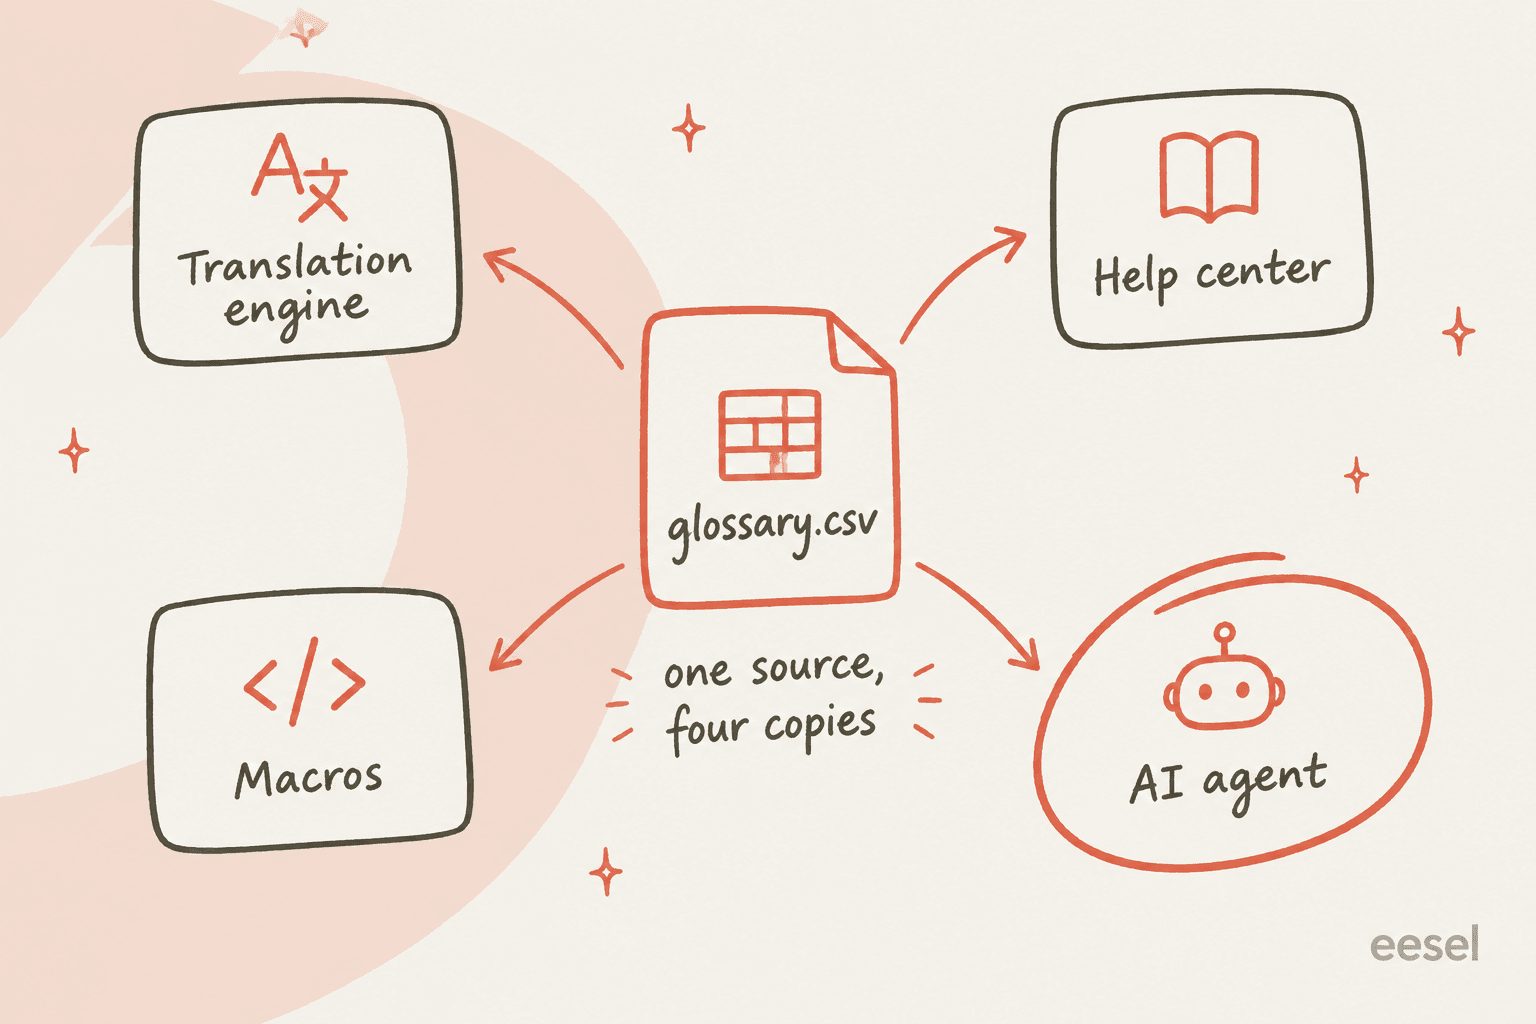
Die CSV ist die Quelle. Alles andere sind Kopien:
- Übersetzungs-Engine: als DeepL-Glossar, Google-Glossar oder Amazon-Terminologiedatei hochladen. Dasselbe gilt für jedes Echtzeit-Übersetzungstool, das du anbindest.
- Hilfecenter: Markennamen zu Zendesks ausgeschlossenen Begriffen hinzufügen (oder zum Pendant in deinem Gorgias-Hilfecenter) und bestehende mehrsprachige Artikel per Suchen und Ersetzen korrigieren.
- Makros: deine vorgefertigten Antworten in jeder Sprache mit der CSV abgleichen.
- KI-Agent: gib ihm die Datei und die Formalitätsregeln (mehr dazu weiter unten).
6. Teste es an echten früheren Tickets, nicht an einem Demosatz
Ein Glossar, das bei „Bitte setze dein Passwort zurück“ funktioniert, kann bei einem unordentlichen echten Ticket trotzdem versagen. Nimm 20 gelöste Tickets pro Sprache, lass sie durch dein Setup laufen und bitte deinen zweisprachigen Prüfer, nur die Glossarbegriffe und die Formalität zu kontrollieren. Das ist ein 30-Minuten-Job pro Sprache. Es ist dieselbe Idee wie ein Audit der Wissensdatenbank, nur enger gefasst.
7. Gib ihm einen Verantwortlichen und einen Korrekturkreislauf
Ein Glossar verfällt wie ein Hilfecenter. Neue Funktionen erscheinen mit neuen Namen, und niemand trägt sie ein. Bestimme einen Verantwortlichen und halte den Kreislauf klein:
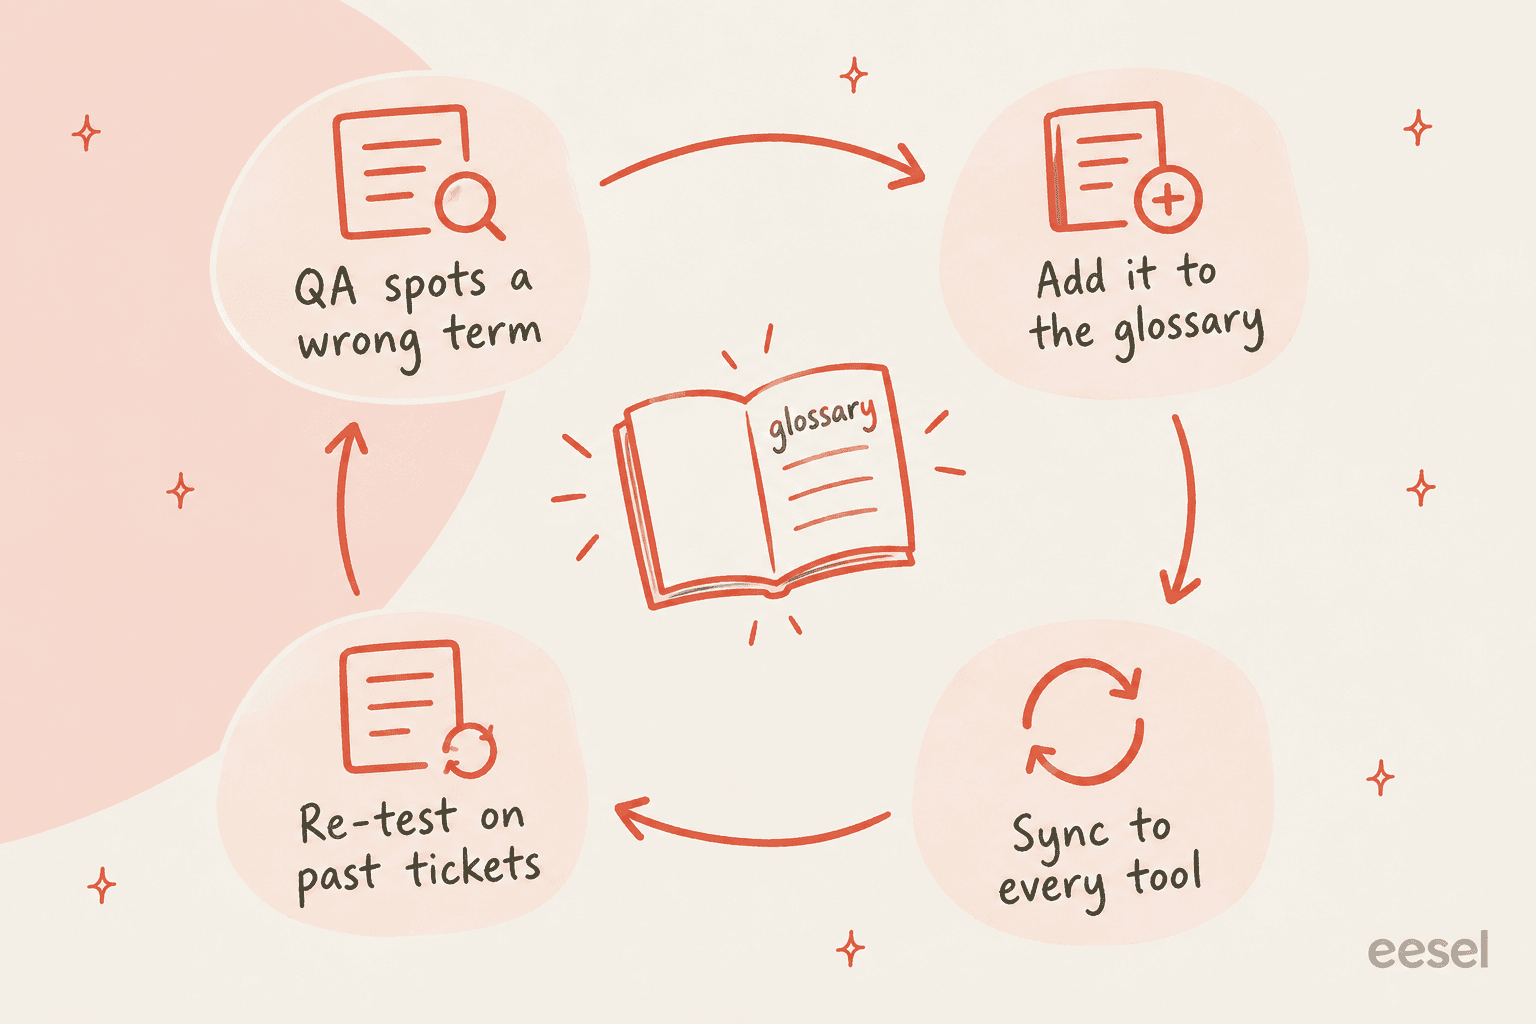
Füge deiner Release-Checkliste „neue Begriffe?“ hinzu und behandle jede Glossaränderung wie jede andere Richtlinienänderung: Quelle aktualisieren, Kopien synchronisieren, das Team informieren.
Häufige Fehler, die ich sehe
- Das Glossar als Übersetzungswörterbuch behandeln. Enthält es 2.000 normale Wörter, pflegt es niemand, und die Engine wird schlechter. Beschränke es auf die Begriffe, bei denen ein Fehler wehtut.
- Eine französische Spalte für zwei französische Märkte. Ein kanadischer DeepL-Kunde schrieb auf Trustpilot, er habe für das Glossar bezahlt, weil Berichte „kept being translated with weird Parisian french terms.“ Trenne Regionen, wenn deine Kunden es tun.
- Die ausgehende Richtung vergessen. Die meiste Helpdesk-Übersetzung läuft in beide Richtungen, auch im mehrsprachigen Live-Chat. Dein Glossar braucht auch die Richtung von der Sprache des Kunden ins Englische, sonst missverstehen Agenten eingehende Produktnamen.
- Annehmen, dass der KI-Agent das Glossar der Engine liest. Tut er nicht. Ein KI-Agent, der Antworten direkt auf Deutsch schreibt, berührt dein DeepL-Glossar nie. Er braucht eine eigene Kopie, als Wissen oder Anweisungen.
- Kein Verantwortlicher. Das Glossar ist am Starttag korrekt und beim nächsten Produkt-Release falsch. Die Gewohnheiten aus meinem Leitfaden zum Wissenserhalt gelten auch hier.
Ein Glossar mit einem KI-Support-Agenten nutzen
Hier der Perspektivwechsel, den ich dir mitgeben möchte. Sobald ein KI-Agent Antworten in der Sprache des Kunden entwirft, ist der Agent deine Übersetzungsschicht, und das Glossar muss in ihm leben. Zuerst dein Hilfecenter zu übersetzen ist weniger wichtig, als du denkst. Meine Übersicht der besten KI für mehrsprachigen Support deckt das Feld ab. In einem eesel-Test antwortete der Agent bei einer deutschen Schmuckmarke auf Zendesk und Shopify mit etwa 1.000 Tickets im Monat in acht Sprachen, ohne für eine davon eingerichtet zu sein. Was er von selbst nicht wissen kann: dass dein „Pro plan“ nie „Profi-Tarif“ heißt.
Bei eesel sagen die Docs, dass der Agent in der Sprache des Kunden antwortet, ohne dass du dein Hilfecenter übersetzt. Es gibt keinen eigenen Glossar-Bildschirm, und das sage ich lieber offen. Die Begriffskontrolle läuft über drei Dinge, die die Docs unterstützen:
- Anweisungen. Regeln in normaler Sprache, die der Agent bei jeder Antwort in jeder App liest, etwa „use Sie in German“ oder „never translate our product names“ (Instructions and Memory).
- Das Glossar als Datei. Lange Referenzlisten gehören in eine Datei, die der Agent nachschlägt, nicht in Anweisungen. Lade die CSV direkt hoch (CSV, Word, PDF oder Markdown bis 25 MB) oder verbinde sie aus Google Drive oder Confluence (Dateien hochladen).
- Korrekturen, die bleiben. Korrigiere einen Begriff in einem Entwurf, bestätige mit Ja, und der Agent schreibt die Korrektur in seine eigenen Anweisungen, sodass sie nächste Woche und in jeder Sprache gilt.
Bevor er etwas sendet, spielt die integrierte Simulation echte frühere Tickets durch und bewertet die Antworten, also Schritt 6 von oben, bereits für dich erledigt. Die meisten Teams starten mit Entwürfen als interne Notizen, damit Agenten die Formulierung prüfen können, bevor Kunden sie sehen.
Wenn du das aus einem Terminal steuerst, bedient die eesel CLI dasselbe Teammitglied. eesel files upload ./glossary.csv fügt die Begriffsliste hinzu, eesel instructions insert ergänzt eine Formalitätsregel, und eesel chat korrigiert den Agenten genauso wie das Dashboard. Jeder Befehl gibt JSON aus, sodass ein Coding-Agent wie Claude Code oder Cursor das Glossar als Teil deines Release-Skripts neu synchronisieren kann. Damit wird Schritt 7 von einer monatlichen Pflichtübung zu einer Zeile in der CI.
eesel für mehrsprachigen Support testen
Wenn dein Team auf Zendesk, Freshdesk, Gorgias oder Front in mehr als einer Sprache antwortet, stößt eesel als KI-Teammitglied zu deinem Helpdesk, entwirft Antworten in der Sprache jedes Kunden, lernt aus deinen früheren Tickets und Makros und befolgt das Glossar und die Formalitätsregeln, die du ihm in einfachen Worten gibst. Korrigiere einen Begriff einmal, und er bleibt in jeder Sprache korrigiert.

Der kostenlose Tarif enthält 100 Credits, um es an deinen eigenen Tickets zu testen, und bezahlte Tarife beginnen bei 299 $ im Monat für 500 Credits (Preise). Teste eesel und lass dein Glossar über eine Woche echter Tickets laufen, bevor irgendetwas einen Kunden erreicht.