

KI für Statusseiten-Updates funktioniert am besten in die andere Richtung: Die Statusseite speist die KI, nicht die KI die Statusseite. Die Statusseite ist der eine Ort, an dem das Engineering sich darauf geeinigt hat, was stimmt. Ein KI-Agent, der sie liest, kann jedes „Ist es down?“-Ticket dem gemeldeten Vorfall zuordnen, mit dem veröffentlichten Text Wort für Wort antworten und bei jedem Ticket nachfassen, sobald die Seite Resolved anzeigt.
Das Update selbst zu schreiben bleibt eine menschliche Entscheidung. Die KI kann es aus dem Incident-Channel entwerfen, aber ein Entwickler gibt es frei, bevor es rausgeht, weil diese eine Nachricht alle Kunden gleichzeitig erreicht.
Die Technik gibt es schon: Statuspage sendet ab dem Startup-Tarif für 99 $ bei jedem Vorfall-Update einen Webhook, und Zendesk und Freshdesk gruppieren beide Störungstickets, aber keines von beiden schreibt die Antworten, solange die Störung läuft. Diese Lücke füllt ein KI-Teammate wie eesel, den SE Ranking über 4,650 Konversationen im Monat einsetzt, mit Agenten, die so eingerichtet sind, dass sie nie etwas versprechen, was das Team nicht halten kann.
Warum hinkt die Statusseite dem Support-Posteingang hinterher?
Ich baue bei eesel Integrationen, das heißt, ich lese viel darüber, was APIs und Webhooks tatsächlich senden, im Gegensatz zu dem, was die Marketingseite sagt. Statusseiten sind ein gutes Beispiel. Jedes große Statusseiten-Tool meldet jedes Vorfall-Update bereits an alles, was sich anmeldet. Die meisten Helpdesks melden sich nie an.
Während einer Störung laufen also zwei Uhren gleichzeitig. Das Engineering behebt das Problem und postet, wenn jemand eine Minute hat, ein Update. Der Support sieht Tickets mit derselben Frage in fünfzig verschiedenen Formulierungen eintreffen, und jeder Agent prüft Slack, die Statusseite und seine Kollegen, um herauszufinden, was er sagen darf. Ein Hacker-News-Kommentator beschrieb die Kundenseite ganz klar:
"If I'm having issues but you show all green, I'm submitting a case."

Und die Verzögerung ist real. Ein anderer Kommentator über den Ausfall eines Hosting-Anbieters:
"they only updated the status page to indicate that there's an issue ~20 minutes into the outage."
Zwanzig Minuten sind in einer Support-Warteschlange eine lange Zeit, und deine erste Antwortzeit leidet darunter. Die meisten Teams greifen zu „KI soll die Status-Updates schneller schreiben“. Ich denke, das löst das kleinere Problem. Das größere ist, dass Statusseite und Helpdesk nicht miteinander sprechen, sodass jeder Agent zum menschlichen Vermittler zwischen beiden wird. Wenn du meinen Leitfaden zum Support bei Ausfällen gelesen hast: Dieser Beitrag ist die Verdrahtung darunter, also wie die Statusseite zur Wahrheitsquelle der KI wird.
Wie sollten KI und Statusseite zusammenarbeiten?
Das Muster, das ich bauen würde, hat fünf Schritte, und nur in einem davon schreibt die KI etwas Neues.
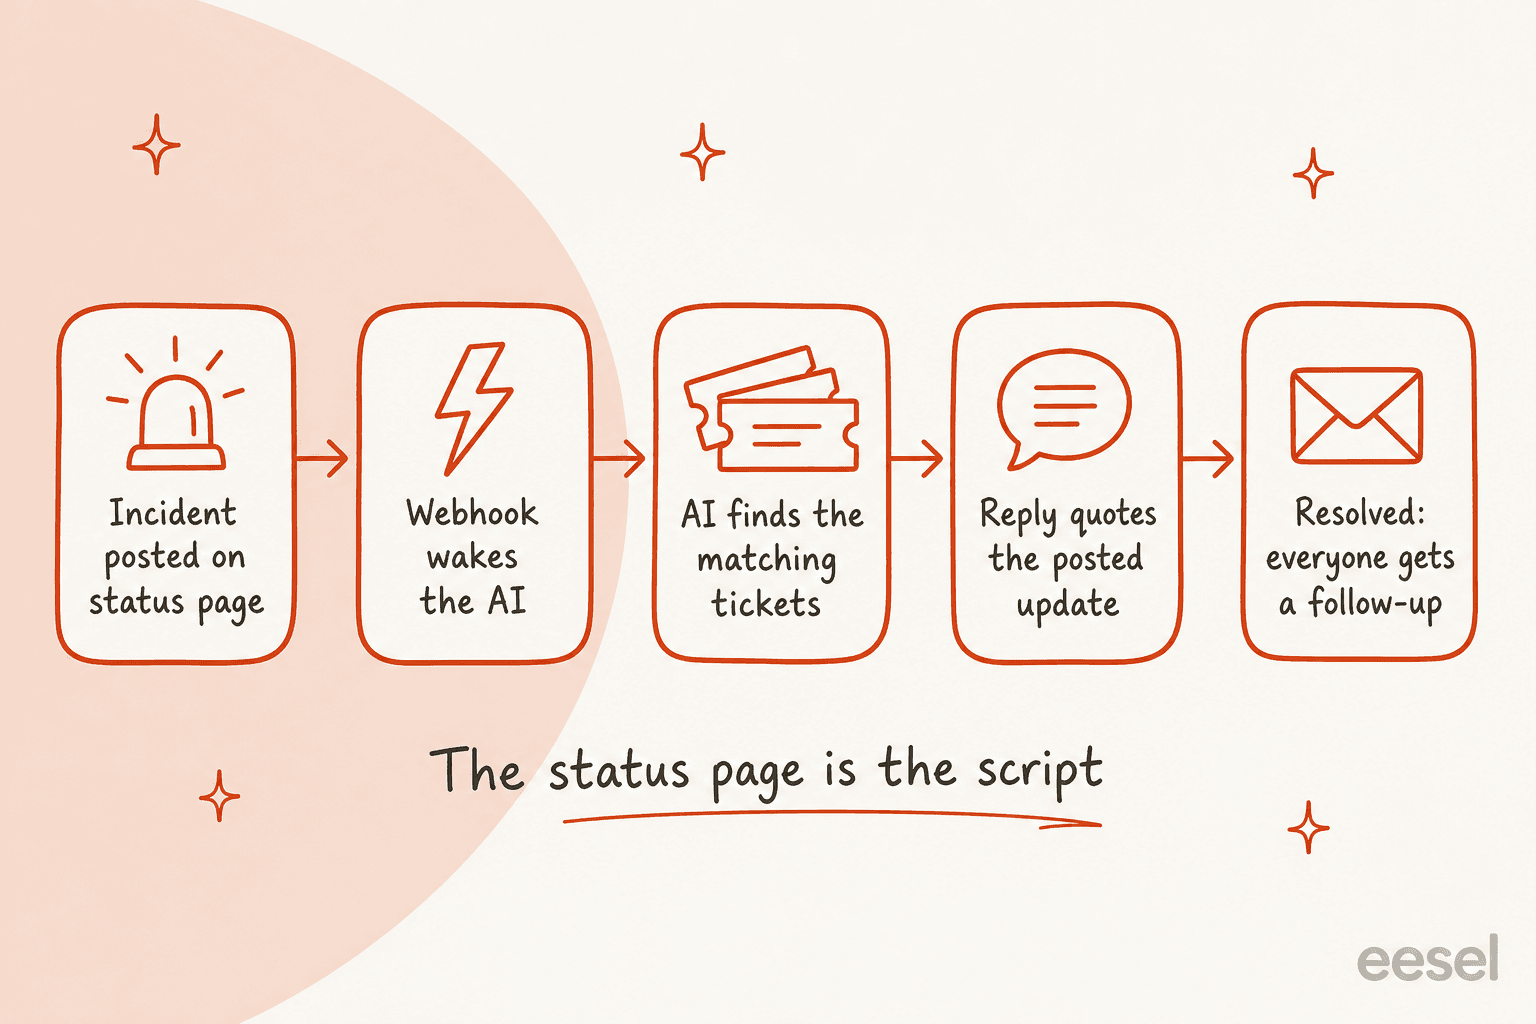
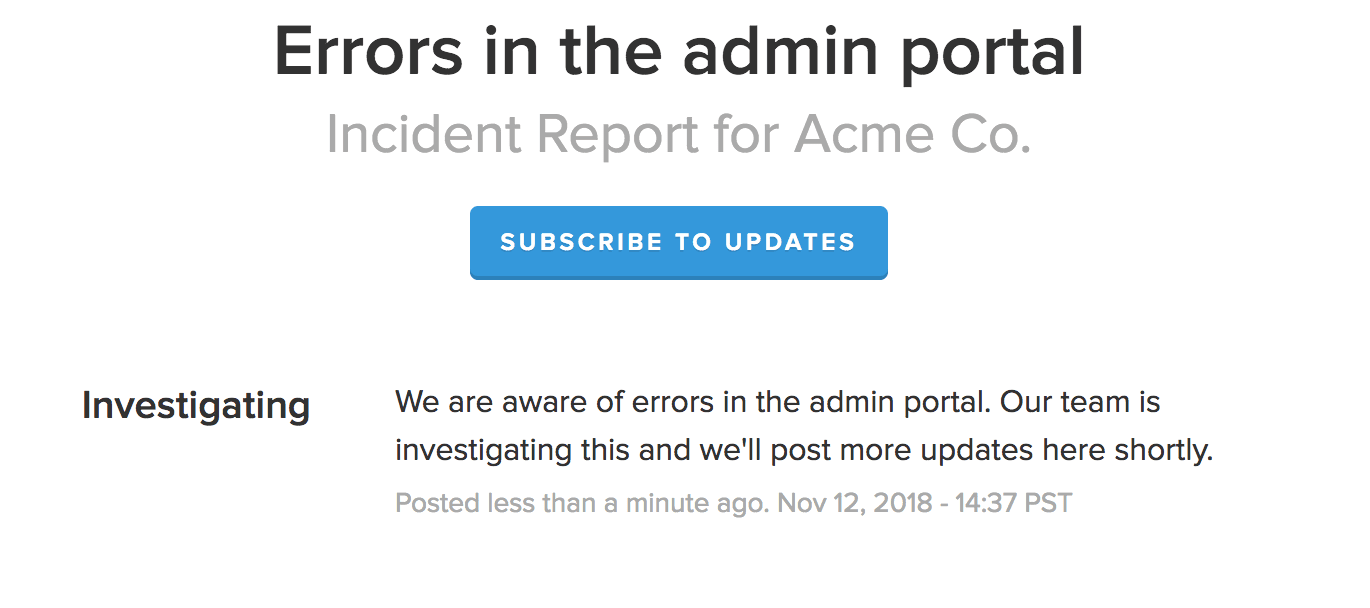
- Ein Entwickler veröffentlicht den Vorfall. Bei Atlassian Statuspage sind das ein Name, einer von vier Status (Investigating, Identified, Monitoring, Resolved), eine Nachricht und die betroffenen Komponenten.
- Die Statusseite informiert die KI. Bei jedem Erstellen oder Aktualisieren wird ein Webhook ausgelöst, und die KI liest Vorfallname, Status, Nachricht und Komponenten.
- Die KI findet die passenden Tickets. Neue und offene Tickets, die die betroffene Komponente beschreiben, werden dem Vorfall zugeordnet, ähnlich wie die Ticket-Deduplizierung wiederkehrende Fragen gruppiert.
- Die Antwort zitiert die Statusseite. Der Kunde bekommt die veröffentlichte Nachricht und einen Link, nichts, was die Entwickler nicht geschrieben haben.
- Resolved schließt den Kreis. Wenn der Status auf Resolved wechselt, bekommt jedes getaggte Ticket eine Nachfassnachricht, auch die, die verstummt waren.
Die Reihenfolge ist wichtig, weil die KI nie entscheidet, was über die Störung wahr ist. Sie entscheidet, welche Tickets zur Störung gehören, eine Sortieraufgabe, in der KI gut ist. Die Fakten kommen von der Seite.
Was senden Webhooks und APIs von Statusseiten tatsächlich?
Das ist der Teil, der mir am wichtigsten ist, denn er entscheidet, was du ohne eigenen Code bauen kannst.
Atlassian Statuspage kann einen Webhook senden, "when you create or update an incident, or update a component status", laut dem Leitfaden zu Webhook-Benachrichtigungen. Die Nutzlast enthält den Gesamtstatus der Seite, die geänderte Komponente mit altem und neuem Status oder den Vorfall mit seinem letzten Update. Dein Endpunkt muss innerhalb von 30 Sekunden mit einem 2xx-Code antworten. Webhook-Benachrichtigungen gibt es ab dem Startup-Tarif für 99 $ im Monat; Free und Hobby listen nur E-Mail, Slack und Teams.
Es gibt auch eine Leseseite. Jede öffentliche Statuspage-Seite stellt einen Summary-Endpunkt mit Statusindikator, Komponentenstatus und ungelösten Vorfällen bereit, ohne Schlüssel. Die authentifizierte Statuspage-REST-API erlaubt es, Vorfälle zu erstellen und zu aktualisieren, begrenzt auf 1 Anfrage pro Sekunde und Token. Das Limit ist für das Posten von Updates in Ordnung und ungeeignet für Polling aus einem ausgelasteten Helpdesk.
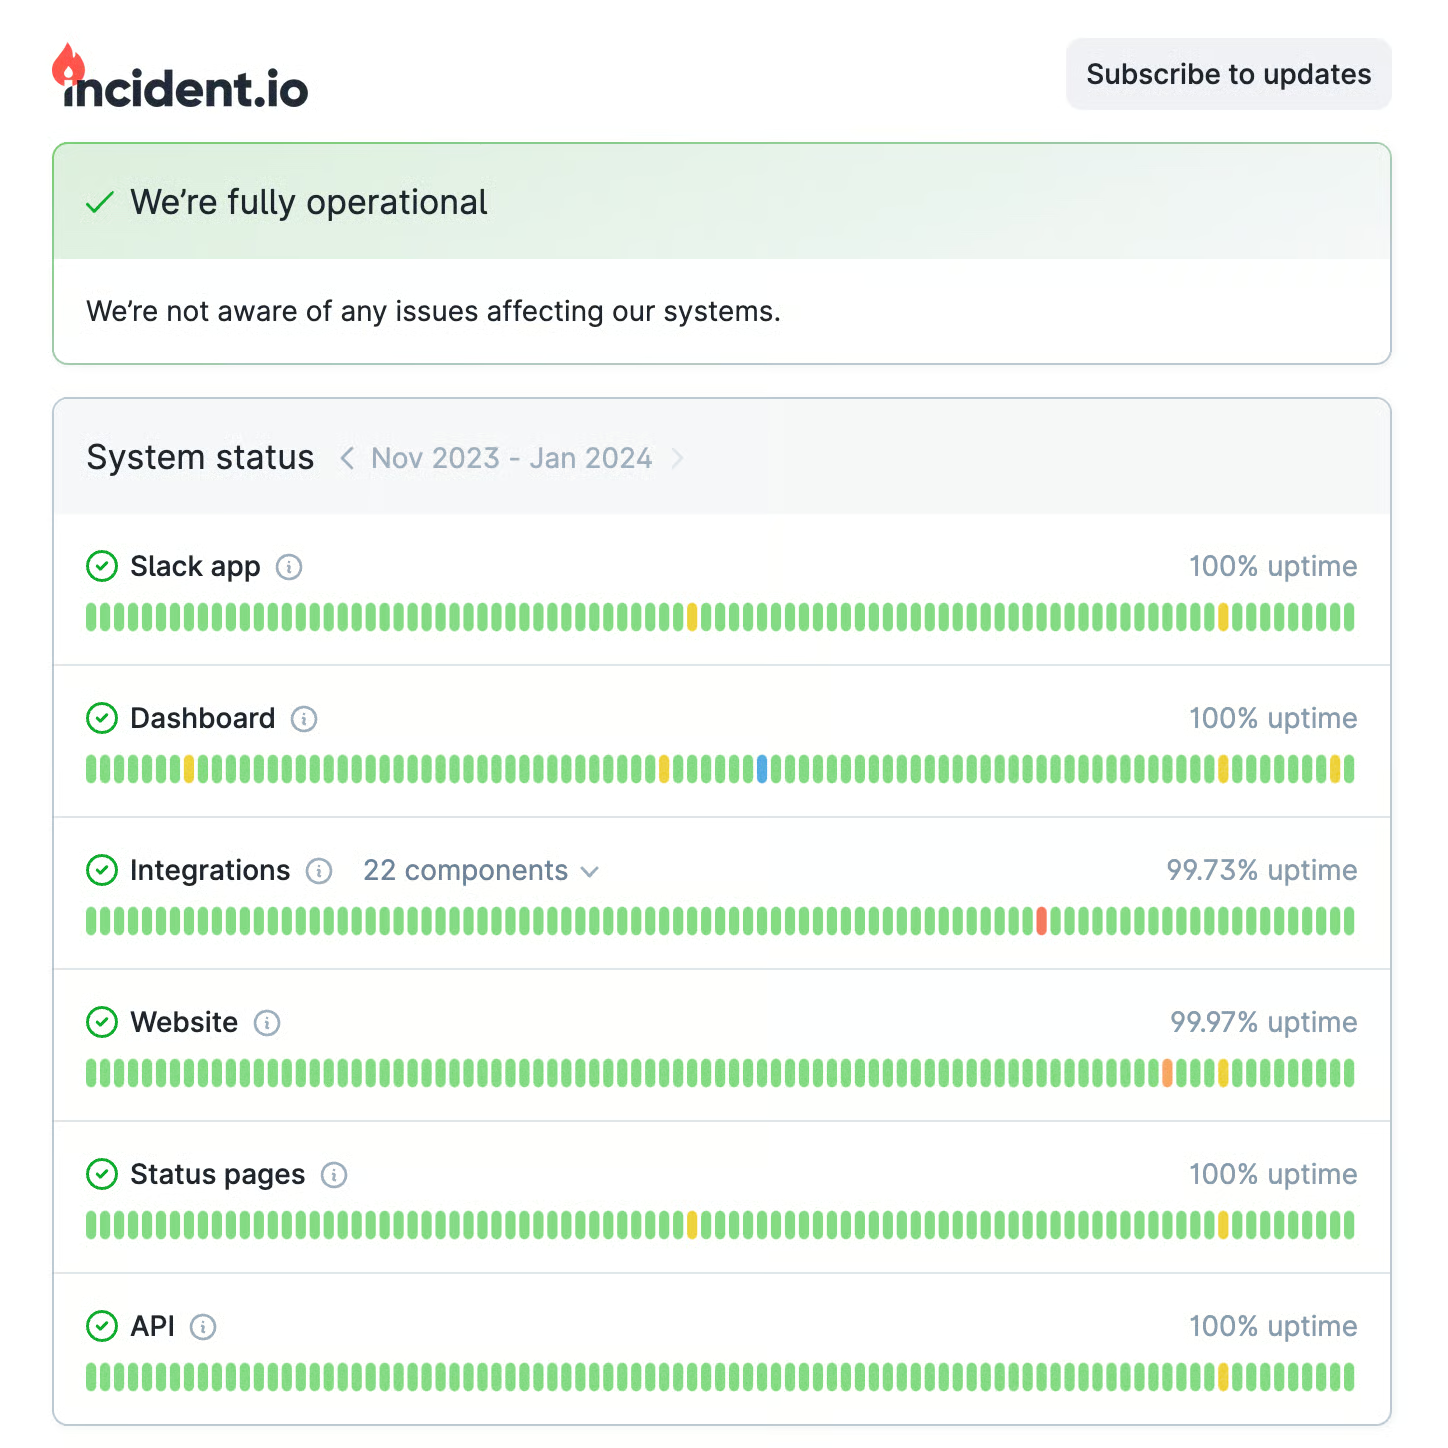
incident.io baut die Statusseite in seinen Incident-Workflow ein, sodass "you're prompted to post when it matters most", und du kannst "automate updates entirely or use templates with pre-approved messaging", laut seiner Statusseiten-Seite. Kunden abonnieren per E-Mail, Slack und RSS.
PagerDuty sagt, seine externen Statusseiten lassen Besucher "via email, Slack or webhook" abonnieren, was dir denselben Push-Auslöser wie bei Statuspage gibt.
Für ein eesel-Setup wird ein Push zu einer Webhook-Automatisierung: Du bittest den Agenten um eine URL, trägst sie bei der Statusseite als Webhook-Abonnent ein, und jedes Vorfall-Update weckt den Agenten mit der vollständigen Nutzlast. Ein Delivery-Header wie X-Eesel-Reference, gesetzt auf die Vorfall-ID, gruppiert alle Updates eines Vorfalls auf der Activity-Seite. Für eine Seite, die nicht pushen kann, lässt Network Access den Agenten die API der Statusseite direkt aufrufen, wobei der Schlüssel in den Einstellungen liegt und der KI nie angezeigt wird.
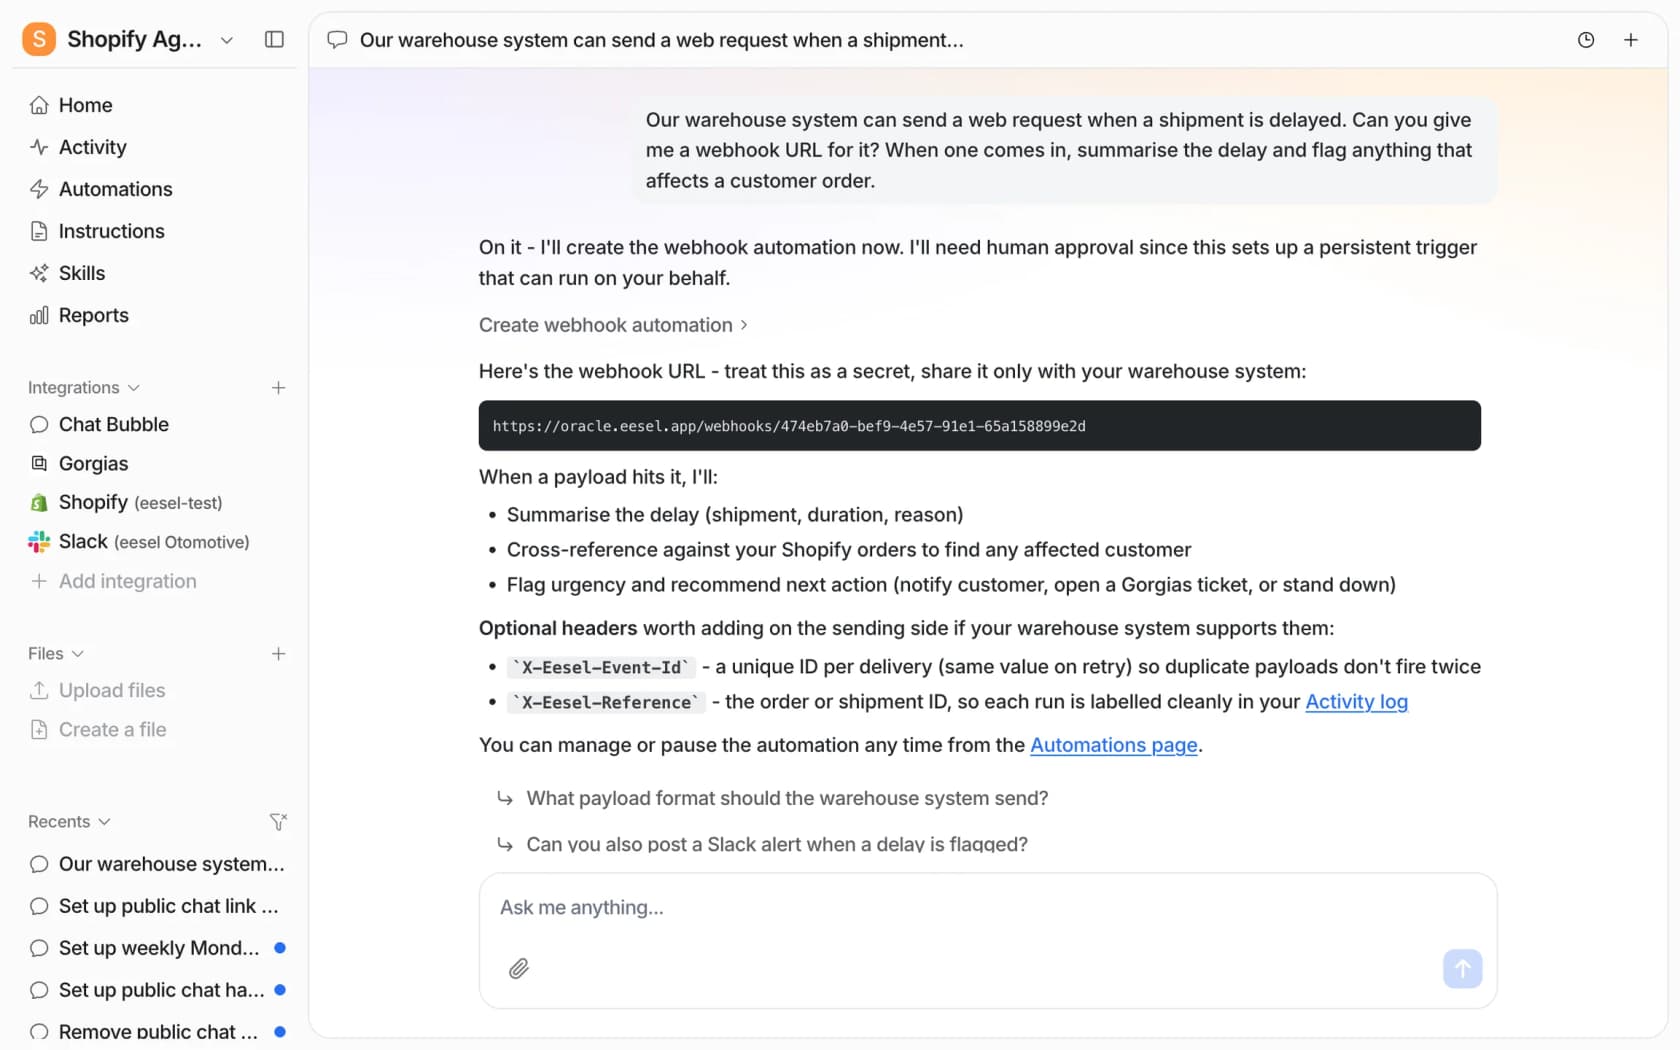
Zwei Grenzen, die du vor einem Vorfall kennen solltest, nicht währenddessen. Die Webhook-URL von eesel nimmt 60 Zustellungen pro Minute und Workspace an und verarbeitet acht gleichzeitig. Eine Statusseite sendet pro Vorfall eine Handvoll Updates, das reicht also locker, ist aber der Grund, warum ich nie den rohen Alarmstrom eines Monitoring-Tools darauf richten würde. Füttere sie mit dem von Menschen bestätigten Vorfall, nicht mit jedem Aussetzer.
Wie sollte KI Störungstickets sortieren?
Sobald die KI weiß, welcher Vorfall aktiv ist, landet jedes eingehende Ticket in einer von vier Spuren. Hier liegt der größte Teil des Nutzens, und hier sind die meisten Setups zu grob.
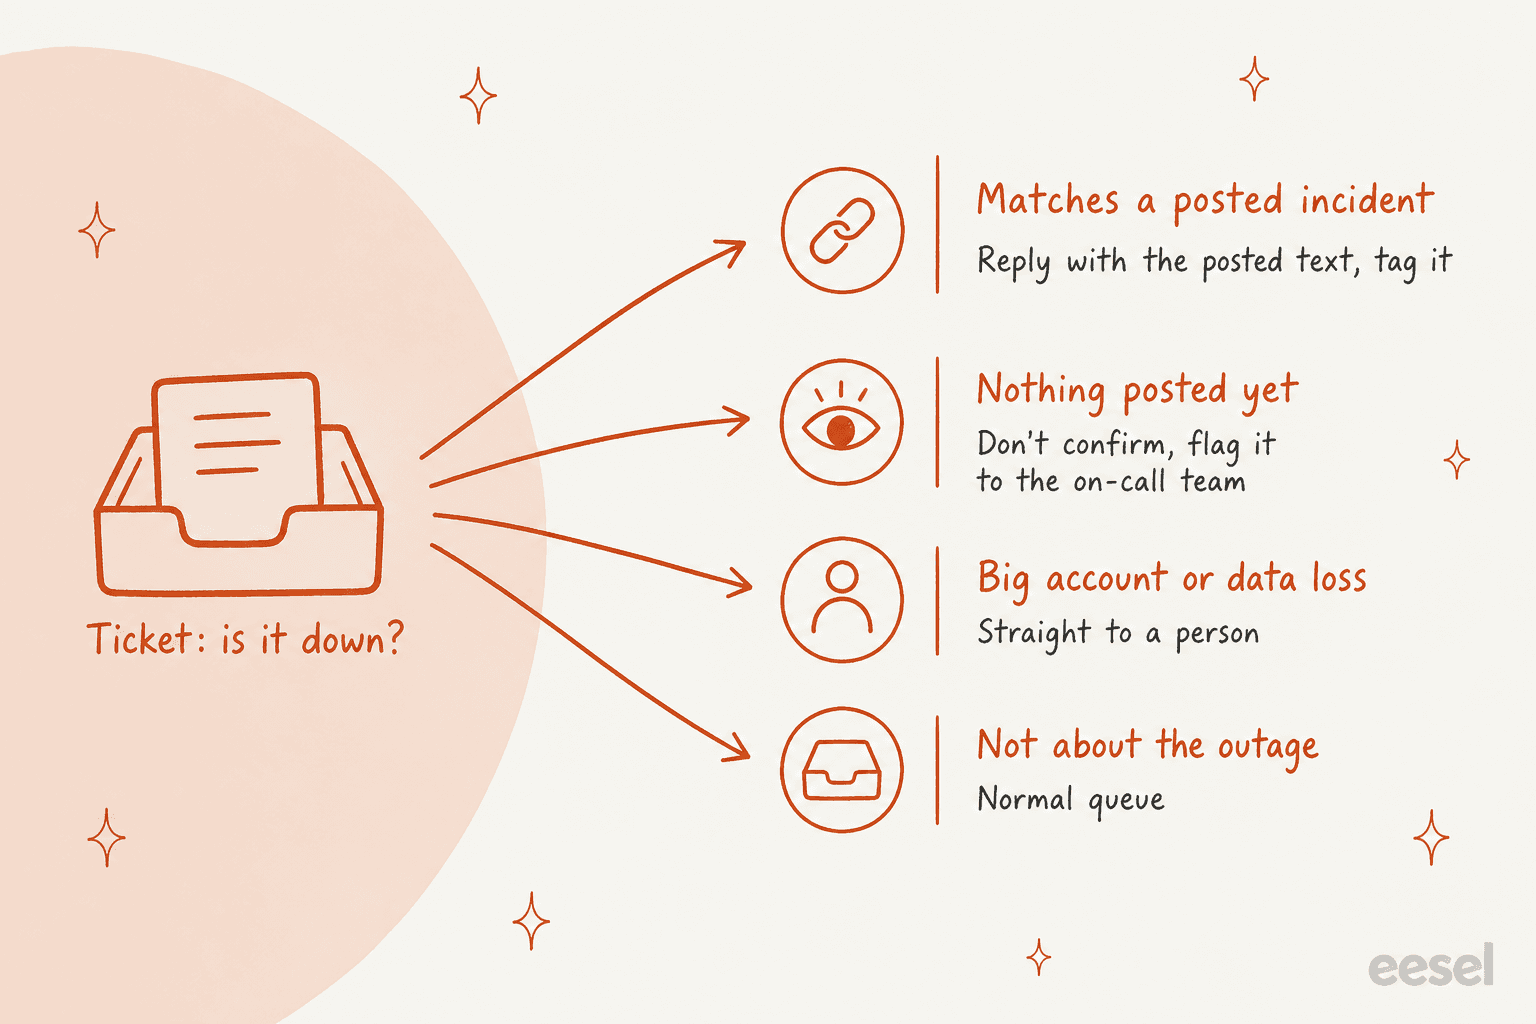
Passt zu einem veröffentlichten Vorfall. Das Ticket erwähnt die betroffene Komponente oder das Symptom, das der Vorfall beschreibt. Die KI antwortet mit der neuesten veröffentlichten Nachricht, verlinkt die Statusseite, sagt, dass das Ticket nach der Lösung aktualisiert wird, und fügt einen Vorfall-Tag hinzu. Das ist die Spur mit dem höchsten Volumen und die, die du zuerst automatisieren solltest, nach derselben Logik wie jede Automatisierung der Erstantwort.
Noch nichts veröffentlicht. Kunden bemerken es oft vor der Seite. Hier darf die KI keine Störung bestätigen, weil sie nichts hat, womit sie sie bestätigen könnte. Sie kann sagen, dass das Team es prüft, das Ticket taggen und einen Alarm in den Bereitschaftskanal posten. Fünf Tickets zum Checkout in zehn Minuten ohne veröffentlichten Vorfall sind ein Frühwarnsignal, und der Support sieht es meist als Erster. Sobald der Vorfall online ist, geht die KI zu diesen Tickets zurück und beantwortet sie ebenfalls.
Großkunde oder Datenverlust. Manche Tickets sollten keine Vorlagenantwort bekommen, so korrekt sie auch wäre. Namentlich bekannte Enterprise-Konten, alle, die verlorene Daten melden, alle, die sich auf eine SLA berufen, alle, die Gutschriften verlangen. Sie gehen über deine normalen KI-Eskalationsregeln an eine Person. Qontro, ein ERP-Softwareunternehmen, das eesel auf Freshdesk einsetzt, schickt Ausfälle, Datenverlust und Abrechnungsfragen direkt an eine Person, statt die KI sie untersuchen zu lassen.
Nicht zur Störung gehörend. Eine Abrechnungsfrage, die mitten in einem Vorfall eintrifft, bleibt eine Abrechnungsfrage. Sie geht in die normale Warteschlange, und die KI sollte den Vorfalltext nicht daraufkleben, nur weil der Zeitpunkt passt. Achte beim Testen darauf, denn es ist der häufigste Fehlabgleich, derselbe Fehler, den ich in False Positives reduzieren behandle.
Was sollte die KI mitten in einer Störung sagen, und was nie?
Die Regeln sind kurz, und sie machen den Unterschied zwischen einer KI, die Kunden beruhigt, und einer, die einen zweiten Vorfall erzeugt.
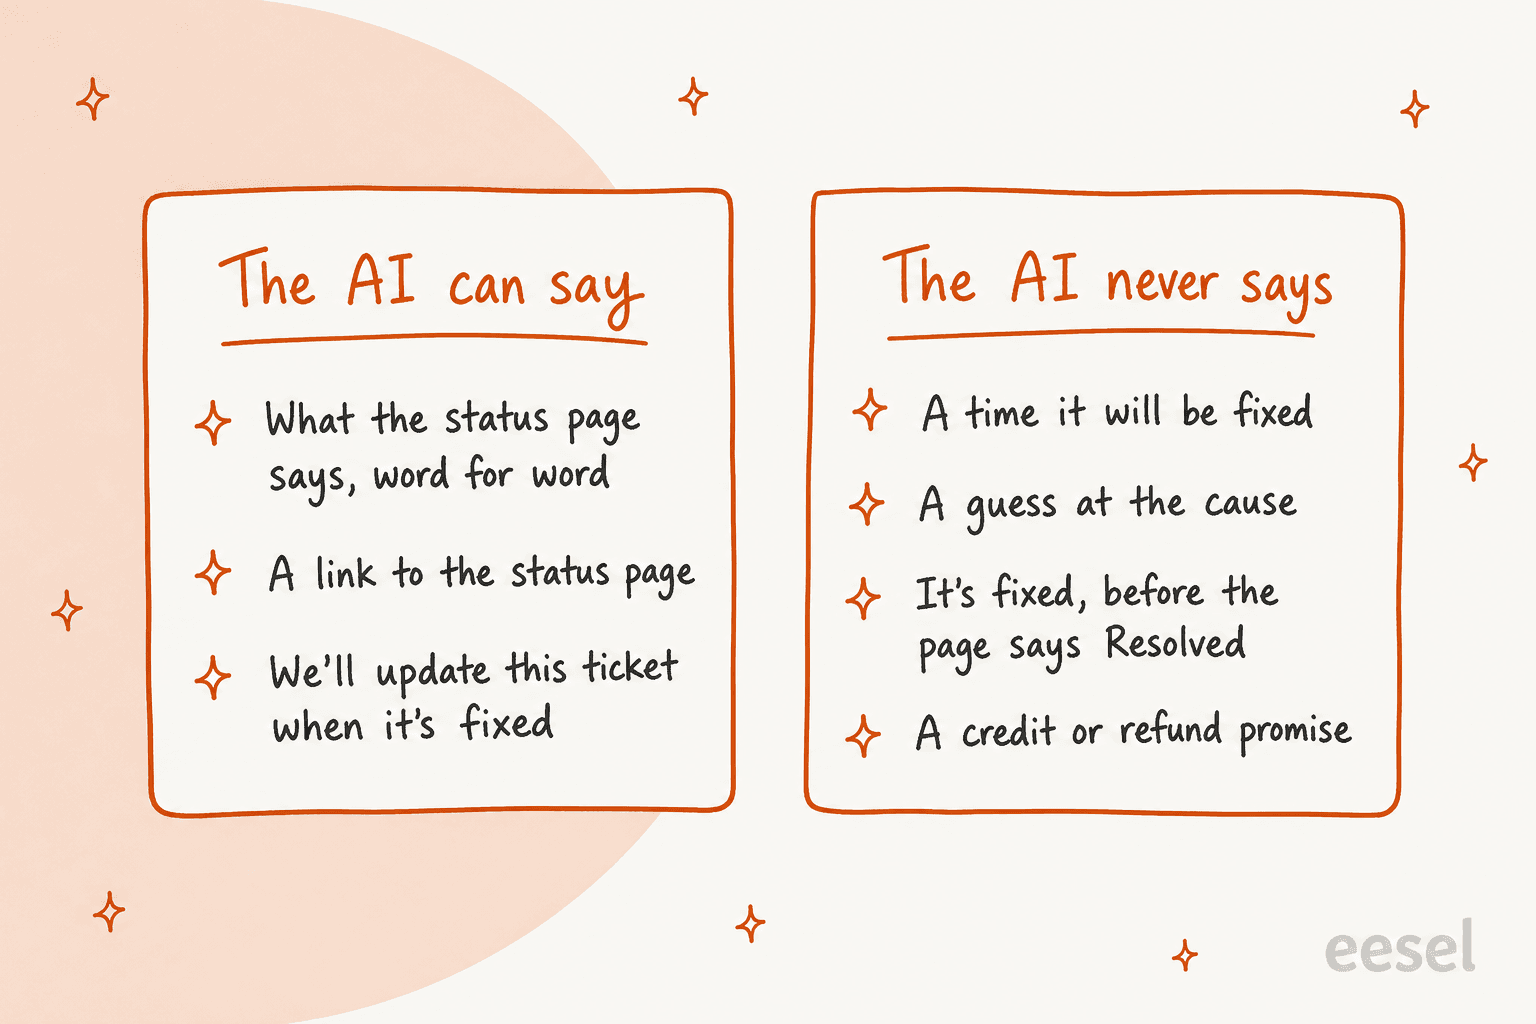
Die „Nie“-Liste dreht sich um eine Sache: Die KI darf nur Zusagen wiederholen, die das Engineering gemacht hat. Ein Modell, das gefragt wird „Wann ist es wieder da?“, produziert bereitwillig eine plausibel klingende Zeit, und das ist eine KI-Halluzination mit Zeitstempel. Dasselbe gilt für die Ursache. Selbst „Identified“ bei Statuspage heißt nur, dass das Team die Ursache gefunden hat, nicht, dass es sie geteilt hat.
Hier würde ich mir abschauen, wie SE Ranking seine Agenten eingerichtet hat. Das Team wollte Live-Chat sofort beantwortet haben "without the bot promising things the team could not deliver." Seine eesel-Agenten sagen Kunden deshalb, dass sie in ein bis zwei Werktagen mit einer Antwort rechnen können, nie, dass gleich jemand dazukommt. Das ist auch bei Störungen der richtige Instinkt: Eine langsamere, wahre Antwort schlägt eine schnelle, erfundene.
Es hilft auch, die Antwort als feste Vorlage zu schreiben, die die KI ausfüllt, statt sie frei formulieren zu lassen:
| Status auf der Seite | Was die Antwort der KI enthält |
|---|---|
| Investigating | Die veröffentlichte Nachricht, der Link zur Statusseite, „Wir aktualisieren dieses Ticket, sobald es behoben ist“ |
| Identified | Die neue veröffentlichte Nachricht, der Link, dasselbe Nachfass-Versprechen |
| Monitoring | Die veröffentlichte Nachricht, ein Hinweis, dass eine Lösung eingespielt ist und beobachtet wird, noch kein „behoben“ |
| Resolved | Die Abschlussnachricht, die Bitte um Antwort, falls das Problem weiter besteht, dann wird das Ticket gelöst |
Wie gehen Zendesk und Freshdesk heute mit Störungstickets um?
Die Helpdesks haben seit Jahren Störungsfunktionen. Sie gruppieren die Tickets gut. Was sie nicht tun, ist die Kundenantwort zu schreiben, und genau in den Details setzt KI an.
Zendesk hat Problem- und Vorfalltickets: Du verknüpfst jede Meldung mit einem Problemticket, und das Lösen des Problems löst die Vorfälle und kopiert den abschließenden Kommentar in jedes ungelöste. Es gibt das ab Suite Team. Zwei Einschränkungen aus Zendesks eigenem Artikel sind hier wichtig. "AI agent tickets can't be linked to problem and incident tickets", und wenn das Problem gelöst wird, "Customers are not notified using the messaging channel." Tickets, die Zendesks eigener KI-Agent bearbeitet hat, und Kunden, die per Messaging geschrieben haben, können das abschließende Update also verpassen. Mein Leitfaden zu Zendesk-Tickettypen behandelt die Einrichtung, und du kannst den Typ automatisch setzen, mit einer Automatisierung.
Freshdesk hat verknüpfte Tickets, die Meldungen unter einem „Tracker“-Ticket gruppieren. Freshdesks eigenes Beispiel ist "your product is facing some unexpected downtime." Ein Kommentar am Tracker wird an alle verknüpften Tickets gesendet, aber "the internal broadcast message will be visible only to agents", sodass ein Agent weiterhin jede Kundenantwort selbst schreibt. Und das Lösen des Trackers "would not resolve the linked tickets by default", laut einer Freshdesk-FAQ.
Zusammengenommen liefern die Helpdesks die Gruppierung. Der Job der KI ist das Stück dazwischen: entscheiden, welches Ticket zu welchem Vorfall gehört, und die kundenseitige Antwort aus dem Text der Statusseite schreiben. Bei Zendesk umgeht eine KI, die direkt in die Vorfalltickets schreibt, auch die Einschränkung „AI agent tickets can't be linked“, weil die Tickets ganz normale Tickets bleiben.
Was kosten die Statusseiten-Tools?
Hier steht, was jedes Tool kostet, laut seiner eigenen Preisseite am 30.10.2026. Die Statusseite ist meist der günstige Teil; die Kosten, die Teams überraschen, liegen auf der Helpdesk-Seite, die ich als Nächstes behandle.
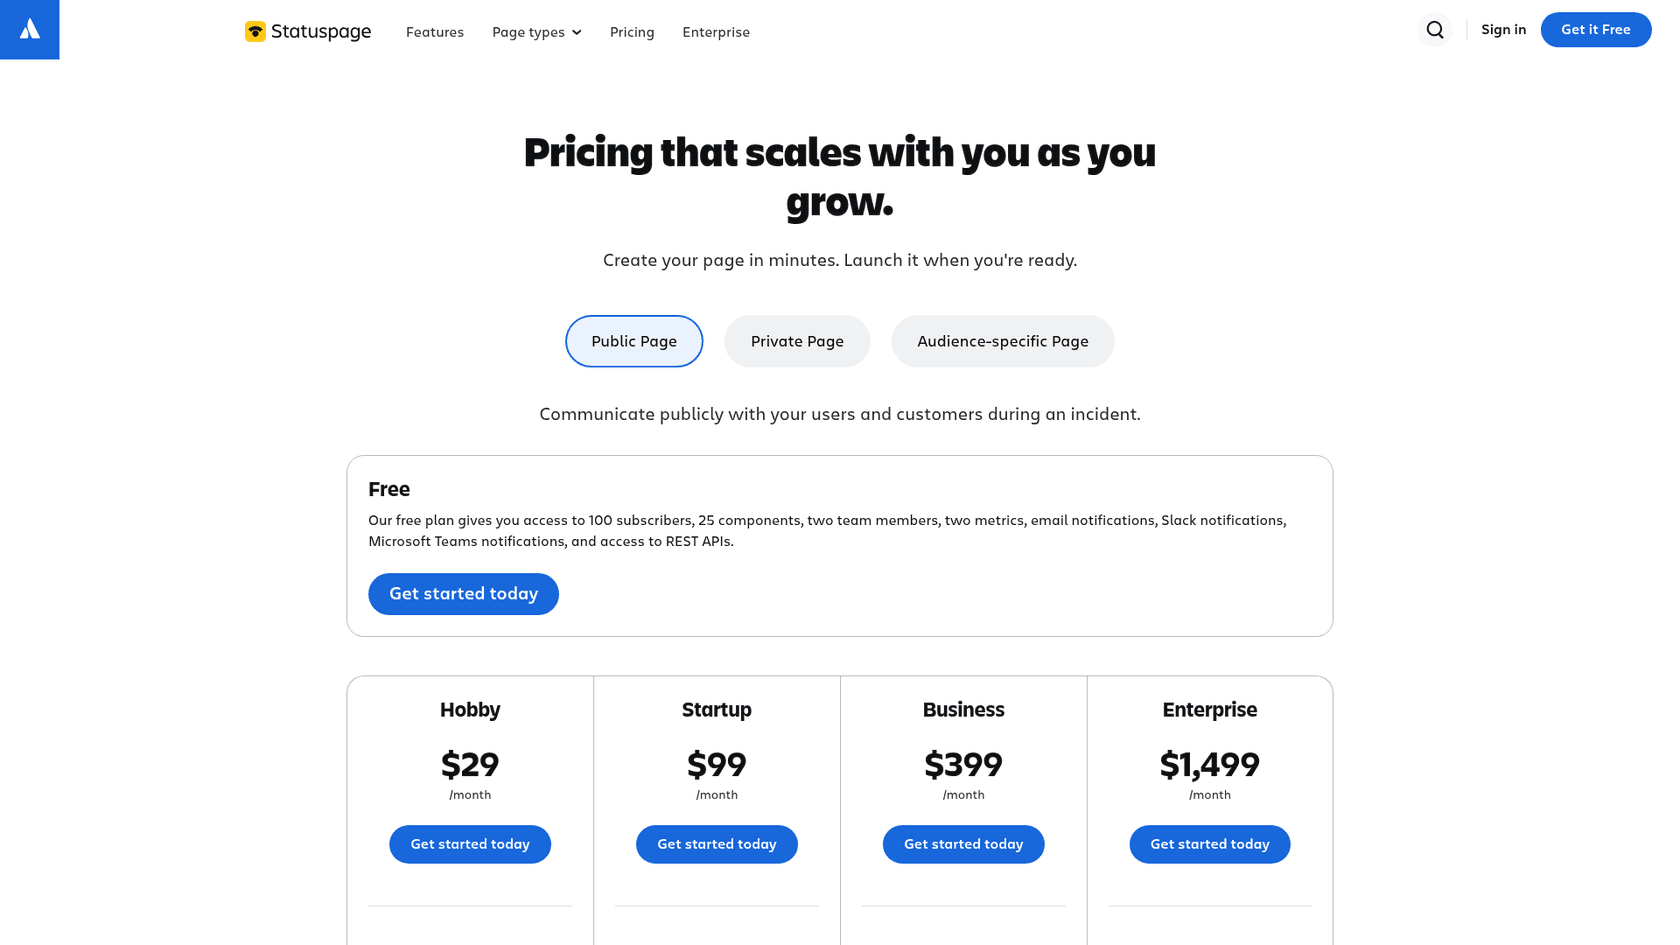
| Tool und Tarif | Preis | Abonnenten | Webhook-Ausgang | KI-Funktionen |
|---|---|---|---|---|
| Statuspage Free | 0 $ | 100 | Nein (E-Mail, Slack, Teams) | Keine aufgeführt |
| Statuspage Hobby | 29 $/Monat | 250 | Nein | Keine aufgeführt |
| Statuspage Startup | 99 $/Monat | 1.000 | Ja | Keine aufgeführt |
| Statuspage Business | 399 $/Monat | 5.000 | Ja, plus Komponenten-Abonnements | Keine aufgeführt |
| Statuspage Enterprise | 1.499 $/Monat | 25.000 | Ja | Keine aufgeführt |
| incident.io Basic | Kostenlos | Unbegrenzt, 1 öffentliche Seite | E-Mail, Slack, RSS | Einfacher Post-Mortem-Editor |
| incident.io Team | 15 $/Nutzer/Monat jährlich, 19 $ monatlich | Unbegrenzt | E-Mail, Slack, RSS | Einfacher Post-Mortem-Editor, Workflows |
| incident.io Pro | 25 $/Nutzer/Monat | Unbegrenzt, plus 1 interne Seite | E-Mail, Slack, RSS | KI-native Post-Mortems |
| PagerDuty Free | 0 $ | Keine Statusseite | n/a | n/a |
| PagerDuty Professional | 21 $/Nutzer/Monat jährlich, 25 $ monatlich | 250 auf der externen Seite, mehr mit dem Add-on Status Pages | Ja (E-Mail, Slack, Webhook) | KI-gestützte Post-Incident-Reviews mit PagerDuty Advance |
| PagerDuty Reliability Platform Starter | 2.800 $/Jahr | Enthalten | Ja | Enthalten |
Meine Einschätzung: Wenn du für die Bereitschaft schon incident.io oder PagerDuty nutzt, nimm die Statusseite, die du hast. Wenn du nur eine öffentliche Seite brauchst und den Webhook willst, ist Statuspage Startup für 99 $ die Schwelle, die du überschreiten musst. Keines dieser Tools beantwortet allerdings deine Tickets; das bleibt Aufgabe des Supports.
Was kostet eine Störung auf der Support-Seite?
Hier werden Preismodelle wichtig. Eine Störung ist ein Support-Spitzenaufkommen aus beinahe identischen Fragen, und manche KI-Preise machen aus dieser Spitze eine Rechnung.
Zendesk berechnet seinen KI-Agenten pro automatisierter Lösung: 1,50 $ je Lösung bei zugesagtem Volumen oder 2,00 $ nach Verbrauch, nach den inkludierten 5 bis 10 pro Agent und Monat. Freshdesk verkauft Sitzungen des Freddy AI Agent für 49 $ pro 100, nach einmalig 500 kostenlosen. Die Preise von eesel sind ein fester monatlicher Credit-Block, bei dem ein Ticket oder Chat ein Credit ist: 299 $ für 500, bis zu 1.749 $ für 5.000. Gib unten deine eigene Störung ein.
Der Punkt ist nicht, dass ein Modell immer günstiger ist. Der Punkt ist, dass Preise pro Lösung eine Störung, den Tag, an dem dein Team ohnehin am stärksten belastet ist, zusätzlich zu einem Ereignis mit variablen Kosten machen. Ein fester Monatsblock lässt sich leichter einplanen, wenn dein Produkt gelegentlich einen schlechten Tag hat.
Sollte KI das Statusseiten-Update selbst schreiben?
Entwerfen kann sie es. Veröffentlichen würde ich sie es nicht lassen. Die Nachricht auf der Statusseite ist das eine Stück Störungskommunikation, das alle Kunden gleichzeitig erreicht, und jede Support-Antwort danach zitiert sie. Wenn sie falsch ist, ist alles darauf Aufbauende falsch.
Ein Hacker-News-Kommentator, der gefragt wurde, ob Statusseiten automatisch aktualisiert werden, brachte die Abwägung gut auf den Punkt:
"Typically no because there's an art to crafting the actual message around impact… but sometimes yes it is automated"
Der gute Mittelweg ist ein Entwurf mit Freigabeschritt. Die Statuspage-REST-API nimmt einen neuen Vorfall oder ein Update als einfachen POST an, sodass ein KI-Agent mit Network Access auf api.statuspage.io das Update aus dem Incident-Channel vorbereiten kann und ein Entwickler es freigibt, bevor es gepostet wird. In eesel ist das eine Aktion, die auf Needs approval gesetzt ist: Der Agent hält an, zeigt den genauen Text und wartet auf Approve oder Deny. Auf der Incident-Seite listet der Pro-Tarif von incident.io einen KI-nativen Post-Mortem-Editor, und PagerDuty bietet KI-generierte Post-Incident-Reviews über das Advance-Add-on, die Nachbereitung ist dort also abgedeckt.
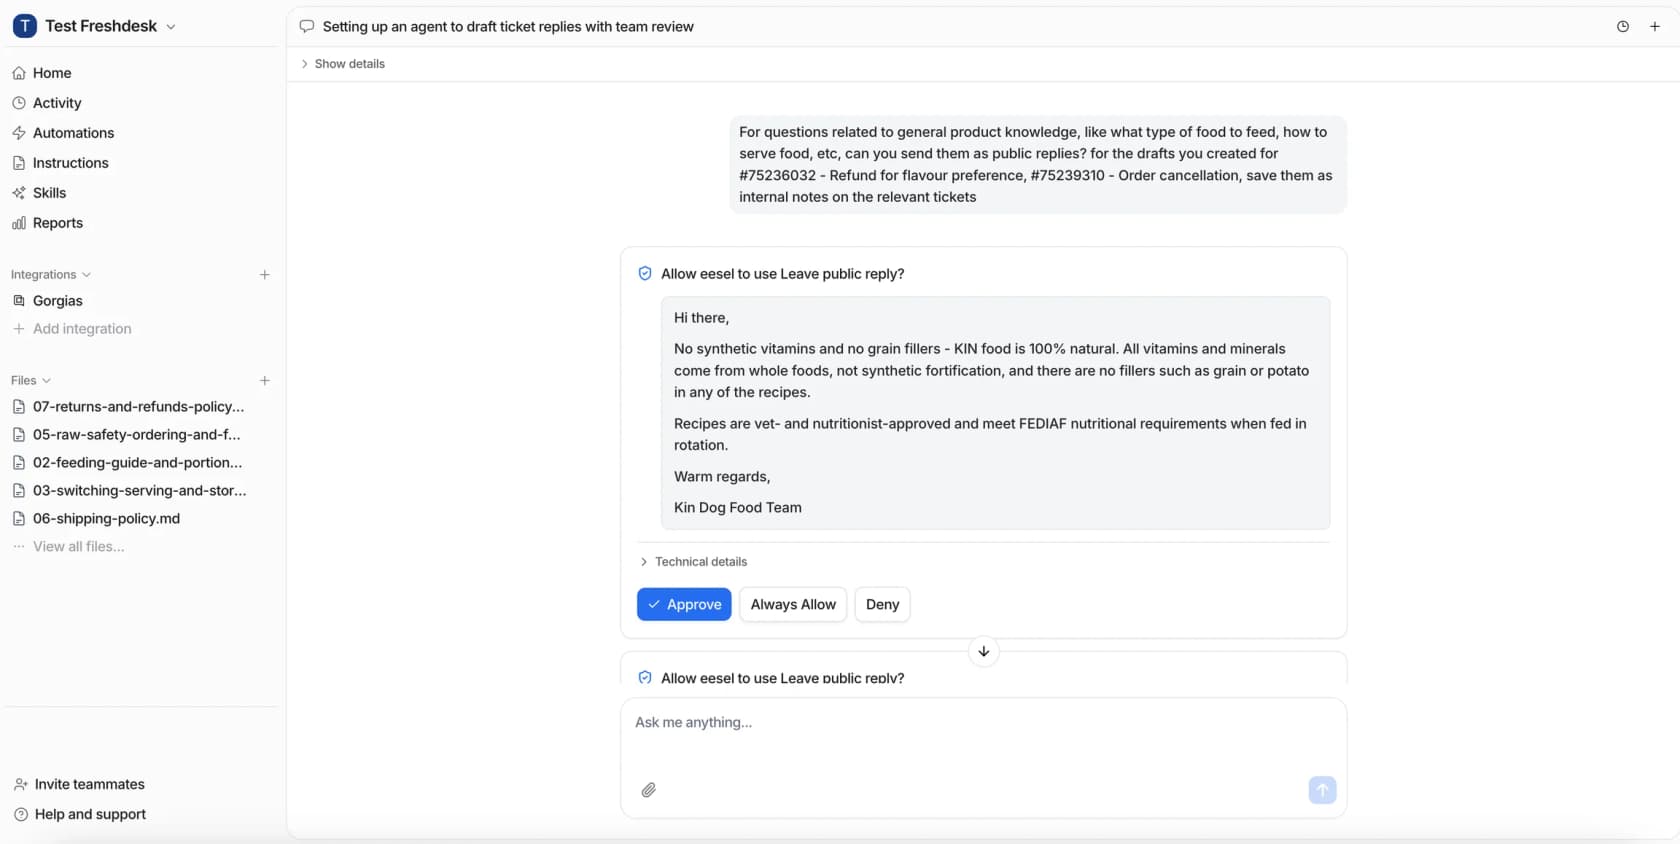
So würde ich auch die Support-Antworten starten. Lesson Pro betreibt eesel auf zwei Zendesk-Konten, wo es in einem Monat 1,700 interne Notizen hinterließ und 560 Antworten entwarf, wobei das Team freigab, bevor etwas einen Kunden erreichte. Mit Beaufsichtigung bei den Störungsantworten zu starten kostet dich beim ersten Vorfall ein paar Minuten und zeigt dir genau, was die KI gesendet hätte.
Wie richtest du das vor der nächsten Störung ein?
Die Einrichtung dauert einen Nachmittag. Mitten in einem Vorfall dauert sie viel länger, daher hier die Reihenfolge, der ich folgen würde.
- Wähle die Wahrheitsquelle. Eine Statusseite, ein Satz Komponentennamen. Wenn Engineering und Support den Checkout-Dienst unterschiedlich nennen, klärst du das zuerst, denn die KI ordnet Tickets nach Komponente zu.
- Abonniere die KI auf die Seite. Bei Statuspage Startup oder höher, oder bei PagerDuty, trägst du die Webhook-URL des Agenten als Abonnent ein. Sonst nutzt du den öffentlichen Summary-Endpunkt oder die Anbieter-API über Network Access.
- Schreibe die Spuren in die Anweisungen. Die vier Spuren von oben, die Antwortvorlage pro Status und die „Nie sagen“-Liste. Nenne die Enterprise-Konten und Schlüsselwörter, die die automatische Antwort überspringen.
- Wähle Tag und Nachfassregel. Ein Vorfall-Tag pro Störung und eine Regel, dass Resolved bei jedem getaggten Ticket eine Nachfassnachricht auslöst. Bei Zendesk kannst du die Tickets außerdem mit einem Problemticket verknüpfen und den Status per Massenbearbeitung ändern, wenn du sie lieber von Hand schließt.
- Teste an einer vergangenen Störung. Spiele die Tickets deines letzten echten Vorfalls erneut ab und prüfe jede Spur, nach dem Ansatz in meinem Leitfaden zu Simulationstests. Behalte die Spur „Nicht zur Störung gehörend“ genau im Blick.
- Starte mit Entwürfen, dann geh live. Setze öffentliche Antworten beim ersten Vorfall auf Needs approval, und stelle die passende Spur dann auf Auto, sobald die Entwürfe stimmen. Gutschriften und Rückerstattungen bleiben dauerhaft hinter einer Freigabe.
- Zähle mit. Tagge jedes von der KI bearbeitete Störungsticket, damit du darüber berichten kannst, so wie SE Ranking einen
ai_handled-Tag auf jedem Ticket verlangte, das eesel anfasst, "so containment is counted in Zendesk, not guessed." Mein Leitfaden zum Support-Reporting behandelt den Rest.
Wenn du das lieber im Terminal einrichtest oder einen Coding-Agenten machen lässt: Die eesel CLI führt denselben Agenten wie das Dashboard aus. eesel automations listet die Webhook-Automatisierung auf und schaltet sie ein oder aus, eesel activity zeigt, was der Agent mit jedem Vorfall-Update gemacht hat, und eesel approvals listet Antworten auf, die auf eine Person warten. Jeder Befehl gibt JSON aus, mit einer --dry-run-Option für Schreibvorgänge, weshalb Claude Code, Cursor oder Codex die gesamte Einrichtung steuern und ihre eigenen Ergebnisse zurücklesen können.
eesel für Störungstickets testen
eesel ist ein KI-Teammate für deinen Helpdesk, und Störungstickets sind ein sauberer erster Job dafür. Er liest jedes Update deiner Statusseite, ordnet die „Ist es down?“-Tickets in Zendesk, Freshdesk oder Gorgias dem Vorfall zu, antwortet mit dem veröffentlichten Text und fasst bei jedem nach, wenn die Seite Resolved anzeigt. Großkunden und Datenverlust gehen direkt an dein Team, so wie Qontro seine Störungstickets weiterleitet.
Starte mit Entwürfen und aktivierten Freigaben, spiele deine letzte Störung erneut ab und stelle die passende Spur auf Auto, wenn du ihr vertraust. Die Tarife beginnen bei 299 $ im Monat für 500 Tickets, mit 100 kostenlosen Credits zum Ausprobieren. eesel testen.