

要点
サポートのオーバーフロー管理は、採用の問題というより、ほとんどがルーティングの判断です。Zendesk、Freshdesk、Help Scout、Front、Gorgias、HubSpotでは、全エージェントが上限に達したときの既定の動作はどれも同じです。新しい仕事は、誰かの手が空くまで未割り当てのままキューに残ります。オーバーフローが処理されるのは、次のチケットの行き先をあらかじめ決めたときだけです。
多くのチームでうまくいく構成は、カスケードです。プライマリチーム、次にバックアップグループ、次に繰り返しの質問に答えるAIレイヤー、次に正直な待ち時間を伝える非同期返信、そして電話にはコールバック、という順です。バックアップグループの機能はプランで制限されています(ZendeskのカスタムキューにはSuite Professional が必要で、Freshdeskのフォールバックグループへの振り替えはEnterpriseのみ)。急増の最中ではなく、その前にプランを確認してください。
私は毎日eeselのサポートキューを担当していますが、急増時のボリュームの大半は、注文状況、サブスクリプションの変更、「障害ですか?」といった、ほんの数種類の同じ質問です。月に約7,000件のGorgiasチケットを扱うDTCブランドのオペレーション責任者は、チームがどうしても追いつけず、メール量の少なくとも半分をAIに解決してほしいとeeselに話してくれました。その繰り返し部分を、既存のヘルプデスクの中でeeselのAIチームメイトがキューから引き取ります。人間のチームは、急増の間、人でなければ対応できないチケットに集中できます。
サポートのオーバーフロー管理が実際に扱うもの
オーバーフローとは、対応できるエージェントが全員、上限に達しているかオフラインのときに届く仕事のすべてです。この最後の点が重要で、単に「チケットが多すぎる」ことではありません。2人が病欠した火曜の午後もオーバーフローの事象です。時間外対応が留守番電話の案内だけという状態での午前2時のチャットも同じです。
通常は次の3つの形のいずれかで現れます。
| 形 | きっかけ | 続く期間 | 必要なもの |
|---|---|---|---|
| スパイク | 障害、ローンチ、バズった投稿、配送遅延 | 数時間〜2日 | 1対多の迅速な回答、数分で開けるバックアップレーン |
| 季節的ピーク | ブラックフライデー、年末年始、更新シーズン、納税期限 | 2〜12週間 | 計画的な増員、教育済みの臨時スタッフやパートナー、事前に用意した回答 |
| カバレッジの穴 | 病欠、タイムゾーン、昼休み、チームミーティング | 数分〜数時間 | 特定の1人がオンラインであることに依存しないルーティング |
多くのガイドはこれを1つの問題として扱い、いきなり「もっと採用する」か「外注する」へ進みます。私はもっと安価なところから始めます。全員が満杯のとき、あなたのヘルプデスクが次のチケットを今どう扱っているかを確認してください。その既定の動作は、おそらく人員よりも大きなコストを生んでいます。
各ヘルプデスクでオーバーフローが既定でどこへ行くか
eeselのサポートキューで最もよく見る7つのツールのルーティングドキュメントを調べました。パターンははっきりしています。対応可能なエージェントが全員上限に達すると、ほとんどのツールは新しい仕事を、担当者の名前がないままサポートキューに残します。
| ヘルプデスク | エージェントごとの上限 | 全員満杯またはオフラインのとき | 組み込みのオーバーフローレーン | 必要なプラン |
|---|---|---|---|---|
| Zendesk | メールは最大500件のオープン、メッセージは最大20件 | チケットはキューに残る | カスタムキューのセカンダリグループ | Suite Professional($115/エージェント/月) |
| Freshdesk | キューごとの負荷(例:メール5、メッセージ10) | チケットは未割り当てのまま | N秒後に「Reroute to a Fallback Group」 | Enterprise($89/エージェント/月) |
| Help Scout | 割り当て上限は最大100、チャットの既定は3 | 会話はUnassignedに残る | 記載なし | Round RobinはPlus($45)、BalancedはPro($75) |
| Front | ロードバランシングの上限、既定・最大とも100 | ロードバランシングは仕事をキューに入れる。ラウンドロビンは入れない | 記載なし | 料金ページに記載なし |
| Gorgias | 2つの上限:チャットとメッセージ、その他のテキスト | チケットは未割り当てのまま | 音声の「Skip queue when it's too busy」 | すべてのHelpdeskプラン(Voiceアドオンは月$25から) |
| HubSpot Service Hub | チケット容量(Pro以上)、チャット容量の既定は3、最大99(Enterprise) | 手動で割り当てるまでチケットは未割り当てのまま | チャットをカスタマーエージェントへ回すオプションのフォールバック | Professional($90/シート)またはEnterprise($150/シート) |
| Aircall(音声) | 呼び出しベース | 通話はキュー時間だけ待ち、その後は留守番電話または不在着信 | 最初の後に別のRing toステップを連結 | コールバックはProfessional($50/ライセンス) |
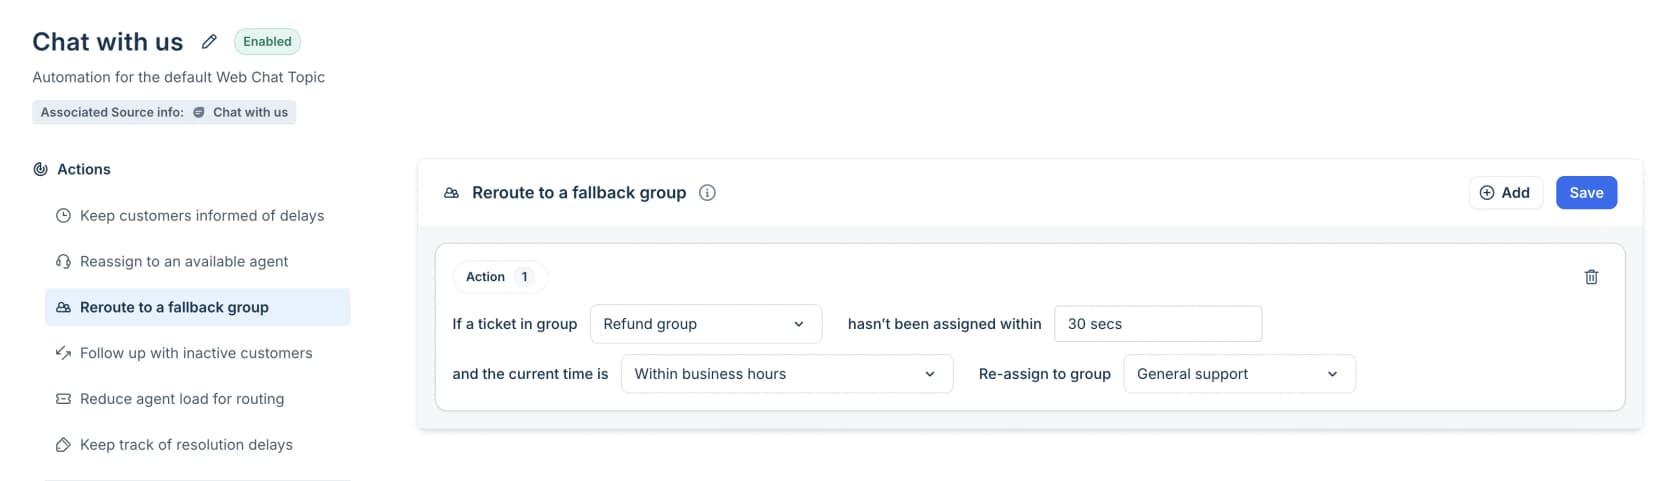
2つの点が目を引きます。1つ目は、「別のグループへ送る」という本物のオーバーフロールールを備えているのはZendeskとFreshdeskだけで、どちらも上位プランの後ろに置いていることです。2つ目は、両者の仕組みが違うことです。Zendeskは空き状況でオーバーフローします。仕事はまずプライマリグループへ行き、プライマリのエージェントが誰も対応できないときだけセカンダリグループに回ります。Freshdeskは時間でオーバーフローします。Quick Automationsのルールは、グループ内のチケットが設定した秒数以内に割り当てられなかったときに作動します。たとえばRefundsのチケットが5分たってもそのままなら、General Supportへ移る、といった具合です。
注意すべきはFrontです。ラウンドロビンを使うと、全員がオフラインのときキューがなく、取りこぼした割り当ては誰かが戻ってきても再試行されません。ロードバランシングはキューに入れ、返信のない最も古い会話から順に渡します。Frontのチームが小規模で急増しやすいなら、この1つの設定で、オーバーフローが順番待ちになるのか失われるのかが決まります。
こうして重大なチケットが埋もれていきます。あるZendesk管理者がRedditでまさにこれを書いていました。
「午前9時に、エンタープライズのお客様から本番システムがダウンしていると連絡があった。夜間に届いた30件以上の他のチケットがあったため、そのチケットは午後2時までキューに放置されていた。」

人員を増やすのではなく、オーバーフローのカスケードを組む
予想外の通話急増を巡るスレッドで、あるシステム管理者は、ピークに合わせた採用がうまくいかない理由をこうまとめていました。
「まれな1%の出来事に合わせて人員を組むことはできない。普通の90%の日に合わせて組むものだ。」
つまり、「仕事が未割り当てのまま残る」問題の解決策は、すべてのチケットに次の行き先を与えることです。私はこれをトレーの積み重ねとして考えています。1つが満杯になると次へあふれ、一番下のトレーは決して「誰もいない」ではありません。
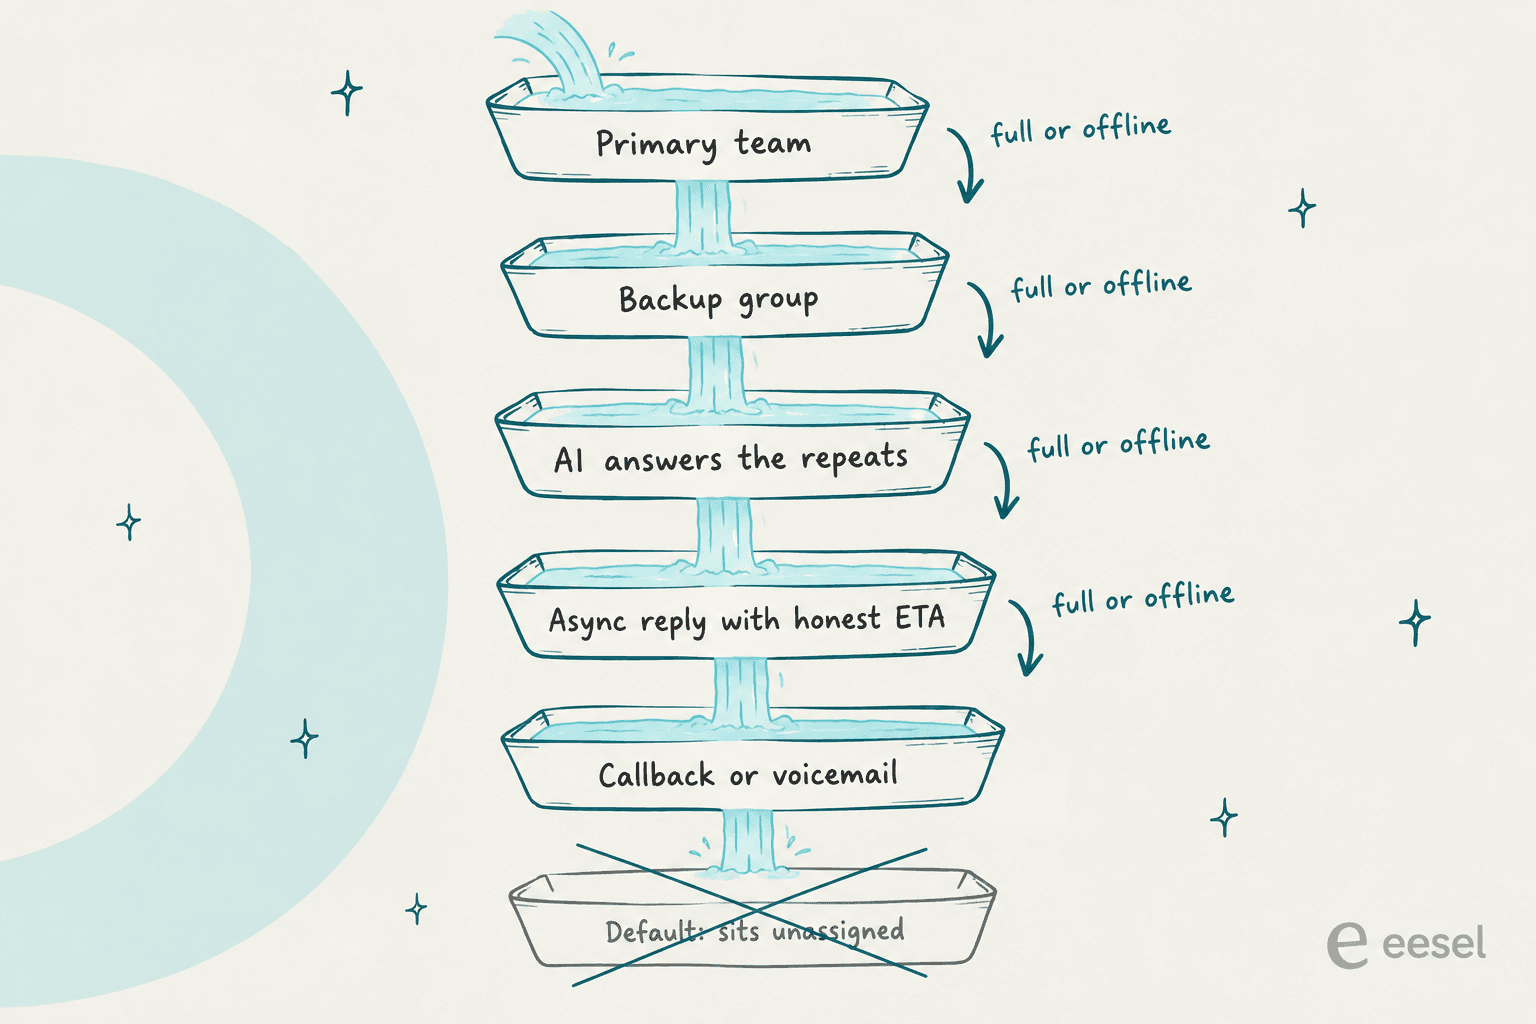
最小のコストで最大の効果が得られる順に、私ならこう組みます。
1. しきい値は件数ではなくチケットの経過時間で決める
10分前に届いた150件のキューは問題ありません。最も古いチケットが18時間待っている40件のキューは火事です。件数は急増時には当てになりません。急に跳ね上がり、すぐ戻るからです。未回答チケットのうち最も古いものの経過時間は、顧客が本当に置き去りにされているかどうかを示し、初回応答時間やSLAの約束にそのまま対応します。
3〜4段階を書き出し、それぞれについて変わる1つのことを決めます。以下の数字は、自社のSLAに合わせて調整する出発点であり、標準ではありません。
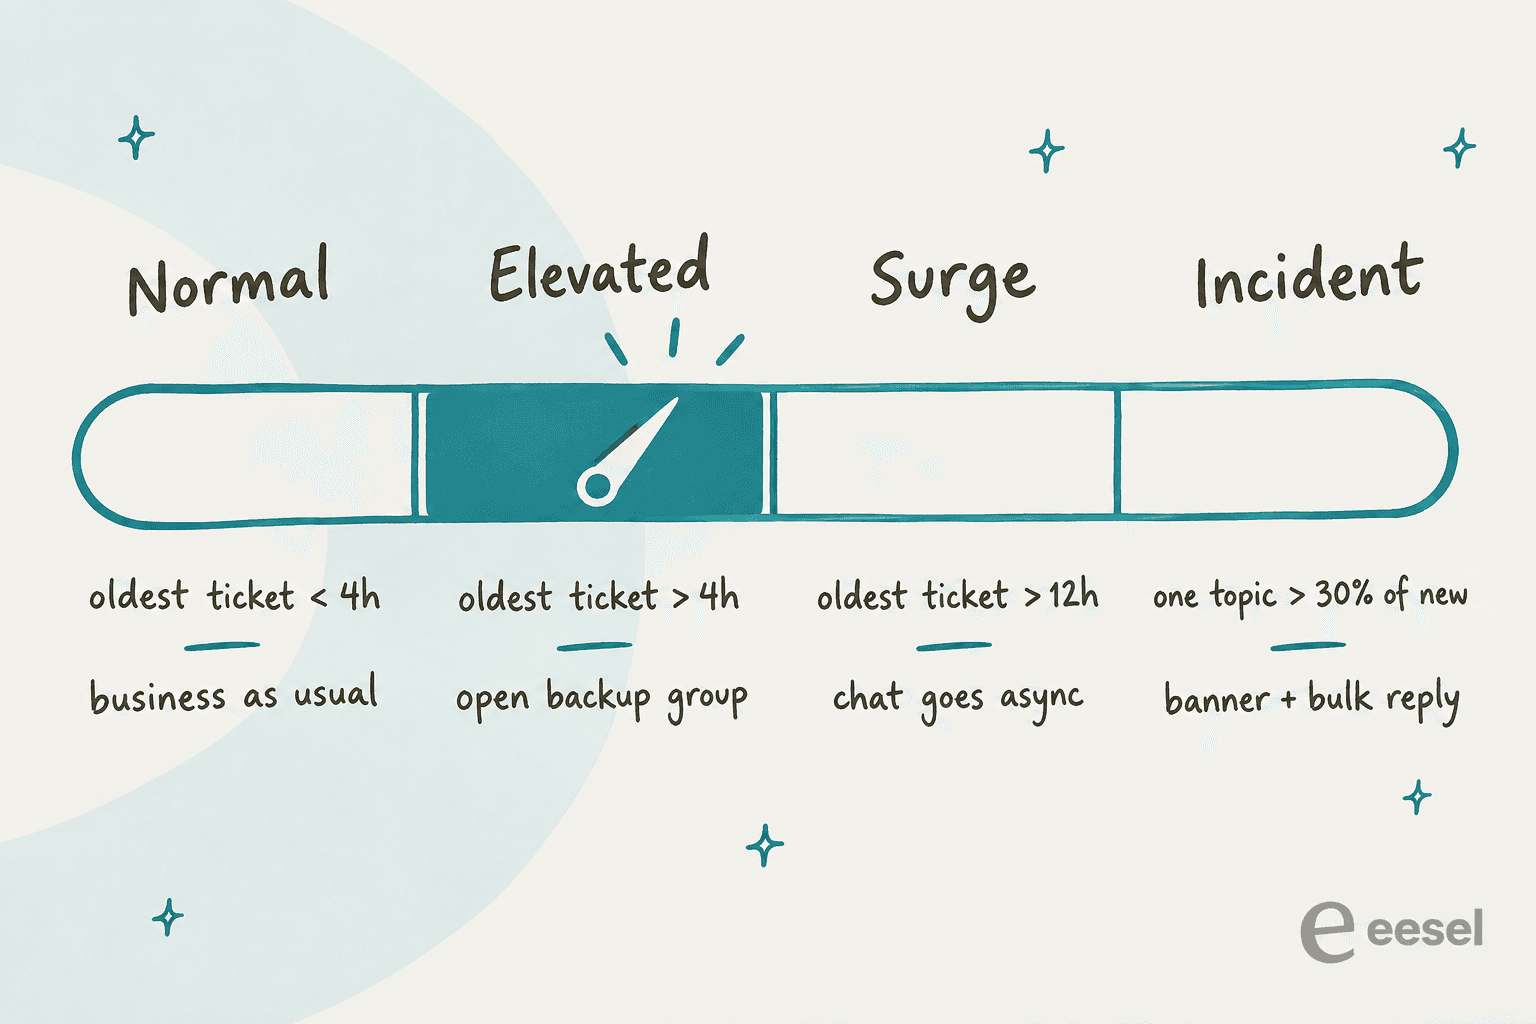
書き出す意味は、ローンチ当日の午後4時に誰も判断を迫られないことです。ルールはすでにあり、ゲージが動いているのに気づいた人がスイッチを入れるだけです。
2. 必要になる前にバックアップグループを開く
バックアップグループとは、メインチームが満杯のときにティア1の仕事を引き受けられる人たちのことです。別のチーム、別の地域のシニアエージェント、カスタマーサクセスやセールスから教育を受けた数人のボランティアなどです。落ち着いた週に、ツール上で設定しておきましょう。
- Zendesk。 カスタムキューを作成し、メインのグループをプライマリとして追加します。次に「Turn on secondary groups」をオンにして、バックアップを追加します。各カスタムキューにはプライマリとセカンダリのグループをそれぞれ最大20個、キューは最大199個まで作れます。メッセージ向けのZendesk自身のレシピでは、最後の砦として「Backup」グループを加え、チケットが「許容できる以上に長くキューに留まらない」ようにしています。
- Freshdesk。 Proでは、Omnirouteでエージェントごとのキャパシティをキューごとに分け、チャットとメールが互いを枯渇させないようにします。Enterpriseでは、リアルタイムチャネル向けのQuick Automation「Reroute to a Fallback Group」を追加します。
- Help Scout、Front、Gorgias、HubSpot。 ネイティブのオーバーフローグループはないため、タグや待ち時間で再割り当てするワークフローやルールと、急増中にバックアップ要員が見守る共有キューを回避策にします。
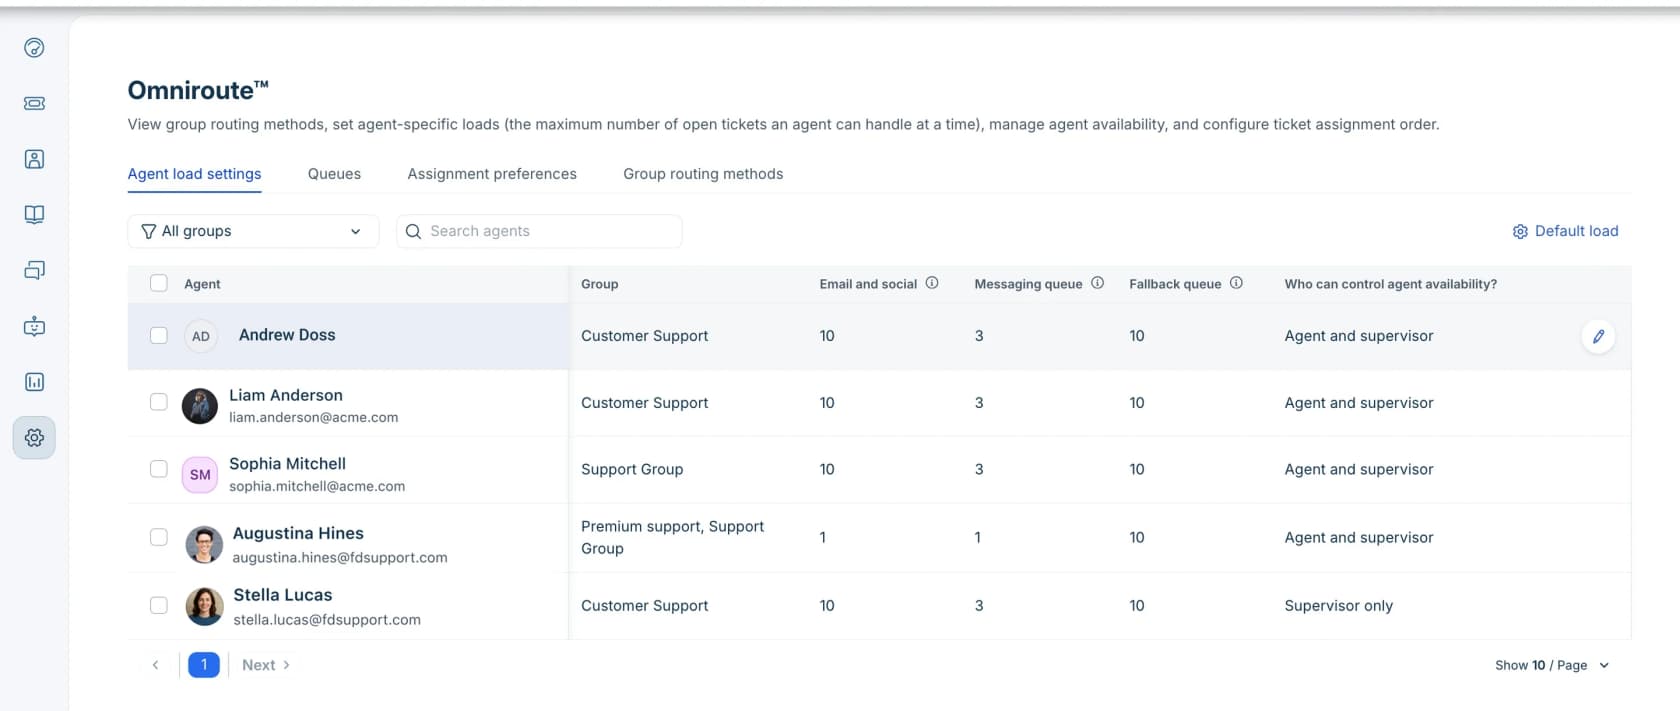
1週間だけ続くスパイクには、Freshdeskの細かな仕様が役立ちます。デイパスはGrowthで$2、Proで$7、Enterpriseで$12なので、ローンチ週に他部署の同僚を借りても、フルシート分を払う必要はありません。
3. スペシャリストをティア1の量から守る
キューがあふれると、最初に引っ張り込まれるのは最も詳しい人たちで、難しいチケットが古くなっていく間、急増期をずっと「注文はどこ?」への回答に費やしてしまいます。仕事を種類で分けましょう。ティア1の質問はバックアップグループとAIレイヤーへ。請求の争い、バグ、怒っているVIPはスペシャリストに残します。Zendesk Suite Professionalには、このためのスキル・優先度ルーティングが加わり、FreshdeskはEnterpriseでスキルベースのルーティングを備えています。
すでにティア制を敷いているなら、いまこそエスカレーション経路の出番です。急増時には、曖昧な「エンジニアリングに回して」が3日間の沈黙に変わります。
4. スパイクの話題には一度だけ、公開の場で答える
障害や配送遅延のとき、新しいチケットの大半が同じことを尋ねます。1件ずつ手で答えるのは、「把握しています、続報はこちらです」と伝える最も高くつく方法です。顧客が問い合わせる前に見る場所、つまりステータスバナー、ヘルプセンター、チャットの挨拶文、そしてAIエージェントの返信に、一度だけ掲載します。そのうえで、それでも届くチケットに回答し、タグ付けし、クローズするマクロを1つ作ります。
同じ工夫は電話でも使えます。あるIT責任者は、更新情報をキューの手前に置いています。
「通話がコールキューへルーティングされる前に、何が起きているか、次の更新はいつか、そしてその問題が起きているなら電話を切り、そうでないなら待ってヘルプデスクキューにつなぐ、というメッセージを流している。」
ここはAIがオーバーフロー対応で最も力を発揮する場面でもあります。インシデントのメモを読み、「チェックアウトは止まっていますか?」に同じ正確な更新情報で何百回も答えます。その間、チームは実際に注文が壊れた顧客に対応できます。詳しくはこの後で説明します。
5. ライブチャネルは正直な待ち時間つきの非同期に切り替える
ライブチャットは、急増時に最初に破綻するチャネルです。エージェント1人が同時に抱えられる数が少ないからです。Help ScoutのMaximum Chatは既定が3で、HubSpotのチャット容量の既定も3です。全員がその上限に達したとき、返事の来ないチャット画面を見つめる訪問者は、「約4時間以内に返信します」というメールを受け取るより悪い状態にあります。
ツールにはそのためのスイッチがあります。
- HubSpot では、全エージェントが最大容量に達したときの動作を選べます。待機メッセージを表示する、ランチャーを非表示にする、何もしない、のいずれかです。
- Gorgias のチャットは、エージェントが対応可能なときだけライブにでき、オフラインの買い物客には、メールチケットになるキャプチャフォームが表示されます。「Share wait time with shoppers」という設定もあります。
- Front は、オンライン時間外にチャットウィジェットを非表示にできますが、すでに開いている顧客はメッセージを送れるため、Frontは自動応答を推奨しています。
- Zendeskメッセージング の会話は、キャパシティの空きが出るまでキューで待ち、未割り当てのものは顧客から返信がないまま10分で非アクティブになります。顧客向けの側面は、Zendeskメッセージングのオフライン対応のガイドで扱っています。
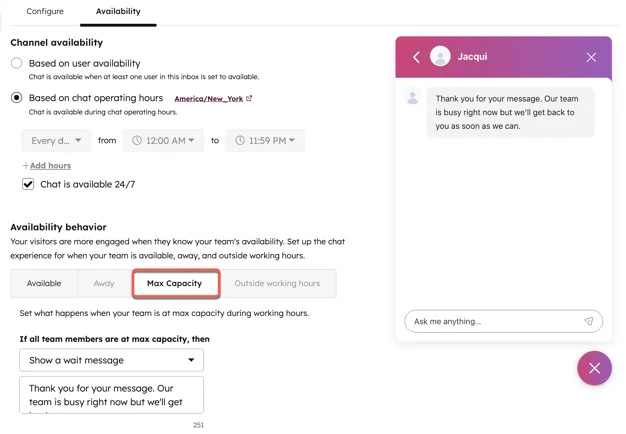
非同期サポートは、ここでは格下げではありません。守れる具体的な約束は、人を宙ぶらりんにするライブチャネルに勝ります。
音声のオーバーフロー:通話を切ってしまう設定
電話のオーバーフローは独立した節に値します。既定の設定が、人の電話を切ってしまうことがあるからです。各ツールは、待てる発信者の数と時間に上限を設けており、その後に起きることは、何も設定していない場合も含め、あなたの設定次第です。
| ツール | 最大キューサイズ | 最大待ち時間 | 待ち時間が尽きたとき | コールバック |
|---|---|---|---|---|
| Zendesk Talk | オムニチャネルルーティングありで750(Team)または1,500(Pro/Enterprise)、なしで15または50 | 1〜20分、Enterpriseは1〜60分 | 留守番電話、留守番電話がオフならオーバーフロー番号 | ProfessionalとEnterprise |
| Freshcaller | 既定20、ProとEnterpriseは要望で拡張 | 30秒〜15分 | 留守番電話、別のキュー、または切断 | 2を押す、エージェントの手が空いたら折り返し |
| Gorgias Voice | キューごとのキュー容量 | 秒単位の最大待ち時間 | 通話フローの次のステップ。「Skip queue when it's too busy」の分岐 | スターを押す、「Callback requested」チケットを作成 |
| Aircall | 呼び出しベース | チームキューは20秒〜40分 | 次のウィジェット、または通話が切れる | 0〜5回の再試行、Professional以上 |
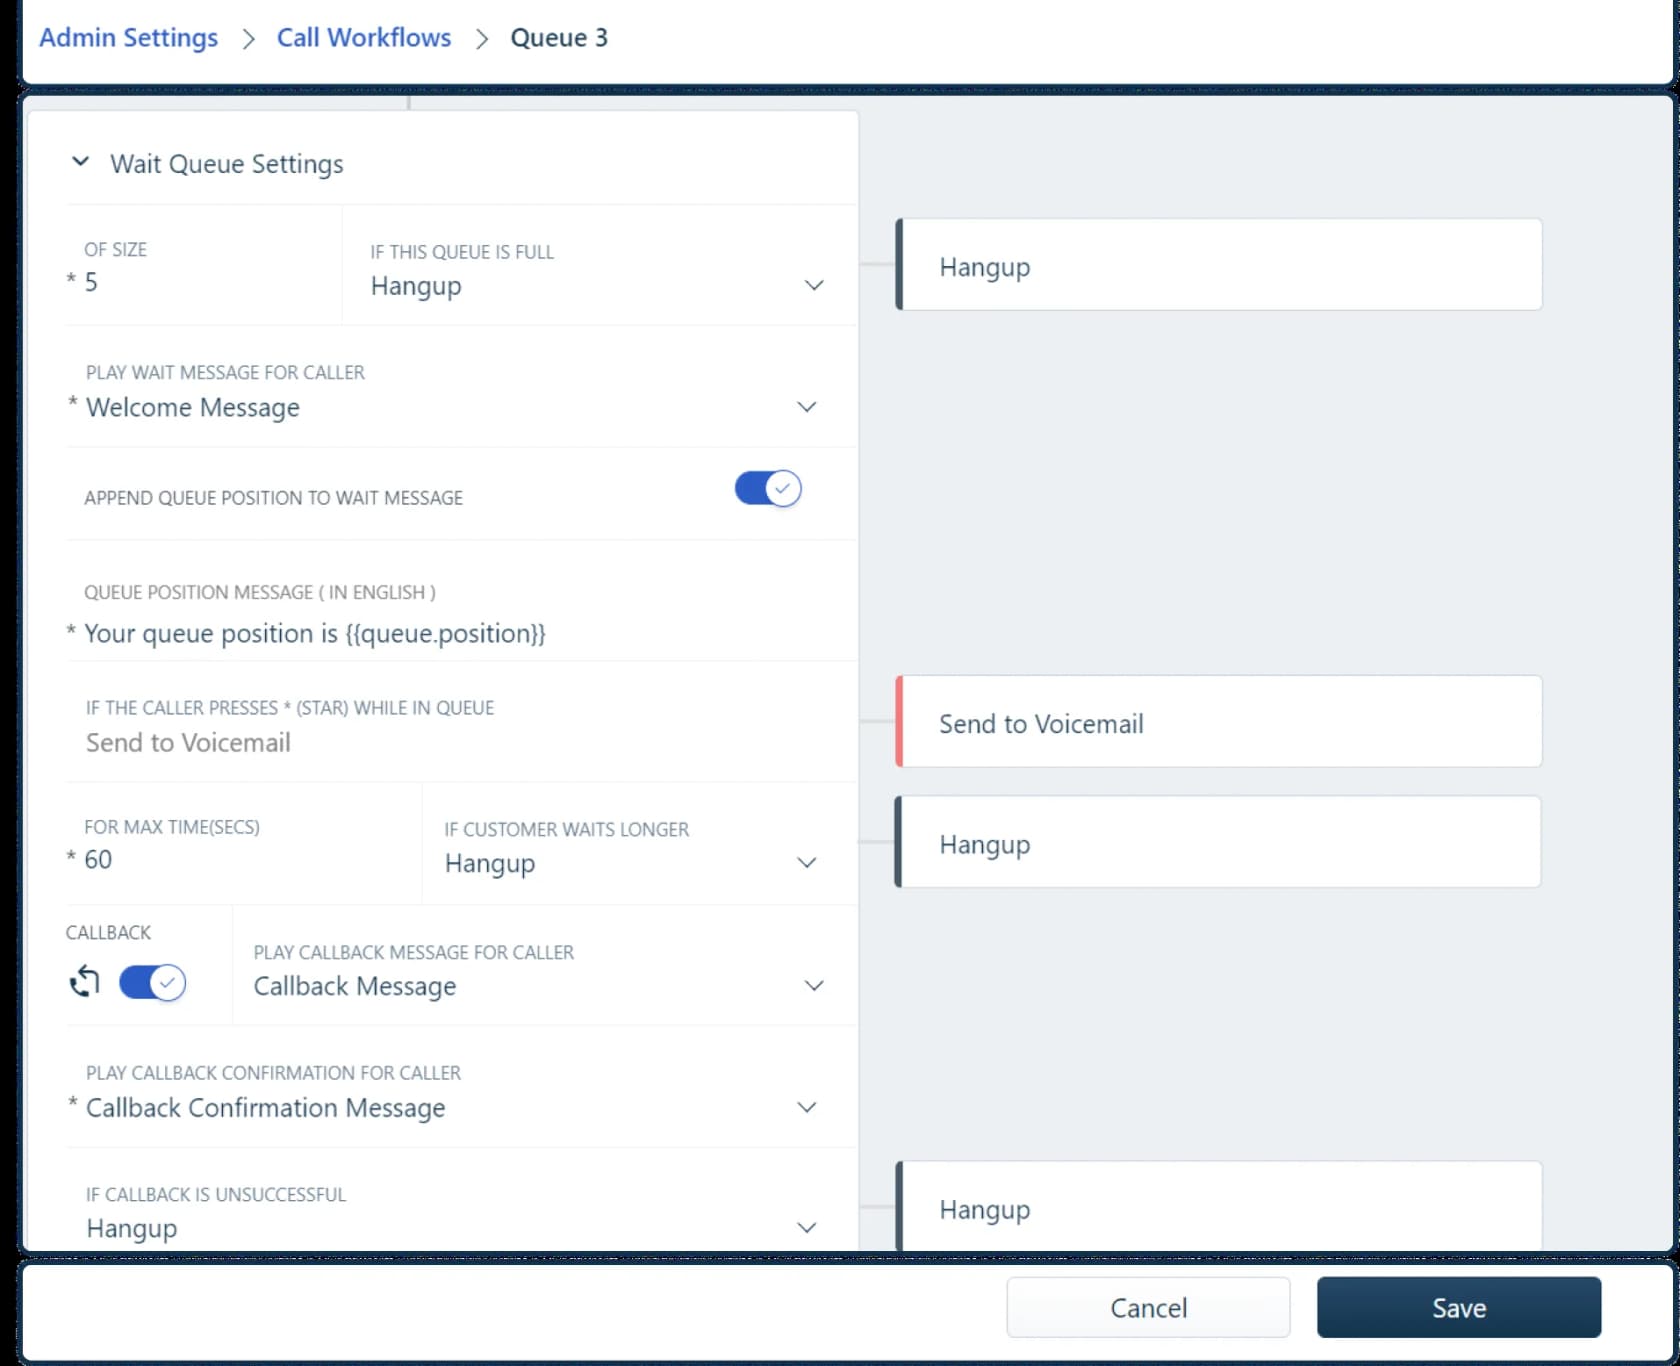
今日確認しておきたい3つの落とし穴です。
- 最後のステップの後に何もない。 Zendeskでは、留守番電話がオフでオーバーフロー番号もない場合、発信者は案内を聞いたあと通話が切断されます。Aircallでは、Ring toステップの後に何も続かないと、Aircallの通話は一度鳴って切れます。フローは必ず留守番電話かコールバックで終えてください。
- 転送は待ち時間の上限を無視する。 Zendeskの最大キュー待ち時間は転送後には無視されるため、転送された発信者はエージェントが応答するまで保留のままです。ティア1がすべてをティア2へ回す急増時に、まさにこれが起きます。
- コールバックにはオンラインの誰かが必要。 Zendeskのコールバックには、OnlineまたはAwayのエージェントが少なくとも1人必要で、Aircallのコールバックも無期限には待ちません。再試行が0回なら、失敗したものは「Failed - No agents available」として記録されます。
Zendeskのオムニチャネルルーティングをオンにしていれば、通話のオーバーフローもチケットと同じプライマリからセカンダリへのグループフォールバックを使うため、オーバーフロー電話番号は不要です。Talkのオーバーフローとタイムアウトのガイドでは、両方の構成を順に説明しています。
あなたのオーバーフロー問題はどれくらいの規模か
オーバーフローは積み重なります。チームが今日さばけなかったチケットは翌日に持ち越されるため、キャパシティを50%上回るだけのスパイクでも、続く日ごとにバックログが積み上がります。簡単な例を挙げます。通常は1日200件のチケットが来て、4人のエージェントが各100件をさばくチームが、5日間、3倍のボリュームに見舞われます。
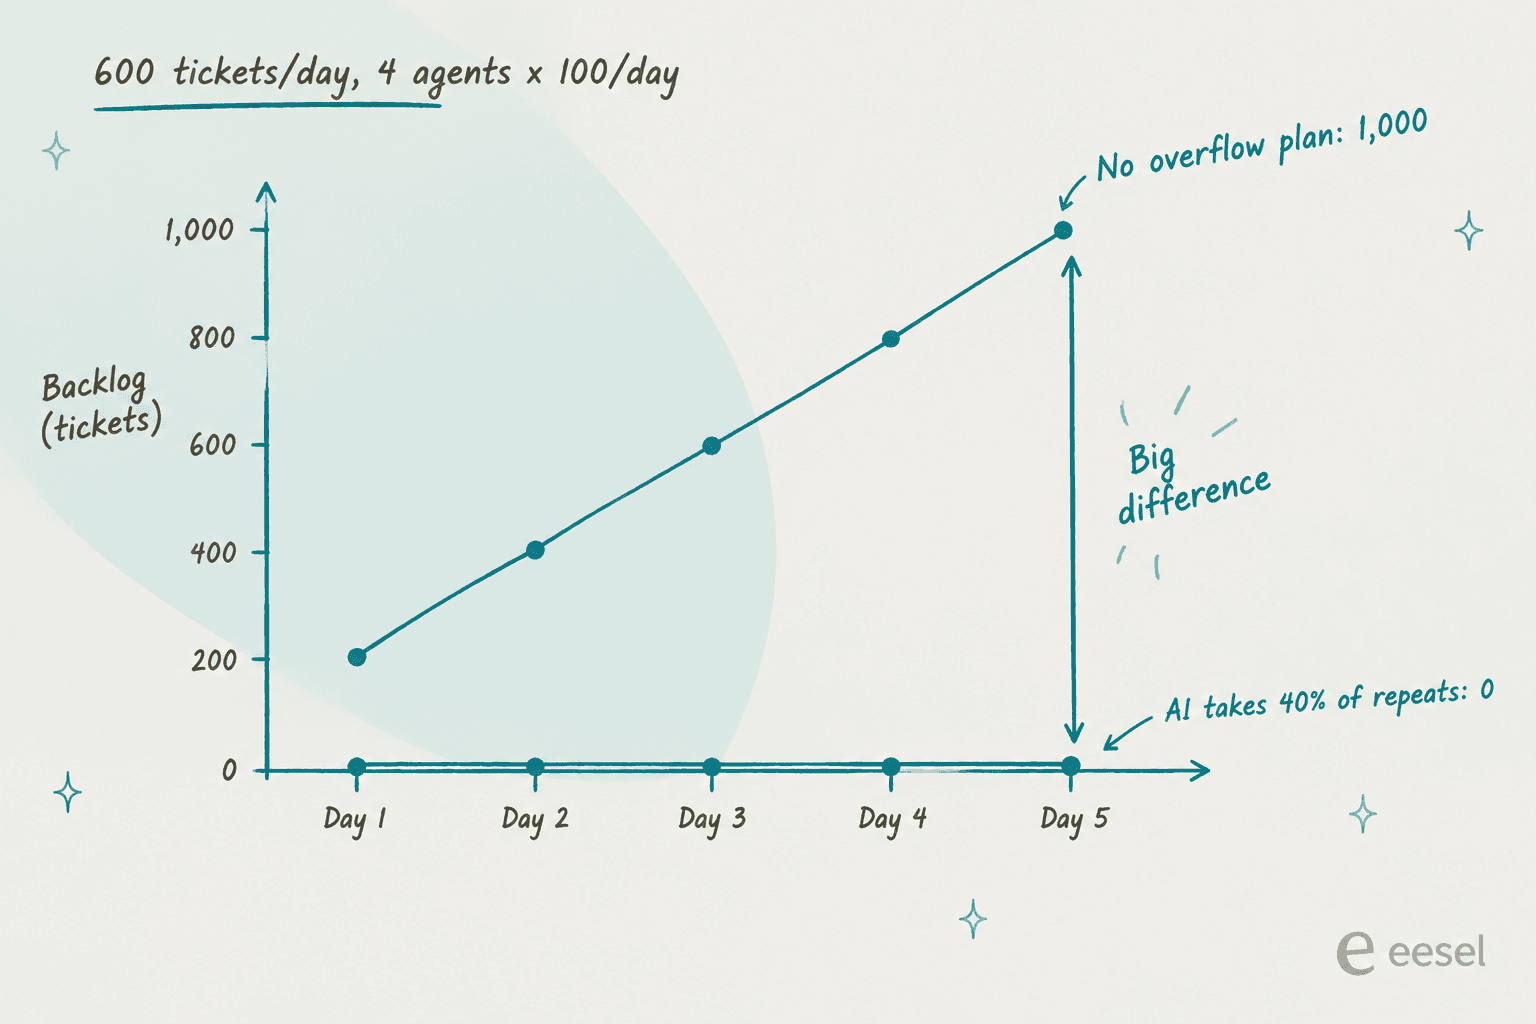
オーバーフローのレーンがなければ、チームは毎日600件のうち400件をさばくため、バックログは1日200件ずつ増え、5日目には1,000件に達します。ボリュームが200に戻っても、1日200件の余力でこれを返済するのにさらに5日かかります。2日目に問い合わせた顧客は、ほぼ1週間待たされます。バックアップレーンがスパイクの40%を吸収すれば、チームが見るのは1日360件だけで、キューは積み上がりません。同じ穴を人だけで埋めるには、教育を終えて初日から動ける状態の10エージェント日が追加で必要です。
ご自身の数字を入れてみてください。
この計算ツールは多くの要素を無視しています(対応時間のばらつき、再オープンされるチケット、疲れて遅くなるエージェントなど)が、形は正しいです。早い段階での小さく安定した軽減は、後からの英雄的な巻き返しに勝ります。
追加のキャパシティはどこから来るか
ルーティングが整ったら、オーバーフローが着地する場所がまだ必要です。現実的な供給源は4つあり、それぞれオーバーフローの形が違うものに向いています。
| 供給源 | 用意できるまで | 向いている場面 | 注意点 |
|---|---|---|---|
| 借りてくる同僚(サクセス、セールス、オペレーション) | 当日 | スパイク、ローンチ週 | 本来の仕事から人を引き離す。マクロと狭い範囲設定が必要 |
| 臨時スタッフや季節採用 | 2〜6週間 | 予測できる季節的ピーク | 立ち上げと教育の時間。季節スタッフのオンボーディングガイドを参照 |
| 外部委託のオーバーフローパートナー | セットアップに4〜8週間 | 長いピーク、24時間365日の対応 | 品質管理と文脈の欠落。まず外部委託のライブチャットを読んでください |
| ヘルプデスク内のAIエージェント | 数日 | どんな形のオーバーフローでも繰り返しの質問 | 知っている範囲にとどまり、きれいに引き継ぐ必要がある |
外部委託の最も良い形として私が見たのは、火事の最中に慌てて契約するのではなく、落ち着いた週に審査しておくパートナーというものでした。
「大きなプロジェクトや障害の間、通話量を逃がせる会社をいくつか知っている。すでにデューデリジェンスを済ませていて、必要になったときのためにホットスタンバイしてくれている。」
計画できるピークには、早めにしっかりしたカバレッジ計画で計算しておきましょう。特にブラックフライデーでは、顧客向けメッセージとシーズンのAI対策も、1か月前に準備しておくのがよいと思います。
AIはオーバーフローのどこに向いていて、どこに向かないか
私は、AIエージェントが実際のキューを処理する様子を長く見てきましたが、正直なところ、AIは1種類のチケットには最良のオーバーフローレーンで、別の種類には負債になります。スパイクの大半を占める繰り返しの質問、つまり注文状況、パスワードのリセット、「アプリは止まっていますか?」、返品期間などは得意です。3回目の注文が行方不明になった怒っている顧客には、不向きな道具です。
うまくいっているチームは、AIに戦う相手を選ばせています。GorgiasとShopifyを使い、月に約7,000件のチケットを扱うDTCサプリメントブランドのCX責任者は、eeselとのセールス通話で、私よりうまく言い表してくれました。
「AIは質問の100%には答えられない。でも、試した結果『申し訳ありません、わかりません』と答えるだけだと、7,000件のチケットを全部確認してAIが良い回答をしたか調べることはできない。そうなると、意味が少し薄れる。自信を持って扱えるチケットだけを処理し、ほかはそっとしておくAIが必要だ。」
これこそ、オーバーフロー用AIへの正しい指示です。知っていることには答え、残りは文脈を添えて引き継ぎ、誰も見直す時間のないキューに自信満々の誤答を決して送らないことです。このブランドの繁忙期は11月から5月で、まさに「注文はどこ?」のチケットの山が、本当の問題に対応すべき人たちを埋もれさせる時期です。
自分でサポートを運営する創業者たちも、ほとんど同じようなチケットが山積みになることを語っています。
「チケットが溜まって、ほとんどは似た問題のティア1の苦情だったのに、把握しきれなかった。解決の欠如による解約が燃え尽きを招いた」
ヘルプデスク各社も独自のAIレイヤーを持っており、ほとんどは成果ごとの課金で、請求額がスパイクとともに増えます。
| AIレイヤー | 課金方法 | 価格 |
|---|---|---|
| Zendesk AIエージェント | 自動解決ごと | コミットで$1.50、従量課金で$2.00 |
| Freddy AI Agent | セッションごと | 500件込み、以降100件ごとに$49 |
| Gorgias AI Agent | 自動対応ごと | $0.85〜$1.00 |
| Help Scout AI Answers | 解決ごと | $0.75、支出上限あり |
| Front Autopilot | 会話ごと | $0.05から |
| eesel AIチームメイト | 対応したチケットまたはチャットごと、各1クレジット | 500クレジットで月$299から、超過分は自分で上限設定 |
成果ごとの課金は、通常の月なら公平です。急増時にはモデル化しておく価値があります。eeselが月1,000件のECサイトの受信箱について行ったコスト分析では、解決率80%が同じ場合、解決ごとの課金は通常の月で月約$792、4,000件のブラックフライデーの月では$3,168になりました。Zendesk自身のヘルプセンターも、従量課金の解決はコミット枠より高くなると記しており、月間の解決数に上限を設けることもできます。どの方式を選ぶにせよ、スパイクの前に上限を設定し、急増に天井を設けましょう。
HubSpotには、カスケードの考え方を組み込んだ便利な機能があります。利用可能なユーザーがいないか全員が上限に達しているとき、チャットをカスタマーエージェントに割り当てるライブチャット設定です。これは1つのツール内での「AIをバックアップグループにする」パターンです。
eeselをオーバーフローレーンとして試す
チームがZendesk、Freshdesk、Gorgias、Help Scout、Frontで動いているなら、eeselのAIヘルプデスクチームメイトは、バックアップグループと非同期返信の間のトレーとしてカスケードに収まります。すでにあるキューに参加し、過去のチケット、ヘルプセンター、マクロから学び、スパイクを構成する繰り返しの質問に回答します。自信のないものは社内メモ付きでチームに渡され、返金などの元に戻せない操作は、人の承認を待たせることもできます。

急増の前に頼りにしたいのはシミュレーションです。eeselは、エージェントを実際の過去のチケットで走らせ、各回答をチームが実際に送った内容と照らして採点します。そのため、どのトピックを任せられるかが、ローンチ当日ではなく事前にわかります。Zendeskを使うGridwiseでは、最初の月にティア1のチケットの73%が解決されました。料金は対応したチケットまたはチャットごとで、シート数は無制限なので、監督役としてバックアップグループを加えても追加費用はかかりません。
ご自身のキューでeeselを無料で試してください。100クレジットの無料枠から始め、FreshdeskまたはGorgiasのアカウントを接続し、次のスパイクの前にシミュレーションを実行しましょう。