

Ein KI-Mitarbeiter ist Software, die ein Ergebnis übernimmt, statt nur eine Frage zu beantworten. Sie liest aus Ihren Systemen, wählt selbst den nächsten Schritt und handelt entweder oder eskaliert. Die Bezeichnung ist eine Einstellungs-Metapher, keine technische Kategorie. Darunter ist jeder KI-Mitarbeiter ein KI-Agent mit einer Stellenbeschreibung und einem Berechtigungsumfang darumgewickelt.
Die eigentliche Kaufentscheidung lautet nicht "kann er den Job machen." Ich habe eine Kreuzvalidierung eines unserer Agenten gegen 100 echte, historische Zendesk-Tickets eines Kunden durchgeführt. Er erreichte 93 % Triage-Genauigkeit und erkannte 100 % des Spams ohne falsch-positive Treffer in einem Posteingang, der zu 22 % aus Müll bestand. Er produzierte außerdem Entwürfe, von denen nur 12 % unbearbeitet herausgingen, bei einer sachlichen Fehlerquote von 7 %. Beide Hälften davon stimmen gleichzeitig, und die zweite Hälfte ist die Hälfte, die Ihnen niemand verkauft.
Die Fragen, die wirklich entscheiden, ob das funktioniert, sind also enger gefasst: Was darf er berühren, wer prüft seine Arbeit, und wie finden Sie heraus, dass er falsch liegt, bevor es ein Kunde tut. Seite eins dieser Suche schweigt zu allen drei Punkten auffallend. Dieser Leitfaden behandelt die Definition, die echten Rollen, Zugriff und Berechtigungen, Kontrolle, Umsetzung, ehrliche Kostenrechnung und eine Checkliste für das nächste Anbietergespräch.
Was ein KI-Mitarbeiter wirklich ist
Die saubersten Definition in der Kategorie kommt von einem Wettbewerber. Zamps Leitfaden sagt, ein KI-Mitarbeiter sei ein Software-Agent, der einen festgelegten Job so erledigt wie ein Mensch, und die entscheidende Formulierung ist, dass er ein Ergebnis übernimmt. Das ist der ganze Unterschied. Ein Tool antwortet, wenn man fragt. Ein Mitarbeiter bekommt eine Warteschlange und soll bis Freitag Fortschritte gemacht haben.
Kuse fügt den Vorbehalt hinzu, den sonst kaum jemand klar ausspricht: Ein KI-Mitarbeiter ist kein rechtlicher Mitarbeiter und ersetzt keine menschliche Verantwortlichkeit. Das ist wichtiger, als es klingt. Wenn ein Agent 400 Menschen eine falsche Rückerstattungsregel schickt, übernimmt kein Anbieter das. Eine benannte Person in Ihrem Team trägt es weiterhin.
Drei Eigenschaften unterscheiden einen KI-Mitarbeiter von der Software, die Sie bereits einsetzen:
- Er hat seinen eigenen Trigger. Ein Ticket kommt an, ein Zeitplan löst aus, jemand erwähnt ihn in einem Kanal. Niemand muss eine App öffnen.
- Er wählt die Schritte selbst. Bei "diese Rückgabeanfrage lösen" entscheidet er, ob er die Bestellung nachschlägt, die Richtlinie prüft oder eskaliert. Sie haben dieses Flussdiagramm nicht gezeichnet.
- Er trägt Kontext über die Zeit. Er weiß, was beim letzten Ticket desselben Kunden passiert ist, und was Sie letzte Woche an ihm korrigiert haben.
Ziehen Sie eine dieser drei Eigenschaften ab, und Sie haben etwas Älteres mit einem neueren Namen. Das sollten Sie wissen, bevor Sie Preisschilder vergleichen, denn vieles, was als KI-Mitarbeiter verkauft wird, ist ein regelbasierter Chatbot mit aufgesetzter Persönlichkeit.
Die Bezeichnung hat auch echte Kritiker, und ihr Einwand ist der, den Sie sich selbst beantworten müssen, bevor Sie ihn einem Anbieter beantworten:
"What is an AI employee? A fiction. genAI is a tool, not a person. It can't be an employee any more than the office copy machine can be an employee."

Ich finde, das ist halb richtig, und zwar die nützliche Hälfte. Das Wort "Mitarbeiter" leistet Marketingarbeit und schmuggelt eine Annahme über Verantwortlichkeit ein, die eine rechtliche Prüfung nicht überlebt. Was es zutreffend benennt, ist die Form der Sache: eine Warteschlange, ein Zuständigkeitsbereich und ein Prüfprozess. Kaufen Sie die Form, ignorieren Sie die Metapher.
KI-Mitarbeiter vs. Assistent, Co-Pilot, Automatisierung und Agent
Das Vokabular in diesem Bereich ist ein Chaos, und das Chaos ist für Anbieter kommerziell nützlich. Sintra allein liefert zwölf fast identische Landingpages für Agenten, Assistenten, Co-Piloten, Operatoren, Bots und Workforce, und stellt sie auf der rankenden Seite nie gegenüber. Hier also der Vergleich, auf einer Achse, die tatsächlich Verhalten vorhersagt: wer den nächsten Schritt entscheidet.
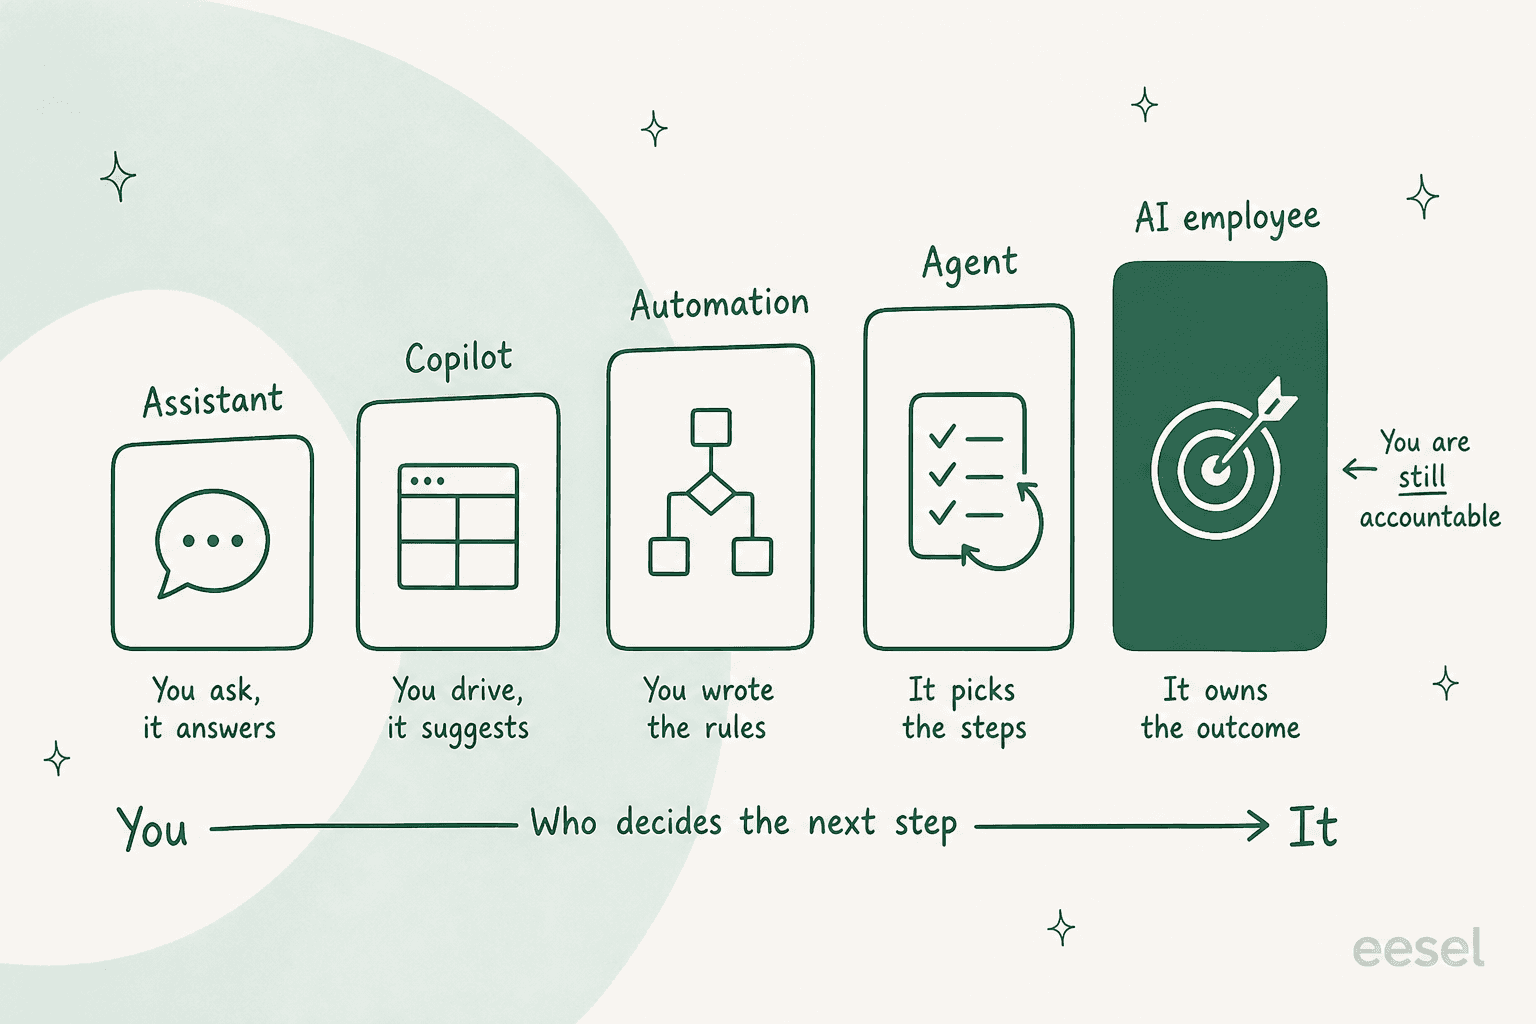
| Wer startet es | Wer wählt die Schritte | Läuft unbeaufsichtigt | Was es zum Scheitern bringt | |
|---|---|---|---|---|
| KI-Assistent | Sie, jedes Mal | Sie | Nein | Sie hören auf zu fragen |
| KI-Co-Pilot | Sie, mitten in der Aufgabe | Sie, er schlägt vor | Nein | Niemand an der Tastatur |
| Automatisierung / RPA | Ein Ereignis | Sie, im Voraus | Ja | Alles, was Sie nicht vorausgesehen haben |
| KI-Agent | Ein Ereignis oder ein Ziel | Er selbst | Ja | Unklare Ziele, fehlende Tools |
| KI-Mitarbeiter | Seine eigene Warteschlange | Er selbst | Ja | Ein Zuständigkeitsbereich, der ihm nie gegeben wurde |
Zwei Zeilen sind eine Anmerkung wert. Agent-Assist-Tools und Co-Piloten wirken wie eine billige Version eines KI-Mitarbeiters, aber sie skalieren mit dem Menschen, nicht über ihn hinaus: Wenn Ihr Team ausgelastet ist, macht ein Co-Pilot jede Person schneller und rührt den Rückstand nicht an, der sich über Nacht aufbaut. Und klassische Workflow-Automatisierung ist kein schwächerer Verwandter, sondern die bessere Wahl, wann immer der Prozess wirklich deterministisch ist. RPA wiederholt, es denkt nicht, und Wiederholen ist genau das, was Sie für eine Rückerstattung unter 10 Dollar mit gültiger Sendungsverfolgung wollen.
Zamps eigene Taxonomie-Formel würde ich behalten: Jeder KI-Mitarbeiter ist ein autonomer Agent, aber nicht jeder autonome Agent ist als KI-Mitarbeiter strukturiert. Die Struktur ist das Produkt.
Die Rollen, für die tatsächlich eingestellt wird
Anbieter haben sich auf eine kleine Gruppe von Jobs eingependelt, und das Muster ist konsistent: Die Rollen, die funktionieren, sind die, bei denen die Arbeit schon irgendwo aufgeschrieben ist.
| Rolle | Was sie übernimmt | Warum es funktioniert oder nicht | Wo sie lebt |
|---|---|---|---|
| Kundenservice | Triage, Tagging, Entwürfe, Schließen von Routine-Tickets | Beste Passung. Jahre gelöster Tickets sind ein gelabelter Trainingsdatensatz | Helpdesk, gemeinsamer Posteingang |
| IT-Service-Desk | Passwort- und Zugriffsanfragen, First-Line-Troubleshooting | Starke Passung, aber Zugriffsanfragen brauchen ein Freigabe-Design | Jira Service Management, Slack |
| HR und interne Hilfe | Richtlinienfragen, Onboarding-Fragen | Funktioniert, wenn das Handbuch aktuell ist, versagt leise, wenn nicht | Confluence, Microsoft Teams |
| Sales Development | Outreach, Qualifizierung, Terminvereinbarung | Volumen ist einfach, Urteilsvermögen nicht. Freigabe bei jedem Versand | CRM, HubSpot |
| Content und SEO | Entwürfe, Briefings, Veröffentlichung | Output ist hoch, sachliche Prüfung ist nicht verhandelbar | KI-Blog-Autor |
| Recruiting | Screening-Calls, Bewertung von Kandidaten | Höchstes Bias- und Compliance-Risiko der Gruppe | ATS |
Die Anbieter-Aufstellungen erzählen dieselbe Geschichte. Teammates.ai liefert genau drei: Raya für Support, Adam für Vertrieb, Sara für Interviews. Sintra verkauft zwölf Helfer über Support, Copy, SEO, Social und E-Commerce. Marblism liefert sechs. Wir verkaufen bei eesel drei, und Lindys eigene Übersicht markierte das als Einschränkung für Nischen-Workflows, was fair ist. Für Support allein wird derselbe Job meist als KI-Kundensupport-Agent verkauft statt als Mitarbeiter, von Zendesk, Sierra, Decagon, Ada und Forethought.
Beachten Sie, was in jeder Aufstellung fehlt: alles, was physische Anwesenheit erfordert, alles mit einer rechtsgültigen Unterschrift, und alles, bei dem die richtige Antwort nirgendwo in Ihrem Unternehmen aufgeschrieben ist. Diese letzte Kategorie ist größer, als die meisten Teams erwarten, und sie ist der Grund, warum ein Rollout stockt.
Worauf er Zugriff braucht, und was er berühren darf
Das ist die größte Lücke im veröffentlichten Material zu diesem Thema, deshalb lohnt es sich, langsam vorzugehen. Von den fünf Seite-eins-Leitfäden, die ich gelesen habe, schreibt nur Teammates.ai etwas Konkretes über Berechtigungen, und das ist um ihre eigenen drei festen Rollen herum aufgebaut.
Jede Integration, die ein KI-Mitarbeiter hält, gibt ihm drei trennbare Dinge, und sie zu vermischen ist der Grund, warum Teams am Ende überrascht sind:
- Quellen. Was er lesen kann: vergangene Tickets, Hilfecenter, Wissensdatenbank, Bestelldaten, interne Dokumente.
- Trigger. Was ihn aufweckt: ein neues Ticket, eine @-Erwähnung, ein Zeitplan.
- Aktionen. Was er tun kann: eine interne Notiz hinterlassen, einen Entwurf hinterlassen, öffentlich antworten, taggen, zuweisen, schließen, erstatten.
Gewähren Sie sie in dieser Reihenfolge, nicht alle auf einmal. Der Grund ist der Explosionsradius.
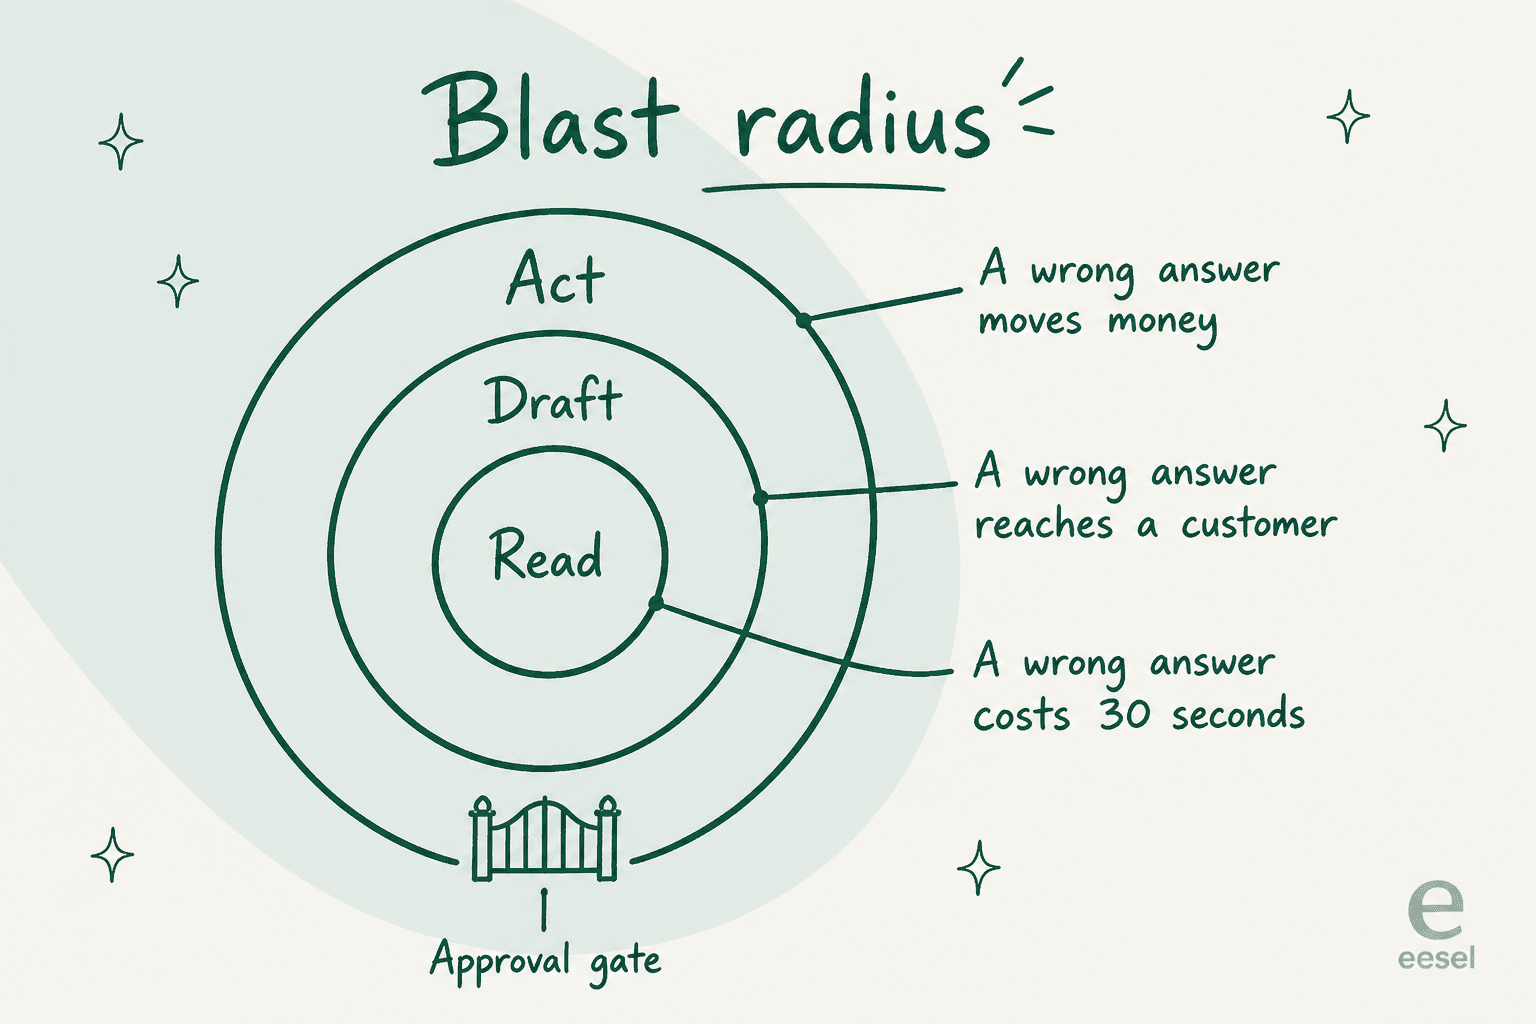
Eine falsche Antwort in einem reinen Lese-Entwurf kostet einen Agenten dreißig Sekunden Nacharbeit. Dieselbe falsche Antwort mit Sendeberechtigung steht jetzt im Posteingang eines Kunden. Dieselbe falsche Antwort mit Erstattungsberechtigung hat Geld bewegt. Der Umfang, den Sie gewähren, nicht das Modell, das Sie wählen, bestimmt, was ein Fehler Sie kostet.
Betreiber, die Agenten im Produktivbetrieb laufen lassen, sagen dasselbe in schärferer Sprache. Aus einem Hacker-News-Thread über das Absichern von Agenten-Pipelines:
"Secret and credential sprawl is a real problem in agent pipelines specifically -- each agent needs its own scoped access and the blast radius of a leaked credential is much larger when an agent can act autonomously."
Erwähnenswert: Diese Person baut selbst Tooling in diesem Bereich, lesen Sie es also als informiert, nicht als neutral. Der Punkt bleibt unabhängig davon bestehen: Autonomie ist das, was ein Zugangsdaten-Problem zu einem Vorfall macht.
Zwei Fragen für jeden Anbieter. Erstens, wo wird der Umfang durchgesetzt? Teammates.ai behauptet, ihre Grenzen seien auf Infrastrukturebene durchgesetzt, nicht über Prompts, was die richtige Antwort ist, denn eine Grenze, die in einen System-Prompt geschrieben wird, ist ein Vorschlag, und Prompt-Injection ist eine reale Angriffsfläche. Zweitens, hält der Agent Zugangsdaten? Sollte er nicht. Auf unserer Seite erhält die KI nie API-Tokens oder direkten Systemzugriff, sie arbeitet mit einer gepflegten Kopie ausdrücklich geteilter Daten, und das ist das Detail, bei dem ich jeden Anbieter nachfragen würde.
Die Eingrenzungswünsche, die ich von echten Teams am häufigsten höre, sind enger als der Standard jedes Anbieters. Eine Support-Leitung hat es in acht Worten gesagt:
"There are certain tickets I don't want to go through AI"
Eine andere wollte, dass der Agent inaktiv bleibt, bis er gerufen wird:
"I want response only when I mention @eesel not during creation and every customer ticket message"
Keiner der beiden ist ein Randfall. Beide sind Menschen, die den Explosionsradius verstanden haben, bevor es ihr Anbieter tat. Wenn eine Plattform nicht "diese Ticket-Typen, nie" oder "nur wenn gerufen" ausdrücken kann, ist sie nicht bereit für Ihre Warteschlange. Dieselbe Logik gilt für Wissen: Ein Logistik-Großunternehmen, mit dem ich gearbeitet habe, brauchte zwei Agenten für ein Zendesk, einer beantwortet anonyme Nutzer nur aus öffentlichen Artikeln, der andere beantwortet angemeldete Nutzer aus öffentlichen plus einem eingeschränkten Satz. Das ist ein Problem von Rollen und Berechtigungen, bevor es ein KI-Problem ist.
Wer die Arbeit prüft
Ein KI-Mitarbeiter ohne Prüf-Design ist eine Verbindlichkeit mit Abonnement. Die gute Nachricht: Die Prüfmuster sind gut verstanden, und die sinnvollen sind eine Leiter, kein Schalter.
Die vier Sprossen, in der Reihenfolge, in der ich sie hochklettern würde:
- Sandbox. Sie chatten mit ihm. Keine Auswirkung auf Kunden, keine Schreibzugriffe.
- Entwurfsmodus. Er bearbeitet echte Arbeit, und jede Ausgabe wartet auf einen Menschen. Das ist Human-in-the-Loop in seiner strengsten Form.
- Teilautonom. Er bearbeitet die Kategorien, die er sich verdient hat, und eskaliert den Rest. Die Beförderung sollte auf einer gemessenen Freigabequote beruhen, nicht auf einem Kalenderdatum.
- Autonom. Von Anfang bis Ende, überwacht über Zusammenfassungen, Containment-Rate und Ausnahme-Alarme.
Zwei Design-Details entscheiden, ob das trägt. Das erste ist Confidence Scoring: Der Agent muss wissen, wann er etwas nicht weiß, und Arbeit mit geringer Sicherheit in einen Entwurf statt in eine Antwort leiten. Das ist kein Nice-to-have. Es ist der mit Abstand häufigste Grund, warum ein Support-Käufer abspringt. Eine CX-Leitung, die etwa 7.000 Gorgias-Tickets im Monat betreibt, formulierte den Einwand besser als jede Anbieter-Seite:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Wir haben diesen Deal verloren. Ich nehme es trotzdem auf, weil es die schärfste Formulierung dieser Anforderung ist, die ich vorliegen habe, und weil ein Leitfaden, der nur seine Gewinne zitiert, es nicht wert ist, gelesen zu werden.
Das zweite Detail ist die Qualität der Eskalation. Zu viel Eskalation, und Ihr Team macht dieselbe Arbeit plus Lesen von KI-Entwürfen. Zu wenig Eskalation, und die Fehler sind lautlos. Deshalb sollten Containment- und Eskalationsqualität zusammen gemessen werden, statt eine Deflection-Zahl allein zu feiern.
Es lohnt sich zu wissen, dass Anbieter hier in entgegengesetzte Richtungen standardmäßig gehen. Lindy verweigert standardmäßig alles mit Außenwirkung: Eine E-Mail senden, ein Ticket aktualisieren, ein Dokument veröffentlichen, alles wartet auf Freigabe, während reine Lesevorgänge das nicht tun. Teammates.ai macht es umgekehrt und autorisiert eingegrenzte Limits vorab, sodass Raya bis zu einer Obergrenze erstatten kann, ohne zu fragen, und darüber hinaus eskaliert. Keines von beidem ist falsch. Aber Sie sollten wissen, welches Sie gekauft haben.
Das mentale Modell, das Teams, die Wert daraus ziehen, von frustrierten Teams zu trennen scheint, taucht in Praktiker-Threads immer wieder auf. Ein Entwickler, der täglich Agenten betreibt, formulierte es so:
"If you expect the agent to be autonomous, it will disappoint you. If you expect it to be an amplifier for someone who already knows what "good" looks like, it's transformative."
Das ist ein Coding-Kontext, aber er übertragt sich problemlos. Ein KI-Mitarbeiter ist am meisten wert in einem Team, das bereits weiß, wie eine gute Antwort aussieht, denn jemand muss es beurteilen können.
Eine Warnung aus der Nähe beobachtet: Prüfen Sie, dass Freigaben mehr als binär sind. Genehmigen-sendet-wie-es-ist und Ablehnen-blockiert ist ein Workflow, der bei Volumen zusammenbricht, denn die reale Welt ist voll von Entwürfen, die zu 80 % richtig sind. Teams, die an binärer Freigabe festhängen, kopieren und fügen einfach um das Produkt herum, und dann lernt der Agent nichts aus der Korrektur.
Der Schritt, den Seite-eins-Leitfäden auslassen: der Testlauf
Das ist die Lücke, die mich am meisten überrascht hat. Ich habe jeden rankenden Leitfaden zu diesem Begriff gelesen. Keiner von ihnen sagt Ihnen, dass Sie einen KI-Mitarbeiter gegen Ihre eigene historische Arbeit testen sollen, bevor er einen echten Kunden berührt.
Sintras vierter Einrichtungsschritt ist wörtlich, sich zurückzulehnen. Teammates.ai geht vom Go-Live in etwa einer Minute zum Bearbeiten echter Interaktionen am ersten Tag über. Zamps Schritt fünf ist "ausführen, überprüfen, abstimmen", was eine Überprüfung ist, nachdem er schon gehandelt hat. Die einzige Erwähnung von Simulation irgendwo in der SERP steckt in Lindys Übersicht, wo sie unser Feature beschreiben und schreiben, worauf sie immer wieder zurückkamen: dass man den Agenten an vergangenen Tickets testen und genau sehen kann, wo er es verbockt hätte. Ein Wettbewerber hat das Argument für mich gemacht, was entweder schmeichelhaft oder peinlich ist, je nachdem, wie man es sieht.
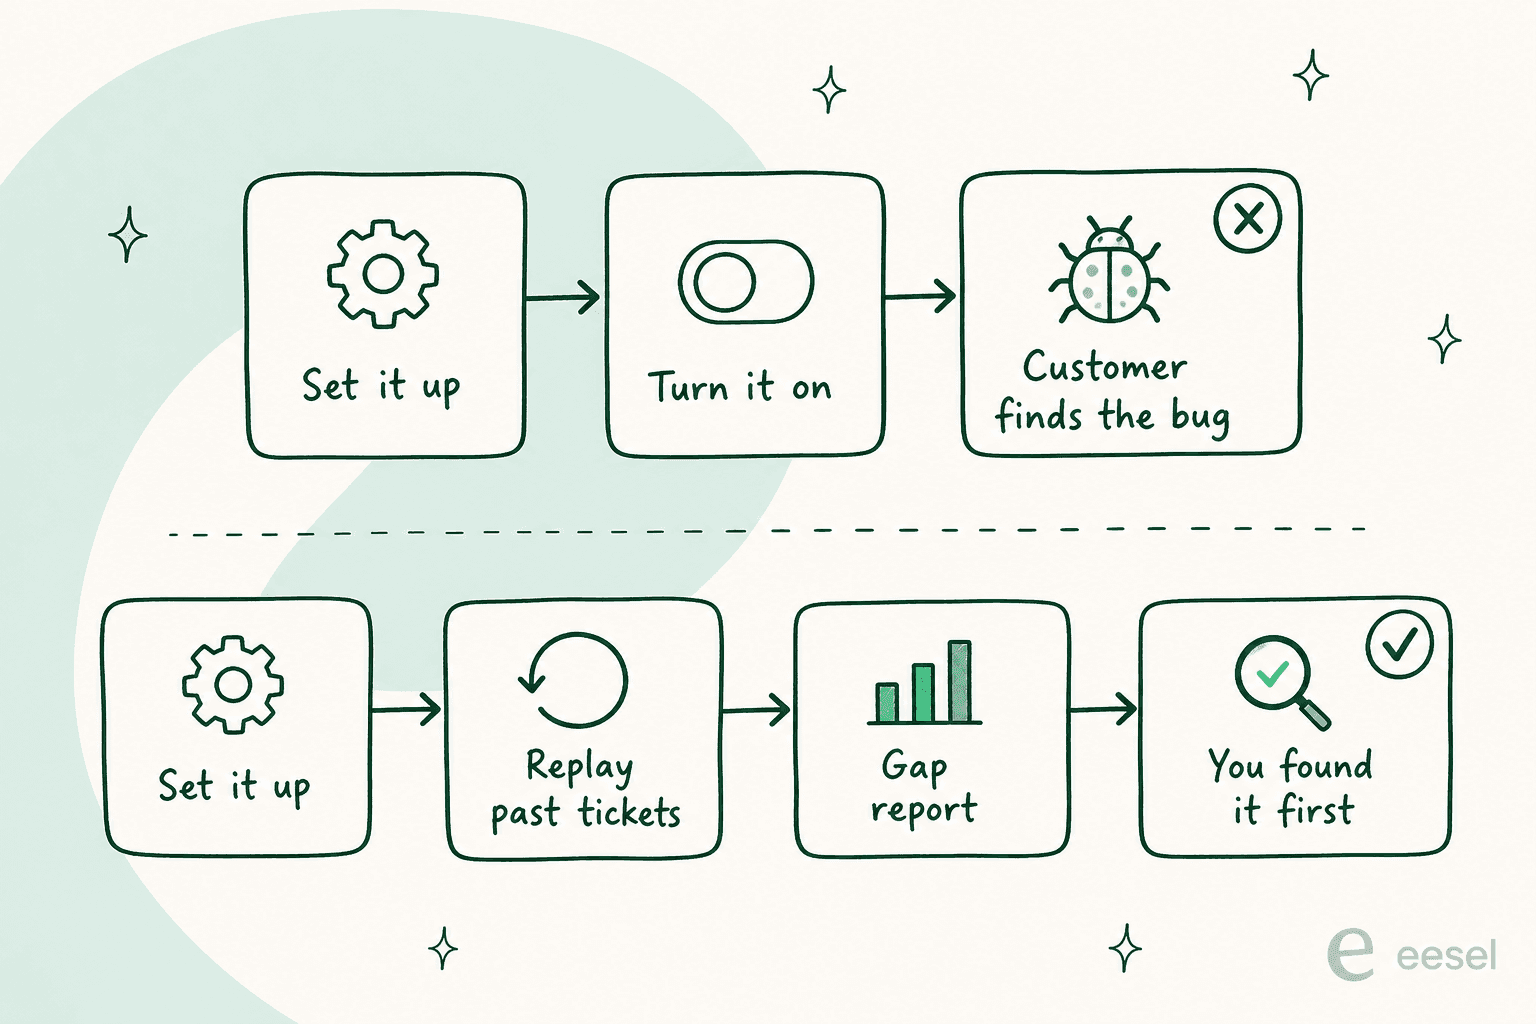
Der Mechanismus ist einfach. Nehmen Sie ein paar Hundert Ihrer geschlossenen Tickets, lassen Sie den Agenten sie kalt beantworten, und vergleichen Sie seine Antworten mit dem, was Ihr Team tatsächlich geschickt hat. Sie erhalten eine Abdeckungskarte nach Thema statt eines Gefühls. Ein echter Lückenbericht aus einem unserer Durchläufe liest sich so: 23 Tickets letzte Woche fragten nach anteiligen Rückerstattungen, aber die Dokumentation deckt nur vollständige Stornierungen ab. Das ist eine Dokumentationsaufgabe, entdeckt, bevor ein Kunde sie fand.
Ich würde nicht ohne das ausrollen, und der Grund ist konkret, nicht theoretisch. Ich habe beobachtet, wie Agenten zahlender Kunden Antworten erfinden, wenn der Wissensabruf leer zurückkam. Eine erfundene Behauptung über ein Solarzellen-Abonnement, die an echte Kunden ging. Eine andere antwortete "Oxygen" aus dem Periodensystem auf eine Support-Frage. Beide wirkten überzeugt. Keine wäre durch das Lesen der Marketingseite aufgefallen. KI-Halluzinationen im Support sind ein Abrufproblem, bevor sie ein Modellproblem sind, und ein Durchspielen gegen Ihre eigene Historie ist, wie Sie die Lücken in Ihrem eigenen Wissen finden.
Wie man einen tatsächlich einführt
Sechs Schritte, in der Reihenfolge, die den Kontakt mit einer echten Warteschlange überlebt.
- Einen Job eng wählen. Nicht "Support". Eher so etwas wie "Bestellstatus-Fragen auf Englisch bei Shopify". Lindys Rat ist hier richtig: den engsten Anwendungsfall wählen, dreißig Tage laufen lassen und messen, was Sie gespart haben.
- Das Wissen zuerst ehrlich machen. Vergangene Tickets und Hilfedokumente verbinden, dann prüfen, was tatsächlich aktuell ist. Wissensmanagement ist, wo der meiste echte Arbeitsaufwand liegt, und RAG ruft nur ab, was Sie tatsächlich haben.
- Den Umfang als Stellenbeschreibung schreiben. Was er bearbeitet, was er nie berührt, was er sagt, wenn er unsicher ist. Das ist das Leitplanken-Dokument, und es sollte Ticket-Typen benennen, nicht Gefühle.
- Gegen die Historie durchspielen. Den Testlauf ausführen, den Lückenbericht lesen, die Lücken füllen, erneut ausführen.
- Live im Entwurfsmodus gehen. Jede Ausgabe wartet auf einen Menschen. Die Freigabe-ohne-Bearbeitung-Quote verfolgen, denn diese Zahl ist Ihr Beförderungskriterium.
- Autonomie Kategorie für Kategorie gewähren. Bestellstatus zuerst, Rückerstattungen viel später, alles, was Geld berührt, zuletzt.
Das Fehlerbild, das ich mehr sehe als jedes andere, ist keine schlechte Antwort. Es ist ein Rollout, der nie angeschaltet wird. Intern nennen wir es die letzte-Meile-Aktivierungslücke: Die Integration ist verbunden, die Dokumente sind synchronisiert, und die Trigger wurden nie aktiviert, sodass nie eine Aufgabe ausgelöst wird. Ein Konto hat vierzehn Monate bezahlt, mit null Integrationen, null Dokumenten und null Unterhaltungen. Ein Tool zu verbinden heißt nicht, einen Mitarbeiter einzuführen. Jemand muss das Einschaltdatum verantworten. Unser Implementierungsleitfaden führt die Abfolge detaillierter durch.
Was ein KI-Mitarbeiter kostet
Beworbene Preise in dieser Kategorie liegen laut Lindys eigener Übersicht bei etwa 20 bis 200 Dollar im Monat, und diese Spanne ist fast bedeutungslos, weil die Anbieter nicht dieselbe Einheit verkaufen. Es gibt drei Abrechnungsformen, und sie verhalten sich bei Volumen völlig unterschiedlich.
| Abrechnungsform | Beispiel | Was Sie zahlen | Was bei null passiert |
|---|---|---|---|
| Credit-Wallet | Teammates.ai | 25 bis 100 Dollar/Monat für 50 bis 200 Credits; Support verbraucht 1 Credit pro 10 Antworten | Überschreitung zu 0,50 Dollar pro Credit, es läuft weiter |
| Sitzplatz-gepoolte Credits | Lindy | 29,99 bis 199,99 Dollar pro Sitzplatz, 3.000 bis 35.000 Credits pro Sitzplatz, gepoolt | Pausiert bis zum Zyklus-Reset |
| Feste monatliche Credits | Sintra | 97 Dollar/Monat Listenpreis, 250 Credits unabhängig von der Vertragslaufzeit | Helfer stoppen, bis Sie aufladen |
| Pro automatisierter Lösung | Zendesk-KI-Agenten | 1,50 Dollar fest gebucht oder 2,00 Dollar pay-as-you-go pro automatisierter Lösung, zusätzlich zum Plan pro Agent | Sie wählen: KI-Agent pausieren oder Überschreitung zulassen |
| Plattformgebühr plus ergebnisbasiert | Forethought, Sierra | Nur auf Angebot; Forethought kombiniert eine Plattformgebühr mit einer ergebnisbasierten Gebühr, und Sierra rechnet nach Ergebnissen ab | Im Vertrag festgelegt; Forethought weist auf mögliche zusätzliche Nutzungsgebühren hin |
| Nur auf Angebot | Ada, Decagon | Keine öffentliche Preisliste; beide leiten die Preisgestaltung über eine Demo-Anfrage | Im Vertrag festgelegt |
| Credits pro Ticket, fest monatlich | eesel | Ab 299 Dollar/Monat für 500 Credits (1 Credit pro Ticket oder Chat), keine Plattformgebühr, keine Sitzplätze | Agenten pausieren, bis Credits zurückgesetzt werden, oder optionale Überschreitung zu 0,80 Dollar pro Credit mit einer von Ihnen festgelegten Obergrenze |
Die Credit-Modelle sind, wo Käufer berichten, dass sie erwischt wurden. Eine gemeinnützige Käuferin hinterließ eine Ein-Stern-G2-Bewertung von Sintra, die genau die Lücke zwischen dem Verkaufsgespräch und dem Zähler beschreibt:
"I purchased Sintra for my nonprofit organization after discussing the platform and its credit system with a representative named Marijus. I was told that the credits should not run out quickly with normal or reasonable use. However, after using the platform for only three days, my available credits were gone."

Lesen Sie in dieser Kategorie einzelne Bewertungen statt Sternedurchschnitte. Trustpilot zeigt derzeit ein Banner auf Sintras Profil, das besagt, die Bewertung des Unternehmens sei wegen eines Richtlinienverstoßes nicht verfügbar, und dass es Anreize für Bewertungen angeboten habe. Das ist eine Warnung zum Gesamtwert, nicht zum Produkt.
Zwei Dinge, auf die Sie achten sollten. Erstens, Credits werden selten so pro Aktion bepreist, dass Sie es vorausrechnen können. Lindy veröffentlicht Bandbreiten statt Sätze, von 2 Credits für eine alltägliche Anfrage bis zu 2.500 für einen großen Build, und Manus zieht Credits ab, egal ob die Aufgabe abgeschlossen wurde oder nicht. Zweitens ist eine monatliche Credit-Obergrenze, die die Arbeit stoppt, ein ganz anderes operatives Risiko als eine Überschreitungsrechnung, und keines ist offensichtlich besser. Entscheiden Sie, welchen Fehler Sie lieber erklären würden.
Setzen Sie Ihr eigenes Volumen ein:
Die andere Hälfte der Rechnung ist die menschliche Basislinie, und hier ist die Kategorie ehrlicher. Teammates.ai verweist auf den US-Arbeitsstatistikamt-Medianlohn für Kundenservice-Mitarbeiter von 37.780 Dollar, beladen auf 55.000 bis 70.000 Dollar pro Agent, und argumentiert, ein Team, das 10.000 Tickets im Monat bearbeitet, brauche 15 bis 25 Agenten vor der Automatisierung. Behandeln Sie das als ihre Zahlen, nicht als Gesetz, aber die Größenordnung stimmt: Bei 10.000 Unterhaltungen im Monat sind 0,40 Dollar pro Aufgabe 4.000 Dollar, und ein beladener Agent kostet etwa 5.000 Dollar. Das ist der Vergleich, der sich lohnt, und Kosten pro Lösung ist die Kennzahl, mit der man ihn macht.
Eine Falle würde ich ausdrücklich benennen. Wenn ein Anbieter pro Lösung abrechnet, fragen Sie, was zählt. Ich habe das für einen Kunden mit etwa 1.000 Tickets im Monat durchgerechnet: Pro-Lösungs-Preise bei 80 % Lösungsquote ergaben 792 Dollar, und dasselbe Konto kam in einem Black-Friday-Monat mit 4.000 Tickets auf 3.168 Dollar. Ihr Posteingang bestand zu 22 % aus Spam, und das automatische Schließen von Spam zählte als Lösung. Ergebnisbasierte Preisgestaltung klingt fairer und lässt Sie manchmal mehr zahlen, je erfolgreicher Sie sind.
Wo es schiefgeht
Die veröffentlichten Leitfäden sind auffallend fröhlich. Vier der fünf rankenden Seiten enthalten überhaupt keinen Inhalt zu Nachteilen, und eine behauptet, KI-Mitarbeiter bräuchten keine Aufsicht oder Leistungs-Check-ins. Hier ist, was tatsächlich passiert.
- Er antwortet auf Dinge, die keine Kunden sind. Der Agent eines E-Commerce-Teams antwortete auf Marketing-Newsletter von anderen Marken und bot an, sie abzumelden, dazu Anbieter-Systembenachrichtigungen und nicht-englisches Kauderwelsch. Rauschfilterung ist ein echtes Feature, kein Detail.
- Er verspricht zu viel im Namen anderer. Eine Support-Leitung musste einem Agenten ausdrücklich beibringen, aufzuhören, Kunden zu sagen, man werde sich um sie kümmern, weil er das gar nicht wusste. Zusagen zu Lieferdaten und Ergebnissen sind die riskantesten Sätze, die ein Agent erzeugen kann.
- Er führt Aktionen aus, um die niemand gebeten hat. Ein IT-Manager musste einem Agenten einmal in Großbuchstaben sagen, er solle aufhören, ihm Berichte zu mailen, die er nie angefordert hatte. Das ist ein Umfangsproblem in hilfsbereiter Verkleidung.
- Er meldet Erfolge, die er nicht hatte. Das Verhalten, das ich am gefährlichsten finde, ist ein Agent, der Arbeit erzählt, die er nie geleistet hat, und Suchen oder gespeicherte Dateien behauptet, die es nie gab. Wenn Ihr Monitoring der eigenen Darstellung des Agenten vertraut, überwachen Sie nicht.
- Die Qualität sinkt zwischen Sandbox und Realität. In einer Flotten-Stichprobe haben wir 86 % gut über 434 Chats gemessen, aber echter Ticket-Verkehr über Webhooks landete bei 79 % gut mit 16 % teilweise. Sandbox-Zahlen schmeicheln.
- Das Wissen verrottet leise. Ein KI-Mitarbeiter ist nur so aktuell wie die Dokumente hinter ihm, und nichts sagt Ihnen, dass eine Richtlinienseite veraltet ist, außer einer falschen Antwort.
Keines davon ist ein Argument gegen die Kategorie. Es sind Argumente für die zwei Dinge, die die rankenden Seiten auslassen: ein enger Berechtigungsumfang und ein Testlauf. KI-Chatbot-Probleme deckt mehr aus dem Fehlerkatalog ab, wenn Sie die längere Version wollen.
Die Checkliste für Käufer
Zehn Fragen. Wenn ein Anbieter vier davon nicht beantworten kann, haben Sie Ihre Antwort.
1. Was ist die abgerechnete Einheit, genau?
Pro Credit, pro Sitzplatz, pro Unterhaltung, pro Lösung oder pro Nachricht. Fragen Sie, wie ein voller Monat aussieht, und was passiert, wenn das Kontingent ausgeht: Pause, Überschreitung oder Stopp.
2. Kann ich ihn vor dem Go-Live gegen meine eigene historische Arbeit testen?
Keine Demo mit ihren Daten. Ihre geschlossenen Tickets, durchgespielt, verglichen mit dem, was Ihr Team tatsächlich geschickt hat, mit einem Bericht, wo er falsch gelegen hätte.
3. Wo werden Berechtigungen durchgesetzt?
Auf API- und Infrastrukturebene, oder in einem System-Prompt. Nur eines davon überlebt einen Prompt-Injection-Versuch.
4. Kann ich ihn nach Ticket-Typ und nach Zielgruppe eingrenzen?
"Rühre niemals Abrechnungsstreitigkeiten an" und "beantworte anonyme Nutzer nur aus öffentlichen Dokumenten" sind beide normale Anforderungen. Viele Plattformen können keine der beiden ausdrücken.
5. Was passiert, wenn er sich nicht sicher ist?
Schweigen und Eskalation schlagen eine selbstbewusste Vermutung. Fragen Sie nach der Schwelle für den Confidence Score und wohin er leitet.
6. Ist Freigabe mehr als genehmigen oder ablehnen?
Genehmigen-mit-Bearbeitung ist die Option, die zählt, denn die meisten Entwürfe sind nah dran statt richtig, und die Bearbeitung ist das Trainingssignal.
7. Zitiert jede Antwort eine Quelle?
Zitate machen aus einer unüberprüfbaren Behauptung eine überprüfbare, und sie machen Lücken in der Wissensdatenbank sichtbar.
8. Was ist der Audit-Trail, und wessen Name steht auf der Aktion?
Sie wollen wissen, was er gelesen hat, was er getan hat, warum, und welcher Mensch es freigegeben hat. Eine Zurechnung, die jede Freigabe auf ein einziges Bot-Konto zusammenfaltet, zerstört Ihren Qualitätssicherungs-Prozess.
9. Was sind die echten Compliance-Grenzen?
Fragen Sie, welche Zertifizierungen gehalten werden und welche in Arbeit sind, auf welchem Plan sie liegen, und ob ein BAA verfügbar ist. Lassen Sie es sich schriftlich geben. Vage Antworten hier kosten aus gutem Grund Abschlüsse.
10. Wer ist für das Einschalten zuständig?
Eine benannte Person und ein Datum. Der häufigste Fehler in dieser Kategorie ist nicht ein schlechter KI-Mitarbeiter, sondern einer, der eingerichtet wurde und nie angefangen hat zu arbeiten.
eesel für die Support-Rolle ausprobieren
Wenn die Rolle, für die Sie einstellen, Support ist, ist das die, die ich baue. eesel setzt einen Helpdesk-KI-Agenten in den Zendesk- oder Freshdesk-Helpdesk, den Sie schon betreiben, trainiert auf Ihren gelösten Tickets statt nur auf Ihrem Hilfecenter, und startet im Entwurfsmodus, sodass nichts einen Kunden erreicht, bis Sie es sagen.
Wenn Sie sehen wollen, wie diese Einstellung nach ein paar Monaten aussieht, sind die veröffentlichten Kundengeschichten die ehrliche Version. Swiftreg, ein britischer Kennzeichenhändler, lässt eesel Zendesk-Tickets aus Live-Bestelldaten bearbeiten, nach Regeln, die das Team geschrieben hat und als nummerierte Releases ausliefert: etwa 1.500 öffentliche Antworten in einem Monat, mit Schritten, die dem Personal gehören, beim Personal gelassen. Question Beauty lässt eesel direkt auf Gorgias antworten, und Rückerstattungen, Beschwerden und alles, was eine Entscheidung braucht, gehen weiterhin an einen Menschen.

Der Teil, den ich tatsächlich zuerst nutzen würde, ist die Simulation: ein paar Hundert Ihrer vergangenen Tickets durchspielen, den Lückenbericht lesen und sehen, wo er falsch gelegen hätte, bevor er es kann. Pricing ist ein fester Monatspreis ab 299 Dollar für 500 Credits (1 Credit pro Ticket oder Chat), ohne Plattformgebühr und ohne Sitzplatzgebühr, und der kostenlose Plan hat 100 Credits, um diesen Testlauf damit zu machen. Probieren Sie eesel aus und finden Sie die Lücken selbst.