
Level AIとは?
Level AIは、顧客との会話をスコアリングし、コーチングし、一部を自動化するコンタクトセンタープラットフォームです。現在のトップページのキャッチコピーは「full stack AI agents for the entire customer experience journey」ですが、製品が実際に何を軸に作られているかを見ると、依然として品質保証、つまりエージェントがスクリプトとポリシーに従い、チームが期待するトーンを保ったかを確認することです。
まず会社の概要を数字で押さえておきましょう。Level AIは、Amazon Alexaチームの元プロダクトリーダーであるAshish Nagarと、CTOのSumeet Khullarによって設立されました。2024年7月にAdams Street Partnersが主導する3,940万ドルのシリーズCを調達し、累計調達額は7,310万ドルになりました。About ページでは、100社以上で年間10億件以上の顧客インタラクションを分析していると主張しています。導入事例にはVistaPrint、Smartsheet、Extra Space Storageが挙がっており、シリーズCの記事ではAffirm、Penske、Cartaも加わっています。
会社と製品の全体像を先に知りたい場合は、私のLevel AIガイドから始めてください。G2では220件のレビューのうち162件がContact Center Quality Assuranceカテゴリにあり、企業規模の内訳もかなりはっきりしています。中堅企業のレビュアーが123件、大企業が72件で、小規模企業は23件です。つまり実際には、QA部門を持つチーム向けのツールであり、2人体制のサポートデスク向けではありません。
Level AIのレビュー方法
私は毎日eeselのサポートキューを担当しているので、QAはサポートの中で私が日常的に向き合っている部分です。会話を読み返し、技術的には正しいのに印象が悪かった回答を見つけ、その改善がコーチングの問題なのかドキュメントの問題なのかを見極めます。役に立つQAフィードバックを書くことは仕事の半分です。このレビューには、おおよそそうした視点を持ち込みました。
Level AIはデモ経由でしか使えず、無料トライアルも公開ヘルプセンターもないため、自分のキューで動かすことはできませんでした。代わりに、すべての製品ページとFAQ、2026年第1・第2四半期のリリースノート、6件の顧客事例、セキュリティページ、そして220件のG2レビューを読みました。価格が隠れていそうなマーケットプレイスもすべて確認しました。Level AI自身のページ同士が矛盾している箇所は、その旨を指摘します。
先に断っておくべきバイアスがもう1つあります。eeselは何年もライブのサポートキューにAIを導入してきており、そこで定着した教訓は、AIのスコアは、その裏にあるテストの質で決まるということです。だからこそ、eeselのすべての導入では、エージェントが誰かに回答する前に過去のチケットでシミュレーションを行います。Level AIの精度に関する主張も、その点を念頭に置いて読みました。
Level AIにできること
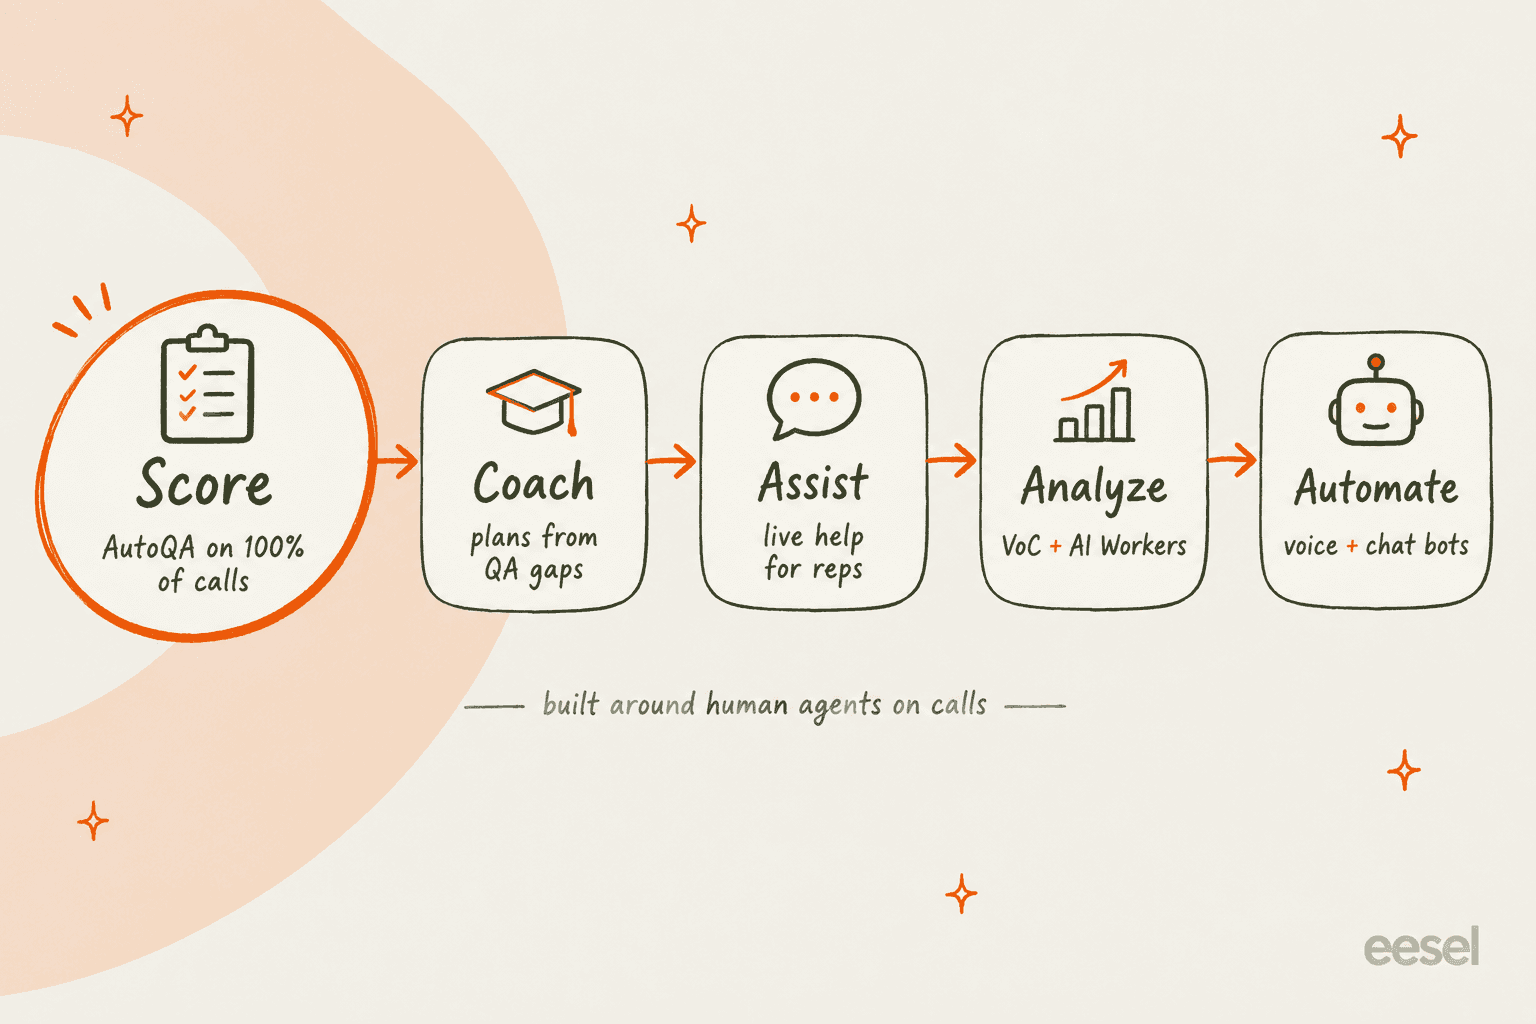
Level AIは、5つの機能を組み合わせた1つのプラットフォームを販売しています。ここではスコアリングが要で、それ以外は、スコアリングに情報を供給するか、その結果に基づいて動くかのどちらかです。
AutoQAとQA-GPT:中核製品
AutoQAは、ほとんどのチームがLevel AIを購入する主な理由です。QA製品ページは、「100 percent of calls, chats, emails, and bot conversations」をスコアリングすると約束しており、Level AIが「often around 1% to 3%」とする手動の基準との対比になっています。このギャップが、基本的にAI支援QAの存在理由のすべてです。
スコアリングエンジンはQA-GPTで、Level AIはこれを、自社のコンタクトセンターデータで学習し「evaluate over 90% of the standards and metrics that scorecards cover」できる独自モデルと説明しています。私が気に入っているのは、スコアカードの仕組みが日常でどれだけ実用的かという点です。
- 自社のスコアカードをそのまま使えます。 既存のルーブリック(外部報告に使っているものも含む)を持ち込むことも、Level AIの学習済み質問ライブラリから始めることもできます。
- ハイブリッド採点。 挨拶や本人確認のような客観的な項目は自動採点されます。共感のような主観的な項目は人に回すことができ、両方が1つのスコアにまとめられます。
- 条件付きN/A。 質問は通話タイプや部署ごとにオフにできるため、請求トラブルの通話が営業トークをしなかったことで減点されることはありません。
- すべての回答に根拠。 自動採点には、その根拠となる文字起こしの引用とタイムスタンプが付きます。
- 学習につながる上書き。 評価者はスコアを覆すことができ、その修正は今後の会話の採点方法にフィードバックされます。
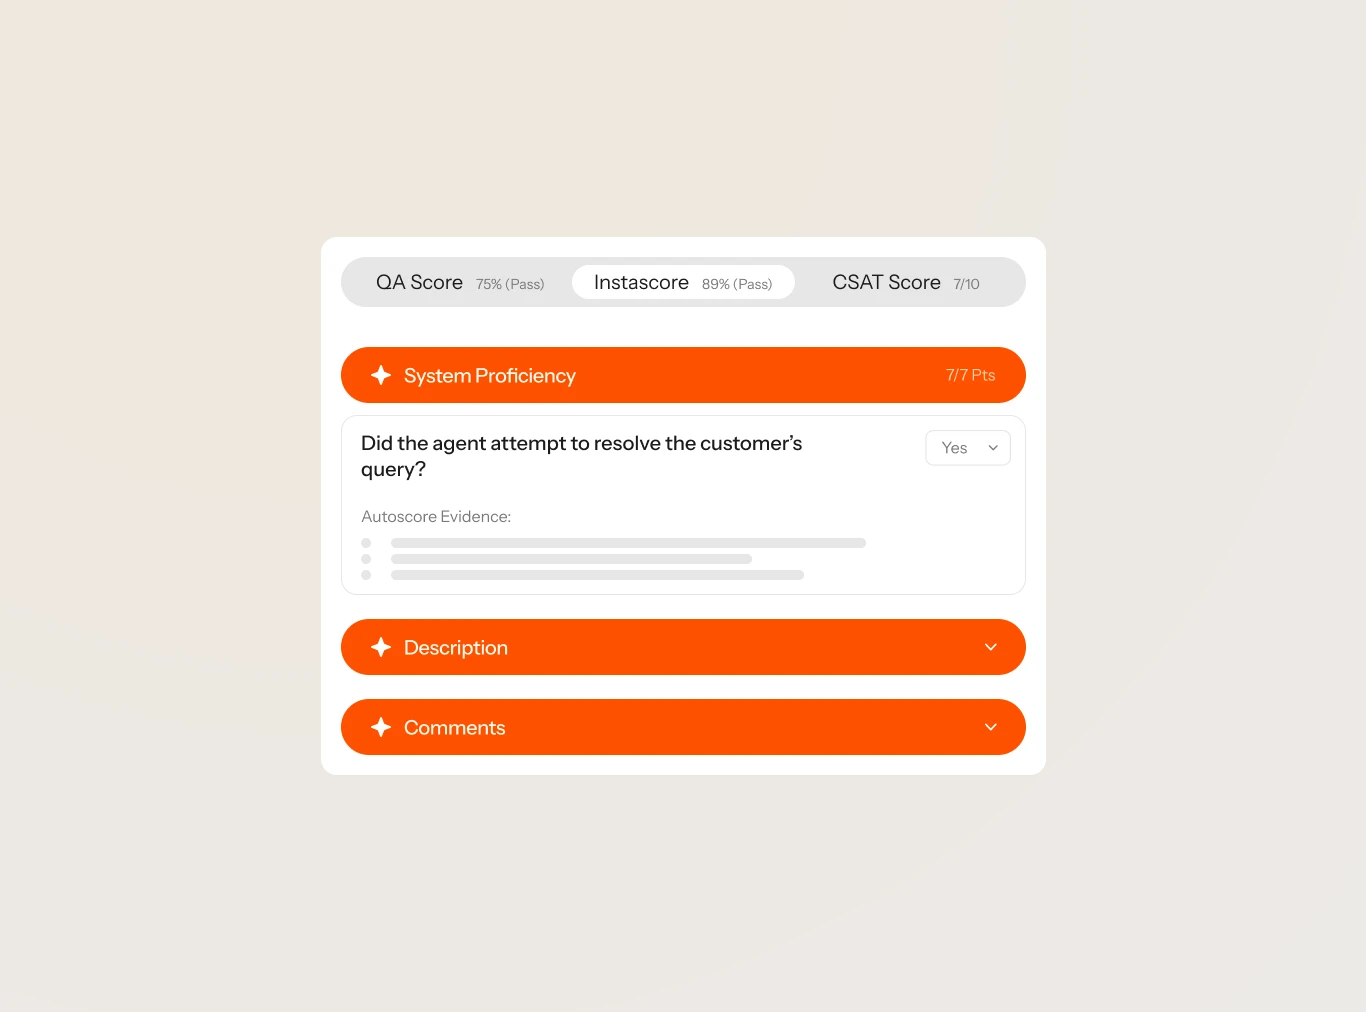
私にとっては、100%という見出しよりも、この根拠の記録のほうが重要です。クリックして確認できるスコアなら、QAリーダーがエージェントの前で説明できるスコアになります。アプローチを比較する際は、説明可能なルーブリックとはどういうものかを扱った私のコールセンターQAガイドが参考になります。
製品ページには互いに食い違う点が2つあり、デモに臨む前に知っておく価値があります。QAページはQA-GPTが採点のために「even monitors agents' screens」と述べていますが、画面録画のFAQでは、画面データからの採点はまだ「product roadmap」にあるとしています。また、QAページはレビューが「10x faster」だとしていますが、Level AIの自動QAのランディングページでは「5x faster」となっています。自社の環境ではどちらが当てはまるのか確認してください。
コーチングと画面録画
コーチングは採点の下流にあります。コーチングモジュールは、会話をQAスコア、感情、トピックで絞り込み、AI Workersがパーソナライズされたコーチングプランを下書きして、マネージャーが編集して送信できます。通話後のツールで、リアルタイムのガイダンスはAgent Assistにあります。
画面録画は製品の控えめな強みで、見落とされがちです。最大4台のモニターを、Level AIが「90%+」とする伏せ字処理の精度で記録します。サイト上の優れた顧客コメントの1つもこの機能に関するもので、VistaのGlobal Director of Qualityは「added 'eyes' to a process where we only had 'ears' before」と述べています。エージェントコーチングが主な目的の場合、あるエンタープライズのG2レビュアーが、自社ではコーチング機能が「has not been used/adopted」と述べていたことに留意してください。
ライブ通話向けのAgent Assist
Agent Assistは、通話やチャット中の人間のオペレーター向けのコパイロットです。リアルタイムで文字起こしを行い、次に取るべき最善の行動と適切なナレッジ記事を提示し、通話サマリーを作成し、会話中にエージェントが質問すると出典付きで答えるナレッジボットのPhiも含まれます。マネージャーは、全通話のステータスと感情を表示するライブボードに加え、オペレーターが必須の開示を飛ばしたときのコンプライアンスフラグも確認できます。
ウィジェットはSalesforce、Zendesk、Five9に埋め込めます。このカテゴリを検討しているなら、私のエージェントアシストツールのまとめで他の選択肢と並べて比較しています。
iCSAT、Voice of the Customer、AI Workers
iCSATは、Level AIの推定満足度スコアです。感情モデル、顧客努力モデル(繰り返し、転送、時間)、そして問題が解決したかどうかを組み合わせ、アンケートなしで会話ごとに1つのスコアにします。アンケートに答えてくれる顧客がごく一部しかいない場合に便利ですが、Level AIは重み付けも検証の数値も公開していません。推定スコアのトレードオフについては、AI CSATの記事で説明しています。
新しいレイヤーが、2026年5月に開始されたAI Workersです。会話データに関する質問、たとえば「What are the top reasons for customers asking for a refund?」に答える役割別のエージェントで、Level AIによれば、開始時点で約100のエンタープライズCXチームが25,000回以上のワーカー実行を行っていました。カスタムワーカーのローンチから、注意すべき制限が1つあります。カスタムワーカーには、まだ自社のポリシーやナレッジの文書をアップロードできません。
音声とチャット向けのバーチャルエージェント
Level AIは、顧客に直接対応するボットも作っています。バーチャルエージェントのページは「humanlike voice and chat agents in 50+ languages」と説明しており、2026年のリリースは音声中心でした。9月のアウトバウンド通話と、4部構成のブリーフィングカードを人間のエージェントに渡すContext Handoff機能で、Level AIによればエスカレーションされた通話1件あたり60〜90秒を短縮します。引き継ぎはほとんどのボットが顧客の信頼を失う場面なので、エスカレーションの品質について読んでおく価値があります。
賢いのは、Level AIが自社のボットをVA Pulseで採点している点です。意思決定に40%、速度と安全性に35%、会話品質に25%の重みを置き、2.5秒より遅い返信は不合格とされます。人間と同じルーブリックで自社のボットを監査するベンダーは多くありませんが、ここはその1つです。
ただし、これはチケットエージェントではありません。メールはバーチャルエージェントの対応チャネルとして挙げられておらず、ページにはヘルプデスクの名前もなく、Zendesk Marketplaceの検索でLevel AIを探してもアプリは0件です。レイテンシの数値もページによって異なり、バーチャルエージェントのページでは「<2 s」、Voice AIのページでは「<500 ms」です。電話ボットに絞って探しているなら、私のAI音声エージェントの一覧と比較してください。
Level AIのAIスコアリングはどのくらい正確か?
これは、Level AIがQAチームの時間を節約するのか、それともAIを確認するという第2の仕事を生むのかを決める問いです。正直な答えは、詳しく見るほど主張は控えめになっていく、ということです。
各情報源の内容を順に見ていきます。
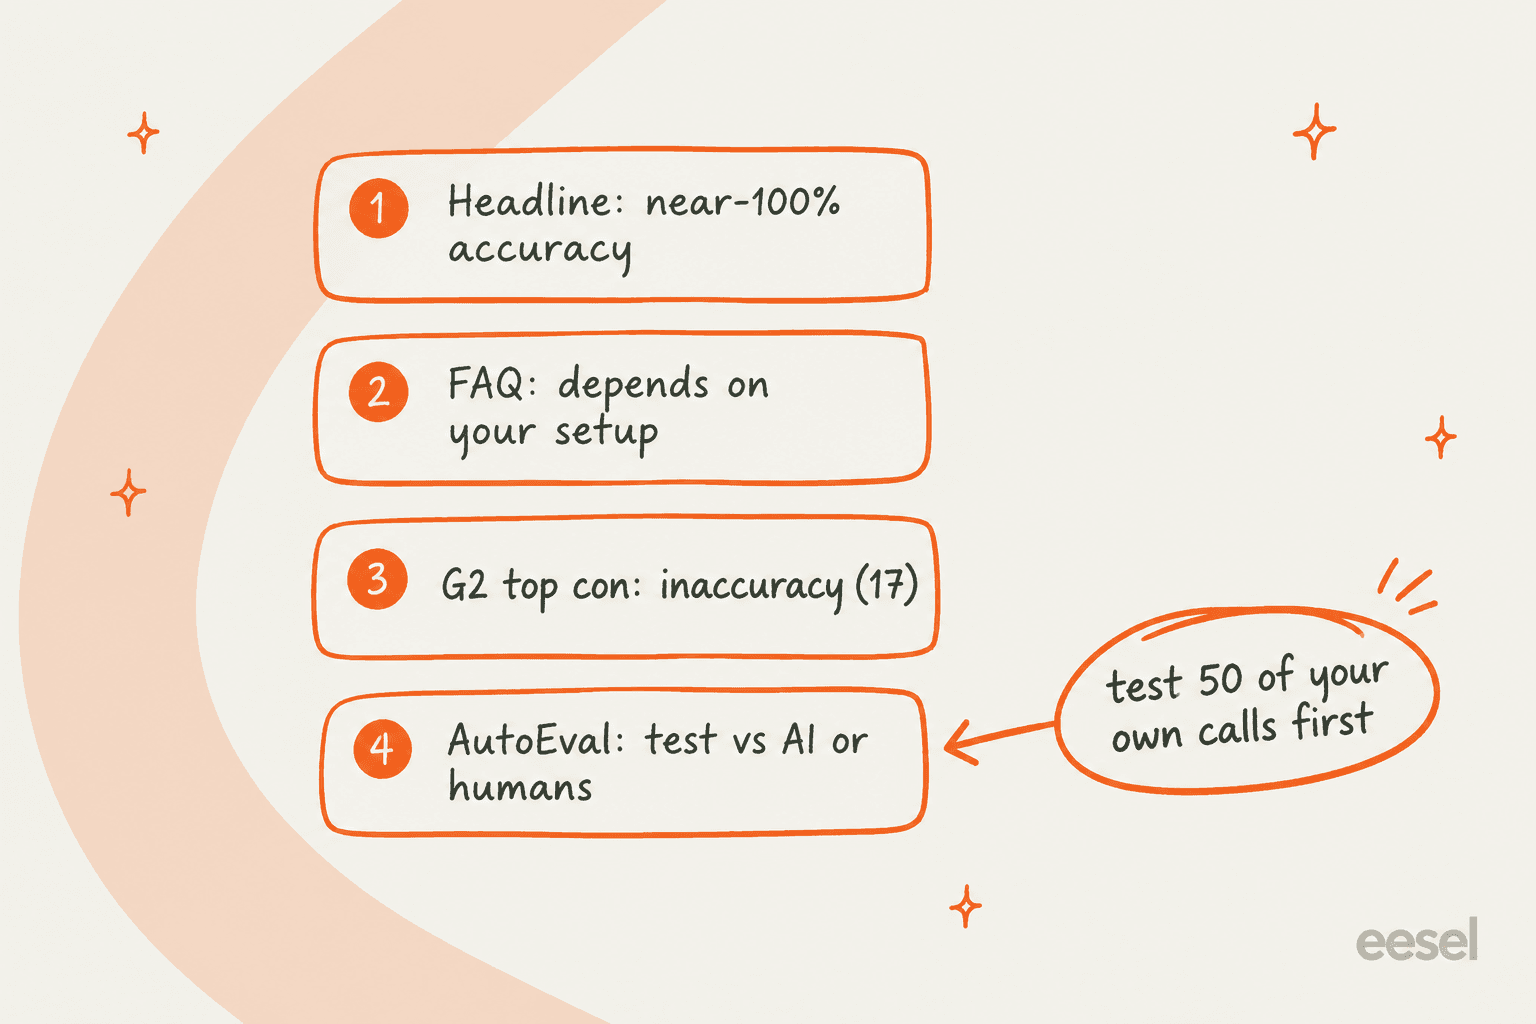
- 見出し。 QAページは、QA-GPTが「the most subjective scorecard questions with near-100% accuracy」をスコアリングすると主張しています。方法もサンプル数も示されていません。
- 同じページのFAQ。 「The accuracy of AI-based QA depends on how well the evaluation criteria and scoring logic are configured.」2つの文のうち、こちらのほうが正直で、計画の拠り所にすべきです。
- 最初のベンチマーク。 2023年のQA-GPTローンチ記事は、「compared to a consensus of human QA managers」で「over 90%」の精度と主張していました。これは実際のテストの一種ですが、ここでもサンプル数は示されていません。
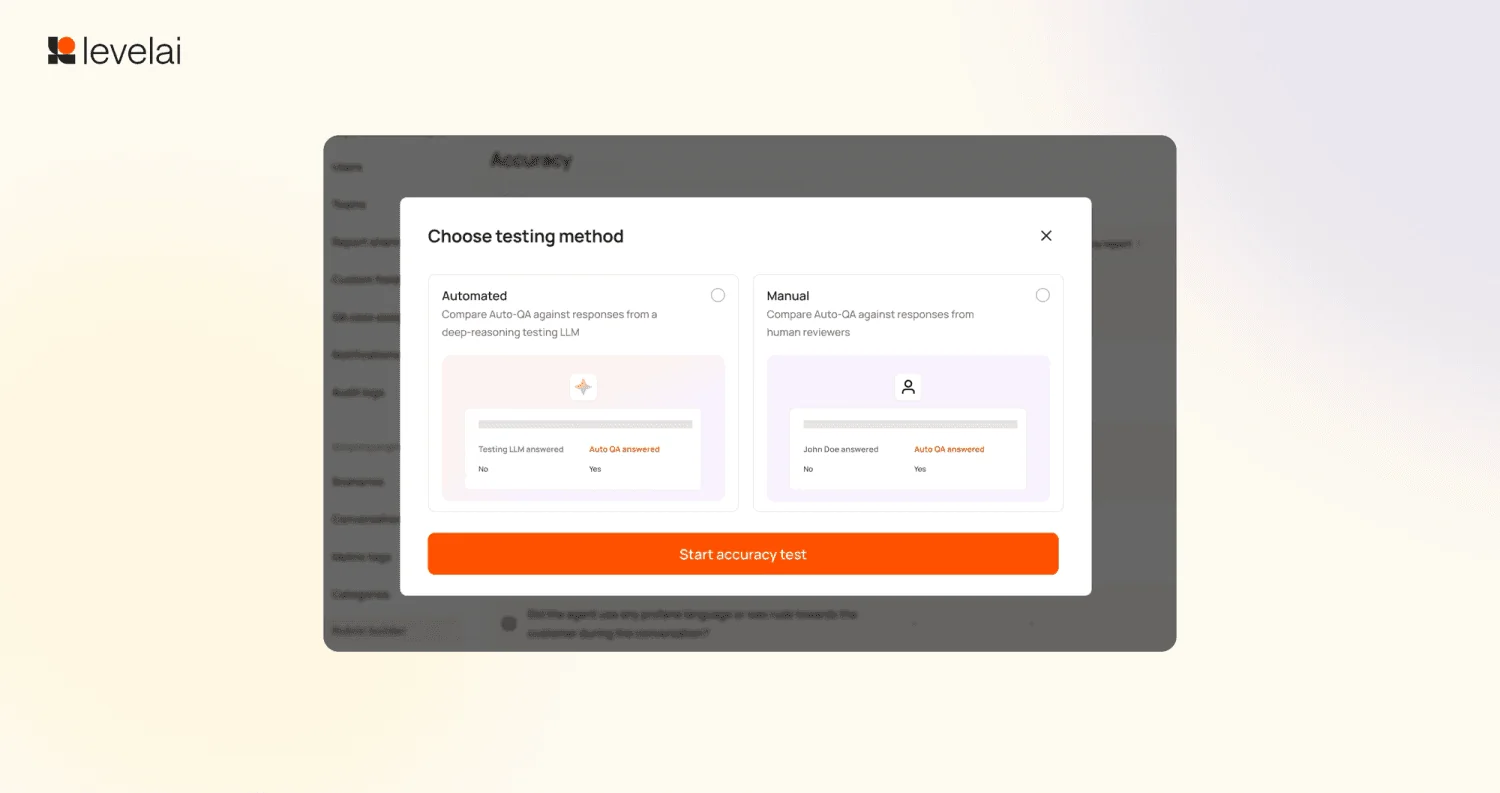
- 2026年のツール。 2026年第1四半期のリリースノートにあるAutoEvalでは、「deep-reasoning LLM」がAutoQAと同じ質問を採点し、両者が食い違う箇所を表示します。テスト画面にはManualモードもあり、AutoQAを自社の人間のレビュアーと比較できます。マニュアルモードを選んでください。2つ目のAIが1つ目に同意しても、最も優秀な監査担当者が同意するほどの証明にはならないからです。
- ユーザー。 G2のメリット・デメリットのまとめでは、Inaccuracyが17件の言及で最大のデメリットで、G2のまとめはこれを「inaccuracy in AI QA scores」と呼んでいます。
これらは、スコアリングが悪いという意味ではありません。精度はG2の27件の言及ではメリットとしても挙がっており、明確な基準でキャリブレーションされたルーブリックはモデルが得意とする領域です。意味するのは、精度はセットアップの中で獲得するものだということです。良いニュースは、Level AIがそのためのツールを提供していることです。新しいAutoQAの質問は、本番に出す前にサンドボックスで50件の会話に対してテストできます。そのサンドボックスは、最もきれいな通話ではなく最も難しい通話で使ってください。そして稼働後も、毎週、人がスコアの一部をサンプリングし続けてください。
これは、eeselの営業の場でよく出る話とも重なります。Gorgiasを使う、月に約7,000件のチケットを扱うDTCサプリメントブランドのCXリーダーは、何が懸かっているかを率直にこう述べました。
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer"
「answer」を「score」に置き換えれば、それがAutoQAの購入判断を一行で表しています。スコアを再確認しないと信頼できないなら、100%のカバレッジは、監査しなければならないデータが100%増えただけです。
G2でのLevel AIのユーザーの声
全体として、G2での評価は良好です。Level AIは220件のレビューで4.6/5、うち78%が星5つです。細かい点ですが、Level AI自身のサイトのバッジは「4.7 (200+ reviews)」となっており、G2のリアルタイムの数字より少し古くなっています。
| G2の指標 | Level AI |
|---|---|
| 総合評価 | 4.6/5(220件のレビュー) |
| Ease of Use | 8.9 |
| Ease of Setup | 8.8 |
| Ease of Admin | 9.0 |
| Quality of Support | 9.0 |
| 導入までの期間 | 3か月(19件の回答) |
| 投資回収 | 4か月(18件の回答) |
| 平均割引 | 8% |
サブスコアはG2のLevel AI vs Observe.AIページから、割引の数字はG2のレビューページからのものです。評価はかなり一貫しており、主にサンプリングからほぼ全件カバーへの移行についてです。
"Our QA has migrated from 2% manual volume to nearly 100% automated volume as a direct result of using Level AI. We also have iCSAT on 100% of contacts rather than traditional CSAT on just a fraction."

"Instead of sampling a handful of calls by hand, we can now review trends across thousands of interactions and immediately pull up the exact examples we need for training or root-cause analysis."
不満は3つの領域に集中しています。1つ目は精度で、上で扱いました。2つ目はダッシュボードと設定です。
"At times, the analytics dashboard can be somewhat ambiguous. It is occasionally unclear how certain metrics are being calculated or visualized, which can make it difficult to fully trust the data without secondary validation."
3つ目は安定性です。Slow Performanceは14件の言及があり、あるエンタープライズのレビュアーは、アップデートを「because of bugs they cause」で頻繁に「発見」すると述べていました。価格は、私が読んだレビューでは意外にもテーマとして上がっていません。
公平のために付け加えると、G2の1ページ目の10件のレビューのうち7件が2026年6月24日付で、レビュー収集キャンペーンのように見えます。これはよくあることでそれだけでは警告サインではありませんが、古いレビューにも重みを置く価値があります。
Level AIの顧客が報告する成果
導入事例は、Level AIが実際の運用上の成果を示す場所です。これらはベンダー自身の数字で、各導入事例から記載どおりに引用しています。
| 顧客 | チーム規模 | 記載された成果 |
|---|---|---|
| VistaPrint | エージェント1,200〜1,700人 | 6か月以内にオーバークレジットが20%から8%に低下 |
| Empyrean | エージェント約400人 | QAが通話の3%から100%に。年間13,000時間以上のエージェント工数を削減 |
| Ollie | エージェント50人 | QAカバレッジが1%未満から約90%に、QA人員は同じ |
| Purple | 記載なし | 2分を超える音声通話でQAカバレッジ100% |
| Smartsheet | 記載なし | 推定CSATが2月から7月にかけて2.95から3.31に上昇 |
| Extra Space Storage | エージェント500人 | コーチングの準備時間が約2時間から30分に |
ここで最も説得力があるのはVistaPrintのオーバークレジットの減少です。お金に関する指標であり、QAが実際に捉えられる行動に結びついているからです。また、2つのページには内部の食い違いがあり、注目に値します。Extra Spaceは見出しに「120 Min saved」とありながら本文では90分と説明しており、Ollieは見出しでQAスコアの30%がAuto QA由来としながら、本文では「half」としています。
Smartsheetの数字も再検討に値します。iCSATは顧客アンケートではなくLevel AI自身の推定スコアだからです。モデルが読み取る感情が動いたことの証拠であり、それは有用ですが、顧客が満足度が上がったと伝えてくれることと同じではありません。すでに信頼しているサポート指標と組み合わせてください。
連携とセキュリティ
Level AIの連携ページには51のタイルが表示され、電話システムに大きく偏っています。ページ自体がこのリストを「non-exhaustive」としており、各連携が実際に何をするのかは説明していません。
| カテゴリ | 連携ページの例 |
|---|---|
| 電話・コンタクトセンター(14) | Five9, Genesys, Amazon Connect, Nice, Talkdesk, Twilio, Dialpad |
| ヘルプデスク | Zendesk, Freshworks, Kustomer, Gladly, Gorgias, Front |
| CRM | Salesforce |
| ワークフォースマネジメント | Calabrio, Assembled |
Five9とGenesysとの連携には専用のパートナーシップページがあり、Salesforce AppExchangeにも掲載があります。こちらはService Cloudが必要で、対応言語は英語と記載されています。ワークフォース計画がスタックの一部なら、2026年2月のAssembledとのパートナーシップでは、連携機能は「will roll out over the coming months」と述べられています。
セキュリティは、規制の厳しい業界の購入者にとって本物の強みです。セキュリティページには、SOC 2 Type II、ISO 27001、BAA付きのHIPAA、PCI DSS、HITRUST CSF、GDPRが挙げられ、氏名、カード番号、SSNはAI処理の前に伏せ字処理されるとあります。インフラはGoogle Cloud上で稼働し、顧客データは共有モデルの学習には使われません。EUの購入者にとっての唯一の欠点は、ホスティングリージョンやデータレジデンシーのオプションがどこにも記載されていないことです。
Level AIの料金
Level AIは料金を公開していません。/pricingページは404を返し、私が確認したどの経路も「talk to sales」に行き着きます。
| 確認した場所 | 表示内容 |
|---|---|
| Level AIのウェブサイト | 料金ページなし。「Schedule a demo」のみ |
| Capterraの掲載 | 「Contact vendor」「Free trial not available」 |
| G2の料金ページ | ベンダーは未掲載。平均割引8% |
| Salesforce AppExchange、Five9 Marketplace | 掲載はあるが価格は非表示 |
| AWS、Zendesk、Google Cloudのマーケットプレイス | Level AIの掲載なし |
| ROI計算ツール | 月間インタラクション数、エージェント数、チャネル構成を入力 |
課金単位も公開されていません。ROI計算ツールはインタラクション量とエージェント数を尋ねるので、営業が契約をどの基準で見積もるかはわかりますが、実際にどう請求されるかはわかりません。何かに署名する前に、単位を書面で確認してください。エージェント単位か、インタラクション単位か、プラットフォーム料金か、そして量が急増したときに何が起きるかです。聞くべき質問は、私のAIカスタマーサービスのコストの解説にまとめています。
総コストについては、ライセンスだけでなく時間も予算に入れてください。導入に3か月かかるということは、QAチームが丸1四半期、旧プロセスと新プロセスを並行して回すことを意味します。
Level AIのメリットとデメリット
| メリット | デメリット |
|---|---|
| 通話、チャット、メール、ボットの会話の100%をスコアリング | 精度の主張が根拠を上回る。不正確さがG2で最大のデメリット |
| すべてのAIスコアに根拠とタイムスタンプ | 料金は見積もりのみ、トライアルなし、公開ヘルプセンターなし |
| ハイブリッドのスコアカードと条件付きN/Aロジック | 導入に約3か月 |
| 人間のエージェントとボットで同じQAルーブリック(VA Pulse) | ダッシュボードとラベルの設定に試行錯誤が必要 |
| 電話システムとの深い連携(Five9、Genesys、Nice) | バーチャルエージェントはヘルプデスクのチケットを扱えない |
| HITRUSTとPCI DSSを含む強力なセキュリティ認証 | 一部の製品ページが重要な主張で矛盾している |
Level AIはどんな人に向いているか?
適合性の問題は、実のところ2つに尽きます。エージェントが何人いるか、そして仕事が通話として来るか、チケットとして来るかです。
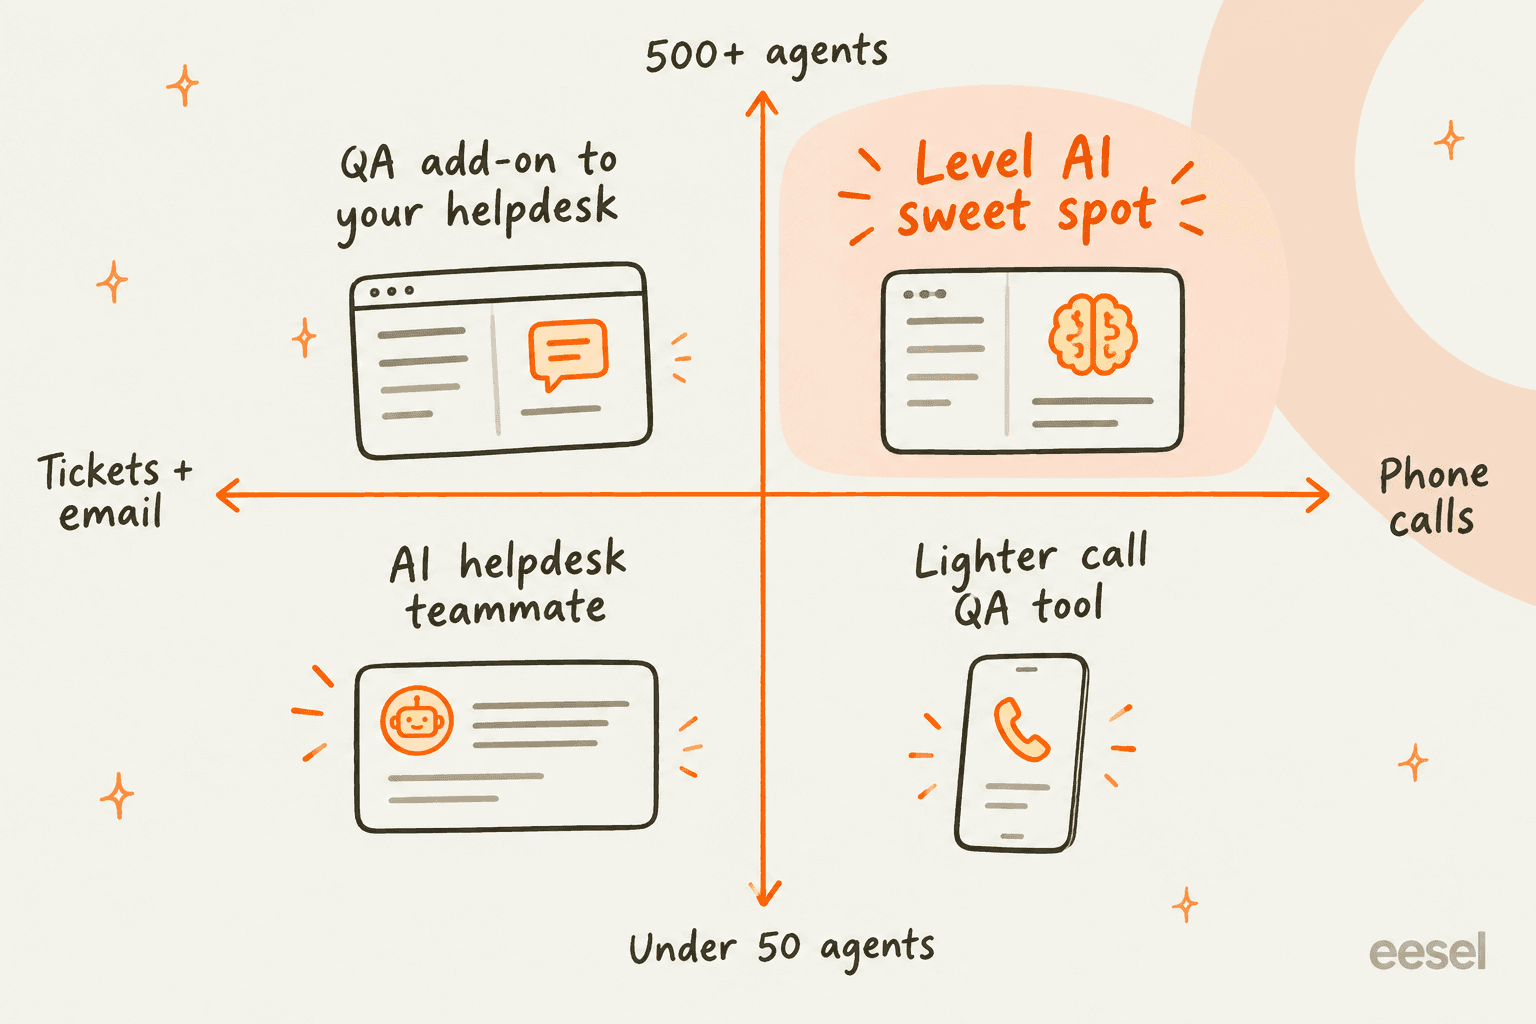
Level AIが向いているのは、数百人のエージェントと本格的なQA部門、そして多くの電話ボリュームを抱えるコンタクトセンターです。Five9、Genesys、Niceを使っていて、HIPAAやPCIの統制が必要で、QAチームが手動の通話サンプリングに追われているなら、真剣に検討できる選択肢です。導入事例はまさにこのグループに当たります。
Level AIが過剰になるのは、エージェントが約50人未満のチーム、または仕事の大半がメールとヘルプデスクのチケットであるチームです。より軽量なQAツールやZendesk QAでカバーできるキューを採点するためだけに、3か月の導入期間と営業主導の契約が必要なエンタープライズQAプラットフォームを買うことになります。最も近い同種の比較がほしければ、私のCrestaレビューをご覧ください。Crestaは同じ大規模コンタクトセンター領域で競合しています。
課題が「十分な数の会話を採点できない」ではなく、むしろ「十分な数のチケットに回答できない」なら、必要なのは仕事を採点するものではなく、仕事をこなすものです。
チケットキューを扱うチーム向けのeesel
eeselはAIチームメイトのプラットフォームで、ここで重要なチームメイトはAIヘルプデスクチームメイトです。Level AIが人間のエージェントを通話で採点するのに対し、eeselは新しいエージェントとしてヘルプデスクに加わります。ヘルプセンター、マクロ、過去のチケットを読み、Zendesk、Freshdesk、Gorgias、Frontなどのヘルプデスク内で、返信の下書きや送信、タグ付け、ルーティングを行います。これは、稼働前に自分自身をテストするAIヘルプデスクツールです。
QAの視点は最初から組み込まれています。eeselがお客様に回答する前に、シミュレーションスキルが過去の数百件のチケットを再生し、チームが実際に送った内容と照らして各回答を採点し、足りなかった部分については指示の変更を提案します。これは、Level AIがAutoQAのユーザーに求める「信頼する前にテストする」という規律と同じものを、エージェント自身に適用したものです。下書きモードで始めて、人がすべての返信を承認し、その後アクションを1つずつ自動に切り替えることができます。

料金は公開されています。無料プランではカード不要で100クレジットが使え、Teammateプランは500クレジットで月額299ドルからです。チケットまたはチャットは、返信が何回になっても1クレジットで、エージェントとシートは無制限です。正直な制限を1つ挙げると、eeselには電話チャネルがないため、ボリュームが通話なら、Level AIか音声エージェントが適切なツールです。チケットなら、自社のキューでeeselを試し、お客様に触れる前にシミュレーションを確認してください。
よくある質問
Level AIは導入する価値がありますか?
数百人規模のエージェントを抱え、通話の1%〜3%しかサンプリングできていないQAチームがいる、音声中心のコンタクトセンターなら、はい。Level AIのAutoQAはすべての通話、チャット、メールをスコアリングし、G2の評価は220件のレビューで4.6/5です。チケットやメールを扱う小規模チームには、より軽量なサポートQAツールやAIヘルプデスクエージェントのほうが適しています。
Level AIの料金はいくらですか?
Level AIは料金を公開していません。/pricingページは404を返し、Capterraでは価格が「Contact vendor」と表示され、無料トライアルもありません。見積もりはデモの後に提示されます。比較として、Crestaの料金とZendesk AIの料金の仕組みもご覧ください。
Level AIのAutoQAはどのくらい正確ですか?
Level AIはほぼ100%の精度を謳っていますが、自社のFAQでも、精度はスコアリングロジックの設定の良し悪しに左右されると述べています。不正確さはG2で最もタグ付けされたデメリットです(17件)。スコアを信頼する前に、内蔵のサンドボックスで新しいルーブリックの質問を自社の会話50件でテストしてください。これは優れたAIサポートQAの背後にある規律と同じです。
G2のLevel AIレビューには何と書かれていますか?
レビュアーは使いやすさ(60件の言及)と、手動サンプリングからほぼ全件のQAカバレッジへの移行を評価しています。最も多い不満は、AIスコアリングと文字起こしの精度、大量処理時の動作の遅さ、設定しにくいダッシュボードです。Ease of Useは8.9、Quality of Supportは9.0です。
Level AIはZendeskと連携できますか?
部分的に可能です。ZendeskはLevel AIの連携リストに含まれ、Agent AssistウィジェットもZendesk内に埋め込めますが、Zendesk MarketplaceにLevel AIのアプリはなく、バーチャルエージェントは音声・チャットのボットでチケットエージェントではありません。Zendeskのチケットに回答するAIが必要なら、ヘルプデスクネイティブの選択肢を検討してください。
Level AIの最適な代替製品は何ですか?
コールセンターQAとリアルタイムコーチングなら、Crestaが最も近い選択肢です。ヘルプデスク内でのQAなら、すでにZendeskを使っているチームにはZendesk QAが合います。AIに回答させ、自分で採点もさせたいチケットキューには、eeselのAIヘルプデスクチームメイトがその仕事のために作られています。
Level AIの導入にはどのくらい時間がかかりますか?
G2のレビュアーは、導入までに平均3か月、投資回収の確認までに4か月かかると報告しています。Level AIには公開ヘルプセンターがないため、セットアップは同社チームを通して進みます。自動スコアに頼る前に、スコアカード基準のキャリブレーション期間を見込んでください。

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.