

重大インシデントのコミュニケーションにAIが効果を発揮するのは、検証済みのインシデント記録を一つだけ持ち、すべてのチャネルがそこから回答する場合です。対象は、ステータスページ、チケットへの返信、エージェントのマクロ、大口顧客へのメール、社内チャネルです。AIが各更新を下書きし、指名された担当者(インシデント責任者または広報担当)が公開するものをすべて承認し、重大インシデントでは30分ごとに更新を出します。これはincident.ioが目標としている間隔です。
チケットに自動で返信するAIは、宣言済みのインシデントに紐づくチケットだけを扱い、最後に承認された更新の文言だけを使うべきです。でっち上げの復旧見込み、根本原因の推測、「データは安全です」はいずれも禁止です。そのうえで、解決後に来る第二波にも備えましょう。「本当に直りましたか?」という返信、レポートの依頼、SLAクレジットの請求です。
私はeeselのヘルプデスク連携を開発していて、担当しているAIヘルプデスクのチームメイトは、Zendesk、Freshdesk、Gorgias上でこれを行います。障害チケットにタグを付け、承認済みの更新から返信を下書きし、障害やデータ損失はそのまま人に引き継ぎます。QontroがFreshdeskで運用しているのと同じやり方です。プランは500クレジットで月299ドルからです。
なぜ障害中に顧客ごとに違う説明を聞くことになるのですか?
人はそれぞれ、その時点で知っていることをもとに答えますが、知っていることが全員違うからです。チケット#4012の担当者は10分前にステータスページを読みました。アカウントマネージャーはSlackのスレッドで何かを耳にしました。エンジニアは大口顧客に「1時間で直るはずです」と伝えました。ステータスページ自体は最初の投稿から動いていません。誰も嘘をついていません。違う時点のスナップショットから答えているだけです。
Freshdeskのヘルプセンターはこれをうまく説明しています。リンクされたチケットのガイドには、ダウンタイム中は顧客ごとに更新を受け取る間隔が異なり、それは"based on the persistence of the customer and the workload of the agent."だと書かれています。4回メールした顧客は4回の更新を受け取り、1回しかメールしなかった顧客は何も受け取りません。
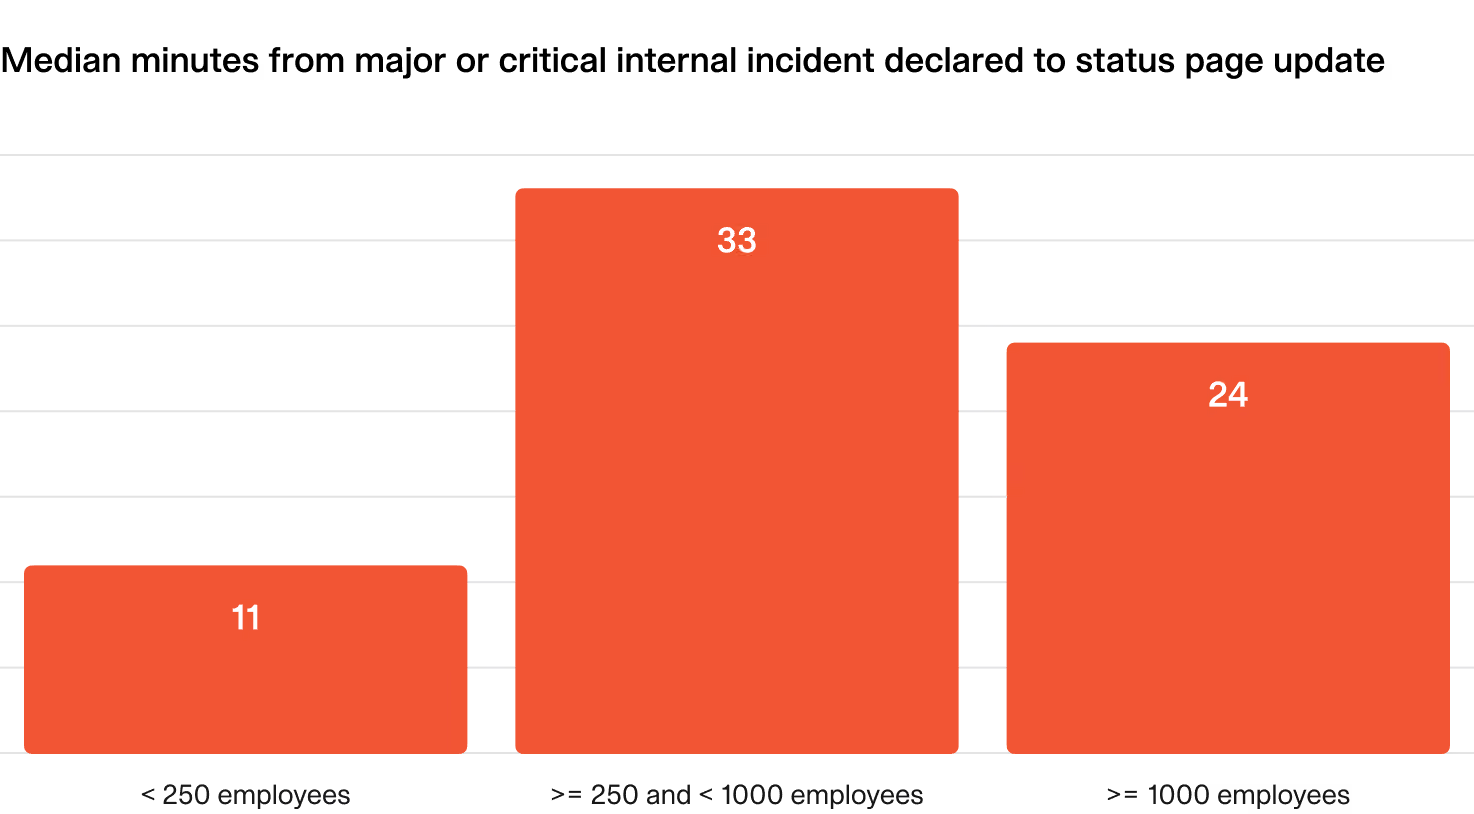
最初の更新が遅いと、さらに悪化します。incident.ioのgood incident management reportによると、従業員250〜1,000人の企業では、重大インシデントを宣言してから最初のステータスページ投稿までの中央値が33分で、それより小さい企業や大きい企業よりも遅い結果でした。この30分の間にチケットが積み上がり、説明がばらばらになっていきます。
インシデントを回している人たちも、内側からそれを実感しています。あるSREは、まさにこの件でRedditに助けを求めました。
"When stuff is finally resolved, I have to parse through slack to see what happened when, ignore the "what's the status" slacks sent by 15 different random people, build a timeline with my investigation steps, etc."

つまり、解決策は「もっと速く書くこと」ではありません。全員が読む場所を一つにして、読者ごとの書き直しをAIに任せることです。この記事と合わせて、SaaS障害時のAIサポートのガイドもお読みください。あちらはチケットの急増を、ステータスページ更新のためのAIのガイドはステータスページそのものを扱い、この記事ではすべてのチャネルで何を、誰が伝えるかを扱います。
すべてのチャネルは何をもとに回答すべきですか?
一人の担当者が管理・更新する、平易な言葉で書かれた一つのインシデント記録です。エンジニアリングのSlackチャネルでも、ウォールームの通話でも、誰かの記憶でもありません。次の4項目に絞ります。
- 影響範囲: 製品領域、地域、顧客グループを、サービス名(「payments-api-v2」)ではなく、顧客の言葉(「ウェブアプリのチェックアウト」)で書きます。
- 検証済みの事実: エンジニアが確認したことだけです。「一部のカード決済が失敗している」は事実です。「不具合のあるデプロイが原因」は、誰かが確認するまでは推測です。
- 対応内容: 1行で書きます。「14:10のリリースをロールバック中」で十分です。
- 次回更新時刻: 毎回、時計の時刻で書きます。
この記録は、インシデント管理ツール(incident.io、PagerDuty、Jira Service Management)に置いても、ステータスページ自体に置いてもかまいません。どこに置くかよりも、誰宛てのメッセージも必ずこの記録から書き直すというルールのほうが重要で、脇の会話から書いてはいけません。
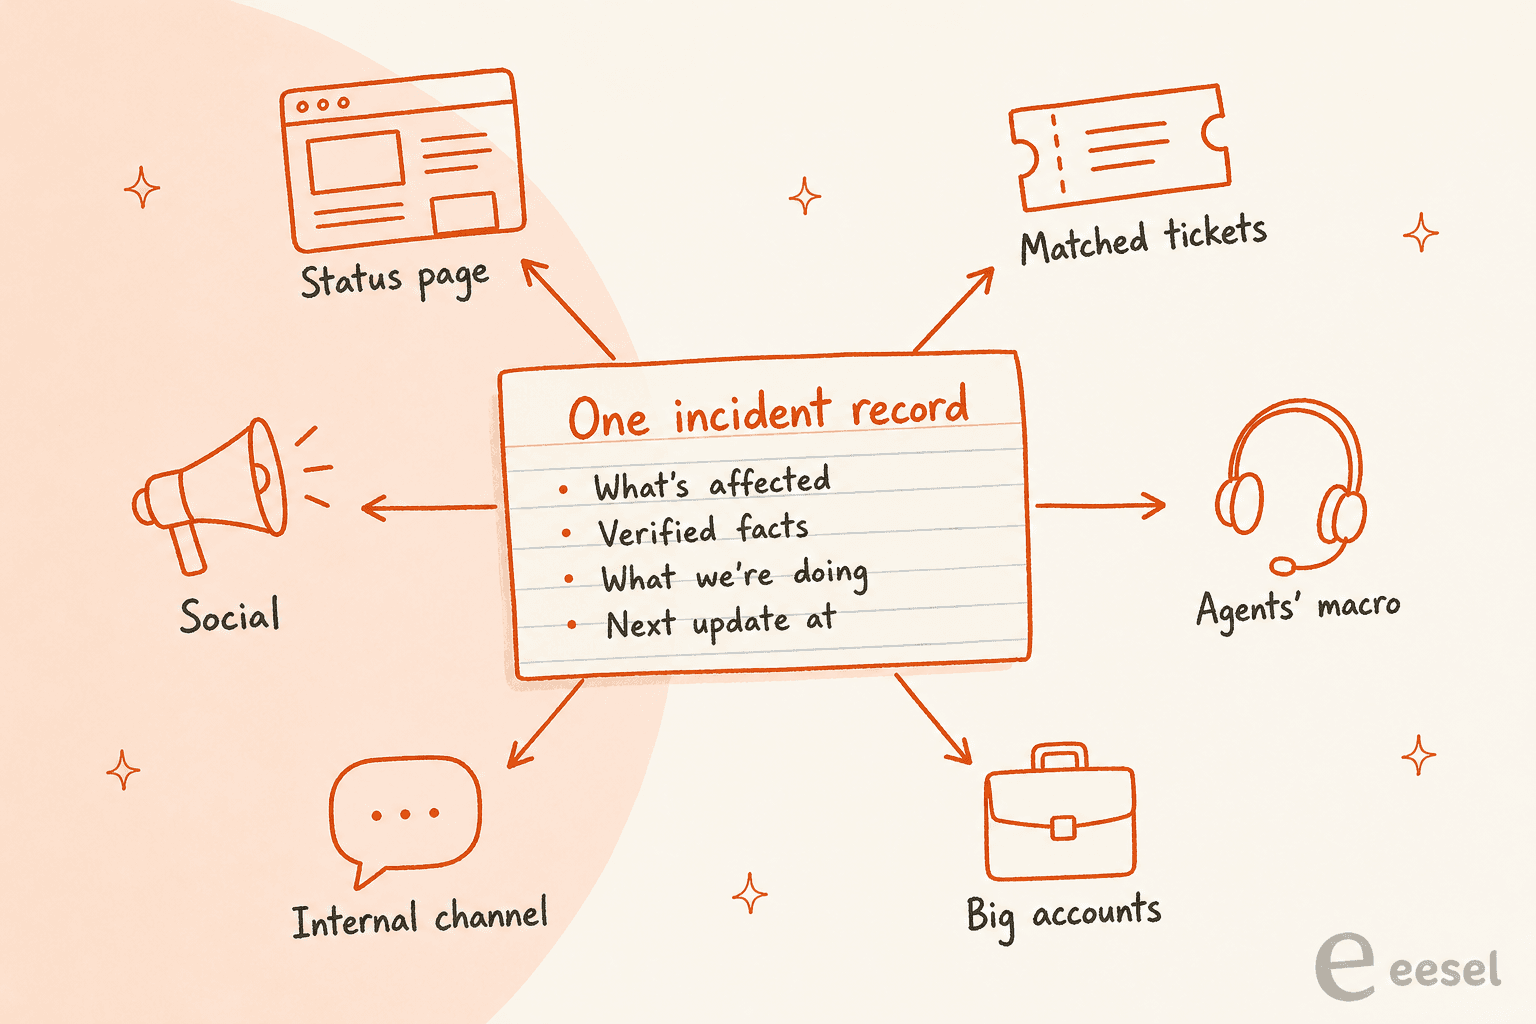
矢印が外向きだけなのは意図的です。チケットの顧客が新しいこと(「モバイルでも壊れています」)を報告したら、それは広報担当に渡り、担当者が確認して記録に追加します。別の顧客への返信に直接飛び火することはありません。このルール一つで、6番目のチャネルが1番目のチャネルからずれていくのを防げます。
インシデント広報は誰が担当し、AIはどこに入るのですか?
問題の修正にあたっていない人です。本番環境をデバッグしているエンジニアが、お詫びの文面を練るべきではありません。運用担当者の対応を調べていると、この点が何度も出てきました。
"Someone not directly working the incident owns comms. gets updates from the team, tracks timelines, and updates the dedicated status page/notification channels."
incident.ioのレポートも、より平易な言葉で同じことを勧めています。"Assign communications roles"として、ステータスページの更新を誰が担当するかを明確にします。AIはその担当者の隣ではなく、その下に位置します。記録を5種類の読者向けの5つのバージョンに変換し、広報担当が読んで承認します。これが最もシンプルな形のヒューマン・イン・ザ・ループであり、incident.io自身のコミュニケーションガイドも同じ線を引いています。AIは下書きを手伝うものであり、人のレビューなしに外部向けメッセージを送るべきではない、という考え方です。
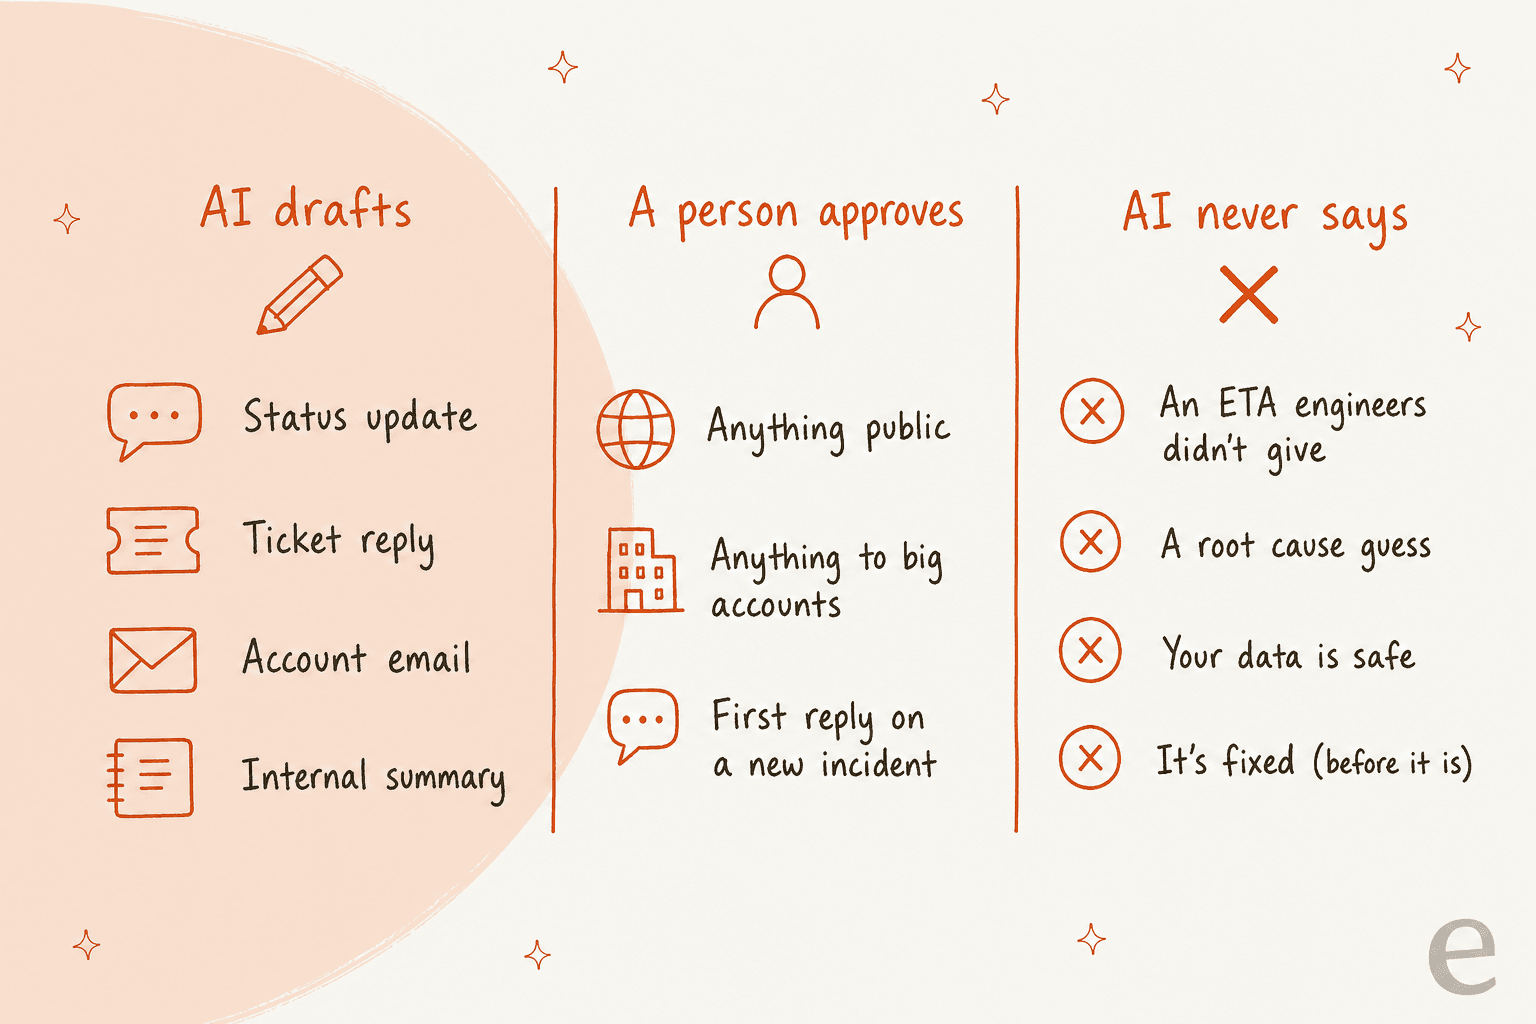
右の列は、印刷しておきたい部分です。この4行はどれも、プロンプトが少し誘導すれば言語モデルが喜んで書いてしまう文です。不安な顧客が聞きたがることそのものだからです。通常のチケットでのAIのハルシネーションなら、影響は顧客1人です。同じ文がインシデントの返信に入れば、数百人に一度に届き、後でスクリーンショットを撮られる一文になります。
インシデントの更新はどのくらいの頻度で送るべきですか?
重大インシデントでは、変化がなくても30分ごとです。これはincident.ioのレポートの目標で、"aim to share status page updates every 30 minutes during major and critical incidents."と述べています。同社のデータでも、ほとんどのチームがこれに近い間隔に収まっています。
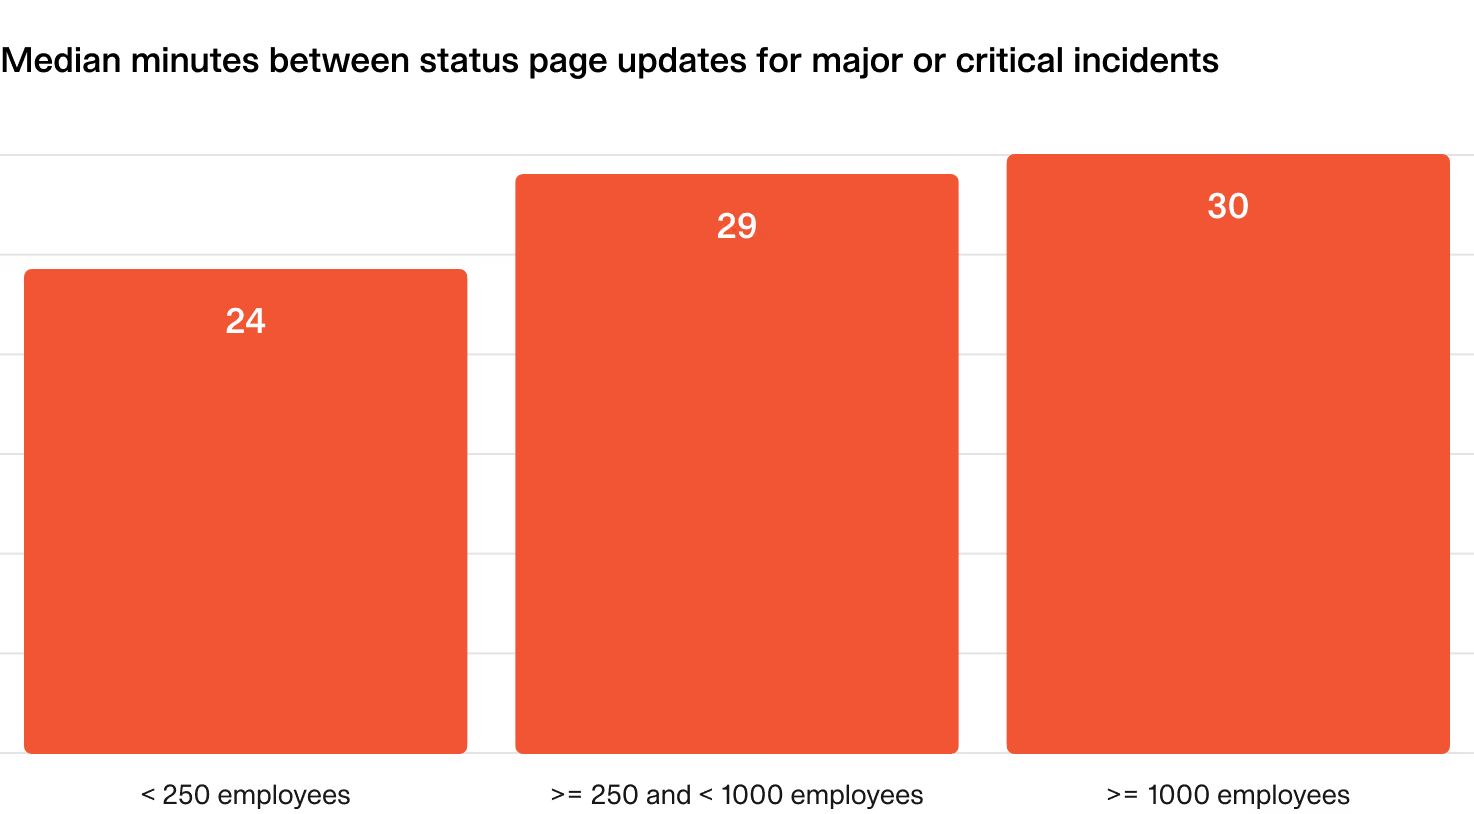
incident.ioのガイドは、中身のない更新を「ハートビート」ルールと呼んでいます。"We're still investigating. No new information. Next update in 30 minutes."何の意味もないように見えますが、実際には大きな働きをします。次の更新が15:30だと知っている顧客は、15:20にチケットを開きません。同社のコミュニケーションガイドは、重大度に応じてリズムを変えることを勧めています。SEV1は20〜30分ごと、SEV2は4時間ごと、SEV3は営業時間内の更新です。
これはAIに任せやすい仕事の筆頭です。ハートビート更新は退屈で、深刻なインシデントの45分目に忘れられがちですが、新しいことを何も言わないのでリスクはほとんどありません。記録からAIに下書きを作らせ、期限が来たら広報担当に知らせてもらいましょう。以下のプランは、重大度ごとに何が必要かを示しています。インシデントの最中ではなく、次のインシデントの前に合意しておけます。
エージェントとAIを同じ台本に乗せるにはどうしますか?
サポートデスクに、ステータスページと同じ言葉を渡し、インシデントに関するすべてのチケットを簡単に見つけられるようにします。後半の仕組みは、大手2つのヘルプデスクにすでにあります。それぞれが何をするのかは詳しく知っておく価値があります。機能の実際の動作よりも多くを期待しているチームを見てきたからです。
Zendeskの問題チケットとインシデントチケット。 Zendeskのドキュメントによると、障害に対して問題チケットを1つ作成し、関連するすべてのチケットのタイプをインシデントに設定して紐づけます。問題チケットを解決すると、紐づいたすべてのインシデントチケットが解決され、問題チケットに書いたコメントが、まだ開いているインシデントチケットに追加されます。同じページには2つの注意点もあります。"Customers are not notified using the messaging channel"と"AI agent tickets can't be linked to problem and incident tickets."です。障害関連の問い合わせの半分がZendesk自身のボット経由で来る場合、一括クローズはそこには届きません。設定方法はインシデントチケットと問題チケットの解説で、取りこぼしは一括ステータス更新で埋められます。
Freshdeskのリンクされたチケット。 Freshdeskは、関連するチケットをトラッカーと呼ばれるマスターチケットに紐づけます。トラッカーへのコメントはブロードキャストとして紐づいたすべてのチケットに届きますが、セットアップガイドには、"internal broadcast message will be visible only to agents of the helpdesk."とあります。顧客には見えません。実際の返信は、引き続き各エージェントが送ります。さらに、トラッカーを解決しても、デフォルトでは紐づいたチケットは解決されません。リンクされたチケットを使うにはProまたはEnterpriseプランが必要です。
そこがAIの得意な隙間です。ヘルプデスクの機能は、障害に関するすべてのチケットの一覧を与えてくれます。AIは、最新の承認済みの更新を、顧客の言語で各チケットへの返信に変換します。300回もコピー&ペーストする人は必要ありません。ここではタグ付けも重要です。r/sreのある運用担当者が基本の動きをこう要約しています。
"support tools like zendesk allow you to add tags to tickets related to the same issue via a "master" ticket"
紐づけたすべてのチケットにincident-2026-10-30-checkoutのようなタグを付けておくと、後でまとめてクローズでき、インシデント後レポートのために数えられ、3回問い合わせてきた顧客も見つけられます。AIによるチケットのタグ付けをまだ設定していないなら、障害の最中にその必要性に気づくのはつらいものです。チケットの重複排除も同じで、障害チケットは同じ人たちから束になって届きます。
人間のエージェントが使うマクロも、ステータスページと同時に更新してください。修正がリリースされて1時間たっても「調査中です」と言い続けるAIマクロは、顧客が同じ午後に2つの異なる回答を受け取る原因になります。
インシデント中、AIが単独で返信してよいのはいつですか?
次の3つがすべて当てはまるときだけです。誰かがインシデントを宣言していて、チケットが明確にそれに該当し、返信が人によってすでに承認された文言を使っていることです。どれか一つでも欠けていれば、AIが下書きして人が送ります。ルールはこれだけで、ほぼすべてのケースをカバーします。
重大インシデント中の受信チケットは、次のように振り分けます。
| チケット | AIがすること | 理由 |
|---|---|---|
| 宣言済みのインシデントに該当する | 最新の承認済みの更新と次回更新時刻で返信し、タグを付け、紐づける | 文言はすでに一度確認されている |
| 障害のようだが、まだ何も宣言されていない | 社内メモを残してオンコールチームに知らせ、何も確認しない | 本物のインシデントの最初の兆候かもしれないし、1人の顧客のWi-Fiかもしれない |
| 大口顧客からのもの、または契約に言及している | 要約を付けてアカウント担当に引き継ぐ | こうした顧客は人の対応とエスカレーションの経路を期待している |
| データ損失、セキュリティ上の懸念、二重請求を報告している | 返信せず、そのまま人へ | ここでの一言の誤りは法的な問題になる |
| 障害とは無関係 | 通常のキュー | インシデントにほかのすべてを飲み込ませない |
このうち2つは、実際の運用から直接来ています。FreshdeskでERPを提供するQontroは、すべての新規チケット(1か月で190件)に返信を下書きしますが、障害、データ損失、請求に関する質問はそのまま人に回し、チケットに自信を持って答えるだけの情報がないときは、推測せずにエージェントがそう伝えます。SE Rankingは、月に4,650件のZendesk会話でeeselを運用し、扱ったすべてのチケットにai_handledタグを付けるので、チームはAIが何をしたかを正確に数えられます。同社の引き継ぎルールも、インシデント当日にうまく合っています。エージェントは顧客に1〜2営業日以内に返信が来ると伝え、今すぐ誰かが加わるとは決して言いません。
この最後の点は、私にとって苦い経験です。Zendeskを使うウェブホスティング会社で、ボットが顧客に「担当者におつなぎします」と伝えたのに、実際には引き継ぎが行われなかったことがありました。障害の最中にこうした空約束をすると、怒りが倍になります。ですから、AIが次のステップについて言うことは、システムが実際に行うことでなければなりません。引き継ぎのベストプラクティスの記事では、必要になる前にそれをテストする方法を解説しており、シミュレーションテストでは、前四半期の障害チケットを新しいルールで先に再現できます。
もう一つの落とし穴があります。AIによるインシデント返信は、人がスレッドを引き継いだ瞬間に止める必要があります。ClutchLoopはGorgias上でエージェントをまさにこのルールで運用しています。チームメンバーがすでにスレッドで返信しているなら、エージェントは手を出しません。アカウントマネージャーがチケットについている大口顧客には、これが望ましい動作です。
インシデントツールとヘルプデスクツールのAIは実際に何をしてくれますか?
インシデントツールのAIの大半はエンジニア向けです。サマリー、タイムライン、ポストモーテムなどです。顧客向けメッセージに関わる機能は少なく、あるものも人がレビューする下書きツールです。各ベンダー自身のページに書かれている内容と価格は次のとおりです。
| ツール | インシデントコミュニケーション向けAI | ステータスページ | 価格(ベンダーのページ) |
|---|---|---|---|
| Atlassian Statuspage | 料金ページには記載なし | あり、主力製品 | Free(購読者100人)、Hobby 29ドル、Startup 99ドル、Business 399ドル、Enterprise 1,499ドル(月額) |
| incident.io | ScribeやSuggestionsなどのAI機能に加え、ProとEnterpriseにAIネイティブのポストモーテムエディタ | Basic、Team、Proで公開ページ1つ、Enterpriseで顧客向けページ | Basicは無料、Teamはユーザーあたり月19ドル、Proは25ドル、オンコールはユーザーあたり10〜20ドル追加 |
| PagerDuty | AI Status Updatesが社内向けと社外向けの更新を下書きし、対応担当者が送信前に確認 | Professional(購読者250人)以上で外部ページ | Professionalは年払いでユーザーあたり月21ドル、AIはアドオン。Starterは年2,800ドルでAIアクション1,000回 |
| Jira Service Management | StandardからRovoエージェント。PremiumでAIによるインシデント作成とインシデント後レビューの下書き | Enterpriseプランのみ | Standard 21.50ドル、Premium 55.28ドル(エージェントあたり月額) |
| Zendesk | Copilot(サマリー、統合の提案、類似チケット)、AIエージェントは自動解決ごとの課金 | なし | Suite Team 55ドル、Professional 115ドル(エージェントあたり月額・年払い)、Copilotはエージェントあたり月50ドル |
| Freshdesk | Freddy AI Agent(500セッション込み、以降100セッションごとに49ドル)、Copilotはエージェントあたり月29ドル | なし | Growth 19ドル、Pro 55ドル、Enterprise 89ドル(エージェントあたり月額・年払い) |
| eesel | ヘルプデスク内で返信を下書きまたは送信し、チケットにタグを付けて紐づけ、操作ごとに承認 | なし、お使いのものを読み取る | 月299ドルで500クレジット、チケット1件が1クレジット |
価格欄よりも重要な細かい点がいくつかあります。PagerDutyのドキュメントによると、AI Status Updatesが外部向けの更新を下書きできるのはSlackからだけで、Microsoft TeamsとWebアプリでは社内向けの更新のみです。Jira Service Managementでは、「incident stakeholder communication」(社内外の関係者を招待してメールを送る機能)はPremiumの機能で、Standardプランには含まれません。詳しくはJSMの料金の解説と、AIによるインシデント後レビューの記事をご覧ください。
ヘルプデスク側では、Zendesk CopilotもFreddy AIも、誰かが教えない限りインシデントのことを知りません。チケットとヘルプ記事をもとに動き、インシデント記録は別のツールにあるからです。両者をつなぐことが本当の仕事です。
プランの詳細は、Zendeskの料金とFreshdeskの料金のガイドにあります。
インシデント記録をヘルプデスクにつなぐにはどうしますか?
インシデントツールからのすべてのステータス更新を、データとして、チケットに回答するAIに送ります。ここは私が日々取り組んでいる部分なので、仕組みを平易に説明します。
Statuspageは、各インシデント更新をURLに送れます。そのWebhook通知は、インシデントやコンポーネントの更新を載せたHTTP POSTリクエストで、Startupプラン(月99ドル)以上で利用できます。これらのペイロードが運ぶ更新は、次のようなものです。
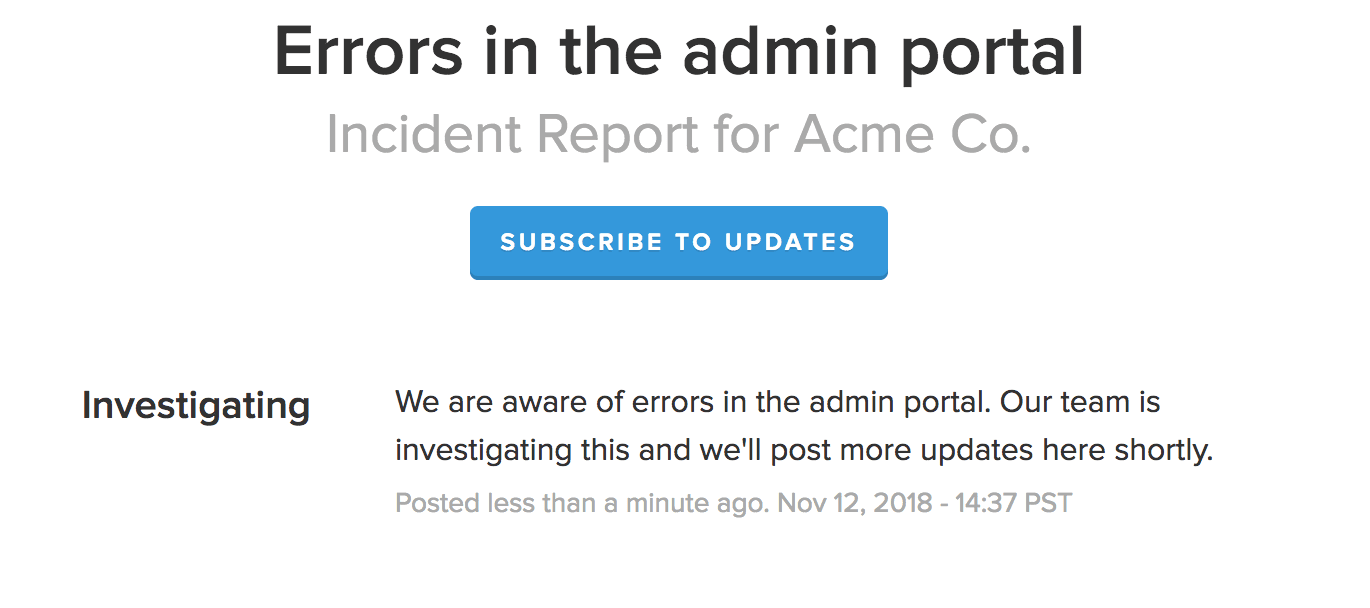
eesel側では、Webhook自動化で、どのサービスからもJSONをPOSTできるプライベートURLが発行され、エージェントはそのデータとともに起動して、あなたが書いた指示に従います。そこでStatuspageのWebhookをそのURLに向け、エージェントにこう伝えます。"When an incident update arrives, save the latest approved text as the current incident status. On new tickets that match it, reply with that text and the next update time, add the incident tag, and leave everything else for a person."incident.ioやPagerDutyからも、それぞれのWebhookやZapier経由で同じことができます。eeselにはStatuspageのネイティブ連携がないため、Webhookが経路になります。
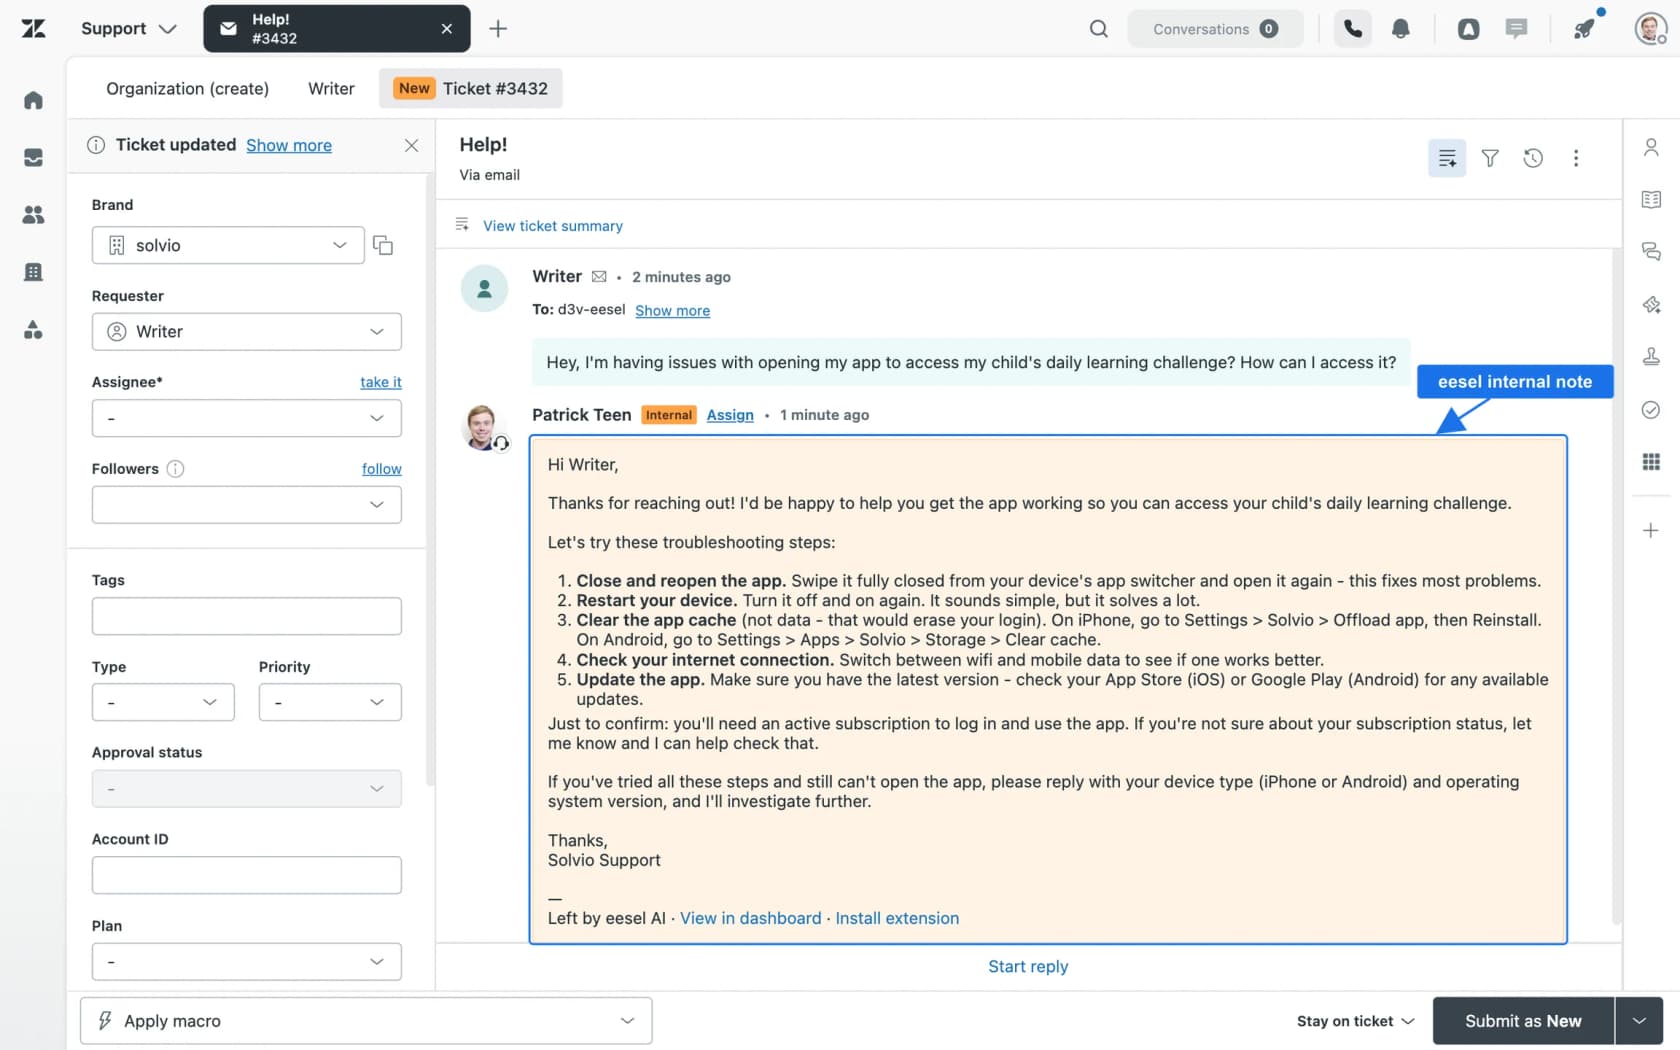
Zendesk内では、インシデント当日に重要なeeselのアクションは、チケット返信の下書き(人が承認するまで保留)、社内メモの追加、タグの追加、チケット検索、ステータスや優先度などのフィールド更新です。各アクションは、自動実行、承認が必要、オフのいずれかに設定できます。初日は、"Send ticket reply"を承認制にし、"Add tags"と"Leave internal note"を自動にするのがよいでしょう。
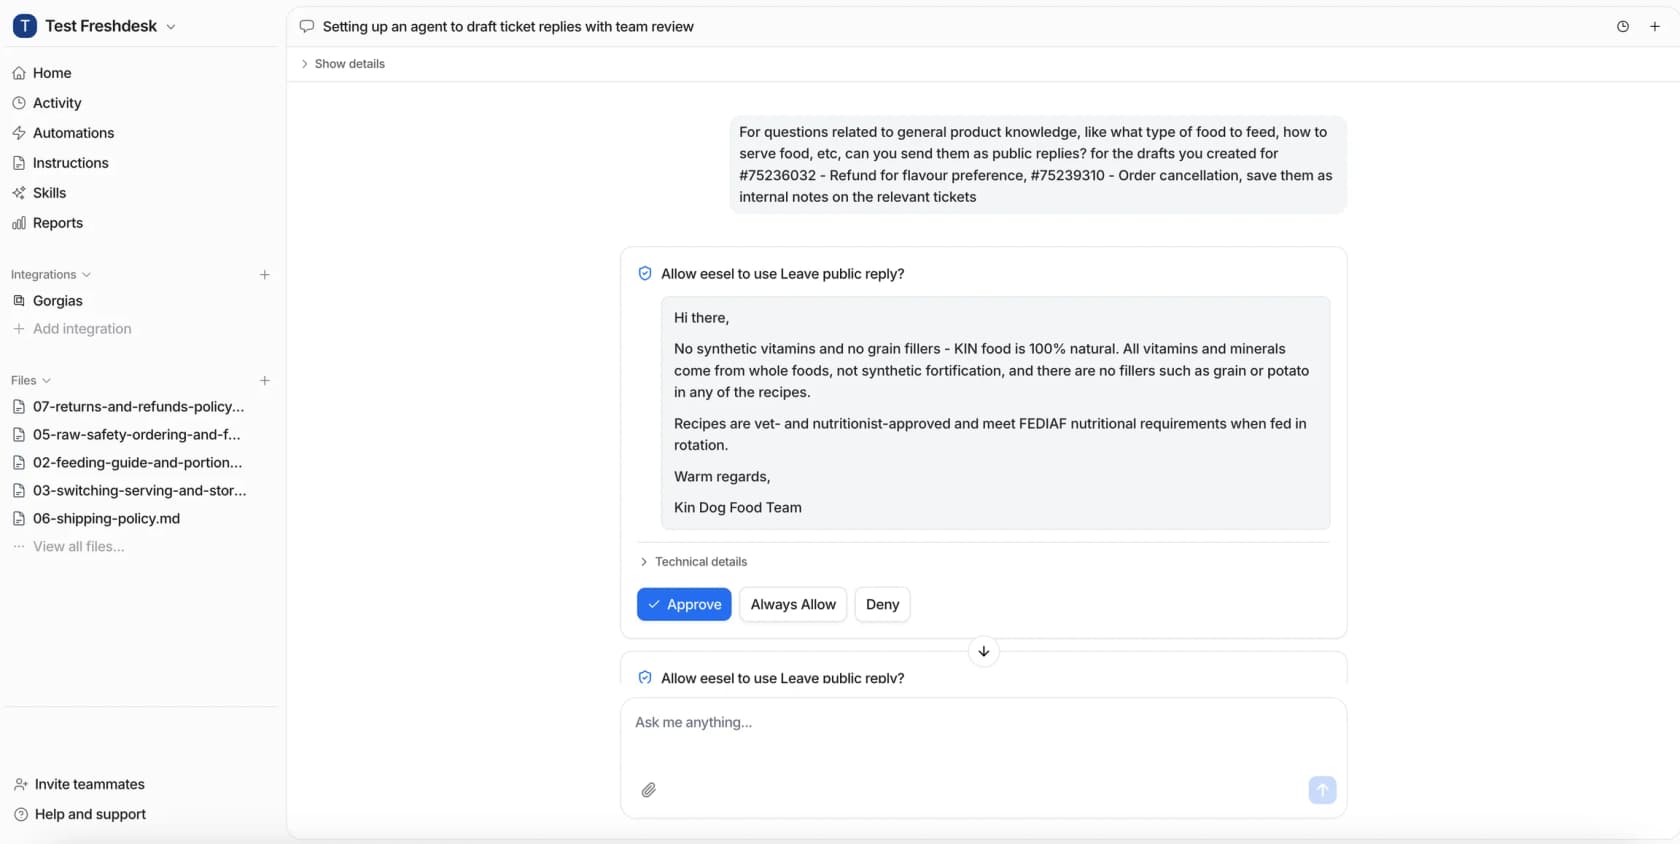
承認はダッシュボードで行う必要はありません。実行がSlackから始まった場合、承認カードはそのスレッドに届くので、広報担当はすでに見ているチャネルから返信を承認できます。インシデント責任者がターミナルを使っているなら、eesel CLIで同じことができます。eesel approvalsで待機中のものを一覧し、eesel approvals approve <id>で送信します。つまり、Claude Codeのようなコーディングエージェントや、インシデントのランブックにあるスクリプトが、代わりにキューを確認することもできます。ダッシュボード、Slack、ターミナルのどれを使ってもエージェントは変わりません。同じ権限を持つ同じチームメイトです。
インシデントが解決した後はどうなりますか?
チケットの第二波が来ますが、ほとんどのチームは計画していません。ステータスページが解決済みに変わり、全員がほっと息をついたところで、受信トレイは別の種類のメッセージで埋まっていきます。
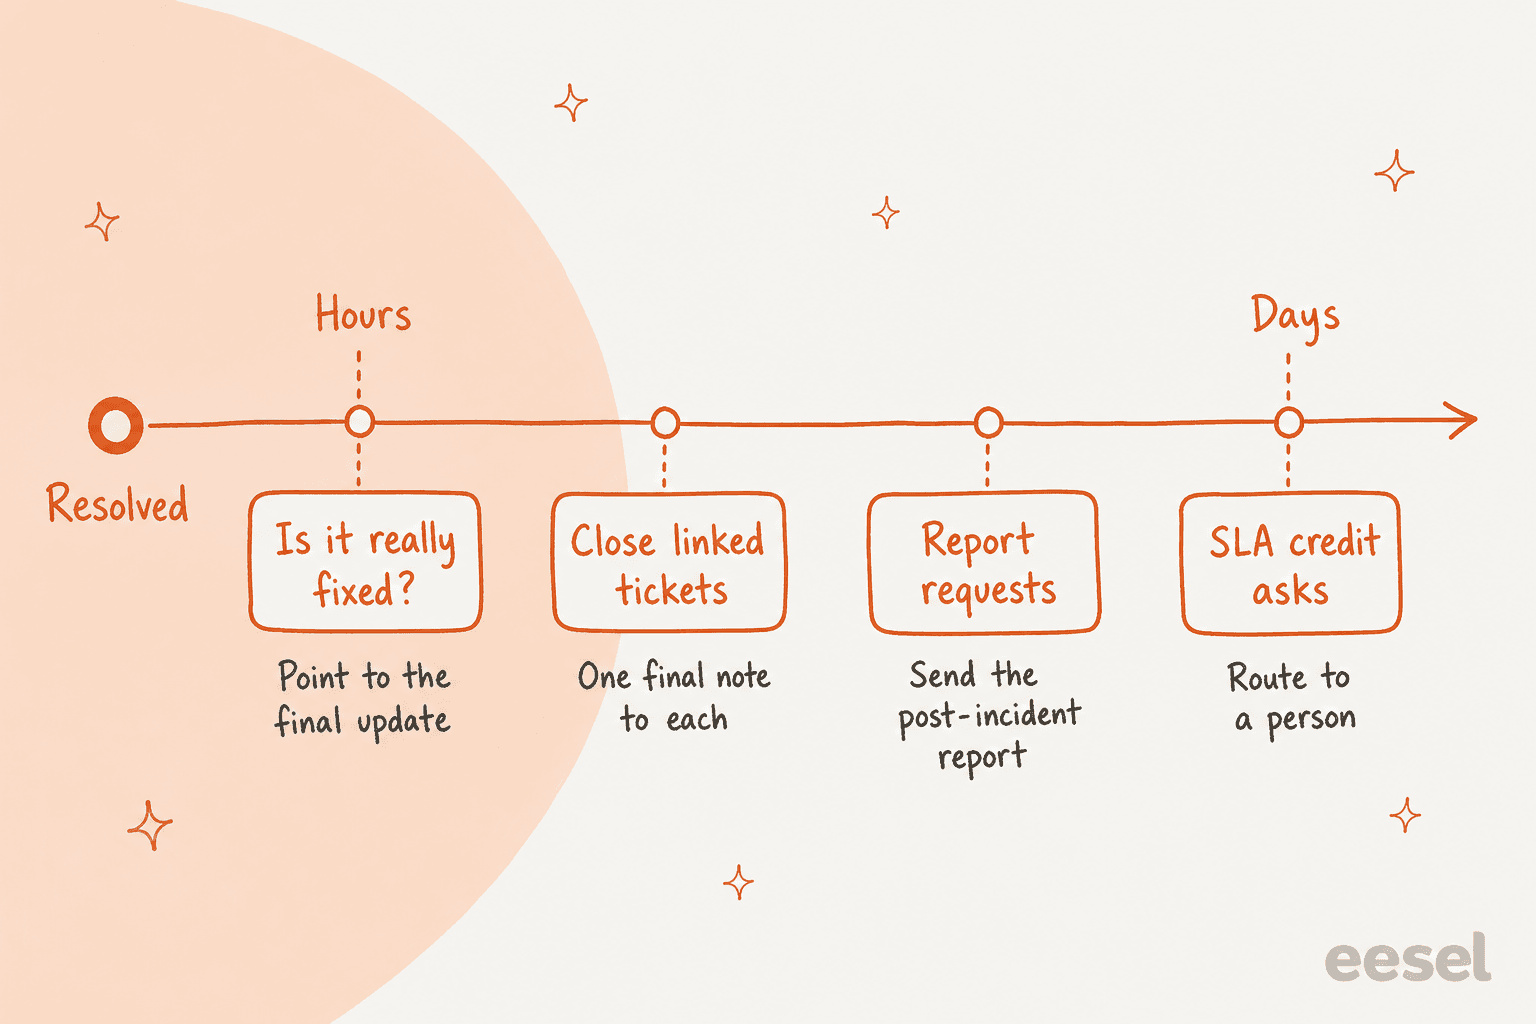
届くものを、おおよその順に挙げます。
- 「本当に直りましたか?」 数時間以内に届き、解決の投稿を見ていない顧客からのことが多いです。AIは最終更新のテキストと、まだ問題がある場合は返信してほしいという一文で答えられます。本当の「私のところではまだ壊れています」は人に回します。修正がすべての人に届いていないことを意味するかもしれないからです。
- 紐づけたチケットのクローズ。 まだ開いているものだけでなく、インシデントのタグが付いたすべてのチケットに最終メモを送ります。Zendeskでは、問題チケットを解決すればほとんど済みます。Freshdeskでは、紐づいたチケットを自分で解決するか、AIに各チケットへ最終メモを投稿させます。「解決済み」のメッセージが届いたかどうかは、今後数日間の再オープン率でわかるので、注意して見ておきましょう。
- インシデント後レポートの依頼。 大きな顧客は、多くの場合自社のコンプライアンスのために、経緯の報告を求めます。インシデント中に誰が依頼したかのリストを作り(タグがあれば簡単です)、公開されたらその全員にレポートを送ります。エンジニアが公開する前に、AIに根本原因を要約させてはいけません。
- SLAクレジットの請求。 お金が絡む契約上の問題です。顧客のプランとインシデントの開始・終了時刻を添えて人に回します。私が請求に関する争いを扱うときと同じやり方です。
この波は、最も多くを学べる場でもあります。タグ付きチケットの数、最初のステータス投稿より前に来た数、「更新はありますか?」と尋ねてきた数を数えてください。この3つの数字から、最初の投稿が遅かったか、更新のリズムが保てたか、次回どこから手を付けるべきかがわかります。AIによるサポートレポートで集計できます。
これを正しく行うことは、その日だけでなく先々まで影響します。r/SaaSのある創業者はこう述べています。
"if you wait until an outage to figure this out it’s already chaos, so even a simple status page plus a prewritten we’re investigating template and one owner for updates goes a long way because trying to debug while replying to tickets in real time is how small issues turn into trust problems fast"
信頼の問題でもあるので、これを解約防止の取り組みともつなげたいところです。障害中に問い合わせてきた顧客は、その後に乗り換えを検討する可能性が最も高く、1週間後にアカウントマネージャーが個別にフォローするコストはごくわずかです。
次の障害の前にどう準備しますか?
午前2時ではなく、静かな火曜日に済ませましょう。私ならこの順番で進めます。
- 広報担当のローテーションを決める。 エンジニアリングの当番ではない人を、シフトごとに1人。オンコールのスケジュールの隣に書いておきます。
- インシデント記録のテンプレートを書く。 4項目:影響範囲、検証済みの事実、対応内容、次回更新時刻。
- 文言を事前に承認しておく。 「調査中」「原因特定」「監視中」「解決済み」の投稿と、それぞれに対応するチケット返信とアカウント向けメール。incident.ioのレポートも、まさにこのために、よくあるインシデント向けの事前承認済みテンプレートを勧めています。
- チケットの紐づけをオンにする。 Zendeskなら問題チケットとインシデントチケット、Freshdeskならリンクされたチケット、それに加えてすべてのインシデントで共通のタグ形式。
- 承認をオンにしてAIをつなぐ。 公開返信は承認制、タグと社内メモは自動にして、ステータスページのWebhookをつなぎます。どの返信も自動に切り替える前に、実際のチケットでの下書きを1週間レビューします。
- 訓練を行う。 テスト用ブランドでSEV2を模擬します。最初の投稿が目標内に出るか、ハートビートが動くか、マクロが更新されるか、タグ付きのすべてのチケットに最終メモが届くかを確認します。
チームがシフト交代をまたいで働いていたり、週末の体制が手薄だったりするなら、ステップ1が最も重要です。午前3時の障害で広報ローテーションに誰もいないと、ステータスページが4時間も「調査中」のまま放置されることになります。
インシデント当日にeeselを試す
サポートキューがZendesk、Freshdesk、Gorgiasで動いているなら、eeselのAIヘルプデスクのチームメイトは、ヘルプセンターと過去のチケットをすでに読み込んだ新人エージェントのように加わります。インシデント当日は、すべての障害チケットにタグを付け、広報担当が承認した更新で紐づけたチケットに返信し、大口顧客、データ損失、請求はそのまま人に引き継ぎます。これはQontroがFreshdeskで運用している構成です。ステータスページをWebhookでつなげば、すべての返信がステータスページと同じ内容にそろいます。
100クレジットまで無料で始められ、その後は月299ドルで500クレジットです。チケット1件は、更新を何回受けても1クレジットとして数えます。次の障害の最中ではなく、その前に、ZendeskまたはFreshdeskで設定しておきましょう。