

Muse Code ne coûte rien. Meta vous facture le modèle en dessous : 1,25 $ par million de tokens en entrée, 0,15 $ en cache et 4,25 $ en sortie sur muse-spark-1.2, ou 0,10 $ / 0,002 $ / 0,20 $ sur le palier contributor si vous laissez Meta s'entraîner sur votre code. Il n'y a ni prix par poste, ni abonnement, ni palier gratuit, ni crédit d'essai sur aucune des pages de tarifs, de produit ou de facturation de Meta. J'ai vérifié les trois.
Ça paraît bon marché, et au token, ça l'est. Le piège, c'est que Muse Code décide combien de tokens dépenser, et rien ne l'arrête. Par défaut, il tourne avec le modèle cher, au deuxième niveau de raisonnement le plus élevé sur sept, avec trois agents observateurs en arrière-plan qui font chacun leurs propres appels au modèle, et un éclatement en sous-agents qui évolue avec le nombre de cœurs de votre CPU. Meta ne propose aucun plafond de dépenses, quel qu'il soit. La seule chose appelée limite dans la documentation de facturation est un "seuil de paiement", et il monte à mesure que vous payez.
Si votre raison de regarder les tarifs des tokens, c'est que vous voulez une facture de support prévisible, c'est un autre problème avec une autre réponse. eesel facture 1 crédit par ticket ou chat, quelle que soit sa durée, à un prix mensuel fixe à partir de 299 $/mois pour 500 crédits, plutôt que de facturer par million de tokens, ce qui veut dire que la facture suit le travail traité plutôt que le temps qu'un modèle a eu envie de réfléchir. Cette unité est tout l'enjeu.
Ce que Muse Code vous facture réellement
Muse Code est l'outil de codage IA pour terminal de Meta AI, sorti en bêta le 5 août 2026 en même temps que le modèle Muse Spark 1.2. Il s'installe avec une ligne, curl -fsSL https://dev.meta.ai/install.sh | bash, et se lance en tapant muse dans un répertoire de projet.
Voici ce qui fait trébucher les gens sur la page produit de Muse Code : la section intitulée "Models and pricing" ne contient aucun prix pour Muse Code. Elle contient un tableau de tokens à cinq colonnes pour Muse Spark. J'ai cherché dans tout le texte affiché de cette page les mots free, trial, credit, subscription, seat, plan, spend, limit et cap. Zéro résultat sur les neuf. Toute l'histoire commerciale de l'agent de code de Meta est un tableau de tokens.
La vraie grille tarifaire, c'est donc celle de la Model API. Chaque modèle vendu par Meta, tel que publié sur pricing and rate limits :
| Modèle | Palier | Fenêtre de contexte | Entrée / Mtok | Entrée en cache / Mtok | Sortie / Mtok | Requêtes par minute | Tokens par minute |
|---|---|---|---|---|---|---|---|
muse-spark-1.2 | Standard | 1 048 576 | 1,25 $ | 0,15 $ | 4,25 $ | 3 000 | 4M |
muse-spark-1.2-contributor | Contributor | 1 048 576 | 0,10 $ | 0,002 $ | 0,20 $ | 100 | 3M |
muse-spark-1.1 | Standard | 1 048 576 | 1,25 $ | 0,15 $ | 4,25 $ | 3 000 | 4M |
Trois modèles, deux prix, et aucune porte dérobée bon marché côté legacy : 1.1 coûte exactement le même prix que 1.2. Les limites de débit s'appliquent par équipe plutôt que par clé, donc des clés supplémentaires n'achètent rien. Les envois en arrière-plan portent en plus un troisième plafond de 600 par minute. Si vous voulez la lecture côté modèle de ces mêmes chiffres, y compris ce qui a changé entre 1.1 et 1.2, c'est ce que couvre le guide des tarifs de Muse Spark 1.2.
Puis les extras, ou plutôt leur absence. Il y a un seul véritable compteur additionnel, le grounding par recherche web à 2,50 $ pour 1 000 requêtes, facturé en plus des tokens et fixe, quelle que soit la quantité de contexte que chaque recherche tire. À part cela, Meta a moins de mécanique tarifaire que la plupart des fournisseurs, et le plus souvent en votre faveur :
- Aucune surtaxe de contexte long. Meta le dit sans détour : "There is no long-context premium: you pay the same rate whether your context window is mostly empty or almost full." Plusieurs concurrents augmentent le prix au-delà d'un seuil de contexte. Meta ne le fait pas.
- Aucun frais d'écriture dans le cache. La mise en cache est automatique, les tokens en cache sont un sous-ensemble des tokens d'entrée plutôt qu'une ligne séparée, et l'indication de rétention optionnelle
"24h"ne coûte rien de plus. - L'échafaudage propre de Meta est gratuit. Extrait de la documentation : "Meta injects a small amount of steering context into every prompt (a system prompt and related scaffolding); those injected tokens are not billed."
- Aucune API par lots ni remise sur les lots. Les réponses
background: trueexistent mais ne sont pas remisées. - Aucun fine-tuning, à aucun prix. Il n'y a aucun produit de fine-tuning dans la documentation.
- Aucune remise de volume ou d'engagement. Les mots de la page de tarifs sont "no minimums or upfront commitment", ce qui joue dans les deux sens.
C'est une grille tarifaire inhabituellement propre. Tout ce qui coûte cher dans Muse Code se passe ailleurs.
Les trois réglages par défaut qui fixent votre facture
Chaque agent facturé à l'usage a trois ou quatre réglages qui décident de la taille de la facture. Ce qui rend Muse Code digne d'intérêt, c'est que ses trois curseurs de coût sont, dès la sortie de la boîte, réglés sur la position la plus chère, et aucun d'eux ne figure sur la page de tarifs.
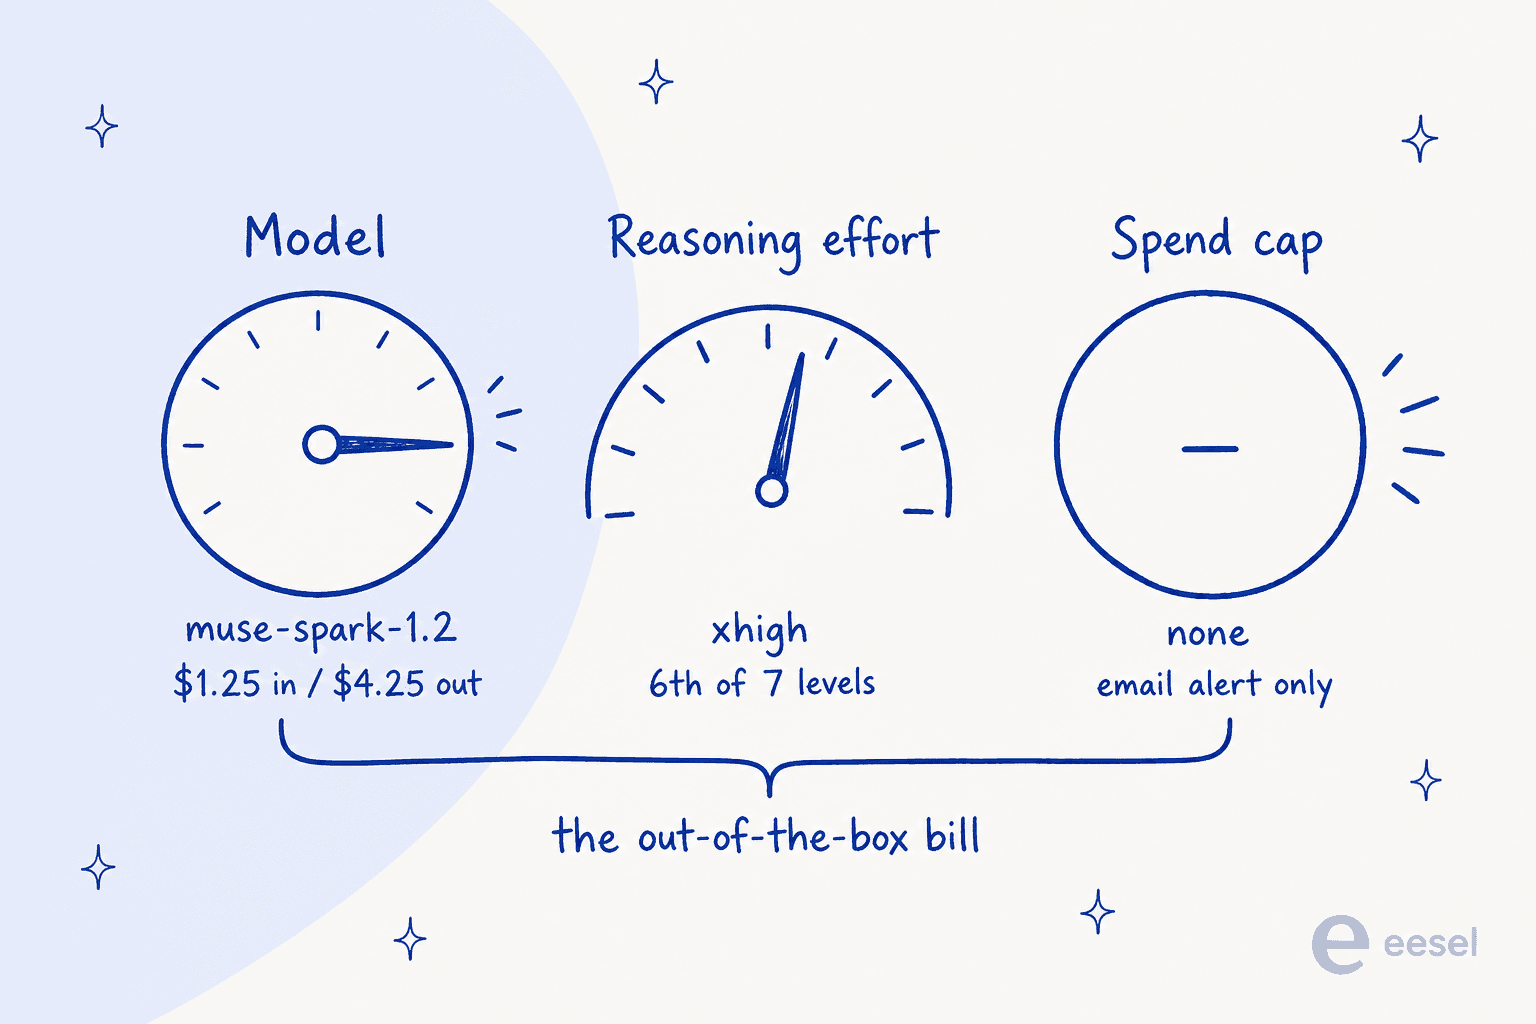
Le premier curseur est le modèle. La documentation de configuration de Meta le dit sans ambiguïté : "The default model is muse-spark-1.2." C'est le palier à 1,25 $ et 4,25 $, pas celui à dix cents.
C'est là que ça devient flou, et je veux être précis parce que l'écart entre les deux réponses est de 12,5x en entrée. Le blog de lancement dit le contraire : Muse Code "starts on a contributor tier", et il donne la commande pour changer, /model to muse-spark-1.2-contributor. La page de configuration ne mentionne jamais le palier contributor. Le mot y apparaît zéro fois, et le seul exemple --model imprimé par Meta est le redondant muse --model muse-spark-1.2. Les deux pages de Meta se contredisent sur le prix que vous payez. Le blog appelle aussi la commande /model là où la documentation l'appelle /models. Jusqu'à ce que Meta réconcilie les deux, lancez /models dès votre première session et lisez ce qui s'affiche, plutôt que de faire confiance à l'une ou l'autre des deux pages.
Le deuxième curseur est l'effort de raisonnement. Muse Spark est un modèle de raisonnement, et Meta est direct sur ce que cela signifie pour la facture : "It thinks before it answers; those tokens are billed as output." La sortie, c'est le compteur à 4,25 $. Les niveaux d'effort documentés sont none, minimal, low, medium, high, xhigh et ultra, et le défaut est xhigh, le sixième sur sept. none n'est pas du tout pris en charge dans Muse Code.
ultra mérite un avertissement, et au crédit de Meta, il en a un. Ce n'est pas un réglage de réflexion plus profonde ; le client plafonne quand même la requête au modèle à xhigh. Ce que ultra fait réellement, dans les mots de Meta, c'est changer "how aggressively Muse Code delegates to multi-agent workflows on the client, which can raise token usage". Qui y recourt en espérant de meilleures réponses obtiendra à la place une facture plus grosse.
Le troisième curseur est le plafond de dépenses, et il n'existe pas. On y revient plus loin, car c'est la partie qui décide si tout cela peut être posé sans risque sur une carte d'entreprise.
Votre conversation, c'est ce que vous achetez
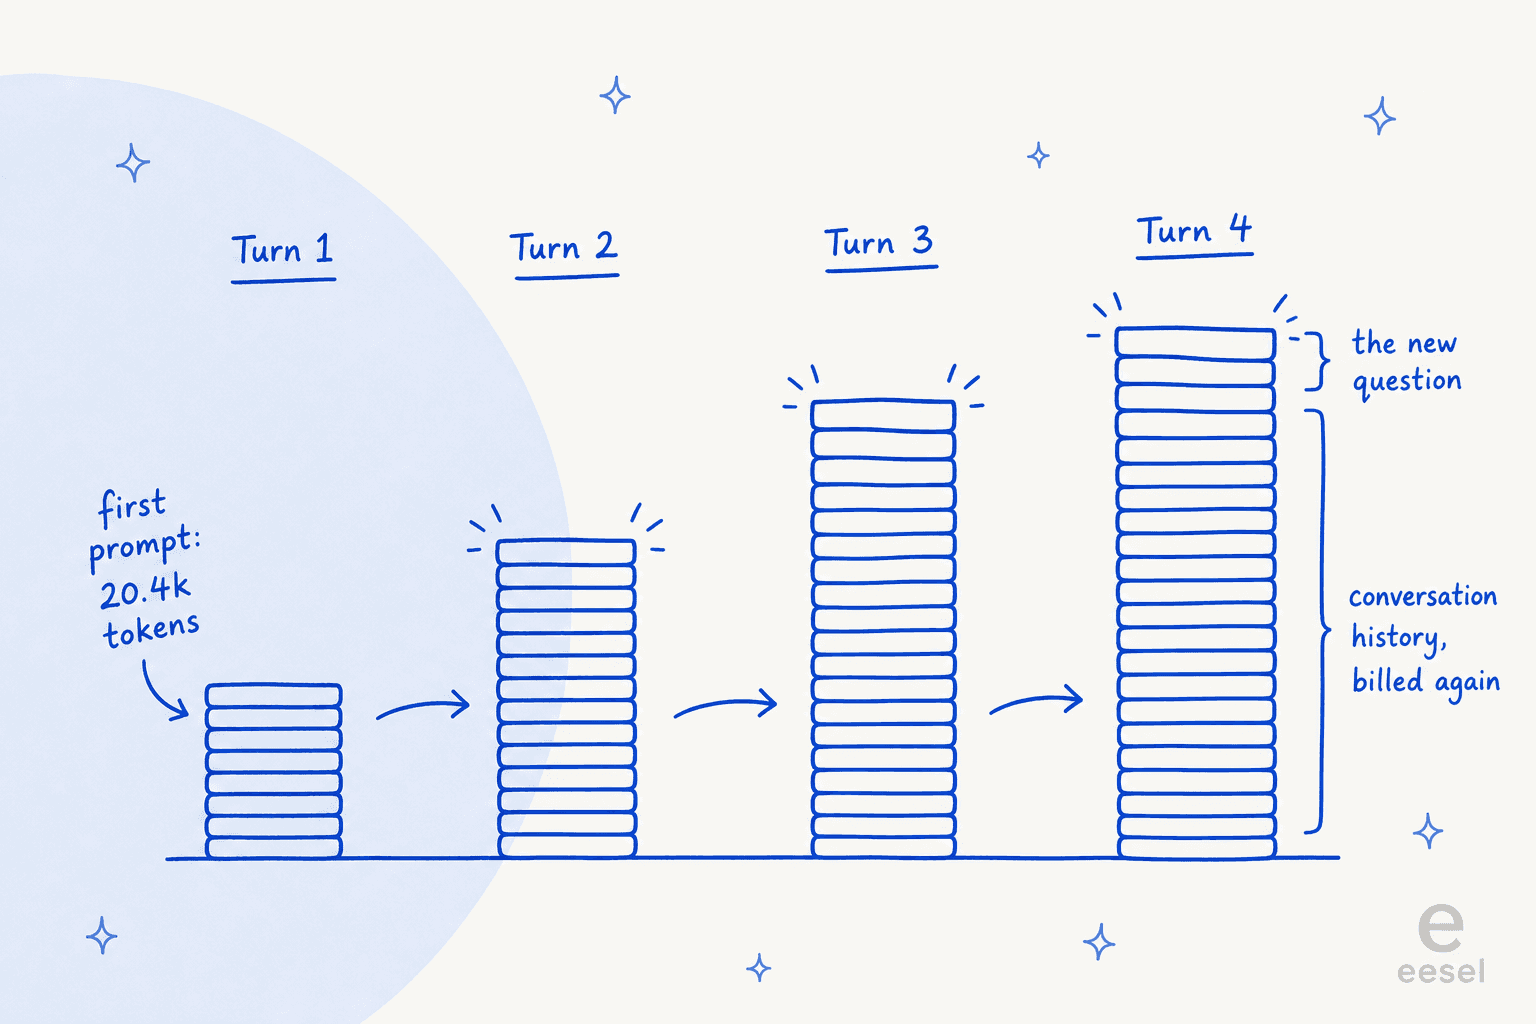
La phrase la plus utile de toute la documentation de facturation de Meta est une définition que la plupart des gens survolent. Les frais sont basés sur l'usage des tokens, et chaque requête consomme "Input tokens: your prompt, system instructions, and conversation history."
Historique de conversation. Dans une fenêtre de chat, c'est une note de bas de page. Dans un agent qui lit des fichiers, exécute des tests, lit le résultat et réessaie, c'est tout le modèle de coût. Le tour douze est facturé pour les tours un à onze.
Deux choses atténuent cela, et une l'aggrave.
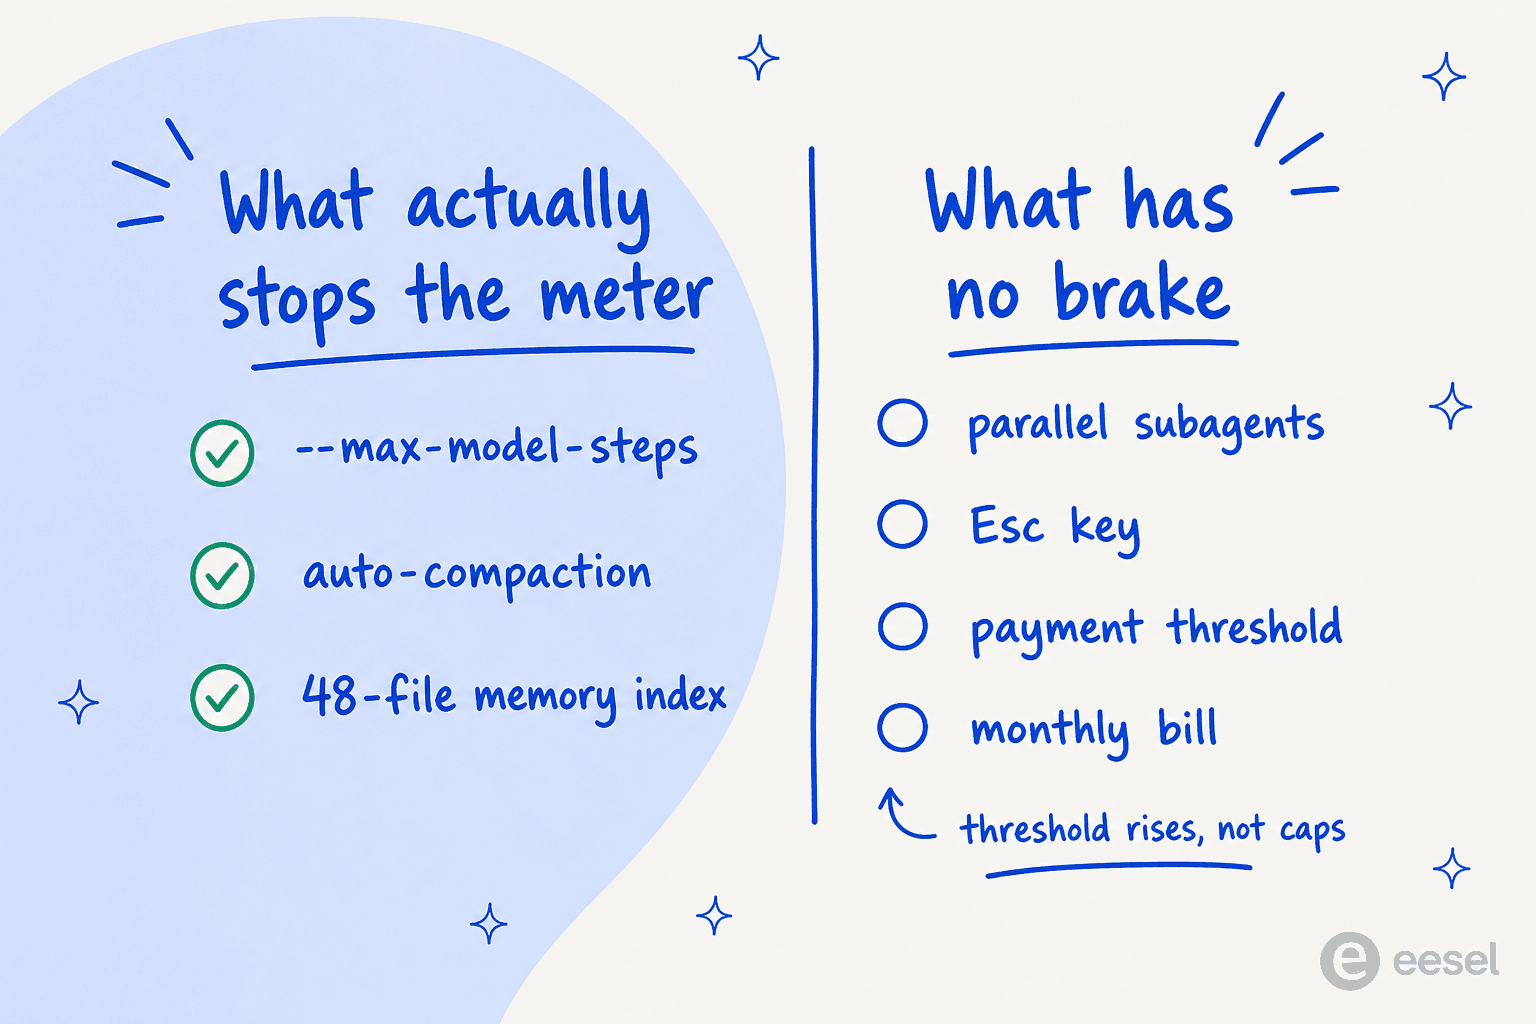
Ce qui l'atténue : la mise en cache des prompts est automatique, et le préfixe répété est facturé à 0,15 $ plutôt qu'à 1,25 $, une remise de 88 % sur la partie de votre contexte qui n'a pas changé. Meta garde aussi par conception le rappel de mémoire bon marché. Au début de la session, l'agent injecte un index de vos fichiers de mémoire, "their paths, not their contents, up to 48 files", et ne lit les fichiers individuels que lorsqu'il le souhaite. C'est un vrai contrôle de coût, et ça fait plaisir d'en voir un.
Ce qui l'aggrave : le code se tokenise moins bien que la prose, ce que Meta dit aussi ouvertement. "A token is roughly 3 to 4 characters of English text. Non-English text and code often use more tokens per word, so equivalent requests can cost more." Un agent de code est le pire cas pour un compteur au token, et c'est exactement le produit que vend Meta.
Vous pouvez voir le plancher de tout cela avec une seule mesure. Un développeur a tapé un seul mot dans Muse Code le jour du lancement et a observé le compteur :
"Meta AI released muse code today. so i tested out. just said
hias the first prompt, and it consumed 20.4k tokens (and $0.02)."

Deux cents, ce n'est rien. 20 400 tokens pour deux caractères, c'est le chiffre à retenir, car c'est la taille de la base à partir de laquelle votre session commence à s'accumuler avant même d'avoir demandé quoi que ce soit.
Le multi-agent par défaut est une décision de facturation
Meta présente la fonctionnalité phare de Muse Code comme "Multi-agent by default". Sur la page produit, ça se lit comme une capacité. Au compteur, c'est un multiplicateur, et la documentation est assez précise pour faire le calcul.
Commençons par l'éclatement. Extrait de la documentation d'extension de Meta : "The runtime runs several children at once. The default cap scales with the machine: roughly core count minus two, clamped between 2 and 16." Le nombre de cœurs de votre ordinateur portable est une variable de prix. Sur une machine à 16 cœurs, cela fait jusqu'à 14 processus enfants capables d'écrire, tournant comme des flux facturés séparément, chacun avec son propre contexte, chacun avec sa propre copie de la tâche. Les enfants ne tournent que sur un niveau de profondeur, donc au moins pas de récursion possible.
Vous ne choisissez pas cela activement. Le blog de lancement est catégorique : les tâches sont "fanned out automatically... Your working copy is never touched and you don't set any of this up - Muse Code does it all automatically." C'est une vraie réussite d'ingénierie et j'aime la conception. C'est aussi ce qui multiplie vos dépenses de tokens pendant que vous regardez une seule barre de progression.
Puis les observateurs, que je n'avais vu traités nulle part ailleurs et qui m'ont le plus surpris. Muse Code fait tourner une équipe d'agents en arrière-plan qui surveillent le rappel de mémoire, le rappel de compétences, le suivi d'objectifs et la vérification. La phrase de Meta : "Three of the four observers run by default, and each makes its own model calls, so they add token usage in addition to the main session." Trois conversations facturées en plus, dans lesquelles vous n'avez jamais rien tapé, activées par défaut, désactivables dans settings.json sous runtime_capabilities.
Et il y a un piège dans l'interruption. Appuyer sur Esc "stops the turn only. It does not stop background terminals or subagents." Le réflexe de panique universel quand un agent part en roue libre n'arrête pas le compteur sur les flux parallèles. Ça vaut le coup de le savoir avant d'en avoir besoin, et c'est une version plus aiguë du même problème qui rend l'orchestration de sous-agents difficile à budgétiser dans tous les harnais, celui-ci compris. Si vous voulez la comparaison, les sous-agents de Claude Code et les systèmes multi-agents traversent le même compromis depuis l'autre côté.
Calculez votre propre chiffre
Meta ne publie aucun calculateur de coût, et tout exemple chiffré que je pourrais écrire serait faux pour votre dépôt. Voici donc le calcul dans une boîte où vous pouvez mettre vos propres chiffres. Elle utilise la grille tarifaire publiée et modélise la seule chose qui fait vraiment bouger la facture : votre conversation refacturée à chaque tour, au tarif mis en cache, une fois par flux parallèle.
Le pourcentage dans cette note est tout l'enjeu de l'exercice. Sur toute session assez longue pour être utile, la majeure partie de ce que vous payez à Meta sert à relire une conversation que vous avez déjà payée. Raccourcir les sessions est un levier plus puissant que changer de modèle, ce qui n'est pas là où la plupart des gens regardent en premier. C'est la même raison pour laquelle la taille de la fenêtre de contexte devient une question de budget plutôt que de capacité dès qu'un agent fait du vrai travail.
Comment cela se compare à l'achat d'un forfait
La raison pour laquelle un agent facturé à l'usage paraît étrange, c'est que presque rien d'autre dans cette catégorie n'est vendu ainsi. J'ai comparé chaque CLI de codage agentique sérieux à celui de Meta, et le schéma est assez constant pour constituer la conclusion : cinq des six proposent un forfait fixe et vous donnent aussi un plafond de dépenses strict sur la voie facturée à l'usage. Muse Code n'a ni l'un ni l'autre.
| Outil | Forfait fixe | Tarif à l'usage | Plafond de dépenses strict | Palier gratuit |
|---|---|---|---|---|
| Muse Code | Aucun, à aucun prix | 1,25 $ / 0,15 $ / 4,25 $, ou 0,10 $ / 0,002 $ / 0,20 $ contributor | Non. Alerte par e-mail uniquement | Non |
| Claude Code | Pro 20 $, Max 5x 100 $, Max 20x 200 $ | Opus 5 5 $ / 25 $ ; Sonnet 5 2 $ / 10 $ | Oui, limite mensuelle réglable, plus des limites de workspace sur les organisations API | Pas sur le forfait gratuit |
| Codex CLI | Go 8 $, Plus 20 $, Pro à partir de 100 $, Business 25 $/utilisateur | Sol 5 $ / 30 $, Terra 2 $ / 12 $, Luna 0,20 $ / 1,20 $ | Oui, une limite d'usage approuvée par l'organisation qui échoue en dur | Palier gratuit existant, CLI dès Plus |
| Gemini CLI | Inclus dans les forfaits AI Pro et Ultra | Paliers de l'API Gemini, Tier 1 plafonné à 250 $ | Oui, plafonds par palier de facturation et limites de dépenses par tranche de 10 minutes | Oui, 60 requêtes/min et 1 000 requêtes/jour |
| Cursor | Pro 20 $, Pro Plus 60 $, Ultra 200 $, Teams 40 $/utilisateur | Quota d'usage inclus, puis facturation au-delà | Oui, et les fonctionnalités IA s'arrêtent une fois atteint | Oui, Hobby |
| Grok Build | SuperGrok 30 $, SuperGrok Plus 100 $ | grok-build-0.1 1,00 $ / 2,00 $, 0,20 $ en cache | Oui, et c'est l'état par défaut | Oui |
| OpenCode | Logiciel gratuit, forfait Go optionnel 10 $/mois | Ce que coûte votre propre clé | Hérité de votre fournisseur | Oui |
Lisez la colonne du plafond de dépenses de haut en bas. La documentation de Cursor est la plus claire sur ce que signifie une limite en pratique : "When a limit is reached, AI features stop for that user until the next billing cycle." Grok Build arrive par défaut avec une limite de facturation à 0 $, donc les requêtes sont rejetées dès que le crédit prépayé est épuisé. Même les voies d'API facturées à l'usage ont des plafonds, parce que les fournisseurs ont appris il y a des années que les développeurs ne laissent pas leur carte sans en avoir un.
Il y a une deuxième chose que ces fournisseurs font et que Meta ne fait pas, et c'est la plus utile. Ils publient ce que vous devriez vous attendre à dépenser. La documentation d'Anthropic elle-même situe Claude Code à "$13 per developer per active day and $150-250 per developer per month." Cursor publie aussi des fourchettes, environ 60 à 100 $ par mois pour les utilisateurs quotidiens d'agents et plus de 200 $ pour les utilisateurs intensifs. Meta publie une grille tarifaire et vous souhaite bonne chance. Nulle part dans sa documentation il n'y a une phrase qui vous dit à quoi ressemble un mois normal.
Donc au prix par token, Muse Spark est compétitif, et le palier contributor est agressif face à tout sauf les laboratoires chinois les moins chers. En matière de prévisibilité des prix, Muse Code est la seule option ici qui ne peut pas répondre à "combien cela peut-il me coûter au maximum ce mois-ci". Si vous avez déjà traversé une conversation d'achat sur les tarifs de Claude, les tarifs de Codex, les tarifs de Windsurf ou les tarifs de GitHub Copilot, vous savez ce que vaut cette certitude pour une équipe finance, et c'est généralement plus que l'écart de tokens.
Acheter des tokens directement reste une vraie stratégie, juste une autre. C'est la même décision que de recourir à l'API OpenAI ou à l'API Anthropic plutôt qu'à un produit packagé : une meilleure économie unitaire, et vous héritez du problème de prévision. La comparaison des trois grandes API de modèles couvre où chacune se situe à côté des tarifs de Claude Opus 4.6 et des tarifs de GPT 5.3 Codex. Si vous achetez purement pour des tokens bon marché, les tarifs de Qwen, les tarifs de Kimi K2.5, les tarifs de Mistral AI et DeepSeek V3.2 appartiennent tous au même tableau. Héberger les poids ailleurs est la troisième voie, celle pour laquelle existent les tarifs de Together AI et les tarifs de Groq.
Un point positif à accorder à Meta, puisque j'ai passé la majeure partie de cet article sur l'écart : la grille tarifaire elle-même est honnête. Deux prix, tous deux imprimés, avec les conditions sur les données en anglais clair sous chacun. Aucun système de crédits ne s'interpose entre vous et le chiffre, ce qui est plus qu'on ne peut en dire des dispositifs de crédits IA et de Flex Credits qui se sont répandus dans le reste de l'industrie. Le problème n'est pas que Meta ait caché le prix. C'est que Meta a tarifé les tokens et laissé le volume entièrement à l'agent.
Une observation de la communauté vaut d'être répétée ici car elle fixe la barre à laquelle Meta est réellement jugé, et ce n'est pas Anthropic :
"This is a nice release and a solid improvement over Spark 1.1. It compares favorably with Grok 4.5. Not SOTA, but solid releases. I think they need to really get this more competitive with Deepseek V4 Flash / Luna pricing to move the needle."

Ce que Muse Code ne vous vend pas : un plafond
J'ai lu chaque page de facturation que Meta publie pour ce produit, et il n'y a ni plafond de dépenses, ni limite de budget, ni arrêt strict, ni alerte d'usage dans aucune d'elles. Ce qu'il y a, c'est un seuil de paiement, et il est facile de le confondre avec un plafond parce que c'est un chiffre attaché à votre compte avec un signe dollar.
Les mots de Meta : "Whenever your current balance reaches your payment threshold amount, your payment method is charged for that amount. As you make successful payments, your payment threshold may be raised until your account reaches a final threshold amount."
Lisez bien cela. C'est un déclencheur pour débiter votre carte, et il augmente à mesure que vous prouvez que vous pouvez payer. C'est une limite de crédit qui joue en faveur du fournisseur. Ce qui reste est de toute façon débité le premier du mois. Le mot "plans" apparaît dans le titre de la page de facturation et dans la description de navigation, et n'est jamais suivi d'un forfait réel.
Les développeurs l'ont remarqué dès le premier jour, et l'objection n'est pas théorique :
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
Je veux m'arrêter sur ce commentaire, parce que je le reconnais d'un marché complètement différent. Je construis des intégrations chez eesel et j'assiste à suffisamment d'appels commerciaux pour savoir que demander un plafond est la chose la plus banale qu'un acheteur puisse réclamer. Une équipe avec qui j'ai échangé, anonymisée ici comme un groupe de support matériel B2B soucieux de son budget qui gère environ 250 tickets par mois, avait vu le prix d'un fournisseur précédent plus que doubler et est venue demander spécifiquement des blocages de prix contractuels, en proposant un prépaiement annuel comme moyen d'en obtenir un. Personne n'appelle ça de la paranoïa. C'est simplement ce qui arrive après avoir été surpris une fois.
Et la surprise arrive généralement après que le produit a déjà fait ses preuves, ce qui est la partie qui fait mal. Une autre équipe, une marque de mode américaine sur Gorgias, a fait tourner douze chats de test contre l'agent d'eesel. L'agent a bien fonctionné. Puis ils ont ouvert la page de facturation et ont immédiatement déposé deux demandes d'annulation, dont une disait simplement :
"PLEASE CANCEL MY subscription"
Cela portait sur la propre page de tarifs d'eesel, pas sur celle d'un concurrent, et ça m'a appris quelque chose sur lequel je me base depuis : ce n'est pas le fait que le produit fonctionne qui décide de l'achat, c'est la facture. Un agent facturé à l'usage sans plafond garde cette conversation pour la fin du mois.
Ce qui ressemble le plus à un frein que Meta vous donne est une limite de pas plutôt qu'une limite en dollars : --max-model-steps <n> sur les exécutions headless, que Meta décrit comme étant là "so a stuck task can't loop indefinitely". Utile en CI. Ça ne fait rien pour une session interactive, qui est l'endroit où se dépense la majeure partie de l'argent.
Là où le palier bon marché devient cher
Le palier contributor est la décision tarifaire la plus intéressante de tout le lancement, et la plus débattue. 0,10 $ en entrée et 0,20 $ en sortie, c'est 12,5x et 21x moins cher que le standard, et l'étiquette que Meta met dessous sur la page produit est une seule phrase : "Used to improve our products." L'étiquette du palier standard est "Not used to improve our products." J'ai rarement vu un fournisseur énoncer le compromis aussi crûment, et beaucoup de développeurs l'ont respecté pour ça :
"I actually really like that pricing strategy. It's very transparent"
"The fact that Facebook has so much experience taking advantage of people's private data is one of the reasons I believe them when they say they won't be doing it when you pay them for that service."
La contestation s'est divisée en deux. Certains ont avancé que la remise sous-évalue les données, puisque le coût réel de ce choix, ce sont les 4,05 $ par million de tokens de sortie non gagnés. D'autres ont souligné qu'on peut obtenir le même prix sans céder les données :
"FYI: there are providers of deepseek that offer the same or lower pricing and zero retention policies."
Au-delà de l'éthique, il y a quatre raisons concrètes pour lesquelles le palier bon marché pourrait vous coûter plus que ce que suggère l'étiquette de prix, et ce sont celles que je voudrais avoir sur un tableau blanc avant d'engager une équipe là-dessus.
Il est 30x plus limité en débit sur les requêtes. 100 requêtes par minute contre les 3 000 du palier standard, alors que les tokens par minute ne chutent que de 25 %, de 4M à 3M. Meta a spécifiquement bridé la voie des requêtes. Un agent qui tire beaucoup de petits appels d'outils en parallèle, ce qui est exactement ce que fait l'éclatement de Muse Code, se heurte à un plafond de requêtes bien avant un plafond de tokens. Un agent en file d'attente est un agent lent, et les agents lents sont relancés.
L'accès peut être retiré sans préavis. Un développeur a rapporté l'avoir perdu en plein projet :
"Pointing out for others: without warning I was restricted from using the contributor model because of "policy violations". I was working on Kaggle research and some Apple Security work at the time. They really need to make cyber a first priority product feature."
Les conditions des crédits gratuits ont changé après coup. Meta a distribué des crédits de 20 $ au lancement de Muse Spark 1.1, et le texte sur l'usage des données qui y était attaché a changé plus tard :
"If you got the $20 in free credits from Meta for signing up when muse-spark-1.1 was release, please note that there's now small print stating "While using free credits your content may be used for product improvement" which was not present at muse-spark-1.1 launch when the credits were given out."
La rétention zéro des données est verrouillée aux ventes et sans prix. Extrait du blog de lancement : "We're also beginning to accept requests for zero data retention. Contact Meta sales to request this." En train de commencer, et sur demande. Si une revue de sécurité doit vous bloquer, c'est exactement ici qu'elle le fera, et il n'y a ni réglage en libre-service ni prix publié pour y remédier.
Ce dernier point est là où le coût et la vie privée cessent d'être des questions séparées. Un agent de terminal lit votre dépôt et l'envoie comme entrée facturable à l'API d'un fournisseur, donc chaque token qui quitte votre machine est à la fois une ligne de facture et une divulgation. J'entends la même question constamment du côté support de ce métier. Un évaluateur technique dans une entreprise de matériel semi-conducteur n'a pas voulu avancer avant d'être sûr que l'IA répondait uniquement à partir des connaissances approuvées de son organisation plutôt que d'interroger un modèle général, et a demandé directement si ce comportement pouvait être désactivé. Il ne posait pas une question de prix. Il posait la même question. Ce chevauchement explique exactement pourquoi la sécurité de Claude Code se lit par endroits comme un document de coûts.
Sur ce que vaut le modèle lui-même à ce prix, la lecture pratique la plus honnête du fil de lancement était aussi la plus utile :
"Muse code is rough around the edges. But combined with almost free model (muse spark contributor) it's actually pretty good. I think it's on the same level as grok build."
Ce que je ferais vraiment
Concrètement, dans l'ordre où je le ferais, si je mettais Muse Code sur un vrai projet cette semaine.
- Lancez
/modelsdès votre première session et confirmez sur quel palier vous êtes. La documentation de Meta et le blog de lancement se contredisent, et la différence est de 12,5x. Ne le déduisez pas, lisez-le. - Baissez
--reasoning-effortàmediumet voyez si vous le remarquez. Le raisonnement est facturé comme sortie à 4,25 $.xhighest le défaut, pas une recommandation, et la plupart des tâches ne sont pas difficiles. C'est le même levier qu'offrent la sélection de modèle et le passage à un palier de modèle bon marché dans d'autres harnais. - Désactivez les agents observateurs que vous n'utilisez pas. Trois tournent par défaut dans
settings.jsonsousruntime_capabilities, chacun avec ses propres appels au modèle. La vérification est déjà désactivée ; les trois autres sont un choix. - Terminez les sessions plutôt que de les prolonger. La transcription est une entrée facturable à chaque tour, donc un
/newpropre pour une nouvelle tâche est l'habitude la moins chère disponible, de loin. Utilisez/compactquand vous devez continuer. - Mettez
--max-model-stepssur chaque exécution headless. Ce n'est pas un plafond en dollars, mais c'est le seul arrêt documenté, et la CI est l'endroit où une boucle tourne sans surveillance à 3 heures du matin. - Surveillez le tableau de bord d'usage chaque semaine, parce que rien d'autre ne vous le dira. Il n'y a ni plafond ni alerte au-delà de l'e-mail. Traitez l'habitude des analyses d'utilisation comme obligatoire plutôt qu'optionnelle, et si cela doit aller dans une équipe, lisez d'abord sur les contrôles d'administration.
Et le point structurel, que je préfère dire clairement plutôt que de le cacher. Un agent facturé à l'usage sans plafond, c'est l'extrémité faites-le-vous-même du marché, et le faire soi-même a un coût qui n'apparaît sur aucune grille tarifaire. Un client d'eesel, un responsable d'ingénierie dans une entreprise de matériel crypto, l'a dit mieux que je ne pourrais :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Certaines équipes devraient tout de même acheter des tokens bruts. Si votre charge est en dents de scie, vos ingénieurs sont solides et quelqu'un possède la facture, l'économie unitaire est meilleure et Muse Code est un harnais bien construit pour les dépenser. La décision construire ou acheter dépend de qui a du temps, pas de qui a la grille tarifaire la moins chère. Et si la réponse est "ni l'un ni l'autre, je veux un forfait", le tour d'horizon des meilleurs assistants de codage IA est le chemin le plus court vers un.
Essayez eesel pour le volet support de ce problème
Si vous êtes arrivé ici parce que vous essayez de prévoir ce que l'IA coûte réellement, et que le travail que vous prévoyez est du support client plutôt que du code, l'unité est tout l'argument. Muse Code tarife l'effort machine, donc sa facture bouge selon la durée de fonctionnement d'un modèle. eesel tarife un ticket résolu, donc la facture bouge avec le travail accompli, un chiffre que votre équipe finance suit déjà.
Cela compte le plus précisément là où Muse Code n'a pas de réponse : vous pouvez voir ce que vous allez devoir. eesel simule un nouvel agent sur vos propres tickets historiques avant de toucher une file d'attente en direct, donc vous obtenez le taux de résolution et la projection de coût à partir de votre historique de tickets réel plutôt que de découvrir les deux en production. J'ai livré beaucoup de ces intégrations, et l'étape de simulation est celle que les clients mentionnent sans cesse, parce que c'est la différence entre une prévision et un espoir.

Ça vaut le coup de regarder si vous pesez une facture de modèle à l'usage contre une facture par résolution : le détail du coût par résolution, l'argument en faveur de la tarification basée sur les résultats, et comment construire la chose en pratique avec un helpdesk IA. Gratuit à essayer, et vous connaîtrez votre chiffre avant de vous engager.
Questions fréquentes
Combien coûte Meta Muse Code ?
Muse Code est-il gratuit à utiliser ?
Puis-je fixer une limite de dépenses sur Muse Code ?
--reasoning-effort plus bas, --max-model-steps sur les exécutions headless, désactiver les agents observateurs en arrière-plan, et changer de modèle. Comparez cela aux plafonds publiés des limites de débit d'OpenAI ou aux plafonds de crédits dans des systèmes comme les crédits IA.Quels sont les tarifs de Muse Code pour une petite équipe ?
Quelle est la différence entre les paliers contributor et standard de Muse Spark ?
muse-spark-1.2 porte l'étiquette "Not used to improve our products", et le détail complet se trouve dans notre guide des tarifs de Muse Spark 1.2.Pourquoi mon premier prompt Muse Code a-t-il coûté de l'argent ?
hi à 20 400 tokens et deux cents, et à partir de là, chaque tour renvoie la conversation comme entrée facturable au tarif mis en cache. C'est le même effet cumulatif qui fait de la taille de la fenêtre de contexte une question de coût plutôt que de capacité, et c'est pourquoi presque toutes les bonnes pratiques pour ces agents se résument à garder des sessions courtes.