

En bref
Fish Audio Drama 3 est le meilleur modèle de synthèse vocale à poids ouverts que l'on puisse télécharger aujourd'hui, et le premier où l'on dirige une ligne comme on briefe un acteur : [barely holding it together] I'm fine. Il est n° 1 au test de prononciation d'Artificial Analysis avec 93,2 %, devant Eleven v4.
Les trois bémols : il se classe 10e, et non 1er, quand les auditeurs choisissent la voix qu'ils préfèrent ; la licence commerciale gratuite s'arrête à 500 000 US$ de revenus annuels ; et les 10 $ par million de caractères de l'API sont une remise de lancement de 80 % qui repasse à 50 $ après le 12 novembre.
Choisissez-le pour les livres audio, les fictions sonores, les jeux et les vidéos courtes, où l'on génère une ligne, garde la meilleure prise et passe à la suite. Évitez-le pour la voix en direct à gros volume, où la variation d'une prise à l'autre pénalise. Et si le travail derrière votre audio est l'écriture elle-même, c'est là que le rédacteur de blog IA d'eesel trouve sa place : il produit le script documenté qu'un modèle comme Drama 3 lit ensuite à voix haute.
Qu'est-ce que Fish Audio Drama 3 ?
Drama 3 est le nouveau modèle de synthèse vocale de Fish Audio, sorti le 13 octobre 2026 dans l'application web fish.audio, les applications iOS et Android et l'API. Un aperçu a été envoyé aux utilisateurs de l'API le 23 septembre sous le nom drama-3-preview, et la page d'accueil affiche toujours un badge « Preview » aujourd'hui.
Je travaille chaque jour sur la file de support d'eesel, et une grande partie de ce travail consiste à distinguer les outils qui font bonne impression en démo de ceux qui tiennent à la centième exécution. eesel met l'IA sur des files clients en direct depuis des années, et la principale leçon est qu'une sortie assurée peut quand même être fausse, c'est pourquoi chaque déploiement d'eesel est d'abord simulé sur des tickets passés. J'ai lu Drama 3 avec le même regard : au-delà de la vidéo de lancement, dans la documentation, le rapport technique, les pages de tarifs et les premières réactions de la communauté.
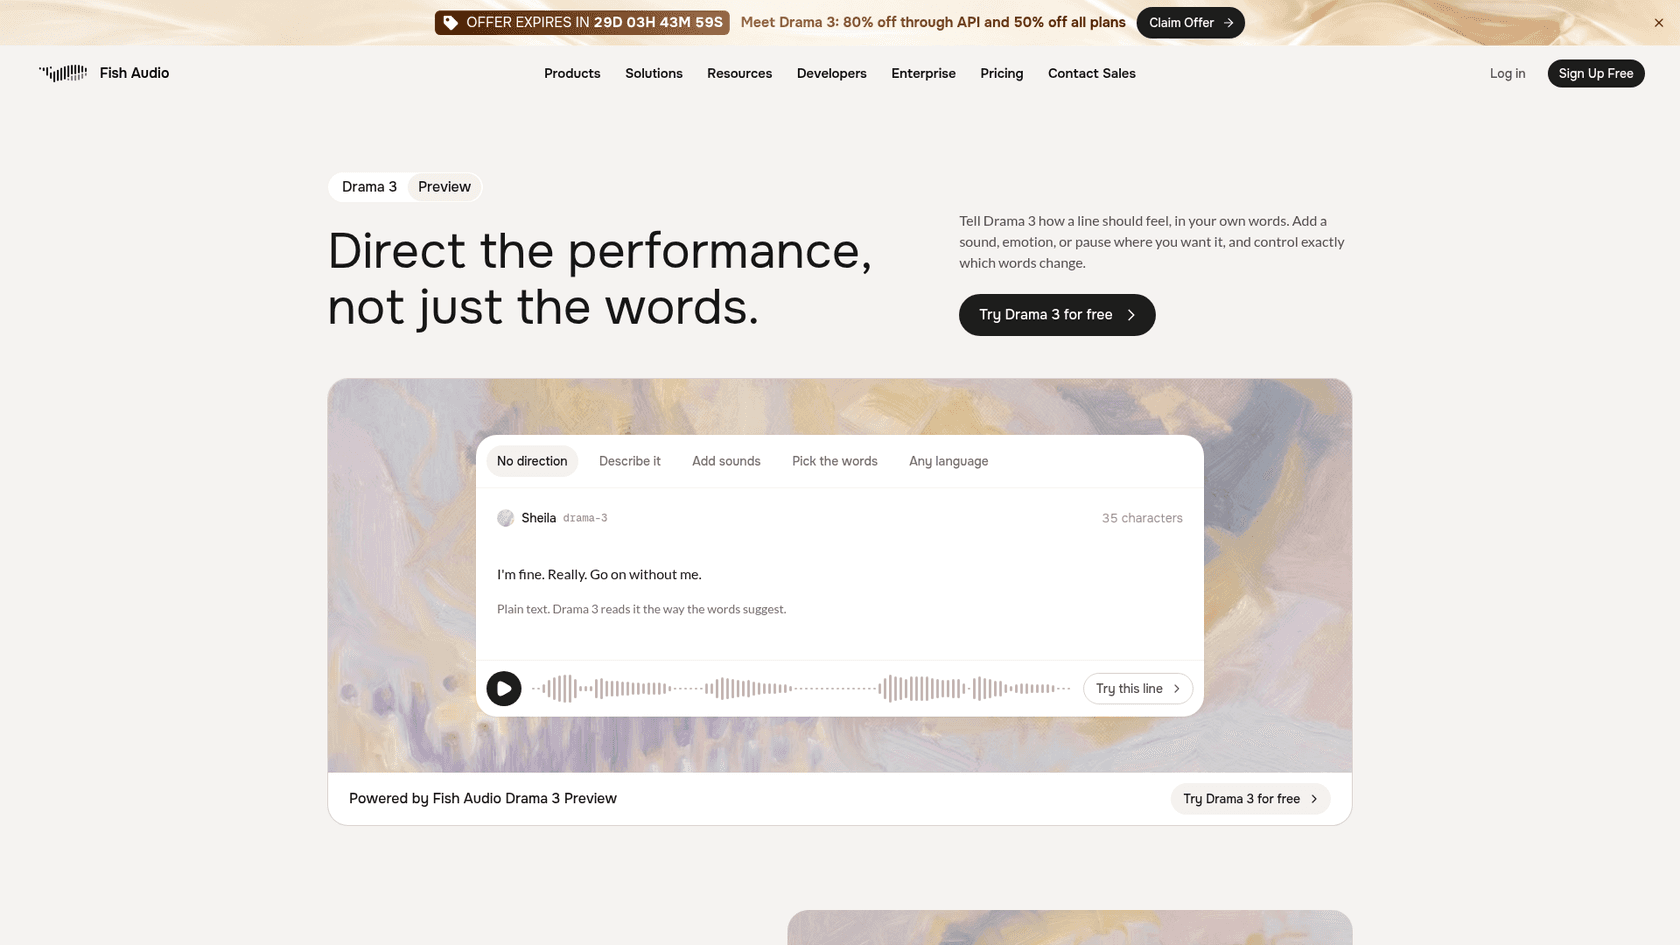
Les faits principaux, tous tirés des pages de Fish Audio elles-mêmes :
- 83 langues, et l'indication peut être écrite dans une langue différente de celle de la ligne (article de lancement).
- Poids ouverts sur Hugging Face sous la nouvelle Fish Audio Community License v1.0. Nouveau sur le hub ? Mon guide Hugging Face couvre les bases.
- Mélange d'experts de 35 milliards de paramètres, environ 3 milliards actifs par jeton, initialisé à partir du modèle de langage de Qwen3.5-35B-A3B, d'après le rapport technique.
- Même point d'accès d'API que S2.1 Pro, donc le changement tient à un en-tête :
model: drama-3.
Fish Audio est elle-même une jeune entreprise avec une vraie traction : fondée en 2025, elle annonce 21 millions de dollars de revenus récurrents annuels et plus de 15 millions d'utilisateurs dans son communiqué de lancement, avec HeyGen, Runway et Vercel cités comme clients.
Comment fonctionne la direction d'une ligne
C'est ce qui distingue Drama 3 du fonctionnement d'ElevenLabs et de l'API vocale d'OpenAI que la plupart connaissent. Au lieu de choisir dans une liste fixe de préréglages d'émotion, vous écrivez des indications de jeu directement dans le script.
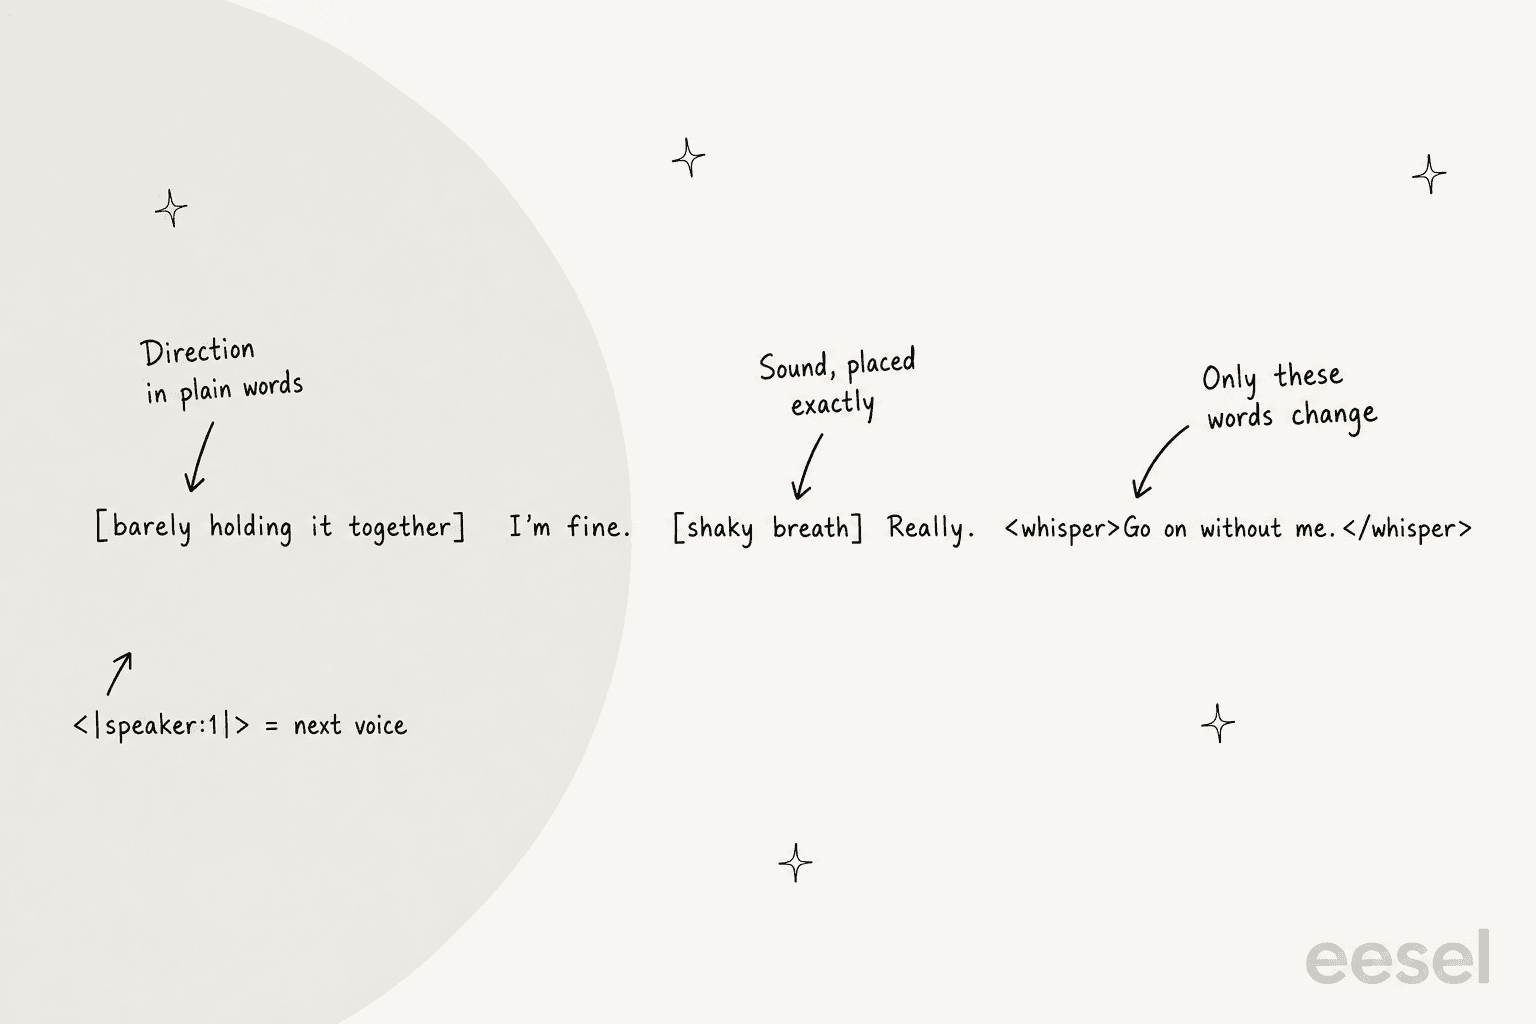
La documentation de Drama 3 décrit cinq outils, et vous pouvez tous les mélanger dans une même ligne :
| Ce que vous voulez | Comment l'écrire | Exemple |
|---|---|---|
| Définir la diction | Des mots simples entre crochets | [slow, dangerously quiet] Just one. |
| Placer un son ou une pause | Un crochet là où cela se produit | I'm fine. [shaky breath] Really. |
| Modifier seulement certains mots | Balises appariées : <whisper>, <emphasis>, <soft>, <fast>, <slow>, <stress>, <forceful> | <whisper>Go on without me.</whisper> |
| Changer de langue en cours de ligne (expérimental) | Balises de langue | <french>Je voudrais une table pour deux</french> |
| Fixer une prononciation | Balises de phonèmes (CMU Arpabet, pinyin, romaji) | <|phoneme_start|>EH1 N JH AH0 N IH0 R<|phoneme_end|> |
Une scène entière tient dans une seule requête : vous transmettez un identifiant de voix par locuteur dans reference_id et vous commencez chaque réplique par <|speaker:0|>, <|speaker:1|> et ainsi de suite. La fiche du modèle indique qu'un texte peut porter jusqu'à 16 personnages. Dans l'application web, un bouton Auto Tag rédige des premières indications pour un script simple, une bonne porte d'entrée si vous n'avez jamais écrit d'indications de jeu.
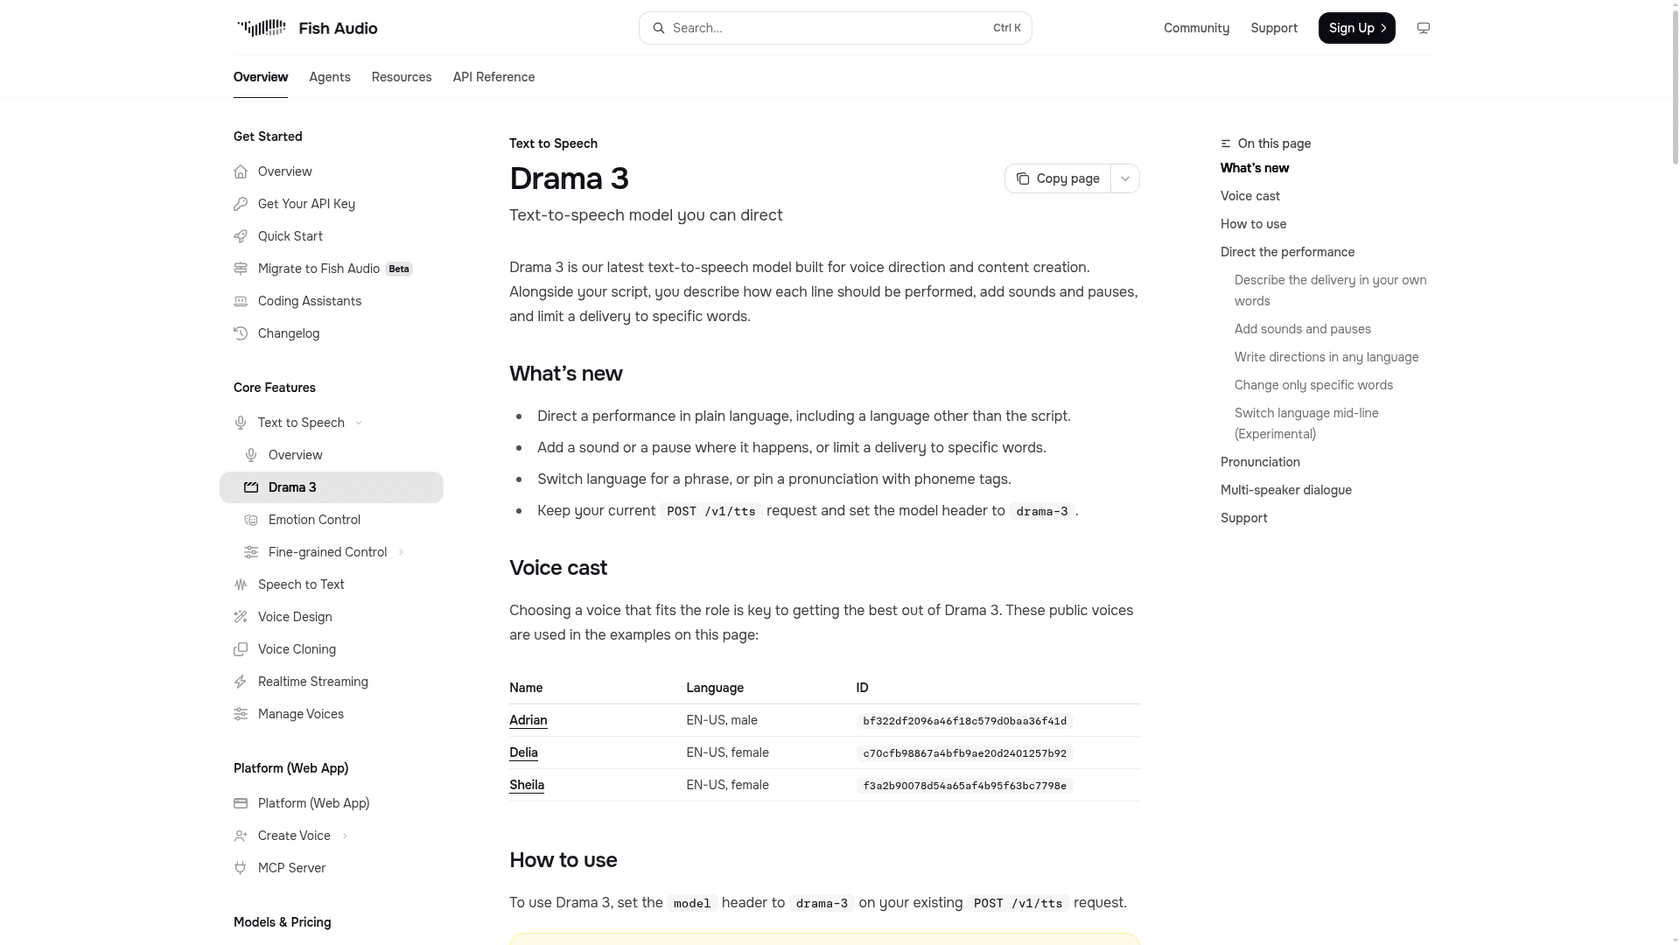
Un piège de la documentation mérite d'être tatoué quelque part : si l'en-tête model est absent ou mal orthographié, la requête n'échoue pas ; elle bascule silencieusement sur s2.1-pro. Vous obtenez de l'audio, vous êtes facturé, et vous n'avez jamais Drama 3. Si vos lignes dirigées sonnent plates, vérifiez l'en-tête avant d'accuser le modèle.
Ce que Drama 3 fait bien
Trois points se détachent, et ils sont mesurables, pas des impressions.
Il lit correctement les mots difficiles
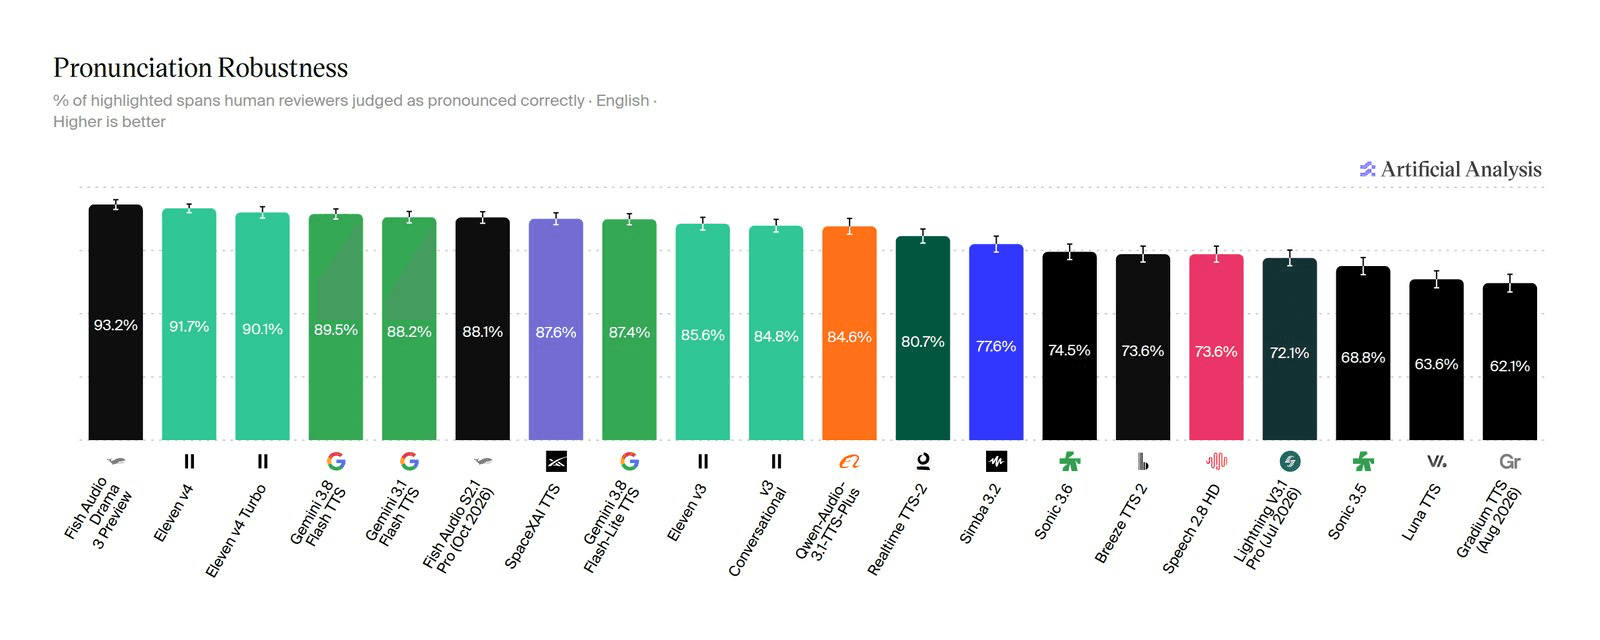
Plus d'émotion n'aide que si les mots y survivent. Au test Pronunciation Robustness d'Artificial Analysis, où des évaluateurs humains vérifient noms de marques, nombres, codes et mots dépendant du contexte, Drama 3 a obtenu 93,2 %, premier du classement, devant Eleven v4 à 91,7 % et Eleven v4 Turbo à 90,1 %.
La répartition par catégorie de l'article de lancement de Fish Audio montre d'où vient le bond par rapport à son prédécesseur :
| Ce qui est lu | Drama 3 | S2.1 Pro |
|---|---|---|
| Marques, lieux, termes techniques | 95,9 % | 87,3 % |
| Mots dont la lecture dépend du contexte | 95,3 % | 86,1 % |
| Nombres, dates, unités | 93,6 % | 92,7 % |
| Codes, chemins de fichiers, e-mails | 86,3 % | 79,4 % |
| Global | 93,2 % | 88,1 % |
Pour un livre audio qui dit « Chapter XVII » ou une présentation produit pleine de références, ce gain de 8,6 points sur les marques et les termes techniques fait la différence entre un rendu et trois.
Il accepte la direction en cours de ligne
Fish Audio a entraîné Drama 3 autrement que ses modèles précédents. Les modèles vocaux sont généralement récompensés pour être faciles à transcrire et proches du clip de référence, ce qui pénalise discrètement un rire ou un chuchotement. Drama 3 a été réglé avec un unique modèle de récompense appris sur la prise que les gens préféraient, selon l'article de lancement. En pratique, une ligne peut commencer essoufflée, tomber en chuchotement et finir d'un sérieux mortel, et la lecture tourne là où vous placez le crochet.
Il génère aussi une scène à plusieurs personnages en une seule passe, et ComfyUI l'a livré comme nœud partenaire dès le premier jour pour cette raison. Si vous écrivez des scripts pour la vidéo IA ou les podcasts, pouvoir écrire l'émotion dans le fichier de script lui-même est un flux plus propre que de régler des curseurs clip par clip.
On peut vraiment le télécharger
Les poids ouverts sont la raison pour laquelle la communauté TTS s'est enflammée sur Reddit. Fish Audio publie les poids, le code sur GitHub et la recette de service pour SGLang-Omni, et sa fiche de modèle indique un premier audio en 88,9 ms pour un flux unique sur une H200. Artificial Analysis le classe comme le modèle à poids ouverts n° 1 sur ses trois classements TTS, 15 points devant Voxtral TTS de Mistral en prononciation.
"After getting banned on Eleven Labs three times, I'm so happy something like this is finally open weight. It's fast and sounds great."

Ce même utilisateur l'a fait tourner sur deux RTX 3090 avec environ 39 Go de VRAM avec l'aide de Claude Opus 5.5, ce qui montre à la fois que c'est possible sur du matériel grand public et que ce n'est pas une installation en un clic.
Là où Drama 3 déçoit
Aucun de ces points n'est rédhibitoire. Ce sont des choses que la vidéo de lancement ne mentionne pas et que je voudrais connaître avant de parier une chaîne de production dessus.
C'est le meilleur modèle ouvert, pas le modèle au meilleur rendu
Le titre du n° 1 concerne la précision de prononciation. Quand Artificial Analysis demande aux auditeurs quelle voix ils préfèrent, le tableau change.
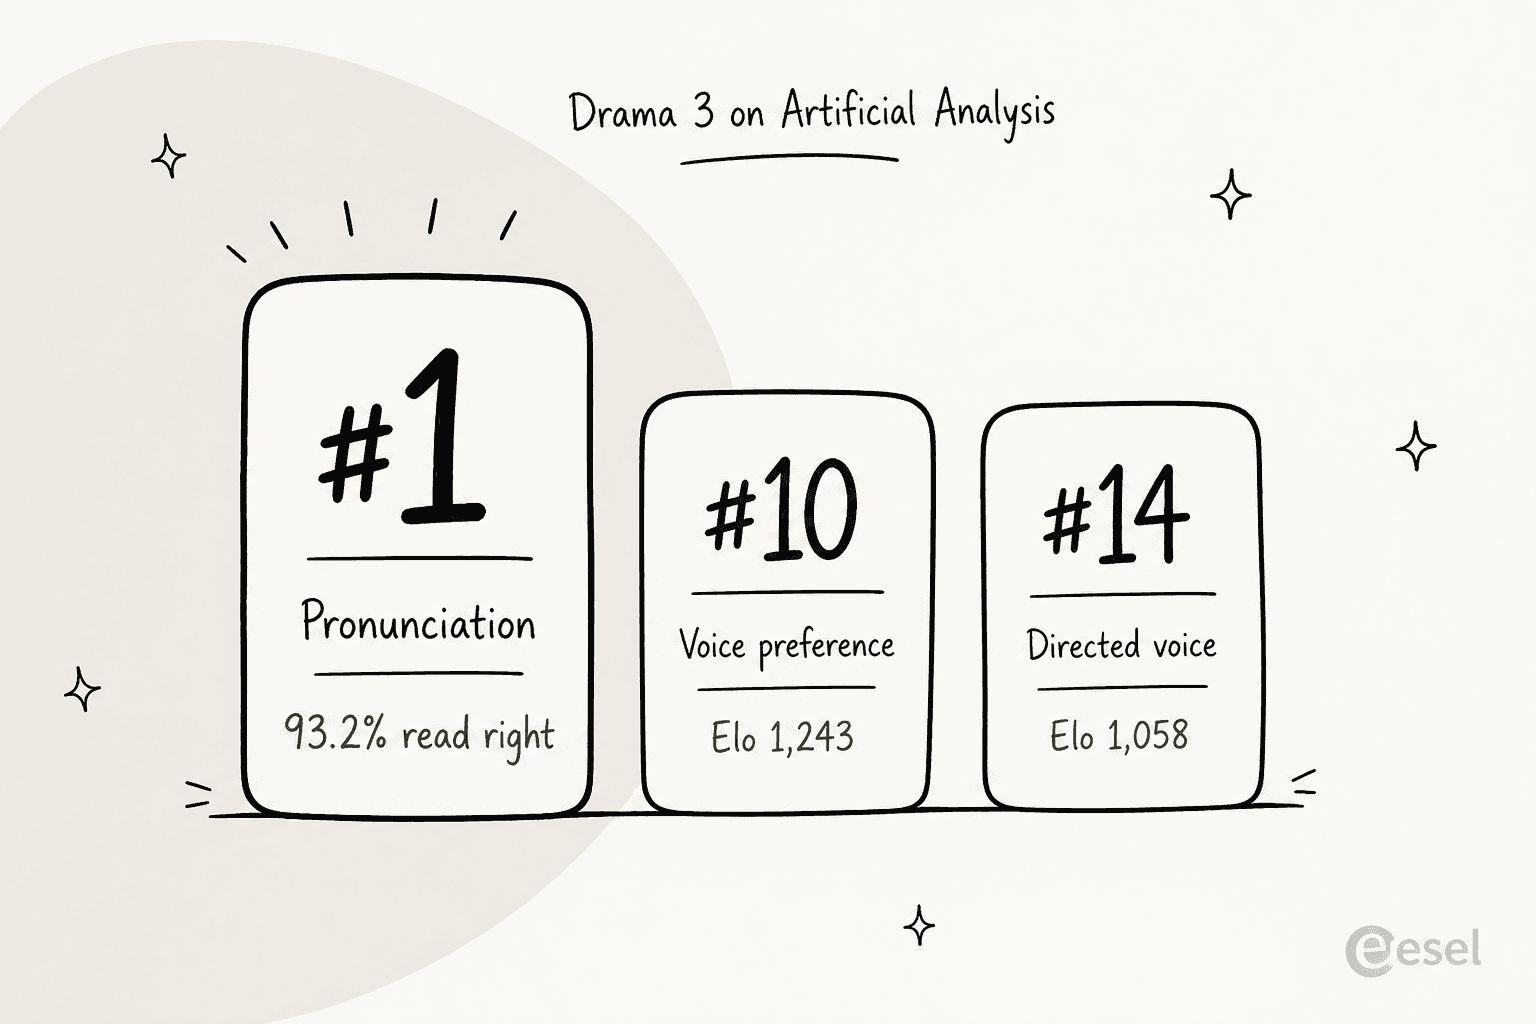
Dans l'arène Provider Voice, Drama 3 a un Elo de 1 243 sur 1 857 duels, classé n° 10, juste derrière Simba 3.2 de Speechify, d'après le fil d'Artificial Analysis. C'est un bond de 101 points par rapport à S2.1 Pro, un grand pas. Mais neuf modèles remportent encore plus de comparaisons à l'aveugle sur la qualité de voix globale, et dans l'arène Controlled Voice il est 14e. Sur Reddit, tout le monde n'était pas convaincu non plus :
"barely better than breeze with nearly 10x the size"
Les prises varient et les outils d'édition ne sont pas encore là
Fish Audio est franche : « Takes vary, so render a few and keep the one that plays », dit l'article de lancement, et la FAQ de la page d'accueil explique l'étiquette Preview de la même manière. C'est acceptable pour un narrateur qui génère un chapitre une fois. C'est un vrai coût pour qui génère des milliers de lignes automatiquement, sans personne pour choisir la meilleure prise.
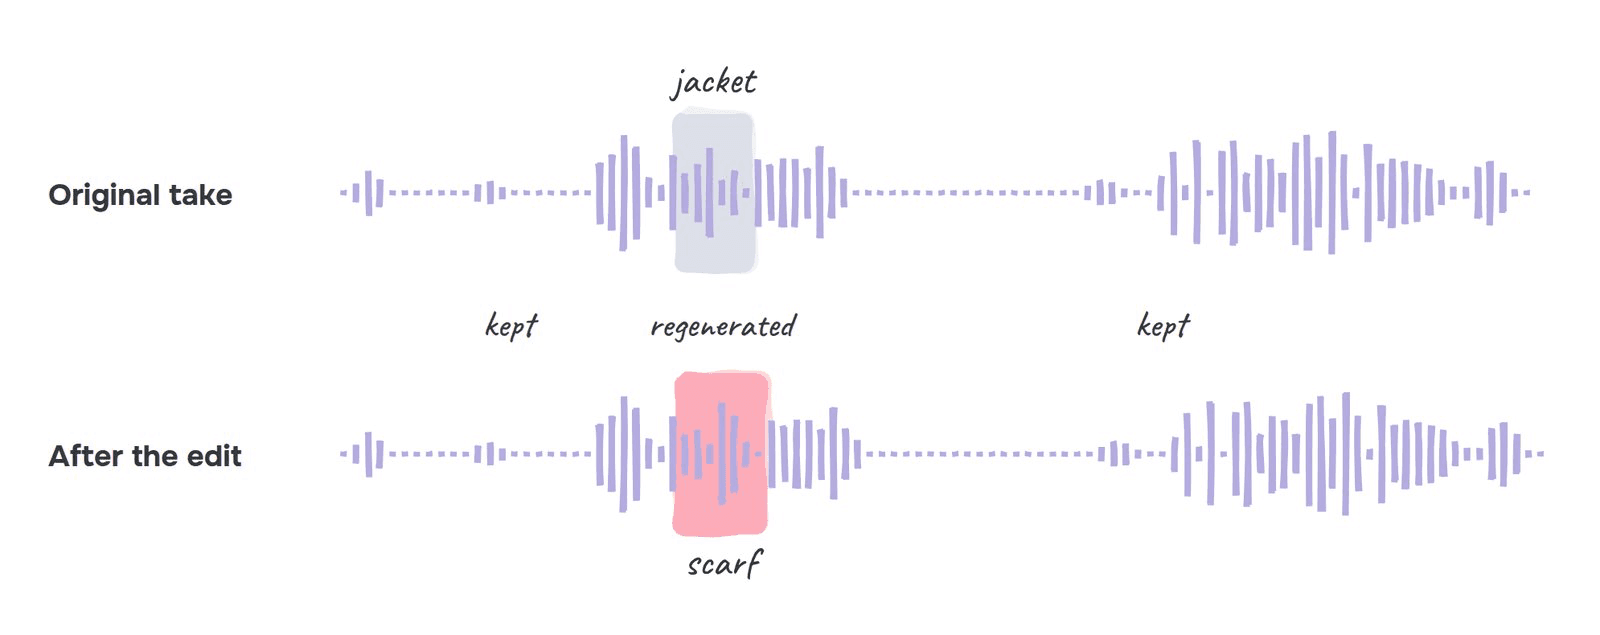
Les deux fonctions qui régleraient l'essentiel, l'édition interactive (« softer than that one ») et l'inpainting audio (régénérer un seul mot dans une prise validée), sont en test sur invitation uniquement, avec une API d'édition « coming soon ».
La licence a un plafond, et le matériel un plancher
La Fish Audio Community License n'est gratuite pour un usage commercial que tant que vous et vos affiliés gagnez moins de 500 000 US$ par an. Au-delà, ou si vous voulez proposer Drama 3 à d'autres comme API vocale, il faut une licence payante. La FAQ de Fish Audio elle-même parle de « open-weight rather than open source », et la communauté l'a remarqué :
"Lame license."
La licence interdit aussi de cloner la voix d'une personne réelle sans consentement, ce que je compte comme un atout. Côté matériel, l'auteur du fil a placé la barre à une carte CUDA de 48 Go ; une quantification communautaire en 4 bits la ramène à 32 Go. Dans les deux cas, ce n'est pas un modèle pour ordinateur portable.
Tarifs de Fish Audio Drama 3
Il y a deux façons de payer : l'API développeur, facturée au texte, ou une formule créateur dans l'application web, facturée en crédits. Le prix de l'API est celui qui comporte une falaise.
| Modèle d'API | Prix | Unité | Source |
|---|---|---|---|
| Drama 3, offre de lancement (13 oct. au 12 nov. 2026) | 10 $ | par million de caractères | Article de lancement |
| Drama 3, prix catalogue | 50 $ | par million de caractères | Article de lancement |
| S2.1 Pro | 15 $ | par million d'octets UTF-8 | Documentation des tarifs de l'API |
| S2.1 Pro Free | 0 $ | par million d'octets UTF-8 | Documentation des tarifs de l'API |
Deux points à surveiller. D'abord, au 14 octobre, le tableau officiel des tarifs dans la documentation ne liste pas drama-3 du tout, donc l'article de lancement est le seul endroit où Fish Audio donne le chiffre. Ensuite, au prix catalogue, Drama 3 coûte 3,3 fois ce que coûte S2.1 Pro, donc après le 12 novembre vous payez une prime pour le jeu d'acteur, pas pour la voix. La documentation de Fish Audio situe 1 million d'octets UTF-8 à environ 180 000 mots anglais, soit environ 12 heures de parole ; pour du texte anglais, un caractère vaut un octet, donc les unités concordent.
Saisissez votre propre volume mensuel pour voir où tombe le changement du 12 novembre :
Un exemple concret : un roman de 90 000 mots représente environ un demi-million de caractères. Le narrer une fois coûte environ 5 $ avec Drama 3 au prix de lancement, 25 $ au prix catalogue et 7,50 $ avec S2.1 Pro. Générez chaque chapitre trois fois pour choisir la meilleure prise et ces chiffres triplent. Pour un créateur indépendant, cela reste bon marché ; pour une plateforme qui met en voix des millions de mots par mois, c'est le prix catalogue qu'il faut budgéter.
Côté créateurs, Fish Audio indique que Drama 3 utilise les mêmes crédits que S2.1 Pro, soit environ 600 à 625 crédits par minute d'audio d'après la page des formules.
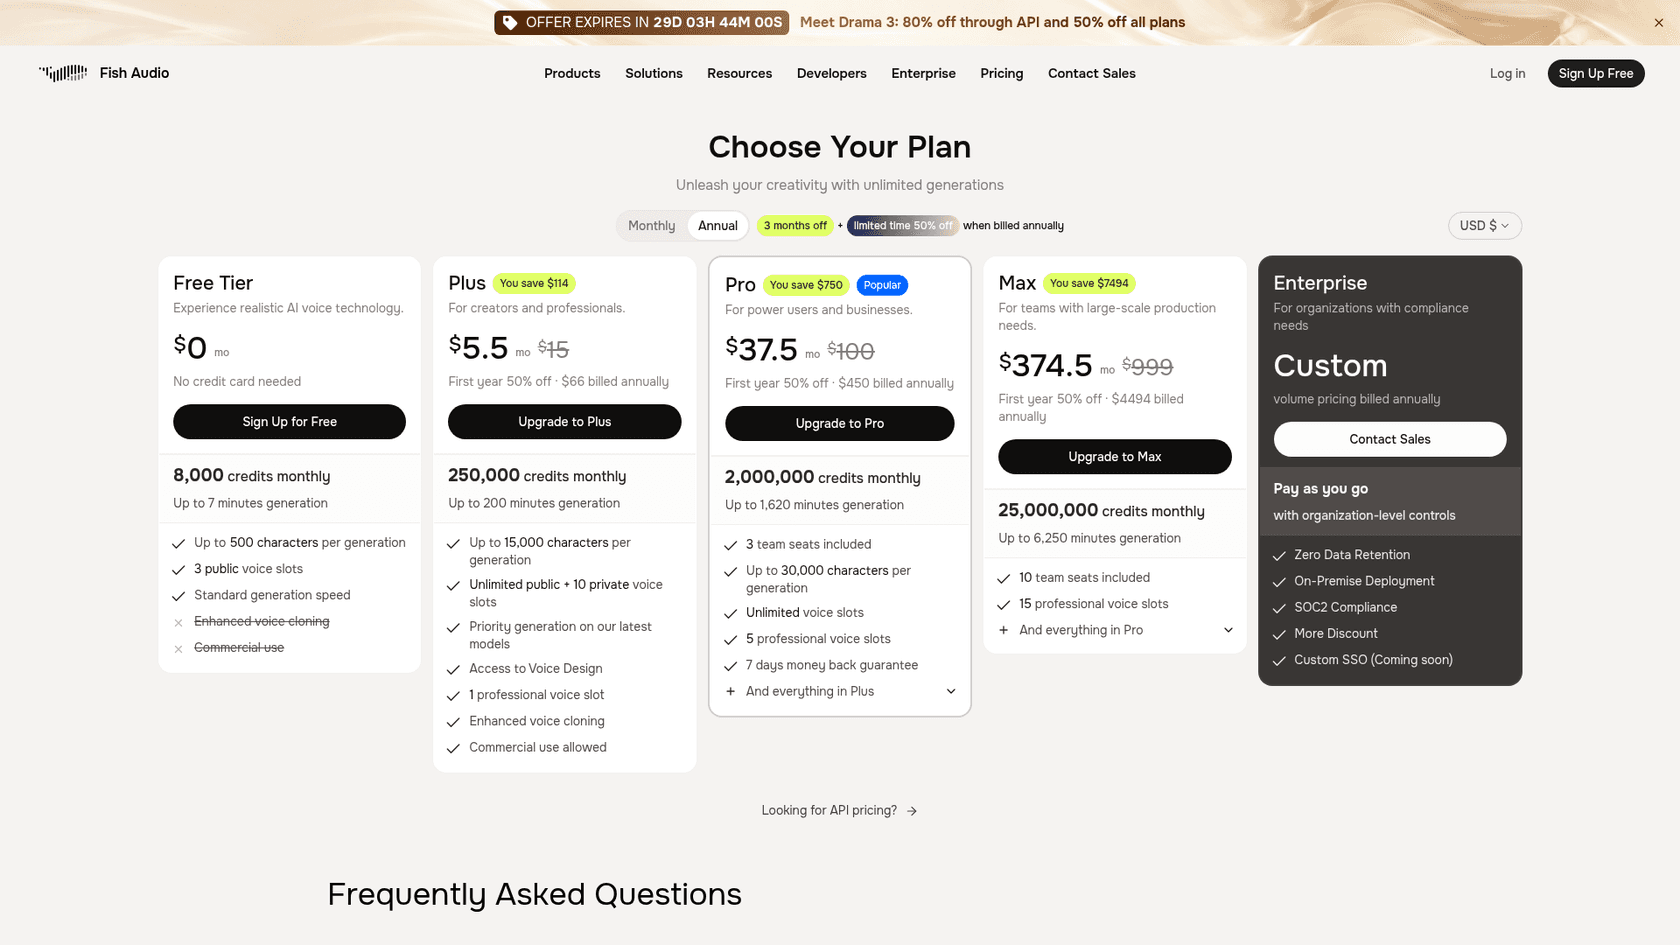
| Formule | Prix catalogue mensuel | Première année, annuelle (offre de lancement) | Crédits par mois | Audio par mois | Caractères par génération | À savoir |
|---|---|---|---|---|---|---|
| Free | 0 $ | 0 $ | 8 000 | Jusqu'à 7 min | 500 | Pas de clonage de voix, pas d'usage commercial |
| Plus | 15 $ | 66 $ | 250 000 | Jusqu'à 200 min | 15 000 | Usage commercial, Voice Design, 1 emplacement de voix professionnelle |
| Pro | 100 $ | 450 $ | 2 000 000 | Jusqu'à 1 620 min | 30 000 | 3 sièges d'équipe, 5 emplacements de voix professionnelle |
| Max | 999 $ | 4 494 $ | 25 000 000 | Jusqu'à 6 250 min | 30 000 (comme Pro) | 10 sièges d'équipe, 15 emplacements de voix professionnelle |
| Enterprise | Sur mesure | Sur mesure | Sur mesure | Sur mesure | Sur mesure | Zéro rétention de données, on-premise, SOC 2 |
Jusqu'au 12 novembre, les nouveaux abonnements Plus, Pro et Max sont à moitié prix le premier mois en facturation mensuelle, ou la première année en facturation annuelle. Les crédits inutilisés ne sont pas reportés. Les entreprises qui quittent un autre fournisseur vocal obtiennent les trois premiers mois gratuits, selon le communiqué de presse.
Comment Drama 3 se compare
Voici sa place face aux modèles vocaux auxquels on le comparera le plus probablement. Les scores de prononciation viennent du même classement Artificial Analysis ; pour le prix de chaque concurrent, suivez le lien vers mon décryptage.
| Modèle | Prononciation (AA) | Poids ouverts | Avis | Tarifs |
|---|---|---|---|---|
| Fish Audio Drama 3 | 93,2 % (n° 1) | Oui, licence plafonnée en revenus | Vous le lisez | 10 $ lancement / 50 $ catalogue par million de caractères |
| Eleven v4 | 91,7 % | Non | Avis sur ElevenLabs | Tarifs d'Eleven v4 |
| Gemini 3.8 Flash TTS | 89,5 % | Non | Avis sur Gemini TTS | Tarifs de Gemini TTS |
| Fish Audio S2.1 Pro | 88,1 % | Famille S2, licence de recherche | Traité plus haut | 15 $ par million d'octets, offre gratuite |
Deux remarques que le tableau ne peut pas contenir. Gemini 3.8 Flash TTS bat Drama 3 sur les mots dépendant du contexte (97,9 % contre 95,3 %), donc testez les deux si vos scripts regorgent de mots comme « read » et « lead » (fil AA). Et si ElevenLabs est votre outil actuel, mon décryptage des tarifs d'ElevenLabs est la base de comparaison équitable.
Si votre usage est un agent vocal en temps réel plutôt qu'un script généré, l'ensemble de comparaison change entièrement. Commencez par mon avis sur Cartesia Sonic 3, conçu autour de la latence. L'article sur Grok Voice Think Fast 2 couvre le versant parole-à-parole.
Pour la voix guidée par l'émotion en particulier, Hume AI est l'autre nom à regarder, et mon article sur les tarifs de Hume AI donne ses chiffres. Si vous hésitez encore entre modèles de parole et modèles de transcription, Whisper vs API TTS démêle les deux.
Qui devrait utiliser Drama 3, et qui devrait passer son tour
Fish Audio est d'une honnêteté inhabituelle sur son point fort : « Drama 3 does its best work on scripted lines you render once and keep. » Je le prendrais au pied de la lettre.
Utilisez-le si vous êtes :
- Producteur de livres audio ou de fictions sonores. La direction dans le script, une prononciation de premier plan et des scènes à plusieurs personnages en une passe correspondent exactement à votre flux de travail.
- Un studio de jeux ou d'animation. La direction ligne par ligne et les balises au niveau du mot battent le réenregistrement, et les poids ouverts permettent de l'exécuter en interne si vous êtes sous le plafond de revenus.
- Créateur de vidéos courtes. L'Auto Tag de l'application web et la remise de lancement de 50 % le rendent peu coûteux à essayer. Pour les visuels, un outil d'avatars comme HeyGen s'associe bien. Mon guide de la création de contenu par IA couvre le reste de la chaîne.
- Un développeur qui veut une voix auto-hébergeable. C'est la meilleure option ouverte sur Artificial Analysis aujourd'hui, avec une recette de service publiée.
Passez votre tour, ou attendez, si vous :
- Faites de la voix en direct à gros volume. La variation d'une prise à l'autre et la prime de 3,3x au prix catalogue sur S2.1 Pro vous orientent vers S2.1 Pro ou un modèle temps réel. Ma liste des meilleurs agents vocaux IA les couvre.
- Êtes une entreprise au-dessus de 500 000 US$ de revenus qui prévoit d'auto-héberger. Budgétez d'abord la discussion sur la licence commerciale.
- Avez simplement besoin d'une narration simple. S2.1 Pro lit bien le texte brut et coûte moins ; vous paieriez un jeu d'acteur que vous n'utilisez pas.
Si vous êtes ici parce que vous pensez à la voix pour le support client, une mise en garde côté support de mon métier : la voix est rarement le plus difficile. Une voix expressive qui lit une mauvaise réponse reste une mauvaise réponse, c'est pourquoi je lirais d'abord sur les hallucinations de l'IA dans le support et regarderais des agents vocaux IA pour le support conçus pour cela, comme Decagon Voice 3, avant de me tourner vers un modèle de performance.
eesel pour les équipes qui transforment l'écrit en audio
Drama 3 est un modèle vocal. Il lit ce qu'on lui donne, magnifiquement, mais il ne décide pas de ce qui vaut la peine d'être dit. Si vous transformez des articles de blog en audio narré, en podcasts ou en scripts vidéo, le goulot d'étranglement se situe généralement une étape plus tôt : obtenir un script documenté et exact au départ.
C'est le travail du rédacteur de blog IA d'eesel. C'est un coéquipier IA qui étudie un sujet à partir de sources primaires, rédige l'article long dans la voix de votre marque, génère les images et vous remet un brouillon prêt à publier, ou à injecter directement dans Drama 3. Voyez le partage ainsi : Drama 3 est l'interprète, eesel est l'auteur que vous avez embauché. Vous pouvez voir ce qu'il vaut dans mon avis sur le rédacteur de blog IA, et comment il s'intègre dans le recyclage de contenu.
Envie d'un script qui mérite d'être dirigé ? Écrivez votre prochain article avec eesel et consultez les tarifs quand vous serez prêt. Essayer eesel.