

Qu'est-ce que Fish Audio Drama 3 ?
Je construis des agents d'IA chez eesel, donc je lis chaque lancement de modèle vocal avec une question : cela change-t-il ce qu'une équipe peut livrer, ou seulement le son d'une démo ? Drama 3 est du type le plus intéressant, parce que le changement est dans l'interface. Au lieu de choisir une émotion prédéfinie dans un menu, vous écrivez une indication de mise en scène.
Fish Audio le décrit comme un modèle conçu pour la direction : en plus de votre script, vous décrivez comment une réplique doit être jouée, vous ajoutez des sons et des pauses, et vous limitez un effet à certains mots. Le rapport technique ajoute la mécanique. L'ossature est un modèle à mélange d'experts de 35 Md de paramètres qui en active environ 3 Md par jeton, initialisé à partir de Qwen3.5-35B-A3B (voyez mon aperçu de Qwen si cette famille est nouvelle pour vous), plus un nouveau décodeur audio qui prédit dix codebooks par trame.
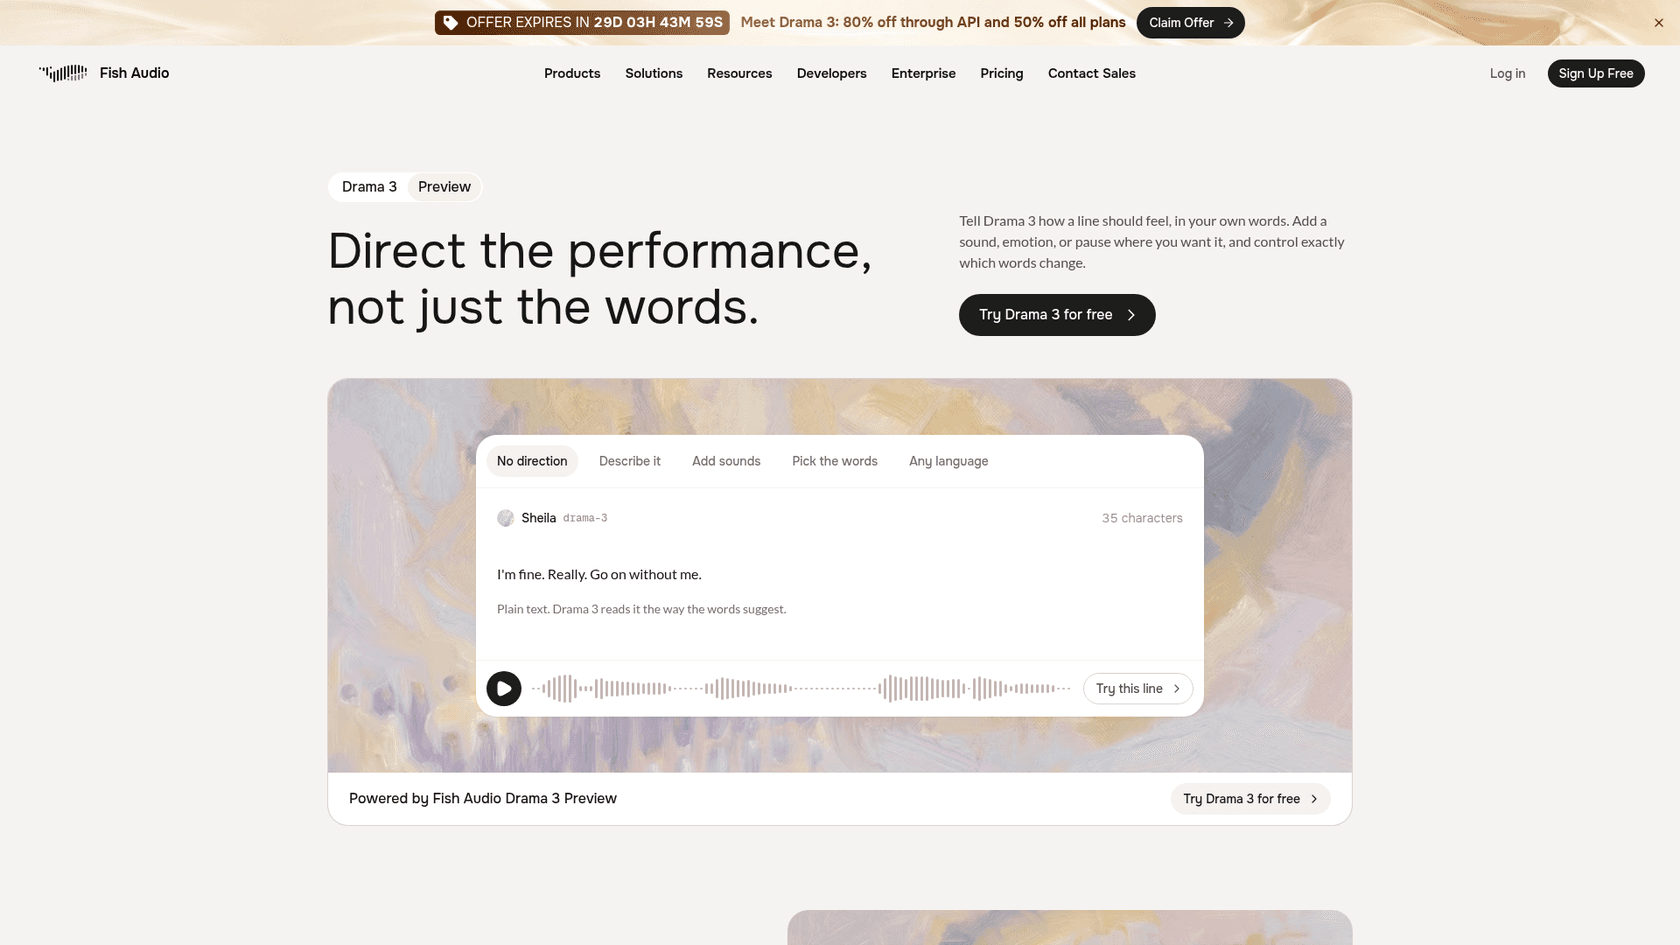
Il y a aussi un bref historique. Fish Audio a annoncé une préversion le 23 septembre, accessible via la chaîne de modèle drama-3-preview, et a livré le modèle final le 13 octobre. La page d'accueil porte encore un badge "Preview", alors attendez-vous à des finitions après le lancement. Fish Audio n'est pas un petit laboratoire : son communiqué de presse de lancement cite 15 millions d'utilisateurs et 21 millions de dollars de revenu annuel récurrent.
Quoi de neuf par rapport à S2.1 Pro ?
Le résumé honnête : l'interface est restée, l'interprétation a changé. Les deux modèles acceptent des indications entre crochets, parlent 83 langues et reposent sur le même endpoint POST /v1/tts. Drama 3 ajoute un respect plus fidèle de l'indication, des balises délimitées pour des mots isolés et un objectif d'entraînement différent.
| S2.1 Pro | Drama 3 | |
|---|---|---|
Indication entre [crochets] | Oui | Oui, avec plus de sentiment selon Fish Audio |
Balises délimitées (<whisper>, <emphasis>, <slow>...) | Non listées dans l'aperçu des modèles | Oui, sept balises |
| Langues | 83 | 83 |
| Pronunciation Robustness (Artificial Analysis) | 88,1 % | 93,2 % |
| Prix de l'API par million | 15 $ | 50 $ au tarif public, 10 $ jusqu'au 12 nov. |
| Poids | API hébergée | Poids ouverts, Community License |
Sources : aperçu des modèles de Fish Audio pour S2.1 Pro, article de lancement de Drama 3 pour le reste.
Le changement d'entraînement est la partie que je trouve la plus crédible. Fish Audio explique que la plupart des modèles vocaux, dont son propre S2, sont réglés avec des récompenses pour être faciles à transcrire et ressembler à l'extrait de référence, et que ces scores pénalisent un rire ou un murmure. Drama 3 est réglé avec un unique modèle appris des prises que les gens ont préférées, si bien qu'un rire demandé n'est pas sanctionné. C'est une explication plausible de la raison pour laquelle un modèle peut être plus expressif sans devenir plus approximatif sur les mots.
Comment dirige-t-on une réplique ?
La direction est du texte simple dans votre script, en trois couches que vous pouvez mélanger librement. Les crochets avant une réplique fixent la façon de la jouer, écrits comme vous briefieriez un comédien de doublage. Les crochets peuvent aussi contenir un son ou une pause à l'endroit où elle doit tomber, comme [shaky breath]. Des balises par paires limitent un effet à quelques mots : <whisper>, <emphasis>, <soft>, <fast>, <slow>, <stress> et <forceful>.
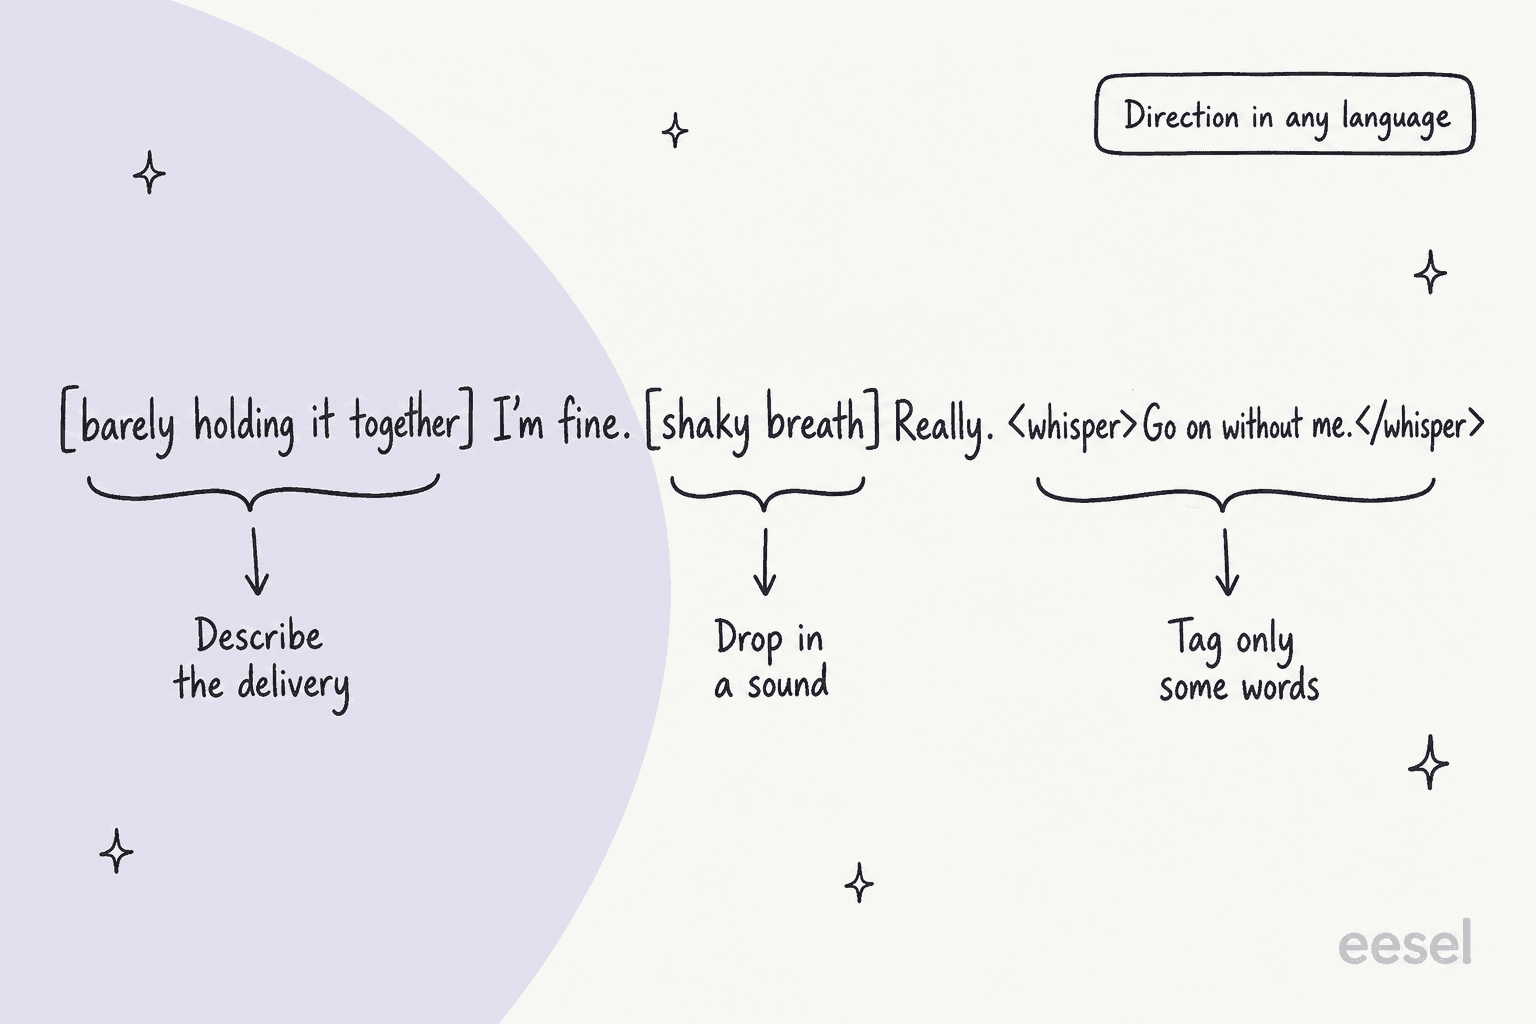
La direction n'a pas besoin d'être en anglais. La documentation de Drama 3 montre un crochet en chinois, un en espagnol et un en japonais sur la même réplique en anglais, et Fish Audio affirme que l'interprétation suit l'indication quelle que soit la langue dans laquelle elle est écrite. Une balise de langue pour basculer en milieu de réplique, comme <french>...</french>, existe mais est étiquetée comme expérimentale, avec une précision qui varie selon la langue et la voix.
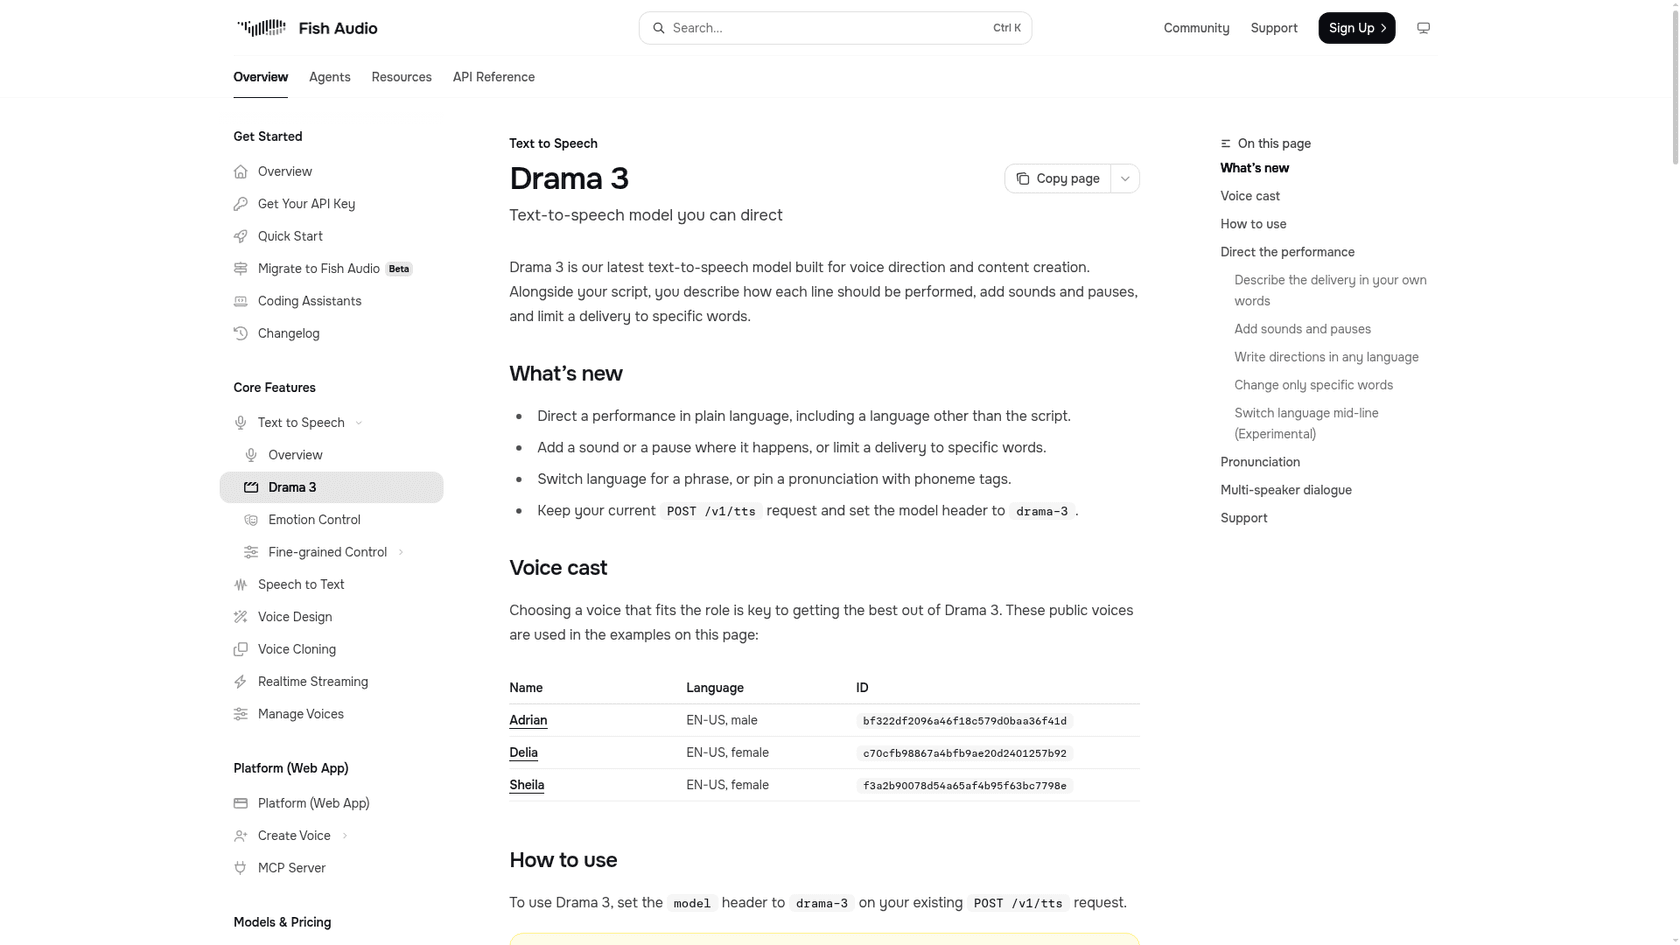
Deux détails comptent si vous automatisez cela par script. D'abord, les scènes à plusieurs voix utilisent des balises de style <|speaker:0|> avec un identifiant de voix par locuteur passé sous forme de tableau dans reference_id, et la fiche du modèle sur Hugging Face indique qu'un texte peut contenir jusqu'à 16 personnages. Ensuite, un en-tête model absent ou mal orthographié n'échoue pas : la requête retombe silencieusement sur s2.1-pro. Si votre audio sonne soudain plus plat que les démos, vérifiez l'en-tête avant d'accuser le modèle.
Un exemple à reprendre dans la documentation est [barely holding it together, forcing a smile] I'm fine. [shaky breath] Really. [small laugh] Go on without me. C'est une réplique avec trois fonctions différentes, et le moyen le plus rapide de savoir si le modèle suit la direction avec votre voix.
Que vaut Drama 3 dans les tests indépendants ?
Le blog de Fish Audio affirme que Drama 3 est premier chez Artificial Analysis sur la Pronunciation Robustness. Artificial Analysis le confirme, et ses chiffres tracent aussi les limites de cette affirmation.
"Drama 3 Preview is the #1 open weights model on all three of our Text to Speech leaderboards."
| Mesure d'Artificial Analysis | Drama 3 Preview | Point de référence |
|---|---|---|
| Pronunciation Robustness | 93,2 %, rang 1 | Eleven v4 91,7 %, Eleven v4 Turbo 90,1 %, S2.1 Pro 88,1 % |
| Arène Provider Voice (Elo) | 1 243, rang 10 | S2.1 Pro 1 142 (un gain de 101 points) |
| Arène Controlled Voice (Elo) | 1 058, rang 14 | n/d |
| Meilleur rival à poids ouverts en prononciation | n/d | Voxtral TTS de Mistral à 78,1 % |
Source : fil d'Artificial Analysis, 13 octobre 2026.
Lisez ce tableau comme un acheteur doit le faire. L'avance en prononciation est réelle, et l'écart sur tout modèle à poids ouverts est de 15 points, ce qui compte si votre script est plein de noms de marque, de codes et de chiffres. Face à Eleven v4, la marge est de 1,5 point. À l'écoute à l'aveugle, en revanche, Drama 3 est 10e dans l'arène Provider Voice, donc "most emotive in the world" est la description de Fish Audio, pas un classement que quelqu'un d'autre ait établi pour l'instant. Le bond par rapport à S2.1 Pro est le chiffre le plus utile : 101 points Elo entre deux modèles du même laboratoire.
La réaction de la communauté lors du premier jour correspond à cette dualité. Un utilisateur qui a fait tourner les poids sur sa propre machine a écrit :
"It's fast and sounds great."

Un autre a été plus direct sur le compromis de taille :
"barely better than breeze with nearly 10x the size"
Ce commentaire compare Drama 3 à Breeze TTS 2, un modèle ouvert qu'Artificial Analysis classe juste derrière dans l'arène Provider Voice (1 221 contre 1 243). Les deux choses sont vraies : l'avance est faible, et l'écart entre modèles ouverts l'est aussi.
Comment accéder à Drama 3 ?
Il y a quatre voies, qui conviennent à des profils différents.
- Application web et applications mobiles. Ouvrez Text to Speech sur fish.audio avec
?version=drama-3, ou utilisez les applications iOS et Android. La page d'accueil propose Drama 3 en essai gratuit, et la voix sous licence d'Uncle Roger est disponible pour ses piques. - API. Gardez votre requête
POST /v1/ttset ajoutez l'en-têtemodel: drama-3. Le fil de lancement de Fish Audio cite des partenaires du jour J dont ComfyUI, Runway, Pika, OpenRouter et Vercel, mais je n'ai vérifié que l'annonce de ComfyUI, qui indique qu'il fonctionne comme un Partner Node. Si vous utilisez déjà Runway, vérifiez si son nœud expose la même syntaxe de direction. - Poids ouverts. Le modèle est sur Hugging Face, avec un service SGLang-Omni dès le premier jour.
- Entreprise. Le communiqué de presse de Fish Audio indique que les entreprises qui quittent un autre fournisseur vocal ont les trois premiers mois gratuits ; c'est une discussion commerciale.
Pour les équipes de support et d'exploitation qui jonglent déjà avec plusieurs fournisseurs vocaux, le panorama des agents vocaux et ma liste des entreprises de voix IA montrent où se situe un modèle comme celui-ci par rapport aux plateformes d'agents complètes.
Combien coûte Drama 3 ?
Commencez par l'API, car le prix est le chiffre le plus confus de ce lancement. L'article de lancement de Fish Audio indique que Drama 3 est affiché à 50 $ le million de caractères, et du 13 octobre au 12 novembre il bénéficie de 80 % de remise, soit 10 $. La documentation tarifaire et la page développeurs de Fish Audio ne listent encore que S2.1 Pro à 15 $ et n'ont aucune ligne Drama 3 au 14 octobre, et la documentation facture en octets UTF-8 plutôt qu'en caractères. Pour du texte anglais simple, les deux sont proches, mais vérifiez votre tableau de bord avant de budgéter.
"Drama 3 Preview is available via the Fish Audio API at $15/1M characters, the same as S2.1 Pro, compared to Eleven v4 at $80/1M characters and Eleven v4 Turbo at $40/1M characters."
C'est une mention du jour du lancement pour le modèle en préversion, je la traiterais donc comme de l'histoire. Budgétez au tarif public de 50 $ et considérez les 10 $ comme une remise d'un mois. La page des tarifs API d'ElevenLabs affiche v4 à 0,08 $ les 1 000 caractères et v4 Turbo à 0,04 $, soit 80 $ et 40 $ le million.
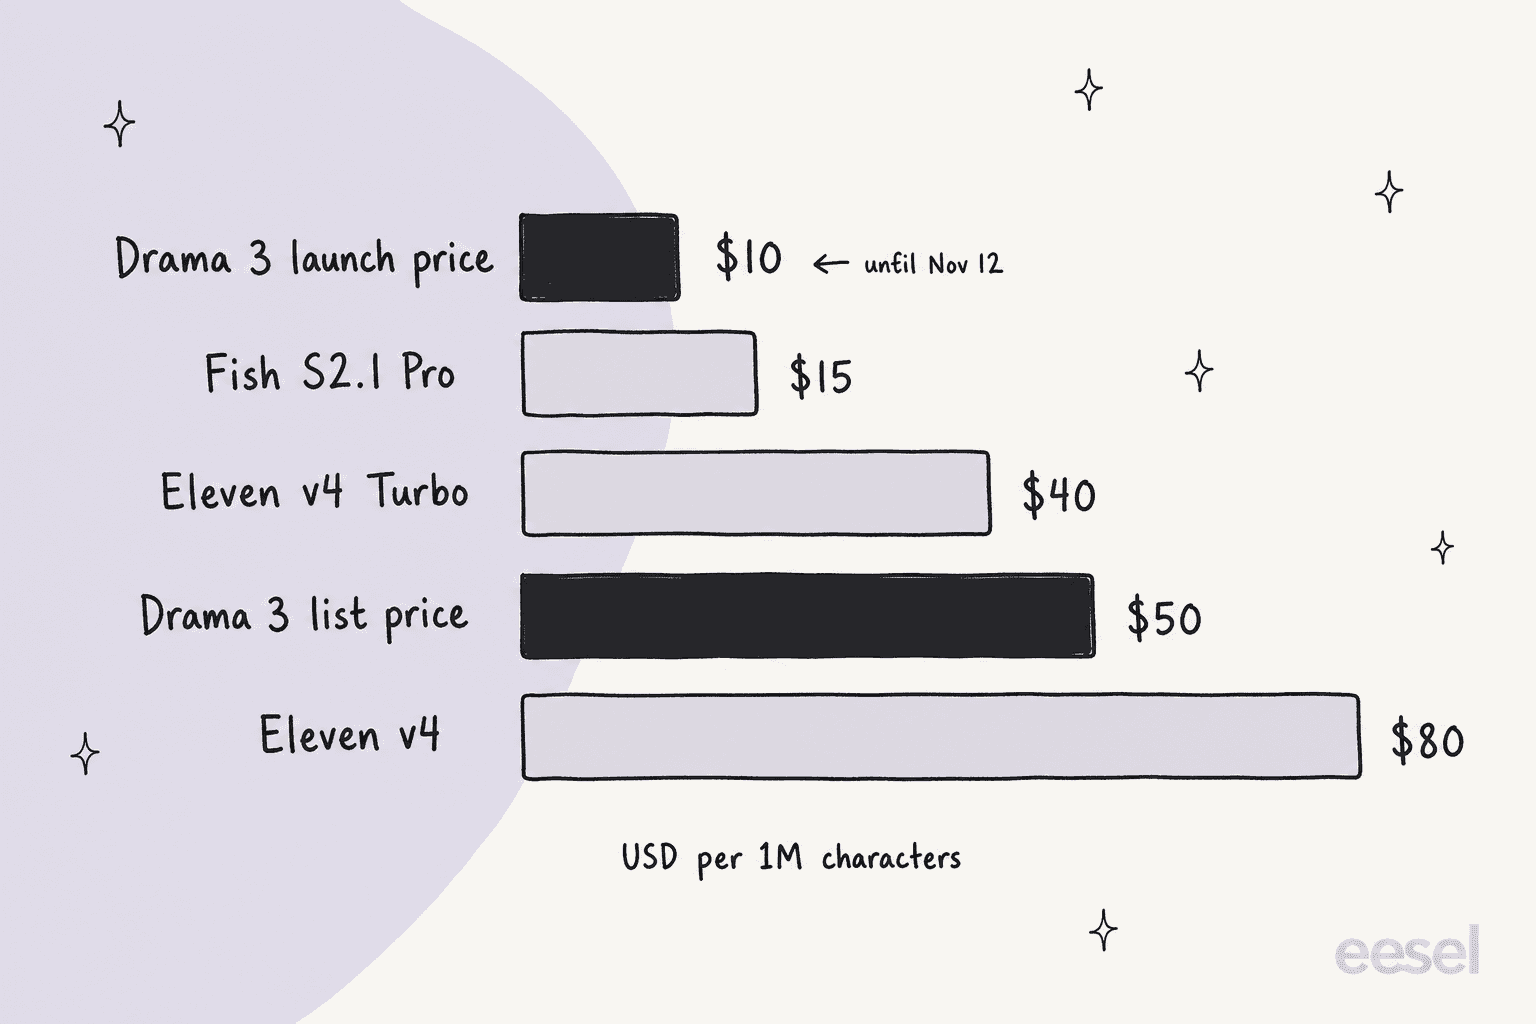
Voici ce que coûte un travail de 450 000 caractères, soit environ un roman de 80 000 mots, avec le même nombre de caractères sur chaque ligne :
| Voie | Tarif par million de caractères | Coût pour 450 000 caractères |
|---|---|---|
| Drama 3, prix de lancement (jusqu'au 12 nov.) | 10 $ | 4,50 $ |
| Drama 3, tarif public | 50 $ | 22,50 $ |
| Eleven v4 Turbo | 40 $ | 18,00 $ |
| Eleven v4 | 80 $ | 36,00 $ |
| Drama 3 auto-hébergé | Temps GPU seulement | Gratuit sous 500 000 US$ de chiffre d'affaires |
Au tarif public, Drama 3 est moins cher qu'Eleven v4 mais plus cher que Turbo, donc le choix porte sur la voix plutôt que sur la facture. Pour des analyses plus détaillées, voyez mes guides des tarifs d'Eleven v4 et des tarifs d'ElevenLabs, ainsi que les tarifs de Gemini 3.8 Flash TTS si vous hésitez avec Google.
Les applications fonctionnent différemment. Drama 3 coûte les mêmes crédits que S2.1 Pro, et jusqu'au 12 novembre un nouveau forfait Plus, Pro ou Max est à moitié prix le premier mois en facturation mensuelle ou la première année en facturation annuelle.
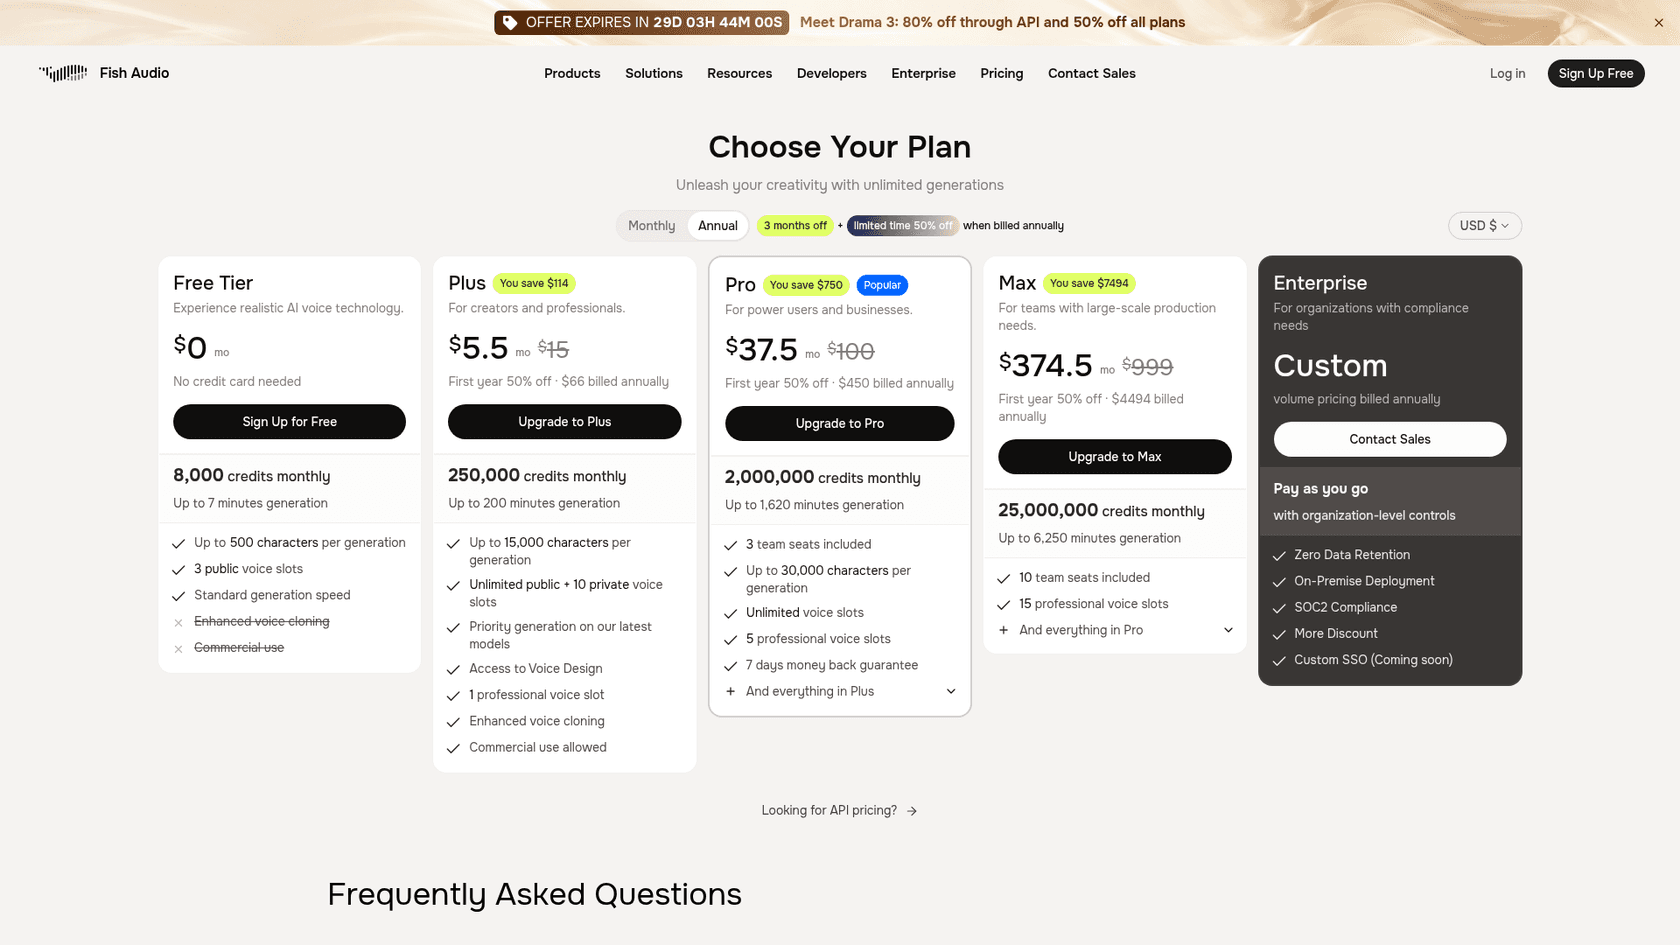
| Forfait | Prix affiché (annuel, première année) | Crédits par mois |
|---|---|---|
| Free | 0 $ | 8 000, jusqu'à 500 caractères par génération, pas d'usage commercial |
| Plus | 5,50 $ par mois, 15 $ barré | 250 000 |
| Pro | 37,50 $ par mois, 100 $ barré | 2 000 000, 3 sièges d'équipe |
| Max | 374,50 $ par mois, 999 $ barré | 25 000 000, 10 sièges d'équipe |
| Enterprise | Sur mesure | Paiement à l'usage, SOC 2, zéro rétention des données |
Source : page des forfaits de Fish Audio, consultée le 14 octobre 2026. Les prix barrés sont les tarifs après l'offre.
Peut-on faire tourner Drama 3 soi-même ?
Oui, sous conditions. Les poids sont sur Hugging Face sous la Fish Audio Community License v1.0. Elle est gratuite pour la recherche et l'usage non commercial, et gratuite pour un usage commercial si vous et vos sociétés affiliées réalisez moins de 500 000 US$ de chiffre d'affaires annuel. Au-delà, ou pour proposer Drama 3 à des tiers comme service de synthèse vocale, de clonage de voix ou d'inférence, il vous faut une licence de Fish Audio. Elle interdit aussi de cloner la voix d'une personne réelle sans son consentement. Fish Audio parle de publication à poids ouverts plutôt que d'open source, et c'est le terme exact.
Le matériel est l'autre limite. La fiche du modèle indique 36 Md de paramètres en FP8 et bf16, et les retours de la communauté le jour du lancement allaient de "needs a 48gb Cuda card" à une exécution sur deux GPU grand public :
"Opus 5.5 was able to get it running on my two RTX 3090s at ~39gb of VRAM."
Les chiffres de Fish Audio proviennent de NVIDIA H200. Sur une H200 avec un seul flux, la fiche Hugging Face indique un délai médian avant le premier audio de 88,9 ms, et à 16 flux simultanés la médiane est de 210,1 ms. La licence a fait grincer quelques dents, et un commentateur a répondu avec justesse :
"License is a bit lame but I understand they need to make money too lol"
Si vous comparez l'auto-hébergement à une voie gérée, mon panorama des agents d'IA open source couvre le même compromis pour les logiciels d'agents.
Quelles sont les limites de Drama 3 ?
Six choses à savoir avant d'engager un projet dessus :
- Il vise les répliques générées. L'article de lancement de Fish Audio dit lui-même que Drama 3 donne le meilleur sur des répliques scénarisées que l'on génère une fois et que l'on garde, comme les livres audio, les fictions sonores, les jeux et les vidéos courtes. La conversation en direct est un autre métier ; comparez Eleven v4 Turbo ou Cartesia Sonic 3 pour cela.
- Les prises varient. Fish Audio vous conseille d'en générer quelques-unes et de garder celle qui passe.
- L'édition n'est pas encore ouverte. L'édition interactive et l'inpainting audio sont en test restreint sur invitation, avec une API d'édition "coming soon".
- Le changement de langue est expérimental. Les balises de style
<french>ne sont pas garanties pour chaque langue ou voix. - La licence a des conditions. Le plafond de chiffre d'affaires et l'interdiction de revendre un service comptent pour quiconque construit un produit vocal par-dessus.
- La ligne de prix n'est pas encore dans la documentation. Voir plus haut.
Je ne lirais pas non plus les 83 langues comme 83 langues d'égale qualité. Les scores de prononciation de Fish Audio ne portent que sur l'anglais, alors testez la langue dont vous avez réellement besoin, comme un utilisateur de Reddit l'a demandé le jour du lancement pour l'allemand, sans réponse pour l'instant. Pour un travail multilingue face aux clients, mon guide du contrôle qualité du support multilingue explique comment vérifier chaque langue séparément.
Qui devrait utiliser Drama 3, et qui devrait s'en passer ?
Utilisez-le pour les livres audio, les podcasts de fiction, les dialogues de jeux et les vidéos courtes où chaque réplique est générée, relue et conservée. Les balises délimitées sont la fonction qui justifie la mise à niveau : corriger un mot dans une réplique coûte moins cher que régénérer un chapitre, ce que la PDG de Fish Audio, Rissa Cao, présente comme l'enjeu du long format. Si vous écrivez des scripts de vidéos ou de podcasts, les générateurs de scripts de podcast IA et les outils de scripts vidéo IA s'y marient naturellement.
Regardez les alternatives si vous voulez la voix la plus éprouvée à l'écoute à l'aveugle ; dans ce cas, ElevenLabs et Cartesia sont les comparaisons évidentes, ou une couche d'émotion à la Hume AI. Mon article sur les alternatives à ElevenLabs les met en regard.
Passez votre tour pour l'instant si vous avez besoin d'un agent téléphonique en direct clé en main. Drama 3 est une voix, pas un agent, donc il vous faut encore quelque chose qui décide quoi dire et quand passer la main. Pour cela, voyez Retell AI, Vapi, Decagon Voice 3 et Grok Voice Think Fast 2. Si vous comparez seulement des API vocales sur le coût et la simplicité, l'API vocale d'OpenAI et Whisper vs l'API TTS sont les références les plus sobres.
Que signifie un modèle vocal pour une équipe de support ?
Un modèle vocal change le son d'une réponse, pas son exactitude. Un client qui entend une politique de remboursement chaleureuse et bien rythmée reçoit quand même le mauvais délai de remboursement si l'agent derrière a deviné. Les voix expressives rendent les erreurs plus convaincantes, c'est pourquoi la couche du dessous m'importe.
Le schéma que je vois sans cesse dans les files réelles, c'est que les équipes veulent de la voix mais commencent par les tickets. Une équipe de support utilisant eesel a écrit que l'absence de prise en charge des enregistrements vocaux obligeait les agents à résumer les appels à la main pour l'IA, et que l'ajouter "would significantly increase our usage". C'est une demande de fonctionnalité, et je ne vais pas la surévaluer : eesel est aujourd'hui centré sur le texte, et traite des tickets et des chats plutôt que de l'audio téléphonique. La configuration utile consiste à obtenir d'abord les bonnes réponses en texte, puis à les transmettre au modèle vocal qui convient.
Si vous réfléchissez à la voix pour le support, les outils de support client par la voix et les agents vocaux IA de Zendesk sont de bons points de départ, et l'IA conversationnelle pour le service client couvre la couche qui précède la voix. Gardez aussi la voix cohérente avec votre marque ; un modèle qui suit la direction n'est utile que si quelqu'un écrit cette direction.
Essayer eesel
Si votre équipe évalue la voix parce que les tickets et les chats s'accumulent, commencez là où les réponses se fabriquent. Le coéquipier IA pour helpdesk d'eesel rejoint le helpdesk que vous utilisez déjà, apprend de vos anciens tickets et de votre centre d'aide, et répond avec votre ton. Avant qu'il touche un client réel, vous pouvez le lancer sur des tickets historiques pour voir ce qu'il aurait dit, ce qui est aussi la façon dont je testerais le script de n'importe quelle couche vocale.

Si vous préférez un terminal, la CLI d'eesel permet à vous, à un script ou à un agent de code comme Claude Code de lire et de modifier les instructions du même coéquipier et d'examiner son activité, comme vous géreriez n'importe quel autre service. L'offre gratuite inclut 100 crédits sans carte, et la page des tarifs présente les niveaux payants. Essayez eesel sur les tickets du mois dernier avant de décider quoi que ce soit au sujet de la voix.
Comment utiliser Drama 3 via l'API ?
POST /v1/ttsactuelle et définissez l'en-têtemodel: drama-3. Un en-tête absent ou mal orthographié revient às2.1-prosans erreur, alors vérifiez-le d'abord si l'audio sonne plat. Le même appel fonctionne depuis des scripts et des agents de code, un peu comme la CLI d'eesel le fait pour un coéquipier de support.