

Mon verdict en un coup d'œil
Si vous ne lisez qu'une section, lisez ce tableau. C'est l'avis condensé en six dimensions, celles qui m'importent vraiment quand un modèle comme celui-ci atterrit sur mon bureau.
| Dimension | Note | Ce que j'ai constaté |
|---|---|---|
| Vitesse | A | 32,8 ms p50 par question routée, environ 7,8 fois plus rapide que les 236-276 ms de Jev |
| Calibration | A | ECE 0.081 après réajustement de la température contre 0.246 pour Jev, un vrai 3x |
| Précision zero-shot | D | ~0.362 en base, à peine au-dessus de la référence aléatoire de 0.318 |
| Précision après fine-tuning | A- | 0.766 sur le jeu typé, au-dessus du plafond du professeur de 0.735 |
| Tâches à forte cardinalité | C | Se dégrade au-delà de ~20 options ; 0.425 sur Banking77 à 77 classes |
| Coût et licence | A+ | Apache 2.0, $0 en auto-hébergement, fonctionne hors réseau |
La forme de ce bulletin résume tout l'avis : brillant pour être rapide, honnête et bon marché ; moyen tant que vous n'investissez pas dans le fine-tuning ; faible en classification large. Si vous voulez la visite complète de l'architecture plutôt que le verdict, je l'ai rédigée à part dans l'analyse approfondie de Laya AI.
Ce qu'est Laya AI, en un paragraphe
La plupart des IA que vous avez utilisées sont autorégressives : elles prédisent le token suivant, puis le suivant, pour construire une phrase. C'est idéal pour rédiger une réponse et du gâchis pour une décision oui ou non, le genre d'écart qui sépare une vraie plateforme d'IA conversationnelle d'un modèle brut. Laya est d'une autre espèce : un encodeur bidirectionnel qui lit toute l'entrée d'un coup et répond à une question fixe en notant vos options au lieu de les écrire. Convai l'appelle un modèle de Système 1, le jugement réflexe instantané, par opposition au raisonnement lent de Système 2 d'un LLM génératif. Son créateur, Nandakishor Mukkunnoth, résume la motivation en une ligne :
"Not every AI problem requires an autoregressive chatbot."
Il a raison, et si vous avez déjà greffé un modèle de 8B sur un prompt finissant par « respond only with JSON » juste pour router un ticket, vous avez ressenti exactement la douleur qu'il résout. Cet avis suppose que vous adhérez déjà à cette prémisse et regarde si l'exécution tient.
Devriez-vous utiliser Laya AI ? Un test d'adéquation rapide
La décision d'achat est ici étonnamment nette, donc plutôt que de l'enfouir dans la prose, voici la décision que j'expliquerais à un collègue. Choisissez la branche qui vous correspond.
Ce que disent vraiment les benchmarks
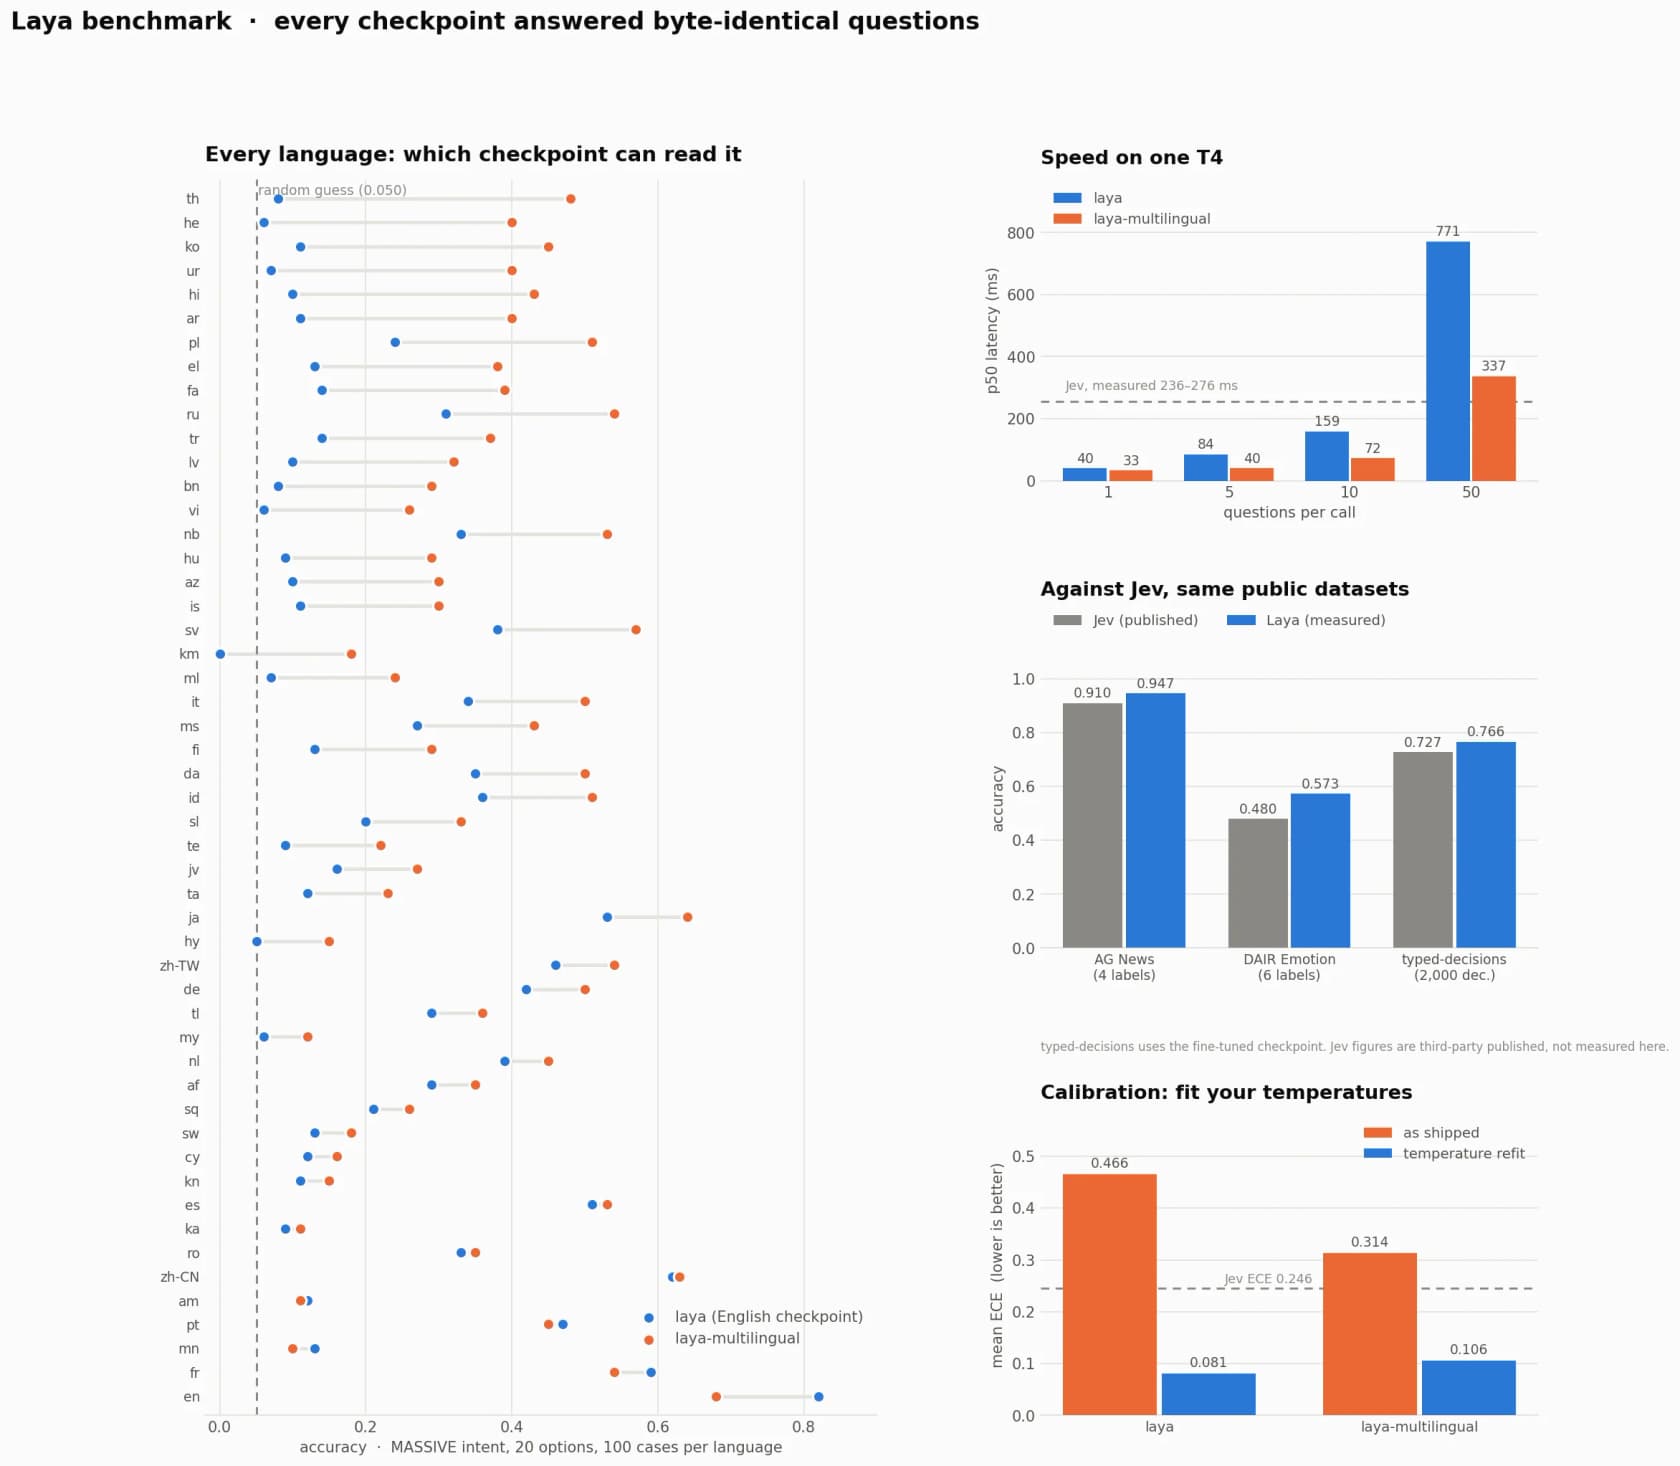
Voici la comparaison complète publiée par le projet face à Jev. Elle est dense, mais le titre est que Laya (routé) devance Jev sur les jeux de données publics communs tout en étant bien plus rapide et mieux calibré.
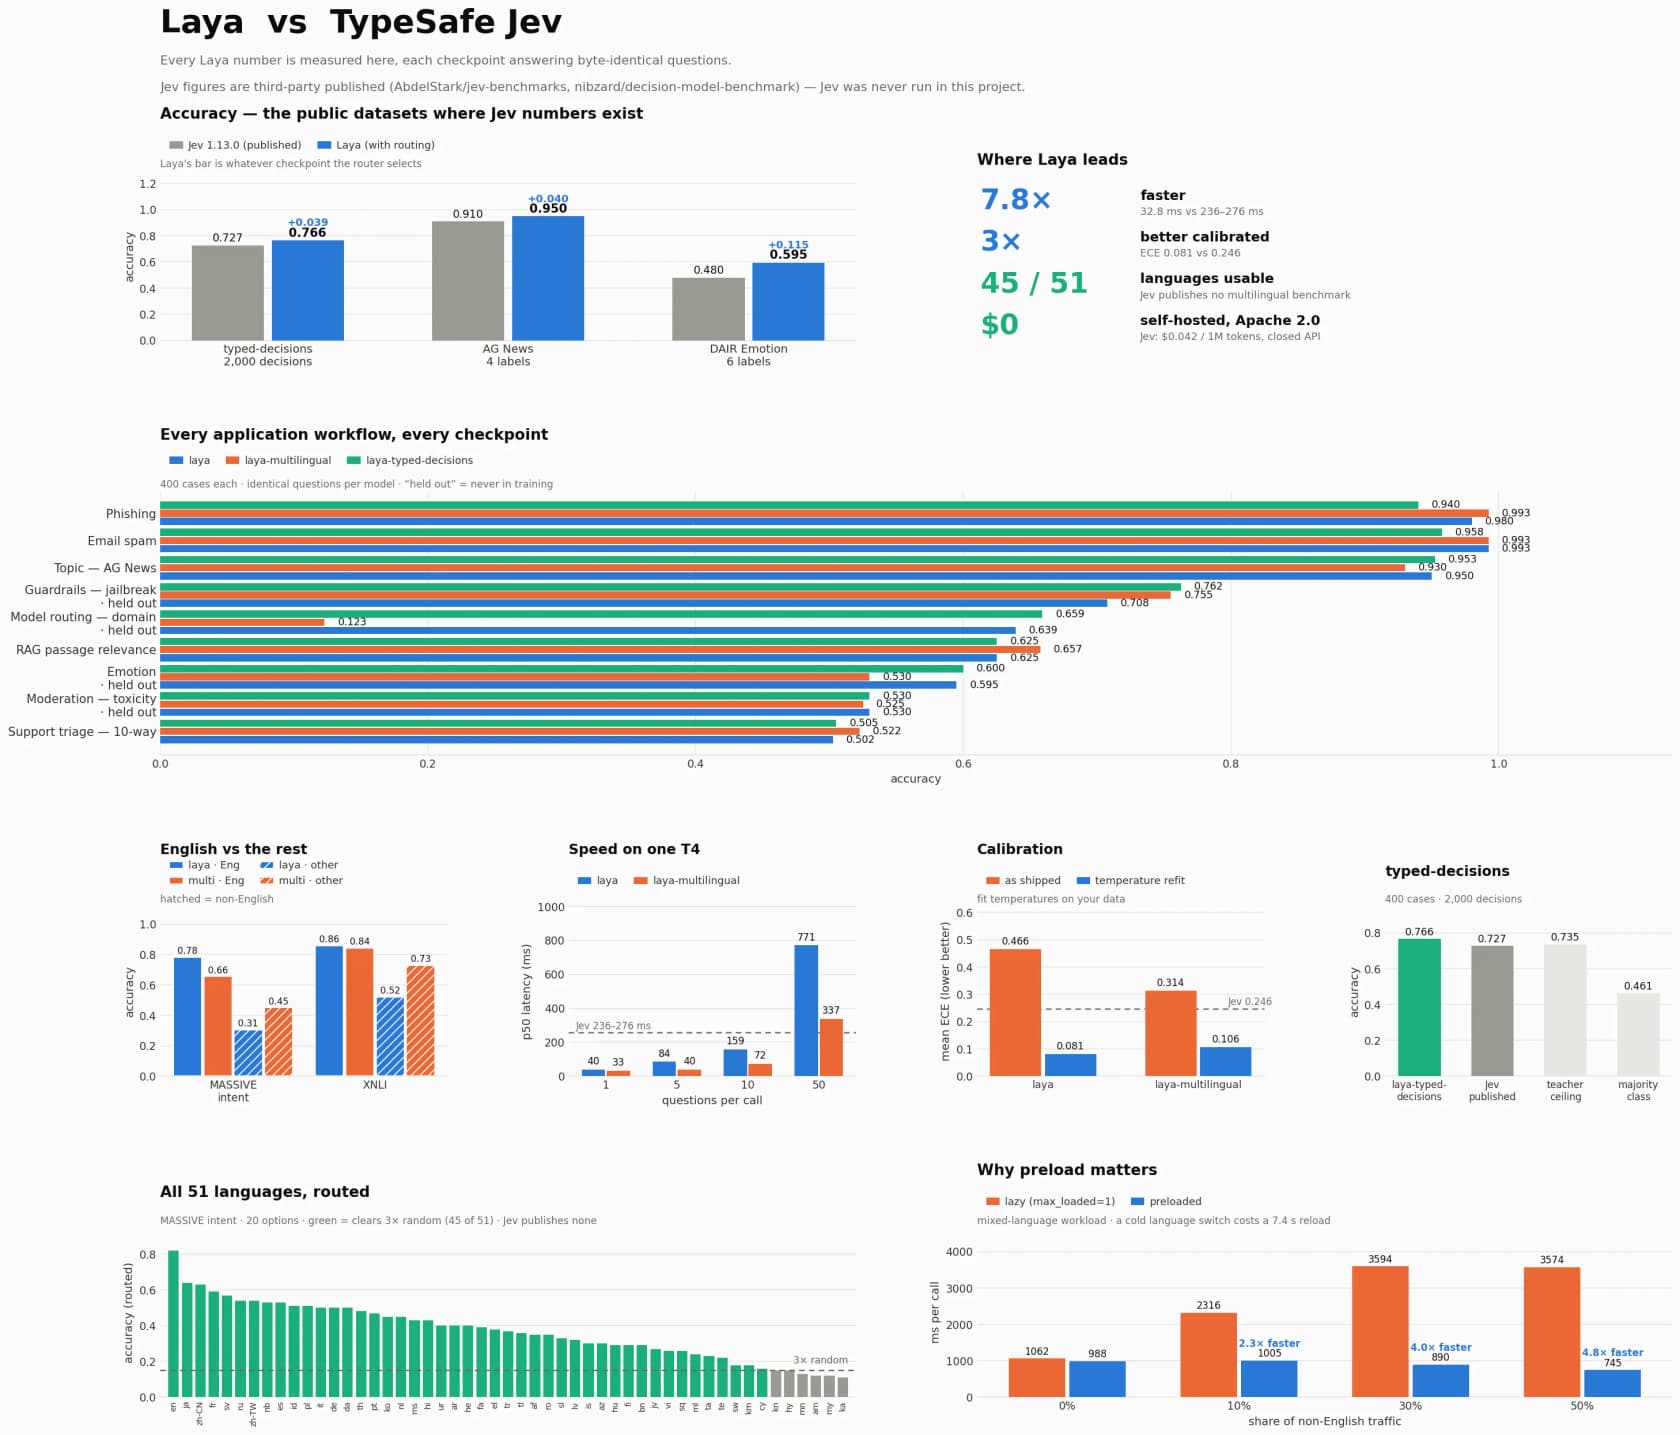
Les trois chiffres à retenir, tous mesurés sur un seul Tesla T4 avec des chiffres de Jev publiés par des tiers (Convai n'avait pas accès à l'API) :
- Latence : 32,8 ms p50 pour une question routée, contre 236 à 276 ms pour Jev. C'est le 7,8x.
- Calibration : ECE de 0.081 après réajustement de la température, contre 0.246 pour Jev, un score de calibration 3x meilleur.
- Précision : 0.766 sur le jeu typé de 2 000 décisions, contre 0.727 pour Jev, et il dépasse le plafond du professeur de 0.735.
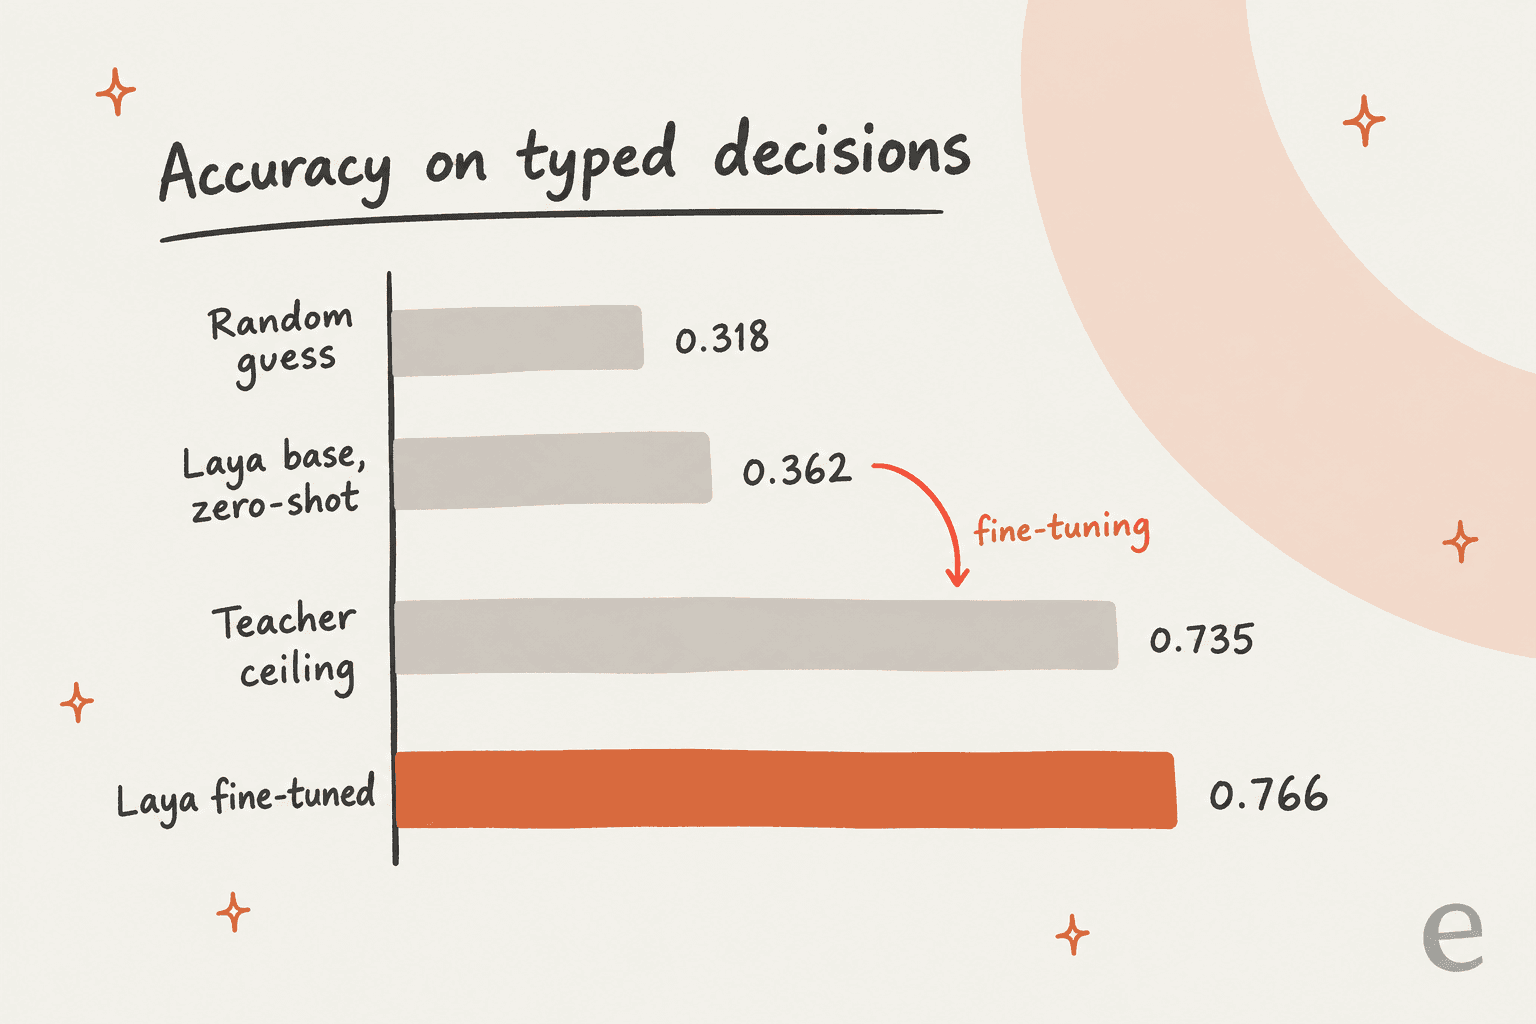
Puis l'astérisque qui a dominé toute discussion sérieuse du lancement. Ce 0.766 est le checkpoint fine-tuné. Les modèles de base, intacts, obtiennent environ 0.362 sur le même benchmark, un cheveu au-dessus de la référence aléatoire de 0.318. La section limites de Convai le dit clairement, ce que je respecte. Sur Hacker News, où le lancement a dépassé 1 300 points, le principal commentaire critique disait exactement cela :
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

C'est un coup légitime et la ligne la plus importante de tout cet avis. Jev se vend comme utilisable en zero-shot ; Laya, lu honnêtement, est une base que l'on spécialise.
Là où Laya brille vraiment
Sans le psychodrame autour de Jev, Laya est un classifieur rapide à la confiance honnête, ce qui vaut beaucoup. La calibration est ce que j'irais chercher en priorité, et elle rejoint une leçon apprise à la dure en exploitant de l'automatisation de support : l'échec dangereux n'est pas un bot qui dit « je ne sais pas », c'est celui qui se trompe avec assurance. Un modèle qui rapporte des probabilités honnêtes permet de filtrer par confiance et d'escalader les cas douteux, et cela vaut plus pour moi qu'un point de précision brute. Convai l'entraîne avec un schéma appelé RLCD, de l'apprentissage par renforcement contre des règles de score strictement propres, et la phrase de Nandakishor sur l'échec de l'entraînement naïf est la plus incisive du texte :
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
Les résultats par flux de travail confirment où il est fort. Laya rapporte :
- Filtrage du spam e-mail : 0.993
- Détection du phishing : 0.980
- Garde-fous LLM et détection de jailbreak : 0.755 à 0.762 (0.931 à 50 % de couverture sélective)
- Pertinence de passages en RAG : 0.657
- Routage de tickets de support, 10 classes : 0.522
Les décisions de sécurité binaires sont excellentes, et le score de routage est une base solide pour le type d'exemples d'agents IA que les équipes déploient réellement. Le côté exploitation est tout aussi bon : 45 langues sur 51 dépassent 3 fois le hasard une fois routées, contre aucun chiffre multilingue publié par Jev.
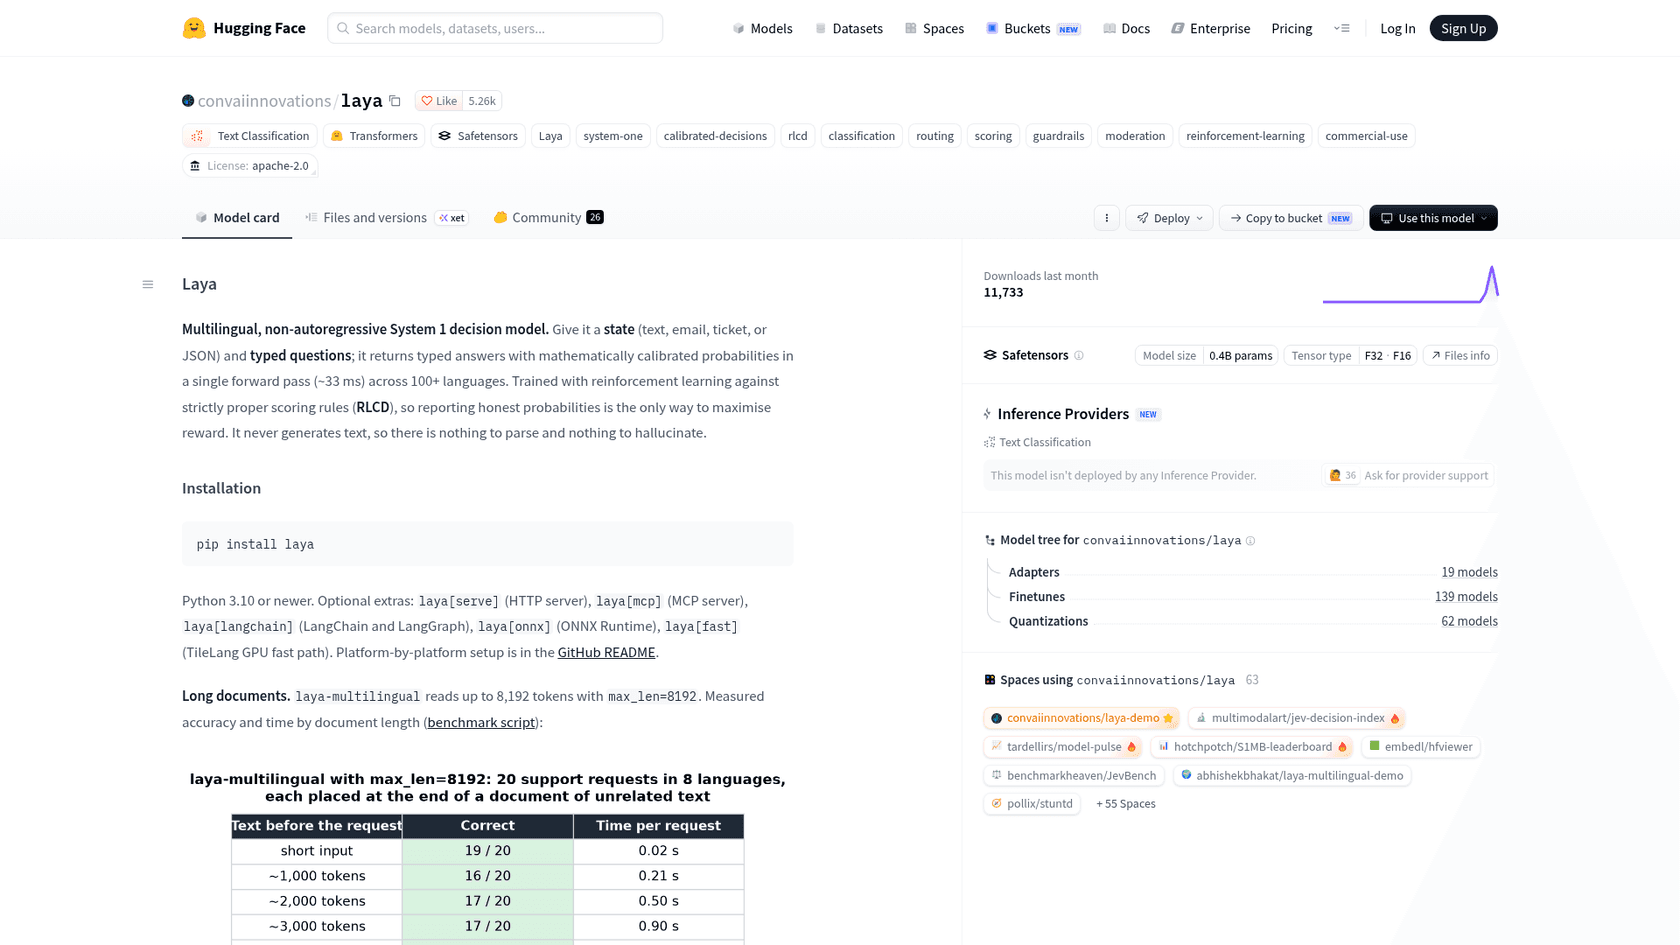
Côté coût, il est en Apache 2.0 et auto-hébergé, soit $0.00 par million de tokens contre $0.042 pour Jev, un écart qui grossit vite face au coût d'un agent humain, et il fonctionne hors réseau sur votre propre matériel, ce qui compte pour ceux soumis à HIPAA ou au RGPD. L'installation tient en une ligne, pip install laya, et Router(preload=True) garde tous les checkpoints résidents pour éviter un rechargement à froid de 7 à 10 secondes lors d'un changement de langue.
La fiche de modèle liste désormais des extras optionnels pour un serveur HTTP, un serveur MCP, LangChain et ONNX. Le dépôt GitHub documente aussi un endpoint /v1/systemone compatible Jev, ce qui permet de servir Laya comme une API au lieu de l'appeler dans le même processus.
Là où il déçoit
Je veux rester juste, car les lacunes sont réelles mais plus étroites que ce qu'Internet a laissé entendre. Trois choses ont ressorti lors des tests.
D'abord, le fine-tuning n'est pas optionnel pour un travail de précision, ce qui écarte Laya comme chatbot sans code pour les non-ingénieurs. Le 0.362 zero-shot est le chiffre honnête, et un praticien sur HN a exprimé le coût de cela mieux que je ne saurais le faire :
"Idk, your limitations section sure makes it seem less drop in and less general than Jev... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
Ensuite, la classification à forte cardinalité peine, ce qui compte si vous espériez remplacer une flotte de modèles d'IA sur mesure par un seul routeur. Sur Banking77 (77 étiquettes), Laya a obtenu 0.425 contre 0.870 pour Jev, parce que chaque option ne dispose que de 3 à 4 tokens pour se démarquer au budget par défaut. La solution est d'augmenter le budget de tokens ou de découper en hiérarchie du grossier au fin, mais de base un routeur à 10 classes est à l'aise et un à 77 ne l'est pas.
Enfin, le mode d'échec multilingue est vilain si vous ignorez le routeur. Le modèle racine anglais s'effondre hors des écritures latines : sur le balayage de 51 langues, il a obtenu 0.000 de précision en khmer tout en affichant 0.952 de confiance, exactement le piège du « se tromper avec assurance » que le modèle est censé éviter. Laya fournit un Router intégré qui détecte l'écriture en moins d'une demi-milliseconde et choisit le checkpoint multilingue, donc c'est soluble, mais il faut l'utiliser.
Rien de tout cela n'est rédhibitoire. Ce sont les limites d'un composant, et elles sont toutes documentées, ce que peu de lancements font.
Ce que la communauté pense vraiment
La réaction a été bruyante et, une fois filtré le psychodrame de la paternité, utile. La critique la plus répétée était la réserve du zero-shot proche du hasard, collée mot pour mot par plusieurs personnes qui pensaient qu'elle devait figurer en tête de l'annonce. Le contre-argument du camp enthousiaste était tout aussi constant :
"In the limitations you say that 'Out-of-the-box base models score ~0.35 on the typed-decisions benchmark (near random)...' - but that's the whole point, you can obviously fine-tune specialized models but having a model follow you instructions and be promotable and fast makes it massively easier to use."
Et la valeur pratique, quand quelqu'un a coupé à travers le bruit, était claire :
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
Il y a eu aussi un soulagement général que la version ouverte existe, même chez des sceptiques qui ont lu le « can't hallucinate » du lancement jumeau de Jev comme un appât à capital-risque. C'est à peu près là que j'atterris aussi, et cela rappelle la réaction de la communauté aux mises à jour de Claude d'Anthropic pour le support : la confiance méritée l'emporte sur les déclarations tapageuses.
La polémique, en bref
On ne peut pas évaluer Laya sans son histoire, car elle explique la moitié de son succès viral. Nandakishor revendique l'antériorité : il dit avoir publié cette approche non autorégressive entraînée par RL dans un article arXiv de mars 2025, un an entier avant le lancement de Jev par TypeSafe.
La communauté s'est partagée équitablement, certains notant qu'une marque soignée et une API utilisable sont elles-mêmes le produit. Mon avis est que la querelle de crédit détourne l'attention d'une solide publication. Que Laya ait été premier ou non, il est ouvert, rapide, honnêtement documenté et fonctionne bien pour les tâches sur lesquelles il est honnête. Je détaille toute la chronologie dans la présentation de Laya AI si vous voulez la lire.
Où un modèle de décision s'insère face à un collègue IA
C'est la partie qui me tient le plus à cœur, car c'est mon métier. Un modèle de décision et un collègue IA ne sont pas concurrents, ils vivent sur des couches différentes.
Laya est une infrastructure. Il répond à « dans quelle file ce ticket va-t-il » ou « est-ce urgent » en 33 ms, et il fait cette seule chose à merveille. Mais il ne lit pas votre centre d'aide, ne rédige pas la réponse, ne vérifie pas le statut de la commande et ne clôt pas la conversation. Ce sont les vraies tâches dont une équipe support a besoin, et elles exigent un modèle qui agit, pas un qui se contente de classer. C'est la différence entre un composant et un employé.
eesel est une plateforme de collègues IA, et le collègue IA de helpdesk est celui recruté pour le support. Il rejoint votre file existante dans Zendesk, Freshdesk ou là où vous travaillez déjà, lit vos anciens tickets et documents, et résout le ticket de bout en bout. En coulisses, il prend les mêmes décisions rapides et calibrées de routage et de confiance où Laya excelle, mais il les enveloppe de la lecture, de la rédaction et de l'action qui transforment une classification en conversation résolue. Si vous êtes développeur et préférez scripter ce collègue plutôt que cliquer, la CLI eesel et le serveur MCP permettent à une personne, un script ou un agent de code comme Claude Code de piloter le même espace de travail que le tableau de bord, ce qui est le foyer naturel du type de classification programmatique que recherchent les fans de Laya.
Essayer eesel
Si vous regardez Laya parce que vous voulez des décisions de support plus intelligentes et plus rapides, autant être clair sur ce que vous achetez. Un modèle de décision vous donne un composant pour construire. Un collègue IA de support vous donne le travailleur fini.

Je fais confiance à l'argument de calibration de Laya parce que j'ai vécu l'alternative. J'ai vu des bots au ton assuré donner discrètement de mauvaises réponses sur des files en production, c'est pourquoi chaque déploiement eesel commence par une simulation sur vos propres tickets historiques, afin que vous voyiez le taux de résolution exact et les réponses exactes avant qu'un seul client ne soit touché. Le tarif est un prix mensuel fixe, à partir de $299/mois pour 500 crédits (1 crédit par ticket ou chat), sans frais par utilisateur, et il existe un plan gratuit avec 100 crédits. Si vous voulez que la décision soit exécutée et pas seulement étiquetée, c'est la couche à regarder.
Ce que je dirais à un ami
Laya est une vraie contribution, et je suis content qu'il soit ouvert. Si vous êtes développeur avec des problèmes de classification ou de routage et prêt à faire du fine-tuning, c'est l'un des outils récents les plus intéressants de l'année : rapide, calibré, multilingue et gratuit. Lisez d'abord la fiche de modèle, elle est d'une honnêteté rafraîchissante sur ses propres limites, et cette honnêteté explique en grande partie pourquoi cet avis est positif.
Mais lisez cette section sur les limites avant de construire dessus. Les chiffres zero-shot sont proches du hasard, la confiance doit être réajustée sur vos données et la classification large demande un fine-tuning. Traitez-le comme l'excellente base qu'il prétend être. Et si ce dont vous avez vraiment besoin est tout le travail de support fait plutôt qu'une simple décision renvoyée, tournez-vous vers un collègue, pas un composant.
Questions fréquentes
Laya AI vaut-il le coup en 2026 ?
Pour la bonne tâche, oui. Mon avis sur Laya AI tient en ceci : si vous êtes développeur, avec des problèmes de routage ou de classification et l'envie de faire du fine-tuning, Laya est l'une des publications ouvertes les plus intéressantes de l'année : rapide, calibré, multilingue et gratuit. Si vous voulez quelque chose qui résolve un ticket de support entier plutôt que de simplement l'étiqueter, il vous faut plutôt un collègue IA de helpdesk.
Combien coûte Laya AI ?
Laya est gratuit. Les poids sont en Apache 2.0 sur Hugging Face, donc l'auto-hébergement coûte $0.00 par million de tokens contre les $0.042 par million de tokens facturés par l'API fermée de Jev. Votre seul vrai coût est le GPU ou le CPU sur lequel vous le faites tourner. Si vous préférez ne faire tourner aucun modèle, eesel propose un prix mensuel fixe à partir de $299/mois pour 500 crédits (1 crédit par ticket ou chat), sans frais par utilisateur.
Laya AI est-il bon pour le routage des tickets de support ?
C'est une base solide pour cela, pas un routeur fini. Sur un jeu de tri de support à 10 classes, le modèle de base obtient 0.522, et chaque réponse inclut un score de confiance calibré sur lequel vous pouvez poser un seuil. Pour une vue plus complète, consultez notre comparatif des meilleures IA pour le tri des tickets de support et la mécanique du tri des tickets lui-même.
Dois-je faire du fine-tuning sur Laya AI ?
Pour une précision sérieuse, en général oui. Sans ajustement, les checkpoints de base obtiennent un score proche du hasard (~0.362) sur le benchmark de décisions typées ; le 0.766 affiché vient du fine-tuning sur cette tâche. Voyez Laya comme une base rapide à spécialiser, et réajustez sa température sur vos propres données avant de vous fier aux chiffres de confiance. Des outils comme eesel évitent cette étape en apprenant directement de votre base de connaissances.
Laya AI ne peut-il vraiment pas halluciner ?
Dans son espace de sortie, oui. Laya n'émet jamais de tokens de texte, seulement des probabilités sur un ensemble fixe d'options que vous définissez, donc une catégorie inventée ou un JSON mal formé est impossible par construction. Il peut quand même se tromper, c'est pourquoi le score de confiance calibré compte bien plus que le slogan marketing, et pourquoi un taux de résolution honnête vaut mieux qu'une supposition assurée.
Laya AI contre Jev : lequel est meilleur ?
Ils visent des acheteurs différents. Jev est présenté comme une API zero-shot utilisable ; Laya est une base ouverte que vous spécialisez, et selon ses propres benchmarks il est environ 7,8 fois plus rapide et 3 fois mieux calibré. Le verdict de mon avis sur Laya AI : choisissez Laya si vous allez l'héberger et le fine-tuner vous-même, et Jev si vous voulez une API qui fonctionne sans réglage. Pour une vue plus large, consultez notre analyse complète de Laya AI.
Que peut-on réellement construire avec Laya AI ?
Des décisions structurées rapides : filtres anti-spam et anti-phishing, garde-fous pour LLM, pertinence de passages en RAG, scoring de sentiment et routage. Il s'intègre partout où vous payez trop cher un modèle génératif pour une petite décision. Dans une pile de support, il s'associe naturellement à l'analyse de sentiment par IA et à l'étiquetage automatique des tickets.