

En bref
Pour intégrer un agent IA à votre stack métier, pensez en trois tâches plutôt qu'en une grande connexion : ce qu'il lit (centre d'aide, anciens tickets, Confluence, Notion, Google Drive), ce qui le déclenche (un nouveau ticket, une mention Slack, un webhook de vos propres systèmes) et ce qu'il peut faire (taguer, répondre, consulter une commande, rembourser). Connectez dans cet ordre, en lecture seule d'abord, et placez toute action qui déplace de l'argent derrière une validation humaine.
Les permissions sont l'endroit où la plupart des déploiements déraillent. Un agent ne voit que ce que voit l'utilisateur qui le connecte, ce que permettent les scopes et ce que vous avez explicitement partagé. Les jetons d'API Zendesk peuvent usurper des administrateurs, une clé d'API Freshdesk hérite du rôle d'une seule personne, le scope read_orders de Shopify ne couvre que les 60 derniers jours, et une nouvelle connexion Notion ne voit rien tant que vous ne l'ajoutez pas à une page. Préférez OAuth aux jetons personnels, donnez à l'agent sa propre identité étroite et testez sur d'anciens tickets avant qu'un client ne voie une réponse.
Le collègue IA pour helpdesk d'eesel est construit exactement autour de ce découpage. Il rejoint votre helpdesk existant, lit vos outils de connaissances, appelle vos propres API via une liste d'autorisation, et chaque action est réglée sur automatique, demander d'abord ou désactivée. Vous pouvez tout configurer depuis le tableau de bord, la CLI eesel ou un client MCP, et un ticket coûte un crédit quel que soit le nombre de systèmes qu'il touche.
Ce que signifie vraiment intégrer un agent IA à votre stack
Je travaille sur le produit d'eesel, ce qui consiste surtout à construire les connecteurs qui permettent à un collègue IA de travailler dans les outils des autres. Ce que j'ai appris de plus utile, c'est que l'IA est rarement le maillon faible. La plomberie, si. Dans un essai en trafic réel sur une boîte de réception e-commerce tournant sous Zendesk et Shopify (environ 1 000 tickets par mois), environ 65 % des modifications que les agents apportaient aux brouillons de l'IA portaient sur le ton et la longueur, et seulement environ 5 % sur une erreur factuelle de l'IA. Environ 20 % des modifications venaient du fait que la réponse nécessitait des données d'un système auquel l'agent n'était pas encore connecté, comme l'ERP ou le prestataire logistique. De meilleurs prompts ne règlent pas ces 20 %. Plus d'intégration, si.
Alors quand une responsable support me demande comment « brancher l'IA sur notre stack », je découpe la question en trois parties. La documentation d'eesel décrit chaque intégration de la même façon, comme un mélange de sources, déclencheurs et actions, et ce modèle vaut pour n'importe quel fournisseur que vous évaluez :
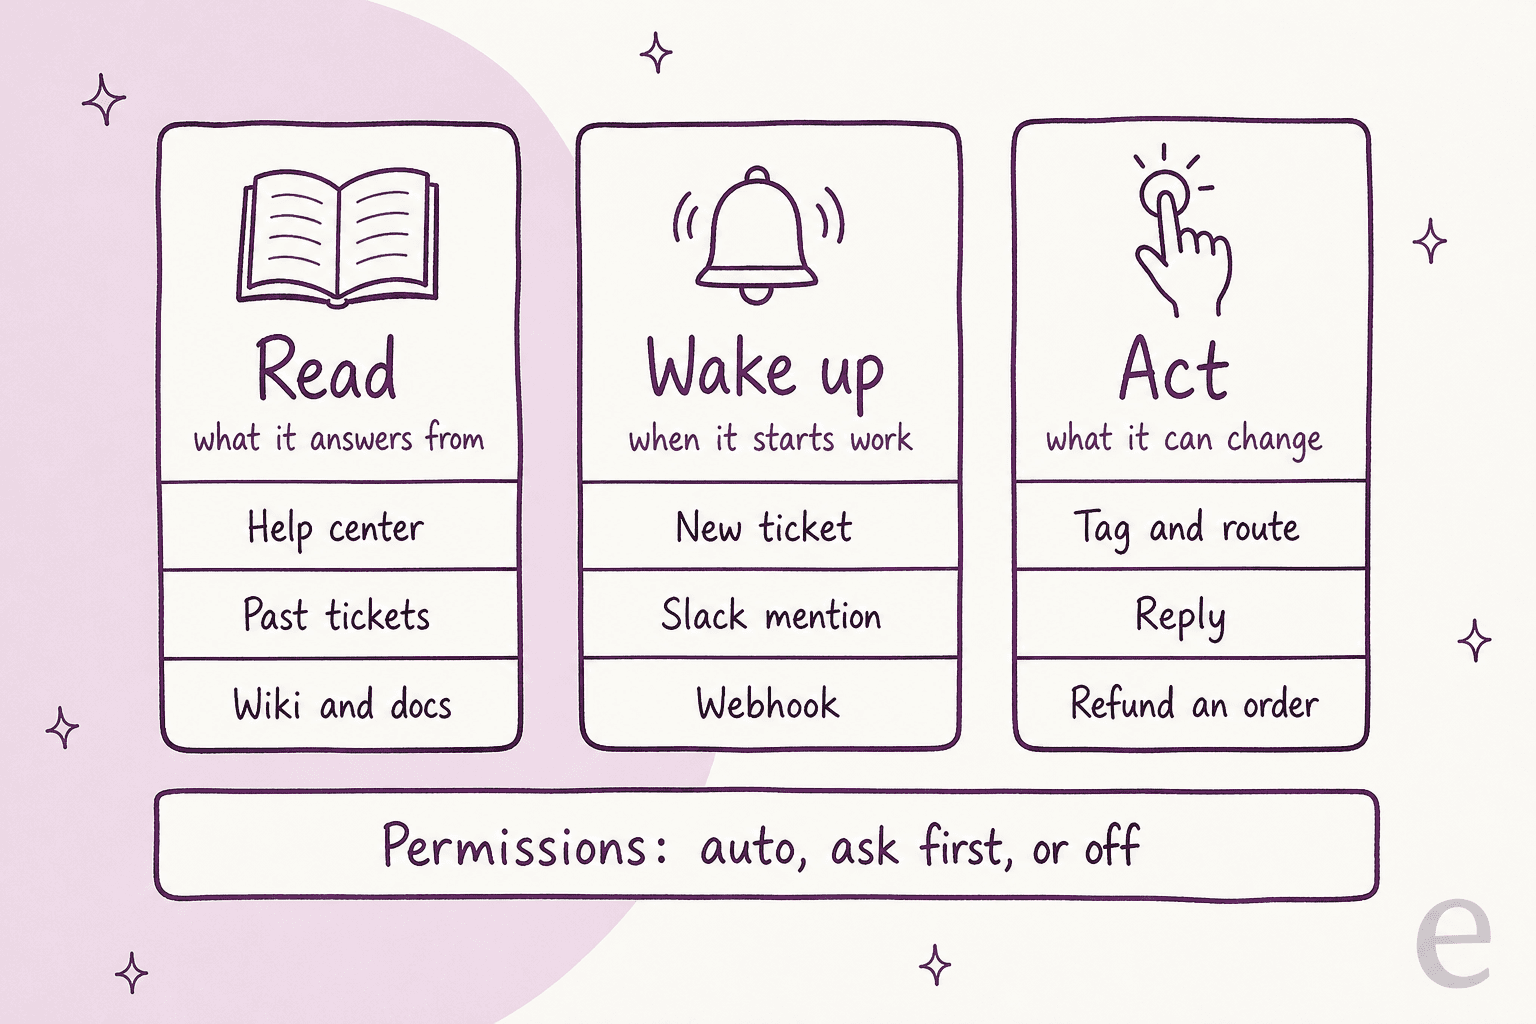
- Lire. Les connaissances sur lesquelles il s'appuie pour répondre. Articles du centre d'aide, anciens tickets et macros, wikis internes, documentation produit, politiques.
- Se déclencher. Les événements qui lancent le travail. Un nouveau ticket, un message client, une @mention dans Slack, un webhook de votre système d'entrepôt, une planification.
- Agir. Ce qu'il peut modifier. Taguer et router un ticket, laisser une note interne, envoyer une réponse, consulter une commande, lancer un retour, émettre un remboursement.
Certains outils font les trois. Un helpdesk comme Zendesk est une source (tickets, macros, centre d'aide), un déclencheur (nouveau ticket) et une surface d'action (répondre, taguer, assigner). D'autres ne sont que des sources : Confluence, Notion et Google Drive sont lus, jamais modifiés. Votre propre base de commandes sert généralement uniquement aux actions. Classer votre stack ainsi vous montre quelles connexions sont peu risquées (lectures) et lesquelles demandent de vrais garde-fous (écritures).
Si vous voulez d'abord une vue d'ensemble des agents et des outils métier, mes collègues ont écrit une introduction sur les agents IA et les outils métier. Cet article en est la version pratique pour un responsable support ou opérations.
Étape 1 : Cartographiez votre stack avant de connecter quoi que ce soit
Avant d'ouvrir une page de réglages, écrivez une ligne par système dont l'agent aura besoin. Cela prend 20 minutes et vous évite l'échec le plus courant que je vois : connecter le helpdesk, obtenir des réponses correctes, puis découvrir que les questions les plus fréquentes des clients (« où est ma commande ? », « pourquoi ai-je été débité deux fois ? ») exigent des données qui se trouvent ailleurs.
| Système | Rôle pour l'agent | Ce dont il a besoin | Qui doit approuver la connexion |
|---|---|---|---|
| Helpdesk (Zendesk, Freshdesk, Gorgias) | Lire, se déclencher, agir | Anciens tickets, macros, déclencheurs, actions de réponse et de tag | Un administrateur du helpdesk, une fois, dans le navigateur |
| Centre d'aide | Lire | Articles publics | Personne, s'il est public |
| Wiki (Confluence, Notion, Google Drive) | Lire | Les espaces, pages ou dossiers précis auxquels vous faites confiance | Un administrateur de l'espace ou le propriétaire de la page |
| Chat d'équipe (Slack, Teams) | Se déclencher, agir | Canaux qu'il peut rejoindre, droit de publier | Un administrateur de l'espace de travail |
| Boutique (Shopify, BigCommerce) | Agir | Consultation de commandes, puis retours, changements d'adresse, remboursements | Propriétaire de la boutique ou personnel avec droits d'application |
| Facturation (Stripe, votre système de facturation) | Agir | Une clé étroite : lire les paiements, peut-être rembourser | Finance ou ingénierie |
| CRM (Salesforce, HubSpot) | Lire, agir | Contexte de compte et d'offre, mises à jour de dossiers | Un administrateur CRM |
| Vos propres API (base de commandes, entrepôt) | Agir | Un domaine autorisé et un en-tête d'authentification | Ingénierie |
Marquez ensuite chaque ligne avec ce qui casse si l'agent se trompe. Une mauvaise réponse issue du wiki vous coûte une correction. Un remboursement sur la mauvaise commande vous coûte de l'argent. C'est l'ordre dans lequel vous les connecterez.
J'ai construit le planificateur ci-dessous pour que vous cochiez ce qui se trouve dans votre stack et obteniez l'ordre dans lequel je le connecterais, avec le piège de permissions de chaque système tiré de la documentation du fournisseur lui-même.
Planificateur d'intégration
Que contient votre stack ?
Cochez chaque système que votre équipe support utilise. Le plan ci-dessous les liste dans l'ordre où je les connecterais, du moins risqué au plus risqué, avec le piège de permissions à vérifier pour chacun.
Wiki ou documentation (Confluence, Notion, Google Drive)
Lecture seule. Choisissez les espaces, pages ou dossiers auxquels vous faites confiance, pas tout l'espace de travail.
Piège : une nouvelle connexion Notion ne voit aucune page tant que vous ne l'ajoutez pas à chacune, et une application Confluence ne voit jamais plus que l'utilisateur qui l'a autorisée.
Helpdesk (Zendesk, Freshdesk, Gorgias)
Connectez-vous avec OAuth, importez anciens tickets et macros, et commencez avec des réponses en notes internes uniquement.
Piège : les jetons d'API Zendesk sont obsolètes et peuvent usurper des administrateurs ; une clé d'API Freshdesk ne peut faire que ce que permet le rôle de cet agent.
Slack
Validations et questions internes dans des fils. Il ne rejoint que les canaux que vous nommez.
Piège : depuis mai 2025, une nouvelle application Slack hors Marketplace obtient 1 appel d'historique par minute et 15 messages par appel.
CRM (Salesforce, HubSpot)
D'abord des consultations de compte et d'offre en lecture seule. Mises à jour de dossiers ou tickets plus tard, derrière une validation.
Piège : le plafond quotidien d'API de HubSpot est partagé par toutes les applications privées du compte ; une intégration Salesforce s'exécute sous l'utilisateur « Run As » que vous choisissez.
Boutique Shopify
Consultations de commande et de suivi en automatique. Retours, changements d'adresse, annulations et remboursements en demandant d'abord.
Piège : read_orders ne couvre que les 60 derniers jours sauf si Shopify approuve read_all_orders, et l'annulation d'une commande est irréversible.
Stripe ou facturation
Une clé restreinte avec lecture sur ce qu'il doit consulter et écriture uniquement sur les remboursements, le cas échéant.
Piège : ne donnez jamais votre clé secrète à un agent. Stripe recommande les clés restreintes pour les agents IA, et une clé marquée comme clé d'agent reçoit par défaut des règles de validation sur les remboursements.
Votre propre API (base de commandes, entrepôt, ERP)
Autorisez un seul domaine, stockez l'en-tête d'authentification côté serveur et commencez par des requêtes GET.
Piège : si le modèle peut voir la clé, quiconque lui fait répéter ses instructions le peut aussi. Gardez les identifiants totalement hors des prompts.
Limites et scopes tirés de la documentation développeur de chaque fournisseur, vérifiés en octobre 2026. Les offres et les limites de débit changent : revérifiez la page liée dans cet article avant de vous appuyer sur un chiffre.
Étape 2 : Connectez les connaissances qu'il lit, et seulement celles auxquelles vous faites confiance
Les connaissances sont la couche la plus sûre pour commencer, car toutes les connexions y sont en lecture seule. C'est aussi là que se joue la qualité. L'IA répétera ce que vous lui donnez, plus vite que n'importe quel humain :
« J'ai vu un bot donner avec aplomb des réponses fausses parce que la base de connaissances n'avait pas été mise à jour depuis 8 mois. Les clients n'ont pas seulement reçu de mauvaises réponses. Ils les ont reçues instantanément. »

Trois sources comptent plus que les autres :
- Anciens tickets et macros. C'est ainsi que votre équipe répond réellement, y compris sur les cas limites pour lesquels personne n'a écrit d'article. Si l'agent d'un fournisseur ne peut pas apprendre des tickets résolus, il travaille uniquement à partir de votre documentation idéale. Mon collègue en parle davantage dans son guide sur l'entraînement sur la base de connaissances.
- Le centre d'aide. Public, structuré, généralement le plus à jour. Bon point de départ, mince à lui seul.
- Wikis et documents internes. Confluence, Notion, Google Drive, SharePoint. C'est là que vivent les exceptions de remboursement et les règles d'escalade.
Chaque outil de wiki a son propre modèle de permissions, et tous partent de « moins que vous ne le pensez » :
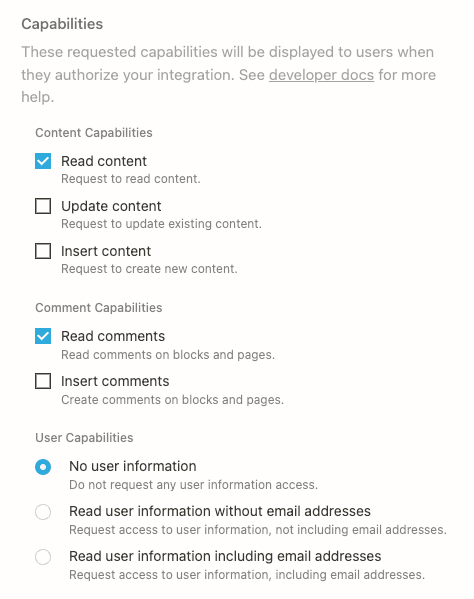
- Notion appelle désormais les intégrations des « connexions ». Une connexion ne voit que les pages qui ont été partagées avec elle : « Si la page n'est pas partagée, toute requête d'API répondra par une erreur » (documentation d'autorisation Notion). Lire, mettre à jour et insérer sont des capacités distinctes, vous pouvez donc accorder la lecture seule.
- Les applications Confluence Cloud agissent au nom d'un utilisateur, et « les permissions de l'utilisateur au nom duquel une application agit la limitent toujours, quels que soient les scopes de l'application » (documentation OAuth d'Atlassian). Les espaces restreints exigent d'ajouter explicitement l'application.
- Google Drive propose un large scope
drive.readonlyque Google classe comme restreint, et le stockage de ces données sur un serveur déclenche une évaluation de sécurité (documentation des scopes Drive). C'est pourquoi la plupart des outils vous demandent de choisir des fichiers et des dossiers.
Côté eesel, le connecteur Confluence est en lecture seule par conception, et le connecteur Notion ne fait que lire, sauf si vous activez son unique action d'écriture générale, désactivée par défaut.
La deuxième leçon concerne la synchronisation. Les connecteurs de connaissances sont généralement une copie prise à un instant donné, pas un flux en direct, et ils échouent en silence. J'ai vu un client partir à cause de cela : sa principale source de données était une feuille de calcul de statut de commandes dans Google Drive qui changeait chaque jour, la synchronisation a échoué silencieusement trois fois et il est parti vers un outil moins cher. Demandez à chaque fournisseur comment arrivent les nouveaux fichiers et comment vous sauriez qu'une synchronisation est cassée. Chez eesel, les réponses diffèrent selon l'outil, et la documentation le dit franchement : les pages Confluence sont réindexées quand vous les modifiez et l'application se réconcilie environ une fois par heure (documentation Confluence), tandis qu'un nouveau fichier Google Drive doit être resélectionné dans le sélecteur et qu'un espace de travail peut synchroniser jusqu'à 2 500 fichiers par jour (documentation Google Drive).
Vérifiez aussi les formats que votre équipe utilise réellement. Une marque de compléments alimentaires en DTC, lors d'un appel commercial eesel (environ 7 000 tickets Gorgias par mois), gardait ses vraies procédures dans des SOP ClickUp et des vidéos Loom, avec un tas de macros périmées par-dessus. Rien de cela n'est lisible par un connecteur de texte tant que quelqu'un ne l'a pas écrit. Si c'est votre cas, le travail sur la base de connaissances IA passe avant le travail d'intégration.
Étape 3 : Branchez-le sur le helpdesk où vivent déjà les tickets
Le helpdesk est l'intégration qui compte le plus, car il cumule les trois tâches. Mon opinion tranchée : placez l'agent dans le helpdesk que votre équipe utilise déjà plutôt que d'envoyer les tickets vers une boîte IA séparée. Vos agents gardent leurs vues, macros et SLA, et le travail de l'IA apparaît sous forme de notes et de réponses sur le même ticket. C'est à cela que devrait ressembler une intégration de l'IA au helpdesk.
Ce qui change selon le helpdesk, c'est la façon dont une application externe s'authentifie, sous quelle identité elle agit et combien elle peut appeler. Voici ce que disent les documentations développeur de chaque fournisseur :
| Helpdesk | Comment une application externe se connecte | Sous quelle identité elle agit | Limite de débit de l'API | Réponse publique vs note |
|---|---|---|---|---|
| Zendesk | OAuth (les jetons d'API sont marqués obsolètes) | Les jetons d'API « peuvent servir à usurper n'importe qui dans le compte, y compris les administrateurs » | 200/min sur Team jusqu'à 2 500/min sur Enterprise Plus | public: false crée une note interne |
| Freshdesk | Clé d'API personnelle | Le rôle de cet agent : un rôle en lecture seule ne peut pas répondre via l'API | 100/min Growth, 400 Pro, 700 Enterprise | Points d'accès distincts pour réponse et note ; les notes sont privées par défaut |
| Gorgias | Clé d'API (privée) ou OAuth2 (obligatoire pour les applications publiques) | Le compte qui a créé la clé, avec « accès complet » aux données du compte | 40 requêtes par 20 s avec des clés d'API, 80 avec OAuth | Canal internal-note |
| HubSpot | Jeton d'application privée (super administrateur uniquement) ou application OAuth | L'application, limitée à ses scopes | De 100 à 190 par 10 s, plus un plafond quotidien partagé par toutes les applications | Non confirmé dans la documentation publique de HubSpot |
| Salesforce | Connected app, identifiants client OAuth | L'utilisateur « Run As » que vous choisissez ; Salesforce suggère un utilisateur API uniquement | 100 000 appels/jour plus 1 000 par licence (Enterprise) | CaseComment.IsPublished |
Trois points de ce tableau changent la façon dont je le configurerais :
- Utilisez OAuth, pas le jeton d'API d'une personne. Zendesk indique que les fournisseurs qui servent de nombreux clients « doivent utiliser des jetons d'accès OAuth globaux » (documentation d'authentification Zendesk). Un jeton lié à une personne casse aussi le jour où elle part. Si votre helpdesk ne propose que des clés personnelles, créez un poste d'agent dédié avec un rôle étroit pour l'IA et générez la clé depuis ce poste.
- Les limites de débit sont partagées. Sur l'offre Team de Zendesk, 200 requêtes par minute couvrent votre IA, votre synchronisation CRM et toutes les autres applications. Zendesk plafonne aussi les mises à jour d'un même ticket à 30 par 10 minutes et par utilisateur (limites de débit). Un agent qui tague, annote et répond dans des appels séparés les consomme plus vite que prévu. L'analyse de mon collègue sur les limites de débit de l'API Zendesk va plus loin.
- Commencez par des notes internes. Tous les helpdesks ci-dessus peuvent publier une note privée. C'est votre première semaine la plus sûre : l'IA rédige, un humain lit et envoie, et rien n'atteint un client par accident.
Vous devrez aussi choisir entre l'IA intégrée du helpdesk et une couche qui s'y branche. Les agents intégrés comme Zendesk AI, Freddy AI Agent ou Agentforce demandent le moins de configuration, mais leur portée hors du helpdesk est souvent plus étroite que ne le laisse croire la démo. Un évaluateur l'a formulé ainsi à propos de Gorgias :
« L'agent IA suit le même schéma : fonctionnalité complète uniquement pour Shopify et une configuration pénible d'un e-mail par boutique qui ne convient pas à toutes les entreprises. »

C'est une remarque juste d'un évaluateur à 5 étoiles, et c'est la bonne question à poser à tout fournisseur : les actions fonctionnent-elles sur ma stack, ou seulement sur celle de la démo ? J'ai aussi été du côté perdant. Plus tôt cette année, eesel a perdu des contrats mid-market faute de connecteur helpdesk natif pour Salesforce ou HubSpot. Les deux existent désormais (Salesforce, HubSpot), mais la leçon demeure. La liste des connecteurs est un filtre éliminatoire, vérifiez-la d'abord.
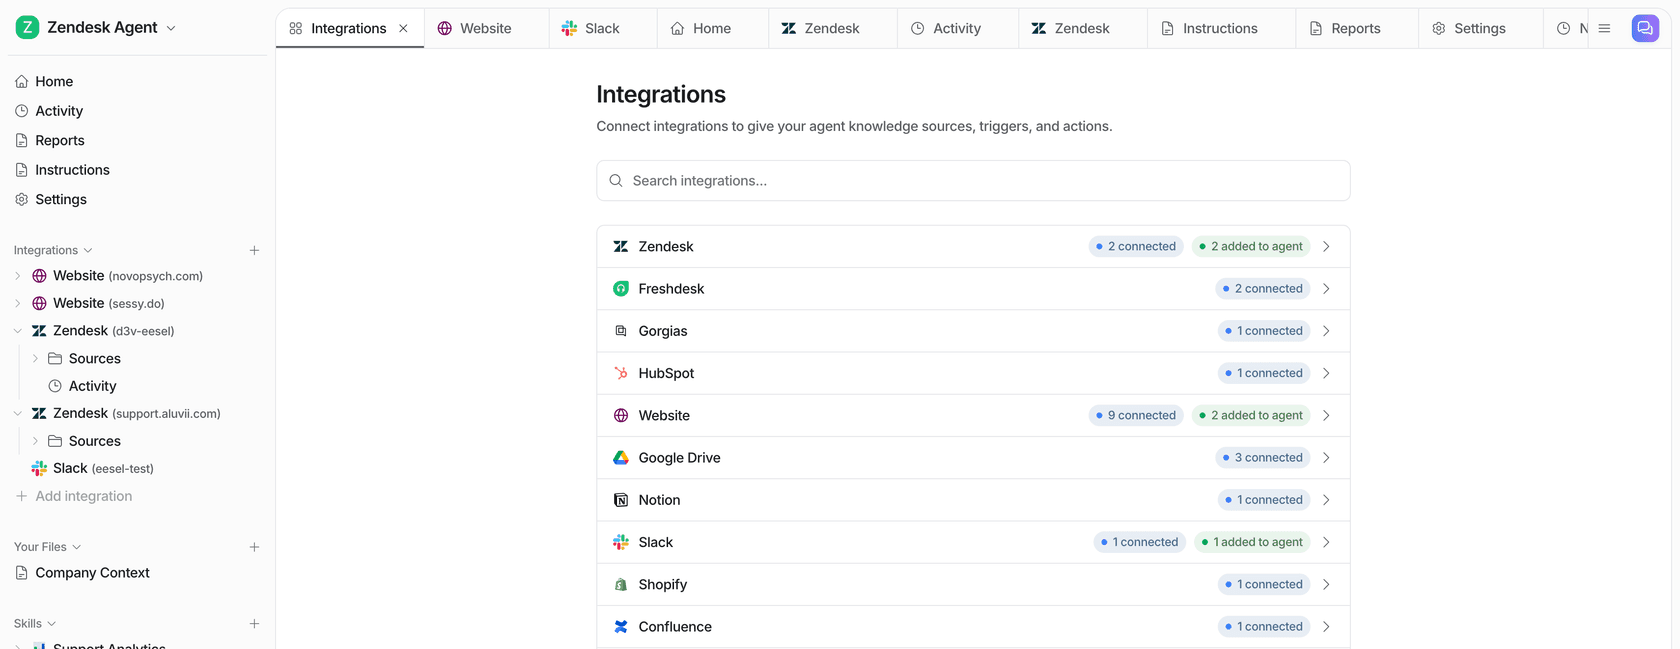
Voici à quoi ressemble une connexion Zendesk complète côté eesel : centre d'aide, macros et anciens tickets comme trois sources distinctes, chacune avec son interrupteur, pour que vous puissiez en écarter une.
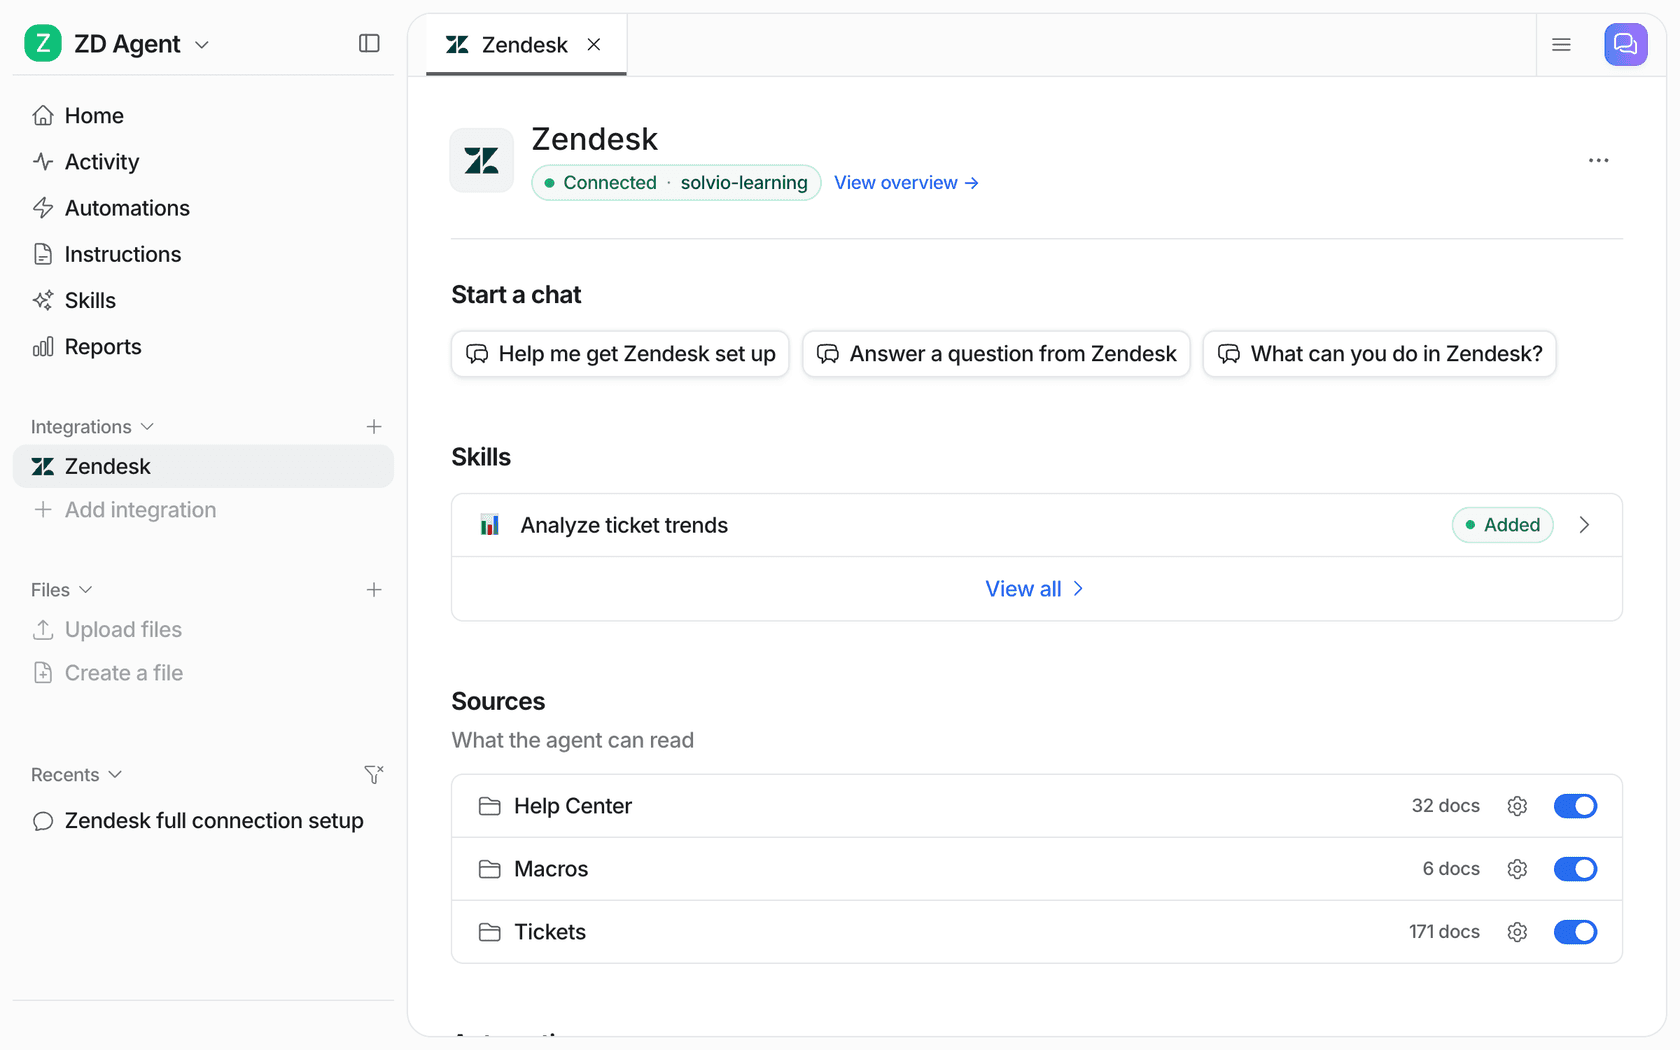
La documentation helpdesk d'eesel fait une remarque que je voudrais voir chez tous les fournisseurs : « Se connecter permet seulement à votre agent de lire votre helpdesk. Il ne fait rien sur les tickets tant que vous n'avez pas créé une automatisation. » (documentation helpdesk). Connecter et passer en production sont deux étapes distinctes, et vous voulez les garder séparées.
Étape 4 : Câblez des actions vers votre boutique, votre facturation et vos systèmes internes
C'est la couche qui transforme un bot de réponses en quelque chose qui clôt des tickets. C'est aussi là qu'une erreur coûte de l'argent. La plupart des tickets « où est ma commande », « changer mon adresse » et « remboursez-moi » nécessitent une consultation ou une écriture dans un système qui n'est pas votre helpdesk.
Shopify et autres boutiques
Shopify est celui que je vois le plus, et ses scopes d'accès présentent deux pièges à connaître avant de vous connecter :
read_ordersetwrite_orders« couvrent les commandes créées au cours des 60 derniers jours. Pour des commandes plus anciennes, ajoutezread_all_orders, dont vous devez demander l'accès » (scopes d'accès Shopify). Un agent qui ne trouve pas une commande vieille de trois mois dira au client qu'elle n'existe pas.- Annuler nécessite
write_orders, et la documentation de Shopify dit elle-même deorderCancel: « Cette action est irréversible » (orderCancel). Le nom, l'e-mail, le téléphone et l'adresse du client sont aussi des données protégées de niveau 2, qui exigent une revue supplémentaire pour les applications (données client protégées).
L'intégration Shopify d'eesel répartit ses actions en un groupe de lecture (obtenir une commande, historique des commandes, expédition et suivi) et un groupe d'écriture (créer un retour, modifier une adresse de livraison, rembourser, annuler). La documentation précise aussi qu'elle demande désormais la permission de lire toutes les commandes de Shopify, mais qu'une boutique connectée avant ce changement conserve la limite de 60 jours jusqu'à ce que quelqu'un la reconnecte (documentation Shopify d'eesel). C'est précisément le genre de détail à vérifier dans votre propre configuration. Pour un pas-à-pas plus complet, voyez comment connecter les données de commandes Shopify à un agent de support.
Facturation et paiements
Ne donnez jamais à un agent IA votre clé de paiement secrète. Le conseil de Stripe est direct : « Les RAK sont le type de clé recommandé pour les clés d'API que vous donnez aux agents IA » (clés restreintes Stripe). Une clé restreinte définit Lecture, Écriture ou Aucun par ressource, de sorte qu'un agent de support peut lire paiements et factures sans pouvoir toucher aux virements. Stripe permet aussi de marquer une clé comme clé d'agent, et les clés marquées reçoivent par défaut des règles de validation sur les virements, les remboursements et les changements de compte (clés d'API Stripe).
Vos propres systèmes (base de commandes, entrepôt, ERP)
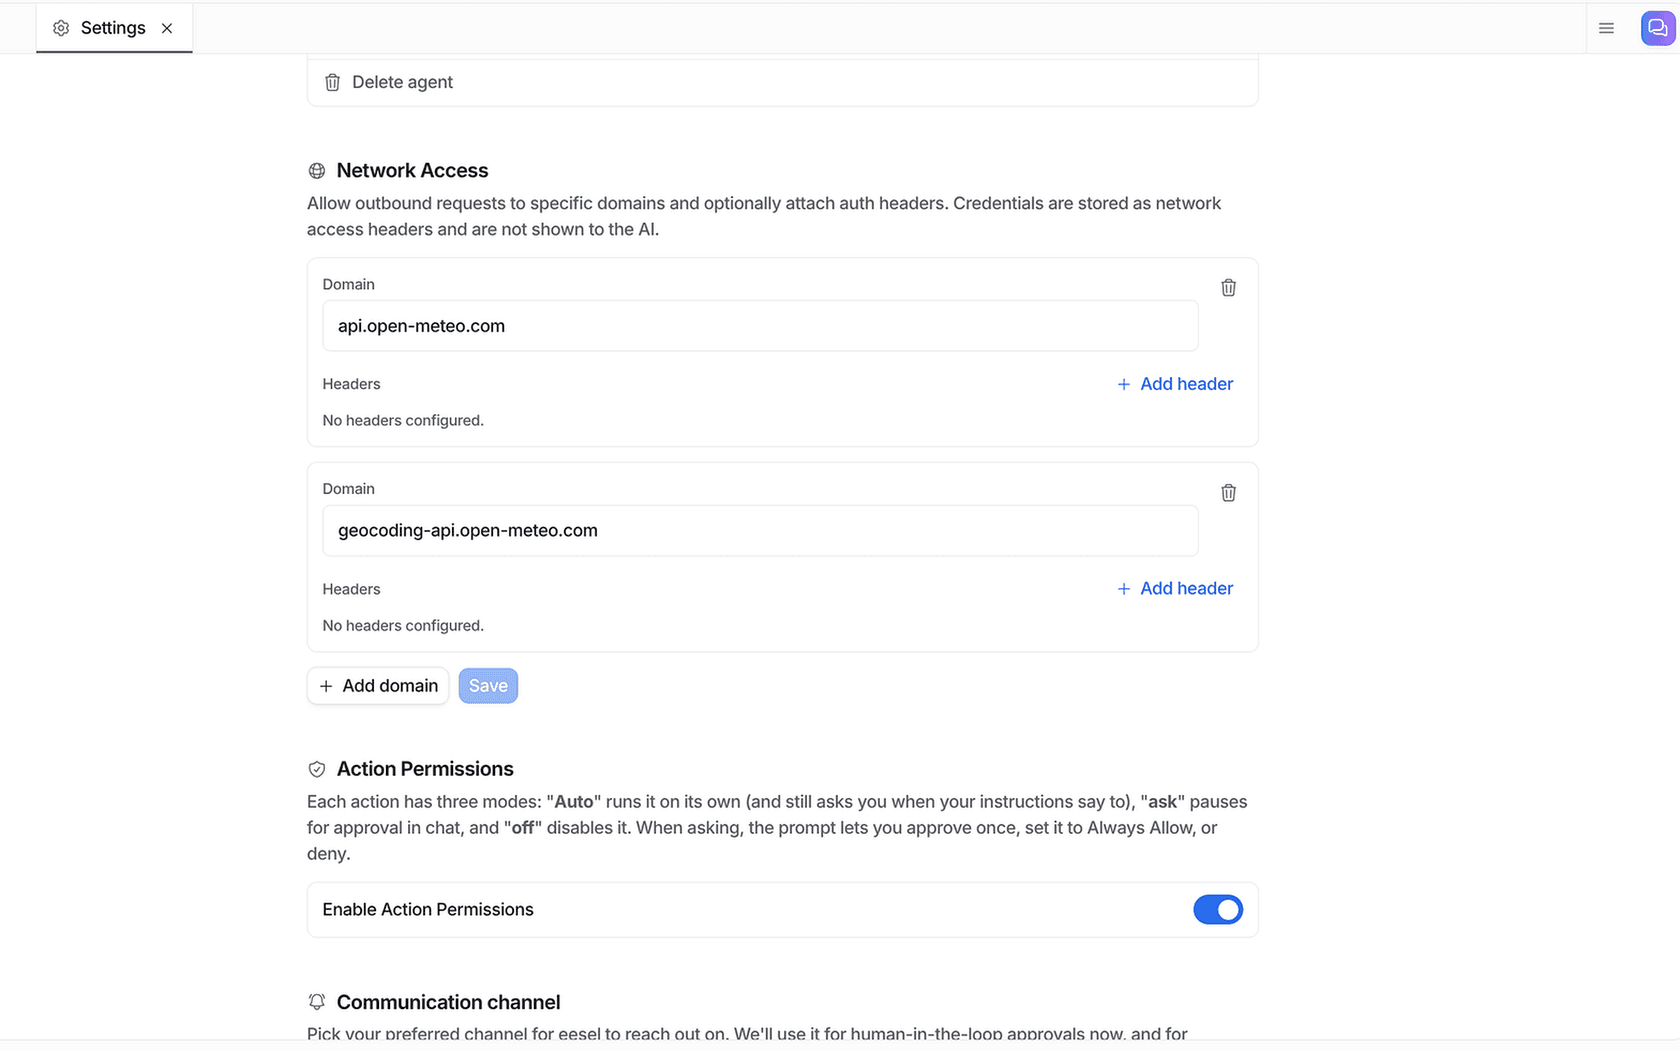
Pour tout ce qui n'a pas de connecteur prêt à l'emploi, le schéma est un appel d'API sur liste d'autorisation. Vous indiquez à l'agent quel domaine il peut appeler et quel en-tête d'authentification envoyer, et la plateforme ajoute l'identifiant côté serveur pour que le modèle ne le voie jamais. Chez eesel, c'est Network Access : les requêtes vers tout domaine que vous n'avez pas ajouté sont refusées, GET, POST, PATCH et DELETE sont pris en charge, et « les identifiants restent dans vos réglages et sont ajoutés à chaque requête par eesel, l'IA ne les voit donc jamais. »
Quel que soit l'outil, testez qu'une action fonctionne réellement avant de laisser l'agent en parler. Un modèle qui a lu votre politique de remboursement proposera volontiers des remboursements qu'il ne peut pas traiter. Un évaluateur d'Ada sur G2 a vu exactement cela, avec l'agent proposant d'annuler des commandes qu'il ne pouvait pas annuler :
« Parfois, Ada a donné des réponses ou pris des engagements qui ne faisaient pas partie de son entraînement initial ... Heureusement, ces problèmes ont été faciles à corriger avec du coaching et des mises à jour supplémentaires, et sa précision a continué de s'améliorer avec le temps. »

La solution tient autant aux instructions qu'à l'intégration : dites à l'agent quelles actions existent et quoi répondre quand un client en demande une qui n'existe pas. Le guide de mon collègue sur l'automatisation des remboursements avec l'IA couvre le volet politique.
Étape 5 : Fixez les permissions avant de fixer les déclencheurs
Voici le modèle mental que j'utilise. Un agent IA ne voit jamais « votre stack ». Il voit l'intersection de quatre limites, chacune fixée par une personne différente :
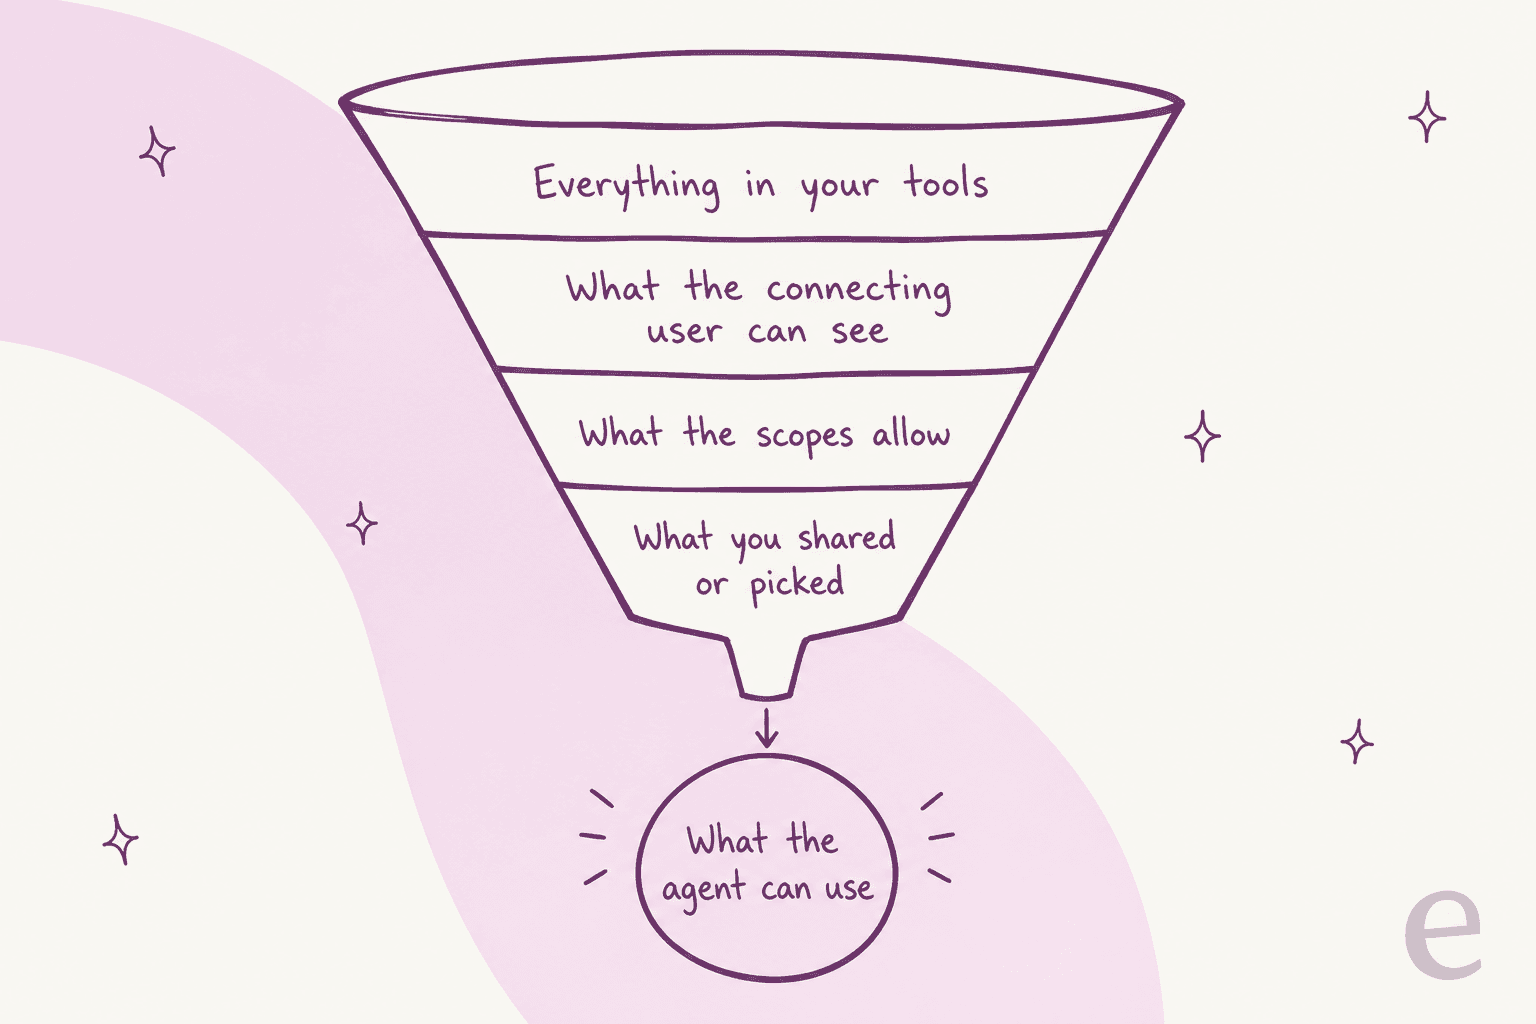
- L'utilisateur qui se connecte. Les applications Confluence sont plafonnées par l'utilisateur qui autorise, une clé Freshdesk par le rôle de cet agent, une connected app Salesforce par son utilisateur Run As. Celui qui clique sur « Autoriser » définit le plafond.
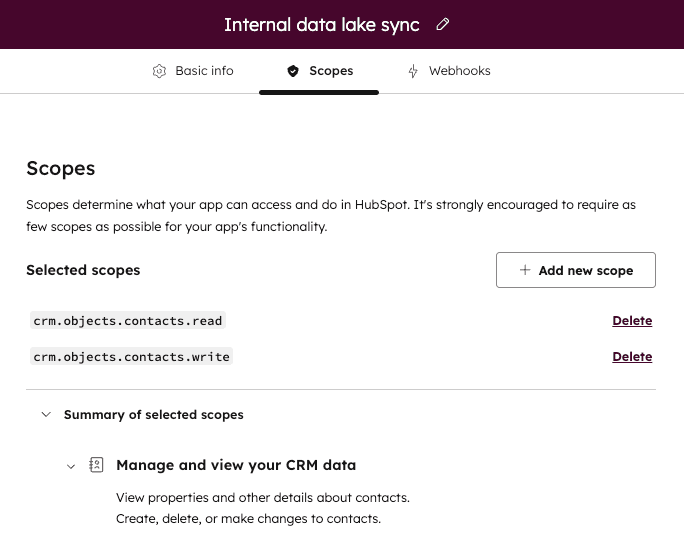
- Les scopes. Ce que l'application a demandé à l'installation. L'écran des scopes de HubSpot le dit clairement : exigez le moins de scopes possible.
- Ce que vous avez partagé ou choisi. Les pages Notion ajoutées à la connexion, les dossiers Drive dans le sélecteur, les canaux Slack rejoints.
- Ce que l'agent a le droit d'en faire. Les réglages par action dans l'outil IA lui-même.
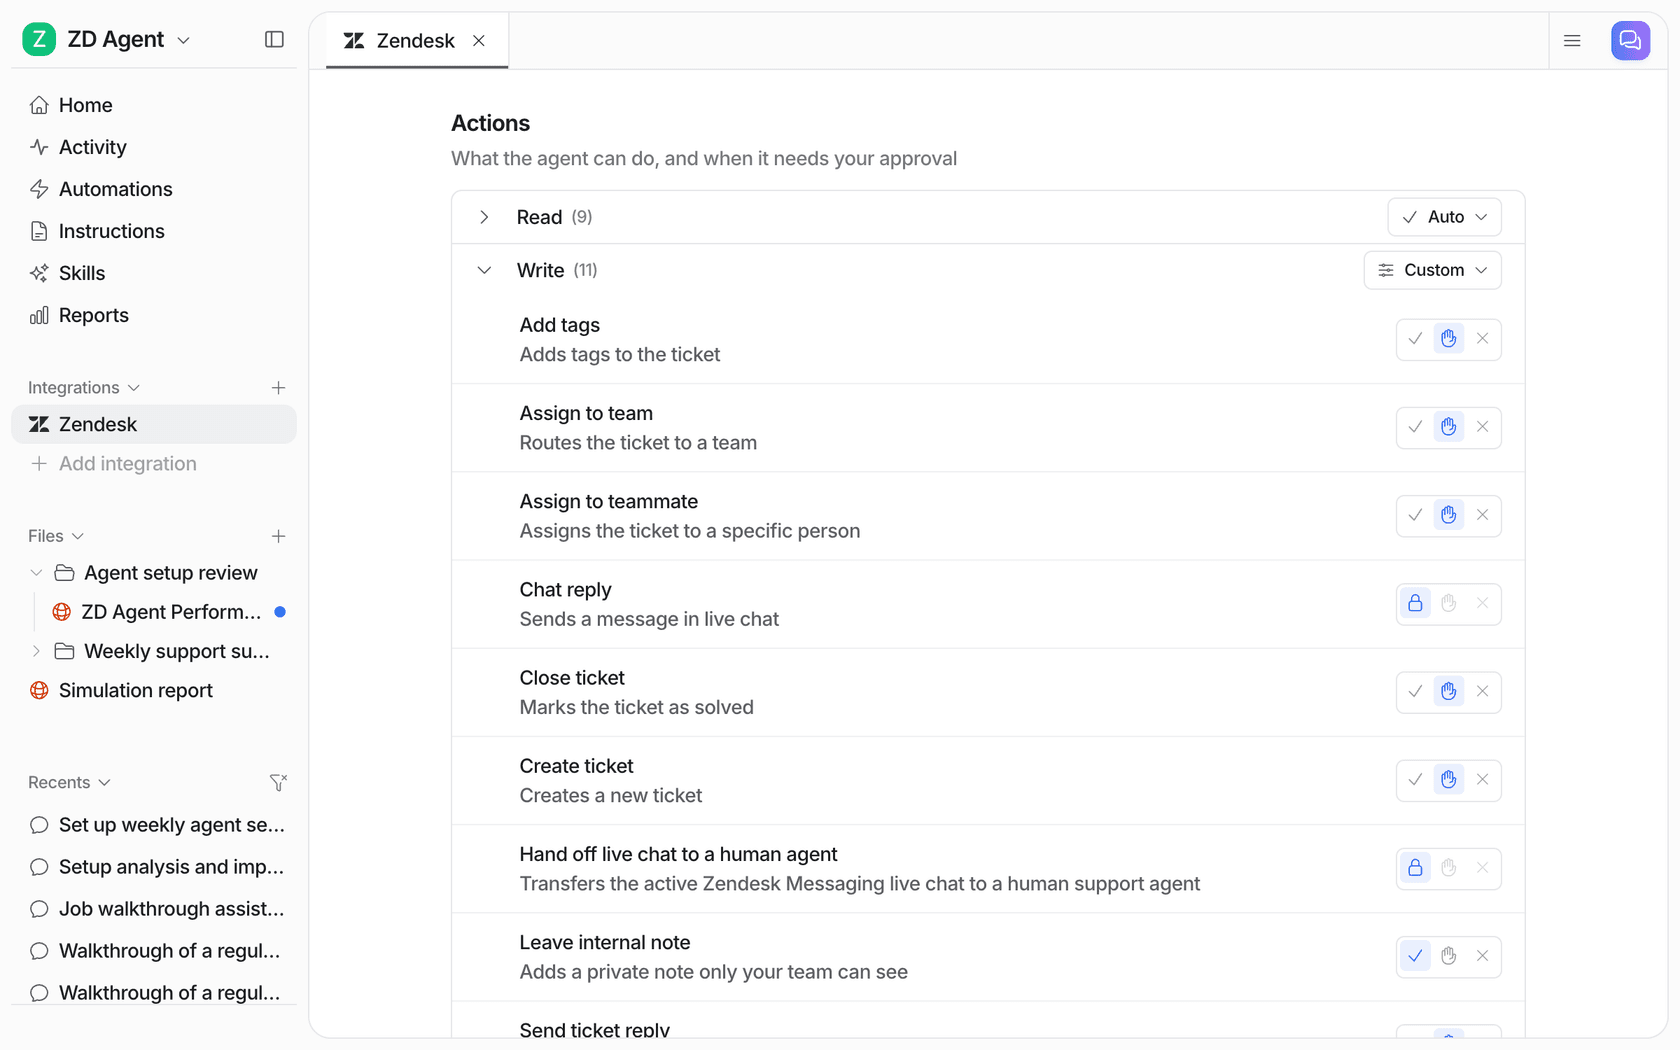
La quatrième limite est celle que vous contrôlez au quotidien, et c'est là que je mettrais le plus de soin. Chez eesel, chaque action est réglée sur Automatique, Validation requise ou Désactivée, par agent, et une action que vous n'avez pas activée « n'est pas du tout disponible pour le modèle, quoi qu'on lui demande » (documentation sécurité d'eesel). Les recommandations de la documentation sur les actions et validations sont la configuration que je copierais partout : garder les réponses et tout ce qui est irréversible sous validation au début, et garder « les remboursements, annulations et tout ce qui coûte de l'argent derrière une validation ».
Le bug d'intégration le plus effrayant n'est pas une mauvaise réponse. C'est une réponse d'apparence juste construite sur les données du mauvais client :
« la plus grosse défaillance que j'ai vue était un agent qui récupérait sans cesse les données du compte d'un autre utilisateur parce que le jeton de session n'était pas transmis correctement à l'appel d'API ; les réponses textuelles semblaient parfaites, donc personne ne l'a remarqué jusqu'à ce qu'un client se plaigne d'avoir vu le solde de quelqu'un d'autre »
Salesforce signale le même risque dans son guide de sécurité Agentforce : quand un agent de service invoque une action, « l'identité de l'agent est utilisée », donc votre propre code doit vérifier à quel client appartiennent les données (documentation Salesforce). Quelle que soit la plateforme, recherchez les données de commande et de compte via l'identité figurant sur le ticket, et testez avec deux clients aux noms proches. Si vous traitez des données réglementées, renseignez-vous aussi sur SOC 2 et le RGPD pour l'IA de support.
Étape 6 : Décidez ce qui réveille l'agent
Une fois qu'il peut lire et agir, l'agent a besoin d'une raison de démarrer. Il existe trois types de déclencheurs, et la plupart des stacks les utilisent tous.
Événements du helpdesk. Un nouveau ticket, une réponse du client, une @mention dans une note interne. Ils viennent de l'intégration helpdesk. Surveillez les règles de livraison : les intégrations HTTP de Gorgias expirent après 5 secondes, ne retentent pas un 429 ou un 500 et se désactivent après 500 échecs consécutifs (intégrations HTTP Gorgias). Plus de détails dans le guide des webhooks Gorgias. Les webhooks HubSpot expirent aussi après 5 secondes, et les actions personnalisées Zendesk après 10. Un backend IA lent doit accuser réception d'abord et faire le travail ensuite, sinon des événements sont perdus. Il existe un guide complet sur les webhooks Zendesk si vous construisez le vôtre.
Mentions dans le chat. Slack est l'endroit où atterrissent souvent validations et questions internes, et l'intégration Slack d'eesel demande avant de rejoindre un canal. Une limite à connaître si vous construisez votre propre bot : depuis le 29 mai 2025, les nouvelles applications à distribution commerciale absentes du Slack Marketplace obtiennent « 1 requête par minute » et « un maximum de 15 objets par requête » sur conversations.history et conversations.replies (changelog Slack). Les applications personnalisées internes gardent plus de 50 requêtes par minute. La raison avancée par Slack était d'empêcher l'exfiltration massive de données, ne prévoyez donc pas une architecture qui copie tout votre historique Slack dans une IA.
Webhooks de vos propres systèmes. C'est le déclencheur que l'on oublie. Un retard d'entrepôt, un paiement échoué ou une nouvelle inscription peuvent réveiller l'agent avec des données jointes. Chez eesel, une automatisation par webhook vous donne une URL privée à laquelle tout système (Zapier, Make, votre backend) peut envoyer du JSON en POST. Envoyez un en-tête X-Eesel-Event-Id et les nouvelles tentatives sont traitées exactement une fois. Un espace de travail accepte 60 livraisons par minute, et une livraison que vos instructions filtrent n'est pas facturée.
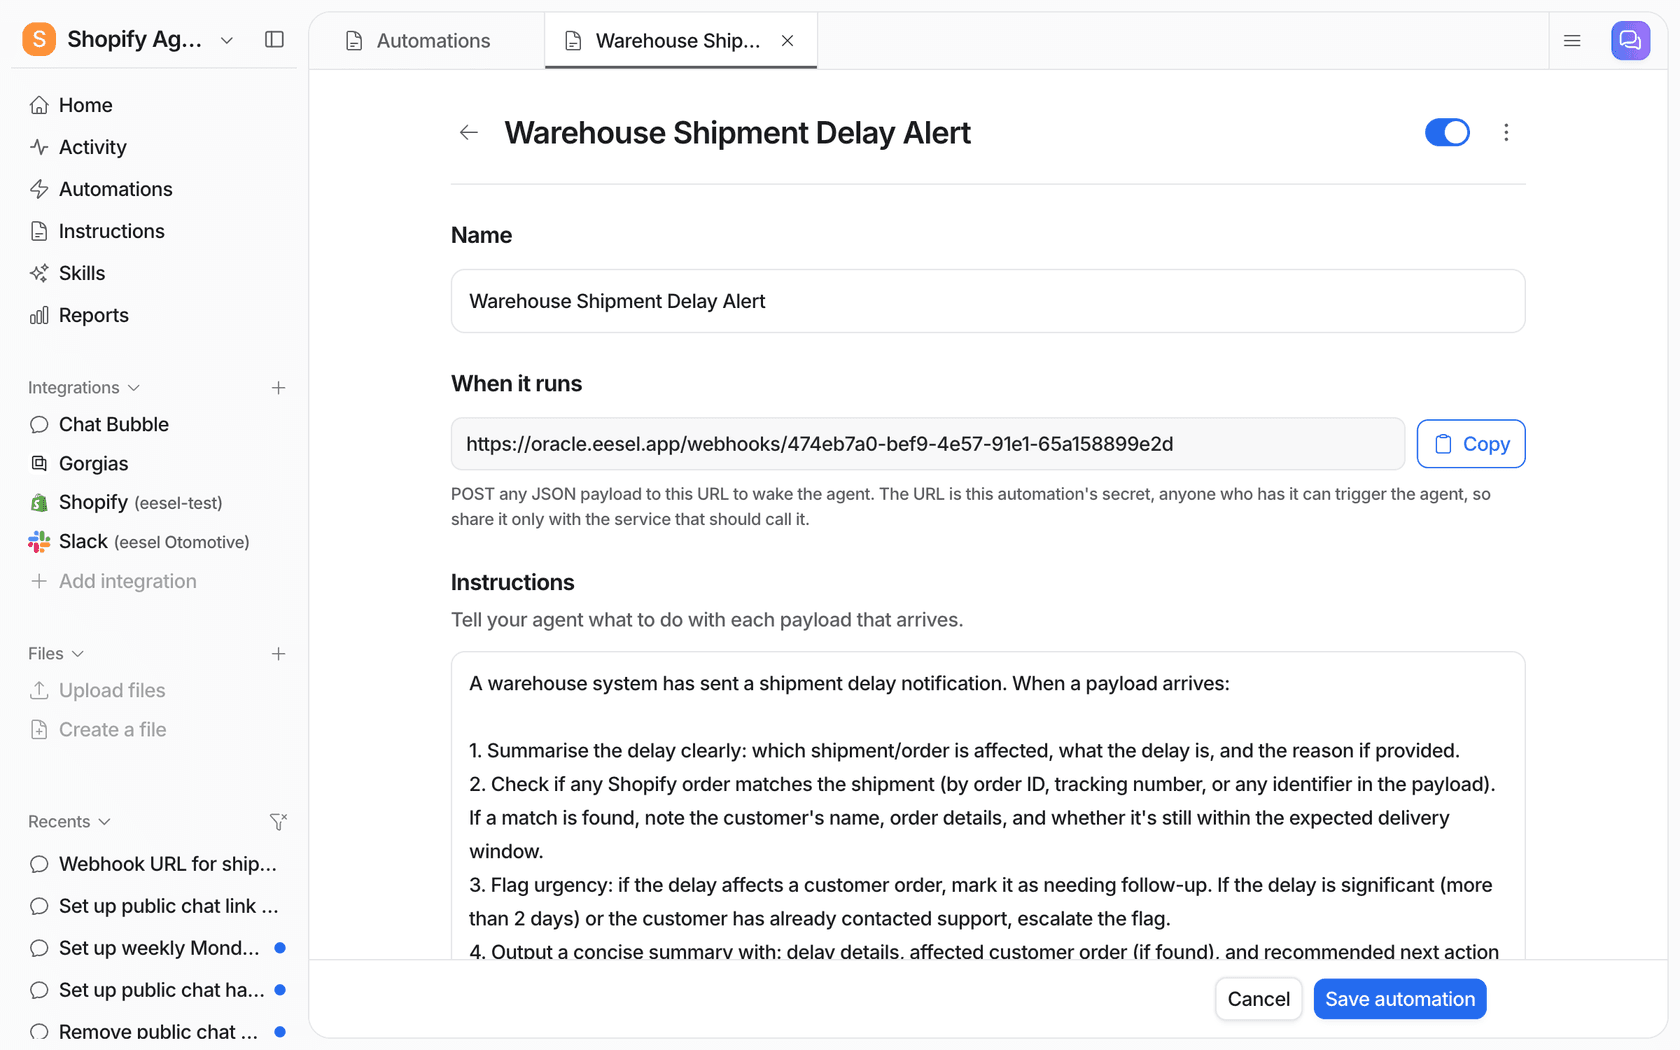
Dans l'exemple de la documentation, un payload de retard d'expédition arrive, l'agent cherche la commande Shopify correspondante, ne la trouve pas et ouvre un ticket tagué dans Gorgias pour l'équipe. Cela fait trois systèmes en une seule exécution, sans qu'un humain copie des données d'un onglet à l'autre.
Étape 7 : Testez sur vos propres anciens tickets avant de passer en production
Tester l'intégration d'un agent IA, ce n'est pas « l'API renvoie-t-elle 200 ». C'est « l'agent donne-t-il la réponse que mon équipe aurait donnée, avec les données qu'il peut maintenant atteindre ». Vos meilleures données de test sont les tickets résolus du mois dernier. Je ne répéterai pas ici la méthode complète, car tout un article sur le choix d'un agent IA de support la couvre, mais trois vérifications sont propres à l'intégration :
- Échantillonnez des tickets qui nécessitent chaque système. Si 30 % de vos tickets concernent le statut de commande, 30 % de votre jeu de test devraient aussi. Sinon vous ne testez que le centre d'aide.
- Vérifiez les actions, pas seulement les mots. Contrôlez quelles consultations et écritures l'agent a tentées, et sur quel enregistrement. Une réponse parfaite construite sur la mauvaise commande est un échec.
- Notez l'écart par sujet. Chez eesel, la compétence Simulation rejoue des tickets résolus et compare chaque réponse à ce que votre équipe a réellement envoyé. L'exemple de la documentation a échantillonné 20 tickets et 17 correspondaient, avec une liste hiérarchisée de correctifs pour le reste (documentation helpdesk). Les écarts pointent généralement droit vers une intégration manquante.
Étape 8 : Déployez une couche à la fois
Activez les choses dans l'ordre où vous les avez connectées, et n'élargissez l'accès qu'une fois la couche précédente passée proprement pendant un moment.
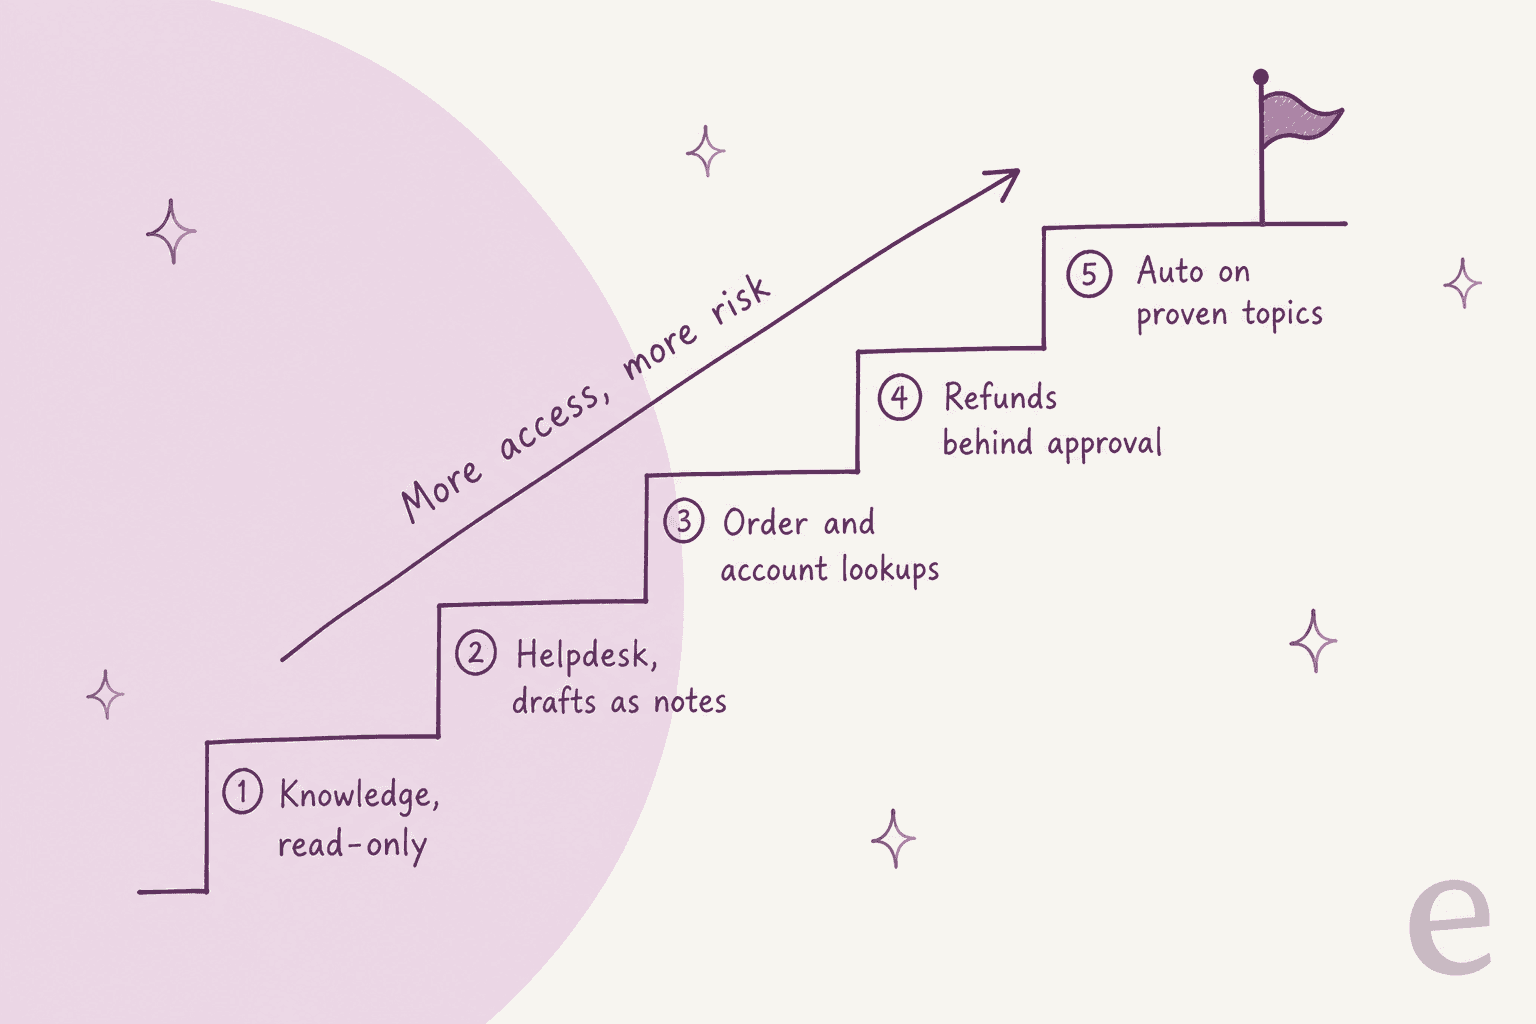
- Connaissances, lecture seule. Posez-lui des questions en interne. Aucun client ne voit rien.
- Helpdesk, brouillons en notes internes. Les agents lisent, modifient et envoient.
- Consultations de commandes et de comptes. Les brouillons incluent désormais le vrai statut de commande et le suivi.
- Remboursements et modifications sous validation. L'agent prépare l'action, un humain clique sur approuver. Chez eesel, cette validation peut se faire dans le tableau de bord, dans un fil Slack ou depuis le terminal avec
eesel approvals. - Automatique sur les sujets éprouvés. Uniquement pour les types de tickets dont les brouillons sont envoyés tels quels depuis des semaines.
Cela rejoint ce que recommandent les praticiens expérimentés :
« Le déploiement le plus sûr que j'aie vu : laisser l'agent rédiger, taguer la confiance et la raison, exiger une validation pour les remboursements ou changements de compte, et revoir chaque conversation rouverte pendant le premier mois. Ce journal de revue est généralement l'endroit où apparaît la vraie limite de l'automatisation. »
Prévoyez le passage de relais en même temps. Quand l'agent confie un ticket à un humain, celui-ci devrait recevoir un résumé de ce que l'agent a déjà consulté, pas une transcription brute. Le guide du transfert d'agent IA propose des modèles pour cela, et le guide d'automatisation explique quels types de tickets automatiser en premier.
Où se placent MCP, les API et les CLI
Vous entendrez beaucoup « utilisez simplement MCP » en ce moment, voici donc la version simple. MCP, le Model Context Protocol, est « un standard open source pour connecter des applications IA à des systèmes externes » (modelcontextprotocol.io). Un serveur MCP expose des outils (des actions qu'une IA peut appeler) et des ressources (des données qu'elle peut lire) sous une forme standard, afin que tout client compatible MCP puisse les utiliser. C'est une façon plus propre de câbler les couches « lire » et « agir », pas un remplacement de la réflexion sur les permissions ci-dessus. La dernière spécification va jusqu'à dire « L'autorisation est FACULTATIVE pour les implémentations MCP » (spécification d'autorisation MCP), vérifiez donc comment chaque serveur que vous connectez la gère.
Les fournisseurs avancent vite sur ce terrain. Le serveur MCP Rovo d'Atlassian couvre Jira, Confluence et plus, utilise OAuth 2.1 et respecte les permissions existantes des utilisateurs (documentation Atlassian). Shopify a déjà déplacé ses outils MCP de panier et de catalogue de la vitrine vers un nouveau point d'accès Universal Commerce Protocol (Shopify Storefront MCP). Attendez-vous à ce que les points d'accès continuent de bouger, et préférez une plateforme qui les maintient pour vous plutôt que de câbler chacun à la main. Il existe une explication plus longue sur MCP pour le support client.
MCP fonctionne aussi dans l'autre sens : votre agent de support peut être un serveur MCP avec lequel d'autres outils IA dialoguent. C'est ainsi qu'eesel fonctionne, et c'est pourquoi la CLI eesel existe.
Configurer toute l'intégration depuis un terminal
La CLI eesel place le même collègue IA dans votre terminal. Ce n'est pas un produit séparé ni une copie : « Tout ce que vous configurez dans la CLI apparaît dans le tableau de bord, et inversement. » Cela compte pour le travail d'intégration, car la configuration décrite dans cet article devient un script que vous pouvez relire, relancer et confier à un agent de code. Une configuration helpdesk plus boutique ressemble à ceci :
npx @eesel/cli login                       # or: npm install -g @eesel/cli
eesel integrations connect zendesk         # prints an approval link for a Zendesk admin
eesel integrations connect shopify         # a store owner approves the app install
eesel integrations download start          # copy past tickets, macros and pages into knowledge
eesel integrations zendesk actions         # every action, with its auto / ask / off setting
eesel integrations api check               # custom API access for your own systems
eesel automations                          # what wakes the agent, and the instructions it follows
eesel approvals                            # held actions waiting on a human
eesel activity                             # what the agent actually did, newest first
Quelques détails la rendent efficace pour l'automatisation. Chaque commande affiche du JSON. Les erreurs reviennent sous forme d'une ligne JSON avec un hint indiquant quoi exécuter à la place, ce qui permet à Claude Code, Cursor ou Codex d'exécuter la configuration sans qu'un humain lise la documentation. Les écritures faites depuis la CLI suivent les mêmes réglages de validation que le tableau de bord, --dry-run affiche l'appel exact qu'une écriture ferait sans l'envoyer, et EESEL_API_TOKEN avec EESEL_AGENT_ID permettent de l'exécuter en CI. La seule étape qu'elle ne peut pas sauter est la validation humaine dans chaque outil, et c'est très bien ainsi : un administrateur Zendesk doit toujours cliquer sur Autoriser.
Pour les clients MCP, eesel mcp token affiche une ligne claude mcp add prête à coller. Le jeton dure 30 jours et porte votre rôle dans l'espace de travail, de sorte qu'un lecteur peut discuter et lire l'activité tandis que seuls les éditeurs peuvent modifier instructions ou automatisations (documentation des clients MCP). Mes collègues en disent plus sur le pilotage des agents depuis une CLI et sur les serveurs MCP d'agents IA en général.
Erreurs que j'éviterais
- Se connecter avec votre propre identifiant d'administrateur. L'agent hérite de tout ce que vous voyez. Utilisez OAuth avec une identité dédiée et étroite.
- Connecter tout le wiki. Choisissez les espaces et dossiers que vous assumeriez devant un client. De vieux brouillons deviennent des réponses fausses énoncées avec aplomb.
- Activer les écritures dès le premier jour. Consultations d'abord, écritures sous validation, automatique en dernier.
- Supposer que la synchronisation est en direct. Découvrez comment chaque source se rafraîchit et comment vous remarqueriez une défaillance.
- Oublier les limites de débit partagées. Votre IA, votre synchronisation CRM et votre outil de reporting puisent dans le même budget d'API du helpdesk.
- Laisser l'agent décrire des actions qu'il ne peut pas faire. S'il ne peut pas annuler de commandes, ses instructions doivent le dire.
- Une tarification qui pénalise l'intégration. Demandez si une consultation de commande, une vérification CRM ou un appel d'outil comptent comme usage supplémentaire. Certains compteurs comptent chaque message ou action.
Branchez eesel sur la stack que vous avez déjà
Si vous parcourez cette liste et ne voulez pas construire chaque connecteur à la main, le collègue IA pour helpdesk d'eesel est conçu pour cela. Il rejoint votre helpdesk existant (Zendesk, Freshdesk, Gorgias, HubSpot, Salesforce et plus), apprend de vos anciens tickets, lit Confluence, Notion et Google Drive, consulte de vraies commandes dans Shopify et atteint vos propres API via une liste d'autorisation. Chaque action est réglée sur automatique, demander d'abord ou désactivée, et les validations peuvent venir de Slack, du tableau de bord ou de la CLI. Si Zendesk est votre helpdesk, la page d'intégration Zendesk montre la liste complète de ce qu'il peut lire et faire.
La tarification convient aussi à un travail riche en intégrations. Sur la page tarifs d'eesel, un ticket vaut un crédit « quel que soit le nombre de réponses échangées et ce que fait l'agent dedans : consulter une commande, vérifier une politique, mettre à jour un autre outil. » Les forfaits démarrent à 299 $ par mois pour 500 crédits, toutes les intégrations sont incluses, et l'offre gratuite vous donne 100 crédits pour connecter votre helpdesk et voir de vrais brouillons avant de payer.
Essayez eesel sur votre propre stack, ou réservez une démo si vous voulez que moi ou un collègue passions en revue votre configuration avec vous.
Questions fréquentes
Quels systèmes connecter en premier à un agent IA de support ?
Comment les agents IA s'intègrent-ils à Zendesk, Shopify et Slack ?
read_orders de Shopify ne couvre que 60 jours de commandes. Il existe des guides dédiés pour intégrer l'IA à Zendesk et intégrer l'IA à Shopify.
Comment intégrer un agent IA à ma stack métier ?